BioMCP


Destaques
Democratizando o acesso agêntico a bancos de dados e análises de bioinformática e biofarmacêutica.
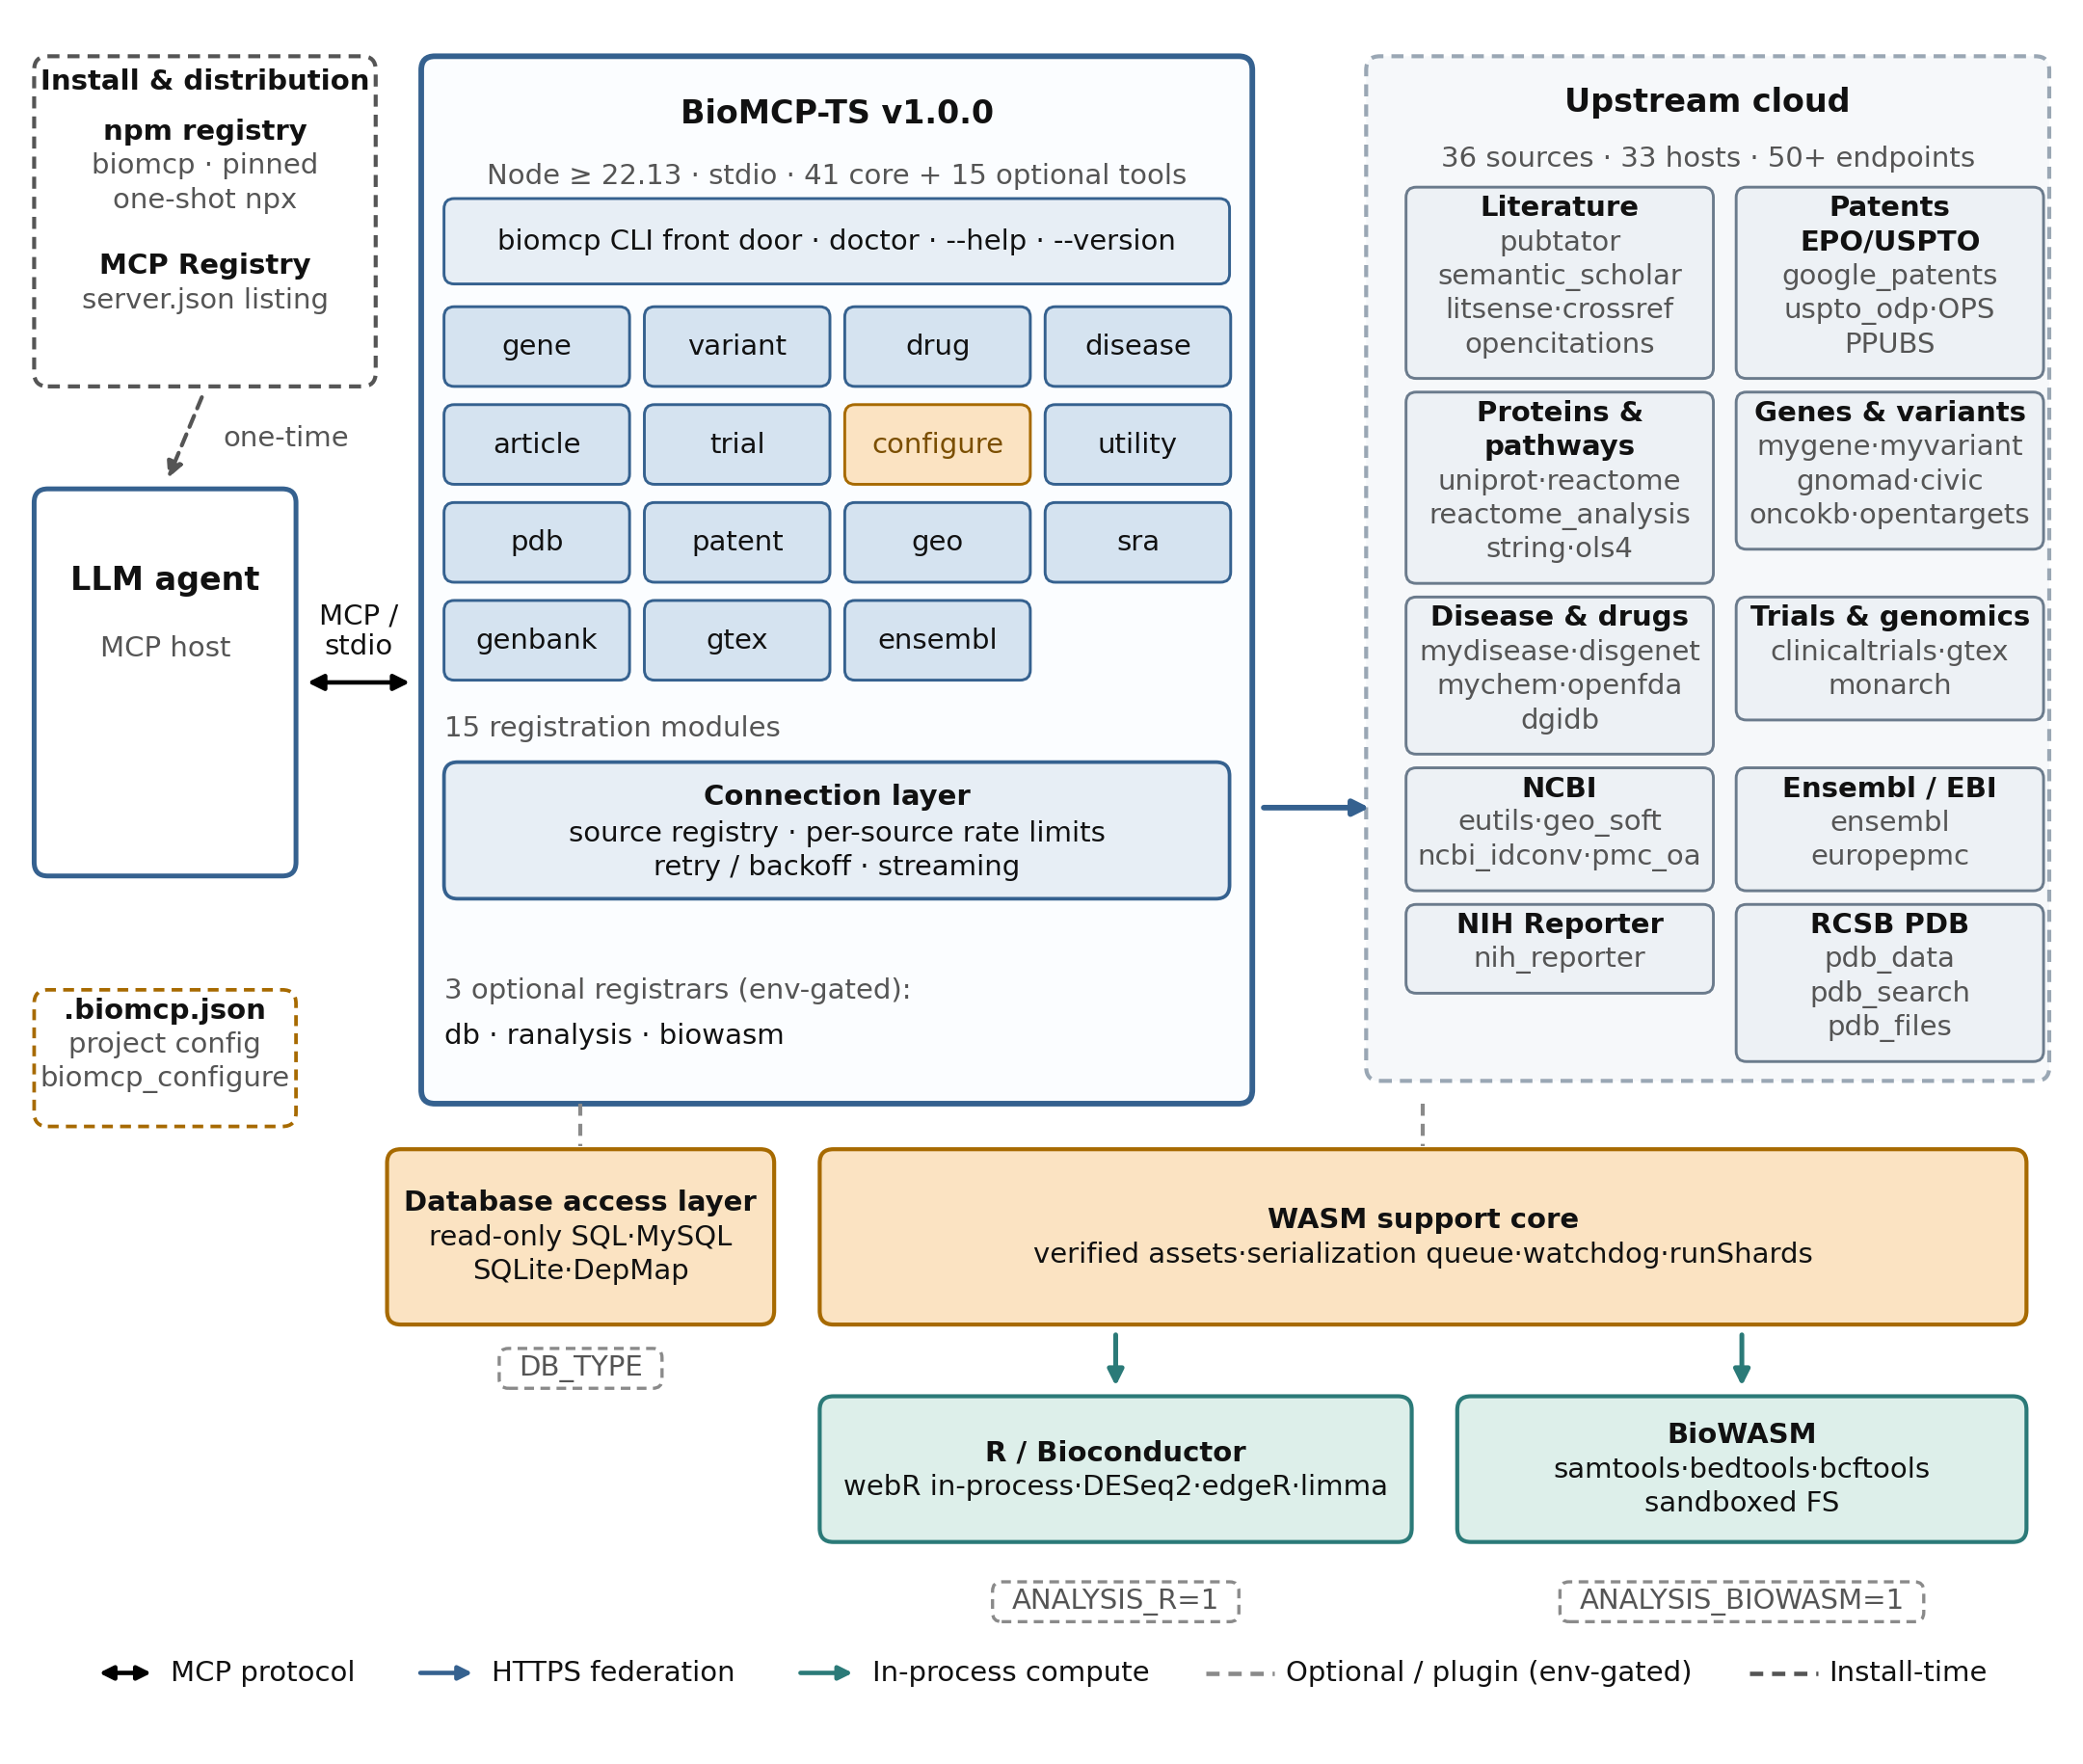
- Acesso federado baseado em seções a mais de 50 bancos de dados de bioinformática, farmacêutica e patentes
- Caixas de ferramentas opcionais para curadoria local de bancos de dados e análise sem dependências com Bioconductor e SAM/BED/BCFtools — sem instalação de R, toolchain C ou contêineres
- Exemplos concretos de vignettes, desenvolvidos totalmente em código aberto
Instalação
npx -y biomcp doctor   # diagnose a machine: Node gate, config health, feature gates, peer deps
npx biomcp             # zero-config stdio MCP server (this is what MCP clients run); Node >= 22.13
A configuração é guiada em docs/AGENT-INSTALL.md — início em um minuto, entradas de configuração copiar-e-colar para Claude Desktop, Claude Code, Codex e OpenCode (um único comando canônico fixado cobrindo todos os recursos), biomcp doctor como ponto único de entrada para solução de problemas e caminhos amigáveis para agentes para chaves de API e recursos opcionais.
Múltiplos agentes em uma máquina: o biomcp aplica o limite de taxa dos Termos de Uso do arXiv (1 requisição / 3 s) por processo. Ao executar múltiplas instâncias MCP do biomcp em uma máquina (por exemplo, uma instância stdio por agente), os limites de taxa não são coordenados entre processos, e os Termos de Uso do arXiv se aplicam a todas as suas máquinas em conjunto. Para implantações multi-agente em uma única máquina, execute um único daemon biomcp serve compartilhado (veja docs/SELF-HOSTING.md) para que todos os agentes compartilhem um processo e um limitador de taxa global.
Ferramentas Disponíveis
Os esquemas completos das ferramentas (parâmetros, enums, padrões) estão em src/server/README.md.
Gene (7)
| Ferramenta | Descrição |
|---|
gene_search | Pesquisar genes por símbolo, nome ou palavra-chave com filtro de cromossomo |
gene_get | Obter informações detalhadas do gene pelo símbolo HGNC com seções opcionais (core, pathways, protein, ontology, go, interactions, expression, protein_atlas, constraint, druggability, dosage_sensitivity, clinical_evidence, disease_associations, diseases, funding). Defina smart=true para resolver automaticamente aliases de genes (por exemplo, "HER2" → "ERBB2") |
gene_diseases | Obter doenças associadas a um gene (DisGeNET / OpenTargets) |
gene_drugs | Encontrar medicamentos que têm como alvo um gene (OpenTargets) |
gene_trials | Encontrar ensaios clínicos para um gene |
gene_articles | Encontrar artigos sobre um gene |
gene_enrich | Análise de enriquecimento de vias para uma lista de genes (Reactome) |
Variante (4)
| Ferramenta | Descrição |
|---|
variant_search | Pesquisar variantes por rsid, HGVS, gene, significância ClinVar, frequência, CADD |
variant_get | Obter informações detalhadas da variante com seções opcionais (frequency, predictions, clinical; alphagenome_scores atualmente retorna um erro de indisponibilidade até a reimplementação) |
variant_oncokb | Obter anotações de variantes de câncer OncoKB (requer ONCOKB_TOKEN) |
variant_trials | Encontrar ensaios clínicos para uma variante |
Medicamento (3)
| Ferramenta | Descrição |
|---|
drug_search | Pesquisar medicamentos por nome, mecanismo ou palavra-chave |
drug_get | Obter informações detalhadas do medicamento com seções opcionais (us_regulatory, eu_regulatory, who_regulatory, safety, targets, indications, adverse_events — reações FDA FAERS classificadas por contagem de relatos) |
drug_trials | Encontrar ensaios clínicos para um medicamento |
Doença (4)
| Ferramenta | Descrição |
|---|
disease_search | Pesquisar doenças por nome, fenótipo ou palavra-chave |
disease_get | Obter informações detalhadas da doença por ID (DOID, MONDO, OMIM, etc.) com seções opcionais (gene_associations, phenotypes, pathways) |
disease_drugs | Obter medicamentos para uma doença (OpenTargets) |
disease_trials | Obter ensaios clínicos para uma doença (ClinicalTrials.gov) |
Artigo (2)
| Ferramenta | Descrição |
|---|
article_search | Pesquisa federada de literatura em PubMed, EuropePMC, Semantic Scholar, arXiv, PubTator e LitSense com filtragem opcional por intervalo de datas; source: "preprint_only" alterna para apenas preprints bioRxiv+medRxiv (resumos, contagens de citações, filtragem por data) |
article_get | Obter informações detalhadas do artigo por identificador (PMID, PMCID, DOI ou DOI de preprint bioRxiv/medRxiv) com seções opcionais: oa (acesso aberto / informações de licença), annotations, graph (grafo de citações), citation (dados de citação rápidos/completos; citações Europe PMC para preprints). Registros de preprints incluem todas as versões, licença, categoria, financiadores, URL do texto completo JATS e mapeamento da versão publicada |
Ensaio Clínico (2)
| Ferramenta | Descrição |
|---|
trial_search | Pesquisar ensaios clínicos por condição, intervenção, status ou fase. Paginação baseada em cursor via page_token |
trial_get | Obter informações detalhadas do ensaio pelo ID NCT com seções opcionais (eligibility, locations, outcomes) |
Utilitário (2)
| Ferramenta | Descrição |
|---|
discover | Resolução de conceitos em texto livre em todos os tipos de entidades |
batch_get | Recuperar múltiplas entidades em paralelo |
Biologia Estrutural (1)
| Ferramenta | Descrição |
|---|
pdb | Pesquisar estruturas PDB, obter metadados de entrada com seções opcionais (polymer entities, ligands, assembly, experiment, citation) e baixar arquivos de estrutura (mmCIF/PDB) |
Patentes (2)
| Ferramenta | Descrição |
|---|
patent_search | Pesquisar patentes mundialmente (US, EP, WO, JP, 100+ autoridades) com filtros de cessionário/inventor/CPC/status/data e classificação por relevância (sort_by). Cite conceitos exatos de múltiplas palavras (por exemplo, "mRNA display"). Arte anterior fundamental é descoberta automaticamente via mineração de co-citação (seminal_prior_art; desative com seminal: false). Backends padrão: USPTO Public Search texto completo (US, sem chave, classificado por relevância) + EPO OPS (mundial, com chave); uspto_odp (metadados bibliográficos US) e google_patents (melhor esforço) disponíveis via source |
patent_get | Obter detalhes da patente por número de publicação com seções: resumo, reivindicações (texto completo US via USPTO Public Search; EP/WO via EPO OPS), citações (para frente + para trás), família, classificações |
GEO (2)
| Ferramenta | Descrição |
|---|
geo_search | Pesquisar NCBI GEO para estudos de genômica funcional (microarranjos de expressão, RNA-seq, séries de célula única) por tipo de entrada (GSE/GSM/GPL/GDS) e organismo; resultados trazem links cruzados (sra_project, bioproject, pubmed_ids) para encadeamento |
geo_get | Obter o registro SOFT completo para uma série/amostra/plataforma GEO: resumo, organismos, pré-visualização de amostras (≤20), URLs de arquivos suplementares e referências cruzadas; opcionalmente baixar o primeiro arquivo suplementar |
SRA (2)
| Ferramenta | Descrição |
|---|
sra_search | Pesquisar o Sequence Read Archive do NCBI para experimentos e execuções de sequenciamento por texto livre, acesso ou sintaxe de campo; retorna acessos de experimento/estudo/amostra com estratégia de biblioteca e contagens de execuções |
sra_get | Obter detalhes completos para um acesso SRA: execução SRR (instrumento, spots, bases, tamanho), experimento SRX (design de biblioteca), estudo SRP (lista de experimentos) ou amostra SRS; acessos ENA/DDBJ rejeitados com um ponteiro ENA |
GenBank (3)
| Ferramenta | Descrição |
|---|
genbank_search | Pesquisar registros de nucleotídeos do NCBI (GenBank/RefSeq/INSDC) por termos simples, acesso ou sintaxe de campo; resultados incluem accession.version, definição, comprimento, organismo, topologia |
genbank_get | Buscar um registro GenBank/RefSeq como arquivo plano GenBank ou FASTA; registros completos limitados a 2 Mb — registros maiores requerem uma região seq_start/seq_stop (até 10 Mb, fita reversa via strand=2) |
genbank_genes | Mapear um acesso GenBank/RefSeq para seus IDs de genes NCBI (elink nuccore→gene) para ponte nas ferramentas de genes |
GTEx (2)
| Ferramenta | Descrição |
|---|
gtex_expression | Obter expressão gênica mediana entre tecidos GTEx (Analysis v10, 54 sítios de tecido, TPM, maior primeiro); aceita símbolo HGNC ou ID de gene Ensembl, com filtro opcional de tecido único |
gtex_eqtl | Obter associações cis-eQTL significativas para um gene em um tecido GTEx específico (v10): variant_id, p_value, NES, slope, ordenados por p-valor ascendente |
Ensembl (4)
| Ferramenta | Descrição |
|---|
ensembl_lookup | Resolver um gene em termos Ensembl para qualquer uma das ~356 espécies: ID estável (+versão), símbolo, coordenadas na montagem atual, transcrito canônico; expand=true adiciona transcritos com IDs de tradução/proteína |
ensembl_homology | Encontrar ortólogos/parálogos entre espécies via Ensembl Compara — IDs estáveis alvo, nível taxonômico, identidade percentual, ordenados por identidade; filtre com target_species/target_taxon |
ensembl_consequence | Calcular consequências de variantes sob demanda via Ensembl VEP para variantes NOVAS e espécies não humanas: consequência mais grave, efeitos por transcrito (SIFT/PolyPhen), dados co-localizados ClinVar/COSMIC/gnomAD. Variantes humanas conhecidas obtêm pontuações pré-computadas mais profundas via variant_get; prefira entrada HGVS em vez de rsIDs para precisão |
ensembl_region | Consultar genes/transcritos/variantes conhecidas em um intervalo genômico (chr:start-end) na montagem atual — triagem de locus |
Análise R (4, opcional — ANALYSIS_R=1)
| Ferramenta | Descrição |
|---|
analysis_r_deseq2 | Expressão diferencial para contagens de RNA-seq com Bioconductor DESeq2 (binomial negativa, filtragem independente, encolhimento LFC opcional) em R WebAssembly em sandbox. Entradas: matriz de contagens inteiras + metadados de amostras + fórmula de design; saída: tabela markdown dos principais genes por p-valor ajustado com resumo (format="json", include_full=true para tabela completa base64(gzip(TSV))) |
analysis_r_edger | Expressão diferencial com edgeR — normalização TMM, dispersão empírica de Bayes, teste F de quase-verossimilhança (test="qlm") ou teste exato de 2 grupos; mesmo contrato de entrada/saída |
analysis_r_limma | Expressão diferencial com limma-voom — modelos lineares ponderados por precisão com moderação empírica de Bayes; mesmo contrato de entrada/saída |
analysis_r_session_info | Relatório de runtime R: versões R/webR, versões de pacotes instalados, memória, endpoint de espelho — para diagnosticar problemas de análise |
O primeiro uso inicia um worker R WebAssembly de ~1 GB e baixa o pacote wasm (~62 MB) dos releases do GitHub (em cache). Requer webr instalado ao lado do biomcp. Guia: docs/R-ANALYSIS.md.
Análise Biowasm (8, opcional — ANALYSIS_BIOWASM=1)
| Ferramenta | Descrição |
|---|
analysis_bam_summary | Inspecionar um alinhamento (SAM/BAM/CRAM): contigs do cabeçalho, amostras/grupos de leitura, métricas de mapeamento flagstat, contagens por contig via idxstats quando indexado — "o que há neste BAM?" antes do trabalho em região |
analysis_bam_view_region | Leituras, profundidade, pileup ou extração de leituras em uma região genômica (samtools view/depth/mpileup); fontes indexadas usam recuperação posicional rápida, fontes sem índice transmitem um filtro BED (profundidade requer entrada ordenada por coordenadas e detecta violações de ordem), retornando contagens, tabelas de cobertura, linhas SAM ou um artefato BAM |
analysis_bcf_summary | Inspecionar um VCF/BCF: contigs, número e nomes de amostras, inventário de campos INFO/FORMAT do cabeçalho |
analysis_bcf_view_region | Variantes em uma região como uma projeção estreita de campos (bcftools query): colunas escolhidas, subconjuntos de amostras, filtros de expressão, tipos de variantes — ou um artefato VCF.gz fatiado |
analysis_bed_op | Álgebra de intervalos em faixas BED (bedtools intersect/merge/subtract/coverage/jaccard/sort) com o algoritmo de streaming -sorted para entradas ordenadas |
analysis_biowasm_convert | Conectividade de formatos: SAM/BAM/CRAM via samtools view, VCF/BCF via bcftools view, VCF/BCF → TSV via bcftools query; resultados são identificadores de artefatos reutilizáveis como artifact_id |
analysis_biowasm_session_info | Relatório de runtime do Biowasm: versões fixadas de ferramentas, estado do cache de ativos, status do motor, artefatos retidos, memória |
analysis_biowasm_cli | Saída de emergência restrita: um subcomando samtools/bedtools/bcftools na lista de permissões com argumentos validados por esquema (sem shell, caminhos apenas sob /shared) |
O primeiro uso baixa ativos wasm verificados por checksum (~4,5 MB, em cache); sem pacotes npm extras. Fontes indexadas respondem a consultas de região com recuperação posicional rápida (~0,2 % do arquivo lido); fontes sem índice recorrem a filtros BED de streaming. Guia: docs/BIOWASM-ANALYSIS.md.
Módulo de Citações
Citações federam 5 provedores em modo rápido (~4s) ou completo (~15-30s). Listas de citações diretas vêm de Europe PMC, OpenCitations e Semantic Scholar; Crossref fornece contagens e referências reversas. Matriz de provedores e detalhes de esquema: src/server/README.md.
Recursos Opcionais
Capacidades que acompanham o pacote, mas permanecem inativas até serem habilitadas. Cada uma tem seu próprio guia:
| Recurso | Habilitar | Guia |
|---|
Acesso a banco de dados — ferramentas SQL somente leitura (db_query, db_list_tables, db_describe_table) para MySQL e SQLite de arquivo local | Defina DB_TYPE (+ variáveis de ambiente de conexão); MySQL precisa da dependência par mysql2 — use o comando de cliente único fixado (veja docs/DATABASE.md) | docs/DATABASE.md |
Análise em R — expressão diferencial Bioconductor (analysis_r_deseq2, analysis_r_edger, analysis_r_limma, analysis_r_session_info) executando DESeq2/edgeR/limma em R WebAssembly em sandbox; pacotes wasm baixam de releases do GitHub no primeiro uso (~62 MB, em cache; links lentos: asset_timeout_ms ou um mirror_url auto-buscado) | Defina ANALYSIS_R=1; precisa da dependência par webr — use o comando de cliente único fixado ["npx","-y","-p","biomcp@1.5","-p","webr@0.6","biomcp"] (variante com todos os recursos adiciona -p mysql2@3); espere ~1 GB RSS | docs/R-ANALYSIS.md |
| Análise Biowasm — samtools/bedtools/bcftools (BAM/BED/VCF) em WebAssembly em sandbox; transmite/indexa conjuntos de dados reais em escala humana (~300 MB de varreduras BAM, consultas de região tocam ~0,2 % do arquivo); ativos ~4,5 MB em cache no primeiro uso; sem pacotes npm extras | Defina ANALYSIS_BIOWASM=1 | docs/BIOWASM-ANALYSIS.md |
Em vez de editar blocos de ambiente manualmente, agentes (e usuários) podem se autoatender pela ferramenta sempre disponível biomcp_configure: ela relata o status/proveniência de cada parâmetro, escreve o arquivo de configuração do projeto .biomcp.json para os recursos opcionais acima (variáveis de ambiente mantêm precedência; parâmetros somente de ambiente são somente consulta e com valor mascarado), valida alterações, detecta conflitos, verifica pré-requisitos de dependências par e detalha as etapas de reinicialização/verificação. Detalhes: docs/ENV-VARS.md → Arquivo de configuração do projeto.
Documentação
Licença
Licenciado sob a Apache License, Versão 2.0. Veja NOTICE para atribuições.
BioMCP-TS é adaptado do projeto upstream BioMCP Rust (MIT) com uma abordagem de desenvolvimento priorizando agentes e melhorias — créditos aos autores originais.