BioMCP


Aspectos destacados
Democratizando el acceso agéntico a bases de datos y análisis bioinformáticos y biofarmacéuticos.
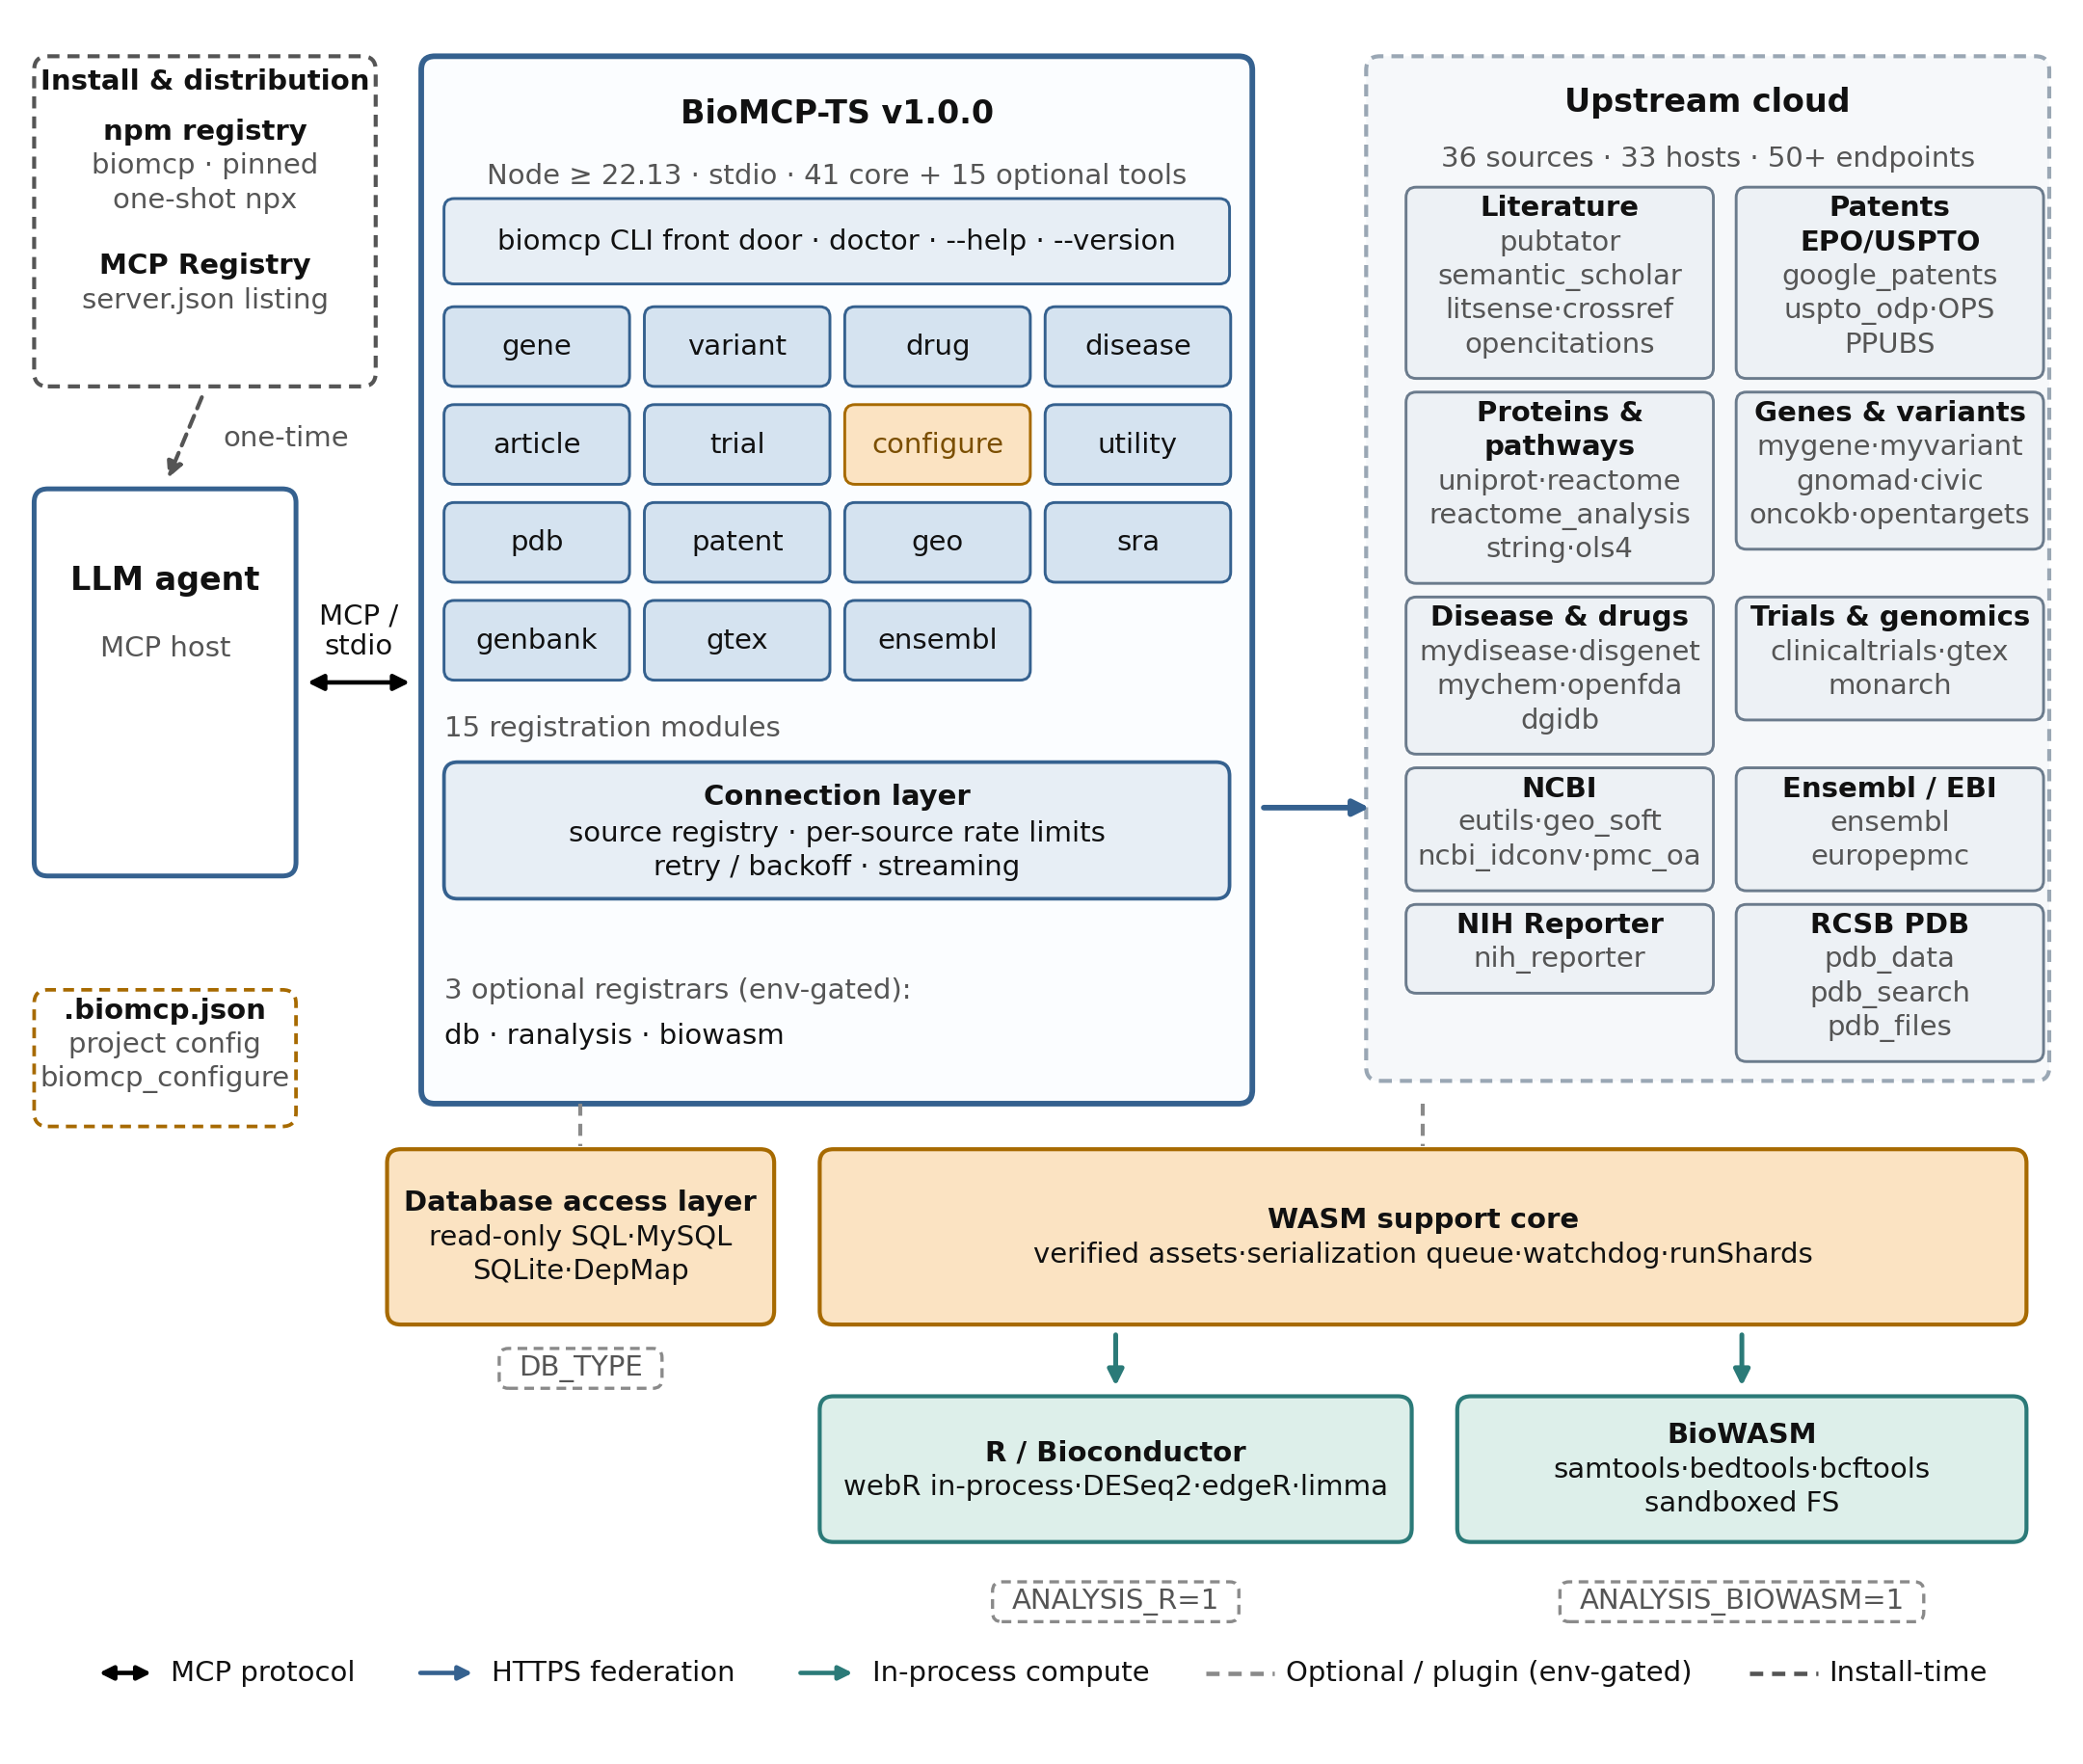
- Acceso federado basado en secciones a más de 50 bases de datos bioinformáticas, farmacéuticas y de patentes
- Cajas de herramientas opcionales para curación local de bases de datos y análisis sin dependencias con Bioconductor y SAM/BED/BCFtools — sin instalación de R, cadena de herramientas C ni contenedores
- Ejemplos concretos de viñetas, desarrollados completamente en abierto
Instalación
npx -y biomcp doctor   # diagnose a machine: Node gate, config health, feature gates, peer deps
npx biomcp             # zero-config stdio MCP server (this is what MCP clients run); Node >= 22.13
La configuración está guiada en docs/AGENT-INSTALL.md — un inicio de un minuto, entradas de configuración de copiar y pegar para Claude Desktop, Claude Code, Codex y OpenCode (un único comando canónico fijado que cubre todas las funciones), biomcp doctor como punto único de entrada para resolución de problemas, y rutas amigables para agentes para claves API y funciones opcionales.
Múltiples agentes en una máquina: biomcp aplica el límite de tasa de los Términos de Uso de arXiv (1 solicitud / 3 s) por proceso. Al ejecutar múltiples instancias MCP de biomcp en una máquina (por ejemplo, una instancia stdio por agente), los límites de tasa no se coordinan entre procesos, y los TOU de arXiv se aplican a todas sus máquinas en conjunto. Para implementaciones de múltiples agentes en una sola máquina, ejecute un único daemon biomcp serve compartido (ver docs/SELF-HOSTING.md) para que todos los agentes compartan un proceso y un limitador de tasa global.
Herramientas disponibles
Los esquemas completos de las herramientas (parámetros, enums, valores predeterminados) se encuentran en src/server/README.md.
Gen (7)
| Herramienta | Descripción |
|---|
gene_search | Buscar genes por símbolo, nombre o palabra clave con filtro de cromosoma |
gene_get | Obtener información detallada del gen por símbolo HGNC con secciones opcionales (core, pathways, protein, ontology, go, interactions, expression, protein_atlas, constraint, druggability, dosage_sensitivity, clinical_evidence, disease_associations, diseases, funding). Establezca smart=true para resolver automáticamente alias de genes (por ejemplo, "HER2" → "ERBB2") |
gene_diseases | Obtener enfermedades asociadas a un gen (DisGeNET / OpenTargets) |
gene_drugs | Encontrar fármacos que se dirigen a un gen (OpenTargets) |
gene_trials | Encontrar ensayos clínicos para un gen |
gene_articles | Encontrar artículos sobre un gen |
gene_enrich | Análisis de enriquecimiento de rutas para una lista de genes (Reactome) |
Variante (4)
| Herramienta | Descripción |
|---|
variant_search | Buscar variantes por rsid, HGVS, gen, significancia ClinVar, frecuencia, CADD |
variant_get | Obtener información detallada de la variante con secciones opcionales (frequency, predictions, clinical; alphagenome_scores actualmente devuelve un error de indisponibilidad pendiente de reimplementación) |
variant_oncokb | Obtener anotaciones de variantes de cáncer OncoKB (requiere ONCOKB_TOKEN) |
variant_trials | Encontrar ensayos clínicos para una variante |
Fármaco (3)
| Herramienta | Descripción |
|---|
drug_search | Buscar fármacos por nombre, mecanismo o palabra clave |
drug_get | Obtener información detallada del fármaco con secciones opcionales (us_regulatory, eu_regulatory, who_regulatory, safety, targets, indications, adverse_events — reacciones FDA FAERS clasificadas por número de informes) |
drug_trials | Encontrar ensayos clínicos para un fármaco |
Enfermedad (4)
| Herramienta | Descripción |
|---|
disease_search | Buscar enfermedades por nombre, fenotipo o palabra clave |
disease_get | Obtener información detallada de la enfermedad por ID (DOID, MONDO, OMIM, etc.) con secciones opcionales (gene_associations, phenotypes, pathways) |
disease_drugs | Obtener fármacos para una enfermedad (OpenTargets) |
disease_trials | Obtener ensayos clínicos para una enfermedad (ClinicalTrials.gov) |
Artículo (2)
| Herramienta | Descripción |
|---|
article_search | Búsqueda federada de literatura en PubMed, EuropePMC, Semantic Scholar, arXiv, PubTator y LitSense con filtrado opcional por rango de fechas; source: "preprint_only" cambia a solo preprints de bioRxiv+medRxiv (resúmenes, recuentos de citas, filtrado por fecha) |
article_get | Obtener información detallada del artículo por identificador (PMID, PMCID, DOI o DOI de preprint de bioRxiv/medRxiv) con secciones opcionales: oa (información de acceso abierto / licencia), annotations, graph (grafo de citas), citation (datos de citas rápidos/completos; citas de Europe PMC para preprints). Los registros de preprints incluyen todas las versiones, licencia, categoría, financiadores, URL de texto completo JATS y mapeo de versión publicada |
Ensayo clínico (2)
| Herramienta | Descripción |
|---|
trial_search | Buscar ensayos clínicos por condición, intervención, estado o fase. Paginación basada en cursor mediante page_token |
trial_get | Obtener información detallada del ensayo por ID de NCT con secciones opcionales (eligibility, locations, outcomes) |
Utilidad (2)
| Herramienta | Descripción |
|---|
discover | Resolución de conceptos en texto libre en todos los tipos de entidades |
batch_get | Recuperar múltiples entidades en paralelo |
Biología estructural (1)
| Herramienta | Descripción |
|---|
pdb | Buscar estructuras PDB, obtener metadatos de entrada con secciones opcionales (polymer entities, ligands, assembly, experiment, citation) y descargar archivos de estructura (mmCIF/PDB) |
Patentes (2)
| Herramienta | Descripción |
|---|
patent_search | Buscar patentes en todo el mundo (US, EP, WO, JP, más de 100 autoridades) con filtros de cesionario/inventor/CPC/estado/fecha y clasificación por relevancia (sort_by). Cite conceptos exactos de múltiples palabras (por ejemplo, "mRNA display"). La técnica anterior fundamental se descubre automáticamente mediante minería de co-citas (seminal_prior_art; deshabilitar con seminal: false). Backends predeterminados: USPTO Public Search de texto completo (US, sin clave, clasificado por relevancia) + EPO OPS (mundial, con clave); uspto_odp (metadatos bibliográficos de EE. UU.) y google_patents (mejor esfuerzo) disponibles mediante source |
patent_get | Obtener detalles de la patente por número de publicación con secciones: resumen, reivindicaciones (texto completo de EE. UU. mediante USPTO Public Search; EP/WO mediante EPO OPS), citas (hacia adelante + hacia atrás), familia, clasificaciones |
GEO (2)
| Herramienta | Descripción |
|---|
geo_search | Buscar en NCBI GEO estudios de genómica funcional (microarrays de expresión, RNA-seq, series de células individuales) por tipo de entrada (GSE/GSM/GPL/GDS) y organismo; los resultados incluyen enlaces cruzados (sra_project, bioproject, pubmed_ids) para encadenamiento |
geo_get | Obtener el registro SOFT completo para una serie/muestra/plataforma GEO: resumen, organismos, vista previa de muestra (≤20), URL de archivos suplementarios y referencias cruzadas; opcionalmente descargar el primer archivo suplementario |
SRA (2)
| Herramienta | Descripción |
|---|
sra_search | Buscar en el Archivo de Lecturas de Secuencia de NCBI experimentos y ejecuciones de secuenciación por texto libre, acceso o sintaxis de campo; devuelve accesiones de experimento/estudio/muestra con estrategia de biblioteca y recuentos de ejecuciones |
sra_get | Obtener detalles completos para una accesión SRA: ejecución SRR (instrumento, spots, bases, tamaño), experimento SRX (diseño de biblioteca), estudio SRP (lista de experimentos) o muestra SRS; las accesiones ENA/DDBJ se rechazan con un puntero a ENA |
GenBank (3)
| Herramienta | Descripción |
|---|
genbank_search | Buscar registros de nucleótidos de NCBI (GenBank/RefSeq/INSDC) por términos simples, accesión o sintaxis de campo; los resultados incluyen accession.version, definición, longitud, organismo, topología |
genbank_get | Obtener un registro GenBank/RefSeq como archivo plano GenBank o FASTA; los registros completos están limitados a 2 Mb — los registros más grandes requieren una región seq_start/seq_stop (hasta 10 Mb, cadena inversa mediante strand=2) |
genbank_genes | Mapear una accesión GenBank/RefSeq a sus IDs de genes NCBI (elink nuccore→gene) para puentear hacia herramientas de genes |
GTEx (2)
| Herramienta | Descripción |
|---|
gtex_expression | Obtener expresión génica mediana en tejidos GTEx (Análisis v10, 54 sitios de tejido, TPM, mayor primero); acepta símbolo HGNC o ID de gen Ensembl, con filtro opcional de tejido único |
gtex_eqtl | Obtener asociaciones cis-eQTL significativas para un gen en un tejido GTEx específico (v10): variant_id, p_value, NES, slope, ordenados por valor p ascendente |
Ensembl (4)
| Herramienta | Descripción |
|---|
ensembl_lookup | Resolver un gen en términos Ensembl para cualquiera de ~356 especies: ID estable (+versión), símbolo, coordenadas en el ensamblaje actual, transcripción canónica; expand=true añade transcripciones con IDs de traducción/proteína |
ensembl_homology | Encontrar ortólogos/parálogos entre especies mediante Ensembl Compara — IDs estables objetivo, nivel taxonómico, porcentaje de identidad, ordenados por identidad; filtrar con target_species/target_taxon |
ensembl_consequence | Calcular consecuencias de variantes bajo demanda mediante Ensembl VEP para variantes NOVEDOSAS y especies no humanas: consecuencia más grave, efectos por transcripción (SIFT/PolyPhen), datos co-ubicados de ClinVar/COSMIC/gnomAD. Las variantes humanas conocidas obtienen puntuaciones precomputadas más profundas mediante variant_get; prefiera entrada HGVS sobre rsIDs para precisión |
ensembl_region | Consultar genes/transcripciones/variantes conocidas en un intervalo genómico (chr:start-end) en el ensamblaje actual — triaje de locus |
Análisis R (4, opcional — ANALYSIS_R=1)
| Herramienta | Descripción |
|---|
analysis_r_deseq2 | Expresión diferencial para recuentos de RNA-seq con Bioconductor DESeq2 (binomial negativa, filtrado independiente, contracción LFC opcional) en R WebAssembly en sandbox. Entradas: matriz de recuentos enteros + metadatos de muestra + fórmula de diseño; salida: tabla markdown de los principales genes por valor p ajustado con resumen (format="json", include_full=true para tabla completa base64(gzip(TSV))) |
analysis_r_edger | Expresión diferencial con edgeR — normalización TMM, dispersión empírica-Bayes, prueba F de cuasi-verosimilitud (test="qlm") o prueba exacta de 2 grupos; mismo contrato de entrada/salida |
analysis_r_limma | Expresión diferencial con limma-voom — modelos lineales ponderados por precisión con moderación empírica-Bayes; mismo contrato de entrada/salida |
analysis_r_session_info | Informe de tiempo de ejecución de R: versiones de R/webR, versiones de paquetes instalados, memoria, endpoint de espejo — para diagnosticar problemas de análisis |
El primer uso inicia un trabajador R WebAssembly de ~1 GB y descarga el paquete wasm (~62 MB) de los lanzamientos de GitHub (en caché). Requiere webr instalado junto a biomcp. Guía: docs/R-ANALYSIS.md.
Análisis Biowasm (8, opcional — ANALYSIS_BIOWASM=1)
| Herramienta | Descripción |
|---|
analysis_bam_summary | Inspeccionar una alineación (SAM/BAM/CRAM): contigs del encabezado, muestras/grupos de lectura, métricas de mapeo flagstat, recuentos por contig mediante idxstats cuando está indexado — "¿qué hay en este BAM?" antes del trabajo por región |
analysis_bam_view_region | Lecturas, profundidad, pileup o extracción de lecturas en una región genómica (samtools view/depth/mpileup); las fuentes indexadas usan recuperación posicional rápida, las fuentes sin índice transmiten un filtro BED (la profundidad requiere entrada ordenada por coordenadas y detecta violaciones de orden), devolviendo recuentos, tablas de cobertura, filas SAM o un artefacto BAM |
analysis_bcf_summary | Inspeccionar un VCF/BCF: contigs, número y nombres de muestras, inventario de campos INFO/FORMAT del encabezado |
analysis_bcf_view_region | Variantes en una región como proyección de campos estrecha (bcftools query): columnas elegidas, subconjuntos de muestras, filtros de expresión, tipos de variante — o un artefacto VCF.gz segmentado |
analysis_bed_op | Álgebra de intervalos en pistas BED (bedtools intersect/merge/subtract/coverage/jaccard/sort) con el algoritmo de transmisión -sorted para entradas ordenadas |
analysis_biowasm_convert | Plomería de formatos: SAM/BAM/CRAM mediante samtools view, VCF/BCF mediante bcftools view, VCF/BCF → TSV mediante bcftools query; los resultados son identificadores de artefactos reutilizables como artifact_id |
analysis_biowasm_session_info | Informe del runtime de Biowasm: versiones de herramientas fijadas, estado de caché de activos, estado del motor, artefactos retenidos, memoria |
analysis_biowasm_cli | Vía de escape restringida: un subcomando samtools/bedtools/bcftools en lista blanca con argumentos validados por esquema (sin shell, rutas solo bajo /shared) |
El primer uso descarga activos wasm verificados por checksum (~4.5 MB, en caché); sin paquetes npm adicionales. Las fuentes indexadas responden consultas de región con recuperación posicional rápida (~0.2 % del archivo leído); las fuentes sin índice recurren a filtros BED de transmisión. Guía: docs/BIOWASM-ANALYSIS.md.
Módulo de Citas
Las citas federan 5 proveedores en modo rápido (~4s) o completo (~15-30s). Las listas de citas directas provienen de Europe PMC, OpenCitations y Semantic Scholar; Crossref proporciona recuentos y referencias inversas. Matriz de proveedores y detalles de esquema: src/server/README.md.
Características Opcionales
Capacidades que se incluyen con el paquete pero permanecen inactivas hasta que se habilitan. Cada una enlaza a su propia guía:
| Característica | Habilitar | Guía |
|---|
Acceso a bases de datos — herramientas SQL de solo lectura (db_query, db_list_tables, db_describe_table) para MySQL y SQLite de archivos locales | Establecer DB_TYPE (+ variables de entorno de conexión); MySQL necesita la dependencia par mysql2 — usa el comando de cliente único fijado (ver docs/DATABASE.md) | docs/DATABASE.md |
Análisis R — expresión diferencial de Bioconductor (analysis_r_deseq2, analysis_r_edger, analysis_r_limma, analysis_r_session_info) ejecutando DESeq2/edgeR/limma en R WebAssembly en sandbox; los paquetes wasm se descargan de releases de GitHub en el primer uso (~62 MB, en caché; enlaces lentos: asset_timeout_ms o un mirror_url auto-descargado) | Establecer ANALYSIS_R=1; necesita la dependencia par webr — usa el comando de cliente único fijado ["npx","-y","-p","biomcp@1.5","-p","webr@0.6","biomcp"] (la variante de todas las características añade -p mysql2@3); espera ~1 GB RSS | docs/R-ANALYSIS.md |
| Análisis Biowasm — samtools/bedtools/bcftools (BAM/BED/VCF) en WebAssembly en sandbox; transmite/indexa conjuntos de datos reales a escala humana (~escaneos de BAM de 300 MB, consultas de región tocan ~0.2 % del archivo); activos ~4.5 MB en caché en el primer uso; sin paquetes npm adicionales | Establecer ANALYSIS_BIOWASM=1 | docs/BIOWASM-ANALYSIS.md |
En lugar de editar manualmente bloques de entorno, los agentes (y usuarios) pueden autogestionarse mediante la herramienta siempre disponible biomcp_configure: informa el estado/procedencia de cada parámetro, escribe el archivo de configuración del proyecto .biomcp.json para las características opcionales anteriores (las variables de entorno mantienen precedencia; los parámetros solo de entorno son de solo consulta y con valor enmascarado), valida cambios, detecta conflictos, verifica requisitos previos de dependencias par y detalla los pasos de reinicio/verificación. Detalles: docs/ENV-VARS.md → Archivo de configuración del proyecto.
Documentación
Licencia
Licenciado bajo la Apache License, Version 2.0. Ver NOTICE para atribuciones.
BioMCP-TS está adaptado del proyecto upstream BioMCP Rust (MIT) con un enfoque de desarrollo primero para agentes y mejoras — reconocimiento a los autores originales.