llmtrim
Servidor MCP que comprime tus solicitudes a la API de LLM para que pagues menos, sin cambiar las respuestas. Recorta tokens desperdiciados de prompts, historial, salida de herramientas y código antes de enviarlos: -31% de entrada / -74% de salida, medido en vivo.
Documentación
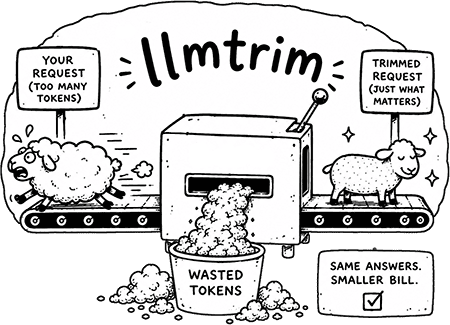
llmtrim
Proxy local que comprime el tráfico de API de LLM para que pagues menos. Mismas respuestas, factura más pequeña.
−31% entrada · −74% salida · −66% costo de ida y vuelta · 112 casos A/B en vivo · ~5 ms/llamada · sin modelo que cargar
¿Usas Claude Code? Una instalación también te da /sub
para servirlo a través de CLIProxyAPI.
Proxy · CLI · MCP · librería (Python · Ruby · Swift · Kotlin · JS/WASM)



Qué hace • Instalación • Día a día • En acción • Funciona con • Claude Code • Números • Config • CLI y librería
Qué hace
Ejecutas Claude Code, Codex, Cursor o tu propia aplicación. En cada turno, la herramienta envía una solicitud grande: prompt del sistema, herramientas, historial, salida cruda de comandos. Pagas por cada token de eso, incluidas las partes que no ayudan al modelo.
Un registro de compilación de 200 líneas con dos errores. Esquemas de herramientas reenviados en cada llamada. JSON con cientos de filas casi idénticas. Ese volumen igual se factura.
llmtrim se instala en tu máquina como proxy local, recorta el desperdicio y reenvía una solicitud más pequeña. La respuesta no cambia. Conservas las mismas herramientas y respuestas; gastas menos.
  before:  your tool ───── full request ─────▶  OpenAI / Anthropic / …
                    ◀──────── reply ──────────

  after:   your tool ──▶ llmtrim ──smaller──▶  OpenAI / Anthropic / …
                            (on your machine)
                    ◀──────── reply ──────────  (same answer)
La compresión no puede aumentar tu factura ni romper una solicitud; el peor caso es cero ahorro. Todo se ejecuta localmente, nada se nos envía. En acción →
Para Claude Code, la misma instalación también conecta /sub para enrutar sesiones a través de otra suscripción. Detalles →
Comenzar
npm install -g @llmtrim/cli@latest && llmtrim setup
# open a new terminal, then keep working
llmtrim status
Eso es todo. setup inicia un proxy local y configura tu shell. Cuando Claude Code está presente, también activa /sub. No necesitas una instalación separada para eso.
| Lo que quieres | Ejecuta |
|---|---|
| Primera instalación | llmtrim setup |
| Nueva versión | llmtrim update (luego llmtrim ensure después de npm/brew/cargo) |
| Algo roto | llmtrim ensure · llmtrim doctor --fix · o f en status |
Cualquier herramienta que respete
HTTPS_PROXYfunciona (Claude Code, Codex, Cursor, Aider, tu SDK). GitHub Copilot no (fijación de certificados). Lista completa →
Otros instaladores (Homebrew, curl, Scoop, Cargo, Docker)
# Linux / macOS
curl -fsSL https://raw.githubusercontent.com/fkiene/llmtrim/main/install.sh | sh

# Windows (PowerShell)
irm https://raw.githubusercontent.com/fkiene/llmtrim/main/install.ps1 | iex

# Package managers
brew install fkiene/tap/llmtrim
cargo binstall llmtrim
scoop install llmtrim
docker run -d -p 43117:43117 -v llmtrim-state:/data ghcr.io/fkiene/llmtrim
Opciones completas: INSTALL.md.
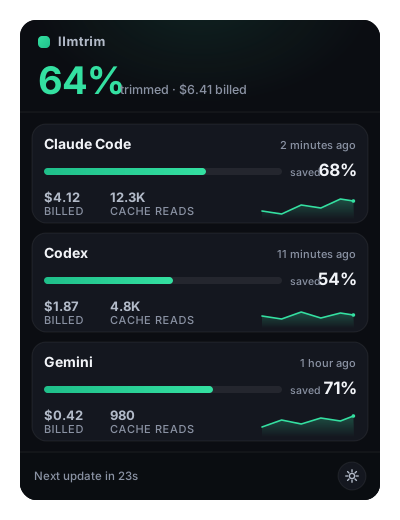
Bandeja de escritorio (barra de menú / bandeja del sistema)
Popover en barra de menú / bandeja del sistema con los mismos números de ahorro. Incluido en Homebrew, Scoop y npm; setup puede habilitar abrir al iniciar sesión. Abre con llmtrim tray. En escritorios Linux, ensure interactivo puede obtener el binario de bandeja desde el último lanzamiento (necesita libwebkit2gtk-4.1 y libayatana-appindicator3).
¿Es seguro?
Misma técnica que mitmproxy, limitada solo a hosts de API de LLM. setup cambia tres cosas; llmtrim uninstall revierte las tres:
- CA privada en
~/.llmtrim/(restringida por nombre; no puede interceptar tu banco o correo) - Env del shell:
HTTPS_PROXY+ confianza de CA - Servicio de inicio de sesión: daemon al iniciar sesión
No se almacenan claves de API (la autenticación de tu herramienta se reenvía). Los prompts nunca tocan el disco; solo conteos anónimos de tokens. Los resultados recuperables de herramientas permanecen en RAM limitada del daemon durante cinco horas por defecto y desaparecen al reiniciar. Modelo de amenazas completo: SECURITY.md.
llmtrim ca
openssl x509 -in ~/.llmtrim/ca.pem -noout -text | grep -A3 "Name Constraints"
Día a día
llmtrim status     # savings + health  (aliases: monitor, gain)
llmtrim update     # new release, restart daemon, refresh integrations
llmtrim ensure     # match the recommended install state on this machine
| Situación | Comando |
|---|---|
| Ver ahorros | llmtrim status |
Después de actualizar npm / brew / cargo | llmtrim ensure (o f en estado) |
| Diagnosticar | llmtrim doctor · reparar con doctor --fix |
| Pausar / reanudar proxy | llmtrim stop · llmtrim start |
| Forzar una sesión a través de llmtrim | llmtrim wrap claude |
| Eliminar todo | llmtrim uninstall |
Después de setup, update o ensure, el /sub de Claude Code propiedad se mantiene sincronizado con el binario.
Series temporales: llmtrim status --daily · --weekly · --monthly · --json · --csv.
En acción
Un agente ejecutó una compilación. La herramienta devolvió 58 líneas; dos eran errores. Las 58 habrían sido facturadas.
4,662 caracteres → 978 (−79%). Los errores permanecen textuales. Las líneas INFO repetidas se pliegan en una plantilla más los valores (sin pérdida cuando el rango es regular).
# before (noise + signal)
[2026-06-13T10:02:00Z] INFO  compiling module core::worker::task_0 (incremental)
… 28 more near-identical INFO lines …
[2026-06-13T10:02:31Z] ERROR src/worker/pool.rs:214: mismatched types: expected `usize`, found `i64`
… 25 more INFO lines …
[2026-06-13T10:03:01Z] ERROR src/net/conn.rs:88: cannot borrow `buf` as mutable more than once
[2026-06-13T10:03:02Z] INFO  build failed, 2 errors

# after (errors verbatim; INFO folded losslessly)
[{}] INFO compiling module core::worker::task_{} (incremental) [×30: (10:02:00Z..10:02:29Z step 1s; 0..29)]
[2026-06-13T10:02:31Z] ERROR src/worker/pool.rs:214: mismatched types: expected `usize`, found `i64`
[{}] INFO compiling module core::net::conn_{} (incremental) [×25: 10:02:32Z..10:02:56Z; 0..24]
[2026-06-13T10:03:01Z] ERROR src/net/conn.rs:88: cannot borrow `buf` as mutable more than once
[2026-06-13T10:03:02Z] INFO  build failed, 2 errors
Pruébalo en un cuerpo de solicitud propio:
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim compress --provider openai
El plegado de registros es una etapa. Otras actúan sobre diferentes desperdicios:
| Desperdicio | Qué sucede |
|---|---|
| Registros de compilación, diffs, volcados de grep | Conservar errores / cambios / coincidencias; plegar el resto |
| Contexto pegado largo | Conservar fragmentos relevantes a la pregunta |
| Código fuente | Conservar cuerpos útiles; el resto → firmas |
| Esquemas de herramientas en cada turno | Recortar + mantener el prefijo de caché estable |
| Arrays JSON enormes | Tabla compacta (TOON) o muestra |
| Respuestas verbosas del modelo | Pedir salida más concisa donde sea seguro |
[!IMPORTANT] La compresión no puede aumentar tu factura ni romper una solicitud. Cada etapa se re-mide con el tokenizador real del proveedor y se deshace si no ahorra tokens. Si el proveedor rechaza el cuerpo comprimido, se reenvía el original. El peor caso es cero ahorro.
Los prefijos de caché de prompt existentes (cache_control) se dejan intactos. El modelado recuperable de primera llegada (llmtrim recall r_…) está desactivado por defecto; el recorte de ventana de salida de herramientas en zona viva aún se ejecuta, y una re-ejecución de la misma herramienta se envía completa. Para omitir el modelado de un comando (stdout textual, incluido un trailer de terminal), establece toolout_passthrough = ["*gpt.sh*"] o prefija el comando con LLMTRIM_TOOL_OUTPUT=passthrough. Las líneas que comienzan con LLMTRIM_KEEP: sobreviven al recorte de ventana incluso cuando el resto se recorta.
Los 10 compresores
Las etapas se ejecutan en orden de ahorro. Nada bajo un marcador cache_control se reescribe.
| Etapa | Qué hace | Cuándo se ejecuta |
|---|---|---|
| salida de herramientas | Plegado de plantilla sin pérdida primero, luego recorte de ventana de registros · diffs · grep · volcados a errores / cambios / coincidencias; recuperación opcional de primera llegada puede restaurar resultados omitidos en límite de caché con llmtrim recall | resultados de herramientas |
| disciplina de caché | Marcar + estabilizar el prefijo invariante (ordenar herramientas/esquema · OpenAI prompt_cache_key) para que permanezca en caché | herramientas |
| recuperación léxica | Ranking BM25+ con retroalimentación RM3 · cortes de tema TextTiling · selección presupuestada no redundante; pregunta protegida | contexto largo |
| esqueletización | tree-sitter conserva cuerpos de funciones relevantes, reduce el resto a firmas (14 lenguajes) | código |
| serializar + higiene | Minificar JSON, codificar arrays de registros a TOON o CSV, normalizar Unicode | siempre · sin pérdida |
| muestra JSON | Sub-muestrear arrays de registros enormes: primero/último + valores atípicos + muestra diversa sesgada por consulta | JSON grande |
| deduplicación | Colapsar líneas duplicadas + casi duplicadas (solo prosa) | siempre |
| control de salida | Instrucción concisa · Chain-of-Draft · presupuesto de tokens · esquema JSON nativo · directiva anti-sobrepensamiento (razonamiento cuantizado) · directiva de frugalidad en bucle de agente | automático |
| capa de herramientas | Selección estática de herramientas + recorte de descripciones | herramientas |
| multimodal | Reducir imágenes al límite de resolución del proveedor | imágenes |
El auto por defecto habilita cada etapa solo donde paga. safe es solo sin pérdida. Config →
Claude Code
Cuando ~/.claude existe, setup, update y ensure conectan /sub (y subagentes enrutados). No hay comando de instalación separado para eso.
| Característica | Qué obtienes |
|---|---|
/sub | Por ventana: /sub on [optional:codex|kimi|grok] · /sub off · /sub status |
Redirección de suscripción (`sub`) (opt-in; puede entrar en conflicto con los ToS del proveedor)
Envía Claude Code a través de CLIProxyAPI en lugar de Anthropic, o como salto de respaldo cuando la ruta actual falla. El inicio de sesión es la TUI de CLIProxyAPI; decide por ti mismo si eso se ajusta a los ToS del proveedor.
llmtrim sub on                  # install + start CLIProxyAPI, enable redirect
llmtrim sub on grok             # write opus/sonnet/haiku/fable → that CLI's models
llmtrim sub auth                # CLIProxyAPI TUI — sign in
llmtrim sub models              # official + live sidecar models
llmtrim sub map on opus grok-4.6
llmtrim sub chain anthropic,codex
llmtrim sub mode fallback       # try hops in order when the current one fails
llmtrim sub status
llmtrim sub off
Interactivo: llmtrim status → pestaña 4 Sub — Off / Always / Fallback, luego e para editar el
mapa entrada→salida (escribe para buscar en el catálogo de CLIProxyAPI;
s guardar, a agregar, d eliminar). [ ] rotar el primer salto de respaldo.
llmtrim update también actualiza CLIProxyAPI cuando lo usas. Apunta LLMTRIM_CLIPROXY_URL a una
instancia existente para omitir el sidecar administrado.
Enruta solo un subagente delegado de Claude Code mientras dejas la ventana principal sin cambios:
llmtrim agents install # also installed/refreshed by setup, update, and ensure
Luego pregunta naturalmente: Implement it using a Grok subagent, use Terra o review this with GPT Terra.
Los agentes solo de proveedor preservan el nivel de Claude de la solicitud del hijo a través del mapeo configurado; un
agente de modelo explícito fija ese modelo de proveedor. Los agentes locales de solicitud anulan el /sub de ventana y
la política global solo para sus propias solicitudes. llmtrim agents uninstall elimina solo archivos de agente propiedad de llmtrim
y registra una exclusión para que ensure los deje eliminados.
Solo esta ventana (instalado con ensure; incluye subagentes; sobrevive a /clear):
/sub on [optional:cli-or-model]  # gemini, codex, claude, grok, kimi, vertex, qwen, copilot, or a model id
/sub off
/sub status
Sidecar: ~/.llmtrim/cliproxy/ (binario + config). Autenticación: ~/.cli-proxy-api cuando está presente, si no
~/.llmtrim/cliproxy/auth. Env: LLMTRIM_SUB, LLMTRIM_SUB_MODE, LLMTRIM_CLIPROXY_URL,
LLMTRIM_CLIPROXY_KEY.
Conectores Anthropic /login vs claude.ai: con sub global en modo always, por
defecto llmtrim escribe un ANTHROPIC_AUTH_TOKEN ficticio en ~/.claude/settings.json (misma
idea que claude-code-proxy's
ANTHROPIC_AUTH_TOKEN=unused) para que Claude Code no necesite una sesión OAuth de Anthropic en vivo.
El MITM elimina ese token ficticio y envía /v1/messages a CLIProxyAPI; las sondas
no-messages de Anthropic se responden localmente para que nunca devuelvan 401 Invalid bearer token.
Claude Code trata cualquier autenticación de clave de API como anulación del inicio de sesión de claude.ai, por lo que los conectores claude.ai
están deshabilitados mientras el token ficticio esté establecido. Eso es esperado. Para conservar conectores (y aceptar
/login de Anthropic cuando la sesión expire):
llmtrim sub anthropic-login keep   # connectors OK; Anthropic login required
llmtrim sub anthropic-login skip   # default: no Anthropic /login; connectors off
Reinicia Claude Code después de sub on / sub off / sub mode / sub anthropic-login para que el
cambio de configuración surta efecto. El respaldo cuyo primer salto es "lo que está en uso" aún necesita un
inicio de sesión real de Anthropic.
Úsalo como CLI, MCP o librería
Same engine, no proxy required. No extra model calls; compress runs in-process.
| Language | Install |
|---|---|
| Rust | cargo add llmtrim-core |
| Python | pip install llmtrim |
| Ruby | gem install llmtrim |
| Kotlin | implementation("io.github.fkiene:llmtrim:0.13.7") |
| Swift | SwiftPM fkiene/llmtrim-swift ≥ 0.1.8 |
| JS / TS | @llmtrim/js (WASM) |
CLI pipe
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim compress --provider openai > out.json
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim send --provider openai
Rust · Python · JS
use llmtrim_core::{compress, ir::ProviderKind};
let out = compress(request_json, Some(ProviderKind::OpenAi))?;
import llmtrim
out = llmtrim.compress(request_json, llmtrim.Provider.OPEN_AI, "aggressive")
import { compress } from "@llmtrim/js";
const out = compress(requestJson, "openai", "aggressive");
Notas sobre bindings y WASM: crates/llmtrim-uniffi · crates/llmtrim-wasm.
Servidor MCP
llmtrim mcp install          # Claude Code
llmtrim mcp install --print  # paste into any client
{
  "mcpServers": {
    "llmtrim": { "command": "llmtrim", "args": ["mcp"] }
  }
}
Herramientas: llmtrim_compress, llmtrim_compress_text, llmtrim_stats (mismo registro que status).
Funciona con
Cualquier herramienta que respete HTTPS_PROXY y una CA proporcionada por el entorno:
| Herramienta | Funciona | Notas |
|---|---|---|
| Claude Code | ✅ | El descuento de caché de prompt se mantiene intacto |
| Codex CLI | ✅ | |
| Gemini CLI | ✅ | |
| Cursor (IDE), Cline, Roo, Kilo Code | ✅ | Extensiones de VS Code; establece NODE_EXTRA_CA_CERTS para el proceso host de Node |
| Goose, OpenCode, Crush, Mux, Forge, OpenClaw, Pi/OMP | ✅ | Agentes CLI en hosts de proveedores estándar |
| Qwen Code, Grok CLI, Kimi Code, Mistral Vibe | ✅ | Los hosts de proveedores vienen en el registro de llm_providers, interceptados de serie |
Aider, cualquier otro CLI compatible con HTTPS_PROXY | ✅ | |
| Hermes, Droid (modo BYOK) | ✅ | Solo se puede interceptar cuando hay una clave de proveedor directa configurada; consulta la guía para Hermes |
| Tu propia app / SDK | ✅ | O llama directamente al CLI / biblioteca |
| GitHub Copilot | ❌ | El anclaje de certificados bloquea la intercepción |
| Warp, Devin | ❌ | La llamada al proveedor es del lado del servidor; un proxy local nunca la ve |
| Cursor Agent, Kiro | ❌ | Se enruta a través de una pasarela del proveedor, no de un host de proveedor estándar |
Sin proxy: cualquier cliente MCP puede llamar a llmtrim como herramientas (llmtrim mcp install), o usar el CLI / biblioteca.
Los proveedores provienen del registro llm_providers (OpenAI, Anthropic, Google, DeepSeek, Mistral, xAI, Moonshot, Zhipu, Qwen, OpenRouter, …) y se actualizan con él. Las conexiones que no son de LLM pasan sin tocarse.
Configuración
El valor predeterminado es suficiente para la mayoría del tráfico. auto inspecciona cada solicitud y elige compresores según la forma (herramientas → agent, código → code, preguntas y respuestas largas → rag, si no → aggressive).
Anula con LLMTRIM_PRESET=<name> o preset = "<name>" en $XDG_CONFIG_HOME/llmtrim/config.toml:
| preset | Cuándo usarlo |
|---|---|
auto (predeterminado) | Deja que llmtrim elija por solicitud |
safe | Solo entrada sin pérdida |
aggressive | Máxima compresión, con control de calidad |
Presets avanzados
auto los compone según la forma de cada solicitud, por lo que la mayoría de los usuarios nunca los establecen directamente. Elige uno cuando conozcas tu tráfico y quieras omitir la detección de forma:
| preset | para |
|---|---|
agent | bucles de llamada a herramientas: poda el bloque de herramientas solo en el primer turno para que la caché de prompt se mantenga caliente |
code | turnos de codificación: esqueletiza y minimiza el código, comprime registros y diffs pegados |
rag | contexto largo con una pregunta: recuperación a nivel de oración |
cache | un prefijo fijo reutilizado en muchas llamadas |
reasoning | cargas de trabajo de matemáticas y paso a paso |
frugal | aísla solo la directiva de frugalidad del bucle de agente, para una evaluación comparativa limpia |
Anulaciones por bandera (usuarios avanzados)
Cada etapa es ajustable individualmente mediante banderas de configuración; preset gana sobre las banderas individuales. La tabla completa es larga; consulta la lista de campos en config.rs o ejecuta llmtrim compress --help. Los ajustes más útiles:
| campo | predeterminado | significado |
|---|---|---|
toolout | activado en agent/aggressive | compresión de salida de herramientas (registros / diffs / grep / volcados) |
retrieve | false | recuperación léxica para contexto largo (con pérdida) |
skeletonize | false | elimina cuerpos de funciones no relevantes a firmas |
serialize | true | codificación TOON / CSV de matrices de registros |
json_crush | activado en agent/aggressive | muestrea matrices de registros enormes |
output_control | false | instrucción de salida concisa + límite |
output_anti_overthink | activado en aggressive/rag/code/agent | directiva de compromiso con la respuesta para tráfico de razonamiento cuantizado |
output_frugal_tools | activado en agent | orienta los bucles de agente hacia menos turnos de llamada a herramientas (agrupa, no repitas) |
cache | false | puntos de interrupción cache_control (sin pérdida) |
dedup | true | colapsa líneas duplicadas (sin pérdida) |
quality_gate | true | revierte cualquier corte con pérdida cuya cobertura relevante a la consulta caiga demasiado |
Entorno: LLMTRIM_PRESET (preset), LLMTRIM_CONFIG (ruta del archivo de configuración).
Ajustes de tiempo de ejecución (entorno o archivo de configuración)
Estos ajustes son ortogonales a la compresión. Cada uno se resuelve primero desde el entorno y luego desde el archivo de configuración, así que establece el que encaje. La variable de entorno gana cuando ambas están presentes.
| variable de entorno | clave de configuración | significado |
|---|---|---|
LLMTRIM_EXTRA_HOSTS | extra_hosts | hosts adicionales exactos de API de LLM a interceptar (separados por comas en entorno / matriz en archivo), p. ej. un endpoint compatible con OpenAI autoalojado |
LLMTRIM_EXCLUDE_PROVIDERS | exclude_providers | formas de cable a omitir en la compresión: openai / anthropic / google (p. ej. anthropic para dejar Claude Code intacto); grueso, cubre todos los hosts de esa forma |
LLMTRIM_EXCLUDE_HOSTS | exclude_hosts | nombres de host exactos a omitir en la compresión (p. ej. openrouter.ai); preciso, deja otros hosts de la misma forma comprimidos |
LLMTRIM_UPSTREAM_PROXY | upstream_proxy | enruta la salida a través de otro proxy (ver más abajo) |
LLMTRIM_DB_PATH | db_path | ubicación del registro |
LLMTRIM_CAPTURE_DIR | capture_dir | directorio de captura de QA antes/después |
LLMTRIM_CAPTURE_MAX_MB | capture_max_mb | límite máximo de tamaño del corpus de captura (0 desactiva) |
LLMTRIM_FIRST_ARRIVAL_RECALL | first_arrival_recall | modelado de salida de herramientas de primera llegada recuperable (predeterminado false; establece true para admitir resultados de límite de caché para llmtrim recall) |
LLMTRIM_TOOL_OUTPUT | toolout_passthrough | omite la compresión de salida de herramientas para comandos coincidentes: passthrough (todos) o globs de comandos (*gpt.sh*); también se respeta como asignación de comando o línea de resultado. Las líneas LLMTRIM_KEEP: siempre se conservan |
LLMTRIM_FIRST_ARRIVAL_RECALL_TTL_SECS | first_arrival_recall_ttl_secs | vida útil del resultado bruto en memoria (predeterminado 18 000 segundos / cinco horas) |
LLMTRIM_BIND | bind | IP de escucha (predeterminado loopback; 0.0.0.0 para contenedores) |
LLMTRIM_BREAKDOWN_WINDOW | breakdown_window | anulación de la ventana de contexto para el desglose de costos |
LLMTRIM_RETENTION_DAYS | retention_days | retención por antigüedad del registro en días |
LLMTRIM_NO_UPDATE_CHECK | no_update_check | desactiva la verificación de actualización pasiva |
Las entradas de extra_hosts deben ser nombres de host exactos (llm.acme.com, nunca un acme.com simple): cada una amplía la CA MITM restringida por nombre, que se regenera automáticamente en el próximo lanzamiento para cubrirlas.
Las opciones de Claude Code (redirección de suscripción) están en Claude Code.
Proxy ascendente (egreso corporativo o encadenamiento de herramientas locales)
export LLMTRIM_UPSTREAM_PROXY=http://host:port
# or with auth: http://user:pass@host:port  (redacted in logs)
Las llamadas salientes usan CONNECT + TLS de verificación; el ascendente solo ve el flujo cifrado.
Se rechaza el bucle hacia la propia dirección de escucha de llmtrim. Pon la variable en el entorno de lanzamiento del daemon (launchd / systemd), no solo en tu shell interactivo. Los secretos del perfil están en texto plano.
Las herramientas complementarias en otro puerto (p. ej. headroom) están bien.
Los números
Cada caso se envía dos veces, una original y una comprimida, luego ambas respuestas se puntúan y se facturan a tarifas reales. El costo y la calidad se miden juntos, no se estiman, en 112 casos:

| original | comprimido | ahorrado | |
|---|---|---|---|
| tokens de entrada | 71 031 | 49 062 | −31 % |
| tokens de salida | 25 843 | 6 628 | −74 % |
| costo de ida y vuelta | $0.0365 | $0.0126 | −66 % |
| calidad de respuesta | 78.9 % | 82.2 % | sin degradación medida |
Los recortes de tokens son independientes del modelo (−31 % entrada, −74 % salida). El ahorro en dólares sigue la relación de precio salida-entrada del modelo: −66 % aquí, proyectando a −57 % a tarifas de GPT-4o y −59 % a tarifas de Claude Sonnet. El proxy comprime solo la superficie de contenido nuevo y nunca reescribe el prefijo controlado por caché, por lo que tu descuento de caché de prompt sobrevive.
Precisión preservada en benchmarks estándar
El mismo A/B en las suites académicas estándar, con un preset conservador de forma coincidente (qwen3-next-80b, IC del 95 % pareado). La calidad es la puntuación en la solicitud original frente a la comprimida. GSM8K proviene de la frontera anterior (n=12); los otros tres son los benchmarks nombrados con los que los lectores comparan (n=20 cada uno):
| benchmark | tarea | puntuador | entrada ahorrada | calidad (orig → comp) | retención |
|---|---|---|---|---|---|
| GSM8K | matemáticas de escuela primaria | exacto numérico | −47 %¹ | 100 % → 92 % | −8pp |
| TruthfulQA (MC1) | veracidad factual | exacto de elección | 0 % | 75 % → 75 % | +0.0±0.0pp |
| SQuAD v2 | QA extractiva | token-F1 / EM | 11 % | 84 % → 84 % | −0.0±15.2pp |
| BFCL (live_multiple) | llamada a funciones | coincidencia de llamada a herramienta | 33 % | 95 % → 95 % | +0.0±15.2pp |
Tres filas comprimen sin pérdida de calidad; GSM8K es la única caída:
- BFCL elimina los esquemas de herramientas que la consulta no necesita (un menú de 2 a 37 candidatos por llamada).
- SQuAD v2 aún responde correctamente sus preguntas sin respuesta.
- TruthfulQA mantiene la precisión factual exacta: sus prompts de ~75 tokens son casi todo texto de respuesta, por lo que el preset seguro no encuentra nada que cortar.
- GSM8K intercambia −8pp de precisión por −71 % de costo, así que mide por carga de trabajo antes de habilitar su preset de razonamiento. ¹Su entrada se vuelve negativa porque ese preset inyecta una instrucción de Chain-of-Draft cuyo beneficio está del lado de la salida (ver la tabla de frontera).
Evidencia y una reproducción de una línea (instantánea de benchmark nombrado):
make -C crates/llmtrim-cli/bench data
(cd crates/llmtrim-cli && cargo run -q --features live -- bench quality \
   --corpus bench/data/squad2.jsonl --preset rag \
   --model qwen/qwen3-next-80b-a3b-instruct --route "" --n 20)
Metodología, frontera por corpus e intervalos de confianza: crates/llmtrim-cli/bench/README.md. Reprodúcelo:
make -C crates/llmtrim-cli/bench data   # pull real corpora (gsm8k, humaneval, dolly, hotpotqa, …)
(cd crates/llmtrim-cli && cargo run -q --features live -- bench suite)  # live A/B across all corpora (needs OPENROUTER_API_KEY)
(cd crates/llmtrim-cli/bench/scripts && PYTHONPATH=. python3 -m benchkit.tools.chart)  # regenerate the chart + table
Cómo se compara
Cada herramienta comprime una porción de la solicitud. llmtrim comprime entrada y salida, deja el prefijo en caché intacto para mantener estable la caché de prompt, y puntúa si la respuesta sobrevive al corte, no por tokens eliminados. Ambos ejes a continuación usan el codificador o200k_base y se reproducen desde este repositorio.
| llmtrim | Headroom | RTK | caveman | |
|---|---|---|---|---|
| Comprime | entrada · salida | entrada | salida de herramienta/CLI | salida del modelo |
| Omite transformaciones sin efecto | ✅ | ❌ | ❌ | n/a |
| Un binario estático | ✅ | Python + modelos | ✅ | ✅ |
Entrada
Reducción de entrada (determinista) junto a la calidad de respuesta de un A/B en vivo. La calidad es la caída frente a llmtrim en el ajuste comparado de cada herramienta (✅ mantenida, un empate estadístico; ❌ significativamente menor), por lo que una gran reducción con ❌ significa que la herramienta compró tokens perdiendo respuestas:
| Herramienta | Reducción | Calidad vs llmtrim | Sobrecarga |
|---|---|---|---|
llmtrim auto | 25% | ✅ ref | ~5 ms |
llmtrim aggressive | 28% | ✅ ref | ~5 ms |
| Headroom (ML activado) | 24% | ✅ empate | ~0.9 s |
| leanctx / LLMLingua-2 | 52-81% | ❌ 18% inferior | ~6 s |
| entroly | 80-89% | ❌ 42% inferior | <1 ms |
La sobrecarga es el tiempo de compresión mediano por llamada (tiempo de reloj en Python, no comparable CPU a CPU): Headroom y leanctx ejecutan ML en CPU aquí (más rápido en GPU) y pagan una carga de modelo única adicional (~3 s y ~4 s); llmtrim es Rust y entroly es léxico, así que ninguno lo hace.
autoes el predeterminado con control de calidad;aggressiveacepta recortes con pérdida cuando el control se mantiene.- Headroom cae al 0% con su ML desactivado (sus enrutadores no operan en prosa).
- leanctx y entroly son con pérdida sin control de calidad; entroly no tiene modo de baja reducción.
Headroom empata en reducción equivalente (24-25%, n=30, no significativo), pero sus respuestas más largas alcanzan el límite de tokens de salida del modelo y se truncan 12 veces frente a las 2 de llmtrim, la inflación de salida detrás de su mayor costo. leanctx (medido al 26%) y entroly (al 69%, su modo más suave) puntúan significativamente más bajo que llmtrim (n=20), y caen más en sus reducciones destacadas (vs-leanctx, vs-entroly).
Salida
Reducción de salida pidiendo respuestas más concisas, en una llamada en vivo de pago sobre 9 indicaciones de codificación:
| recorte de salida | sobrecarga / solicitud | |
|---|---|---|
| caveman | 80% | 949 tokens |
llmtrim output_terse | 69% | 19 tokens |
El costo es el prompt de sistema de 949 tokens que caveman reenvía en cada solicitud (columna derecha); el de llmtrim es de 19 para casi el mismo recorte. Ambos aún ahorran neto aquí, así que el recorte más profundo de caveman sale adelante solo cuando la salida que elimina vale más que los 949 tokens que añade de vuelta (artefacto vs-caveman).
Las herramientas se apilan: RTK reduce la salida de CLI, luego llmtrim comprime los esquemas de herramientas encima. Comparativas completas: crates/llmtrim-cli/bench/README.md.
Limitaciones conocidas
Estas se revelan con el mismo A/B que demuestra los ahorros:
- Los conteos de tokens de Anthropic / Gemini son aproximados. No hay un tokenizador público exacto, así que se usa un proxy BPE y se marca en
status. OpenAI es exacto. - Los ahorros de salida no se miden en vivo. El proxy comprime la entrada; un ahorro de salida necesita el contrafactual A/B, que solo ejecuta el benchmark fuera de línea.
status"ahorrado" es del lado de la entrada. - El predeterminado tiene control de calidad, no es sin pérdida. Las etapas con pérdida se ejecutan solo donde la evaluación muestra que la calidad se mantiene. ¿Quieres un viaje de ida y vuelta byte a byte fiel? Usa el preset
safe. - "Sin pérdida" es del lado de la entrada, no restauración de respuestas. Una etapa sin pérdida preserva la información que el modelo lee (un registro de log plegado, un array codificado en TOON, una leyenda de abreviaturas que el modelo decodifica en el prompt), y el control de tokens revierte cualquier recorte de entrada que no dé frutos. El motor no transforma la respuesta del modelo de vuelta a una forma original.
Agradecimientos
Cada compresor es una implementación determinista de investigación publicada: las ideas son suyas, la ingeniería y el control de tokens son nuestros.
Artículos + crates detrás de cada etapa
Recuperación y contexto: BM25 (Robertson & Zaragoza 2009, bm25); BM25+ (Lv & Zhai, CIKM 2011); RM3 (Lavrenko & Croft, SIGIR 2001); TextTiling (Hearst, CL 1997); TextRank (Mihalcea & Tarau, EMNLP 2004); MMR (Carbonell & Goldstein, SIGIR 1998); Objetivo submodular (Lin & Bilmes, ACL 2011); Maximizador de mochila codicioso modificado (Tang et al., SIGMETRICS 2021, arXiv:2008.05391); Muestreo diverso DPP (Chen et al., NeurIPS 2018); Lost in the Middle (arXiv:2307.03172); DSLR (arXiv:2407.03627).
Código: RepoCoder (arXiv:2303.12570); Hierarchical Context Pruning (arXiv:2406.18294); The Hidden Cost of Readability (arXiv:2508.13666); Contabilidad de tokens por minificación (arXiv:2606.01326).
Salida de herramientas: Drain (He et al., ICWS 2017); Brain (Yu et al., IEEE TSC 2023); LogLSHD (arXiv:2504.02172).
Deduplicación y abreviación: SimHash (Charikar, STOC 2002, gaoya); CompactPrompt (arXiv:2510.18043); Repeticiones máximas (arXiv:1304.0528) + Re-Pair (Larsson & Moffat, DCC 1999).
Control de salida: Chain-of-Draft (arXiv:2502.18600); TALE (arXiv:2412.18547).
Serialización: TOON (Token-Oriented Object Notation), Johann Schopplich.
Construido sobre tiktoken-rs, tree-sitter, image, whatlang, hudsucker, rusqlite, y más.
¿Encontraste un problema?
llmtrim doctor          # diagnose
llmtrim doctor --fix     # diagnose + apply repairs
llmtrim ensure          # same repair path
Cada verificación fallida nombra su solución. Si una solicitud se dañó, establece LLMTRIM_CAPTURE_DIR y
abre un issue con el par antes/después.
Si llmtrim te ahorró dinero, una ⭐ ayuda a otros a encontrarlo.
Historial de estrellas
Licenciado bajo MPL-2.0. Usa llmtrim libremente en tu stack, incluso comercialmente, sin obligación de divulgación de código fuente para tu propio código; el copyleft a nivel de archivo se aplica solo a las modificaciones que hagas a los archivos fuente de llmtrim. Contribuciones mediante firma DCO.