tokensave
ทางการเพิ่มพลังให้ Agent ของคุณด้วย Semantic Code Intelligence และประหยัดเงิน 💰 ไปพร้อมกัน!
คุณทำอะไรได้บ้างด้วย Tokensave MCP?
- การค้นหาโค้ดเชิงความหมาย — ขอให้ผู้ช่วยค้นหาโค้ดตามความหมาย เช่น ค้นหา "การยืนยันตัวตน" เพื่อค้นพบ
loginและAuthService - การวิเคราะห์ผลกระทบ — ติดตามผู้เรียก ผู้ถูกเรียก และขอบเขตผลกระทบทั้งหมดของสัญลักษณ์ก่อนแก้ไข
- การสร้างบริบทอัจฉริยะ — รับจุดเริ่มต้น สัญลักษณ์ที่เกี่ยวข้อง และตัวอย่างโค้ดสำหรับงานหนึ่ง ๆ ได้ในคำสั่งเดียว
- หน่วยความจำข้ามเซสชัน — บันทึกการตัดสินใจด้านสถาปัตยกรรมและเรียกดูภายหลัง เพื่อไม่ต้องอธิบายบริบทซ้ำในแต่ละเซสชัน
- การค้นหาข้ามสาขา — ค้นหาหรือเปรียบเทียบกราฟโค้ดระหว่างสาขาที่ติดตาม โดยไม่ต้องสลับ checkout
- การแก้ไขแบบอะตอมมิก — ใช้การแทนที่สตริงที่ระบุตำแหน่งและการแก้ไขหลายจุด โดยไม่เสี่ยงต่อปัญหาจาก regex หรือการใส่เครื่องหมายอัญประกาศใน shell
เอกสาร
Semantic Code Intelligence for AI Coding Agents
ใช้โทเค็นน้อยลง • เรียกใช้เครื่องมือน้อยลง • ทำงานในเครื่อง 100%




พร้อมใช้งานในรุ่นเบต้า: ลองใช้คิวรีใหม่ที่ปรับปรุงแล้วใน สาขาเบต้า ซึ่งมีการจัดอันดับผลการค้นหาที่เหมาะสมยิ่งขึ้น การวิเคราะห์กราฟ และการปรับปรุงการทำดัชนี ดูรายละเอียดได้ที่ บันทึกการเปลี่ยนแปลงเบต้า
ติดตั้งจากซอร์ส:
cargo install --git https://github.com/aovestdipaperino/tokensave.git --branch beta --locked --forceสำหรับบิลด์ที่ใช้พื้นที่จัดเก็บเบต้าแยกต่างหาก ให้ทำตาม คู่มือความเข้ากันได้ของฐานข้อมูล เมื่อตั้งค่าเบต้าหรือกลับไปใช้รุ่นเสถียร ฐานข้อมูลที่ใช้ร่วมกันอยู่แล้วจะยังคงเดิม ส่วนเบต้าจะใช้ดัชนีใหม่ที่
.tokensave/beta/
สารบัญ
- ทำไมต้องใช้ tokensave?
- คุณสมบัติหลัก
- เริ่มต้นใช้งานอย่างรวดเร็ว
- การซิงก์ที่ทนต่อการแครช
- การทำดัชนีหลายสาขา (ไม่บังคับ)
- หน่วยความจำข้ามเซสชัน
- บัญชีรายการการประหยัด
- เบนช์มาร์กที่ทำซ้ำได้
- เครื่องมือ MCP มากกว่า 80 รายการ
- การติดตามโทเค็น
- ความใหม่ของดัชนี
- อัปเกรดด้วยตนเอง
- การกำหนดเวอร์ชันและการอัปเกรด
- ข้อมูลอ้างอิง CLI
- tokensave doctor
- การทำงานร่วมกับ Claude Code
- การเรียกใช้เครือข่ายและความเป็นส่วนตัว
- ภาษามากกว่า 50 ภาษา
- tokensave เทียบกับ CodeGraph
- เหตุผลที่ควรเลือก tokensave แทนทางเลือกอื่น
- การแก้ไขปัญหา
- ที่มา
- การสร้าง
- ประวัติดาว
- ผู้สนับสนุน
- สัญญาอนุญาต
ทำไมต้องใช้ tokensave?
เอเจนต์เขียนโค้ด AI ใช้โทเค็นสิ้นเปลืองไปกับการสำรวจโค้ดเบส การค้นหาด้วย grep, glob และการอ่านไฟล์แต่ละครั้งมีค่าใช้จ่าย ในงานที่ซับซ้อน เอเจนต์จะเรียกใช้เอเจนต์ย่อย Explore หลายตัวเพื่อสแกนไฟล์หลายร้อยไฟล์เพียงเพื่อรวบรวมบริบท
tokensave มอบกราฟความรู้เชิงความหมายที่จัดทำดัชนีไว้ล่วงหน้าให้เอเจนต์ แทนที่จะสแกนไฟล์ เอเจนต์จะค้นหาจากกราฟและรับคำตอบที่มีโครงสร้างได้ทันที ทั้งสัญลักษณ์ที่เกี่ยวข้อง ความสัมพันธ์ระหว่างกัน และซอร์สโค้ด ในการเรียกใช้ครั้งเดียว
วิธีการทำงาน
flowchart TB
    subgraph agent["AI Coding Agent (Claude Code, Codex, Gemini, Cursor, ...)"]
        task["Implement user authentication"]
        first["Sub-agent"]
        second["Sub-agent"]
        task --> first
        task --> second
        first --- second
    end

    subgraph server["tokensave MCP Server"]
        search["Search: auth"]
        callers["Callers: login()"]
        context["Context for task"]
        db[("libSQL Graph DB<br/>Instant lookups<br/>FTS5 search")]
        search --> db
        callers --> db
        context --> db
    end

    first --> search
    first --> callers
    second --> context
เมื่อไม่มี tokensave: เอเจนต์ใช้ grep, glob และ Read เพื่อสแกนไฟล์ ซึ่งต้องเรียก API หลายครั้งและใช้โทเค็นจำนวนมาก
เมื่อใช้ tokensave: เอเจนต์ค้นหาจากกราฟผ่านเครื่องมือ MCP ได้ผลลัพธ์ทันที ประมวลผลในเครื่อง และใช้โทเค็นน้อยลง
คุณสมบัติหลัก
| การสร้างบริบทอย่างชาญฉลาด | การค้นหาเชิงความหมาย | การวิเคราะห์ผลกระทบ |
| การเรียกใช้เครื่องมือครั้งเดียวจะส่งคืนทุกสิ่งที่เอเจนต์ต้องการ ทั้งจุดเริ่มต้น สัญลักษณ์ที่เกี่ยวข้อง และตัวอย่างโค้ด | ค้นหาโค้ดจากความหมาย ไม่ใช่แค่ข้อความ ค้นหา "authentication" แล้วพบ login, validateToken, AuthService | รู้แน่ชัดว่าอะไรจะเสียหายก่อนแก้ไข ติดตามผู้เรียก ผู้ถูกเรียก และขอบเขตผลกระทบทั้งหมดของสัญลักษณ์ใดก็ได้ |
| เครื่องมือ MCP มากกว่า 80 รายการ | ภาษามากกว่า 50 ภาษา | รองรับการผสานรวมกับเอเจนต์มากกว่า 12 รายการ |
| ตั้งแต่การไล่สำรวจกราฟการเรียกใช้ไปจนถึงการตรวจหาโค้ดที่ไม่ได้ใช้ พื้นฐานการแก้ไขแบบอะตอมิก เมตริกสุขภาพโค้ด การจับคู่การทดสอบ และการวิเคราะห์ความซับซ้อน | Rust, Go, Java, Python, TypeScript, C, C++, Swift, Svelte, Astro และอีก 43 ภาษา รวมถึงเชดเดอร์ WGSL/HLSL/Metal, CUDA/HIP และ Markdown มีสามระดับ (lite/medium/full) เพื่อควบคุมขนาดไบนารี | Claude Code, Codex CLI, Gemini CLI, Qwen Code, Kiro, Cursor, OpenCode, Copilot, Cline, Roo Code, Zed, Antigravity, Kilo CLI, Kimi CLI, Mistral Vibe, Grok Build, Factory Droid, OMP, Pi, Plank |
| การทำดัชนีหลายสาขา (เลือกใช้ได้) | ทำงานในเครื่อง 100% | ข้อมูลเป็นปัจจุบันเสมอ |
| ฐานข้อมูลแยกตามสาขาแบบไม่บังคับ เปรียบเทียบความแตกต่างและค้นหาข้ามสาขาได้โดยไม่ต้องสลับ checkout | ไม่มีข้อมูลออกจากเครื่องของคุณ ไม่ต้องใช้คีย์ API ไม่มีบริการภายนอก ทุกอย่างทำงานบนฐานข้อมูล libSQL ในเครื่อง | ตรวจสอบความล้าสมัยตามต้องการทุกครั้งที่เรียก MCP (พัก 30 วินาทีระหว่างการตรวจ) พร้อมซิงก์ข้อมูลที่ตกค้างเมื่อเซิร์ฟเวอร์เชื่อมต่อ คาดว่าการทำงานแบบหลายเอเจนต์จะใช้ git worktrees โดยแต่ละเอเจนต์มี checkout ของตนเอง และ git จะรวมความแตกต่างของดัชนี ไม่ใช่ file watcher |
| การแยกการดึงข้อมูลไว้ในโปรเซสย่อย | การวิเคราะห์สุขภาพโค้ด | พื้นฐานการแก้ไขแบบอะตอมิก |
| หาก grammar ของ tree-sitter ใดเกิดข้อผิดพลาดแบบ native (abort, segfault หรืออย่างอื่น) จะมีเพียง worker ที่หยุดทำงาน จากนั้นพูลจะสร้าง worker ใหม่และซิงก์ต่อได้ การซิงก์จะไม่หยุดทำงานเพราะไฟล์ที่มีรูปแบบผิดพลาด | คะแนนสุขภาพแบบรวม (0-10000), ความไม่เท่าเทียมแบบ Gini, ความลึกของ file-DAG, เมทริกซ์โครงสร้างการออกแบบ, ช่องว่างการทดสอบที่ถ่วงน้ำหนักตามความเสี่ยง และการเปลี่ยนแปลงในเซสชัน | แก้ไขไฟล์โดยไม่เสี่ยงจาก regex หรือการ escape เครื่องหมายคำพูดใน shell: str_replace ที่ยึดกับจุดอ้างอิงเฉพาะ การแทนที่หลายตำแหน่งแบบอะตอมิก การเขียน AST ใหม่ และการแทรกโดยยึดจุดอ้างอิง ระบบจะจัดทำดัชนีใหม่โดยอัตโนมัติหลังเขียนไฟล์ |
เริ่มต้นใช้งานอย่างรวดเร็ว
1. ติดตั้ง
เลือกวิธีติดตั้งหนึ่งวิธี:
| แพลตฟอร์ม | คำสั่ง |
|---|---|
| macOS (Homebrew) | brew install aovestdipaperino/tap/tokensave |
| แพลตฟอร์มใดก็ได้ที่มี Rust | cargo install tokensave |
| แพลตฟอร์มใดก็ได้ที่มี cargo-binstall | cargo binstall tokensave |
หากต้องการติดตั้งโค้ดล่าสุดจากสาขา master ต้นทางโดยตรง แทนรุ่นที่เผยแพร่บน crates.io:
cargo install --git https://github.com/aovestdipaperino/tokensave.git --branch master --locked --force
คำสั่งนี้จะสร้างสาขา master ปัจจุบันจากซอร์ส ซึ่งอาจมีการเปลี่ยนแปลงที่ยังไม่ได้เผยแพร่ในรุ่นเสถียร และต้องใช้ Rust toolchain
บน Windows ที่ใช้ Scoop:
scoop bucket add tokensave https://github.com/aovestdipaperino/scoop-bucket
scoop install tokensave
คุณยังสามารถดาวน์โหลด ไบนารีที่สร้างไว้ล่วงหน้า แล้วเพิ่มลงใน PATH ได้
ทางเลือกในการติดตั้งและระดับภาษา
บิลด์ Cargo เริ่มต้นจะรวมภาษาที่รองรับทั้งหมด หากต้องการบิลด์ที่มีขนาดเล็กลง:
cargo install tokensave --no-default-features --features medium
cargo install tokensave --no-default-features    # lite (smallest binary)
ไฟล์เก็บถาวรรุ่นที่สร้างไว้ล่วงหน้า:
| แพลตฟอร์ม | ไฟล์เก็บถาวร |
|---|---|
| macOS (Apple Silicon) | tokensave-vX.Y.Z-aarch64-macos.tar.gz |
| Linux (x86_64) | tokensave-vX.Y.Z-x86_64-linux.tar.gz |
| Linux (ARM64) | tokensave-vX.Y.Z-aarch64-linux.tar.gz |
| Windows (x86_64) | tokensave-vX.Y.Z-x86_64-windows.zip |
2. กำหนดค่าเอเจนต์ของคุณ
เรียกใช้คำสั่งตั้งค่าเพื่อตรวจหาเอเจนต์ที่ติดตั้งไว้โดยอัตโนมัติ:
tokensave install
หากต้องการเลือกเอเจนต์ ให้ใช้ --agent (เช่น codex, claude หรือ cursor):
tokensave install --agent codex
เอเจนต์ที่รองรับ (ใช้ตัวระบุร่วมกับ --agent):
| เอเจนต์ | ตัวระบุ |
|---|---|
| Antigravity | antigravity |
| AugmentCode | auggie |
| Claude Code | claude |
| Cline | cline |
| Codex CLI | codex |
| GitHub Copilot | copilot |
| Cursor | cursor |
| Factory Droid | droid |
| Gemini CLI | gemini |
| Grok Build | grok |
| Kilo CLI | kilo |
| Kimi CLI | kimi |
| Kiro | kiro |
| Oh My Pi (OMP) | omp |
| OpenCode | opencode |
| Pi | pi |
| Plank (macOS เท่านั้น) | plank |
| Qwen Code | qwen |
| Roo Code | roo-code |
| Mistral Vibe | vibe |
| Zed | zed |
การตั้งค่าจะลงทะเบียนเซิร์ฟเวอร์ MCP และการผสานรวมของเอเจนต์ นอกจากนี้ยังเสนอให้ติดตั้ง Git hooks แบบ global เพื่อให้โปรเจกต์ที่เริ่มต้นใช้งานแล้วเป็นปัจจุบัน คุณสามารถเรียกใช้การตั้งค่าซ้ำได้อย่างปลอดภัยหลังอัปเกรด
เอเจนต์หลายตัว การตั้งค่าเฉพาะโปรเจกต์ และรายละเอียดการผสานรวม
รายละเอียดส่วนขยาย Pi และการบันทึกบัญชีเซสชันของ Pi ด้านล่างอธิบายบิลด์รุ่นเสถียร ส่วนเบต้าปัจจุบันยังคงใช้การผสานรวม Pi แบบเดิม
เอเจนต์แต่ละตัวจะได้รับการลงทะเบียนเซิร์ฟเวอร์ MCP ในรูปแบบการกำหนดค่าดั้งเดิม Claude Code จะได้รับ PreToolUse hook เพิ่มเติม (บล็อกเอเจนต์ Explore ที่สิ้นเปลือง), UserPromptSubmit hook, Stop hook, กฎพรอมป์ต์ใน CLAUDE.md และสิทธิ์อนุญาตเครื่องมือโดยอัตโนมัติ Pi จะได้รับ "exposure": "direct" ในรายการ MCP โดยปกติ Pi จะกำหนดค่าเซิร์ฟเวอร์เป็น codemode ซึ่งไม่ได้ประกาศเครื่องมือใด ๆ ให้โมเดลทราบ รวมถึงกฎพรอมป์ต์ใน AGENTS.md และส่วนขยาย TypeScript ที่จัดการโดย tokensave ซึ่งมีระบบป้องกันแบบเดียวกัน การรีเซ็ตยอดประหยัด และใบรับรองเซสชัน เนื่องจาก Pi ไม่มี shell hooks ส่วน Kiro จะได้รับการกำหนดค่า MCP แบบ global, การตั้งค่า tokensave.md ที่โหลดเป็นทรัพยากร และเอเจนต์เริ่มต้นที่ tokensave จัดการ โดยอนุญาตการใช้เครื่องมือในตัวและเครื่องมือของ tokensave อย่างยืดหยุ่น พร้อม hooks ป้องกันการมอบหมายงานและซิงก์หลังเขียนไฟล์ โดยจะเก็บเอเจนต์ Kiro ที่ผู้ใช้จัดการไว้
การติดตั้ง OMP แบบ global จะกำหนดเป้าหมายไปยังโปรไฟล์ที่รายงานโดย omp config path แบบเปล่า และเขียนไฟล์ <resolved-agent-dir>/mcp.json กับ <resolved-agent-dir>/rules/tokensave.md หากติดตั้งลงในโปรไฟล์ที่ระบุชื่อ ให้ส่งออก OMP_PROFILE หรือ PI_PROFILE ที่เข้ากันได้กับ OMP ตัวแก้ไขโปรไฟล์ของ OMP ยังรองรับ PI_CONFIG_DIR และ PI_CODING_AGENT_DIR ด้วย Tokensave เชื่อถือตัวแก้ไขดั้งเดิมนั้น แทนการทำซ้ำตรรกะโปรไฟล์ของ OMP Tokensave ติดตั้ง MCP และกฎแนะนำสำหรับ OMP แต่ไม่ได้ติดตั้งการบังคับใช้ hook ของ OMP
การเปลี่ยนแปลงทั้งหมดทำซ้ำได้อย่างปลอดภัย หลังอัปเกรดจึงเรียกใช้ซ้ำได้ หลังตั้งค่าเอเจนต์แล้ว ระบบจะเสนอให้ติดตั้ง Git hooks แบบ global สำหรับ post-commit และ post-checkout tokensave uninstall จะลบ hooks เหล่านั้นพร้อมกับการผสานรวมของเอเจนต์ หากต้องการเก็บ hooks ไว้ ให้ส่ง --keep-git-hooks หรือจัดการ hooks แยกต่างหากด้วย tokensave githooks
ติดตั้งให้เอเจนต์หลายตัวพร้อมกัน
เรียกใช้ --agent ซ้ำเพื่อติดตั้งเอเจนต์หลายตัวในการเรียกใช้ครั้งเดียว การให้สิทธิ์ การเสนอ Git hooks และการเขียนการกำหนดค่า global จะเกิดขึ้นเพียงครั้งเดียว ไม่ว่าคุณจะระบุเอเจนต์กี่ตัว:
tokensave install --agent claude --agent cursor --agent droid
ติดตั้งเฉพาะโปรเจกต์
โดยค่าเริ่มต้น tokensave install จะลงทะเบียนเซิร์ฟเวอร์ MCP ในการกำหนดค่าเอเจนต์แบบ global ของคุณ (เช่น ~/.claude.json) หากต้องการลงทะเบียน tokensave เฉพาะโปรเจกต์ปัจจุบัน ให้เพิ่ม --local:
tokensave install --local --agent claude
tokensave install --local --agent omp
คำสั่งนี้จะเขียนการกำหนดค่าที่กำหนดขอบเขตเฉพาะโปรเจกต์ ซึ่งคุณสามารถ commit และแชร์กับทีมได้ สำหรับ Claude จะเป็น ./.mcp.json, ./.claude/settings.json และ ./CLAUDE.md; ส่วน OMP จะใช้ ./.omp/mcp.json และ ./.omp/rules/tokensave.md โดยไม่เรียกใช้ OMP CLI เอเจนต์ที่รองรับ: claude, cursor, droid, gemini, zed, opencode, roo-code, kiro, auggie, omp, plank, pi (แต่ละตัวจะเขียนไฟล์โปรเจกต์ของตนเอง เช่น .cursor/mcp.json, .factory/mcp.json, .gemini/settings.json, .zed/settings.json, opencode.json, .roo/mcp.json, .kiro/settings/mcp.json, .augment/settings.json, .omp/mcp.json, .mcp.json สำหรับ plank, .pi/mcp.json และ ./AGENTS.md สำหรับ pi) เอเจนต์อื่นไม่มีการกำหนดค่าเฉพาะโปรเจกต์ และจะแสดงข้อผิดพลาดพร้อม --local
ลบการติดตั้งเฉพาะโปรเจกต์ด้วย tokensave uninstall --local
หากต้องการยอมรับหรือข้าม Git hooks โดยไม่แสดงข้อความถาม ให้เพิ่ม --git-hook yes หรือ --git-hook no ใช้ tokensave githooks เพื่อตรวจสอบ หรือ tokensave githooks off เพื่อลบ hooks
ดูคำแนะนำเฉพาะเอเจนต์ได้ที่ การเชื่อมต่อกับเอเจนต์ของคุณ
3. จัดทำดัชนีโปรเจกต์ของคุณ
cd /path/to/your/project
tokensave init
คำสั่งนี้จะสร้างไดเรกทอรี .tokensave/ ที่มีฐานข้อมูลกราฟความรู้ การเริ่มต้นใช้งานและการซิงก์เป็นคำสั่งแยกกัน: init เป็นการเลือกเริ่มต้นใช้งานเพียงครั้งเดียวต่อโปรเจกต์ ส่วน sync จะอัปเดตเฉพาะโปรเจกต์ที่เริ่มต้นใช้งานแล้วเท่านั้น วิธีนี้ช่วยป้องกันไม่ให้ Git hooks แบบ global สร้างฐานข้อมูลใน repo ที่คุณไม่ได้ตั้งใจจัดทำดัชนีโดยไม่แจ้งให้ทราบ หลังจาก init ให้ใช้ tokensave sync เพื่ออัปเดตแบบเพิ่มทีละส่วน โดยจะจัดทำดัชนีใหม่เฉพาะไฟล์ที่เปลี่ยนแปลง
เรียกใช้จากไดเรกทอรีย่อย
ทุกคำสั่งจะค้นหาโปรเจกต์ที่เป็นเจ้าของไดเรกทอรีปัจจุบัน โดยไล่ขึ้นไปจนถึง .tokensave/ ที่ใกล้ที่สุด คุณจึงเรียกใช้คำสั่งจากที่ใดก็ได้ภายในโปรเจกต์:
cd repository
tokensave init                     # creates repository/.tokensave/

cd src/backend/services
tokensave tool search database     # searches the repository's index
tokensave init                     # reports the existing project; exits 0, indexes nothing

cd ../..
tokensave sync                     # syncs the repository's index
MCP server และ agent hooks แก้ไขโปรเจกต์ด้วยวิธีเดียวกัน เส้นทางค้นหาจะอ้างอิงจากรูทของโปรเจกต์เสมอ (src/backend/db.rs) โปรดทราบว่า MCP server ที่เปิดใช้งานจากไดเรกทอรีย่อยยังคงใช้ไดเรกทอรีย่อยนั้นเป็นตัวกรองเส้นทางเริ่มต้นสำหรับการแสดงรายการเครื่องมือ
- Git repositories. หากยังไม่มีโปรเจกต์
initจากภายใน git repository จะเริ่มต้นที่รูทของ repository (หรือรูทของ linked worktree) ไม่ใช่ไดเรกทอรีปัจจุบัน - ขอบเขตของ repository. รูทของ git repository เป็นขอบเขตการแยก ภายใน repository อิสระที่ซ้อนอยู่ (nested clone หรือ submodule) คำสั่งจะไม่ใช้ index ของ repository ชั้นนอก ให้เรียกใช้
tokensave initที่นั่นเพื่อสร้าง index ของตัวเอง ส่วน linked worktree ที่ซ้อนอยู่ใน checkout หลักยังคงยืม index ของ checkout หลัก และข้อความแจ้งเรื่อง worktree ที่ยืม index จะระบุไว้เช่นนั้น - โปรเจกต์ที่ไม่ใช่ git.
.tokensave/ในโฟลเดอร์ที่ไม่ได้อยู่ภายใน git repository จะทำงานในลักษณะเดียวกัน รวมถึง repository ใดๆ ที่อยู่ภายในโฟลเดอร์นั้น - รูทที่ระบุชัดเจน.
tokensave init <path>,--path(-p), และtool --project <path>จะใช้ไดเรกทอรีที่คุณระบุ โดยไม่มีการค้นหา - การติดตั้งที่เสียหาย. ระบบจะแจ้ง
.tokensave/ที่มีconfig.jsonแต่ไม่มีฐานข้อมูล แทนที่จะข้ามไปใช้โปรเจกต์ชั้นนอก ไฟล์ config ที่แยกวิเคราะห์ไม่ได้จะทำให้เกิดข้อผิดพลาดพร้อมระบุชื่อไฟล์ที่ต้องแก้ไข
สิ่งที่ install เขียนลงใน Claude Code
MCP server
{
  "mcpServers": {
    "tokensave": {
      "command": "/path/to/tokensave",
      "args": ["serve"]
    }
  }
}
PreToolUse hook
hook ทำงานด้วย tokensave hook-pre-tool-use ซึ่งเป็นคำสั่ง Rust แบบ native (ไม่ต้องใช้ bash หรือ jq) โดยจะดักจับการเรียกใช้เครื่องมือ Agent, Grep, Glob และ Bash: agent แบบ Explore จะถูกบล็อกทั้งหมด การเรียก grep/rg/ag ที่มีรูปแบบเป็นสัญลักษณ์ (ตัวระบุทั่วไป, alternations, ชื่อที่ครอบด้วย \b) จะถูกเปลี่ยนเส้นทางไปยัง MCP tool ของ tokensave ที่ตรงกัน และการค้นหาที่มีรูปแบบเป็นเส้นทาง (Glob, find -name, fd --extension) บนส่วนขยายไฟล์โค้ดจะถูกเปลี่ยนเส้นทางไปยัง tokensave_files ส่วนรูปแบบ regex, git grep, คำสั่งที่ส่งผ่าน pipe, ส่วนขยายที่ไม่ใช่โค้ด, รูทการค้นหาที่อยู่นอก index และเงื่อนไข find ที่เปลี่ยนการทำงานของคำสั่ง (-exec, -delete, -mtime) จะทำงานต่อไปโดยไม่ถูกแตะต้อง ตั้งค่า TOKENSAVE_DISABLE_GREP_HOOK=1 เพื่อปิดใช้เป็นราย shell
ตัวกรองจะถูกอ่านจากเฉพาะเจาะจงที่สุดก่อน: type ที่ระบุชัดเจนจะมีผลเหนือกว่า ตามด้วย file glob ที่ระบุชัดเจน แล้วจึงเป็น search path ดังนั้นการค้นหาเอกสาร เช่น path: "." ที่ใช้ glob: "**/*.md" จะทำงานต่อไปโดยไม่ถูกแตะต้อง แทนที่จะถูกมองเป็นการค้นหาโค้ดบน path ที่กว้าง ขณะที่ glob ที่มีเฉพาะโค้ด (**/*.rs) จะยังถูกเปลี่ยนเส้นทางแม้จะอยู่ใต้ path ที่ไม่ใช่โค้ด ส่วน glob แบบผสม (**/*.{rs,md}) จะทำงานต่อไปโดยไม่ถูกแตะต้อง เพราะอาจแสดงเอกสารได้
การ dispatch แบบ headless / subagent (claude -p). โปรเซสลูกที่ session ผู้ประสานงาน dispatch จะสืบทอด ~/.claude/settings.json ของ session นั้น รวมถึง hook นี้ด้วย หากต้องการให้โปรเซสลูกค้นหาแบบ raw ได้ ให้ตั้งค่า TOKENSAVE_DISABLE_GREP_HOOK=1 ใน environment ของโปรเซสลูก -- binary แบบ native จะรองรับค่านี้และส่งผ่านทุก path (Grep, Glob, Bash, Agent) จึงไม่จำเป็นต้องใช้ --settings '{"hooks": {}}' แบบครอบจักรวาลที่ถอด hook ทั้งหมด ออก กลไกป้องกันนี้ไม่มีสถานะ: ไม่เคยตรวจสอบประวัติการอ้างอิง จึงเปลี่ยนเส้นทางเฉพาะการค้นหาที่มีรูปแบบเป็นสัญลักษณ์ตามที่อธิบายไว้ข้างต้น และชี้นำการกระจายงานค้นคว้าที่ไม่ได้ระบุชนิดเท่านั้น คำสั่งทั่วไปจะไม่ได้รับผลกระทบ ไม่ว่า session จะเป็นแบบโต้ตอบหรือ headless
กฎของ CLAUDE.md
เพิ่มคำแนะนำลงใน ~/.claude/CLAUDE.md เพื่อบอก Claude ให้ใช้เครื่องมือ tokensave ก่อนเรียกใช้ agent แบบ Explore หรืออ่านไฟล์โดยตรง
การซิงก์ที่ทนต่อการแครช
ไวยากรณ์ Tree-sitter เป็นโค้ด C/C++ ที่คอมไพล์แล้ว บางครั้งอาจพบ assertion ภายในหรือยุติโปรเซสด้วยวิธีที่ Rust panic handling ดักจับไม่ได้ ตั้งแต่ v4.3.0 เป็นต้นมา ไฟล์แต่ละไฟล์จะถูกแยกวิเคราะห์ภายใน worker subprocess ที่มีอายุสั้น: หากไวยากรณ์เกิด segfault เรียก abort() หรือเกิด stack overflow จะมีเพียง worker ที่หยุดทำงานเท่านั้น pool จะสร้าง worker ใหม่ บันทึกไฟล์ที่มีปัญหาและข้ามไฟล์นั้น จากนั้น sync จะทำงานต่อ
worker เป็น subcommand extract-worker ที่ซ่อนไว้ โดยยืนยันตัวตนกับ parent ผ่าน token ขนาด 256 บิตที่สร้างขึ้นต่อการ spawn หนึ่งครั้ง ซึ่งต้องส่งทั้งในรูป env var TOKENSAVE_WORKER_TOKEN และเป็น 32 ไบต์แรกที่รับทาง stdin ผู้ใช้เรียกใช้โดยตรงไม่ได้ จำนวน worker ที่ทำงานพร้อมกันจะเป็นไปตาม cpu_usage ใน .tokensave/config.json: low ใช้ worker หนึ่งตัว, balanced (ค่าเริ่มต้น) ใช้ครึ่งหนึ่งของ CPU ที่มี โดยปัดขึ้น และ performance ใช้ CPU ที่มีทั้งหมด การเรียกใช้ tokensave init ครั้งแรกบนเครื่องจะทดสอบประสิทธิภาพหนึ่งครั้งและบันทึกโปรไฟล์ที่แนะนำไว้ใน ~/.tokensave/benchmark.toml ซึ่งทุกโปรเจกต์ที่ไม่มี cpu_usage ของตัวเองจะนำไปใช้ tokensave config benchmark [--force|--show|--reset] ใช้จัดการผลลัพธ์ดังกล่าว ส่วน TOKENSAVE_CPU_USAGE หรือ cpu_usage ระดับ global ใน ~/.tokensave/config.toml จะมีผลเหนือกว่า (ดู คู่มือผู้ใช้) memory_usage จำกัดจำนวน extraction parser ที่ทำงานพร้อมกันแยกต่างหาก: low ใช้หนึ่งตัว, balanced (ค่าเริ่มต้น) ใช้ไม่เกินสองตัว และ performance ยังคงจำกัดตามจำนวน CPU การตรวจสอบล่วงหน้าแบบอัตโนมัติอาจลดจำนวน parser ที่ทำงานพร้อมกันลงอีกเมื่อหน่วยความจำ RAM จริงที่เหลือมีจำกัด รวมถึงในโหมด performance ด้วย วิธีนี้ช่วยลดการใช้หน่วยความจำของ parser โดยอาจแลกกับ throughput ที่ลดลง ส่วนหน่วยความจำรวมของกราฟยังคงแปรผันตามขนาดโปรเจกต์ จึงไม่ใช่การจำกัด RAM แบบตายตัว TOKENSAVE_WORKERS สามารถลดขีดจำกัด subprocess ลงได้อีก ขีดจำกัดเหล่านี้ไม่ใช่การจำกัดเปอร์เซ็นต์ CPU ให้รีสตาร์ต MCP server หลังเปลี่ยนโปรไฟล์ หากต้องการปิดการแยก subprocess ให้ใช้ TOKENSAVE_DISABLE_SUBPROCESS=1
primitive สำหรับแก้ไข (tokensave_str_replace, tokensave_insert_at ฯลฯ) ยังคงทำงานภายในโปรเซส: แต่ละรายการทำงานกับไฟล์ครั้งละหนึ่งไฟล์ ซึ่ง overhead ของ subprocess จะมีสัดส่วนมากเกินไป และหาก extractor แครช agent จะเห็นได้ทันที
การทำ Index หลาย Branch (ไม่บังคับ)
tokensave สามารถเลือกให้ดูแล code graph แยกกันสำหรับแต่ละ git branch ได้ เมื่อเปิดใช้ การสลับ branch จะไม่ทำให้ได้ผลลัพธ์เก่า และไม่ทำ index ไฟล์ที่แยกวิเคราะห์ไปแล้วใน branch อื่นซ้ำ การติดตามหลาย branch เป็นแบบ opt-in -- หากไม่เปิดใช้ tokensave จะใช้ฐานข้อมูลเดียวสำหรับทุก branch
วิธีการทำงาน
เมื่อคุณติดตาม branch หนึ่ง tokensave จะคัดลอก DB ของ ancestor ที่ใกล้ที่สุด แล้วซิงก์เฉพาะไฟล์ที่แตกต่างกัน ดังนั้นการติดตาม feature branch ที่แยกจาก main จึงแทบจะทันที -- ระบบจะแยกวิเคราะห์เฉพาะไฟล์ที่คุณเปลี่ยนแปลง
คำสั่ง CLI
tokensave branch add              # track the current branch
tokensave branch list             # see tracked branches and DB sizes
tokensave branch remove <name>    # stop tracking a branch
tokensave branch removeall        # remove all tracked branches except default
tokensave branch gc               # clean up branches deleted from git
MCP tools สำหรับข้าม branch
MCP tools สามรายการช่วยให้ค้นหาข้าม branch ได้โดยไม่ต้องสลับ checkout:
tokensave_branch_search-- ค้นหาสัญลักษณ์ในกราฟของ branch อื่นtokensave_branch_diff-- เปรียบเทียบ code graph ระหว่างสอง branch: สัญลักษณ์ที่เพิ่ม ลบ และเปลี่ยนแปลง (signature แตกต่างกัน) รองรับตัวกรองไฟล์และชนิดtokensave_branch_list-- แสดงรายการ branch ที่ติดตาม พร้อมขนาด DB, branch แม่ และเวลาซิงก์
การ fallback ของ branch
เมื่อ MCP server ไม่พบฐานข้อมูลสำหรับ branch ปัจจุบัน ระบบจะให้บริการจาก DB ของ branch ancestor ที่ใกล้ที่สุด และแนบคำเตือนในทุกการตอบกลับของเครื่องมือเพื่อแนะนำให้เรียกใช้ tokensave branch add
การติดตาม branch อัตโนมัติ (v7.3.0)
เมื่อเริ่มใช้โหมดหลาย branch แล้ว (ต้องสร้าง metadata ของ branch ด้วย tokensave branch add ด้วยตนเองก่อน) ระบบจะติดตาม branch ใหม่โดยอัตโนมัติได้ แทนที่จะ fallback ไปใช้ DB ของ ancestor มีกลไกอิสระสองแบบที่ครอบคลุมกรณีนี้ โปรเจกต์ที่ใช้โหมด DB เดียวจะไม่ได้รับผลกระทบ และทั้งสองกลไกจะไม่แตะต้องฐานข้อมูลของ branch เริ่มต้น
Git hook (เมื่อ checkout branch). hook post-checkout ที่ tokensave install ตั้งค่าไว้จะตรวจจับการ checkout แบบ branch (ต่างจากการ checkout ไฟล์) และเรียกใช้ tokensave branch add ในเบื้องหลัง คำสั่งนี้จะไม่ทำอะไรหากติดตาม branch นั้นอยู่แล้วหรือเป็น branch เริ่มต้น ดังนั้นการสลับไปมาระหว่าง branch ที่รู้จักจึงไม่มีค่าใช้จ่าย การ checkout ครั้งแรกของ git clone ใหม่และของ git worktree add ใหม่ก็ถือเป็นการ checkout branch เช่นกัน และอาจเริ่มต้นที่ branch ที่ไม่ใช่ branch เริ่มต้น (git clone -b feature, git worktree add -b feature); ในกรณีนั้น hook จะเรียก tokensave init ก่อน แล้วจึงเรียก tokensave branch add ตามลำดับ hook ที่เขียนโดยเวอร์ชันก่อนหน้าจะคงเนื้อหาที่ติดตั้งไว้เดิม -- installer จะไม่เขียนทับ hook ที่มีอยู่ ดังนั้นการติดตั้งเหล่านั้นยังต้องใช้ auto_track ด้านล่างกับ worktree ใหม่ หรือเรียก tokensave branch add ด้วยตนเอง
การติดตามอัตโนมัติเมื่อเปิดโปรเจกต์ (ไม่บังคับ). เมื่อเรียกใช้ TokenSave::open -- ไม่ว่าจะเป็นคำสั่ง CLI หรือการเริ่ม MCP server -- และ branch ที่ใช้งานอยู่ยังไม่ได้ติดตาม tokensave สามารถติดตาม branch นั้นได้ทันที โดยคัดลอก DB ของ ancestor ที่ติดตามอยู่และใกล้ที่สุด แล้วบันทึกลงใน metadata ของ branch การทำงานนี้ควบคุมด้วยฟิลด์ config auto_track (ค่าเริ่มต้น false) หรือ environment variable TOKENSAVE_AUTO_TRACK ซึ่งมีผลเหนือ config สำหรับการเรียกใช้ครั้งนั้น (ค่าใดๆ จะเปิดใช้ ยกเว้น 0, false, no, off หรือค่าว่าง) การคัดลอกเป็นการคัดลอก DB ของ ancestor ที่แทบจะทันทีเช่นเดียวกับที่ branch add ทำด้วยตนเอง โดยจะไม่มีการซิงก์ในขณะนั้น -- hook post-commit จะคอยทำให้ DB ของ branch ใหม่เป็นปัจจุบันเมื่อคุณ commit หรือเรียกใช้ tokensave sync เพื่อรีเฟรชทันที การติดตามอัตโนมัติเป็นการทำงานแบบ best-effort อย่างเคร่งครัด: หากเกิดข้อผิดพลาดใดๆ ระบบจะแจ้งเป็นคำเตือน และ open() จะดำเนินการต่อด้วยการ fallback ไปยัง ancestor ตามปกติ จึงไม่มีทางทำให้การเรียกใช้เครื่องมือล้มเหลว
การล้างข้อมูลอัตโนมัติ (ไม่บังคับ). ตั้งค่า "auto_gc": true ใน .tokensave/config.json
(หรือ TOKENSAVE_AUTO_GC=1 สำหรับการเรียกใช้ครั้งเดียว) เพื่อเก็บกวาด index ของ branch Git ในเครื่องที่ถูกลบไปแล้ว การล้างข้อมูลจะทำงานเมื่อเปิดโปรเจกต์และระหว่างการตรวจสอบความใหม่ตามปกติของ MCP server โดยใช้ collector เดียวกับ tokensave branch gc
และเก็บรักษา branch เริ่มต้น, branch ที่ยังมีอยู่, branch ที่ Git worktree ใดๆ ใช้งานอยู่ และฐานข้อมูลที่ TokenSave server ที่กำลังทำงานให้บริการอยู่ หากการเรียก Git ล้มเหลวหรือมี sync lock ที่กำลังใช้งาน ระบบจะข้ามการล้างข้อมูลอัตโนมัติโดยไม่ทำให้คำสั่งล้มเหลว ค่าเริ่มต้นคือ false ดังนั้นโปรเจกต์เก่าจะเก็บ index ไว้จนกว่าจะสั่งล้างอย่างชัดเจน TOKENSAVE_AUTO_GC=0 มีผลเหนือการตั้งค่าระดับโปรเจกต์ที่เปิดใช้งานอยู่ ส่วน tokensave branch gc ที่ระบุชัดเจนจะทำงานโดยไม่คำนึงถึงการตั้งค่านี้
สรุป: เมื่อติดตั้ง hook แล้ว การ checkout feature branch ใหม่ -- รวมถึง branch ที่ clone หรือ worktree ใหม่เริ่มต้นใช้งาน -- จะสร้างกราฟแยกตาม branch ให้โดยอัตโนมัติ ส่วนเมื่อเปิดใช้ auto_track แม้แต่ branch ที่สร้างขึ้นนอกขั้นตอน checkout ก็จะถูกตรวจพบในครั้งแรกที่ tokensave เปิดโปรเจกต์บน branch นั้น
ดู docs/BRANCHING-USER-GUIDE.md สำหรับคู่มือฉบับเต็ม
หน่วยความจำข้าม Session
MCP tools สามรายการช่วยบันทึกการตัดสินใจและบริบทของพื้นที่โค้ดข้าม session โดยจัดเก็บไว้ใน .tokensave/tokensave.db ของแต่ละโปรเจกต์
| Tool | วัตถุประสงค์ |
|---|---|
tokensave_record_decision | บันทึกการตัดสินใจด้านการออกแบบ/สถาปัตยกรรม พร้อมเหตุผล ไฟล์ และแท็ก (ไม่บังคับ) |
tokensave_record_code_area | ทำเครื่องหมาย path ที่ agent เคยทำงาน (ตัวนับการแตะต้อง + last_touched_at) |
tokensave_session_recall | ค้นหา FTS5 ในการตัดสินใจที่บันทึกไว้ ใช้คู่กับเครื่องมือเขียนข้อมูลสองรายการ |
ใช้เครื่องมือเหล่านี้เพื่อให้ agent ไม่ต้องอธิบายตัวเลือกด้านสถาปัตยกรรมซ้ำในแต่ละ session
บัญชีบันทึกการประหยัด
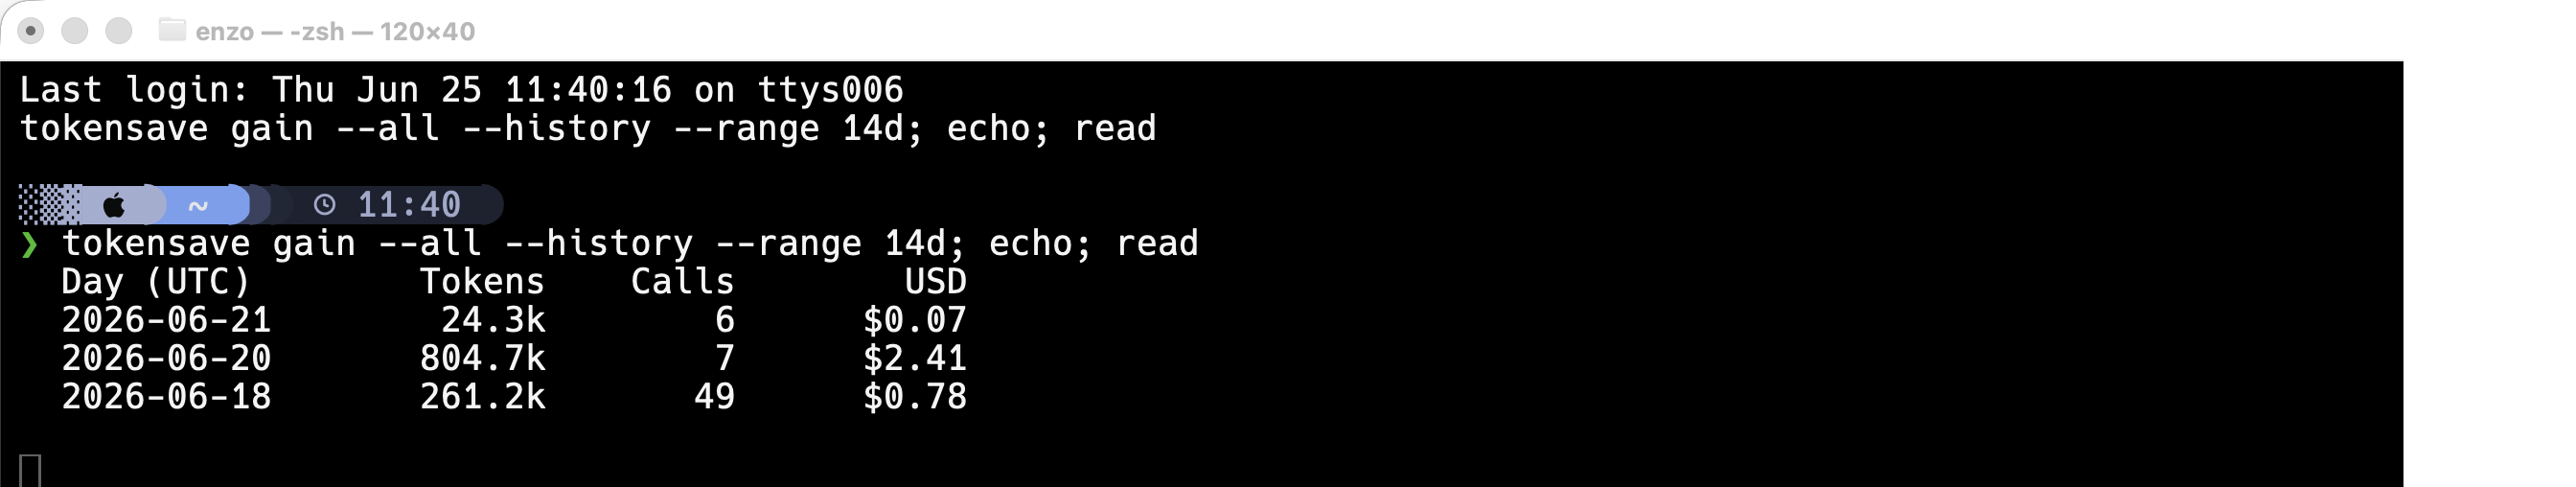
ทุกการเรียก MCP จะเขียนแถวแบบ append-only ลงใน ~/.tokensave/global.db (ตาราง savings_ledger) ตรวจสอบด้วย tokensave gain:
tokensave gain                    # current project, last 30 days
tokensave gain --all              # all projects
tokensave gain --history --range 7d
tokensave gain --json
การประเมินมูลค่าเป็นดอลลาร์ใช้ pricing module ที่มีอยู่ (ราคา input ของ Sonnet ซึ่งอัปเดตทุกวันผ่าน LiteLLM)
การทดสอบประสิทธิภาพที่ทำซ้ำได้
tokensave bench เรียกใช้ชุด query ที่กำหนดไว้ตายตัวผ่าน tokensave_context และรายงานการประหยัดจากการดึงข้อมูลเมื่อเทียบกับ baseline แบบอ่านไฟล์เต็ม (ใช้วิธีการเดียวกับ CCE):
tokensave bench                                    # ships with 10 default queries
tokensave bench --queries my-queries.toml --json
tokensave bench --max-nodes 5
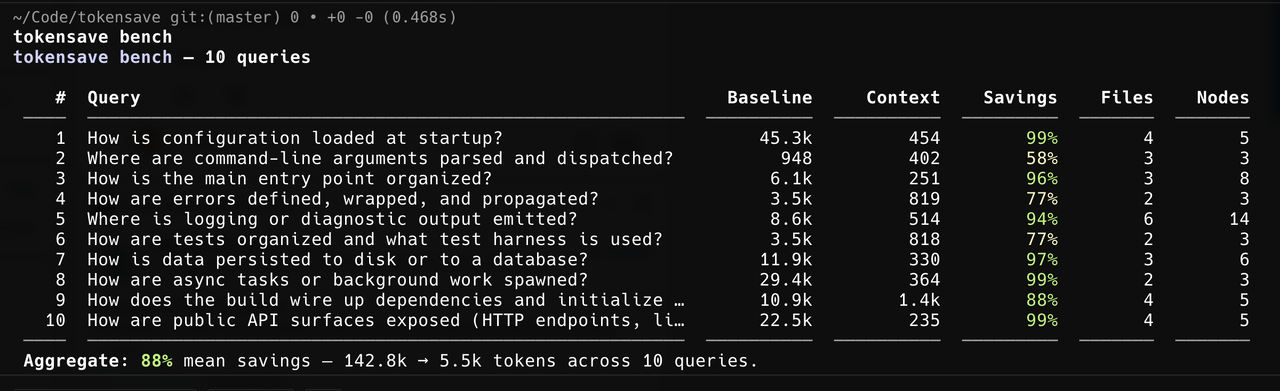
วัดผลกับ repo นี้ (tokensave เอง) โดยใช้ชุด query ทั่วไปที่มาพร้อมโปรแกรม:
| # | คำถาม | ค่าพื้นฐาน | บริบท | ประหยัด | ไฟล์ | โหนด |
|---|---|---|---|---|---|---|
| 1 | โหลดการกำหนดค่าเมื่อเริ่มต้นอย่างไร | 45.3k | 454 | 99% | 4 | 5 |
| 2 | แยกวิเคราะห์และส่งต่ออาร์กิวเมนต์บรรทัดคำสั่งที่ใด | 948 | 402 | 58% | 3 | 3 |
| 3 | จัดโครงสร้างจุดเริ่มต้นหลักอย่างไร | 6.1k | 251 | 96% | 3 | 8 |
| 4 | กำหนด ครอบ และส่งต่อข้อผิดพลาดอย่างไร | 3.5k | 819 | 77% | 2 | 3 |
| 5 | ส่งเอาต์พุตการบันทึกหรือการวินิจฉัยที่ใด | 8.6k | 514 | 94% | 6 | 14 |
| 6 | จัดโครงสร้างการทดสอบอย่างไร และใช้ชุดทดสอบใด | 3.5k | 818 | 77% | 2 | 3 |
| 7 | บันทึกข้อมูลลงดิสก์หรือฐานข้อมูลอย่างไร | 11.9k | 330 | 97% | 3 | 6 |
| 8 | สร้างงาน async หรืองานเบื้องหลังอย่างไร | 29.4k | 364 | 99% | 2 | 3 |
| 9 | บิลด์เชื่อมโยง dependencies และเริ่มต้นสถานะอย่างไร | 10.9k | 1.4k | 88% | 4 | 5 |
| 10 | เปิดเผยพื้นผิว API สาธารณะอย่างไร (HTTP endpoints, การส่งออกไลบรารี หรือคำสั่ง CLI) | 22.5k | 235 | 99% | 4 | 5 |
ผลรวม: ประหยัดการดึงข้อมูลเฉลี่ย 88% (142.8k → 5.5k tokens จาก 10 คำถาม)
ชุดคำถามเริ่มต้นมุ่งเป้าไปที่รูปแบบที่พบใน codebase ของแอปพลิเคชันส่วนใหญ่ (CLI, daemons, services) เรียกใช้กับโปรเจกต์ของคุณเองด้วย tokensave bench เพื่อดูตัวเลขของคุณ หรือเขียนไฟล์คำถามที่ปรับแต่งเอง (--queries my.toml) เพื่อให้ค้นคืนได้ตรงเป้าหมายยิ่งขึ้น
เกณฑ์ benchmark ด้วย repos ขนาดใหญ่ในโลกจริง
benches/large_repos.rs คือ micro-benchmark ของ criterion ที่ทดสอบเครื่องมือ MCP แบบ end-to-end กับ codebase โอเพนซอร์สขนาดใหญ่ 4 แห่งที่ตรึงไว้กับ refs คงที่ เครื่องมือแต่ละรายการทำงานด้วย คำถามอย่างน้อย 5 ข้อ พร้อมอาร์กิวเมนต์ (node ids, qualified names, file globs, …) ที่สุ่มจากกราฟที่จัดทำดัชนีไว้หนึ่งครั้งต่อ repo เพื่อให้เวลาที่วัดได้ทำซ้ำได้ในแต่ละรอบ
Repos และ refs ที่ตรึงไว้ (กำหนดใน benches/repos.rs):
| Repo | URL | Ref |
|---|---|---|
| polkadot-sdk | https://github.com/paritytech/polkadot-sdk | polkadot-stable2412 |
| emacs | https://github.com/emacs-mirror/emacs | emacs-30.1 |
| scipy | https://github.com/scipy/scipy | v1.14.1 |
| node | https://github.com/nodejs/node | v22.11.0 |
แต่ละ repo จะถูก shallow-clone (git init + git fetch --progress --depth 1 origin <ref> + checkout FETCH_HEAD) เมื่อใช้งานครั้งแรกและแคชไว้ในเครื่อง การเรียกใช้ครั้งต่อไปจะใช้ checkout เดิม เอาต์พุต Git จะสตรีมไปยังเทอร์มินัลเพื่อให้เห็นความคืบหน้าแบบเรียลไทม์ระหว่างการดึงข้อมูลหลาย GB
เครื่องมือที่ครอบคลุม (เครื่องมือละ 5 คำถาม) เครื่องมืออ่าน — search, context, callers, callees, node, by_qualified_name, signature, impact, body, files, complexity, doc_coverage, largest, hotspots, god_class, module_api, derives, dead_code, rank, coupling, circular. เครื่องมือเขียน — str_replace, multi_str_replace, insert_at และ (หาก ast-grep อยู่บน PATH) ast_grep_rewrite
บังคับซิงก์ทุกครั้งที่เรียกใช้ ก่อนเริ่ม benchmark ใด ๆ harness จะเรียกใช้คำสั่งที่เทียบเท่ากับ tokensave sync --force กับแต่ละ repo (index_all() โดยไม่คำนึงถึงความใหม่ของ .tokensave/) เพื่อให้เวลาที่วัดได้สะท้อนซอร์สที่ตรึงไว้เสมอ
การเขียน benchmark และการล้างข้อมูล เครื่องมือเขียนจะแก้ไขไฟล์ เพื่อให้เงื่อนไขเบื้องต้น "ต้องพบรายการที่ตรงกันเพียงรายการเดียว" ยังคงเป็นจริง harness จะใช้ iter_batched ของ criterion — ไฟล์ชั่วคราวขนาดเล็กใน <repo>/.tokensave-bench-scratch/ จะถูกเขียนทับด้วยเนื้อหาที่ทราบแน่ชัด ก่อนการทำซ้ำที่จับเวลาแต่ละครั้ง จากนั้นจึงเรียกใช้เครื่องมือแก้ไข หลัง benchmark ทั้งหมดเสร็จสิ้น harness จะเรียกใช้ git stash --include-untracked && git stash drop ภายใน repo ที่เตรียมไว้ทุกแห่ง เพื่อให้ working tree กลับไปยัง ref ที่ตรึงไว้
การกำหนดค่า Criterion benchmark จะเขียนทับค่าเริ่มต้นของ criterion เป็น sample_size = 10 และ measurement_time = 30s (แทนค่าเริ่มต้น 100 / 5s) ซึ่งทำให้การจับเวลาต่อคำถามแต่ละครั้งใช้เวลาวัดประมาณ 30 วินาที — นานพอให้เครื่องมือที่ช้า เช่น tokensave_context บน polkadot-sdk ได้ตัวเลขที่เสถียร
เรียกใช้:
# Required: a writable cache directory for the cloned repos + their indexes.

<p align="center">
  <a href="https://ai.enzolombardi.net/"><img src="https://img.shields.io/badge/built%20with-AI-D97757?style=flat-square&labelColor=101010&logo=anthropic&logoColor=white" alt="Built with AI — part of Enzo Lombardi's AI portfolio"></a>
</p>

# Expect several GB of disk and a long first run (shallow clone + full index of each repo).
export TOKENSAVE_BENCH_REPOS_DIR=~/tokensave-bench-cache

cargo bench --bench large_repos
หากไม่ได้กำหนด TOKENSAVE_BENCH_REPOS_DIR benchmark จะแสดงข้อความแจ้งและลงทะเบียน benchmark เป็นศูนย์รายการ (ดังนั้น cargo bench --all จึงยังทำงานได้รวดเร็วบนเครื่องของผู้ร่วมพัฒนา)
การกำหนดค่า (ทั้งหมดเป็นตัวเลือก ผ่าน environment):
| ตัวแปร | ผลลัพธ์ |
|---|---|
TOKENSAVE_BENCH_REPOS_DIR | จำเป็น ไดเรกทอรีรากที่ใช้ clone แต่ละ repo ไปยัง $DIR/<repo-name>/ |
TOKENSAVE_BENCH_REPOS | รายชื่อ repo ที่คั่นด้วยจุลภาคเพื่อใช้ทำ benchmark เช่น TOKENSAVE_BENCH_REPOS=emacs,scipy ค่าเริ่มต้นคือทั้งสี่รายการ |
TOKENSAVE_BENCH_SKIP_CLONE | หากกำหนดไว้ benchmark จะหยุดทันทีเมื่อพบ repo ที่ไม่ได้อยู่ที่ ref ซึ่งตรึงไว้ แทนที่จะดึงข้อมูล มีประโยชน์สำหรับการเรียกใช้ใน CI / ออฟไลน์ |
การกรอง benchmark ใช้ CLI มาตรฐานของ criterion — ตัวอย่างเช่น ใช้เฉพาะเครื่องมือ search บน scipy:
cargo bench --bench large_repos -- 'scipy/tokensave_search'
รายงาน (HTML + ตัวอย่างดิบ) จะอยู่ใน target/criterion/
หากต้องการเปลี่ยน refs ที่ตรึงไว้ (เช่น เป็นรุ่นใหม่กว่าหรือ SHA ที่ระบุ) ให้แก้ไข REPOS ใน benches/repos.rs และลบ marker $TOKENSAVE_BENCH_REPOS_DIR/<repo>/.bench-ref ที่เกี่ยวข้อง เพื่อให้การเรียกใช้ครั้งถัดไปดึงข้อมูลใหม่ หากข้ามการล้างข้อมูลหลังเรียกใช้ (เช่น คุณ Ctrl-C ระหว่าง benchmark) ให้เรียกใช้ git stash --include-untracked && git stash drop ภายในไดเรกทอรีของแต่ละ repo เพื่อคืนสถานะด้วยตนเอง
โพรบเมทริกซ์ทดสอบ MCP (scripts/mcp_probe)
scripts/mcp_probe/ คือ harness ของ Python ที่เรียกใช้ tokensave serve ผ่าน stdio กับชุด repos จริงที่กำหนดค่าได้ และทดสอบ เครื่องมือ MCP แบบอ่านอย่างเดียวทุกตัวด้วยรูปแบบคำถาม 5 แบบต่อภาษา พร้อมสร้างตารางสถานะแยกตามเครื่องมือ / repo harness เดียวกันนี้ใช้ได้สองวัตถุประสงค์:
- การตรวจสอบการถดถอย เพิ่มการรองรับภาษาใหม่ เพิ่มเครื่องมือใหม่ หรือปรับโครงสร้างโค้ด — เรียกใช้เมทริกซ์อีกครั้ง แล้วเซลล์ใดที่เพิ่งเกิดข้อผิดพลาด หมดเวลา หรือคืนผลลัพธ์ว่างจะเห็นได้ชัดด้วย 🚩
- โพรบประสิทธิภาพ บันทึกเวลาต่อการเรียกใช้ใน TSV; ชุด repos คงที่ชุดเดียวกันยังใช้เปรียบเทียบข้ามเวอร์ชันแบบคร่าว ๆ ได้ด้วย harness นี้พบข้อบกพร่อง cycle ปัจจุบันของ
tokensave_inheritance_depthเมื่อเครื่องมือหนึ่งตัวบน polkadot-sdk หมดเวลาที่ >60 s
โครงสร้าง — probe.py เป็นตัวขับเคลื่อน (ใช้ JSON-RPC ที่จับคู่ด้วย id เพื่อไม่ให้เครื่องมือที่ช้าทำให้การเรียกครั้งถัดไปเสียหาย), isolated.py เรียกใช้เครื่องมือเดียวซ้ำโดยเริ่มเซิร์ฟเวอร์ใหม่ทุกครั้ง (หลีกเลี่ยงการรอคิวของเซิร์ฟเวอร์), build_matrix.py อ่าน TSV และสร้าง Markdown, โมดูล tools/<lang>.py เพิ่มชุดคำถามแยกตามภาษา (มี Rust มาให้แล้ว; เพิ่ม Python/Go/… ได้โดยวางโมดูลใหม่), repos.toml แสดงรายการ repos เป้าหมาย (เขียนทับได้ผ่าน $TOKENSAVE_PROBE_REPOS)
เรียกใช้อย่างรวดเร็ว:
cargo build --release --bin tokensave
python3 scripts/mcp_probe/probe.py
python3 scripts/mcp_probe/build_matrix.py > matrix.md
เซลล์เอาต์พุตคือ ✓ 5/5 (ปกติ), 🐛 e/N (ข้อผิดพลาด), ⏱ N/N (หมดเวลา), ∅ E/N (ว่าง), 🐢 ok/slow (การเรียกใช้ >10 s) เซลล์ที่มีข้อผิดพลาดหรือหมดเวลาจะได้รับเครื่องหมาย 🚩 ในคอลัมน์ขวาสุด รายละเอียดต่อการเรียกใช้พร้อมอักขระ 100 ตัวแรกของข้อผิดพลาดแต่ละรายการจะถูกบันทึกใน TSV เพื่อใช้ติดตามผล
ต่างจาก benchmark ของ criterion ด้านบน: criterion วัดเวลาแฝงต่อการทำซ้ำสำหรับชุดเครื่องมือที่เน้นเฉพาะบน refs ที่ตรึงไว้ และสร้างรายงานทางสถิติไว้ใน target/criterion/; ส่วน mcp_probe ทดสอบเครื่องมือทุกตัวด้วยชุดคำถามที่กว้างกว่า บน repos ที่คุณระบุ โดยเน้นความครอบคลุมที่กว้างมากกว่าความแม่นยำในการวัด
เครื่องมือ MCP มากกว่า 80 รายการ
เซิร์ฟเวอร์เปิดเผยเครื่องมือมากกว่า 80 รายการ (น้อยลงหนึ่งรายการเมื่อไม่มีไบนารี ast-grep ซึ่งเป็นตัวเลือกอยู่ใน PATH) ตั้งแต่ 7.14.0 เป็นต้นมา มีเพียงเครื่องมือหลัก 11 รายการและ tokensave_more เท่านั้นที่แสดงตามค่าเริ่มต้น ส่วนที่เหลือจะแสดงเมื่อต้องการผ่าน tokensave_more ยังคงเรียกใช้ด้วยชื่อได้ และจะแสดงทั้งหมดด้วย "tools": "full" ตารางด้านล่างจัดกลุ่มเครื่องมือที่ใช้บ่อยที่สุดตามหมวดหมู่ ส่วนใหญ่เป็นแบบอ่านอย่างเดียว เรียกใช้พร้อมกันได้อย่างปลอดภัย และมีคำอธิบายประกอบด้วย readOnlyHint primitives สำหรับแก้ไขจะจำกัดขอบเขตไว้ที่ไฟล์เดียวและจัดทำดัชนีใหม่ในตำแหน่งเดิม เครื่องมือบันทึก baseline ของเซสชันและบันทึก memory ก็แก้ไขสถานะ .tokensave ในเครื่องด้วย และมีคำอธิบายประกอบว่าไม่ใช่แบบอ่านอย่างเดียว เครื่องมือหลักสามรายการ (tokensave_context, tokensave_search, tokensave_status) มีเครื่องหมาย anthropic/alwaysLoad เพื่อข้ามการค้นหาเครื่องมือไปกลับของไคลเอนต์
ค้นหาโปรเจกต์อื่นที่เริ่มต้นไว้แล้ว
เครื่องมืออ่านเชิงความหมายสามารถค้นหากราฟในเครื่องที่เลือกไว้อย่างชัดเจนได้ โดยไม่ต้อง เริ่มเซิร์ฟเวอร์ MCP ใหม่:
{
  "query": "screenGate",
  "graph_root": "/absolute/path/to/typewhisper"
}
ผลลัพธ์ที่เลือกจะแสดงข้อมูลที่มาของ root/branch แบบ canonical รหัสโหนดจะมี namespace ตามกราฟนั้น และต้องระบุตัวเลือกที่ใช้ค้นหาเดิมซ้ำในการเรียกครั้งถัดไป ตัวอย่างเช่น การเรียกต่อจาก คำถามที่เลือก branch จะต้องมีค่าทั้งสองรายการ:
{
  "node_id": "graph:<fingerprint>:function:<raw-id>",
  "graph_root": "/absolute/path/to/typewhisper",
  "graph_branch": "feature/auth"
}
graph_root ต้องเป็น root แบบ absolute ที่ตรงกันทุกประการของโปรเจกต์ที่เริ่มต้นไว้แล้ว
graph_branch เป็นตัวเลือกเสริม และหากระบุไว้ ต้องเป็นชื่อ branch ที่ติดตามอยู่
การเปิดโปรเจกต์ที่เลือกเป็นแบบอ่านอย่างเดียว: จะไม่เริ่มต้น ซิงก์ ย้ายข้อมูล ติดตามอัตโนมัติ
หรือเขียนข้อมูลกราฟ/ซอร์ส และจะไม่นำไปคำนวณการประหยัดด้วย
การเรียกโดยไม่มีตัวเลือกจะทำงานเหมือนเดิมทุกประการ
graph_root มีประโยชน์เฉพาะเมื่อคุณทราบว่ามีโปรเจกต์อื่นอยู่ ดังนั้นเซิร์ฟเวอร์
จึงแจ้งให้ทราบ: โปรเจกต์ที่เริ่มต้นไว้แล้วและอยู่ติดกับ root ที่ให้บริการโดยตรง
จะปรากฏใน MCP instructions ใน tokensave_status และในผลลัพธ์
tokensave_search / tokensave_context ที่ว่างเปล่า — ซึ่งเป็นจุดที่เซสชัน
อาจสรุปว่าไม่มี symbol นั้น แทนที่จะค้นหาโปรเจกต์ข้างเคียง (#375) ระบบจะแสดงเฉพาะโปรเจกต์ที่อยู่ติดกันโดยตรง
ไม่เกินห้ารายการ และจะไม่เปิดหรือจัดทำดัชนีแทนโปรเจกต์เหล่านั้น การค้นหาโปรเจกต์ใดโปรเจกต์หนึ่งยังต้องระบุ graph_root อย่างชัดเจน
จงใจไม่ให้ใช้ตัวเลือกกับเครื่องมือที่เขียนข้อมูล เรียกใช้ shell หรือขึ้นอยู่กับ checkout ปัจจุบัน ได้แก่ primitives สำหรับแก้ไข เครื่องมือ VCS และ branch การวินิจฉัยและการเรียกใช้การทดสอบ การตรวจสอบ dependencies และ runtime เครื่องมือ workflow และ session-memory รวมถึงการจัดการเซิร์ฟเวอร์ เครื่องมือเหล่านั้นจะปฏิเสธตัวเลือกแทนที่จะเพิกเฉยอย่างเงียบ ๆ
tokensave_simplify_scan และ tokensave_redundancy รองรับตัวเลือก เมื่อเลือกกราฟแล้ว
tokensave_redundancy จะอ่านเนื้อหาฟังก์ชันจาก working tree ของโปรเจกต์ที่เลือก และจะไม่เขียนแคช fingerprint ดังนั้นจึงปฏิเสธคำขอ เว้นแต่ branch ที่เลือกจะเป็น branch ที่ checkout อยู่ในตำแหน่งนั้น (ไม่ใช่ detached HEAD และไม่ fallback ไปยังดัชนีของ branch แม่)
การค้นพบ
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_context | รับบริบทโค้ดที่เกี่ยวข้องกับงาน -- จุดเริ่มต้น, symbols ที่เกี่ยวข้อง, snippets ของโค้ด |
tokensave_search | ค้นหา symbols ตามชื่อ (functions, classes, types) |
tokensave_node | รับรายละเอียด + ซอร์สโค้ดของ symbol ที่ระบุ |
tokensave_files | แสดงรายการไฟล์โปรเจกต์ที่จัดทำดัชนีไว้ (ซอร์สและ artifacts ที่ติดตาม) พร้อมตัวกรอง |
tokensave_module_api | พื้นผิว API สาธารณะของไฟล์หรือไดเรกทอรี |
tokensave_similar | ค้นหา symbols ที่มีชื่อคล้ายกัน |
tokensave_annotations | ตรวจสอบ attributes/annotations/decorators -- ฮิสโตแกรมของ annotations ทั้งหมด หรือรายการแยกตามตำแหน่งพร้อมตัวกรองเป้าหมาย |
tokensave_doc | เอกสาร Markdown ประกอบสำหรับไฟล์ซอร์ส -- เนื้อหาเอกสาร ไฟล์ที่ครอบคลุม และสัญญาณบอกความล้าสมัย |
tokensave_dependencies | ตรวจสอบ package manifests ใน 17 ecosystems -- สรุป workspace ค้นหาแพ็กเกจรายรายการ พื้นผิวใบอนุญาต และความคลาดเคลื่อนของเวอร์ชัน |
tokensave_status | สถานะดัชนี สถิติ tokens ที่ประหยัดได้ |
นามสกุลซอร์สที่กำหนดเอง
จับคู่นามสกุลกับ extractor ที่เปิดใช้งานใน .tokensave/config.json:
"language_aliases": { ".t": "perl", ".ep": "perl" }
วิธีนี้จะแยกวิเคราะห์การทดสอบ Perl แบบเก่าโดยไม่ต้องเปลี่ยนชื่อ Keys สามารถมีจุดนำหน้าได้
และจับคู่โดยไม่สนใจตัวพิมพ์เล็ก-ใหญ่ การจับคู่ที่ไม่ถูกต้อง ขัดแย้ง ไม่รู้จัก หรือปิดใช้งาน
จะทำให้การซิงก์ล้มเหลวพร้อมข้อผิดพลาดในการกำหนดค่า Aliases จะเขียนทับการจับคู่นามสกุล
ที่มีมาให้และการติดตาม artifacts ใช้ project.json ที่มีอยู่แล้ว
entries ร่วมกับ language สำหรับการเขียนทับไฟล์/glob ซึ่งมีลำดับความสำคัญสูงกว่า
aliases เรียกใช้ tokensave sync หลังแก้ไข mappings (sync -f ก็ใช้ได้เช่นกัน)
ดู คู่มือการกำหนดค่า
Artifacts ที่ไม่ใช่โค้ด
tokensave_files ครอบคลุมมากกว่า source ไฟล์ที่มีนามสกุลอยู่ใน
artifact_extensions (.feature, .json, .yaml, .yml, .sql, .toml,
.proto, .graphql, .md, .bnd, .bndrun ตามค่าเริ่มต้น) จะถูกติดตามตาม path
ดังนั้นคำถามอย่าง "ไฟล์ .feature สำหรับขั้นตอนการเข้าสู่ระบบอยู่ที่ไหน" จึงได้คำตอบจากกราฟ
แทนที่จะถูกขัดขวางโดย find (#323) ไฟล์เหล่านี้จะไม่ถูกแยกวิเคราะห์และไม่มีส่วนสร้าง symbols;
kind: "artifact" และ kind: "code" ใช้กรองระหว่างสองประเภทนี้ และการวิเคราะห์ที่
หมายถึง "code" จะไม่รวมไฟล์เหล่านี้ นามสกุลที่ language extractor จัดการอยู่แล้ว
จะถูกละเว้นจากรายการนี้ จึงไม่สามารถใช้เพื่อหยุดการแยกวิเคราะห์ภาษานั้นได้
รายการนี้ยังกำหนดด้วยว่า การค้นหาแบบ literal จะค้นหาภายในอะไรได้บ้าง (#442) การค้นหา
(literal: true) แบบ literal ใน tokensave_search จะอ่าน bytes แทน
symbols จึงไม่ต้องใช้ parser -- แต่จะวนดูไฟล์ที่ทำดัชนีไว้ จึงเข้าถึงได้
เฉพาะไฟล์ที่มีแถวอยู่ในดัชนีเท่านั้น เอกสาร .rst หรือ
เทมเพลต .tmpl ที่ติดตามอยู่ไม่มีทั้ง extractor และรายการ artifact เริ่มต้น ดังนั้น
ผลการค้นหาจึงขาดหายไป ให้เพิ่มนามสกุลที่นี่แล้วเรียกใช้ tokensave sync -f จากนั้น
ระบบจะค้นหาบรรทัดของไฟล์เหล่านั้นเช่นเดียวกับไฟล์อื่น และรายงานด้วย enclosing: null เนื่องจาก
ไม่มีบริบทของ symbol คำตอบจากการค้นหาแบบ literal ที่เข้าถึงไฟล์ที่ติดตามอยู่ได้ไม่ครบทุกไฟล์
จะแจ้งเรื่องนี้ในบล็อก unscanned โดยระบุจำนวนและนามสกุล เพื่อไม่ให้แสดง
คำตอบบางส่วนเสมือนเป็นคำตอบที่ครบถ้วน
กราฟการเรียกใช้และผลกระทบ
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_callers | ค้นหาว่าอะไรเรียกใช้ฟังก์ชัน |
tokensave_callees | ค้นหาว่าฟังก์ชันเรียกใช้อะไร |
tokensave_impact | ดูว่าสิ่งใดได้รับผลกระทบจากการเปลี่ยน symbol |
tokensave_affected | ค้นหาไฟล์ทดสอบที่ได้รับผลกระทบจากการเปลี่ยนแปลง source |
tokensave_rename | เปลี่ยนชื่อโดยอิงกราฟ: ทุกตำแหน่งพร้อมระดับความเชื่อมั่น (exact, heuristic, ambiguous, text_only), ตัวอย่าง diff และการนำไปใช้แบบทั้งหมดหรือไม่ทำเลย ไม่รับรู้ binding |
tokensave_hotspots | symbols ที่เชื่อมโยงมากที่สุด (จำนวนการเรียกใช้สูงสุด) |
คุณภาพโค้ด
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_complexity | จัดอันดับฟังก์ชันตามความซับซ้อนแบบ cyclomatic และ cognitive, ความลึกของการซ้อน, เมตริก Halstead, ดัชนีความสามารถในการบำรุงรักษา, CRAP และเมตริกด้านความปลอดภัย |
tokensave_dead_code | ค้นหา symbols ที่เข้าไม่ถึง (ไม่มีขอบขาเข้า; ไม่รวม symbols ที่ระบุชื่อเป็นตัวเลือกของความกำกวม) |
tokensave_ambiguous_calls | ตำแหน่งเรียกใช้ที่ resolver ไม่สามารถระบุเป้าหมายเดียวได้ พร้อมตัวเลือกที่เสมอกันทั้งหมด |
tokensave_god_class | ค้นหาคลาสที่มีสมาชิกมากเกินไป |
tokensave_coupling | จัดอันดับไฟล์ตาม fan-in/fan-out |
tokensave_inheritance_depth | ค้นหาลำดับชั้นการสืบทอดที่ลึกที่สุด |
tokensave_circular | ตรวจจับการพึ่งพาระหว่างไฟล์แบบวนรอบ |
tokensave_imports | การพึ่งพาระหว่าง import ระดับโมดูล, วงจร และการจำลองการตัด |
tokensave_recursion | ตรวจจับวงจรการเรียกใช้แบบเรียกซ้ำ/เรียกซ้ำถึงกัน |
tokensave_unused_imports | คำสั่ง import ที่ไม่มีการอ้างอิง |
tokensave_doc_coverage | symbols สาธารณะที่ไม่มีเอกสารประกอบ |
tokensave_simplify_scan | วิเคราะห์คุณภาพของไฟล์ที่เปลี่ยนแปลง (โค้ดซ้ำ, โค้ดที่ไม่ทำงาน, ความซับซ้อน) |
การวิเคราะห์สุขภาพโค้ด
เครื่องมือห้ารายการแสดงสัญญาณคุณภาพเชิงโครงสร้างจากกราฟที่มีอยู่ คะแนนรวมใช้ค่าเฉลี่ยเรขาคณิตของมิติที่เป็นอิสระต่อกัน เพื่อไม่ให้สามารถปรับแต่งคะแนนด้วยมิติใดมิติหนึ่งเพียงอย่างเดียวได้
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_health | สัญญาณคุณภาพรวม (0-10000) จากความไม่มีวงจร, ความลึก, ความเท่าเทียม, ความซ้ำซ้อน และความเป็นโมดูล |
tokensave_gini | ค่าสัมประสิทธิ์ความไม่เท่าเทียม Gini สำหรับเมตริกใดก็ได้ (ความซับซ้อน, จำนวนบรรทัด, fan-in/out, สมาชิก) -- ใช้ค้นหาไฟล์ขนาดใหญ่เกินควรและการกระจายที่ไม่สม่ำเสมอ |
tokensave_dependency_depth | สายโซ่การพึ่งพาระดับไฟล์ที่ยาวที่สุด (การจัดระดับ Lakos) พร้อมสร้างสายโซ่ทั้งหมดกลับคืนหลังตัดวงจร Tarjan SCC |
tokensave_dsm | Design Structure Matrix ในรูปแบบ stats, clusters หรือ matrix -- เผยให้เห็นการละเมิดลำดับชั้นและการเชื่อมโยงที่ซ่อนอยู่ |
tokensave_test_risk | วิเคราะห์ช่องว่างการทดสอบโดยถ่วงน้ำหนักความเสี่ยง ซึ่งรวมความซับซ้อน, fan-in, coverage และการเปลี่ยนแปลงใน git ช่วง 90 วันเป็นคะแนนเดียว |
เซสชัน
บันทึกเมตริกสุขภาพเมื่อเริ่มเซสชันเขียนโค้ดด้วย AI จากนั้นเปรียบเทียบความแตกต่างเมื่อจบเซสชันเพื่อดูว่าสิ่งใดดีขึ้นหรือแย่ลง
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_session_start | บันทึกเมตริกสุขภาพปัจจุบันเป็น baseline JSON สำหรับเปรียบเทียบภายหลัง |
tokensave_session_end | คำนวณใหม่และเปรียบเทียบกับ baseline -- การเปลี่ยนแปลงแยกตามมิติ, ผ่าน/ไม่ผ่าน, การล้างข้อมูลอัตโนมัติ |
เครื่องมือแก้ไขพื้นฐาน
เครื่องมือเขียนสี่รายการช่วยให้ agents แก้ไขไฟล์ได้โดยไม่เสี่ยงจาก regex หรือการ escape เครื่องหมายคำพูดใน shell แต่ละรายการทำงานกับไฟล์เดียว มีจุดยึด และทำดัชนีใหม่ในตำแหน่งเดิมหลังเขียน เพื่อไม่ให้กราฟล้าสมัย
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_str_replace | แทนที่ old_str ที่ไม่ซ้ำด้วย new_str; ล้มเหลวหากพบ 0 หรือมากกว่า 1 รายการ (ป้องกันข้อผิดพลาดจากการแก้ไขหลายจุด) |
tokensave_multi_str_replace | ใช้การแทนที่ (old, new) จำนวน N รายการแบบ atomic -- ธุรกรรมที่ทำทั้งหมดหรือไม่ทำเลย |
tokensave_insert_at | แทรกเนื้อหาก่อนหรือหลังสตริงจุดยึดที่ไม่ซ้ำ หรือหมายเลขบรรทัด |
tokensave_ast_grep_rewrite | เขียนโค้ดใหม่เชิงโครงสร้างผ่าน CLI ast-grep ในโหมด --rewrite |
Git และเวิร์กโฟลว์
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_diff_context | บริบทเชิงความหมายสำหรับไฟล์ที่เปลี่ยนแปลง -- symbols ที่แก้ไข, การพึ่งพา, การทดสอบที่ได้รับผลกระทบ |
tokensave_commit_context | สรุปเชิงความหมายของการเปลี่ยนแปลงที่ยังไม่ได้ commit เพื่อร่างข้อความ commit |
tokensave_pr_context | diff เชิงความหมายระหว่าง git refs สำหรับคำอธิบาย pull request |
tokensave_changelog | diff เชิงความหมายระหว่าง git refs สองรายการ |
tokensave_test_map | จับคู่ source กับ test ในระดับ symbol พร้อมตรวจจับ symbols ที่ไม่มีการทดสอบครอบคลุม |
tokensave_test_coverage | สรุป coverage แยกตามไฟล์/symbol/test-fn พร้อมขยายขอบการเรียกใช้แบบถ่ายทอด |
ระบบชนิดข้อมูล
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_type_hierarchy | แผนผังลำดับชั้นชนิดข้อมูลแบบเรียกซ้ำสำหรับ traits, interfaces และ classes |
tokensave_rank | จัดอันดับ nodes ตามจำนวนความสัมพันธ์ (interface ที่ถูกนำไปใช้มากที่สุด, class ที่ถูกขยายมากที่สุด) |
tokensave_distribution | แจกแจงชนิดของ node แยกตามไฟล์หรือไดเรกทอรี |
tokensave_largest | จัดอันดับ nodes ตามขนาด -- classes ที่ใหญ่ที่สุด, methods ที่ยาวที่สุด |
การพอร์ต
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_port_status | เปรียบเทียบ symbols ระหว่างไดเรกทอรีต้นทาง/เป้าหมายเพื่อติดตามความคืบหน้าการพอร์ต |
tokensave_port_order | เรียงลำดับ symbols ตามลำดับเชิงทอพอโลยีสำหรับการพอร์ต -- พอร์ต leaves ก่อน แล้วจึงพอร์ตสิ่งที่ขึ้นต่อกัน |
หลาย Branch
| เครื่องมือ | วัตถุประสงค์ |
|---|---|
tokensave_branch_search | ค้นหา symbols ในกราฟของ branch อื่น |
tokensave_branch_diff | เปรียบเทียบ symbols ระหว่าง branches; quality: true เปรียบเทียบคุณภาพเชิงโครงสร้าง |
tokensave_branch_list | แสดงรายการ branches ที่ติดตาม พร้อมขนาด DB และเวลาซิงก์ |
การถดถอยด้านคุณภาพของ branch
เปรียบเทียบ ดัชนี branch ที่มีอยู่แล้ว สองรายการ ณ Git tips ของแต่ละรายการ:
tokensave quality-diff --base master --target feature/example
tokensave quality-diff --base master --target HEAD --json --fail-on regression
tokensave quality-diff --base origin/master --target feature/example --cyclomatic 15 --min-increase 5
แต่ละ reference ต้อง resolve เป็น commit และระบุ branch ของ Tokensave ที่ติดตามอยู่
HEAD resolve เป็น branch เชิงสัญลักษณ์ปัจจุบัน; หาก HEAD แยกออกจาก branch ต้องระบุ
branch อย่างชัดเจน ยอมรับชื่อเต็มของ refs/heads/... และ refs/remotes/... สร้างและ
ซิงก์แต่ละดัชนีอย่างชัดเจนโดยใช้เวิร์กโฟลว์ tokensave branch add / sync
ที่มีอยู่ก่อนเปรียบเทียบ การเปรียบเทียบจะไม่ checkout branch หรือสร้างดัชนีใหม่
ดัชนีที่ขาดหายและข้อมูลการวิเคราะห์ที่ว่างเปล่าถือเป็นข้อผิดพลาด รวมถึงการเปรียบเทียบ
branch กับตัวเอง
baseline เปรียบเทียบแบบ tip กับ tip ไม่ใช่ merge base สำหรับ branches ที่แยกทางกัน ความแตกต่างที่รายงานอาจเกิดขึ้นบน branch ใดก็ได้ จึงไม่ใช่หลักฐานว่าฟีเจอร์ ทำให้เกิดความแตกต่างนั้นนับตั้งแต่เริ่มแยก branch
การวินิจฉัยที่รองรับจะนำข้อมูลที่แยกและทำดัชนีไว้แล้วกลับมาใช้:
| Code | เมตริก / อัตลักษณ์ | เกณฑ์เริ่มต้น |
|---|---|---|
Q_COMPLEXITY_CYCLOMATIC | จำนวน branches ของฟังก์ชัน + 1 | >10 |
Q_COMPLEXITY_COGNITIVE | ความซับซ้อนเชิง cognitive ที่แยกได้ | >15 |
Q_FUNCTION_LINES | ช่วงครอบคลุมของฟังก์ชัน | >100 |
Q_FILE_FAN_OUT / Q_FILE_FAN_IN | ไฟล์ที่แตกต่างกันซึ่งเข้าถึงได้จาก calls/uses ที่ resolve แล้ว หรือไฟล์ที่เข้าถึงไฟล์นี้ | >10 |
Q_CYCLIC_DEPENDENCY_EDGE | ขอบไฟล์แบบมีทิศทางภายใน strongly connected component ที่มีวงจร | มีอยู่ |
เปลี่ยนเกณฑ์ด้วย --cyclomatic, --cognitive, --function-lines และ
--fan-out (รายการหลังใช้กับทั้ง fan-in และ fan-out) ปัญหาที่เกินเกณฑ์อยู่แล้ว
จะกลายเป็น worsened เมื่อเมตริกเพิ่มขึ้นอย่างน้อย --min-increase
(ค่าเริ่มต้น 3); การเพิ่มขึ้นที่น้อยกว่ายังคงเป็น unchanged สำหรับการตรวจผ่าน/ไม่ผ่าน
การข้ามเกณฑ์ถือเป็น new; การลดลงต่ำกว่าเกณฑ์หรือการลบถือเป็น resolved;
การลดลงขณะที่ยังเกินเกณฑ์ถือเป็น improved ขอบที่อยู่ในวงจรอยู่ก่อนแล้วจะไม่เปลี่ยนแปลง
ขอบที่กลายเป็นวงจรถือเป็นรายการใหม่ แม้ตัวขอบจะมีอยู่ก่อนการเปรียบเทียบก็ตาม วงจรจะรายงาน
เป็นขอบใน components ที่มีวงจร ไม่ใช่เส้นทางวงจรที่แจกแจงไว้
JSON ประกอบด้วยลำดับการวินิจฉัยที่กำหนดแน่นอน, codes, categories, ระดับความรุนแรงแบบ warning,
อัตลักษณ์, ค่า base/target, ตำแหน่ง (ฟังก์ชันเริ่มนับที่ 1), ความเชื่อมั่น,
จำนวนการจัดประเภท และข้อจำกัด --fail-on regression ออกจากโปรเซสด้วยรหัส 1 เมื่อพบ
รายการใหม่หรือแย่ลง และ 0 ในกรณีอื่น ข้อผิดพลาดในการทำงานและผลลัพธ์ที่ไม่สมบูรณ์ซึ่งยอมรับไว้อย่างชัดเจน
จะออกด้วยรหัส 2 โดยไม่ขึ้นกับ --fail-on หากไม่มี flag
การเปรียบเทียบที่สมบูรณ์จะออกด้วยรหัส 0 โหมด JSON เขียนเอกสาร JSON เพียงชุดเดียวไปยัง stdout
รวมถึงกรณีเกิดข้อผิดพลาดในการทำงาน
เครื่องมือ MCP ที่มีอยู่รองรับการเปรียบเทียบแบบเดียวกันผ่าน:
{"base":"master","head":"feature/example","quality":true,"limit":20,"thresholds":{"cyclomatic":10,"min_increase":3}}
MCP report ใช้ schema เดียวกับ CLI จำนวนครอบคลุมผลการตรวจทั้งหมด; รายละเอียดแสดง
ค่าเริ่มต้น 20 รายการ (สูงสุด 500) โดยมี truncated และ total_findings อยู่นอก
รายงาน ใช้ limit: 0 เพื่อดูเฉพาะจำนวน thresholds ยอมรับชื่อ option ในตาราง
(cyclomatic, cognitive, function_lines, fan_out) รวมถึง min_increase และ
allow_stale; จะปฏิเสธ options ที่ไม่รู้จัก ตัวกรองไฟล์/ชนิดจะถูกปฏิเสธใน
โหมดคุณภาพ เนื่องจากการตรวจวงจรและการเชื่อมโยงต้องใช้หลักฐานทั่วทั้งระบบ ไม่มีการเปิดเผย
เครื่องมือ MCP เพิ่มเติม การเรียกใช้ด้านคุณภาพจะข้ามการซิงก์/ทำดัชนีเวอร์ชันใหม่อัตโนมัติในแต่ละครั้ง
ส่วนกิจกรรมอิสระอื่นในเซิร์ฟเวอร์ที่กำลังทำงานอยู่แล้วจะยังคงทำงานตามปกติ
การตรวจสอบความใหม่จะคำนวณ hash ของไฟล์ที่ทำดัชนีไว้เทียบกับ Git blobs โดยใช้ตัวถอดรหัส source
เดียวกับตอนทำดัชนี และยอมรับการแปลงการขึ้นบรรทัดใหม่ระหว่าง LF/CRLF จากการ checkout หรือ
การปรับรูปแบบตอน commit ไฟล์ที่ไม่ตรงกัน/ถูกลบ หรือ source candidate ที่ไม่มีดัชนี
จะถูกรายงานว่าล้าสมัย/ไม่สมบูรณ์ การค้นหา candidate จะเคารพกฎการยกเว้นที่กำหนดค่าไว้
กฎไฟล์ซ่อน และกฎขนาด; นโยบาย ignore หรือ manifest เฉพาะ branch อาจอธิบาย candidate ได้
จึงระบุว่าไม่แน่ชัด --allow-stale (MCP
thresholds.allow_stale) อนุญาตให้ตรวจสอบด้วย complete: false และออกด้วยรหัส 2;
จะไม่ยอมรับหลักฐานที่ล้าสมัยอย่างเงียบ ๆ ว่าเป็นผล CI ที่สะอาด complete หมายความว่า
การตรวจสอบเนื้อหาดัชนีเหล่านี้ผ่านแล้ว ไม่ได้หมายความว่ามีการวิเคราะห์ทุกภาษาและการพึ่งพาทั้งหมด
สิ่งที่ถูกยกเว้นตามการตั้งค่าและภาษาที่ไม่รองรับยังอยู่นอกขอบเขต;
เมตริก extractor ที่เป็นศูนย์ไม่ได้พิสูจน์ว่าความซับซ้อนต่ำ ดัชนีต้องใช้เวอร์ชัน/การตั้งค่า
การวิเคราะห์ที่เทียบเคียงกันได้ การตรวจสอบนี้ไม่ได้รับรองความครบถ้วนของ resolver
หรือการตรวจจับการแก้ไขแถวกราฟด้วยตนเองตามอำเภอใจ
ตำแหน่งไม่มีส่วนในการกำหนดอัตลักษณ์ การเปลี่ยนชื่อไฟล์ที่ Git ตรวจพบจะปรับอัตลักษณ์ของฟังก์ชัน
และการพึ่งพาให้เป็นมาตรฐาน ส่วนชื่อ symbol แบบระบุคุณสมบัติครบถ้วนจะใช้ระบุฟังก์ชัน
การเปลี่ยนชื่อ symbols, การย้ายที่ Git ตรวจไม่พบ และ overload ที่กำกวม ไม่สามารถจับคู่ได้
อย่างน่าเชื่อถือ: รายการที่จับคู่ไม่ได้จะระบุ confidence: "unmatched" อย่างชัดเจน และเมตริกที่ชื่อ/ชนิด/ลายเซ็นเหมือนกันแต่กำกวมจะถูกตัดออกจากทั้งสอง snapshots และทำให้ผลลัพธ์ไม่สมบูรณ์ Overloads ใช้ลายเซ็นเพื่อแยกชื่อแบบระบุคุณสมบัติครบถ้วนที่เหมือนกันในด้านอื่น ตรวจสอบคู่รายการใหม่/รายการที่แก้ไขแล้วซึ่งจับคู่ไม่ได้ก่อนใช้เป็นข้อบกพร่อง เพราะยังอาจส่งผลต่อ CI ได้
รายการขนาดฟังก์ชันใช้ช่วงของ source ไม่ใช่จำนวนคำสั่งที่ทำงานได้
การถดถอยของนโยบายสถาปัตยกรรม, โค้ดที่ไม่ทำงาน, การเข้าถึง/coverage ของการทดสอบ และขนาดโมดูล จะเลื่อนการพิจารณาออกไป
สแนปช็อตจะถูกอ่านตามลำดับภายในธุรกรรมการอ่านของฐานข้อมูล เนื้อหาของสัญลักษณ์จะโหลดทีละไฟล์ที่จัดทำดัชนีไว้ โดยจะเก็บไว้ในการเปรียบเทียบเฉพาะระเบียนเมตริกแบบย่อเท่านั้น การเชื่อมโยงระหว่างไฟล์และอัลกอริทึม SCC แบบวนซ้ำที่มีอยู่ต้องใช้พื้นที่/เวลา O(files + resolved file dependencies) สำหรับการวิเคราะห์วงจร โดยไม่มีการแจกแจงวงจรแต่ละวง การตรวจสอบความถูกต้องใช้กระบวนการ Git batch หนึ่งกระบวนการต่อสแนปช็อต และถอดรหัส blob ทีละรายการ (สูงสุด 64 MiB) โดยอ่านเนื้อหาที่จัดทำดัชนีไว้พร้อมข้อมูลเมตาของ Git tree โดยไม่สแกน working tree ต้นทุนรวมยังเพิ่มตามจำนวนไบต์ของซอร์สและสัญลักษณ์ที่จัดทำดัชนีไว้ด้วย ซึ่งเป็นการแลก I/O บางส่วนโดยตั้งใจ เพื่อให้ตรวจสอบความใหม่ได้โดยไม่ต้องมีข้อมูลที่มาของ commit การเปรียบเทียบนี้ไม่สร้างแคช worker pool หรืองานเบื้องหลัง รายงาน JSON ขนาดใหญ่อาจมีขนาดมาก หากต้องคำนึงถึงงบประมาณโทเค็น ให้ใช้จำนวนจาก MCP หรือจำกัดรายละเอียด
MCP Resources
มี resource สี่รายการให้ใช้งานผ่าน resources/list และ resources/read:
tokensave://status-- สถิติกราฟในรูปแบบ JSONtokensave://files-- แผนผังไฟล์ที่จัดทำดัชนีไว้ โดยจัดกลุ่มตามไดเรกทอรีtokensave://overview-- สรุปโปรเจกต์พร้อมการกระจายตามภาษาและชนิดของสัญลักษณ์tokensave://branches-- branch ที่ติดตาม พร้อมขนาด DB และข้อมูล parent
การติดตามโทเค็น
tokensave วัดจำนวนโทเค็นที่ประหยัดได้จากการเรียกใช้เครื่องมือ MCP ทุกครั้ง การตอบกลับจากเครื่องมือแต่ละครั้งมีบรรทัด tokensave_metrics: before=N after=M ซึ่งแสดงจำนวนโทเค็นจากไฟล์ดิบที่การเรียกใช้นั้นช่วยหลีกเลี่ยงได้
การปิดการรายงาน บรรทัดเมตริกพร้อมกับประโยคใน instructions จะขอให้ agent รายงานจำนวนที่ประหยัดได้ ซึ่งหมายความว่าโมเดลใช้โทเค็น เอาต์พุต เพื่อบรรยายการประหยัดโทเค็น อินพุต ที่ tokensave ทำได้ โทเค็นเอาต์พุตมีราคาแพงกว่า ดังนั้นหาก agent ของคุณพูดถึง tokensave แทบทุกเทิร์น การบรรยายนั้นอาจหักล้างประโยชน์ที่ได้ (#356) ตั้งค่า report_savings เป็น false ใน .tokensave/config.json หรือกำหนดตัวแปรสภาพแวดล้อม TOKENSAVE_REPORT_SAVINGS เพื่อแทนค่ารายรัน (ค่าใดก็ได้จะเปิดใช้ ยกเว้น 0, false, no, off หรือค่าว่าง) ทั้งบรรทัดเมตริกและคำสั่งจะหายไป และ tokensave install ก็จะหยุดเขียนกฎการรายงานลงในไฟล์พรอมป์ต์ของ agent ด้วย ไม่ว่าจะตั้งค่าอย่างไร การวัดผลยังคงเหมือนเดิม ทุกการเรียกใช้ยังถูกบันทึกลงในบัญชีรายการการประหยัด ดังนั้น tokensave gain, tokensave list, status และ monitor จึงยังรายงานเหมือนเดิมทุกประการ ค่าเริ่มต้นยังคงเป็น true
โดยค่าเริ่มต้นจะแสดงเฉพาะเครื่องมือหลัก ไคลเอนต์ MCP จะส่ง schema ของเครื่องมือทุกรายการที่แสดงในทุกเทิร์น ก่อนเรียกใช้เครื่องมือใด ๆ พื้นผิวการทำงานทั้งหมดของ tokensave มี schema ประมาณ 89 KB ซึ่งในโมเดลที่มี context ขนาดเล็กอาจกินพื้นที่เกินครึ่งของหน้าต่าง (#576) ดังนั้น tools/list จึงส่งเฉพาะเครื่องมือหลัก ได้แก่ context, search, status, read, body, files, callers, callees, impact, str_replace และ multi_str_replace (ประมาณ 17 KB เมื่อใช้ tokensave_more) คำแนะนำของ initialize ระบุชื่อเครื่องมือเหล่านี้และหมวดหมู่ที่ tokensave_more แสดงรายการได้ ดังนั้นไคลเอนต์ที่เลื่อนการโหลด schema ของเครื่องมือก็ยังทราบว่ามีเครื่องมืออื่นอยู่ การตั้งค่านี้กำหนดว่าเซิร์ฟเวอร์จะแสดงรายการใด ไม่ใช่กำหนดว่าเซิร์ฟเวอร์เรียกใช้รายการใดได้ เครื่องมือที่ไม่ได้แสดงรายการยังคงตอบสนองต่อการเรียกตามชื่อได้ ดังนั้นรายการสิทธิ์ของ agent และ hooks จึงยังทำงานได้ หากต้องการแสดงเครื่องมือทั้งหมด ให้ตั้งค่า "tools": "full" ใน .tokensave/config.json หรือกำหนด TOKENSAVE_TOOLS=full ในสภาพแวดล้อมของเซิร์ฟเวอร์ MCP โดยตัวแปรสภาพแวดล้อมจะมีผลเหนือไฟล์ "tools": "full" ที่เขียนโดย 7.13.0 ซึ่งบันทึกค่านี้ไว้ในทุก config ที่บันทึก จะถูกอ่านเป็นค่าเริ่มต้นแบบเก่า หากต้องการคงรายการทั้งหมดไว้หลังอัปเกรด ให้ตั้งค่าอีกครั้ง
เมื่อใช้ชุดเครื่องมือหลัก เซิร์ฟเวอร์จะแสดง tokensave_more ด้วย การเรียกใช้พร้อม area (analysis, edit, git, memory, navigate หรือ all) จะแสดงเครื่องมือของหมวดหมู่นั้นตลอดช่วงเวลาที่เหลือของเซสชัน และเซิร์ฟเวอร์จะส่ง notifications/tools/list_changed เพื่อให้ไคลเอนต์ดึงรายการใหม่อีกครั้ง เซสชันจะเสียค่าใช้จ่ายเฉพาะหมวดหมู่ที่ใช้งานเท่านั้น หมวดหมู่ git เพิ่มประมาณ 6 KB ไคลเอนต์ที่ไม่สนใจ list_changed จะยังคงใช้รายการหลัก tokensave install ให้สิทธิ์ tokensave_more พร้อมกับเครื่องมืออื่นทั้งหมด จึงไม่แสดงข้อความขออนุญาต การติดตั้งก่อนรุ่นนี้จะแสดงข้อความขออนุญาตหนึ่งครั้ง จนกว่า tokensave reinstall หรือการซิงก์สิทธิ์ใหม่หลังอัปเกรดจะรีเฟรชรายการสิทธิ์
การตรวจสอบต้นทุน
tokensave cost                     # 7-day cost summary (default)
tokensave cost today               # today only
tokensave cost --by-model          # breakdown by Claude model
tokensave cost --by-task           # breakdown by task category (coding, debugging, exploration, ...)
tokensave cost --export json       # JSON export to stdout
tokensave cost --export csv        # CSV export to stdout
แยกวิเคราะห์บันทึกเซสชันของ Claude Code (~/.claude/projects/**/*.jsonl) และคำนวณราคาของแต่ละ API turn ตามราคาของโมเดล อ่านเซสชัน Pi (~/.pi/agent/sessions/**/*.jsonl) โดยใช้ต้นทุนต่อข้อความที่ Pi รายงานอยู่แล้ว และนำเข้าการตั้งค่าเซสชันของ Factory Droid ในหน่วยเครดิต แต่ละ turn จะถูกจัดประเภทเป็นหนึ่งใน 13 หมวดหมู่งาน และจัดเก็บไว้ใน ~/.tokensave/global.db เพื่อให้ค้นหาข้อมูลสรุปได้อย่างรวดเร็ว ระบบจะอัปเดตราคาจาก LiteLLM ทุก 24 ชั่วโมง และใช้ตารางที่ฝังไว้เป็นข้อมูลสำรองเมื่อออฟไลน์
ส่วนหัว tokensave status มีแถวต้นทุนที่แสดงยอดใช้จ่ายของวันนี้ ยอดรวม 7 วัน และอัตราประสิทธิภาพ (โทเค็นที่ประหยัดได้ / โทเค็นทั้งหมด) TUI ของ tokensave monitor แสดงแผงต้นทุนแบบเรียลไทม์ควบคู่กับฟีดการประหยัด เมื่อสิ้นสุดแต่ละเซสชัน Claude Code ตัวจัดการ hook_stop จะแสดงใบสรุปหนึ่งบรรทัดในเทอร์มินัล ส่วนใน Pi ส่วนขยายที่ติดตั้งไว้จะทำเช่นเดียวกันผ่านตัวจัดการ agent_settled
หมวดหมู่การจำแนกงาน: Coding, Debugging, Feature Dev, Refactoring, Testing, Exploration, Planning, Delegation, Git Ops, Build/Deploy, Brainstorming, Conversation, General การจำแนกเป็นแบบกำหนดแน่นอน (จับคู่รูปแบบจากชื่อเครื่องมือและคำสั่ง Bash) ไม่ต้องเรียกใช้ LLM และดัดแปลงมาจาก AgentSeal/codeburn
ตัวตรวจสอบแบบเรียลไทม์
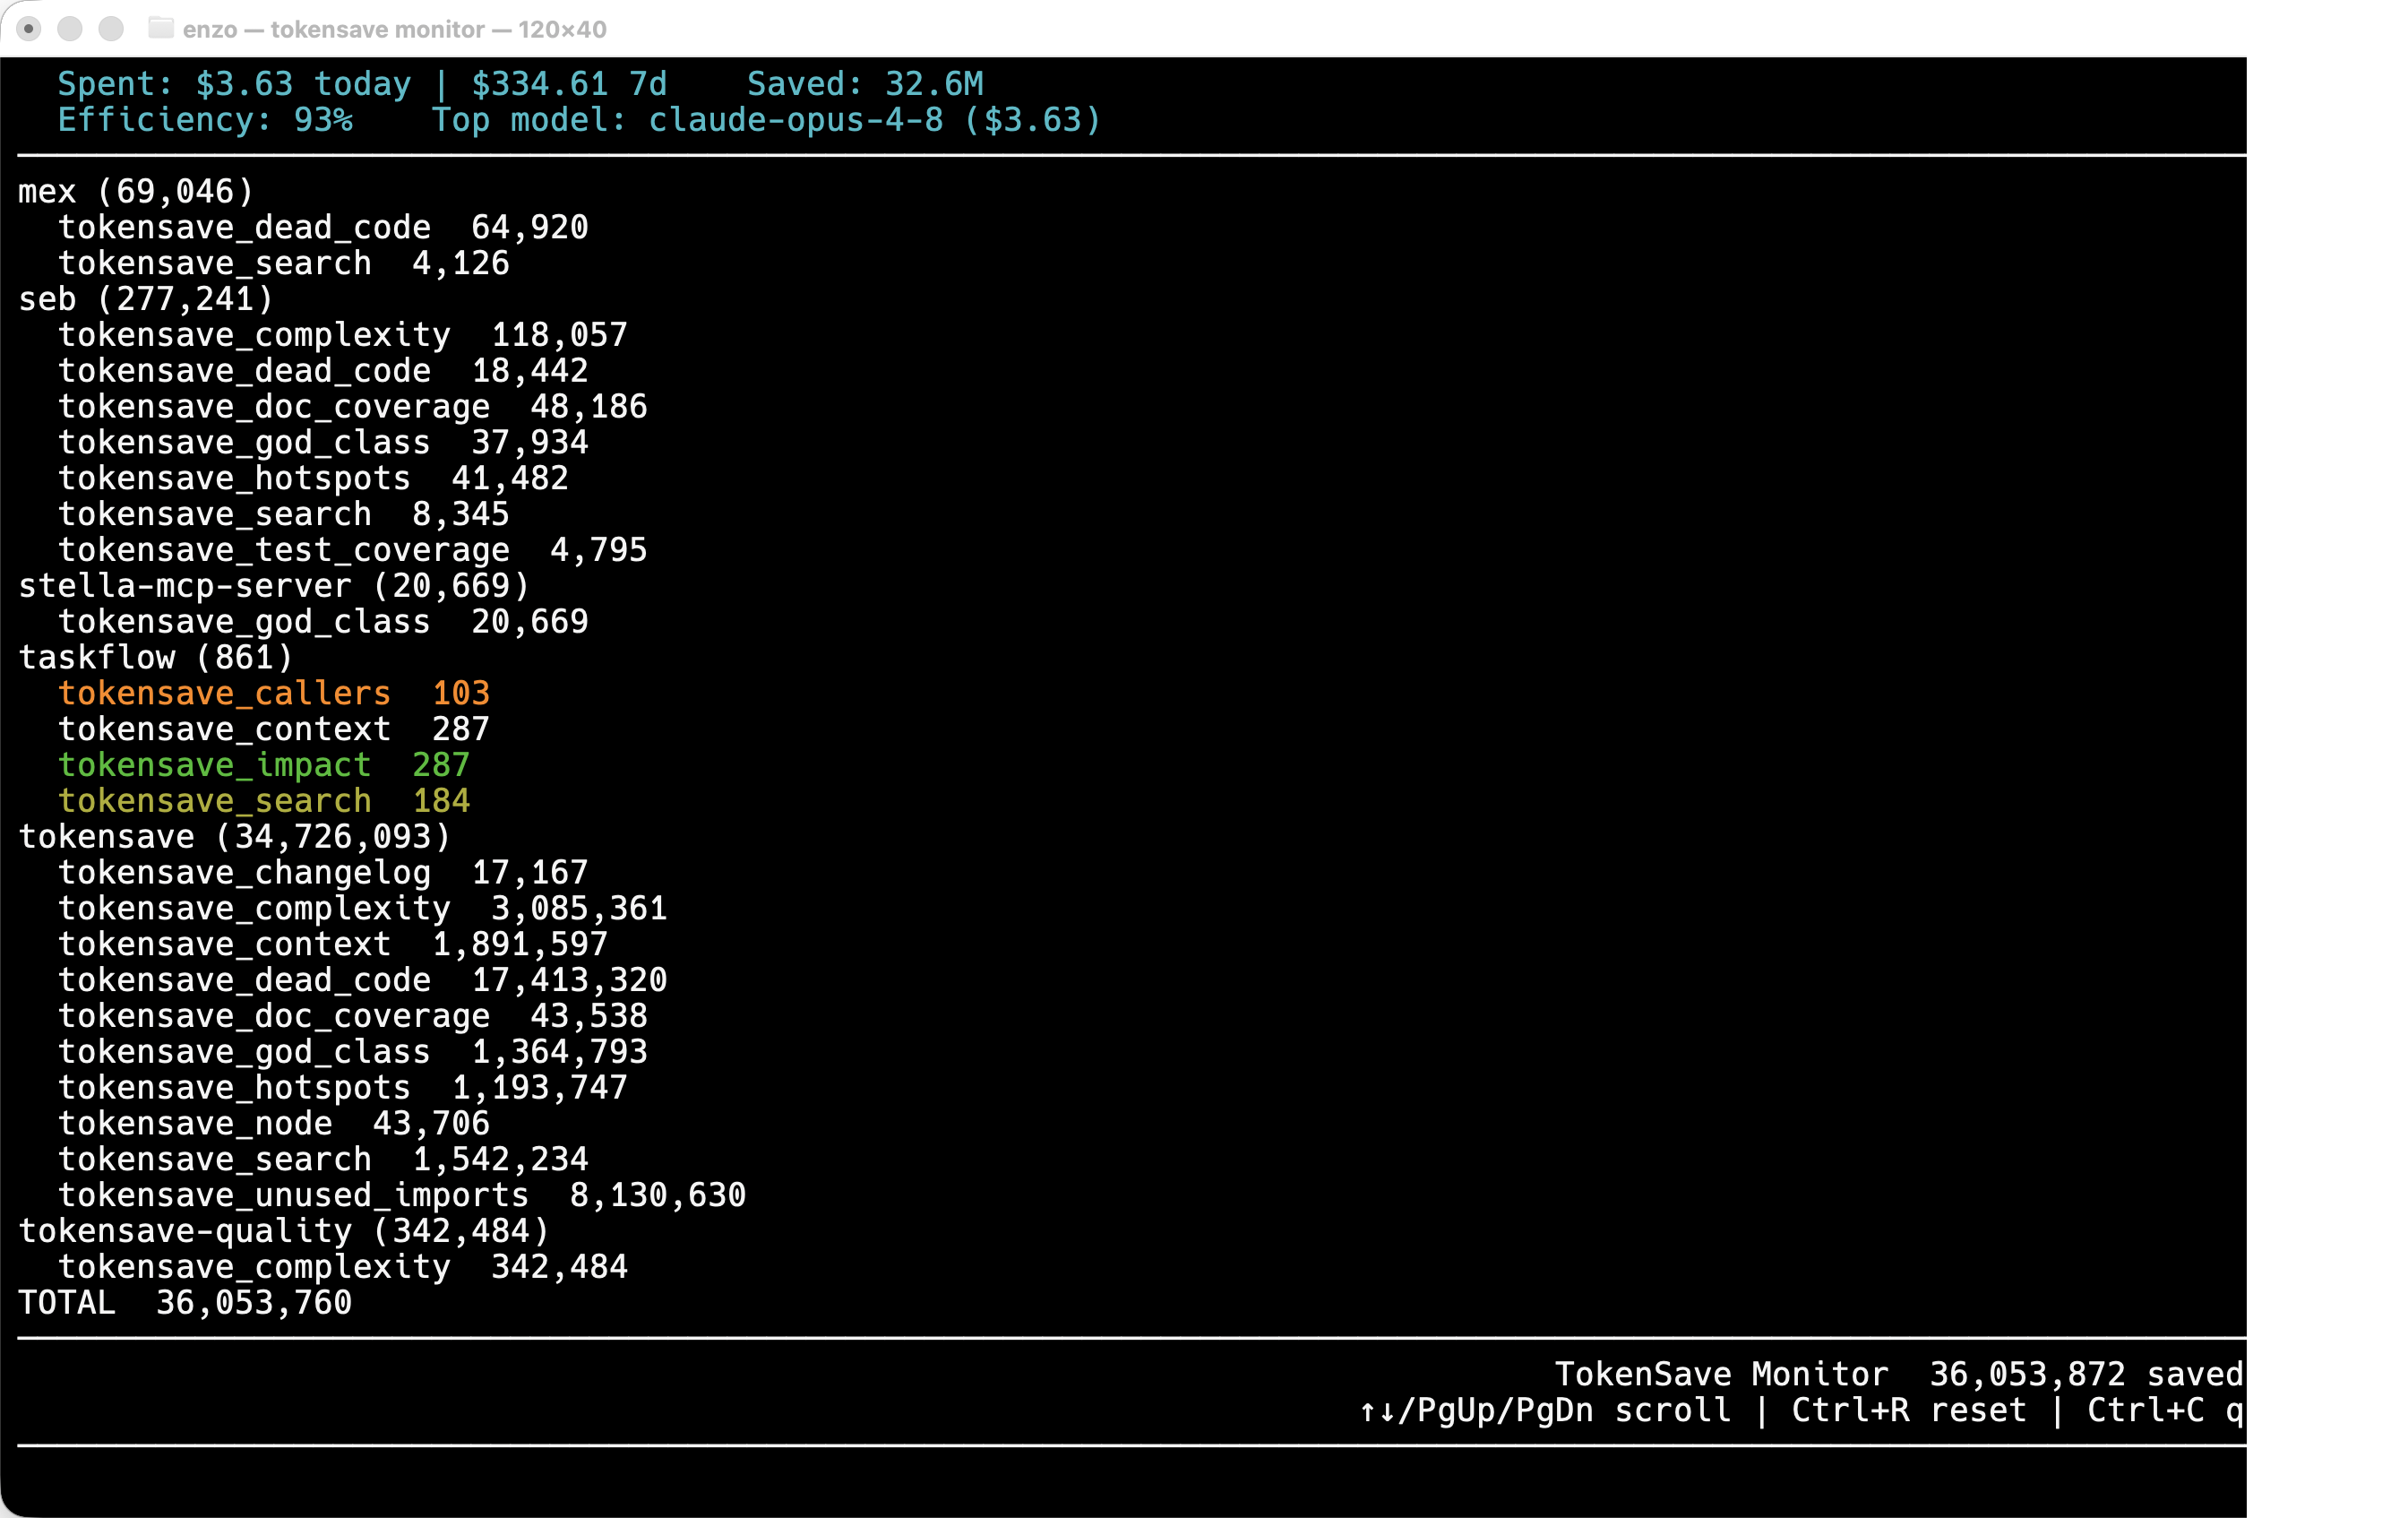
tokensave monitor
TUI ส่วนกลางที่แสดงการเรียกใช้เครื่องมือ MCP จากทุกโปรเจกต์แบบเรียลไทม์ ผ่าน ring buffer ที่แมปหน่วยความจำร่วมกัน ณ ~/.tokensave/monitor.mmap แต่ละรายการแสดงชื่อโปรเจกต์ ชื่อเครื่องมือ และส่วนต่างของโทเค็น แผงต้นทุนด้านบนแสดงยอดใช้จ่ายของวันนี้ ยอดประหยัด ประสิทธิภาพ และโมเดลที่ใช้มากที่สุด (อัปเดตทุก 30 วินาที)
การวินิจฉัยหน่วยความจำ
tokensave memory [--clean]
รายงานหน่วยความจำทั่วทั้งเครื่องสำหรับทุกกระบวนการ tokensave (เซิร์ฟเวอร์ MCP, การซิงก์, การทำดัชนี) ผ่านตารางที่แมปหน่วยความจำร่วมกัน ณ ~/.tokensave/memory.mmap แต่ละอินสแตนซ์จะสุ่มตัวอย่าง RSS ด้วยวิธี best-effort เมื่อเริ่มต้น เมื่อมีการเรียกใช้เครื่องมือ MCP แต่ละครั้ง และในช่วงก่อนหรือหลังขั้นตอนการซิงก์/การแก้ไขการอ้างอิง ดังนั้นรายงานจึงแสดง RSS ปัจจุบันและค่าสูงสุด พร้อมขั้นตอนที่ทำให้เกิดค่าสูงสุด ซึ่งเป็นข้อมูลที่จำเป็นต่อการระบุสาเหตุของการใช้หน่วยความจำสูง (ดู #253) แถวต่าง ๆ จะถูกทำเครื่องหมายเป็น alive, dead (กระบวนการที่ถูกยุติด้วย OOM จะทิ้งค่าสูงสุด/ขั้นตอนไว้เป็นหลักฐานสำหรับการตรวจสอบ) หรือ orphan (ยังทำงานอยู่แต่ถูกย้ายไปอยู่ใต้ init) --clean จะล้างช่องของกระบวนการที่ตายแล้ว
PEAK PHASE ระบุ ตัวอย่างค่าสูงสุด จึงมีความแม่นยำได้เท่ากับความถี่ในการสุ่มตัวอย่างเท่านั้น การซิงก์แบบเพิ่มทีละส่วนจะบันทึกตามลำดับดังนี้: sync:extract, sync:resolve:load_nodes, sync:resolve:build_caches, sync:resolve:refs, sync:variants, sync:done การทำดัชนีแบบเต็มจะบันทึก index:extract, index:resolve:build_caches, index:resolve:refs, index:resolve:done, index:insert, index:done
แต่ละรายการจะบันทึกหลังจากทำงานที่ระบุเสร็จแล้ว ก่อนหน้านี้มีการบันทึกก่อนทำงาน ทำให้ทุกตัวอย่างรายงาน RSS ของขั้นตอนก่อนหน้าโดยใช้ป้ายชื่อของขั้นตอนถัดไป ซึ่งระบุว่า node load ใช้หน่วยความจำ 73 MiB ทั้งที่จริงเป็นของการโหลด unresolved references ซึ่งไม่มีตัวอย่างของตัวเองเลย และทำให้การตรวจสอบหน่วยความจำมุ่งไปยังระบบย่อยที่ผิดเป็นเวลาหลายเดือน (#409) หากเพิ่มขั้นตอน ให้สุ่มตัวอย่างหลังทำงาน ไม่ใช่ก่อน และเพิ่มตัวอย่างสำหรับทุกขั้นตอนที่มีขนาดใหญ่พอจะทำให้เกิดค่าสูงสุด
ตัวนับของเซสชันและตลอดอายุการใช้งาน
tokensave current-counter          # show per-project session counter
tokensave reset-counter            # reset the session counter
tokensave status                   # shows project + global lifetime totals + cost
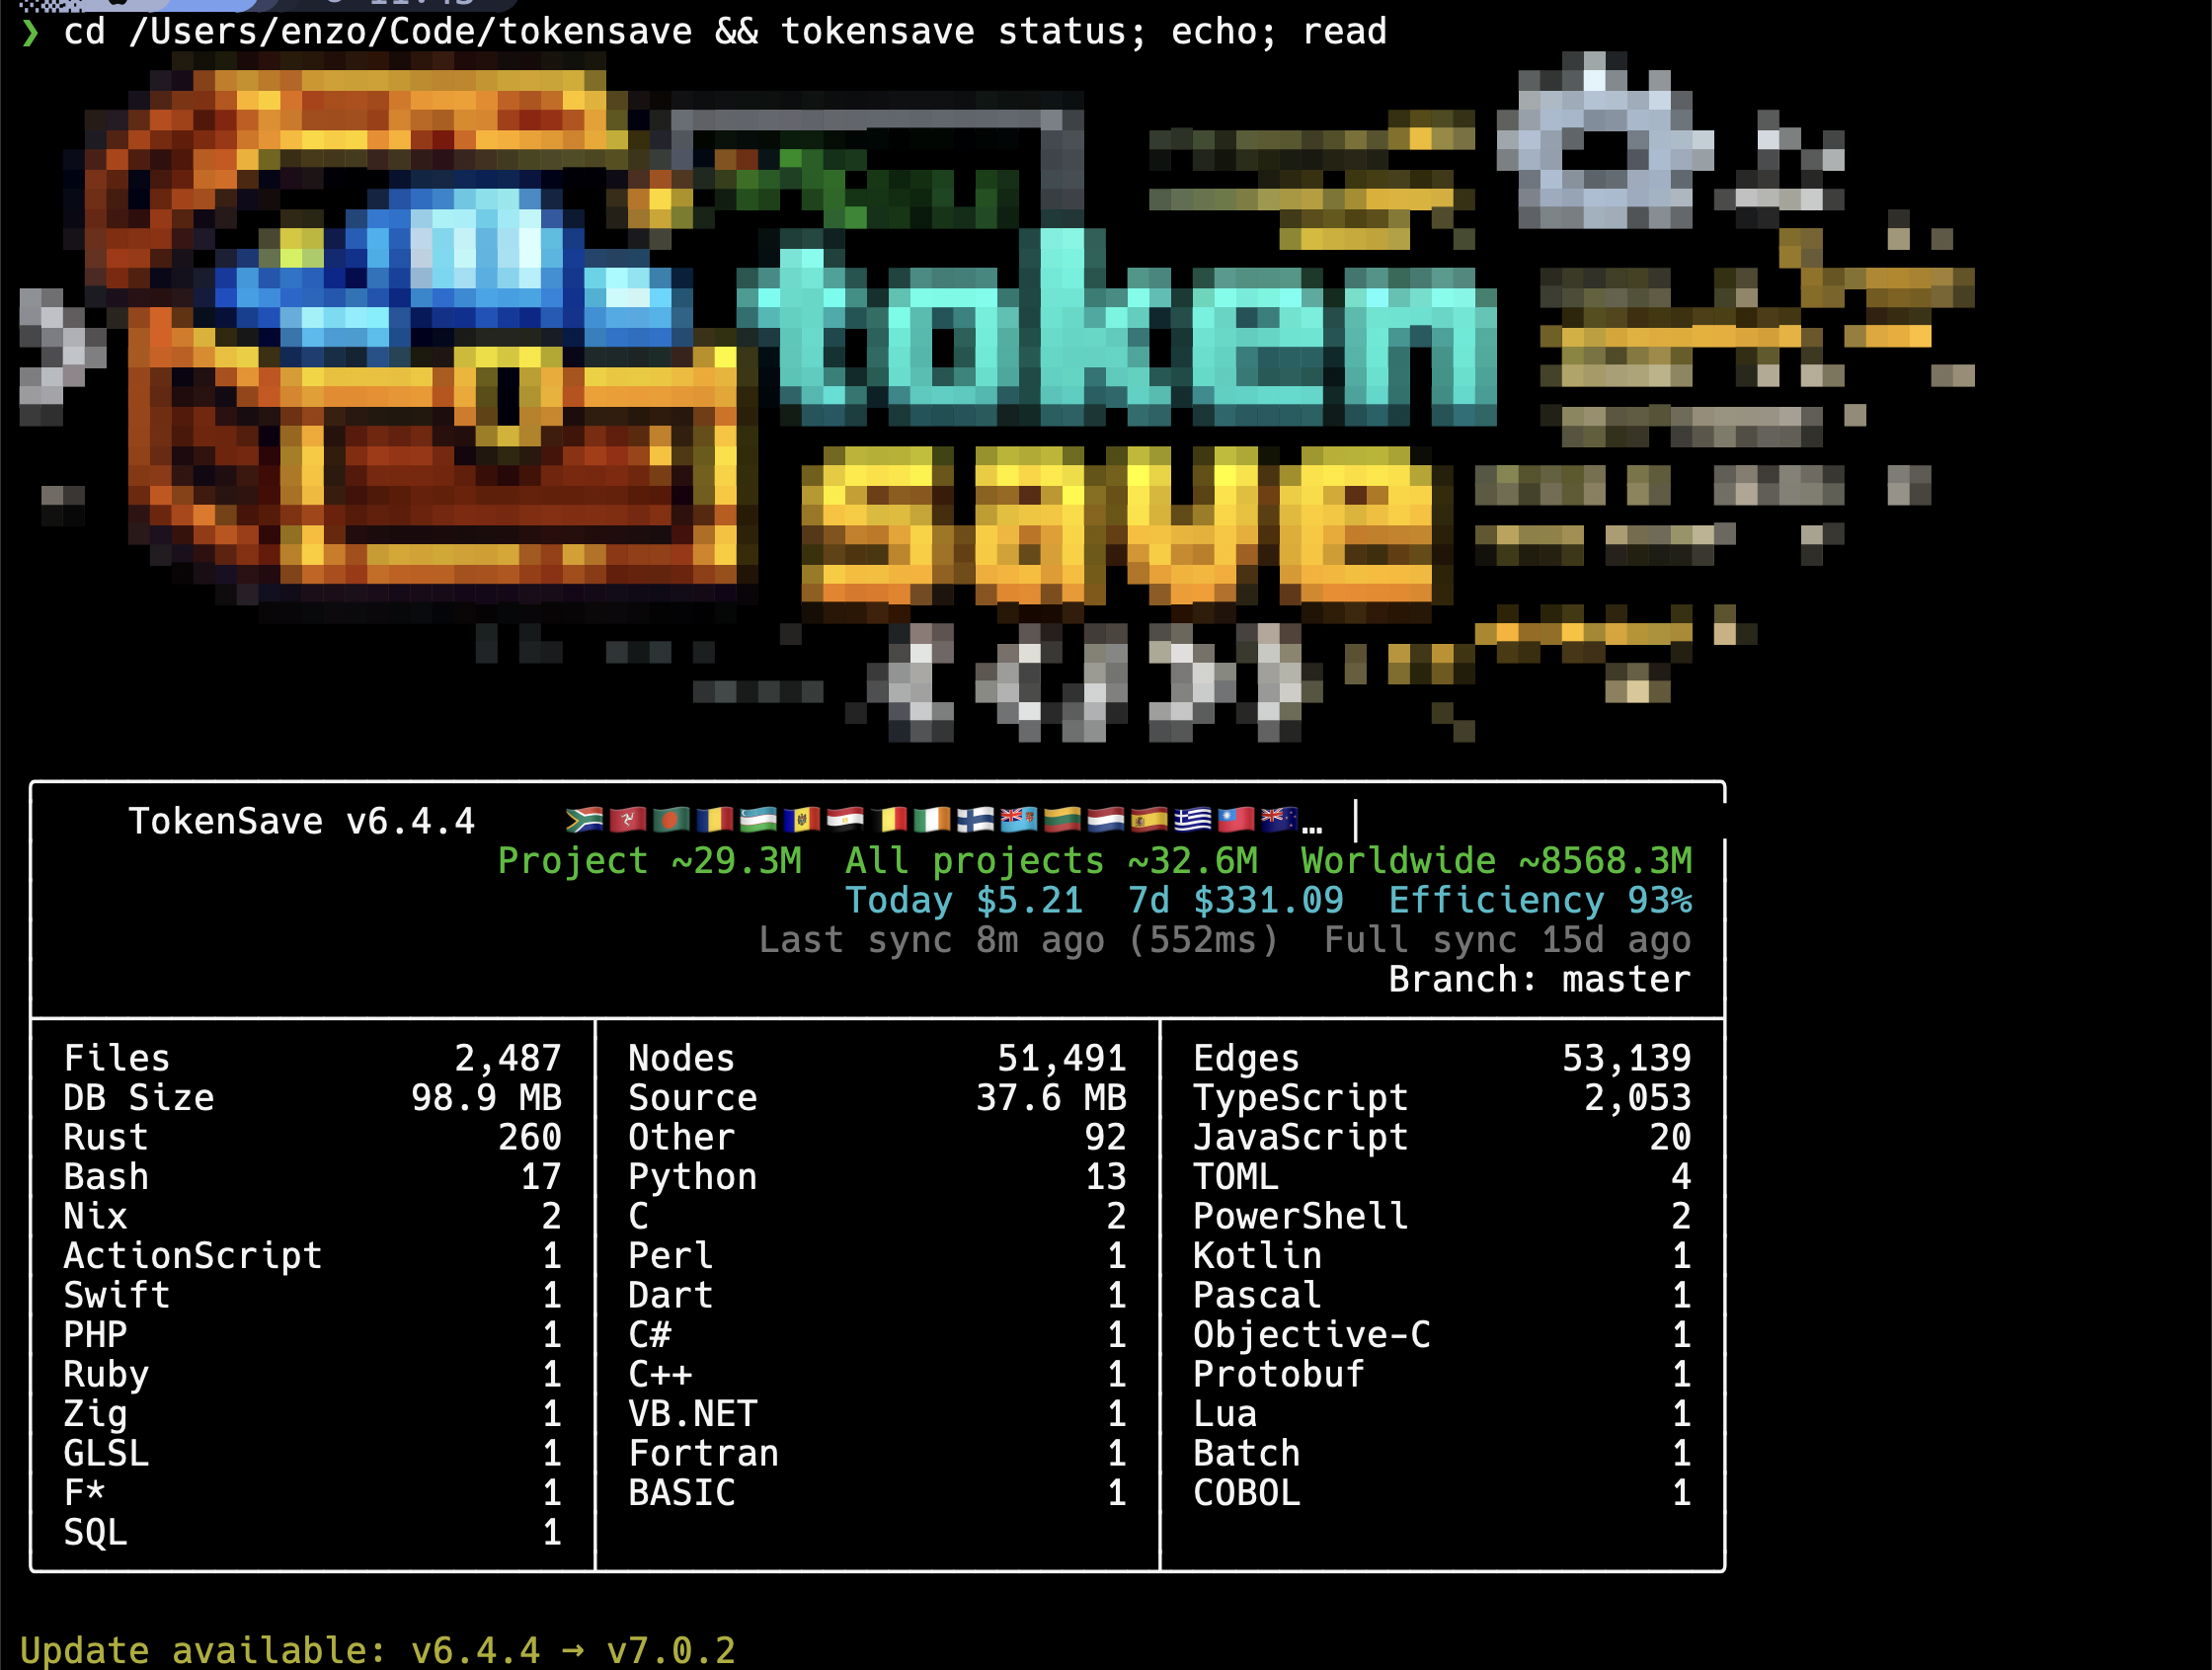
tokensave status แสดงสถิติของดัชนีโปรเจกต์ รายละเอียดแยกตามภาษา แถวต้นทุน (วันนี้ / 7d / ประสิทธิภาพ) และยอดรวมตลอดอายุการใช้งานของโปรเจกต์และทั่วโลก:
ตัวนับทั่วโลก
ผู้ใช้ tokensave ทุกคนมีส่วนร่วมในตัวนับรวมแบบไม่ระบุตัวตน tokensave status แสดงทั้งยอดรวมของโปรเจกต์คุณและยอดรวมทั่วโลก การอัปโหลดจะส่งเพียงตัวเลขเดียว (เช่น 4823) โดยไม่มีข้อมูลระบุตัวตน เลือกไม่เข้าร่วมได้ด้วย tokensave disable-upload-counter
ความใหม่ของดัชนี
tokensave ทำให้กราฟเป็นปัจจุบันอยู่เสมอโดยไม่ต้องใช้ daemon เบื้องหลังหรือ file watcher ระดับระบบปฏิบัติการ
ตรวจสอบความล้าสมัยตามต้องการ การเรียกใช้เครื่องมือ MCP ทุกครั้งจะตรวจสอบว่ามีไฟล์ที่จัดทำดัชนีไว้ถูกแก้ไขนับจากการซิงก์ครั้งล่าสุดหรือไม่ หากพบไฟล์ที่ล้าสมัย ระบบจะดึงข้อมูลใหม่ก่อนส่งการตอบกลับจากเครื่องมือ ช่วงพัก 30 วินาทีช่วยป้องกันไม่ให้มีการเดินสำรวจ tree ซ้ำทุกครั้งที่กดแป้นพิมพ์
ซิงก์ตามเก็บเมื่อเชื่อมต่อ เมื่อเซิร์ฟเวอร์ MCP เริ่มทำงาน ระบบจะเริ่มซิงก์ตามเก็บแบบไม่บล็อกทันที เพื่อรับการเปลี่ยนแปลงที่เกิดขึ้นระหว่างที่ไม่มี agent เชื่อมต่ออยู่ เช่น git pull, การแก้ไขใน IDE หรือขั้นตอน build เพื่อให้การเรียกใช้เครื่องมือครั้งแรกของเซสชันเห็นดัชนีที่เป็นปัจจุบัน
การทำงานร่วมกันของหลาย agent และ git worktree เมื่อมี agent หลายตัวทำงานในโปรเจกต์เดียวกันพร้อมกัน สมมติฐานหลักคือ agent แต่ละตัวทำงานใน git worktree ของตนเอง Worktree คือ checkout ของ repository เดียวกันที่แยกจากกันในระบบไฟล์ agent A และ agent B จึงมีสำเนาของทุกไฟล์เป็นของตนเอง และจะไม่เขียนทับการแก้ไขที่อีกฝ่ายกำลังทำอยู่ tokensave ตรวจจับโดยอัตโนมัติเมื่อมีการค้นหาจาก worktree ที่ซ้อนอยู่ภายใน checkout หลัก และแสดงผลจากกราฟของ branch ที่ถูกต้อง การเปลี่ยนแปลงจะสะสมแยกจากกันและนำมารวมกันภายหลังผ่าน git merge หรือ rebase ซึ่งเป็นกระบวนการเดียวกับการพัฒนาแบบขนานทั่วไป การออกแบบนี้ช่วยหลีกเลี่ยงความซับซ้อนและรูปแบบความล้มเหลวของการล็อกข้าม agent บนไดเรกทอรีที่ใช้ร่วมกันและเปลี่ยนแปลงได้
เวิร์กโฟลว์ที่ใช้ CLI เท่านั้น หากคุณเรียกใช้คำสั่ง tokensave โดยไม่มี agent เชื่อมต่ออยู่ (ไม่มีเซิร์ฟเวอร์ MCP) การตรวจสอบความล้าสมัยจะไม่ทำงานระหว่างคำสั่ง ติดตั้ง git hooks เพื่อให้ดัชนีเป็นปัจจุบันโดยอัตโนมัติหลังทุก commit หรือ clone:
cp scripts/post-commit scripts/post-checkout .git/hooks/
chmod +x .git/hooks/post-commit .git/hooks/post-checkout
การอัปเกรดจาก 5.x
คำสั่ง tokensave daemon แบบ standalone และการเริ่มทำงานอัตโนมัติผ่าน launchd/systemd/Windows Service ถูกนำออกใน 6.0.0 ส่วน file watcher ระดับระบบปฏิบัติการที่ฝังมาเพื่อแทน daemon ก็ถูกนำออกใน 6.1.1 เช่นกัน (ทำให้ CPU และหน่วยความจำพุ่งสูงต่อเนื่องใน monorepo ขนาดใหญ่ที่มีต้นไม้ node_modules หรือ target ซ้อนลึก) รูปแบบตรวจสอบความล้าสมัยตามต้องการข้างต้นคือการออกแบบปัจจุบัน
หากยังมีการตั้งค่าให้ daemon เริ่มทำงานอัตโนมัติจาก 5.x ให้ลบออก:
- macOS:
launchctl unload ~/Library/LaunchAgents/com.tokensave.daemon.plist && rm ~/Library/LaunchAgents/com.tokensave.daemon.plist - Linux:
systemctl --user disable --now tokensave-daemon && rm ~/.config/systemd/user/tokensave-daemon.service - Windows:
sc.exe delete tokensave-daemon(จากเทอร์มินัลที่ยกระดับสิทธิ์)
หากจำชื่อที่แน่นอนไม่ได้: launchctl list | grep tokensave / systemctl --user list-units | grep tokensave / sc.exe query state= all | findstr -i tokensave
การอัปเกรดด้วยตนเอง
tokensave upgrade                  # upgrade to latest in current channel
tokensave channel                  # show current channel (stable/beta)
tokensave channel beta             # switch to beta channel
tokensave channel stable           # switch back to stable
tokensave upgrade ดาวน์โหลดไบนารีที่ถูกต้องสำหรับแพลตฟอร์มจาก GitHub releases และแทนที่ไบนารีที่กำลังทำงานอยู่โดยตรง รองรับช่อง stable และ beta แยกจากกัน
การกำหนดเวอร์ชันและการอัปเกรด
หมายเลขเวอร์ชันของ tokensave ดูเหมือน SemVer แต่ ไม่ได้ทำตามมาตรฐานนี้: ส่วนที่เปลี่ยนแปลงจะระบุการบำรุงรักษาที่การอัปเดตต้องใช้ ซึ่ง tokensave จะดำเนินการโดยอัตโนมัติเมื่อเปิดใช้งานครั้งถัดไป คุณไม่ต้องติดตั้งใหม่หรือจัดทำดัชนีใหม่ด้วยตนเอง
| การเพิ่มเวอร์ชัน | ตัวอย่าง | สิ่งที่ต้องทำในการอัปเดต | การดำเนินการอัตโนมัติ |
|---|---|---|---|
Patch (x.y.Z) | 7.2.0 → 7.2.1 | ไม่ต้องทำอะไร | ไม่มี — ไม่ต้องติดตั้งใหม่หรือจัดทำดัชนีใหม่ |
Minor (x.Y.0) | 7.2.0 → 7.3.0 | ติดตั้งใหม่ (harness ใหม่ เครื่องมือใหม่ config ใหม่) | ติดตั้งใหม่ทั่วทั้งระบบ สำหรับการเชื่อมต่อ agent ที่ติดตั้งไว้ทั้งหมด (รีเฟรชสิทธิ์ hooks และ MCP config) |
Major (X.0.0) | 7.2.0 → 8.0.0 | ติดตั้งใหม่และซิงก์ใหม่ทั้งหมด | ติดตั้งใหม่ทั่วทั้งระบบ และ บังคับจัดทำดัชนีใหม่แยกตามโปรเจกต์ (เทียบเท่า sync -f) |
ติดตั้งใหม่ทั่วทั้งระบบ เมื่อเรียกใช้ build minor หรือ major ใหม่เป็นครั้งแรก tokensave จะเรียกใช้ install ซ้ำอย่างเงียบ ๆ สำหรับ agent แต่ละตัวที่ลงทะเบียนไว้ เพื่อให้ config ของ agent ชี้ไปยังไบนารีปัจจุบันและแสดงชุดเครื่องมือปัจจุบัน การเพิ่มเวอร์ชันแบบ patch จะข้ามขั้นตอนนี้ โดยจะเลื่อนตัวระบุเวอร์ชันที่กำลังทำงานอยู่เท่านั้น
การติดตั้งใหม่ทำงานแบบเงียบสนิทจริง ๆ: เอาต์พุตการตั้งค่ารายเอเจนต์ที่คุณเห็นจาก tokensave install ที่เรียกใช้โดยตรงจะถูกระงับไว้ที่นี่ จึงไม่ปรากฏต่อหน้า tokensave init หรือ tokensave sync ทั่วไป หากรีเฟรชการกำหนดค่าของเอเจนต์ไม่ได้ — ไม่ได้ติดตั้งแอป หรือไฟล์กำหนดค่าอยู่ในตำแหน่งที่อ่านได้อย่างเดียว — คุณจะได้รับข้อความหนึ่งบรรทัดที่ระบุชื่อเอเจนต์ที่ดำเนินการไม่สำเร็จ:
warning: could not refresh tokensave config for: copilot.
  Run tokensave install to see the error.
เรียกใช้ tokensave install เพื่อดูข้อผิดพลาดต้นทาง ไม่ว่าอย่างไร ตัวระบุเวอร์ชันก็จะเลื่อนไปข้างหน้า ดังนั้นเส้นทางไฟล์กำหนดค่าที่เขียนไม่ได้เลยจะถูกรายงานเพียงครั้งเดียวต่อการอัปเกรด แทนที่จะลองซ้ำทุกครั้งที่เรียกใช้คำสั่งครั้งถัดไป
บังคับสร้างดัชนีใหม่รายโปรเจกต์ (เฉพาะเวอร์ชันหลัก) การอัปเกรดเวอร์ชันหลักหมายความว่าต้องสร้างดัชนีโปรเจกต์ใหม่ tokensave จะทำงานนี้แบบขี้เกียจและแยกตามโปรเจกต์: เมื่อมีการเรียกใช้เครื่องมือ MCP ครั้งแรก ในโปรเจกต์หลังอัปเกรดเวอร์ชันหลัก ระบบจะเริ่มสร้างดัชนีใหม่ทั้งหมดในเบื้องหลัง (เทียบเท่ากับ tokensave sync --force) โดยไม่บล็อกการตอบกลับของเครื่องมือ
ทางเลือกสำรองสำหรับ Brew / cargo การอัปเกรดจากภายนอกที่แทนที่ไบนารีนอก tokensave upgrade — brew upgrade tokensave หรือ cargo install tokensave — จะถูกตรวจจับด้วยวิธีเดียวกัน: หากเวอร์ชันที่กำลังทำงานใหม่กว่าเวอร์ชันล่าสุดที่ติดตั้ง ระบบจะติดตั้งใหม่เมื่อเปิดใช้งานครั้งถัดไป เช่นเดียวกับกรณีอัปเกรดด้วยตนเอง
ดู TOKENSAVE-VERSIONING.md เพื่ออ่านเหตุผลที่ tokensave แตกต่างจาก SemVer (การเข้ารหัสการบำรุงรักษาไว้ในเวอร์ชันทำให้การอัปเกรดแบบไม่ต้องดำเนินการใด ๆ เป็นไปได้) กลไกของตัวระบุเวอร์ชัน เวอร์ชันสคีมาฐานข้อมูลที่แยกต่างหาก และกฎสำหรับผู้ดูแลในการเผยแพร่รุ่นใหม่
ข้อมูลอ้างอิง CLI
tokensave init [path]              # Initialize a new project (full index); without a path, the git root
                                   # (a no-op inside an existing project)
tokensave init --cpu-usage low     # Initialize with a fixed CPU profile (skip the benchmark)
tokensave config benchmark         # Run or reuse the machine-level hardware benchmark
tokensave config benchmark --show  # Show the saved benchmark and settings (never measures)
tokensave config benchmark --force # Measure this machine again
tokensave config benchmark --reset # Delete the saved benchmark
tokensave tune [path] [--dry-run]  # Re-benchmark, save globally, update a pinned cpu_usage
tokensave sync [path]              # Incremental sync (must be initialized first)
tokensave sync --force [path]      # Force a full re-index
tokensave sync --doctor [path]     # Sync and list added/modified/removed files
tokensave verify [path]            # Read-only index integrity and source-stat checks
tokensave verify [path] --deep --json # Full SQLite checks and bounded source hashing
tokensave status [path]            # Show statistics + cost summary
tokensave status [path] --json     # Show statistics (JSON output)
tokensave status --details         # Include node-kind breakdown
tokensave cost [range]             # Token cost summary (default: 7d)
tokensave cost --by-model          # Cost grouped by model
tokensave cost --by-task           # Cost grouped by task category
tokensave cost --export json|csv   # Export cost data
tokensave query <search> [path]    # Search symbols
tokensave files [--filter dir] [--pattern glob] [--json]   # List indexed files
tokensave affected <files...> [--stdin] [--depth N]        # Find affected test files
tokensave install [--agent NAME]   # Configure agent integration
tokensave reinstall                # Refresh settings for all installed agents
tokensave uninstall [--agent NAME] # Remove agent integration
tokensave serve [--idle-timeout-secs N]   # Start MCP server (N: exit after N idle seconds)
tokensave servers [--json]         # List running servers and the index each one holds
tokensave monitor                  # Live TUI showing MCP calls across all projects
tokensave memory [--clean]         # Per-instance RSS report for all tokensave processes
tokensave upgrade                  # Self-update to latest version
tokensave channel [stable|beta]    # Show or switch update channel
tokensave doctor [--agent NAME]    # Check installation health
tokensave githooks [on|off] [--local]  # Manage git hooks (--local: this repo only, no core.hooksPath)
tokensave branch add|list|remove|removeall|gc   # Multi-branch management
tokensave current-counter          # Show per-project token counter
tokensave reset-counter            # Reset per-project token counter
tokensave disable-upload-counter   # Opt out of worldwide counter uploads
tokensave enable-upload-counter    # Re-enable worldwide counter uploads
tokensave doctor
เรียกใช้การตรวจสอบสถานะอย่างครอบคลุมสำหรับการติดตั้ง tokensave ของคุณ:
tokensave doctor
ตรวจสอบ: ตำแหน่งไบนารี ดัชนีโปรเจกต์ ฐานข้อมูลส่วนกลาง การกำหนดค่าผู้ใช้ การผสานรวมกับเอเจนต์ (เซิร์ฟเวอร์ MCP, hooks, สิทธิ์, กฎพรอมป์ต์) และการเชื่อมต่อเครือข่าย หากหลังอัปเกรดมีสิทธิ์ของเครื่องมือที่ขาดหาย ระบบจะแจ้งให้คุณเรียกใช้ tokensave install ใช้ --agent เพื่อตรวจสอบเฉพาะเอเจนต์ที่ระบุ
Doctor ยังตรวจสอบด้วยว่า hook ที่ติดตั้งแต่ละรายการใช้คำสั่งย่อยของ tokensave ที่ถูกต้อง และซ่อมแซม hook ที่เสียโดยอัตโนมัติ
วิธีทำงานร่วมกับ Claude Code
เมื่อตั้งค่าแล้ว Claude Code จะใช้ tokensave แทนการอ่านไฟล์ดิบโดยอัตโนมัติเมื่อต้องทำความเข้าใจโค้ดเบสของคุณ กลไกสามชั้นช่วยเสริมการทำงานซึ่งกันและกัน:
| ชั้น | ทำอะไร | เหตุใดจึงสำคัญ |
|---|---|---|
| เซิร์ฟเวอร์ MCP | เปิดเผยเครื่องมือ tokensave_* มากกว่า 80 รายการให้ Claude | Claude สามารถค้นหาข้อมูลจากกราฟได้โดยตรง |
| กฎ CLAUDE.md | แจ้งให้ Claude เลือกใช้ tokensave แทนเอเจนต์/การอ่านไฟล์ | ป้องกันไม่ให้โมเดลหันกลับไปใช้รูปแบบที่สิ้นเปลือง |
| hook PreToolUse | hook แบบ Rust ดั้งเดิมบล็อกเอเจนต์ Explore | จัดการกรณีที่โมเดลไม่ทำตามกฎใน CLAUDE.md |
| hook UserPromptSubmit | ทำงานเมื่อส่งพรอมป์ต์ | ติดตามวงจรการทำงานเพื่อคำนวณโทเค็น |
| hook Stop | ทำงานเมื่อเซสชันสิ้นสุด | บันทึกตัวนับโทเค็น |
ผลลัพธ์คือ Claude เข้าใจโค้ดได้เท่าเดิมโดยใช้โทเค็นน้อยลงมาก โดยทั่วไปเอเจนต์ Explore จะอ่านไฟล์ 20-50 ไฟล์ ส่วน tokensave จะส่งคืนสัญลักษณ์ ความสัมพันธ์ และตัวอย่างโค้ดที่เกี่ยวข้องจากดัชนีที่สร้างไว้ล่วงหน้า
การเรียกเครือข่ายและความเป็นส่วนตัว
ฟังก์ชันหลักของ tokensave (การสร้างดัชนี การค้นหา การค้นหากราฟ เซิร์ฟเวอร์ MCP) ทำงาน ภายในเครื่อง 100% -- โค้ดของคุณจะไม่ออกจากเครื่อง
| การเรียก | ข้อมูลที่ส่ง | เมื่อใด | วิธีปิด |
|---|---|---|---|
| อัปโหลดตัวนับทั่วโลก | จำนวนโทเค็น (ตัวเลข) + ประเทศ (จาก IP) | sync, status, เซสชัน MCP | tokensave disable-upload-counter |
| อ่านตัวนับทั่วโลก | ไม่มี (คำขอ GET) | status | N/A (อ่านอย่างเดียว หมดเวลา 1s) |
| ตรวจสอบเวอร์ชัน | ไม่มี (คำขอ GET) | status (แคช 5m), sync (ทำงานพร้อมกัน) | N/A (หมดเวลา 1s หากล้มเหลวจะไม่ทำอะไร) |
| รีเฟรชราคาของโมเดล | ไม่มี (คำขอ GET) | tokensave cost (แคช 24h) | N/A (หมดเวลา 5s หากล้มเหลวจะใช้ราคาที่ฝังมา) |
การอัปโหลดตัวนับทั่วโลกจะส่ง HTTP POST เพียงครั้งเดียว โดยมีเนื้อหา JSON เช่น {"amount": 4823} ไม่มีคุกกี้ ไม่มีการติดตาม ไม่มี ID ผู้ใช้ Cloudflare Worker จะบันทึกประเทศของที่อยู่ IP ของคุณ (อนุมานจากส่วนหัวของคำขอ) เพื่อใช้ทำสถิติทางภูมิศาสตร์แบบรวม -- ไม่มีการจัดเก็บที่อยู่ IP จริงของคุณ
การรีเฟรชราคาของโมเดลจะดึงไฟล์ JSON สาธารณะจาก GitHub (raw.githubusercontent.com/BerriAI/litellm/main/model_prices_and_context_window.json) เพื่อให้ราคาของโมเดล Claude เป็นปัจจุบันสำหรับ tokensave cost ไม่มีการส่งข้อมูลใด ๆ -- เป็นคำขอ HTTPS GET ธรรมดา ระบบจะแคชการตอบกลับไว้ที่ ~/.tokensave/pricing.json เป็นเวลา 24 ชั่วโมง หากดึงข้อมูลไม่สำเร็จ tokensave จะใช้ตารางราคาที่คอมไพล์รวมไว้
รองรับมากกว่า 50 ภาษา
tokensave รองรับภาษาโปรแกรมมากกว่า 50 ภาษา โดยจัดเป็นสามระดับที่ควบคุมด้วย Cargo feature flags แต่ละระดับจะรวมภาษาทั้งหมดจากระดับก่อนหน้าไว้ด้วย ส่วนหัว Markdown จะถูกดึงออกมาเป็นโหนด Module พร้อมขอบ Contains แบบลำดับชั้น เพื่อให้โครงสร้างเอกสารมีส่วนร่วมในการค้นหากราฟควบคู่ไปกับซอร์สโค้ด
Lite -- --no-default-features
คอมไพล์รวมไว้เสมอ ไบนารีขนาดเล็กที่สุดสำหรับภาษายอดนิยม พร้อม Svelte และ Astro (ดึงบล็อกสคริปต์ผ่านตัวดึงข้อมูล TypeScript โดยไม่ต้องพึ่งพาไวยากรณ์เพิ่มเติม)
| ภาษา | นามสกุลไฟล์ |
|---|---|
| Rust | .rs |
| Go | .go |
| Java | .java |
| Scala | .scala, .sc |
| TypeScript | .ts, .tsx |
| JavaScript | .js, .jsx |
| Python | .py |
| C | .c, .h |
| C++ | .cpp, .hpp, .cc, .cxx, .hh |
| Kotlin | .kt, .kts |
| C# | .cs |
| Swift | .swift |
| Svelte | .svelte |
| Astro | .astro |
Medium (Lite + เพิ่มอีก 9 ภาษา) -- --features medium
| ภาษา | นามสกุลไฟล์ | feature flag |
|---|---|---|
| Dart | .dart | lang-dart |
| Pascal | .pas, .pp, .dpr | lang-pascal |
| PHP | .php | lang-php |
| Ruby (รวมเทมเพลต ERB และ Slim) | .rb, .rake, .erb, .slim | lang-ruby |
| Bash | .sh, .bash | lang-bash |
| Protobuf | .proto | lang-protobuf |
| PowerShell | .ps1, .psm1 | lang-powershell |
| Nix | .nix | lang-nix |
| VB.NET | .vb | lang-vbnet |
เทมเพลต ERB และ Slim ใช้ไวยากรณ์ของ Ruby โดยไม่ต้องติดตั้ง Ruby หรือ gem ของเทมเพลตขณะสร้างดัชนี การเรียกใช้ในเทมเพลตจะผูกกับโหนดไฟล์และคงบรรทัดกับคอลัมน์ไบต์เดิมไว้ ERB รองรับแท็กโค้ด/เอาต์พุต เครื่องหมายตัดช่องว่าง ความคิดเห็น และแท็กที่ escape แล้ว Slim รองรับบรรทัดควบคุม/เอาต์พุต บล็อกที่ใช้การเยื้อง แอตทริบิวต์ (รวมถึงรายการแอตทริบิวต์หลายบรรทัด) การแทรกข้อความ และบล็อก ruby:
ไม่รองรับทางลัด Slim แบบกำหนดเองและการคอมไพล์ภาษาแบบฝัง ตัวแปรเฉพาะที่ซึ่ง Rails ส่งให้ขณะเรนเดอร์ไม่สามารถแยกความแตกต่างจากการเรียก helper แบบเปล่าได้ ระบบจึงตัดชื่อที่กำหนดค่าหรือผูกไว้ในเทมเพลตออกอย่างระมัดระวัง ความสัมพันธ์ระหว่างคอนโทรลเลอร์กับวิวและการเรนเดอร์ partial ต้องอาศัยการเชื่อมโยงความหมายของ Rails แยกต่างหาก
Full (Medium + ภาษาอื่นทั้งหมด) -- ค่าเริ่มต้น
| ภาษา | นามสกุลไฟล์ | feature flag |
|---|---|---|
| ActionScript | .as | lang-actionscript |
| Lua | .lua | lang-lua |
| Zig | .zig | lang-zig |
| Objective-C | .m, .mm | lang-objc |
| Perl | .pl, .pm | lang-perl |
| Batch/CMD | .bat, .cmd | lang-batch |
| Fortran | .f90, .f95, .f03, .f08, .f18, .f, .for | lang-fortran |
| COBOL | .cob, .cbl, .cpy | lang-cobol |
| MS BASIC 2.0 | .bas | lang-msbasic2 |
| GW-BASIC | .gw | lang-gwbasic |
| QBasic | .qb | lang-qbasic |
| QuickBASIC 4.5 | .bi, .bm | lang-qbasic |
| Dockerfile | Dockerfile, .dockerfile | lang-dockerfile |
| GLSL | .glsl, .vert, .frag, .comp | lang-glsl |
| Godot Shader | .gdshader, .gdshaderinc | lang-glsl |
| Minecraft Function | .mcfunction | lang-mcfunction |
| WGSL | .wgsl | lang-wgsl |
| HLSL | .hlsl, .fx | lang-hlsl |
| Verilog / SystemVerilog | .v, .vh, .sv, .svh | lang-systemverilog |
| VHDL | .vhd, .vhdl | lang-vhdl |
| Metal | .metal | lang-metal |
| CUDA / HIP | .cu, .cuh | lang-cuda |
| Markdown | .md, .markdown | lang-markdown |
| R | .r, .R | lang-r |
| SQL | .sql | lang-sql |
| Julia | .jl | lang-julia |
| Haskell | .hs, .lhs | lang-haskell |
| OCaml | .ml, .mli | lang-ocaml |
| Clojure | .clj, .cljs, .cljc | lang-clojure |
| Erlang | .erl, .hrl | lang-erlang |
| Elixir | .ex, .exs | lang-elixir |
| F# | .fs, .fsi, .fsx | lang-fsharp |
| F* | .fst, .fsti | lang-fstar |
| Quint | .qnt | lang-quint |
| Terraform | .tf, .tfvars | lang-terraform |
| TOML | .toml | lang-toml |
| Lean | .lean | lang-lean |
| HTML | .html, .htm | lang-html |
| CSS | .css | lang-css |
นอกจากนี้ยังเลือกเพิ่มเฉพาะบางภาษาได้โดยไม่ต้องใช้ระดับเต็ม:
cargo install tokensave --no-default-features --features lang-nix,lang-bash
ตัวดึงข้อมูลทั้งหมดมีความสามารถในระดับเดียวกัน ได้แก่ ฟังก์ชัน คลาส เมธอด ฟิลด์ การนำเข้า กราฟการเรียกใช้ ลำดับการสืบทอด docstring เมตริกความซับซ้อน การดึงข้อมูล decorator/annotation และการติดตามการพึ่งพาข้ามไฟล์
HTML และ CSS เป็นข้อยกเว้น เพราะทั้งสองภาษาไม่มีสัญลักษณ์ที่เรียกใช้ได้ HTML บันทึกองค์ประกอบที่มี id องค์ประกอบแบบกำหนดเอง และสไตล์ชีตกับสคริปต์ที่หน้าเว็บเรียกใช้ ส่วน CSS บันทึกตัวเลือกคลาสและ id, custom properties, ชื่อ @keyframes และ @import ทั้งสองภาษาไม่สามารถแก้ความสัมพันธ์จากแอตทริบิวต์ class="..." ไปยังกฎในสไตล์ชีตได้: ชื่อคลาสเป็นคำทั่วไป และการจับคู่ด้วยชื่อเปล่าทั่วทั้งโปรเจกต์จะสร้างขอบความสัมพันธ์ขึ้นมาเอง แทนที่จะค้นหาความสัมพันธ์ที่มีอยู่จริง
tokensave เทียบกับ CodeGraph
tokensave เป็นการเขียน CodeGraph (Node.js/TypeScript) ใหม่ด้วย Rust ตั้งแต่ต้น ทั้งสองระบบสร้างกราฟโค้ดเชิงความหมายสำหรับเอเจนต์เขียนโค้ด AI แต่มีขอบเขตและความสามารถที่แตกต่างกันอย่างมาก
| tokensave | CodeGraph | |
|---|---|---|
| รันไทม์ | ไบนารีเนทีฟ (Rust) | Node.js 18+ |
| ติดตั้ง | brew install, cargo install, scoop install | npx @colbymchenry/codegraph |
| ภาษา | 50+ (3 ระดับ: lite/medium/full) | 19+ |
| เครื่องมือ MCP | 80+ | 9 |
| การผสานรวมกับเอเจนต์ | 12+ (Claude, Codex, Gemini, Qwen, OpenCode, Cursor, Cline, Copilot, Roo Code, Zed, Antigravity, Kilo, Kiro, Kimi, Vibe, Grok, OMP, Pi, Plank, Factory Droid) | 1 (Claude Code) |
| ความใหม่ของดัชนี | ตรวจสอบความล้าสมัยตามต้องการทุกครั้งที่เรียก MCP; ซิงก์ข้อมูลที่ตกหล่นเมื่อเชื่อมต่อ; คาดว่างานหลายเอเจนต์จะใช้ git worktrees | ตัวเฝ้าดูไฟล์ระดับ OS แบบเนทีฟ (FSEvents/inotify/ReadDirectoryChangesW, debounce 2 วินาที); ซิงก์ข้อมูลที่ตกหล่นเมื่อเชื่อมต่อ |
| การทำดัชนีหลายสาขา | มี เลือกเปิดได้ (ฐานข้อมูลแยกตามสาขา, diff/search ข้ามสาขา) | ไม่มี |
| เมตริกความซับซ้อน | ดึงข้อมูลจาก AST (สาขา, ลูป, ความลึกของการซ้อน, ความซับซ้อนแบบ cyclomatic และ cognitive, Halstead, ดัชนีความสามารถในการบำรุงรักษา, CRAP) | ไม่มี |
| เครื่องมือย้ายโค้ด | มี (port_status, port_order) | ไม่มี |
| ตัวแสดงกราฟ | นำออกแล้ว (v4.0.1) | มี |
| การค้นหาเชิงความหมาย | ขยายคำค้นด้วยเอเจนต์ (ไม่มีค่าใช้จ่าย) | embedding ในเครื่อง (nomic-embed-text-v1.5 ผ่าน ONNX) |
| ทรัพยากร MCP | 4 (สถานะ, ไฟล์, ภาพรวม, สาขา) | ไม่มี |
| คำอธิบายประกอบ MCP | มี (readOnlyHint, alwaysLoad) | ไม่มี |
| การตรวจจับโค้ดที่ไม่ได้ใช้งาน | มี | ไม่มี |
| การตรวจจับการพึ่งพาแบบวนรอบ | มี | ไม่มี |
| ลำดับชั้นประเภท | มี | ไม่มี |
| การวิเคราะห์ God class / coupling | มี | ไม่มี |
| บริบทของ commit / PR | มี | ไม่มี |
| การจับคู่การทดสอบ | มี | ไม่มี |
| ตัวอย่างการเปลี่ยนชื่อ | มี | ไม่มี |
| การติดตามโทเค็น | เมตริกต่อการเรียก, ตัวตรวจสอบ TUI แบบเรียลไทม์, ตัวนับเซสชันและตลอดอายุการใช้งาน | ไม่มี |
| การวิเคราะห์สุขภาพโค้ด | คะแนนรวม, Gini, ความลึกของการพึ่งพา, DSM, ช่องว่างการทดสอบที่ถ่วงน้ำหนักตามความเสี่ยง, ผลต่างของเซสชัน | ไม่มี |
| คำสั่งพื้นฐานสำหรับแก้ไข | ตัวเขียนแบบอะตอม 4 รายการ (str_replace, multi_str_replace, insert_at, ast_grep_rewrite) พร้อมจัดทำดัชนีใหม่อัตโนมัติ | ไม่มี |
| ความทนทานต่อการแครช | แยกการดึงข้อมูลไว้ใน subprocess; หากไวยากรณ์เนทีฟหยุดทำงาน จะข้ามไฟล์นั้นและซิงก์ต่อ | ไม่มี |
| อัปเกรดตัวเอง | tokensave upgrade พร้อมช่อง stable/beta | npm update |
| เอนจินฐานข้อมูล | libsql (fork ของ SQLite, WAL, async) | better-sqlite3 / wa-sqlite (WASM) |
| ความเร็วในการจัดทำดัชนี | ~1.2 วินาทีสำหรับ 1,782 ไฟล์ | ~4 วินาทีสำหรับ 1,782 ไฟล์ |
| ขนาดไบนารี | ดาวน์โหลดแบบบีบอัด ~25 MB (รวม grammar ทั้งหมด) | ~80 MB (node_modules + WASM) |
CodeGraph เป็นผู้บุกเบิกแนวทางนี้ และยังคงเป็นตัวเลือกที่ดีหากคุณต้องการใช้เครื่องมือ npm และต้องการเพียงการผสานรวมกับ Claude Code เท่านั้น tokensave ต่อยอดแนวคิดนี้ด้วยการวิเคราะห์ที่ลึกกว่า รองรับเอเจนต์มากกว่า รองรับหลายสาขา และเป็นไบนารีเนทีฟที่ไม่มีการพึ่งพารันไทม์
ดูการเปรียบเทียบโดยละเอียดกับ CodeGraph, Dual-Graph (GrapeRoot), code-review-graph และ OpenWolf ได้ที่ docs/COMPARABLE-TOOLS.md.
หน้าเปรียบเทียบแบบเคียงข้างกัน (แต่ละหน้าระบุว่าเครื่องมืออีกตัวทำได้ดีกว่าตรงไหน): Serena · code-review-graph · Graphify · CodeGraph · token-savior · GrapeRoot · LeanCTX · OpenWolf — ดัชนีอยู่ที่ tokensave.dev/vs.
เหตุใดจึงเลือก tokensave แทนตัวเลือกอื่น
มีเครื่องมือหลายตัวที่ช่วยลดการใช้โทเค็นของเอเจนต์เขียนโค้ด AI นี่คือเหตุผลที่ทำให้ tokensave โดดเด่น
ไบนารีเนทีฟไฟล์เดียว ไม่มีการพึ่งพา
ตัวเลือกอื่นส่วนใหญ่ต้องใช้รันไทม์ เช่น Python, Node.js หรือทั้งสองอย่าง tokensave มาในรูปไบนารี Rust ไฟล์เดียว ซึ่งรวม grammar ของ tree-sitter มากกว่า 50 รายการไว้แล้ว (ดาวน์โหลดแบบบีบอัด ~25 MB) ไม่ต้องติดตั้งอะไรเพิ่มเติม และต่างจากเครื่องมือที่ใช้ LSP อย่าง Serena ตรงที่ไม่ต้องติดตั้ง เริ่มทำงาน หรือวอร์มอัป language server แยกตามภาษา ปัจจุบันมีเครื่องมืออีกสองตัวที่เทียบเท่า tokensave ในด้านการจัดแพ็กเกจ ได้แก่ CodeGraph ที่รวมรันไทม์ของตัวเองไว้ และ LeanCTX ซึ่งเป็นไบนารี Rust ไฟล์เดียวเช่นกัน
ความเข้าใจโค้ดที่ลึกที่สุด
tokensave ทำงานในระดับสัญลักษณ์ ได้แก่ ฟังก์ชัน, struct, ฟิลด์, เส้นเชื่อมการเรียก, ลำดับชั้นประเภท และเมตริกความซับซ้อน ตัวเลือกอื่นอย่าง Dual-Graph (GrapeRoot) ทำงานในระดับไฟล์ กล่าวคือรู้ว่ามีไฟล์ใดบ้าง แต่ตอบคำถามอย่าง “ฟังก์ชันนี้ถูกเรียกจากที่ไหนบ้าง?” หรือ “ถ้าฉันเปลี่ยน struct นี้ อะไรจะพัง?” ไม่ได้ เครื่องมือ MCP เฉพาะทางกว่า 80 รายการของ tokensave ครอบคลุมการไล่สำรวจกราฟการเรียก การวิเคราะห์ผลกระทบ การตรวจจับโค้ดที่ไม่ได้ใช้งาน การจับคู่การทดสอบ ตัวอย่างการเปลี่ยนชื่อ ลำดับชั้นประเภท การตรวจจับการพึ่งพาแบบวนรอบ การจัดอันดับความซับซ้อน การวิเคราะห์สุขภาพโค้ด (Gini, DSM, ความลึกของการพึ่งพา, ช่องว่างการทดสอบที่ถ่วงน้ำหนักตามความเสี่ยง) คำสั่งพื้นฐานสำหรับแก้ไขแบบอะตอม และอื่น ๆ เครื่องมือกราฟที่ใกล้เคียงที่สุดอย่าง code-review-graph มีเครื่องมือ 30 รายการ ส่วนเครื่องมืออื่น ๆ อีกหลายตัวมีน้อยกว่า 10 รายการโดยตั้งใจ
รองรับเอเจนต์ได้กว้างที่สุด
ผสานรวมกับเอเจนต์เขียนโค้ด AI มากกว่าหนึ่งโหล พร้อมรูปแบบการกำหนดค่าเนทีฟสำหรับแต่ละเอเจนต์ ไม่มีเครื่องมืออื่นที่รองรับเอเจนต์ได้มากเท่านี้พร้อมการผสานรวมที่ลึกเท่านี้ Claude Code ได้รับ hooks, กฎ prompt และสิทธิ์อนุญาตเครื่องมืออัตโนมัติ Kiro ได้รับการกำหนดค่า MCP ระดับ global, tokensave.md steering ที่โหลดเป็นทรัพยากร, managed agent ที่อนุมัติเครื่องมือในตัวและเครื่องมือของ tokensave ได้อย่างยืดหยุ่น และ hooks สำหรับกำกับการมอบหมายงานพร้อมซิงก์หลังเขียน Pi ได้รับการลงทะเบียน MCP พร้อมการเปิดเผยเครื่องมือที่กฎของ Pi ต้องใช้ รวมถึง managed extension สำหรับ guardrail, การรีเซ็ตยอดประหยัด และใบรับรองเซสชัน ส่วนเอเจนต์อื่น ๆ จะได้รับการลงทะเบียนเซิร์ฟเวอร์ MCP ในรูปแบบการกำหนดค่าเนทีฟของตน
การทำดัชนีหลายสาขา
เป็นเครื่องมือเดียวในกลุ่มนี้ที่มีฐานข้อมูลกราฟแยกตามสาขาให้เลือกใช้ พร้อม diff และการค้นหาข้ามสาขา เมื่อเปิดใช้ การสลับสาขาจะเกิดขึ้นทันทีโดยไม่ต้องจัดทำดัชนีใหม่
การติดตามโทเค็นต่อการเรียก
เป็นเครื่องมือเดียวที่รายงานจำนวนโทเค็นที่ประหยัดได้อย่างแม่นยำสำหรับการเรียกเครื่องมือ MCP แต่ละครั้ง พร้อมตัวตรวจสอบ TUI แบบเรียลไทม์สำหรับทุกโปรเจกต์และตัวนับตลอดอายุการใช้งาน
โอเพนซอร์สเต็มรูปแบบ
Rust ภายใต้สัญญาอนุญาต MIT ตรวจสอบได้ตั้งแต่ต้นจนจบ เอนจินหลักของ Dual-Graph (graperoot บน PyPI) เป็นกรรมสิทธิ์ คุณจึงตรวจสอบไม่ได้ว่ามันทำอะไรกับกราฟโค้ดของคุณ OpenWolf ใช้ AGPL-3.0 ซึ่งกำหนดให้ต้องเปิดซอร์สงานดัดแปลง
ประสิทธิภาพ
การทดสอบประสิทธิภาพการจัดทำดัชนีเต็มรูปแบบบนโค้ดเบส Rust/Java/Scala แบบผสมที่มี 1,782 ไฟล์ (57K โหนด, 103K เส้นเชื่อม):
| เครื่องมือ | เวลา | เร็วขึ้น |
|---|---|---|
| CodeGraph (TypeScript) | 31.2 วินาที | 1x |
| tokensave (Rust) | 1.2 วินาที | 26x |
การแก้ไขปัญหา
"tokensave not initialized"
ไม่มีไดเรกทอรี .tokensave/ ในโปรเจกต์ของคุณ
tokensave init
เซิร์ฟเวอร์ MCP ไม่เชื่อมต่อ
เอเจนต์ไม่เห็นเครื่องมือของ tokensave
- ตรวจสอบว่าการกำหนดค่าของเอเจนต์มีเซิร์ฟเวอร์ MCP ของ tokensave (เรียกใช้
tokensave doctor) - รีสตาร์ทเอเจนต์ทั้งหมด
- ตรวจสอบว่า
tokensaveอยู่ใน PATH ของคุณ:which tokensave
ค้นหาแล้วไม่พบสัญลักษณ์
- เรียกใช้
tokensave syncเพื่ออัปเดตดัชนี - ตรวจสอบว่ารองรับภาษานั้น (ดูตารางด้านบน)
- ตรวจสอบว่าไฟล์ไม่ได้ถูกยกเว้นโดย
.gitignore
การจัดทำดัชนีช้า
โปรเจกต์ขนาดใหญ่ใช้เวลานานกว่าในการจัดทำดัชนีเต็มรูปแบบครั้งแรก
- การเรียกใช้ครั้งถัดไปจะใช้การซิงก์แบบเพิ่มทีละส่วน จึงเร็วขึ้นมาก
- ใช้
tokensave sync(ไม่ใช่--force) สำหรับการอัปเดตประจำวัน - ระบบจะตรวจสอบความล้าสมัยโดยอัตโนมัติทุกครั้งที่เรียกเครื่องมือ MCP ขณะเอเจนต์เชื่อมต่ออยู่
ปิดใช้ tokensave สำหรับบางโปรเจกต์
หากโปรเจกต์มีขนาดใหญ่เกินไปและ tokensave ใช้ RAM มากเกินไป คุณสามารถปิดใช้เซิร์ฟเวอร์ MCP เฉพาะโปรเจกต์ได้โดยตั้งค่า TOKENSAVE_DISABLE_SERVER=true ใน environment ของโปรเจกต์ เซิร์ฟเวอร์จะออกจากการทำงานอย่างเรียบร้อยโดยไม่เริ่มต้นระบบ
Claude Code — เพิ่มลงใน .claude/settings.json ของโปรเจกต์:
{
  "mcpServers": {
    "tokensave": {
      "command": "tokensave",
      "args": ["serve"],
      "env": {
        "TOKENSAVE_DISABLE_SERVER": "true"
      }
    }
  }
}
เอเจนต์อื่น ๆ — ตั้งค่าตัวแปร environment ในไฟล์กำหนดค่าที่เอเจนต์ใช้เปิดเซิร์ฟเวอร์ MCP
คุณยังตั้งค่าตัวแปรนี้แบบ global ผ่าน shell ได้ (TOKENSAVE_DISABLE_SERVER=true claude) แต่จะปิดใช้เซิร์ฟเวอร์ MCP ของ tokensave สำหรับทุกโปรเจกต์ในเซสชัน
ยังรองรับ DISABLE_TOKENSAVE=true ในฐานะ alias เพื่อความเข้ากันได้แบบเลิกใช้แล้ว สำหรับการกำหนดค่าที่สร้างก่อนตั้งชื่อตัวแปรนี้ให้มี namespace
ที่มา
โปรเจกต์นี้เป็นการพอร์ต CodeGraph ฉบับ TypeScript ดั้งเดิมโดย @colbymchenry มาเป็น Rust การพอร์ตนี้คงสถาปัตยกรรมและอินเทอร์เฟซเครื่องมือ MCP เดิมไว้ พร้อมใช้ประโยชน์จาก Rust เพื่อเพิ่มประสิทธิภาพและใช้ tree-sitter bindings แบบเนทีฟ
การสร้าง
cargo build --locked --release                          # full (50+ languages, default)
cargo build --locked --release --features medium        # medium tier
cargo build --locked --release --no-default-features    # lite (smallest binary)

cargo test --workspace --locked                         # run all tests (requires full)
cargo check --locked --no-default-features              # verify lite compiles
cargo clippy --workspace --all-targets --locked
คำสั่งสำหรับพัฒนาใช้ debug builds ส่วนการติดตั้งใช้เฉพาะผลลัพธ์ release ที่ปรับประสิทธิภาพแล้ว
(cargo install --path . --locked) โดย target/debug จะไม่ถูกใช้เป็นอินพุตสำหรับการติดตั้ง
ประวัติดาว

ผู้สนับสนุน
| การลงนามโค้ดบน Windows ฟรี สนับสนุนโดย SignPath.io ใบรับรองโดย SignPath Foundation |
สัญญาอนุญาต
สัญญาอนุญาต MIT — ดูรายละเอียดที่ LICENSE.