Myco Brain
Servidor MCP de memória e grafo de conhecimento auto-hospedado para agentes de IA. TypeScript em Postgres 16 + pgvector, 11 ferramentas brain_*. Funciona sem chaves: busca textual e semântica, ingestão, deduplicação por hash de conteúdo, proveniência via brain_why, e o grafo de conhecimento operam sem chaves de API via Ollama local. Apache-2.0.
Documentação

Memória persistente e rastreável até a fonte para agentes de IA — auto-hospedada no seu próprio Postgres, sem necessidade de chaves de API para executar.




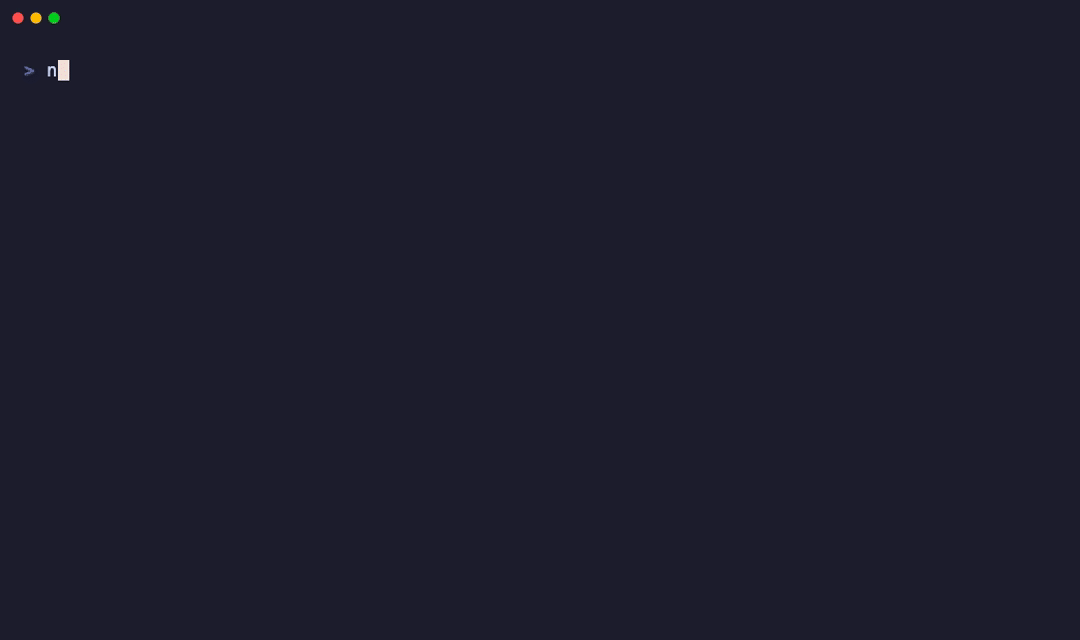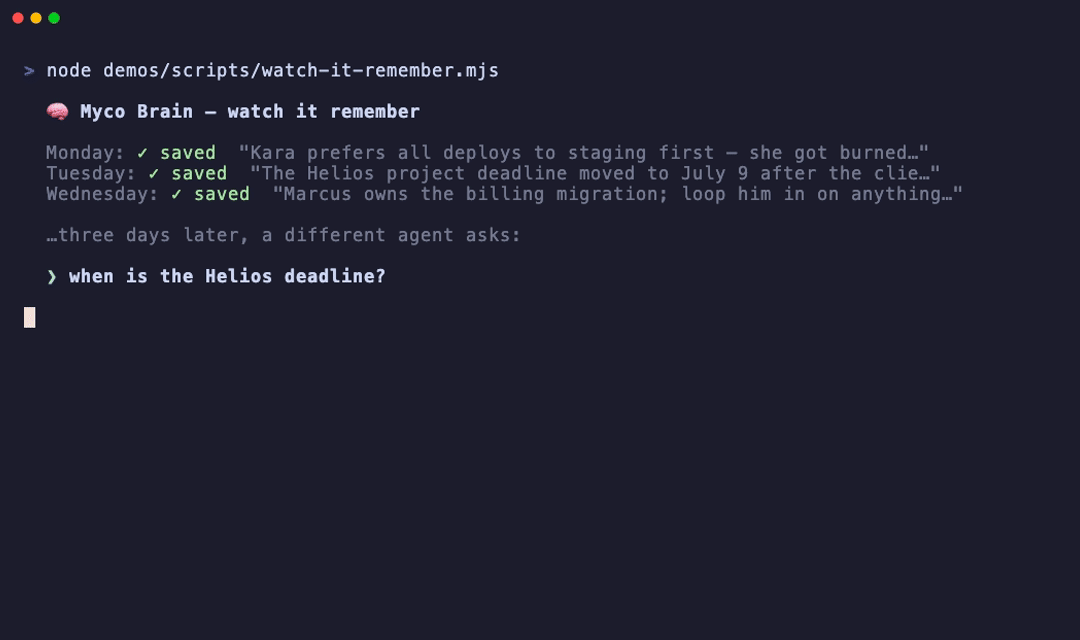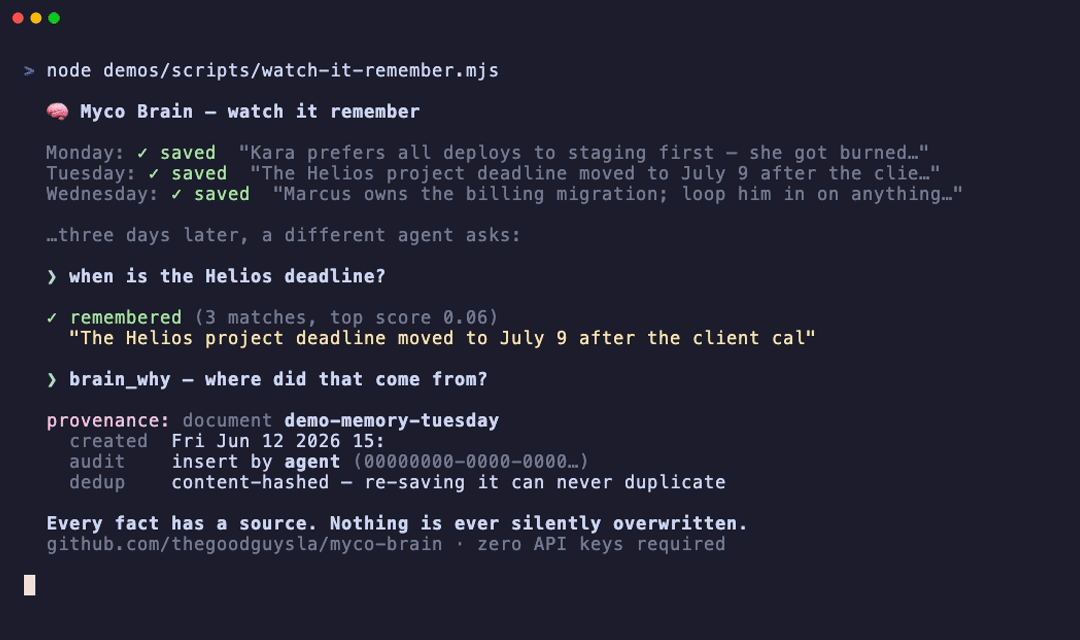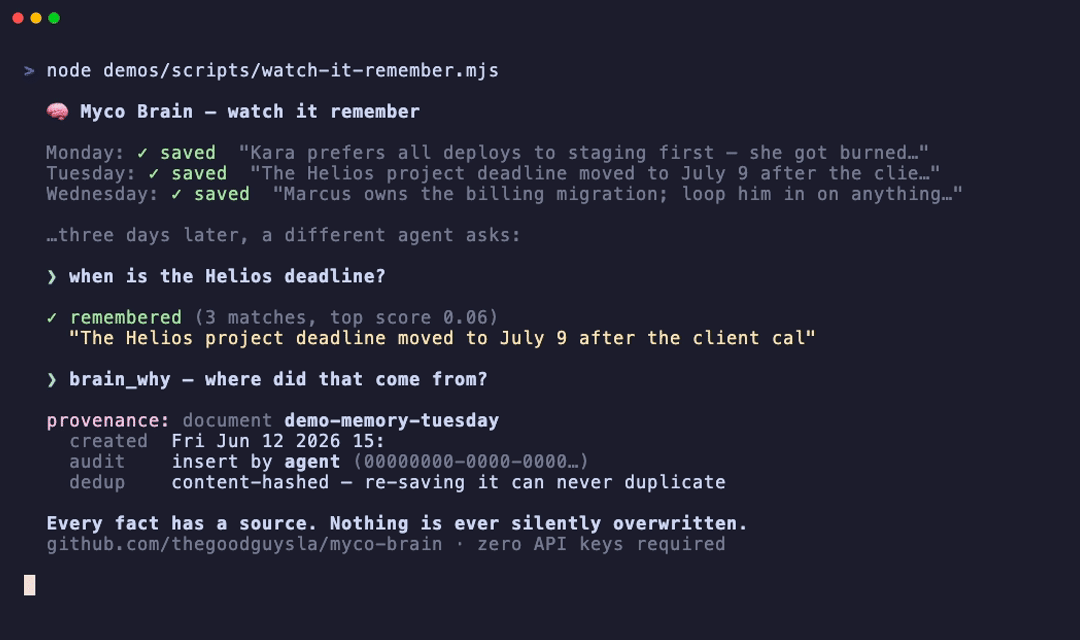
- Rastreável até a fonte. Cada fato remete ao documento de onde veio (
brain_why) — nada de resumos "confie em mim". - Confiança que se acumula. Corroboração independente aumenta a confiança de um fato; uma contradição o substitui — mantida e auditada, nunca sobrescrita silenciosamente.
- Sem chaves e local-first. Busca de texto completo + semântica e o grafo de conhecimento rodam sem nenhuma dependência hospedada — adicione uma chave Anthropic apenas para o grafo mais preciso.
- Seu. Apache-2.0, tabelas Postgres simples, 13 ferramentas MCP. Funciona com Claude, Cursor, Windsurf, Continue, Zed.
Para quem é: times de dev que rodam agentes precisando de uma memória compartilhada · agências que precisam de isolamento rígido por cliente · qualquer pessoa que queira que seu assistente lembre entre sessões — importe seu histórico do ChatGPT / Claude (do seu export de dados) e sua IA te conhece desde o primeiro dia.
Construído solo por um growth marketer — não um engenheiro de carreira — dirigindo agentes de codificação de IA por ~3 meses. Como foi construído ↓
A correção usual para a amnésia de agentes — deixar um LLM manter sua própria memória — a enche de duplicatas, resumos alucinados e respostas confiantes que ninguém consegue rastrear. Myco Brain é construído sobre o contrato oposto:
O LLM propõe. Regras determinísticas decidem o que vira fato. Você define o nível — desde auto-promoção com gate de corroboração (o padrão) até revisão humana estrita de cada fato (
BRAIN_REQUIRE_HUMAN_REVIEW=1).
Claude, Cursor, Windsurf, Continue, Zed e agentes customizados compartilham uma única memória respaldada pelo seu próprio Postgres.
⭐ Se o modelo de confiança ressoar, uma estrela ajuda outros a encontrá-lo.
# 1. Boot the stack (Postgres + MCP server + extraction worker)
git clone https://github.com/thegoodguysla/myco-brain.git && cd myco-brain
docker compose up -d

# 2. Give your agent a memory — point it at any repo or folder
#    (no env needed: it finds the quickstart stack on localhost)
npx -y -p @mycobrain/mcp-server mycobrain-ingest github:your-org/your-repo

# 3. Connect your client (one-liner below), then ask across sessions:
#    "what did we decide about auth, and where is that documented?"
#    → answered from your docs, with the source cited.
[!TIP] Zero chaves de API, até o fim. Busca de texto completo, busca semântica (embeddings locais) e o grafo de conhecimento (extração local) rodam sem nenhuma dependência hospedada. Adicione uma chave Anthropic apenas se quiser o grafo mais preciso.
MCP-nativo por design — seu agente sabe quando usar memória, não apenas como.
A maioria dos servidores MCP expõe ferramentas e espera que o modelo as chame. Myco entrega um contrato
de uso sobre o canal instructions do MCP: no momento em que conecta, seu agente
sabe puxar contexto antes de uma tarefa, salvar decisões duráveis e citar fontes
com brain_why — sem prompting por projeto. Ajuste a política em um bloco copy-paste:
Ensine seu agente a usar bem.
Links rápidos: Quickstart de 10 minutos · Ensine seu agente a usar bem · O motor de confiança · Benchmark — rode você mesmo · Rode todas as provas · Para quem é · Variáveis de ambiente · Arquitetura · Roadmap · Lista de espera cloud
Memória que fica mais confiável (confiança composta)
A maioria das memórias de agente sobrescreve fatos silenciosamente. Myco Brain compõe:
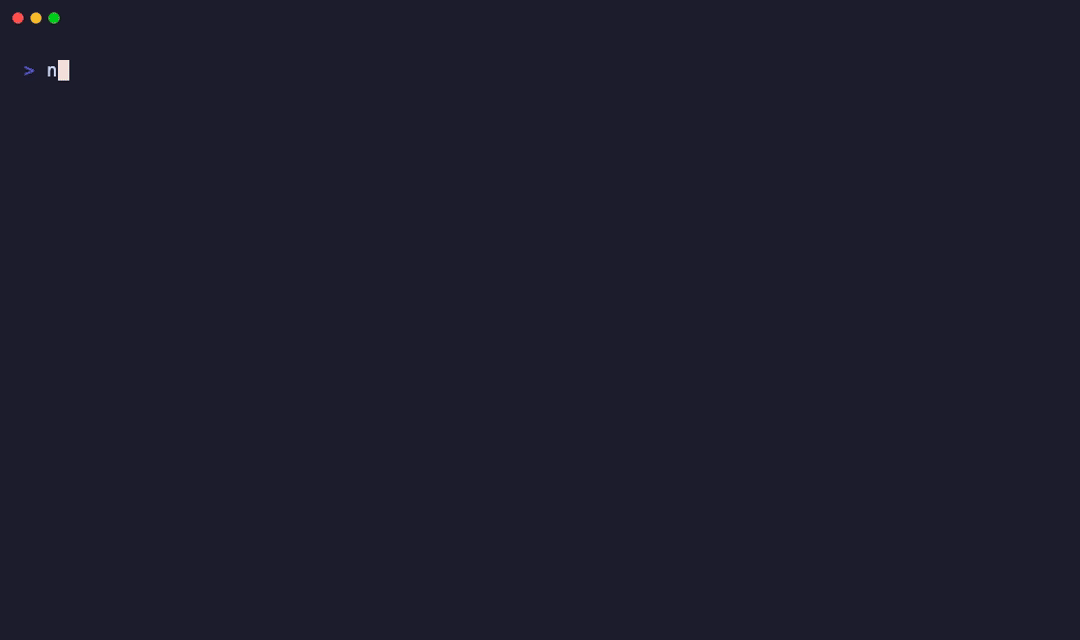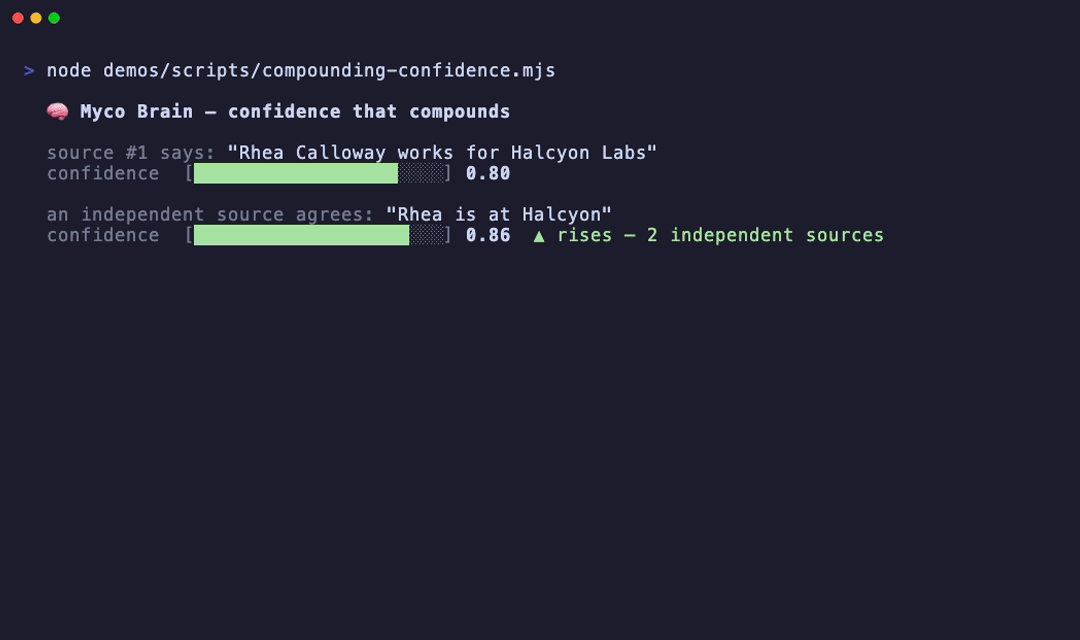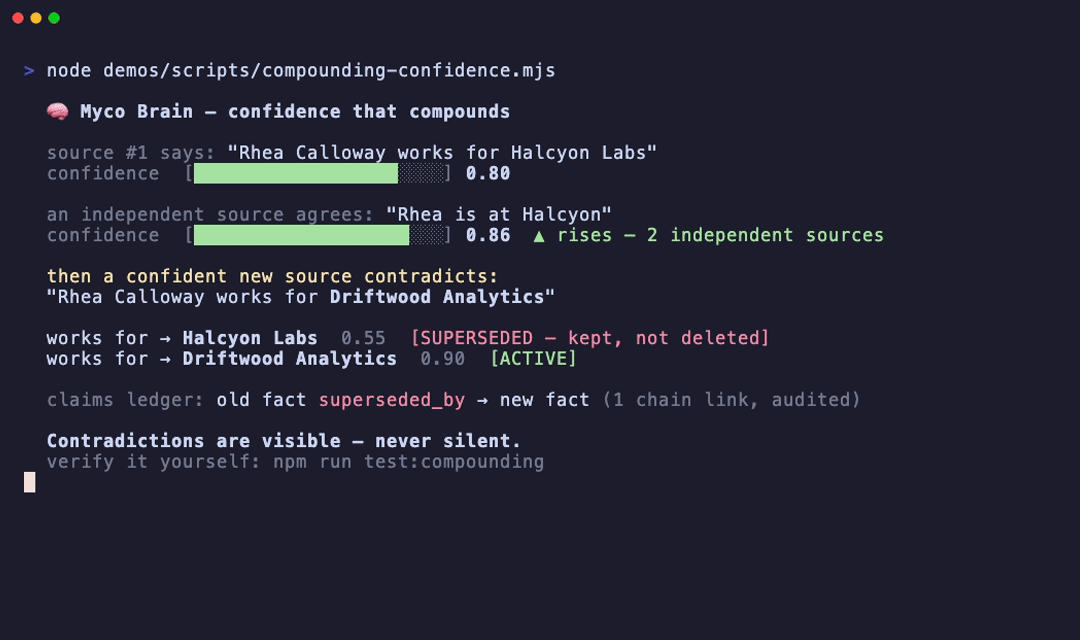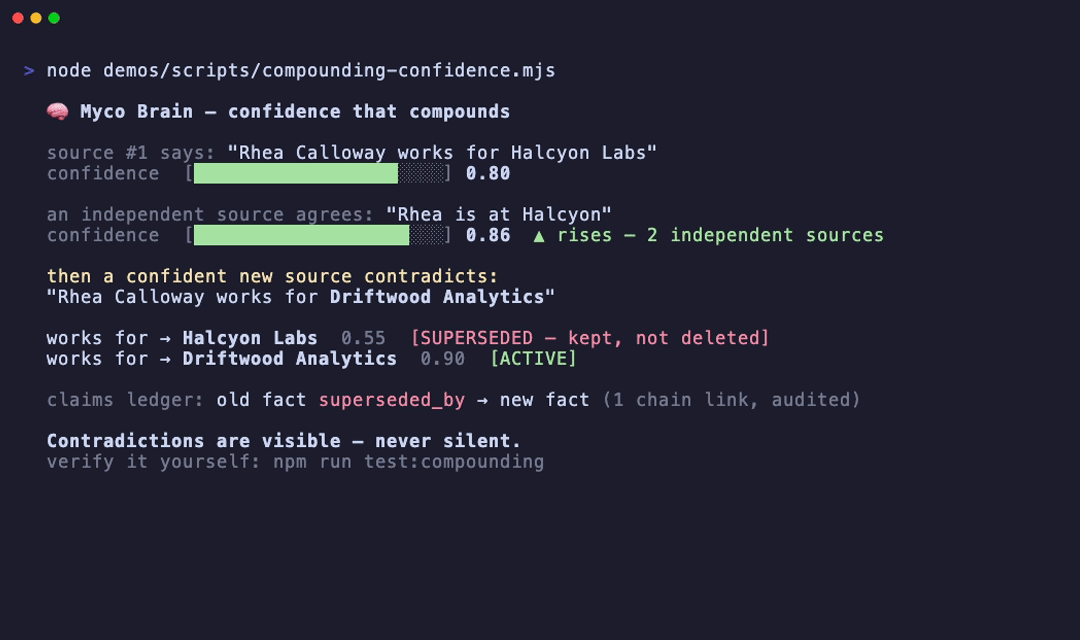
- Uma fonte independente concordando com um fato aumenta sua confiança (noisy-OR amortecido — dez chunks de um mesmo documento não corroboram nada; apenas fontes distintas contam).
- Uma contradição confiante em um relacionamento de valor único (para quem você trabalha, onde algo está localizado) substitui o fato antigo: ele é fechado e enfraquecido — mantido, nunca deletado — com a substituição registrada em um ledger de claims auditado.
- Pergunte a
brain_whysobre qualquer fato e você obtém sua contagem distinta de fontes (por relacionamento, não por menção), sua tendência de confiança ao longo do tempo ("0.8 → 0.86"), e qualquer histórico substituído. Contradições permanecem visíveis. Sua memória não pode te gaslight.
works for → Halcyon Labs           0.55  [SUPERSEDED — kept, not deleted]
works for → Driftwood Analytics    0.90  [ACTIVE]
claims ledger: old fact superseded_by → new fact (audited)
Prova: npm run test:compounding — o ciclo de vida completo roda contra um banco
de dados real em segundos, sem necessidade de LLM.
O schema evolui com seus dados (schema dinâmico)
- O worker de extração percebe tipos de entidade e relacionamentos que seu catálogo
ainda não tem e os propõe (
brain_stats: "Brain propôs 3 novos tipos a partir dos seus dados"). - A promoção é sua por padrão — ou opte pela auto-promoção para tipos
corroborados por documentos-fonte distintos suficientes
(
BRAIN_SCHEMA_AUTO_PROMOTE=1), contados por documento, não por menção, então dois documentos passados de um lado para o outro não podem fabricar consenso. Um único documento tagarela nunca pode promover nada. - Um tipo promovido permanece escopado ao workspace que o conquistou — o vocabulário de um cliente nunca vaza para o catálogo de outro (veja isolamento por cliente).
Provas: npm run test:dynamic-schema, npm run test:schema-promotion.
Você escolhe o dial de confiança:
| Modo | Comportamento |
|---|---|
| Padrão | Fatos confiantes auto-promovem; tipos novos aguardam revisão |
BRAIN_REQUIRE_HUMAN_REVIEW=1 | Curadoria estrita — nada que o LLM propõe toca o grafo canônico sem uma decisão humana |
BRAIN_SCHEMA_AUTO_PROMOTE=1 | Novos tipos corroborados se promovem, auditados |
Quando algo está esperando por você — tipos novos no modo padrão, ou tudo no modo estrito — revise pela linha de comando:
mycobrain review                 # list pending entities, relationships, types
mycobrain review approve <id>    # promote it into the graph
mycobrain review reject  <id>    # reject it (kept and audited, never deleted)
Prova: npm run test:review — aprovar realmente coloca a entidade / aresta /
tipo no grafo canônico; rejeitar nunca coloca.
Memórias privadas, conhecimento compartilhado
Times multi-agente têm isolamento real: documentos marcados como private são legíveis
apenas pelo agente que os criou — aplicado em toda ferramenta de leitura, em cima
da segurança em nível de linha do workspace. A memória do workspace permanece compartilhada. Prova:
npm run test:sharing (uma matriz de visibilidade de dois agentes). Como o isolamento
de workspace, ele só se aplica sob o papel brain_app de menor privilégio
(nota de segurança).
Um workspace isolado por cliente — feito para agências
Coloque cada cliente em seu próprio workspace, compartilhe um playbook de agência, e
a garantia que você vende é segurança em nível de linha do Postgres — uma sessão escopada
ao Cliente A não pode retornar linhas do Cliente B. O
kit inicial para agências provisiona isso (um comando) e entrega
o papel de banco de menor privilégio que faz o isolamento realmente valer. Prova:
npm run test:agency — o Cliente A vê zero fatos do Cliente B.
[!IMPORTANT] O isolamento só se aplica sob o papel de menor privilégio. RLS não restringe um superusuário do Postgres, e o papel
brainpadrão do quickstart zero-config é um superusuário (ok para um self-host de workspace único — não há nada para isolar). Antes de colocar mais de um cliente em um banco, rode o app como o papelNOSUPERUSERbrain_appque o kit de agência entrega;mycobrain-doctorsinaliza uma conexão de superusuário. Isolamento multi-tenant é uma garantia debrain_app, não do papel padrão do quickstart.
Avançado — gateways multi-tenant: quem é o chamador? (BRAIN_TRUST_REQUEST_IDENTITY)
RLS decide quais linhas um tenant pode ler; esta configuração decide qual tenant uma
requisição é — o passo antes do RLS. No servidor stdio, a identidade é obtida
apenas do ambiente do servidor por padrão: um workspace_id, agent_id,
ou api_key fornecido nos argumentos da chamada de ferramenta é ignorado, então até
um agente com prompt injection não pode passar workspace_id: "<someone-else>" para alcançar
outro workspace. (Para chaves brain_, a identidade vem da string da chave e
nada mais.)
Defina BRAIN_TRUST_REQUEST_IDENTITY=1 apenas quando você colocar o servidor atrás de um
gateway multi-tenant real que autentica cada requisição e mapeia para um
tenant ele mesmo — então a identidade por requisição é honrada (e um JWT de service-role
deve ser igual a BRAIN_SERVICE_ROLE_KEY, não apenas parecer um). Self-hosts
single-tenant não precisam de nada disso — sua identidade já é derivada do ambiente.
Consulta via HTTP (somente leitura)
Nem tudo fala MCP. Para um app web, uma automação ou um backend parceiro,
mycobrain-rest coloca uma pequena API somente leitura na frente do cérebro — exatamente duas
ferramentas, search e why, além de health:
mycobrain-rest                                  # → http://127.0.0.1:8787

curl -s localhost:8787/search \
  -H "Authorization: Bearer brain_<ws>_<agent>_<secret>" \
  -d '{"query":"what did we decide about pricing?","limit":5}'
- Escopo: a chave escopa cada consulta ao seu workspace (mesmo RLS do MCP), e
não há rotas de escrita. Como no MCP, isso só se aplica sob o papel
brain_appde menor privilégio (nota de segurança) — nunca exponha REST como o superusuáriobrainpadrão (mycobrain-doctorsinaliza). - Verificação de chave: instalações migradas para
…_agent_api_key_verification.sqlverificam o<secret>de cada chave contraagent_api_keysuma vez que um segredo é registrado (registre/rotacione viabrain_set_agent_api_key_secret(...)). Até lá, a chave age como um bearer token; definaBRAIN_REQUIRE_API_KEY_SECRET=1para exigir um segredo registrado antes de expor REST. - Binding: loopback por padrão — defina
BRAIN_REST_HOST=0.0.0.0atrás do seu próprio TLS/proxy apenas quando quiser expor, e trate a chave como senha.
Prova: npm run test:rest.
Cinco Demos Verificadas
1. Recall entre sessões
Salve um fato em uma conversa:
Save a memory: the board meeting is every Wednesday at 9 AM Pacific.
Inicie uma conversa nova e pergunte:
What time is the board meeting?
Resultado esperado: a nova sessão recupera o fato armazenado em vez de depender do histórico do chat.
2. Memória compartilhada entre agentes
Escreva de um cliente:
Save a memory: Acme's renewal call is on October 15 with Jordan.
Leia de outro cliente:
What is Acme's renewal date?
Resultado esperado: ambos os clientes leem a mesma memória compartilhada porque a fonte da verdade é o Postgres, não um único thread de chat.
3. Proveniência para respostas
Pergunte a brain_why sobre qualquer fato e obtenha a cadeia de fontes — não um resumo "confie em mim".
Saída real para uma entidade construída a partir do corpus de demo:
{
  "subject": { "kind": "entity", "name": "Mara Quinn" },
  "evidence": {
    "mention_count": 4,
    "source_document_count": 4,
    "summary": "Supported by 4 mentions across 4 source documents."
  },
  "source_proposals": [
    { "extracted_by": "ollama:llama3.2:3b", "confidence": 1, "state": "auto_promoted",
      "source_hyobject_id": "8e31414c-…" }
  ]
}
Cada fato aceito remete ao(s) documento(s) de onde veio e como foi extraído.
4. Ingestão de documentos com fontes
Ingira um arquivo ou URL:
Ingest ./docs/customer-handbook.pdf and summarize the onboarding checklist with sources.
Resultado esperado: o documento é chunked, indexado e citado de volta via retrieval.
5. Relacionamentos no grafo
Pergunte:
Show related entities for Acme and explain how they connect.
Resultado esperado: consultas de relacionamento trazem pessoas, documentos e entidades conectadas — e as arestas entidade-para-entidade que o worker de extração constrói (ex.: Mara Quinn —gerencia→ Northwind Coffee) — em vez de matches vetoriais planos. Construa esse grafo localmente com Ollama, sem chave de API.
Todas as demos são código, não gravações de tela —
demos/as re-renderiza deterministicamente contra uma stack nova (npm run demo:render -- all).
Como Myco se compara
Ferramentas diferentes fazem tradeoffs diferentes; isto compara abordagens arquiteturais, não head-to-heads com benchmark — quando o recall de retrieval é alto, o modelo de resposta vira o gargalo, então comparações de score entre sistemas enganam (veja a seção de benchmark).
| Memória típica mantida por LLM | Memória de framework (ex.: LangChain) | Myco Brain | |
|---|---|---|---|
| Benchmark reproduzível | Autorrelatado | — | Harness incluso no repositório — reproduza o número você mesmo |
| Extração de fatos | Baseada em LLM | Baseada em LLM | Caminho de escrita determinístico; a saída do LLM entra apenas via filas de propostas com gate |
| Fatos contraditórios | Coexistem como registros independentes | Possível | Substituído, nunca sobrescrito — livro-razão de alegações auditado |
| Confiança do fato | Estática | — | Acumula com evidências independentes, cai em contradição |
| Fatos alucinados | Possível | Possível | Restringido fora do caminho de escrita |
| Proveniência | Parcial | Parcial | Primeira classe via brain_why (fonte + trilha de auditoria + tendência de confiança) |
| Memória compartilhada | Depende da configuração do app | Depende da configuração do app | Fonte de verdade nativa em Postgres, multi-agente com privacidade por objeto |
| Portabilidade de dados | Moldada por fornecedor / framework | Moldada por framework | Tabelas Postgres simples |
Comece em menos de 10 minutos
Caminho local verificado: Docker Compose a partir de um clone limpo.
git clone https://github.com/thegoodguysla/myco-brain.git
cd myco-brain
docker compose up -d
O que inicia:
- Postgres 16 + pgvector
- Servidor MCP
- Worker de extração
Nenhuma chave de API é necessária para iniciar — aqui está o que cada capacidade precisa:
| Capacidade | Funciona de imediato? | Para habilitar |
|---|---|---|
| Busca de texto completo (BM25) | ✅ imediatamente | nada |
| Busca semântica | precisa de embeddings | BRAIN_EMBED_PROVIDER=ollama (local, sem chave) |
| Grafo de conhecimento | precisa de um extrator | Ollama localmente (sem chave) ou BRAIN_ANTHROPIC_API_KEY (mais preciso) |
Confirme que está saudável com um comando. mycobrain-doctor não apenas verifica se
as variáveis de ambiente estão definidas — para o caminho local com Ollama, ele verifica ao vivo a configuração (pinga o
Ollama, confirma que os modelos de embed/extração estão baixados e executa um embed + geração reais), depois verifica o backlog de extração e a fila de revisão. Ele sai
com código não-zero apenas em uma falha real (uma linha vermelha), então verde significa que funciona:
npx -y -p @mycobrain/mcp-server mycobrain-doctor
Adicione --fix para que ele se ofereça para baixar quaisquer modelos Ollama ausentes para você:
npx -y -p @mycobrain/mcp-server mycobrain-doctor --fix
Conecte seu cliente
Recomendado — configuração guiada. Um comando orienta você na conexão de um agente, com consentimento em cada etapa:
npx -y -p @mycobrain/mcp-server mycobrain-setup
Ele executa verificações pré-voo (cada uma com uma correção oferecida), verifica pgvector e uma
escrita real no seu banco de dados, conecta seu cliente MCP (Claude Code, Claude
Desktop, Cursor, Codex, Windsurf) e oferece uma importação com um toque do seu
export de dados do ChatGPT ou Claude se o zip já estiver em ~/Downloads. Cada cliente
conectado recebe sua própria identidade de agente, então lembranças posteriores mostram de qual ferramenta uma memória
veio. Prefere fazer você mesmo? Os caminhos manuais estão abaixo.
Claude Code — manualmente (usa as credenciais públicas de dev local semeadas pela stack de quickstart):
claude mcp add myco-brain \
  --env DATABASE_URL=postgresql://brain:brain@localhost:5432/brain \
  --env BRAIN_API_KEY=brain_00000000-0000-0000-0000-000000000001_00000000-0000-0000-0000-0000000000a1_localdev \
  -- npx -y @mycobrain/mcp-server
Reinicie o Claude Code e as ferramentas brain_* estarão ativas — o servidor entrega a cada
agente conectado seu contrato de uso automaticamente (quando lembrar, salvar e
citar), então funciona bem de imediato.
Claude Desktop — adicione isto a
~/Library/Application Support/Claude/claude_desktop_config.json
(Cursor e Windsurf aceitam o mesmo bloco mcpServers em
.cursor/mcp.json / suas configurações MCP):
{
  "mcpServers": {
    "myco-brain": {
      "command": "npx",
      "args": ["-y", "@mycobrain/mcp-server"],
      "env": {
        "DATABASE_URL": "postgresql://brain:brain@localhost:5432/brain",
        "BRAIN_WORKSPACE_ID": "00000000-0000-0000-0000-000000000001",
        "BRAIN_API_KEY": "brain_00000000-0000-0000-0000-000000000001_00000000-0000-0000-0000-0000000000a1_localdev"
      }
    }
  }
}
Nota:
BRAIN_WORKSPACE_IDé derivado da sua chave de APIbrain_, então é opcional — o one-liner do Claude Code acima o omite e funciona da mesma forma.
Depois teste o caminho feliz:
Save a memory: the launch checklist lives in the ops folder.
Abra uma nova sessão e pergunte:
Where does the launch checklist live?
Guia de configuração completo: docs/quickstart.md
Primeira execução — o caminho mais rápido para o seu momento mágico
Myco vem vazio. O "uau" impacta mais nos seus próprios dados, então o primeiro passo recomendado é trazer seu histórico:
# Guided getting-started — leads with importing your own history
npx -y -p @mycobrain/mcp-server mycobrain-onboard
# Import your ChatGPT or Claude export (~30s), then ask your agent about your past
mycobrain-ingest --from chatgpt-export ~/Downloads/<your-export>.zip
mycobrain-ingest --from claude-export  ~/Downloads/<your-export>.zip
#   → "what did I decide about <topic>?" answered from your own conversations.
Prefere pular? Apenas comece a usar — o Brain lembra enquanto você trabalha. Ou faça um tour ao vivo de 60 segundos com dados de exemplo que se limpam sozinhos (seu espaço de trabalho fica intocado):
mycobrain-onboard --tour
Veja funcionar com o corpus de demonstração (sandbox opcional)
Quer um exemplo guiado mais rico? Carregue o corpus de demonstração incluído — um pequeno conjunto de documentos interconectados para uma agência fictícia e seu cliente:
npx -y -p @mycobrain/mcp-server mycobrain-ingest ./examples/demo-corpus
Depois pergunte a qualquer agente conectado:
- "Quando o rebranding da Northwind lança, e quem é o responsável pela conta?"
- "Qual modelo de precificação escolhemos para a Northwind, e por quê?"
- "Mostre a fonte disso." — proveniência via
brain_why - "Mostre minhas estatísticas de memória Myco." — snapshot de saúde via
brain_stats
Cada resposta rastreia até o documento de onde veio. Nenhuma chave de API necessária.
O final: o corpus contém uma contradição deliberada — um documento diz que Devin Osei trabalha para a Lumen, um posterior diz que ele saiu para a Harbor & Co. Com o grafo local sem chave em execução, pergunte:
- "Para quem Devin Osei trabalha? O que mudou, e como você sabe?"
O fato antigo volta substituído — mantido, não deletado — com ambos os documentos citados. Esse é o motor de confiança trabalhando nos seus dados, não um script de demonstração.
Terminou de explorar? Limpe apenas os dados de exemplo incluídos (suas próprias importações e memórias nunca são tocadas) com:
mycobrain-onboard --reset-demo
Ingestão em massa de uma pasta ou repositório
Aponte o Brain para um diretório ou um repositório GitHub e ele indexa cada arquivo de texto — pesquisável entre sessões, com cada resposta rastreável até seu arquivo de origem.
npx -y -p @mycobrain/mcp-server mycobrain-ingest ./docs        # a local folder
npx -y -p @mycobrain/mcp-server mycobrain-ingest github:owner/repo   # a GitHub repo
Nenhuma env necessária contra a stack de quickstart — a CLI usa os padrões dela. Para seu
próprio Postgres ou espaço de trabalho, defina as mesmas variáveis de ambiente que o servidor MCP usa
(DATABASE_URL, BRAIN_WORKSPACE_ID, BRAIN_API_KEY).
Depois pergunte a qualquer agente conectado: "pesquise meus arquivos ingeridos pelo fluxo de auth" ou
"mostre minhas estatísticas de memória Myco". Defina GITHUB_TOKEN para repositórios privados.
Construa o grafo de conhecimento — localmente, sem chaves de API
O que separa o Myco de um vector store é o grafo. O worker de extração lê seus documentos ingeridos e:
- extrai as entidades — pessoas, empresas, projetos, lugares;
- colapsa duplicatas para que "Priya" e "Priya Raman" virem um único nó;
- conecta-os com relacionamentos direcionados — Mara Quinn —trabalha para→ Northwind Coffee, nunca o inverso (o prompt enviado é ciente de direção, e endpoints que o modelo esquece de listar são recuperados automaticamente);
- e propõe novos tipos que observa, então o esquema cresce com seu domínio.
Você escolhe qual modelo faz a extração. Nada sai da sua máquina com Ollama; a Anthropic produz o grafo mais preciso.
Duas medidas de qualidade distintas, frequentemente confundidas, no fixture dourado de 14 arestas
(prova: npm run test:direction):
| Métrica | O que mede | Pontuação |
|---|---|---|
| Precisão direcional | arestas apontam na direção certa | 86% (12/14, llama3.2:3b) |
| Sobrevivência de arestas | endpoints recuperados, não descartados | ~80% (11–12/14, gate ≥75%) |
Opção A — Local e gratuito (Ollama, sem chave de API)
# Install Ollama (https://ollama.com/download), then pull a model:
ollama pull llama3.2:3b

# Point the worker at it and restart:
echo "BRAIN_OLLAMA_BASE_URL=http://host.docker.internal:11434" >> .env
docker compose up -d
Opção B — Mais preciso (Anthropic, traga sua chave)
echo "BRAIN_ANTHROPIC_API_KEY=sk-ant-..." >> .env
docker compose up -d
Se ambos estiverem configurados, a Anthropic é usada automaticamente (é mais precisa);
force uma escolha com BRAIN_EXTRACTION_PROVIDER=ollama|anthropic.
Experimente
Ingira alguns documentos, dê um momento ao worker, depois pergunte a um agente conectado:
- "Quais entidades estão nos meus documentos Northwind?" —
brain_neighbors - "Como Mara Quinn se conecta à Northwind?" — relacionamentos entidade-para-entidade
- "Mostre minhas estatísticas de memória Myco." — veja o grafo crescer (
brain_stats)
De qualquer forma, o grafo canônico vive no seu Postgres — o modelo apenas propõe; o banco de dados decide o que se torna um fato durável.
Benchmark — execute você mesmo
O ponto aqui é reprodutibilidade, não uma pontuação única — o harness LongMemEval está incluído neste repositório, então você executa os números você mesmo; nós não os afirmamos.
| Métrica | Subconjunto (500q) | Config | Pontuação |
|---|---|---|---|
| QA ponta a ponta | oracle | leitor gpt-4o-mini · juiz gpt-4o | 73.6% |
| QA ponta a ponta | oracle | leitor forte (gpt-4o) | 71.8% |
Recall de evidência@5 (Ev@5) | longmemeval_s | híbrido (vector + BM25) | 89.2% |
Recall de evidência@5 (Ev@5) | longmemeval_s | reranker de recência sem chave | 91.6% |
| Recall de evidência@10 | longmemeval_s | híbrido → recência | 90.2% → 93.2% |
QA ponta a ponta usa o subconjunto oracle, que entrega ao leitor apenas as sessões de evidência douradas
— então isola raciocínio, não recuperação (isso é Ev@5,
abaixo). A config de leitor forte pontua menor (gpt-4o, 71.8%): com a evidência
já em contexto, a camada de memória está saturada, então o leitor não é a restrição
limitante — exatamente por que comparações de manchete única entre sistemas enganam.
Números que outros citam na faixa de ~90% são tipicamente um subconjunto, leitor
e juiz diferentes; não estamos reivindicando uma vitória direta, apenas entregando o harness para
pontuar qualquer sistema no mesmo pé.
cd evals/longmemeval && python3 -m venv .venv && .venv/bin/pip install -r requirements.txt && cd ../..
OPENAI_API_KEY=sk-... DATABASE_URL=postgresql://brain:brain@localhost:5432/brain \
  evals/longmemeval/.venv/bin/python3 -m evals.longmemeval.run \
  --examples 500 --subset longmemeval_oracle --judge-model gpt-4o
Qualidade de recuperação (Ev@5 na tabela) é a métrica de recuperação real — o
subconjunto oracle acima não a testa — medida no subconjunto completo longmemeval_s
com distratores. O reranker de recência (brain_search(reranker: 'recency')) é determinístico: sem chave de API, sem chamada de rede. Recuperação híbrida precisa
de um provedor de embeddings (sem chave via Ollama local, ou OpenAI); busca somente BM25
pontua menor. Reproduza (apenas embeddings, sem juiz):
python -m evals.longmemeval.run --subset longmemeval_s -n 500 --no-qa.
Metodologia, ambas as configs, detalhamento por categoria (incluindo as categorias que são difíceis para nós — relatadas, não escondidas) e comandos de amostra mais baratos: evals/longmemeval/README.md.
Cada afirmação tem uma verificação
Nada nesta página pede sua confiança — cada capacidade nomeia a prova executável
que a gateia no desenvolvimento. (Execute as verificações npm run e node test/
de mcp-server/ após npm install; os caminhos node examples/ e evals/ são
relativos à raiz do repositório.)
| Afirmação | Verificação |
|---|---|
| Quickstart funciona ponta a ponta | node test/quickstart-e2e.mjs (também roda em CI contra a stack Docker real) |
| Duplicatas não podem acontecer; proveniência é total | node examples/benchmark/run.mjs |
| Busca semântica sem chave encontra significado, não palavras | npm run test:local-embeddings |
| Relacionamentos são cientes de direção; arestas sobrevivem | npm run test:direction |
| Confiança aumenta com evidência, contradição substitui | npm run test:compounding |
| Novos tipos são propostos (e auto-promovem apenas quando corroborados + opt-in) | npm run test:dynamic-schema · npm run test:schema-promotion |
| Modo de curadoria estrita bloqueia toda auto-promoção | npm run test:strict-mode |
| Documentos privados são privados | npm run test:sharing |
| Todas as 13 ferramentas cabem no seu contexto (~2.5K tokens, não inchaço) | npm run audit:tokens |
| Agência: Cliente A não pode ler Cliente B (RLS de workspace) | npm run test:agency |
| Revisar uma proposta realmente promove/rejeita | npm run test:review |
| API REST somente leitura: auth, somente leitura, limitada contra DoS | npm run test:rest |
| O número do benchmark | evals/longmemeval/ (harness completo no repositório) |
Para quem é
Myco é a camada de memória para qualquer equipe cujos agentes de IA precisam lembrar, com comprovantes. Cada página abaixo a reformula para seu público e percorre os mesmos casos de uso em indústrias (FinTech, Saúde, Jurídico, Contabilidade, Seguros, SaaS, suporte ao cliente, e-commerce).
- Desenvolvedores construindo agentes para produção: um servidor MCP, um caminho de escrita determinístico e proveniência que você possui.
- Vibecoders entregando rápido: memória persistente em uma linha, sem chave e gratuita, sem infraestrutura para construir.
- Equipes colocando IA em um produto: memória do cliente, isolada por tenant, em Postgres que você possui.
- Agências: cada cliente em um workspace isolado e auditável.
Arquitetura

O design é simples de propósito: o banco de dados é autoritativo, o caminho de escrita é programático e LLMs auxiliam sem se tornar o armazenamento de memória.
Superfície de ferramentas
Myco Brain expõe 13 ferramentas MCP:
brain_context_packbrain_searchbrain_whybrain_neighborsbrain_ingestbrain_propose_factbrain_annotatebrain_save_memorybrain_recall_memorybrain_get_relatedbrain_statsbrain_set_modebrain_self_check
Entradas, saídas e exemplos completos para cada ferramenta: docs/api-reference.md.
Variáveis de ambiente
O quickstart com Docker não precisa de nenhuma delas — ele já vem com credenciais locais pré-configuradas e a busca BM25 funciona imediatamente. Esta é a referência para sua própria implantação. Lista anotada completa com limites de ajuste:
.env.example. Não sabe o que está ativo? Execute mycobrain-doctor.
Obrigatórias
| Variável | Padrão | O que faz |
|---|---|---|
DATABASE_URL | — | String de conexão do Postgres. O único requisito obrigatório. |
BRAIN_API_KEY | pré-configurada | Chave brain_<workspace>_<agent>_<secret>; o quickstart inclui uma chave de desenvolvimento local. |
BRAIN_WORKSPACE_ID | da chave | Derivada de BRAIN_API_KEY; defina explicitamente apenas para autenticação de service-role. |
Busca semântica (opcional — sem ela, o texto completo BM25 ainda funciona)
| Variável | Padrão | O que faz |
|---|---|---|
BRAIN_EMBED_PROVIDER | auto | ollama ou openai; seleciona automaticamente com base na credencial definida. |
BRAIN_OLLAMA_EMBED_MODEL | nomic-embed-text | Modelo de embeddings local (sem chave, nada sai da sua máquina). |
BRAIN_OPENAI_API_KEY | — | Usa embeddings da OpenAI em vez do modelo local. |
Grafo de conhecimento (opcional)
| Variável | Padrão | O que faz |
|---|---|---|
BRAIN_OLLAMA_BASE_URL | — | Endpoint local de extração/embeddings (ex.: http://localhost:11434). |
BRAIN_OLLAMA_MODEL | llama3.2:3b | Modelo local de extração. |
BRAIN_ANTHROPIC_API_KEY | — | Grafo mais preciso; usado automaticamente se definido. |
BRAIN_EXTRACTION_PROVIDER | auto | Força ollama ou anthropic. |
Controle de confiança (governança)
| Variável | Padrão | O que faz |
|---|---|---|
BRAIN_REQUIRE_HUMAN_REVIEW | 0 | Curadoria rigorosa — nada que o LLM propõe entra no grafo sem uma decisão humana. |
BRAIN_SCHEMA_AUTO_PROMOTE | 0 | Permite que novos tipos corroborados se promovam sozinhos, auditados e limitados ao workspace. |
Serviço
| Variável | Padrão | O que faz |
|---|---|---|
BRAIN_REST_HOST | 127.0.0.1 | Host de vinculação para mycobrain-rest. Use 0.0.0.0 apenas atrás do seu próprio TLS/proxy. |
BRAIN_REST_PORT | 8787 | Porta REST somente leitura. |
BRAIN_HEALTH_PORT | 8080 | Porta de verificação de saúde. |
Identidade e segurança
| Variável | Padrão | O que faz |
|---|---|---|
BRAIN_REQUIRE_API_KEY_SECRET | 0 | Exige um <secret> registrado para cada chave de agente antes que a autenticação seja bem-sucedida. |
BRAIN_TRUST_REQUEST_IDENTITY | 0 | Somente gateways stdio multi-tenant. Desligado: a identidade vem exclusivamente do ambiente, então um workspace_id/api_key fornecido pelo chamador é ignorado (resistente a injeção de prompt). Defina 1 apenas atrás de um gateway que autentique cada requisição. Detalhes ↑ |
BRAIN_AGENT_ID | da chave | Identidade do agente para autenticação service-role; derivada de BRAIN_API_KEY caso contrário. |
BRAIN_SERVICE_ROLE_KEY | — | JWT service-role do Supabase para chamadores de serviço confiáveis (alternativa a uma chave brain_). |
Limites de ajuste (
BRAIN_SCHEMA_PROMOTE_MIN_SEEN,BRAIN_EXTRACTION_LEASE_MS,BRAIN_FUNCTIONAL_PREDICATES, …) estão em.env.example.
Estrutura do repositório
myco-brain/
├── mcp-server/              # TypeScript MCP server + bulk-ingest CLI
├── supabase/migrations/     # versioned SQL migrations
├── demos/                   # demos-as-code (VHS + ffmpeg + narration pipeline)
├── docs/quickstart.md       # setup guide
├── evals/
│   └── longmemeval/         # LongMemEval benchmark harness (run it yourself)
├── examples/
│   ├── demo-corpus/         # sample interconnected docs to ingest
│   └── benchmark/           # reproducible dedup + provenance benchmark
├── docker-compose.yml       # local quickstart
├── ROADMAP.md               # where this is headed
└── LICENSE                  # Apache-2.0
Importe seu histórico do ChatGPT / Claude
Meses de conversas com assistentes se tornam memória rastreável por proveniência, deduplicada e pesquisável — um documento por conversa:
# Official OpenAI data export (zip, extracted folder, or conversations.json)
mycobrain-ingest --from chatgpt-export ./chatgpt-export.zip

# claude.ai data export
mycobrain-ingest --from claude-export ./claude-export.zip
- Reimportar nunca duplica — cada conversa é um documento com chave de hash de conteúdo, então uma nova execução não faz nada. Continue uma conversa e reexporte, e a transcrição mais longa será importada como uma nova versão ao lado da antiga.
- Threads ramificados do ChatGPT importam o branch ATIVO — a transcrição que você realmente manteve, não as regenerações rejeitadas.
- Proveniência completa —
brain_whyrastreia cada fato importado até seu arquivo de exportação.
Prova: npm run test:export-import.
Mãos livres — observe seus Downloads. Solicite sua exportação e deixe o Myco importá-la no momento em que ela chegar, sem caminho para copiar e sem que nada saia da sua máquina:
# Poll ~/Downloads and auto-import a ChatGPT/Claude export the second it arrives (Ctrl-C to stop)
mycobrain-ingest --watch-downloads

# Already downloaded it? Import whatever export is there, then exit
mycobrain-ingest --watch-downloads --once
Opt-in e deduplicado como qualquer outra importação; aponte para uma pasta diferente com BRAIN_WATCH_DIR (requer unzip no seu PATH).
Lista de espera na nuvem
Auto-hospedagem é o padrão. Se você prefere hospedagem gerenciada, entre na lista de espera:
Essa página é o ponto de entrada canônico da lista. Este README intencionalmente não incorpora um formulário.
Arquivos OSS
Recursos
- Quickstart
- Pacote npm
- Changelog
- Público + casos de uso por setor
- Rastreador de problemas
- Lista de espera na nuvem
Quem construiu isso
O Myco Brain foi construído por Nick Taylor — um profissional de growth marketing, não um engenheiro de carreira — dirigindo uma equipe de agentes de codificação de IA. Cerca de três meses e aproximadamente US$ 6 mil em gastos com modelos, construído com engenharia assistida por IA. O ponto não é o preço; é que uma visão clara de produto mais ferramentas modernas de agentes agora podem entregar infraestrutura de nível de produção — e este repositório é o resultado: cada afirmação nesta página nomeia uma verificação executável (veja Cada afirmação tem uma verificação), para que você possa julgar por si mesmo em vez de aceitar a história de origem pela fé.
Gostou? Uma ⭐ ajuda outras pessoas a encontrá-lo, e Watch → Releases (no topo da página) avisará você quando novos recursos forem lançados — veja o roadmap para o que vem a seguir.
Quer isso para sua equipe? Se sua empresa quer alguém que possa construir sistemas de agentes, automação e engenharia de growth como este, é isso que The Good Guys faz — envie um e-mail para nick@thegoodguys.la ou agende uma chamada.