Lorekeeper
Servidor de memória MCP autoaprimorável para agentes de IA. Um comando, sem nuvem, sem configuração. Pesquisa híbrida, sistema de qualidade com ciclo de feedback, interface de painel, grafo de conhecimento com vinculação automática. Melhora quanto mais você usa.
Documentação

Lorekeeper
Memória auto-melhorável para agentes de IA. Um comando, sem nuvem, sem configuração.
pip install lorekeeper-mcp && lorekeeper setup && lorekeeperSeu agente lembra entre sessões — e a memória fica melhor, não apenas maior. Local. Sem chaves de API. Sem cadastro. Grátis para rodar para sempre.
Por que Lorekeeper
Toda sessão de agente de IA começa em branco. Você reexplica contexto, reafirma preferências, reensina padrões — toda vez.
Arquivos como CLAUDE.md e .cursorrules ajudam, mas são mantidos manualmente, não conseguem se buscar sozinhos e ficam desatualizados. Serviços em nuvem funcionam, mas seus dados de sessão saem da sua máquina e você paga por chamada de API. Bibliotecas são poderosas, mas você escreve a integração por conta própria.
Lorekeeper tem um formato diferente: um servidor MCP local que você pip install uma vez. Ele conecta aos seus agentes existentes, armazena memórias em SQLite no seu próprio disco e começa a melhorar a cada sessão:
Agent uses a memory → rates it useful or not →
scores adjust automatically → weak memories decay →
strong memories surface more often → search gets sharper
Uma instalação nova e uma instalação de seis meses são produtos genuinamente diferentes. Quanto mais você usa, menos ruído você recebe — e mais seus agentes parecem realmente conhecer seu código.
Início Rápido
3 minutos, zero configuração:
# 1. Install
pip install lorekeeper-mcp

# 2. Configure your agents (auto-detects Hermes, Claude Code, Cursor)
lorekeeper setup

# 3. Start the MCP server
lorekeeper
lorekeeper setup verifica agentes instalados e injeta automaticamente a entrada MCP, o prompt do agente e as habilidades incluídas. Use --check para pré-visualizar sem gravar. Execute lorekeeper --help ou lorekeeper --version para verificar a instalação.
Depois pergunte ao seu agente:
"Lembre que eu prefiro
curl -vX GETpara depurar endpoints."
Ele chama lore_remember → memória armazenada. Próxima sessão:
"Qual é o meu comando de depuração preferido?"
Ele chama lore_search → memória recuperada. ✅
Passo a passo completo → docs/quickstart.md
Recursos
| O quê | Como |
|---|---|
| Busca híbrida | Vetores semânticos + palavras-chave BM25 + decaimento temporal + frequência de uso + pontuação de memória — tudo ranqueado por uma fórmula ponderada |
| Auto-melhorável | lore_update feedback ajusta pontuações. Memórias ruins desaparecem (<2 confiança + não útil → exclusão suave). Boas sobem. |
| Vinculação automática | Novas memórias são automaticamente vinculadas ao vizinho semântico mais próximo. Um grafo de conhecimento leve se forma sem esforço. |
| Detecção de duplicatas | Novas inserções são verificadas contra memórias existentes. Conteúdo quase idêntico é bloqueado (substitua com force=true). |
| Painel | Interface web completa — navegue, busque, edite, exclua. Sete abas incluindo backup/restauração com pré-visualização de deduplicação. |
| MCP universal | Funciona com Claude Code, Cursor, Hermes, Copilot, OpenCode — qualquer agente compatível com MCP. |
| Local primeiro | Seus dados ficam na sua máquina. SQLite + LanceDB. Sem dependência de nuvem, sem chaves de API. |
| Namespaces | Vários agentes compartilham um armazenamento com namespaces isolados. Gravações vão para seu namespace; leituras incluem o pool compartilhado. |
| Reflexão | Agentes extraem aprendizados automaticamente das sessões. Descobertas e lições viram memórias pesquisáveis. |
Casos de Uso
Permanecer no contexto entre sessões
Você configura sua camada de autenticação na segunda-feira. Na quarta, um agente diferente começa do zero sem ideia. Com Lorekeeper, ele já sabe o caminho do middleware, o formato do token e qual teste cobre o caso extremo — porque você contou uma vez.
"Remember that our JWT uses jose middleware in src/middleware/auth.ts
 and refresh tokens expire in 7 days."
→ lore_remember stores it
→ Every future session, on any agent: already in context
Um pool de memória, vários agentes
Claude Code para revisão, Cursor para implementação, Hermes para planejamento — eles não deveriam começar do zero cada um. Os namespaces do Lorekeeper permitem que compartilhem um armazenamento. A descoberta de um agente vira conhecimento de todos os agentes.
→ Engineer agent notes a performance quirk in the search service
→ lore_remember stores it under the shared namespace
→ PM agent surfaces it during sprint planning
→ No briefing, no copy-paste
Depuração entre sessões
Você corrigiu um bug sutil de CORS há três semanas e seu agente ajudou. Nenhum de vocês lembra dos detalhes.
"What did we figure out about the CORS issue?"
→ lore_search returns the root cause, the fix, and the context around it
Integração de projetos
Repositório novo, sessão de agente nova. Em vez de reexplicar a arquitetura, você executa algumas chamadas lore_remember após a primeira sessão. A próxima sessão — e todo agente depois dela — começa com a base certa.
"Remember: the payment service requires X-Idempotency-Key on all POST requests."
→ Claude Code, Cursor, and Codex all read from the same store
Para Quem É
Você, se usa:
- Claude Code e quer que ele lembre do contexto do projeto entre sessões
- Cursor e quer memória persistente de agente
- Hermes, OpenCode, Codex CLI, Copilot CLI ou qualquer agente compatível com MCP
- Vários agentes e quer que compartilhem conhecimento
Ainda não é para você, se:
- Você precisa de RBAC de equipe, logs de auditoria ou SSO (chegando pós-beta)
- Você está construindo um aplicativo de IA para consumidores (somos agentes primeiro, não API primeiro)
- Você não usa agentes de codificação de IA (Lorekeeper é uma ferramenta MCP)
Como se Compara
Existem ótimas ferramentas neste espaço — cada uma faz diferentes compensações. Aqui está onde Lorekeeper se posiciona:
| Baseado em arquivos | Serviços em nuvem | Servidores Docker | Biblioteca (Mem0) | agentmemory (Node) | Lorekeeper | |
|---|---|---|---|---|---|---|
| Configuração | Integrado | Chave de API + configuração em nuvem | docker compose | Escreva código de integração | npx agentmemory | pip install |
| Dados | Local | Nuvem | Local | Sua escolha | Local | Local |
| Busca | grep | Vetorial | Vetorial | Vetorial | Híbrida | Híbrida + decaimento temporal + uso + pontuação |
| Auto-melhorável | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ Loop de qualidade |
| Grafo de conhecimento | ❌ | Pago | ❌ | Pago | ❌ | ✅ Vinculação automática gratuita |
| Painel | ❌ | ✅ | ❌ | ❌ | Visualizador | ✅ Interface web completa |
| Dependências | Nenhuma | ~300MB | ~2GB | ~1.4GB | ~200MB | ~1.4GB (embeddings) |
| Construído por agentes | ❌ | ❌ | ❌ | ❌ | ❌ | ✅ Usado diariamente |
Serviços em nuvem e soluções baseadas em Docker são escolhas fortes para equipes ou aplicativos de produção. Lorekeeper é otimizado para o outro extremo: desenvolvedores solo e fluxos de trabalho de agentes onde zero operação, zero nuvem e um armazenamento auto-melhorável importam mais.
Nota sobre dependências: ~1.4GB vem do modelo de embeddings sentence-transformers (PyTorch). Isso é a mesma classe de peso de qualquer solução local de embeddings. Somos honestos sobre isso.
Ferramentas MCP
Lorekeeper expõe 10 ferramentas MCP cobrindo todo o ciclo de vida da memória:
| Ferramenta | Propósito |
|---|---|
lore_search | Busca híbrida semântica + palavras-chave com pontuações de relevância |
lore_remember | Salvamento rápido de memória em uma etapa (títulos automáticos, links automáticos) |
lore_insert | Inserção estruturada em lote com pontuações e links personalizados |
lore_update | Loop de feedback — avalie memórias, conduza qualidade |
lore_forget | Exclusão suave de memórias erradas ou desatualizadas |
lore_reflect | Fim de sessão: extraia aprendizados, salve descobertas automaticamente |
lore_processed_sessions | Verifique quais sessões já foram processadas |
lore_recommend_links | Sugira links candidatos entre memórias relacionadas |
lore_get_suggestions | Liste sugestões de links pendentes do mecanismo de varredura |
lore_review_suggestion | Aceite ou rejeite uma ou mais sugestões de links (em lote) |
Referência completa da API → docs/api-reference.md
Painel
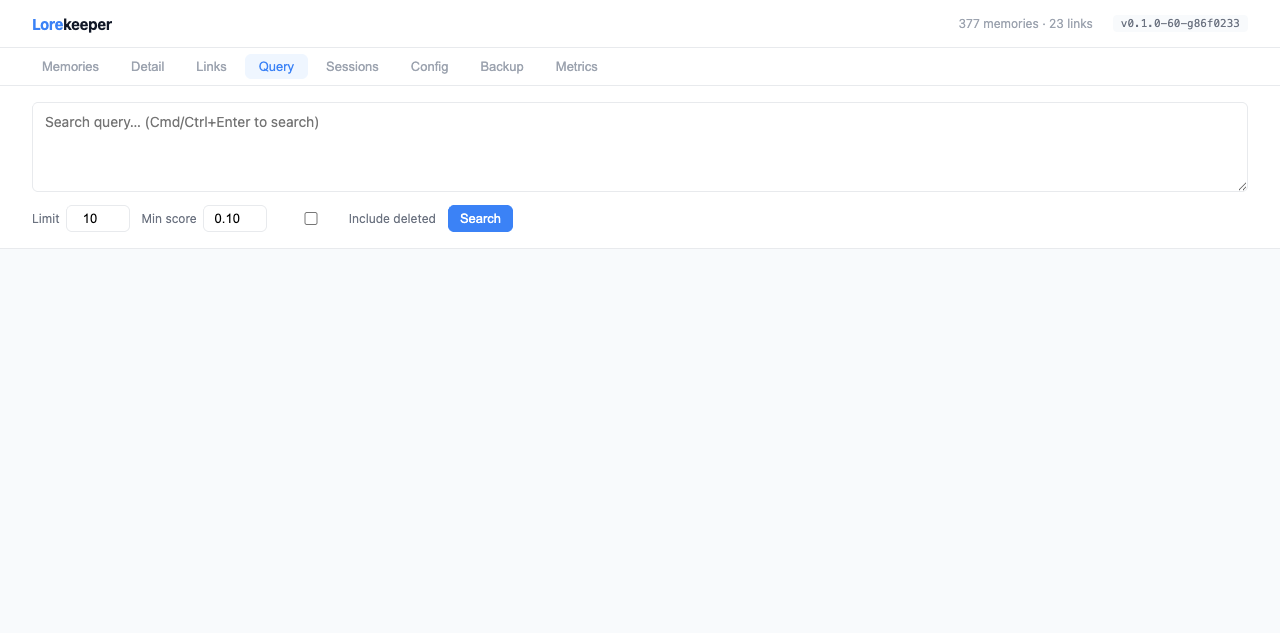
Uma interface web local para navegar, buscar, editar e gerenciar seu armazenamento de memória.
lorekeeper-dashboard
# → http://127.0.0.1:7777
Sete abas:
| Aba | O que faz |
|---|---|
| Memórias | Tabela classificável com filtro ao vivo — título, pontuação, confiança, uso, datas |
| Detalhe | Edite o conteúdo de uma memória, gerencie seus links, exclusão suave ou exclusão definitiva |
| Links | Navegue pelo grafo de conhecimento — origem → relação → destino |
| Consulta | Buscas semânticas + palavras-chave ad-hoc com detalhamento de pontuação por resultado |
| Sessões | Todas as sessões de agentes processadas com aprendizados extraídos |
| Configuração | Ajuste ao vivo de pesos de busca, limites de qualidade, limites |
| Backup | Exporte/importe memórias como JSON com pré-visualização de deduplicação |
| Sugestões | Revise candidatos a links gerados por IA do mecanismo de varredura — aceite ou rejeite um por um ou em lote |
Aba de Sugestões
A aba Sugestões exibe candidatos a links gerados automaticamente pelo mecanismo de varredura em segundo plano. Cada candidato é um par de memórias que o mecanismo considera relacionadas, pontuado por similaridade de cosseno, sobreposição de palavras-chave BM25, co-ocorrência de entidades e proximidade temporal.
Fluxo de trabalho:
- O mecanismo de varredura roda em um intervalo configurável (
LORE_SUGGEST_INTERVAL_HOURS, padrão12). - Candidatos aparecem na aba Sugestões, ordenados por pontuação (maior primeiro).
- Clique em ✓ (ou selecione várias linhas + Aceitar Selecionadas) para criar um link permanente entre as duas memórias.
- Clique em ✗ (ou Rejeitar Selecionadas) para descartar — pares rejeitados nunca são reexibidos por varreduras futuras.
- Use Acionar Varredura na aba Configuração para rodar a varredura imediatamente em vez de esperar o intervalo.
Configuração da varredura (via variáveis de ambiente com prefixo LORE_ ou na aba Configuração):
| Configuração | Padrão | Descrição |
|---|---|---|
LORE_SUGGEST_INTERVAL_HOURS | 12 | Com que frequência a varredura roda (horas) |
LORE_SUGGEST_MIN_SCORE | 0.55 | Pontuação ponderada mínima para exibir um candidato |
LORE_SUGGEST_MAX_CANDIDATES | 500 | Máximo de candidatos por execução de varredura |
LORE_SUGGEST_TTL_DAYS | 30 | Dias antes de sugestões não revisadas serem removidas |
Construído por Agentes, Para Agentes
Lorekeeper é desenvolvido usando agentes de IA — Claude Code, Hermes e nossa própria equipe de agentes. O ciclo de desenvolvimento é em si uma demonstração prática do que ele faz:
agent builds a feature → uses Lorekeeper to capture what it learned →
searches those memories next session →
builds the next feature with the context already there
Isso não é uma frase de marketing. Cada esquema de ferramenta, tipo de retorno e fluxo de trabalho em Lorekeeper foi moldado por agentes que o usam diariamente — não por humanos lendo especificações. Quando algo era chato de usar, mudávamos. Quando a busca retornava ruído, ajustávamos os pesos. O produto é o que é porque os agentes que o constroem dependem dele.
O loop de desenvolvimento agêntico documentado neste repositório é como realmente trabalhamos — e é isso que o Lorekeeper foi projetado para apoiar para você.
Para Desenvolvedores
Clone, execute a partir do código-fonte ou contribua:
git clone https://github.com/Jessinra/Lorekeeper.git
cd Lorekeeper
bash scripts/setup.sh
# Tests
uv run pytest

# Lint
uv run ruff check src tests

# Type check
uv run mypy src

# Dashboard dev
uv sync --extra dashboard
uv run lorekeeper-dashboard
Estrutura do Projeto
src/lorekeeper/
├── __main__.py          # Entrypoint — init_service() + mcp.run(stdio)
├── server.py            # FastMCP tool definitions (8 tools)
├── config.py            # Settings (pydantic-settings, LORE_ prefix)
├── models.py            # Pydantic models
├── dashboard/           # Web UI (FastAPI + uvicorn)
└── services/
    ├── orchestrator.py  # MemoryService — coordinates sub-services
    ├── memory_engine.py # Vector store abstraction
    ├── lancedb_engine.py# LanceDB backend
    ├── link_store.py    # SQLite — memories, links, suggestions
    ├── keyword_index.py # BM25 index
    ├── search.py        # Hybrid ranking
    └── ...
Configuração Principal
Todas as configurações via variáveis de ambiente com prefixo LORE_ ou na aba Config do painel:
| Variável | Padrão | Descrição |
|---|---|---|
LORE_DATA_DIR | ~/.lorekeeper | Diretório de dados (SQLite + vetores) |
LORE_NAMESPACE | shared | Namespace do agente — grava com escopo, lê união com shared |
LORE_SEARCH_LIMIT | 5 | Contagem de resultados padrão de lore_search |
LORE_LINK_TOP_M | 10 | Máximo de candidatos retornados por lore_recommend_links |
LORE_LINK_SCORE_THRESHOLD | 0.3 | Pontuação mínima para candidatos de link aparecerem |
LORE_LINK_TEMPORAL_TAU_DAYS | 30 | Meia-vida de decaimento para pontuação de proximidade temporal (dias) |
Lista completa → src/lorekeeper/config.py e CLAUDE.md.
Desempenho
Todas as 500 perguntas do LongMemEval-S, pesos híbridos padrão (sem=0.45, kw=0.30):
| Métrica | Valor | Latência |
|---|---|---|
| R@1 | 84.6% | 32.9 ms/consulta |
| R@3 | 93.6% | |
| R@5 | 96.6% | |
| R@10 | 98.8% |
Detalhamento completo por categoria → docs/research/2026-06-11-retrieval-benchmark-results.md
Licença
Apache-2.0 — veja LICENSE.
Construído por agentes, para agentes. Manifesto · Estratégia
Última verificação: 2026-06-20