Semble
Busca de código local rápida e precisa para agentes. Indexa qualquer caminho local ou repositório GitHub sob demanda em ~250ms e responde consultas em ~1.5ms. Funciona em CPU, sem chaves de API ou serviços externos.
Documentação
Busca de Código Rápida e Precisa para Agentes
Usa ~99% menos tokens do que grep+read


Quickstart • CLI • MCP Server • Instalação • Benchmarks
Semble é uma biblioteca de busca de código construída para agentes. Ela retorna os trechos de código exatos que eles precisam instantaneamente, usando ~99% menos tokens do que grep+read. Indexar e buscar um codebase completo de ponta a ponta leva menos de um segundo para a maioria dos repositórios, igualando a qualidade de recuperação de um transformer especializado em código enquanto indexa ~380x mais rápido e consulta ~17x mais rápido (veja benchmarks). Tudo roda em CPU sem chaves de API, GPU ou serviços externos. Use como um servidor MCP, uma ferramenta CLI via AGENTS.md, ou um sub-agente dedicado, e qualquer agente de codificação (Claude Code, Cursor, Codex, OpenCode, etc.) terá acesso instantâneo a qualquer repositório.
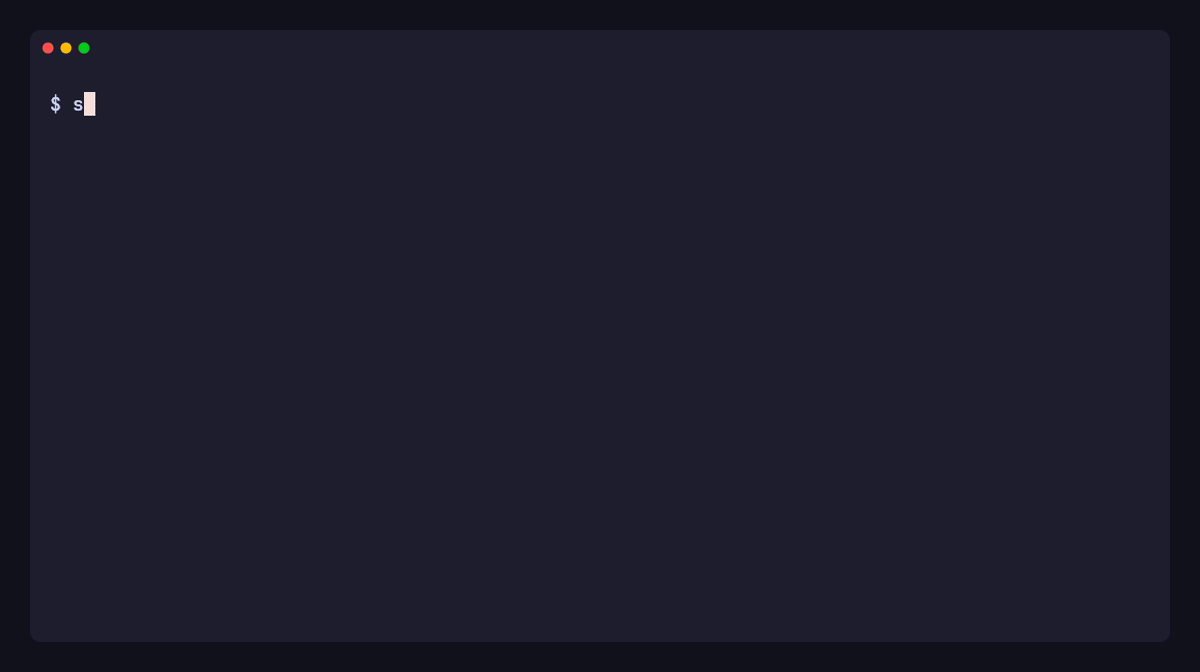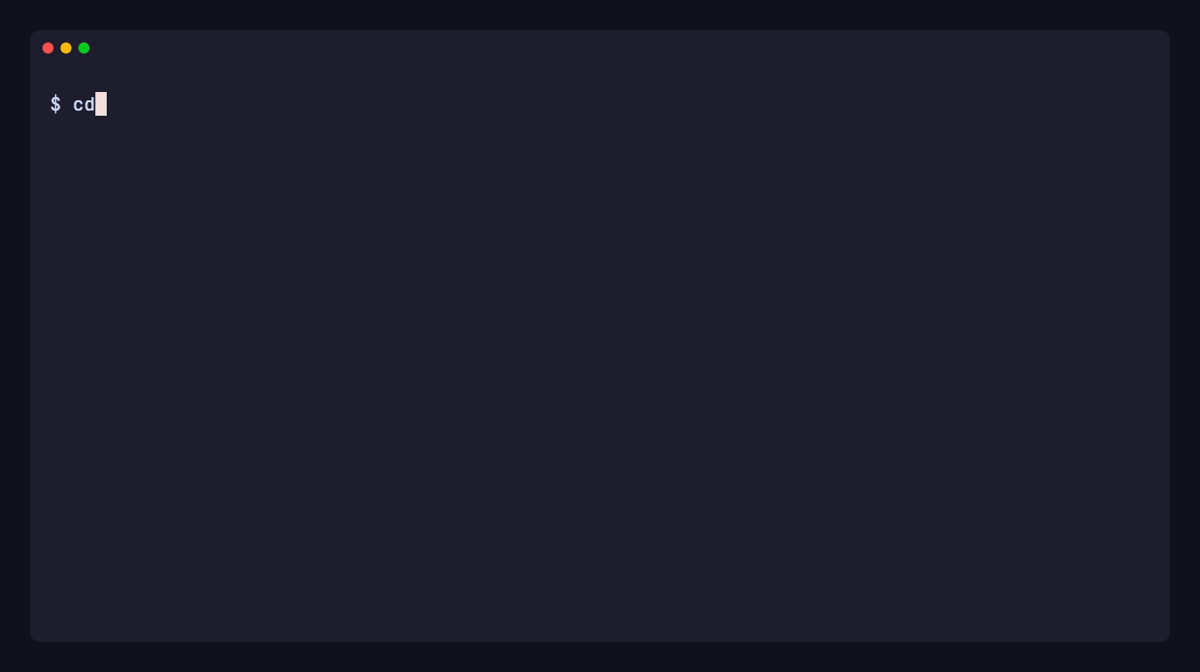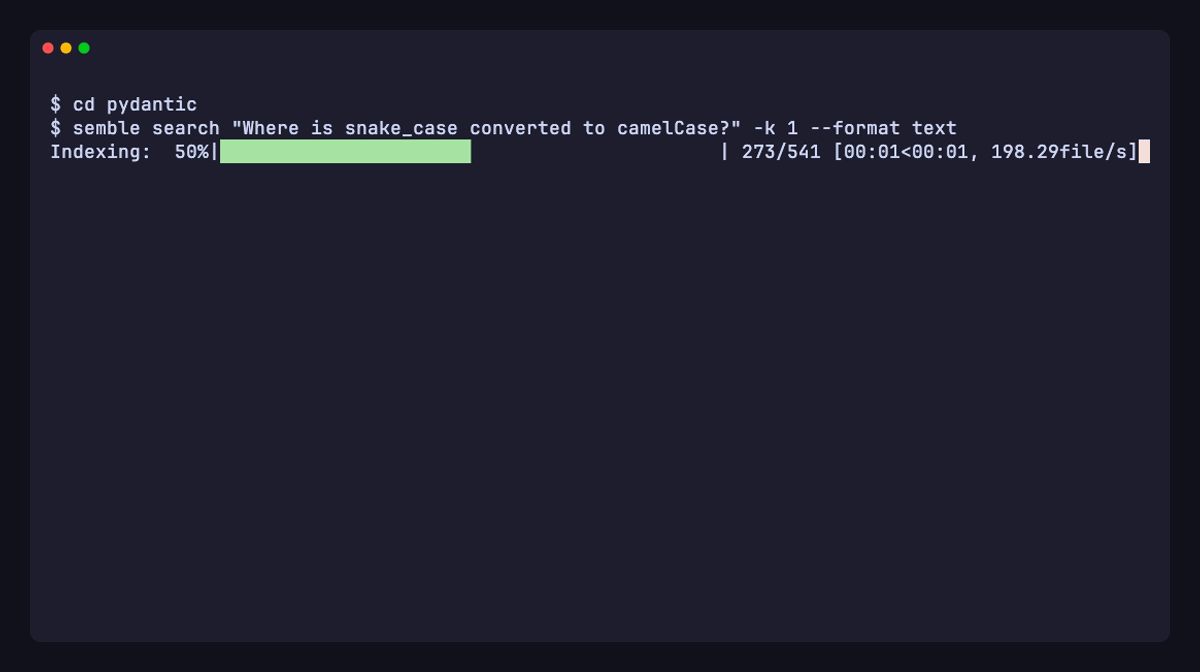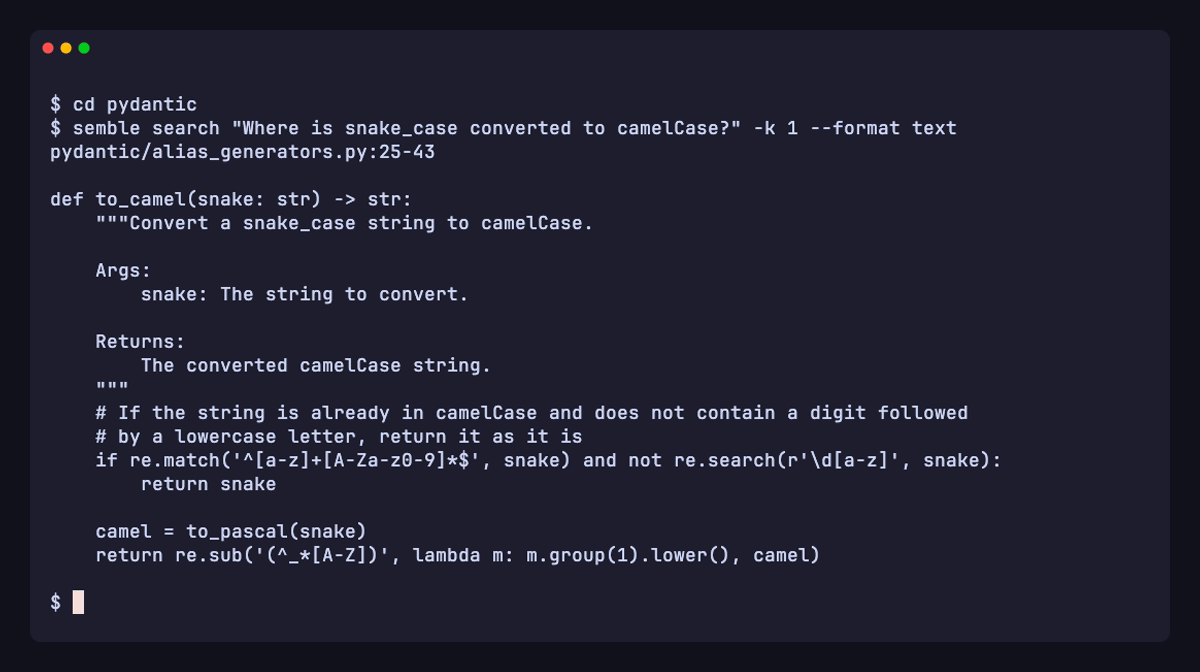
Quickstart
Seu agente consulta o Semble em linguagem natural (ex.: "How is authentication handled?") e recebe de volta apenas os trechos de código relevantes, sem precisar usar grep ou ler arquivos completos.
A maneira mais rápida de começar é o instalador interativo. Instale o uv e então execute:
uv tool install semble
semble install
semble install detecta agentes de codificação instalados, como Claude Code, Codex e OpenCode, e então permite que você escolha quais integrações habilitar:
- Servidor MCP: permite que o agente chame o Semble diretamente como uma ferramenta.
- Instruções: adiciona orientações de uso da CLI ao AGENTS.md / CLAUDE.md.
- Sub-agente: instala um sub-agente
semble-searchdedicado.
Para desfazer a configuração, execute semble uninstall.
Para instruções de configuração manual (config MCP por agente, trecho AGENTS.md, arquivos de sub-agente), veja a documentação de instalação.
Atualizando o Semble
uv tool upgrade semble   # upgrade
uv cache clean semble    # for MCP users (restart your MCP client after)
Instalação não assistida
Para ambientes em sandbox ou com scripts, pule os prompts com --agent e, opcionalmente, --type:
semble install --agent claude --type mcp subagent --yes
--agent aceita um ou mais IDs de agente (ex.: claude, codex, pi); --type aceita mcp, instructions, subagent ou all (padrão: todos); --yes pula o prompt de confirmação (requer --agent para uma execução totalmente não interativa).
Principais Recursos
- Rápido: indexa um repositório médio em ~500 ms e responde consultas em ~1 ms, tudo em CPU.
- Preciso: NDCG@10 de 0,854 em nossos benchmarks, no mesmo nível de modelos transformer especializados em código, a uma fração do tamanho e custo.
- Eficiente em tokens: retorna apenas os trechos relevantes, usando ~99% menos tokens do que grep+read.
- Zero configuração: roda em CPU sem chaves de API, GPU ou serviços externos necessários.
- Servidor MCP: funciona com Claude Code, Cursor, Codex, OpenCode, VS Code e qualquer outro agente compatível com MCP.
- Local e remoto: passe um caminho local ou uma URL git, ou vários deles para buscar repositórios relacionados juntos.
CLI
O Semble também é distribuído como uma CLI independente. Isso é útil em scripts ou em qualquer lugar onde você queira resultados de busca sem uma sessão MCP. Os índices são construídos e armazenados em cache na primeira execução e invalidados automaticamente quando os arquivos mudam.
# Search a local repo (index is built and cached automatically)
semble search "authentication flow" ./my-project

# Search a remote repo (cloned on demand)
semble search "save model to disk" https://github.com/MinishLab/model2vec

# Search several repos at once (results are prefixed with the repo name)
semble search "invoice endpoint" ./service-a ./service-b

# Limit results
semble search "save model to disk" ./my-project --top-k 10

# Search docs/config/everything instead of just code
semble search "deployment guide" ./my-project --content docs   # or: config, all

# Find code similar to a known location
semble find-related src/auth.py 42 ./my-project

# Show only the first N lines of each result's snippet (0 = path/line range only)
semble search "authentication flow" ./my-project --max-snippet-lines 10
--content aceita code (padrão), docs, config ou all. --format aceita json (padrão) ou text. path usa o diretório atual por padrão quando omitido; URLs git são aceitas. Se semble não estiver em $PATH, use uvx --from "semble[mcp]" semble em seu lugar. semble --version (ou -V) imprime a versão instalada.
Passar vários caminhos ou URLs os busca como um único corpus, então uma consulta do repositório A pode encontrar um endpoint definido no repositório B. Cada índice é armazenado em cache por repositório e mesclado no momento da consulta. Os caminhos dos resultados são prefixados com o nome do repositório (service-b/api/invoices.py) e a saída inclui um mapa repos de prefixo para caminho absoluto ou URL. Passe o caminho prefixado para find-related para buscar em todos os repositórios a partir de um local conhecido.
Controlando quais arquivos são indexados
O Semble lê os arquivos .gitignore e .sembleignore para determinar quais arquivos indexar. Ambos os arquivos usam sintaxe padrão de gitignore e seus padrões são mesclados. .sembleignore permite adicionar regras específicas do semble sem tocar em .gitignore. As regras são aplicadas recursivamente, então um .sembleignore em um subdiretório se aplica àquela subárvore.
Excluindo arquivos: adicione padrões da mesma forma que faria em .gitignore:
# .sembleignore
generated/     # exclude generated dir
*.pb.go.       # exclude Go protobuf files
Incluindo extensões não padrão: prefixe o padrão de extensão com ! para forçar a inclusão de arquivos que o semble não indexaria por padrão:
# .sembleignore
!*.proto       # include Protobuf files
!*.cob         # include COBOL files
O Semble também sempre ignora um conjunto de diretórios não-fonte bem conhecidos, independentemente dos arquivos de ignore (ex.: node_modules/, .venv/, dist/, build/, __pycache__/ e similares).
Economia
semble savings mostra quantos tokens o semble economizou em todas as suas buscas:
semble savings
  Semble Token Savings
  ════════════════════════════════════════════════════════════════════════

  Total saved:  ~714.2M tokens  (94%)
  Total calls:  14.3k
  Efficiency:  ███████████████████████░  94%

  By Period
  ────────────────────────────────────────────────────────────────────────
  Period             Calls           Saved  Ratio
  ────────────────────────────────────────────────────────────────────────
  Today                198    ~1.4M tokens  ███████████████████████░  95%
  Last 7 days        13.1k  ~707.2M tokens  ███████████████████████░  94%
  All time           14.3k  ~714.2M tokens  ███████████████████████░  94%

  By Call Type
  ────────────────────────────────────────────────────────────────────────
  #     Call type            Calls  Share
  ────────────────────────────────────────────────────────────────────────
  1.    search               14.1k  ████████████████    99%
  2.    find_related           205  █░░░░░░░░░░░░░░░     1%
  ════════════════════════════════════════════════════════════════════════
A economia é calculada da seguinte forma: para cada chamada, o semble registra a contagem total de caracteres dos arquivos únicos que contêm os trechos retornados e a contagem de caracteres dos trechos retornados. Os tokens economizados estimados são (file chars − snippet chars) / 4 (4 caracteres por token). Esta é uma estimativa conservadora: a linha de base é ler os arquivos correspondentes por completo, que é como os agentes de codificação frequentemente exploram código desconhecido.
Armazenamento
Por padrão, suas estatísticas de economia do Semble e quaisquer índices salvos são armazenados na pasta de cache do sistema operacional (~/Library/Caches/semble/ no macOS, ~/.cache/semble/ no Linux, %LOCALAPPDATA%\semble\Cache\ no Windows). Para substituir este local, você pode fornecer uma variável de ambiente SEMBLE_CACHE_LOCATION que deve ser o caminho completo para o local de cache desejado, ex.: ~/my-folder/my-caches/semble.
Arquivos maiores que 1 MB são ignorados durante a indexação para manter as construções de índice enxutas. Arquivos ignorados são relatados como um aviso no momento da indexação. Se você trabalha com documentos grandes gerados ou ingeridos, você pode aumentar (ou diminuir) este limite com a variável de ambiente SEMBLE_MAX_FILE_BYTES (em bytes).
No primeiro uso, o Semble também baixa o modelo de embeddings do Hugging Face e o armazena em cache no cache padrão do Hugging Face (~/.cache/huggingface/ por padrão, ou $HF_HOME se definido); isso acontece apenas uma vez e requer acesso à rede.
Use semble clear para remover dados em cache: semble clear index (índices salvos), semble clear savings (estatísticas de uso), semble clear orphans (índices para repositórios que não estão mais presentes no disco) ou semble clear all (tudo).
Uso como biblioteca
O Semble também pode ser usado como uma biblioteca Python para acesso programático, útil ao construir ferramentas personalizadas ou integrar a busca diretamente em seu próprio código.
from semble import ContentType, SembleIndex

# Index a local directory (code only, the default)
index = SembleIndex.from_path("./my-project")

# Index docs and prose (markdown, rst, etc.)
index = SembleIndex.from_path("./my-project", content=ContentType.DOCS)

# Index everything (code, docs, and config)
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS, ContentType.CONFIG])

# Index code and docs together
index = SembleIndex.from_path("./my-project", content=[ContentType.CODE, ContentType.DOCS])

# Index a remote git repository
index = SembleIndex.from_git("https://github.com/MinishLab/model2vec")

# Merge indexes from several repos into one (chunk paths are prefixed with the repo name)
index = SembleIndex.merge([("./service-a", SembleIndex.from_path("./service-a")), ("./service-b", SembleIndex.from_path("./service-b"))])

# Search the index with a natural-language or code query
results = index.search("save model to disk", top_k=3)

# Find code similar to a specific result
related = index.find_related(results[0], top_k=3)

# Each result exposes the matched chunk
result = results[0]
result.chunk.file_path   # "model2vec/model.py"
result.chunk.start_line  # 127
result.chunk.end_line    # 150
result.chunk.content     # "def save_pretrained(self, path: PathLike, ..."
Servidor MCP
O Semble roda como um servidor MCP para que agentes possam buscar em qualquer codebase diretamente como uma chamada de ferramenta nativa. Repositórios são indexados sob demanda e armazenados em cache; caminhos locais são reindexados automaticamente quando os arquivos mudam.
| Ferramenta | Descrição |
|---|---|
search | Busca em um codebase com uma consulta em linguagem natural ou código. Passe repo como um caminho local ou uma URL git https:// (ou uma lista deles para buscar vários repositórios juntos) e content como code, docs, config ou all (padrão: code). |
find_related | Dado um caminho de arquivo e número de linha, retorna trechos semanticamente semelhantes ao código naquele local. |
Para instruções de configuração por agente, veja a documentação de instalação.
Benchmarks
Avaliamos qualidade e velocidade em ~1.250 consultas em 63 repositórios em 19 linguagens (esquerda), e eficiência de tokens contra grep+read em níveis de recall equivalentes (direita).
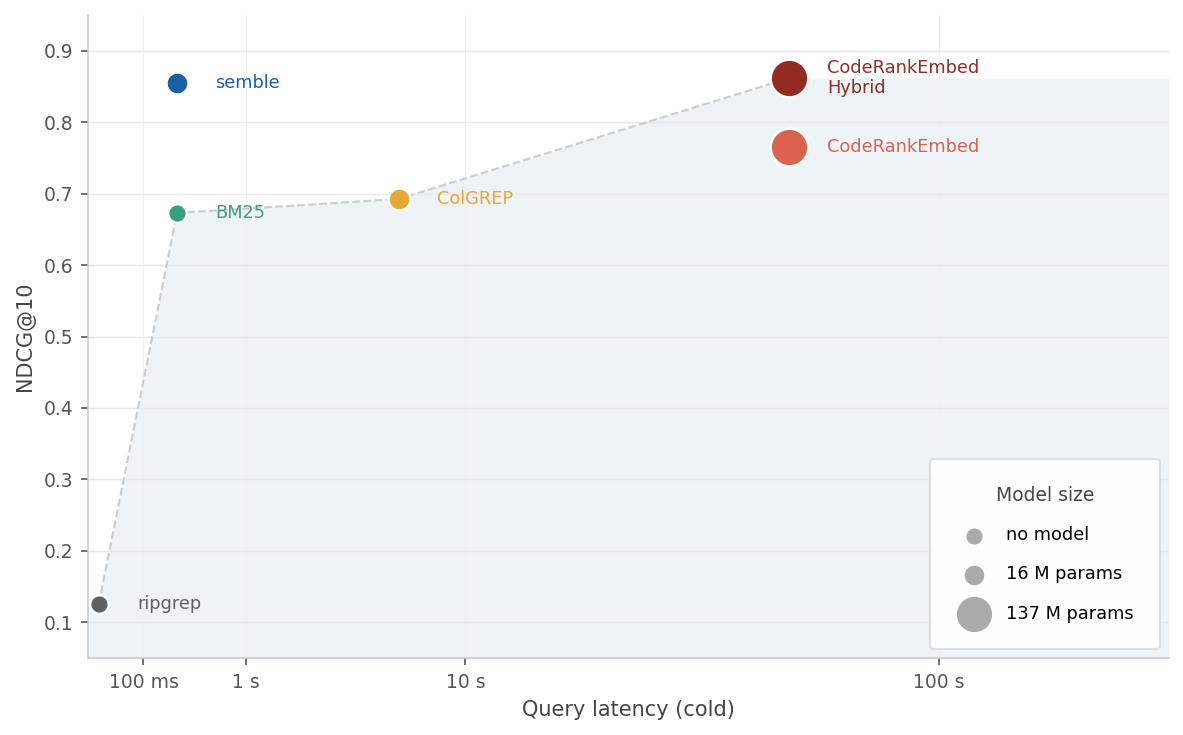 | 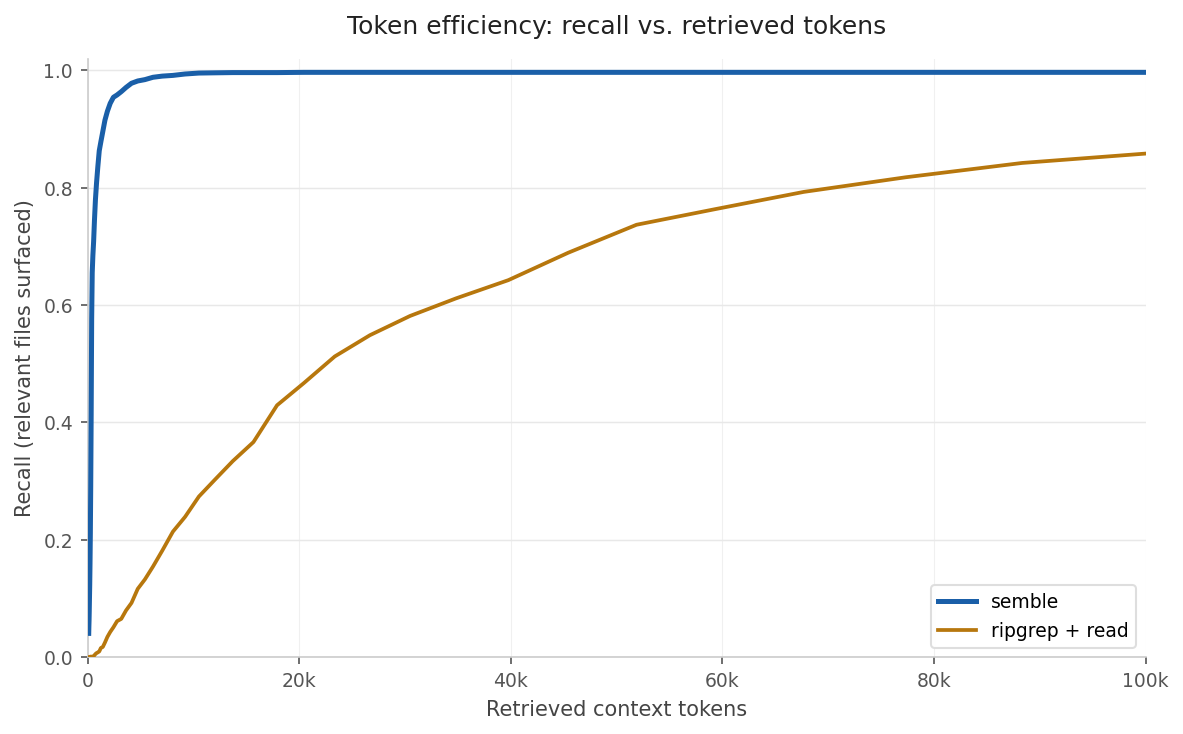 |
O benchmark de qualidade (esquerda) pontua a qualidade de recuperação (NDCG@10) contra a latência total; o semble iguala a qualidade do CodeRankEmbed de 137M de parâmetros enquanto indexa 380x mais rápido. O benchmark de eficiência de tokens (direita) mede quantos tokens cada método precisa para atingir um determinado nível de recall; o semble usa 99% menos tokens em média e atinge 97% de recall com apenas 2k tokens, enquanto grep+read precisa de uma janela de contexto completa de 100k para atingir 85%. Veja benchmarks para resultados por linguagem, ablações e metodologia completa.
Como funciona
O Semble divide cada arquivo em trechos cientes de código usando tree-sitter, então pontua cada consulta contra os trechos com dois recuperadores complementares: embeddings estáticos Model2Vec usando o modelo potion-code-16M-v2 especializado em código para similaridade semântica, e BM25 para correspondências lexicais em identificadores e nomes de API. As duas listas de pontuação são fundidas com Reciprocal Rank Fusion (RRF).
Após a fusão, os resultados são reordenados com um conjunto de sinais cientes de código:
Sinais de ranqueamento
- Ponderação adaptativa. Consultas semelhantes a símbolos (
Foo::bar,_private,getUserById) recebem mais peso lexical, enquanto consultas em linguagem natural permanecem equilibradas entre recuperadores semânticos e lexicais. - Impulsos de definição. Um trecho que define o símbolo consultado (um
class,def,func, etc.) é classificado acima de trechos que apenas o referenciam. - Radicais de identificadores. Os tokens da consulta são reduzidos ao radical e comparados com os radicais de identificadores em um trecho, dando peso adicional a trechos que os contêm. Por exemplo, consultar
parse configimpulsiona trechos que contêmparseConfig,ConfigParserouconfig_parser. - Coerência de arquivo. Quando vários trechos do mesmo arquivo correspondem à consulta, o arquivo é impulsionado para que o resultado principal reflita relevância ampla em nível de arquivo, em vez de um único trecho fora de contexto.
- Penalidades de ruído. Arquivos de teste, shims
compat//legacy/, código de exemplo e stubs de declaração.d.tssão rebaixados para que implementações canônicas apareçam primeiro.
Como o modelo de embeddings é estático, sem passagem direta de transformer no momento da consulta, tudo isso roda em milissegundos em CPU.
Os índices são armazenados em cache no disco automaticamente na primeira busca. Em execuções subsequentes, o Semble percorre a árvore de arquivos e compara os tempos de modificação; arquivos adicionados, removidos ou alterados são reindexados incrementalmente, sem reconstruir o resto do índice. Uma reconstrução completa só acontece se as configurações de indexação mudarem (ex.: após uma atualização do semble que altere o modelo, a divisão em trechos ou o formato do cache). No modo MCP, o índice é verificado e atualizado automaticamente conforme os arquivos mudam, então os resultados permanecem atuais durante a sessão.
Usando um modelo personalizado
Se você quiser usar outro modelo, pode definir sua variável de ambiente SEMBLE_MODEL_NAME para um caminho local ou repositório Hugging Face. Este caminho é lido literalmente e deve conter um modelo compatível com Model2Vec. Isso é particularmente útil se você não puder acessar o Hugging Face em tempo de execução.
Agradecimentos
Agradecemos à Greptile por fornecer acesso gratuito à sua plataforma de revisão de código com IA.
Licença
MIT
Citação
Se você usar o Semble em sua pesquisa, por favor cite o seguinte:
@software{minishlab2026semble,
  author       = {{van Dongen}, Thomas and Stephan Tulkens},
  title        = {Semble: Fast and Accurate Code Search for Agents},
  year         = {2026},
  publisher    = {Zenodo},
  doi          = {10.5281/zenodo.19785932},
  url          = {https://github.com/MinishLab/semble},
  license      = {MIT}
}