code context engine
Um servidor MCP local para agentes de codificação de IA. Indexação com reconhecimento de AST, busca semântica e compressão automática. Seu agente para de reler toda a sua base de código a cada sessão.
Documentação

Code Context Engine
Indexe sua base de código. A IA pesquisa em vez de reler arquivos.
94% de economia de tokens, com benchmark reproduzível.
Website · Docs · Por que CCE? · Benchmark · GitHub




Python 3.11+ · macOS · Linux · Windows




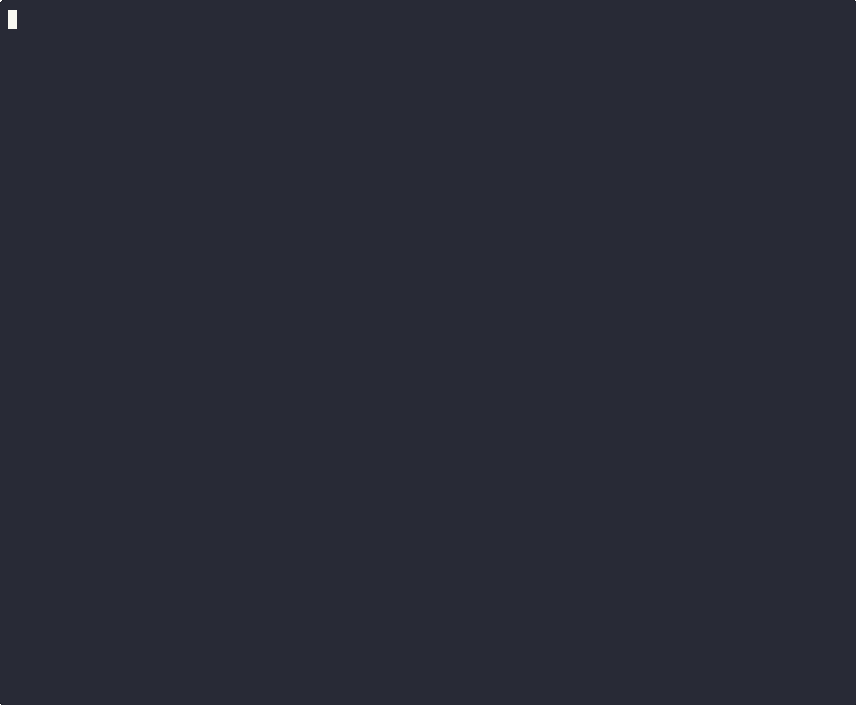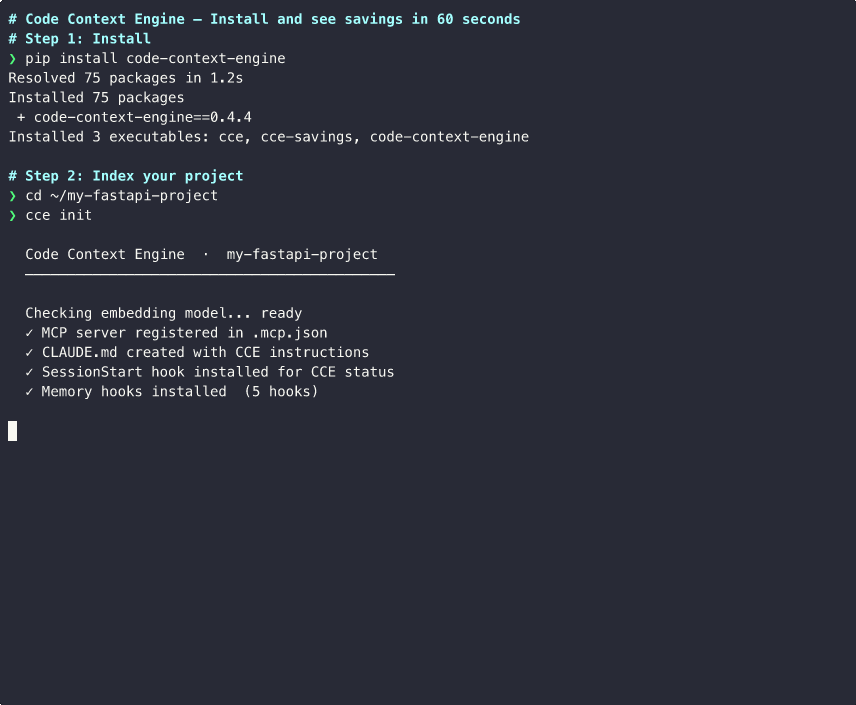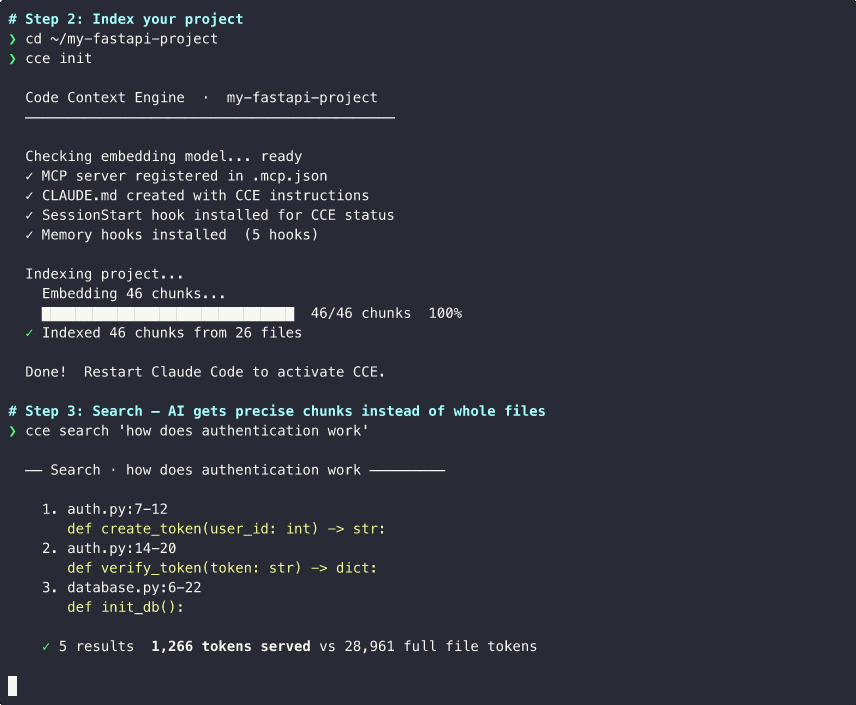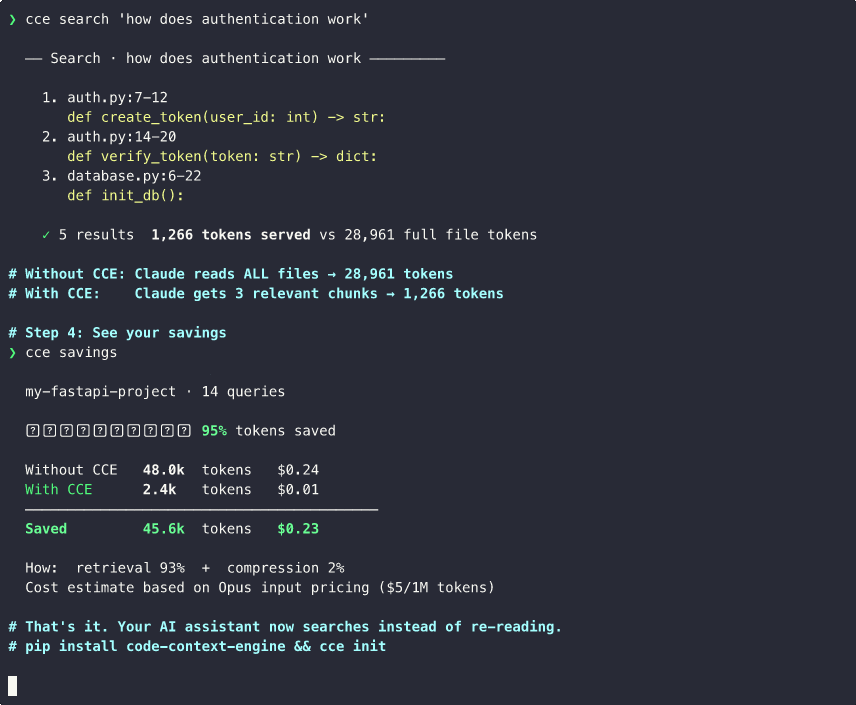
Um comando. Detecta seu editor automaticamente. Zero nuvem, zero configuração.
Palestra: Cortamos 94% dos Nossos Tokens de Codificação com IA — AI Engineer World's Fair 2026
Casos de uso
| Caso de uso | Como o CCE ajuda | |
|---|---|---|
| 💰 | Reduza custos do Claude Code | 94% menos tokens de entrada por sessão |
| 🔒 | Mantenha o código privado | Tudo local, sem indexação em nuvem |
| 🔄 | Equipes multi-editor | Um índice em Claude Code, Cursor, VS Code, Gemini CLI |
| 🧠 | Memória entre sessões | Decisões e contexto sobrevivem a reinicializações |
| ⚡ | Respostas mais rápidas | Menos contexto = respostas do Claude mais rápidas |
| 📊 | Acompanhe a economia real | Valores em dólares, não estimativas |
Início rápido
Um comando. 30 segundos.
uvx --from "code-context-engine[local]" cce init # install + index + configure, one shot
Ou, se preferir uma instalação persistente:
uv tool install "code-context-engine[local]"    # or: pipx install "code-context-engine[local]"
cd /path/to/your/project
cce init
Reinicie seu editor. Pronto. Agora cada pergunta consulta o índice em vez de reler arquivos.
Suporte a Agent Plugin: Execute
cce init --pluginpara gerar um diretório Agent Plugin portátil que funciona com VS Code, Cursor, Copilot, Codex, ChatGPT e Kiro. O plugin usauvxpara iniciar o CCE sob demanda, então os usuários não precisam pré-instalar o pacote Python. Veja Agent Plugin abaixo.
Já tem Ollama? Pule
[local]e useuv tool install code-context-engineem vez disso. O CCE detecta automaticamente o Ollama em localhost:11434 e usanomic-embed-text.
Requisitos do sistema
Python 3.11+ e um compilador C (para gramáticas tree-sitter).
| Plataforma | Configuração |
|---|---|
| macOS | xcode-select --install |
| Ubuntu/Debian | sudo apt install build-essential cmake |
| Fedora/RHEL | sudo dnf install gcc gcc-c++ cmake |
| Windows | Visual Studio Build Tools (carga de trabalho C++) + CMake |
Testado em macOS, Linux, Windows com Python 3.11/3.12/3.13.
cce init detecta seu editor automaticamente e grava a configuração correta. Para direcionar um
agente específico, use --agent claude, --agent codex, --agent copilot, --agent pi ou
--agent all.
| Editor | Configuração gravada | Instruções |
|---|---|---|
| Claude Code | .mcp.json | CLAUDE.md |
| VS Code / Copilot | .vscode/mcp.json | .github/copilot-instructions.md |
| Cursor | .cursor/mcp.json | .cursorrules |
| Gemini CLI | .gemini/settings.json | GEMINI.md |
| OpenAI Codex | ~/.codex/config.toml (global do usuário, seção por projeto) | AGENTS.md |
| OpenCode | opencode.json | |
| Tabnine | .tabnine/agent/settings.json | TABNINE.md |
| Pi | .mcp.json | AGENTS.md |
Vários editores no mesmo projeto? Todos são configurados com um único comando.
Nota sobre Codex: O Codex CLI lê servidores MCP apenas de ~/.codex/config.toml —
ele não tem configuração por projeto. cce init adiciona uma seção [mcp_servers.cce-<project>-<hash>]
por projeto para que vários projetos coexistam; cce uninstall remove apenas
a seção do projeto atual.
Nota sobre Pi: O Pi não suporta MCP nativamente. Para usar o CCE com o Pi, você precisa de uma
extensão de adaptador MCP para Pi (ex.: pi-mcp-adapter)
que consuma a configuração .mcp.json e exponha as ferramentas do CCE ao agente Pi.
cce init configura tanto .mcp.json quanto AGENTS.md (o Pi carrega o último
automaticamente para instruções de inicialização).
  my-project · 38 queries · last query 5m ago

  ⛁ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶  88% tokens saved

  Input savings   1.9M  tokens   $27.78
  Output savings  4.8k  tokens   $0.36
  ──────────────────────────────────────────
  Total saved   1.9M  tokens   $28.15

  Breakdown:
    retrieval              84%  ▰▰▰▰▰▰▰▰▰▰    1.8M   $26.76 · 12 calls
    chunk compression       3%  ▰▱▱▱▱▱▱▱▱▱   68.5k    $1.03 · 12 calls
    output compression*    <1%  ▰▱▱▱▱▱▱▱▱▱    4.8k    $0.36 · 12 calls

  Cost estimate based on Opus pricing (input $15.0/1M, output $75.0/1M)
Suporta preços de modelos Anthropic, OpenAI e Google. Configure via pricing.model em ~/.cce/config.yaml.
Por que isso importa
Tokens de entrada representam 85-95% da sua conta do Claude Code. O CCE os reduz em 94% (benchmark no FastAPI).
Without CCE:    Claude reads payments.py + shipping.py   = 45,000 tokens
With CCE:       context_search "payment flow"            =    800 tokens
| Sem CCE | Com CCE | |
|---|---|---|
| Inicialização da sessão | Relê arquivos toda vez | Consulta o índice |
| Encontrar uma função | Ler arquivo inteiro de 800 linhas | Obter a função de 40 linhas |
| Memória entre sessões | Nenhuma | Decisões + áreas de código persistidas |
| Custo de tokens (Sonnet, projeto médio) | ~$0.14/sessão | ~$0.04/sessão |
Benchmark: FastAPI (reproduzível)
Fizemos benchmark do CCE contra o FastAPI (53 arquivos-fonte, 180K tokens) com 20 perguntas reais de codificação. Sem cherry-picking, sem consultas sintéticas.
Metodologia: Para cada consulta, "sem CCE" significa ler o conteúdo completo de cada arquivo que a consulta toca. "Com CCE" significa os trechos relevantes após a compressão.
Nota importante sobre a linha de base: O número de 94% é medido contra leituras de arquivos completos, não contra o que o Claude Code realmente faz. Na prática, o Claude Code já usa grep, leituras parciais de arquivos e ferramentas direcionadas, então a economia no mundo real comparada ao comportamento normal do Claude Code será menor que 94%. Usamos arquivo completo como linha de base porque é reproduzível e determinístico (sem variabilidade de comportamento do agente). O benchmark mede a eficiência de recuperação do CCE, não uma comparação direta com a exploração integrada do Claude Code.
| Métrica | Resultado |
|---|---|
| Economia de recuperação | 94% (83,681 → 4,927 tokens/consulta) |
| Compressão (adicional, nos trechos recuperados) | 89% (4,927 → 523 tokens/consulta) |
| Recall@10 (encontrou os arquivos certos) | 0.90 |
| Latência p50 | 0.4ms |
| Consultas testadas | 20 |
Economia por Camada (cada uma medida independentemente)
| Camada | O que faz | Economia | Método |
|---|---|---|---|
| Recuperação | Arquivos completos → trechos de código relevantes | 94% | medido |
| Compressão de Trechos | Trechos brutos → assinaturas + docstrings | 89% | medido |
| Gramática | Remove artigos/preenchimentos do texto de memória | 13% | medido |
A compressão de saída (reduzindo o tamanho da resposta do Claude) proporciona economia adicional (~65% estimado), mas não está incluída no número principal acima.
Benchmarks multi-idioma
| Repo | Linguagem | Arquivos | Economia de recuperação | Recall@10 |
|---|---|---|---|---|
| FastAPI | Python | 53 | 94% | 0.90 |
| Django | Python (grande) | 2,347 | 93% | 0.95 |
| Express | JavaScript | 6 | 94% | 1.00 |
| chi | Go | 94 | 76% | 0.67 |
| fiber | Go (monorepo) | 396 | 93% | 0.07 |
O Django (2.347 arquivos, 5,4M tokens) mostra que o CCE escala para bases de código grandes com recall de 0,95. Os arquivos mais curtos do Go reduzem a margem de recuperação (linha de base menor). Monorepos diluem o recall no top-10 (fiber). Consultas de middleware com um recurso por arquivo atingem R=1,00 de forma consistente.
Reproduza você mesmo:
pip install code-context-engine
python benchmarks/run_benchmark.py --repo https://github.com/fastapi/fastapi.git --source-dir fastapi
python benchmarks/run_benchmark.py --repo https://github.com/go-chi/chi.git --source-dir .
Resultados completos em benchmarks/results/. Consultas e metodologia em benchmarks/.
O que você obtém
11 ferramentas MCP que o Claude usa automaticamente:
| Ferramenta | O que faz |
|---|---|
context_search | Busca híbrida vetorial + BM25 com expansão de grafo |
expand_chunk | Código-fonte completo para um resultado comprimido |
related_context | Encontre código via arestas do grafo (chamadas, imports) |
session_recall | Recupere decisões de sessões anteriores |
session_timeline | Navegue pelos resumos de turnos de uma sessão (aprofunde-se nos resultados de recall) |
session_event | Inspecione entrada/saída bruta da ferramenta para um evento específico |
record_decision | Salve uma decisão para sessões futuras |
record_code_area | Registre em quais arquivos foram trabalhados |
index_status | Verifique a atualização do índice |
reindex | Re-indexe um arquivo ou o projeto inteiro |
set_output_compression | Ajuste a verbosidade da resposta (off / lite / standard / max) |
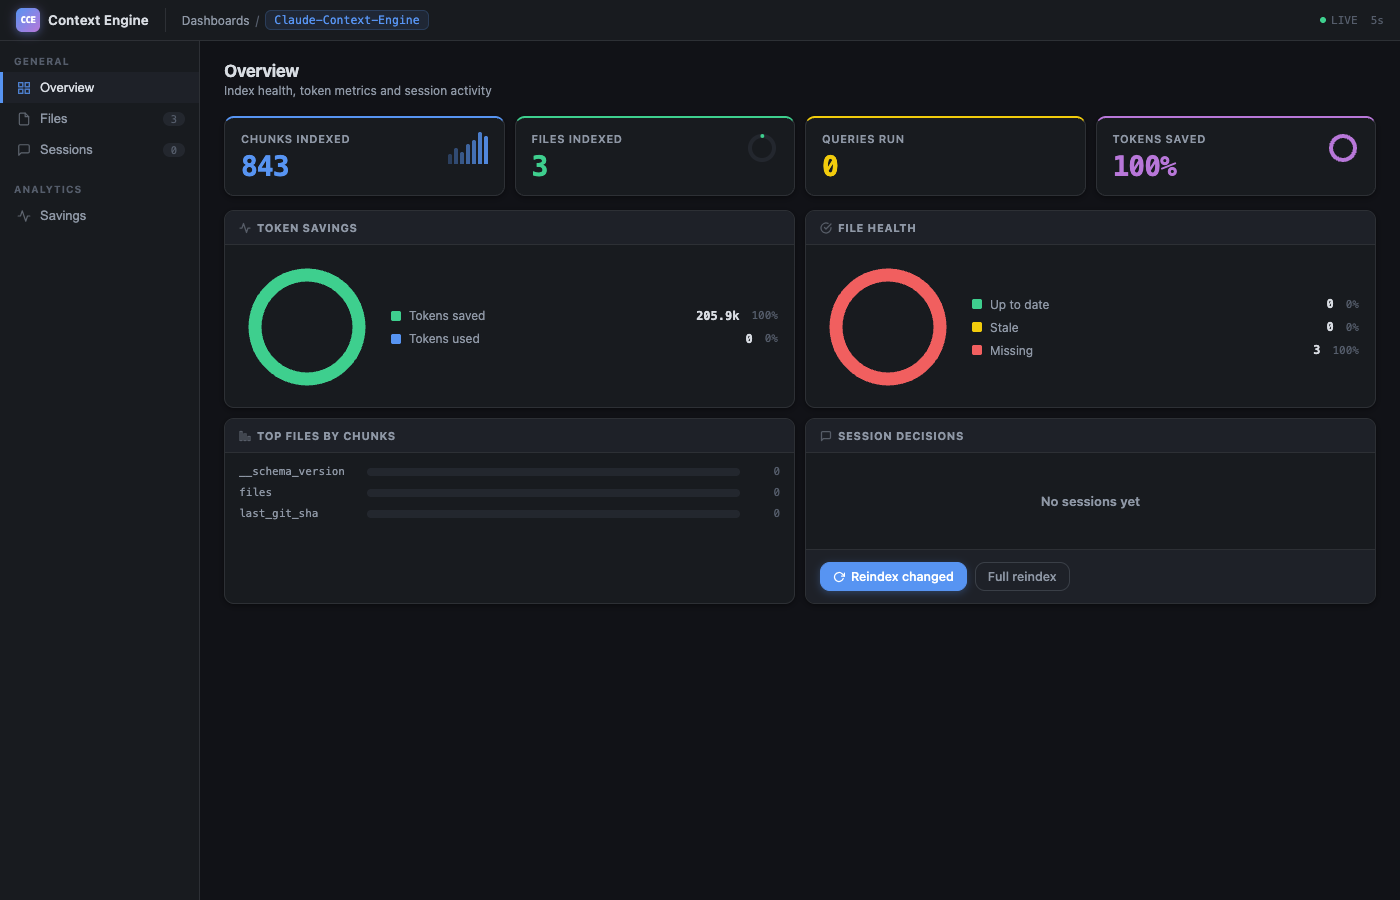
Dashboard ao vivo com gráficos de rosca, saúde dos arquivos e histórico de sessões:
cce dashboard
Estimativas em dólares com preços de múltiplos provedores (Anthropic, OpenAI, Google):
cce savings --all # see savings across all projects
Como funciona
- Indexação: O Tree-sitter analisa seu código em trechos semânticos (funções, classes, módulos). Armazenados como embeddings vetoriais localmente.
- Busca: O Claude chama
context_search. A recuperação híbrida vetorial + BM25 encontra os trechos certos. O grafo de código adiciona arquivos relacionados automaticamente. - Compressão: Os trechos são truncados para assinaturas + docstrings (ou resumidos por LLM se o Ollama estiver em execução).
- Memória: Decisões e áreas de código persistem entre sessões via
session_recall. - Acompanhamento: Cada consulta é registrada.
cce savingsmostra exatamente quanto você economizou.
A re-indexação após edições leva menos de 1 segundo (96% de taxa de acerto no cache de embeddings). Git hooks mantêm o índice atualizado automaticamente.
O que torna o CCE diferente
Ele economiza onde está o dinheiro
Ferramentas de compressão de saída (como Caveman) economizam 20-75% nos tokens de saída. A saída é 5-15% da sua conta. Economia líquida: ~11%.
O CCE economiza nos tokens de entrada (94% de economia na recuperação no FastAPI, benchmark reproduzível). A entrada é 85-95% da sua conta.
Ele realmente entende seu código
Não é uma busca de texto. A análise AST do Tree-sitter cria trechos semânticos. A recuperação híbrida combina similaridade vetorial com correspondência de palavras-chave BM25 via Reciprocal Rank Fusion. Um avaliador de confiança combina similaridade (50%), correspondência de palavras-chave (30%) e recência (20%). A expansão de grafo percorre arestas CALLS/IMPORTS para trazer código relacionado.
Ele lembra
record_decision("use JWT for auth", reason="session tokens flagged by legal") é armazenado em SQLite e aparece via session_recall na próxima sessão. Sem precisar reexplicar sua arquitetura.
Ele acompanha a economia real
Não são estimativas. Tokens reais servidos vs. linha de base de arquivo completo, divididos por categorias (recuperação, compressão, saída, memória, gramática). Custos em dólares obtidos da página de preços da Anthropic. Resumo de economia exibido no início de cada sessão.
É seguro por padrão
Arquivos secretos (.env, *.pem, credentials.json) nunca são indexados. O conteúdo é verificado em busca de chaves AWS, tokens GitHub, tokens Slack, chaves Stripe, JWTs e credenciais genéricas. PII (emails, IPs, SSNs, cartões de crédito) é removida das gravações de memória. Todos os caminhos de arquivo MCP são validados contra path traversal.
Por baixo dos panos
Content-Hash Embedding Cache
SHA-256 fingerprint por chunk, com salt do nome do modelo. Reindexação ignora código inalterado. Armazenamento binário float32 (10x menor que JSON). Reindexação típica: 96% de cache hit, menos de 1 segundo.sqlite-vec: 2 MB em vez de 217 MB
Substituímos LanceDB por sqlite-vec. Mesma qualidade de distância de cosseno, instalação 99% menor. Modo WAL + PRAGMA NORMAL para 80% de aceleração de escrita. Vetores, FTS5, grafo de código e cache de compressão, tudo em três arquivos SQLite.
Compressão Gramatical Determinística
Entradas de memória comprimidas sem chamadas de LLM. Remove artigos, palavras de preenchimento e pronomes. Três níveis (lite/full/ultra, economia de 20-60%). Código, caminhos e URLs preservados byte a byte. A mesma entrada sempre produz a mesma saída.
Design de Hook Fail-Closed
5 hooks de ciclo de vida do Claude Code capturam o contexto da sessão. Cada hook executa curl ... || true, então um servidor que falhou nunca bloqueia o usuário. SessionStart injeta o contexto de bootstrap; os demais capturam silenciosamente.
Preços Multi-Provedor
Estimativas em dólares em cce savings suportam mais de 15 modelos da Anthropic, OpenAI e Google. Preços estáticos acompanham o CCE, preços ao vivo da Anthropic são buscados e armazenados em cache por 7 dias. Configure pricing.model (ex.: gpt-4o, gemini-2.5-pro, sonnet) ou substitua com pricing.input / pricing.output para taxas personalizadas.
Governador de Recursos (Segurança Multi-Instância)
Executar dezenas de processos cce serve (um por projeto por sessão de IA) pode esgotar a memória do sistema. O governador de recursos limita os threads do ONNX Runtime por processo, usa bloqueios de arquivo consultivos para que apenas um processo indexe um determinado projeto por vez, reduz a carga sob pressão de memória do Linux (PSI) e desliga automaticamente servidores ociosos após 30 minutos. Configure via serve.idle_timeout_minutes e serve.max_ort_threads.
Lembretes de Memória
A memória entre sessões do CCE depende do agente chamar record_decision e record_code_area. Os lembretes de memória tornam o registro ambiente: após N buscas sem um registro, os resultados de context_search incluem um lembrete curto. No final da sessão, o hook Stop resume a atividade não registrada. Os lembretes são rearmados após o primeiro registro para continuarem úteis sem serem intrusivos.
Endpoint de Busca HTTP
cce serve --http expõe um endpoint POST /search para integrações de agentes personalizados que falam HTTP em vez de MCP stdio. Mesmo pipeline de recuperação híbrida, resposta JSON estruturada com pontuações de confiança. A validação de entrada limita top_k (1..100) e confidence_threshold (0.0..1.0).
Registro de Economia Append-Only
7 categorias rastreiam cada token economizado: recuperação, compressão de chunk, compressão de saída, recall de memória, gramática, sumarização de turno, divulgação progressiva. Sobrevive a reinicializações. Alimenta análises de CLI e painel.
Plugin de Agente
Agent Plugins é um padrão aberto (v1.0.0) apoiado por Amazon, Cursor, Microsoft, OpenAI e Vercel para empacotar habilidades de IA e servidores MCP em pacotes portáteis e de instalação zero. O CCE pode gerar um diretório de plugin que editores compatíveis podem descobrir e carregar automaticamente.
cce init --plugin                          # Generate at .cce/plugin/
cce init --plugin --plugin-dir ~/plugins/cce  # Custom location
cce init --agent claude --plugin           # Both: agent config + plugin
O que é gerado
.cce/plugin/
├── plugin.json                       # Agent Plugins v1.0.0 manifest
├── mcp.json                          # MCP server config (uvx + stdio)
├── skills/
│   └── code-context/
│       ├── SKILL.md                  # Agent instructions (frontmatter + body)
│       └── references/
│           └── tools.md              # Per-tool parameter docs (loaded on demand)
└── LICENSE
Editores compatíveis
VS Code, GitHub Copilot, ChatGPT, Codex, Cursor e Kiro. O plugin usa uvx para iniciar o CCE sob demanda, então os usuários não precisam pré-instalar o pacote Python. O servidor MCP descobre automaticamente a raiz do projeto subindo a partir do diretório de trabalho, procurando por .context-engine.yaml ou .git/.
Quando usar --plugin vs --agent
--agent (padrão) | --plugin | |
|---|---|---|
| Método de instalação | Escreve arquivos de configuração específicos do editor | Gera um diretório de plugin portátil |
| Instalação zero | Não, o CCE deve estar no PATH | Sim, uvx busca o CCE sob demanda |
| Atualizações de instruções | Desatualizado até cce init ser executado novamente | Desatualizado até cce init --plugin ser executado novamente |
| Melhor para | Sua própria máquina | Compartilhar com uma equipe ou distribuir |
Ambos podem ser usados juntos. --agent lida com a configuração MCP por editor, --plugin fornece uma alternativa portátil.
CLI em resumo
cce init                    # Index + install hooks + register MCP
cce init --plugin           # Generate Agent Plugin for VS Code, Cursor, etc.
cce                         # Status banner
cce savings                 # Token savings with dollar estimates
cce savings --all           # All projects
cce dashboard               # Web dashboard with live charts
cce search "auth flow"      # Test a query
cce status                  # Index health + config
cce services                # Ollama + dashboard + MCP status
cce commands add-rule '...' # Project rules for Claude
cce uninstall               # Clean removal of all CCE artifacts
Execute cce list para a referência completa de comandos.
Configuração
Zero configuração por padrão. Substitua o que precisar em ~/.cce/config.yaml ou .context-engine.yaml:
compression:
  level: standard          # minimal | standard | full
  output: standard         # off | lite | standard | max
  ollama_url: http://localhost:11434   # point at a remote Ollama if desired

retrieval:
  top_k: 20
  confidence_threshold: 0.5

pricing:
  model: opus              # opus | sonnet | haiku | gpt-4o | gemini-2.5-pro | ...
  # input: 15.0            # override $/1M input tokens
  # output: 75.0           # override $/1M output tokens
Ollama remoto: Se você executa o Ollama em outra máquina da sua rede, defina compression.ollama_url (ex.: http://nas.local:11434) ou exporte CCE_OLLAMA_URL (a variável de ambiente vence). O CCE testa o endpoint e cai para compressão apenas por truncamento quando ele está inacessível, então um link instável não quebra a indexação.
Compressão de Saída
O CCE também comprime as respostas do Claude (mesmo conceito do Caveman):
| Nível | Estilo | Economia |
|---|---|---|
off | Saída completa | 0% |
lite | Sem preenchimento ou hesitação | ~30% |
standard | Fragmentos, remove artigos | ~65% |
max | Telegráfico | ~75% |
Diga ao Claude: "mude para compressão máxima" ou "desligue a compressão". Blocos de código e comandos nunca são comprimidos.
Espaço em Disco
| Componente | Tamanho |
|---|---|
| Instalação principal (backend Ollama) | ~17 MB |
Com extra [local] (fastembed + ONNX) | ~189 MB |
| Modelo de embedding (download único) | ~60 MB (fastembed) ou gerenciado pelo Ollama |
| Índice por projeto (pequeno/médio/grande) | 5-60 MB |
Nenhuma GPU necessária. Com Ollama, os embeddings são tratados pelo servidor Ollama. Com o extra [local], o modelo de embedding roda na CPU via ONNX Runtime.
Idiomas Suportados
Chunking ciente de AST (analisado por tree-sitter, 11 extensões):
| Idioma | Extensões |
|---|---|
| Python | .py |
| JavaScript | .js, .jsx |
| TypeScript | .ts, .tsx |
| PHP | .php |
| Go | .go |
| Rust | .rs |
| Java | .java |
| C# | .cs |
Chunking de fallback ciente de idioma (40+ extensões):
| Categoria | Idiomas |
|---|---|
| Web | HTML, CSS, SCSS, LESS, Vue, Svelte |
| Sistemas | C, C++, Zig, Nim |
| Mobile | Swift, Kotlin, Dart |
| Funcional | Haskell, Scala, Clojure, Elixir, Erlang, F# |
| Scripts | Ruby, Perl, Lua, R, Bash/Zsh |
| Dados/Config | JSON, YAML, TOML, XML, SQL, GraphQL, Protobuf |
| DevOps | Terraform, HCL, Dockerfile |
| Docs | Markdown |
Todos os outros arquivos de texto são divididos por intervalo de linhas. Arquivos binários são ignorados.
Documentação
| Página | Conteúdo |
|---|---|
| Quanto Você Está Gastando em Tokens de Codificação com IA? | A matemática de tokens de entrada vs saída |
| O que é CCE? (Guia Completo) | Configuração, ferramentas, como funciona, FAQ |
| Como Economizar Tokens do Claude Code | Detalhamento de custos e guia de economia |
| Análise Aprofundada de Benchmarks | Metodologia completa de benchmark FastAPI |
| Comparação com Alternativas | CCE vs Cursor, Aider, Continue, Greptile |
| Exemplos | Conversas reais com Claude |
| Como Funciona | Pipeline completo de 9 estágios |
| Referência CLI | Todos os comandos com saída |
| Configuração | Todas as opções de configuração |
FAQ
O CCE afeta a qualidade das respostas?
Não. A qualidade permanece a mesma ou melhora ligeiramente.
O CCE substitui "despejar o arquivo inteiro" por "buscar a função relevante". O modelo ainda recebe o código de que precisa (0,90 Recall@10 em benchmarks). Menos contexto irrelevante significa menos ruído competindo por atenção, o que pode melhorar o foco do modelo na sua pergunta real.
Como funciona a economia de tokens de saída?
O CCE escreve regras de compressão de saída diretamente nos arquivos de instrução do seu agente (CLAUDE.md, AGENTS.md, .cursorrules, etc.) durante cce init. Essas regras se aplicam à sessão inteira, não apenas às respostas das ferramentas do CCE, então cada resposta do agente as segue.
Defina o nível em ~/.cce/config.yaml ou .context-engine.yaml:
compression:
  output: max       # off | lite | standard | max
Depois execute novamente cce init para atualizar os arquivos de instrução. Ou altere em tempo de execução:
set_output_level output_level=max
| Nível | Economia | O que faz |
|---|---|---|
off | 0% | Sem compressão |
lite | ~25% | Remove preenchimento/hesitação/formalidades + apenas diff para mudanças de código |
standard | ~70% | Remove artigos, fragmentos, sinônimos curtos + apenas diff para código |
max | ~80% | Estilo telegráfico + apenas diff para código |
Padrão é standard. Todos os níveis incluem regras de saída de código que dizem ao modelo para mostrar apenas linhas alteradas (não reescritas completas de arquivos), que é onde a maioria dos tokens de saída vai em sessões de codificação. O nível max produz prosa muito concisa (semelhante ao "modo homem das cavernas"). Blocos de código, caminhos e comandos nunca são comprimidos, independentemente do nível.
De onde vêm as economias?
A maioria das economias são tokens de entrada (o que entra no modelo):
| Camada | Tipo | Economia típica |
|---|---|---|
| Recuperação | Entrada | 94% (arquivos completos → chunks relevantes) |
| Compressão de chunk | Entrada | 89% (chunks → assinaturas) |
| Compressão gramatical | Entrada | 13% (remoção de artigos/preenchimento) |
| Sumarização de turno | Entrada | varia (histórico da sessão) |
| Divulgação progressiva | Entrada | varia (cargas de ferramentas) |
| Compressão de saída | Saída | 25-80% (depende do nível) |
Tokens de saída custam 5x mais por token (ex.: Opus: $15/1M entrada vs $75/1M saída), então mesmo uma pequena redução na saída tem impacto de custo desproporcional.
Roadmap
- Benchmarks multi-repo (FastAPI, chi, fiber)
- Mais benchmarks (Django, Express)
- Suporte tree-sitter para C, C++, Ruby, Swift, Kotlin
- Suporte Docker para modo remoto
- Portar para API mcp 2.x
Veja CHANGELOG.md para recursos já lançados.
Contribuindo
Contribuições são bem-vindas. Veja https://github.com/elara-labs/code-context-engine/blob/main/CONTRIBUTING.md para configuração.
Licença
MIT. Veja LICENSE.
Autores
Agradecimentos
Claude Code · MCP · sqlite-vec · Tree-sitter · fastembed · Ollama
Se o CCE economiza tokens para você, dê uma estrela.