Compendio MCP
Indexa a documentação markdown de um projeto e a expõe a agentes: busca híbrida em linguagem natural (BM25 + semântica), um mapa de todo o corpus de documentos e leituras em nível de seção, para que agentes encontrem os documentos certos sem carregar arquivos inteiros no contexto.
Documentação
A documentação do seu projeto, entregue a qualquer agente no menor número possível de tokens.
Uma camada local de recuperação RAG exposta como um servidor MCP. Seu agente para de fazer grep e despejar arquivos inteiros — ele chega ao parágrafo certo.



O que faz • Requisitos • Início rápido • Configuração • Ferramentas MCP • CLI • Como funciona • Sincronização incremental • Multilíngue • Documentação completa
O problema
Seu agente não conhece sua documentação. Então ele faz o que pode: grep, depois cat um arquivo de 400 linhas para responder a uma pergunta que estava em um parágrafo. Três arquivos depois, a janela de contexto está cheia de ruído e a resposta ainda é um palpite.
Anexar a pasta docs/ inteira não resolve — apenas move o desperdício para antes. Busca por palavras-chave também não: ninguém escreve perguntas usando exatamente as palavras que o documento usa.
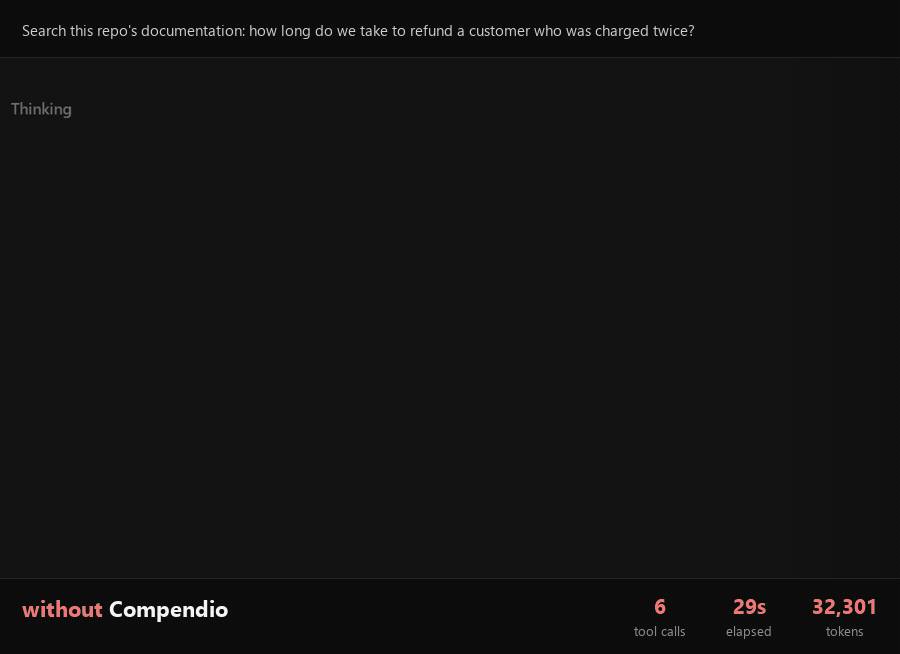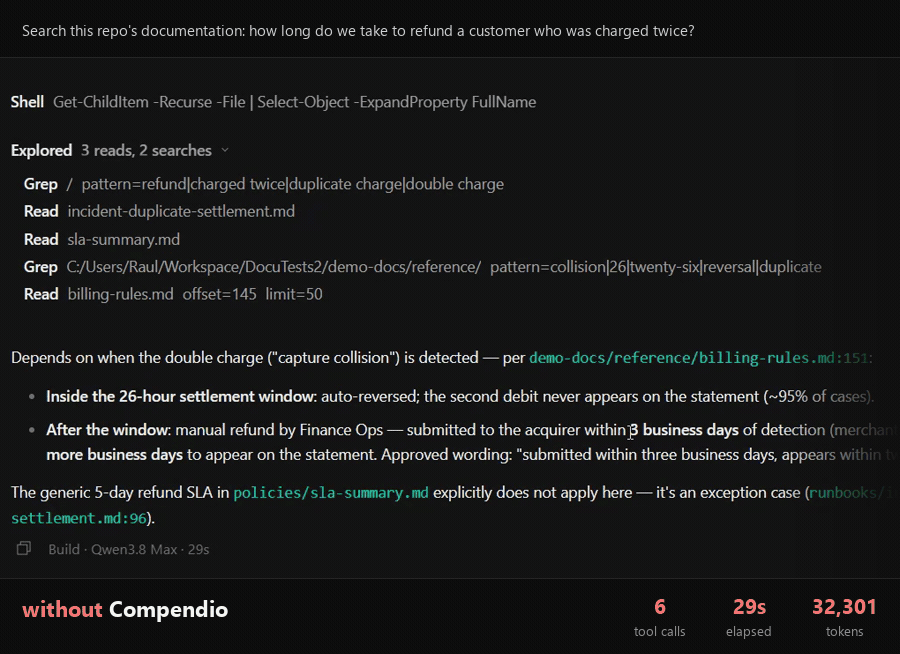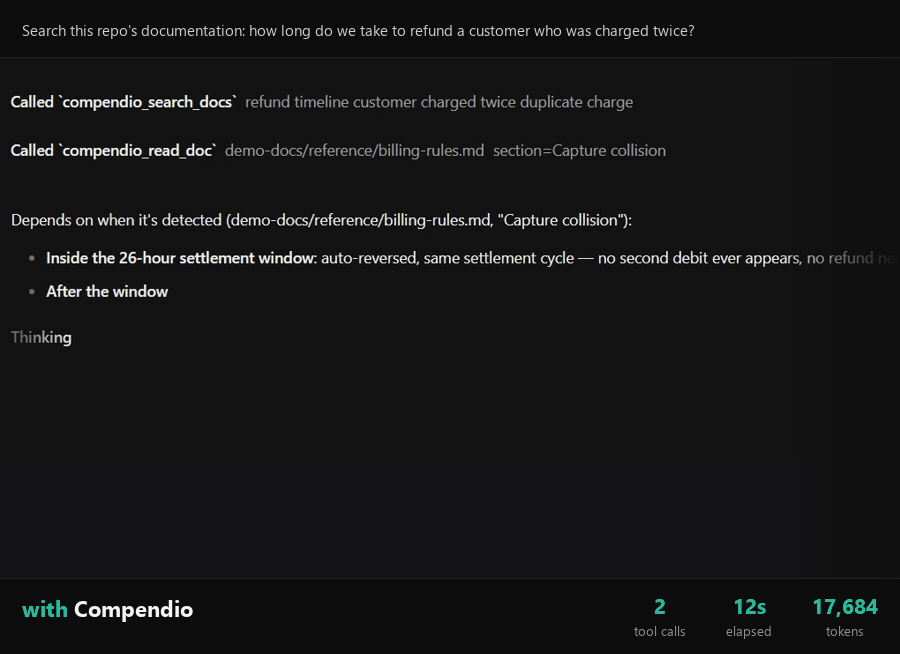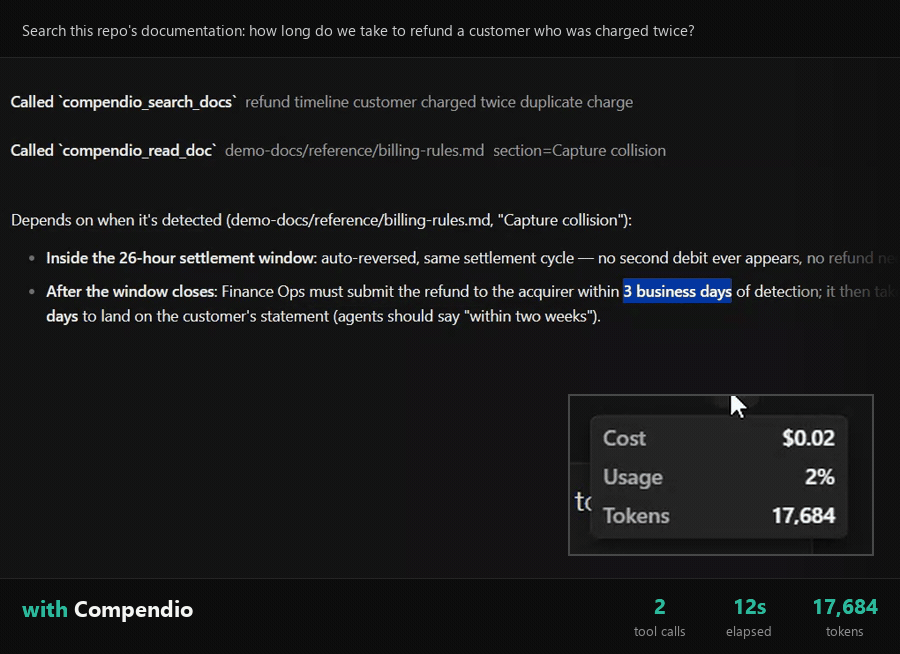
Mesma pergunta, mesmo modelo, e ambas as respostas estão corretas — a diferença é o custo para chegar lá.
6 chamadas de ferramenta • 29s • 32.301 tokens → 2 chamadas de ferramenta • 12s • 17.684 tokens.
Números lidos do próprio rótulo de tempo decorrido e dica de custo do OpenCode, em um corpus de 81 documentos.
O que o Compendio faz
O Compendio indexa sua documentação em Markdown e dá a qualquer agente de IA três ferramentas para encontrar e ler exatamente o que ele precisa.
- 🔍 Recuperação híbrida, não grep — busca por palavras-chave encontra o termo exato, busca semântica encontra a paráfrase. O Compendio executa ambas e mescla os resultados.
- ✂️ Econômico em tokens por design — oriente-se com ~10 tokens por documento, busque por alguns fragmentos, leia uma única seção. Nunca o corpus inteiro.
- 🔒 100% local — um único arquivo SQLite, embeddings na CPU, zero chamadas de rede em tempo de consulta. Sem chaves de API, sem Docker, sem serviços, nada sai da sua máquina.
- ♻️ Mantém-se atualizado — um servidor em execução capta suas edições de documentação sozinho. Sem processo de observação, sem loop de reconstrução manual.
- 🗣️ Multilíngue — indexe documentação em qualquer idioma. O modelo de embeddings é multilíngue e a busca é insensível a diacríticos. Veja Multilíngue.
- 🧩 Zero configuração — funciona em qualquer pasta de arquivos
.md. Sem frontmatter obrigatório, sem arquivo de configuração. Uma convenção de documentação opcional existe se sua equipe já tiver uma taxonomia para impor.
Requisitos
- Node.js ≥ 22.12.
- Nada mais.
Início rápido
1. Instale.
npm install -g compendio-mcp
Para atualizar o Compendio depois, execute o mesmo comando novamente — ele sempre baixa a versão publicada mais recente.
2. Registre-o como um servidor MCP no seu cliente, apontando para a raiz do seu projeto.
Claude Code (.mcp.json na raiz do repositório ou {USER_FOLDER} .claude.json para instalação global):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Claude Desktop (~/Library/Application Support/Claude/claude_desktop_config.json no macOS, %APPDATA%\Claude\claude_desktop_config.json no Windows — ou Configurações → Desenvolvedor → Editar Config):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
OpenCode (opencode.json):
{
  "mcp": {
    "compendio": {
      "type": "local",
      "command": ["compendio", "serve"],
      "enabled": true
    }
  }
}
VS Code / Copilot (.vscode/mcp.json):
{
  "servers": {
    "compendio": {
      "type": "stdio",
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Cursor (.cursor/mcp.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Codex (.codex/config.toml):
[mcp_servers.compendio]
command = "npx"
args = ["compendio-mcp", "serve"]
enabled = true
startup_timeout_sec = 60
Windsurf (~/.codeium/windsurf/mcp_config.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Zed (settings.json, ou Configurações → IA → Servidores MCP → Adicionar Servidor Personalizado):
{
  "context_servers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"],
      "env": {}
    }
  }
}
Cline (ícone de Servidores MCP → Configurar → Configurar Servidores MCP; a CLI lê ~/.cline/mcp.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
Gemini CLI (.gemini/settings.json no projeto, ou ~/.gemini/settings.json):
{
  "mcpServers": {
    "compendio": {
      "command": "compendio",
      "args": ["serve"]
    }
  }
}
3. Construa o índice uma vez, a partir da raiz do projeto:
compendio index
É isso. Sem arquivo de configuração, o Compendio descobre automaticamente pastas de nível superior que contêm arquivos Markdown — sem docs/ oculto padrão necessário. Adicione .compendio/ ao seu .gitignore.
Por que esta etapa existe. O servidor também indexa na inicialização, então, estritamente falando, você poderia pular — mas a primeira execução baixa e armazena em cache o modelo de embeddings (dezenas de MB), e quem o acionar espera. Executá-lo aqui paga esse custo no seu terminal, com uma barra de progresso, em vez de dentro da primeira chamada de ferramenta do seu agente. A partir daí, tudo fica offline e o índice se mantém atualizado (abaixo).
Nota para Windows. Alguns clientes MCP não conseguem iniciar o shim
compendio.cmddiretamente. Se o servidor falhar ao iniciar comENOENT, use"command": "npx"com"args": ["compendio-mcp", "serve"].
Configuração
Totalmente opcional — o Compendio funciona sem nenhum arquivo de configuração. Crie compendio.config.json na raiz do seu projeto apenas para substituir o que precisar:
{
  "docsDir": ["docs"],
  "exclude": ["INDEX.md"],
  "db": ".compendio/compendio.db",
  "embeddings": { "provider": "local", "model": "Xenova/multilingual-e5-small" },
  "chunk": { "minTokens": 100, "maxTokens": 480 },
  "search": { "k": 5 },
  "sync": { "throttleMs": 30000 },
  "convention": {
    "mode": "loose",
    "excludedStatuses": [],
    "frontmatterFields": { "type": "type", "module": "module", "status": "status" }
  }
}
| Chave | Para que serve |
|---|---|
docsDir | Uma ou mais raízes de documentação explícitas, relativas à raiz do projeto. Sempre um array — não existe forma de string única. Omita ou defina [] para usar o modo de descoberta |
exclude | Entradas para ignorar ao indexar: um caminho exato, um nome de arquivo simples (correspondido em qualquer lugar) ou um prefixo de diretório (ex.: "adr/superseded" ignora tudo abaixo dele) |
db | Onde o arquivo de índice SQLite é gravado |
search.k | Número padrão de fragmentos retornados por busca |
chunk | Limites de tamanho de fragmento, em tokens |
sync.throttleMs | Tempo mínimo entre passadas de sincronização automática, em ms (30000 = 30 s). Um piso, não um temporizador — limita apenas os gatilhos automáticos de serve, não um compendio sync executado manualmente — veja Sincronização incremental |
convention | Taxonomia de documentação opcional — veja abaixo |
Declarar apenas parte do bloco convention mescla com os padrões campo a campo; nunca apaga os irmãos que você não mencionou. frontmatterFields mapeia type/module/status para chaves de frontmatter não padrão (ex.: { "status": "estado" } lê o campo estado: de um documento em espanhol como status).
Toda chave numérica (search.k, chunk.minTokens, chunk.maxTokens, sync.throttleMs) é respeitada apenas quando é um número finito maior que 0 — search.k deve adicionalmente ser um número inteiro. Qualquer outra coisa, incluindo um número entre aspas como "480", volta ao padrão exatamente como uma chave ausente faria, e o fallback é relatado: no stderr para cada comando CLI, e na resposta de docs_overview para um cliente MCP. Uma chave não reconhecida sob embeddings, chunk ou convention.frontmatterFields (um erro de digitação como maxtokens) é relatada da mesma forma. Uma configuração sem nada errado não relata nada.
Múltiplas raízes de documentação
Declare mais de uma raiz para indexar várias pastas — adr/, rfcs/, um diretório de especificações — como um único corpus pesquisável:
{ "docsDir": ["docs", "openspec"], "exclude": ["INDEX.md", "openspec/changes/archive"] }
Todo documento path é prefixado com o alias da sua raiz — o próprio nome do diretório, então docs/x.md e openspec/specs/y.md ambos são lidos como o caminho real relativo ao projeto. Isso vale com uma única raiz explícita e com raízes descobertas também: openspec/specs/y.md, não specs/y.md. search_docs, docs_overview, read_doc e o INDEX.md gerado usam todos essa forma prefixada; passar um path de volta para read_doc exatamente como retornado sempre resolve.
Raízes declaradas não podem colidir: duas raízes resolvendo para o mesmo diretório, uma aninhada dentro da outra (em qualquer ordem de declaração), ou duas raízes compartilhando o mesmo nome de diretório (e portanto o mesmo alias) são todas rejeitadas antes de qualquer indexação. Uma raiz que é declarada mas não pode ser lida (um erro de digitação, ou uma pasta que apenas alguns checkouts têm) é relatada e ignorada — a execução continua nas raízes restantes, e só lança erro se toda raiz declarada falhar. Remover uma raiz de docsDir exclui seus documentos na próxima passada de sincronização, assim como excluir os próprios arquivos faria.
No modo de descoberta, o Compendio reexamina pastas de nível superior em toda passada de sincronização index, sync e serve, seleciona aquelas com arquivos .md em qualquer lugar abaixo delas, ignora conteúdo com symlink e pastas geradas/internas como .git, .compendio, node_modules, dist, build e coverage, e grava INDEX.md na raiz do projeto. A descoberta falha de forma segura: JSON de config de nível superior malformado, árvores candidatas ilegíveis, falhas de travessia/leitura, ou uma raiz descoberta previamente indexada que desaparece ou se torna um symlink/junction antes da sincronização abortam antes de mutar o índice. Uma raiz previamente indexada que ainda é um diretório legível ainda é percorrida mesmo após seu último arquivo Markdown ser excluído, então exclusões legítimas são reconciliadas normalmente. As verificações de symlink usam lstat/realpath no momento da varredura/travessia, mas não são uma sandbox em nível de kernel; uma corrida de sistema de arquivos entre verificação e leitura permanece fora do escopo. --dir <path> (abaixo) é o modo explícito: substitui todo o conjunto de raízes declaradas/descobertas por aquele único diretório e grava INDEX.md dentro dele.
Funciona com seu framework SDD
Frameworks de desenvolvimento orientado a especificações mantêm seus artefatos de planejamento em Markdown, que é exatamente o que o Compendio indexa. Aponte docsDir para as pastas que seu framework grava:
| Framework | Config | Indexa |
|---|---|---|
| Spec Kit | { "docsDir": ["specs", ".specify"] } | Especificações de recursos, planos e tarefas sob specs/NNN-feature/, além da constituição em .specify/memory/constitution.md |
| OpenSpec | { "docsDir": ["openspec"] } | openspec/project.md, especificações de capacidade e mudanças em andamento |
| Kiro | { "docsDir": [".kiro"] } | requirements.md/design.md/tasks.md por recurso sob .kiro/specs/, além de .kiro/steering/ |
| BMAD | { "docsDir": ["docs"] } | PRD, arquitetura, épicos fragmentados e histórias |
| Framework + seus próprios docs | { "docsDir": ["docs", "openspec"] } | Ambos, como um único corpus pesquisável |
Diretórios ocultos como .specify/ e .kiro/ são indexados normalmente, tanto como raízes declaradas quanto no modo de descoberta — entradas dentro de uma raiz com prefixo de ponto são o que é ignorado, não a raiz em si. Então, sem nenhum arquivo de configuração, um projeto Spec Kit ou Kiro já é indexado.
Três coisas que vale a pena saber antes de copiar uma linha:
- O alias de uma raiz é o nome do diretório, não o caminho declarado.
.kiro/specstem o aliasspecs, então seus documentos retornam comospecs/auth/design.md. Isso também significa que ele colide com uma raizspecs/de nível superior e não pode ser combinado com o Spec Kit — declare.kiroem vez disso, que é o que a tabela faz. - A pasta de saída do BMAD é configurável.
docsé o padrão; o BMAD v6 lêoutput_folderda própria configuração, então declare o que estiver definido no seu caso. - Templates são ruído.
.specify/templates/contém scaffolding de espaço reservado, não conhecimento do projeto. Adicione"exclude": [".specify/templates", ".specify/scripts"]se preferir que eles fiquem fora dos resultados de busca.
Convenção de documentação (opcional)
Dois modos, selecionados por convention.mode:
loose(padrão, zero-configuração) — nunca rejeita um arquivo por metadados ausentes. O título vem do primeiro H1 (com fallback para um nome de arquivo humanizado), o módulo é inferido da pasta, etype/statussão lidos do frontmatter quando presentes e deixados ausentes caso contrário.strict(opt-in) — um linter: todo documento precisa de um H1 etype/module/statusnão vazios, validados contra as listas que seu projeto declara. Arquivos que falham são ignorados e relatados, nunca interrompem a execução.
{
  "convention": {
    "mode": "strict",
    "types": ["functional", "adr", "api", "qa", "guide"],
    "statuses": ["draft", "current", "deprecated"],
    "excludedStatuses": ["draft", "deprecated"]
  }
}
excludedStatuses oculta documentos da busca por estado de ciclo de vida — rascunhos e páginas descontinuadas param de poluir os resultados. Veja docs/documentation-convention.md para a convenção completa que a documentação deste repositório segue.
Ferramentas MCP
Projetadas como divulgação progressiva: oriente-se barato → busque barato → leia apenas o necessário.
1. docs_overview() — o mapa do corpus. Contagens por tipo e módulo, mais uma linha por documento. Aproximadamente 10 tokens por documento.
2. search_docs({ query, type?, module?, tags?, k?, include_excluded? }) — os k principais fragmentos (5 por padrão, no máximo 2 por documento), cada um com caminho, seção, trecho e pontuação. type é uma string aberta definida pelo projeto, não uma lista fixa.
3. read_doc({ path, section? }) — uma seção, ou o documento inteiro. Um documento grande com seções (acima de ~6.000 tokens estimados) retorna um resumo compacto de seus cabeçalhos H2/H3 em vez do corpo, para que o agente leia apenas as seções necessárias. Um caminho que não existe retorna os 3 caminhos mais semelhantes em vez de um erro, para que o agente se autocorrija em vez de tentar novamente às cegas.
CLI
| Comando | O que faz |
|---|---|
compendio serve | Inicia o servidor MCP via stdio |
compendio index | Reconstrução completa do índice |
compendio sync | Executa uma passada de sincronização incremental pelo terminal — sincroniza apenas os documentos cujo conteúdo mudou, com progresso ao vivo. Veja Sincronização incremental |
compendio search "..." | Busca híbrida com filtros: --type, --module, --tags, -k, --all |
compendio overview | Mapa do corpus indexado |
compendio index-md | Gera ou atualiza um INDEX.md combinado: INDEX.md na raiz do projeto em modo de descoberta, ou INDEX.md dentro da primeira raiz explícita/--dir — uma linha por documento |
compendio eval | Mede a qualidade da recuperação contra um conjunto dourado |
Opção global -C, --root <dir>: raiz do projeto. Adicione --lexical a index, sync ou search para pular embeddings completamente. --dir <path> em index/index-md substitui o docsDir configurado por aquele diretório — não adiciona a ele, e o índice produzido ainda tem a forma de caminho prefixado (<dirname>/x.md). sync não tem --dir: sob uma passada incremental, descartar uma raiz dessa forma excluiria seus documentos em vez de apenas ignorá-los (veja compendio sync --help).
Como funciona
docs/**/*.md
     │
     ├─▶ split into fragments at heading boundaries, then bounded to maxTokens
     │
     ├─▶ index each fragment twice ─┬─ full-text (keywords)
     │                              └─ embeddings (meaning)
     │
     └─▶ one file: .compendio/compendio.db
No momento da consulta, ambos os índices são pesquisados independentemente e seus rankings são mesclados com Fusão de Classificação Recíproca — uma mesclagem baseada em classificação sem pesos para ajustar às cegas. O agente recebe o menor conjunto de fragmentos relevantes.
Compendio é a metade de recuperação do RAG. Ele nunca chama um LLM e não gera nada: encontra os parágrafos certos e sai do caminho.
Se o modelo de embeddings não estiver disponível, o Compendio não trava — ele degrada para busca apenas por palavras-chave e informa isso em suas respostas.
Sincronização incremental
A documentação muda enquanto você trabalha, e o Compendio acompanha sozinho — ou sob solicitação. Há quatro maneiras de o índice ser atualizado:
| Gatilho | O que acontece |
|---|---|
Inicialização do servidor (compendio serve) | Uma passada de sincronização incremental, iniciada antes da conexão do transporte. A primeira chamada de ferramenta espera por ela, então nada é respondido contra um índice frio |
Qualquer chamada de ferramenta MCP (search_docs, docs_overview, read_doc) | Uma passada de sincronização incremental — mas apenas se 30 s tiverem passado desde a última (sync.throttleMs, 30000 por padrão). Caso contrário, a chamada prossegue contra o índice atual |
compendio sync | Uma passada de sincronização incremental, executada manualmente pelo terminal, com progresso ao vivo. sync.throttleMs não a limita — cada invocação executa uma passada nova, independentemente de quão recente foi a última. Recomendado executar isso se você adicionou um grande número de documentos de uma vez. |
compendio index | Reconstrução completa do zero: o índice é descartado e recriado |
Não é um temporizador. Não há intervalo em segundo plano nem observador de arquivos. A sincronização é impulsionada pelas chamadas de ferramentas do seu agente, ou por você executando compendio sync, e o limitador é um piso entre os dois gatilhos automáticos, não um agendamento: um servidor que ninguém consulta não sincroniza, e uma rajada de dez chamadas em um segundo ainda dispara no máximo uma passada. Chamadas concorrentes se juntam à passada já em execução em vez de iniciar uma segunda.
Cada passada de sincronização incremental compara hashes de conteúdo com o que já está indexado, então apenas documentos novos, alterados e excluídos fazem trabalho — um corpus inalterado não custa nada. Dentro de serve, se uma passada falhar, ela é registrada no stderr e a ferramenta ainda responde contra o índice atual; compendio sync não tem esse fallback, então a mesma falha encerra o processo com código não zero.
Quando você precisa da reconstrução completa. compendio index é o único comando que reindexa: ele descarta e recria todo o banco de dados, e é o autoritativo. Use-o após uma grande reestruturação, se suspeitar que o índice se desviou, ou — o caso que surpreende as pessoas — após alterar chunk.minTokens/chunk.maxTokens. Uma passada de sincronização incremental, seja automática ou manual via compendio sync, identifica um documento apenas pelo hash de conteúdo, então um documento que você não editou mantém seus limites de fragmento antigos, não importa o que a configuração diga agora. Apenas uma reindexação completa (compendio index) aplica novo chunking a arquivos inalterados — veja compendio sync --help para a mesma ressalva no ponto em que você provavelmente mais precisa dela.
Multilíngue
Escreva sua documentação no idioma em que sua equipe trabalha. O Compendio não se importa:
- O contrato é em inglês, o corpus não precisa ser. Parâmetros de ferramentas (
path,type,module,tags,section), campos de resposta e descrições de ferramentas estão em inglês, então qualquer agente os lê sem atrito. Isso é independente do idioma em que seus documentos estão escritos: chaves de frontmatter são removidas antes da indexação, e o tokenizador FTS5 não carrega stemmer específico de idioma. - Chaves de frontmatter não inglesas são mapeadas de volta. Se seus documentos usam
estado:em vez destatus:,convention.frontmatterFieldsas traduz. - Acentos são tratados corretamente. A busca é insensível a diacríticos, então validación e validacion correspondem. Busca sensível a acentos perde resultados silenciosamente.
- O modelo de embeddings é multilíngue (
Xenova/multilingual-e5-small), então corpora em um único idioma ou mistos são indexados e recuperados igualmente.
O corpus de referência e o conjunto de avaliação incluídos em ejemplos/ estão em espanhol — deliberadamente, como prova de que um código e contrato de ferramentas em inglês recuperam documentação não inglesa sem perda.
Quanto a semântica adiciona sobre grep?
Medido com compendio eval no corpus de exemplo (ejemplos/: 11 documentos, 29 chunks, sem arquivo de configuração — o próprio caminho zero-config) e seu conjunto dourado de 22 perguntas reais:
| modo | recall@5 | MRR | falhas |
|---|---|---|---|
| híbrido | 1.00 | 0.943 | 0 |
| apenas palavras-chave | 0.95 | 0.856 | 1 |
- A busca por palavras-chave já é forte quando a pergunta usa a terminologia do corpus.
- A lacuna se abre em paráfrases e sinônimos: «¿Qué endpoint hay que llamar para crear un lead?» sai do top 5 sem embeddings, e a perna semântica o recupera. Perguntas com zero sobreposição de palavras com o documento correspondente são resolvidas apenas pela semântica.
- Velocidade: com o modelo aquecido, a busca híbrida responde em 5–20 ms.
compendio eval reproduz esta tabela a qualquer momento — também é o instrumento para ajustar chunking e k sem adivinhar.
Arquitetura
Hexagonal: o núcleo não sabe nada sobre SQLite, transformers.js ou o sistema de arquivos.
src/
├── domain/            # pure, no dependencies: model, chunking, ranking, convention policy
├── application/       # use cases
├── infrastructure/    # adapters: SQLite, markdown parsing, filesystem, embeddings
├── composition.ts     # composition root — start here to see the whole app
├── cli.ts             # input adapter: commander
└── server.ts          # input adapter: MCP server (stdio)
Cada dependência externa fica atrás de uma porta em src/domain/ports.ts. Trocar o armazenamento de vetores ou o provedor de embeddings é uma mudança local em um adaptador, não uma reescrita.
Desenvolvimento
npm install
npm run build       # compiles to dist/
npm test            # vitest: domain, adapters and integration
npm run typecheck   # tsc --noEmit
npm run dev -- ...  # CLI without compiling (tsx)
Testes de integração usam um provedor de embeddings determinístico (sem downloads) contra o corpus real ejemplos/.
Experimente a CLI contra o corpus de exemplo incluído sem instalar o pacote:
node dist/cli.js --root ejemplos index
node dist/cli.js --root ejemplos search "¿cuándo se considera duplicado un lead?"
Este repositório inclui um .mcp.json que serve o corpus ejemplos/, então você pode experimentar as ferramentas do Claude Code com zero configuração.
Licença
MIT © Raúl García Barciela