PostgreSQL MCP
Transforma bancos de dados PostgreSQL de "Eu tenho tabelas e não sei o que elas fazem" para "Eu entendo toda a estrutura do banco de dados, relacionamentos e melhores práticas
Documentação
PostgreSQL MCP Server
Transforma bancos de dados PostgreSQL de "tenho tabelas e não sei o que elas fazem" para "entendo toda a estrutura do banco de dados, relacionamentos e melhores práticas"
Visão Geral
Este é um servidor MCP (Model Context Protocol) que fornece análise inteligente, documentação e operações CRUD completas para bancos de dados PostgreSQL. Ele combina extração determinística de esquema com raciocínio baseado em IA e operações seguras de manipulação de dados para ajudar usuários e agentes de IA a entender e interagir com estruturas complexas de banco de dados.
Otimizado e Estendido em Performance: Começou com 38 ferramentas, otimizado para 19 ferramentas (~50% de redução), depois estrategicamente estendido para 27 ferramentas com otimização de consultas de alto valor, gerenciamento de dados, transações e capacidades de monitoramento.
Principais Recursos
- Cobertura Abrangente: 27 ferramentas cuidadosamente projetadas cobrindo todas as operações PostgreSQL
- Extração de Esquema: Extrai automaticamente tabelas, colunas, relacionamentos e restrições
- Análise Inteligente: Detecta tabelas de junção, relacionamentos implícitos e sugere junções ideais
- Insights com IA: Aproveita Ollama/LLM para gerar explicações de negócio e recomendações
- Operações CRUD Completas: Ferramentas unificadas para toda manipulação de dados com prevenção de injeção SQL
- Otimização de Consultas: Análise de planos de execução, análise combinada de índices (sugestão + detecção de não utilizados)
- Gerenciamento de Dados: Importação/exportação (CSV/JSON/SQL), pesquisa de texto completo
- Suporte a Transações: Transações atômicas multi-operação com rollback
- Monitoramento: Estatísticas do banco de dados, métricas de cache, consultas lentas, rastreamento de conexões
- Múltiplos Formatos de Saída:
- Diagramas ER PlantUML (com renderização SVG)
- Diagramas de Classes PlantUML (com renderização SVG)
- Diagramas de Componentes PlantUML (com renderização SVG)
- Documentação Markdown abrangente
- Arquivos de diagrama visuais (SVG, PNG, PDF)
- Assistência de Consultas: Recomendações inteligentes de tipo de junção (INNER vs LEFT)
- Arquitetura Modular: Design limpo e extensível organizado por capacidade
- Renderização de Diagramas: Gera automaticamente diagramas visuais de estrutura do banco de dados
- Segurança: Consultas parametrizadas, validação de entrada, prevenção de injeção SQL
Começando
Pré-requisitos
- Python 3.11+
- Banco de dados PostgreSQL
- Servidor Ollama (opcional, para explicações de IA)
- Gerenciador de pacotes
uv
Instalação
-
Clone o repositório e instale as dependências:
cd PostgreSQL-MCP uv sync -
Defina as variáveis de ambiente (crie
.env):# PostgreSQL DB_HOST=localhost DB_PORT=5432 DB_NAME=your_database DB_USER=postgres DB_PASSWORD=your_password # Ollama/LLM OLLAMA_BASE_URL=http://192.168.1.143:11434 OLLAMA_MODEL=deepseek-r1:14b # App DEBUG=False
Executando o Servidor
# Start MCP server
uv run postgresql_server.py
Ferramentas MCP Disponíveis (27 no Total)
Categoria 1: Ferramentas de Análise e Esquema (5 ferramentas)
1. analyze_database()
Análise abrangente de esquema sem LLM.
- Estrutura completa do esquema (tabelas, colunas, chaves, tipos de dados)
- Tabelas de junção detectadas
- Relacionamentos implícitos descobertos
- Sugestões de junção (INNER vs LEFT)
- Diagrama ER PlantUML
- Diagrama de Classes PlantUML
- Diagrama de Componentes PlantUML
- Documentação Markdown abrangente
2. explain_database()
Análise de banco de dados com IA usando Ollama LLM.
- Explicação de negócio sobre o propósito do banco de dados
- Relacionamentos detectados e recomendações de junção
- ERD PlantUML aprimorado com insights de IA
- Recomendações de qualidade do banco de dados
3. get_table_details(table_name: str)
Análise detalhada de uma tabela específica.
- Estrutura da tabela e relacionamentos
- Informações de colunas e restrições
- Documentação Markdown específica da tabela
4. get_database_info(info_type: str = "tables")
NOVO: Ferramenta unificada de recuperação de informações - Consolida list_tables, check_ollama_status
info_type="tables": Lista todas as tabelas com contageminfo_type="ollama": Verifica o status do serviço Ollama/LLM e modelos disponíveisinfo_type="summary": Estatísticas rápidas do banco de dados
5. render_database_diagrams(output_format: str = "svg")
Gera diagramas visuais de estrutura do banco de dados.
- Diagrama ER (erd_svg.svg)
- Diagrama de Classes (class_svg.svg)
- Diagrama de Componentes (component_svg.svg)
- Arquivos SVG/PNG/PDF no diretório
diagrams/
Categoria 2: Operações CRUD de Criação (4 ferramentas)
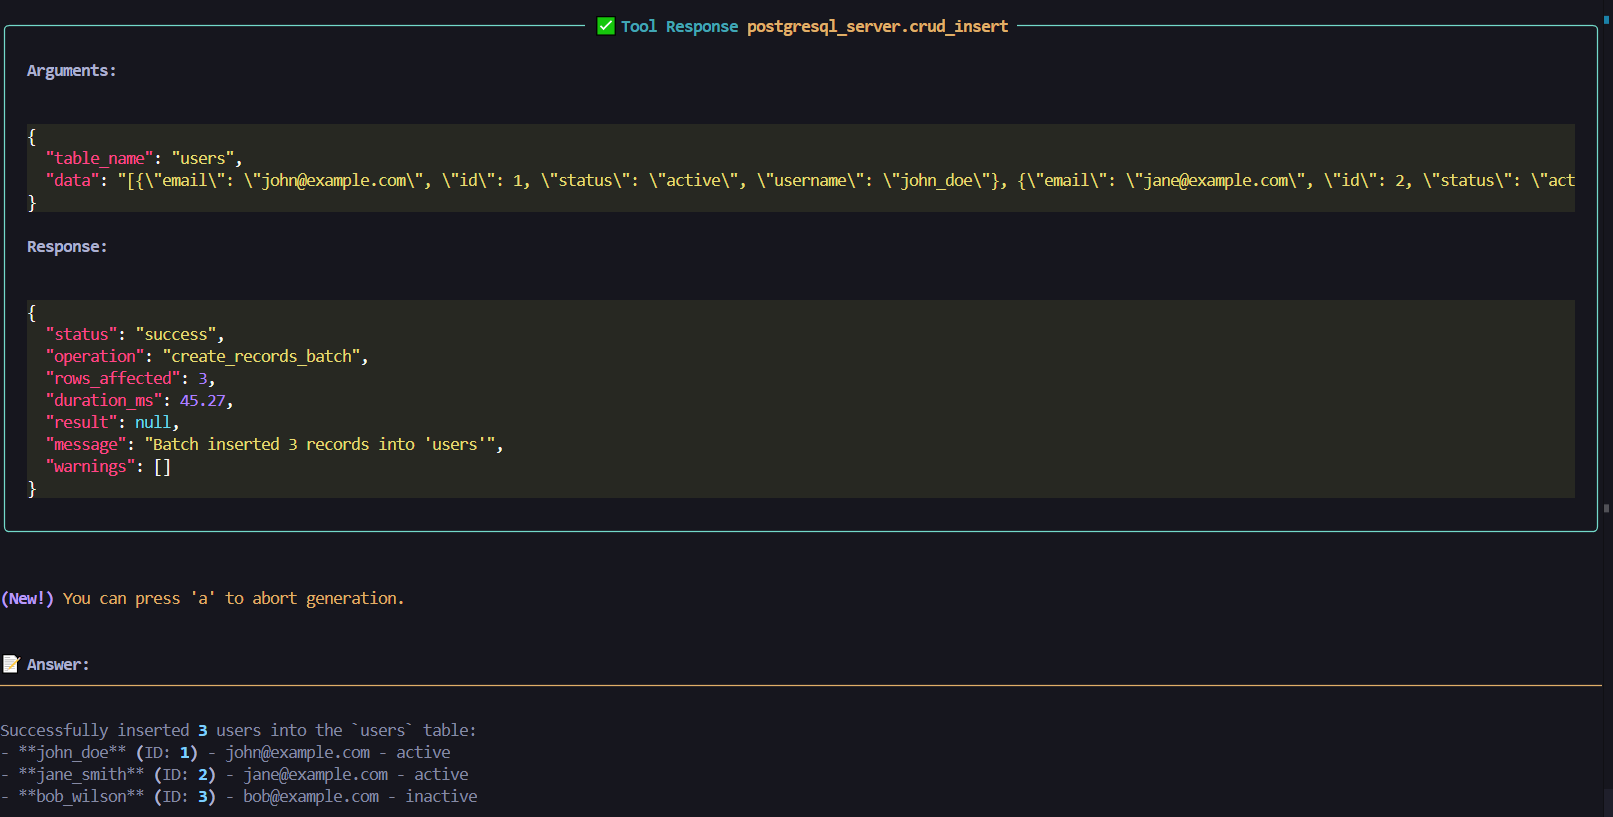
6. crud_insert(table_name: str, data: Dict | List[Dict])
NOVO: Inserção inteligente - Consolida inserções únicas e em lote
- Inserção única: Passe Dict →
{"name": "John", "age": 30} - Inserção em lote: Passe List[Dict] →
[{"name": "John"}, {"name": "Jane"}] - Detecção automática do modo único vs lote
- Consultas parametrizadas para prevenção de injeção SQL
7. crud_create_table(table_name, columns, primary_key)
Cria uma nova tabela com colunas e restrições.
- Defina colunas com tipos:
{"name": "id", "type": "INTEGER", "nullable": False} - Especificação opcional de chave primária
- Suporte completo a restrições
8. crud_create_view(view_name, select_query, replace_if_exists)
Cria visões de banco de dados a partir de consultas SELECT.
- Defina tabelas virtuais
- Substituição opcional de visão
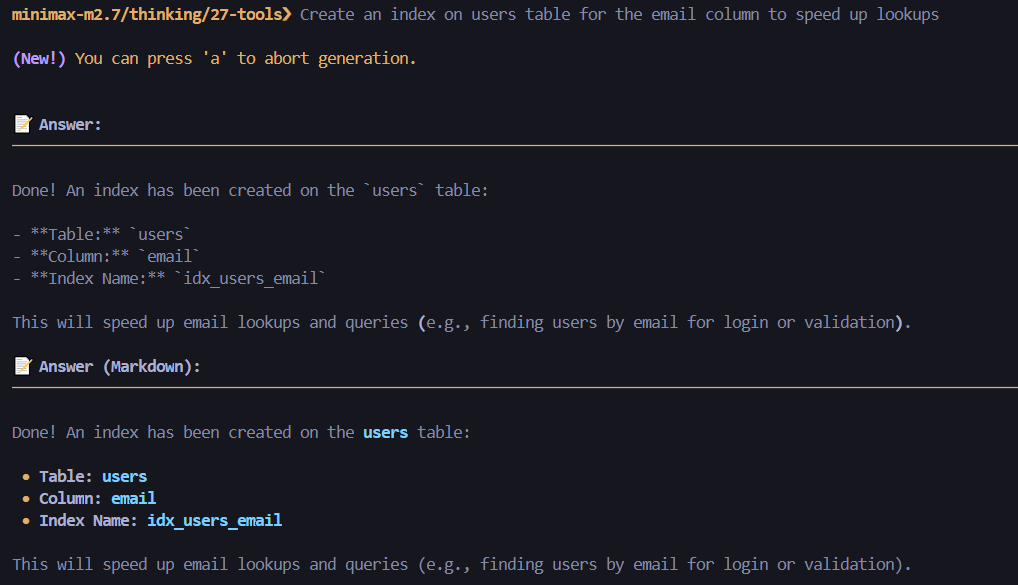
9. crud_create_index(index_name, table_name, columns, unique)
Cria índices únicos ou compostos.
- Coluna única:
columns=["email"] - Composto:
columns=["last_name", "first_name"] - Restrição UNIQUE opcional
Categoria 3: Operações CRUD de Leitura (2 ferramentas)
10. crud_query(query, params, limit, offset)
NOVO: Execução de consultas SQL brutas - Para consultas complexas com JOINs e agregações
- Execute qualquer instrução SELECT
- Valores parametrizados: Use placeholders
%s - Suporte a paginação com limit/offset
- Exemplo:
query="SELECT * FROM users WHERE age > %s", params=[30]
11. crud_get(table_name, mode, where_clause, where_params, options)
NOVO: Leitura unificada de alto nível - Consolida 4 operações de leitura
mode="records": Obtém registros filtrados (substitui crud_get_records)mode="count": Conta registros (substitui crud_get_record_count)mode="distinct": Obtém valores distintos (substitui crud_distinct_values)mode="paginate": Resultados paginados com metadados (substitui crud_paginate_data)- Suporte completo a cláusula WHERE, ordenação e filtros
Categoria 4: Operações CRUD de Atualização (2 ferramentas)
12. crud_update(table_name, values, where_clause, where_params, id_column, record_id)
NOVO: Atualização unificada - Consolida atualizações únicas, em lote e de coluna
- Registro único: Forneça
record_id+id_column - Atualização em lote: Forneça
where_clause+where_params - Atualização de coluna: Chave-valor único no dicionário
values - Consultas parametrizadas para segurança
13. crud_rename(object_type, old_name, new_name, table_name)
NOVO: Renomeie qualquer coisa - Consolida renomeação de tabela e coluna
object_type="table": Renomeia tabelaobject_type="column": Renomeia coluna (requertable_name)- Renomeação segura com validação
Categoria 5: Operações CRUD de Exclusão (1 ferramenta)
14. crud_delete(table_name, mode, where_clause, where_params, id_column, record_id, cascade)
NOVO: Exclusão unificada - Consolida 4 operações de exclusão
mode="records": Exclui registros específicos (único ou em lote)- Único: Forneça
record_id+id_column - Lote: Forneça
where_clause+where_params
- Único: Forneça
mode="truncate": Limpa todos os dados (rápido, redefine sequências)mode="drop": Remove tabela inteira (AVISO: destrói a estrutura)cascadeopcional para objetos dependentes
Categoria 6: Modificação de Esquema (5 ferramentas)
15. mod_column(table_name, action, column_name, column_spec, cascade)
NOVO: Gerenciamento unificado de colunas - Consolida 4 operações de coluna
action="add": Adiciona nova coluna →column_spec={"name": "status", "type": "VARCHAR(50)"}action="modify_type": Altera o tipo de dados →column_spec={"new_type": "TEXT"}action="drop": Remove colunaaction="set_nullable": Alterna restrição NULL →column_spec={"is_nullable": True}
16. mod_index(action, index_name, table_name, cascade)
NOVO: Gerenciamento de índices - Consolida operações de listar e remover
action="list": Lista todos os índices (opcionalmente filtrados por tabela)action="drop": Remove índice com cascade opcional
17. mod_constraint(action, table_name, constraint_name, cascade)
NOVO: Gerenciamento de restrições - Consolida operações de listar e remover
action="list": Lista todas as restrições (PK, FK, unique, check)action="drop": Remove restrição com cascade opcional
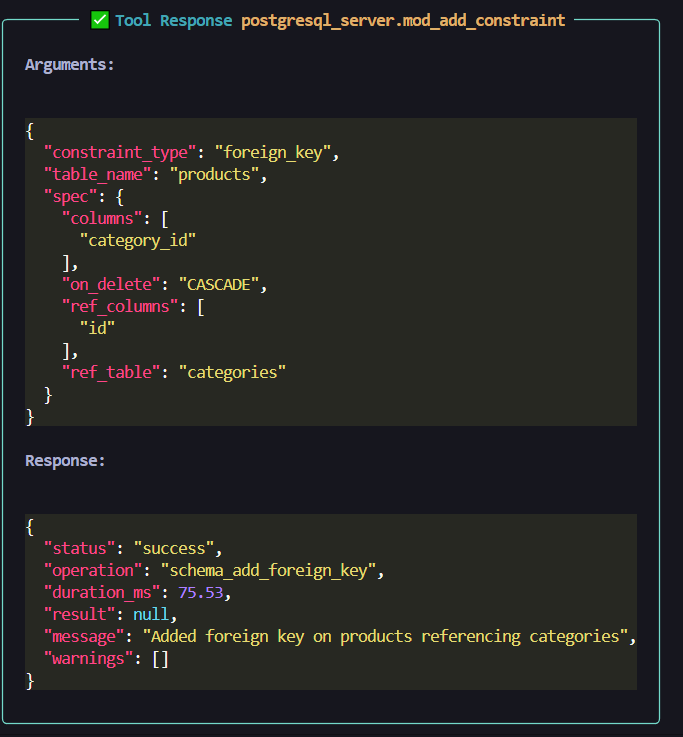
18. mod_add_constraint(constraint_type, table_name, spec)
NOVO: Adicionar restrições - Consolida adição de chave primária e chave estrangeira
constraint_type="primary_key"+spec={"columns": ["id"]}constraint_type="foreign_key"+spec={"columns": ["user_id"], "ref_table": "users", "ref_columns": ["id"], "on_delete": "CASCADE"}
19. mod_view(action, view_name, cascade)
NOVO: Gerenciamento de visões - Consolida 3 operações de visão
action="list": Lista todas as visõesaction="get": Obtém a definição SQL da visãoaction="drop": Remove visão com cascade opcional
Categoria 7: Ferramentas Estendidas das Fases 3-6 (8 ferramentas)
20. query_explain(query, analyze, format)
Obtém a saída de EXPLAIN / EXPLAIN ANALYZE para qualquer consulta SQL.
analyze=False: Mostra apenas o plano estimadoanalyze=True: Executa a consulta e mostra contagens reais de linhas e temposformat:"text"(padrão) ou"json"
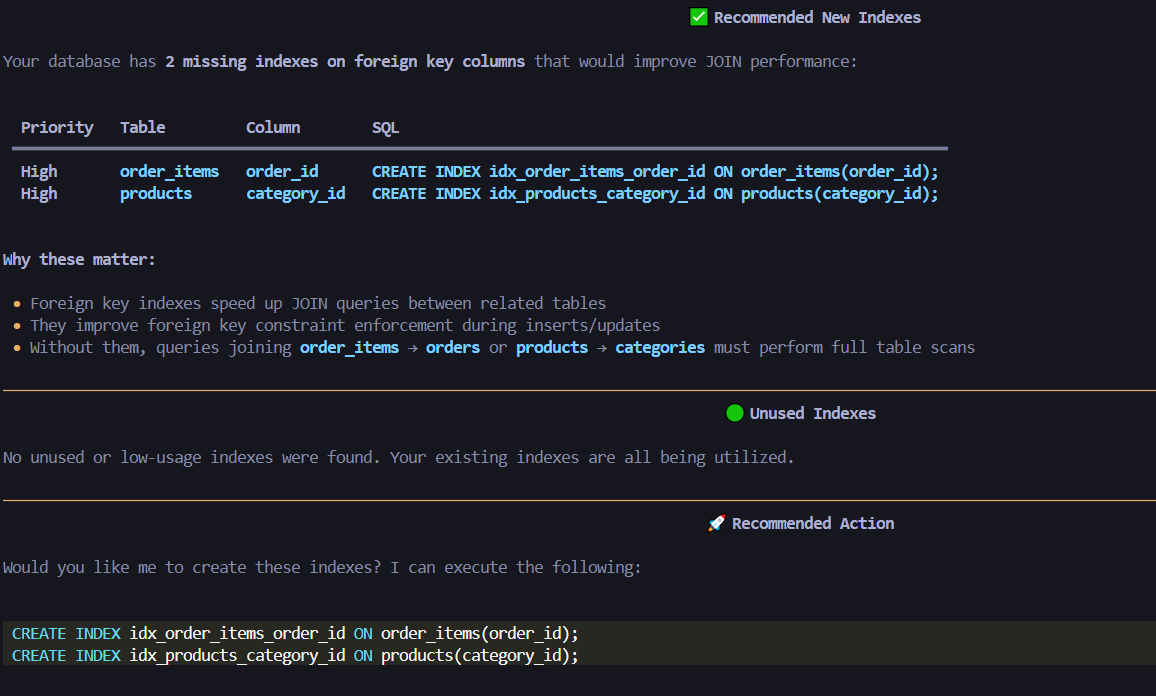
21. query_analyze_indexes(mode, table_name, min_size_mb)
Análise combinada de índices — sugere índices ausentes ou detecta os não utilizados.
mode="suggest": Recomenda índices para colunas FK e tabelas grandes (opcionalmente limitado atable_name)mode="unused": Encontra índices com contagens de varredura zero/baixas acima demin_size_mbmode="all": Executa ambas as análises e retorna um relatório combinado
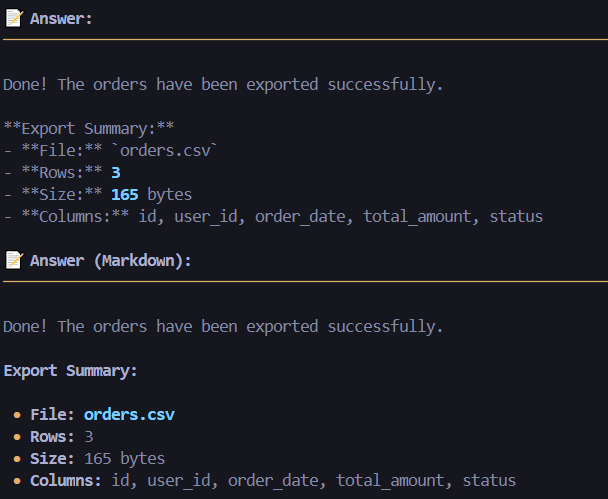
22. data_export(table_name, format, where_clause, where_params, columns, limit)
Exporta dados de tabela para formato CSV, JSON ou SQL INSERT.
- Suporta seleção de colunas, filtragem WHERE e limites de linhas
- A saída JSON inclui metadados de esquema
23. data_import(table_name, data, format, column_mapping, conflict_action)
Importa dados de CSV ou JSON para uma tabela.
conflict_action:"error"|"ignore"|"update"column_mapping: Renomeia campos recebidos para corresponder às colunas da tabela
24. data_search(table_name, search_term, columns, search_type, limit)
Pesquisa de texto completo em colunas especificadas.
search_type:"ilike"(insensível a maiúsculas/minúsculas),"like"(sensível a maiúsculas/minúsculas),"fuzzy"(similaridade)- Pesquisa em todas as colunas de texto quando
columnsé omitido
25. transaction_execute(operations, rollback_on_error)
Executa múltiplas operações SQL atomicamente em uma única transação.
- Cada operação:
{"sql": "...", "params": [...]} - Rollback automático em qualquer falha quando
rollback_on_error=True
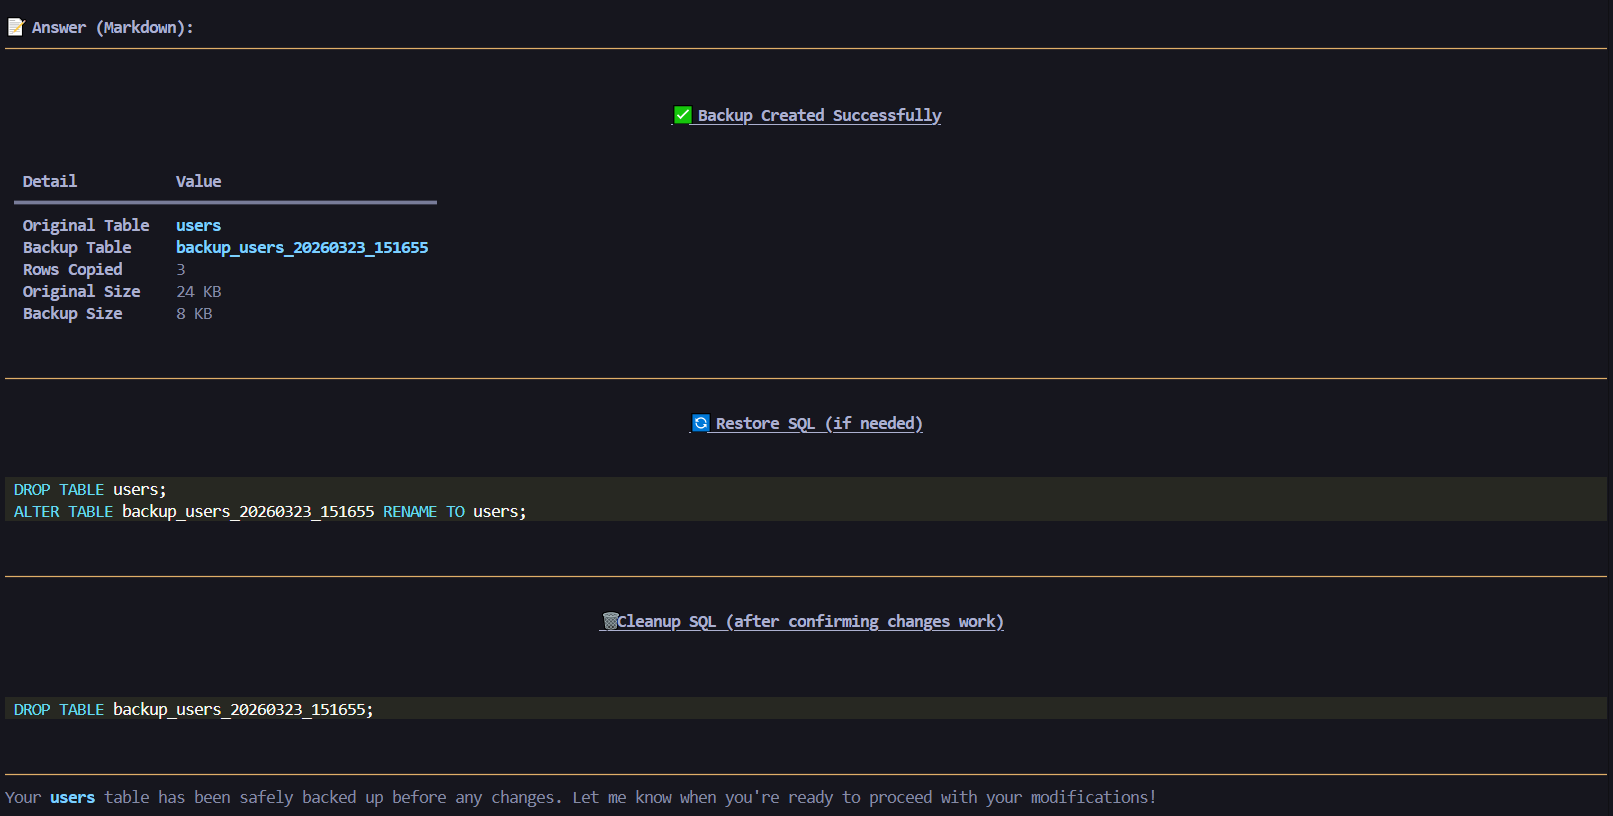
26. transaction_backup_table(table_name, backup_name, include_indexes)
Cria um backup de snapshot rápido de uma tabela.
- Copia dados e opcionalmente recria índices no backup
- Retorna SQL de restauração para recuperar ou comparar com o original
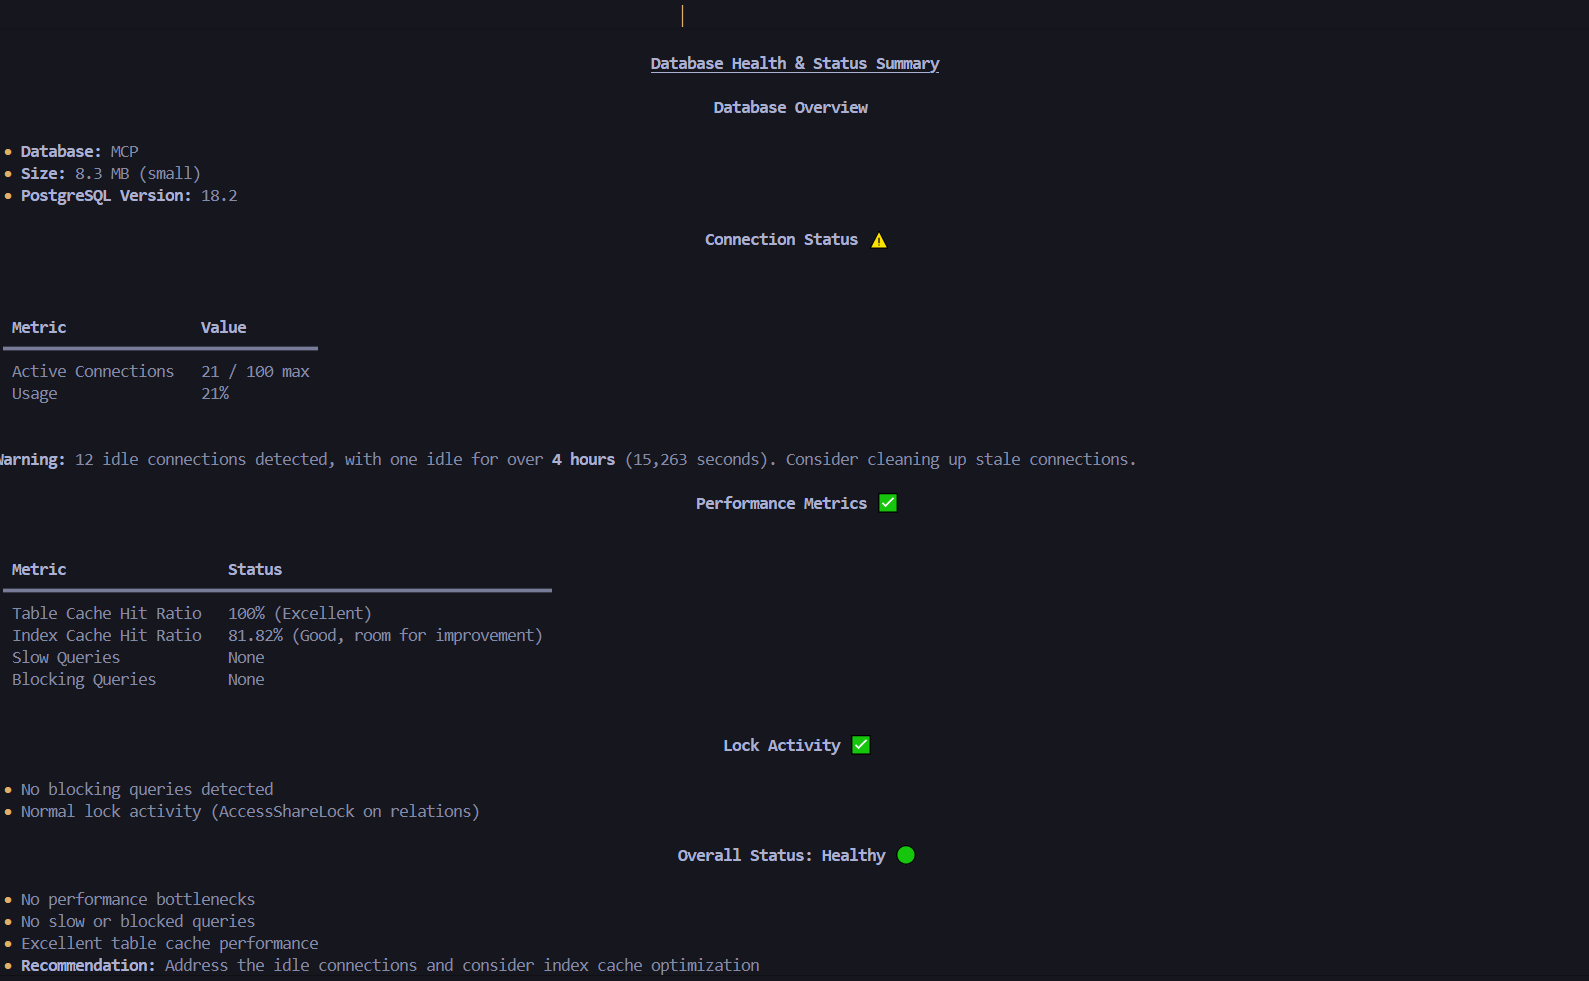
27. monitoring_database_stats(stat_type)
Monitoramento abrangente de saúde e desempenho do banco de dados.
stat_type:"summary"|"size"|"connections"|"cache_hit_ratio"|"slow_queries"|"locks"|"all"
Use o cliente OLLMCP para testes locais com provedores ollama
Recursos de Segurança (Todas as Operações):
- Consultas parametrizadas (previne injeção SQL)
- Validação de entrada (validação de nomes de tabela/coluna)
- Verificação de restrições (valida tipos de dados e restrições)
- Formato de resposta padronizado com status e duração
VÍDEO DE ANÁLISE CRUD & ESQUEMA

Consulte AGENT_TESTING_SUITE.md para o fluxo completo de testes
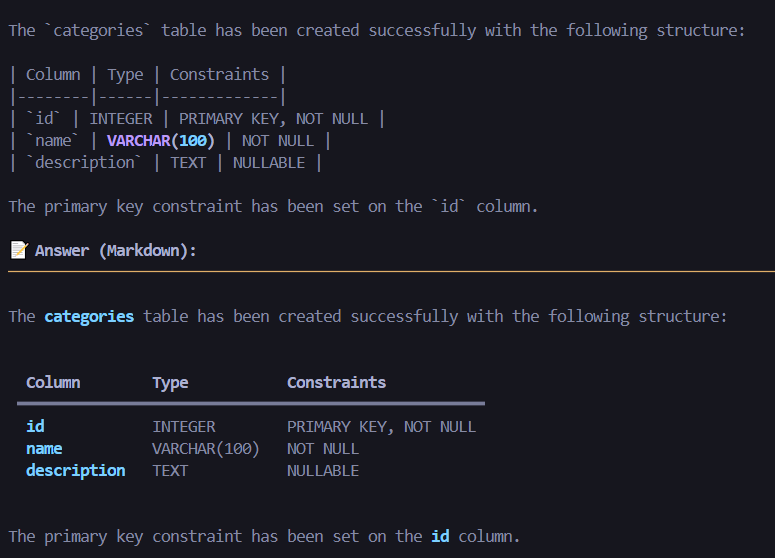
Aqui estão imagens de algumas ferramentas em ação:
Visão Geral do Banco de Dados
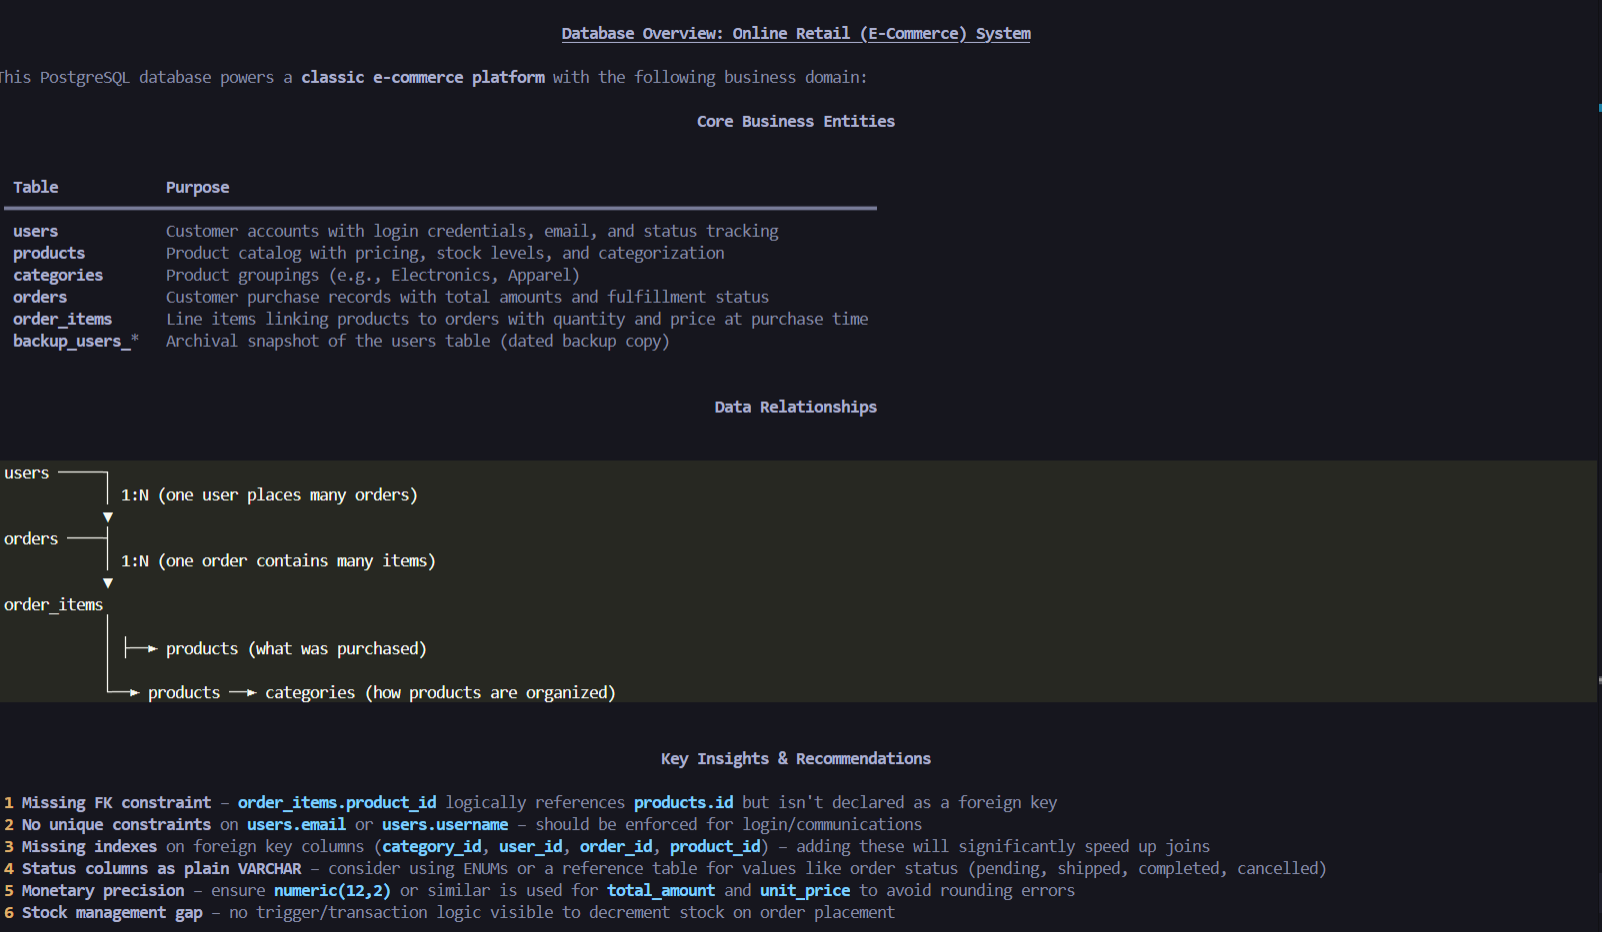
Tabela de Backup
Exportar dados para CSV/JSON/SQL
Ferramenta de Chave Estrangeira
Sugerir Novos Índices
Monitoramento do Banco de Dados
Criar Novo Índice
Operações CRUD
Consulte a pasta diagrams/ para visualizar os Diagramas ERD Gerados
🤝 Contribuição
Este projeto é OpenSource. Contribuições são bem-vindas.