Scrapeless
公式リアルタイムのScrapeless Google SERP(Google検索、Googleフライト、Googleマップ、Google求人など)の結果をLLMアプリケーションに統合します。このサーバーは、AIワークフロー、チャットボット、リサーチツールに動的なコンテキスト取得を可能にします。
Scrapeless MCPで何ができますか?
- Google検索とトレンド —
google_searchとgoogle_trendsを使って、ライブの検索結果やトレンドデータをリクエストします。 - ブラウザ自動化 — クラウドブラウザを操作して、
browser_gotoやbrowser_clickなどのツールでナビゲート、クリック、入力、スクロール、スクリーンショットの取得を行います。 - 任意のURLをスクレイピング —
scrape_html、scrape_markdown、またはscrape_screenshotでページのHTML、Markdown、スクリーンショットを取得します。 - サイト全体をクロール —
crawl_startで非同期クロールジョブを開始し、crawl_resultで結果をポーリングします。 - AIを活用した抽出 —
ai_scraperを使用して、ChatGPT、Gemini、Perplexity などのエンジン向けの構造化スクレイピングタスクを作成します。
ドキュメント
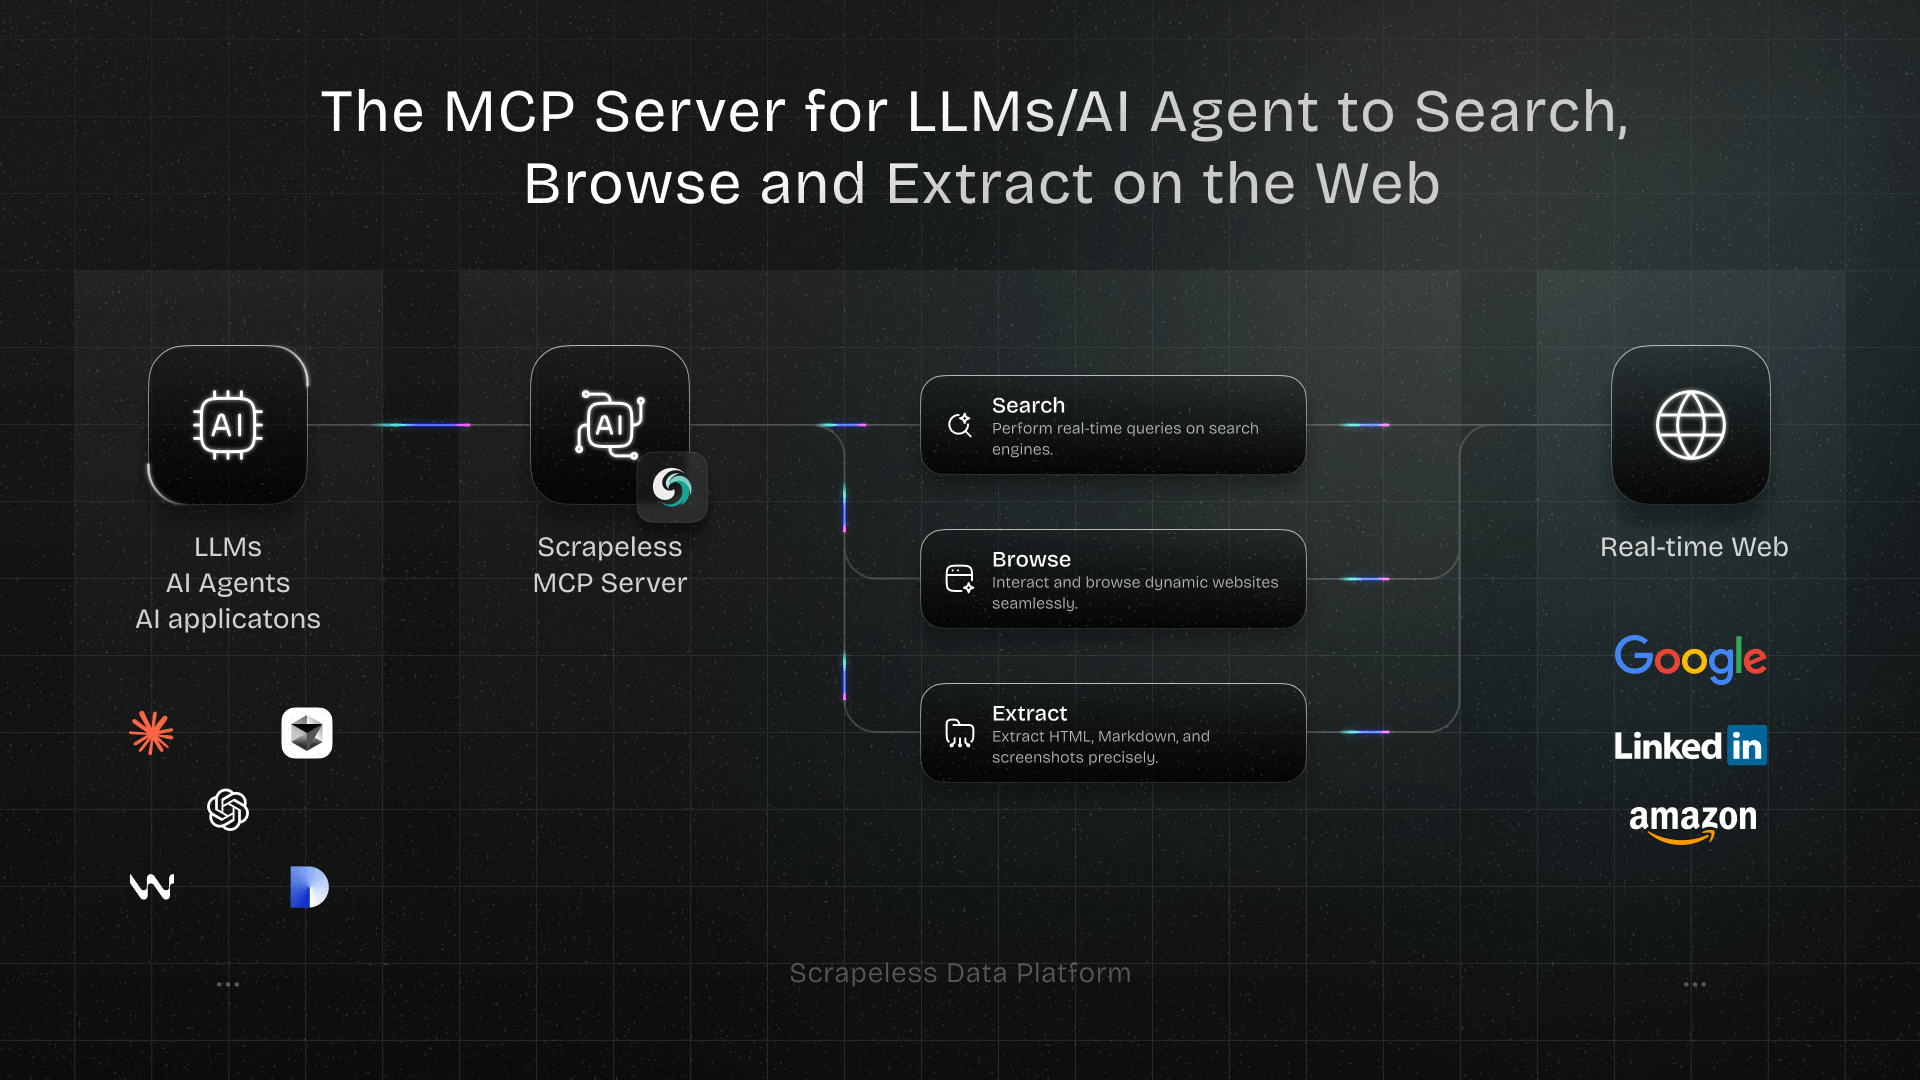
Scrapeless MCP サーバー
Scrapeless Model Context Protocol(MCP)サーバーへようこそ — LLM、AIエージェント、AIアプリケーションがリアルタイムでウェブと対話できるようにする強力な統合レイヤーです。
オープンなMCP標準に基づいて構築されたScrapeless MCPサーバーは、ChatGPT、Claudeなどのモデルや、Cursor、Windsurfなどのツールを、以下の幅広い外部機能にシームレスに接続します:
- Googleサービス統合(検索、トレンド)
- ページレベルのナビゲーションと操作のためのブラウザ自動化
- 動的でJS主体のサイトをスクレイピング — HTML、Markdown、またはスクリーンショットとしてエクスポート
- リンクを辿ってウェブサイト全体をクロールし、各ページを複数の形式でキャプチャ
- AIスクレイパー ChatGPT、Gemini、Perplexity、Copilot、Google AI Mode、Google AI Overview、Grok、またはAlexa向けのAIスクレイパータスクを作成
AIリサーチアシスタント、コーディングコパイロット、自律型ウェブエージェントのいずれを構築している場合でも、このサーバーはワークフローに必要な動的コンテキストと実世界のデータを提供します — ブロックされることなく。
使用例
- Claudeによる自動ウェブ操作とデータ抽出
Scrapeless MCPブラウザを使用すると、Claudeは会話形式のコマンドでウェブナビゲーション、クリック、スクロール、スクレイピングなどの複雑なタスクを実行でき、live sessionsを介してウェブ操作結果のリアルタイムプレビューが可能です。
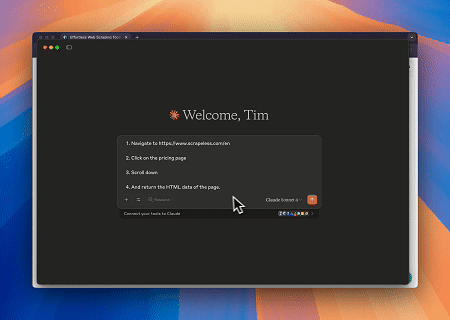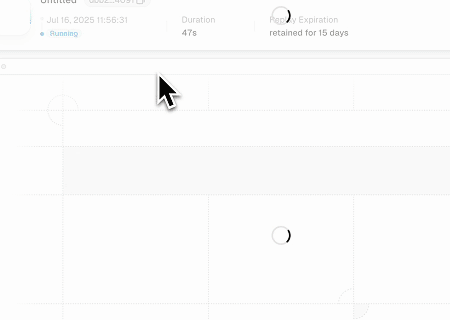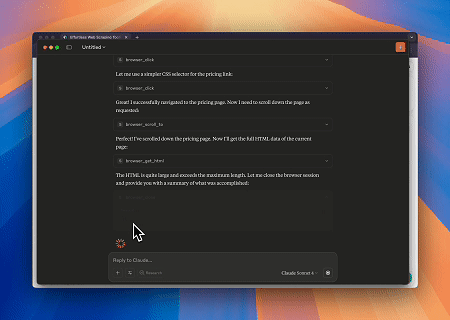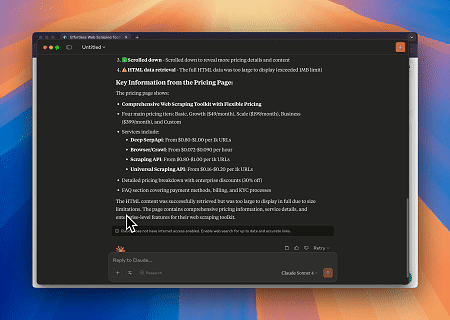
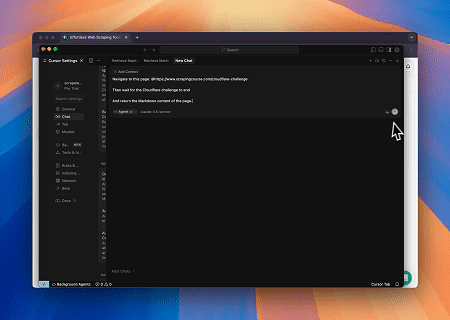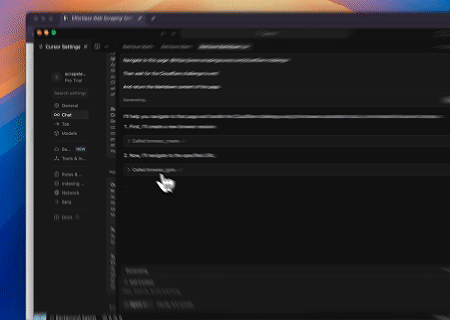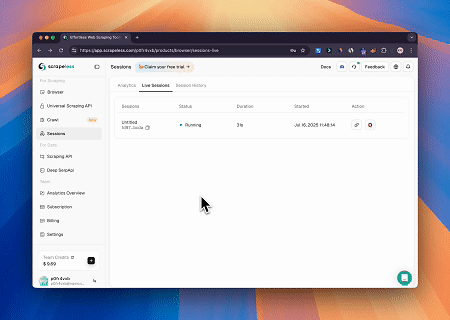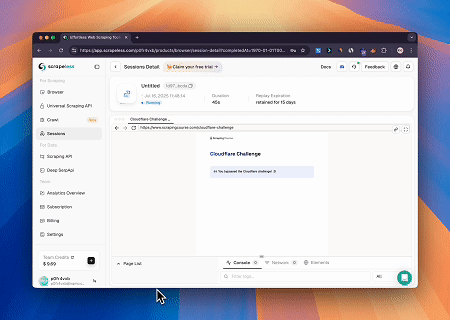
- Cloudflareをバイパスしてターゲットページのコンテンツを取得
Scrapeless MCPブラウザサービスを使用すると、Cloudflareページに自動的にアクセスし、プロセス完了後にページコンテンツを抽出してMarkdown形式で返します。
- 動的にレンダリングされたページコンテンツの抽出とファイルへの書き込み
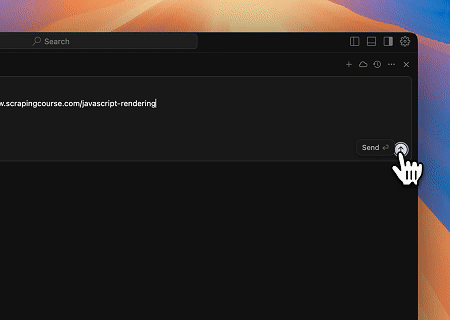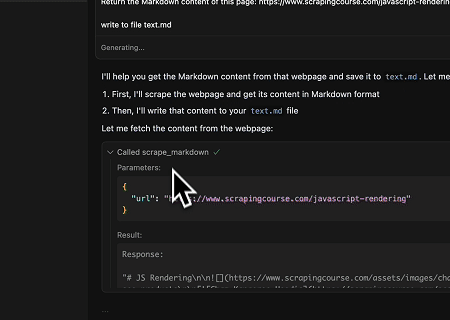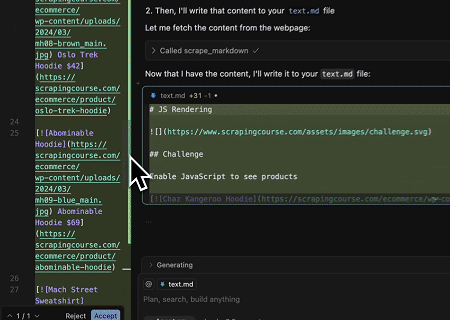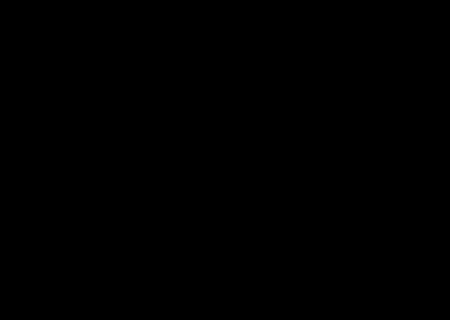
Scrapeless MCPユニバーサルAPIを使用して、上記のターゲットページのJavaScriptレンダリングコンテンツをスクレイピングし、Markdown形式でエクスポートし、最後に**text.md**という名前のローカルファイルに書き込みます。
- 自動SERPスクレイピング
Scrapeless MCPサーバーを使用して、Google検索でキーワード「web scraping」をクエリし、最初の10件の検索結果(タイトル、リンク、概要を含む)を取得し、serp.textという名前のファイルにコンテンツを書き込みます。
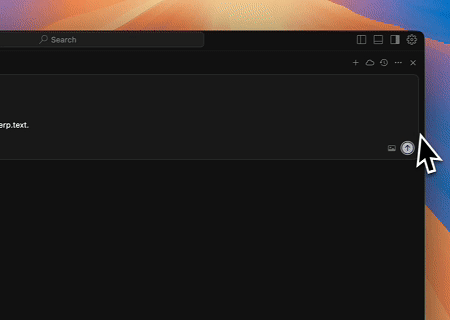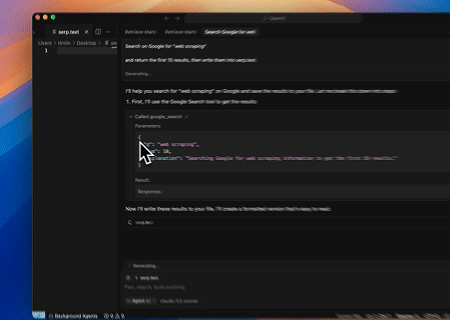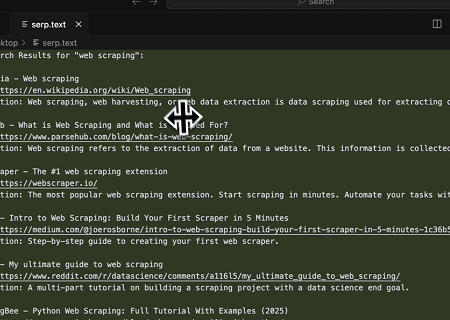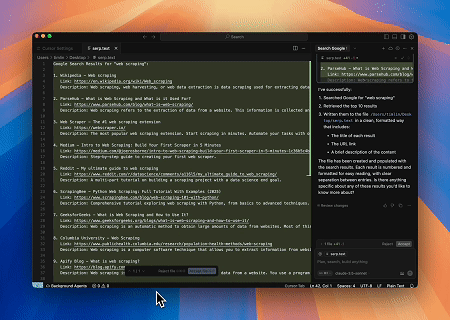
これらのサーバーの使用方法の追加例をいくつか示します:
| 例 |
|---|
| Google検索でscrapelessを検索します。 |
| 過去1年間の「AI」の検索関心を調べます。 |
| ブラウザを使用してchatgpt.comにアクセスし、「今日の天気は?」を検索して、結果を要約します。 |
| scrapeless.comページのHTMLコンテンツをスクレイピングします。 |
| scrapeless.comページのMarkdownコンテンツをスクレイピングします。 |
| scrapeless.comのスクリーンショットを取得します。 |
セットアップガイド
- Scrapelessキーを取得
- Scrapelessダッシュボードにログインします(無料トライアルあり)
- 左側の「設定」をクリック → 「APIキー管理」を選択 → 「APIキーを作成」をクリックします。最後に、作成したAPIキーをクリックしてコピーします。
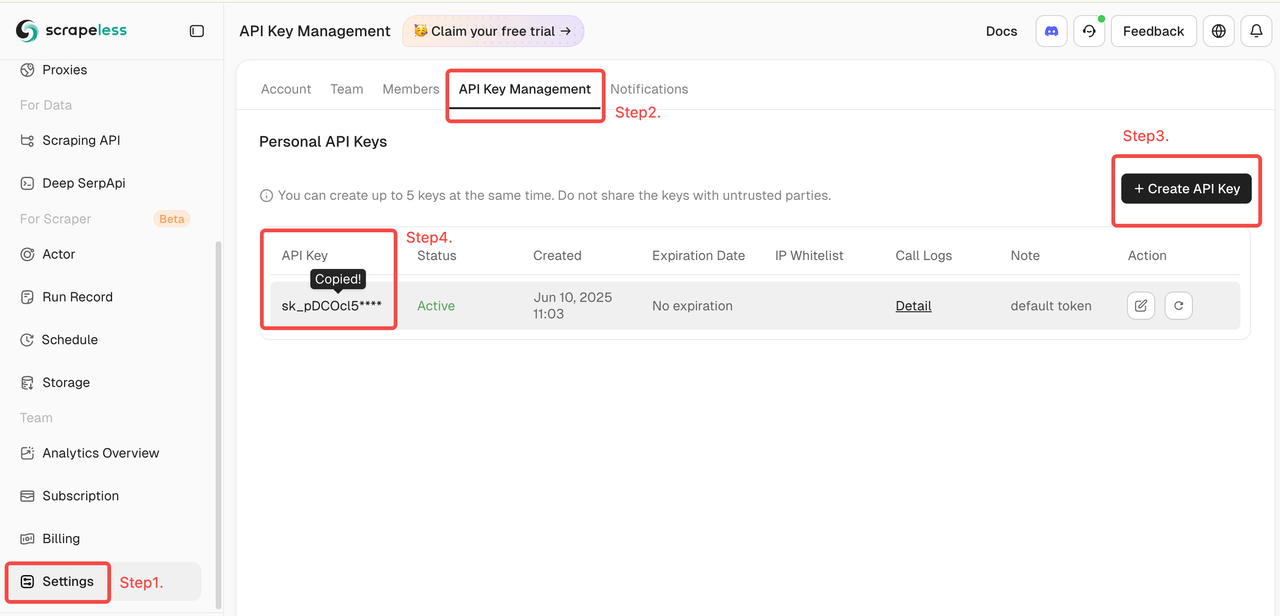
- MCPクライアントを設定
Scrapeless MCPサーバーは、StdioとStreamable HTTPの両方のトランスポートモードをサポートしています。
🖥️ Stdio(ローカル実行)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP(ホステッドAPIモード)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
詳細オプション
オプションのパラメータでブラウザセッションの動作をカスタマイズします。これらは環境変数(Stdioの場合)またはHTTPヘッダー(Streamable HTTPの場合)で設定できます:
| Stdio(環境変数) | Streamable HTTP(HTTPヘッダー) | 説明 |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | セッション継続のための再利用可能なブラウザプロファイルIDを指定します。 |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Cookie、ローカルストレージなどの永続ストレージを有効にします。 |
| BROWSER_SESSION_TTL | x-browser-session-ttl | 最大セッションタイムアウトを秒単位で定義します。この非アクティブ期間の後、セッションは自動的に期限切れになります。 |
Claude Desktopとの統合
- Claude Desktopを開きます
- 次の場所に移動します:
Settings→Tools→MCP Servers - **「MCPサーバーを追加」**をクリックします
- 上記の
StdioまたはStreamable HTTP設定を貼り付けます - 保存してサーバーを有効にします
- ClaudeはScrapelessを使用してウェブクエリの発行、コンテンツの抽出、ページとの対話ができるようになります
Cursor IDEとの統合
- Cursorを開きます
Cmd + Shift + Pを押して、Configure MCP Serversを検索します- 上記の形式でScrapeless MCP設定を追加します
- ファイルを保存し、Cursorを再起動します(必要に応じて)
- これでCursorに次のようなことを依頼できます:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- バックグラウンドでScrapelessが使用されます。
サポートされているMCPツール
| 名前 | 説明 |
|---|---|
| google_search | ユニバーサル情報検索エンジン。 |
| google_trends | Googleトレンドからトレンド検索データを取得します。 |
| browser_create | Scrapelessを使用してクラウドブラウザセッションを作成または再利用します。 |
| browser_close | クラウドブラウザを切断して現在のセッションを閉じます。 |
| browser_goto | ブラウザを指定されたURLに移動します。 |
| browser_go_back | ブラウザ履歴で1つ戻ります。 |
| browser_go_forward | ブラウザ履歴で1つ進みます。 |
| browser_click | ページ上の特定の要素をクリックします。 |
| browser_type | 指定された入力フィールドにテキストを入力します。 |
| browser_press_key | キー押下をシミュレートします。 |
| browser_wait_for | 特定のページ要素が表示されるまで待機します。 |
| browser_wait | 固定時間実行を一時停止します。 |
| browser_screenshot | 現在のページのスクリーンショットをキャプチャします。 |
| browser_get_html | 現在のページの完全なHTMLを取得します。 |
| browser_get_text | 現在のページからすべての表示テキストを取得します。 |
| browser_scroll | ページの下部までスクロールします。 |
| browser_scroll_to | 特定の要素が表示されるまでスクロールします。 |
| scrape_html | URLをスクレイピングし、完全なHTMLコンテンツを返します。 |
| scrape_markdown | URLをスクレイピングし、コンテンツをMarkdownとして返します。 |
| scrape_screenshot | 任意のウェブページの高品質スクリーンショットをキャプチャします。 |
| crawl_start | ベースURLから非同期クロールジョブを開始し、そのジョブIDを返します。 |
| crawl_cancel | 進行中のクロールジョブをIDでキャンセルします。 |
| crawl_result | クロールジョブをIDでポーリングし、完了するまで待ってクロールデータを返します。 |
| ai_scraper | ChatGPT、Gemini、Perplexity、Copilot、Google AI Mode、Google AI Overview、Grok、またはAlexa向けのAIスクレイパータスクを作成します。 |
セキュリティのベストプラクティス
Scrapeless MCPサーバーをLLM(ChatGPT、Claude、Cursorなど)で使用する場合、スクレイピングまたは抽出されたすべてのウェブコンテンツを慎重に扱うことが重要です。ウェブデータはデフォルトで信頼できないものであり、不適切な処理はアプリケーションをプロンプトインジェクションやその他のセキュリティ脆弱性にさらす可能性があります。
✅ 推奨されるプラクティス
- スクレイピングされた生のコンテンツをLLMプロンプトに直接渡さないでください。 生のHTML、JavaScript、またはユーザー生成テキストには、隠れたインジェクションペイロードが含まれている可能性があります。
- 抽出されたすべてのコンテンツをサニタイズして検証します。 ダウンストリームロジックやAIモデルでコンテンツを使用する前に、潜在的に有害なタグやスクリプトを削除またはエスケープします。
- 自由形式のテキストよりも構造化抽出を優先します。
scrape_html、scrape_markdown、または既知の安全なセレクタを使用したターゲット指定のbrowser_get_textなどのツールを使用して、信頼できるコンテンツのみを抽出します。 - 動的に生成されたページをスクレイピングする場合は、ドメインまたはセレクタのホワイトリストを適用して、データフローを既知の信頼できるソースに制限します。
- ブラウザまたはスクレイピングツールを介して行われたすべての送信リクエストをログに記録して監視します。特に機密データ、トークン、または内部ネットワークアクセスを扱う場合は重要です。
🚫 避けるべきこと
- スクレイピングされたHTMLをプロンプトに直接注入する
- 検証なしでユーザーに任意のURLやCSSセレクタを指定させる
- 将来のプロンプト使用のためにフィルタリングされていないスクレイピングコンテンツを保存する
コミュニティ
お問い合わせ
質問、提案、コラボレーションのお問い合わせは、以下の方法でお気軽にご連絡ください:
- メール:market@scrapeless.com
- 公式ウェブサイト:https://www.scrapeless.com
- コミュニティフォーラム:https://discord.gg/Np4CAHxB9a