tokensave
公式エージェントにセマンティックコードインテリジェンスを搭載し、その過程で💰を節約しましょう!
Tokensave MCPで何ができますか?
- セマンティックコード検索 — アシスタントに意味でコードを探してもらいます。例えば、
login、validateToken、AuthServiceにまたがる認証ロジックを1つのクエリで特定します。 - 編集前の影響分析 — 任意のシンボルの呼び出し元、呼び出し先、および影響範囲全体を追跡し、変更前に何が壊れるかを正確に把握します。
- ブランチ間コード比較 — 2つのブランチ間でコードグラフを比較し、チェックアウトを切り替えることなく、追加・削除・変更されたシンボルを確認します。
- 永続的なセッションメモリ —
tokensave_record_decisionとtokensave_record_code_areaで設計上の決定やコード領域を保存し、将来のセッションでtokensave_session_recallを使って呼び出します。 - アトミックなコード編集 — 正規表現やシェルクォートの危険性なしに、一意のアンカー文字列置換や正確な位置へのコード挿入を適用し、書き込み後に自動で再インデックス化します。
ドキュメント
AIコーディングエージェントのためのセマンティックコードインテリジェンス
より少ないトークン • より少ないツール呼び出し • 100%ローカル




tokensaveが必要な理由
AIコーディングエージェントはコードベースの探索でトークンを浪費します。grep、glob、ファイル読み取りのたびにコストがかかります。複雑なタスクでは、エージェントが複数のExploreサブエージェントを起動し、コンテキストを構築するためだけに数百のファイルをスキャンします。
tokensaveはエージェントに事前インデックス化されたセマンティック知識グラフを提供します。 ファイルをスキャンする代わりに、エージェントはグラフにクエリを実行し、即座に構造化された回答を得られます -- 正しいシンボル、その関係性、ソースコードを1回の呼び出しで取得できます。
仕組み
┌──────────────────────────────────────────────────────────────┐
│  AI Coding Agent (Claude Code, Codex, Gemini, Cursor, ...)   │
│                                                              │
│  "Implement user authentication"                             │
│        │                                                     │
│        ▼                                                     │
│  ┌─────────────────┐       ┌─────────────────┐               │
│  │  Sub-agent      │ ───── │  Sub-agent      │               │
│  └────────┬────────┘       └─────────┬───────┘               │
└───────────┼──────────────────────────┼───────────────────────┘
            │                          │
            ▼                          ▼
┌──────────────────────────────────────────────────────────────┐
│  tokensave MCP Server                                        │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐           │
│  │   Search    │  │   Callers   │  │   Context   │           │
│  │   "auth"    │  │  "login()"  │  │   for task  │           │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘           │
│         └────────────────┼────────────────┘                  │
│                          ▼                                   │
│              ┌───────────────────────┐                       │
│              │   libSQL Graph DB     │                       │
│              │   • Instant lookups   │                       │
│              │   • FTS5 search       │                       │
│              └───────────────────────┘                       │
└──────────────────────────────────────────────────────────────┘
tokensaveなし: エージェントはgrep、glob、Readを使用してファイルをスキャンします -- 多数のAPI呼び出し、高いトークン使用量。
tokensaveあり: エージェントはMCPツールを介してグラフにクエリを実行します -- 即時結果、ローカル処理、より少ないトークン。
主な機能
| スマートコンテキスト構築 | セマンティック検索 | 影響分析 |
| 1回のツール呼び出しでエージェントが必要とするすべてを返します -- エントリポイント、関連シンボル、コードスニペット。 | テキストだけでなく意味でコードを見つけます。「authentication」を検索するとlogin、validateToken、AuthServiceが見つかります。 | 変更する前に何が壊れるかを正確に把握します。呼び出し元、呼び出し先、任意のシンボルの完全な影響範囲をトレースします。 |
| 80以上のMCPツール | 50以上の言語 | 12以上のエージェント統合 |
| コールグラフ探索からデッドコード検出、アトミック編集プリミティブ、コードヘルスメトリクス、テストマッピング、複雑性分析まで。 | Rust、Go、Java、Python、TypeScript、C、C++、Swift、Svelte、Astro、およびWGSL/HLSL/Metalシェーダー、CUDA/HIP、Markdownを含む43言語以上。3つのティア(lite/medium/full)でバイナリサイズを制御します。 | Claude Code、Codex CLI、Gemini CLI、Qwen Code、Kiro、Cursor、OpenCode、Copilot、Cline、Roo Code、Zed、Antigravity、Kilo CLI、Kimi CLI、Mistral Vibe、Grok Build、Factory Droid、OMP、Pi、Plank。 |
| マルチブランチインデックス(オプトイン) | 100%ローカル | 常に最新 |
| ブランチごとのオプションのデータベース。チェックアウトを切り替えずにブランチ間の差分と検索が可能。 | データがマシンから出ることはありません。APIキー不要。外部サービス不要。すべてローカルのlibSQLデータベースで実行されます。 | すべてのMCP呼び出しでオンデマンドの鮮度チェック(30秒のクールダウン)に加え、サーバー接続時のキャッチアップ同期。マルチエージェント作業ではgit worktreesの使用が想定されています -- 各エージェントが独自のチェックアウトを持ち、インデックスの分岐はファイルウォッチャーではなくgitによってマージされます。 |
| サブプロセス分離抽出 | コードヘルス分析 | アトミック編集プリミティブ |
| 任意のtree-sitterグラマーでのネイティブクラッシュ(abort、segfaultなど)はワーカーのみを終了させます。プールがそれを再生成し、同期は継続します。不正なファイルでも同期が停止することはありません。 | 複合ヘルススコア(0-10000)、Gini不平等度、ファイルDAG深度、設計構造マトリックス、リスク加重テストギャップ、セッションデルタ。 | 正規表現やシェルクォーティングの危険性なしでファイルを編集:ユニークアンカーstr_replace、アトミック複数置換、AST書き換え、アンカー挿入。書き込み後に自動で再インデックスします。 |
クイックスタート
1. インストール
Homebrew(macOS):
brew install aovestdipaperino/tap/tokensave
Scoop(Windows):
scoop bucket add tokensave https://github.com/aovestdipaperino/scoop-bucket
scoop install tokensave
Cargo / cargo-binstall(任意のプラットフォーム):
# Fast install prebuilt binary without compiling:
cargo binstall tokensave

# Or compile from source:
cargo install tokensave                          # full (50+ languages, default)
cargo install tokensave --features medium        # medium tier
cargo install tokensave --no-default-features    # lite (smallest binary)
プリビルドバイナリ(Linux、Windows、macOS):
最新リリースからダウンロードし、バイナリをPATHに配置します。
| プラットフォーム | アーカイブ |
|---|---|
| macOS(Apple Silicon) | tokensave-vX.Y.Z-aarch64-macos.tar.gz |
| Linux(x86_64) | tokensave-vX.Y.Z-x86_64-linux.tar.gz |
| Linux(ARM64) | tokensave-vX.Y.Z-aarch64-linux.tar.gz |
| Windows(x86_64) | tokensave-vX.Y.Z-x86_64-windows.zip |
2. エージェントの設定
tokensave install                         # auto-detects installed agents
tokensave install --agent antigravity     # Google Antigravity (formerly Windsurf)
tokensave install --agent auggie          # AugmentCode
tokensave install --agent claude          # Claude Code
tokensave install --agent cline           # Cline
tokensave install --agent codex           # OpenAI Codex CLI
tokensave install --agent copilot         # GitHub Copilot
tokensave install --agent cursor          # Cursor
tokensave install --agent droid           # Factory Droid
tokensave install --agent gemini          # Gemini CLI
tokensave install --agent kilo            # Kilo CLI
tokensave install --agent kiro            # AWS Kiro
tokensave install --agent kimi            # Moonshot Kimi CLI
tokensave install --agent omp             # Oh My Pi (OMP)
tokensave install --agent opencode        # OpenCode
tokensave install --agent pi              # Pi (pi.dev)
tokensave install --agent plank           # Plank (macOS only)
tokensave install --agent qwen            # Qwen Code
tokensave install --agent roo-code        # Roo Code
tokensave install --agent vibe            # Mistral Vibe
tokensave install --agent zed             # Zed
tokensave install --agent grok            # Grok Build (xAI)
tokensave install --git-hook yes           # auto-install the global post-commit and post-checkout hooks (no prompt)
tokensave install --git-hook no            # skip the post-commit and post-checkout hooks (no prompt)
tokensave githooks                         # show which global git hooks tokensave owns
tokensave githooks off                     # remove them, leaving any hook content you wrote
各エージェントはネイティブ設定形式でMCPサーバーが登録されます。Claude CodeにはさらにPreToolUseフック(無駄なExploreエージェントをブロック)、UserPromptSubmitフック、Stopフック、CLAUDE.mdのプロンプトルール、自動許可されたツール権限が追加されます。KiroにはグローバルMCP設定、リソースとして読み込まれるtokensave.mdステアリング、組み込み/トークンセーブツール承認、委任ガードレールフック、書き込み後同期を備えたtokensave管理のデフォルトエージェントが設定されます。ユーザー管理のKiroエージェントは保持されます。
グローバルOMPインストールは、ベアのomp config pathが報告するプロファイルを対象とし、<resolved-agent-dir>/mcp.jsonと<resolved-agent-dir>/rules/tokensave.mdを書き込みます。名前付きプロファイルにインストールする場合はOMP_PROFILEまたはOMPの互換性のあるPI_PROFILEをエクスポートします。OMPのリゾルバーはPI_CONFIG_DIRとPI_CODING_AGENT_DIRも尊重します。tokensaveはOMPのプロファイルロジックを複製するのではなく、そのネイティブリゾルバーを信頼します。tokensaveはOMP用のMCPとアドバイザリールールをインストールします。OMPフックの強制はインストールしません。
すべての変更は冪等です -- アップグレード後に再実行しても安全です。エージェント設定後、グローバルなgit post-commitおよびpost-checkoutフックが提案されます。tokensave uninstallはエージェント統合とともにこれらのフックを削除します。--keep-git-hooksを渡すと残し、tokensave githooksで個別に管理できます。
複数のエージェントを一度にインストール
--agentを繰り返して、1回の実行で複数のエージェントをインストールします。権限付与、gitフックの提案、グローバル設定の書き込みは、リストするエージェントの数に関係なくそれぞれ1回だけ行われます:
tokensave install --agent claude --agent cursor --agent droid
プロジェクトローカルインストール
デフォルトではtokensave installはMCPサーバーをグローバルエージェント設定(例:~/.claude.json)に登録します。現在のプロジェクトのみにtokensaveを登録するには、--localを追加します:
tokensave install --local --agent claude
tokensave install --local --agent omp
これにより、チームと共有・コミットできるプロジェクトスコープの設定が書き込まれます。Claudeの場合、それは./.mcp.json、./.claude/settings.json、./CLAUDE.mdです。OMPはOMP CLIを呼び出さずに./.omp/mcp.jsonと./.omp/rules/tokensave.mdを使用します。サポートされているエージェント:claude、cursor、droid、gemini、zed、opencode、roo-code、kiro、auggie、omp、plank(各エージェントは独自のプロジェクトファイルを書き込みます。例:plankの場合は.cursor/mcp.json、.factory/mcp.json、.gemini/settings.json、.zed/settings.json、opencode.json、.roo/mcp.json、.kiro/settings/mcp.json、.augment/settings.json、.omp/mcp.json、.mcp.json)。他のエージェントにはプロジェクトスコープの設定がなく、--localでエラーを報告します。
プロジェクトローカルインストールはtokensave uninstall --localで削除します。
3. プロジェクトのインデックス化
cd /path/to/your/project
tokensave init
これにより、知識グラフデータベースを含む.tokensave/ディレクトリが作成されます。初期化と同期は別々のコマンドです:initはプロジェクトごとの1回限りのオプトインであり、syncはすでに初期化されたプロジェクトのみを更新します。これにより、グローバルgitフックがインデックス化する意図のないリポジトリにデータベースを静かに作成するのを防ぎます。initの後、tokensave syncを使用して増分更新します -- 変更されたファイルのみが再インデックスされます。
Claude Code用にインストールが書き込むもの
MCPサーバー
{
  "mcpServers": {
    "tokensave": {
      "command": "/path/to/tokensave",
      "args": ["serve"]
    }
  }
}
PreToolUseフック
フックはtokensave hook-pre-tool-useを実行します -- ネイティブRustコマンド(bashやjqは不要)。Agent、Grep、Glob、Bashツール呼び出しをインターセプトします:Exploreエージェントは完全にブロックされ、シンボル形状のgrep/rg/ag呼び出し(プレーンな識別子、代替、\bでラップされた名前)は一致するtokensave MCPツールにリダイレクトされ、コード拡張子に対するパス形状の探索(Glob、find -name、fd --extension)はtokensave_filesにリダイレクトされます。正規表現パターン、git grep、パイプされたコマンド、非コード拡張子、インデックス外の検索ルート、およびコマンドの動作を変更するfind述語(-exec、-delete、-mtime)はすべてそのまま通過します。シェルごとにTOKENSAVE_DISABLE_GREP_HOOK=1を設定してオプトアウトできます。
フィルターは最も具体的なものから順に読み取られます:明示的なtypeが優先され、次に明示的なファイルグロブ、次に検索パス。したがって、glob: "**/*.md"付きのpath: "."のようなドキュメント検索は、広いパスでのコード検索として扱われるのではなく通過します。一方、コードのみのグロブ(**/*.rs)は非コードパスでもリダイレクトされます。混合グロブ(**/*.{rs,md})はドキュメントを返す可能性があるため通過します。
ヘッドレス/サブエージェントディスパッチ(claude -p)。 オーケストレーションセッションによってディスパッチされた子プロセスは、このフックを含む~/.claude/settings.jsonを継承します。子に生の検索を実行させるには、子の環境でTOKENSAVE_DISABLE_GREP_HOOK=1を設定します -- ネイティブバイナリがそれを尊重し、すべてのパス(Grep、Glob、Bash、Agent)を通過させるため、すべてのフックを除去する大雑把な--settings '{"hooks": {}}'は不要です。ガードレールはステートレスです:引用履歴を参照しないため、上記のシンボル形状の検索のみをリダイレクトし、型指定されていない調査ファンアウトを誘導します。通常のコマンドは、セッションがインタラクティブでもヘッドレスでも影響を受けません。
CLAUDE.mdルール
Exploreエージェントや生のファイル読み取りに手を伸ばす前にtokensaveツールを使用するようClaudeに指示する手順を~/.claude/CLAUDE.mdに追加します。
クラッシュ耐性同期
Tree-sitterグラマーはコンパイルされたC/C++コードです。内部アサーションにヒットしたり、Rustのパニック処理ではインターセプトできないパスでプロセスを終了したりすることがあります。v4.3.0以降、すべてのファイルは短命のワーカーサブプロセス内で解析されます:グラマーがセグメンテーションフォールトを起こしたり、abort()を呼び出したり、スタックオーバーフローにヒットしたりすると、ワーカーのみが終了します。プールがそれを再生成し、問題のあるファイルはログに記録されてスキップされ、syncは継続します。
ワーカーは隠しextract-workerサブコマンドで、親に対して256ビットのスポーンごとのトークンで認証されます。これはTOKENSAVE_WORKER_TOKEN環境変数として、またstdinで受信する最初の32バイトとして必須です。ユーザーによる直接呼び出しは失敗します。デフォルトはavailable_parallelism()ワーカーで、TOKENSAVE_DISABLE_SUBPROCESS=1でオプトアウトします。
編集プリミティブ(tokensave_str_replace、tokensave_insert_atなど)は引き続きプロセス内で実行されます:サブプロセスのオーバーヘッドが支配的になる1ファイルずつの処理を対象とし、抽出クラッシュはエージェントに即座に表示されます。
マルチブランチインデックス(オプション)
tokensaveはgitブランチごとに個別のコードグラフをオプションで維持できます。有効にすると、ブランチを切り替えても古い結果が返されることはなく、別のブランチで既に解析したファイルを再インデックスすることもありません。マルチブランチ追跡はオプトインです -- 有効にしない場合、tokensaveはすべてのブランチに単一のデータベースを使用します。
仕組み
ブランチを追跡すると、tokensaveは最も近い祖先DBをコピーし、異なるファイルのみを同期します。つまり、mainからのフィーチャーブランチの追跡はほぼ瞬時です -- 変更したファイルのみを解析します。
CLIコマンド
tokensave branch add              # track the current branch
tokensave branch list             # see tracked branches and DB sizes
tokensave branch remove <name>    # stop tracking a branch
tokensave branch removeall        # remove all tracked branches except default
tokensave branch gc               # clean up branches deleted from git
ブランチ間MCPツール
3つのMCPツールにより、チェックアウトを切り替えずにブランチ間クエリが可能です:
tokensave_branch_search-- 別のブランチのグラフでシンボルを検索tokensave_branch_diff-- 2つのブランチ間のコードグラフを比較:追加、削除、変更(シグネチャが異なる)されたシンボル。ファイルと種類のフィルターをサポート。tokensave_branch_list-- 追跡されたブランチをDBサイズ、親ブランチ、同期時刻とともに一覧表示
ブランチフォールバック
MCPサーバーが現在のブランチのデータベースを見つけられない場合、最も近い祖先ブランチのDBから提供し、tokensave branch addの実行を提案する警告をすべてのツール応答に含めます。
自動ブランチ追跡(v7.3.0)
マルチブランチモードがブートストラップされると(最初の手動によるtokensave branch addがブランチメタデータを作成した後)、新しいブランチは祖先DBにフォールバックする代わりに自動的に追跡できます。これをカバーする2つの独立したメカニズムがあります。シングルDBモードのプロジェクトは影響を受けず、どちらのメカニズムもデフォルトブランチのデータベースには決して触れません。
Gitフック(ブランチチェックアウト時)。 tokensave installがセットアップするpost-checkoutフックは、ブランチチェックアウト(ファイルチェックアウトとは対照的)を認識し、バックグラウンドでtokensave branch addを実行します。そのコマンドは、ブランチがすでに追跡されているかデフォルトブランチである場合は何もしないため、既知のブランチ間の通常の切り替えにはコストがかかりません。新しいgit cloneと新しいgit worktree addの最初のチェックアウトもブランチチェックアウトであり、デフォルトブランチではないブランチに着地する可能性があります(git clone -b feature、git worktree add -b feature)。そこでは、フックはtokensave initを最初に実行し、その後にtokensave branch addをその順序で実行します。以前のバージョンによって書き込まれたフックは、インストールされたときの本体を保持します(インストーラーは既存のフックを書き換えることはありません)。そのため、それらのインストールでは、新しいワークツリーには以下のauto_trackまたは手動のtokensave branch addが引き続き必要です。
オープン時自動追跡(オプトイン)。 TokenSave::openが実行されるとき(CLIコマンドまたはMCPサーバー起動)、アクティブなブランチが未追跡の場合、tokensaveは最も近い追跡済み祖先のDBをコピーしてブランチメタデータに記録することで、その場で追跡できます。これはauto_track設定フィールド(デフォルトfalse)またはTOKENSAVE_AUTO_TRACK環境変数によって制御され、環境変数は実行ごとに設定を上書きします(0、false、no、off、または空を除く任意の値で有効になります)。コピーは手動のbranch addが実行するものと同じほぼ瞬時の祖先DBコピーです。その時点では同期は実行されません。post-commitフックがコミット時に新しいブランチDBを最新に保つか、tokensave syncを実行して即座に更新します。自動追跡は厳密にベストエフォートです。失敗は警告として報告され、open()は通常の祖先フォールバックで続行するため、ツール呼び出しを壊すことはありません。
要約すると、フックがインストールされている場合、新しいフィーチャーブランチをチェックアウトすると(新しいクローンやワークツリーが開始するブランチを含む)、透過的に独自のブランチごとのグラフが与えられます。auto_trackが有効な場合、チェックアウト外で作成されたブランチでも、tokensaveがそのブランチでプロジェクトを最初に開いたときに取得されます。
完全なガイドについてはdocs/BRANCHING-USER-GUIDE.mdを参照してください。
クロスセッションメモリ
3つのMCPツールが、セッションをまたいで決定とコード領域のコンテキストを永続化し、プロジェクトごとの.tokensave/tokensave.dbに保存します。
| ツール | 目的 |
|---|---|
tokensave_record_decision | オプションの理由、ファイル、タグ付きで設計/アーキテクチャの決定を保存 |
tokensave_record_code_area | エージェントが作業したパスをマーク(タッチカウンター+ last_touched_at) |
tokensave_session_recall | 保存された決定に対するFTS5クエリ。2つの書き込みツールと組み合わせて使用 |
これらを使用して、エージェントがセッションごとにアーキテクチャの選択を再説明する必要がないようにします。
節約台帳
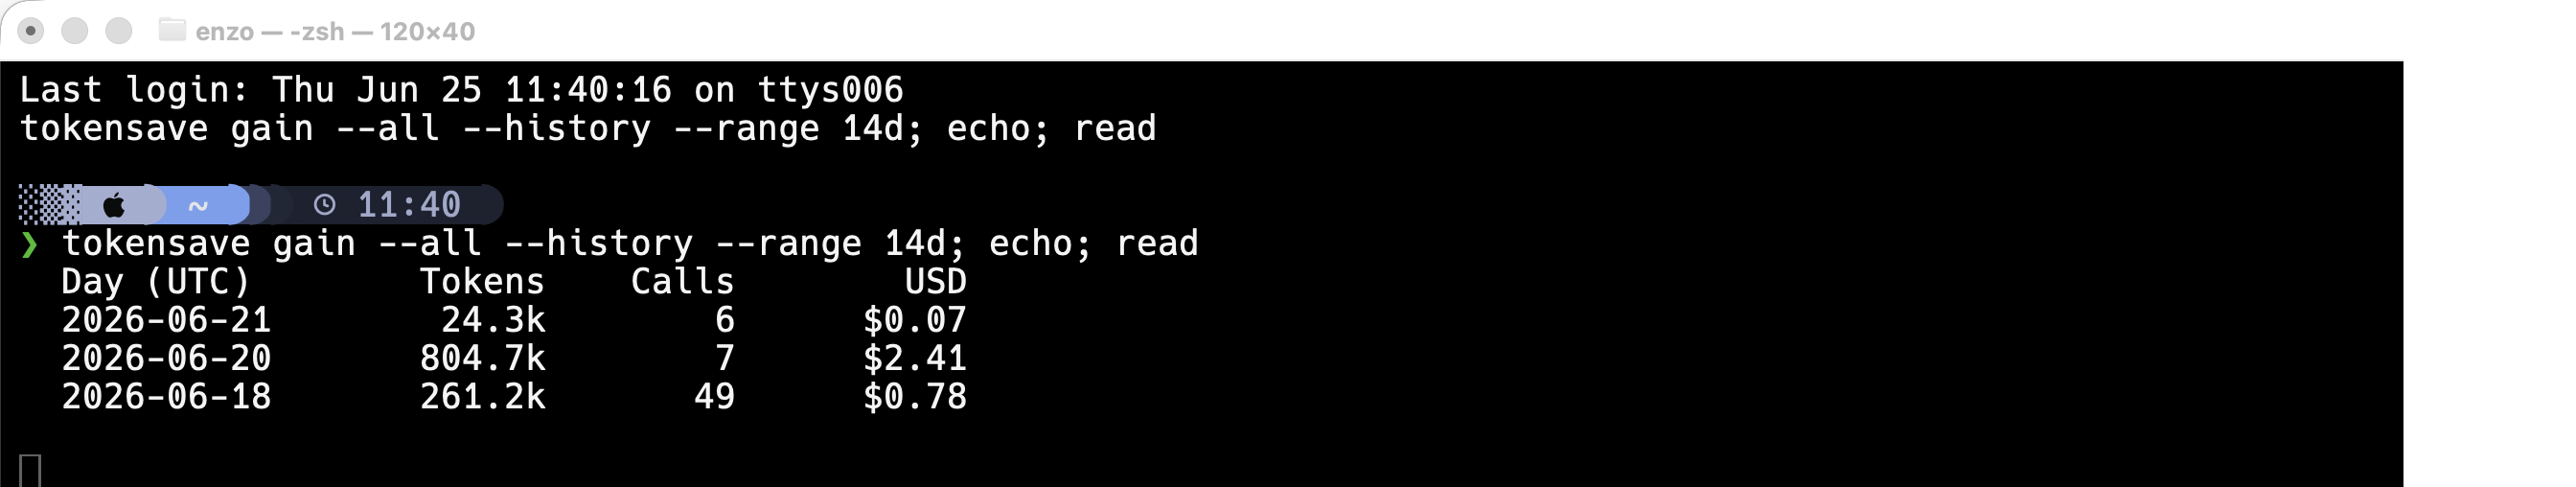
すべてのMCP呼び出しは、~/.tokensave/global.db(savings_ledgerテーブル)に追加専用の行を書き込みます。tokensave gainで検査します:
tokensave gain                    # current project, last 30 days
tokensave gain --all              # all projects
tokensave gain --history --range 7d
tokensave gain --json
ドル見積もりは既存の価格設定モジュール(Sonnet入力価格、LiteLLM経由で毎日更新)を使用します。
再現可能なベンチマーク
tokensave benchは固定クエリセットをtokensave_contextを通じて実行し、フルファイルベースラインに対する取得節約を報告します(CCE方法論をミラーリング):
tokensave bench                                    # ships with 10 default queries
tokensave bench --queries my-queries.toml --json
tokensave bench --max-nodes 5
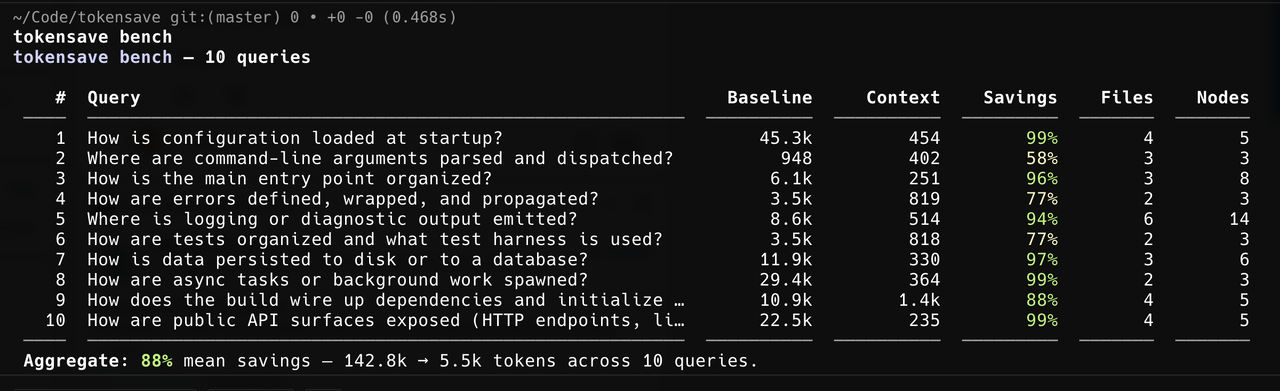
このリポジトリ(tokensave自体)に対して、同梱の汎用クエリセットを使用して測定:
| # | クエリ | ベースライン | コンテキスト | 節約 | ファイル | ノード |
|---|---|---|---|---|---|---|
| 1 | 起動時に設定はどのように読み込まれますか? | 45.3k | 454 | 99% | 4 | 5 |
| 2 | コマンドライン引数はどこで解析されディスパッチされますか? | 948 | 402 | 58% | 3 | 3 |
| 3 | メインエントリポイントはどのように構成されていますか? | 6.1k | 251 | 96% | 3 | 8 |
| 4 | エラーはどのように定義、ラップ、伝播されますか? | 3.5k | 819 | 77% | 2 | 3 |
| 5 | ロギングまたは診断出力はどこで生成されますか? | 8.6k | 514 | 94% | 6 | 14 |
| 6 | テストはどのように構成され、どのテストハーネスが使用されますか? | 3.5k | 818 | 77% | 2 | 3 |
| 7 | データはディスクまたはデータベースにどのように永続化されますか? | 11.9k | 330 | 97% | 3 | 6 |
| 8 | 非同期タスクまたはバックグラウンド作業はどのように生成されますか? | 29.4k | 364 | 99% | 2 | 3 |
| 9 | ビルドはどのように依存関係を配線し状態を初期化しますか? | 10.9k | 1.4k | 88% | 4 | 5 |
| 10 | パブリックAPIサーフェスはどのように公開されますか(HTTPエンドポイント、ライブラリエクスポート、CLIコマンド)? | 22.5k | 235 | 99% | 4 | 5 |
集計: 平均88%の取得節約(10クエリで142.8k→5.5kトークン)。
デフォルトのクエリセットは、ほとんどのアプリケーションコードベース(CLI、デーモン、サービス)に存在するパターンを対象としています。tokensave benchを使用して自分のプロジェクトで実行して数値を確認するか、より厳密な再現のために調整されたクエリファイル(--queries my.toml)を作成します。
大規模な実世界リポジトリに対するCriterionベンチマーク
benches/large_repos.rsはcriterionマイクロベンチマークで、固定リファレンスにピン留めされた4つの大規模オープンソースコードベースに対してMCPツールをエンドツーエンドで実行します。各ツールは、リポジトリごとにインデックス化されたグラフからサンプリングされた引数(ノードID、修飾名、ファイルグロブなど)を持つ少なくとも5つのクエリで駆動されるため、タイミングは実行間で再現可能です。
リポジトリとピン留めされたリファレンス(benches/repos.rsで定義):
| リポジトリ | URL | リファレンス |
|---|---|---|
| polkadot-sdk | https://github.com/paritytech/polkadot-sdk | polkadot-stable2412 |
| emacs | https://github.com/emacs-mirror/emacs | emacs-30.1 |
| scipy | https://github.com/scipy/scipy | v1.14.1 |
| node | https://github.com/nodejs/node | v22.11.0 |
各リポジトリは最初の使用時にシャロークローンされ(git init + git fetch --progress --depth 1 origin <ref> + checkout FETCH_HEAD)、ローカルにキャッシュされます。後続の実行はチェックアウトを再利用します。Git出力はターミナルにストリーミングされるため、マルチGBのフェッチでリアルタイムの進行状況が表示されます。
カバーされるツール(各5クエリ)。 読み取りツール — search、context、callers、callees、node、by_qualified_name、signature、impact、body、files、complexity、doc_coverage、largest、hotspots、god_class、module_api、derives、dead_code、rank、coupling、circular。書き込みツール — str_replace、multi_str_replace、insert_at、および(ast-grepがPATHの場合)ast_grep_rewrite。
毎回の強制同期。 ベンチマークが発火する前に、ハーネスは各リポジトリでtokensave sync --forceと同等の処理を実行します(.tokensave/の鮮度に関係なくindex_all())。これにより、タイミングは常にピン留めされたソースを反映します。
書き込みベンチとクリーンアップ。 書き込みツールはファイルを変更します。「一致は一意でなければならない」という前提条件を維持するために、ハーネスはcriterionのiter_batchedを使用します。<repo>/.tokensave-bench-scratch/の下の小さなスクラッチファイルが毎回のタイミング反復の前に既知のコンテンツで書き換えられ、その後編集ツールがそれに対して実行されます。すべてのベンチマークが完了した後、ハーネスは準備された各リポジトリ内でgit stash --include-untracked && git stash dropを実行し、作業ツリーがピン留めされたリファレンスに戻るようにします。
Criterion設定。 ベンチはcriterionのデフォルトをsample_size = 10とmeasurement_time = 30sに上書きします(標準の100 / 5秒に対して)。これにより、各クエリごとのタイミングに約30秒の測定時間が与えられ、polkadot-sdkでのtokensave_contextのような遅いツールでも安定した数値が生成されます。
実行:
# Required: a writable cache directory for the cloned repos + their indexes.

<p align="center">
  <a href="https://ai.enzolombardi.net/"><img src="https://img.shields.io/badge/built%20with-AI-D97757?style=flat-square&labelColor=101010&logo=anthropic&logoColor=white" alt="Built with AI — part of Enzo Lombardi's AI portfolio"></a>
</p>

# Expect several GB of disk and a long first run (shallow clone + full index of each repo).
export TOKENSAVE_BENCH_REPOS_DIR=~/tokensave-bench-cache

cargo bench --bench large_repos
TOKENSAVE_BENCH_REPOS_DIRが設定されていない場合、ベンチは通知を出力し、ゼロベンチマークを登録します(そのためcargo bench --allは貢献者のマシンで安価に保たれます)。
設定(すべてオプション、環境変数経由):
| 変数 | 効果 |
|---|---|
TOKENSAVE_BENCH_REPOS_DIR | 必須。 各リポジトリが$DIR/<repo-name>/にクローンされるルートディレクトリ。 |
TOKENSAVE_BENCH_REPOS | ベンチするリポジトリ名のカンマ区切りサブセット(例:TOKENSAVE_BENCH_REPOS=emacs,scipy)。デフォルトは4つすべて。 |
TOKENSAVE_BENCH_SKIP_CLONE | 設定されている場合、ベンチはフェッチする代わりに、ピン留めされたリファレンスにないリポジトリに対して即座に失敗します。CI / オフライン実行で便利です。 |
ベンチマークのフィルタリングは標準のcriterion CLIを使用します — 例えば、scipy上のsearchツールのみ:
cargo bench --bench large_repos -- 'scipy/tokensave_search'
レポート(HTML + 生サンプル)はtarget/criterion/の下に配置されます。
ピン留めされたリファレンスを変更するには(例:新しいリリースや特定のSHAに)、benches/repos.rsのREPOSを編集し、対応する$TOKENSAVE_BENCH_REPOS_DIR/<repo>/.bench-refマーカーを削除して、次の実行で再フェッチされるようにします。実行後のクリーンアップをスキップした場合(例:ベンチの途中でCtrl-Cした場合)、各リポジトリディレクトリ内でgit stash --include-untracked && git stash dropを実行すると手動で復元されます。
MCPテストマトリックスプローブ(scripts/mcp_probe)
scripts/mcp_probe/は、設定可能な実リポジトリのセットに対してstdio経由でtokensave serveを駆動し、言語ごとに5つのクエリバリアントで読み取り専用のMCPツールをすべて実行するPythonハーネスで、ツールごと/リポジトリごとのステータステーブルを生成します。同じハーネスが2つの目的に役立ちます:
- 回帰スイープ。 新しい言語サポート、新しいツール、またはリファクタリング — マトリックスを再実行すると、新しくエラー、タイムアウト、または空の結果を返すセルが🚩として目立ちます。
- パフォーマンスプローブ。 呼び出しごとのタイミングがTSVに記録されます。同じ固定コーパスのリポジトリは、大まかなクロスバージョン比較としても機能します。現在の
tokensave_inheritance_depthサイクルバグは、polkadot-sdk上の単一のツールが>60秒でタイムアウトしたときに、このハーネスによって発見されました。
レイアウト — probe.pyはドライバーです(ID一致のJSON-RPCで、遅いツールが後続の呼び出しを汚染しないようにします)。isolated.pyは呼び出しごとに新しいサーバーで単一のツールを再実行します(サーバーキューイングを回避)。build_matrix.pyはTSVを読み取り、マークダウンを出力します。tools/<lang>.pyモジュールは言語ごとのクエリセットを提供します(Rust同梱。新しいモジュールをドロップしてPython/Go/…を追加)。repos.tomlはターゲットリポジトリをリストします($TOKENSAVE_PROBE_REPOSで上書き可能)。
クイック実行:
cargo build --release --bin tokensave
python3 scripts/mcp_probe/probe.py
python3 scripts/mcp_probe/build_matrix.py > matrix.md
出力セルは✓ 5/5(クリーン)、🐛 e/N(エラー)、⏱ N/N(タイムアウト)、∅ E/N(空)、🐢 ok/slow(>10秒の呼び出し)です。エラーまたはタイムアウトを含むセルは、右端の列で🚩を獲得します。各エラーの最初の100文字を含む呼び出しごとの詳細は、フォローアップのためにTSVログに記録されます。
上記のcriterionベンチとは異なります:criterionはピン留めされたリファレンス上の焦点を絞ったツールセットの反復ごとのレイテンシを測定し、target/criterion/の下に統計レポートを生成します。mcp_probeは、指定したリポジトリでより広いクエリセットですべてのツールを実行し、測定精度よりもカバレッジの広さを最適化します。
80以上のMCPツール
サーバーは80以上のツールを公開します(オプションのast-grepバイナリがPATHにない場合は1つ少なくなります)。7.14.0以降、デフォルトで11のコアツールとtokensave_moreのみがリストされます。残りはtokensave_moreを通じてオンデマンドでリストされ、名前で呼び出し可能なままであり、"tools": "full"ですべてリストされます。以下の表は、最も一般的に使用されるものをカテゴリ別にグループ化しています。ほとんどは読み取り専用で、並列で安全に呼び出せ、readOnlyHintで注釈されています。編集プリミティブは単一ファイルにスコープされ、その場で再インデックスします。セッションベースラインとメモリ記録ツールもローカルの.tokensave状態を変更し、非読み取り専用として注釈されています。3つのコアツール(tokensave_context、tokensave_search、tokensave_status)はanthropic/alwaysLoadとしてマークされているため、クライアントのツール検索ラウンドトリップをバイパスします。
別の初期化済みプロジェクトをクエリ
セマンティック読み取りツールは、MCPサーバーを再起動せずに明示的に選択されたローカルグラフをクエリできます:
{
  "query": "screenGate",
  "graph_root": "/absolute/path/to/typewhisper"
}
選択された結果には、正規のルート/ブランチの来歴が含まれます。ノードIDはそのグラフに名前空間化され、一致するセレクターはフォローアップ呼び出しで繰り返す必要があります。たとえば、ブランチ選択クエリへのフォローアップには両方の値が含まれます:
{
  "node_id": "graph:<fingerprint>:function:<raw-id>",
  "graph_root": "/absolute/path/to/typewhisper",
  "graph_branch": "feature/auth"
}
graph_root は、すでに初期化済みプロジェクトの正確な絶対ルートでなければなりません。
graph_branch はオプションで、指定する場合は追跡対象のブランチ名を指定する必要があります。
選択したオープンは読み取り専用です。初期化、同期、マイグレーション、自動追跡、グラフ/ソースデータの書き込みは一切行いません。また、節約額の計算にも寄与しません。セレクタなしの呼び出しは、これまでとまったく同じように動作します。
graph_root は、他のプロジェクトが存在することを事前に知っている場合にのみ有用です。そのため、サーバーは次のことを通知します。提供されたルートのすぐ隣に存在する初期化済みプロジェクトは、MCP instructions、tokensave_status、および空の tokensave_search / tokensave_context 結果に名前が表示されます。これは、セッションがシンボルが存在しないと結論付ける代わりに、隣のプロジェクトを探すポイントです(#375)。提供されるのは直接の兄弟プロジェクトのみで、最大5つまでです。それらのために何かが開かれたりインデックスされたりすることはありません。クエリには依然として明示的な graph_root が必要です。
セレクタは、書き込み、シェルアウト、または現在のチェックアウトに依存するツールでは意図的に使用できません。編集プリミティブ、VCSおよびブランチツール、診断とテスト実行、依存関係とランタイムのイントロスペクション、ワークフローとセッションメモリツール、永続キャッシュツール(tokensave_redundancy)、およびサーバー管理です。これらのツールは、セレクタを黙って無視する代わりに拒否します。
ディスカバリ
| ツール | 目的 |
|---|---|
tokensave_context | タスクに関連するコードコンテキストを取得 -- エントリポイント、関連シンボル、コードスニペット |
tokensave_search | 名前でシンボルを検索(関数、クラス、型) |
tokensave_node | 特定のシンボルの詳細とソースコードを取得 |
tokensave_files | インデックスされたプロジェクトファイル(ソースと追跡されたアーティファクト)をフィルタリング付きで一覧表示 |
tokensave_module_api | ファイルまたはディレクトリのパブリックAPIサーフェス |
tokensave_similar | 類似した名前のシンボルを検索 |
tokensave_annotations | 属性/アノテーション/デコレータのイントロスペクション -- すべてのアノテーションのヒストグラム、またはターゲットフィルタ付きのサイトごとのリスト |
tokensave_doc | ソースファイルの付属Markdownドキュメント -- ドキュメントコンテンツ、対象ファイル、および陳腐化シグナル |
tokensave_dependencies | 17のエコシステムにわたるパッケージマニフェストのイントロスペクション -- ワークスペースサマリー、パッケージごとのルックアップ、ライセンスサーフェス、バージョン差異 |
tokensave_status | インデックスステータス、統計、節約されたトークン |
非コードアーティファクト
tokensave_files はソース以上のものをカバーします。拡張子が artifact_extensions(デフォルトでは .feature、.json、.yaml、.yml、.sql、.toml、.proto、.graphql、.md、.bnd、.bndrun)にリストされているファイルは、パスで追跡されるため、「ログインフローの .feature ファイルはどこにあるか」といった質問に対して、ブロックされた find ではなくグラフによる回答が得られます(#323)。これらは決して解析されず、シンボルを提供しません。kind: "artifact" と kind: "code" は2つの間をフィルタリングし、「コード」を意味する分析はこれらを除外します。言語エクストラクタによってすでに処理されている拡張子はこのリストでは無視されるため、言語の解析を停止するために使用することはできません。
このリストは、リテラル検索が内部を調べられるものも決定します(#442)。tokensave_search に対するリテラル(literal: true)検索は、シンボルではなくバイトを読み取るため、パーサーは不要ですが、インデックスされたファイルを反復処理するため、インデックスが行を保持しているファイルにしか到達できません。追跡された .rst ドキュメントや .tmpl テンプレートには、エクストラクタもデフォルトのアーティファクトエントリもないため、そのマッチは見つかりません。ここに拡張子を追加して tokensave sync -f を実行すると、その行は他の行と同様に検索され、シンボルコンテキストがないため enclosing: null 付きで報告されます。すべての追跡ファイルに到達できなかったリテラル応答は、件数と拡張子を指定した unscanned ブロックでその旨を明示するため、部分的な回答が完全なものとして提示されることはありません。
コールグラフと影響
| ツール | 目的 |
|---|---|
tokensave_callers | 関数を呼び出すものを検索 |
tokensave_callees | 関数が呼び出すものを検索 |
tokensave_impact | シンボルの変更によって影響を受けるものを確認 |
tokensave_affected | ソース変更の影響を受けるテストファイルを検索 |
tokensave_rename | グラフベースの名前変更:信頼度クラス(exact、heuristic、ambiguous、text_only)を持つすべてのサイト、差分プレビュー、および全か無かの適用。バインディング認識なし |
tokensave_hotspots | 最も接続されたシンボル(最も高い呼び出し数) |
コード品質
| ツール | 目的 |
|---|---|
tokensave_complexity | 循環的複雑度と認知的複雑度、ネスト深度、Halsteadメトリクス、保守性インデックス、CRAP、および安全性メトリクスで関数をランク付け |
tokensave_dead_code | 到達不能なシンボルを検索(入力エッジなし。曖昧性候補として名前が付けられたシンボルは除外) |
tokensave_ambiguous_calls | リゾルバが1つのターゲットに特定できなかった呼び出しサイト。すべての同点候補を含む |
tokensave_god_class | メンバーが多すぎるクラスを検索 |
tokensave_coupling | ファンイン/ファンアウトでファイルをランク付け |
tokensave_inheritance_depth | 最も深い継承階層を検索 |
tokensave_circular | 循環ファイル依存関係を検出 |
tokensave_imports | モジュールレベルのインポート依存関係、サイクル、およびカットシミュレーション |
tokensave_recursion | 再帰的/相互再帰的な呼び出しサイクルを検出 |
tokensave_unused_imports | 参照されていないインポートステートメント |
tokensave_doc_coverage | ドキュメントが欠落しているパブリックシンボル |
tokensave_simplify_scan | 変更されたファイルの品質分析(重複、デッドコード、複雑度) |
コードヘルス分析
5つのツールが、既存のグラフから構造品質シグナルを表面化します。複合スコアは、独立した次元にわたる幾何平均を使用するため、単一の次元を操作することはできません。
| ツール | 目的 |
|---|---|
tokensave_health | 非循環性、深さ、等価性、冗長性、およびモジュール性からの複合品質シグナル(0-10000) |
tokensave_gini | 任意のメトリクス(複雑度、行数、ファンイン/アウト、メンバー)のジニ不平等係数 -- 神ファイルと不均一な分布を検出 |
tokensave_dependency_depth | 最長のファイルレベル依存チェーン(Lakosレベライゼーション)。Tarjan SCCサイクル解除後の完全なチェーン再構築付き |
tokensave_dsm | stats、clusters、または matrix 形式の設計構造マトリックス -- レイヤリング違反と隠れた結合を明らかにする |
tokensave_test_risk | 複雑度、ファンイン、カバレッジ、および90日間のgitチャーンを単一スコアに組み合わせたリスク加重テストギャップ分析 |
セッション
AIコーディングセッションの開始時にヘルスメトリクスのスナップショットを取得し、最後に差分を確認して何が改善または悪化したかを確認します。
| ツール | 目的 |
|---|---|
tokensave_session_start | 現在のヘルスメトリクスをJSONベースラインとして保存し、後で比較 |
tokensave_session_end | ベースラインに対して再計算して差分 -- 次元ごとのデルタ、合格/不合格、自動クリーンアップ |
編集プリミティブ
エージェントが正規表現やシェルクォートの危険なしにファイルを変更できる4つのライターツール。それぞれが単一ファイル、アンカー付きであり、書き込み後にその場で再インデックスをトリガーするため、グラフが古くなることはありません。
| ツール | 目的 |
|---|---|
tokensave_str_replace | 一意の old_str を new_str に置き換えます。0または1より多いマッチの場合は失敗します(マルチ編集バグから保護) |
tokensave_multi_str_replace | N個の (old, new) 置換を原子的に適用 -- 全か無かのトランザクション |
tokensave_insert_at | 一意のアンカー文字列または行番号の前後にコンテンツを挿入 |
tokensave_ast_grep_rewrite | --rewrite モードの ast-grep CLI による構造的コード書き換え |
Gitとワークフロー
| ツール | 目的 |
|---|---|
tokensave_diff_context | 変更されたファイルのセマンティックコンテキスト -- 変更されたシンボル、依存関係、影響を受けるテスト |
tokensave_commit_context | コミットメッセージ作成のための未コミット変更のセマンティックサマリー |
tokensave_pr_context | プルリクエスト説明のためのgit参照間のセマンティック差分 |
tokensave_changelog | 2つのgit参照間のセマンティック差分 |
tokensave_test_map | シンボルレベルのソースからテストへのマッピング。カバーされていないシンボル検出付き |
tokensave_test_coverage | 推移的な呼び出しエッジ展開を伴うファイル/シンボル/テスト関数ごとのカバレッジロールアップ |
型システム
| ツール | 目的 |
|---|---|
tokensave_type_hierarchy | トレイト、インターフェース、クラスの再帰的型階層ツリー |
tokensave_rank | 関係数でノードをランク付け(最も実装されたインターフェース、最も拡張されたクラス) |
tokensave_distribution | ファイルまたはディレクトリごとのノード種類の内訳 |
tokensave_largest | サイズでノードをランク付け -- 最大のクラス、最長のメソッド |
移植
| ツール | 目的 |
|---|---|
tokensave_port_status | 移植の進行状況を追跡するためにソース/ターゲットディレクトリ間のシンボルを比較 |
tokensave_port_order | 移植のためのシンボルのトポロジカルソート -- 葉を最初に移植し、次に依存関係 |
マルチブランチ
| ツール | 目的 |
|---|---|
tokensave_branch_search | 別のブランチのグラフでシンボルを検索 |
tokensave_branch_diff | ブランチ間のシンボルを比較(追加/削除/変更) |
tokensave_branch_list | DBサイズと同期時間で追跡されたブランチを一覧表示 |
MCPリソース
4つのリソースが resources/list と resources/read を介して公開されています:
tokensave://status-- グラフ統計(JSON)tokensave://files-- ディレクトリごとにグループ化されたインデックスファイルツリーtokensave://overview-- 言語分布とシンボル種類を含むプロジェクトサマリーtokensave://branches-- DBサイズと親情報を含む追跡されたブランチ
トークン追跡
tokensave は、すべてのMCPツール呼び出しで節約したトークンを測定します。各ツール応答には、その特定の呼び出しで回避された生ファイルトークン数を示す tokensave_metrics: before=N after=M 行が含まれます。
レポートのオフ。 メトリクス行は、MCP instructions の文とともに、エージェントに節約額を報告するよう求めます。つまり、モデルは、tokensave が 入力 トークンで節約したことを説明するために 出力 トークンを費やすことになります。出力トークンはより高価な種類であるため、エージェントがほぼすべてのターンで tokensave に言及する場合、その説明が利点を相殺する可能性があります(#356)。.tokensave/config.json で report_savings を false に設定するか、TOKENSAVE_REPORT_SAVINGS 環境変数を設定して実行ごとに上書きします(0、false、no、off、または空を除く任意の値で有効)。メトリクス行と指示の両方が消えます。tokensave install も同様に、エージェントプロンプトファイルへのレポートルールの書き込みを停止します。測定はどちらの場合も影響を受けません。すべての呼び出しは引き続き節約台帳に記録されるため、tokensave gain、tokensave list、status、および monitor はこれまでとまったく同じように報告を続けます。デフォルトは true のままです。
デフォルトではコアツールのみがリストされます。 MCPクライアントは、ツールが呼び出される前に、毎ターン、リストされたすべてのツールのスキーマを送信します。完全な tokensave サーフェスは約89 KBのスキーマであり、小さなコンテキストモデルではウィンドウの半分以上になる可能性があります(#576)。そのため、tools/list はコアツールのみを送信します:context、search、status、read、body、files、callers、callees、impact、str_replace、および multi_str_replace(tokensave_more で約17 KB)。initialize の指示はこれらのツールと tokensave_more がリストできる領域を指定するため、ツールスキーマを延期するクライアントでも残りが存在することを認識しています。この設定は、サーバーがリストするものを選択しますが、実行できるものを選択するわけではありません。リストされていないツールでも、名前による呼び出しには応答するため、エージェントの権限リストとフックは機能し続けます。すべてのツールをリストするには、.tokensave/config.json で "tools": "full" を設定するか、MCPサーバーの環境で TOKENSAVE_TOOLS=full を設定します。環境変数はファイルよりも優先されます。7.13.0 によって書き込まれた "tools": "full" は、保存したすべての設定に書き込まれ、古いデフォルトとして読み取られます。完全なリストを維持するには、アップグレード後に再度設定してください。
コアツールセットに加えて、サーバーはtokensave_moreも一覧表示します。area(analysis、edit、git、memory、navigate、またはall)を指定した呼び出しでは、そのセッションの残りの間、その領域のツールが一覧表示され、サーバーはnotifications/tools/list_changedを送信して、クライアントが再度リストを取得するようにします。セッションは使用する領域に対してのみ課金されます。git領域は約6 KBを追加します。list_changedを無視するクライアントは、コアリストを保持します。tokensave installは、他のすべてのツールとともにtokensave_moreを許可するため、プロンプトは表示されません。このリリースより前のインストールでは、tokensave reinstallまたはアップグレードによる再同期が権限リストを更新するまで、一度だけプロンプトが表示されます。
コスト可視性
tokensave cost                     # 7-day cost summary (default)
tokensave cost today               # today only
tokensave cost --by-model          # breakdown by Claude model
tokensave cost --by-task           # breakdown by task category (coding, debugging, exploration, ...)
tokensave cost --export json       # JSON export to stdout
tokensave cost --export csv        # CSV export to stdout
Claude Codeセッションのトランスクリプト(~/.claude/projects/**/*.jsonl)を解析し、各APIターンを13のタスクカテゴリのいずれかに分類し、モデル価格を使用してドルコストを計算し、結果を~/.tokensave/global.dbに保存して、高速な集計クエリを実現します。価格はLiteLLMから24時間ごとに更新され、オフライン時には組み込みテーブルにフォールバックします。
tokensave statusヘッダーには、今日の支出、7日間の合計、効率比(節約トークン/総トークン)を示すコスト行が含まれています。tokensave monitor TUIは、節約フィードとともにライブコストパネルを表示します。各Claude Codeセッションの終了時に、hook_stopハンドラーはターミナルに1行のレシートを出力します。
タスク分類カテゴリ:コーディング、デバッグ、機能開発、リファクタリング、テスト、探索、計画、委任、Git操作、ビルド/デプロイ、ブレインストーミング、会話、一般。分類は決定的(ツール名とBashコマンドのパターンマッチング)であり、LLM呼び出しを必要とせず、AgentSeal/codeburnから適合されています。
ライブモニター
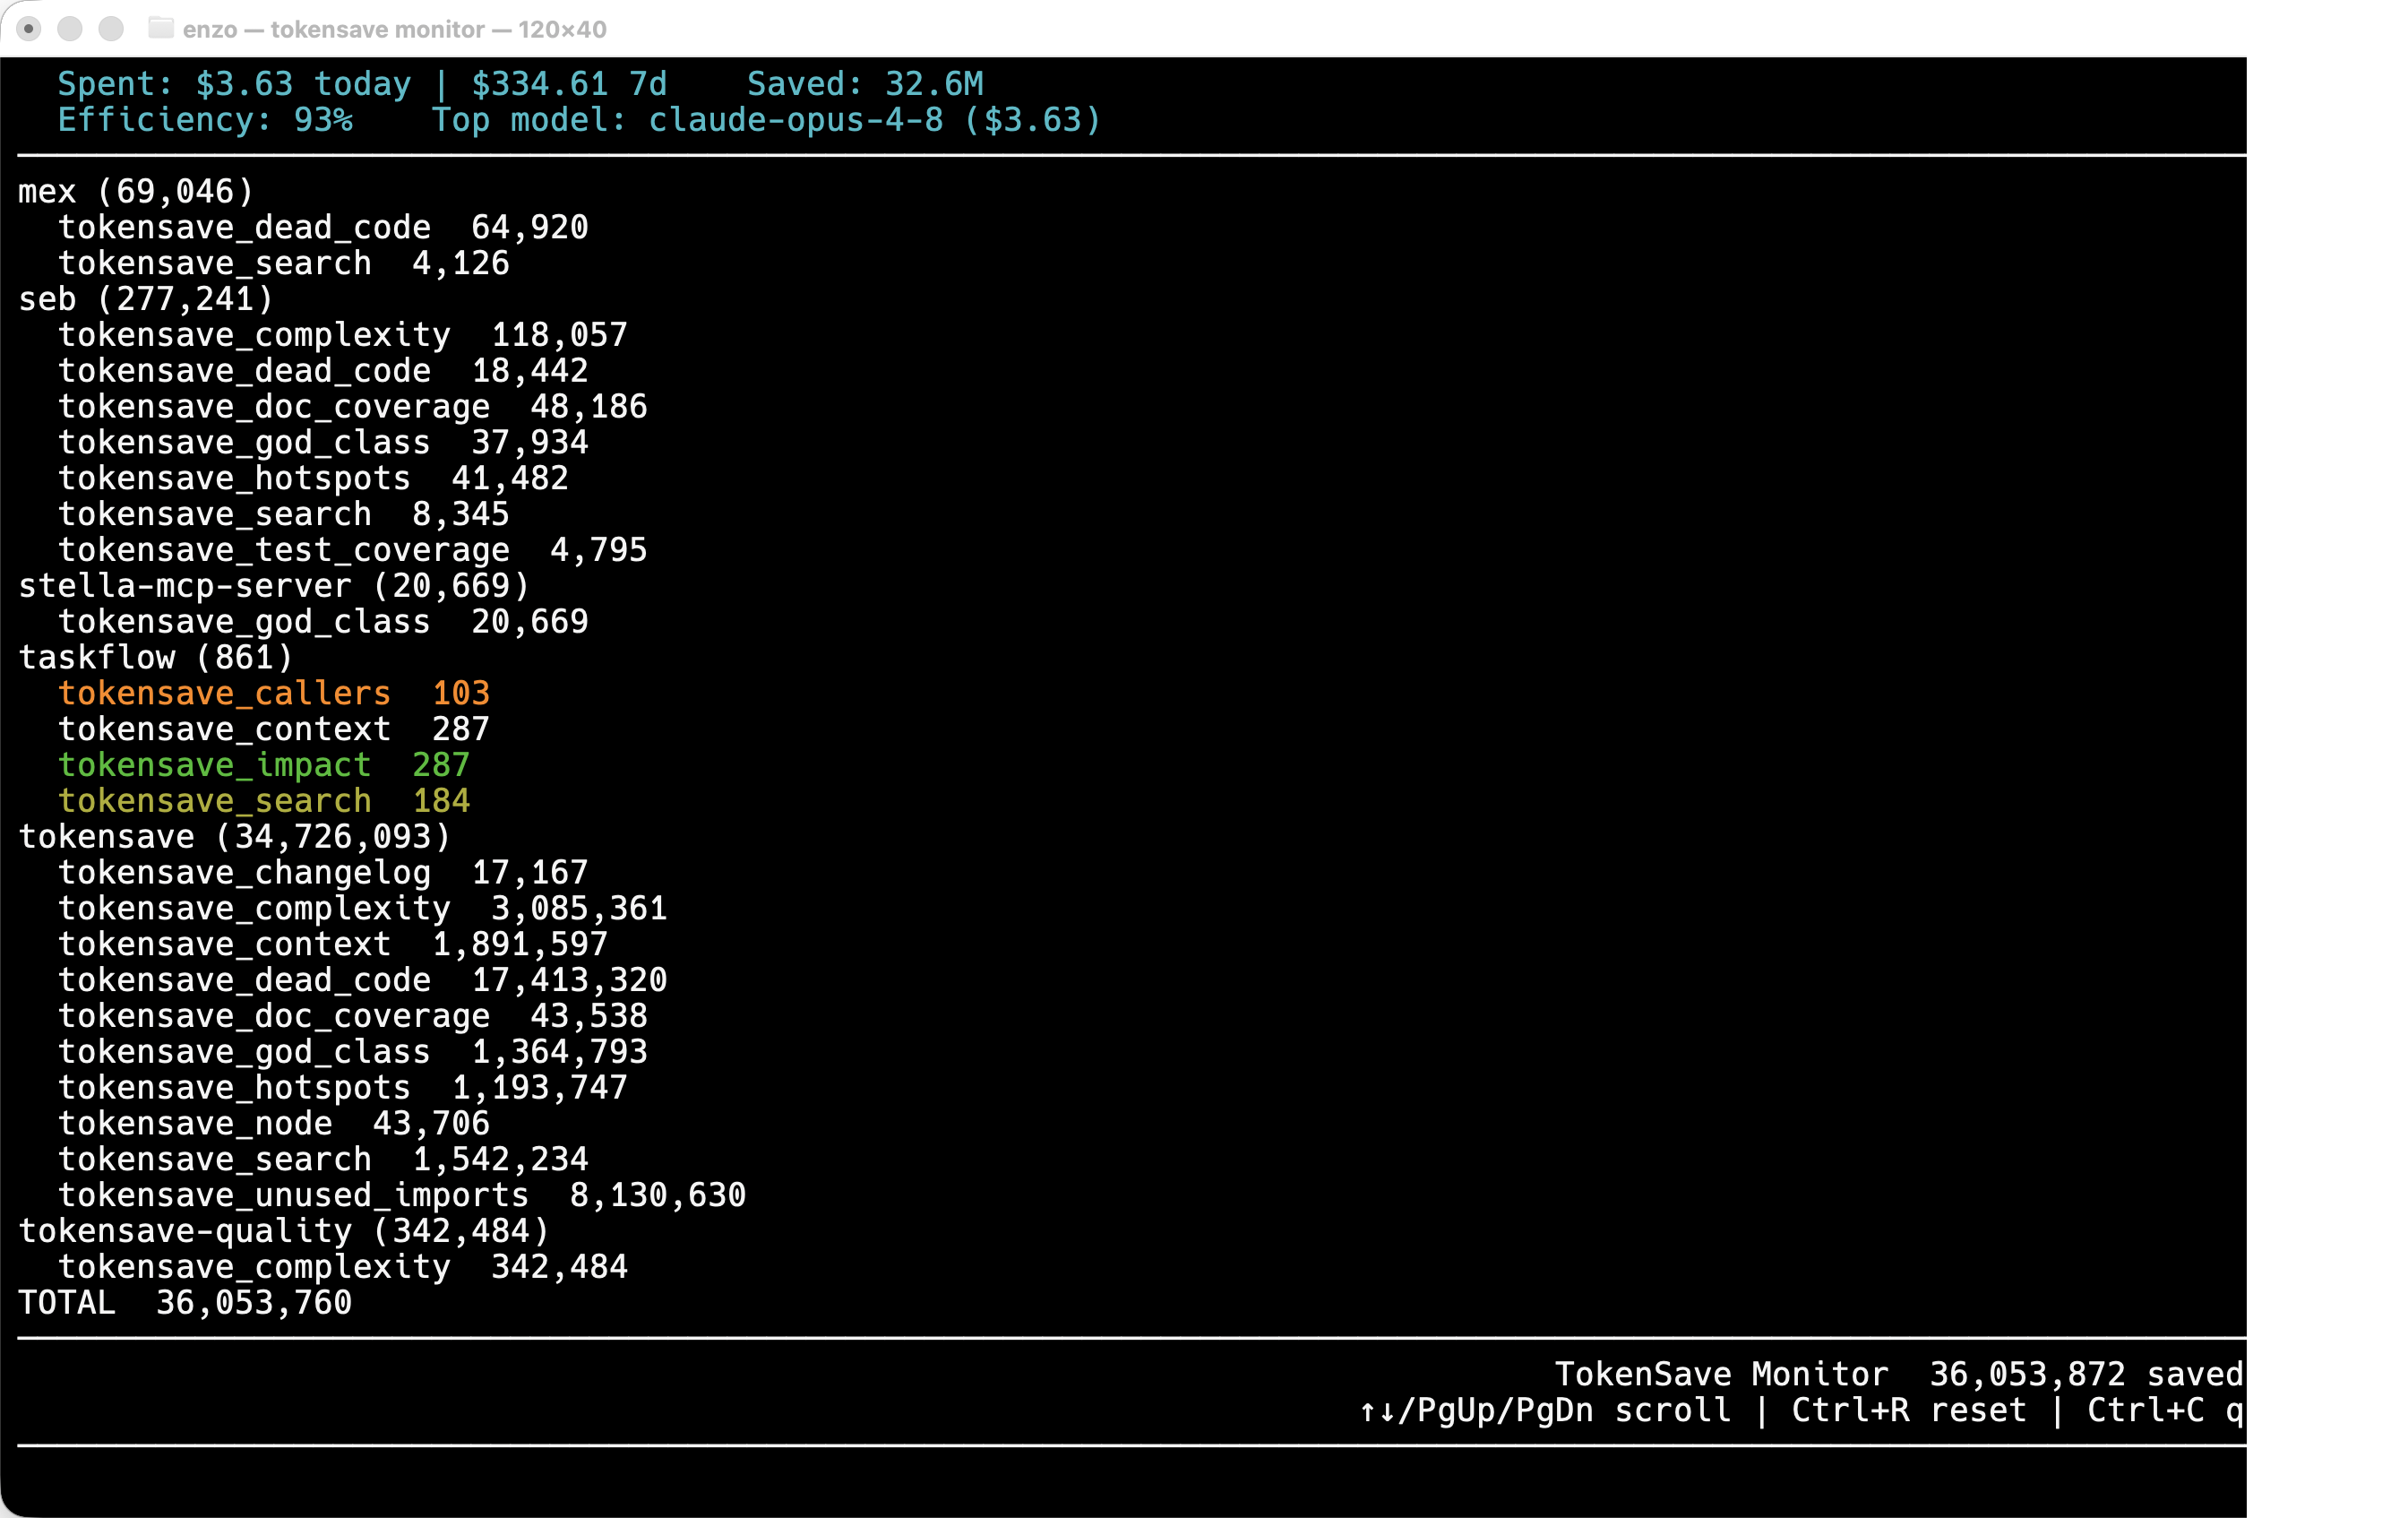
tokensave monitor
~/.tokensave/monitor.mmapの共有メモリマップリングバッファを介して、すべてのプロジェクトからのMCPツール呼び出しをリアルタイムで表示するグローバルTUI。各エントリは、プロジェクト名、ツール名、トークンデルタを示します。上部のコストパネルには、今日の支出、節約、効率、トップモデルが表示されます(30秒ごとに更新)。
メモリ診断
tokensave memory [--clean]
~/.tokensave/memory.mmapの共有メモリマップテーブルを介した、すべてのtokensaveプロセス(MCPサーバー、同期、インデックス実行)のマシン全体のメモリレポート。各インスタンスは、起動時、MCPツール呼び出しごと、同期/解決フェーズの前後に、RSSをベストエフォートで自己サンプリングするため、レポートには現在およびピークのRSSがピークを生成したフェーズとともに表示されます。これは、高いメモリ使用量を特定するために必要なデータです(#253を参照)。行はalive、dead(OOMで強制終了されたプロセスは、フォレンジックレコードとしてピーク/フェーズを残します)、またはorphan(まだ実行中だがinitにリペアレントされた)としてフラグ付けされます。--cleanは、デッドスロットをパージします。
PEAK PHASEは最高のサンプルを指定するため、サンプリングと同じ精度しかありません。増分同期は、sync:extract、sync:resolve:load_nodes、sync:resolve:build_caches、sync:resolve:refs、sync:variants、sync:doneの順に記録します。フルインデックスは、index:extract、index:resolve:build_caches、index:resolve:refs、index:resolve:done、index:insert、index:doneを記録します。
各項目は、その名前の由来となった作業の後に記録されます。 以前はその前に記録されていたため、すべてのサンプルが次のステップのラベルで前のステップのRSSを報告していました。これにより、73 MiBがノードのロードに起因するとされましたが、実際には未解決の参照のロードに起因しており、サンプルがまったくないステップであり、メモリ調査を数か月間間違ったサブシステムに向けていました(#409)。フェーズを追加する場合は、作業の前ではなく後にサンプリングし、ピークを保持するのに十分な大きさのステップにはサンプルを追加してください。
セッションとライフタイムカウンター
tokensave current-counter          # show per-project session counter
tokensave reset-counter            # reset the session counter
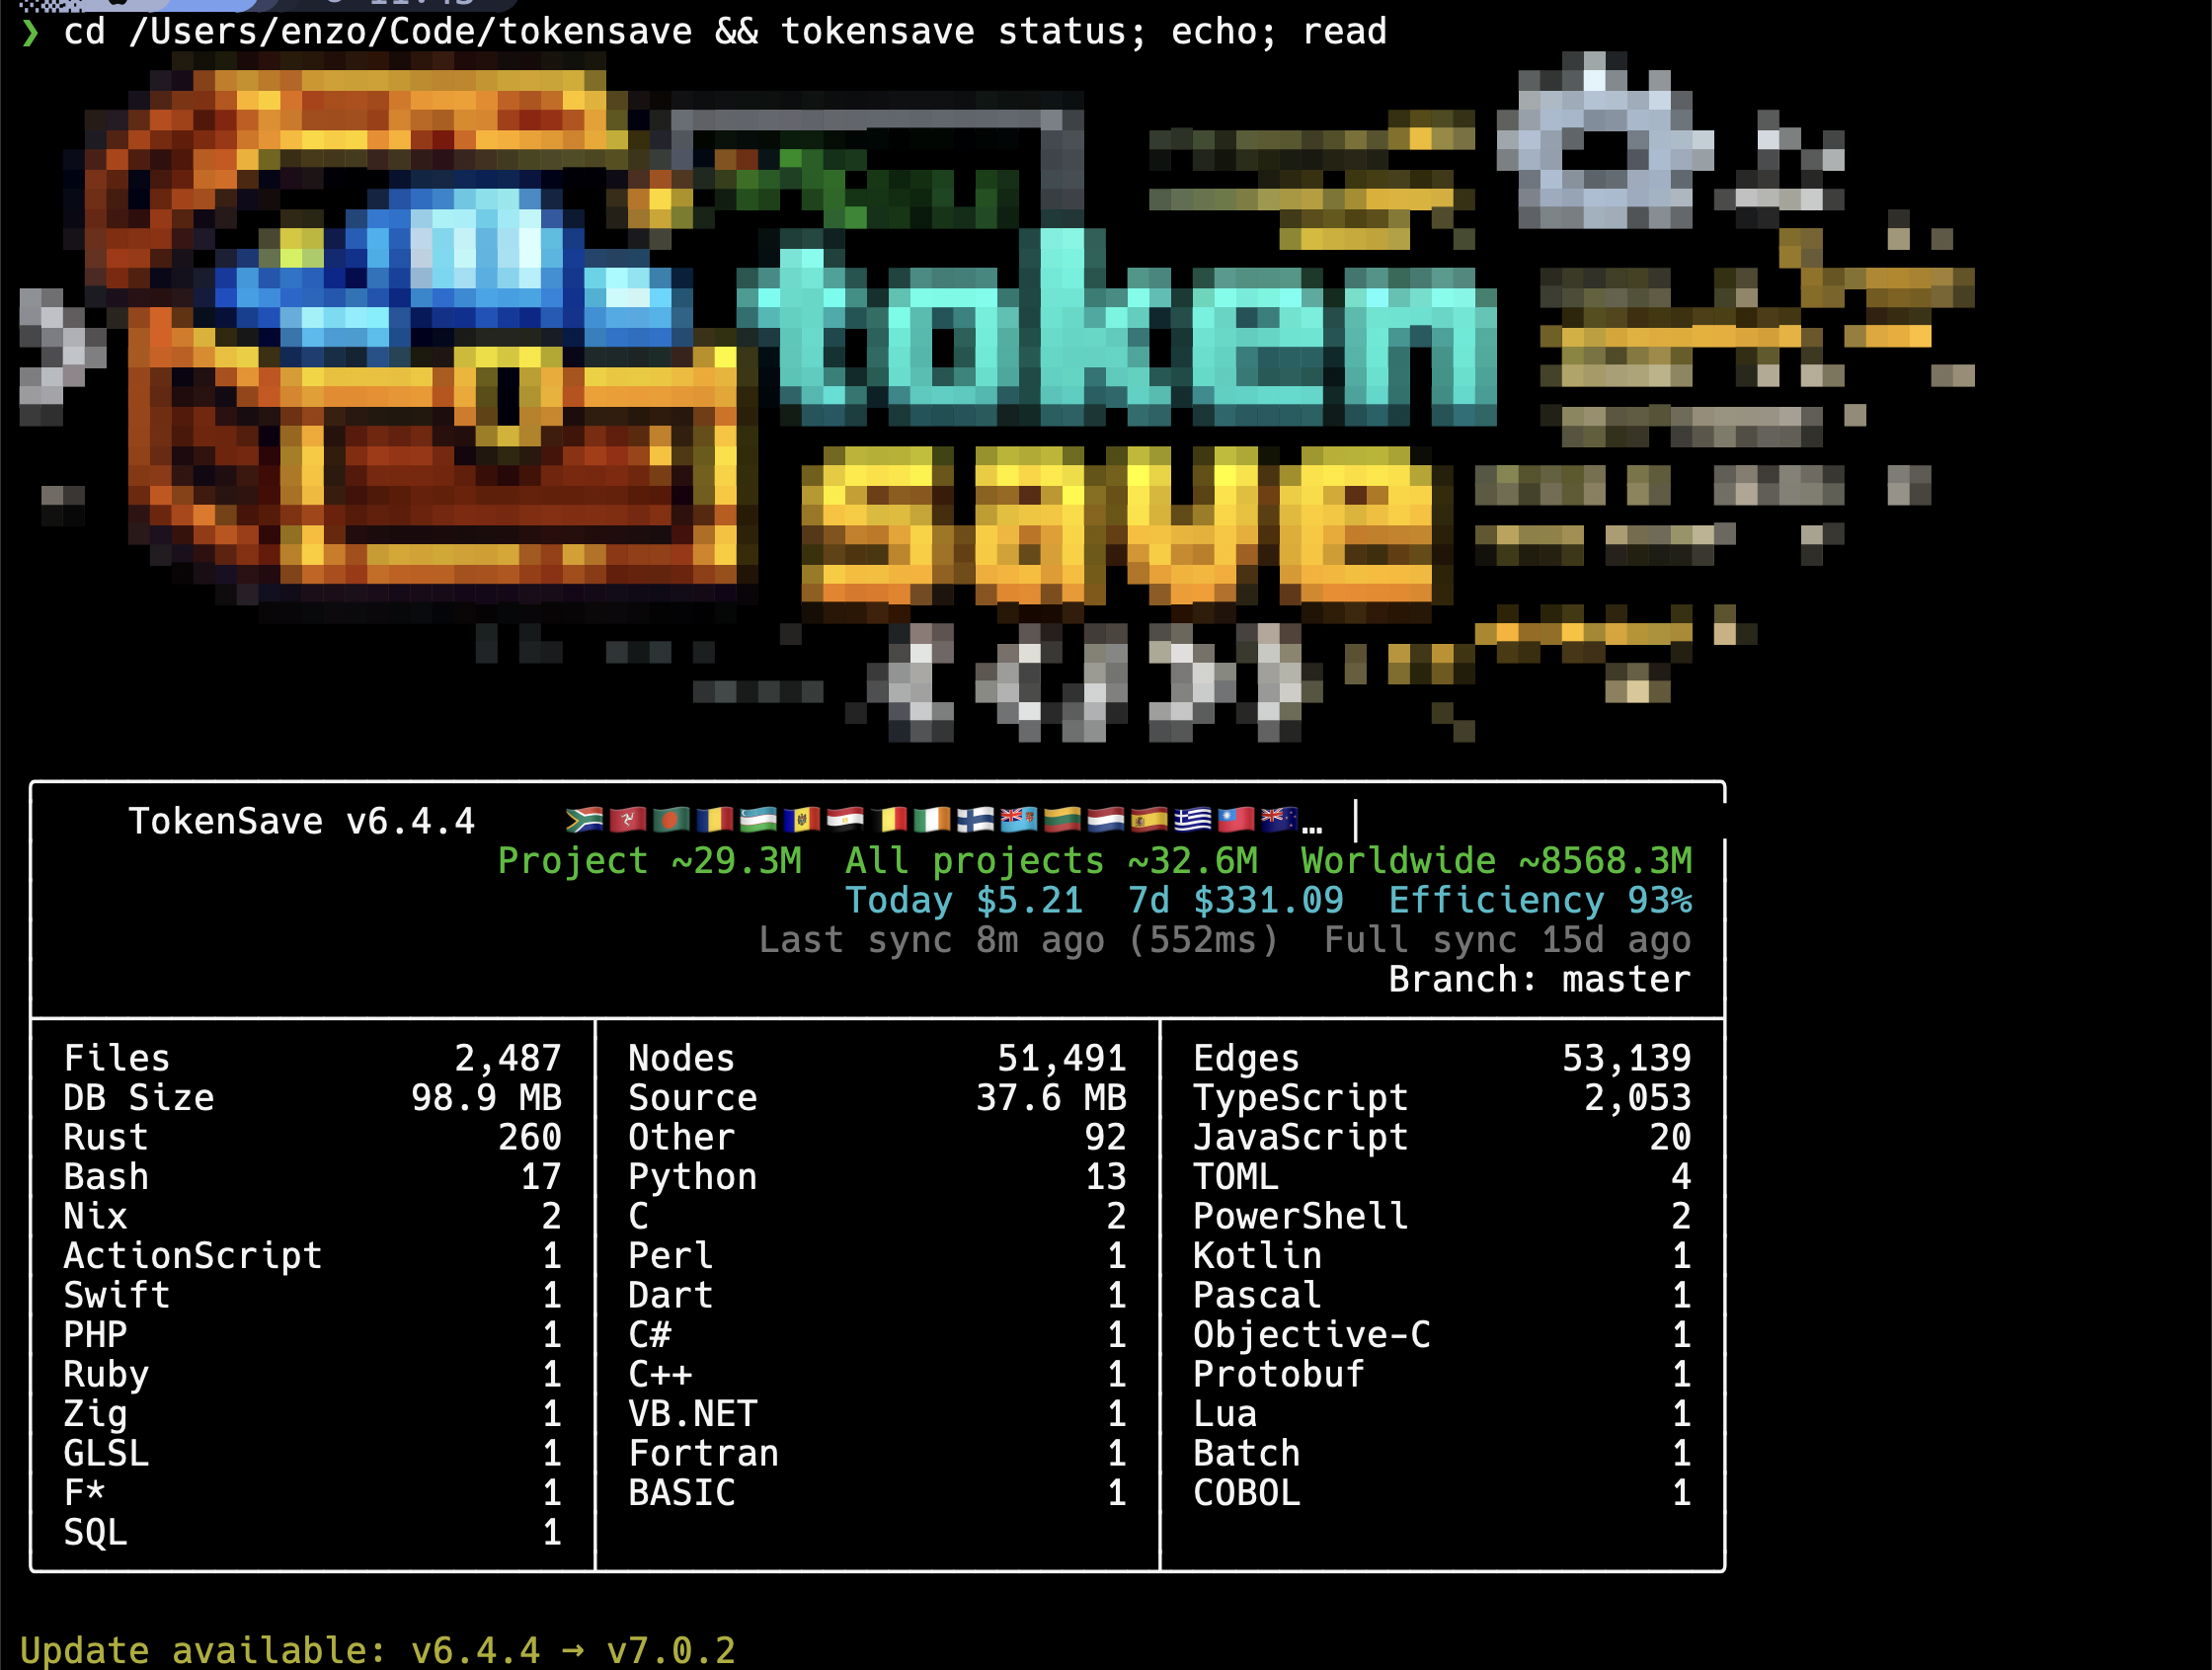
tokensave status                   # shows project + global lifetime totals + cost
tokensave statusは、プロジェクトインデックス統計、言語別内訳、コスト行(今日/7日/効率)、およびプロジェクト+ワールドワイドのライフタイム合計をレンダリングします:
ワールドワイドカウンター
すべてのtokensaveユーザーは、匿名の集計カウンターに貢献します。tokensave statusは、プロジェクトの合計とワールドワイドの合計の両方を表示します。アップロードでは、識別情報なしで単一の数値(例:4823)のみが送信されます。tokensave disable-upload-counterでオプトアウトできます。
インデックスの鮮度
tokensaveは、バックグラウンドデーモンやOSレベルのファイルウォッチャーなしでグラフを最新の状態に保ちます。
オンデマンドの鮮度チェック。 すべてのMCPツール呼び出しは、最後の同期以降にインデックス付きファイルが変更されたかどうかをチェックします。古いファイルが見つかった場合、ツールの応答が返される前に再抽出されます。30秒のクールダウンにより、連続した呼び出しがキーストロークごとにツリーを再ウォークするのを防ぎます。
接続時のキャッチアップ同期。 MCPサーバーが起動すると、非ブロッキングのキャッチアップ同期がすぐに実行され、エージェントが接続されていない間に行われた変更(git pull、IDE編集、ビルドステップなど)を取得するため、セッションの最初のツール呼び出しで新鮮なインデックスが表示されます。
マルチエージェント作業とgitワークツリー。 複数のエージェントが同じプロジェクトで同時に作業する場合、各エージェントが独自のgitワークツリーで動作するという強い前提があります。ワークツリーは、同じリポジトリの独立したファイルシステムチェックアウトです。エージェントAとエージェントBはそれぞれすべてのファイルの独自のコピーを持っているため、互いの進行中の編集を上書きすることはありません。tokensaveは、クエリがメインチェックアウト内にネストされたワークツリーから来た場合を自動的に検出し、正しいブランチグラフから結果を提供します。変更は独立して蓄積され、最終的にgit mergeまたはrebaseを介して調整されます。これは、他の並行開発で使用されるのと同じプロセスです。この設計により、共有の可変ディレクトリに対するクロスエージェントロックの複雑さと障害モードが回避されます。
CLIのみのワークフロー。 エージェント(MCPサーバーなし)を接続せずにtokensaveコマンドを実行する場合、コマンド間で鮮度チェックは実行されません。gitフックをインストールして、コミットまたはクローンごとにインデックスを自動的に最新の状態に保ちます:
cp scripts/post-commit scripts/post-checkout .git/hooks/
chmod +x .git/hooks/post-commit .git/hooks/post-checkout
5.xからのアップグレード
スタンドアロンのtokensave daemonコマンドとそのlaunchd/systemd/Windows Service自動起動は6.0.0で削除されました。デーモンを置き換えた組み込みのOSレベルファイルウォッチャーも6.1.1で削除されました(深いnode_modulesまたはtargetツリーを持つ大規模なモノレポでCPUとメモリの暴走を引き起こしました)。上記のオンデマンド鮮度モデルが現在の設計です。
5.xのデーモン自動起動がまだある場合は、削除してください:
- macOS:
launchctl unload ~/Library/LaunchAgents/com.tokensave.daemon.plist && rm ~/Library/LaunchAgents/com.tokensave.daemon.plist - Linux:
systemctl --user disable --now tokensave-daemon && rm ~/.config/systemd/user/tokensave-daemon.service - Windows:
sc.exe delete tokensave-daemon(昇格したターミナルから)
正確な名前を覚えていない場合:launchctl list | grep tokensave / systemctl --user list-units | grep tokensave / sc.exe query state= all | findstr -i tokensave。
自己アップグレード
tokensave upgrade                  # upgrade to latest in current channel
tokensave channel                  # show current channel (stable/beta)
tokensave channel beta             # switch to beta channel
tokensave channel stable           # switch back to stable
tokensave upgradeは、GitHubリリースから正しいプラットフォームバイナリをダウンロードし、実行中のバイナリをその場で置き換えます。安定版とベータ版のチャネルを個別にサポートします。
バージョニングとアップグレード
tokensaveのバージョン番号はSemVerのように見えますが、それに従っていません:変更されるコンポーネントは、更新が必要とするメンテナンスをエンコードしており、tokensaveは次回の起動時に自動的に実行します。手動で再インストールや再インデックスを実行する必要はありません。
| バンプ | 例 | 更新が必要 | 自動アクション |
|---|---|---|---|
パッチ (x.y.Z) | 7.2.0 → 7.2.1 | なし | なし — 再インストールも再インデックスも不要 |
マイナー (x.Y.0) | 7.2.0 → 7.3.0 | 再インストール(新しいハーネス、新しいツール、新しい設定) | インストールされているすべてのエージェント統合のグローバル再インストール(権限、フック、MCP設定を更新) |
メジャー (X.0.0) | 7.2.0 → 8.0.0 | 再インストール+完全再同期 | グローバル再インストールおよびプロジェクトごとの強制再インデックス(sync -fと同等) |
グローバル再インストール。 新しいマイナーまたはメジャービルドの初回実行時に、tokensaveは登録済みの各エージェントに対してinstallを静かに再実行するため、エージェント設定は常に現在のバイナリを指し、現在のツールセットを公開します。パッチバンプはこれをスキップします。実行中のバージョンマーカーが単に進められます。
再インストールは本当に静かです。明示的なtokensave installで表示されるエージェントごとのセットアップ出力はここでは抑制されるため、通常のtokensave initやtokensave syncの前に表示されることはありません。エージェントの設定を更新できない場合(アプリがインストールされていない、または設定が読み取り専用の場所にある場合)、失敗したエージェントを指定する1行が表示されます:
warning: could not refresh tokensave config for: copilot.
  Run tokensave install to see the error.
tokensave installを実行して、基になるエラーを確認します。バージョンマーカーはどちらの場合も進むため、書き込めない設定パスは、後続のコマンドごとに再試行されるのではなく、アップグレードごとに1回報告されます。
プロジェクトごとの強制再インデックス(メジャーのみ)。 メジャーバンプは、プロジェクトインデックスを再構築する必要があることを意味します。tokensaveはこれを遅延かつプロジェクトごとに実行します。メジャーアップグレード後のプロジェクトでの最初のMCPツール呼び出しで、ツールの応答をブロックしないバックグラウンドの完全再インデックス(tokensave sync --forceと同等)を生成します。
Brew / cargoフォールバック。 tokensave upgradeの外部でバイナリを置き換える外部アップグレード(brew upgrade tokensaveやcargo install tokensaveなど)も同じ方法で検出されます。実行中のバージョンがインストールを実行した最後のバージョンより新しい場合、自己アップグレード後と同様に、次回の起動時に再インストールが実行されます。
tokensaveがSemVerから逸脱する理由(バージョンにメンテナンスをエンコードすることでゼロタッチアップグレードが可能になる)、マーカーメカニズム、独立したデータベーススキーマバージョン、リリースをカットするためのメンテナー規則については、TOKENSAVE-VERSIONING.mdを参照してください。
CLIリファレンス
tokensave init [path]              # Initialize a new project (full index)
tokensave sync [path]              # Incremental sync (must be initialized first)
tokensave sync --force [path]      # Force a full re-index
tokensave sync --doctor [path]     # Sync and list added/modified/removed files
tokensave status [path]            # Show statistics + cost summary
tokensave status [path] --json     # Show statistics (JSON output)
tokensave status --details         # Include node-kind breakdown
tokensave cost [range]             # Token cost summary (default: 7d)
tokensave cost --by-model          # Cost grouped by model
tokensave cost --by-task           # Cost grouped by task category
tokensave cost --export json|csv   # Export cost data
tokensave query <search> [path]    # Search symbols
tokensave files [--filter dir] [--pattern glob] [--json]   # List indexed files
tokensave affected <files...> [--stdin] [--depth N]        # Find affected test files
tokensave install [--agent NAME]   # Configure agent integration
tokensave reinstall                # Refresh settings for all installed agents
tokensave uninstall [--agent NAME] # Remove agent integration
tokensave serve [--idle-timeout-secs N]   # Start MCP server (N: exit after N idle seconds)
tokensave servers [--json]         # List running servers and the index each one holds
tokensave monitor                  # Live TUI showing MCP calls across all projects
tokensave memory [--clean]         # Per-instance RSS report for all tokensave processes
tokensave upgrade                  # Self-update to latest version
tokensave channel [stable|beta]    # Show or switch update channel
tokensave doctor [--agent NAME]    # Check installation health
tokensave githooks [on|off] [--local]  # Manage git hooks (--local: this repo only, no core.hooksPath)
tokensave branch add|list|remove|removeall|gc   # Multi-branch management
tokensave current-counter          # Show per-project token counter
tokensave reset-counter            # Reset per-project token counter
tokensave disable-upload-counter   # Opt out of worldwide counter uploads
tokensave enable-upload-counter    # Re-enable worldwide counter uploads
tokensave doctor
tokensaveインストールの包括的なヘルスチェックを実行します:
tokensave doctor
チェック内容:バイナリの場所、プロジェクトインデックス、グローバルDB、ユーザー設定、エージェント統合(MCPサーバー、フック、権限、プロンプトルール)、ネットワーク接続。アップグレード後にツール権限が不足している場合は、tokensave installを実行するように指示されます。--agentを使用して、特定のエージェントのみをチェックします。
Doctorは、インストールされている各フックが正しいtokensaveサブコマンドを使用しているかも検証し、壊れたフックを自動修復します。
Claude Codeでの動作方法
設定後、Claude Codeはコードベースを理解する必要があるときに、生のファイルを読む代わりに自動的にtokensaveを使用します。3つのレイヤーが相互に強化し合います:
| レイヤー | 機能 | 重要性 |
|---|---|---|
| MCPサーバー | 80以上のtokensave_*ツールをClaudeに公開 | Claudeはグラフを直接クエリできる |
| CLAUDE.mdルール | Claudeにエージェント/ファイル読み取りよりもtokensaveを優先するように指示 | モデルが高コストなパターンにフォールバックするのを防ぐ |
| PreToolUseフック | ネイティブRustフックがExploreエージェントをブロック | モデルがCLAUDE.mdルールを無視するケースをキャッチ |
| UserPromptSubmitフック | プロンプト送信時に実行 | トークン会計のライフサイクル追跡 |
| Stopフック | セッション終了時に実行 | トークンカウンターをフラッシュ |
結果:Claudeははるかに少ないトークンで同じコード理解を得られます。典型的なExploreエージェントは20〜50ファイルを読み取ります。tokensaveは、事前構築されたインデックスから関連するシンボル、関係、コードスニペットを返します。
ネットワーク呼び出しとプライバシー
tokensaveのコア機能(インデックス作成、検索、グラフクエリ、MCPサーバー)は100%ローカルです。コードがマシンを離れることはありません。
| 呼び出し | 送信データ | タイミング | オプトアウト |
|---|---|---|---|
| ワールドワイドカウンターのアップロード | トークン数(数値)+国(IPから) | 同期、ステータス、MCPセッション | tokensave disable-upload-counter |
| ワールドワイドカウンターの読み取り | なし(GETリクエスト) | ステータス | N/A(読み取り専用、1秒タイムアウト) |
| バージョンチェック | なし(GETリクエスト) | ステータス(5分キャッシュ)、同期(並列) | N/A(1秒タイムアウト、失敗時はno-op) |
| モデル価格の更新 | なし(GETリクエスト) | tokensave cost(24時間キャッシュ) | N/A(5秒タイムアウト、組み込み価格にフォールバック) |
世界規模のカウンターアップロードは、{"amount": 4823} のようなJSONボディを持つ単一のHTTP POSTを送信します。CookieもトラッキングもユーザーIDもありません。Cloudflare Workerは、リクエストヘッダーから取得したIPアドレスの国を記録し、地理的な集計統計に使用します。実際のIPアドレスは保存されません。 |
モデル価格の更新は、GitHubから公開JSONファイル(raw.githubusercontent.com/BerriAI/litellm/main/model_prices_and_context_window.json)を取得して、Claudeモデルの価格をtokensave cost用に最新の状態に保ちます。データは送信されません。これは単純なHTTPS GETです。レスポンスは~/.tokensave/pricing.jsonに24時間キャッシュされます。取得に失敗した場合、tokensaveは組み込みの価格テーブルを使用します。
50以上の言語
tokensaveは、Cargoのフィーチャーフラグで制御される3つのティアに編成された50以上のプログラミング言語をサポートしています。各ティアには、下位ティアのすべての言語が含まれます。Markdownヘッダーは、階層的なContainsエッジを持つModuleノードとして抽出され、ドキュメント構造がソースコードとともにグラフクエリに参加できるようにします。
Lite -- --no-default-features
常にコンパイルされます。最も人気のある言語向けの最小のバイナリに加えて、SvelteとAstro(TypeScriptエクストラクタによるスクリプトブロック抽出、追加の文法依存関係なし)。
| 言語 | 拡張子 |
|---|---|
| Rust | .rs |
| Go | .go |
| Java | .java |
| Scala | .scala、.sc |
| TypeScript | .ts、.tsx |
| JavaScript | .js、.jsx |
| Python | .py |
| C | .c、.h |
| C++ | .cpp、.hpp、.cc、.cxx、.hh |
| Kotlin | .kt、.kts |
| C# | .cs |
| Swift | .swift |
| Svelte | .svelte |
| Astro | .astro |
Medium(Lite + 9言語追加) -- --features medium
| 言語 | 拡張子 | フィーチャーフラグ |
|---|---|---|
| Dart | .dart | lang-dart |
| Pascal | .pas、.pp、.dpr | lang-pascal |
| PHP | .php | lang-php |
| Ruby(ERBおよびSlimテンプレートを含む) | .rb、.rake、.erb、.slim | lang-ruby |
| Bash | .sh、.bash | lang-bash |
| Protobuf | .proto | lang-protobuf |
| PowerShell | .ps1、.psm1 | lang-powershell |
| Nix | .nix | lang-nix |
| VB.NET | .vb | lang-vbnet |
ERBおよびSlimテンプレートは、インデックス作成時にRubyまたはテンプレートのgemを必要とせずにRuby文法を使用します。テンプレート呼び出しはファイルノードに属し、元の行とバイト列を保持します。ERBは、コード/出力タグ、トリムマーカー、コメント、エスケープされたタグをサポートします。Slimは、制御/出力行、インデントベースのブロック、属性(複数行の属性リストを含む)、テキスト補間、およびruby:ブロックをサポートします。
カスタムSlimショートカットと埋め込み言語のコンパイルはサポートされていません。Railsがレンダリング時に提供するローカル変数は、ベアヘルパー呼び出しと区別できません。テンプレート内で割り当てまたはバインドされた名前は、保守的に除外されます。コントローラーからビューへの関係や部分レンダリングの関係には、別途Railsのセマンティック配線が必要です。
Full(Medium + その他すべて) -- デフォルト
| 言語 | 拡張子 | フィーチャーフラグ |
|---|---|---|
| ActionScript | .as | lang-actionscript |
| Lua | .lua | lang-lua |
| Zig | .zig | lang-zig |
| Objective-C | .m、.mm | lang-objc |
| Perl | .pl、.pm | lang-perl |
| Batch/CMD | .bat、.cmd | lang-batch |
| Fortran | .f90、.f95、.f03、.f08、.f18、.f、.for | lang-fortran |
| COBOL | .cob、.cbl、.cpy | lang-cobol |
| MS BASIC 2.0 | .bas | lang-msbasic2 |
| GW-BASIC | .gw | lang-gwbasic |
| QBasic | .qb | lang-qbasic |
| QuickBASIC 4.5 | .bi、.bm | lang-qbasic |
| Dockerfile | Dockerfile、.dockerfile | lang-dockerfile |
| GLSL | .glsl、.vert、.frag、.comp | lang-glsl |
| Godot Shader | .gdshader、.gdshaderinc | lang-glsl |
| Minecraft Function | .mcfunction | lang-mcfunction |
| WGSL | .wgsl | lang-wgsl |
| HLSL | .hlsl、.fx | lang-hlsl |
| Verilog / SystemVerilog | .v、.vh、.sv、.svh | lang-systemverilog |
| VHDL | .vhd、.vhdl | lang-vhdl |
| Metal | .metal | lang-metal |
| CUDA / HIP | .cu、.cuh | lang-cuda |
| Markdown | .md、.markdown | lang-markdown |
| R | .r、.R | lang-r |
| SQL | .sql | lang-sql |
| Julia | .jl | lang-julia |
| Haskell | .hs、.lhs | lang-haskell |
| OCaml | .ml、.mli | lang-ocaml |
| Clojure | .clj、.cljs、.cljc | lang-clojure |
| Erlang | .erl、.hrl | lang-erlang |
| Elixir | .ex、.exs | lang-elixir |
| F# | .fs、.fsi、.fsx | lang-fsharp |
| F* | .fst、.fsti | lang-fstar |
| Quint | .qnt | lang-quint |
| Terraform | .tf、.tfvars | lang-terraform |
| TOML | .toml | lang-toml |
| Lean | .lean | lang-lean |
| HTML | .html、.htm | lang-html |
| CSS | .css | lang-css |
個々の言語は、フルティアなしで個別に選択することもできます:
cargo install tokensave --no-default-features --features lang-nix,lang-bash
すべてのエクストラクタは同じ深さを共有します:関数、クラス、メソッド、フィールド、インポート、コールグラフ、継承チェーン、docstring、複雑性メトリクス、デコレータ/アノテーション抽出、およびクロスファイル依存関係の追跡。
HTMLとCSSは例外です。どちらの言語にも呼び出し可能なシンボルがないためです。HTMLは、idを持つ要素、カスタム要素、およびページが取り込むスタイルシートとスクリプトを記録します。CSSは、クラスおよびIDセレクタ、カスタムプロパティ、@keyframes名、および@importを記録します。どちらもclass="..."属性をスタイルシートルールに解決しません。クラス名は通常の単語であり、プロジェクト全体でベア名で一致させると、エッジを見つけるのではなく発明してしまうためです。
tokensave vs CodeGraph
tokensaveは、CodeGraph(Node.js/TypeScript)のゼロからのRust書き換えです。どちらもAIコーディングエージェント向けのセマンティックコードグラフを構築しますが、範囲と機能において大きく異なります。
| tokensave | CodeGraph | |
|---|---|---|
| ランタイム | ネイティブバイナリ(Rust) | Node.js 18+ |
| インストール | brew install、cargo install、scoop install | npx @colbymchenry/codegraph |
| 言語 | 50以上(3ティア:lite/medium/full) | 19以上 |
| MCPツール | 80以上 | 9 |
| エージェント統合 | 12以上(Claude、Codex、Gemini、Qwen、OpenCode、Cursor、Cline、Copilot、Roo Code、Zed、Antigravity、Kilo、Kiro、Kimi、Vibe、Grok、OMP、Pi、Plank、Factory Droid) | 1(Claude Code) |
| インデックスの鮮度 | すべてのMCP呼び出しでオンデマンドの陳腐化チェック。接続時のキャッチアップ同期。マルチエージェント作業はgit worktreesの使用を想定 | ネイティブOSレベルのファイルウォッチャー(FSEvents/inotify/ReadDirectoryChangesW、2秒デバウンス)。接続時のキャッチアップ同期 |
| マルチブランチインデックス | はい、オプトイン(ブランチごとのDB、ブランチ間差分/検索) | いいえ |
| 複雑性メトリクス | AST抽出(ブランチ、ループ、ネスト深さ、循環的および認知的複雑性、Halstead、保守性インデックス、CRAP) | いいえ |
| 移植ツール | はい(port_status、port_order) | いいえ |
| グラフビジュアライザー | 削除済み(v4.0.1) | はい |
| セマンティック検索 | エージェント駆動のキーワード拡張(ゼロコスト) | ローカル埋め込み(nomic-embed-text-v1.5 via ONNX) |
| MCPリソース | 4(status、files、overview、branches) | いいえ |
| MCPアノテーション | はい(readOnlyHint、alwaysLoad) | いいえ |
| デッドコード検出 | はい | いいえ |
| 循環依存関係検出 | はい | いいえ |
| 型階層 | はい | いいえ |
| 神クラス / 結合度分析 | はい | いいえ |
| コミット / PRコンテキスト | はい | いいえ |
| テストマッピング | はい | いいえ |
| リネームプレビュー | はい | いいえ |
| トークン追跡 | 呼び出しごとのメトリクス、ライブTUIモニター、セッション+ライフタイムカウンター | いいえ |
| コードヘルス分析 | 複合スコア、Gini、依存関係の深さ、DSM、リスク加重テストギャップ、セッションデルタ | いいえ |
| 編集プリミティブ | 自動再インデックス付きの4つのアトミックライター(str_replace、multi_str_replace、insert_at、ast_grep_rewrite) | いいえ |
| クラッシュ耐性 | サブプロセス分離抽出。ネイティブ文法のアボートはファイルをスキップし、同期は継続 | いいえ |
| 自己アップグレード | 安定版/ベータ版チャンネル付きのtokensave upgrade | npm update |
| DBエンジン | libsql(SQLiteフォーク、WAL、非同期) | better-sqlite3 / wa-sqlite(WASM) |
| インデックス速度 | 1,782ファイルで約1.2秒 | 1,782ファイルで約4秒 |
| バイナリサイズ | 約25 MB圧縮ダウンロード(すべての文法バンドル) | 約80 MB(node_modules + WASM) |
CodeGraphはこのアプローチの先駆者であり、npmツールを好み、Claude Code統合のみが必要な場合は、依然として堅実な選択肢です。tokensaveは、より深い分析、より多くのエージェント、マルチブランチサポート、およびランタイム依存関係のないネイティブバイナリでコンセプトを拡張します。
CodeGraph、Dual-Graph(GrapeRoot)、code-review-graph、およびOpenWolfとの詳細な比較については、docs/COMPARABLE-TOOLS.mdを参照してください。
サイドバイサイド比較ページ(各ページで、他のツールが優れている点が示されています): Serena · code-review-graph · Graphify · CodeGraph · token-savior · GrapeRoot · LeanCTX · OpenWolf — インデックスは tokensave.dev/vs にあります。
代替手段よりもtokensaveを選ぶ理由
いくつかのツールがAIコーディングエージェントのトークン使用量を削減します。tokensaveが際立っている理由は次のとおりです。
単一のネイティブバイナリ、ゼロ依存関係
ほとんどの代替手段はランタイム(Python、Node.js、またはその両方)を必要とします。tokensaveは、50以上のtree-sitter文法をすべてバンドルした単一のRustバイナリとして提供されます(約25 MBの圧縮ダウンロード)。他にインストールするものはありません。また、SerenaなどのLSPベースのツールとは異なり、言語ごとに言語サーバーをインストール、起動、またはウォームアップする必要もありません。現在、パッケージングでtokensaveに匹敵するツールが2つあります:CodeGraphは独自のランタイムをバンドルし、LeanCTXも単一のRustバイナリです。
最も深いコードインテリジェンス
tokensaveはシンボルレベルで動作します:関数、構造体、フィールド、呼び出しエッジ、型階層、複雑性メトリクス。Dual-Graph(GrapeRoot)などの代替手段はファイルレベルで動作します。どのファイルが存在するかはわかりますが、「この関数を誰が呼んでいるか?」や「この構造体を変更したら何が壊れるか?」には答えられません。tokensaveの80以上の専門MCPツールは、コールグラフトラバーサル、影響分析、デッドコード検出、テストマッピング、リネームプレビュー、型階層、循環依存関係検出、複雑性ランキング、コードヘルス分析(Gini、DSM、依存関係の深さ、リスク加重テストギャップ)、アトミック編集プリミティブなどをカバーしています。最も近い比較可能なグラフツールであるcode-review-graphは30を公開しています。他のいくつかは、意図的な設計により10未満しか公開していません。
最も広範なエージェントサポート
10以上のAIコーディングエージェント統合に対応し、各エージェント固有のネイティブ設定形式をサポートしています。これほど多くのエージェントをこれほど深く統合しているツールは他にありません。Claude Codeはフック、プロンプトルール、自動許可されたツール権限を取得します。KiroはグローバルMCP設定、リソースとして読み込まれるtokensave.mdステアリング、組み込みの/tokensaveツール承認を備えた管理エージェント、委任ガードレールと書き込み後同期のためのフックを取得します。他のエージェントは、ネイティブ設定形式でMCPサーバー登録を取得します。
マルチブランチインデックス
この分野で唯一、オプションのブランチ別グラフデータベースとクロスブランチ差分・検索を備えたツールです。有効にすると、ブランチの切り替えは瞬時に行われ、再インデックスは不要です。
呼び出しごとのトークン追跡
各MCPツール呼び出しが正確に何トークンを節約したかを報告する唯一のツールで、全プロジェクトにわたるライブTUIモニターと累積カウンターも備えています。
完全オープンソース
MITライセンスのRustで、エンドツーエンドで監査可能です。Dual-Graphのコアエンジン(PyPIのgraperoot)はプロプライエタリであり、コードグラフで何が行われているかは確認できません。OpenWolfはAGPL-3.0で、派生作品のオープンソース化が義務付けられています。
パフォーマンス
1,782ファイルのRust/Java/Scala混在コードベース(57Kノード、103Kエッジ)でのフルインデックスベンチマーク:
| ツール | 時間 | 高速化 |
|---|---|---|
| CodeGraph (TypeScript) | 31.2秒 | 1倍 |
| tokensave (Rust) | 1.2秒 | 26倍 |
トラブルシューティング
「tokensave not initialized」
プロジェクトに.tokensave/ディレクトリが存在しません。
tokensave init
MCPサーバーが接続されない
AIエージェントがtokensaveツールを認識しません。
- エージェント設定にtokensave MCPサーバーが含まれていることを確認します(
tokensave doctorを実行) - エージェントを完全に再起動します
tokensaveがPATHにあることを確認します:which tokensave
検索でシンボルが見つからない
tokensave syncを実行してインデックスを更新します- 言語がサポートされているか確認します(上の表を参照)
- ファイルが
.gitignoreによって除外されていないか確認します
インデックスが遅い
大規模なプロジェクトでは、最初のフルインデックスに時間がかかります。
- 以降の実行では増分同期が使用され、はるかに高速です
- 日常的な更新には
tokensave sync(--forceではなく)を使用します - エージェントが接続されている間、MCPツール呼び出しのたびに鮮度が自動的にチェックされます
特定のプロジェクトでtokensaveを無効にする
プロジェクトが大きすぎてtokensaveがRAMを使いすぎる場合は、環境でTOKENSAVE_DISABLE_SERVER=trueを設定することで、プロジェクトごとにMCPサーバーを無効にできます。サーバーは初期化せずにクリーンに終了します。
Claude Code — プロジェクトの.claude/settings.jsonに追加します:
{
  "mcpServers": {
    "tokensave": {
      "command": "tokensave",
      "args": ["serve"],
      "env": {
        "TOKENSAVE_DISABLE_SERVER": "true"
      }
    }
  }
}
その他のエージェント — エージェントがMCPサーバーを起動するために使用する設定に環境変数を設定します。
シェルを介してグローバルに設定することもできますが(TOKENSAVE_DISABLE_SERVER=true claude)、これによりセッション内のすべてのプロジェクトでtokensave MCPサーバーが無効になります。
DISABLE_TOKENSAVE=trueは、この変数が名前空間化される前に作成された設定のための非推奨の互換性エイリアスとして引き続きサポートされています。
由来
このプロジェクトは、@colbymchenryによる元のCodeGraph TypeScript実装のRustポートです。このポートは同じアーキテクチャとMCPツールインターフェースを維持しながら、パフォーマンスとネイティブtree-sitterバインディングのためにRustを活用しています。
ビルド
cargo build --locked --release                          # full (50+ languages, default)
cargo build --locked --release --features medium        # medium tier
cargo build --locked --release --no-default-features    # lite (smallest binary)

cargo test --workspace --locked                         # run all tests (requires full)
cargo check --locked --no-default-features              # verify lite compiles
cargo clippy --workspace --all-targets --locked
開発コマンドはデバッグビルドを使用します。インストールは最適化されたリリース出力のみを使用します(cargo install --path . --locked)。target/debugはインストール入力になることはありません。
スター履歴

スポンサー
| Windows向け無料コード署名はSignPath.ioが提供し、証明書はSignPath Foundationによるものです |
ライセンス
MITライセンス — 詳細はLICENSEを参照してください。