Iris
आधिकारिकMCP-नेटिव एजेंट मूल्यांकन और अवलोकन सर्वर जिसमें ट्रेस लॉगिंग, आउटपुट गुणवत्ता मूल्यांकन, लागत ट्रैकिंग, 12 अंतर्निहित मूल्यांकन नियम, रीयल-टाइम डैशबोर्ड और PII डिटेक्शन शामिल है
Iris MCP के साथ आप क्या कर सकते हैं?
- रन लॉग करें और स्कोर दें — अपने असिस्टेंट से किसी एजेंट रन को Iris में लॉग करने और उसके आउटपुट का मूल्यांकन करने के लिए कहें, फिर डैशबोर्ड पर निर्णय और स्कोर देखें।
- सुरक्षा और लागत के नियम जाँचें — PII, प्रॉम्प्ट इंजेक्शन, मतिभ्रम संकेतकों और लागत सीमाओं के लिए बने 28 नियतात्मक नियम बिना किसी LLM कॉल के चलाएँ।
- नियमों की जाँच और संपादन करें — बने हुए नियमों की सूची देखें और उनकी समीक्षा करें या उन्हें बदलें, क्योंकि हर नियम की जाँच और संपादन किया जा सकता है।
- कस्टम नियम जोड़ें —
config.jsonमेंeval.pluginsके ज़रिए कोड के रूप में लिखे नियम लोड करें; उनकी पहचान फ़ाइल हैश से तय होती है। - रनों की तुलना करें — डैशबोर्ड के Runs दृश्य में अंतराल के साथ, एक ही सवालों पर दो रन अगल-बगल खोलें।
- निर्णयों के आधार पर CI रोकें —
--evaluate --fail-on anyके साथingestचलाएँ, ताकि पास न होने वाले किसी भी निर्णय पर जॉब विफल हो जाए।
दस्तावेज़
Iris — अंदाज़े के भरोसे एजेंट शिप करना बंद करें


Iris को एजेंट का एक रन भेजें और उससे उसकी गुणवत्ता, सुरक्षा और लागत पर फैसला माँगें — अपनी मशीन पर, बिना SDK और बिना खाते के। ज़्यादातर एजेंट प्रोजेक्ट कुछ याद रखे हुए प्रॉम्प्ट चलाकर और आउटपुट को देखकर गुणवत्ता जाँचते हैं। Iris इसकी जगह ऐसे आँकड़े देता है जिनका ऑडिट आप कर सकते हैं: आपके एजेंट के रन आपकी डिस्क पर SQLite डेटाबेस में दर्ज होते हैं, और 28 अंतर्निहित नियम उन्हें नियतात्मक रूप से स्कोर करते हैं — PII, प्रॉम्प्ट इंजेक्शन, मतिभ्रम के संकेत, लागत सीमाएँ और एजेंट के अपने टूल कॉल — मुफ़्त, बिना LLM कॉल के। वैकल्पिक LLM जज, जिसकी हर मूल्यांकन की लागत पर सख़्त सीमा है, अर्थ-संबंधी सवालों को सँभालता है। हर नियम की जाँच और संपादन किया जा सकता है, क्योंकि जिस जज का ऑडिट न हो सके, वह बस एक संख्या के साथ अंदाज़ा ही है। MIT लाइसेंस प्राप्त, कोई टेलीमेट्री नहीं। जब तक आप इनमें से कोई सुविधा चालू न करें, आपकी मशीन से कुछ भी बाहर नहीं जाता: एक OpenTelemetry एंडपॉइंट (IRIS_OTEL_ENDPOINT), जो ट्रेस को आपके बताए कलेक्टर तक भेजता है; आपकी अपनी कुंजी वाला LLM जज, जो जाँचे जा रहे टेक्स्ट को उस प्रदाता को भेजता है और जिसका उद्धरण-जाँच फ़ीचर आउटपुट में उद्धृत पेज लाता है; या एक वेबहुक, जो आपके तय पते पर आईडी, फैसला और नियमों के नाम भेजता है — कभी टेक्स्ट नहीं।
इसके लिए Node.js 22.13 या बाद का संस्करण चाहिए। node --version से जाँचें।
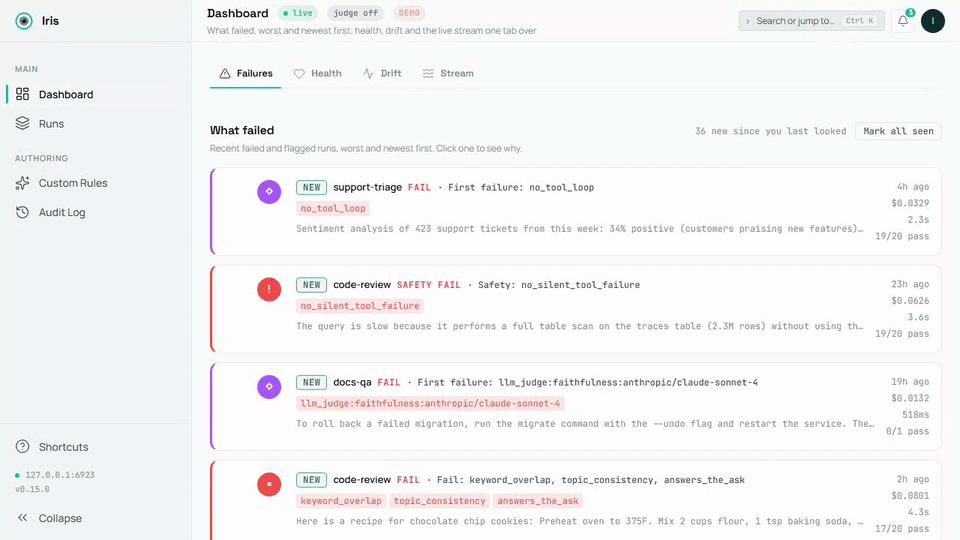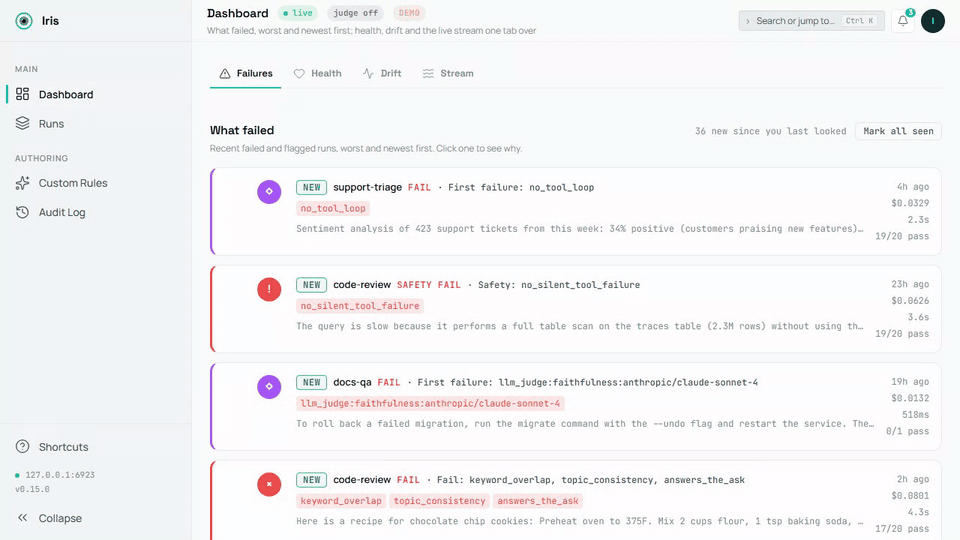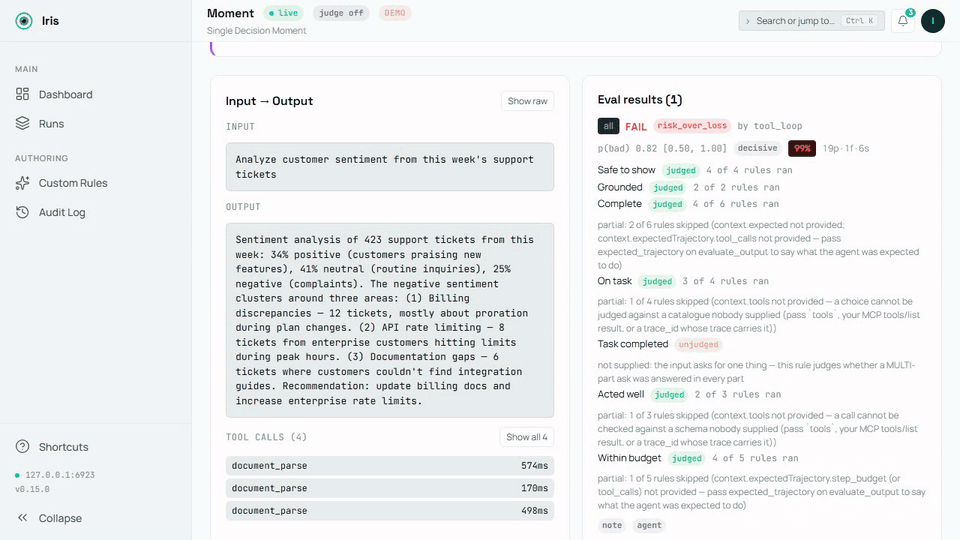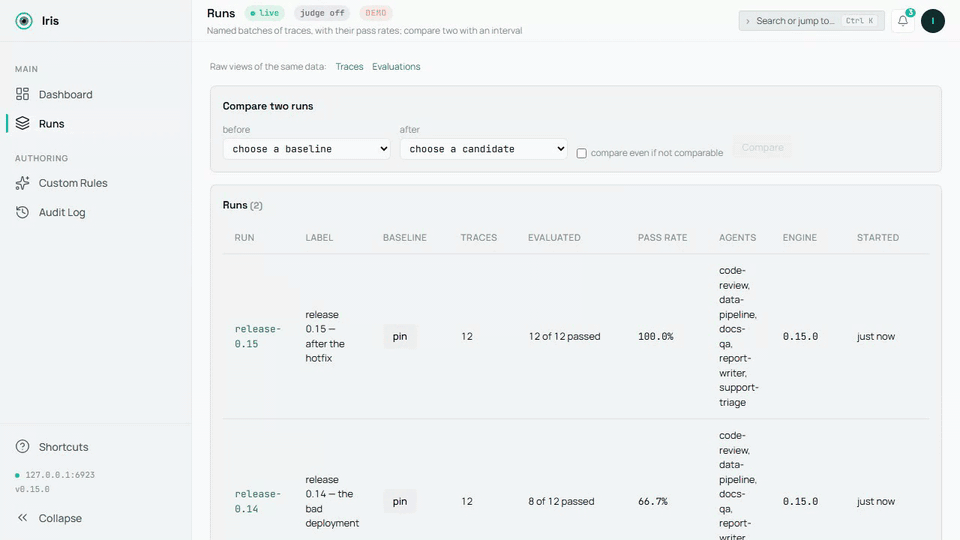
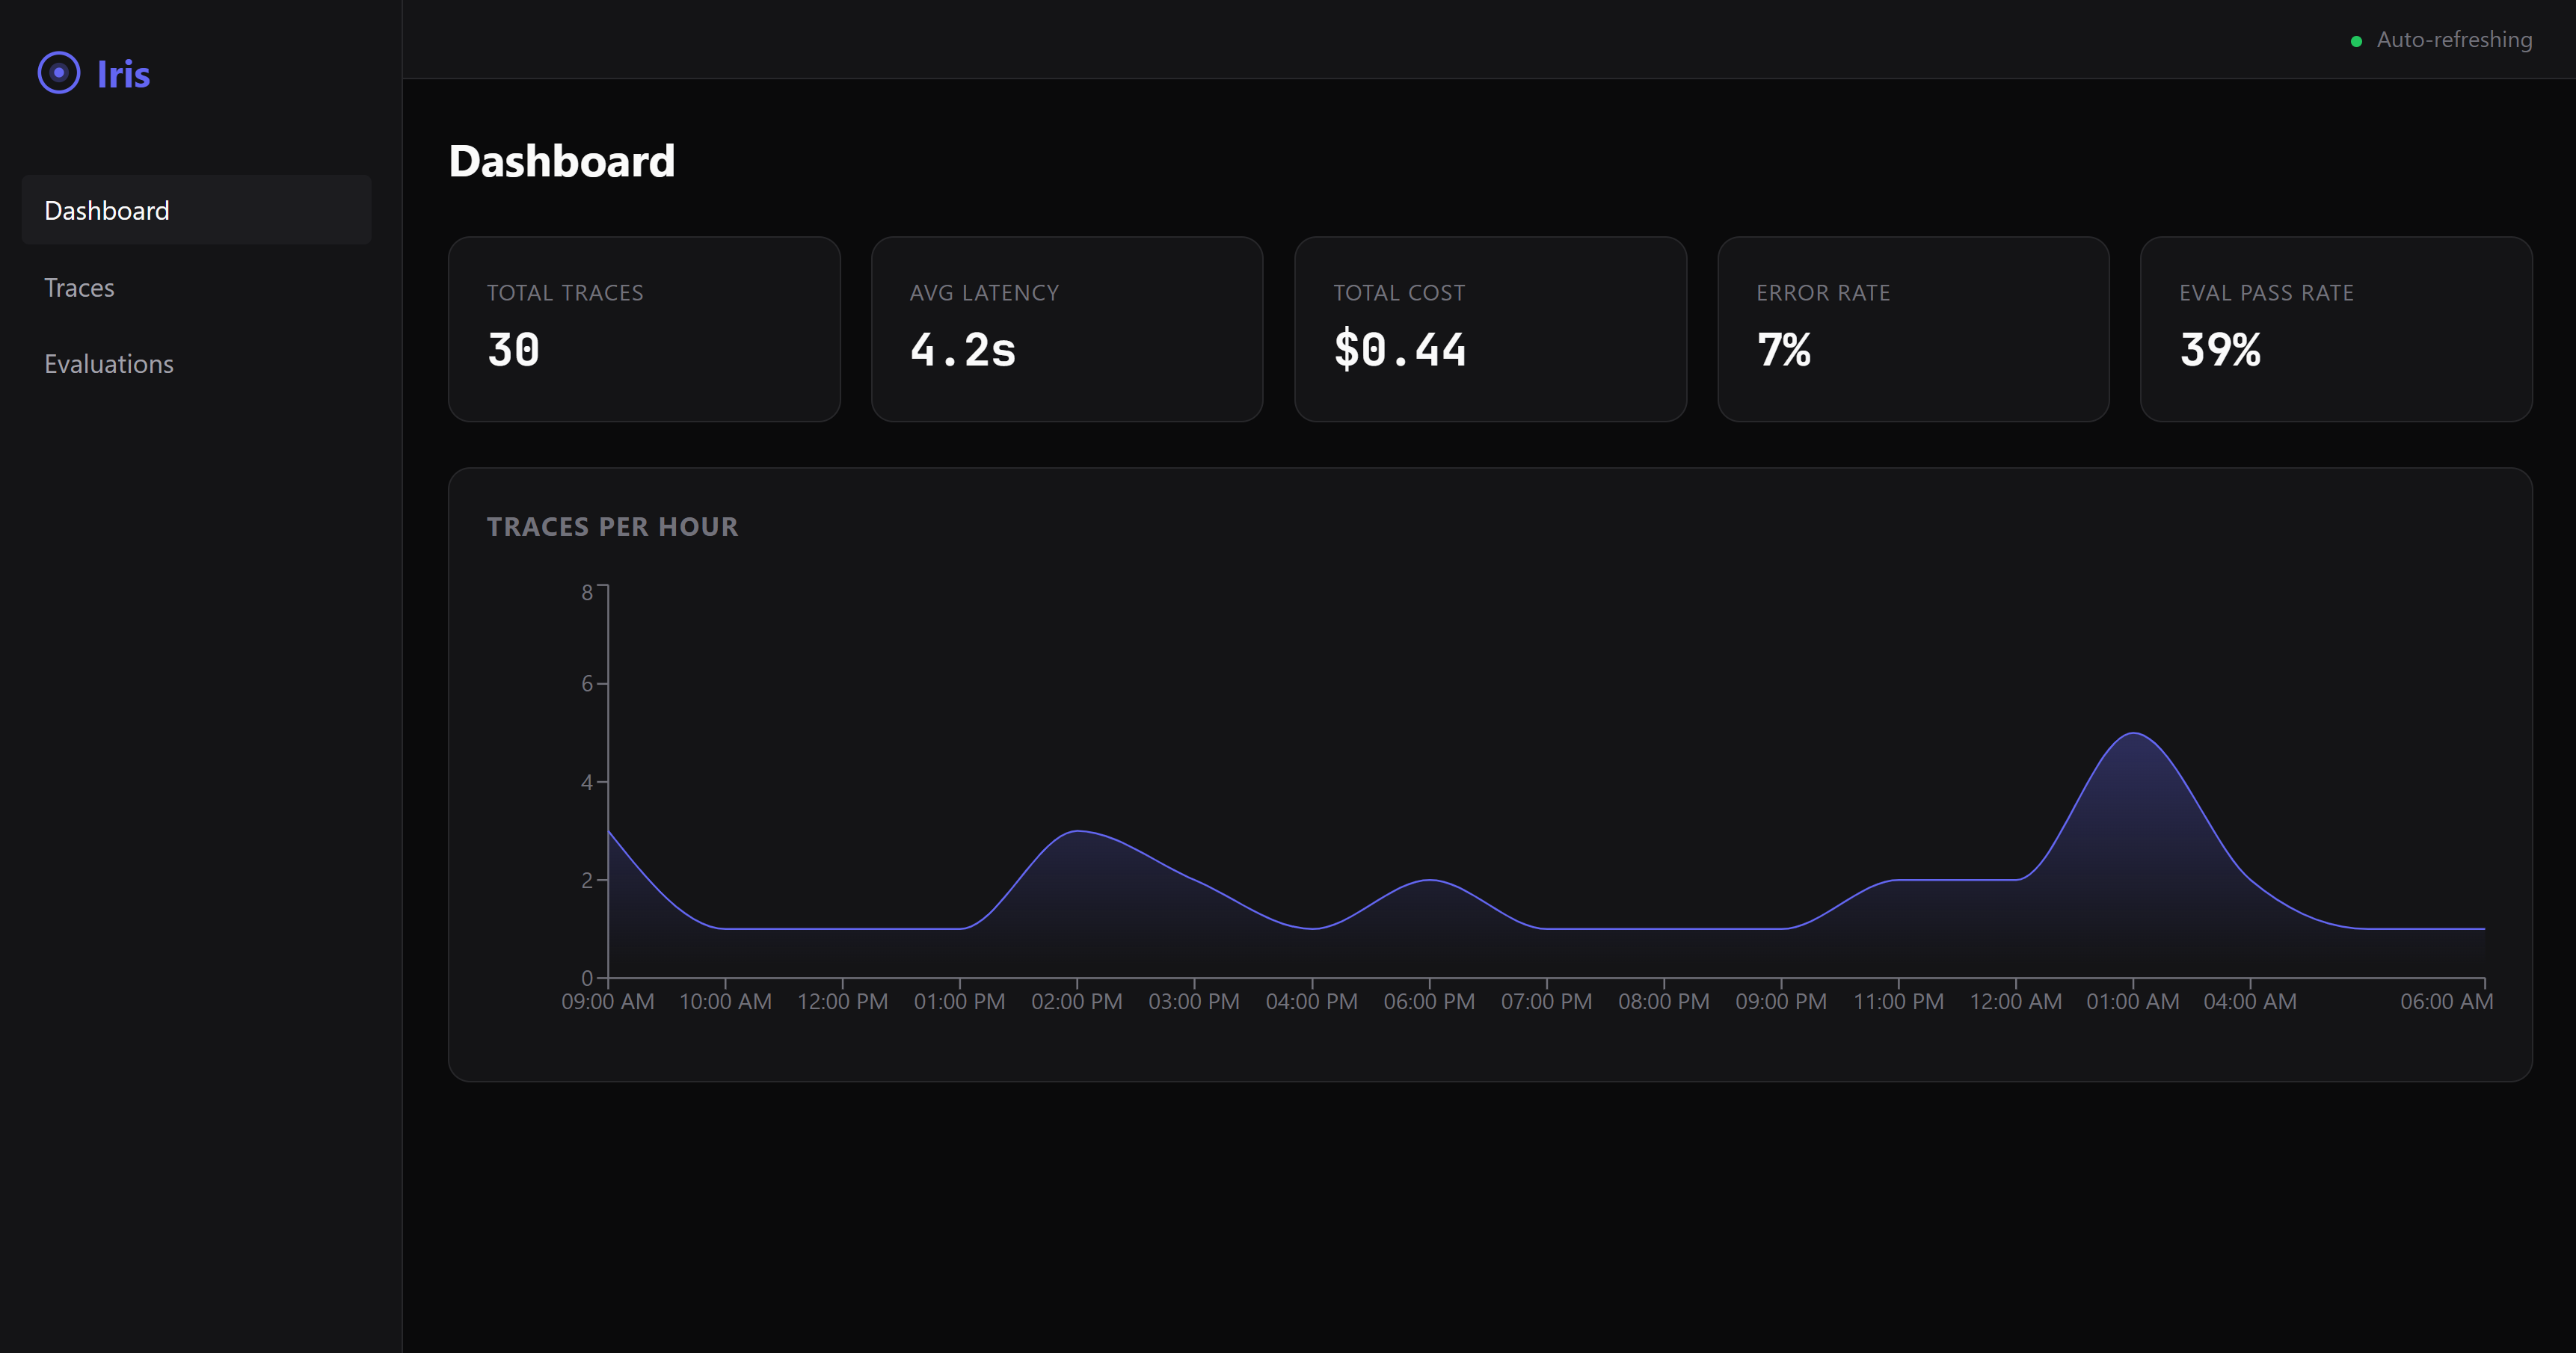
डेमो डेटाबेस, जिसे scripts/demo-media.mts ने रिकॉर्ड किया है; स्रोत demo.mp4 है। एक स्थिर चित्र: dashboard-overview.png।
60 सेकंड में स्क्रीन पर एक विफलता देखें
एजेंट की कोई वायरिंग नहीं, कोई कॉन्फ़िगरेशन नहीं — बस एक कमांड:
npx @iris-eval/mcp-server --demo
इससे एक डेमो डेटाबेस तैयार होता है — पाँच छोटे एजेंट, दो हफ़्तों के रन और इंजन के अपने सभी फैसले — और उसके आधार पर डैशबोर्ड http://localhost:6920 पर चलाता है (पहली बार चलाने पर आपका ब्राउज़र अपने आप खुल जाएगा)। डैशबोर्ड Failures पर खुलता है: क्या विफल हुआ, सबसे खराब और सबसे नया पहले, और हर कार्ड में नियम तथा उसके साक्ष्य का नाम। इनमें क्लिक करके देखना उपयोगी है — सुरक्षा नियमों द्वारा पकड़ा गया PII लीक, फ़ोरम पोस्ट में छिपा निर्देश जिसका सारांशकर्ता ने पालन किया, ऐसा आँकड़ा जो स्रोत दस्तावेज़ में कभी था ही नहीं, उन्हीं बारह सवालों पर दो रन की अंतराल सहित तुलना (Runs), तैनात किया गया एक कस्टम नियम और रोका गया दूसरा नियम, दोनों की ऑडिट पंक्तियों के साथ, और तर्क सहित विफल LLM-जज स्कोर।
डेमो डेटा अपने अलग डेटाबेस में रहता है (demo.db आपके Iris होम डायरेक्टरी में — macOS/Linux पर ~/.iris, Windows पर %USERPROFILE%\.iris) और आपके असली ट्रेस के साथ कभी नहीं मिलता। इसे एक कमांड से पूरी तरह हटाएँ:
npx @iris-eval/mcp-server --demo-clear
अपना एजेंट जोड़ें
पहले साबित करें कि इंस्टॉल इस मशीन पर काम करता है — यह ऑफ़लाइन चलता है और आपकी कोई चीज़ नहीं खोलता:
npx @iris-eval/mcp-server --self-test # exit 0 = healthy
फिर Iris को अपने MCP क्लाइंट में जोड़ें। एक कमांड क्लाइंट की अपनी कॉन्फ़िगरेशन फ़ाइल लिखता है, उसमें मौजूद बाकी सभी सर्वर जस के तस रखता है और आपके चलाए गए संस्करण को पिन करता है:
npx -y @iris-eval/mcp-server install claude-code
क्लाइंट: claude-code, claude-desktop, cursor, windsurf, continue, vscode, cline, zed, codex, gemini. install --list इस मशीन पर मिले क्लाइंट, उनमें चलने वाला Iris संस्करण और उनके द्वारा पढ़ी जाने वाली फ़ाइल दिखाता है; install <client> --uninstall Iris को फिर से हटा देता है। सभी क्लाइंट एक ही डेटाबेस साझा करते हैं, इसलिए अपग्रेड के बाद install --upgrade से उन सभी को एक साथ स्थानांतरित करें (अपडेट करना)। इसे लोड करने के लिए क्लाइंट रीस्टार्ट करें।
Claude Desktop: एक क्लिक। 0.20.0 से शुरू होने वाली हर रिलीज़ में iris-eval.mcpb शामिल है, जो एक MCP Bundle है: नवीनतम संस्करण डाउनलोड करें, उसे खोलें और Claude Desktop एक इंस्टॉल डायलॉग दिखाएगा। उसमें कुछ भी अनिवार्य नहीं है — LLM जज के लिए Anthropic या OpenAI कुंजी वैकल्पिक है, और डैशबोर्ड का स्विच डिफ़ॉल्ट रूप से बंद रहता है। बंडल में npm पैकेज और उसकी निर्भरताएँ शामिल हैं, इसलिए कुछ और इंस्टॉल करने की ज़रूरत नहीं: Claude Desktop इसे अपने साथ आने वाले Node पर चलाता है, बशर्ते वह Node 22.13 या नया हो (Claude Desktop 1.1.6679 में 24.13 आता है), और Iris ट्रेस को Node के अंतर्निहित SQLite में उसी ~/.iris में रखता है जिसका उपयोग हर दूसरा इंस्टॉल करता है। रिलीज़ नोट्स में बताया गया है कि इसके हस्ताक्षर और बिल्ड अटेस्टेशन की पुष्टि कैसे करें।
यह किसी भी MCP क्लाइंट में चलता है, और जिन क्लाइंटों का नाम दिया गया है, उनमें से हर एक की पंक्ति बताती है कि उसकी जाँच कैसे की जाती है। हर CI रन पर सत्यापित: Claude Code, Gemini CLI — असली क्लाइंट इंस्टॉलर द्वारा लिखे गए कॉन्फ़िगरेशन से Iris शुरू करता है और कनेक्शन की पुष्टि करता है (claude mcp list, gemini mcp list), Linux, macOS और Windows पर; Claude Code के कैप्चर प्लगइन हुक भी असली स्क्रिप्ट के ज़रिए चलाए जाते हैं। हर क्लाइंट के अपने MCP दस्तावेज़ के अनुसार कॉन्फ़िगर किया गया — इंस्टॉलर हर क्लाइंट की दस्तावेज़ित फ़ाइल, दस्तावेज़ित पथ और उसके अपने फ़ॉर्मैट में लिखता है (एक mcpServers ब्लॉक, VS Code का servers, Zed का context_servers, Codex का TOML), टिप्पणियों और बाकी सभी सर्वरों को जस का तस रखते हुए। यूनिट टेस्ट हर पथ और हर फ़ॉर्मैट लेखक को उस दस्तावेज़ के अनुरूप जाँचते हैं: Claude Desktop, Cursor, Devin Desktop (Windsurf), Continue, VS Code, Cline, Zed, OpenAI Codex CLI। हर पंक्ति के साथ उसका स्रोत और उसे पढ़े जाने की तारीख: https://iris-eval.com/clients. इसके बजाय हाथ से जोड़ने के लिए, डैशबोर्ड सहित एक ब्लॉक:
{
  "mcpServers": {
    "iris-eval": {
      "command": "npx",
      "args": ["-y", "@iris-eval/mcp-server", "--dashboard"]
    }
  }
}
कनेक्ट होने पर आपका क्लाइंट Iris के बारह टूल दिखाता है, और डैशबोर्ड http://localhost:6920. पर उपलब्ध होता है। अब अपने एजेंट को यह भेजें:
उस आख़िरी काम को Iris में लॉग करें और आउटपुट का मूल्यांकन करें।
ट्रेस अपने स्कोर के साथ डैशबोर्ड पर दिखाई देगा। MCP सर्वर को बिना हेडलेस मोड में चलाना पसंद है? आर्ग्युमेंट्स से --dashboard हटा दें — आप जब चाहें उसी डैशबोर्ड को npx @iris-eval/mcp-server --dashboard से खोल सकते हैं।
एक बात पहले से जानना उपयोगी है: MCP टूल तभी कॉल होते हैं जब मॉडल उन्हें कॉल करने का फ़ैसला करता है। Iris आपके एजेंट को बीच में रोकता नहीं, इसलिए ट्रेस तभी लॉग होते हैं जब आपका एजेंट उससे लॉग करने को कहता है — या तो इसलिए कि आपने उसे ऐसा करने को कहा, या इसलिए कि आपका कोड सीधे टूल कॉल करता है। अपने एजेंट से कहें, “इसे Iris में लॉग करो और इसका मूल्यांकन करो,” और वह ऐसा करेगा। अगर आप ऐसा कैप्चर चाहते हैं जो मॉडल के चुनने पर निर्भर न हो, तो POST /api/v1/traces ठीक यही करता है — आपका कोड सादे HTTP से ट्रेस भेजता है, और प्रक्रिया में कोई मॉडल शामिल नहीं होता (देखें docs/http-ingest.md)। रोडमैप पर मौजूद CLI और होस्ट हुक इसी एंडपॉइंट के पतले क्लाइंट होंगे।
HTTP से कैप्चर करें (प्रक्रिया में कोई मॉडल नहीं)
इनजेस्ट एंडपॉइंट डैशबोर्ड पोर्ट पर उपलब्ध है — डिफ़ॉल्ट रूप से 6920, MCP ट्रांसपोर्ट पोर्ट पर नहीं — और केवल तभी मौजूद होता है जब डैशबोर्ड चल रहा हो। --dashboard पास करें (या IRIS_DASHBOARD=true सेट करें); केवल --transport http से यह शुरू नहीं होता, और ट्रांसपोर्ट पोर्ट पर भेजी गई रिक्वेस्ट का जवाब 404 होता है। डैशबोर्ड चालू होने पर, HTTP रिक्वेस्ट भेज सकने वाली कोई भी चीज़ ट्रेस लॉग कर सकती है — और चाहें तो उसी रिक्वेस्ट में नियतात्मक मूल्यांकन भी चला सकती है। उसी पोर्ट पर मौजूद GET /api/v1/capabilities बताता है कि यह सर्वर किन चीज़ों का मूल्यांकन कर सकता है, हर नियम को क्या चाहिए, जज की स्थिति और उसे सक्षम करने के चरण, तथा सीमाएँ — यही ऑब्जेक्ट MCP रिसोर्स iris://capabilities भी देता है — ताकि HTTP कॉलर को वही संदर्भ मिले जो MCP क्लाइंट को initialize के समय मिलता है:
curl -s -X POST "http://127.0.0.1:6920/api/v1/traces" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_name": "support-bot",
    "input": "What is the refund policy?",
    "output": "Refunds are available within 30 days of purchase.",
    "evaluate": true,
    "eval_type": "safety"
  }'
यह 201 के साथ संग्रहित trace_id और मूल्यांकन का परिणाम लौटाता है ( --demo मोड में एंडपॉइंट 403 के साथ लिखने से इनकार करता है, ताकि डेमो डेटा आपके डेटा के साथ न मिले)। एंडपॉइंट वही बॉडी स्वीकार करता है जो log_trace टूल स्वीकार करता है और डैशबोर्ड के बाकी हिस्से वाले उसी मिडलवेयर स्टैक के पीछे चलता है: डिफ़ॉल्ट रूप से लूपबैक बाइंड और DNS-रीबाइंडिंग सुरक्षा, साथ ही Bearer प्रमाणीकरण, अगर आप उसे सेट करें। इसके बारे में दो सीधी बातें: यह बिना प्रमाणीकरण वाली लिखने की रिक्वेस्ट स्वीकार करता है, जब तक Iris को --api-key (या IRIS_API_KEY) के साथ शुरू न किया गया हो — डिफ़ॉल्ट रूप से लूपबैक बाइंड ही इसे आपकी मशीन तक सीमित रखता है, इसलिए लूपबैक से बाहर बाइंड करने से पहले कुंजी सेट करें; और यह जो संग्रहित करता है वह हूबहू होता है — input और output ठीक वैसे ही iris.db में पहुँचते हैं जैसे भेजे गए थे, जिसमें वह टेक्स्ट भी शामिल है जिसे no_pii बाद में फ़्लैग करता है। पूरा अनुबंध, फ़ील्ड संदर्भ और त्रुटि का अर्थ: docs/http-ingest.md।
Claude Code के हर टर्न को कैप्चर करें (वैकल्पिक)
/plugin marketplace add iris-eval/mcp-server
/plugin install iris-eval-capture@iris-eval
एक दूसरा, अलग से इंस्टॉल किया जाने वाला प्लगइन: इसके हुक हर टर्न का प्रॉम्प्ट, टूल कॉल (विफल कॉल भी, एजेंट को मिली त्रुटि सहित) और अंतिम उत्तर रिकॉर्ड करते हैं। इन्हें प्रॉम्प्ट के आधार पर जोड़कर iris-eval ingest को अलग से भेजते हैं; संग्रहित मूल्यांकन टेक्स्ट में महत्वपूर्ण स्पैन पहले से छिपाए जाते हैं — ऐसा कैप्चर जो मॉडल के टूल कॉल करने के फ़ैसले पर निर्भर नहीं करता। API त्रुटि पर समाप्त हुआ टर्न बिना मूल्यांकन के संग्रहित होता है; अगर मॉडल ने भी टर्न लॉग किया हो, तो दोनों ट्रेस रखे जाते हैं और प्लगइन वाला मॉडल के ट्रेस का नाम बताता है। यह कभी कुछ प्रिंट नहीं करता, कभी रोकता नहीं और कहीं कुछ नहीं भेजता। केवल iris-eval इंस्टॉल करने से आपके टर्न लूप में कोई बदलाव नहीं होता। सीमाएँ और हटाने का तरीका: claude-plugin-capture/README.md।
Python
pip install iris-eval
from iris_eval import IrisClient
iris = IrisClient()                       # IRIS_URL, or the running dashboard's runtime.json
iris.evaluate_output("…", input="…", agent_name="support-bot")["verdict"]   # {"state": "pass", "basis": "clean", "by": []}
सर्वर 0.16.0 और बाद के संस्करणों के HTTP API पर आधारित एक पतला क्लाइंट, जिसका संस्करण अलग से तय होता है — iris_eval.__version__ और PyPI पेज पर इसका नंबर दिया है, जो सर्वर का संस्करण नहीं है: log_trace(), evaluate_output(), get_traces(), get_trace(), health(), capabilities(), सिंक और एसिंक, टाइप किए गए जवाब, इनकार पर सर्वर का अपना वाक्य — और एक pytest प्लगइन: एक iris फ़िक्स्चर और assert_iris(output, expect="pass"), जो फैसले की स्थिति पर दावा जाँचता है। packages/python/README.md।
हर OpenAI और Anthropic कॉल रिकॉर्ड करें
from iris_eval import wrap_openai
client = wrap_openai(OpenAI(), agent_name="support-bot")   # every call: a GenAI span to POST /v1/traces, scored
import { wrapOpenAI } from '@iris-eval/sdk';
const openai = wrapOpenAI(new OpenAI(), { agentName: 'support-bot' });
प्रदाता क्लाइंट को एक बार रैप करें और हर मॉडल कॉल एक OpenTelemetry GenAI स्पैन बन जाता है, जो OTLP एंडपॉइंट पर भेजा जाता है, इनपुट, आउटपुट, टोकन उपयोग और टूल कॉल के साथ संग्रहित होता है और स्कोर किया जाता है: ऐसा कैप्चर जो मॉडल के टूल कॉल करने पर निर्भर नहीं करता। Python क्लाइंट में wrap_openai / wrap_anthropic; @iris-eval/sdk में Vercel AI SDK के लिए wrapOpenAI, wrapAnthropic और irisMiddleware। दोनों अभी प्रकाशित नहीं हुए हैं (अगली iris-eval रिलीज़ PyPI पर आएगी; पहली npm रिलीज़ तक @iris-eval/sdk स्रोत से बनाया जाता है)। स्ट्रीम, SDK के स्ट्रीम हेल्पर और टूल कॉल शामिल हैं, मूल क्लाइंट में कोई बदलाव नहीं होता, और Iris बंद होने पर भी कॉल कभी विफल नहीं होती — packages/sdk/README.md, packages/python/README.md।
हर LangChain और LangGraph रन को स्कोर करें
from iris_eval.langchain import IrisCallbackHandler
graph.invoke(inputs, config={"callbacks": [IrisCallbackHandler(agent_name="support-bot")]})
हर टॉप-लेवल रन एक ट्रेस बनता है (रन, उसके मॉडल कॉल, उसके टूल कॉल और उसके ग्राफ़ नोड GenAI स्पैन के रूप में), जिसमें इनपुट, आउटपुट, टूल कॉल, टोकन उपयोग और फैसला शामिल होते हैं। क्लाइंट में Python (pip install iris-eval, 0.2.0 और बाद के संस्करण), JavaScript के रूप में @iris-eval/langchain (इस रिपॉज़िटरी में, अभी npm पर प्रकाशित नहीं)। दोनों को CI में स्क्रिप्टेड मॉडल वाले असली LangGraph ऐप के साथ साबित किया गया है; LangSmith का अपना OpenTelemetry एक्सपोर्ट भी इसी तरह साबित किया गया है — docs/otel-recipes.md।
बिना सर्वर के CI गेट
npx -y @iris-eval/mcp-server ingest --file traces.ndjson --evaluate --fail-on any
any हर उस फैसले पर जॉब को विफल करता है जो पास नहीं है: विफलता और ऐसा फैसला जिसकी जाँच नहीं हुई। इसके बजाय एक आधार चुनें (--fail-on detector_veto), ताकि केवल उसी आधार पर जॉब विफल हो।
या GitHub Action (0.16.0), जो आपके बताए फैसलों पर जॉब को विफल करता है, जॉब सारांश में रसीद लिखता है और उसे एक पुल-रिक्वेस्ट टिप्पणी के रूप में पोस्ट करता है, जिसे वहीं अपडेट किया जाता है: uses: iris-eval/mcp-server/.github/actions/gate@v0.21.0 के साथ traces: traces.ndjson — docs/ci-gate.md।
चौथा दरवाज़ा (0.15.0): POST /v1/traces डैशबोर्ड पोर्ट पर वह OTLP/HTTP JSON या protobuf स्वीकार करता है जिसे आपकी OpenTelemetry इंस्ट्रूमेंटेशन पहले से उत्सर्जित करती है (Python SDK का exporter केवल protobuf बोलता है, इसलिए Python के लिए भी यही दरवाज़ा है), और हर OTLP trace अपने spans के साथ Iris trace बन जाता है — docs/otel-integration.md; हर framework के लिए एक recipe (Pydantic AI, Google ADK, LangSmith के ज़रिए LangGraph, CrewAI, Python और JavaScript में OpenAI Agents SDK, LlamaIndex, AutoGen, Microsoft Agent Framework, Semantic Kernel, Vercel AI SDK और Mastra), हर एक fixture से प्रमाणित, docs/otel-recipes.md में। ingest stdin या किसी फ़ाइल से एक JSON trace (या NDJSON, हर पंक्ति में एक) पढ़ता है, उसे संग्रहीत करता है, ठीक उन्हीं नियमों के तहत उसका मूल्यांकन करता है जिन्हें evaluate_output चलाता है, verdict और उसके आधार के साथ हर trace के लिए एक JSON पंक्ति प्रिंट करता है, और जब कोई verdict --fail-on से मेल खाता है तो 1 के साथ बाहर निकलता है। --dataset <id|label> उस gate को dataset की case keys तक सीमित करता है (POST /api/v1/datasets किसी run की case keys को एक dataset में शामिल करता है), ताकि job केवल उन्हीं cases पर विफल हो जिन्हें आपने चुना है। पूरी recipe, exit codes और आठ आधार docs/ci-gate.md में हैं।
नियम को कोड के रूप में लिखें
eval.plugins in config.json आपके लिखे नियम लोड करता है — एक ES module जिसका default export { name, kind, mechanism, version, needs, evaluate(ctx) } है — और फ़ाइल के sha256 से उसे पिन करता है, ताकि पिन करने के बाद बदली हुई फ़ाइल चलने के बजाय startup को अस्वीकार कर दे। लोड किया गया plugin किसी built-in की तरह सक्रिय होता है और list_rules पर plugins के अंतर्गत दिखाई देता है। इसका contract, hash recipe और plugin क्या लौटा सकता है: docs/plugins.md।
अपने process में engine का उपयोग करें
Evaluation engine import किया जा सकता है — न server, न database, न model:
import { EvalEngine, defaultConfig } from '@iris-eval/mcp-server/engine';

const engine = new EvalEngine(defaultConfig.eval.defaultThreshold, defaultConfig.eval.ruleThresholds, defaultConfig.eval);
const result = await engine.evaluateAll({ output: answer, input: prompt, toolCalls, costUsd });
result.verdict.state;       // 'pass' | 'fail' | 'unknown', with result.verdict.basis and result.interpretations
वही engine, वही नियम और वही composer जो server चलाता है; builtInRules(), createCustomRule(), compose() और प्रकाशित accuracy readers भी इसके साथ export किए जाते हैं।
HTTP route के लिए typed client
import { createClient } from '@iris-eval/mcp-server/client';

const iris = createClient({ baseUrl: 'http://127.0.0.1:6920', apiKey: process.env.IRIS_API_KEY });
const { trace_id, evaluation } = await iris.logTrace({ agent_name: 'support-bot', input, output, tool_calls, evaluate: true });
evaluation?.verdict?.state;  // the same object evaluate_output returns
हर दरवाज़े पर एक ही body: इसे log_trace और iris-eval ingest स्वीकार करते हैं। अस्वीकृति पर server के अपने वाक्य और status के साथ IrisClientError throw होता है। दोनों subpaths को हर build में packed tarball से जाँचा जाता है।
अपना install सत्यापित करें
npx @iris-eval/mcp-server --self-test   # offline diagnostic; exit 0 = healthy, 1 = a check failed
npx @iris-eval/mcp-server --version     # prints the bare version, e.g. 1.2.3
--self-test पहले आपका Iris home बनाता है, यदि वह मौजूद न हो, और जाँचता है कि उसमें लिखा जा सकता है (नहीं लिखे जा सकने पर exit 1 और path का नाम बताता है); बताता है कि आपके database का search index कहाँ है (पूरा, background build ने अब तक कितने traces index किए हैं, या इस SQLite में FTS5 नहीं है); आपके database का schema पढ़ता है (जब यह version या पुराने release पर pinned MCP client उसे खोल न सके, तो सुधार के निर्देश के साथ exit 1); फिर एक अलग temp home के भीतर अपनी जाँचें चलाता है — storage round-trip, एक लगाया गया SSN और safety rules द्वारा पकड़ा गया एक लगाया गया injection, dashboard boot, DNS-rebinding guard। आपका असली database केवल पढ़ा जाता है, उसमें कभी बदलाव नहीं किया जाता। Iris जो कुछ भी लिखता है, वह एक ही directory, आपके Iris home, के अंतर्गत रहता है: डिफ़ॉल्ट रूप से ~/.iris (%USERPROFILE%\.iris Windows पर), या जहाँ IRIS_HOME इंगित करता है। वहीं iris.db, config.json, custom-rules.json, audit.log, preferences.json और demo files रहती हैं; अपने असली data को छुए बिना Iris आज़माने के लिए IRIS_HOME को किसी scratch directory पर इंगित करें।
टूल के अनुसार सेटअप
| Client | स्थिति | इसका अर्थ | पढ़ें |
|---|---|---|---|
| Claude Code | सत्यापित | हर CI run में एक test असली client चलाता है | 2026-09-25 |
| Claude Desktop | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Cursor | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Devin Desktop (Windsurf) | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Continue | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| VS Code | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Cline | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Zed | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| OpenAI Codex CLI | दावा किया गया | client के अपने MCP दस्तावेज़ों के अनुसार कॉन्फ़िगर किया गया; installer का path और format unit-tested है | 2026-09-25 |
| Gemini CLI | सत्यापित | हर CI run में एक test असली client चलाता है | 2026-09-25 |
हर पंक्ति में क्या जाँचा गया है: iris-eval.com/clients। किसी client को समर्थित नहीं कहा जाता, जब तक उसकी पंक्ति न हो।
npx -y @iris-eval/mcp-server install <client> ये सभी आपके लिए लिखता है। हर client के लिए हाथ से:
Claude Desktop
अपनी MCP config file संपादित करें:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
ऊपर दी गई JSON config जोड़ें, फिर Claude Desktop को restart करें।
Claude Code
claude mcp add --transport stdio iris-eval -- npx -y @iris-eval/mcp-server
फिर tools लोड करने के लिए session restart करें (/clear या relaunch)।
Windows नोट:
cmd /cwrapper का उपयोग न करें — इससे path parsing की समस्याएँ होती हैं।npxcommand सीधे काम करती है।
Cursor
ऊपर दी गई JSON config को ~/.cursor/mcp.json (हर project) या workspace में .cursor/mcp.json में जोड़ें, और iris-eval entry में "type": "stdio" रखें — Cursor के docs इसे आवश्यक बताते हैं।
Devin Desktop (Windsurf)
ऊपर दी गई JSON config को mcp_config.json में जोड़ें: macOS और Linux पर ~/.config/devin/mcp_config.json, Windows पर %APPDATA%\devin\mcp_config.json।
Continue
ऊपर दी गई JSON config को Continue के mcpServers folder में अलग file के रूप में सहेजें: ~/.continue/mcpServers/iris-eval.json (हर workspace) या किसी एक में .continue/mcpServers/iris-eval.json।
VS Code (native MCP)
अपने workspace में .vscode/mcp.json में जोड़ें (ध्यान दें: VS Code mcpServers नहीं, servers इस्तेमाल करता है):
{
  "servers": {
    "iris-eval": {
      "command": "npx",
      "args": ["-y", "@iris-eval/mcp-server"]
    }
  }
}
Cline
Cline का MCP Servers panel → Configure MCP Servers खोलें, और ऊपर दी गई mcpServers JSON config को cline_mcp_settings.json में जोड़ें (~/.cline/data/settings/cline_mcp_settings.json, जिसे Cline VS Code, JetBrains और CLI में साझा करता है)।
Zed
Zed के settings.json में जोड़ें:
{
  "context_servers": {
    "iris-eval": {
      "command": "npx",
      "args": ["-y", "@iris-eval/mcp-server"],
      "env": {}
    }
  }
}
OpenAI Codex CLI
~/.codex/config.toml में जोड़ें:
[mcp_servers.iris-eval]
command = "npx"
args = ["-y", "@iris-eval/mcp-server"]
Gemini CLI
ऊपर दी गई mcpServers JSON config को ~/.gemini/settings.json में जोड़ें। Gemini CLI केवल भरोसेमंद folders में MCP servers से जुड़ता है: यदि gemini mcp list में iris-eval Disabled दिखे, तो उस folder में /permissions चलाएँ।
कोई भी अन्य client जो MCP बोलता हो
Iris एक मानक stdio MCP server है — एक npx @iris-eval/mcp-server command, न SDK, न code में बदलाव। यदि आपका client MCP का समर्थन करता है, तो वह Iris का भी समर्थन करता है। Client config formats बदलते रहते हैं; संदेह होने पर अपने client के MCP docs देखें और उसे उस command की ओर इंगित करें।
इंस्टॉल करने के अन्य तरीके
# Global install (recommended for persistent data and faster startup)
npm install -g @iris-eval/mcp-server
iris-eval --dashboard

# Docker — two servers, two ports: 3000 = MCP HTTP transport,
# 6920 = dashboard (which also serves the POST /api/v1/traces ingest endpoint).
# The image binds 0.0.0.0 inside the container, so a key is required (see Production).
# The volume is the Iris home: the database, deployed rules and audit log persist in it.
docker run -p 3000:3000 -p 6920:6920 -v iris-data:/data \
  -e IRIS_API_KEY="$(openssl rand -hex 32)" ghcr.io/iris-eval/mcp-server
सुझाव: Global install (
npm install -g) traces को~/.iris/iris.dbपर स्थायी रूप से संग्रहीत करता है।npxके साथ traces उसी जगह स्थायी रहते हैं, लेकिन package resolution के कारण startup धीमा होता है।
Container image और वे MCP directories जहाँ Iris सूचीबद्ध है:


आपको क्या मिलता है
| Trace लॉगिंग | हर tool call के लिए latency, token usage और USD में लागत सहित पदानुक्रमित span trees। SQLite में संग्रहीत, तुरंत query किए जा सकते हैं। |
| Output मूल्यांकन | 4 श्रेणियों में 28 built-in नियम: completeness, relevance, safety, cost। PII पहचान (21 पैटर्न: SSN, credit card, phone, email, IBAN, DOB, MRN, IP, API key, passport, साथ ही AWS/Slack/SendGrid/GitHub/Google/npm/DigitalOcean tokens, URLs के भीतर credentials, secret-नाम वाले assignments, PEM private-key blocks और seed phrases; date of birth, medical record number, passport और seed phrase केवल अपने label के पास होने पर सक्रिय होते हैं, जानबूझकर), prompt injection (38 पैटर्न, phrase + structural), stub-output पहचान, hallucination पहचान (25 context-grounded fabrication/contradiction संकेत — उन्हें agent की source material के आधार पर जाँचने के लिए input दें), और छह trajectory नियम जो पढ़ते हैं कि agent ने क्या किया: ऐसा विफल tool call जिसे स्वीकार नहीं किया गया; दोहराया गया call (एक call के रूप में, दोहराए गए sequence के रूप में, या target के आधार पर, जब आप tools भेजें); ऐसा call जिसके arguments को tool का अपना JSON Schema अस्वीकार करता है और agent ने फिर कोशिश नहीं की; ऐसा file, directory या URL जिसका उत्तर में उल्लेख है, लेकिन जिसे agent ने पढ़ी किसी चीज़ में नहीं पाया गया; ऐसा निर्देश जो TOOL RESULT के भीतर आया और बाद के call में माना गया; और ऐसा task जिसमें आपके step budget से अधिक tool calls लगे। दो अन्य नियम किसी run की तुलना उसी agent के अपने case के पुराने runs से करते हैं, बिना किसी के expectation लिखे: ऐसा action जो किसी पुराने run ने नहीं किया, और ऐसा step जो हर पुराने run ने किया लेकिन इस run ने नहीं। Trajectory tool_calls के रूप में या OpenTelemetry TOOL spans के रूप में आ सकती है। Zod schemas के साथ custom नियम जोड़ें। |
| LLM-as-Judge | Anthropic या OpenAI के ज़रिए वैकल्पिक semantic scoring — अपनी API key लाएँ। सात templates। IRIS_RELEVANCE_JUDGE_MODEL सेट होने पर, answers_the_ask relevance judge से पूछता है और विषय से हटे उत्तर को विफल करता है; इसके बिना नियम ask को lexical रूप से पढ़ता है और सलाह देता है। प्रति-eval लागत की सख्त सीमा (IRIS_LLM_JUDGE_MAX_COST_USD_PER_EVAL, डिफ़ॉल्ट $0.25), और परिणाम में प्रति-eval pricing बताई जाती है। |
| लागत की दृश्यता | किसी भी समयावधि में सभी agents की कुल लागत। Budget thresholds सेट करें। Agents के ज़रूरत से ज़्यादा खर्च करने पर सूचना पाएँ। ऐसा trace जो token counts और model भेजता है, लेकिन लागत नहीं (अधिकांश OpenTelemetry और framework traces), model की सूची कीमत पर आँका जाता है और जहाँ भी दिखता है, estimated के रूप में चिह्नित होता है; built-in table में न होने वाले models की कीमत तय करने के लिए pricing.models को config.json में रखें — docs/cost.md। |
| Web Dashboard | वास्तविक समय का dark-mode UI, जो पहले विफलताओं पर जाता है और सबसे खराब तथा सबसे नए को पहले दिखाता है — हर trace के text पर full-text search के साथ trace visualization, eval results, लागत का विवरण और command palette (⌘K), जो आपके अपने नियमों, traces और evals में खोजता है। |
| Local-first | सब कुछ आपकी disk पर SQLite में रहता है। Self-hosted server को account या sign-up की ज़रूरत नहीं और वह telemetry नहीं भेजता। Outbound HTTP केवल वहीं होता है जहाँ आप अनुमति देते हैं: आपकी अपनी LLM-judge key, citation fetching, आपके द्वारा कॉन्फ़िगर किया गया OTel exporter, या आपके द्वारा सेट किया गया webhook। |
आगे की दिशा: capability map — हर विषय के बारे में Iris से पूछे जा सकने वाले हर सवाल के साथ, उसके पास क्या है और क्या नहीं — और तीन tracks।
दावे नहीं, मापे गए परिणाम
हर अंतर्निहित नियम के लिए प्रकाशित precision, recall और F1, 95% confidence intervals के साथ उपलब्ध हैं। इन्हें इस repository में मौजूद labelled corpus (proof/corpus/) पर मापा जाता है और एक command — npm run proof — से, offline, बिना किसी key और बिना किसी model के, फिर से तैयार किया जा सकता है। ये आँकड़े दो अलग-अलग प्रकार के हैं, और पृष्ठ इन्हें कभी जोड़ता नहीं है: कुछ नियमों को उन labels के आधार पर मापा जाता है जो किसी model ने स्वयं failure को पढ़कर दिए थे; इससे detection मापा जाता है। बाकी नियमों को उनकी अपनी documented definition के विरुद्ध, स्वतंत्र रूप से लागू करके जाँचा जाता है; इससे पता चलता है कि code उनका formula लागू करता है, लेकिन यह कुछ नहीं बताता कि formula failure पकड़ता है या नहीं। proof/RESULTS.md और proof page हर नियम को चिह्नित करते हैं। CI हर pull request पर मापन फिर से चलाता है और यदि committed आँकड़े code से मिले परिणामों से अलग हों तो विफल हो जाता है, इसलिए कोई नियम अपने आँकड़े बदले बिना नहीं बदल सकता। आँकड़े iris-eval.com/proof और proof/RESULTS.md पर हैं; corpus कैसे बनाया गया, वह क्या नहीं है, और interval को कैसे पढ़ें—यह docs/proof.md में है। Corpus synthetic और model-labelled है — human blind label अभी लंबित है, और पृष्ठ यह बात स्पष्ट करता है; node proof/blind-sample.mjs वह reproducible sample तैयार करता है जो इसका निर्णय करेगा।
MCP Tools
Iris बारह tools पंजीकृत करता है जिन्हें कोई भी MCP-compatible agent चला सकता है — trace और rule lifecycle, runs के बीच तुलना, LLM-as-judge और semantic citation verification:
log_trace— spans, tool calls, token usage और cost के साथ agent execution लॉग करें; उसी call में score करने के लिएevaluate: trueदेंevaluate_output— completeness, relevance, safety और cost नियमों के आधार पर output quality score करें (heuristic, deterministic, निःशुल्क)get_traces— filtering, pagination और time-range support के साथ संग्रहीत traces की query करें, और वह run खोजें जिसमें agent नेqके साथ कुछ कहा था: input, output, tool-call values और metadata पर full-text search, क्रमबद्ध परिणामों के साथ और मेल खाते शब्दों को चिह्नित करकेlist_rules— deployed custom eval rules की सूची दें (केवल पढ़ने के लिए)deploy_rule— नया custom eval rule पंजीकृत करें, ताकि वह उस category के हरevaluate_outputपर लागू होdelete_rule— deployed custom rule हटाएँ (विनाशकारी, idempotent)delete_trace— ID से एक संग्रहीत trace हटाएँ (विनाशकारी, tenant-scoped)evaluate_with_llm_judge— LLM के ज़रिए semantic eval (Anthropic या OpenAI)। सात templates: accuracy, helpfulness, safety, correctness, faithfulness, task_completed, relevance। लागत सीमित, प्रति-eval मूल्य पहले से बताया जाता है। अपनी API key लाएँ (IRIS_ANTHROPIC_API_KEYयाIRIS_OPENAI_API_KEY) — Iris LLM calls को proxy या relay नहीं करता।verify_citations— output से citations निकालें (numbered, author-year, URLs, DOIs), SSRF-guarded और domain-allowlisted resolver के पीछे के sources fetch करें, और LLM judge से जाँचें कि हर source वास्तव में उद्धृत दावे का समर्थन करता है या नहीं। Outbound HTTP वैकल्पिक है।evaluate_with_llm_judgeजैसी ही BYOK आवश्यकता लागू होती है।compare_runs— क्या किसी बदलाव से agent का प्रदर्शन खराब हुआ? संग्रहीत evaluations के दो runs की तुलना करता है: runs में case keys साझा होने पर paired exact test, अन्यथा अंतर का interval, आवश्यक cases की संख्या सहित ईमानदार "cannot tell", या "equivalent within a margin"। हर नियम का अपना one-sided test होता है; इन्हें एक साथ (Benjamini–Hochberg) सुधार किया जाता है, ताकि बीस नियम मिलकर regression न गढ़ सकेंcompare_traces— agent एक ही प्रश्न का उत्तर कितनी विश्वसनीयता से देता है? हर case की pass rates और intervals, पहले flaky cases, और repeats का ध्यान रखने वाली समग्र rateevaluate_runs— आज के नियमों के तहत किसी run के हर trace को फिर से score करके नया run बनाएँ, ताकि नियमों में बदलाव को कभी agent में बदलाव न समझा जाए
LLM judge सक्षम करें (वैकल्पिक; deterministic नियमों को इसकी कभी आवश्यकता नहीं होती)
- Anthropic या OpenAI से API key लें।
- इसे उस process के environment में रखें जो Iris चलाता है, केवल अपने shell में नहीं। Claude Code, Claude Desktop, Cursor और अधिकांश MCP clients के लिए: अपने MCP config में iris-eval entry के "env" block में — "iris-eval": { "command": "npx", "args": ["-y", "@iris-eval/mcp-server"], "env": { "IRIS_ANTHROPIC_API_KEY": "sk-ant-..." } } (OpenAI key के लिए IRIS_OPENAI_API_KEY)। Docker: run command में -e IRIS_ANTHROPIC_API_KEY=...। HTTP या CI: iris-eval शुरू करने से पहले इसे export करें।
- MCP session फिर से शुरू करें। चल रहा process शुरू होने के बाद सेट किया गया variable कभी नहीं देखता।
- अपने client के भीतर से पुष्टि करें: iris://capabilities पढ़ें — वहाँ judge.enabled true होना चाहिए। आपके shell में export की गई key उस process तक नहीं पहुँचती जिसे आपका client शुरू करता है, जब तक उसका config इसे सूचीबद्ध न करे। किसी machine पर,
npx @iris-eval/mcp-server --self-testउस shell के लिए judge line दिखाता है, और GET /api/v1/health चल रहे dashboard पर judge.enabled बताता है। - खर्च की सीमा: हर call पर IRIS_LLM_JUDGE_MAX_COST_USD_PER_EVAL की सीमा लागू होती है (डिफ़ॉल्ट 0.25 USD), और यदि अधिकतम संभावित खर्च इससे ज़्यादा हो तो खर्च होने से पहले ही call अस्वीकार कर दी जाती है। Iris द्वारा आपकी key पर की गई हर judge call एक ही दैनिक budget से खर्च होती है, IRIS_LLM_JUDGE_DAILY_BUDGET_USD (डिफ़ॉल्ट 1 USD प्रति UTC दिन); सीमा पार होने पर, UTC मध्यरात्रि तक कोई call नहीं की जाती। Iris आपकी key से सीधे provider को call करता है और उसे कभी proxy नहीं करता।
- वैकल्पिक: IRIS_RELEVANCE_JUDGE_MODEL को किसी priced model id (उदाहरण के लिए claude-haiku-4-5) पर सेट करें, ताकि answers_the_ask judge से पूछे कि हर उत्तर उसके ask को संबोधित करता है या नहीं, और विषय से हटे उत्तर को विफल माने। जिस evaluation में input हो, उसके लिए यह एक judge call है; यह आपकी key पर और ऊपर दी गई सीमा के अधीन है। केवल key होने से यह सुविधा चालू नहीं होती। हर call उस input और output को model provider को भेजती है; पहले personal data और credentials वाले no_pii flags को बदल दिया जाता है (IRIS_RELEVANCE_JUDGE_REDACT=off उन्हें ज्यों का त्यों भेजता है)। यह उसी दैनिक budget से खर्च करती है और प्रति request अधिकतम IRIS_RELEVANCE_JUDGE_MAX_CALLS_PER_REQUEST calls करती है (डिफ़ॉल्ट 20); इनमें से कोई भी सीमा पार होने पर, answers_the_ask ask को lexical रूप से पढ़ता है और कारण बताता है।
जब IRIS_OTEL_ENDPOINT कॉन्फ़िगर हो, तो log_trace calls किसी भी OpenTelemetry collector (Jaeger, Grafana Tempo, Datadog OTLP, Honeycomb आदि) को best-effort OTLP/HTTP JSON export भी भेजती हैं। docs/otel-integration.md देखें।
passed का निर्णय कैसे होता है
evaluate_output एक score और एक passed flag, दोनों लौटाता है — ये अलग-अलग सवालों के जवाब देते हैं:
score(0..1) चलाए गए नियमों का weighted average है — गुणवत्ता का एक gradient।passedship/no-ship का निर्णय है, और इसके लिए score पर कभी विचार नहीं किया जाता। एक composer हर नियम को उसके दावे के प्रकार के अनुसार पढ़ता है: आपके द्वारा कॉन्फ़िगर की गई policy gate करती है; critical detector veto करता है; जिस critical check को चलाने के लिए कहा गया हो लेकिन जो उत्तर न दे सके, वह साफ़ परिणाम के बजाय unknown (passed: false) बनाता है; बाकी सभी detectors मिलकर इस संभावना का एक मान निकालते हैं कि output खराब है, जिसेeval.falsePassCostमें बताए गए loss ratio के विरुद्ध तौला जाता है (डिफ़ॉल्ट 1, इसलिए सीमा 0.5 है)।verdict.basisनिर्णय लेने वाली layer का नाम बताता है औरverdict.byनियमों के नाम;verdict.alsoउन सभी बाद की layers की सूची देता है जो यह निर्णय लेतीं;interpretations[]बताता है कि विफल हुआ नियम निर्णय क्यों नहीं ले पाया और कौन-सी setting इसे बदल सकती है, साथ ही उस प्रश्न का नाम भी बताता है जिसका मूल्यांकन नहीं हुआ और वह input भी जो इसे संभव बनाता।
वास्तविक safety violations पर hard-fail होता है। डिफ़ॉल्ट रूप से no_pii, no_injection_patterns, और no_blocklist_words critical rules हैं: इनमें से कोई विफल हो तो अन्य नियमों के score चाहे जितने अच्छे हों, eval passed: false रिपोर्ट करता है और response critical_failures में दोषी नियमों के नाम बताता है। लीक हुआ SSN औसत में दबाया नहीं जा सकता। कौन-से built-in rules critical हैं, यह deployment setting (eval.criticalRules / eval.nonCriticalRules) है; और कौन-से detectors केवल रिपोर्ट करते हैं, यह भी (eval.advisoryRules)। हर rule result में प्रभावी critical flag और criticalSource होता है, और list_rules इस server पर लागू roster बताता है। severity: "high" या "critical" से deployed custom rules भी इसी तरह hard-fail करते हैं; low/medium severities केवल score को प्रभावित करती हैं। एक सीमा ध्यान में रखें, जो हर surface पर एक ही तरह से बताई गई है: जो critical rule skipped हुआ हो (context न होना, definition का टूटना, या sandbox budget में regex का रुक जाना), उसने output का मूल्यांकन नहीं किया है और veto नहीं करता — ऐसे हर नियम का नाम critical_skipped में दिया जाता है। जो gate fail closed होना चाहिए, वह non-empty critical_skipped को साफ़ नहीं, unknown मानता है, और rule_results में किसी भी budgetExceeded skip को भी इसी तरह मान सकता है।
CI gates के लिए: यदि आप eval_type छोड़ देते हैं, तो हर bundle चलता है — completeness, relevance, safety, cost और कोई भी custom rules — और response eval_type: "all" बताता है, साथ में note देता है कि default चला था, और हर bundle का categories map भी देता है। हर row में state होता है: उस bundle के नियमों के लिए verdict, ताकि कोई row उन नियमों को पारित न बताए जो evaluation में विफल हुए। जिस bundle में जाँचने के लिए कुछ न हो (जैसे cost_usd के बिना cost, या input के बिना relevance), वह वहाँ state: "unknown" और passed: null रिपोर्ट करता है — यानी मूल्यांकन नहीं हुआ, विफल नहीं — और verdict में कभी नहीं गिना जाता। Response हमेशा चलाए गए eval_type को echo करता है, ताकि आपका gate coverage की पुष्टि कर सके; verdict के लिए passed पर निर्भर करें और bundle का नाम केवल तभी दें जब आप सीमित run चाहते हों।
Custom rule लिखना
Rule जोड़ने के दो तरीके हैं। Inline rules एक evaluate_output call के साथ चलते हैं (custom_rules, प्रति call अधिकतम 10); वे आपके चुने हुए eval_type bundle के साथ लागू होते हैं, या eval_type: "custom" के साथ अकेले। Deployed rules को deploy_rule से एक बार पंजीकृत किया जाता है, आपके Iris home में custom-rules.json के तहत बने रहते हैं, और उनके evalType के हर भविष्य के evaluate_output पर लागू होते हैं। दोनों तरीकों में definition का आकार एक जैसा है:
| Field | Required | What it is |
|---|---|---|
name | हाँ | 1–80 characters; परिणामों में ruleName के रूप में दिखता है |
type | हाँ | इनमें से एक: regex_match · regex_no_match · min_length · max_length · contains_keywords · excludes_keywords · json_schema · cost_threshold |
config | हाँ | उस type की keys: दो regex types के लिए pattern (+ वैकल्पिक flags) · min_length / max_length (character count) · दो keyword types के लिए keywords (+ वैकल्पिक threshold, 0–1, डिफ़ॉल्ट 1 = सभी का होना आवश्यक) · json_schema के लिए {} · cost_threshold के लिए USD में max_cost |
weight | नहीं | score में weight; डिफ़ॉल्ट 1 |
deploy_rule definition को name, वैकल्पिक description, evalType (completeness · relevance · safety · cost · custom) और severity के साथ wrap करता है। Severity बताती है कि विफलता का क्या अर्थ है: low/medium केवल score घटाते हैं; high/critical evaluation को hard-fail करते हैं — passed: false, और नियम का नाम critical_failures में दिया जाता है — weighted score चाहे जो कहे। जो नियम skip हो (बिना cost_usd वाला cost_threshold rule, या 100 ms sandbox budget में रुक गया regex), उसने output का मूल्यांकन नहीं किया है और इसके बजाय critical_skipped में सूचीबद्ध होता है। Agent की कही किसी भी बात में internal hostnames को रोकने वाला critical rule deploy करें:
{
  "name": "no_internal_hostnames",
  "description": "Output must not mention internal hostnames.",
  "evalType": "safety",
  "severity": "critical",
  "definition": {
    "name": "no_internal_hostnames",
    "type": "regex_no_match",
    "config": { "pattern": "\\b[a-z0-9-]+\\.internal\\.example\\b", "flags": "i" }
  }
}
Response में persisted rule होता है — delete_rule के लिए id सुरक्षित रखें:
{ "rule": { "id": "rule-588823d0", "name": "no_internal_hostnames", "evalType": "safety", "severity": "critical", "enabled": true, "version": 1, "definition": { "…": "…" } } }
अगले ही evaluate_output के साथ eval_type: "safety" से, db-primary.internal.example का उल्लेख करने वाला आउटपुट passed: false के साथ critical_failures: ["no_internal_hostnames"] लौटता है — जबकि सभी पाँच अंतर्निहित सुरक्षा नियम पास हुए और भारित स्कोर 0.895 है। Regex पैटर्न को डिप्लॉय के समय ReDoS जाँच पास करनी होगी और हमेशा सख्त 100 ms समय-सीमा के भीतर सैंडबॉक्स वर्कर में चलना होगा। list_rules दिखाता है कि क्या डिप्लॉय किया गया है; डैशबोर्ड का नियम कंपोज़र आपके द्वारा क्लिक की गई विफलता से यही संरचना बनाता है। पूरा संदर्भ, प्रकार के अनुसार स्कोरिंग और उदाहरण: docs/custom-rules.md।
टूल स्कीमा और कॉन्फ़िगरेशन का पूरा विवरण: iris-eval.com
स्वयं होस्ट करें और मुफ़्त
Iris आपकी मशीन या आपके अपने इन्फ़्रास्ट्रक्चर पर चलता है। ओपन-सोर्स कोर मुफ़्त है और MIT लाइसेंस के तहत उपलब्ध है; इसमें उपयोग की कोई सीमा नहीं है और किसी खाते की ज़रूरत नहीं है। होस्ट की गई स्टोरेज, साझा टीम इतिहास और अलर्टिंग पर विचार किया जा रहा है, उन पर काम शुरू नहीं हुआ है; अगर ये आपके काम आएँ, तो हमें hello@iris-eval.com पर बताएँ।
दो प्रतिबद्धताएँ कायम हैं: आज जो भी मुफ़्त है, उसे कभी पेवॉल के पीछे नहीं रखा जाएगा, और कोई अनुपालन प्रमाणन तब तक दावा नहीं किया जाएगा, जब तक वह प्राप्त न हो जाए।
उदाहरण
- Claude Desktop सेटअप — stdio और HTTP मोड के लिए MCP कॉन्फ़िगरेशन
- TypeScript — MCP SDK क्लाइंट — कनेक्ट करें और टूल चलाएँ
- HTTP ट्रांसपोर्ट (TS + Python) — REST-शैली इंटीग्रेशन के लिए पूरा क्लाइंट कोड
- एक LangGraph एजेंट, हर रन का स्कोर (Python) — ग्राफ़ के कॉलबैक में
IrisCallbackHandler; CI उसी ग्राफ़ को स्क्रिप्टेड मॉडल के साथ चलाता है - OpenTelemetry पर CrewAI क्रू (Python) — OpenInference इंस्ट्रूमेंटर सीधे Iris के OTLP एंडपॉइंट पर, और CrewAI रेसिपी एक स्क्रिप्ट के रूप में
- OpenTelemetry पर OpenAI Agents SDK एजेंट (Python) और (JavaScript), और एक LlamaIndex एजेंट — हर रेसिपी वह स्क्रिप्ट है जिसे CI असली Iris सर्वर के विरुद्ध चलाता है
समुदाय
- GitHub Issues — बग रिपोर्ट और फ़ीचर अनुरोध
- GitHub Discussions — सवाल और विचार
- मदद पाएँ — सवाल पूछने, बग रिपोर्ट करने या सुरक्षा कमज़ोरी की सूचना देने की जगह
- योगदान मार्गदर्शिका — योगदान कैसे करें; AGENTS.md कोडिंग एजेंटों के लिए यही मार्गदर्शिका है
- गवर्नेंस — फ़ैसले कौन लेता है, बदलाव कैसे शामिल होता है, और रिलीज़ कैसे बनाई और सत्यापित की जाती है
- HTTP Ingest —
POST /api/v1/tracesके ज़रिए नियतात्मक ट्रेस कैप्चर - क्षमता मानचित्र — Iris से पूछे जा सकने वाले हर सवाल की सूची और उसमें क्या कमी है
- वर्ज़निंग नीति — हर वर्ज़न नंबर क्या वादा करता है और 1.0 से पहले क्या सच होना ज़रूरी है
कॉन्फ़िगरेशन और सुरक्षा
CLI आर्ग्युमेंट
| फ़्लैग | डिफ़ॉल्ट | विवरण |
|---|---|---|
--transport | stdio | ट्रांसपोर्ट प्रकार: stdio या http |
--port | 3000 | HTTP ट्रांसपोर्ट पोर्ट |
--db-path | ~/.iris/iris.db | SQLite डेटाबेस पथ |
--config | ~/.iris/config.json | कॉन्फ़िग फ़ाइल पथ |
--api-key | — | HTTP प्रमाणीकरण के लिए API key (ट्रांसपोर्ट और डैशबोर्ड, जिसमें POST /api/v1/traces भी शामिल है) |
--dashboard | false | वेब डैशबोर्ड सक्षम करें। POST /api/v1/traces ingest endpoint शुरू करने का यह एकमात्र तरीका भी है — यह --transport http के साथ कभी अपने-आप शुरू नहीं होता |
--dashboard-port | 6920 | डैशबोर्ड पोर्ट |
--dashboard-host | 127.0.0.1 | डैशबोर्ड का bind address। डिफ़ॉल्ट रूप से loopback — डैशबोर्ड पर प्रमाणीकरण नहीं है, जब तक --api-key सेट न हो; इसलिए loopback से बाहर bind करने पर आपका पूरा ट्रेस इतिहास उजागर हो जाता है |
--demo | false | डेमो डेटाबेस बनाएँ (आपके असली ट्रेस से अलग) और उसी पर डैशबोर्ड चलाएँ |
--demo-clear | false | डेमो डेटाबेस हटाएँ और बाहर निकलें |
--self-test | false | अलग-थलग अस्थायी होम में ऑफ़लाइन इंस्टॉल डायग्नोस्टिक चलाएँ, फिर बाहर निकलें (0 = सब ठीक, 1 = कोई जाँच विफल)। यह कॉन्फ़िगर किया गया डेटाबेस भी केवल-पढ़ने के लिए खोलता है और तब विफल होता है, जब यह वर्ज़न या पिन किया गया MCP क्लाइंट उसे खोल न सके |
--purge | false | कॉन्फ़िगर किए गए डेटाबेस से हर संग्रहीत ट्रेस, स्पैन और मूल्यांकन हटाएँ, फ़ाइल को कॉम्पैक्ट करें और write-ahead log को ट्रंकेट करें, ताकि हटाया गया टेक्स्ट डिस्क पर न बचा रहे; डिप्लॉय किए गए नियम, ऑडिट लॉग और प्राथमिकताएँ सुरक्षित रहती हैं। इसे वापस नहीं किया जा सकता। पहले चल रहे किसी भी Iris सर्वर को रोकें — फ़ाइल को उसी जगह कॉम्पैक्ट किया जाता है। इसे --demo, --demo-clear या --self-test के साथ चलाने से मना करता है |
--version | — | सादा वर्ज़न (जैसे 1.2.3) stdout पर प्रिंट करें और 0 के साथ बाहर निकलें। आपके Iris होम में कुछ भी नहीं पढ़ता |
तीन कमांड अपने आर्ग्युमेंट लेकर चलते हैं और बाहर निकल जाते हैं: iris-eval ingest किसी फ़ाइल या stdin से ट्रेस लोड करता है (CI गेट, सर्वर की ज़रूरत नहीं), iris-eval export traces|evaluations --format csv|jsonl डैशबोर्ड की सूचियों जैसे फ़िल्टर के साथ संग्रहीत डेटा stdout या --out पर लिखता है (docs/api-reference.md), और iris-eval install <client> Iris को MCP क्लाइंट के कॉन्फ़िग में लिखता है — --uninstall उसे हटाता है, --list इस मशीन पर मिले क्लाइंट और उनमें चल रहे Iris दिखाता है, और --upgrade Iris चलाने वाले हर क्लाइंट को इस वर्ज़न पर ले जाता है (अपने एजेंट को जोड़ें, अपडेट करना)। इनमें से कोई भी सर्वर शुरू नहीं करता।
Iris शुरू होने पर config.json की जाँच होती है। अगर Iris किसी कुंजी को नहीं पढ़ता — जैसे eval.critcalRules जैसी टाइपो, किसी दूसरे टूल की कुंजी — या उसका मान गलत प्रकार का है, तो स्टार्टअप रुक जाता है और एक वाक्य में पूरी कुंजी, उसका सबसे संभावित आशय या अपेक्षित प्रकार बताया जाता है। फ़ाइल में मौजूद किसी भी चीज़ को चुपचाप अनदेखा नहीं किया जाता।
Environment Variables
हर वेरिएबल --help में दर्ज है। दोनों सेट होने पर CLI फ़्लैग को environment variables पर प्राथमिकता मिलती है।
| Variable | विवरण |
|---|---|
IRIS_TRANSPORT | ट्रांसपोर्ट का प्रकार (stdio या http) |
IRIS_HOST | HTTP ट्रांसपोर्ट का बाइंड पता (डिफ़ॉल्ट 127.0.0.1) |
IRIS_PORT | HTTP ट्रांसपोर्ट का पोर्ट (1-65535, डिफ़ॉल्ट 3000) |
IRIS_HOME | प्रति-उपयोगकर्ता सभी फ़ाइलों की डायरेक्टरी: config.json, iris.db, custom-rules.json, audit.log, preferences.json (डिफ़ॉल्ट ~/.iris) |
IRIS_DB_PATH | SQLite डेटाबेस पथ (केवल DB के लिए IRIS_HOME को ओवरराइड करता है) |
IRIS_SQLITE_DRIVER | डेटाबेस किस SQLite ड्राइवर में रखा जाता है: native (better-sqlite3, डिफ़ॉल्ट) या node (Node का अंतर्निहित node:sqlite, Node 22.13+)। सेट न होने पर: native, और जब native मॉड्यूल लोड न हो सके (या ऐसा बिल्ड हो जो इस Node पर क्रैश हो जाए), तो Iris एक बार चेतावनी देता है और अंतर्निहित ड्राइवर पर वापस चला जाता है |
IRIS_SEARCH_BUDGET_MS | एक ट्रेस खोज (q) कितनी देर तक पढ़ सकती है, इससे पहले कि वह अब तक मिले मिलानों के साथ जवाब दे और search.complete: false, मिलीसेकंड में (50 से 60000, डिफ़ॉल्ट 1000)। पढ़ते समय खोज अन्य अनुरोधों को रोकती है, इसलिए यह उनके इंतज़ार की अधिकतम अवधि भी है। साथ ही config.json में storage.searchBudgetMs |
IRIS_SEARCH_INDEX | on (डिफ़ॉल्ट) या off। off ट्रेस का कोई पूर्ण-पाठ इंडेक्स नहीं रखता: लिखने पर ट्रेस और कुछ नहीं सहेजा जाता, और ट्रेस खोज (q) IRIS_SEARCH_BUDGET_MS के भीतर, सबसे नए पहले, स्वयं ट्रेस पढ़ती है; इसलिए बड़े स्टोर पर वह मिलानों के केवल एक हिस्से के साथ जवाब दे सकती है (search.complete: false)। इसे बंद करने पर डेटाबेस में रखा इंडेक्स मिट जाता है; फिर से चालू करने पर पृष्ठभूमि में नया इंडेक्स बनता है। साथ ही config.json में storage.searchIndex |
IRIS_LOG_LEVEL | लॉग स्तर: debug, info, warn, error |
IRIS_DASHBOARD | true/1/yes/on वेब डैशबोर्ड चालू करता है; false/0/no/off इसे बंद करता है (और config.json में dashboard.enabled को भी ओवरराइड करता है) |
IRIS_DASHBOARD_PORT | डैशबोर्ड पोर्ट (1-65535, डिफ़ॉल्ट 6920) |
IRIS_WEBHOOK_URL | किसी क्षण पर सक्रिय होने वाले webhook का प्राप्तकर्ता — config.json में notify.webhook के साथ मर्ज किया जाता है (docs/webhooks.md) |
IRIS_WEBHOOK_SECRET | Webhook की हस्ताक्षर कुंजी (कोई भी स्ट्रिंग, या whsec_ + base64); iris फ़ॉर्मैट इसके बिना चलने से इनकार करता है |
IRIS_DASHBOARD_HOST | डैशबोर्ड बाइंड पता (डिफ़ॉल्ट 127.0.0.1) |
IRIS_API_KEY | HTTP प्रमाणीकरण के लिए API कुंजी। HTTP ट्रांसपोर्ट या डैशबोर्ड को loopback से आगे बाइंड करने के लिए आवश्यक (0.0.0.0, LAN पता, कंटेनर): इसके बिना सर्वर शुरू होने से इनकार करता है |
IRIS_API_KEY_FILE | ऐसी फ़ाइल का पथ जिसकी ट्रिम की गई सामग्री API कुंजी हो — Docker और Kubernetes द्वारा माउंट किया जाने वाला secret-file पैटर्न, ताकि कुंजी environment block में न रहे। इनमें से एक सेट करें, IRIS_API_KEY या यह; दोनों नहीं |
IRIS_ALLOW_UNAUTHENTICATED | जानबूझकर बिना कुंजी के non-loopback bind चलाने के लिए 1 पर सेट करें (इनकार हटाता है; तब नेटवर्क ही आपकी सुरक्षा सीमा है) |
IRIS_ALLOWED_ORIGINS | कॉमा से अलग की गई origin allowlist। डैशबोर्ड: CORS हेडर (globs समर्थित, जैसे http://localhost:*)। HTTP ट्रांसपोर्ट: DNS-rebinding सुरक्षा के लिए सटीक-मिलान वाली Origin allowlist (globs अनदेखे किए जाते हैं; सर्वर के अपने loopback origins हमेशा अनुमत हैं) |
IRIS_MAX_INPUT_ELEMENTS | सत्यापन से पहले किसी इनपुट में अधिकतम array elements और object keys की संख्या (पूर्णांक, डिफ़ॉल्ट 100000): हर ट्रांसपोर्ट पर tool call के arguments, और डैशबोर्ड पोर्ट पर request body (API के JSON bodies और POST /v1/traces, JSON या protobuf)। सीमा से अधिक tool call को error result मिलता है; body को 413। डिफ़ॉल्ट सीमा हर वैध JSON इनपुट को स्वीकार करती है, यहाँ तक कि 1 MB की पूरी request भरने वाले इनपुट को भी। POST /v1/traces पर protobuf body की अपनी सीमा है: security.requestSizeLimit के हर 5 bytes पर एक element (1 MB पर 209,716), या यह सेटिंग यदि इससे अधिक हो; इसलिए request आकार के भीतर exporter का batch उसकी सघनता के कारण अस्वीकार नहीं होता (मापे गए सबसे सघन वास्तविक exporter body में हर 7.5 bytes पर एक element है); collector के बड़े batches के लिए requestSizeLimit बढ़ाने से यह सीमा भी बढ़ती है। साथ ही config.json में security.maxInputElements |
IRIS_MAX_TOOL_INPUT_ELEMENTS | 0.21.0 से पहले का IRIS_MAX_INPUT_ELEMENTS नाम; नया नाम सेट न होने पर पढ़ा जाता है (और इसी तरह config.json में security.maxToolInputElements) |
IRIS_NO_AUTO_LAUNCH | पहली बार चलने पर डैशबोर्ड के अपने-आप खुलने को बंद करने के लिए 1 पर सेट करें |
IRIS_ANTHROPIC_API_KEY | provider=anthropic के साथ evaluate_with_llm_judge + verify_citations के लिए आवश्यक |
IRIS_OPENAI_API_KEY | provider=openai के साथ evaluate_with_llm_judge + verify_citations के लिए आवश्यक |
IRIS_LLM_JUDGE_MAX_COST_USD_PER_EVAL | हर LLM judge call की अधिकतम लागत (डिफ़ॉल्ट 0.25)। max_cost_usd इसे किसी call के लिए कम कर सकता है, बढ़ा नहीं सकता |
IRIS_RELEVANCE_JUDGE_MODEL | कीमत वाला judge model id (जैसे claude-haiku-4-5)। सेट होने पर, उस provider की कुंजी के साथ, answers_the_ask इनपुट वाले हर मूल्यांकन पर इस LLM judge से पूछता है और उसकी प्रासंगिकता संबंधी राय के आधार पर निर्णय लेता है — हर मूल्यांकन पर एक judge call, ऊपर दी गई लागत सीमा और नीचे दी गई दो सीमाओं के भीतर। ऐसे हर मूल्यांकन का इनपुट और आउटपुट उस model के provider (Anthropic या OpenAI) को आपकी कुंजी के माध्यम से भेजा जाता है, और पहले no_pii द्वारा चिह्नित व्यक्तिगत डेटा तथा credentials को बदल दिया जाता है। सेट न होने पर (डिफ़ॉल्ट), answers_the_ask अनुरोध को भाषाई रूप से पढ़कर सलाह देता है, और कुछ भी नहीं भेजा जाता (docs/llm-as-judge.md) |
IRIS_LLM_JUDGE_DAILY_BUDGET_USD | प्रति UTC दिन, प्रति tenant, सभी judge calls मिलाकर अधिकतम खर्च (डिफ़ॉल्ट 1): relevance judge, evaluate_with_llm_judge और verify_citations इसे साझा करते हैं। डेटाबेस में रखा जाता है, इसलिए restart से यह रीसेट नहीं होता। कोई call तभी किया जाता है जब उसकी अधिकतम संभावित लागत शेष सीमा में समा जाए; सीमा पार होने पर answers_the_ask अनुरोध को भाषाई रूप से पढ़ता है (judge.withheld: "daily_budget") और judge tools IRIS_BUDGET_EXCEEDED जवाब देते हैं (एक citation, daily_budget_reached)। 0 हर call रोकता है |
IRIS_RELEVANCE_JUDGE_DAILY_BUDGET_USD | 0.21.0 से पहले का IRIS_LLM_JUDGE_DAILY_BUDGET_USD नाम, जब यह केवल relevance judge को सीमित करता था। नया नाम सेट न होने पर पढ़ा जाता है, और तब यह हर judge call को सीमित करता है; सर्वर स्टार्टअप पर इसकी सूचना देता है |
IRIS_RELEVANCE_JUDGE_MAX_CALLS_PER_REQUEST | एक अनुरोध में relevance judge अधिकतम कितने calls कर सकता है (डिफ़ॉल्ट 20): OTLP batch या evaluate_runs re-score में पहले 20 traces को judge किया जाता है और बाकी को भाषाई रूप से पढ़ा जाता है, judge.withheld: "request_cap" के साथ |
IRIS_RELEVANCE_JUDGE_REDACT | on (डिफ़ॉल्ट): इनपुट और आउटपुट में हर span के no_pii flags (व्यक्तिगत डेटा और credentials) को relevance judge को भेजने से पहले [REDACTED:<kind>#<n>] marker से बदल दिया जाता है। off उन्हें ज्यों का त्यों भेजता है |
IRIS_CITATION_ALLOW_FETCH | verify_citations में outbound HTTP की अनुमति देने के लिए 1 पर सेट करें (डिफ़ॉल्ट रूप से बंद)। Tool argument इसे किसी call के लिए बंद कर सकता है, चालू नहीं |
IRIS_CITATION_DOMAINS | verify_citations के लिए कॉमा से अलग की गई hostname allowlist (suffix match)। Tool argument इसे सीमित कर सकता है, इसमें नए नाम नहीं जोड़ सकता |
IRIS_CITATION_MAX_COST_USD_TOTAL | एक verify_citations call judge calls पर अधिकतम कितना खर्च कर सकता है (डिफ़ॉल्ट 1)। max_cost_usd_total इसे किसी call के लिए कम कर सकता है, बढ़ा नहीं सकता |
IRIS_OTEL_ENDPOINT | इस collector URL पर best-effort OTLP/HTTP JSON trace export चालू करें |
IRIS_OTEL_SERVICE_NAME | OTel export के लिए service.name resource attribute (डिफ़ॉल्ट iris-eval) |
IRIS_OTEL_HEADERS | OTel export के लिए कॉमा से अलग किए गए k=v headers (जैसे authorization=Bearer abc) |
IRIS_OTEL_TIMEOUT_MS | प्रति-export timeout (डिफ़ॉल्ट 15000) |
RATE_LIMIT_SALT | केवल वेबसाइट — iris-eval.com playground rate limit द्वारा रखे गए address hash में salt जोड़ता है; सर्वर इसे कभी नहीं पढ़ता |
सुरक्षा
HTTP ट्रांसपोर्ट का उपयोग करते समय, Iris में ये सुविधाएँ शामिल हैं:
- समय-सुरक्षित तुलना के साथ API कुंजी प्रमाणीकरण (API clients के लिए Bearer;
?key=के माध्यम से डैशबोर्ड में ब्राउज़र साइन-इन) - डिफ़ॉल्ट रूप से CORS केवल localhost तक सीमित
- प्रति client address और मिनट के हिसाब से rate limiting: डैशबोर्ड API के लिए 600 अनुरोध (
security.rateLimit.api) और MCP endpoint के लिए 20 (security.rateLimit.mcp), दोनोंconfig.jsonमें सेट हैं; सीमा से अधिक MCP अनुरोध को ऐसा JSON-RPC error मिलता है जिसमें कुंजी का नाम दिया जाता है - Helmet सुरक्षा हेडर
- सभी routes पर Zod इनपुट सत्यापन
- कस्टम eval नियमों के लिए ReDoS-सुरक्षित regex
- हर ट्रांसपोर्ट पर 1MB की एक request आकार सीमा (
security.requestSizeLimit): HTTP जवाब देता है413, stdio JSON-RPC error देता है और session खुला रखता है - इनपुट में array elements और object keys की 100,000 की एक सीमा, सत्यापन से पहले गिनी जाती है (
security.maxInputElements): हर ट्रांसपोर्ट पर tool call के arguments सीमा से अधिक होने पर error result देते हैं, और डैशबोर्ड या OTLP request body को413 - सत्यापन त्रुटियों में अधिकतम 20 समस्याएँ और कुल संख्या लौटाई जाती है (
issueCount), ताकि अनुरोध कितना भी गलत हो, जवाब छोटा रहे
# Production deployment
iris-eval --transport http --port 3000 --api-key "$(openssl rand -hex 32)" --dashboard
कुंजी सेट होने पर, API clients — MCP clients, capture SDKs, POST /api/v1/traces — Authorization: Bearer <key> भेजते हैं। ब्राउज़र में डैशबोर्ड खोलने के लिए, किसी भी dashboard URL में एक बार कुंजी जोड़ें, http://localhost:6920/?key=<api key>: Iris इसे HttpOnly, SameSite=Lax session cookie में बदलता है और उसी पृष्ठ पर वापस भेजता है, जिसमें address bar से कुंजी हटा दी जाती है। बिना session के खोले गए पृष्ठ पर साइन-इन फ़ॉर्म दिखता है, जो यही बदलाव करता है। कुंजी ब्राउज़र में कभी सहेजी नहीं जाती, और sessions केवल सर्वर प्रक्रिया में रहते हैं (एक समय में अधिकतम 256 सक्रिय; यदि साइन-इन के समय सभी सक्रिय हों, तो किसी एक को हटाने के बजाय साइन-इन अस्वीकार कर दिया जाता है)।
प्रोडक्शन
कई कुंजियाँ, और बिना रुकावट रोटेशन। config.json में security.apiKeys किसी भी संख्या में अतिरिक्त कुंजियाँ रखता है; हर कुंजी के लिए एक id और इनमें से ठीक एक आवश्यक है: keyFile (ऐसी फ़ाइल जिसकी ट्रिम की गई सामग्री कुंजी हो) या keyHash (कुंजी का sha256 hex, ताकि config फ़ाइल में कोई secret न रहे — printf %s "$KEY" | openssl dgst -sha256); साथ ही वैकल्पिक expiresAt (ISO 8601), जिसके बाद वह उसी क्षण मिलान करना बंद कर देती है। रोटेट करने के लिए: नई कुंजी जोड़ें, अपने clients को उस पर ले जाएँ, पुरानी कुंजी हटाएँ। config.json और key files में मौजूद कुंजियाँ बिना restart के प्रभावी होती हैं (0.20.0): हर अनुरोध पर सर्वर जाँचता है कि config.json या उसके द्वारा बताई गई कोई key file बदली है या नहीं; बदली होने पर जवाब देने से पहले कुंजियाँ फिर पढ़ी जाती हैं। security.apiKeys से कुंजी हटाने या उसकी key file मिटाने पर, अगले अनुरोध पर वह रद्द हो जाती है: वह अनुरोध अस्वीकार किया जाता है और उससे खोले गए सभी browser sessions साइन आउट हो जाते हैं। ऐसी config.json फ़ाइल जिसे पढ़ा न जा सके (उदाहरण के लिए, आधी लिखी हुई) पर सुरक्षा के लिए पहुँच बंद कर दी जाती है; ठीक किए जाने तक केवल IRIS_API_KEY या --api-key की कुंजी स्वीकार की जाती है। IRIS_API_KEY या --api-key में मौजूद कुंजी स्वयं, और प्रमाणीकरण चालू है या नहीं, अब भी केवल restart पर बदलते हैं। हर कुंजी तब तक प्रमाणीकरण करती है जब तक उसे हटाया या उसकी अवधि समाप्त नहीं की जाती — Bearer पथ और browser sign-in, दोनों पर; स्टार्टअप लॉग में ids दिए जाते हैं। security.rateLimit.mcpKeyBy: "apiKey" MCP endpoint का प्रति-मिनट बजट client address के बजाय प्रति कुंजी गिनता है, ताकि एक ही address के पीछे कई agents को हर मिनट अपना अलग बजट मिले।
कई clients। --transport http एक ही address पर कितने भी MCP clients को सेवा देता है: हर initialize एक ही engine और store पर अपना अलग session खोलता है, एक समय में अधिकतम 256। stdio पर हर client अपनी server प्रक्रिया शुरू करता है, और वे प्रक्रियाएँ Iris home साझा करती हैं: एक के माध्यम से deploy, बंद या हटाया गया नियम 20 ms के भीतर बाकी सभी पर लागू होता है; एक के माध्यम से लिखे गए label को दूसरे भी उतनी ही जल्दी पढ़ लेते हैं; और एक ही समय पर नियम बदलने पर दोनों बदलाव सुरक्षित रहते हैं।
Iris शुरू होने से इनकार करता है जब HTTP transport या dashboard loopback से बाहर — 0.0.0.0, LAN address, container — बिना API key के bind होता है, और एक वाक्य में IRIS_API_KEY का नाम लेकर ऐसा कहता है। इसमें image का bare docker run भी शामिल है, जो container के अंदर 0.0.0.0 को bind करता है, क्योंकि प्रकाशित port के ज़रिए loopback तक पहुँचना संभव नहीं है। बिना key के loopback काम करता रहता है (HTTP transport पर चेतावनी के साथ): वहाँ मशीन की सीमा ही exposure control है।
# The image: pass a key
docker run -p 3000:3000 -p 6920:6920 -v iris-data:/data \
  -e IRIS_API_KEY="$(openssl rand -hex 32)" ghcr.io/iris-eval/mcp-server

# Compose: the file requires the variable and refuses before the container starts
IRIS_API_KEY="$(openssl rand -hex 32)" docker compose up

# A network you have already fenced some other way: run open, on purpose
IRIS_ALLOW_UNAUTHENTICATED=1 iris-eval --transport http --dashboard
डिज़ाइन के अनुसार खुला, key वाले server पर: transport पर GET /health और dashboard पर GET /api/v1/health बिना key और हर rate limit से बाहर जवाब देते हैं, एक ही रूप में: status, version, uptime, SQLite driver, storage के लिए checks, deployed-rules file और migrations (known के विरुद्ध लागू), search index की स्थिति (search: ready, या traces के अनुपात में build कहाँ तक पहुँचा है), और judge key मौजूद है या नहीं — कभी key नहीं, कभी trace नहीं, कभी उनकी संख्या नहीं। status केवल तभी ok होता है जब हर जाँच ऐसी हो; अन्यथा यह HTTP 503 के साथ degraded होता है, जिसे Docker image का अपना HEALTHCHECK पढ़ता है। बाकी हर चीज़ के लिए Authorization: Bearer <key> या browser session चाहिए। हर server पर retention चलता है: retention.days से पुराने traces और evaluations (डिफ़ॉल्ट 30) startup पर, server के जवाब देने लगने के बाद, और हर retention.sweepIntervalHours पर हटाए जाते हैं; छोटे चरणों में, जो किसी request को लंबे समय तक इंतज़ार नहीं करवाते; --self-test इस install की policy दिखाता है, और iris://capabilities / GET /api/v1/capabilities इसे retention के रूप में साथ ले जाते हैं।
Webhook किसी घटना पर सक्रिय होता है (0.16.0): config.json में notify.webhook (या IRIS_WEBHOOK_URL और IRIS_WEBHOOK_SECRET) receiver का नाम बताता है, और जब verdict विफल होता है, critical detection veto करता है, cost असामान्य होती है, किसी rule की fail rate बदलती है, या किसी case का पहली बार दोनों तरीकों से जवाब दिया जाता है, तब Iris एक signed message भेजता है — ids, verdict, rules और संख्याएँ, agent का text कभी नहीं। Standard Webhooks और GitHub, दोनों तरीकों से एक साथ signed; backoff के साथ retry; agent और rule के अनुसार cooldown; evaluation के रास्ते में कभी बाधा नहीं; Slack और Discord के bodies पहले से शामिल। docs/webhooks.md.
डिस्क पर आपका डेटा
Iris जो कुछ भी संग्रहीत करता है, वह आपके Iris home (~/.iris, या IRIS_HOME) के अंतर्गत रहता है। iris.db हर trace का input और output ज्यों का त्यों रखता है — इसमें वह text भी शामिल है जिसे no_pii बाद में flag करता है; जब तक आप न कहें, detection उसे redact नहीं करता: config.json में storage.redact: "critical_spans" हर evaluation का output संग्रहीत करता है, जिसमें critical detector द्वारा flag किए गए spans को [REDACTED:<pattern>] से बदल दिया जाता है (डिफ़ॉल्ट रूप से बंद; evidence offsets फिर भी उस text को index करते हैं जो caller ने देखा था)। storage.synchronous तय करता है कि write डिस्क पर कब पहुँचता है: normal (डिफ़ॉल्ट) हर checkpoint पर write-ahead log को sync करता है, इसलिए Iris crash होने पर कुछ नहीं खोता और file corrupt नहीं हो सकती, लेकिन power cut या operating-system crash से आखिरी sync के बाद के writes वापस हो सकते हैं; full हर commit को sync करता है और दोनों स्थितियों में उन्हें बनाए रखता है, हर write पर लगभग 1.5 ms अतिरिक्त लागत के साथ। Startup पर, और उसके बाद हर retention.sweepIntervalHours पर (डिफ़ॉल्ट 24; 0 timer बंद करता है), retention.days से पुराने traces और evaluations (डिफ़ॉल्ट 30; 0 इसे बंद करता है; config.json में सेट करें) हटाए जाते हैं और write-ahead log को checkpoint किया जाता है। एक चीज़ इस अवधि के बाद भी रखी जाती है: pinned baseline run और उसकी evaluations, क्योंकि हर बाद के run की तुलना उसी से होती है। हर sweep जो उसका कुछ हिस्सा रखता है, log में run और counts के साथ इसकी जानकारी देता है; run को unpin करें और अगला sweep उसे हटा देगा। Dataset cases और labels, traces या evaluations नहीं हैं और sweep में नहीं हटाए जाते। किसी trace को हटाने पर — delete_trace से या sweep द्वारा — उससे जुड़ी हर evaluation का text मिट जाता है (output, expected text और rule messages) और erased_at stamp किया जाता है; verdict, scores और evidence offsets बने रहते हैं। हर delete लौटने से पहले write-ahead log को checkpoint करता है, इसलिए हटाया गया text iris.db या iris.db-wal में पढ़ने योग्य नहीं रहता (यदि उस समय कोई search file पढ़ रहा हो, या कोई दूसरी process उसे पढ़ या लिख रही हो, तो delete इंतज़ार किए बिना लौटता है और काम पूरा होते ही text file से हट जाता है)। अभी सब कुछ हटाने के लिए, server रोकें और --purge चलाएँ: यह हर संग्रहीत trace, span और evaluation हटाता है, database को compact करता है और write-ahead log को truncate करता है ताकि text डिस्क से मिट जाए; आपके deployed rules, audit log और preferences बने रहते हैं। किसी release द्वारा मौजूदा iris.db पर migration लागू करने से पहले, वह file की एक copy उसके बगल में बनाता है (iris.db.<from>-to-<to>.<time>.bak, केवल owner के लिए; सबसे नई तीन copies रखी जाती हैं; Downgrading): copy में traces उनकी पुरानी स्थिति में होते हैं, इसलिए retention sweep retention.days से पुरानी copy को हटाता है और --purge उन्हें सबको हटा देता है। Server अपने client को जवाब देने के बाद, अलग thread पर copy और migrations करता है: इस दौरान आने वाले tool calls, resource reads और HTTP requests उनके लिए इंतज़ार करते हैं, हर एक अधिकतम 30 s तक, फिर एक वाक्य के साथ अस्वीकार कर दिए जाते हैं जो बताता है कि server क्या कर रहा है (IRIS_STORAGE_ERROR, retryable; HTTP 503 के साथ Retry-After)। Health पूरे समय जवाब देता है और बताता है कि upgrade में क्या हो रहा है। 0.19.0 से, 100,000 traces पर, जिनमें हर trace एक agent loop है, copy और migrations में लगभग 6 s लगे। iris-eval ingest, --purge और --self-test अब भी कुछ और करने से पहले upgrade करते हैं।
Iris अपने डेटा को at rest encrypt नहीं करता। iris.db और उसकी write-ahead-log files केवल owner के लिए बनाई जाती हैं (mode 600), और Iris home directory mode 700 में बनाई जाती है (Windows पर, इसके बजाय file ACLs लागू होते हैं)। Database में LLM provider keys संग्रहीत नहीं होतीं: IRIS_ANTHROPIC_API_KEY और IRIS_OPENAI_API_KEY environment से पढ़े जाते हैं और कभी डिस्क पर नहीं लिखे जाते। इसमें trace inputs और outputs ज्यों के त्यों संग्रहीत होते हैं, इसलिए Iris home को encrypted disk या volume पर रखें (FileVault, BitLocker, LUKS, या Docker image के /data mount के लिए encrypted cloud volume)।
Export — dashboard के Traces और Evaluations pages पर Export button, GET /api/v1/traces/export और /api/v1/evaluations/export, या iris-eval export — इस संग्रहीत text को उसी रूप में ले जाता है, जैसा dashboard दिखाता है: trace input और output ज्यों के त्यों, evaluation output पर storage.redact लागू। Export की गई file को उसी database की तरह संभालें जिससे वह आई है।
समस्या निवारण
पहला कदम: self-test चलाएँ
npx @iris-eval/mcp-server --self-test
यह एक अलग-थलग temp home में storage, deterministic evals और dashboard की जाँच करता है और हर चरण का verdict दिखाता है — failure output में खराब चरण का नाम होता है। Exit code 0 का अर्थ है कि install स्वस्थ है।
Iris शुरू नहीं होगा / ERR_MODULE_NOT_FOUND
हो सकता है आपके पास पुराना cached version हो। npx cache साफ़ करें और फिर कोशिश करें:
npx --yes @iris-eval/mcp-server@latest
या cache की समस्याओं से पूरी तरह बचने के लिए globally install करें:
npm install -g @iris-eval/mcp-server@latest
npm install --ignore-scripts ने SQLite binding तोड़ दी
Iris traces को better-sqlite3 के साथ संग्रहीत करता है, जो एक native module है और install script में अपनी binding डाउनलोड या compile करता है। यदि वह script छोड़ दी गई हो — command line पर --ignore-scripts, किसी .npmrc में ignore-scripts=true (corporate machines पर आम), या ऐसा registry mirror जो postinstall हटा देता हो — तो startup एक लंबा "Could not locate the bindings file" dump दिखाते हुए विफल होता है, जिसमें आज़माए गए दर्जन भर paths सूचीबद्ध होते हैं। केवल उस module को rebuild करें:
npm rebuild better-sqlite3
# for a global install:
npm rebuild -g better-sqlite3
Claude Code में tools नहीं दिख रहे
MCP tools केवल session शुरू होने पर load होते हैं। iris-eval जोड़ने के बाद, /clear से session restart करें या terminal फिर से खोलें।
Version जाँच
npx @iris-eval/mcp-server --version
पहली startup log line में भी यह होता है (Starting Iris MCP server vX.Y.Z), और --self-test इसे अपने summary में दिखाता है। Global install के लिए, npm ls -g @iris-eval/mcp-server installed version दिखाता है।
Updating
किसी मशीन पर हर MCP client एक ही database, ~/.iris/iris.db, साझा करता है, और install हर client को उस release पर pin करता है जिसने उसका config लिखा था। जब कोई release database का schema बदलता है, तो उस release की पहली process जो file खोलती है, उसे upgrade करती है; उसके बाद पुराने release पर pinned client शुरू होने से इनकार करता है। इसलिए upgrade करने से पहले या तुरंत बाद, सभी clients को एक ही चरण में बदलें:
npx -y @iris-eval/mcp-server@latest install --upgrade
यह इस मशीन पर हर उस client config को ढूँढ़ता है जो Iris चलाता है, और हर client का pin उस release पर ले जाता है (entry में जोड़ी गई चीज़ें, जैसे --dashboard या env block, बनाए रखते हुए); नए release पर pin और npm package के अलावा कुछ और चलाने वाली entry को नहीं बदलता, और किए गए बदलावों की सूची देता है। जिन clients के नाम यह दिखाए, उन्हें restart करें। install --list दिखाता है कि हर client कौन-सा Iris चलाता है।
दो installs इन files के बाहर रहते हैं: Claude Desktop extension (iris-eval.mcpb) तब बदलता है जब आप नया bundle खोलते हैं, और Claude Code plugins में पहले claude plugin marketplace update iris-eval, फिर claude plugin update iris-eval@iris-eval (और capture plugin के लिए claude plugin update iris-eval-capture@iris-eval)।
0.19.x से 0.20.0 पर upgrade करना। 0.20.0 database में search index और अन्य additions जोड़ता है (migrations 015 और उसके बाद)। जैसे ही कोई 0.20.0 process ~/.iris/iris.db खोलती है (Claude Desktop extension, npx iris-eval, या बिना version वाला npx @iris-eval/mcp-server), 0.19.x पर pinned client This database was migrated by a newer Iris (…) — migration(s) 015-trace-search, … are unknown to v0.19.0. Upgrade Iris, … के साथ रुक जाता है। यह message 0.19.x से आता है और इसे बदला नहीं जा सकता; इसका समाधान ऊपर दिया गया command है। Upgrade से पहले, 0.20.0 file की एक copy उसके बगल में बनाता है, इसलिए वापस जाना भी संभव है (नीचे देखें)।
Database को upgrade करने वाला start stderr पर किए गए काम की जानकारी देता है: बनाई गई copy, वे पुराने releases जो अब file नहीं खोल सकते, और इस मशीन पर उन releases में से किसी एक पर pinned client, साथ में command। --self-test database को बिना बदले पढ़ता है और कुछ भी शुरू करने से पहले यही जानकारी देता है।
Global install के लिए, npm update -g @iris-eval/mcp-server, फिर iris-eval install --upgrade।
Downgrading
Database को upgrade करने वाला release पहले उसकी copy बनाता है, उसके बगल में: आपके Iris home में iris.db.<from>-to-<to>.<time>.bak (<from> वह release है जिसने आखिरी बार file का schema बदला था, <to> वह जिसने उसे upgrade किया; startup line में सटीक path छपा था)। वापस जाने के लिए:
- हर MCP client और database का उपयोग करने वाली किसी भी अन्य Iris process को रोकें।
- Upgraded file को संभालकर रखें, यदि आप वापस लौटें:
iris.dbका नाम बदलकरiris.db.upgradedकरें, और यदि मौजूद हों तोiris.db-walऔरiris.db-shmहटाएँ। - Backup को
iris.dbपर copy करें:cp ~/.iris/iris.db.0.19.0-to-0.20.0.<time>.bak ~/.iris/iris.db। - हर client को पुराने release पर वापस pin करें: हर एक के लिए
npx -y @iris-eval/mcp-server@0.19.0 install <client>(install --upgradeकिसी client को कभी पीछे नहीं ले जाता)।
Upgrade के बाद संग्रहीत traces iris.db.upgraded में हैं, backup में नहीं। यदि कोई copy नहीं बनाई गई (startup line कारण बताती है, उदाहरण के लिए disk भर जाना), तो पुराना release upgraded file नहीं खोल सकता; आगे बढ़ने का तरीका install --upgrade है।
Storage driver
ऐसे platform पर जहाँ पहले से बना better-sqlite3 उपलब्ध नहीं है, install फिर भी सफल होता है। better-sqlite3 एक optional dependency है: जब npm न तो आपके Node और platform के लिए prebuilt binary डाउनलोड कर सकता है, न ही उसे compile कर सकता है (compile करने के लिए Python और C++ toolchain चाहिए — Windows पर Visual Studio के C++ build tools), तो npm build error दिखाता है, module छोड़ देता है और install पूरा करता है। इसके बाद Iris Node के built-in SQLite पर चलता है और इसकी जानकारी देता है: startup stderr पर कारण बताते हुए एक line दिखाता है, और --self-test में driver node: better-sqlite3 is not installed … दिखता है। Native driver वापस पाने के लिए, उसे वहाँ install करें जहाँ prebuild या toolchain उपलब्ध हो (project में npm install better-sqlite3; global install के लिए, toolchain उपलब्ध होने पर npm install -g @iris-eval/mcp-server के साथ Iris फिर से install करें)। CI हर बदलाव पर native build को विफल करने के लिए बाध्य करके packed server install करता है, और यह आवश्यक करता है कि install पूरा हो तथा self-test built-in पर trace संग्रहीत और पढ़ सके।
Iris सब कुछ एक SQLite फ़ाइल में रखता है, जिसे better-sqlite3 खोलता है — यह एक नेटिव ऐडऑन है, जिसे आपके Node और प्लेटफ़ॉर्म के लिए डाउनलोड या कंपाइल किया जाता है। जब वह मॉड्यूल लोड नहीं हो पाता, तो Iris Node के अंतर्निहित SQLite (node:sqlite, Node 22.13 या बाद का संस्करण) पर चला जाता है और stderr पर एक चेतावनी देता है, इसलिए प्रीबिल्ट न मिलने पर शुरुआत धीमी होती है, बंद नहीं। यह better-sqlite3 के लिए भी उसे लोड करने से पहले यही करता है, जिसे आपकी मशीन पर Node 24.19 या बाद के हेडर के साथ कंपाइल किया गया हो और Node 24.19 से 24.21 पर चलाया गया हो: वहाँ ऐसा बाइनरी पहली बार किसी स्टेटमेंट को मुक्त करते समय पूरी प्रक्रिया को बंद कर देता है (Assertion failed: (env) != nullptr, nodejs/node#65446)। Node 24.22.0 में यह सुधार शामिल है, और Iris वहाँ बाइनरी लोड करता है। npm rebuild better-sqlite3 इसे प्रीबिल्ट बाइनरी से बदल देता है, जो हर संस्करण पर सुरक्षित है। IRIS_SQLITE_DRIVER=node जानबूझकर अंतर्निहित विकल्प चुनता है, जबकि native फ़ॉलबैक को रोकता है। अंतर्निहित विकल्प को एक्सटेंशन लोडिंग बंद रखकर और trusted_schema बंद रखकर खोला जाता है; लोड होने पर Node stderr पर अपनी ExperimentalWarning: SQLite is an experimental feature पंक्ति प्रिंट करता है, और Iris उसे दबाता नहीं है। --self-test और GET /health उपयोग में चल रहे ड्राइवर का नाम बताते हैं; प्रमाण पृष्ठ पर हर संख्या नेटिव ड्राइवर पर मापी गई थी, और CI में टेस्ट सूट दोनों पर चलता है।
Node.js संस्करण
Iris के लिए Node.js 22.13 या बाद का संस्करण आवश्यक है। Node 20 का समर्थन-जीवनकाल 2026-04-30 को समाप्त हो गया और यह समर्थित नहीं है; Node 18 का समर्थन अप्रैल 2025 में समाप्त हुआ।
न्यूनतम संस्करण 22.0 के बजाय 22.13 है, क्योंकि 22.13.0 पहला रिलीज़ है जिसमें node:sqlite शामिल है। इससे यह पहला ऐसा संस्करण बनता है जिसमें हर समर्थित Iris इंस्टॉल के पास स्टोरेज का दूसरा ड्राइवर होता है: जब नेटिव better-sqlite3 ऐडऑन लोड नहीं हो पाता, तो Iris शुरू होने में विफल होने के बजाय Node के अंतर्निहित SQLite पर चला जाता है। 22.13 से पुराने संस्करणों में — और Node 20 के पूरे जीवनकाल में — केवल एक ही ड्राइवर था, और प्रीबिल्ट न मिलने पर शुरुआत ही नहीं हो पाती थी।
node --version # Must be v22.13.0 or newer
Windows: cmd /c की ज़रूरत नहीं
Claude Code का /doctor npx को cmd /c के साथ रैप करने का सुझाव दे सकता है। इसकी ज़रूरत नहीं है और इससे पाथ पार्स करने में समस्याएँ आती हैं। सीधे npx का उपयोग करें:
# Correct
claude mcp add --transport stdio iris-eval -- npx -y @iris-eval/mcp-server

# Wrong (causes /c to be parsed as a path)
claude mcp add --transport stdio iris-eval -- cmd /c "npx -y @iris-eval/mcp-server"
अगर Iris आपके काम आता है, तो रेपो को स्टार देने पर विचार करें — इससे दूसरों को इसे ढूँढ़ने में मदद मिलती है।

MIT लाइसेंस प्राप्त।