tokensave
आधिकारिकअपने एजेंट को सिमैंटिक कोड इंटेलिजेंस से सुपरचार्ज करें और इस प्रक्रिया में 💰 बचाएं!
Tokensave MCP के साथ आप क्या कर सकते हैं?
- सिमेंटिक कोड खोज — अपने सहायक से अर्थ के आधार पर कोड खोजने के लिए कहें, जैसे एक ही क्वेरी में
login,validateToken, औरAuthServiceमें प्रमाणीकरण लॉजिक ढूँढना। - संपादन से पहले प्रभाव विश्लेषण — किसी भी सिंबल के कॉलर, कैली और पूरे प्रभाव क्षेत्र का पता लगाएँ ताकि बदलने से पहले ठीक-ठीक पता चले कि क्या टूटेगा।
- क्रॉस-ब्रांच कोड तुलना — दो ब्रांचों के बीच कोड ग्राफ़ की तुलना करें ताकि बिना अपना चेकआउट बदले जोड़े, हटाए या बदले गए सिंबल देख सकें।
- स्थायी सत्र मेमोरी —
tokensave_record_decisionऔरtokensave_record_code_areaके साथ डिज़ाइन निर्णय और कोड क्षेत्र सहेजें, फिर भविष्य के सत्रों मेंtokensave_session_recallके माध्यम से उन्हें याद करें। - परमाणु कोड संपादन — बिना regex या शेल-कोटिंग खतरों के, सटीक स्थानों पर अद्वितीय-एंकर स्ट्रिंग प्रतिस्थापन लागू करें या कोड डालें, लिखने के बाद स्वचालित पुनः-अनुक्रमण के साथ।
दस्तावेज़
AI कोडिंग एजेंटों के लिए सिमेंटिक कोड इंटेलिजेंस
कम टोकन • कम टूल कॉल • 100% स्थानीय




tokensave क्यों?
AI कोडिंग एजेंट कोडबेस की खोज में टोकन बर्बाद करते हैं। हर grep, glob, और फ़ाइल पढ़ने में पैसा खर्च होता है। जटिल कार्यों पर, एजेंट कई Explore उप-एजेंट बनाते हैं जो सिर्फ संदर्भ बनाने के लिए सैकड़ों फ़ाइलों को स्कैन करते हैं।
tokensave एजेंटों को एक पूर्व-अनुक्रमित सिमेंटिक ज्ञान ग्राफ देता है। फ़ाइलों को स्कैन करने के बजाय, एजेंट ग्राफ से पूछताछ करता है और तुरंत संरचित उत्तर प्राप्त करता है -- सही प्रतीक, उनके संबंध, और स्रोत कोड, एक ही कॉल में।
यह कैसे काम करता है
┌──────────────────────────────────────────────────────────────┐
│  AI Coding Agent (Claude Code, Codex, Gemini, Cursor, ...)   │
│                                                              │
│  "Implement user authentication"                             │
│        │                                                     │
│        ▼                                                     │
│  ┌─────────────────┐       ┌─────────────────┐               │
│  │  Sub-agent      │ ───── │  Sub-agent      │               │
│  └────────┬────────┘       └─────────┬───────┘               │
└───────────┼──────────────────────────┼───────────────────────┘
            │                          │
            ▼                          ▼
┌──────────────────────────────────────────────────────────────┐
│  tokensave MCP Server                                        │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐           │
│  │   Search    │  │   Callers   │  │   Context   │           │
│  │   "auth"    │  │  "login()"  │  │   for task  │           │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘           │
│         └────────────────┼────────────────┘                  │
│                          ▼                                   │
│              ┌───────────────────────┐                       │
│              │   libSQL Graph DB     │                       │
│              │   • Instant lookups   │                       │
│              │   • FTS5 search       │                       │
│              └───────────────────────┘                       │
└──────────────────────────────────────────────────────────────┘
tokensave के बिना: एजेंट फ़ाइलों को स्कैन करने के लिए grep, glob, और Read का उपयोग करते हैं -- कई API कॉल, उच्च टोकन उपयोग।
tokensave के साथ: एजेंट MCP टूल के माध्यम से ग्राफ से पूछताछ करते हैं -- तत्काल परिणाम, स्थानीय प्रसंस्करण, कम टोकन।
मुख्य विशेषताएं
| स्मार्ट संदर्भ निर्माण | सिमेंटिक खोज | प्रभाव विश्लेषण |
| एक टूल कॉल एजेंट को आवश्यक सब कुछ लौटाता है -- प्रवेश बिंदु, संबंधित प्रतीक, और कोड स्निपेट। | कोड को अर्थ से खोजें, केवल पाठ से नहीं। "authentication" खोजें और login, validateToken, AuthService खोजें। | बदलने से पहले जानें कि वास्तव में क्या टूटता है। कॉलर, कैली, और किसी भी प्रतीक के पूर्ण प्रभाव क्षेत्र का पता लगाएं। |
| 80+ MCP टूल | 50+ भाषाएं | 12+ एजेंट एकीकरण |
| कॉल ग्राफ ट्रैवर्सल से डेड कोड डिटेक्शन, परमाणु संपादन प्रिमिटिव, कोड-स्वास्थ्य मेट्रिक्स, टेस्ट मैपिंग, और जटिलता विश्लेषण तक। | Rust, Go, Java, Python, TypeScript, C, C++, Swift, Svelte, Astro, और WGSL/HLSL/Metal शेडर्स, CUDA/HIP, और Markdown सहित 43 और। तीन स्तर (lite/medium/full) बाइनरी आकार को नियंत्रित करते हैं। | Claude Code, Codex CLI, Gemini CLI, Qwen Code, Kiro, Cursor, OpenCode, Copilot, Cline, Roo Code, Zed, Antigravity, Kilo CLI, Kimi CLI, Mistral Vibe, Grok Build, Factory Droid, OMP, Pi, Plank। |
| मल्टी-ब्रांच इंडेक्सिंग (ऑप्ट-इन) | 100% स्थानीय | हमेशा ताज़ा |
| वैकल्पिक प्रति-शाखा डेटाबेस। अपना चेकआउट बदले बिना क्रॉस-ब्रांच डिफ और खोज। | कोई डेटा आपकी मशीन से बाहर नहीं जाता। कोई API कुंजी नहीं। कोई बाहरी सेवाएं नहीं। सब कुछ स्थानीय libSQL डेटाबेस पर चलता है। | हर MCP कॉल पर ऑन-डिमांड स्टेलनेस जांच (30 सेकंड कूलडाउन) के साथ-साथ सर्वर कनेक्ट होने पर कैच-अप सिंक। मल्टी-एजेंट कार्य git worktrees का उपयोग करने की उम्मीद है -- प्रत्येक एजेंट को अपना चेकआउट मिलता है और इंडेक्स विचलन git द्वारा मर्ज किए जाते हैं, फ़ाइल वॉचर द्वारा नहीं। |
| सबप्रोसेस-पृथक निष्कर्षण | कोड-स्वास्थ्य विश्लेषण | परमाणु संपादन प्रिमिटिव |
| किसी भी tree-sitter व्याकरण में मूल क्रैश (abort, segfault, कुछ भी) केवल वर्कर को मारता है; पूल इसे फिर से शुरू करता है और सिंक जारी रहता है। सिंक कभी भी दोषपूर्ण फ़ाइल पर नहीं मरता। | समग्र स्वास्थ्य स्कोर (0-10000), Gini असमानता, फ़ाइल-DAG गहराई, डिज़ाइन-संरचना मैट्रिक्स, जोखिम-भारित टेस्ट अंतराल, और सत्र डेल्टा। | regex या शेल-कोटिंग खतरों के बिना फ़ाइलें संपादित करें: अद्वितीय-एंकर str_replace, परमाणु मल्टी-रिप्लेस, AST-रीराइट, एंकर इंसर्ट। लिखने के बाद स्वचालित रूप से फिर से इंडेक्स करता है। |
त्वरित प्रारंभ
1. इंस्टॉल करें
Homebrew (macOS):
brew install aovestdipaperino/tap/tokensave
Scoop (Windows):
scoop bucket add tokensave https://github.com/aovestdipaperino/scoop-bucket
scoop install tokensave
Cargo / cargo-binstall (किसी भी प्लेटफॉर्म):
# Fast install prebuilt binary without compiling:
cargo binstall tokensave

# Or compile from source:
cargo install tokensave                          # full (50+ languages, default)
cargo install tokensave --features medium        # medium tier
cargo install tokensave --no-default-features    # lite (smallest binary)
पूर्व-निर्मित बाइनरी (Linux, Windows, macOS):
नवीनतम रिलीज़ से डाउनलोड करें और बाइनरी को अपने PATH में रखें।
| प्लेटफॉर्म | संग्रह |
|---|---|
| macOS (Apple Silicon) | tokensave-vX.Y.Z-aarch64-macos.tar.gz |
| Linux (x86_64) | tokensave-vX.Y.Z-x86_64-linux.tar.gz |
| Linux (ARM64) | tokensave-vX.Y.Z-aarch64-linux.tar.gz |
| Windows (x86_64) | tokensave-vX.Y.Z-x86_64-windows.zip |
2. अपने एजेंट को कॉन्फ़िगर करें
tokensave install                         # auto-detects installed agents
tokensave install --agent antigravity     # Google Antigravity (formerly Windsurf)
tokensave install --agent auggie          # AugmentCode
tokensave install --agent claude          # Claude Code
tokensave install --agent cline           # Cline
tokensave install --agent codex           # OpenAI Codex CLI
tokensave install --agent copilot         # GitHub Copilot
tokensave install --agent cursor          # Cursor
tokensave install --agent droid           # Factory Droid
tokensave install --agent gemini          # Gemini CLI
tokensave install --agent kilo            # Kilo CLI
tokensave install --agent kiro            # AWS Kiro
tokensave install --agent kimi            # Moonshot Kimi CLI
tokensave install --agent omp             # Oh My Pi (OMP)
tokensave install --agent opencode        # OpenCode
tokensave install --agent pi              # Pi (pi.dev)
tokensave install --agent plank           # Plank (macOS only)
tokensave install --agent qwen            # Qwen Code
tokensave install --agent roo-code        # Roo Code
tokensave install --agent vibe            # Mistral Vibe
tokensave install --agent zed             # Zed
tokensave install --agent grok            # Grok Build (xAI)
tokensave install --git-hook yes           # auto-install the global post-commit and post-checkout hooks (no prompt)
tokensave install --git-hook no            # skip the post-commit and post-checkout hooks (no prompt)
tokensave githooks                         # show which global git hooks tokensave owns
tokensave githooks off                     # remove them, leaving any hook content you wrote
प्रत्येक एजेंट को मूल कॉन्फ़िग प्रारूप में अपना MCP सर्वर पंजीकृत मिलता है। Claude Code को अतिरिक्त रूप से एक PreToolUse हुक (बेकार Explore एजेंटों को ब्लॉक करता है), एक UserPromptSubmit हुक, एक Stop हुक, CLAUDE.md में प्रॉम्प्ट नियम, और स्वचालित-अनुमत टूल अनुमतियां मिलती हैं। Kiro को वैश्विक MCP कॉन्फ़िग, संसाधन के रूप में लोड किया गया tokensave.md स्टीयरिंग, और अनुमेय अंतर्निहित/tokensave टूल अनुमोदन, प्रतिनिधिमंडल गार्डरेल हुक, और पोस्ट-राइट सिंक के साथ एक tokensave-प्रबंधित डिफ़ॉल्ट एजेंट मिलता है; उपयोगकर्ता-प्रबंधित Kiro एजेंट संरक्षित हैं।
वैश्विक OMP इंस्टॉल बेयर omp config path द्वारा रिपोर्ट किए गए प्रोफ़ाइल को लक्षित करते हैं, <resolved-agent-dir>/mcp.json और <resolved-agent-dir>/rules/tokensave.md लिखते हैं। नामित प्रोफ़ाइल में इंस्टॉल करते समय OMP_PROFILE या OMP के संगत PI_PROFILE निर्यात करें; OMP का रिज़ॉल्वर भी PI_CONFIG_DIR और PI_CODING_AGENT_DIR का सम्मान करता है। Tokensave OMP की प्रोफ़ाइल तर्क को दोहराने के बजाय उस मूल रिज़ॉल्वर पर भरोसा करता है। Tokensave OMP के लिए MCP और सलाहकार नियम स्थापित करता है; यह OMP हुक प्रवर्तन स्थापित नहीं करता है।
सभी परिवर्तन idempotent हैं -- अपग्रेड के बाद फिर से चलाना सुरक्षित है। एजेंट सेटअप के बाद, आपको वैश्विक git post-commit और post-checkout हुक की पेशकश की जाएगी। tokensave uninstall एजेंट एकीकरण के साथ उन हुकों को हटा देता है; उन्हें छोड़ने के लिए --keep-git-hooks पास करें, या उन्हें tokensave githooks के साथ स्वयं प्रबंधित करें।
एक साथ कई एजेंटों के लिए इंस्टॉल करें
एक ही रन में कई एजेंटों को इंस्टॉल करने के लिए --agent दोहराएं। अनुमति अनुदान, git-हुक पेशकश, और वैश्विक कॉन्फ़िग लेखन प्रत्येक एक बार होता है, चाहे आप कितने भी एजेंट सूचीबद्ध करें:
tokensave install --agent claude --agent cursor --agent droid
प्रोजेक्ट-स्थानीय इंस्टॉल
डिफ़ॉल्ट रूप से tokensave install MCP सर्वर को आपके वैश्विक एजेंट कॉन्फ़िग में पंजीकृत करता है (जैसे ~/.claude.json)। केवल वर्तमान प्रोजेक्ट के लिए tokensave पंजीकृत करने के लिए, --local जोड़ें:
tokensave install --local --agent claude
tokensave install --local --agent omp
यह प्रोजेक्ट-स्कोप्ड कॉन्फ़िग लिखता है जिसे आप कमिट कर सकते हैं और अपनी टीम के साथ साझा कर सकते हैं। Claude के लिए वह ./.mcp.json, ./.claude/settings.json, और ./CLAUDE.md है; OMP OMP CLI को लागू किए बिना ./.omp/mcp.json और ./.omp/rules/tokensave.md का उपयोग करता है। समर्थित एजेंट: claude, cursor, droid, gemini, zed, opencode, roo-code, kiro, auggie, omp, plank (प्रत्येक अपनी प्रोजेक्ट फ़ाइल लिखता है, जैसे plank के लिए .cursor/mcp.json, .factory/mcp.json, .gemini/settings.json, .zed/settings.json, opencode.json, .roo/mcp.json, .kiro/settings/mcp.json, .augment/settings.json, .omp/mcp.json, .mcp.json)। अन्य एजेंटों के पास प्रोजेक्ट-स्कोप्ड कॉन्फ़िग नहीं है और --local के साथ त्रुटि रिपोर्ट करते हैं।
tokensave uninstall --local के साथ प्रोजेक्ट-स्थानीय इंस्टॉल हटाएं।
3. अपने प्रोजेक्ट को इंडेक्स करें
cd /path/to/your/project
tokensave init
यह ज्ञान ग्राफ डेटाबेस के साथ एक .tokensave/ निर्देशिका बनाता है। आरंभीकरण और सिंक अलग-अलग कमांड हैं: init प्रति प्रोजेक्ट एक बार का ऑप्ट-इन है, जबकि sync केवल उन प्रोजेक्टों को अपडेट करता है जो पहले से आरंभ किए गए थे। यह वैश्विक git हुक को उन रिपॉजिटरी में चुपचाप डेटाबेस बनाने से रोकता है जिन्हें आप कभी इंडेक्स करने का इरादा नहीं रखते थे। init के बाद, वृद्धिशील रूप से अपडेट करने के लिए tokensave sync का उपयोग करें -- केवल बदली गई फ़ाइलें फिर से इंडेक्स की जाती हैं।
Claude Code के लिए इंस्टॉल क्या लिखता है
MCP सर्वर
{
  "mcpServers": {
    "tokensave": {
      "command": "/path/to/tokensave",
      "args": ["serve"]
    }
  }
}
PreToolUse हुक
हुक tokensave hook-pre-tool-use चलाता है -- एक मूल Rust कमांड (कोई bash या jq आवश्यक नहीं)। यह Agent, Grep, Glob, और Bash टूल कॉल को इंटरसेप्ट करता है: Explore एजेंट सीधे ब्लॉक किए जाते हैं, प्रतीक-आकार की grep/rg/ag इनवोकेशन (सादे पहचानकर्ता, विकल्प, \b-लिपटे नाम) को मिलान tokensave MCP टूल पर पुनर्निर्देशित किया जाता है, और कोड एक्सटेंशन पर पथ-आकार की खोज (Glob, find -name, fd --extension) को tokensave_files पर पुनर्निर्देशित किया जाता है। Regex पैटर्न, git grep, पाइप किए गए कमांड, गैर-कोड एक्सटेंशन, इंडेक्स के बाहर खोज रूट, और find विधेय जो कमांड के व्यवहार को बदलते हैं (-exec, -delete, -mtime) सभी बिना छुए गुजरते हैं; प्रति शेल ऑप्ट आउट करने के लिए TOKENSAVE_DISABLE_GREP_HOOK=1 सेट करें।
फ़िल्टर सबसे-विशिष्ट-पहले पढ़े जाते हैं: एक स्पष्ट type आधिकारिक है, फिर एक स्पष्ट फ़ाइल ग्लोब, फिर खोज पथ। glob: "**/*.md" के साथ एक दस्तावेज़ीकरण खोज जैसे path: "." इसलिए व्यापक पथ पर कोड खोज के रूप में माने जाने के बजाय गुजरती है, जबकि एक कोड-केवल ग्लोब (**/*.rs) गैर-कोड पथ के तहत भी पुनर्निर्देशित करता है। मिश्रित ग्लोब (**/*.{rs,md}) गुजरते हैं, क्योंकि वे दस्तावेज़ीकरण लौटा सकते हैं।
हेडलेस / सबएजेंट डिस्पैच (claude -p)। एक ऑर्केस्ट्रेटिंग सत्र द्वारा भेजी गई चाइल्ड प्रक्रियाएं इसका ~/.claude/settings.json विरासत में लेती हैं, जिसमें यह हुक भी शामिल है। चाइल्ड को कच्ची खोज चलाने देने के लिए, चाइल्ड के वातावरण में TOKENSAVE_DISABLE_GREP_HOOK=1 सेट करें -- मूल बाइनरी इसका सम्मान करता है और हर पथ (Grep, Glob, Bash, Agent) को गुजरने देता है, इसलिए कुंद --settings '{"hooks": {}}' की कोई आवश्यकता नहीं है जो सभी हुक हटा देता है। गार्डरेल स्टेटलेस है: यह कभी भी उद्धरण इतिहास से परामर्श नहीं करता है, इसलिए यह केवल ऊपर वर्णित प्रतीक-आकार की खोजों को पुनर्निर्देशित करता है और अटाइप्ड अनुसंधान फैन-आउट को निर्देशित करता है; सामान्य कमांड अप्रभावित रहते हैं चाहे सत्र इंटरैक्टिव हो या हेडलेस।
CLAUDE.md नियम
~/.claude/CLAUDE.md में निर्देश जोड़ता है जो Claude को Explore एजेंटों या कच्ची फ़ाइल रीड तक पहुंचने से पहले tokensave टूल का उपयोग करने के लिए कहते हैं।
क्रैश-प्रतिरोधी सिंक
Tree-sitter व्याकरण संकलित C/C++ कोड हैं। वे कभी-कभी आंतरिक assertion से टकराते हैं या अन्यथा उन पथों द्वारा प्रक्रिया को समाप्त करते हैं जिन्हें Rust panic हैंडलिंग इंटरसेप्ट नहीं कर सकती। v4.3.0 के अनुसार, प्रत्येक फ़ाइल को एक अल्पकालिक वर्कर सबप्रोसेस के अंदर पार्स किया जाता है: यदि कोई व्याकरण segfault करता है, abort() कॉल करता है, या स्टैक ओवरफ्लो से टकराता है, केवल वर्कर मरता है। पूल इसे फिर से शुरू करता है, अपमानजनक फ़ाइल लॉग और छोड़ दी जाती है, और sync जारी रहता है।
वर्कर एक छिपा हुआ extract-worker सबकमांड है जो 256-बिट प्रति-स्पॉन टोकन के माध्यम से पैरेंट के खिलाफ प्रमाणित होता है, जो TOKENSAVE_WORKER_TOKEN env var और stdin पर प्राप्त पहले 32 बाइट्स दोनों के रूप में आवश्यक है। उपयोगकर्ताओं द्वारा सीधा इनवोकेशन विफल रहता है। डिफ़ॉल्ट रूप से available_parallelism() वर्कर; TOKENSAVE_DISABLE_SUBPROCESS=1 के साथ ऑप्ट आउट करें।
संपादन प्रिमिटिव (tokensave_str_replace, tokensave_insert_at, आदि) अभी भी इन-प्रोसेस चलते हैं: वे एक समय में एक फ़ाइल को लक्षित करते हैं जहां सबप्रोसेस ओवरहेड हावी होगा, और वहां एक एक्सट्रैक्टर क्रैश तुरंत एजेंट को दिखाई देता है।
मल्टी-ब्रांच इंडेक्सिंग (वैकल्पिक)
tokensave वैकल्पिक रूप से प्रति git शाखा एक अलग कोड ग्राफ बनाए रख सकता है। सक्षम होने पर, शाखा स्विच करने से कभी भी पुराने परिणाम नहीं मिलते और उन फ़ाइलों को फिर से इंडेक्स नहीं करता जिन्हें आपने पहले से किसी अन्य शाखा पर पार्स किया था। मल्टी-ब्रांच ट्रैकिंग ऑप्ट-इन है -- इसके बिना, tokensave सभी शाखाओं के लिए एकल डेटाबेस का उपयोग करता है।
यह कैसे काम करता है
जब आप एक शाखा ट्रैक करते हैं, tokensave निकटतम पूर्वज DB की प्रतिलिपि बनाता है और केवल उन फ़ाइलों को सिंक करता है जो भिन्न हैं। इसका मतलब है कि main से एक फीचर शाखा ट्रैक करना लगभग तत्काल है -- यह केवल उन फ़ाइलों को पार्स करता है जिन्हें आपने बदला है।
CLI कमांड
tokensave branch add              # track the current branch
tokensave branch list             # see tracked branches and DB sizes
tokensave branch remove <name>    # stop tracking a branch
tokensave branch removeall        # remove all tracked branches except default
tokensave branch gc               # clean up branches deleted from git
क्रॉस-ब्रांच MCP टूल
तीन MCP टूल आपके चेकआउट को स्विच किए बिना क्रॉस-ब्रांच क्वेरी सक्षम करते हैं:
tokensave_branch_search-- दूसरी शाखा के ग्राफ में प्रतीक खोजेंtokensave_branch_diff-- दो शाखाओं के बीच कोड ग्राफ की तुलना करें: जोड़े गए, हटाए गए, और बदले गए प्रतीक (हस्ताक्षर भिन्न)। फ़ाइल और किंड फ़िल्टर का समर्थन करता है।tokensave_branch_list-- DB आकार, पैरेंट शाखा, और सिंक समय के साथ ट्रैक की गई शाखाओं की सूची बनाएं
शाखा फ़ॉलबैक
जब MCP सर्वर वर्तमान शाखा के लिए डेटाबेस नहीं ढूंढ सकता, यह निकटतम पूर्वज शाखा के DB से सेवा करता है और हर टूल प्रतिक्रिया में एक चेतावनी शामिल करता है जो tokensave branch add चलाने का सुझाव देती है।
स्वचालित शाखा ट्रैकिंग (v7.3.0)
जब मल्टी-ब्रांच मोड बूटस्ट्रैप हो जाता है (पहली मैनुअल tokensave branch add ने ब्रांच मेटाडेटा बनाया), तो नई ब्रांचें स्वचालित रूप से ट्रैक की जा सकती हैं, बजाय पूर्वज DB पर वापस गिरने के। दो स्वतंत्र तंत्र इसे कवर करते हैं; सिंगल-DB मोड वाली परियोजनाएं कभी प्रभावित नहीं होतीं, और कोई भी तंत्र डिफ़ॉल्ट ब्रांच के डेटाबेस को कभी नहीं छूता।
Git हुक (ब्रांच चेकआउट पर)। post-checkout हुक जिसे tokensave install सेट करता है, एक ब्रांच चेकआउट (फ़ाइल चेकआउट के विपरीत) को पहचानता है और पृष्ठभूमि में tokensave branch add चलाता है। जब ब्रांच पहले से ट्रैक की गई हो या डिफ़ॉल्ट ब्रांच हो, तो वह कमांड नो-ऑप होती है, इसलिए ज्ञात ब्रांचों के बीच सामान्य स्विचिंग पर कोई लागत नहीं आती। एक नए git clone और नई git worktree add का प्रारंभिक चेकआउट भी ब्रांच चेकआउट होता है, और यह ऐसी ब्रांच पर उतर सकता है जो डिफ़ॉल्ट नहीं है (git clone -b feature, git worktree add -b feature); वहाँ हुक पहले tokensave init और उसके बाद tokensave branch add चलाता है, इसी क्रम में। पुराने संस्करण द्वारा लिखा गया हुक अपने स्थापित बॉडी को बनाए रखता है — इंस्टॉलर कभी मौजूदा हुक को फिर से नहीं लिखता — इसलिए उन इंस्टॉलों पर एक नए वर्कट्री को अभी भी नीचे auto_track की आवश्यकता होती है, या एक मैनुअल tokensave branch add की।
ओपन-टाइम ऑटो-ट्रैक (ऑप्ट-इन)। जब TokenSave::open चलता है — CLI कमांड या MCP सर्वर स्टार्ट — और सक्रिय ब्रांच अनट्रैक्ड है, तो tokensave निकटतम ट्रैक किए गए पूर्वज के DB को कॉपी करके और उसे ब्रांच मेटाडेटा में दर्ज करके उसे मौके पर ट्रैक कर सकता है। यह auto_track कॉन्फ़िग फ़ील्ड (डिफ़ॉल्ट false) या TOKENSAVE_AUTO_TRACK पर्यावरण चर द्वारा नियंत्रित होता है, जो प्रति-रन कॉन्फ़िग को ओवरराइड करता है (कोई भी मान इसे सक्षम करता है, 0, false, no, off, या खाली को छोड़कर)। कॉपी वही लगभग-तात्कालिक पूर्वज-DB कॉपी है जो एक मैनुअल branch add करता है; उस समय कोई सिंक नहीं चलता — post-commit हुक नई ब्रांच DB को ताज़ा रखता है जैसे आप कमिट करते हैं, या तुरंत रीफ़्रेश करने के लिए tokensave sync चलाएँ। ऑटो-ट्रैकिंग सख्ती से बेस्ट-एफ़र्ट है: कोई भी विफलता चेतावनी के रूप में रिपोर्ट की जाती है और open() सामान्य पूर्वज फ़ॉलबैक के साथ आगे बढ़ता है, इसलिए यह कभी भी टूल कॉल को तोड़ नहीं सकता।
संक्षेप में: हुक स्थापित होने पर, एक नई फ़ीचर ब्रांच चेकआउट करना — जिसमें वह ब्रांच भी शामिल है जिस पर एक नया क्लोन या वर्कट्री शुरू होता है — पारदर्शी रूप से उसे अपना स्वयं का प्रति-ब्रांच ग्राफ़ देता है; auto_track सक्षम होने पर, चेकआउट के बाहर बनाई गई ब्रांच भी पहली बार tokensave उस पर प्रोजेक्ट खोलते समय उठाई जाती है।
पूर्ण गाइड के लिए docs/BRANCHING-USER-GUIDE.md देखें।
क्रॉस-सेशन मेमोरी
तीन MCP टूल निर्णयों और कोड-क्षेत्र संदर्भ को सत्रों के बीच बनाए रखते हैं, जो प्रति-प्रोजेक्ट .tokensave/tokensave.db में संग्रहीत होते हैं।
| टूल | उद्देश्य |
|---|---|
tokensave_record_decision | वैकल्पिक कारण, फ़ाइलों और टैग के साथ डिज़ाइन/आर्किटेक्चर निर्णय सहेजें |
tokensave_record_code_area | उस पथ को चिह्नित करें जिस पर एजेंट ने काम किया है (टच काउंटर + last_touched_at) |
tokensave_session_recall | सहेजे गए निर्णयों पर FTS5 क्वेरी; दो लेखन टूल के साथ जोड़ें |
इनका उपयोग करें ताकि एजेंट को सत्र-दर-सत्र आर्किटेक्चर विकल्पों को फिर से समझाना न पड़े।
सेविंग्स लेज़र
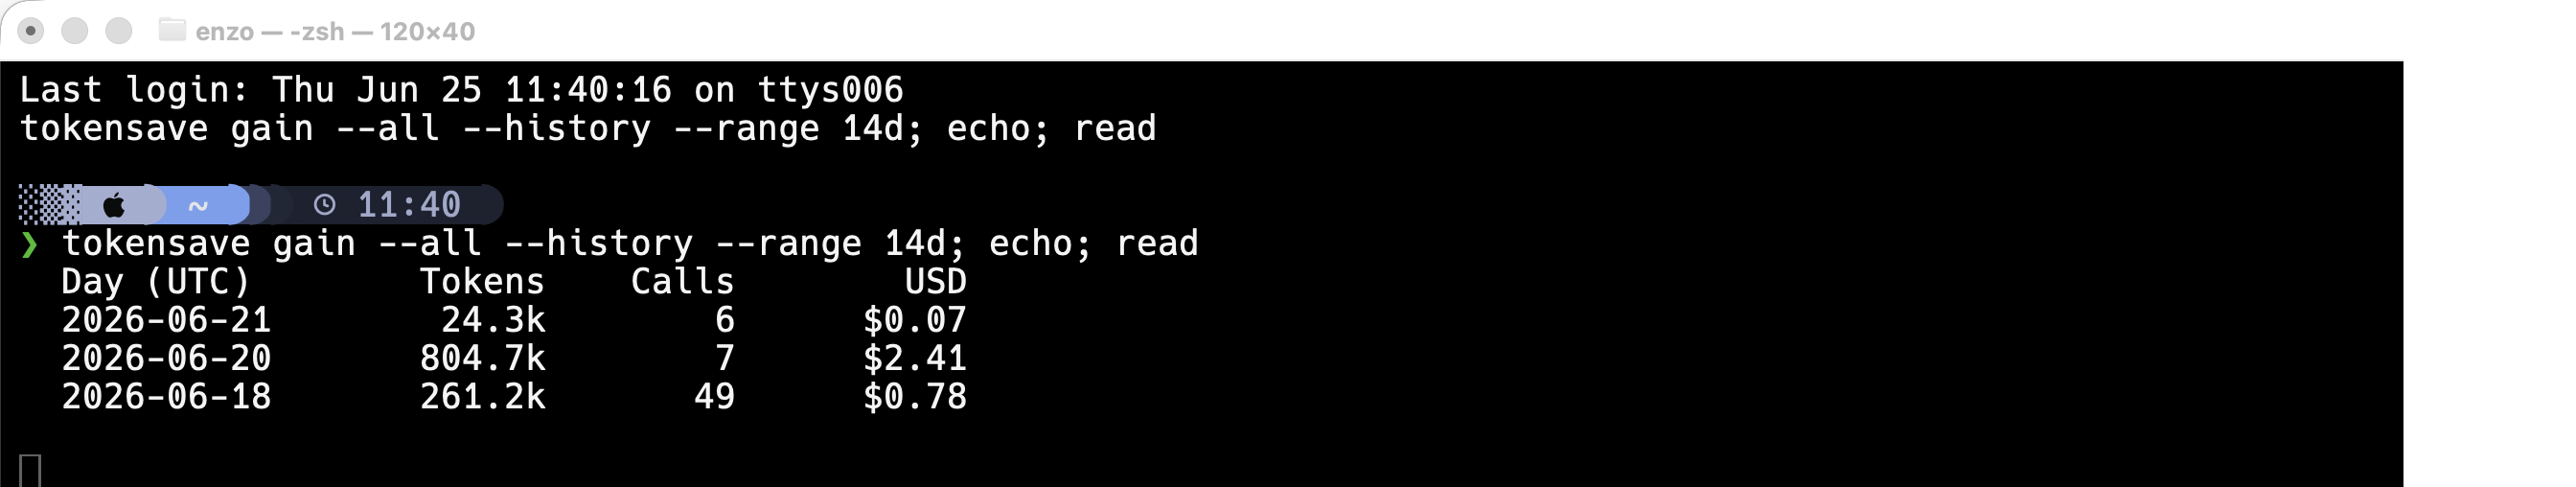
हर MCP कॉल ~/.tokensave/global.db (savings_ledger तालिका) में एक एपेंड-ओनली पंक्ति लिखता है। tokensave gain के साथ निरीक्षण करें:
tokensave gain                    # current project, last 30 days
tokensave gain --all              # all projects
tokensave gain --history --range 7d
tokensave gain --json
डॉलर अनुमान मौजूदा मूल्य निर्धारण मॉड्यूल का उपयोग करते हैं (Sonnet इनपुट मूल्य निर्धारण, LiteLLM के माध्यम से दैनिक रीफ़्रेश)।
प्रतिलिपि योग्य बेंचमार्क
tokensave bench एक निश्चित क्वेरी सेट को tokensave_context के माध्यम से चलाता है और पूर्ण-फ़ाइल बेसलाइन के मुकाबले पुनर्प्राप्ति बचत की रिपोर्ट करता है (CCE पद्धति को दर्शाता है):
tokensave bench                                    # ships with 10 default queries
tokensave bench --queries my-queries.toml --json
tokensave bench --max-nodes 5
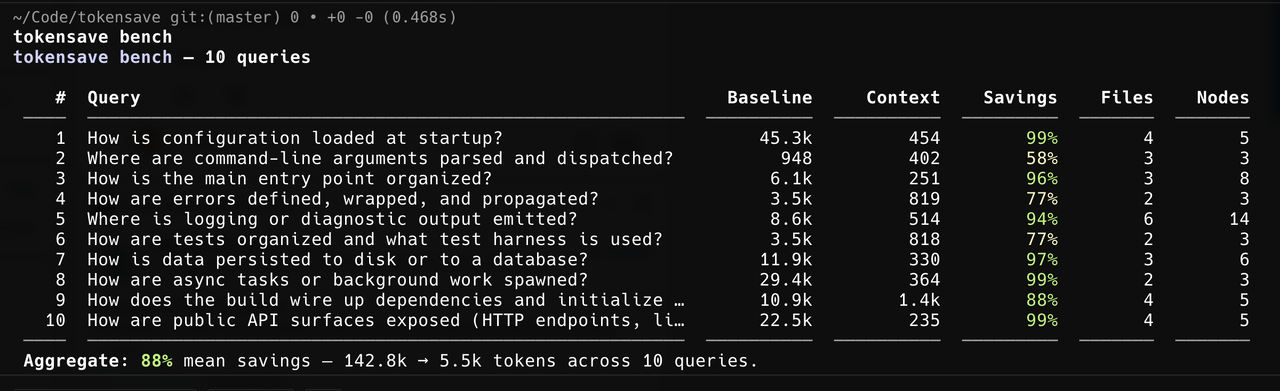
इस रिपॉजिटरी (tokensave स्वयं) के विरुद्ध शिप किए गए सामान्य क्वेरी सेट का उपयोग करके मापा गया:
| # | क्वेरी | बेसलाइन | संदर्भ | बचत | फ़ाइलें | नोड्स |
|---|---|---|---|---|---|---|
| 1 | स्टार्टअप पर कॉन्फ़िगरेशन कैसे लोड होता है? | 45.3k | 454 | 99% | 4 | 5 |
| 2 | कमांड-लाइन तर्क कहाँ पार्स और डिस्पैच किए जाते हैं? | 948 | 402 | 58% | 3 | 3 |
| 3 | मुख्य प्रवेश बिंदु कैसे व्यवस्थित है? | 6.1k | 251 | 96% | 3 | 8 |
| 4 | त्रुटियाँ कैसे परिभाषित, लपेटी और प्रचारित की जाती हैं? | 3.5k | 819 | 77% | 2 | 3 |
| 5 | लॉगिंग या डायग्नोस्टिक आउटपुट कहाँ उत्सर्जित होता है? | 8.6k | 514 | 94% | 6 | 14 |
| 6 | परीक्षण कैसे व्यवस्थित हैं और कौन सा परीक्षण हार्नेस उपयोग किया जाता है? | 3.5k | 818 | 77% | 2 | 3 |
| 7 | डेटा डिस्क या डेटाबेस में कैसे स्थायी होता है? | 11.9k | 330 | 97% | 3 | 6 |
| 8 | एसिंक कार्य या पृष्ठभूमि कार्य कैसे स्पॉन होते हैं? | 29.4k | 364 | 99% | 2 | 3 |
| 9 | बिल्ड निर्भरताओं को कैसे जोड़ता है और स्थिति को आरंभ करता है? | 10.9k | 1.4k | 88% | 4 | 5 |
| 10 | सार्वजनिक API सतहें कैसे उजागर होती हैं (HTTP एंडपॉइंट, लाइब्रेरी निर्यात, या CLI कमांड)? | 22.5k | 235 | 99% | 4 | 5 |
कुल: 88% औसत पुनर्प्राप्ति बचत (10 क्वेरीज़ में 142.8k → 5.5k टोकन)।
डिफ़ॉल्ट क्वेरी सेट अधिकांश एप्लिकेशन कोडबेस (CLI, डेमन, सेवाएँ) में मौजूद पैटर्न को लक्षित करता है। अपने स्वयं के प्रोजेक्ट पर tokensave bench के साथ चलाएँ ताकि अपने नंबर देखें, या कड़े रिकॉल के लिए एक अनुकूलित क्वेरी फ़ाइल (--queries my.toml) लिखें।
बड़े वास्तविक-विश्व रिपॉजिटरीज़ के विरुद्ध Criterion बेंच
benches/large_repos.rs एक criterion माइक्रो-बेंचमार्क है जो MCP टूल को स्थिर refs पर पिन किए गए चार बड़े ओपन-सोर्स कोडबेस के विरुद्ध एंड-टू-एंड चलाता है। प्रत्येक टूल को कम से कम 5 क्वेरीज़ के साथ चलाया जाता है, जिनमें तर्क (नोड आईडी, योग्य नाम, फ़ाइल ग्लोब्स, …) प्रति रिपॉजिटरी एक बार अनुक्रमित ग्राफ़ से नमूना किए जाते हैं, इसलिए समय रनों के बीच प्रतिलिपि योग्य होते हैं।
रिपॉजिटरीज़ और पिन किए गए refs (benches/repos.rs में परिभाषित):
| रिपॉजिटरी | URL | Ref |
|---|---|---|
| polkadot-sdk | https://github.com/paritytech/polkadot-sdk | polkadot-stable2412 |
| emacs | https://github.com/emacs-mirror/emacs | emacs-30.1 |
| scipy | https://github.com/scipy/scipy | v1.14.1 |
| node | https://github.com/nodejs/node | v22.11.0 |
प्रत्येक रिपॉजिटरी पहले उपयोग पर शैलो-क्लोन (git init + git fetch --progress --depth 1 origin <ref> + checkout FETCH_HEAD) होती है और स्थानीय रूप से कैश की जाती है; बाद के रन चेकआउट का पुन: उपयोग करते हैं। Git आउटपुट टर्मिनल पर स्ट्रीम होता है ताकि मल्टी-GB फ़ेच वास्तविक-समय प्रगति दिखाए।
कवर किए गए टूल (प्रत्येक 5 क्वेरीज़)। रीड टूल — search, context, callers, callees, node, by_qualified_name, signature, impact, body, files, complexity, doc_coverage, largest, hotspots, god_class, module_api, derives, dead_code, rank, coupling, circular। राइट टूल — str_replace, multi_str_replace, insert_at, और (यदि ast-grep PATH पर है) ast_grep_rewrite।
हर रन पर फोर्स-सिंक। किसी भी बेंचमार्क के चलने से पहले, हार्नेस प्रत्येक रिपॉजिटरी पर tokensave sync --force के समकक्ष चलाता है (.tokensave/ ताज़गी की परवाह किए बिना index_all()) ताकि समय हमेशा पिन किए गए स्रोत को प्रतिबिंबित करे।
राइट बेंच और सफाई। राइट टूल फ़ाइलों को बदलते हैं। "मैच अद्वितीय होना चाहिए" पूर्वशर्त को बनाए रखने के लिए, हार्नेस criterion के iter_batched का उपयोग करता है — <repo>/.tokensave-bench-scratch/ के अंतर्गत एक छोटी स्क्रैच फ़ाइल हर समयबद्ध पुनरावृत्ति से पहले ज्ञात सामग्री के साथ फिर से लिखी जाती है, फिर संपादन टूल उसके विरुद्ध चलता है। सभी बेंचमार्क समाप्त होने के बाद, हार्नेस प्रत्येक तैयार रिपॉजिटरी के अंदर git stash --include-untracked && git stash drop चलाता है ताकि कार्यशील ट्री पिन किए गए ref पर लौट आए।
Criterion कॉन्फ़िगरेशन। बेंच criterion के डिफ़ॉल्ट को sample_size = 10 और measurement_time = 30s (स्टॉक 100 / 5s के मुकाबले) में ओवरराइड करता है, जो प्रत्येक प्रति-क्वेरी समय को ~30 सेकंड का मापन देता है — इतना कि polkadot-sdk पर tokensave_context जैसे धीमे टूल स्थिर संख्याएँ उत्पन्न करते हैं।
इसे चलाएँ:
# Required: a writable cache directory for the cloned repos + their indexes.

<p align="center">
  <a href="https://ai.enzolombardi.net/"><img src="https://img.shields.io/badge/built%20with-AI-D97757?style=flat-square&labelColor=101010&logo=anthropic&logoColor=white" alt="Built with AI — part of Enzo Lombardi's AI portfolio"></a>
</p>

# Expect several GB of disk and a long first run (shallow clone + full index of each repo).
export TOKENSAVE_BENCH_REPOS_DIR=~/tokensave-bench-cache

cargo bench --bench large_repos
यदि TOKENSAVE_BENCH_REPOS_DIR अनसेट है तो बेंच एक सूचना प्रिंट करता है और शून्य बेंचमार्क पंजीकृत करता है (ताकि cargo bench --all योगदानकर्ताओं की मशीनों पर सस्ता रहे)।
कॉन्फ़िगरेशन (सभी वैकल्पिक, पर्यावरण के माध्यम से):
| चर | प्रभाव |
|---|---|
TOKENSAVE_BENCH_REPOS_DIR | आवश्यक। मूल निर्देशिका जहाँ प्रत्येक रिपॉजिटरी $DIR/<repo-name>/ में क्लोन की जाती है। |
TOKENSAVE_BENCH_REPOS | बेंच करने के लिए रिपॉजिटरी नामों का अल्पविराम-पृथक उपसमुच्चय, जैसे TOKENSAVE_BENCH_REPOS=emacs,scipy। डिफ़ॉल्ट सभी चार हैं। |
TOKENSAVE_BENCH_SKIP_CLONE | यदि सेट है, तो बेंच किसी भी रिपॉजिटरी के लिए तेज़ी से विफल हो जाता है जो पहले से अपने पिन किए गए ref पर नहीं है, बजाय फ़ेच करने के। CI / ऑफ़लाइन रनों में उपयोगी। |
बेंचमार्क फ़िल्टर करना मानक criterion CLI का उपयोग करता है — उदाहरण के लिए, केवल scipy पर search टूल:
cargo bench --bench large_repos -- 'scipy/tokensave_search'
रिपोर्ट (HTML + कच्चे नमूने) target/criterion/ के अंतर्गत आती हैं।
पिन किए गए refs को बदलने के लिए (जैसे नए रिलीज़ या विशिष्ट SHA में), benches/repos.rs में REPOS संपादित करें और संबंधित $TOKENSAVE_BENCH_REPOS_DIR/<repo>/.bench-ref मार्कर हटाएँ ताकि अगला रन फिर से फ़ेच करे। यदि आप पोस्ट-रन सफाई छोड़ देते हैं (जैसे आप बेंच के बीच में Ctrl-C करते हैं), तो प्रत्येक रिपॉजिटरी निर्देशिका के अंदर git stash --include-untracked && git stash drop चलाना इसे मैन्युअल रूप से पुनर्स्थापित करता है।
MCP टेस्ट-मैट्रिक्स प्रोब (scripts/mcp_probe)
scripts/mcp_probe/ एक Python हार्नेस है जो tokensave serve को stdio पर वास्तविक रिपॉजिटरीज़ के कॉन्फ़िगर योग्य सेट के विरुद्ध चलाता है और प्रत्येक भाषा के लिए 5 क्वेरी वेरिएंट के साथ हर रीड-ओनली MCP टूल का अभ्यास करता है, जिससे प्रति-टूल / प्रति-रिपॉजिटरी स्थिति तालिका उत्पन्न होती है। वही हार्नेस दो उद्देश्यों की सेवा करता है:
- प्रतिगमन स्वीप। नई भाषा समर्थन, नया टूल, या रीफैक्टर — मैट्रिक्स को फिर से चलाएँ और कोई भी सेल जो नई त्रुटि करता है, समय समाप्त करता है, या खाली परिणाम लौटाता है, 🚩 के रूप में सामने आता है।
- प्रदर्शन प्रोब। प्रति-कॉल समय TSV में लॉग किया जाता है; रिपॉजिटरीज़ का वही निश्चित कोर्पस क्रॉस-संस्करण तुलना के रूप में दोगुना होता है। वर्तमान
tokensave_inheritance_depthचक्र बग इस हार्नेस द्वारा पाया गया था जब polkadot-sdk पर एक एकल टूल >60 s पर समय समाप्त हो गया।
लेआउट — probe.py ड्राइवर है (id-मिलान JSON-RPC ताकि एक धीमा टूल बाद के कॉलों को जहर न दे), isolated.py प्रति कॉल एक नए सर्वर के साथ एक एकल टूल को फिर से चलाता है (सर्वर कतार से बचता है), build_matrix.py TSV पढ़ता है और मार्कडाउन उत्सर्जित करता है, tools/<lang>.py मॉड्यूल प्रति-भाषा क्वेरी सेट में योगदान करते हैं (Rust शिप किया गया; एक नया मॉड्यूल छोड़ कर Python/Go/… जोड़ें), repos.toml लक्षित रिपॉजिटरीज़ सूचीबद्ध करता है ($TOKENSAVE_PROBE_REPOS के माध्यम से ओवरराइड करें)।
त्वरित रन:
cargo build --release --bin tokensave
python3 scripts/mcp_probe/probe.py
python3 scripts/mcp_probe/build_matrix.py > matrix.md
आउटपुट सेल ✓ 5/5 (स्वच्छ), 🐛 e/N (त्रुटियाँ), ⏱ N/N (समय समाप्त), ∅ E/N (खाली), 🐢 ok/slow (>10 s कॉल) हैं। त्रुटि या समय समाप्ति वाला कोई भी सेल सबसे दाएँ कॉलम में 🚩 अर्जित करता है। प्रति-कॉल विवरण प्रत्येक त्रुटि के पहले 100 वर्णों के साथ TSV लॉग में आता है।
ऊपर दिए गए criterion बेंच से अलग: criterion पिन किए गए refs पर केंद्रित टूल सेट के लिए प्रति-पुनरावृत्ति विलंबता मापता है और target/criterion/ के अंतर्गत सांख्यिकीय रिपोर्ट उत्पन्न करता है; mcp_probe व्यापक क्वेरी सेट के साथ हर टूल का अभ्यास करता है, जिस पर आप इसे इंगित करते हैं, मापन सटीकता के बजाय कवरेज की चौड़ाई के लिए अनुकूलन करता है।
80+ MCP टूल
सर्वर 80 से अधिक टूल उजागर करता है (एक कम जब वैकल्पिक ast-grep बाइनरी PATH पर नहीं है)। 7.14.0 से केवल 11 कोर टूल प्लस tokensave_more डिफ़ॉल्ट रूप से सूचीबद्ध हैं; बाकी tokensave_more के माध्यम से मांग पर सूचीबद्ध होते हैं, नाम से कॉल करने योग्य रहते हैं, और सभी "tools": "full" के साथ सूचीबद्ध होते हैं। नीचे दी गई तालिकाएँ श्रेणी के अनुसार सबसे सामान्य रूप से उपयोग किए जाने वाले टूल को समूहित करती हैं। अधिकांश रीड-ओनली हैं, समानांतर में कॉल करने के लिए सुरक्षित हैं, और readOnlyHint के साथ एनोटेट हैं। संपादन प्राइमिटिव एकल फ़ाइलों तक सीमित हैं और स्थान पर पुन: अनुक्रमित होते हैं; सत्र बेसलाइन और मेमोरी-रिकॉर्डिंग टूल भी स्थानीय .tokensave स्थिति को बदलते हैं और गैर-रीड-ओनली के रूप में एनोटेट हैं। तीन कोर टूल (tokensave_context, tokensave_search, tokensave_status) anthropic/alwaysLoad के रूप में चिह्नित हैं ताकि वे क्लाइंट के टूल-खोज राउंड-ट्रिप को बायपास करें।
किसी अन्य आरंभित प्रोजेक्ट को क्वेरी करें
सिमेंटिक रीड टूल MCP सर्वर को पुनरारंभ किए बिना स्पष्ट रूप से चयनित स्थानीय ग्राफ़ को क्वेरी कर सकते हैं:
{
  "query": "screenGate",
  "graph_root": "/absolute/path/to/typewhisper"
}
चयनित परिणामों में विहित रूट/ब्रांच प्रोवेनेंस शामिल है। नोड आईडी उस ग्राफ़ के लिए नेमस्पेस किए गए हैं, और मिलान करने वाले चयनकर्ताओं को अनुवर्ती कॉलों पर दोहराया जाना चाहिए। उदाहरण के लिए, ब्रांच-चयनित क्वेरी का अनुवर्ती दोनों मान शामिल करता है:
{
  "node_id": "graph:<fingerprint>:function:<raw-id>",
  "graph_root": "/absolute/path/to/typewhisper",
  "graph_branch": "feature/auth"
}
graph_root किसी पहले से आरंभ किए गए प्रोजेक्ट का सटीक पूर्ण रूट होना चाहिए।
graph_branch वैकल्पिक है और, जब प्रदान किया जाए, तो उसे एक ट्रैक की गई शाखा का नाम देना चाहिए।
चयनित खोल केवल-पठनीय हैं: वे कभी आरंभ, सिंक, माइग्रेट, ऑटो-ट्रैक नहीं करते,
और न ही ग्राफ/स्रोत डेटा लिखते हैं। वे बचत लेखांकन में भी योगदान नहीं करते।
बिना चयनकर्ता वाले कॉल बिल्कुल पहले जैसे व्यवहार करते हैं।
graph_root केवल तभी उपयोगी है जब आप जानते हैं कि दूसरा प्रोजेक्ट मौजूद है, इसलिए सर्वर
आपको बताता है: सेवा किए गए रूट के ठीक बगल में स्थित आरंभिक प्रोजेक्ट
MCP instructions, tokensave_status, और खाली
tokensave_search / tokensave_context परिणामों में नामित हैं — वह बिंदु जहाँ एक सत्र
अन्यथा निष्कर्ष निकालता है कि कोई प्रतीक मौजूद नहीं है, बजाय अगले दरवाजे पर देखने के
(#375)। केवल तत्काल सहोदर प्रस्तावित हैं, अधिकतम पाँच, और उनकी ओर से कुछ भी खोला
या अनुक्रमित नहीं किया जाता; किसी एक को क्वेरी करने के लिए अभी भी एक स्पष्ट graph_root की आवश्यकता होती है।
चयनकर्ता जानबूझकर उन टूल पर उपलब्ध नहीं हैं जो लिखते हैं, शेल आउट करते हैं, या
वर्तमान चेकआउट पर निर्भर करते हैं: संपादन प्रिमिटिव, VCS और शाखा टूल,
डायग्नोस्टिक्स और टेस्ट निष्पादन, निर्भरता और रनटाइम इंट्रोस्पेक्शन, वर्कफ़्लो
और सत्र-मेमोरी टूल, स्थायी-कैश टूल (tokensave_redundancy),
और सर्वर प्रशासन। वे टूल चयनकर्ता को चुपचाप अनदेखा करने के बजाय अस्वीकार कर देते हैं।
खोज
| टूल | उद्देश्य |
|---|---|
tokensave_context | किसी कार्य के लिए प्रासंगिक कोड संदर्भ प्राप्त करें -- प्रवेश बिंदु, संबंधित प्रतीक, कोड स्निपेट |
tokensave_search | नाम से प्रतीक खोजें (फ़ंक्शन, क्लास, प्रकार) |
tokensave_node | किसी विशिष्ट प्रतीक के लिए विवरण + स्रोत कोड प्राप्त करें |
tokensave_files | फ़िल्टरिंग के साथ अनुक्रमित प्रोजेक्ट फ़ाइलें सूचीबद्ध करें (स्रोत और ट्रैक किए गए आर्टिफैक्ट) |
tokensave_module_api | किसी फ़ाइल या निर्देशिका की सार्वजनिक API सतह |
tokensave_similar | समान नाम वाले प्रतीक खोजें |
tokensave_annotations | विशेषता/एनोटेशन/डेकोरेटर इंट्रोस्पेक्शन -- सभी एनोटेशन का हिस्टोग्राम या लक्ष्य फ़िल्टर के साथ प्रति-साइट सूचियाँ |
tokensave_doc | स्रोत फ़ाइल के लिए साथी Markdown दस्तावेज़ीकरण -- दस्तावेज़ सामग्री, जिन फ़ाइलों को यह कवर करता है, और एक अप्रचलन संकेत |
tokensave_dependencies | 17 पारिस्थितिक तंत्रों में पैकेज-मेनिफेस्ट इंट्रोस्पेक्शन -- कार्यक्षेत्र सारांश, प्रति-पैकेज लुकअप, लाइसेंस सतह, संस्करण विचलन |
tokensave_status | इंडेक्स स्थिति, आँकड़े, सहेजे गए टोकन |
गैर-कोड आर्टिफैक्ट
tokensave_files स्रोत से अधिक कवर करता है। जिन फ़ाइलों का एक्सटेंशन
artifact_extensions में सूचीबद्ध है (.feature, .json, .yaml, .yml, .sql, .toml,
.proto, .graphql, .md, .bnd, .bndrun डिफ़ॉल्ट रूप से) पथ द्वारा ट्रैक किए जाते हैं
ताकि "लॉगिन फ़्लो के लिए .feature फ़ाइलें कहाँ हैं?" जैसे प्रश्नों का
ग्राफ उत्तर हो, न कि अवरुद्ध find (#323)। वे कभी पार्स नहीं होते और कोई प्रतीक योगदान नहीं करते;
kind: "artifact" और kind: "code" दोनों के बीच फ़िल्टर करते हैं, और विश्लेषण जो
"कोड" का अर्थ रखते हैं, उन्हें बाहर करते हैं। एक भाषा एक्सट्रैक्टर द्वारा पहले से संभाला गया एक्सटेंशन
इस सूची में अनदेखा किया जाता है, इसलिए इसका उपयोग किसी भाषा को पार्स होने से रोकने के लिए नहीं किया जा सकता।
सूची यह भी तय करती है कि शाब्दिक खोज किसके अंदर देख सकती है (#442)। एक शाब्दिक
(literal: true) खोज tokensave_search पर प्रतीकों के बजाय बाइट्स पढ़ती है,
इसलिए इसे किसी पार्सर की आवश्यकता नहीं होती -- लेकिन यह अनुक्रमित फ़ाइलों को पुनरावृत्त करती है, इसलिए यह
केवल उस फ़ाइल तक पहुँच सकती है जिसके लिए इंडेक्स में एक पंक्ति है। एक ट्रैक किया गया .rst दस्तावेज़ या
.tmpl टेम्पलेट में न तो एक्सट्रैक्टर है और न ही डिफ़ॉल्ट आर्टिफैक्ट प्रविष्टि, इसलिए इसके
मिलान गायब हैं; यहाँ एक्सटेंशन जोड़ें और tokensave sync -f चलाएँ और इसकी
पंक्तियाँ किसी भी अन्य की तरह खोजी जाती हैं, enclosing: null के साथ रिपोर्ट की जाती हैं क्योंकि
कोई प्रतीक संदर्भ नहीं है। एक शाब्दिक प्रतिक्रिया जो हर ट्रैक की गई फ़ाइल तक नहीं पहुँच सकी,
एक unscanned ब्लॉक में गिनती और एक्सटेंशन का नाम देकर कहती है, इसलिए एक
आंशिक उत्तर कभी भी पूर्ण के रूप में प्रस्तुत नहीं होता।
कॉल ग्राफ और प्रभाव
| टूल | उद्देश्य |
|---|---|
tokensave_callers | पता लगाएँ कि कौन किसी फ़ंक्शन को कॉल करता है |
tokensave_callees | पता लगाएँ कि कोई फ़ंक्शन किसे कॉल करता है |
tokensave_impact | देखें कि किसी प्रतीक को बदलने से क्या प्रभावित होता है |
tokensave_affected | स्रोत परिवर्तनों से प्रभावित टेस्ट फ़ाइलें खोजें |
tokensave_rename | ग्राफ-आधारित नाम बदलना: हर साइट एक आत्मविश्वास वर्ग (exact, heuristic, ambiguous, text_only), एक अंतर पूर्वावलोकन, और एक सब-या-कुछ नहीं आवेदन के साथ। बाइंडिंग-जागरूक नहीं |
tokensave_hotspots | सबसे अधिक जुड़े प्रतीक (उच्चतम कॉल गणना) |
कोड गुणवत्ता
| टूल | उद्देश्य |
|---|---|
tokensave_complexity | चक्रीय और संज्ञानात्मक जटिलता, नेस्टिंग गहराई, Halstead मेट्रिक्स, रखरखाव सूचकांक, CRAP, और सुरक्षा मेट्रिक्स द्वारा फ़ंक्शन रैंक करें |
tokensave_dead_code | अप्राप्य प्रतीक खोजें (कोई आने वाला किनारा नहीं; अस्पष्टता उम्मीदवार के रूप में नामित प्रतीक बाहर रखे गए हैं) |
tokensave_ambiguous_calls | कॉल साइटें जिन्हें रिज़ॉल्वर एक लक्ष्य पर पिन नहीं कर सका, हर बंधे उम्मीदवार के साथ |
tokensave_god_class | बहुत अधिक सदस्यों वाली क्लास खोजें |
tokensave_coupling | फ़ैन-इन/फ़ैन-आउट द्वारा फ़ाइलें रैंक करें |
tokensave_inheritance_depth | सबसे गहरी विरासत पदानुक्रम खोजें |
tokensave_circular | चक्रीय फ़ाइल निर्भरताएँ पहचानें |
tokensave_imports | मॉड्यूल-स्तरीय आयात निर्भरताएँ, चक्र, और कट सिमुलेशन |
tokensave_recursion | पुनरावर्ती/पारस्परिक-पुनरावर्ती कॉल चक्र पहचानें |
tokensave_unused_imports | आयात कथन जिन्हें कभी संदर्भित नहीं किया गया |
tokensave_doc_coverage | सार्वजनिक प्रतीक जिनमें दस्तावेज़ीकरण गायब है |
tokensave_simplify_scan | परिवर्तित फ़ाइलों का गुणवत्ता विश्लेषण (डुप्लिकेशन, मृत कोड, जटिलता) |
कोड-स्वास्थ्य विश्लेषण
पाँच टूल मौजूदा ग्राफ से संरचनात्मक गुणवत्ता संकेत सतह पर लाते हैं। समग्र स्कोर स्वतंत्र आयामों पर ज्यामितीय माध्य का उपयोग करता है ताकि कोई एक भी खेला न जा सके।
| टूल | उद्देश्य |
|---|---|
tokensave_health | समग्र गुणवत्ता संकेत (0-10000) चक्रीयता, गहराई, समानता, अतिरेक, और मॉड्यूलरिटी से |
tokensave_gini | किसी भी मेट्रिक के लिए Gini असमानता गुणांक (जटिलता, पंक्तियाँ, फ़ैन-इन/आउट, सदस्य) -- गॉड फ़ाइलें और असमान वितरण ढूँढता है |
tokensave_dependency_depth | सबसे लंबी फ़ाइल-स्तरीय निर्भरता श्रृंखलाएँ (Lakos स्तरीकरण) Tarjan SCC चक्र-तोड़ने के बाद पूर्ण श्रृंखला पुनर्निर्माण के साथ |
tokensave_dsm | डिज़ाइन संरचना मैट्रिक्स stats, clusters, या matrix रूप में -- स्तरीकरण उल्लंघन और छिपे युग्मन प्रकट करता है |
tokensave_test_risk | जोखिम-भारित टेस्ट-गैप विश्लेषण जो जटिलता, फ़ैन-इन, कवरेज, और 90-दिन git चर्न को एक स्कोर में जोड़ता है |
सत्र
AI कोडिंग सत्र की शुरुआत में स्वास्थ्य मेट्रिक्स का स्नैपशॉट लें, फिर अंत में अंतर देखें कि क्या सुधार हुआ या बिगड़ा।
| टूल | उद्देश्य |
|---|---|
tokensave_session_start | वर्तमान स्वास्थ्य मेट्रिक्स को बाद की तुलना के लिए JSON बेसलाइन के रूप में सहेजें |
tokensave_session_end | बेसलाइन के विरुद्ध पुनर्गणना और अंतर -- प्रति-आयाम डेल्टा, पास/फेल, स्वचालित सफाई |
संपादन प्रिमिटिव
चार लेखक टूल जो एजेंटों को regex या शेल-कोटिंग खतरों के बिना फ़ाइलें संशोधित करने देते हैं। प्रत्येक एकल-फ़ाइल, एंकर किया हुआ है, और लिखने के बाद इन-प्लेस पुनः-अनुक्रमण ट्रिगर करता है ताकि ग्राफ कभी बासी न हो।
| टूल | उद्देश्य |
|---|---|
tokensave_str_replace | एक अद्वितीय old_str को new_str से बदलें; 0 या >1 मिलान पर विफल (मल्टी-एडिट बग से बचाता है) |
tokensave_multi_str_replace | N (old, new) प्रतिस्थापन परमाणु रूप से लागू करें -- सब-या-कुछ नहीं लेनदेन |
tokensave_insert_at | एक अद्वितीय एंकर स्ट्रिंग या पंक्ति संख्या से पहले या बाद में सामग्री डालें |
tokensave_ast_grep_rewrite | ast-grep CLI के माध्यम से --rewrite मोड में संरचनात्मक कोड पुनर्लेखन |
Git और वर्कफ़्लो
| टूल | उद्देश्य |
|---|---|
tokensave_diff_context | परिवर्तित फ़ाइलों के लिए शब्दार्थ संदर्भ -- संशोधित प्रतीक, निर्भरताएँ, प्रभावित टेस्ट |
tokensave_commit_context | कमिट संदेश प्रारूपण के लिए अप्रतिबद्ध परिवर्तनों का शब्दार्थ सारांश |
tokensave_pr_context | पुल अनुरोध विवरण के लिए git refs के बीच शब्दार्थ अंतर |
tokensave_changelog | दो git refs के बीच शब्दार्थ अंतर |
tokensave_test_map | प्रतीक स्तर पर स्रोत-से-टेस्ट मैपिंग, अनावृत्त प्रतीक पहचान के साथ |
tokensave_test_coverage | प्रति-फ़ाइल/प्रतीक/टेस्ट-फ़ंक्शन कवरेज रोलअप संक्रामक कॉल-एज विस्तार के साथ |
प्रकार प्रणाली
| टूल | उद्देश्य |
|---|---|
tokensave_type_hierarchy | ट्रेट्स, इंटरफेस, और क्लास के लिए पुनरावर्ती प्रकार पदानुक्रम पेड़ |
tokensave_rank | संबंध गणना द्वारा नोड रैंक करें (सबसे अधिक कार्यान्वित इंटरफ़ेस, सबसे अधिक विस्तारित क्लास) |
tokensave_distribution | प्रति फ़ाइल या निर्देशिका नोड प्रकार विभाजन |
tokensave_largest | आकार द्वारा नोड रैंक करें -- सबसे बड़ी क्लास, सबसे लंबी विधियाँ |
पोर्टिंग
| टूल | उद्देश्य |
|---|---|
tokensave_port_status | पोर्टिंग प्रगति ट्रैक करने के लिए स्रोत/लक्ष्य निर्देशिकाओं के बीच प्रतीकों की तुलना करें |
tokensave_port_order | पोर्टिंग के लिए प्रतीकों का टोपोलॉजिकल सॉर्ट -- पहले पत्ते पोर्ट करें, फिर निर्भर |
मल्टी-ब्रांच
| टूल | उद्देश्य |
|---|---|
tokensave_branch_search | दूसरी शाखा के ग्राफ में प्रतीक खोजें |
tokensave_branch_diff | शाखाओं के बीच प्रतीकों की तुलना करें (जोड़े/हटाए/बदले) |
tokensave_branch_list | DB आकार और सिंक समय के साथ ट्रैक की गई शाखाएँ सूचीबद्ध करें |
MCP संसाधन
चार संसाधन resources/list और resources/read के माध्यम से उजागर होते हैं:
tokensave://status-- ग्राफ आँकड़े JSON के रूप मेंtokensave://files-- निर्देशिका द्वारा समूहित अनुक्रमित फ़ाइल पेड़tokensave://overview-- भाषा वितरण और प्रतीक प्रकारों के साथ प्रोजेक्ट सारांशtokensave://branches-- DB आकार और मूल जानकारी के साथ ट्रैक की गई शाखाएँ
टोकन ट्रैकिंग
tokensave हर MCP टूल कॉल पर सहेजे गए टोकन मापता है। प्रत्येक टूल प्रतिक्रिया में एक tokensave_metrics: before=N after=M पंक्ति शामिल होती है जो दिखाती है कि उस विशिष्ट कॉल द्वारा कितने कच्चे-फ़ाइल टोकन से बचा गया।
रिपोर्टिंग बंद करना। मेट्रिक्स पंक्ति, MCP instructions में एक वाक्य के साथ, एजेंट से आपको बचत रिपोर्ट करने के लिए कहती है — जिसका अर्थ है कि मॉडल आउटपुट टोकन खर्च करता है tokensave द्वारा इनपुट टोकन पर की गई बचत का वर्णन करने में। आउटपुट टोकन अधिक महंगे प्रकार हैं, इसलिए यदि आपका एजेंट लगभग हर मोड़ पर tokensave का उल्लेख करता है, तो वह वर्णन लाभ को ऑफसेट कर सकता है (#356)। report_savings को false में .tokensave/config.json पर सेट करें, या TOKENSAVE_REPORT_SAVINGS पर्यावरण चर को प्रति-रन ओवरराइड करने के लिए (कोई भी मान इसे सक्षम करता है सिवाय 0, false, no, off, या खाली)। मेट्रिक्स पंक्ति और निर्देश दोनों गायब हो जाते हैं; tokensave install इसी तरह रिपोर्टिंग नियम को एजेंट प्रॉम्प्ट फ़ाइलों में लिखना बंद कर देता है। मापन किसी भी तरह से अप्रभावित रहता है — हर कॉल अभी भी बचत लेजर में दर्ज होती है, इसलिए tokensave gain, tokensave list, status और monitor बिल्कुल पहले जैसे रिपोर्ट करते रहते हैं। डिफ़ॉल्ट true रहता है।
केवल मुख्य टूल डिफ़ॉल्ट रूप से सूचीबद्ध हैं। एक MCP क्लाइंट हर सूचीबद्ध टूल का स्कीमा हर मोड़ पर भेजता है, किसी भी टूल को कॉल करने से पहले। पूर्ण tokensave सतह लगभग 89 KB स्कीमा है, जो एक छोटे-संदर्भ मॉडल पर विंडो के आधे से अधिक हो सकती है (#576)। इसलिए tools/list केवल मुख्य टूल भेजता है: context, search, status, read, body, files, callers, callees, impact, str_replace और multi_str_replace (लगभग 17 KB tokensave_more के साथ)। initialize निर्देश इन टूल और उन क्षेत्रों का नाम देते हैं जिन्हें tokensave_more सूचीबद्ध कर सकता है, इसलिए एक क्लाइंट जो टूल स्कीमा स्थगित करता है, फिर भी जानता है कि बाकी मौजूद हैं। सेटिंग चुनती है कि सर्वर क्या सूचीबद्ध करता है, न कि वह क्या चला सकता है: एक टूल जो सूचीबद्ध नहीं है, फिर भी नाम से कॉल का उत्तर देता है, इसलिए एजेंट अनुमति सूचियाँ और हुक काम करते रहते हैं। सभी टूल सूचीबद्ध करने के लिए, "tools": "full" को .tokensave/config.json में सेट करें, या MCP सर्वर के पर्यावरण में TOKENSAVE_TOOLS=full; पर्यावरण चर फ़ाइल पर जीतता है। 7.13.0 द्वारा लिखा गया एक "tools": "full", जिसने इसे हर सहेजे गए कॉन्फ़िग में लिखा, पुराने डिफ़ॉल्ट के रूप में पढ़ा जाता है; पूर्ण सूची रखने के लिए अपग्रेड करने के बाद इसे फिर से सेट करें।
कोर टूलसेट के साथ सर्वर tokensave_more की सूची भी देता है। area के साथ एक कॉल (analysis, edit, git, memory, navigate या all) सत्र के बाकी समय के लिए उस क्षेत्र के टूल्स की सूची देता है, और सर्वर notifications/tools/list_changed भेजता है ताकि क्लाइंट सूची फिर से प्राप्त करे। एक सत्र केवल उन्हीं क्षेत्रों के लिए भुगतान करता है जिनका वह उपयोग करता है: git क्षेत्र लगभग 6 KB जोड़ता है। एक क्लाइंट जो list_changed को अनदेखा करता है वह कोर सूची रखता है। tokensave install हर अन्य टूल के साथ tokensave_more प्रदान करता है, इसलिए यह संकेत नहीं देता; इस रिलीज़ से पहले के इंस्टॉल से एक बार संकेत मिलता है, जब तक tokensave reinstall या अपग्रेड रीसिंक अनुमति सूची को ताज़ा नहीं करता।
लागत अवलोकन
tokensave cost                     # 7-day cost summary (default)
tokensave cost today               # today only
tokensave cost --by-model          # breakdown by Claude model
tokensave cost --by-task           # breakdown by task category (coding, debugging, exploration, ...)
tokensave cost --export json       # JSON export to stdout
tokensave cost --export csv        # CSV export to stdout
Claude Code सत्र प्रतिलेखों (~/.claude/projects/**/*.jsonl) को पार्स करता है, प्रत्येक API टर्न को 13 कार्य श्रेणियों में वर्गीकृत करता है, मॉडल मूल्य निर्धारण का उपयोग करके डॉलर लागत की गणना करता है, और तेज़ समग्र क्वेरी के लिए परिणाम ~/.tokensave/global.db में संग्रहीत करता है। मूल्य निर्धारण LiteLLM से हर 24 घंटे में ताज़ा किया जाता है और ऑफ़लाइन होने पर एम्बेडेड तालिका में वापस आ जाता है।
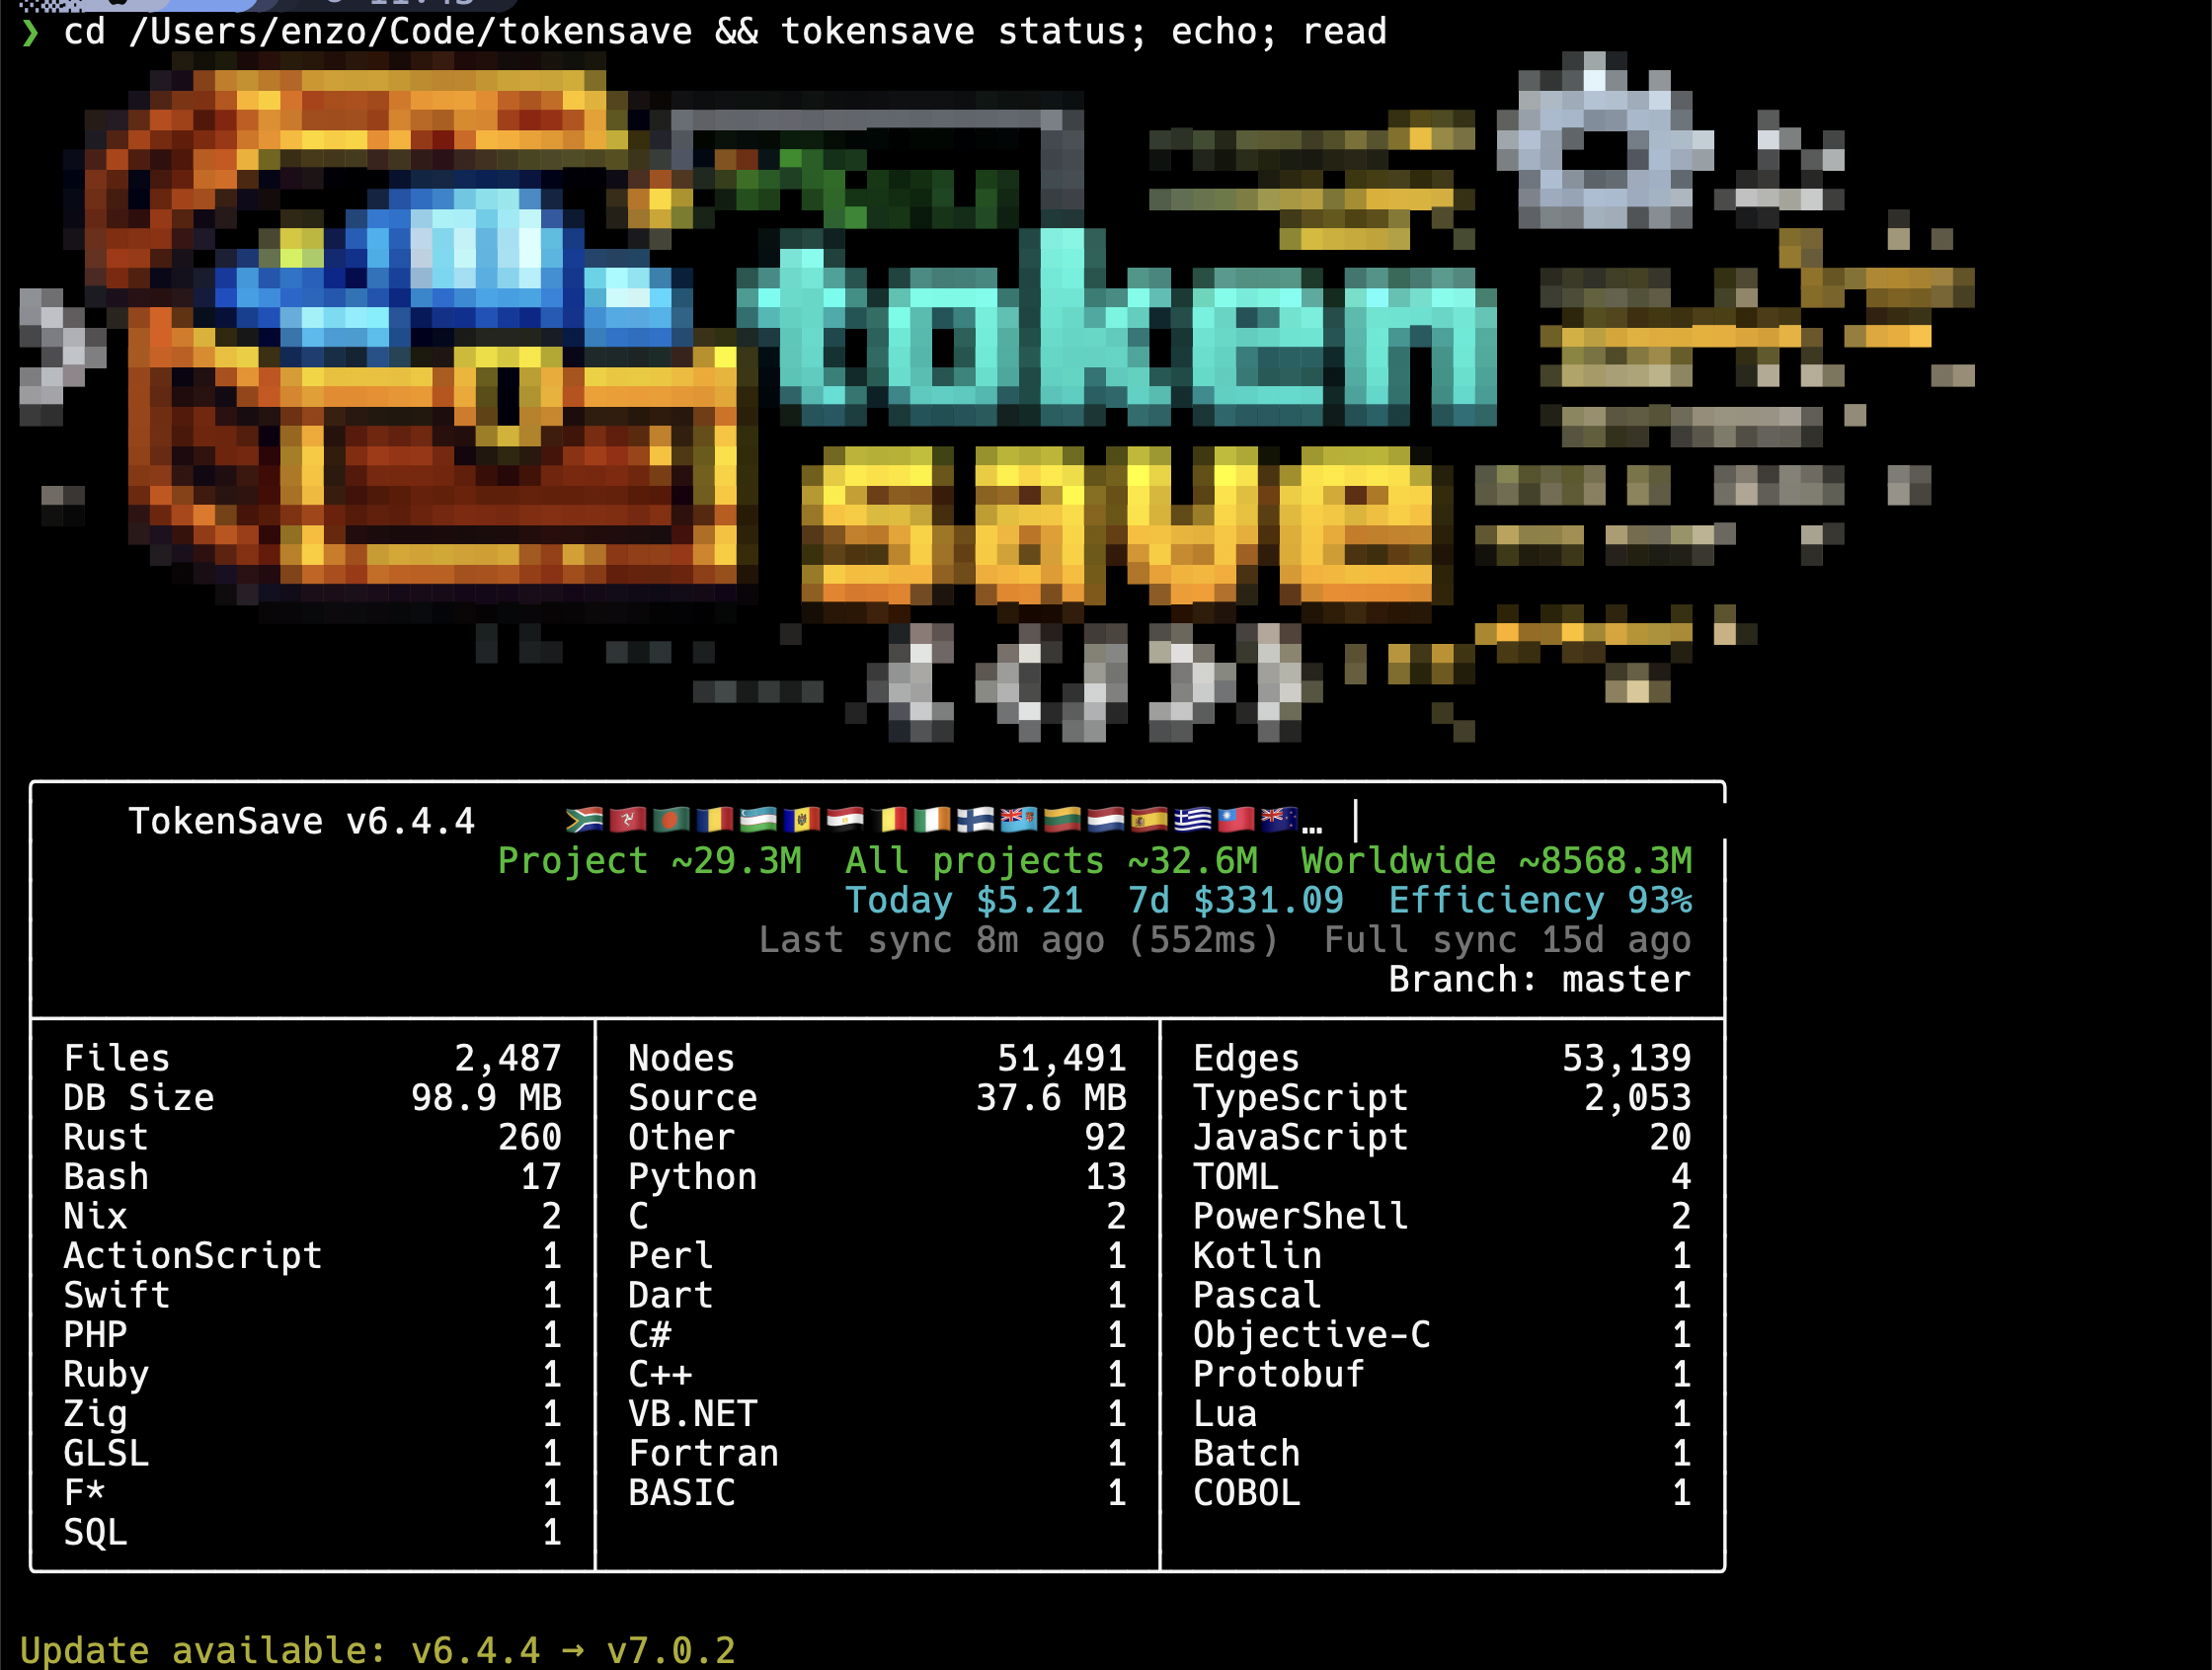
tokensave status हेडर में एक लागत पंक्ति शामिल है जो आज का खर्च, 7-दिन का कुल योग, और दक्षता अनुपात (सहेजे गए टोकन / कुल टोकन) दिखाती है। tokensave monitor TUI बचत फ़ीड के साथ एक लाइव लागत पैनल दिखाता है। प्रत्येक Claude Code सत्र के अंत में, hook_stop हैंडलर टर्मिनल पर एक-पंक्ति की रसीद प्रिंट करता है।
कार्य वर्गीकरण श्रेणियाँ: कोडिंग, डिबगिंग, फीचर विकास, रिफैक्टरिंग, परीक्षण, अन्वेषण, योजना, प्रत्यायोजन, Git संचालन, बिल्ड/डिप्लॉय, विचार-मंथन, बातचीत, सामान्य। वर्गीकरण नियतात्मक है (टूल नामों और Bash कमांड पर पैटर्न मिलान), किसी LLM कॉल की आवश्यकता नहीं है, और AgentSeal/codeburn से अनुकूलित है।
लाइव मॉनिटर
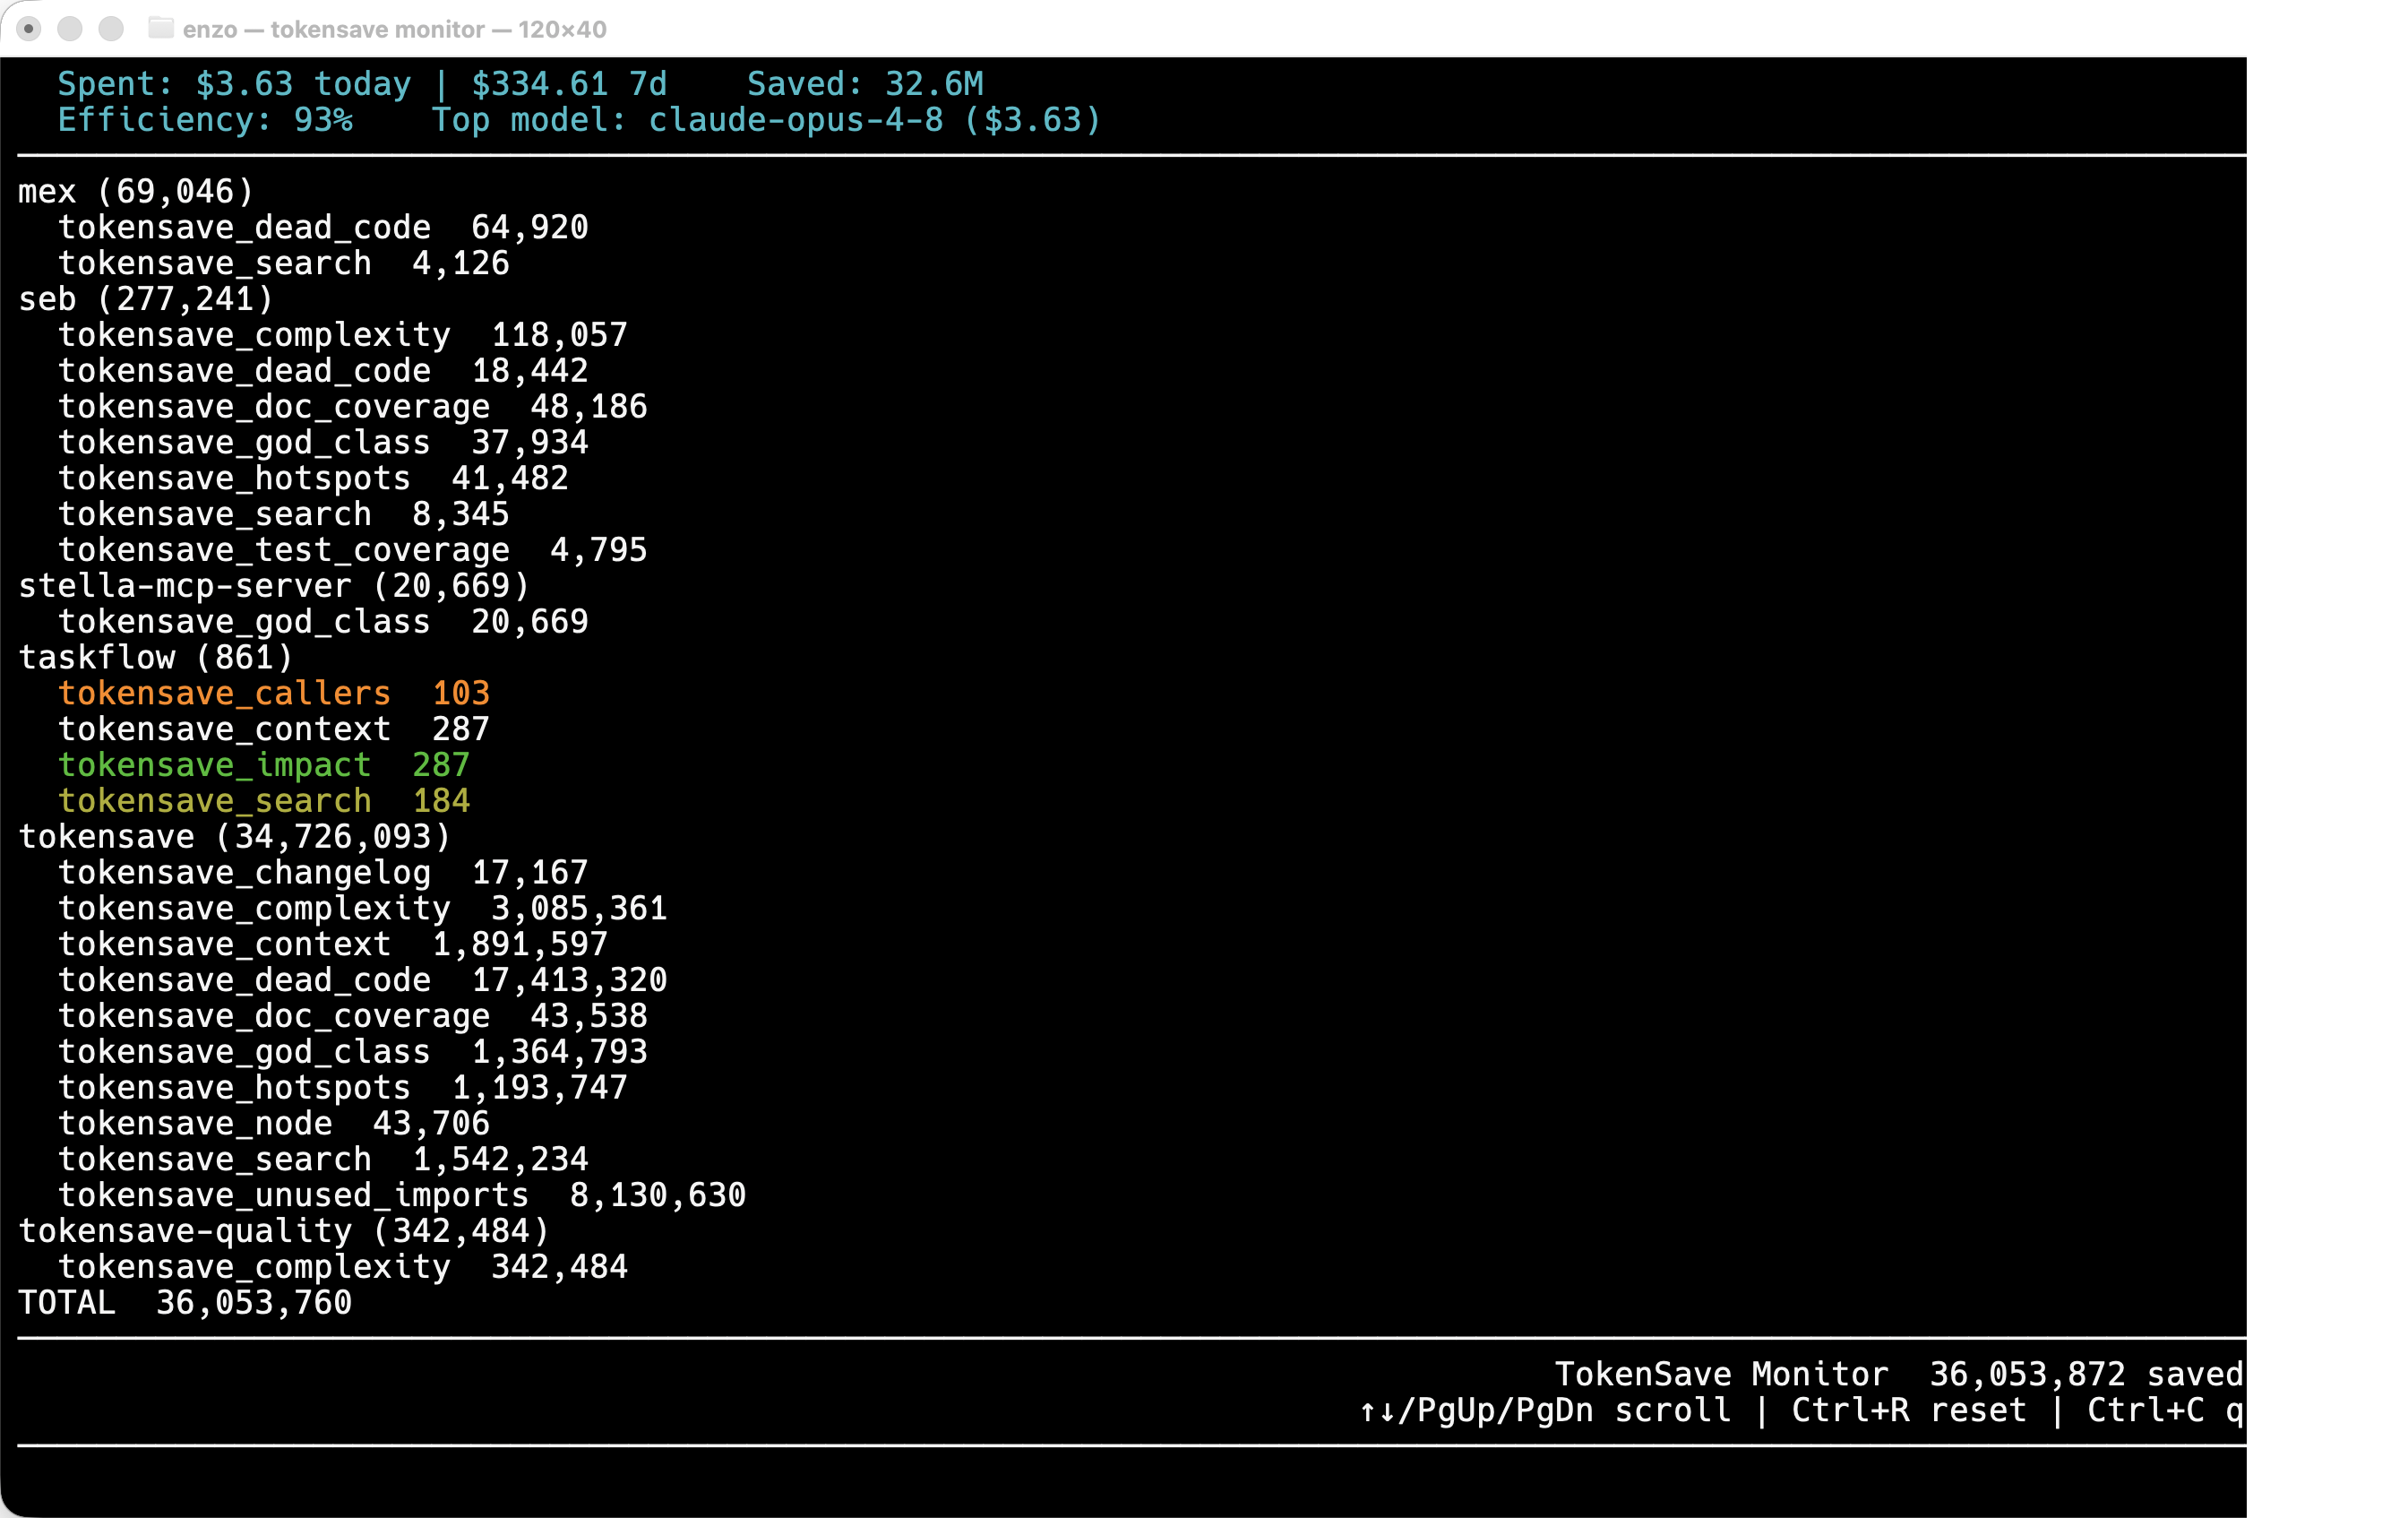
tokensave monitor
एक वैश्विक TUI जो सभी परियोजनाओं से MCP टूल कॉल को वास्तविक समय में दिखाता है, ~/.tokensave/monitor.mmap पर साझा मेमोरी-मैप्ड रिंग बफर के माध्यम से। प्रत्येक प्रविष्टि परियोजना का नाम, टूल का नाम, और टोकन डेल्टा दिखाती है। शीर्ष पर एक लागत पैनल आज का खर्च, बचत, दक्षता, और शीर्ष मॉडल दिखाता है (हर 30 सेकंड में ताज़ा होता है)।
मेमोरी डायग्नोस्टिक्स
tokensave memory [--clean]
हर tokensave प्रक्रिया (MCP सर्वर, सिंक, इंडेक्स रन) के लिए एक मशीन-व्यापी मेमोरी रिपोर्ट, ~/.tokensave/memory.mmap पर साझा मेमोरी-मैप्ड तालिका के माध्यम से। प्रत्येक इंस्टेंस स्टार्टअप पर, प्रति MCP टूल कॉल पर, और सिंक/रिज़ॉल्यूशन चरणों के आसपास अपने RSS को सर्वोत्तम प्रयास से स्व-नमूना करता है, इसलिए रिपोर्ट वर्तमान और पीक RSS उस चरण के साथ दिखाती है जिसने पीक उत्पन्न किया — उच्च मेमोरी उपयोग को जिम्मेदार ठहराने के लिए आवश्यक डेटा (देखें #253)। पंक्तियाँ alive, dead (एक OOM-मारा गया प्रक्रिया अपने पीक/चरण को फोरेंसिक रिकॉर्ड के रूप में छोड़ देता है), या orphan (अभी भी चल रहा है लेकिन init को फिर से माता-पिता बनाया गया) के रूप में चिह्नित हैं। --clean मृत स्लॉट साफ़ करता है।
PEAK PHASE उच्चतम नमूने का नाम देता है, इसलिए यह केवल नमूने जितना सटीक है। वृद्धिशील सिंक रिकॉर्ड, क्रम में: sync:extract, sync:resolve:load_nodes, sync:resolve:build_caches, sync:resolve:refs, sync:variants, sync:done। एक पूर्ण इंडेक्स रिकॉर्ड index:extract, index:resolve:build_caches, index:resolve:refs, index:resolve:done, index:insert, index:done।
प्रत्येक उस कार्य के बाद दर्ज किया जाता है जिसका नाम यह रखता है। वे पहले इससे पहले दर्ज किए जाते थे, इसलिए हर नमूना अगले चरण के लेबल के तहत पिछले चरण का RSS रिपोर्ट करता था — जिसने 73 MiB को नोड लोड के लिए जिम्मेदार ठहराया जो वास्तव में अनसुलझे संदर्भों को लोड करने से संबंधित था, एक ऐसा चरण जिसमें कोई नमूना नहीं था, और एक मेमोरी जांच को महीनों के लिए गलत सबसिस्टम की ओर इंगित किया (#409)। यदि आप एक चरण जोड़ते हैं, तो कार्य के बाद नमूना लें, पहले नहीं, और किसी भी ऐसे चरण के लिए एक जोड़ें जो पीक को धारण करने के लिए पर्याप्त बड़ा हो।
सत्र और जीवनकाल काउंटर
tokensave current-counter          # show per-project session counter
tokensave reset-counter            # reset the session counter
tokensave status                   # shows project + global lifetime totals + cost
tokensave status परियोजना इंडेक्स आँकड़े, भाषा विभाजन, लागत पंक्ति (आज / 7 दिन / दक्षता), और परियोजना + विश्वव्यापी जीवनकाल कुल प्रस्तुत करता है:
विश्वव्यापी काउंटर
सभी tokensave उपयोगकर्ता एक अनाम समग्र काउंटर में योगदान करते हैं। tokensave status आपका परियोजना कुल और विश्वव्यापी कुल दोनों दिखाता है। अपलोड केवल एक संख्या भेजता है (जैसे 4823) बिना किसी पहचान जानकारी के। tokensave disable-upload-counter के साथ ऑप्ट आउट करें।
इंडेक्स ताज़गी
tokensave बिना पृष्ठभूमि डेमन या OS-स्तरीय फ़ाइल वॉचर के ग्राफ़ को अद्यतन रखता है।
ऑन-डिमांड स्टेलनेस जांच। हर MCP टूल कॉल जाँचता है कि क्या कोई अनुक्रमित फ़ाइल अंतिम सिंक के बाद संशोधित हुई है। यदि स्टेल फ़ाइलें मिलती हैं, तो टूल प्रतिक्रिया लौटाने से पहले उन्हें फिर से निकाला जाता है। एक 30-सेकंड का कूलडाउन बैक-टू-बैक कॉल को हर कीस्ट्रोक पर पेड़ को फिर से चलने से रोकता है।
कनेक्ट पर कैच-अप सिंक। जब MCP सर्वर शुरू होता है, यह तुरंत एक गैर-अवरोधक कैच-अप सिंक चलाता है जो किसी भी परिवर्तन को उठाता है जो कोई एजेंट संलग्न नहीं होने पर किया गया था — एक git pull, एक IDE संपादन, एक बिल्ड चरण — ताकि सत्र की पहली टूल कॉल एक ताज़ा इंडेक्स देखे।
मल्टी-एजेंट कार्य और git वर्कट्री। जब कई एजेंट एक ही परियोजना पर समवर्ती रूप से काम करते हैं, तो मजबूत धारणा यह है कि प्रत्येक एजेंट अपने स्वयं के git वर्कट्री में काम करता है। वर्कट्री एक ही रिपॉजिटरी के स्वतंत्र फाइलसिस्टम चेकआउट हैं: एजेंट A और एजेंट B प्रत्येक के पास हर फ़ाइल की अपनी प्रति होती है, इसलिए वे कभी एक-दूसरे के इन-फ्लाइट संपादन को अधिलेखित नहीं करते। tokensave स्वचालित रूप से पता लगाता है जब कोई क्वेरी मुख्य चेकआउट के अंदर नेस्टेड वर्कट्री से आती है और सही शाखा ग्राफ़ से परिणाम प्रस्तुत करता है। परिवर्तन स्वतंत्र रूप से जमा होते हैं और अंततः git मर्ज या रीबेस के माध्यम से समेकित होते हैं — वही प्रक्रिया जो किसी अन्य समानांतर विकास के लिए उपयोग की जाती है। यह डिज़ाइन साझा परिवर्तनीय निर्देशिका पर क्रॉस-एजेंट लॉकिंग की जटिलता और विफलता मोड से बचता है।
CLI-केवल वर्कफ़्लो। यदि आप बिना संलग्न एजेंट (कोई MCP सर्वर नहीं) के tokensave कमांड चलाते हैं, तो कमांड के बीच स्टेलनेस जांच नहीं चल रही है। हर कमिट या क्लोन के बाद इंडेक्स को स्वचालित रूप से ताज़ा रखने के लिए git हुक स्थापित करें:
cp scripts/post-commit scripts/post-checkout .git/hooks/
chmod +x .git/hooks/post-commit .git/hooks/post-checkout
5.x से अपग्रेड करना
स्टैंडअलोन tokensave daemon कमांड और इसका launchd/systemd/Windows Service ऑटोस्टार्ट 6.0.0 में हटा दिया गया था। एम्बेडेड OS-स्तरीय फ़ाइल वॉचर जिसने डेमन को बदल दिया था, वह स्वयं 6.1.1 में हटा दिया गया था (यह गहरे node_modules या target पेड़ों वाले बड़े मोनोरेपो पर अनियंत्रित CPU और मेमोरी का कारण बना)। ऑन-डिमांड स्टेलनेस मॉडल ऊपर वर्तमान डिज़ाइन है।
यदि आपके पास अभी भी 5.x से डेमन ऑटोस्टार्ट है, तो इसे हटा दें:
- macOS:
launchctl unload ~/Library/LaunchAgents/com.tokensave.daemon.plist && rm ~/Library/LaunchAgents/com.tokensave.daemon.plist - Linux:
systemctl --user disable --now tokensave-daemon && rm ~/.config/systemd/user/tokensave-daemon.service - Windows:
sc.exe delete tokensave-daemon(एक उन्नत टर्मिनल से)
यदि आपको सटीक नाम याद नहीं है: launchctl list | grep tokensave / systemctl --user list-units | grep tokensave / sc.exe query state= all | findstr -i tokensave।
स्व-अपग्रेड
tokensave upgrade                  # upgrade to latest in current channel
tokensave channel                  # show current channel (stable/beta)
tokensave channel beta             # switch to beta channel
tokensave channel stable           # switch back to stable
tokensave upgrade GitHub रिलीज़ से सही प्लेटफ़ॉर्म बाइनरी डाउनलोड करता है और चल रहे बाइनरी को उसी स्थान पर बदल देता है। स्थिर और बीटा चैनलों को स्वतंत्र रूप से समर्थन करता है।
संस्करण और अपग्रेड
tokensave संस्करण संख्याएँ SemVer की तरह दिखती हैं लेकिन इसका पालन नहीं करतीं: जो घटक बदलता है वह उस रखरखाव को एन्कोड करता है जो अपडेट की आवश्यकता है, जिसे tokensave अगले लॉन्च पर स्वचालित रूप से करता है — आप कभी भी मैन्युअल रूप से पुनर्स्थापना या पुनः अनुक्रमण नहीं चलाते।
| बंप | उदाहरण | अपडेट की आवश्यकता | स्वचालित क्रिया |
|---|---|---|---|
पैच (x.y.Z) | 7.2.0 → 7.2.1 | कुछ नहीं | कोई नहीं — कोई पुनर्स्थापना नहीं, कोई पुनः अनुक्रमण नहीं |
माइनर (x.Y.0) | 7.2.0 → 7.3.0 | एक पुनर्स्थापना (नए हार्नेस, नए टूल, नया कॉन्फ़िग) | हर स्थापित एजेंट एकीकरण का वैश्विक पुनर्स्थापना (अनुमतियाँ, हुक, और MCP कॉन्फ़िग ताज़ा करता है) |
मेजर (X.0.0) | 7.2.0 → 8.0.0 | एक पुनर्स्थापना + पूर्ण रीसिंक | वैश्विक पुनर्स्थापना और प्रति-परियोजना बलपूर्वक पुनः अनुक्रमण (sync -f समकक्ष) |
वैश्विक पुनर्स्थापना। नए माइनर या मेजर बिल्ड के पहले रन पर, tokensave चुपचाप प्रत्येक पंजीकृत एजेंट के लिए install फिर से चलाता है, ताकि एजेंट कॉन्फ़िग हमेशा वर्तमान बाइनरी की ओर इंगित करे और वर्तमान टूल सेट उजागर करे। पैच बंप इसे छोड़ देते हैं — चल रहा संस्करण मार्कर बस आगे बढ़ाया जाता है।
पुनर्स्थापना वास्तव में मौन है: एक स्पष्ट tokensave install से आप जो प्रति-एजेंट सेटअप आउटपुट देखते हैं वह यहाँ दबा दिया गया है, इसलिए यह कभी भी सामान्य tokensave init या tokensave sync के सामने नहीं आता। यदि किसी एजेंट का कॉन्फ़िग ताज़ा नहीं किया जा सकता — ऐप स्थापित नहीं है, या इसका कॉन्फ़िग केवल-पठनीय स्थान पर रहता है — आपको विफल एजेंटों के नाम वाली एक पंक्ति मिलती है:
warning: could not refresh tokensave config for: copilot.
  Run tokensave install to see the error.
अंतर्निहित त्रुटि देखने के लिए tokensave install चलाएँ। संस्करण मार्कर किसी भी तरह आगे बढ़ते हैं, इसलिए एक कॉन्फ़िग पथ जो कभी नहीं लिखा जा सकता है, प्रत्येक अपग्रेड पर एक बार रिपोर्ट किया जाता है बजाय हर बाद के कमांड पर पुनः प्रयास करने के।
प्रति-परियोजना बलपूर्वक पुनः अनुक्रमण (केवल मेजर)। एक मेजर बंप का मतलब है कि परियोजना इंडेक्स को फिर से बनाया जाना चाहिए। tokensave इसे आलसी और प्रति परियोजना करता है: मेजर अपग्रेड के बाद किसी परियोजना में पहली MCP टूल कॉल पर, यह एक पृष्ठभूमि पूर्ण पुनः अनुक्रमण (tokensave sync --force के समकक्ष) शुरू करता है जो टूल प्रतिक्रिया को कभी अवरुद्ध नहीं करता।
Brew / cargo फ़ॉलबैक। बाहरी अपग्रेड जो tokensave upgrade के बाहर बाइनरी को बदलते हैं — brew upgrade tokensave या cargo install tokensave — उसी तरह पता लगाए जाते हैं: यदि चल रहा संस्करण अंतिम संस्करण से नया है जिसने इंस्टॉल किया था, तो पुनर्स्थापना अगले लॉन्च पर चलती है जैसे स्व-अपग्रेड के बाद होती।
देखें TOKENSAVE-VERSIONING.md क्यों tokensave SemVer से विचलित होता है (रखरखाव को संस्करण में एन्कोड करना ही शून्य-स्पर्श अपग्रेड संभव बनाता है), मार्कर यांत्रिकी, स्वतंत्र डेटाबेस स्कीमा संस्करण, और रिलीज़ काटने के लिए अनुरक्षक नियम।
CLI संदर्भ
tokensave init [path]              # Initialize a new project (full index)
tokensave sync [path]              # Incremental sync (must be initialized first)
tokensave sync --force [path]      # Force a full re-index
tokensave sync --doctor [path]     # Sync and list added/modified/removed files
tokensave status [path]            # Show statistics + cost summary
tokensave status [path] --json     # Show statistics (JSON output)
tokensave status --details         # Include node-kind breakdown
tokensave cost [range]             # Token cost summary (default: 7d)
tokensave cost --by-model          # Cost grouped by model
tokensave cost --by-task           # Cost grouped by task category
tokensave cost --export json|csv   # Export cost data
tokensave query <search> [path]    # Search symbols
tokensave files [--filter dir] [--pattern glob] [--json]   # List indexed files
tokensave affected <files...> [--stdin] [--depth N]        # Find affected test files
tokensave install [--agent NAME]   # Configure agent integration
tokensave reinstall                # Refresh settings for all installed agents
tokensave uninstall [--agent NAME] # Remove agent integration
tokensave serve [--idle-timeout-secs N]   # Start MCP server (N: exit after N idle seconds)
tokensave servers [--json]         # List running servers and the index each one holds
tokensave monitor                  # Live TUI showing MCP calls across all projects
tokensave memory [--clean]         # Per-instance RSS report for all tokensave processes
tokensave upgrade                  # Self-update to latest version
tokensave channel [stable|beta]    # Show or switch update channel
tokensave doctor [--agent NAME]    # Check installation health
tokensave githooks [on|off] [--local]  # Manage git hooks (--local: this repo only, no core.hooksPath)
tokensave branch add|list|remove|removeall|gc   # Multi-branch management
tokensave current-counter          # Show per-project token counter
tokensave reset-counter            # Reset per-project token counter
tokensave disable-upload-counter   # Opt out of worldwide counter uploads
tokensave enable-upload-counter    # Re-enable worldwide counter uploads
tokensave doctor
अपने tokensave इंस्टॉलेशन की एक व्यापक स्वास्थ्य जांच चलाएँ:
tokensave doctor
जाँच: बाइनरी स्थान, परियोजना इंडेक्स, वैश्विक DB, उपयोगकर्ता कॉन्फ़िग, एजेंट एकीकरण (MCP सर्वर, हुक, अनुमतियाँ, प्रॉम्प्ट नियम), और नेटवर्क कनेक्टिविटी। यदि अपग्रेड के बाद कोई टूल अनुमति गायब है, तो यह आपको tokensave install चलाने के लिए कहता है। केवल एक विशिष्ट एजेंट की जाँच करने के लिए --agent का उपयोग करें।
डॉक्टर यह भी सत्यापित करता है कि प्रत्येक स्थापित हुक सही tokensave उपकमांड का उपयोग करता है और टूटे हुए हुक को स्वचालित रूप से मरम्मत करता है।
Claude Code के साथ यह कैसे काम करता है
एक बार कॉन्फ़िगर होने के बाद, Claude Code स्वचालित रूप से tokensave का उपयोग करता है जब उसे आपके कोडबेस को समझने की आवश्यकता होती है, बजाय कच्ची फ़ाइलें पढ़ने के। तीन परतें एक-दूसरे को सुदृढ़ करती हैं:
| परत | यह क्या करता है | यह क्यों मायने रखता है |
|---|---|---|
| MCP सर्वर | Claude को 80+ tokensave_* टूल उजागर करता है | Claude सीधे ग्राफ़ से क्वेरी कर सकता है |
| CLAUDE.md नियम | Claude को एजेंट/फ़ाइल पढ़ने पर tokensave पसंद करने के लिए कहता है | मॉडल को महंगे पैटर्न पर वापस गिरने से रोकता है |
| PreToolUse हुक | देशी Rust हुक Explore एजेंटों को अवरुद्ध करता है | उन मामलों को पकड़ता है जहाँ मॉडल CLAUDE.md नियमों को अनदेखा करता है |
| UserPromptSubmit हुक | प्रॉम्प्ट सबमिशन पर चलता है | टोकन लेखांकन के लिए जीवनचक्र ट्रैकिंग |
| Stop हुक | सत्र समाप्त होने पर चलता है | टोकन काउंटर फ्लश करता है |
परिणाम: Claude को काफी कम टोकन के साथ समान कोड समझ मिलती है। एक विशिष्ट Explore एजेंट 20-50 फ़ाइलें पढ़ता है; tokensave अपने पूर्व-निर्मित इंडेक्स से प्रासंगिक प्रतीक, संबंध, और कोड स्निपेट लौटाता है।
नेटवर्क कॉल और गोपनीयता
tokensave की कोर कार्यक्षमता (इंडेक्सिंग, खोज, ग्राफ़ क्वेरी, MCP सर्वर) 100% स्थानीय है — आपका कोड कभी भी आपकी मशीन नहीं छोड़ता।
| कॉल | भेजा गया डेटा | कब | ऑप्ट-आउट |
|---|---|---|---|
| विश्वव्यापी काउंटर अपलोड | टोकन गिनती (एक संख्या) + देश (IP से) | सिंक, स्थिति, MCP सत्र | tokensave disable-upload-counter |
| विश्वव्यापी काउंटर पढ़ना | कुछ नहीं (GET अनुरोध) | स्थिति | N/A (केवल-पढ़ने, 1s टाइमआउट) |
| संस्करण जांच | कुछ नहीं (GET अनुरोध) | स्थिति (5 मिनट कैश), सिंक (समानांतर) | N/A (1s टाइमआउट, विफलता पर कोई-ऑप नहीं) |
| मॉडल मूल्य ताज़ा करना | कुछ नहीं (GET अनुरोध) | tokensave cost (24 घंटे कैश) | N/A (5s टाइमआउट, एम्बेडेड मूल्य निर्धारण पर वापस गिरता है) |
विश्वव्यापी काउंटर अपलोड एक एकल HTTP POST भेजता है जिसमें JSON बॉडी होती है जैसे {"amount": 4823}। कोई कुकीज़ नहीं, कोई ट्रैकिंग नहीं, कोई उपयोगकर्ता ID नहीं। Cloudflare Worker आपके IP पते का देश (अनुरोध हेडर से प्राप्त) समग्र भौगोलिक आँकड़ों के लिए लॉग करता है -- आपका वास्तविक IP पता संग्रहीत नहीं किया जाता है। |
मॉडल मूल्य रीफ़्रेश GitHub से एक सार्वजनिक JSON फ़ाइल लाता है (raw.githubusercontent.com/BerriAI/litellm/main/model_prices_and_context_window.json) ताकि Claude मॉडल मूल्य निर्धारण tokensave cost के लिए अद्यतित रहे। कोई डेटा नहीं भेजा जाता -- यह एक सादा HTTPS GET है। प्रतिक्रिया ~/.tokensave/pricing.json पर 24 घंटे के लिए कैश की जाती है। यदि फ़ेच विफल हो जाता है, तो tokensave अपनी संकलित मूल्य तालिका का उपयोग करता है।
50+ भाषाएँ
tokensave 50 से अधिक प्रोग्रामिंग भाषाओं का समर्थन करता है जो Cargo फ़ीचर फ़्लैग द्वारा नियंत्रित तीन स्तरों में व्यवस्थित हैं। प्रत्येक स्तर में नीचे के स्तर की सभी भाषाएँ शामिल हैं। Markdown हेडर को Module नोड्स के रूप में निकाला जाता है जिसमें पदानुक्रमित Contains किनारे होते हैं ताकि दस्तावेज़ संरचना स्रोत कोड के साथ ग्राफ़ क्वेरी में भाग ले सके।
Lite -- --no-default-features
हमेशा संकलित। सबसे लोकप्रिय भाषाओं के लिए सबसे छोटा बाइनरी, साथ ही Svelte और Astro (TypeScript एक्सट्रैक्टर के माध्यम से स्क्रिप्ट-ब्लॉक निष्कर्षण, कोई अतिरिक्त व्याकरण निर्भरता नहीं)।
| भाषा | एक्सटेंशन |
|---|---|
| Rust | .rs |
| Go | .go |
| Java | .java |
| Scala | .scala, .sc |
| TypeScript | .ts, .tsx |
| JavaScript | .js, .jsx |
| Python | .py |
| C | .c, .h |
| C++ | .cpp, .hpp, .cc, .cxx, .hh |
| Kotlin | .kt, .kts |
| C# | .cs |
| Swift | .swift |
| Svelte | .svelte |
| Astro | .astro |
Medium (Lite + 9 और) -- --features medium
| भाषा | एक्सटेंशन | फ़ीचर फ़्लैग |
|---|---|---|
| Dart | .dart | lang-dart |
| Pascal | .pas, .pp, .dpr | lang-pascal |
| PHP | .php | lang-php |
| Ruby (ERB और Slim टेम्पलेट्स सहित) | .rb, .rake, .erb, .slim | lang-ruby |
| Bash | .sh, .bash | lang-bash |
| Protobuf | .proto | lang-protobuf |
| PowerShell | .ps1, .psm1 | lang-powershell |
| Nix | .nix | lang-nix |
| VB.NET | .vb | lang-vbnet |
ERB और Slim टेम्पलेट्स Ruby व्याकरण का उपयोग करते हैं बिना इंडेक्सिंग समय पर Ruby या टेम्पलेट जेम्स की आवश्यकता के। टेम्पलेट कॉल फ़ाइल नोड से संबंधित होते हैं और अपनी मूल पंक्ति और बाइट कॉलम बनाए रखते हैं। ERB कोड/आउटपुट टैग, ट्रिम मार्कर, टिप्पणियाँ और एस्केप किए गए टैग का समर्थन करता है। Slim नियंत्रण/आउटपुट लाइनें, इंडेंटेशन-आधारित ब्लॉक, विशेषताएँ (बहु-पंक्ति विशेषता सूचियों सहित), टेक्स्ट इंटरपोलेशन और ruby: ब्लॉक का समर्थन करता है।
कस्टम Slim शॉर्टकट और एम्बेडेड-भाषा संकलन समर्थित नहीं हैं। रेंडर समय पर Rails द्वारा प्रदान किए गए Locals को बेयर हेल्पर कॉल से अलग नहीं किया जा सकता; टेम्पलेट में निर्दिष्ट या बाध्य नामों को रूढ़िवादी रूप से बाहर रखा गया है। कंट्रोलर-से-व्यू और आंशिक-रेंडर संबंधों के लिए अलग Rails सिमेंटिक वायरिंग की आवश्यकता होती है।
Full (Medium + बाकी सब) -- डिफ़ॉल्ट
| भाषा | एक्सटेंशन | फ़ीचर फ़्लैग |
|---|---|---|
| ActionScript | .as | lang-actionscript |
| Lua | .lua | lang-lua |
| Zig | .zig | lang-zig |
| Objective-C | .m, .mm | lang-objc |
| Perl | .pl, .pm | lang-perl |
| Batch/CMD | .bat, .cmd | lang-batch |
| Fortran | .f90, .f95, .f03, .f08, .f18, .f, .for | lang-fortran |
| COBOL | .cob, .cbl, .cpy | lang-cobol |
| MS BASIC 2.0 | .bas | lang-msbasic2 |
| GW-BASIC | .gw | lang-gwbasic |
| QBasic | .qb | lang-qbasic |
| QuickBASIC 4.5 | .bi, .bm | lang-qbasic |
| Dockerfile | Dockerfile, .dockerfile | lang-dockerfile |
| GLSL | .glsl, .vert, .frag, .comp | lang-glsl |
| Godot Shader | .gdshader, .gdshaderinc | lang-glsl |
| Minecraft Function | .mcfunction | lang-mcfunction |
| WGSL | .wgsl | lang-wgsl |
| HLSL | .hlsl, .fx | lang-hlsl |
| Verilog / SystemVerilog | .v, .vh, .sv, .svh | lang-systemverilog |
| VHDL | .vhd, .vhdl | lang-vhdl |
| Metal | .metal | lang-metal |
| CUDA / HIP | .cu, .cuh | lang-cuda |
| Markdown | .md, .markdown | lang-markdown |
| R | .r, .R | lang-r |
| SQL | .sql | lang-sql |
| Julia | .jl | lang-julia |
| Haskell | .hs, .lhs | lang-haskell |
| OCaml | .ml, .mli | lang-ocaml |
| Clojure | .clj, .cljs, .cljc | lang-clojure |
| Erlang | .erl, .hrl | lang-erlang |
| Elixir | .ex, .exs | lang-elixir |
| F# | .fs, .fsi, .fsx | lang-fsharp |
| F* | .fst, .fsti | lang-fstar |
| Quint | .qnt | lang-quint |
| Terraform | .tf, .tfvars | lang-terraform |
| TOML | .toml | lang-toml |
| Lean | .lean | lang-lean |
| HTML | .html, .htm | lang-html |
| CSS | .css | lang-css |
व्यक्तिगत भाषाओं को पूरे स्तर के बिना भी चुना जा सकता है:
cargo install tokensave --no-default-features --features lang-nix,lang-bash
सभी एक्सट्रैक्टर समान गहराई साझा करते हैं: फ़ंक्शन, क्लास, मेथड, फ़ील्ड, इम्पोर्ट, कॉल ग्राफ़, इनहेरिटेंस चेन, डॉकस्ट्रिंग, जटिलता मेट्रिक्स, डेकोरेटर/एनोटेशन निष्कर्षण और क्रॉस-फ़ाइल निर्भरता ट्रैकिंग।
HTML और CSS अपवाद हैं, क्योंकि किसी भी भाषा में कॉल करने योग्य प्रतीक नहीं होते। HTML उन तत्वों को रिकॉर्ड करता है जिनमें id होता है, कस्टम तत्व, और स्टाइलशीट और स्क्रिप्ट जो एक पृष्ठ खींचता है; CSS क्लास और id सेलेक्टर, कस्टम प्रॉपर्टी, @keyframes नाम और @import रिकॉर्ड करता है। कोई भी class="..." विशेषता को स्टाइलशीट नियम में हल नहीं करता: क्लास नाम सामान्य शब्द हैं, और उन्हें पूरे प्रोजेक्ट में बेयर नाम से मिलाना किनारों को खोजने के बजाय आविष्कार करता है।
tokensave बनाम CodeGraph
tokensave CodeGraph (Node.js/TypeScript) का एक ज़मीनी स्तर से Rust पुनर्लेखन है। दोनों AI कोडिंग एजेंटों के लिए सिमेंटिक कोड ग्राफ़ बनाते हैं, लेकिन वे दायरे और क्षमताओं में काफी भिन्न हैं।
| tokensave | CodeGraph | |
|---|---|---|
| रनटाइम | नेटिव बाइनरी (Rust) | Node.js 18+ |
| इंस्टॉल | brew install, cargo install, scoop install | npx @colbymchenry/codegraph |
| भाषाएँ | 50+ (3 स्तर: lite/medium/full) | 19+ |
| MCP टूल | 80+ | 9 |
| एजेंट एकीकरण | 12+ (Claude, Codex, Gemini, Qwen, OpenCode, Cursor, Cline, Copilot, Roo Code, Zed, Antigravity, Kilo, Kiro, Kimi, Vibe, Grok, OMP, Pi, Plank, Factory Droid) | 1 (Claude Code) |
| इंडेक्स ताज़गी | हर MCP कॉल पर ऑन-डिमांड स्टेलनेस जाँच; कनेक्ट पर कैच-अप सिंक; मल्टी-एजेंट कार्य git worktrees का उपयोग करने की उम्मीद | नेटिव OS-स्तरीय फ़ाइल वॉचर (FSEvents/inotify/ReadDirectoryChangesW, 2 s डेबाउंस); कनेक्ट पर कैच-अप सिंक |
| मल्टी-ब्रांच इंडेक्सिंग | हाँ, ऑप्ट-इन (प्रति-ब्रांच DB, क्रॉस-ब्रांच diff/search) | नहीं |
| जटिलता मेट्रिक्स | AST-निकाला गया (ब्रांच, लूप, नेस्टिंग गहराई, cyclomatic और संज्ञानात्मक जटिलता, Halstead, रखरखाव सूचकांक, CRAP) | नहीं |
| पोर्टिंग टूल | हाँ (port_status, port_order) | नहीं |
| ग्राफ़ विज़ुअलाइज़र | हटाया गया (v4.0.1) | हाँ |
| सिमेंटिक खोज | एजेंट-संचालित कीवर्ड विस्तार (शून्य-लागत) | स्थानीय एम्बेडिंग (nomic-embed-text-v1.5 ONNX के माध्यम से) |
| MCP संसाधन | 4 (status, files, overview, branches) | नहीं |
| MCP एनोटेशन | हाँ (readOnlyHint, alwaysLoad) | नहीं |
| मृत कोड पहचान | हाँ | नहीं |
| चक्रीय निर्भरता पहचान | हाँ | नहीं |
| प्रकार पदानुक्रम | हाँ | नहीं |
| God class / युग्मन विश्लेषण | हाँ | नहीं |
| कमिट / PR संदर्भ | हाँ | नहीं |
| परीक्षण मैपिंग | हाँ | नहीं |
| नाम बदलने का पूर्वावलोकन | हाँ | नहीं |
| टोकन ट्रैकिंग | प्रति-कॉल मेट्रिक्स, लाइव TUI मॉनिटर, सत्र + जीवनकाल काउंटर | नहीं |
| कोड-स्वास्थ्य विश्लेषण | समग्र स्कोर, Gini, निर्भरता गहराई, DSM, जोखिम-भारित परीक्षण अंतराल, सत्र डेल्टा | नहीं |
| संपादन प्रिमिटिव | 4 परमाणु लेखक (str_replace, multi_str_replace, insert_at, ast_grep_rewrite) स्वचालित पुनः-इंडेक्सिंग के साथ | नहीं |
| क्रैश लचीलापन | सबप्रोसेस-पृथक निष्कर्षण; नेटिव व्याकरण एबॉर्ट फ़ाइल को छोड़ देते हैं, सिंक जारी रहता है | नहीं |
| स्व-अपग्रेड | tokensave upgrade स्थिर/बीटा चैनलों के साथ | npm update |
| DB इंजन | libsql (SQLite फ़ोर्क, WAL, async) | better-sqlite3 / wa-sqlite (WASM) |
| इंडेक्सिंग गति | 1,782 फ़ाइलों के लिए ~1.2s | 1,782 फ़ाइलों के लिए ~4s |
| बाइनरी आकार | ~25 MB संपीड़ित डाउनलोड (सभी व्याकरण बंडल) | ~80 MB (node_modules + WASM) |
CodeGraph ने दृष्टिकोण का बीड़ा उठाया और यदि आप npm टूलिंग पसंद करते हैं और केवल Claude Code एकीकरण की आवश्यकता है तो यह एक ठोस विकल्प बना हुआ है। tokensave गहन विश्लेषण, अधिक एजेंट, मल्टी-ब्रांच समर्थन और बिना किसी रनटाइम निर्भरता के नेटिव बाइनरी के साथ अवधारणा का विस्तार करता है।
CodeGraph, Dual-Graph (GrapeRoot), code-review-graph और OpenWolf के खिलाफ विस्तृत तुलना के लिए, docs/COMPARABLE-TOOLS.md देखें।
साइड-बाय-साइड तुलना पृष्ठ (प्रत्येक बताता है कि दूसरा टूल कहाँ बेहतर है): Serena · code-review-graph · Graphify · CodeGraph · token-savior · GrapeRoot · LeanCTX · OpenWolf — इंडेक्स tokensave.dev/vs पर।
विकल्पों पर tokensave क्यों
कई टूल AI कोडिंग एजेंटों के लिए टोकन उपयोग कम करते हैं। यहाँ बताया गया है कि tokensave अलग क्यों खड़ा है।
एकल नेटिव बाइनरी, शून्य निर्भरताएँ
अधिकांश विकल्पों को रनटाइम की आवश्यकता होती है: Python, Node.js, या दोनों। tokensave सभी 50+ tree-sitter व्याकरण बंडल (~25 MB संपीड़ित डाउनलोड) के साथ एक एकल Rust बाइनरी के रूप में आता है। इंस्टॉल करने के लिए कुछ और नहीं -- और Serena जैसे LSP-समर्थित टूल के विपरीत, प्रति भाषा कोई भाषा सर्वर इंस्टॉल, शुरू या वार्म अप करने की आवश्यकता नहीं है। दो टूल अब पैकेजिंग पर tokensave से मेल खाते हैं: CodeGraph अपना स्वयं का रनटाइम बंडल करता है, और LeanCTX भी एक एकल Rust बाइनरी है।
सबसे गहरी कोड बुद्धिमत्ता
tokensave प्रतीक स्तर पर काम करता है: फ़ंक्शन, स्ट्रक्चर, फ़ील्ड, कॉल किनारे, प्रकार पदानुक्रम, जटिलता मेट्रिक्स। Dual-Graph (GrapeRoot) जैसे विकल्प फ़ाइल स्तर पर काम करते हैं -- वे जानते हैं कि कौन सी फ़ाइलें मौजूद हैं लेकिन "यह फ़ंक्शन कौन कॉल करता है?" या "यदि मैं यह स्ट्रक्चर बदलता हूँ तो क्या टूटता है?" का उत्तर नहीं दे सकते। tokensave के 80+ विशेष MCP टूल कॉल ग्राफ़ ट्रैवर्सल, प्रभाव विश्लेषण, मृत कोड पहचान, परीक्षण मैपिंग, नाम बदलने का पूर्वावलोकन, प्रकार पदानुक्रम, चक्रीय निर्भरता पहचान, जटिलता रैंकिंग, कोड-स्वास्थ्य विश्लेषण (Gini, DSM, निर्भरता गहराई, जोखिम-भारित परीक्षण अंतराल), परमाणु संपादन प्रिमिटिव और अधिक को कवर करते हैं। सबसे नज़दीकी तुलनीय ग्राफ़ टूल, code-review-graph, 30 उजागर करता है; कई अन्य जानबूझकर डिज़ाइन द्वारा 10 से कम उजागर करते हैं।
सबसे व्यापक एजेंट समर्थन
एक दर्जन से अधिक AI कोडिंग एजेंट एकीकरण, प्रत्येक एजेंट के लिए मूल कॉन्फ़िगरेशन प्रारूपों के साथ। कोई अन्य उपकरण इतने सारे एजेंटों को इतने गहरे एकीकरण के साथ कवर नहीं करता। Claude Code को हुक, प्रॉम्प्ट नियम और स्वतः-अनुमत टूल अनुमतियाँ मिलती हैं। Kiro को वैश्विक MCP कॉन्फ़िगरेशन, tokensave.md स्टीयरिंग एक संसाधन के रूप में लोड की गई, अनुमेय अंतर्निहित/tokensave टूल अनुमोदन के साथ एक प्रबंधित एजेंट, और प्रतिनिधिमंडल सुरक्षा रेलिंग के साथ-साथ पोस्ट-राइट सिंक के लिए हुक मिलते हैं। अन्य एजेंटों को उनके मूल कॉन्फ़िगरेशन प्रारूप में MCP सर्वर पंजीकरण मिलता है।
मल्टी-ब्रांच इंडेक्सिंग
इस क्षेत्र में एकमात्र उपकरण जिसमें वैकल्पिक प्रति-ब्रांच ग्राफ़ डेटाबेस और क्रॉस-ब्रांच डिफ़ और खोज है। सक्षम होने पर, ब्रांच स्विच करना तुरंत होता है -- कोई पुनः-इंडेक्सिंग आवश्यक नहीं है।
प्रति-कॉल टोकन ट्रैकिंग
एकमात्र उपकरण जो रिपोर्ट करता है कि प्रत्येक व्यक्तिगत MCP टूल कॉल ने कितने टोकन बचाए, साथ ही सभी परियोजनाओं में एक लाइव TUI मॉनिटर और आजीवन काउंटर।
पूरी तरह से ओपन सोर्स
MIT-लाइसेंस प्राप्त Rust, अंत से अंत तक ऑडिट योग्य। Dual-Graph का मुख्य इंजन (graperoot PyPI पर) मालिकाना है -- आप देख नहीं सकते कि यह आपके कोड ग्राफ़ के साथ क्या करता है। OpenWolf AGPL-3.0 है, जिसके लिए व्युत्पन्न कार्यों को ओपन-सोर्स होना आवश्यक है।
प्रदर्शन
1,782-फ़ाइल मिश्रित Rust/Java/Scala कोडबेस (57K नोड्स, 103K किनारे) पर पूर्ण-इंडेक्स बेंचमार्क:
| टूल | समय | गति |
|---|---|---|
| CodeGraph (TypeScript) | 31.2s | 1x |
| tokensave (Rust) | 1.2s | 26x |
समस्या निवारण
"tokensave आरंभीकृत नहीं"
.tokensave/ निर्देशिका आपके प्रोजेक्ट में मौजूद नहीं है।
tokensave init
MCP सर्वर कनेक्ट नहीं हो रहा
AI एजेंट tokensave टूल नहीं देखता है।
- सुनिश्चित करें कि एजेंट कॉन्फ़िगरेशन में tokensave MCP सर्वर शामिल है (
tokensave doctorचलाएँ) - एजेंट को पूरी तरह से पुनः आरंभ करें
- जाँचें कि
tokensaveआपके PATH में है:which tokensave
खोज में लापता प्रतीक
- इंडेक्स अपडेट करने के लिए
tokensave syncचलाएँ - जाँचें कि भाषा समर्थित है (ऊपर तालिका देखें)
- सत्यापित करें कि फ़ाइल
.gitignoreद्वारा बाहर नहीं की गई है
इंडेक्सिंग धीमी है
बड़ी परियोजनाओं को पहले पूर्ण इंडेक्स पर अधिक समय लगता है।
- बाद के रन वृद्धिशील सिंक का उपयोग करते हैं और बहुत तेज़ होते हैं
- दैनिक अपडेट के लिए
tokensave sync(न कि--force) का उपयोग करें - एजेंट कनेक्ट होने पर हर MCP टूल कॉल पर स्टेलनेस स्वचालित रूप से जाँची जाती है
विशिष्ट परियोजनाओं के लिए tokensave अक्षम करना
यदि कोई प्रोजेक्ट बहुत बड़ा है और tokensave बहुत अधिक RAM का उपयोग करता है, तो आप उसके वातावरण में TOKENSAVE_DISABLE_SERVER=true सेट करके प्रति-प्रोजेक्ट MCP सर्वर को अक्षम कर सकते हैं। सर्वर बिना आरंभीकरण के साफ-सुथरा बाहर निकलता है।
Claude Code -- अपने प्रोजेक्ट के .claude/settings.json में जोड़ें:
{
  "mcpServers": {
    "tokensave": {
      "command": "tokensave",
      "args": ["serve"],
      "env": {
        "TOKENSAVE_DISABLE_SERVER": "true"
      }
    }
  }
}
अन्य एजेंट -- पर्यावरण चर को उस कॉन्फ़िगरेशन में सेट करें जो आपका एजेंट MCP सर्वर लॉन्च करने के लिए उपयोग करता है।
आप इसे शेल के माध्यम से वैश्विक रूप से भी सेट कर सकते हैं (TOKENSAVE_DISABLE_SERVER=true claude), लेकिन यह सत्र में हर प्रोजेक्ट के लिए tokensave MCP सर्वर को अक्षम कर देता है।
DISABLE_TOKENSAVE=true इस चर को नामस्थानित करने से पहले बनाए गए कॉन्फ़िगरेशन के लिए एक अप्रचलित संगतता उपनाम के रूप में समर्थित रहता है।
उत्पत्ति
यह प्रोजेक्ट मूल CodeGraph TypeScript कार्यान्वयन का एक Rust पोर्ट है जो @colbymchenry द्वारा है। पोर्ट समान आर्किटेक्चर और MCP टूल इंटरफ़ेस बनाए रखता है जबकि प्रदर्शन और मूल tree-sitter बाइंडिंग के लिए Rust का लाभ उठाता है।
निर्माण
cargo build --locked --release                          # full (50+ languages, default)
cargo build --locked --release --features medium        # medium tier
cargo build --locked --release --no-default-features    # lite (smallest binary)

cargo test --workspace --locked                         # run all tests (requires full)
cargo check --locked --no-default-features              # verify lite compiles
cargo clippy --workspace --all-targets --locked
विकास कमांड डिबग बिल्ड का उपयोग करते हैं; स्थापना केवल अनुकूलित रिलीज़ आउटपुट का उपयोग करती है (cargo install --path . --locked)। target/debug कभी भी स्थापना इनपुट नहीं है।
स्टार इतिहास

प्रायोजक
| Windows पर मुफ्त कोड हस्ताक्षर SignPath.io द्वारा प्रदान किया गया, प्रमाणपत्र SignPath Foundation द्वारा |
लाइसेंस
MIT लाइसेंस -- विवरण के लिए LICENSE देखें।