Lexicon
Un léxico personal para voz-a-agentes. Un archivo YAML con las palabras que el reconocimiento de voz falla, aplicado en todos los lugares donde tu voz llega: MCP, Claude Code, el navegador, macOS.
Documentación
Lexicon
Un léxico personal para voz-a-agentes.
Un archivo YAML con las palabras que el reconocimiento de voz falla, aplicado en todos los lugares donde tu voz llega: MCP, Claude Code, el navegador, macOS.


Demo en vivo · Inicio rápido · Documentación · lexicon.ashlr.ai
You said:        "tell Ashlr.AI to deploy the Kubernetes auth service"
STT heard:       "tell Ashler to deploy the Cooper Nettie's off service"
Agent received:  "tell Ashlr.AI to deploy the Kubernetes auth service"
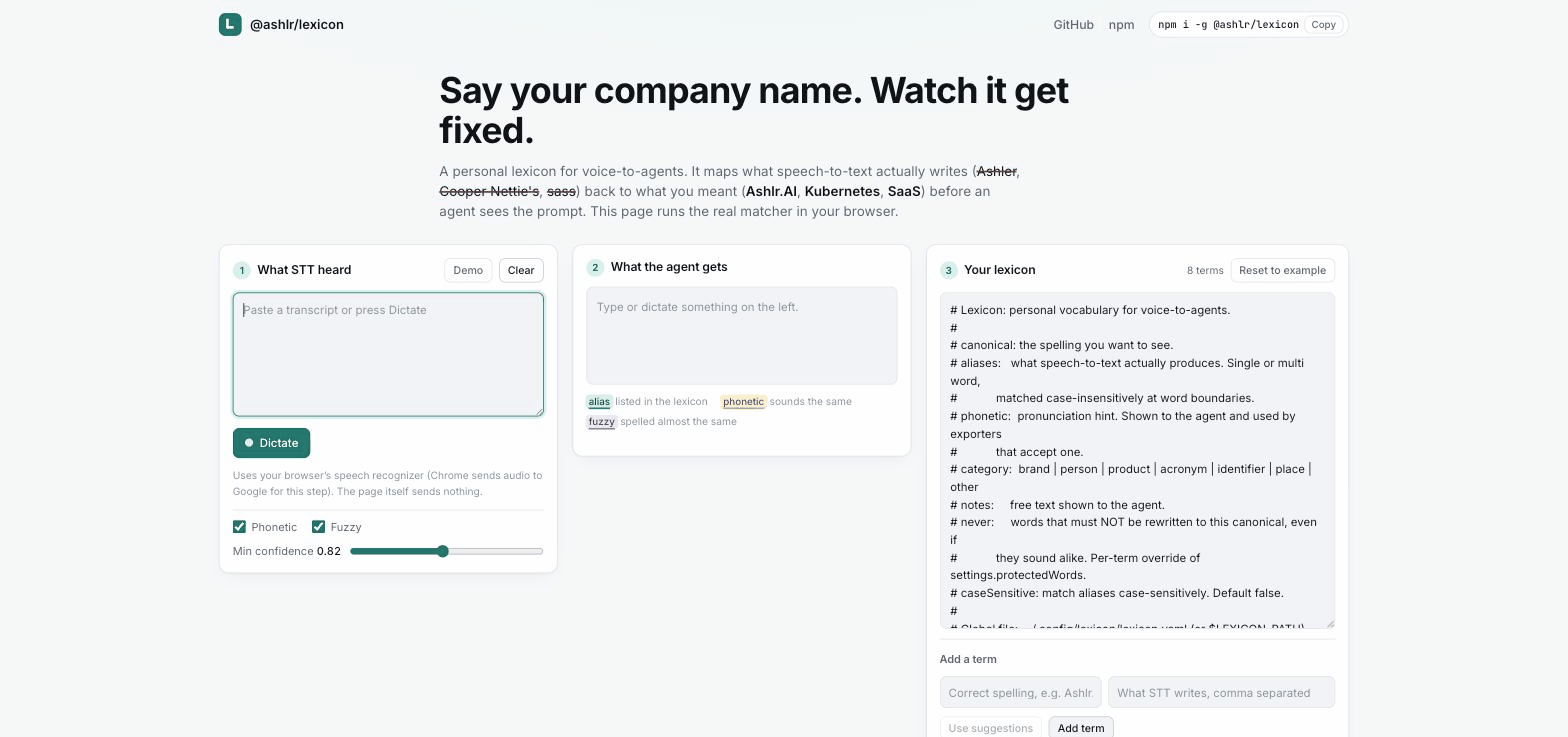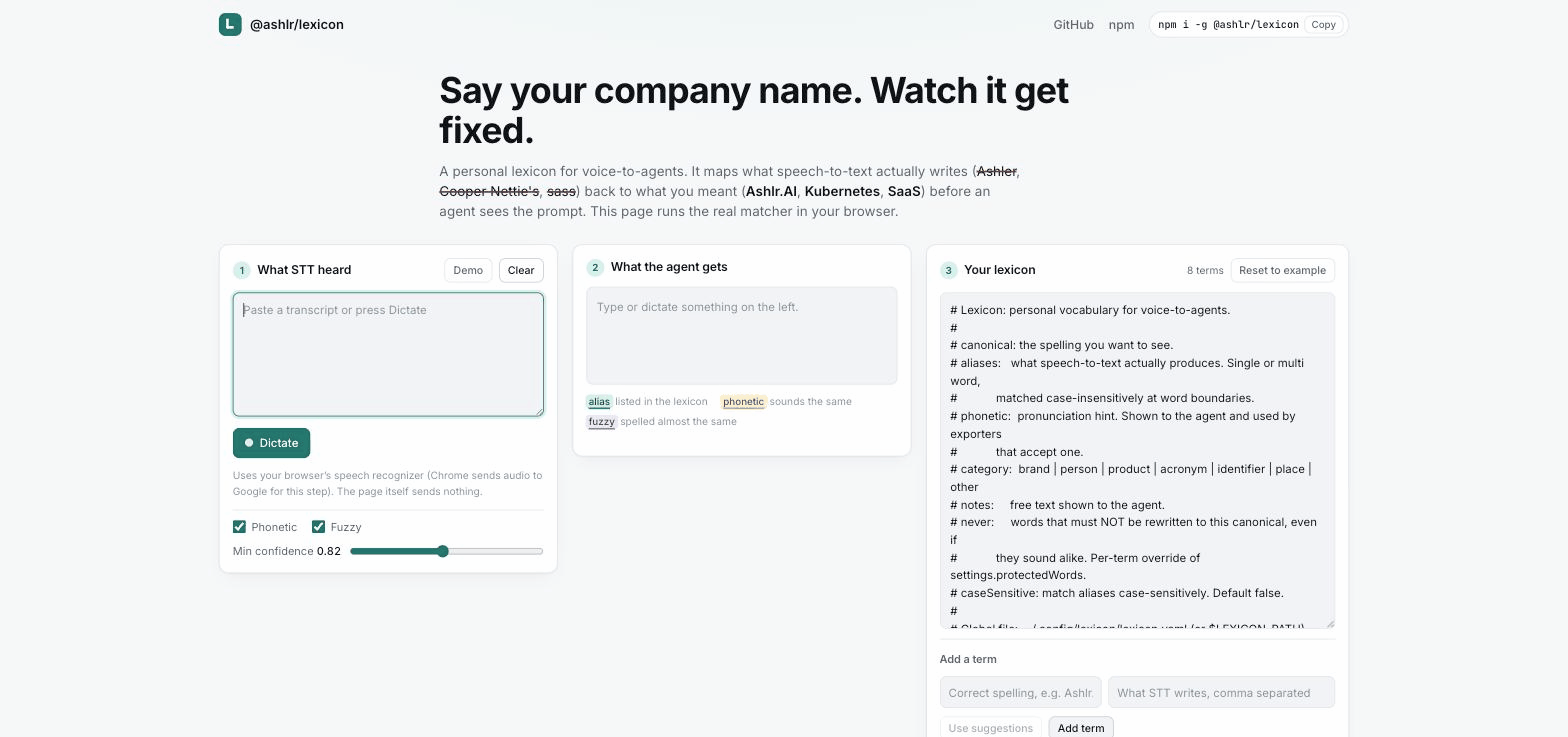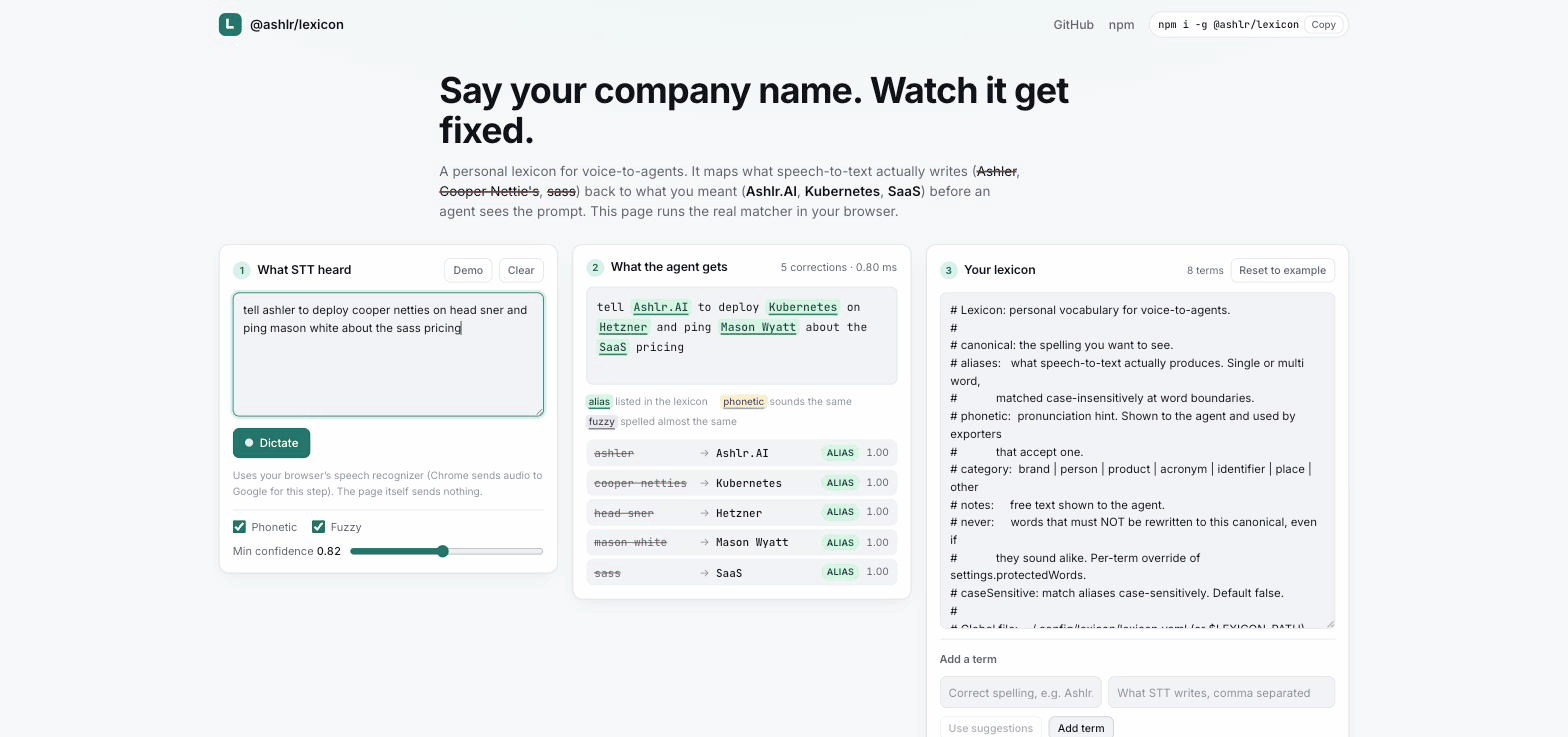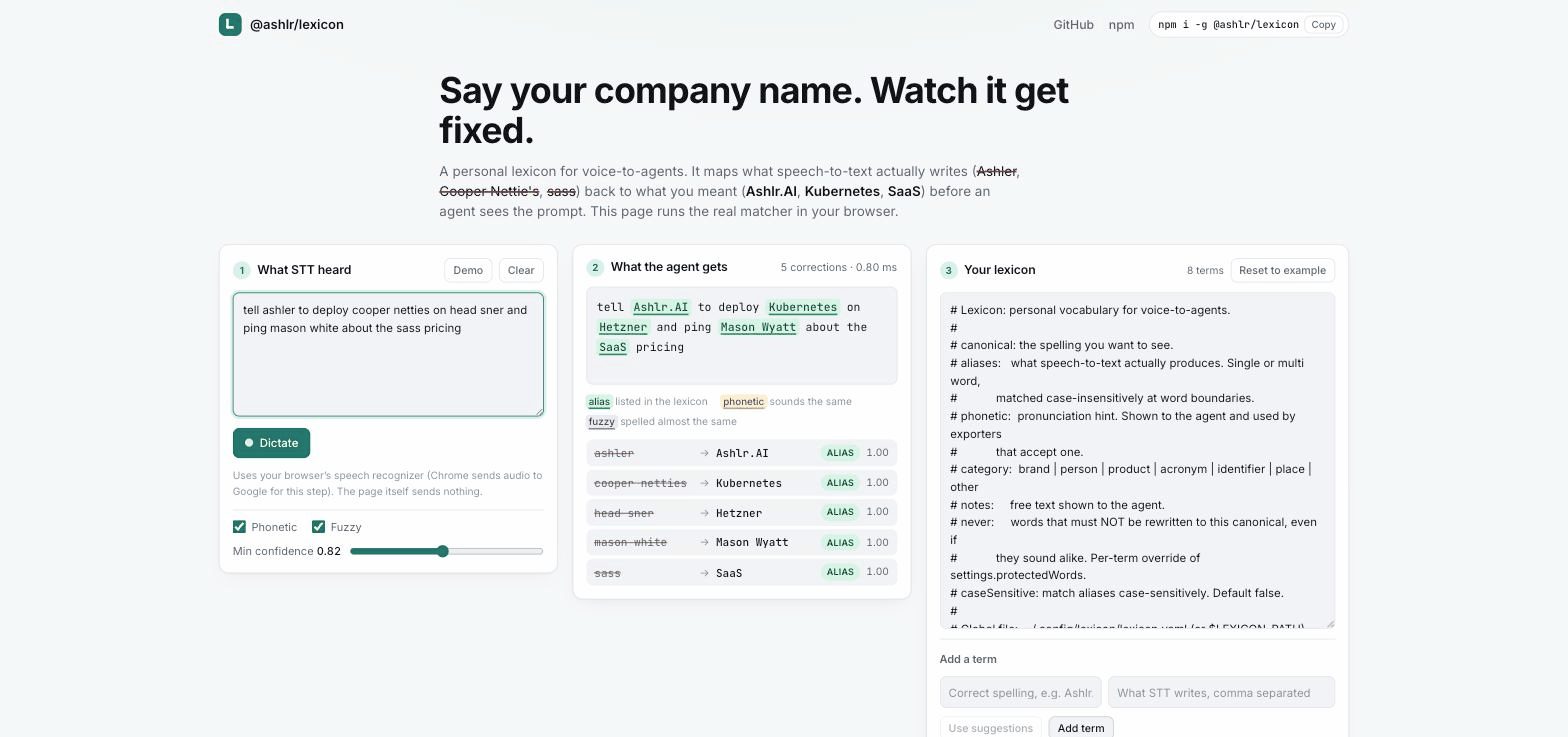
Esa es la demo en vivo que ejecuta el matcher real de este repositorio en tu texto, en tu navegador, sin instalar nada. (Su botón Dictate usa el reconocedor de voz de tu navegador, que en Chrome envía audio a Google.)
Medido
El método, las tablas completas y cada caso fallido están en docs/BENCHMARK.md. Reproduce con npm run bench (sin configuración más allá de un clon), o npm run bench:audio && npm run bench:compare (necesita macOS y whisper.cpp).
Contra las alternativas. 330 clips de audio real a través de whisper.cpp small.en, tres voces. Mismo audio, mismo reconocedor, mismo léxico de 70 términos en cada fila; lo único que cambia es cómo se corrigen los nombres propios.
| cómo se corrigen las palabras | nombres propios recuperados | prosa limpia cambiada erróneamente |
|---|---|---|
| nada, whisper.cpp crudo | 45.9% | n/a, nada se ejecuta |
| sustitución exacta de cadenas, el enfoque de Reemplazo de Texto de macOS | 62.0% | 0 de 72 |
| lo mismo, más una regla de mayúsculas por término | 71.3% | 0 de 72 |
la propia lista de sugerencias --prompt de whisper.cpp | 76.0% | n/a, nada se ejecuta |
| Lexicon | 91.0% | 0 de 72 |
Cada fila usa el mismo léxico curado de setenta términos (bench/lexicon.yaml). La columna de prosa es una propiedad de los términos en el archivo tanto como del matcher, así que un léxico ensamblado de otra manera es una medición diferente.
La sustitución exacta recupera las ortografías que alguien ya escribió, y nada más. No puede alcanzar Versal, Superbase, CloudFloor o pedantic, porque ninguna tabla escrita a mano contiene el error que aún no has escuchado. Los niveles fonético y difuso existen para esa brecha y recuperan 31 de los 279 espacios de términos por sí solos, lo que son 11 puntos. Los 9 puntos restantes sobre la fila con reglas de mayúsculas provienen de la tolerancia del nivel de alias a cómo el reconocedor divide un nombre en palabras, ya que esa fila ya coincide en mayúsculas. --prompt es un complemento más que un rival: apilado con el léxico alcanza 95.7%.
Dos notas honestas sobre esa tabla. whisper.cpp crudo no puede cambiar erróneamente la prosa porque nada se ejecuta, lo cual es la ausencia de la función más que una ventaja. --prompt no es el mismo caso: sesga el propio reconocedor, así que lo que cambia ya está en la transcripción antes de que comience la puntuación, mientras que la métrica cuenta oraciones que un paso posterior alteró. Esa celda no está medida más que cero. Saber hacia dónde va implicaría comparar transcripciones con avisos contra las que no los tienen, lo cual este arnés no hace.
Antes y después.
| corpus | nombres propios recuperados, STT crudo | después del léxico | prosa limpia cambiada erróneamente |
|---|---|---|---|
| audio real, whisper.cpp base.en (330 clips) | 41.9% | 82.8% | 0 de 72 |
| audio real, whisper.cpp small.en con avisos de sugerencia | 76.0% | 95.7% | 0 de 72 |
| errores STT sintéticos (402 oraciones, 70 términos) | 5.1% | 96.5% | 0 de 95 |
La latencia es de aproximadamente 0.3 ms por oración. Las filas de audio real usan texto-a-voz de macOS leído en whisper.cpp, así que son más limpias que un micrófono de teléfono.
El 5.1% sintético no es una afirmación de que el reconocimiento de voz acierta el 5% de los nombres propios en general. Cada oración en ese corpus fue escrita para contener un error de audición, así que 5.1% es solo el puñado que salió bien de todos modos. El número "antes" honesto es el de audio real, 41.9%.
La última columna cuenta solo prosa ordinaria. Cada corpus también contiene oraciones construidas deliberadamente para tropezar al matcher (un "llama" desnudo junto a un término de Ollama, sonidos similares, tramos de código), marcadas expected-hard; con esos incluidos, la tasa de falsos positivos es 15.3% (19 de 124) sintético y 16.7% (15 de 90) en audio. Ambos números, y cada caso fallido, están en docs/BENCHMARK.md.
Instalar
El paquete es @ashlr/lexicon; el comando es lexicon.
curl -fsSL https://ashlrai.github.io/lexicon/install.sh | sh   # CLI + the setup wizard
brew install ashlrai/tap/lexicon                               # or Homebrew (macOS, Linux)
npm i -g @ashlr/lexicon                                        # or npm (Node 20+)
Luego abre Claude Code y di una oración con el nombre de tu empresa. Listo.
El script de instalación ejecuta lexicon setup por ti (LEXICON_NO_SETUP=1 lo omite); después de una instalación de Homebrew o npm, ejecútalo tú mismo. Cada paso es opcional y seguro de repetir, y lexicon setup --dry-run no escribe nada mientras describe la ejecución que obtendrías del mismo comando sin él: los pasos que realizaría, y los que detendría y preguntaría, con la respuesta que presionar Enter da a cada uno.
Con Homebrew, usa siempre el nombre completo del tap ashlrai/tap/lexicon. El simple brew install lexicon instala dns-lexicon, una herramienta DNS no relacionada en homebrew-core.
Lo que configuración de lexicon hace, en siete pasos numerados
- Siembra el léxico con tu nombre y tu empresa, con los errores ortográficos que STT producirá para cada uno.
- Ofrece los paquetes iniciales como una lista de verificación.
- Cosecha el repositorio actual en busca de nombres ya en tu código.
- Registra el servidor MCP y los hooks en cada cliente de agente que detecta.
- Instala la API local como un servicio de inicio de sesión.
- Exporta a tu aplicación de dictado.
- Dicta una oración construida a partir de los términos que acaba de sembrar, y te muestra la corrección.
El recorrido completo, con la salida real del terminal, está en docs/QUICKSTART.md.
O salta el asistente y añade un término a mano. El primer argumento es la ortografía canónica, el resto es lo que STT realmente produce:
lexicon add Ashlr.AI Ashler Ashlar "Ashler AI" --phonetic ASH-ler
lexicon normalize "tell Ashler to ship it"
# tell Ashlr.AI to ship it
Plugin de Claude Code, si prefieres no instalar un CLI en absoluto. Sin paso de instalación de Node, sin compilación:
claude plugin marketplace add ashlrai/lexicon
claude plugin install lexicon@ashlrai
lexicon doctor verifica la instalación. No hay telemetría y todo el estado son archivos locales: el CLI, los hooks, el servidor MCP, la API local y la extensión no hacen ninguna solicitud más allá de loopback. La única solicitud saliente en el código base es lexicon voice descargando un modelo whisper en el primer uso. El script de instalación, npm y Homebrew descargan el paquete en sí. Ver SECURITY.md.
Por qué
El reconocimiento de voz tiene aproximadamente un 95% de precisión en inglés ordinario y mucho peor en nombres inventados. En el benchmark anterior, whisper.cpp base.en crudo transcribió 117 de 279 nombres propios dictados correctamente. "Ashlr.AI" se convierte en "Ashler", "Kubernetes" en "Cooper Nettie's", "SaaS" en "sauce", "auth" en "off". Esas son exactamente las palabras que un agente necesita acertar.
Las aplicaciones de dictado (Wispr Flow, Superwhisper, Aqua) cada una mantiene su propio diccionario y ninguna lo comparte. Los agentes (Claude Code /voice, voz de ChatGPT, Codex, Whisper local) ejecutan su propio reconocedor sin vocabulario de usuario en absoluto. Esta es la capa portátil en el medio: las correcciones ocurren después de STT y antes del modelo, dondequiera que pase el texto.
Esto no es una aplicación de dictado. Se sitúa entre cualquier dictado que ya uses y cualquier agente con el que hables. La investigación detrás de esa decisión, incluidos los criterios de eliminación, está en docs/RESEARCH.md.
Lo que obtienes
- Diecinueve herramientas MCP, dos recursos y dos avisos, para Claude Code, Codex, Cursor, Windsurf, Gemini CLI, VS Code y Claude Desktop. Tu agente puede ejecutar su propia configuración:
setup_lexicon,lexicon_doctor,install_client,trust_project,import_dictionaryysuggest_termssignifican "configura mi léxico" funciona sin un terminal. Las herramientas que cambian tu máquina se previsualizan primero:setup_lexiconyinstall_clientdevuelven un plan y no escriben nada hasta que el agente pasaapply: true,trust_projectmuestra los términos del archivo antes de fijarlo, yimport_dictionarytomadryRun. - Un plugin de Claude Code: servidor MCP, hooks
SessionStartyUserPromptSubmit, una habilidadlexicony un comando/lexicon. Se instala desde el marketplace de este repositorio sin paso de compilación. - Un CLI con 25 comandos, desde
lexicon addhastalexicon voice. - 155 términos iniciales en cuatro paquetes (desarrollador, IA, negocios, herramientas de voz), un comando cada uno.
- Quince formatos de exportación (Wispr Flow, Superwhisper, Reemplazo de Texto de macOS, espanso, avisos de Whisper y OpenAI, Deepgram, AssemblyAI, Azure, Google, CLAUDE.md, markdown, texto, CSV, JSON) y siete importadores para el diccionario que ya entrenaste.
- Cosecha de repositorios, aprendizaje de correcciones ("es Ashlr.AI no Ashler"), estadísticas de uso, sugerencias extraídas de tu historial de voz, y una puerta de confianza para léxicos de proyecto.
- Una biblioteca simple.
normalize()es una función pura: texto más léxico de entrada, texto corregido y una lista de reemplazos de salida.
Dónde se aplica
| Superficie | Cómo | Documentación |
|---|---|---|
| Claude Code | Plugin, o servidor MCP más dos hooks que corrigen el aviso antes de que el modelo lo lea | CLIENTS.md |
| Codex, Cursor, Windsurf, Gemini CLI, VS Code, Claude Desktop | lexicon install <client> --apply registra el servidor MCP | CLIENTS.md |
| Cualquier cliente MCP | servidor stdio, diecinueve herramientas | MCP.md |
| ChatGPT, Claude.ai, Grok, Gemini, Perplexity, Poe, Copilot | Extensión de navegador: reescribe el compositor cuando presionas enviar | EXTENSION.md |
| Cualquier aplicación macOS, cualquier herramienta de dictado | Aplicación de barra de menú LexiconBar: reescribe texto dictado en el campo enfocado a través de Accesibilidad, con una burbuja de deshacer | MACOS-APP.md |
| Shortcuts, Raycast, scripts, tu propia aplicación | lexicon serve: API HTTP de loopback en 127.0.0.1:41733 detrás de un token portador | LOCAL-API.md |
| Dictado sin una aplicación de dictado | lexicon voice: ffmpeg graba, whisper.cpp transcribe con tus canónicos como avisos de sugerencia, el léxico corrige | VOICE.md |
| Cualquier campo de texto, cualquier SO | lexicon daemon --once --paste en una tecla de acceso rápido | DAEMON.md |
| Wispr Flow, Superwhisper, Reemplazo de Texto de macOS, espanso, Deepgram, Azure, Google | Exporta a sus propios diccionarios y parámetros de sesgo | EXPORTS.md |
| Tu propio pipeline de STT | npm i @ashlr/lexicon, llama a normalize() entre la transcripción y el modelo | LIBRARY.md |
| Cualquiera de los anteriores, en Windows o Linux | Qué superficies se prueban en CI en cada SO, cuáles funcionan pero nunca se han ejecutado en hardware real, y cuáles no están allí en absoluto | PLATFORMS.md |
Cómo funciona
Tres niveles sobre ventanas de tokens: alias exacto primero, luego fonético doble-metáfono, luego difuso Damerau-Levenshtein por encima de un umbral de confianza. Los aciertos exactos ganan el tramo; los emparejamientos nunca se superponen. Una lista de parada de aproximadamente 3400 palabras comunes en inglés, listas never por término, y (con el skipCode predeterminado) tramos de código, URLs, correos electrónicos, rutas y identificadores pegados están todos fuera de límites. Es por eso que cero oraciones limpias cambiaron en el benchmark. Cada reemplazo informa su reason y confidence.
lexicon normalize --diff "deploy to head sner with cuban eatties"
# stderr:  "head sner" -> "Hetzner" (alias, 1.00)
#          "cuban eatties" -> "Kubernetes" (phonetic, 0.86)
# stdout:  deploy to Hetzner with Kubernetes
Las reglas completas, incluida cada protección, están en docs/MATCHING.md.
Documentación
El índice completo está en docs/, agrupado por tarea: comienza, úsalo con tu cliente, entiende cómo funciona, contribuye, internos. Las tres páginas que la mayoría de la gente necesita:
| Página | Qué cubre |
|---|---|
| QUICKSTART.md | Cinco minutos de nada a correcciones en Claude Code, con lo que cada paso de configuración escribe |
| CLIENTS.md | Instalación en Claude Code (plugin, hooks, sin cabeza) y cada otro cliente de agente |
| FAQ.md | Las preguntas que la gente hace antes de instalar |
| ¿Escribiendo un agente que instala esto para alguien? docs/AGENTS.md está escrito | |
| para ti. ¿Cambiando el código? Comienza en CONTRIBUTING.md y | |
| docs/ARCHITECTURE.md. |
También en la raíz: SECURITY.md, CODE_OF_CONDUCT.md, CHANGELOG.md.
Descargas
Cada release de GitHub adjunta la extensión del navegador para Chrome/Edge/Brave y para Firefox, LexiconBar.app.zip para macOS, el tarball de npm para instalaciones sin conexión, y SHA256SUMS. La fórmula de Homebrew vive en ashlrai/homebrew-tap; npm i -g github:ashlrai/lexicon#v0.5.4 instala una etiqueta directamente desde GitHub y compila durante la instalación.
Hoja de ruta y no-objetivos
No-objetivos: esto no es una aplicación de dictado, y no hay cuentas alojadas ni servicio de sincronización. Es un archivo.
- Listados en Chrome Web Store y Firefox AMO para la extensión. Hoy se instala desde el zip de la release.
- Aplicación macOS notarizada. LexiconBar está firmada ad-hoc, por lo que el primer lanzamiento necesita clic derecho y Abrir.
- Aplicación de bandeja para Linux con las mismas acciones de push-to-talk y corregir portapapeles. La de Windows está construida: ver docs/WINDOWS-APP.md.
- Fonética no inglesa. El doble metaphone está ajustado para inglés; los nombres en otros idiomas recurren a coincidencia difusa.
- Benchmark con micrófono real. El corpus de audio es texto a voz de macOS leído en whisper.cpp, no habla grabada.
Contribuir
Las buenas primeras issues están etiquetadas y delimitadas: un paquete de inicio nuevo, un exportador, un importador, una fuente de recopilación. CONTRIBUTING.md tiene la configuración, el diseño de pruebas y una receta para cada una.
¿Encontraste un nombre que lo dice mal? Abre una issue de término mal escuchado.
Licencia
MIT. Copyright 2026 AshlrAI, Inc.