tokensave
官方使用語意程式碼智能強化您的代理,並在此過程中
你可以用 Tokensave MCP 做什麼?
- 語意化程式碼搜尋 — 讓您的助理依含義尋找程式碼,例如在單一查詢中定位橫跨
login、validateToken與AuthService的驗證邏輯。 - 編輯前的影響分析 — 追蹤任何符號的呼叫者、被呼叫者及完整影響範圍,在變更前確切知道哪些部分會受影響。
- 跨分支程式碼比對 — 比較兩個分支之間的程式碼圖,查看新增、移除或變更的符號,無需切換您的 checkout。
- 持久化工作階段記憶 — 使用
tokensave_record_decision與tokensave_record_code_area儲存設計決策與程式碼區域,並在未來工作階段中透過tokensave_session_recall喚回。 - 原子化程式碼編輯 — 套用唯一錨點字串替換,或在精確位置插入程式碼,無需正規表示式或 shell 引號轉義的風險,並在寫入後自動重新建立索引。
文件
AI 程式碼代理的語意程式碼智慧
更少 token • 更少工具呼叫 • 100% 本機執行




為什麼選擇 tokensave?
AI 程式碼代理在探索程式碼庫時浪費大量 token。每一次 grep、glob 和檔案讀取都要花錢。在複雜任務中,代理會衍生多個 Explore 子代理,只為了建立上下文就掃描數百個檔案。
tokensave 為代理提供預先索引的語意知識圖譜。 代理不需要掃描檔案,而是查詢圖譜並立即獲得結構化的答案——正確的符號、它們之間的關係以及原始碼,一次呼叫全部搞定。
運作方式
┌──────────────────────────────────────────────────────────────┐
│  AI Coding Agent (Claude Code, Codex, Gemini, Cursor, ...)   │
│                                                              │
│  "Implement user authentication"                             │
│        │                                                     │
│        ▼                                                     │
│  ┌─────────────────┐       ┌─────────────────┐               │
│  │  Sub-agent      │ ───── │  Sub-agent      │               │
│  └────────┬────────┘       └─────────┬───────┘               │
└───────────┼──────────────────────────┼───────────────────────┘
            │                          │
            ▼                          ▼
┌──────────────────────────────────────────────────────────────┐
│  tokensave MCP Server                                        │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐           │
│  │   Search    │  │   Callers   │  │   Context   │           │
│  │   "auth"    │  │  "login()"  │  │   for task  │           │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘           │
│         └────────────────┼────────────────┘                  │
│                          ▼                                   │
│              ┌───────────────────────┐                       │
│              │   libSQL Graph DB     │                       │
│              │   • Instant lookups   │                       │
│              │   • FTS5 search       │                       │
│              └───────────────────────┘                       │
└──────────────────────────────────────────────────────────────┘
沒有 tokensave: 代理使用 grep、glob 和 Read 掃描檔案——大量 API 呼叫、高 token 用量。
使用 tokensave: 代理透過 MCP 工具查詢圖譜——即時結果、本機處理、更少 token。
主要功能
| 智慧上下文建構 | 語意搜尋 | 影響分析 |
| 一次工具呼叫即回傳代理所需的一切——進入點、相關符號和程式碼片段。 | 依意義而非純文字尋找程式碼。搜尋「authentication」即可找到 login、validateToken、AuthService。 | 在變更之前確切知道什麼會壞掉。追蹤呼叫者、被呼叫者以及任何符號的完整影響範圍。 |
| 80+ 個 MCP 工具 | 50+ 種語言 | 12+ 種代理整合 |
| 從呼叫圖遍歷到死碼偵測、原子編輯原語、程式碼健康度指標、測試對應和複雜度分析。 | Rust、Go、Java、Python、TypeScript、C、C++、Swift、Svelte、Astro,以及另外 43 種,包括 WGSL/HLSL/Metal 著色器、CUDA/HIP 和 Markdown。三個層級(lite/medium/full)控制二進位檔大小。 | Claude Code、Codex CLI、Gemini CLI、Qwen Code、Kiro、Cursor、OpenCode、Copilot、Cline、Roo Code、Zed、Antigravity、Kilo CLI、Kimi CLI、Mistral Vibe、Grok Build、Factory Droid、OMP、Pi、Plank。 |
| 多分支索引(選擇性啟用) | 100% 本機執行 | 永遠最新 |
| 可選的每分支資料庫。無需切換 checkout 即可進行跨分支差異比對和搜尋。 | 沒有資料離開你的機器。不需要 API 金鑰。不需要外部服務。一切都在本機 libSQL 資料庫上執行。 | 每次 MCP 呼叫都進行隨需的過期檢查(30 秒冷卻時間),加上伺服器連線時的追趕同步。多代理工作預期使用 git worktrees——每個代理有自己的 checkout,索引分歧由 git 合併,而非檔案監看器。 |
| 子程序隔離的萃取 | 程式碼健康度分析 | 原子編輯原語 |
| 任何 tree-sitter 文法中的原生崩潰(abort、segfault 等)只會終止該 worker;池會重新產生它並繼續同步。同步絕不會因格式錯誤的檔案而中止。 | 綜合健康度分數(0-10000)、Gini 不平等係數、檔案 DAG 深度、設計結構矩陣、風險加權測試缺口和 session 差異。 | 無需 regex 或 shell 引號轉義風險即可編輯檔案:唯一錨點 str_replace、原子多重取代、AST 重寫、錨定插入。寫入後自動重新索引。 |
快速開始
1. 安裝
Homebrew(macOS):
brew install aovestdipaperino/tap/tokensave
Scoop(Windows):
scoop bucket add tokensave https://github.com/aovestdipaperino/scoop-bucket
scoop install tokensave
Cargo / cargo-binstall(任何平台):
# Fast install prebuilt binary without compiling:
cargo binstall tokensave

# Or compile from source:
cargo install tokensave                          # full (50+ languages, default)
cargo install tokensave --features medium        # medium tier
cargo install tokensave --no-default-features    # lite (smallest binary)
預編譯二進位檔(Linux、Windows、macOS):
從最新版本下載,並將二進位檔放入你的 PATH。
| 平台 | 封存檔 |
|---|---|
| macOS(Apple Silicon) | tokensave-vX.Y.Z-aarch64-macos.tar.gz |
| Linux(x86_64) | tokensave-vX.Y.Z-x86_64-linux.tar.gz |
| Linux(ARM64) | tokensave-vX.Y.Z-aarch64-linux.tar.gz |
| Windows(x86_64) | tokensave-vX.Y.Z-x86_64-windows.zip |
2. 設定你的代理
tokensave install                         # auto-detects installed agents
tokensave install --agent antigravity     # Google Antigravity (formerly Windsurf)
tokensave install --agent auggie          # AugmentCode
tokensave install --agent claude          # Claude Code
tokensave install --agent cline           # Cline
tokensave install --agent codex           # OpenAI Codex CLI
tokensave install --agent copilot         # GitHub Copilot
tokensave install --agent cursor          # Cursor
tokensave install --agent droid           # Factory Droid
tokensave install --agent gemini          # Gemini CLI
tokensave install --agent kilo            # Kilo CLI
tokensave install --agent kiro            # AWS Kiro
tokensave install --agent kimi            # Moonshot Kimi CLI
tokensave install --agent omp             # Oh My Pi (OMP)
tokensave install --agent opencode        # OpenCode
tokensave install --agent pi              # Pi (pi.dev)
tokensave install --agent plank           # Plank (macOS only)
tokensave install --agent qwen            # Qwen Code
tokensave install --agent roo-code        # Roo Code
tokensave install --agent vibe            # Mistral Vibe
tokensave install --agent zed             # Zed
tokensave install --agent grok            # Grok Build (xAI)
tokensave install --git-hook yes           # auto-install the global post-commit and post-checkout hooks (no prompt)
tokensave install --git-hook no            # skip the post-commit and post-checkout hooks (no prompt)
tokensave githooks                         # show which global git hooks tokensave owns
tokensave githooks off                     # remove them, leaving any hook content you wrote
每個代理都會以原生設定格式註冊其 MCP 伺服器。Claude Code 額外獲得 PreToolUse hook(阻擋浪費資源的 Explore 代理)、UserPromptSubmit hook、Stop hook、CLAUDE.md 中的提示規則,以及自動允許的工具權限。Kiro 獲得全域 MCP 設定、以資源載入的 tokensave.md 導向,以及 tokensave 管理的預設代理,具備寬鬆的內建/tokensave 工具核准、委派防護 hook 和寫入後同步;使用者管理的 Kiro 代理會被保留。
全域 OMP 安裝會以裸 omp config path 回報的設定檔為目標,寫入 <resolved-agent-dir>/mcp.json 和 <resolved-agent-dir>/rules/tokensave.md。安裝到具名設定檔時,匯出 OMP_PROFILE 或 OMP 相容的 PI_PROFILE;OMP 的解析器也會遵循 PI_CONFIG_DIR 和 PI_CODING_AGENT_DIR。Tokensave 信任該原生解析器,而非重複 OMP 的設定檔邏輯。Tokensave 為 OMP 安裝 MCP 和建議規則;它不安裝 OMP hook 強制執行。
所有變更都是冪等的——升級後再次執行是安全的。代理設定完成後,系統會提供你全域 git post-commit 和 post-checkout hooks。tokensave uninstall 會移除這些 hooks 以及代理整合;傳入 --keep-git-hooks 可保留它們,或使用 tokensave githooks 自行管理。
一次安裝多個代理
重複 --agent 可在單次執行中安裝多個代理。無論你列出多少代理,權限授予、git hook 提議和全域設定寫入都只會各發生一次:
tokensave install --agent claude --agent cursor --agent droid
專案本機安裝
預設情況下,tokensave install 會在你的全域代理設定(例如 ~/.claude.json)中註冊 MCP 伺服器。若要僅為目前專案註冊 tokensave,請加上 --local:
tokensave install --local --agent claude
tokensave install --local --agent omp
這會寫入專案範圍的設定,你可以提交並與團隊分享。對 Claude 而言,那是 ./.mcp.json、./.claude/settings.json 和 ./CLAUDE.md;OMP 使用 ./.omp/mcp.json 和 ./.omp/rules/tokensave.md,不會呼叫 OMP CLI。支援的代理:claude、cursor、droid、gemini、zed、opencode、roo-code、kiro、auggie、omp、plank(每個都會寫入自己的專案檔案,例如 plank 的 .cursor/mcp.json、.factory/mcp.json、.gemini/settings.json、.zed/settings.json、opencode.json、.roo/mcp.json、.kiro/settings/mcp.json、.augment/settings.json、.omp/mcp.json、.mcp.json)。其他代理沒有專案範圍的設定,會以 --local 回報錯誤。
使用 tokensave uninstall --local 移除專案本機安裝。
3. 索引你的專案
cd /path/to/your/project
tokensave init
這會建立一個包含知識圖譜資料庫的 .tokensave/ 目錄。初始化和同步是分開的命令:init 是每個專案的一次性選擇性啟用,而 sync 只更新已初始化的專案。這可防止全域 git hooks 在你從未打算索引的儲存庫中默默建立資料庫。在 init 之後,使用 tokensave sync 進行增量更新——只有變更的檔案會被重新索引。
安裝會為 Claude Code 寫入什麼
MCP 伺服器
{
  "mcpServers": {
    "tokensave": {
      "command": "/path/to/tokensave",
      "args": ["serve"]
    }
  }
}
PreToolUse hook
該 hook 執行 tokensave hook-pre-tool-use——一個原生 Rust 命令(不需要 bash 或 jq)。它攔截 Agent、Grep、Glob 和 Bash 工具呼叫:Explore 代理會被直接阻擋,符號形狀的 grep/rg/ag 呼叫(純識別字、交替、\b 包圍的名稱)會被重新導向到相符的 tokensave MCP 工具,而程式碼副檔名的路徑形狀探索(Glob、find -name、fd --extension)會被重新導向到 tokensave_files。Regex 模式、git grep、管道命令、非程式碼副檔名、索引外的搜尋根目錄,以及改變命令行為的 find 述詞(-exec、-delete、-mtime)都會原封不動地通過;設定 TOKENSAVE_DISABLE_GREP_HOOK=1 可針對每個 shell 選擇退出。
篩選器以最特定優先讀取:明確的 type 具有權威性,然後是明確的檔案 glob,然後是搜尋路徑。因此,帶有 glob: "**/*.md" 的文件搜尋(例如 path: ".")會直接通過,而非被視為對寬鬆路徑的程式碼搜尋,而僅限程式碼的 glob(**/*.rs)即使在非程式碼路徑下仍會重新導向。混合 glob(**/*.{rs,md})會直接通過,因為它們可能回傳文件。
無頭/子代理分派(claude -p)。 由編排 session 分派的子程序會繼承其 ~/.claude/settings.json,包括此 hook。若要讓子代理執行原始搜尋,請在子代理的環境中設定 TOKENSAVE_DISABLE_GREP_HOOK=1——原生二進位檔會遵循它並讓每個路徑(Grep、Glob、Bash、Agent)通過,因此不需要會剝離所有 hooks 的粗糙 --settings '{"hooks": {}}'。此防護是無狀態的:它從不查閱引用歷史,因此只會重新導向上述符號形狀的搜尋,並引導未分類的研究扇出;無論 session 是互動式或無頭,一般命令都不受影響。
CLAUDE.md 規則
將指示附加到 ~/.claude/CLAUDE.md,告訴 Claude 在動用 Explore 代理或原始檔案讀取之前,先使用 tokensave 工具。
崩潰韌性同步
Tree-sitter 文法是編譯的 C/C++ 程式碼。它們偶爾會觸發內部斷言或以 Rust panic 處理無法攔截的路徑終止程序。從 v4.3.0 開始,每個檔案都在短命的 worker 子程序中解析:如果文法 segfault、呼叫 abort() 或遇到堆疊溢位,只有 worker 會終止。池會重新產生它,有問題的檔案會被記錄並跳過,而 sync 會繼續執行。
該 worker 是一個隱藏的 extract-worker 子命令,透過 256 位元的每次產生 token 與父程序驗證,該 token 既是 TOKENSAVE_WORKER_TOKEN 環境變數,也是 stdin 上接收的前 32 個位元組。使用者直接呼叫會失敗。預設為 available_parallelism() 個 worker;使用 TOKENSAVE_DISABLE_SUBPROCESS=1 選擇退出。
編輯原語(tokensave_str_replace、tokensave_insert_at 等)仍在程序中執行:它們一次只針對一個檔案,子程序開銷會佔主導地位,而萃取器在那裡崩潰會立即對代理可見。
多分支索引(選擇性)
tokensave 可以選擇性地為每個 git 分支維護獨立的程式碼圖。啟用後,切換分支永遠不會給你過期的結果,也不會重新索引你在另一個分支上已解析的檔案。多分支追蹤是選擇性啟用的——沒有它,tokensave 會為所有分支使用單一資料庫。
運作方式
當你追蹤一個分支時,tokensave 會複製最近的祖先 DB,並只同步有差異的檔案。這表示從 main 追蹤功能分支幾乎是即時的——它只解析你變更過的檔案。
CLI 命令
tokensave branch add              # track the current branch
tokensave branch list             # see tracked branches and DB sizes
tokensave branch remove <name>    # stop tracking a branch
tokensave branch removeall        # remove all tracked branches except default
tokensave branch gc               # clean up branches deleted from git
跨分支 MCP 工具
三個 MCP 工具讓你在不切換 checkout 的情況下進行跨分支查詢:
tokensave_branch_search—— 在另一個分支的圖中搜尋符號tokensave_branch_diff—— 比較兩個分支之間的程式碼圖:新增、移除和變更(簽名不同)的符號。支援檔案和種類篩選器。tokensave_branch_list—— 列出已追蹤的分支,包含 DB 大小、父分支和同步時間
分支回溯
當 MCP 伺服器找不到目前分支的資料庫時,它會從最近的祖先分支 DB 提供服務,並在每個工具回應中包含警告,建議你執行 tokensave branch add。
自動分支追蹤(v7.3.0)
一旦多分支模式完成引導(首次手動 tokensave branch add 建立分支元資料),新分支即可自動追蹤,而不再回退到祖先資料庫。這由兩個獨立機制涵蓋;單一資料庫模式的專案永遠不受影響,且這兩個機制都不會觸及預設分支的資料庫。
Git 掛鉤(於分支切換時)。 post-checkout 掛鉤由 tokensave install 設定,能辨識分支切換(相對於檔案切換),並在背景執行 tokensave branch add。當分支已被追蹤或是預設分支時,該指令為無操作,因此一般已知分支間的切換不會產生額外成本。全新 git clone 與新 git worktree add 的首次切換也屬於分支切換,且可能落在非預設分支上(git clone -b feature、git worktree add -b feature);此時掛鉤會依序先執行 tokensave init,再執行 tokensave branch add。由較早版本安裝的掛鉤會保留其安裝時的主體——安裝程式絕不會改寫既有掛鉤——因此在這些安裝環境中,新的工作樹仍需要下方的 auto_track,或手動執行 tokensave branch add。
開啟時自動追蹤(選擇加入)。 當 TokenSave::open 執行時——無論是 CLI 指令或 MCP 伺服器啟動——若目前分支未被追蹤,tokensave 可當場追蹤它,方法是複製最近的已追蹤祖先資料庫並記錄於分支元資料中。此功能由 auto_track 設定欄位(預設 false)或 TOKENSAVE_AUTO_TRACK 環境變數控制,後者會依執行覆寫設定(任何值皆可啟用,除了 0、false、no、off 或空值)。此複製與手動 branch add 所執行的近乎即時祖先資料庫複製相同;此時不會執行同步——post-commit 掛鉤會在你提交時保持新分支資料庫的新鮮度,或執行 tokensave sync 立即重新整理。自動追蹤嚴格來說是盡力而為:任何失敗都會回報為警告,且 open() 會以一般的祖先回退繼續執行,因此絕不會中斷工具呼叫。
簡言之:安裝掛鉤後,切換到新功能分支——包括全新複製或工作樹起始的分支——會透明地賦予其各自的分支圖;啟用 auto_track 後,即使在切換之外建立的分支,也會在 tokensave 首次於該分支開啟專案時被擷取。
完整指南請參閱 docs/BRANCHING-USER-GUIDE.md。
跨工作階段記憶
三個 MCP 工具會在工作階段之間持久化決策與程式碼區域脈絡,儲存於每個專案的 .tokensave/tokensave.db。
| 工具 | 用途 |
|---|---|
tokensave_record_decision | 儲存設計/架構決策,可附帶理由、檔案與標籤 |
tokensave_record_code_area | 標記代理程式曾處理過的路徑(觸碰計數器 + last_touched_at) |
tokensave_session_recall | 對已儲存決策執行 FTS5 查詢;與兩個寫入工具搭配使用 |
善用這些工具,讓代理程式不必在工作階段之間重複解釋架構選擇。
節省帳本
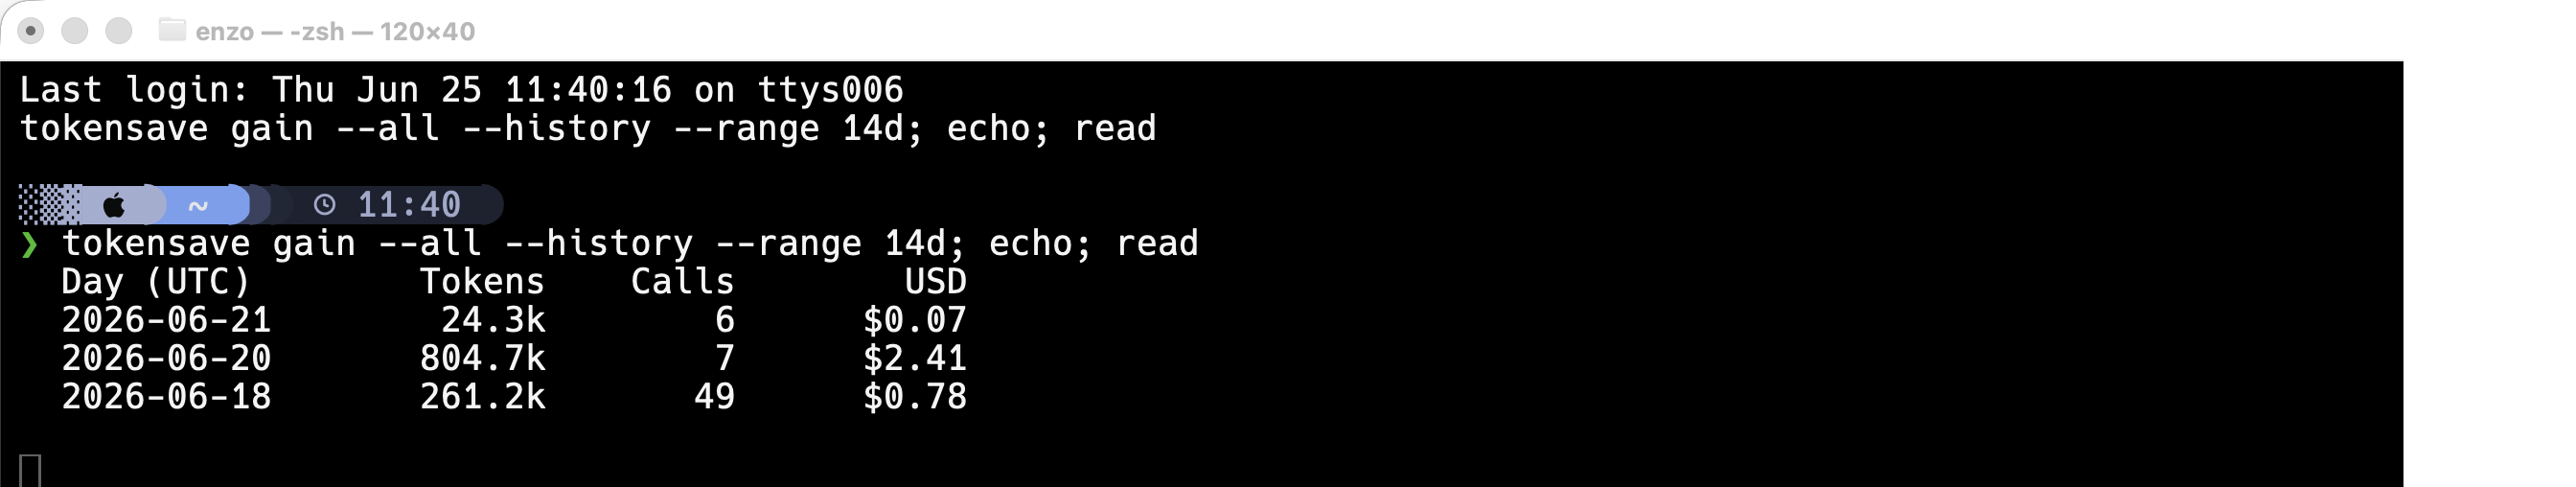
每次 MCP 呼叫都會將一列附加寫入 ~/.tokensave/global.db(savings_ledger 資料表)。可使用 tokensave gain 檢查:
tokensave gain                    # current project, last 30 days
tokensave gain --all              # all projects
tokensave gain --history --range 7d
tokensave gain --json
美元估算使用現有的定價模組(Sonnet 輸入定價,每日透過 LiteLLM 重新整理)。
可重現基準測試
tokensave bench 會透過 tokensave_context 執行一組固定查詢,並回報相對於完整檔案基線的檢索節省(對應 CCE 方法論):
tokensave bench                                    # ships with 10 default queries
tokensave bench --queries my-queries.toml --json
tokensave bench --max-nodes 5
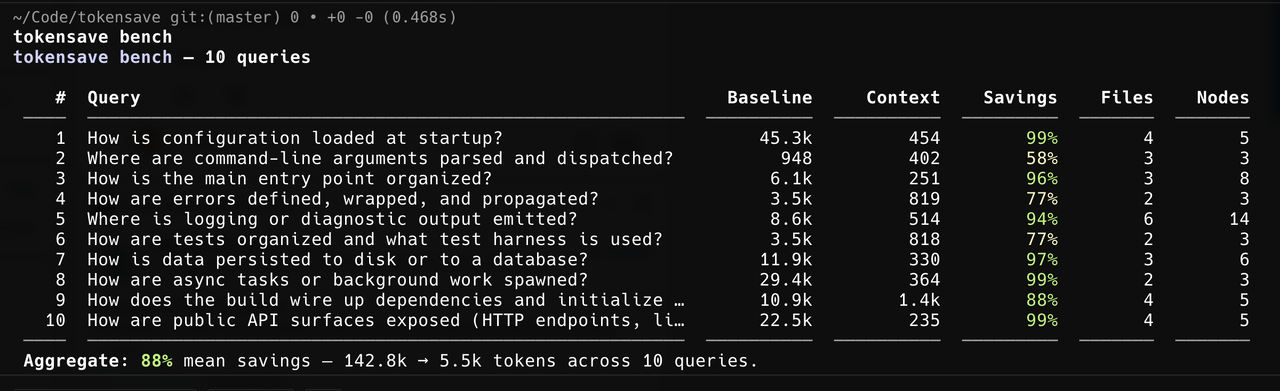
針對此儲存庫(tokensave 本身)使用隨附的通用查詢集測量:
| # | 查詢 | 基線 | 脈絡 | 節省 | 檔案 | 節點 |
|---|---|---|---|---|---|---|
| 1 | 啟動時如何載入設定? | 45.3k | 454 | 99% | 4 | 5 |
| 2 | 命令列引數在哪裡解析與分派? | 948 | 402 | 58% | 3 | 3 |
| 3 | 主要進入點如何組織? | 6.1k | 251 | 96% | 3 | 8 |
| 4 | 錯誤如何定義、包裝與傳播? | 3.5k | 819 | 77% | 2 | 3 |
| 5 | 記錄或診斷輸出在哪裡產生? | 8.6k | 514 | 94% | 6 | 14 |
| 6 | 測試如何組織,使用什麼測試框架? | 3.5k | 818 | 77% | 2 | 3 |
| 7 | 資料如何持久化到磁碟或資料庫? | 11.9k | 330 | 97% | 3 | 6 |
| 8 | 非同步任務或背景工作如何產生? | 29.4k | 364 | 99% | 2 | 3 |
| 9 | 建置如何連接依賴並初始化狀態? | 10.9k | 1.4k | 88% | 4 | 5 |
| 10 | 公開 API 表面如何暴露(HTTP 端點、函式庫匯出或 CLI 指令)? | 22.5k | 235 | 99% | 4 | 5 |
總計: 平均 88% 檢索節省(10 個查詢中 142.8k → 5.5k tokens)。
預設查詢集針對大多數應用程式碼庫中常見的模式(CLI、守護程式、服務)。使用 tokensave bench 在自己的專案上執行以查看數據,或撰寫量身訂製的查詢檔案(--queries my.toml)以獲得更精確的回憶。
針對大型真實世界儲存庫的 Criterion 基準測試
benches/large_repos.rs 是一個 criterion 微基準測試,對四個釘選在固定 refs 的大型開源程式碼庫進行 MCP 工具端對端測試。每個工具由至少 5 個查詢驅動,引數(節點 ID、限定名稱、檔案 glob 等)從每個儲存庫的索引圖中取樣一次,因此計時可在多次執行間重現。
儲存庫與釘選 refs(定義於 benches/repos.rs):
| 儲存庫 | URL | Ref |
|---|---|---|
| polkadot-sdk | https://github.com/paritytech/polkadot-sdk | polkadot-stable2412 |
| emacs | https://github.com/emacs-mirror/emacs | emacs-30.1 |
| scipy | https://github.com/scipy/scipy | v1.14.1 |
| node | https://github.com/nodejs/node | v22.11.0 |
每個儲存庫在首次使用時會淺層複製(git init + git fetch --progress --depth 1 origin <ref> + checkout FETCH_HEAD)並快取於本機;後續執行會重複使用該檢出。Git 輸出會串流到終端機,因此多 GB 的擷取會顯示即時進度。
涵蓋的工具(每個 5 個查詢)。 讀取工具——search、context、callers、callees、node、by_qualified_name、signature、impact、body、files、complexity、doc_coverage、largest、hotspots、god_class、module_api、derives、dead_code、rank、coupling、circular。寫入工具——str_replace、multi_str_replace、insert_at,以及(若 ast-grep 在 PATH 上)ast_grep_rewrite。
每次執行強制同步。 在任何基準測試觸發前,測試框架會在每個儲存庫上執行等同於 tokensave sync --force 的操作(無論 .tokensave/ 的新鮮度如何,index_all()),因此計時始終反映釘選的來源。
寫入基準測試與清理。 寫入工具會變更檔案。為保持「比對必須唯一」的前置條件,測試框架使用 criterion 的 iter_batched——<repo>/.tokensave-bench-scratch/ 下的小型暫存檔案會在每次計時迭代前以已知內容重寫,然後編輯工具對其執行。所有基準測試完成後,測試框架會在每個準備好的儲存庫內執行 git stash --include-untracked && git stash drop,使工作樹回到釘選的 ref。
Criterion 設定。 基準測試將 criterion 的預設值覆寫為 sample_size = 10 和 measurement_time = 30s(相對於標準的 100 / 5s),這使每個查詢的計時約有 30 秒的測量時間——足以讓 polkadot-sdk 上 tokensave_context 等慢速工具產生穩定數據。
執行:
# Required: a writable cache directory for the cloned repos + their indexes.

<p align="center">
  <a href="https://ai.enzolombardi.net/"><img src="https://img.shields.io/badge/built%20with-AI-D97757?style=flat-square&labelColor=101010&logo=anthropic&logoColor=white" alt="Built with AI — part of Enzo Lombardi's AI portfolio"></a>
</p>

# Expect several GB of disk and a long first run (shallow clone + full index of each repo).
export TOKENSAVE_BENCH_REPOS_DIR=~/tokensave-bench-cache

cargo bench --bench large_repos
若 TOKENSAVE_BENCH_REPOS_DIR 未設定,基準測試會列印通知並註冊零個基準測試(因此 cargo bench --all 在貢獻者的機器上保持低成本)。
設定(全部可選,透過環境變數):
| 變數 | 效果 |
|---|---|
TOKENSAVE_BENCH_REPOS_DIR | 必要。 每個儲存庫複製到的根目錄 $DIR/<repo-name>/。 |
TOKENSAVE_BENCH_REPOS | 以逗號分隔的儲存庫名稱子集,例如 TOKENSAVE_BENCH_REPOS=emacs,scipy。預設為全部四個。 |
TOKENSAVE_BENCH_SKIP_CLONE | 若設定,基準測試會對任何尚未位於釘選 ref 的儲存庫快速失敗,而非擷取。適用於 CI / 離線執行。 |
篩選基準測試使用標準 criterion CLI——例如,僅 search 工具在 scipy 上:
cargo bench --bench large_repos -- 'scipy/tokensave_search'
報告(HTML + 原始樣本)位於 target/criterion/ 下。
若要變更釘選 refs(例如更新版本或特定 SHA),請編輯 benches/repos.rs 中的 REPOS,並刪除對應的 $TOKENSAVE_BENCH_REPOS_DIR/<repo>/.bench-ref 標記,以便下次執行重新擷取。若跳過執行後清理(例如在基準測試中途 Ctrl-C),可在每個儲存庫目錄內執行 git stash --include-untracked && git stash drop 手動還原。
MCP 測試矩陣探針(scripts/mcp_probe)
scripts/mcp_probe/ 是一個 Python 測試框架,透過 stdio 驅動 tokensave serve 對一組可設定的真實儲存庫,並以每種語言 5 個查詢變體執行每個唯讀 MCP 工具,產生每個工具 / 每個儲存庫的狀態表。同一測試框架有兩個用途:
- 回歸掃描。 新增語言支援、新工具或重構——重新執行矩陣,任何新出現錯誤、逾時或回傳空結果的儲存格都會以 🚩 標示。
- 效能探針。 每次呼叫的計時會記錄在 TSV 中;相同的固定儲存庫語料庫兼作粗略的跨版本比較。目前的
tokensave_inheritance_depth週期錯誤就是由此測試框架發現的,當時 polkadot-sdk 上的單一工具逾時超過 60 秒。
佈局——probe.py 是驅動程式(ID 比對的 JSON-RPC,因此慢速工具不會污染後續呼叫),isolated.py 以每次呼叫的全新伺服器重新執行單一工具(避開伺服器佇列),build_matrix.py 讀取 TSV 並輸出 markdown,tools/<lang>.py 模組貢獻每種語言的查詢集(已隨附 Rust;新增 Python/Go/… 只需放入新模組),repos.toml 列出目標儲存庫(可透過 $TOKENSAVE_PROBE_REPOS 覆寫)。
快速執行:
cargo build --release --bin tokensave
python3 scripts/mcp_probe/probe.py
python3 scripts/mcp_probe/build_matrix.py > matrix.md
輸出儲存格為 ✓ 5/5(乾淨)、🐛 e/N(錯誤)、⏱ N/N(逾時)、∅ E/N(空)、🐢 ok/slow(>10 秒呼叫)。任何帶有錯誤或逾時的儲存格會在右側欄獲得 🚩。每次呼叫的詳細資訊(含每個錯誤的前 100 個字元)會記錄在 TSV 日誌中供後續追蹤。
與上述 criterion 基準測試不同:criterion 測量釘選 refs 上聚焦工具集的每次迭代延遲,並在 target/criterion/ 下產生統計報告;mcp_probe 以更廣泛的查詢集對你指定的任何儲存庫執行每個工具,最佳化覆蓋廣度而非測量精確度。
80+ 個 MCP 工具
伺服器暴露超過 80 個工具(當選用的 ast-grep 二進位檔不在 PATH 上時少一個)。自 7.14.0 起,預設僅列出 11 個核心工具加上 tokensave_more;其餘工具可透過 tokensave_more 按需列出,仍可按名稱呼叫,且全部會以 "tools": "full" 列出。下表按類別分組最常用的工具。大多數為唯讀、可安全並行呼叫,並以 readOnlyHint 註解。編輯原語限於單一檔案並就地重新索引;工作階段基線與記憶記錄工具也會變更本機 .tokensave 狀態,並標記為非唯讀。三個核心工具(tokensave_context、tokensave_search、tokensave_status)標記為 anthropic/alwaysLoad,因此可繞過用戶端的工具搜尋往返。
查詢另一個已初始化的專案
語意讀取工具可查詢明確選取的本機圖,而無需重新啟動 MCP 伺服器:
{
  "query": "screenGate",
  "graph_root": "/absolute/path/to/typewhisper"
}
選取的結果包含標準的根/分支來源。節點 ID 以該圖為命名空間,且後續呼叫必須重複相符的選擇器。例如,分支選取查詢的後續呼叫會包含兩個值:
{
  "node_id": "graph:<fingerprint>:function:<raw-id>",
  "graph_root": "/absolute/path/to/typewhisper",
  "graph_branch": "feature/auth"
}
graph_root 必須是已初始化專案的確切絕對根目錄。
graph_branch 為選用,若提供,則必須指定一個受追蹤的分支。
選取的開啟操作是唯讀的:它們絕不會初始化、同步、遷移、自動追蹤,
或寫入圖形/原始資料。它們也不會計入節省統計。
沒有選擇器的呼叫行為與之前完全相同。
graph_root 只有在您知道另一個專案存在時才有用,因此伺服器
會告訴您:位於所服務根目錄正旁邊的已初始化專案會
在 MCP instructions、tokensave_status 以及空的
tokensave_search / tokensave_context 結果中被命名——此時工作階段
否則會斷定某個符號不存在,而不是查看隔壁
(#375)。只提供直接相鄰的同級專案,最多五個,且不會為它們開啟或建立索引;
查詢其中一個仍需要明確的 graph_root。
選擇器刻意不適用於會寫入、執行外部命令,或
依賴目前檢出的工具:編輯原語、VCS 和分支工具、
診斷和測試執行、依賴和執行時期內省、工作流程
和會話記憶體工具、持久快取工具 (tokensave_redundancy),
以及伺服器管理。這些工具會拒絕選擇器,而不是靜默忽略它。
探索
| 工具 | 用途 |
|---|---|
tokensave_context | 取得任務相關的程式碼上下文——進入點、相關符號、程式碼片段 |
tokensave_search | 依名稱尋找符號(函式、類別、型別) |
tokensave_node | 取得特定符號的詳細資料 + 原始碼 |
tokensave_files | 列出已建立索引的專案檔案(原始檔和受追蹤的產物),並可篩選 |
tokensave_module_api | 檔案或目錄的公開 API 表面 |
tokensave_similar | 尋找名稱相似的符號 |
tokensave_annotations | 屬性/註解/裝飾器內省——所有註解的直方圖,或帶有目標篩選器的逐位置清單 |
tokensave_doc | 原始檔的配套 Markdown 文件——文件內容、其涵蓋的檔案,以及過時訊號 |
tokensave_dependencies | 跨 17 個生態系統的套件清單內省——工作區摘要、逐套件查詢、授權表面、版本漂移 |
tokensave_status | 索引狀態、統計資料、節省的 token |
非程式碼產物
tokensave_files 涵蓋的不只是原始碼。副檔名列在
artifact_extensions (.feature、.json、.yaml、.yml、.sql、.toml、
.proto、.graphql、.md、.bnd、.bndrun,依預設) 中的檔案會依路徑追蹤,
因此像「登入流程的 .feature 檔案在哪裡?」這類問題會有
圖形答案,而不是被阻擋的 find (#323)。它們絕不會被剖析,也不會貢獻任何符號;
kind: "artifact" 和 kind: "code" 在兩者之間篩選,而意指
「程式碼」的分析會排除它們。已由語言擷取器處理的副檔名
會在此清單中被忽略,因此不能用來阻止語言被剖析。
此清單也決定字面搜尋可以查看的內容 (#442)。字面
(literal: true) 搜尋 tokensave_search 讀取的是位元組,而不是
符號,因此不需要剖析器——但它會迭代已建立索引的檔案,所以它
只能觸及索引中持有資料列的檔案。受追蹤的 .rst 文件或
.tmpl 範本既沒有擷取器,也沒有預設的產物條目,因此其
相符項目會遺失;在此新增副檔名並執行 tokensave sync -f,其
行就會像其他檔案一樣被搜尋,並以 enclosing: null 回報,因為
沒有符號上下文。無法觸及每個受追蹤檔案的字面回應
會在 unscanned 區塊中說明,並指出計數和副檔名,因此
部分答案絕不會被呈現為完整答案。
呼叫圖與影響
| 工具 | 用途 |
|---|---|
tokensave_callers | 找出誰呼叫某個函式 |
tokensave_callees | 找出某個函式呼叫了什麼 |
tokensave_impact | 查看變更某個符號會影響什麼 |
tokensave_affected | 找出受原始檔變更影響的測試檔案 |
tokensave_rename | 基於圖形的重新命名:每個位置都有一個信心等級 (exact、heuristic、ambiguous、text_only)、差異預覽,以及全有或全無的套用。不具繫結感知能力 |
tokensave_hotspots | 連線最多的符號(最高呼叫次數) |
程式碼品質
| 工具 | 用途 |
|---|---|
tokensave_complexity | 依迴圈與認知複雜度、巢狀深度、Halstead 指標、可維護性指數、CRAP 和安全指標對函式排名 |
tokensave_dead_code | 找出無法觸及的符號(沒有傳入邊;命名為模糊候選的符號會被排除) |
tokensave_ambiguous_calls | 解析器無法釘選到單一目標的呼叫位置,並列出所有並列的候選 |
tokensave_god_class | 找出成員過多的類別 |
tokensave_coupling | 依扇入/扇出對檔案排名 |
tokensave_inheritance_depth | 找出最深的繼承階層 |
tokensave_circular | 偵測循環檔案依賴 |
tokensave_imports | 模組層級的匯入依賴、循環和切割模擬 |
tokensave_recursion | 偵測遞迴/相互遞迴的呼叫循環 |
tokensave_unused_imports | 從未參考的匯入陳述式 |
tokensave_doc_coverage | 缺少文件的公開符號 |
tokensave_simplify_scan | 變更檔案的品質分析(重複、死程式碼、複雜度) |
程式碼健康分析
五個工具從現有圖形中呈現結構品質訊號。綜合分數使用獨立維度上的幾何平均數,因此沒有任何單一維度可以被操縱。
| 工具 | 用途 |
|---|---|
tokensave_health | 來自無環性、深度、相等性、冗餘和模組化的綜合品質訊號 (0-10000) |
tokensave_gini | 任何指標的吉尼不平等係數(複雜度、行數、扇入/出、成員)——找出上帝檔案和不均勻分佈 |
tokensave_dependency_depth | 最長的檔案層級依賴鏈(Lakos 分層),並在 Tarjan SCC 循環破壞後進行完整鏈重建 |
tokensave_dsm | 以 stats、clusters 或 matrix 形式呈現的設計結構矩陣——揭示分層違規和隱藏耦合 |
tokensave_test_risk | 風險加權的測試缺口分析,將複雜度、扇入、覆蓋率和 90 天 git 變動組合成單一分數 |
工作階段
在 AI 編碼工作階段開始時擷取健康指標快照,然後在結束時進行差異比對,以查看哪些改善了或退步了。
| 工具 | 用途 |
|---|---|
tokensave_session_start | 將目前的健康指標儲存為 JSON 基準,供日後比較 |
tokensave_session_end | 重新計算並與基準差異比對——每個維度的差異、通過/失敗、自動清理 |
編輯原語
四個寫入工具,讓代理程式可以修改檔案,而無需正規表示式或 shell 引號的危險。每個都是單一檔案、有錨點,並在寫入後觸發就地重新建立索引,因此圖形永遠不會過時。
| 工具 | 用途 |
|---|---|
tokensave_str_replace | 以 new_str 取代唯一的 old_str;如果相符項目為 0 或 >1 則失敗(防止多重編輯錯誤) |
tokensave_multi_str_replace | 以原子方式套用 N 個 (old, new) 取代——全有或全無的交易 |
tokensave_insert_at | 在唯一的錨點字串或行號之前或之後插入內容 |
tokensave_ast_grep_rewrite | 透過 --rewrite 模式中的 ast-grep CLI 進行結構化程式碼重寫 |
Git 與工作流程
| 工具 | 用途 |
|---|---|
tokensave_diff_context | 變更檔案的語意上下文——修改的符號、依賴、受影響的測試 |
tokensave_commit_context | 未提交變更的語意摘要,用於草擬提交訊息 |
tokensave_pr_context | git 參照之間的語意差異,用於拉取請求描述 |
tokensave_changelog | 兩個 git 參照之間的語意差異 |
tokensave_test_map | 符號層級的原始檔到測試對應,並偵測未覆蓋的符號 |
tokensave_test_coverage | 逐檔案/符號/測試函式的覆蓋率彙總,並進行傳遞呼叫邊緣擴充 |
型別系統
| 工具 | 用途 |
|---|---|
tokensave_type_hierarchy | traits、介面和類別的遞迴型別階層樹 |
tokensave_rank | 依關係計數對節點排名(最多實作的介面、最多擴充的類別) |
tokensave_distribution | 每個檔案或目錄的節點種類明細 |
tokensave_largest | 依大小對節點排名——最大的類別、最長的方法 |
移植
| 工具 | 用途 |
|---|---|
tokensave_port_status | 比較來源/目標目錄之間的符號,以追蹤移植進度 |
tokensave_port_order | 用於移植的符號拓撲排序——先移植葉節點,然後是依賴者 |
多分支
| 工具 | 用途 |
|---|---|
tokensave_branch_search | 在另一個分支的圖形中搜尋符號 |
tokensave_branch_diff | 比較分支之間的符號(新增/移除/變更) |
tokensave_branch_list | 列出受追蹤的分支,包含資料庫大小和同步時間 |
MCP 資源
透過 resources/list 和 resources/read 公開四個資源:
tokensave://status-- 圖形統計資料,JSON 格式tokensave://files-- 依目錄分組的已建立索引檔案樹tokensave://overview-- 專案摘要,包含語言分佈和符號種類tokensave://branches-- 受追蹤的分支,包含資料庫大小和父項資訊
Token 追蹤
tokensave 會衡量它在每次 MCP 工具呼叫中節省的 token。每個工具回應都包含一個 tokensave_metrics: before=N after=M 行,顯示該特定呼叫避免了多少原始檔案 token。
關閉回報。 指標行,以及 MCP instructions 中的一句話,會要求代理程式向您回報節省量——這表示模型會花費輸出 token 來敘述 tokensave 在輸入 token 上節省的量。輸出 token 是較昂貴的種類,因此如果您的代理程式幾乎每一輪都提到 tokensave,該敘述可能會抵消節省 (#356)。在 .tokensave/config.json 中將 report_savings 設為 false,或設定 TOKENSAVE_REPORT_SAVINGS 環境變數以在每次執行時覆寫(除了 0、false、no、off 或空值之外的任何值都會啟用它)。指標行和指令都會消失;tokensave install 同樣會停止將回報規則寫入代理程式提示檔案。衡量不受影響——每次呼叫仍會記錄在節省帳本中,因此 tokensave gain、tokensave list、status 和 monitor 會像之前一樣繼續回報。預設值維持 true。
預設只列出核心工具。 MCP 用戶端會在每一輪、在任何工具被呼叫之前,傳送每個列出工具的架構。完整的 tokensave 表面約為 89 KB 的架構,在小上下文模型中可能佔超過一半的視窗 (#576)。因此 tools/list 只傳送核心工具:context、search、status、read、body、files、callers、callees、impact、str_replace 和 multi_str_replace(約 17 KB,含 tokensave_more)。initialize 指令會命名這些工具以及 tokensave_more 可以列出的區域,因此延遲工具架構的用戶端仍知道其餘工具存在。此設定選擇伺服器列出什麼,而不是它能執行什麼:未列出的工具仍會依名稱回應呼叫,因此代理程式權限清單和鉤子會繼續運作。若要列出所有工具,請在 .tokensave/config.json 中設定 "tools": "full",或在 MCP 伺服器的環境中設定 TOKENSAVE_TOOLS=full;環境變數優先於檔案。由 7.13.0 寫入的 "tools": "full"(它會寫入每個儲存的設定)會被讀取為舊的預設值;升級後請再次設定,以保留完整清單。
With the core toolset the server also lists tokensave_more. A call with an area (analysis, edit, git, memory, navigate or all) lists the tools of that area for the rest of the session, and the server sends notifications/tools/list_changed so the client fetches the list again. A session pays only for the areas it uses: the git area adds about 6 KB. A client that ignores list_changed keeps the core list. tokensave install grants tokensave_more along with every other tool, so it does not prompt; an install from before this release prompts once, until tokensave reinstall or the upgrade resync refreshes the permission list.
成本可觀測性
tokensave cost                     # 7-day cost summary (default)
tokensave cost today               # today only
tokensave cost --by-model          # breakdown by Claude model
tokensave cost --by-task           # breakdown by task category (coding, debugging, exploration, ...)
tokensave cost --export json       # JSON export to stdout
tokensave cost --export csv        # CSV export to stdout
解析 Claude Code 工作階段記錄(~/.claude/projects/**/*.jsonl),將每次 API 回合分類為 13 個任務類別之一,使用模型定價計算美元成本,並將結果儲存在 ~/.tokensave/global.db 中以供快速聚合查詢。定價每 24 小時從 LiteLLM 刷新,離線時則回退到內嵌表格。
tokensave status 標頭包含一個成本列,顯示今日花費、7 天總計和效率比(節省的 token / 總 token)。tokensave monitor TUI 在節省資訊流的旁邊顯示即時成本面板。在每個 Claude Code 工作階段結束時,hook_stop 處理器會在終端機列印一行收據。
任務分類類別:編碼、除錯、功能開發、重構、測試、探索、規劃、委派、Git 操作、建置/部署、腦力激盪、對話、一般。分類是確定性的(對工具名稱和 Bash 命令進行模式比對),不需要 LLM 呼叫,改編自 AgentSeal/codeburn。
即時監控
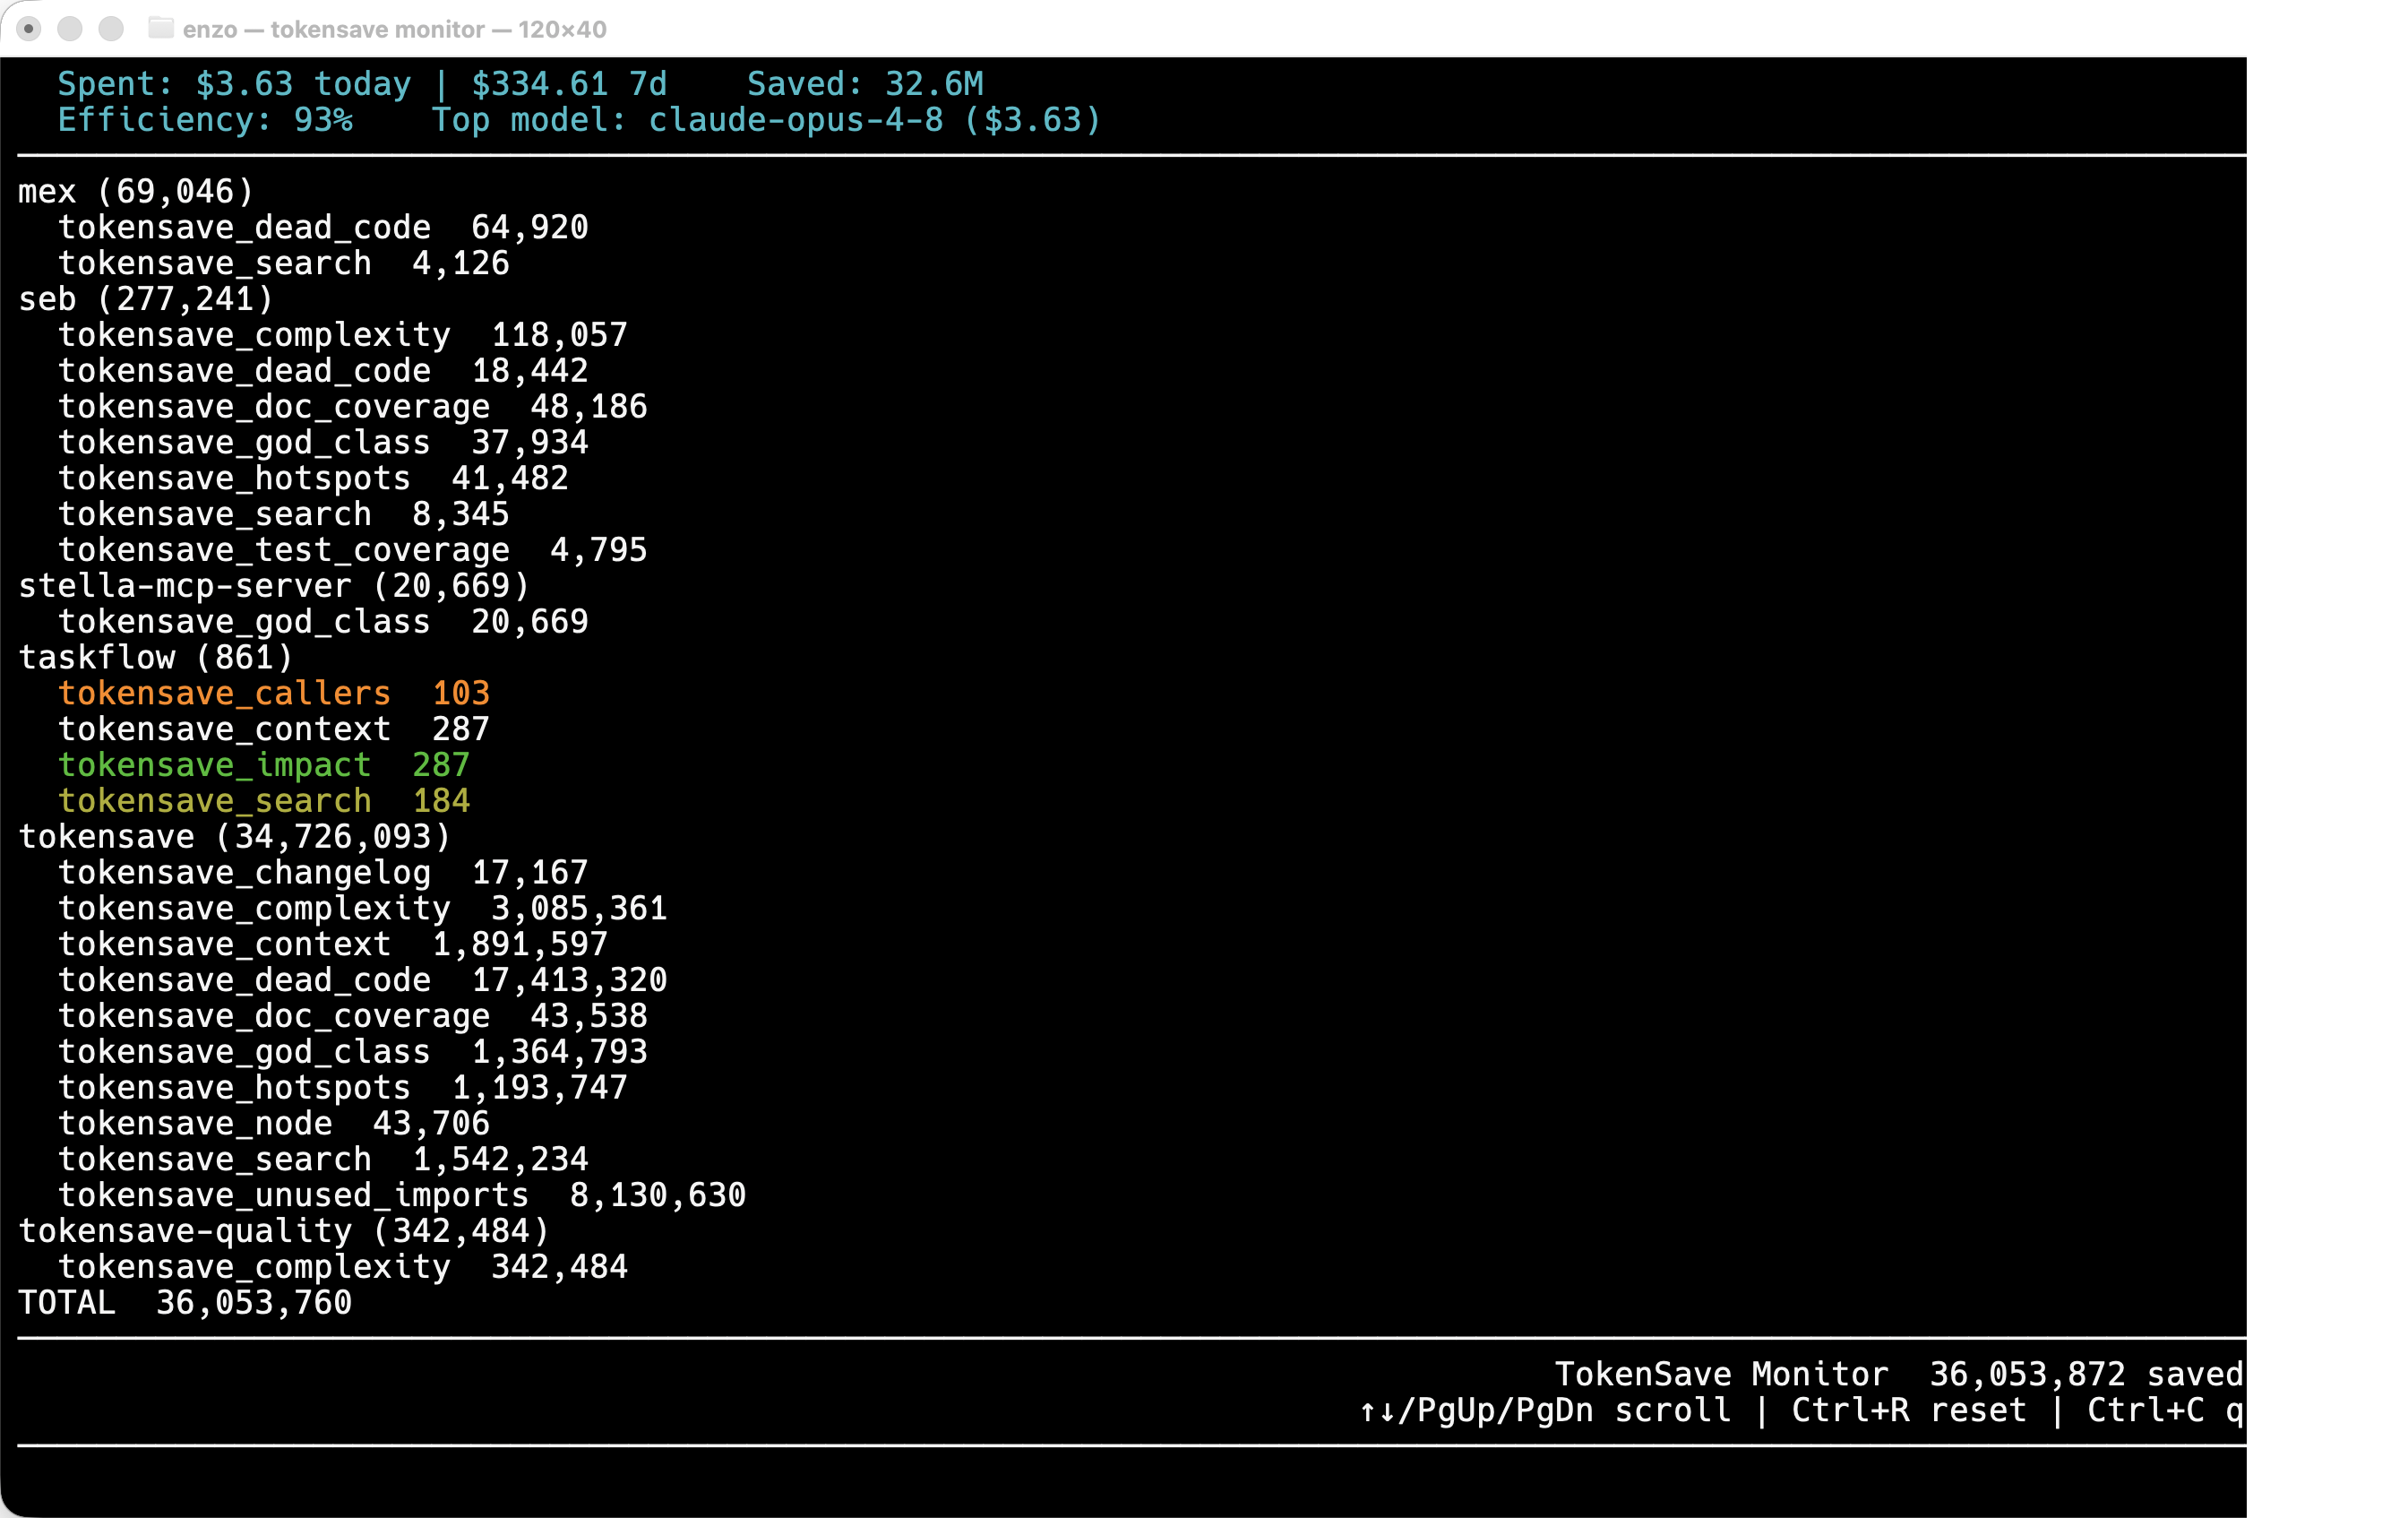
tokensave monitor
一個全域 TUI,透過位於 ~/.tokensave/monitor.mmap 的共享記憶體映射環形緩衝區,即時顯示所有專案的 MCP 工具呼叫。每個條目顯示專案名稱、工具名稱和 token 差異。頂部的成本面板顯示今日花費、節省量、效率和頂級模型(每 30 秒刷新一次)。
記憶體診斷
tokensave memory [--clean]
針對每個 tokensave 程序(MCP 伺服器、同步、索引執行)的機器範圍記憶體報告,透過位於 ~/.tokensave/memory.mmap 的共享記憶體映射表格。每個實例在啟動時、每次 MCP 工具呼叫時,以及同步/解析階段前後,以盡力而為的方式自我取樣其 RSS,因此報告顯示目前和峰值 RSS 以及產生峰值的階段 — 這是歸因高記憶體使用量所需的資料(參見 #253)。列被標記為 alive、dead(被 OOM 終止的程序會將其峰值/階段留作鑑識記錄),或 orphan(仍在執行但已重新父化到 init)。--clean 清除已失效的插槽。
PEAK PHASE 命名最高的樣本,因此其精確度僅限於取樣本身。增量同步依序記錄:sync:extract、sync:resolve:load_nodes、sync:resolve:build_caches、sync:resolve:refs、sync:variants、sync:done。完整索引記錄 index:extract、index:resolve:build_caches、index:resolve:refs、index:resolve:done、index:insert、index:done。
每個都是在其所命名的工作之後記錄的。 它們以前是在工作之前記錄的,因此每個樣本都在下一個步驟的標籤下報告了前一個步驟的 RSS — 這將 73 MiB 歸因於節點載入,而實際上該記憶體屬於載入未解析的引用,這是一個完全沒有樣本的步驟,並將記憶體調查指向了錯誤的子系統長達數月(#409)。如果您新增一個階段,請在工作之後取樣,而不是之前,並為任何大到足以容納峰值的步驟新增一個樣本。
工作階段和生命週期計數器
tokensave current-counter          # show per-project session counter
tokensave reset-counter            # reset the session counter
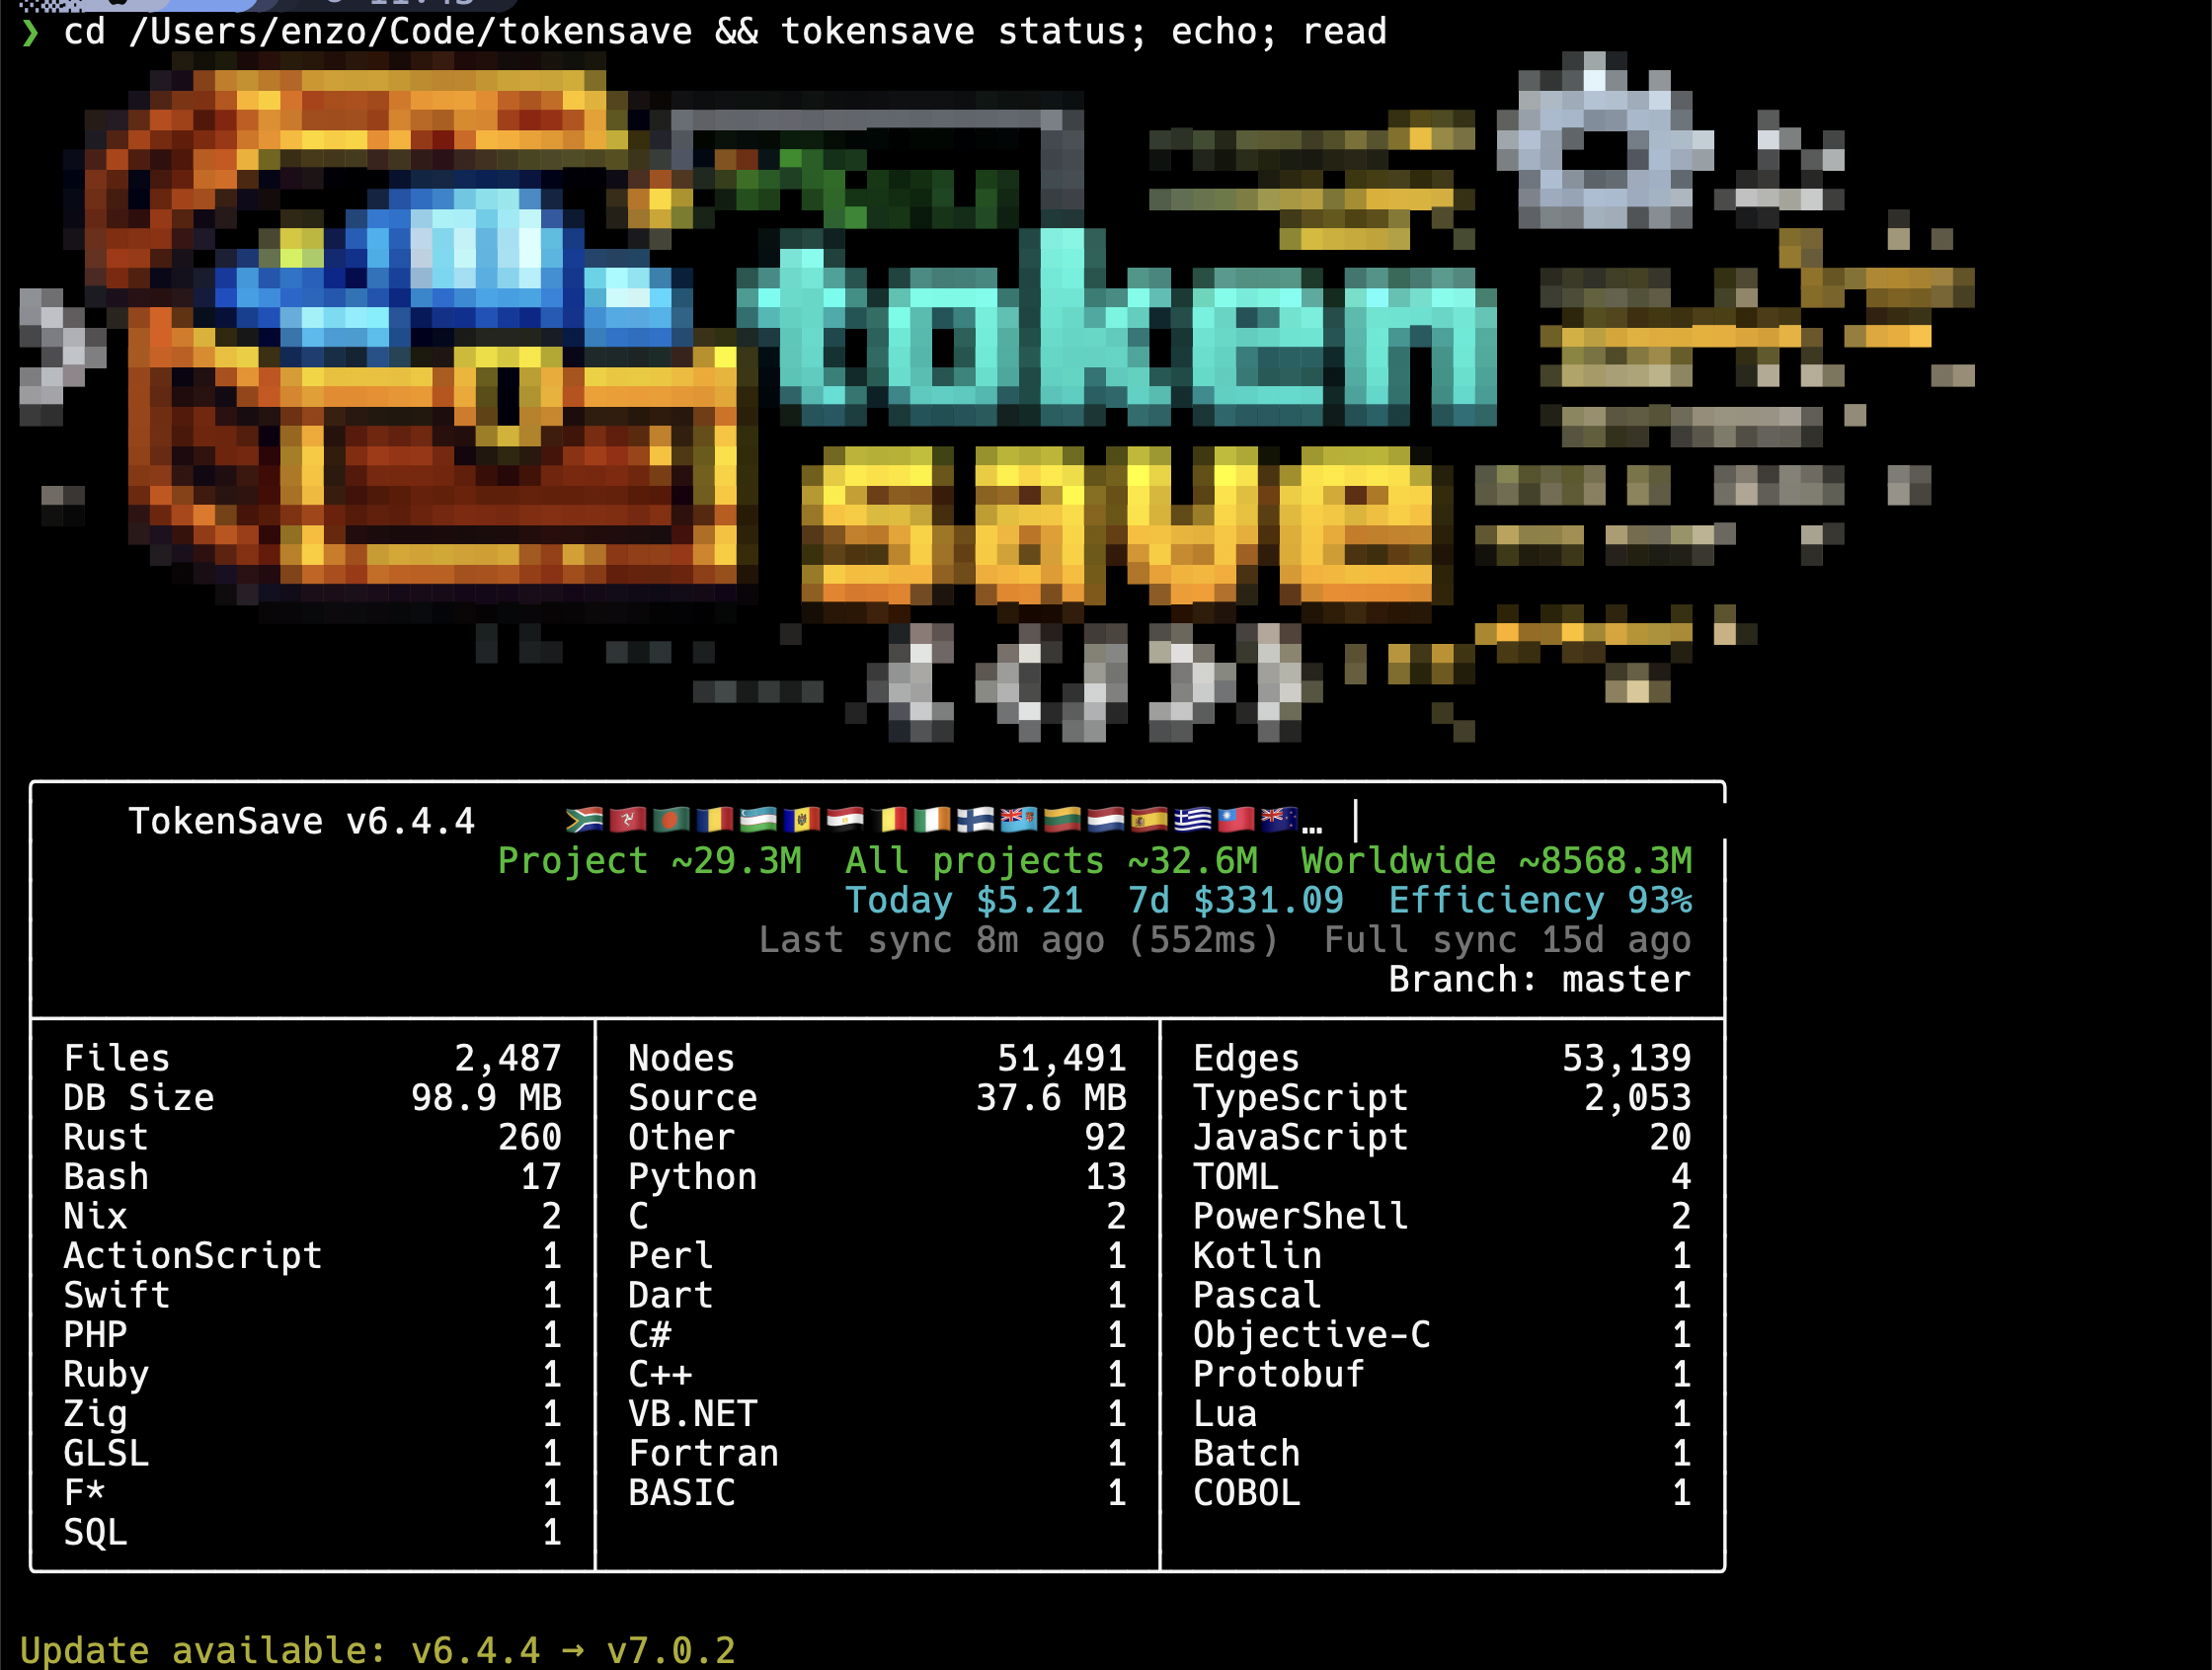
tokensave status                   # shows project + global lifetime totals + cost
tokensave status 呈現專案索引統計、語言分佈、成本列(今日 / 7 天 / 效率),以及專案和全球生命週期總計:
全球計數器
所有 tokensave 使用者都貢獻於一個匿名聚合計數器。tokensave status 顯示您的專案總計和全球總計。上傳僅傳送一個數字(例如 4823),不包含任何識別資訊。使用 tokensave disable-upload-counter 選擇退出。
索引新鮮度
tokensave 在沒有背景守護程序或作業系統層級檔案監視器的情況下保持圖形最新。
按需過時檢查。 每次 MCP 工具呼叫都會檢查自上次同步以來是否有任何已索引的檔案被修改。如果發現過時檔案,會在工具回應返回之前重新提取它們。30 秒的冷卻時間可防止連續呼叫在每次按鍵時重新遍歷樹。
連線時的追趕同步。 當 MCP 伺服器啟動時,它會立即執行非阻塞的追趕同步,以拾取在沒有代理程式附加時所做的任何變更 — 例如 git pull、IDE 編輯、建置步驟 — 因此工作階段的第一次工具呼叫會看到新鮮的索引。
多代理程式工作和 git worktree。 當多個代理程式同時處理同一個專案時,強烈假設每個代理程式在自己的 git worktree 中操作。Worktree 是同一儲存庫的獨立檔案系統簽出:代理程式 A 和代理程式 B 各自擁有每個檔案的副本,因此它們永遠不會覆寫彼此的進行中編輯。tokensave 會自動偵測查詢是否來自主簽出內巢狀的 worktree,並從正確的分支圖提供結果。變更獨立累積,最終透過 git merge 或 rebase 協調 — 與任何其他平行開發使用的過程相同。此設計避免了跨代理程式在共享可變目錄上鎖定的複雜性和失敗模式。
僅 CLI 工作流程。 如果您在沒有附加代理程式(沒有 MCP 伺服器)的情況下執行 tokensave 命令,則命令之間不會執行過時檢查。安裝 git hooks 以在每次提交或複製後自動保持索引新鮮:
cp scripts/post-commit scripts/post-checkout .git/hooks/
chmod +x .git/hooks/post-commit .git/hooks/post-checkout
從 5.x 升級
獨立的 tokensave daemon 命令及其 launchd/systemd/Windows 服務自動啟動已在 6.0.0 中移除。取代守護程序的嵌入式作業系統層級檔案監視器本身也在 6.1.1 中移除(它在具有深層 node_modules 或 target 樹的大型 monorepo 上導致失控的 CPU 和記憶體)。上述按需過時模型是目前的設計。
如果您仍有 5.x 的守護程序自動啟動,請將其移除:
- macOS:
launchctl unload ~/Library/LaunchAgents/com.tokensave.daemon.plist && rm ~/Library/LaunchAgents/com.tokensave.daemon.plist - Linux:
systemctl --user disable --now tokensave-daemon && rm ~/.config/systemd/user/tokensave-daemon.service - Windows:
sc.exe delete tokensave-daemon(從提升的終端機)
如果您不記得確切名稱:launchctl list | grep tokensave / systemctl --user list-units | grep tokensave / sc.exe query state= all | findstr -i tokensave。
自我升級
tokensave upgrade                  # upgrade to latest in current channel
tokensave channel                  # show current channel (stable/beta)
tokensave channel beta             # switch to beta channel
tokensave channel stable           # switch back to stable
tokensave upgrade 從 GitHub releases 下載正確的平台二進位檔,並就地取代正在執行的二進位檔。獨立支援穩定版和測試版通道。
版本與升級
tokensave 版本號看起來像 SemVer,但不遵循它:變更的元件編碼了更新所需的維護,tokensave 會在下次啟動時自動執行 — 您永遠不需要手動重新安裝或重新索引。
| 升級類型 | 範例 | 更新需求 | 自動動作 |
|---|---|---|---|
修補 (x.y.Z) | 7.2.0 → 7.2.1 | 無 | 無 — 不需重新安裝,不需重新索引 |
次要 (x.Y.0) | 7.2.0 → 7.3.0 | 重新安裝(新的 harness、新工具、新設定) | 全域重新安裝每個已安裝的代理程式整合(刷新權限、hooks 和 MCP 設定) |
主要 (X.0.0) | 7.2.0 → 8.0.0 | 重新安裝 + 完整重新同步 | 全域重新安裝以及每個專案的強制重新索引(sync -f 等效) |
全域重新安裝。 在新的次要或主要版本首次執行時,tokensave 會為其已註冊的每個代理程式靜默重新執行 install,因此代理程式設定始終指向目前的二進位檔並公開目前的工具集。修補升級會跳過此步驟 — 執行中的版本標記只是簡單地推進。
重新安裝是真正靜默的:您從明確的 tokensave install 看到的每個代理程式設定輸出在這裡被抑制,因此它永遠不會出現在普通的 tokensave init 或 tokensave sync 前面。如果代理程式的設定無法刷新 — 應用程式未安裝,或其設定位於唯讀位置 — 您會看到一行列出失敗的代理程式:
warning: could not refresh tokensave config for: copilot.
  Run tokensave install to see the error.
執行 tokensave install 以查看底層錯誤。版本標記無論如何都會推進,因此永遠無法寫入的設定路徑會在每次升級時報告一次,而不是在每個後續命令中重試。
每個專案的強制重新索引(僅主要版本)。 主要版本升級意味著必須重建專案索引。tokensave 以延遲且每個專案的方式執行此操作:在主要升級後專案中的第一次 MCP 工具呼叫時,它會產生背景完整重新索引(等效於 tokensave sync --force),永遠不會阻塞工具回應。
Brew / cargo 回退。 在 tokensave upgrade 之外取代二進位檔的外部升級 — brew upgrade tokensave 或 cargo install tokensave — 以相同方式偵測:如果執行中的版本比最後執行安裝的版本更新,則重新安裝會在下次啟動時執行,就像自我升級後一樣。
參見 TOKENSAVE-VERSIONING.md 了解 tokensave 為何偏離 SemVer(在版本中編碼維護是實現零接觸升級的關鍵)、標記機制、獨立的資料庫 schema 版本,以及維護者發布版本的規則。
CLI 參考
tokensave init [path]              # Initialize a new project (full index)
tokensave sync [path]              # Incremental sync (must be initialized first)
tokensave sync --force [path]      # Force a full re-index
tokensave sync --doctor [path]     # Sync and list added/modified/removed files
tokensave status [path]            # Show statistics + cost summary
tokensave status [path] --json     # Show statistics (JSON output)
tokensave status --details         # Include node-kind breakdown
tokensave cost [range]             # Token cost summary (default: 7d)
tokensave cost --by-model          # Cost grouped by model
tokensave cost --by-task           # Cost grouped by task category
tokensave cost --export json|csv   # Export cost data
tokensave query <search> [path]    # Search symbols
tokensave files [--filter dir] [--pattern glob] [--json]   # List indexed files
tokensave affected <files...> [--stdin] [--depth N]        # Find affected test files
tokensave install [--agent NAME]   # Configure agent integration
tokensave reinstall                # Refresh settings for all installed agents
tokensave uninstall [--agent NAME] # Remove agent integration
tokensave serve [--idle-timeout-secs N]   # Start MCP server (N: exit after N idle seconds)
tokensave servers [--json]         # List running servers and the index each one holds
tokensave monitor                  # Live TUI showing MCP calls across all projects
tokensave memory [--clean]         # Per-instance RSS report for all tokensave processes
tokensave upgrade                  # Self-update to latest version
tokensave channel [stable|beta]    # Show or switch update channel
tokensave doctor [--agent NAME]    # Check installation health
tokensave githooks [on|off] [--local]  # Manage git hooks (--local: this repo only, no core.hooksPath)
tokensave branch add|list|remove|removeall|gc   # Multi-branch management
tokensave current-counter          # Show per-project token counter
tokensave reset-counter            # Reset per-project token counter
tokensave disable-upload-counter   # Opt out of worldwide counter uploads
tokensave enable-upload-counter    # Re-enable worldwide counter uploads
tokensave doctor
執行 tokensave 安裝的全面健康檢查:
tokensave doctor
檢查項目:二進位檔位置、專案索引、全域 DB、使用者設定、代理程式整合(MCP 伺服器、hooks、權限、提示規則)和網路連線。如果升級後缺少任何工具權限,它會告訴您執行 tokensave install。使用 --agent 僅檢查特定代理程式。
Doctor 也會驗證每個已安裝的 hook 是否使用正確的 tokensave 子命令,並自動修復損壞的 hooks。
與 Claude Code 的運作方式
設定完成後,Claude Code 在需要理解您的程式碼庫時,會自動使用 tokensave 而不是讀取原始檔案。三個層級互相強化:
| 層級 | 功能 | 重要性 |
|---|---|---|
| MCP 伺服器 | 向 Claude 公開 80+ 個 tokensave_* 工具 | Claude 可以直接查詢圖形 |
| CLAUDE.md 規則 | 告訴 Claude 優先使用 tokensave 而非代理程式/檔案讀取 | 防止模型回退到昂貴的模式 |
| PreToolUse hook | 原生 Rust hook 阻擋 Explore 代理程式 | 捕捉模型忽略 CLAUDE.md 規則的情況 |
| UserPromptSubmit hook | 在提示提交時執行 | 用於 token 會計的生命週期追蹤 |
| Stop hook | 在工作階段結束時執行 | 刷新 token 計數器 |
結果:Claude 以遠更少的 token 獲得相同的程式碼理解。典型的 Explore 代理程式讀取 20-50 個檔案;tokensave 從其預建索引返回相關的符號、關係和程式碼片段。
網路呼叫與隱私
tokensave 的核心功能(索引、搜尋、圖形查詢、MCP 伺服器)100% 在本機 — 您的程式碼永遠不會離開您的機器。
| 呼叫 | 傳送的資料 | 時機 | 選擇退出 |
|---|---|---|---|
| 全球計數器上傳 | Token 計數(數字)+ 國家(來自 IP) | 同步、狀態、MCP 工作階段 | tokensave disable-upload-counter |
| 全球計數器讀取 | 無(GET 請求) | 狀態 | 不適用(唯讀,1 秒逾時) |
| 版本檢查 | 無(GET 請求) | 狀態(快取 5 分鐘)、同步(平行) | 不適用(1 秒逾時,失敗時無操作) |
| 模型定價刷新 | 無(GET 請求) | tokensave cost(快取 24 小時) | 不適用(5 秒逾時,回退到內嵌定價) |
全球計數器上傳會以 JSON 主體(如 {"amount": 4823})發送單一 HTTP POST 請求。不包含 Cookie、不追蹤、沒有使用者 ID。Cloudflare Worker 會記錄您 IP 位址的國家(從請求標頭推導),用於彙總的地理統計——您的實際 IP 位址不會被儲存。 |
模型定價重新整理會從 GitHub 取得公開 JSON 檔案(raw.githubusercontent.com/BerriAI/litellm/main/model_prices_and_context_window.json),以保持 Claude 模型定價為最新狀態(供 tokensave cost 使用)。不會發送任何資料——這是一個純 HTTPS GET 請求。回應會在 ~/.tokensave/pricing.json 快取 24 小時。如果擷取失敗,tokensave 會使用其內建的定價表。
50+ 種語言
tokensave 支援超過 50 種程式語言,分為三個層級,由 Cargo feature flags 控制。每個層級都包含其下層級的所有語言。Markdown 標題會以 Module 節點的形式提取,並帶有階層式的 Contains 邊,因此文件結構可以與原始碼一起參與圖形查詢。
Lite——--no-default-features
永遠會編譯。為最受歡迎的語言提供最小的二進位檔,另外加上 Svelte 和 Astro(透過 TypeScript 提取器進行 script 區塊提取,無需額外的語法依賴)。
| 語言 | 副檔名 |
|---|---|
| Rust | .rs |
| Go | .go |
| Java | .java |
| Scala | .scala、.sc |
| TypeScript | .ts、.tsx |
| JavaScript | .js、.jsx |
| Python | .py |
| C | .c、.h |
| C++ | .cpp、.hpp、.cc、.cxx、.hh |
| Kotlin | .kt、.kts |
| C# | .cs |
| Swift | .swift |
| Svelte | .svelte |
| Astro | .astro |
Medium(Lite + 額外 9 種)——--features medium
| 語言 | 副檔名 | Feature flag |
|---|---|---|
| Dart | .dart | lang-dart |
| Pascal | .pas、.pp、.dpr | lang-pascal |
| PHP | .php | lang-php |
| Ruby(包含 ERB 和 Slim 模板) | .rb、.rake、.erb、.slim | lang-ruby |
| Bash | .sh、.bash | lang-bash |
| Protobuf | .proto | lang-protobuf |
| PowerShell | .ps1、.psm1 | lang-powershell |
| Nix | .nix | lang-nix |
| VB.NET | .vb | lang-vbnet |
ERB 和 Slim 模板使用 Ruby 語法,在索引時不需要 Ruby 或模板 gems。模板呼叫屬於檔案節點,並保留其原始的行號和位元組欄位。ERB 支援程式碼/輸出標籤、trim 標記、註解和跳脫標籤。Slim 支援控制/輸出行、基於縮排的區塊、屬性(包括多行屬性清單)、文字插值和 ruby: 區塊。
不支援自訂 Slim 捷徑和嵌入式語言編譯。Rails 在渲染時提供的 locals 無法與純 helper 呼叫區分;在模板中指派或綁定的名稱會被保守地排除。Controller 到 view 以及 partial render 的關係需要額外的 Rails 語意接線。
Full(Medium + 其他所有語言)——預設
| 語言 | 副檔名 | Feature flag |
|---|---|---|
| ActionScript | .as | lang-actionscript |
| Lua | .lua | lang-lua |
| Zig | .zig | lang-zig |
| Objective-C | .m、.mm | lang-objc |
| Perl | .pl、.pm | lang-perl |
| Batch/CMD | .bat、.cmd | lang-batch |
| Fortran | .f90、.f95、.f03、.f08、.f18、.f、.for | lang-fortran |
| COBOL | .cob、.cbl、.cpy | lang-cobol |
| MS BASIC 2.0 | .bas | lang-msbasic2 |
| GW-BASIC | .gw | lang-gwbasic |
| QBasic | .qb | lang-qbasic |
| QuickBASIC 4.5 | .bi、.bm | lang-qbasic |
| Dockerfile | Dockerfile、.dockerfile | lang-dockerfile |
| GLSL | .glsl、.vert、.frag、.comp | lang-glsl |
| Godot Shader | .gdshader、.gdshaderinc | lang-glsl |
| Minecraft Function | .mcfunction | lang-mcfunction |
| WGSL | .wgsl | lang-wgsl |
| HLSL | .hlsl、.fx | lang-hlsl |
| Verilog / SystemVerilog | .v、.vh、.sv、.svh | lang-systemverilog |
| VHDL | .vhd、.vhdl | lang-vhdl |
| Metal | .metal | lang-metal |
| CUDA / HIP | .cu、.cuh | lang-cuda |
| Markdown | .md、.markdown | lang-markdown |
| R | .r、.R | lang-r |
| SQL | .sql | lang-sql |
| Julia | .jl | lang-julia |
| Haskell | .hs、.lhs | lang-haskell |
| OCaml | .ml、.mli | lang-ocaml |
| Clojure | .clj、.cljs、.cljc | lang-clojure |
| Erlang | .erl、.hrl | lang-erlang |
| Elixir | .ex、.exs | lang-elixir |
| F# | .fs、.fsi、.fsx | lang-fsharp |
| F* | .fst、.fsti | lang-fstar |
| Quint | .qnt | lang-quint |
| Terraform | .tf、.tfvars | lang-terraform |
| TOML | .toml | lang-toml |
| Lean | .lean | lang-lean |
| HTML | .html、.htm | lang-html |
| CSS | .css | lang-css |
也可以在不使用完整層級的情況下單獨挑選個別語言:
cargo install tokensave --no-default-features --features lang-nix,lang-bash
所有提取器都共享相同的深度:函式、類別、方法、欄位、匯入、呼叫圖、繼承鏈、docstrings、複雜度指標、裝飾器/註解提取,以及跨檔案依賴追蹤。
HTML 和 CSS 是例外,因為這兩種語言都沒有可呼叫的符號。HTML 記錄帶有 id 的元素、自訂元素,以及頁面引入的樣式表和腳本;CSS 記錄 class 和 id 選擇器、自訂屬性、@keyframes 名稱和 @import。兩者都不會將 class="..." 屬性解析為樣式表規則:class 名稱是普通單詞,在整個專案中按裸名稱匹配它們會發明邊,而不是找到它們。
tokensave 與 CodeGraph 的比較
tokensave 是 CodeGraph(Node.js/TypeScript)從頭開始的 Rust 重寫。兩者都為 AI 編碼代理建構語意程式碼圖,但它們在範圍和能力上有顯著差異。
| tokensave | CodeGraph | |
|---|---|---|
| 執行環境 | 原生二進位檔(Rust) | Node.js 18+ |
| 安裝 | brew install、cargo install、scoop install | npx @colbymchenry/codegraph |
| 語言 | 50+(3 個層級:lite/medium/full) | 19+ |
| MCP 工具 | 80+ | 9 |
| 代理整合 | 12+(Claude、Codex、Gemini、Qwen、OpenCode、Cursor、Cline、Copilot、Roo Code、Zed、Antigravity、Kilo、Kiro、Kimi、Vibe、Grok、OMP、Pi、Plank、Factory Droid) | 1(Claude Code) |
| 索引新鮮度 | 每次 MCP 呼叫時進行隨需的過時檢查;連線時進行追趕同步;多代理工作預期使用 git worktrees | 原生 OS 層級檔案監視器(FSEvents/inotify/ReadDirectoryChangesW,2 秒防抖動);連線時進行追趕同步 |
| 多分支索引 | 是,可選(每個分支的 DB、跨分支 diff/搜尋) | 否 |
| 複雜度指標 | AST 提取(分支、迴圈、巢狀深度、cyclomatic 和 cognitive 複雜度、Halstead、可維護性指數、CRAP) | 否 |
| 移植工具 | 是(port_status、port_order) | 否 |
| 圖形視覺化器 | 已移除(v4.0.1) | 是 |
| 語意搜尋 | 代理驅動的關鍵字擴展(零成本) | 本地嵌入(nomic-embed-text-v1.5 透過 ONNX) |
| MCP 資源 | 4(status、files、overview、branches) | 否 |
| MCP 註解 | 是(readOnlyHint、alwaysLoad) | 否 |
| 死碼偵測 | 是 | 否 |
| 循環依賴偵測 | 是 | 否 |
| 型別階層 | 是 | 否 |
| God class / 耦合分析 | 是 | 否 |
| Commit / PR 上下文 | 是 | 否 |
| 測試對應 | 是 | 否 |
| 重新命名預覽 | 是 | 否 |
| Token 追蹤 | 每次呼叫指標、即時 TUI 監視器、session + lifetime 計數器 | 否 |
| 程式碼健康分析 | 綜合分數、Gini、依賴深度、DSM、風險加權測試缺口、session 差異 | 否 |
| 編輯原語 | 4 個原子寫入器(str_replace、multi_str_replace、insert_at、ast_grep_rewrite),具有自動重新索引 | 否 |
| 崩潰韌性 | 子程序隔離提取;原生語法中止會跳過檔案,同步繼續 | 否 |
| 自我升級 | tokensave upgrade,具有 stable/beta 頻道 | npm update |
| DB 引擎 | libsql(SQLite fork、WAL、async) | better-sqlite3 / wa-sqlite(WASM) |
| 索引速度 | 1,782 個檔案約 1.2 秒 | 1,782 個檔案約 4 秒 |
| 二進位檔大小 | 約 25 MB 壓縮下載(包含所有語法) | 約 80 MB(node_modules + WASM) |
CodeGraph 開創了這種方法,如果您偏好 npm 工具且只需要 Claude Code 整合,它仍然是可靠的選擇。tokensave 透過更深入的分析、更多代理、多分支支援,以及沒有執行依賴的原生二進位檔,擴展了這個概念。
有關與 CodeGraph、Dual-Graph(GrapeRoot)、code-review-graph 和 OpenWolf 的詳細比較,請參閱 docs/COMPARABLE-TOOLS.md。
並排比較頁面(每個頁面都說明了另一個工具更好的地方): Serena · code-review-graph · Graphify · CodeGraph · token-savior · GrapeRoot · LeanCTX · OpenWolf — 索引位於 tokensave.dev/vs。
為什麼選擇 tokensave 而非其他替代方案
有幾種工具可以減少 AI 編碼代理的 token 使用量。以下是 tokensave 與眾不同的原因。
單一原生二進位檔,零依賴
大多數替代方案需要執行環境:Python、Node.js 或兩者。tokensave 以單一 Rust 二進位檔提供,內含所有 50+ 種 tree-sitter 語法(約 25 MB 壓縮下載)。無需安裝其他東西——而且與 Serena 等 LSP 支援的工具不同,不需要為每種語言安裝、啟動或預熱語言伺服器。現在有兩個工具在打包方面與 tokensave 匹配:CodeGraph 內建自己的執行環境,而 LeanCTX 也是單一 Rust 二進位檔。
最深入的程式碼智慧
tokensave 在符號層級運作:函式、結構體、欄位、呼叫邊、型別階層、複雜度指標。像 Dual-Graph(GrapeRoot)這樣的替代方案在檔案層級運作——它們知道哪些檔案存在,但無法回答「誰呼叫了這個函式?」或「如果我更改這個結構體會破壞什麼?」tokensave 的 80+ 個專門 MCP 工具涵蓋呼叫圖遍歷、影響分析、死碼偵測、測試對應、重新命名預覽、型別階層、循環依賴偵測、複雜度排名、程式碼健康分析(Gini、DSM、依賴深度、風險加權測試缺口)、原子編輯原語等。最接近的可比較圖形工具 code-review-graph 暴露了 30 個;其他幾個則刻意設計為暴露少於 10 個。
最廣泛的代理支援
超過十幾種 AI 編碼代理整合,每種代理都有各自的原生設定格式。沒有其他工具能涵蓋這麼多代理,且整合深度如此之高。Claude Code 獲得 hooks、提示規則,以及自動允許的工具權限。Kiro 獲得全域 MCP 設定、以資源形式載入的 tokensave.md 導向、具寬鬆內建/tokensave 工具核准的受管代理,以及用於委派護欄和寫入後同步的 hooks。其他代理則以其原生設定格式註冊 MCP 伺服器。
多分支索引
此領域中唯一提供可選的每分支圖形資料庫,以及跨分支差異與搜尋的工具。啟用後,切換分支是即時的——無需重新索引。
每次呼叫的 token 追蹤
唯一能回報每個 MCP 工具呼叫節省了多少 token 的工具,並提供跨所有專案的即時 TUI 監控器與終身計數器。
完全開源
MIT 授權的 Rust,可端到端稽核。Dual-Graph 的核心引擎(PyPI 上的 graperoot)是專有的——你無法看到它對你的程式碼圖形做了什麼。OpenWolf 是 AGPL-3.0,要求衍生作品必須開源。
效能
在一個包含 1,782 個檔案的混合 Rust/Java/Scala 程式碼庫(57K 節點、103K 邊)上的完整索引基準測試:
| 工具 | 時間 | 加速 |
|---|---|---|
| CodeGraph (TypeScript) | 31.2s | 1x |
| tokensave (Rust) | 1.2s | 26x |
疑難排解
「tokensave 未初始化」
你的專案中不存在 .tokensave/ 目錄。
tokensave init
MCP 伺服器無法連線
AI 代理看不到 tokensave 工具。
- 確保代理設定包含 tokensave MCP 伺服器(執行
tokensave doctor) - 完全重新啟動代理
- 檢查
tokensave是否在你的 PATH 中:which tokensave
搜尋中缺少符號
- 執行
tokensave sync以更新索引 - 檢查語言是否受支援(見上表)
- 驗證檔案未被
.gitignore排除
索引緩慢
大型專案在首次完整索引時需要較長時間。
- 後續執行使用增量同步,速度快得多
- 日常更新請使用
tokensave sync(而非--force) - 當代理連線時,每次 MCP 工具呼叫都會自動檢查過期狀態
為特定專案停用 tokensave
如果專案太大且 tokensave 使用過多 RAM,你可以透過在其環境中設定 TOKENSAVE_DISABLE_SERVER=true 來按專案停用 MCP 伺服器。伺服器會在不初始化的情況下乾淨退出。
Claude Code — 新增到你的專案 .claude/settings.json:
{
  "mcpServers": {
    "tokensave": {
      "command": "tokensave",
      "args": ["serve"],
      "env": {
        "TOKENSAVE_DISABLE_SERVER": "true"
      }
    }
  }
}
其他代理 — 在你的代理用來啟動 MCP 伺服器的任何設定中設定環境變數。
你也可以透過 shell 全域設定(TOKENSAVE_DISABLE_SERVER=true claude),但這會停用該工作階段中所有專案的 tokensave MCP 伺服器。
DISABLE_TOKENSAVE=true 仍作為已棄用的相容性別名受支援,適用於在此變數命名空間化之前建立的設定。
起源
此專案是原始 CodeGraph TypeScript 實作的 Rust 移植版,原作者為 @colbymchenry。此移植版維持相同的架構和 MCP 工具介面,同時利用 Rust 的效能和原生 tree-sitter 綁定。
建置
cargo build --locked --release                          # full (50+ languages, default)
cargo build --locked --release --features medium        # medium tier
cargo build --locked --release --no-default-features    # lite (smallest binary)

cargo test --workspace --locked                         # run all tests (requires full)
cargo check --locked --no-default-features              # verify lite compiles
cargo clippy --workspace --all-targets --locked
開發指令使用除錯建置;安裝使用最佳化的發行輸出(cargo install --path . --locked)。target/debug 永遠不是安裝輸入。
Star 歷史

贊助者
| Windows 免費程式碼簽章由 SignPath.io 提供,憑證由 SignPath Foundation 提供 |
授權
MIT 授權——詳見 LICENSE。