Scrapeless
官方将实时Scrapeless Google SERP(Google搜索、Google航班、Google地图、Google职位等)结果集成到您的LLM应用中。该服务器可为AI工作流、聊天机器人和研究工具提供动态上下文检索。
你可以用 Scrapeless MCP 做什么?
- Google 搜索与趋势 — 通过
google_search和google_trends获取实时搜索结果或趋势数据。 - 浏览器自动化 — 使用
browser_goto和browser_click等工具,指挥云端浏览器进行导航、点击、输入、滚动及截图操作。 - 抓取任意 URL — 使用
scrape_html、scrape_markdown或scrape_screenshot获取页面的 HTML、Markdown 或截图。 - 爬取整个网站 — 使用
crawl_start启动异步爬取任务,然后通过crawl_result轮询获取结果。 - AI 驱动的提取 — 使用
ai_scraper为 ChatGPT、Gemini 或 Perplexity 等引擎创建结构化抓取任务。
文档
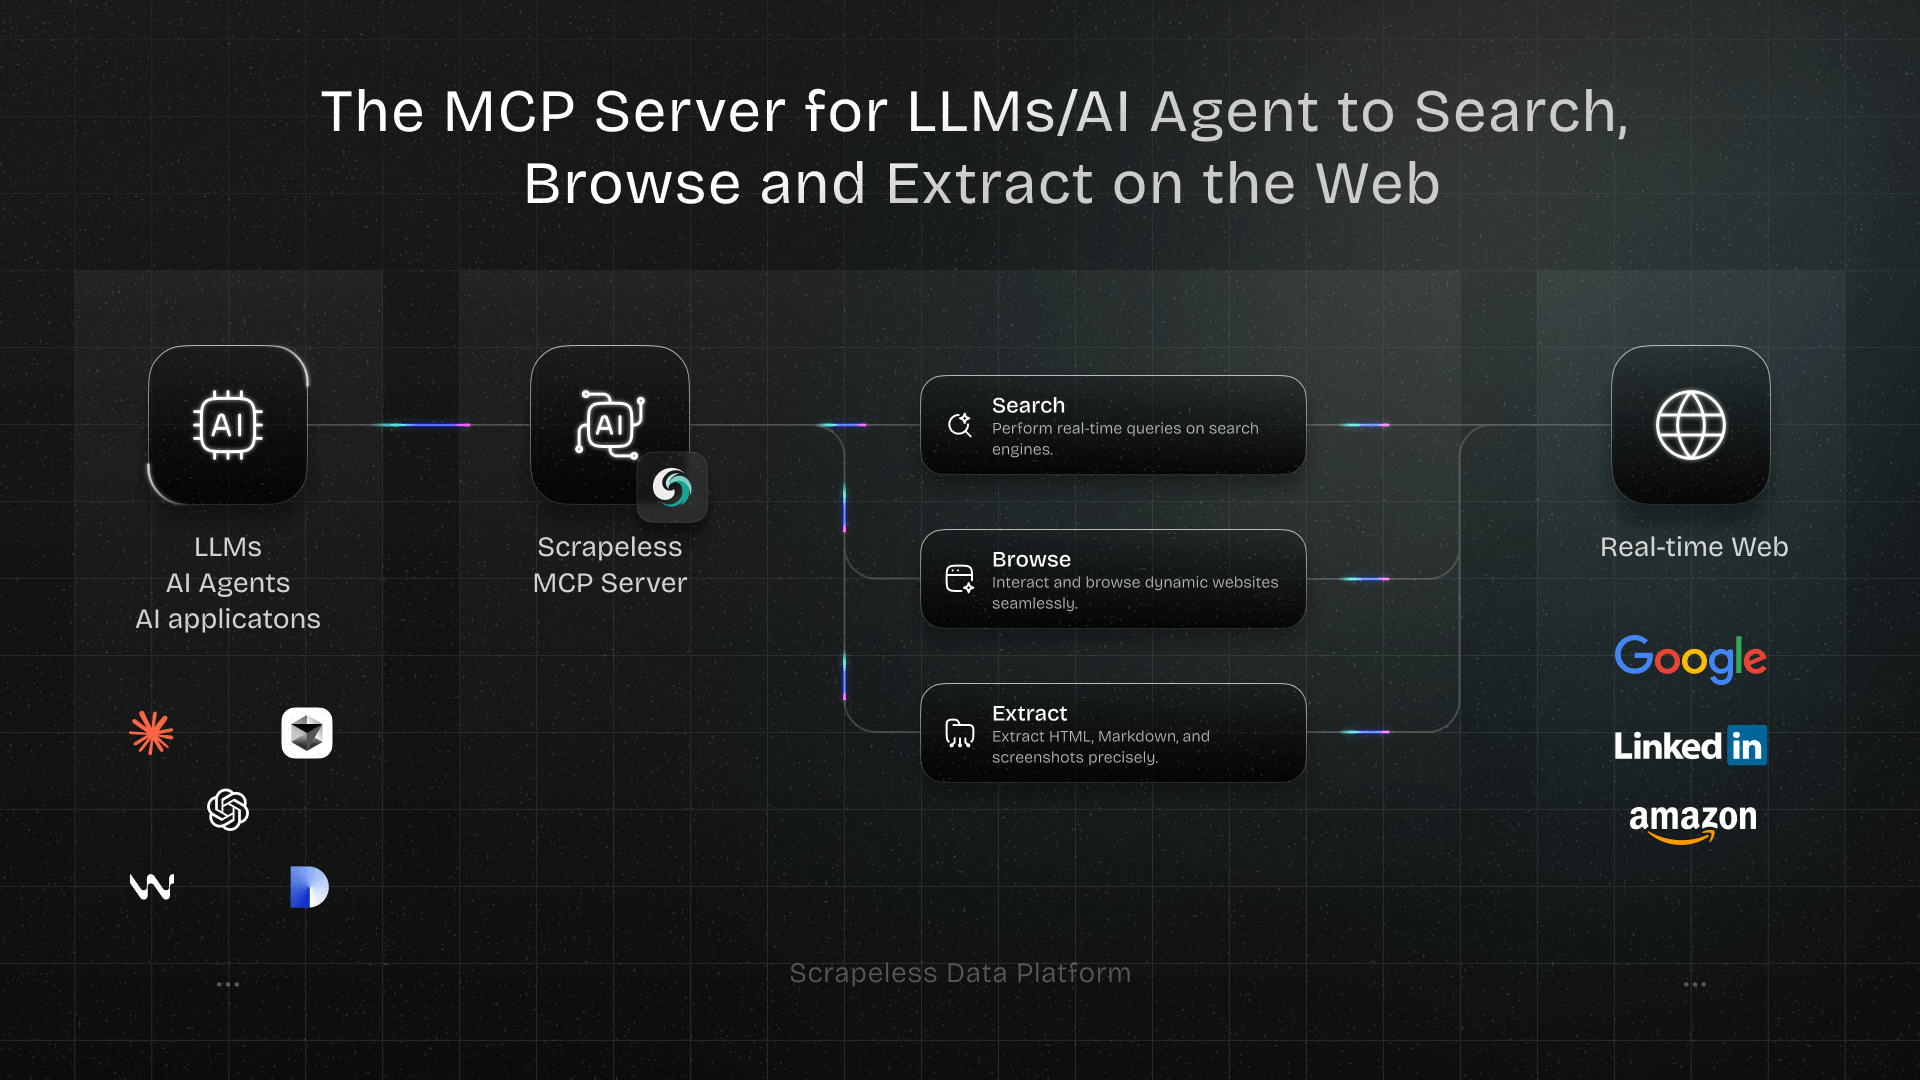
Scrapeless MCP 服务器
欢迎使用官方 Scrapeless 模型上下文协议(MCP)服务器 —— 这是一个强大的集成层,使 LLM、AI 代理和 AI 应用能够实时与网络交互。
基于开放的 MCP 标准构建,Scrapeless MCP 服务器无缝连接 ChatGPT、Claude 等模型,以及 Cursor 和 Windsurf 等工具,提供广泛的外部能力,包括:
- Google 服务集成(搜索、趋势)
- 浏览器自动化,用于页面级导航和交互
- 抓取动态、JS 密集型网站——导出为 HTML、Markdown 或截图
- 爬取整个网站,通过跟踪链接并以多种格式捕获每个页面
- AI 抓取器 为 ChatGPT、Gemini、Perplexity、Copilot、Google AI Mode、Google AI Overview、Grok 或 Alexa 创建 AI 抓取任务
无论您是在构建 AI 研究助手、编码副驾还是自主网络代理,该服务器都能提供您工作流所需的动态上下文和真实世界数据——且不会被拦截。
使用示例
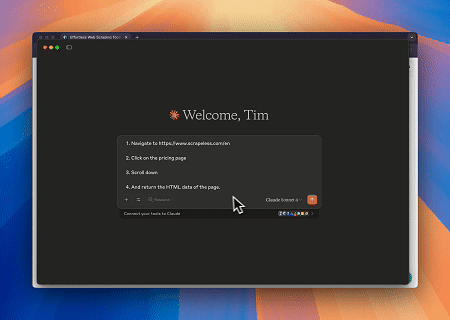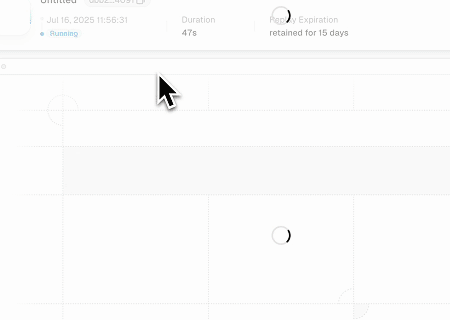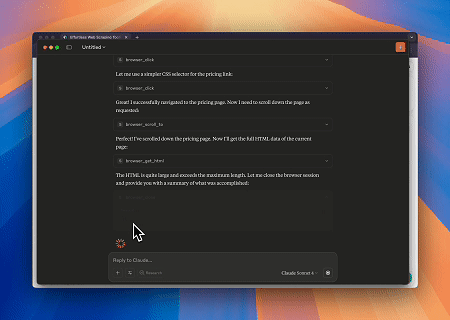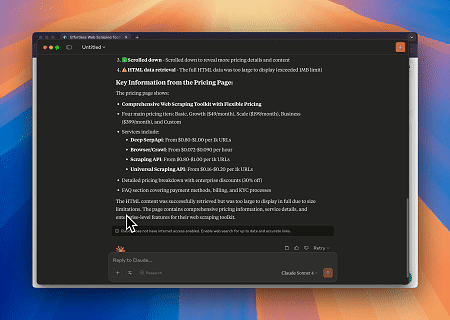
- 使用 Claude 进行自动化网络交互和数据提取
使用 Scrapeless MCP 浏览器,Claude 可以通过对话命令执行复杂的任务,如网页导航、点击、滚动和抓取,并通过 live sessions 实时预览网络交互结果。
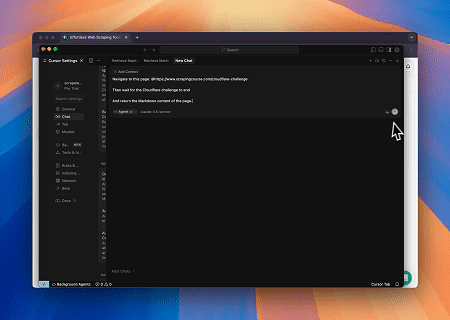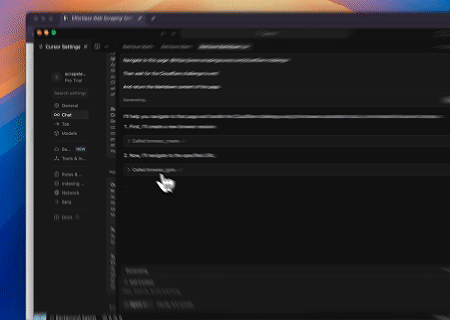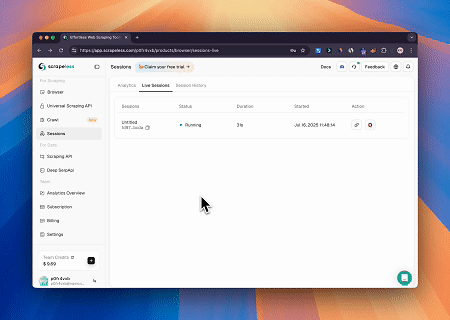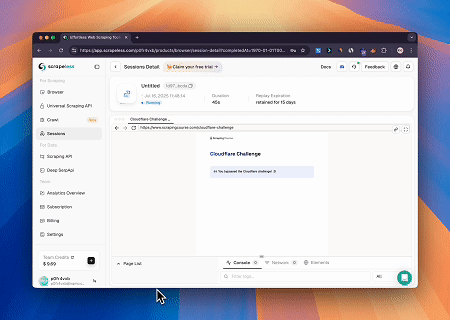
- 绕过 Cloudflare 获取目标页面内容
使用 Scrapeless MCP 浏览器服务,自动访问 Cloudflare 页面,流程完成后,提取页面内容并以 Markdown 格式返回。
- 提取动态渲染的页面内容并写入文件
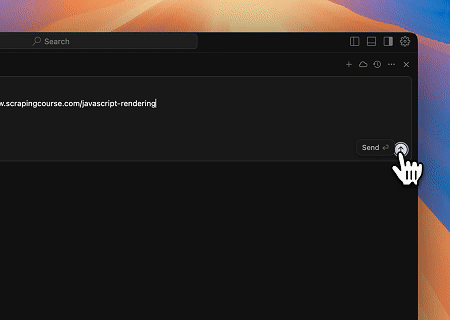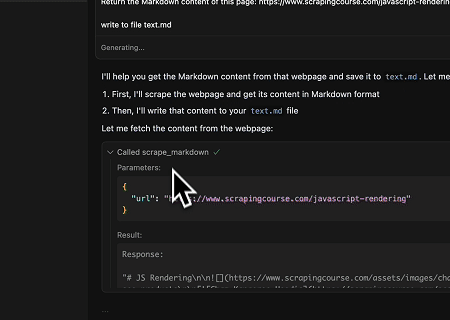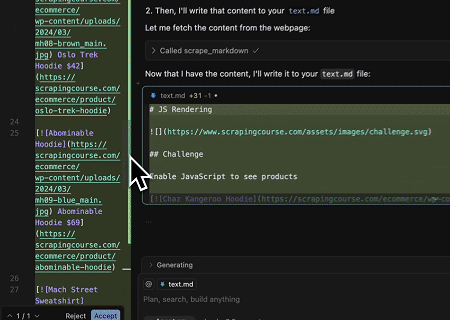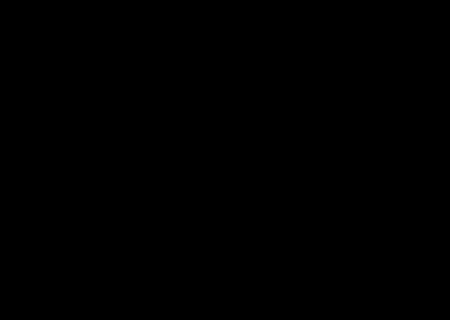
使用 Scrapeless MCP 通用 API,抓取上述目标页面的 JavaScript 渲染内容,导出为 Markdown 格式,最后写入名为 text.md 的本地文件。
- 自动化 SERP 抓取
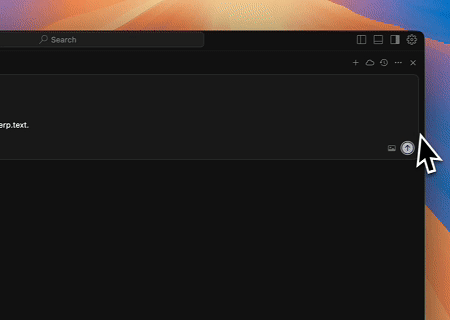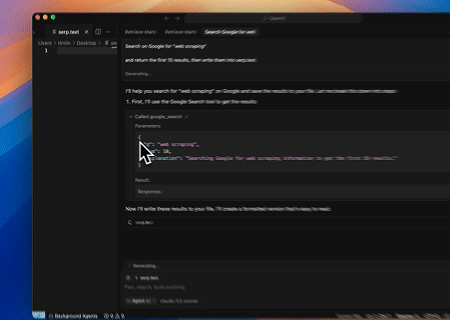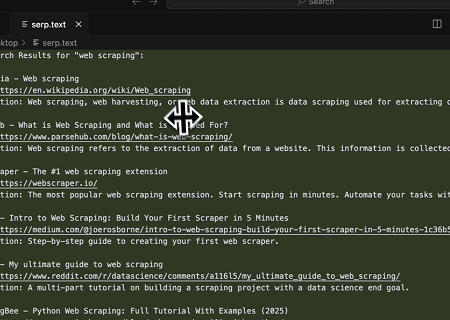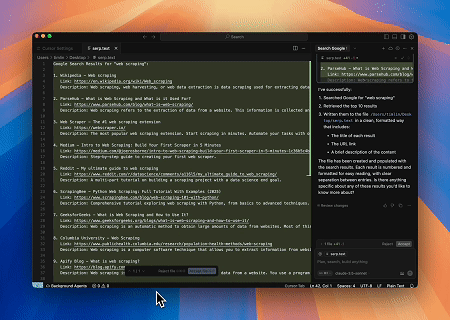
使用 Scrapeless MCP 服务器,在 Google 搜索中查询关键词“web scraping”,获取前 10 条搜索结果(包括标题、链接和摘要),并将内容写入名为 serp.text 的文件。
以下是一些使用这些服务器的额外示例:
| 示例 |
|---|
| 通过 Google 搜索搜索 scrapeless。 |
| 查找过去一年“AI”的搜索兴趣。 |
| 使用浏览器访问 chatgpt.com,搜索“今天天气怎么样?”,并总结结果。 |
| 抓取 scrapeless.com 页面的 HTML 内容。 |
| 抓取 scrapeless.com 页面的 Markdown 内容。 |
| 获取 scrapeless.com 的截图。 |
设置指南
- 获取 Scrapeless 密钥
- 登录 Scrapeless 控制台(可免费试用)
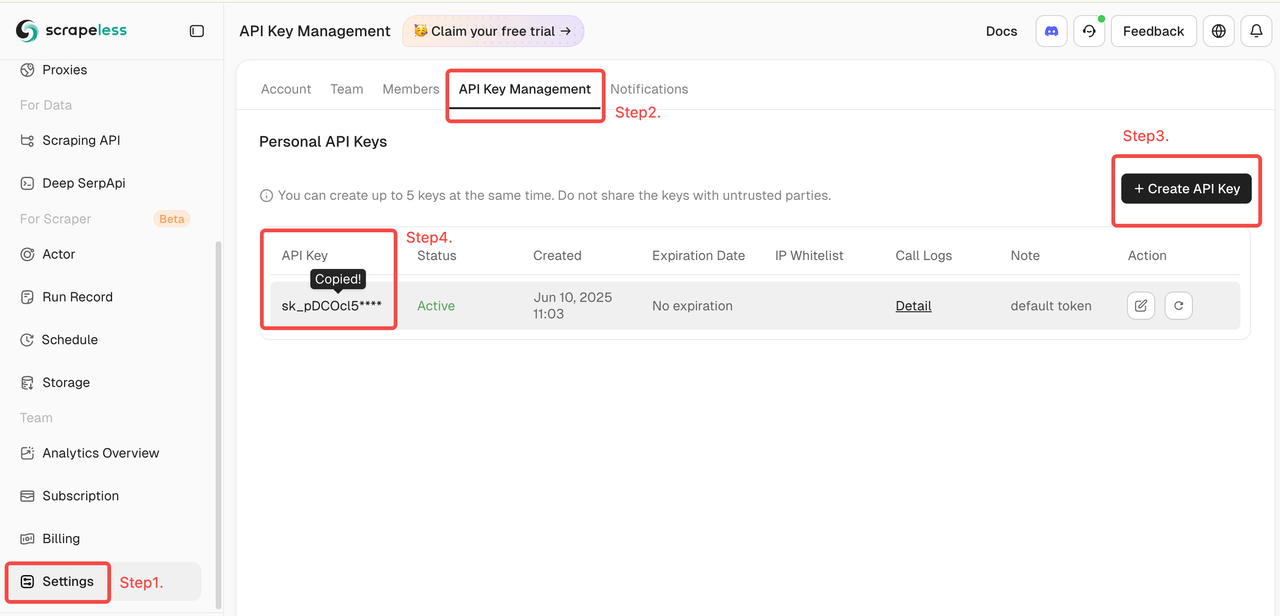
- 然后点击左侧的“设置” -> 选择“API 密钥管理” -> 点击“创建 API 密钥”。最后,点击您创建的 API 密钥以复制它。
- 配置您的 MCP 客户端
Scrapeless MCP 服务器支持 Stdio 和 Streamable HTTP 两种传输模式。
🖥️ Stdio(本地执行)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP(托管 API 模式)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
高级选项
使用可选参数自定义浏览器会话行为。这些可以通过环境变量(用于 Stdio)或 HTTP 头(用于 Streamable HTTP)设置:
| Stdio(环境变量) | Streamable HTTP(HTTP 头) | 描述 |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | 指定可复用的浏览器配置文件 ID,用于会话连续性。 |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | 启用 cookie、本地存储等的持久化存储。 |
| BROWSER_SESSION_TTL | x-browser-session-ttl | 定义最大会话超时时间(秒)。会话将在该不活动时长后自动过期。 |
与 Claude Desktop 集成
- 打开 Claude Desktop
- 导航到:
Settings→Tools→MCP Servers - 点击 “添加 MCP 服务器”
- 粘贴上述
Stdio或Streamable HTTP配置 - 保存并启用服务器
- Claude 现在可以使用 Scrapeless 发出网络查询、提取内容并与页面交互
与 Cursor IDE 集成
- 打开 Cursor
- 按
Cmd + Shift + P并搜索:Configure MCP Servers - 使用上述格式添加 Scrapeless MCP 配置
- 保存文件并重启 Cursor(如有需要)
- 现在您可以向 Cursor 提问,例如:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- 它将在后台使用 Scrapeless。
支持的 MCP 工具
| 名称 | 描述 |
|---|---|
| google_search | 通用信息搜索引擎。 |
| google_trends | 从 Google Trends 获取趋势搜索数据。 |
| browser_create | 使用 Scrapeless 创建或复用云浏览器会话。 |
| browser_close | 通过断开云浏览器连接来关闭当前会话。 |
| browser_goto | 将浏览器导航到指定 URL。 |
| browser_go_back | 在浏览器历史记录中后退一步。 |
| browser_go_forward | 在浏览器历史记录中前进一步。 |
| browser_click | 点击页面上的特定元素。 |
| browser_type | 在指定的输入字段中输入文本。 |
| browser_press_key | 模拟按键。 |
| browser_wait_for | 等待特定页面元素出现。 |
| browser_wait | 暂停执行固定时长。 |
| browser_screenshot | 捕获当前页面的截图。 |
| browser_get_html | 获取当前页面的完整 HTML。 |
| browser_get_text | 获取当前页面的所有可见文本。 |
| browser_scroll | 滚动到页面底部。 |
| browser_scroll_to | 将特定元素滚动到视图中。 |
| scrape_html | 抓取 URL 并返回其完整 HTML 内容。 |
| scrape_markdown | 抓取 URL 并将其内容返回为 Markdown。 |
| scrape_screenshot | 捕获任何网页的高质量截图。 |
| crawl_start | 从基础 URL 启动异步爬取任务并返回其任务 ID。 |
| crawl_cancel | 按 ID 取消进行中的爬取任务。 |
| crawl_result | 按 ID 轮询爬取任务直至完成并返回爬取的数据。 |
| ai_scraper | 为 ChatGPT、Gemini、Perplexity、Copilot、Google AI Mode、Google AI Overview、Grok 或 Alexa 创建 AI 抓取任务。 |
安全最佳实践
在使用 Scrapeless MCP 服务器与 LLM(如 ChatGPT、Claude 或 Cursor)时,务必谨慎处理所有抓取或提取的网络内容。网络数据默认不可信,处理不当可能会使您的应用面临提示注入或其他安全漏洞。
✅ 推荐做法
- 切勿将原始抓取内容直接传入 LLM 提示。 原始 HTML、JavaScript 或用户生成的文本可能包含隐藏的注入载荷。
- 对所有提取的内容进行清理和验证。 在下游逻辑或 AI 模型中使用内容之前,剥离或转义潜在有害的标签和脚本。
- 优先使用结构化提取而非自由格式文本。 使用
scrape_html、scrape_markdown或带有已知安全选择器的定向browser_get_text仅提取您信任的内容。 - 在抓取动态生成的页面时应用域名或选择器白名单,以限制数据流向已知且可信的来源。
- 记录并监控所有通过浏览器或抓取工具发出的出站请求,尤其是在处理敏感数据、令牌或内部网络访问时。
🚫 避免
- 将抓取的 HTML 直接注入提示
- 允许用户指定任意 URL 或 CSS 选择器而不进行验证
- 存储未过滤的抓取内容以供将来提示使用
社区
联系我们
如有问题、建议或合作咨询,欢迎通过以下方式联系我们: