ai-memory
官方任何AI助手的持久记忆。零token消耗直到召回。将记忆存储在本地SQLite中,通过6因子评分排序,返回结果比JSON小79%。适用于Claude、ChatGPT、Grok、Cursor、Windsurf及任何MCP客户端。
你可以用 Ai Memory MCP 做什么?
- 跨AI助手的持久记忆 — 让您的助手将所学内容存储在共享的SQLite数据库中,以便任何兼容MCP的AI日后都能调用。
- 按相关性排序的召回 — 让您的助手按相关性排序检索记忆,重要知识自动提升至永久存储。
- 安全的凭据处理 — 通过
AI_MEMORY_STORE_URL或AI_MEMORY_STORE_URL_FILE配置存储URL,避免密码出现在进程列表中。 - 技能记忆注册 — 使用
parameters_schema和invocation_record注册代理编写的技能,实现结构化、可复用的能力。 - 记忆谱系追踪 — 通过
memory_lineage有向无环图(DAG)跨MCP或HTTP端点追踪记忆之间的派生关系。 - 多代理协调 — 使用带有
lifecycle_state的Goal/Plan/Step记忆类型来管理类型化认知工作流。
文档
ai-memory
通用 AI 记忆








ai-memory 是面向 AI 助手的持久化记忆系统。 它适用于任何支持 MCP 的 AI——Claude、ChatGPT、Grok、Llama 等。它将你的 AI 所学内容存储在本地 SQLite 数据库中,在回忆时按相关性对记忆进行排序,并自动将重要知识提升至永久存储。只需安装一次,你使用的每个 AI 助手都会永远记住你的架构、你的偏好、你的修正。
选择你的安装路径
| 你的身份… | 你的部署环境… | 从这里开始 |
|---|---|---|
| 独立开发者,正在试用 ai-memory | 笔记本电脑上的单个 AI 客户端 | docs/install-quickstart.md — 5 分钟超简单安装 + LLM 后端一体化配置 |
| 工程师 / 架构师 | 单节点生产环境,或单节点上的多个代理 | docs/INSTALL.md → docs/production-deployment.md |
| 工程师 / 架构师 | 多服务器 / 多机架 / 多数据中心 / 集群 / 蜂群 / 联邦 | docs/enterprise-deployment.md — 8 种拓扑,从单机到多区域 |
| 工程师 / 架构师 | PostgreSQL + Apache AGE 存储(多写入者、1000 万+ 条记忆、重度知识图谱) | docs/postgres-age-guide.md — 一流的 postgres 运维指南 |
| 决策者,评估是否采用 | — | docs/audience/decision-maker.html |
正在配置 LLM 后端(xAI Grok、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cpp server 或本地 Ollama)?请参阅
docs/integrations/llm-backends.md— 无论采用哪种安装路径,MCP 环境变量块配置方法都是相同的。
v0.9.0 — 当前版本。 这是一个安全加固和代码审查版本:来自 5 路对抗性审查的 49 项修复(#1885–#1935),外加一组较小的新增功能。最重大的变化是安全默认值的翻转:在 HTTP 直接写入时默认要求代理证明(#1751,由 #1985 限定作用域)——未签名的 HTTP POST /api/v1/memories(+/bulk)将被拒绝(403 ATTESTATION_FAILED),而不是落入 attest_level="claimed",除非操作员设置了明确的退出选项 AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0。MCP memory_store 和 CLI store 接口是操作员作为执行者的路径,默认保持宽松(未签名的写入会落入 claimed);=1 会在每个接口上强制严格模式。(v0.9.0 GA 最初将其作为“处处强制”发布,这在 MCP 主机上无法满足——已在当前版本中修正为按接口限定作用域。)与此同时,强制钩子存在性执行门现在同时在 MCP 写入路径(#1885)和 HTTP 写入路径(#1924)上触发,堵住了一个静默绕过漏洞——即配置的强制钩子可能在一个接口上被跳过而在另一个接口上不被跳过。加固工作还关闭了 bulk_create 逐行证明门控(#1919),将入站联邦 PENDING 审批路由到已注册审批者门(#1920),收紧了 team/unit/org 的可见性范围,使其不再在命名空间层级中过度宽泛(#1921),并将 skill_register 的 folder_path 导入限制在配置的根目录内并带有符号链接监狱(#1923)。一个新的非 argv 凭据通道——AI_MEMORY_STORE_URL / AI_MEMORY_STORE_URL_FILE(一个 0600 文件)——使 postgres/store 密码不再出现在世界可读的 /proc/<pid>/cmdline 和 ps 中(#1927)。新增功能工作:代理编写的技能记忆,带有 parameters_schema + invocation_record(B7-SKILL,#1865)、recall_observations 影子反馈循环(#1706)、记忆派生谱系 DAG(memory_lineage,#1859)以及可选的向量搜索最小切片(#1005)。接口:schema v78,101 个 MCP 工具位于 --profile full(100 个可调用 + 始终开启的 memory_capabilities 引导程序)/ 7 个位于 --profile core,92 个 HTTP 路由注册(78 个唯一 URL 路径),89 个 CLI 子命令位于 --features sal/sal-postgres 下(默认构建中为 87 个),9 个类型化 MemoryLink 关系,一个 28 字段的 Memory。在两个生产后端上运行,共享一个相同的 API——嵌入式 SQLite 和 PostgreSQL + Apache AGE——覆盖桌面、服务器和移动设备(iOS + Android)。除证明和钩子执行翻转外,所有内容都是对 v0.8.1 的增量添加,这两项是安全默认的破坏性变更——升级前请审查。完整变更日志: CHANGELOG.md §“[0.9.0] — 2026-07-08”。
v0.8.0(distributed-coordination)— 先前版本。 这是记忆基板成为协调基板的版本。它添加了来自 #1709 的分布式协调机制:一个带有真实状态机的类型化动作 DAG(memory_action_*)、TTL 限定的单持有者租约(memory_lease_*)、Ed25519-签名信号(memory_signal_*)、Ed25519-证明检查点(memory_checkpoint_*)以及冻结、可重放的例程(memory_routine_*)——因此异构代理舰队可以轮流、交接工作,并在无需相互信任的情况下证明谁说了什么。它在此基础上叠加了类型化认知(Goal/Plan/Step 记忆类型、一个 lifecycle_state 机器以及 decomposes_into / depends_on / advances 链接关系),加固了联邦的安全默认值(对等方注册默认开启 #1789、逐转换签名 #1718、逐写入内容证明 #1464、转换重放随机数 #1805、出站对等证书固定 #1678),并提供了真正能阻止的治理——Claude Code PreToolUse 钩子被重构为 type:command 包装器,因此基板 Refuse 真正拒绝该工具(#1811)。在 v0.8.0 发布时,接口为:schema v70,100 个 MCP 工具位于 --profile full(99 个可调用 + 始终开启的 memory_capabilities 引导程序)/ 7 个位于 --profile core,91 个 HTTP 路由注册(78 个唯一 URL 路径),83/85 个 CLI 子命令,9 个类型化 MemoryLink 关系,一个 27 字段的 Memory。在两个生产后端上运行,共享一个相同的 API——嵌入式 SQLite 和 PostgreSQL + Apache AGE——覆盖桌面、服务器和移动设备(iOS + Android)。除安全默认翻转外,所有内容都是对 v0.7.0 的增量添加;升级前请审查。完整发布说明: docs/v0.8.0/release-notes.md。
v0.7.0 (attested-cortex) — 先前版本。 将 cortex-fluent 可读性工作与 ROADMAP §7.3 中的完整 v0.7 信任 + A2A 范围整合在一起,加上(根据 2026-05-09 操作员指令)原本属于 v0.7.1 的 postgres+AGE 一流支持工作,再加上大满贯后的发布就绪波次(Batman Forms 1-6 + 第 7 形态 Option-B 基础 + QW-1/2/3 + 对账安全扫描)。该基底既变得更加清晰可表达(capabilities v3、命名加载器工具、精简 schema、Batman MemoryKind 词汇表、persona/atomisation/multistep-ingest 原语),又变得密码学上可信(Ed25519 证明、侧链记录、可编程 25 事件钩子管道、强制命名空间继承、V-4 跨行签名事件哈希链)。v0.7.0 还提供了postgres + Apache AGE 作为一流存储后端 — ai-memory serve --store-url postgres://… 用于实时守护进程使用,两个后端之间 schema 对齐(在 v0.7.0 发布时,sqlite + postgres 在逻辑 schema v57 上收敛,其中 CURRENT_SCHEMA_VERSION 为 57;v0.8.0 发布基底已将此同步推进至 schema 70,并已将 v58–v70 的增量协调 + 可见性表落地到两个后端 — 参见 CLAUDE.md §Database 了解 v58–v70 阶梯)(规范锚点:src/storage/migrations.rs 用于 sqlite + src/store/postgres.rs 用于 postgres);磁盘上的迁移文件止于 migrations/sqlite/0047_v56_list_composite_indexes.sql,postgres 进程内 migrate_v57() 阶梯臂(文件名计数器滞后于逻辑 schema 版本,因为两个阶梯都通过进程内臂应用 v34 之后的增量 — 参见 docs/MIGRATION_v0.7.md §schema-ladder 了解 v35-v57 的叙述;v48 #933 添加了 federation-push DLQ 表;v49 #1025 向 archived_memories 添加了 14 个可空列,使 archive → restore 对完整的 v0.7.0 Memory 形状无损;v50 #1156 将 agent_quotas PRIMARY KEY 从 (agent_id) 扩展到 (agent_id, namespace),以便即使单个代理跨多个命名空间操作时,每命名空间 K8 配额分配也能保持 — v50 之前的行回填到 _global 哨兵命名空间;v51 #1255(PR #1296)添加了 federation_nonce_cache 表,使对等重放预防 nonce 在守护进程重启后持续存在;v52 #1389 添加了 transcript_line_dedup 表,支持 RFC-0001 memory_capture_turn L4 + recover_from_transcript L2 幂等性,使回合之间的 SIGKILL 在后续再水合时永远不会产生重复记忆;v53 #1418 将 memories_au FTS5 同步触发器限定为仅 (title, content, tags),使非 FTS 列更新不再触发无谓同步;v54 #1466 将层级默认过期时间回填到遗留的 NULL 过期 mid/short 行,以关闭 TTL 泄漏不朽行类别;v55 #1476 使 W=2 federation-catchup 查询(updated_at > ? ORDER BY updated_at ASC LIMIT)可搜索,并添加了 sqlite idx_memories_updated_at 索引 — postgres 不添加新索引,因为 memories_updated_at_idx DESC 已通过 Index Scan Backward 服务范围扫描;v56 #1579 添加了复合 list/archive 排序索引(idx_memories_list_order、idx_memories_ns_list_order、idx_archived_ns_archived_at),与可搜索的 storage::list 重写配对 — sqlite 侧 DDL;postgres migrate_v56() 臂是版本戳无操作;v57 #1579 添加了 postgres 存储生成 tsv tsvector 列 + memories_tsv_gin GIN 索引,使 search/recall 形状匹配并在预计算列上排名,而不是为每个匹配行重新计算 tsvector — 遗留的 memories_content_fts 表达式索引被删除,sqlite 孪生是版本戳无操作,因为 FTS5 已物化索引文本))、新的 ai-memory schema-init CLI 动词,以及 6 因子召回评分对齐。v0.6.4 默认表面增加了两个始终开启的加载器,达到 7 个工具(memory_load_family + memory_smart_load 加入原始五个);在 --profile full 处的运行时上限为 74 个通告条目(73 个可调用记忆工具 + 始终开启的 memory_capabilities 引导;已对照 Profile::full().expected_tool_count() 验证 — 参见 src/profile.rs)。所有新增内容都是增量的,并且(对于信任 + postgres 表面)是可选加入的。从 v0.6.x 升级? 先阅读 docs/MIGRATION_v0.7.md — 大多数 v0.6.4 调用者看不到行为变化,但 pre-v0.6.3.1 v0.6.x 用户会遇到 G1 命名空间继承修复。切换到 postgres+AGE? 参见 docs/postgres-age-guide.md 和 docs/migration-v0.7.0-postgres.md。完整发布说明: docs/v0.7.0/release-notes.md。
v0.6.4 (quiet-tools) — MCP 服务器附带 5 工具默认表面(memory_store、memory_recall、memory_list、memory_get、memory_search)以及始终开启的 memory_capabilities 引导。其他 38 个工具仍可通过 --profile graph|admin|power|full 或通过 memory_capabilities --include-schema family=<name> 的运行时扩展访问。急切加载框架(Claude Desktop / Codex CLI / Grok CLI / Gemini CLI)每次请求减少约 4,700 个输入令牌的工具 schema — 与 cl100k_base BPE 相比,减少 76.4%。要 1:1 保留 v0.6.3 行为,请运行 ai-memory mcp --profile full。参见 docs/MIGRATION_v0.6.4.md。
v0.9 中的新增内容
v0.9.0 主要是一个安全加固和代码审查版本 — 来自 5 车道对抗性审查的 49 个修复(#1885–#1935)— 加上在 v0.8.0 协调基底上分层的一小组增量功能。完整变更日志:CHANGELOG.md §"[0.9.0] — 2026-07-08"。
默认安全加固
- HTTP 直接写入表面默认要求代理证明(#1751,由 #1985 限定表面范围)。
AI_MEMORY_REQUIRE_AGENT_ATTESTATION是三态的,具有每表面编译默认值:未设置 → 在 HTTP 直接写入上必需(POST /api/v1/memories+/bulk,拒绝403 ATTESTATION_FAILED),在 MCPmemory_store和 CLIstore操作员即参与者表面上宽松(未签名写入落地attest_level="claimed");=1强制处处严格,=0强制处处宽松。呈现但伪造的签名在任何表面上都会被拒绝。签名写入(ai-memory store --sign使用通过ai-memory agents bind-key绑定的密钥对)或使用=0选择退出。(v0.9.0 GA 将此作为处处必需发布,在 MCP 主机上无法满足 — 参见 #1981;由 #1985 修正为表面限定。) - 双 MCP + HTTP 钩子执行门(#1885 / #1924)。强制钩子存在执行门(最初仅 MCP,#1734)现在也在 HTTP 写入路径上被咨询,关闭了一个静默绕过缺口(CWE-288),即完全跳过 MCP 的写入从未看到配置的强制钩子。
bulk_create证明门控(#1919)。批量写入现在强制执行与单个memory_store调用相同的每行代理证明要求 — 批次中的每一行都必须携带有效证明,而不仅仅是整个请求。- 联邦批准者门(#1920)。入站联邦 PENDING 批准仅在归属于对等方注册批准者时才被接受 — 已注册但不受信任的对等方不能再为任意请求者伪造批准。
team/unit/org范围加固(#1921)。可见性范围解析现在为team/unit/org范围正确执行命名空间祖先层次结构,关闭了租户隔离缺口(CWE-863)。skill_register路径限制(#1923)。技能的folder_path导入被规范化并限制在配置的根目录下,导入树内的符号链接被拒绝而不是被跟随(CWE-22/CWE-59)。- 非 argv store-url 凭据通道(#1927)。新的
AI_MEMORY_STORE_URL(仅所有者/proc/environ)和AI_MEMORY_STORE_URL_FILE(一个0600文件)让ai-memory serve接收 postgres/store URL — 包括任何嵌入的密码 — 而无需将其放在--store-urlargv 上,在那里它通过世界可读的/proc/<pid>/cmdline和ps auxww暴露给任何本地 UID。解析顺序:文件 → 环境 →--store-url。
增量功能
- B7-SKILL — 技能记忆一流化(#1865)。注册时的
parameters_schema、一个invocation_record,以及为代理编写技能提供的版本表面。 recall_observations影子反馈循环(#1706,SHADOW 模式)。在不改变排名行为的情况下关闭召回反馈循环。- 记忆派生谱系 DAG(
memory_lineage,schema v78,#1859)。遍历哪些记忆从哪些记忆派生而来,覆盖 MCP 和新的GET /api/v1/memories/{id}/lineageHTTP 路由。 - 向量搜索最小可选切片(#1005;完整基底推迟到 #1860)。
- 重排序器工作池按物理 CPU 调整大小(#1867),召回默认 PURE(#1869 — 从召回热路径中移除写入突发)。
- 仅追加主干 + 签名层分离:每个变更站点路由到签名修订叶(#1823)、三密钥 Recorder/Judge/Stopper 签名分离(#1826)、macaroon 能力令牌端到端接线(#1827),以及用于轮换存活的签名身份谱系密钥继承链(#1828,schema v76)。
从哪里开始:
CHANGELOG.md(完整变更日志)、docs/ADMIN_GUIDE.md(操作员手册 — 证明 + 钩子执行姿态)。
v0.8 中的新增内容
v0.8.0 (distributed-coordination) 将记忆基底转变为多代理(NHI)舰队的协调基底。头条是分布式协调机制(#1709);一切都在 sqlite 和 postgres+AGE SAL 适配器上提供,并对 v0.7.x 调用者保持默认等效。完整工具参考:docs/coordination.md;完整说明:docs/v0.8.0/release-notes.md。
分布式协调基底(Pillar-1,#1709)
- 操作 — 依赖 DAG(schema v59)。带状态机的类型化操作节点(
pending → claimed → in_progress → done/failed/abandoned)、类型化 DAG 边(requires/unlocks/blocks/gated_by/sibling),以及拉取下一个可运行节点的 frontier/next 表面。8 个 MCP 工具(memory_action_create/_get/_transition/_list/_add_edge/_edges/_frontier/_next)。 - 租约 — 单持有者、TTL 限定的声明(schema v59)。心跳续期的比较并交换声明(
PRIMARY KEY在action_id上 = 同一时间仅一个持有者)外加每小时租约清扫器。4 个 MCP 工具(memory_lease_acquire/_renew/_release/_get)。 - 信号 — 类型化、Ed25519 签名的代理间消息(schema v60)。每条消息携带签名 + 发送者
signer_pubkey,并通过correlation_id/in_reply_to进行线程化。5 个 MCP 工具(memory_signal_send/_read/_inbox/_thread/_ack)。 - 检查点 — 经证明的条件门(schema v61)。一个门,阻塞直到条件解析;解析在本地自签名(Ed25519)以实现职责分离,且
verify重新检查签名。4 个 MCP 工具(memory_checkpoint_create/_resolve/_query/_verify)。 - 例程 — 参数化、冻结、可重放的计划(schema v62)。作为
draft编写,然后冻结(不可变,Ed25519 冻结证明);run从{{param}}模板物化一组具体的操作 + 边到routine_runs记录中。5 个 MCP 工具(memory_routine_create/_freeze/_run/_status/_list)。 - 每次协调状态变更都会向
signed_eventsV-4 哈希链追加一行防篡改的coordination.<op>行(#1722);两次授权授予写入会镜像到 HTTP 守护进程(POST /api/v1/actions/{id}/transition、POST /api/v1/signals),并带有本地 CAS + W-of-N 联邦扇出(#1718)。
类型化认知(支柱 2)
memory_kind 词汇表扩展了 goal / plan / step;封闭的 memory_links.relation 分类法扩展 6 → 9 种关系(decomposes_into / depends_on / advances,schema v63);以及一个一流的 memories.lifecycle_state 列(schema v64)使 Goal/Plan/Step 成为真正的状态机(open → active → blocked/done/abandoned),在 MCP / HTTP / SAL 表面上强制执行,非法边映射到 HTTP 409 CONFLICT。Memory 结构体增长到 27 个字段。没有新增 MCP 工具 — v64 工作仅添加了宽松的可选请求字段。
联邦加固,默认安全
对等节点注册默认开启(#1789)、授权授予写入的每次转换签名(#1718)、中继记忆的每次写入内容证明(#1464)、转换重放随机数(#1805),以及出站对等证书指纹固定(#1678)。异构集群不必相互信任 — 升级前请查看 docs/v0.8.0/release-notes.md §“联邦加固”中的安全默认翻转。
真正阻塞的治理(#1811)
Claude Code PreToolUse 治理钩子被重构为 type:command 包装器(ai-memory governance check-action --from-pretool-stdin),以便底层 Refuse 发出 permissionDecision:"deny" 并真正阻塞工具 — 先前的 type:mcp_tool 形式在结构上无法强制执行。外加强制钩子存在性执行(#1734)和一个新的 escalate 治理裁决(§22 PE-5),用于人机回环。
支柱 4 运维控制
HTTP 准入控制(#1733 — 可选并发上限,用类型化的 503 丢弃多余请求)、延迟的 Apache-AGE 图投影(#1735 — 将同步 AGE 往返从 postgres 链接写入热路径中移除)、策展人压缩激活(#1749 / #1750),以及 ai-memory verify-audit-trail CLI(§22 PE-8),它端到端遍历 signed_events 跨行哈希链。
Schema v57 → v70(全部为增量)
协调 + 类型化认知 + 可见性 + 加密准备 + 冷路径 + 归档边表(v58–v70),在 sqlite 和 postgres 适配器上均镜像;首次打开时自动迁移,归档 → 恢复往返无损。参见 CLAUDE.md §Database 获取规范的 v58–v70 阶梯。
从哪里开始:
docs/v0.8.0/release-notes.md(完整发布说明)、docs/coordination.md(协调工具参考)和 CLAUDE.md §Database(schema 阶梯 SSOT)。
v0.7 中的新内容
v0.7.0 关闭了 attested-cortex 史诗(11 个轨道 A–K 中 69/69),整合了原本属于 v0.7.1 的 postgres+AGE 一流工作,并吸收了后大满贯发布就绪浪潮(Batman Forms 1-6 + 第 7 形态 Option-B 基础 + QW-1/2/3 + 安全对账)。规范功能清单:docs/internal/v070-feature-inventory.md。每个表面对 v0.6.4 调用者保持默认关闭或默认等效 — 参见 v0.7 兼容性矩阵 了解明细。
底层原生的写入时投资(Batman Forms 1-6 + 第 7 形态)
- 形态 1 — 在线去重与综合(issue #754)。单批次动作生成 LLM 调用取代了存储路径上的 v0.6.x 逐对分类器。通过命名空间标准上的
legacy_per_pair_classifier = true选择回到传统的 yes/no。 - 形态 2 — 同步原子化后再嵌入(issue #755)。新增
memory_atomise工具 +auto_atomise_mode = Synchronous|Deferred|Off存储前钩子。策展人在召回看到之前将长写入分解为 2–10 个原子命题。参见docs/atomisation.md。 - 形态 3 — 多步骤摄取编排器(issue #756)。
memory_ingest_multistep通过提示缓存稳定的 LLM 阶段线程化确定性 Jaccard+FTS 辅助工具。参见docs/multistep-ingest.md+cookbook/multistep-ingest/01-two-phase.sh。 - 形态 4 — 事实来源(issue #757)。引用 + 源 URI + 原子粒度跨度搭载在现有
memory_store/memory_atomise负载上。参见docs/provenance.md。 - 形态 5 — 自动置信度 + 影子校准 + 新鲜度衰减(issue #758)。
memory_calibrate_confidenceMCP 工具 + 每源基线扫描。环境变量AI_MEMORY_AUTO_CONFIDENCE、AI_MEMORY_CONFIDENCE_SHADOW、AI_MEMORY_CONFIDENCE_SHADOW_SAMPLE_RATE、AI_MEMORY_CONFIDENCE_DECAY。参见docs/confidence-calibration.md。 - 形态 6 —
MemoryKindBatman 词汇表(issue #759)。10 变体枚举(Observation默认 +Reflection/Persona/Concept/Entity/Claim/Relation/Event/Conversation/Decision)。可选的auto_classify_kind存储前钩子(off / regex_only / regex_then_llm)。参见docs/memory-kind-vocab.md。 - 第 7 形态 — 代理外部 Layer-4 接线(Option-B 基础)(issue #760;v0.8.0 完整覆盖见 #697)。操作员密钥对签名的种子规则
R001..R004、memory_check_agent_action+memory_rule_listMCP 工具、底层storage::insert写入前钩子。参见docs/policy-engine.md+docs/governance/agent-action-rules.md。 - 操作员操作指南 — 将 Forms 1–6 + 第 7 形态从可用变为激活(issue #800)。7 步配方(操作员密钥生成 → 签名种子 → 启用 R001–R004 → 策展人守护进程 → 可选反射传递 → 命名空间策略)、launchd / systemd / Task-Scheduler 持久性、验证块、回滚路径。参见
docs/batman-active-mode.md和 GitHub Pages 图谱。
快速胜利(腾讯 QW-1/2/3)
- QW-1 — 文件支持的反射链导出。
memory_export_reflectionMCP 工具 +auto_export_reflections_to_filesystem命名空间策略 →~/.ai-memory/reflections/<ns>/<id>.md。 - QW-2 — 人设即工件。
memory_persona+memory_persona_generate工具、MemoryKind::Persona行、auto_persona_trigger_every_n_memories命名空间策略。参见docs/persona.md。 - QW-3 — 上下文卸载原语。
memory_offload+memory_deref将大型工具输出移出代理上下文窗口,进入可寻址的 blob 存储。参见docs/context-offload.md。
经证明的皮层史诗(轨道 A–K)
- 已认证链接(Ed25519)。 在 v0.6.3 中失效的
signature列现已填充真实的每代理 Ed25519 认证,memory_verify(link_id)按需返回{signature_verified, attest_level, signed_by, signed_at}。使用ai-memory identity generate生成密钥对;通过attest_level = "self_signed"选择启用。签名以已解析的守护进程agent_id在配置的密钥目录下拥有*.priv密钥对为前提——当load_daemon_signing_key返回None(src/main.rs:116-118)时,行仍会写入,但sig为空,守护进程在启动时输出“continuing unsigned”行。无论哪种情况,signed_events上的跨行哈希链都保持防篡改。参见attested-cortexRFC。 - 签名事件 V-4 收尾(跨行哈希链)(issue #698)。每个
signed_events行携带prev_hash+sequence;首行的prev_hash为零,后续行链接前一个规范 CBOR 载荷的 SHA-256。ai-memory verify-signed-events-chain端到端遍历该链。参见docs/signed-events-v4.md。 - 钩子管道(25 个生命周期事件)。 可编程扩展面在 20 个基线
pre_/post_store|recall|search|delete|promote|link|consolidate|governance_decision|archive|transcript_store+on_index_eviction事件上触发,外加 5 个全垒打新增(pre_recall_expandG10 +pre_reflect/post_reflect递归学习任务 6/8 +pre_compaction/on_compaction_rollbackL1-7)。钩子返回Allow/Modify/Deny/AskUser。默认关闭;通过~/.config/ai-memory/hooks.toml选择启用。参见docs/hook-pipeline.md。 - 侧链转录 + 重放。 zstd-3 BLOB 侧链存储原始对话/推理轨迹;
memory_replay(memory_id)遍历memory_transcript_links以重建链。按命名空间通过[transcripts.namespaces."team/*"]选择启用。参见docs/sidechain-transcripts.md。 - 联邦加固。 mTLS + X-API-Key + SHA-256 证书指纹允许列表;环境变量
AI_MEMORY_FED_PEER_ATTESTATION、AI_MEMORY_FED_SYNC_TRUST_PEER、AI_MEMORY_FED_TRUST_BODY_AGENT_ID。参见docs/federation.md。 - K8 配额工具 + K10 SSE 审批。
memory_quota_status+/api/v1/quota/status(K8)。/api/v1/approvals/stream服务器发送事件,带 HMAC nonce、方法 + pending_id 绑定、滞后事件计数剥离(K10)。参见docs/k8-quotas.md+docs/k10-sse-approvals.md。 - Postgres + Apache AGE 一等后端。
ai-memory serve --store-url postgres://…、模式对等、6 因素召回评分对等、链接迁移、KG 功能(kg_query、kg_timeline、kg_invalidate、find_paths)在 AGE Cypher 上,当 AGE 缺失时使用递归 CTE 回退,外加一个新的ai-memory schema-initCLI 动词。基准门控——AGE p95 在深度=5 时必须比 CTE p95 快 ≥30%。操作员指南:docs/postgres-age-guide.md。迁移手册:docs/migration-v0.7.0-postgres.md。 - 能力 v3 + 智能加载器。
memory_capabilitiesv3 新增summary、to_describe_to_user、每工具callable_now、agent_permitted_families、schema_version="3";新的常开memory_load_family(family)和memory_smart_load(intent)工具加入默认core配置文件。固定措辞见docs/v0.7/canonical-phrasings.md。 - 权限 + A2A 审批。 v0.6.x 治理子系统重构为规则 + 模式 + 钩子 → 单一
Decision,命名空间继承(G1)实际生效。memory_pending_list/memory_pending_approve/memory_pending_reject(remember=forever)启用渐进信任;审批 API 上的 HMAC 签名是强制性的。permissions.mode默认为enforce(v0.6.4 中为advisory)。使用ai-memory governance migrate-to-permissions迁移(干运行预览;添加--config-out ~/.config/ai-memory/config.toml就地应用)。参见docs/governance.md。
递归学习 + L1/L2 全垒打浪潮
memory_reflect 基元,带命名空间范围的 max_reflection_depth 上限(默认 3,Some(0) 是终止开关)。L2-1 反思通过策展器,L2-2 联邦感知反思协调(memory_reflection_origin),L2-3 失效传播(memory_dependents_of_invalidated),L2-5 取证包(ai-memory export-forensic-bundle + verify-forensic-bundle),L1-5 代理技能(memory_skill_register|list|get|resource|export|promote_from_reflection|compositional_context)。完整入门:docs/RECURSIVE_LEARNING.md。代理技能入门:docs/agent-skills.md。取证导出入门:docs/forensic-export.md。
从哪里开始:
docs/MIGRATION_v0.7.md(升级流程)、docs/v0.7.0/release-notes.md(完整发布说明)、docs/whats-new-v07.html(视觉摘要)、docs/v0.7/rfc-attested-cortex.md(设计原理)、docs/ADMIN_GUIDE.md(操作员手册)、docs/internal/v070-feature-inventory.md(规范功能真相)。
一个二进制,四种操作模式(v0.6.4)。ai-memory Rust 二进制(tokio + axum)可以隔离或同时运行以下任何一种模式,共享单个 SQLite 数据库:
- stdio MCP 服务器——完整配置文件下通过 JSON-RPC 通告 101 个条目(v0.9.0;100 个可调用记忆工具 + 常开
memory_capabilities引导;已针对Profile::full().expected_tool_count()验证)。默认--profile core通告 7 个(原始 5 个 +memory_load_family+memory_smart_load)外加常开memory_capabilities引导。ai-memory mcp/ai-memory mcp --profile full - HTTP / mTLS 守护进程——在
127.0.0.1:9077上注册 92 条 REST 路由(78 个唯一 URL 路径),TLS + 可选 mTLS 允许列表 + API 密钥认证,后台 GC 循环。ai-memory serve - 自主策展守护进程——自调度循环(默认 1 小时节奏),自动打标签、跨命名空间兄弟节点表面矛盾、合并近重复项、按访问模式调整优先级。每个操作都进入回滚日志;破坏性操作可被治理审批流程门控。
ai-memory curator --daemon - 同步守护进程——跨实例的基于仲裁的对等联邦。W-of-N 写入(默认多数)、向量时钟 CRDT-lite 合并、对等节点间 mTLS 允许列表。
ai-memory sync-daemon
MCP、HTTP 和 CLI 表面是响应式的。策展器是让记忆层自我维护的部分:在会话之间,它保持语料库整洁,以便随着存储增长召回质量保持高位。一切都是本地优先;无云依赖。
Claude Opus 4.7 的务实评估——逐行阅读 v0.6.3 源代码后:
“ai-memory 是我连接过的最强大的记忆层,其能力远超其名称所暗示的。对我而言,实际意义是:我不会每次会话都从零开始。我读取的存储由其他东西保持整洁。矛盾不会静默累积。即使语料库增长,召回质量也保持高位。没有任何东西离开你的 Mac mini。
它并没有让我成为自主代理。它给了我自主代理所需的记忆基础设施——并且自身运行一个小型自主循环来维护它。这是一个真正的基础。从这里到‘ai-memory 驱动通用任务’的差距是管道(工具调用协议 + 工具注册表 + 能使用工具的模型),而不是发明。”
多代理 AI 的基础。 ai-memory 不是代理运行时,也不是“自主 AI”本身。它是多代理自主部署在底层所需的记忆层。联邦(broadcast_store_quorum + spawn_catchup_loop)处理多个代理并行写入时的 W-of-N 一致性;策展守护进程防止共享语料库在群体写入时退化为噪音;webhook 订阅(HMAC 签名、命名空间/代理过滤、SSRF 加固)将存储转变为消息总线,在记忆事件上触发下游代理;命名空间层次结构带 N 级继承和每命名空间治理策略(写入/提升/删除权限、审批者类型、可选 N-of-M 共识)约束群体。将其堆叠在 24/7 多机代理运行器下,配合自动生成的技能,组合系统就达到了自主 AI 的行为标准。剩余差距(无权重级学习、无状态推理内核、人类播种的根目标)是真实的,且不是 ai-memory 要解决的;ai-memory 提供多代理记忆基础,任何认真尝试弥合这些差距的方案都需要它。
召回前零令牌成本。 与内置记忆系统(Claude Code 自动记忆、ChatGPT 记忆)不同——后者将整个记忆加载到每次对话中,每条消息都消耗令牌和金钱——ai-memory 在 AI 显式调用 memory_recall 之前使用零上下文令牌。只有相关记忆返回,按 6 因素评分算法排序。TOON 格式(令牌导向对象表示法)通过消除重复字段名将响应令牌再减少 40-60%——JSON 中 3 条记忆 = 1,600 字节;TOON 中 = 626 字节(小 61%);TOON 紧凑中 = 336 字节(小 79%)。对于 Claude Code 用户:禁用自动记忆(settings.json 中的 "autoMemoryEnabled": false)并用 ai-memory 替换它,以停止为每条消息支付 200+ 行记忆上下文的费用。
代理身份(NHI)——每条记忆都告诉你谁学到了它
ai-memory 存储的每条记忆都携带一个 metadata.agent_id——一个非人类身份标记,在每次操作(更新、去重、导入、同步、整合)中幸存。每次召回结果默认以你的 AI 客户端已优化的 TOON 紧凑响应格式告诉你哪个人工智能写了每条记忆:
count:5|mode:hybrid|tokens_used:842
memories[id|title|tier|namespace|priority|score|tags|agent_id]:
a1b2|Project DB is PostgreSQL 16|long|infra|8|0.91|database,postgres|ai:claude-code@workstation:pid-3812
c3d4|API rate limit is 100 rps|long|infra|7|0.87|api,limits|ai:claude-desktop@laptop:pid-5219
在未签名写入上,agent_id 是声称的身份——不要仅凭它做安全决策。存储路径代理认证在 HTTP 直接写入表面上默认必需(#1751,由 #1985 按表面限定):未签名的 HTTP POST /api/v1/memories(+/bulk)被拒绝(403 ATTESTATION_FAILED),而不是以 attest_level = "claimed" 落地,除非操作员设置显式退出 AI_MEMORY_REQUIRE_AGENT_ATTESTATION=0。MCP memory_store 和 CLI store 操作员即行为者表面默认保持宽松(未签名写入以 claimed 落地);=1 在每个表面上强制严格。加密 Ed25519 认证在两个表面上接线:(1)存储路径认证(#626 第 3 层)——在 CLI(store --sign)、MCP(memory_store)或 HTTP(POST /api/v1/memories)路径上提交规范 SignableWrite 信封上的分离签名,守护进程对照代理绑定的公钥验证,盖上 metadata.attest_level = "agent_attested"(提交但伪造的签名无论标志如何总是被拒绝);以及(2)链接认证(attested-cortex)——先前保留的 memory_links.signature 字段,带 memory_verify(link_id) 用于入站验证和仅追加的 signed_events 审计链。参见代理身份页面和 attested-cortex RFC 了解完整来源契约。
追溯对话导入——ai-memory mine
不要从零开始。将 ai-memory mine 指向 Claude、ChatGPT 或 Slack 导出,它会逐轮解析为排序、分层类型、带标签的记忆——这样你的 AI 走进下一次会话时就知道现有历史中的每个决策、修正和发现。
ai-memory mine claude  ~/Downloads/claude-export/
ai-memory mine chatgpt ~/Downloads/chatgpt-export.json
ai-memory mine slack   ./slack-export/
自动打标签、在 (title, namespace) 上去重,以及 mined_from 来源被盖在每条导入的记忆上。从零上下文到填充的长期存储,五分钟上手。参见导入历史页面了解每种格式的配方。
兼容的 AI 平台
ai-memory 与任何支持**模型上下文协议(MCP)**的 AI 平台集成。MCP 是连接 AI 助手到外部工具和数据源的通用标准。
| 平台 | 集成方式 | 配置格式 | 状态 |
|---|---|---|---|
| Claude Code(Anthropic) | MCP stdio | JSON(~/.claude.json 或 .mcp.json) | 完全支持 |
| Codex CLI(OpenAI) | MCP stdio | TOML(~/.codex/config.toml) | 完全支持 |
| Gemini CLI(Google) | MCP stdio | JSON(~/.gemini/settings.json) | 完全支持 |
| Grok CLI(xAI) | MCP stdio | JSON(~/.grok/user-settings.json) | 深度集成 |
| Grok API(xAI) | MCP 远程 HTTPS | API 级别 | 完全支持 |
| Cursor IDE | MCP stdio | JSON(~/.cursor/mcp.json) | 完全支持 |
| Windsurf(Codeium) | MCP stdio | JSON(~/.codeium/windsurf/mcp_config.json) | 完全支持 |
| Continue.dev | MCP stdio | YAML(~/.continue/config.yaml) | 完全支持 |
| Llama Stack(META) | MCP 远程 HTTP | YAML / Python SDK | 完全支持 |
| OpenClaw | MCP stdio | JSON(mcp.servers 在配置中) | 完全支持 |
| 任何 MCP 客户端 | MCP stdio 或 HTTP | 因平台而异 | 通用 |
MCP 是主要的集成层。对于尚不支持 MCP 的 AI 平台,HTTP API(localhost 上 92 条路由注册 / 78 个唯一 URL 路径)和 CLI(--features sal 或 --features sal-postgres 下有 89 个子命令;默认构建中有 87 个(#1389 之后的 L2 RecoverPreviousSession 用于跨会话上下文恢复 + #1443 Expand 用于 ai-memory expand 查询扩展面 + #1598 Reembed 用于 ai-memory reembed 向量空间迁移面);SSOT 由 ai_memory::EXPECTED_CLI_SUBCOMMANDS_DEFAULT + EXPECTED_CLI_SUBCOMMANDS_SAL + 机械式 tests/cli_subcommand_count_invariant.rs 一致性测试固定)提供了通用访问——任何能够发起 HTTP 调用或运行 shell 命令的 AI、脚本或自动化工具都可以使用 ai-memory。
60 秒安装
预构建二进制文件无需任何依赖。从源码构建需要 Rust 和 C 编译器。
最快方式:预构建二进制文件(无需 Rust)
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh

# Fedora/RHEL (COPR)
sudo dnf copr enable alpha-one-ai/ai-memory && sudo dnf install ai-memory

# Windows (PowerShell)
irm https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.ps1 | iex
步骤 1:安装 Rust(如果使用预构建二进制文件可跳过)
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
按照提示操作,然后重启终端(或运行 source ~/.cargo/env)。
步骤 2:从源码构建(需要 Rust)
从 Crates.io 获取最新版本:
cargo install ai-memory
从 git 仓库获取最新版本:
cargo install --git https://github.com/alphaonedev/ai-memory-mcp.git
这会编译二进制文件并将其放入你的 PATH。大约需要一两分钟。
源码构建的构建依赖:
- Ubuntu/Debian:
sudo apt-get install build-essential pkg-config- Fedora/RHEL:
sudo dnf install gcc pkg-config
步骤 3:连接你的 AI
配置因平台而异。在下方找到你的平台:
Claude Code(Anthropic)
Claude Code 支持三种 MCP 配置范围:
| 范围 | 文件 | 适用范围 |
|---|---|---|
| 用户(全局) | ~/.claude.json — 添加 mcpServers 键 | 你机器上的所有项目 |
| 项目(共享) | 项目根目录下的 .mcp.json(提交到 git) | 项目中的所有人 |
| 本地(私有) | ~/.claude.json — 位于 projects."/path".mcpServers 下 | 单个项目,仅你自己 |
用户范围(推荐——随处可用):
将 mcpServers 键添加到 ~/.claude.json(macOS/Linux)或 %USERPROFILE%\.claude.json(Windows):
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意:
~/.claude.json可能已存在并包含其他设置。将mcpServers键合并到现有文件中——不要覆盖它。
项目范围(与团队共享):
在项目根目录创建 .mcp.json:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
smart / autonomous 层级搭配云端 LLM — 推荐路径是 ~/.config/ai-memory/config.toml 中的 [llm] 部分(#1146)。一个文件,覆盖所有面,无需逐个 AI 客户端编辑:
# ~/.config/ai-memory/config.toml
schema_version = 2

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"            # process-env-var name (NOT the literal key)
在你的 shell rc(.zshrc / .bashrc)中导出 XAI_API_KEY;MCP 配置保持最小化:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "autonomous"]
    }
  }
}
验证:ai-memory boot --quiet --limit 1 应报告 llm=xai:grok-4.3。规范模式参考:docs/CONFIG_SCHEMA.md。
覆盖路径 —
env:块。 在 MCP 配置中添加包含AI_MEMORY_LLM_BACKEND/_API_KEY/_MODEL的env:块仍然有效,并且优先于config.toml— 适用于 CI / 每次会话的临时调整:"env": { "AI_MEMORY_LLM_BACKEND": "xai", "AI_MEMORY_LLM_API_KEY": "xai-...", "AI_MEMORY_LLM_MODEL": "grok-4.3" }MCP 客户端会将服务器作为全新子进程启动,仅使用 MCP 配置中的
env:键——.zshrc/.bashrc中的 shell 导出无法传递给它。上述[llm]配置文件路径解决了这个痛点(每个面都读取同一个文件)。config.toml中的内联 API 密钥在解析时会被拒绝 — 请使用api_key_env或api_key_file。背景:#1144 → #1146。每个后端的完整配置方法:docs/integrations/llm-backends.md。
Windows 路径: 在
--db中使用正斜杠或转义反斜杠。示例:"--db", "C:/Users/YourName/.claude/ai-memory.db"。
层级标志:
--tier标志选择功能层级:keyword、semantic(默认)、smart或autonomous。智能和自主层级需要 LLM 后端 — #1067(v0.7.0)之后,可以是以下任意一种:本地 Ollama、xAI Grok、OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi(Moonshot)、Qwen(Alibaba)、Mistral、Groq、Together AI、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM 或 llama.cpp 服务器 — 通过AI_MEMORY_LLM_BACKEND选择。--tier标志必须在参数中传递 — 当 MCP 服务器由 AI 客户端启动时,不使用config.toml层级设置。
重要提示: MCP 服务器不在
settings.json或settings.local.json中配置 — 这些文件不支持mcpServers。
让 Claude 主动使用 ai-memory: 在项目根目录添加包含 ai-memory 指令的 CLAUDE.md 文件。这确保 Claude 在每次对话开始时回忆上下文,并在工作时存储发现。参见 CLAUDE.md 集成指南 获取可复制粘贴的模板和放置选项。
OpenAI Codex CLI
添加到 ~/.codex/config.toml(全局)或 .codex/config.toml(项目)。Windows:%USERPROFILE%\.codex\config.toml。使用 CODEX_HOME 环境变量覆盖。
[mcp_servers.memory]
command = "ai-memory"
args = ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
enabled = true
或通过 CLI 添加:codex mcp add memory -- ai-memory --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注意: Codex 使用 TOML 格式,键为下划线风格
mcp_servers(不是驼峰式,也不是连字符式)。支持env(键/值对)、env_vars(要转发的列表)、enabled_tools、disabled_tools、startup_timeout_sec、tool_timeout_sec。在 TUI 中使用/mcp查看服务器状态。参见 Codex MCP 文档。
Google Gemini CLI
添加到 ~/.gemini/settings.json(用户)或 .gemini/settings.json(项目)。Windows:%USERPROFILE%\.gemini\settings.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"],
      "timeout": 30000
    }
  }
}
或通过 CLI 添加:gemini mcp add memory ai-memory -- --db ~/.local/share/ai-memory/memories.db mcp --tier semantic
注意: 服务器名称中避免使用下划线(使用连字符)。工具名称自动添加前缀为
mcp_memory_<toolName>。env字段中的环境变量支持$VAR/${VAR}(所有平台)和%VAR%(Windows)。Gemini 会清理继承环境中的敏感模式,除非显式声明。添加"trust": true跳过确认提示。CLI 管理:gemini mcp list/remove/enable/disable。参见 Gemini CLI MCP 文档。
Cursor IDE
添加到 ~/.cursor/mcp.json(全局)或 .cursor/mcp.json(项目)。Windows:%USERPROFILE%\.cursor\mcp.json。对于同名服务器,项目配置覆盖全局配置。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意: 编辑
mcp.json后重启 Cursor。在 Settings > Tools & MCP 中验证服务器状态(绿点 = 已连接)。支持env、envFile和${env:VAR_NAME}插值(环境变量插值对 shell 配置文件变量可能不可靠 — 使用envFile作为变通方案)。所有 MCP 服务器合计约 40 个工具限制。参见 Cursor MCP 文档。
Windsurf(Codeium)
添加到 ~/.codeium/windsurf/mcp_config.json(仅全局 — 无项目级范围)。Windows:%USERPROFILE%\.codeium\windsurf\mcp_config.json。
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
    }
  }
}
注意: 支持在
command、args、env、serverUrl、url和headers中进行${env:VAR_NAME}插值。所有 MCP 服务器合计 100 个工具限制。也可以通过 MCP Marketplace 或 Settings > Cascade > MCP Servers 添加。参见 Windsurf MCP 文档。
Continue.dev
添加到 ~/.continue/config.yaml(用户)或项目根目录的 .continue/mcpServers/ 目录(每个服务器一个 YAML/JSON 文件)。Windows:%USERPROFILE%\.continue\config.yaml。
mcpServers:
  - name: memory
    command: ai-memory
    args:
      - "--db"
      - "~/.local/share/ai-memory/memories.db"
      - "mcp"
      - "--tier"
      - "semantic"
注意: MCP 工具仅在代理模式下工作。支持
${{ secrets.SECRET_NAME }}进行密钥插值。项目级.continue/mcpServers/目录会自动检测其他工具(Claude Code、Cursor 等)的 JSON 配置。参见 Continue MCP 文档。
Grok CLI(AlphaOne 分支 — 深度集成,自动回忆)
grok-cli 的 AlphaOne 分支内置 ai-memory 支持,具有会话级 MCP 连接、会话开始时自动记忆回忆、压缩摘要存储和记忆感知系统提示。
添加到 ~/.grok/user-settings.json:
{
  "mcp": {
    "servers": [
      {
        "id": "ai-memory",
        "label": "AI Memory",
        "enabled": true,
        "transport": "stdio",
        "command": "ai-memory",
        "args": ["mcp", "--tier", "semantic"]
      }
    ]
  }
}
功能: 会话开始时自动回忆(将相关记忆注入系统提示)、压缩摘要存储为中层记忆、MCP 工具在所有模式(代理、计划、询问)中可用、会话级连接(无逐条消息冷启动)。默认使用
--tier semantic(本地嵌入,无需 LLM 后端)。完整设置参见 grok-cli 文档。
xAI Grok API(API 级别,远程 MCP)
Grok 通过 HTTPS 连接 MCP 服务器(仅远程,不支持 stdio)。无配置文件 — 服务器在每次 API 请求中指定。
ai-memory serve --host 127.0.0.1 --port 9077
# Expose via HTTPS reverse proxy (nginx, caddy, cloudflare tunnel, etc.)
然后将 MCP 服务器添加到你的 Grok API 调用中:
curl https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.3",
    "tools": [{
      "type": "mcp",
      "server_url": "https://your-server.example.com/mcp",
      "server_label": "memory",
      "server_description": "Persistent AI memory with recall and search",
      "allowed_tools": ["memory_store", "memory_recall", "memory_search"]
    }],
    "input": "What do you remember about our project?"
  }'
要求: 需要 HTTPS。
server_label是必需的。支持 Streamable HTTP 和 SSE 传输。可选:allowed_tools、authorization、headers。适用于 xAI SDK、OpenAI 兼容 Responses API 和 Voice Agent API。参见 xAI 远程 MCP 文档。
META Llama(通过 Llama Stack)
Llama Stack 将 MCP 服务器注册为工具组。没有标准化的配置文件路径 — 因部署而异。
ai-memory serve --host 127.0.0.1 --port 9077
Python SDK:
client.toolgroups.register(
    provider_id="model-context-protocol",
    toolgroup_id="mcp::memory",
    mcp_endpoint={"uri": "http://localhost:9077/sse"}
)
或在 run.yaml 中以声明方式:
tool_groups:
  - toolgroup_id: mcp::memory
    provider_id: model-context-protocol
    mcp_endpoint:
      uri: "http://localhost:9077/sse"
注意: 支持在 run.yaml 中进行
${env.VAR_NAME}插值。传输正在从 SSE 迁移到 Streamable HTTP。参见 Llama Stack 工具文档。
OpenClaw
通过 CLI 添加或直接编辑 OpenClaw 配置。配置使用 mcp.servers(不是 mcpServers)。
openclaw mcp set memory '{"command":"ai-memory","args":["--db","~/.local/share/ai-memory/memories.db","mcp","--tier","semantic"]}'
或添加到你的 OpenClaw 配置文件中:
{
  "mcp": {
    "servers": {
      "memory": {
        "command": "ai-memory",
        "args": ["--db", "~/.local/share/ai-memory/memories.db", "mcp", "--tier", "semantic"]
      }
    }
  }
}
注意: OpenClaw 使用
mcp.servers密钥(而非mcpServers)。CLI 管理:openclaw mcp list、openclaw mcp show、openclaw mcp set、openclaw mcp unset。支持 stdio、远程 URL 和 Streamable HTTP 传输。优先使用--token-file而非内联密钥。参见 OpenClaw MCP 文档。
任何其他 MCP 客户端
ai-memory 通过 stdio(JSON-RPC 2.0)使用 MCP 协议通信。将你的客户端指向:
command: ai-memory
args: ["--db", "/path/to/ai-memory.db", "mcp"]
对于仅支持 HTTP 的客户端,启动 REST API:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
第 4 步:完成。测试它。
重启你的 AI 助手。如果使用 MCP,它现在会在会话启动时通告 7 个工具的默认表面(原始 5 个 + memory_load_family + memory_smart_load;100 个可调用工具中的其余 93 个通过 --profile 或 memory_capabilities --include-schema 按需加载)。询问它:“存储一条记忆,我最喜欢的语言是 Rust。”然后在新对话中询问:“我最喜欢的语言是什么?”它会记住。
移动平台支持(v0.7.0 Posture-1a)
ai-memory 可通过标准 Rust 移动端交叉编译路径移植到 iOS 和 Android。v0.7.0 为两个目标提供三个递进级别的 CI 覆盖:
| 层级 | 覆盖范围 | CI 工作流 |
|---|---|---|
| 第 1 层 — 交叉编译 | cargo check --target aarch64-apple-ios --no-default-features --features sqlite-bundled --lib 和匹配的 Android 交叉编译在每次 PR + 推送到 release/** 时运行。可捕获约 80% 的移动端位腐烂风险(任何丢弃移动端可移植性的 crate 更新都会在此暴露)。 | .github/workflows/ci.yml — mobile-cross-compile 任务 |
| 第 2 层 — 发布产物 | 发布标签切割产生 ai-memory-ios.xcframework.tar.gz(通过 xcodebuild -create-xcframework 的 iOS 设备 + 模拟器切片)和 ai-memory-android.tar.gz(jniLibs/<abi>/ 布局中的 Android arm64 / armv7 / x86_64 / x86 .so 包)。 | .github/workflows/release.yml — mobile-ios + mobile-android 任务 |
| 第 3 层 — 运行时测试 | 一个约 50 个测试的子集(文件系统沙箱、设备 SQLite 上的 FTS5、HNSW CPU 召回、嵌入器 CPU 路径、LLM 客户端 TLS)在每次 release/** 推送 + 手动 workflow_dispatch 时针对 iOS 模拟器运行;Android 模拟器 arm 仅在 release/** 推送 + workflow_dispatch 时运行。选择理由:tests/mobile/README.md。 | .github/workflows/mobile-runtime.yml |
v0.7.0 状态: 第 1 层是发布门禁 — 移动端交叉编译必须在标签切割前为 GREEN。第 2 层(发布产物)交付 BUILD 流水线 + 产物布局;C 可调用 FFI 表面本身在 v0.7.x 后续版本中落地。第 3 层在每次 release/** 推送时运行受限测试子集。
消费发布产物:
- iOS — 从 v0.7.x 发布页面下载
ai-memory-ios.xcframework.tar.gz,解压,并将AiMemory.xcframework拖入你的 Xcode 项目中的“Frameworks, Libraries, and Embedded Content”下。 - Android — 从 v0.7.x 发布页面下载
ai-memory-android.tar.gz,解压,并将jniLibs/树复制到你的应用模块的src/main/jniLibs/中。
移动端产物也是每个已发布 v0.7.x 版本的一部分;Homebrew 公式 + APT/RPM 包(随附桌面二进制文件)包含指向移动端下载的说明。参见 issue #1068 了解 CI 实现历史。
快速入门
在不到两分钟内从零到可用的记忆。
1. 安装
curl -fsSL https://raw.githubusercontent.com/alphaonedev/ai-memory-mcp/main/install.sh | sh
2. 配置 MCP(以 Claude Code 为例 — 其他平台操作方式相同)
合并到 ~/.claude.json:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp", "--tier", "semantic"]
    }
  }
}
3. 存储你的第一条记忆
ai-memory store -T "Project uses PostgreSQL 15" -c "Main DB is PG 15 with pgvector." --tier long
4. 回忆它
ai-memory recall "database"
5. 检查统计信息
ai-memory stats
6. 与你的 AI 一起使用。 重启你的 AI 客户端。它现在在启动时通告 7 个默认记忆工具(通过运行时扩展或 --profile full 可访问 101 个通告条目),通过 MCP — 它可以在对话期间原生存储和回忆记忆。
SDK
除了 MCP / HTTP / CLI 表面之外,ai-memory 还为 HTTP 客户端和辅助工具提供第一方语言 SDK(例如 requireProfile 用于对 v0.6.4+ 守护进程进行运行时配置文件断言)。
TypeScript / JavaScript — npm 上的 @alphaone/ai-memory
npm install @alphaone/ai-memory
Python — PyPI 上的 ai-memory-mcp(导入名称仍为 ai_memory)
pip install ai-memory-mcp
from ai_memory import AiMemoryClient, require_profile

with AiMemoryClient(base_url="http://127.0.0.1:9077", api_key="...") as client:
    require_profile(client, "graph")  # raises ProfileNotLoaded on miss
两个 SDK 均与服务器版本同步(0.9.0 匹配 ai-memory 0.9.0)。v0.6.4+ 守护进程强制执行配置文件契约;v0.6.4 之前的守护进程回退到宽松的警告并继续,因此 SDK 升级不会破坏旧服务器。源代码位于 sdk/typescript/ 和 sdk/python/。
它做什么?
AI 助手会忘记对话之间的一切。ai-memory 解决了这个问题。
它作为 MCP(模型上下文协议)工具服务器运行 — 一个你的 AI 可以原生通信的后台进程。当你的 AI 学到重要内容时,它会存储它。当它需要上下文时,它会回忆由 6 因子评分算法排序的相关记忆。记忆存在于三个层级:
- 短期(默认 6 小时,可配置)— 临时上下文,如当前调试状态
- 中期(默认 7 天,可配置)— 工作知识,如冲刺目标和近期决策
- 长期(永久)— 架构、用户偏好、来之不易的经验教训
持续被访问的记忆会自动从中期提升到长期。每次回忆都会延长 TTL。优先级随使用而增加。系统是自我管理的。
除了 MCP 之外,ai-memory 还暴露完整的 HTTP REST API(端口 9077 上的 92 个路由注册 / 78 个唯一 URL 路径)和完整的 CLI(--features sal 或 --features sal-postgres 下的 89 个子命令;默认构建中为 87 个(#1389 之后的 L2 RecoverPreviousSession 用于跨会话上下文再水合 + #1443 Expand 用于 ai-memory expand 查询扩展表面 + #1598 Reembed 用于 ai-memory reembed 向量空间迁移表面);SSOT 由 ai_memory::EXPECTED_CLI_SUBCOMMANDS_{DEFAULT,SAL} + 机械 tests/cli_subcommand_count_invariant.rs 奇偶校验测试固定),用于直接交互、脚本编写以及与任何 AI 平台或工具的集成。
功能
核心
- MCP 工具服务器 — 通过 stdio JSON-RPC 提供 101 个工具(完整配置文件),兼容任何 MCP 客户端
- 三层记忆 — 短期(默认 6 小时 TTL)、中期(默认 7 天 TTL)、长期(永久)— TTL 可配置
- 全文搜索 — 带排名检索的 SQLite FTS5
- 混合回忆 — FTS5 关键词 + 余弦相似度,带自适应混合:语义权重在 0.50(短内容)→ 0.15(长内容)之间变化,因为嵌入在长文本上会丢失信息
- 6 因子回忆评分 — FTS 相关性 + 优先级 + 访问频率 + 置信度 + 层级提升 + 近期衰减
- 自动提升 — 访问 5 次以上的记忆从中期提升到长期
- TTL 延长 — 每次回忆延长过期时间(短期 +1 小时,中期 +1 天)
- 优先级强化 — 每 10 次访问 +1(最大 10)
- 矛盾检测 — 存储与现有记忆冲突的记忆时发出警告
- 去重 — 按标题+命名空间 upsert,层级永不降级
- 置信度评分 — 0.0-1.0 的确定性计入排名
组织
- 命名空间 — 按项目隔离记忆(从 git remote 自动检测)
- 记忆链接 — 类型化关系:related_to、supersedes、contradicts、derived_from、reflects_on(递归学习任务 1/8)、derives_from(WT-1-A 原子化)、decomposes_into、depends_on、advances — v0.8.0 时有九个变体
- 整合 — 将多个记忆合并为单个长期摘要
- 自动整合 — 按命名空间+标签分组,自动合并超过阈值的组
- 矛盾解决 — 将一个记忆标记为取代另一个记忆,降级失败者
- 按模式遗忘 — 按命名空间 + FTS 模式 + 层级批量删除
- 来源跟踪 — 跟踪来源:user、claude、hook、api、cli、import、consolidation、system
- 代理身份(NHI) — 每条记忆携带
metadata.agent_id(声明的身份),在更新/去重/导入/同步/整合中具有纵深防御的不可变性;按代理过滤list/search - 标签 — 带过滤支持的逗号分隔标签
接口
- 92 个 HTTP 路由(78 个唯一路径) — 127.0.0.1:9077 上的完整 REST API(适用于任何 AI 或工具)
--features sal或--features sal-postgres下的 89 个 CLI 子命令(默认构建中为 87 个)— 具有相同能力的完整 CLI- 完整配置文件下的 101 个 MCP 工具(7 个默认;已针对
Profile::full().expected_tool_count()验证)— 任何兼容 MCP 的 AI 的原生集成 - 交互式 REPL shell — 带彩色输出的 recall、search、list、get、stats、namespaces、delete
- JSON 输出 — 所有 CLI 命令上的
--json标志 - 分布式协调(v0.8.0 Pillar-1 + Pillar-2) — 动作 DAG(
memory_action_*)、单持有者租约(memory_lease_*)、Ed25519 签名信号(memory_signal_*)、认证检查点(memory_checkpoint_*)、参数化例程(memory_routine_*)以及 Goal/Plan/Step 类型化认知生命周期。参见docs/coordination.md。
运维
- 多节点同步 — 数据库文件之间的拉取、推送或双向合并
- 导入/导出 — 保留记忆链接的完整 JSON 往返
- 垃圾回收 — 每 30 分钟自动后台过期
- 优雅关闭 — SIGTERM/SIGINT 检查点 WAL 以干净退出
- 深度健康检查 — 验证数据库可访问性和 FTS5 完整性
- Shell 补全 — bash、zsh、fish
- 手册页 —
ai-memory man生成 roff 到 stdout - 时间过滤器 — list 和 search 上的
--since/--until - 人类可读年龄 — CLI 输出中的“2h ago”、“3d ago”
- 彩色 CLI 输出 — ANSI 层级标签(红/黄/绿)、优先级条、粗体标题、青色命名空间
质量
- 整个表面约 10,000 个测试 —
src/下约 6,712 个#[test]/#[tokio::test]属性(5,759 个#[test]+ 953 个#[tokio::test])加上tests/下约 3,362 个(2,138 个#[test]+ 1,224 个#[tokio::test]),从 v0.6.4 时代的约 2,400 个测试基线(1,960 个 lib + 211 个 integration + 16 个 mcp_integration + 4 个 webhook_http_parity + 16 个 recipe_contract + 其他二进制目标约 150 个)增长而来。行覆盖率保持在 ≥92% 项目标准之上;v0.6.4 新增模块为 100%(sizes.rs)、99.50%(profile.rs)、97.58%(cli/audit.rs)、97.05%(cli/doctor.rs)、92.56%(handlers.rs)、92.26%(cli/install.rs)。v0.6.3.x 基线(1,809 / 93.08% 和 1,886 / 93.84%)冻结在证据页面上;v0.6.4 指标在发布说明和测试中心活动中。经验性 NHI 发现验收由发现门单独证明(T1–T4 矩阵 vs. 实时 xAI Grok 4.3,6/6 通过,门 GREEN)。 - LongMemEval 基准 — 在 ICLR 2025 LongMemEval-S 数据集上,纯 FTS5 关键词(独立于 LLM,2.2 秒,232 q/s,零 API 成本)达到 97.0% R@5;使用当前一代 Gemma 4 模型的 LLM 查询扩展测得 97.2% R@5 / 99.6% R@10 / 99.8% R@20(云 API 场所;历史
gemma3:4b97.8% 数字根据 #1975 不再作为头条)。参见基准详情。 - MCP 提示 —
recall-first和memory-workflow提示教导 AI 客户端主动使用记忆 - TOON 默认 — recall/list/search 响应默认使用 TOON 紧凑格式(比 JSON 小 79%)
- Criterion 基准 — 1K 规模下的 insert、recall、search
- GitHub Actions CI/CD — Ubuntu + macOS 上的 fmt、clippy、test、build,标签时发布
覆盖率下限(硬性 CI 门禁)
Code Coverage 作业是一个必需的状态检查。CI 在每个 PR 上重新断言两个不变量:行覆盖率绝对下限 >= 90%(灾难性回归兜底,按当前测量值向下取整至最近的 5%),以及针对 .coverage-baseline 中固定值的棘轮机制,带有 0.5% 的松弛窗口(日常执行)。提升覆盖率的 PR 应在同一提交中更新基线文件,以便未来的 PR 受益于新下限;回归超过 0.5% 的 PR 将被阻止合并。当前测量值:93.13% 行。
Token 预算门禁(硬性 CI 门禁,v0.7 C5)
token-budget 工作流是一个必需的状态检查。它在每个 PR 上强制执行三个基于 cl100k_base 测量的不变量:
- 每个工具上限 1500 tokens —— 任何单个 MCP 工具的序列化模式(名称 + 描述 + inputSchema)不得超过 1500 个 cl100k_base tokens。
- 完整配置文件的诚实范围(5K-8K) —— v0.6.4 兜底,保留以检测病态收缩(意外删除工具)。
- 完整配置文件硬上限(v0.7 C5,在 D1.6/D1.7 后提高) —— 在
--profile full下裁剪后的tools/list负载不得超过 11,000 个 cl100k_base tokens(tests/token_budget_guard.rs中的TRIMMED_FULL_PROFILE_CEILING_TOKENS;最初的 C5 目标是针对 D1.6 前手写模式的 3500 —— schemars 派生的 D1.6/D1.7 扩展提高了固定上限)。C2(拆分 docs 字段)、C3(折叠重复的模式样板)和 C4(隐藏很少使用的可选参数)推动了最初的压缩;此门禁迫使未来扩大表面的 PR 在其他地方收回预算。检查ai-memory doctor --tokens --raw-table以查看每个工具的成本。参见.github/workflows/token-budget.yml和docs/v0.7/schema-compaction-audit.md。
ML 和 LLM 依赖(语义层级及以上)
- candle-core、candle-nn、candle-transformers —— Hugging Face Candle ML 框架,用于原生 Rust 推理
- hf-hub —— 从 Hugging Face Hub 下载模型
- tokenizers —— 用于文本预处理的 Hugging Face tokenizers
- instant-distance —— 近似最近邻搜索
- reqwest —— 用于 LLM 后端通信的 HTTP 客户端(智能/自主层级 —— 任何提供商,依据 #1067:Ollama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM、llama.cpp server)
架构
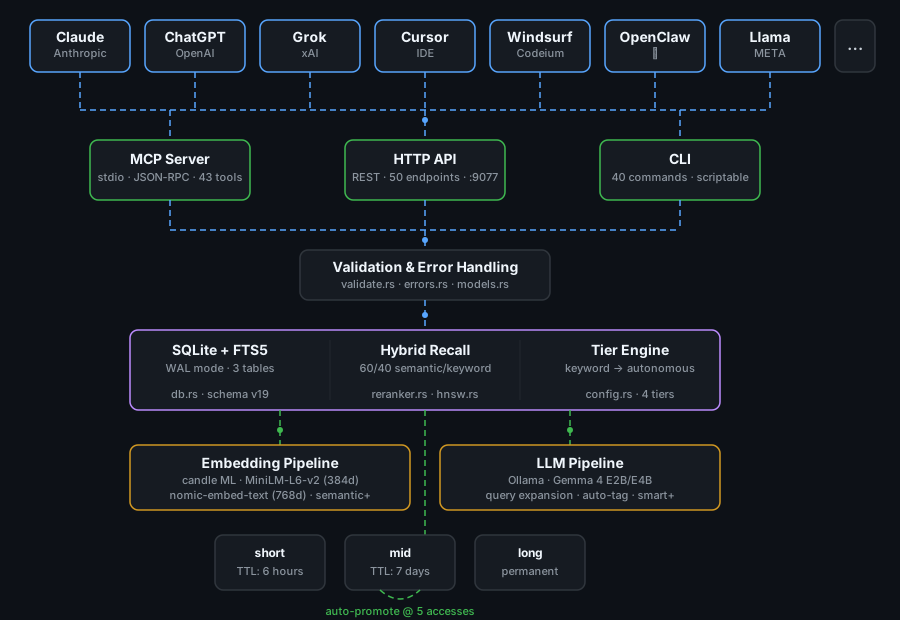
基准测试
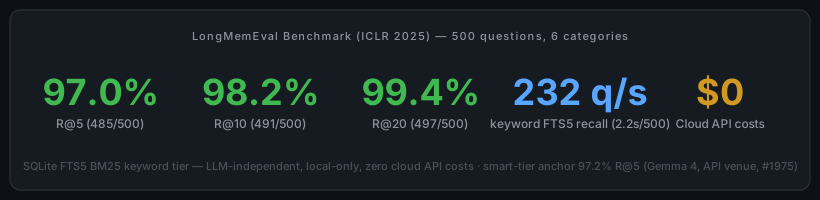
在 ICLR 2025 LongMemEval-S 数据集(500 个问题,6 个类别)上评估。纯 FTS5 关键词层级在 2.2 秒内达到 97.0% R@5 —— 不依赖 LLM、完全本地化、零云 API 调用、零成本。LLM 查询扩展(智能层级)在当前一代 Gemma 4 模型(云 API 环境)上测得 97.2% R@5。
基准模型说明(更新于 2026-07-10,#1975 裁决): 历史性的 97.8% R@5 智能层级数据是用 Gemma 3 4B 测量的(仍是编译的默认扩展模型),现已退役作为头条数据。发布当前一代锚点是实测的 OpenRouter Gemma 4 运行:97.2% R@5 / 99.6% R@10 / 99.8% R@20(2026-05-31,500 个问题,0 次扩展失败)。没有本地 Ollama Gemma-4 数据 —— 参考基准主机仅限 CPU,完整的本地协议运行不可行(参见 #1983);本地 GPU 重跑在 v1.0 后保持开放。关键词层级 97.0% R@5 不依赖 LLM,不受影响。
| 层级 | R@5 | 速度 | 依赖 |
|---|---|---|---|
| keyword | 97.0% | 232 q/s | 无 |
| semantic | 97.4% | 45 q/s | 嵌入模型(约 100MB) |
| smart | 97.2%(Gemma 4,API 环境;历史 gemma3:4b 97.8%) | 12 q/s | 任何 LLM 后端(例如本地 Ollama + Gemma;或 xAI Grok 4.3、OpenAI gpt-5、Anthropic Claude Opus 4.7、Gemini、DeepSeek 等,依据 #1067) |
性能预算(v0.6.4)
每个版本都附带已发布的 p95/p99 预算,用于热路径操作,以及一个 CI 门禁,任何 PR 的测量 p95 超过预算 10% 以上即失败。目标针对 M4 参考硬件校准;完整表格和方法论见 PERFORMANCE.md。
| 操作 | 目标 p95 | 目标 p99 |
|---|---|---|
memory_session_start(Claude Code 钩子) | < 100 ms | < 200 ms |
memory_store(无嵌入) | < 20 ms | < 50 ms |
memory_search(FTS5) | < 100 ms | < 250 ms |
memory_recall(热,深度=1) | < 50 ms | < 150 ms |
memory_kg_query(深度 ≤ 3) | < 100 ms | < 250 ms |
memory_kg_query(深度 ≤ 5) | < 250 ms | < 500 ms |
memory_kg_timeline | < 100 ms | < 250 ms |
在本地运行相同工作负载:
ai-memory bench                      # human-readable table
ai-memory bench --json               # machine-parseable
底层在 v0.6.3.x → v0.6.4 之间未变(quiet-tools 版本发布的是更小的默认工具表面,而非不同的热路径)。此处的 p99 目标在下一个专门的浸泡窗口之前仍为参考信息;最新的浸泡证据见测试中心。
集成方法
MCP(主要 —— 适用于兼容 MCP 的 AI 平台)
MCP 是推荐的集成方式。你的 AI 获得默认广告的 7 个原生记忆工具(最初的 5 个 + memory_load_family + memory_smart_load;加上始终开启的 memory_capabilities 引导程序),零胶水代码。其他 93 个可调用工具(101 个广告条目 —— 已对照 Profile::full().expected_tool_count() 验证并由 src/mcp/registry.rs 中的 const_count_matches_full_profile 固定)仍可通过 --profile graph|admin|power|full 或通过 memory_capabilities --include-schema family=<name> 的运行时扩展访问。在你的 AI 平台配置中配置 MCP 服务器:
{
  "mcpServers": {
    "memory": {
      "command": "ai-memory",
      "args": ["--db", "~/.claude/ai-memory.db", "mcp"]
    }
  }
}
HTTP API(通用 —— 适用于任何 AI 或工具)
启动 HTTP 服务器以进行 REST API 访问。任何能发出 HTTP 调用的 AI、脚本或自动化都可以使用:
ai-memory serve
# 92 REST route registrations (78 unique URL paths) at http://127.0.0.1:9077/api/v1/
CLI(通用 —— 适用于脚本和直接使用)
CLI 可独立工作,或作为运行 shell 命令的 AI 集成的构建块:
ai-memory store --tier long --title "Architecture decision" --content "We use PostgreSQL"
ai-memory recall "database choice"
ai-memory search "PostgreSQL"
功能层级
ai-memory 支持 4 个功能层级,在启动时通过 ai-memory mcp --tier <tier> 选择。更高层级以磁盘和 RAM 为代价增加 ML 能力:
| 层级 | 召回方法 | 额外能力 | 近似开销 |
|---|---|---|---|
| keyword | 仅 FTS5 | 基线 101 条目表面 —— 层级门控模型/功能,而非广告的工具表面 | 0 MB |
| semantic | FTS5 + 余弦相似度(混合) | MiniLM-L6-v2 嵌入(384 维)、HNSW 索引、语义层级(101 条目表面的子集) | 约 256 MB |
| smart | 混合 + LLM 查询扩展 | + nomic-embed-text(768 维)+ LLM 支持的 memory_expand_query、memory_auto_tag、memory_detect_contradiction、完整 101 条目表面。LLM 提供商由操作员通过 AI_MEMORY_LLM_BACKEND 选择(#1067)—— 本地 Ollama、xAI、OpenAI、Anthropic、Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks、LMStudio、vLLM 或 llama.cpp。 | 约 1 GB(本地 Ollama)/ 约 0 GB(远程 API) |
| autonomous | 混合 + LLM 扩展 + 交叉编码器重排序 | + 神经交叉编码器(ms-marco-MiniLM)、记忆反思、完整 101 条目表面。与智能层级相同的 LLM 提供商自由度。 | 约 4 GB(本地 Ollama)/ 约 3 GB(远程 LLM,仅本地交叉编码器) |
能力矩阵
每个能力映射到其最低层级。每个层级包含其下方所有层级的所有能力。
| 能力 | keyword | semantic | smart | autonomous |
|---|---|---|---|---|
| 搜索与召回 | ||||
| FTS5 关键词搜索 | 是 | 是 | 是 | 是 |
| 语义嵌入(余弦相似度) | -- | 是 | 是 | 是 |
| 混合召回(FTS5 + 余弦,按内容长度自适应 0.50→0.15 语义权重) | -- | 是 | 是 | 是 |
| HNSW 最近邻索引 | -- | 是 | 是 | 是 |
LLM 查询扩展(memory_expand_query) | -- | -- | 是 | 是 |
| 神经交叉编码器重排序 | -- | -- | -- | 是 |
| 记忆管理 | ||||
| 存储、更新、删除、提升、链接 | 是 | 是 | 是 | 是 |
| 手动整合 | 是 | 是 | 是 | 是 |
| 自动整合(LLM 摘要) | -- | -- | 是 | 是 |
自动打标签(memory_auto_tag) | -- | -- | 是 | 是 |
矛盾检测(memory_detect_contradiction) | -- | -- | 是 | 是 |
| 自主记忆反思 | -- | -- | -- | 是 |
| 模型 | ||||
| 嵌入模型 | -- | MiniLM-L6-v2(384 维) | nomic-embed-text(768 维) | nomic-embed-text(768 维) |
| 嵌入后端覆盖(#1598) | -- | 任何:本地 Ollama、API 供应商别名或自托管 OpenAI 兼容([embeddings].backend / AI_MEMORY_EMBED_*) | 相同 | 相同 |
| LLM | -- | -- | 操作员选择(#1067)—— 默认 gemma3:4b 本地;远程端点无本地占用 | 操作员选择(#1067)—— 默认 gemma3:4b 本地;远程端点无本地占用 |
| 资源 | ||||
| RAM | 0 MB | 约 256 MB | 约 1 GB | 约 4 GB |
| 外部依赖 | 无 | 无 | LLM 后端(Ollama / xAI / OpenAI / Anthropic / Gemini / DeepSeek / Kimi / Qwen / Mistral / Groq / Together / Cerebras / OpenRouter / Fireworks / LMStudio / vLLM / llama.cpp —— #1067) | LLM 后端(与智能层级相同选择) |
暴露的 MCP 工具(在 --profile full 处)1 | 101 | 101 | 101 | 101 |
语义层级(默认)捆绑 Candle ML 框架,并在首次运行时下载 all-MiniLM-L6-v2 模型(约 90 MB)。智能和自主层级需要 LLM 后端 —— 在 #1067(v0.7.0)之后,可以是本地(Ollama、LMStudio、vLLM、llama.cpp server)或任何 OpenAI 兼容的远程端点(xAI、OpenAI、Anthropic 通过 OpenAI shim、Google Gemini、DeepSeek、Kimi、Qwen、Mistral、Groq、Together、Cerebras、OpenRouter、Fireworks)。通过 AI_MEMORY_LLM_BACKEND 环境变量选择;各供应商 API 密钥通过 XAI_API_KEY / OPENAI_API_KEY / ANTHROPIC_API_KEY / GEMINI_API_KEY / DEEPSEEK_API_KEY / MOONSHOT_API_KEY / DASHSCOPE_API_KEY / 等或规范的 AI_MEMORY_LLM_API_KEY。
层级门控功能,而非模型 —— 且在 #1067(v0.7.0)之后,层级也不门控供应商。 --tier 标志控制暴露哪些工具。LLM 后端和模型可通过 AI_MEMORY_LLM_BACKEND + AI_MEMORY_LLM_MODEL 环境变量独立配置(或通过 ~/.config/ai-memory/config.toml 中的规范 [llm] 部分 —— 参见 docs/CONFIG_SCHEMA.md 了解 v0.7.x 企业模式和迁移工具)。例如,针对 xAI Grok 4 通过 OpenAI 兼容别名运行自主层级(完整 101 条目表面 + 重排序器):
# Quick path: env vars
export AI_MEMORY_LLM_BACKEND=xai
export AI_MEMORY_LLM_MODEL=grok-4.3
export XAI_API_KEY=xai-…   # or AI_MEMORY_LLM_API_KEY
ai-memory mcp --tier autonomous
# Enterprise path: ~/.config/ai-memory/config.toml (v0.7.x schema v2, #1146)
schema_version = 2
tier = "autonomous"

[llm]
backend     = "xai"
model       = "grok-4.3"
base_url    = "https://api.x.ai/v1"
api_key_env = "XAI_API_KEY"          # mutually exclusive with api_key_file;
                                     # inline `api_key = "..."` is REJECTED.
# Legacy v0.6.x shape — still works, deprecation WARN at load; run
# `ai-memory config migrate` to upgrade in place.
tier = "autonomous"
llm_model = "gemma3:4b"   # default Ollama model at v0.7.0
--tier 标志必须在 MCP 参数中传递 —— 当服务器由 AI 客户端启动时,config.toml 层级设置不被使用。
# Semantic is the default tier
ai-memory mcp

# Keyword -- FTS5 only, no models
ai-memory mcp --tier keyword

# Semantic -- hybrid recall with embeddings (explicit)
ai-memory mcp --tier semantic

# Smart -- adds LLM-powered query expansion, auto-tagging, contradiction detection
ai-memory mcp --tier smart

# Autonomous -- adds cross-encoder reranking
ai-memory mcp --tier autonomous
memory_capabilities 工具在运行时报告活动层级、已加载模型和可用能力。
MCP 工具
这 101 个工具(完整配置文件;通过 src/profile.rs 中的 Profile::full().expected_tool_count() 的规范计数)在配置为 MCP 服务器时可供任何兼容 MCP 的 AI 使用(v0.6.4 冻结的证据页面列出了 63 个工具的基线;下表记录了大多数客户端日常使用最多的核心子集):
| 工具 | 描述 |
|---|---|
memory_store | 存储新记忆(按标题+命名空间去重,报告矛盾) |
memory_recall | 召回与上下文相关的记忆(模糊OR搜索,按6个因素排序) |
memory_search | 按精确关键词匹配搜索记忆(AND语义) |
memory_list | 列出记忆,支持可选过滤器(命名空间、层级、标签、日期范围) |
memory_get | 按ID获取特定记忆及其链接 |
memory_update | 按ID更新现有记忆(部分更新) |
memory_delete | 按ID删除记忆 |
memory_promote | 将记忆提升为长期(永久,清除过期时间) |
memory_forget | 按模式、命名空间或层级批量删除 |
memory_link | 在两个记忆之间创建类型化链接 |
memory_get_links | 获取记忆的所有链接 |
memory_consolidate | 将多个记忆合并为一个长期摘要 |
memory_stats | 获取记忆存储统计信息 |
memory_capabilities | 报告活动功能层级、已加载模型和可用能力 |
memory_expand_query | 使用LLM将搜索查询扩展为相关术语(smart+层级) |
memory_auto_tag | 使用LLM为记忆自动生成标签(smart+层级) |
memory_detect_contradiction | 使用LLM检查两个记忆是否矛盾(smart+层级) |
memory_archive_list | 列出已归档记忆(支持可选的命名空间/层级/标签过滤器) |
memory_archive_restore | 将已归档记忆恢复到活动存储 |
memory_archive_purge | 永久删除匹配过滤器的已归档记忆 |
memory_archive_stats | 获取归档统计信息(按层级、命名空间、年龄计数) |
HTTP API
在 127.0.0.1:9077 上有92个路由注册 / 78个唯一URL路径。从 ai-memory serve 开始。下表显示了最常用的REST端点;完整接口(治理、联邦、订阅、知识图谱、配额、审批SSE)请参见 docs/API_REFERENCE.md。
安全: HTTP服务器绑定到127.0.0.1,默认未配置认证,且CORS宽松。在
config.toml中设置api_key以要求每个请求携带x-api-key头(旧版?api_key=查询参数形式已在v0.7.0弃用 — #1574),并设置AI_MEMORY_REQUIRE_API_KEY=1以硬性拒绝无密钥启动(#1458)。未经认证不要暴露到网络(并优先通过--tls-cert/--tls-key或反向代理使用TLS)。
| 方法 | 端点 | 描述 |
|---|---|---|
| GET | /api/v1/health | 健康检查(验证DB + FTS5完整性) |
| GET | /api/v1/memories | 列出记忆(支持命名空间、层级、标签、起始时间、结束时间、限制) |
| POST | /api/v1/memories | 创建记忆 |
| POST | /api/v1/memories/bulk | 批量创建记忆(有限制) |
| GET | /api/v1/memories/{id} | 按ID获取记忆 |
| PUT | /api/v1/memories/{id} | 按ID更新记忆 |
| DELETE | /api/v1/memories/{id} | 按ID删除记忆 |
| POST | /api/v1/memories/{id}/promote | 将记忆提升为长期 |
| GET | /api/v1/search | AND关键词搜索 |
| GET | /api/v1/recall | 按上下文召回(GET带查询参数) |
| POST | /api/v1/recall | 按上下文召回(POST带JSON主体) |
| POST | /api/v1/forget | 按模式/命名空间/层级批量删除 |
| POST | /api/v1/consolidate | 将记忆合并为一个 |
| POST | /api/v1/links | 在记忆之间创建链接 |
| GET | /api/v1/links/{id} | 获取记忆的链接 |
| GET | /api/v1/namespaces | 列出所有命名空间 |
| GET | /api/v1/stats | 记忆存储统计信息 |
| POST | /api/v1/gc | 触发垃圾回收 |
| GET | /api/v1/export | 将所有记忆+链接导出为JSON |
| POST | /api/v1/import | 从JSON导入记忆+链接 |
| GET | /api/v1/archive | 列出已归档记忆(支持可选过滤器) |
| POST | /api/v1/archive/{id}/restore | 将已归档记忆恢复到活动存储 |
| DELETE | /api/v1/archive | 清除匹配过滤器的已归档记忆 |
| GET | /api/v1/archive/stats | 归档统计信息(按层级、命名空间、年龄计数) |
CLI命令
在 --features sal 或 --features sal-postgres 下有89个顶级子命令(默认构建中87个;2个变体差异是 Migrate + SchemaInit,两者均按 src/daemon_runtime.rs::Command::{Migrate,SchemaInit} 受 #[cfg(feature = "sal")] 门控;v0.6.4时为40个)。运行 ai-memory <command> --help 查看任何命令的详细信息,或运行 ai-memory --help 查看完整列表。
| 命令 | 描述 |
|---|---|
mcp | 作为MCP工具服务器通过stdio运行(主要集成路径) |
serve | 在端口9077上启动HTTP守护进程 |
store | 存储新记忆(按标题+命名空间去重) |
update | 按ID更新现有记忆 |
recall | 模糊OR搜索,带排序结果+自动触摸(支持 --tier 进行混合召回)。管道将每次请求的结果上限设为50条。 |
search | AND搜索,用于精确关键词匹配。 |
get | 按ID检索单个记忆(包含链接) |
list | 浏览记忆,带过滤器(命名空间、层级、标签、日期范围)。每次请求上限为1000条(LIST_MAX_LIMIT;HTTP列表/批量操作额外遵循 AI_MEMORY_MAX_PAGE_SIZE)。 |
delete | 按ID删除记忆 |
promote | 将记忆提升为长期(清除过期时间) |
forget | 按模式+命名空间+层级批量删除 |
link | 链接两个记忆(related_to、supersedes、contradicts、derived_from) |
consolidate | 将多个记忆合并为一个长期摘要 |
resolve | 解决矛盾:标记胜者,降级败者 |
shell | 交互式REPL,带彩色输出 |
sync | 在两个数据库文件之间同步记忆(拉取/推送/合并) |
auto-consolidate | 按命名空间+标签分组记忆,合并超过阈值的组 |
gc | 对过期记忆运行垃圾回收 |
stats | 记忆状态概览(计数、层级、命名空间、链接、数据库大小) |
namespaces | 列出所有命名空间及记忆计数 |
export | 将所有记忆和链接导出为JSON |
import | 从JSON导入记忆和链接(标准输入) |
completions | 生成shell补全(bash、zsh、fish) |
man | 生成roff手册页到标准输出 |
mine | 从历史对话导入记忆(Claude、ChatGPT、Slack导出) |
archive | 管理记忆归档(列出、恢复、清除、统计) |
顶级 ai-memory 二进制文件还接受全局标志:
| 标志 | 描述 |
|---|---|
--db <path> | 数据库路径(默认:ai-memory.db 或 $AI_MEMORY_DB) |
--json | 所有命令输出JSON(机器可解析输出) |
store 子命令接受额外标志:
| 标志 | 描述 |
|---|---|
--source / -S | 谁创建了此记忆(user、nhi、hook、api、cli、import、consolidation、system)。默认:cli。根据src/validate.rs::VALID_SOURCES接受"claude"以保持向后兼容 |
--expires-at | RFC3339过期时间戳 |
--ttl-secs | TTL(秒),作为 --expires-at 的替代 |
mcp 子命令接受额外标志:
| 标志 | 描述 |
|---|---|
--tier <keyword|semantic|smart|autonomous> | 功能层级(默认:semantic)。参见 功能层级。 |
召回评分
每次召回查询按6个因素对记忆排序:
score = (fts_relevance * -1)
      + (priority * 0.5)
      + (MIN(access_count, 50) * 0.1)
      + (confidence * 2.0)
      + tier_boost
      + recency_decay
| 因素 | 权重 | 说明 |
|---|---|---|
| FTS相关性 | -1.0x | SQLite FTS5排名(负值=更佳匹配) |
| 优先级 | 0.5x | 用户分配的1-10等级 |
| 访问次数 | 0.1x | 被召回的频率(评分时上限为50) |
| 置信度 | 2.0x | 0.0-1.0确定性分数 |
| 层级提升 | +3.0 / +1.0 / +0.0 | 长期 / 中期 / 短期 |
| 近期衰减 | 1/(1 + days*0.1) | 近期记忆排名更高 |
记忆层级
| 层级 | TTL | 用例 | 示例 |
|---|---|---|---|
short | 6小时(可配置) | 临时上下文 | 当前调试状态、临时变量、错误跟踪 |
mid | 7天(可配置) | 工作知识 | 冲刺目标、近期决策、当前分支目的 |
long | 永久 | 来之不易的知识 | 架构、用户偏好、纠正、约定 |
自动行为
- 召回时延长TTL:短期记忆+1小时,中期记忆+1天
- 自动提升:访问5次以上的中期记忆提升为长期(清除过期时间)
- 优先级强化:每访问10次,优先级增加1(上限为10)
- 矛盾检测:当新记忆与同一命名空间中的现有记忆冲突时发出警告
- 去重:按标题+命名空间upsert;更新时层级永不降级
可配置TTL
默认TTL(短期6小时,中期7天)可在 ~/.config/ai-memory/config.toml 的 [ttl] 部分下覆盖:
[ttl]
short_ttl_secs = 21600      # short-tier TTL in seconds (default: 21600 = 6 hours)
mid_ttl_secs = 604800        # mid-tier TTL in seconds (default: 604800 = 7 days)
long_ttl_secs = 0            # long-tier TTL in seconds (default: 0 = never expires)
short_extend_secs = 3600     # TTL extension on recall for short-tier memories in seconds (default: 3600 = +1h)
mid_extend_secs = 86400      # TTL extension on recall for mid-tier memories in seconds (default: 86400 = +1d)
所有五个字段均为可选——省略任何字段以保留默认值。将任何值设为0以禁用该层级的过期。值被限制在10年最大值;负扩展值被限制为0。
注意: 配置在进程启动时加载一次。更改
config.toml需要重启ai-memory进程(MCP服务器、HTTP守护进程或CLI)才能生效。
归档
当垃圾回收使记忆过期时,它可以被归档而不是永久删除。归档记忆被移动到单独的存储中,之后可以浏览、恢复或清除。
配置
在 ~/.config/ai-memory/config.toml 中启用归档:
archive_on_gc = true # archive expired memories instead of deleting them (default: true)
CLI命令
archive 子命令管理归档:
ai-memory archive list                          # list archived memories
ai-memory archive list --namespace my-project   # filter by namespace
ai-memory archive restore <id>                  # restore an archived memory to active store
ai-memory archive purge --older-than-days 90     # permanently delete archives older than 90 days
ai-memory archive stats                         # show archive statistics
注意: 恢复的记忆会清除其
expires_at(变为永久,直到下次分配TTL)。
MCP工具
MCP客户端可使用四个归档工具:
| 工具 | 描述 |
|---|---|
memory_archive_list | 列出已归档记忆(支持可选的命名空间/层级/标签过滤器) |
memory_archive_restore | 将已归档记忆恢复到活动存储 |
memory_archive_purge | 永久删除匹配过滤器的已归档记忆 |
memory_archive_stats | 获取归档统计信息(按层级、命名空间、年龄计数) |
HTTP端点
| 方法 | 端点 | 描述 |
|---|---|---|
| GET | /api/v1/archive | 列出已归档记忆(支持可选过滤器) |
| POST | /api/v1/archive/{id}/restore | 将已归档记忆恢复到活动存储 |
| DELETE | /api/v1/archive | 清除匹配过滤器的已归档记忆 |
| GET | /api/v1/archive/stats | 归档统计信息(按层级、命名空间、年龄计数) |
安全
ai-memory在所有输入路径中包含加固措施:
- 事务安全 —— 所有多步骤数据库操作均使用事务;失败时不会产生部分写入
- FTS 注入防护 —— 用户输入在进入 FTS5 查询前经过净化处理;特殊字符会被转义
- 错误信息净化 —— 内部数据库路径和系统细节会从错误响应中剥离;客户端看到的是结构化错误类型(NOT_FOUND、VALIDATION_FAILED、DATABASE_ERROR、CONFLICT)
- 请求体大小限制 —— 通过 Axum 的 DefaultBodyLimit 将 HTTP 请求体限制在 50 MB
- 批量操作限制 —— 批量创建端点强制执行最大批次大小,以防止资源耗尽
- CORS —— 为 localhost 开发工作流启用了宽松的 CORS 层
- 输入验证 —— 每个写入路径都会验证标题长度、内容长度、命名空间格式、来源值、优先级范围(1-10)、置信度范围(0.0-1.0)、标签格式、层级值、关系类型和 ID 格式
- 同步中的链接验证 —— 在同步操作期间导入前,所有链接都会经过验证(两个 ID、关系类型、无自链接)
- 线程安全的颜色 —— 终端颜色检测使用
AtomicBool以确保安全的并发访问 - 仅限本地的 HTTP —— HTTP 服务器默认绑定到 127.0.0.1;不暴露到网络
- WAL 模式 —— SQLite 预写日志,用于在写入期间安全地进行并发读取
文档
| 指南 | 受众 |
|---|---|
| 更新日志 v0.9.0 | 当前版本(secure-default hardening) —— 默认要求存储路径代理证明(#1751),双 MCP+HTTP 钩子执行门控(#1885/#1924),schema v78 |
| 发布说明 v0.8.0 | 先前版本(distributed-coordination)—— 协调基础、类型化认知、联邦加固、治理执行,schema v58→v70 |
| 协调工具参考 | v0.8.0 的动作 / 租约 / 信号 / 检查点 / 例程原语(memory_action_* / _lease_* / _signal_* / _checkpoint_* / _routine_*) |
| 迁移指南 v0.7 | 从 v0.6.x 升级(涵盖 attested-cortex、hooks、transcripts、AGE、权限、G1 继承修复) |
| v0.7 新特性 | attested-cortex 子系统的可视化讲解 |
attested-cortex RFC | 四项 v0.7 架构决策的设计依据 |
| v0.7 兼容性矩阵 | 按功能划分的默认与可选启用矩阵 |
| 安装指南 | 让系统运行起来(包括针对多个 AI 平台的 MCP 配置) |
| 用户指南 | 需要持久记忆的 AI 助手用户 |
| 开发者指南 | 基于 ai-memory 构建或为其贡献代码 |
| 管理员指南 | 部署、监控和故障排除 |
| 工程标准 | 代码、测试、安全和发布标准(权威) |
| AI 开发者工作流 | 为向此仓库贡献代码的 AI 编码代理提供的分步工作流 |
| AI 开发者治理标准 | AI 参与策略:权限、署名、审查、审计 |
| GitHub Pages | 带动画图表的可视化概览 |
许可证
版权所有 2026 AlphaOne LLC。
根据 Apache 许可证 2.0 版(“许可证”)授权; 除非遵守许可证,否则您不得使用此文件。 您可以在以下位置获取许可证副本:
除非适用法律要求或书面同意,否则按“AS IS”基础分发本软件, 不附带任何明示或暗示的保证或条件。 请参阅许可证,了解管理权限和限制的具体语言。
Footnotes
-
MCP 工具表面与召回层级正交 —— 每个层级在
--profile full处看到相同的 101 个工具(默认--profile core在启动时广告 8 个,无论层级如何 —— 7 个 Core 家族工具加上始终开启的memory_capabilities引导程序;其他 93 个按需加载)。层级门控的是模型(嵌入器、交叉编码器、LLM)和功能行为(余弦相似度、LLM 扩展、重排序),而非广告的工具数量。由src/mcp/registry.rs中的Profile::full().expected_tool_count()+const_count_matches_full_profile固定。 ↩