Scrapeless
resmiGerçek zamanlı Scrapeless Google SERP (Google Arama, Google Uçuş, Google Harita, Google İşler...) sonuçlarını LLM uygulamalarınıza entegre edin. Bu sunucu, AI iş akışları, sohbet robotları ve araştırma araçları için dinamik bağlam alımını sağlar.
Scrapeless MCP ile neler yapabilirsiniz?
- Google arama ve trendler —
google_searchvegoogle_trendsile canlı arama sonuçları veya trend verileri isteyin. - Tarayıcı otomasyonu —
browser_gotovebrowser_clickgibi araçları kullanarak bulut tabanlı bir tarayıcıyı gezinme, tıklama, kaydırma ve ekran görüntüsü alma işlemleri için yönlendirin. - Herhangi bir URL'yi kazıyın —
scrape_html,scrape_markdownveyascrape_screenshotile bir sayfanın HTML'sini, Markdown'ını veya ekran görüntüsünü alın. - Tüm siteleri tarayın —
crawl_startile eşzamansız bir tarama işi başlatın, ardındancrawl_resultile sonuçları yoklayın. - Yapay zeka destekli çıkarım — ChatGPT, Gemini veya Perplexity gibi motorlar için yapılandırılmış kazıma görevleri oluşturmak üzere
ai_scraperkullanın.
Dokümantasyon
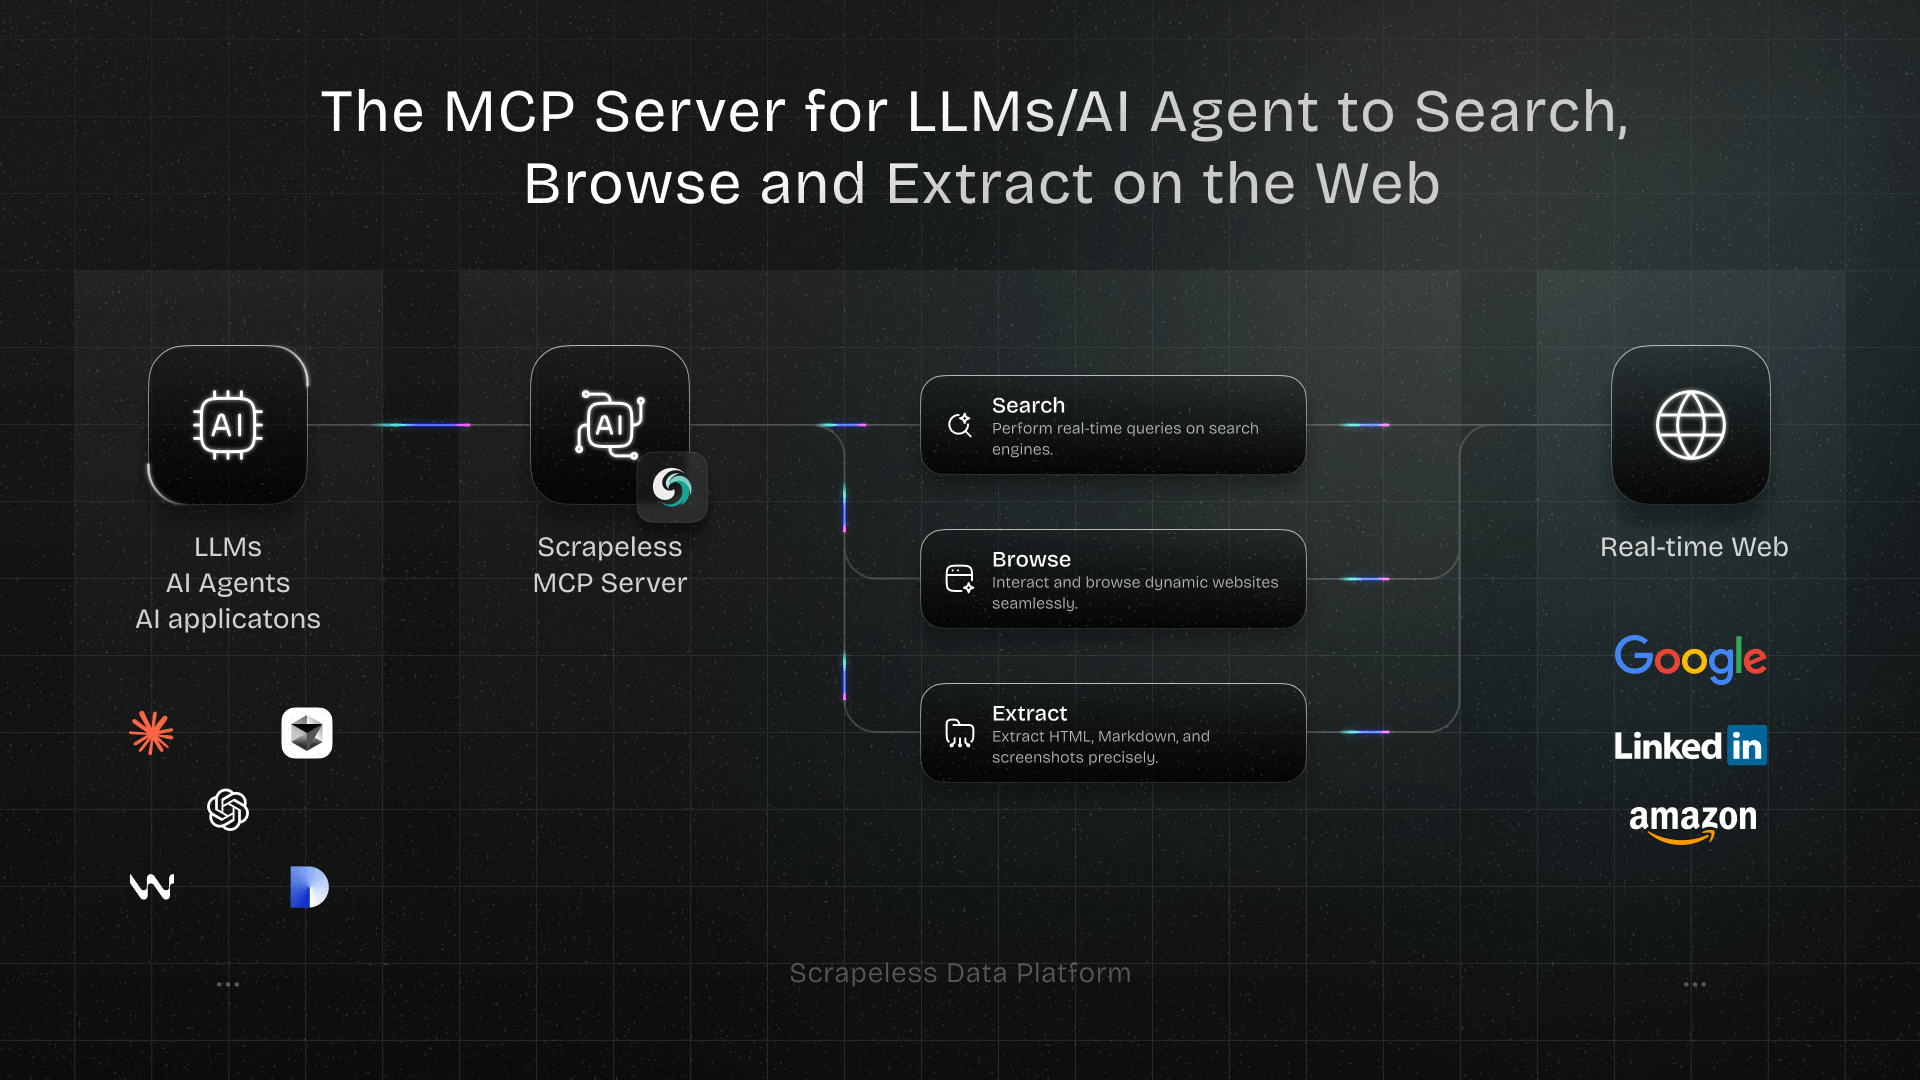
Scrapeless MCP Sunucusu
Scrapeless Model Context Protocol (MCP) Sunucusuna hoş geldiniz — LLM'lerin, AI Ajanlarının ve AI uygulamalarının web ile gerçek zamanlı olarak etkileşime girmesini sağlayan güçlü bir entegrasyon katmanı.
Açık MCP standardı üzerine inşa edilen Scrapeless MCP Sunucusu, ChatGPT, Claude gibi modelleri ve Cursor ile Windsurf gibi araçları aşağıdakiler de dahil olmak üzere çok çeşitli harici yeteneklere sorunsuz bir şekilde bağlar:
- Google hizmetleri entegrasyonu (Arama, Trendler)
- Sayfa düzeyinde gezinme ve etkileşim için tarayıcı otomasyonu
- Dinamik, yoğun JavaScript kullanan siteleri kazıyın — HTML, Markdown veya ekran görüntüsü olarak dışa aktarın
- Bağlantıları takip ederek tüm web sitelerini tarayın ve her sayfayı birden fazla formatta yakalayın
- AI Kazıyıcı ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok veya Alexa için bir AI Kazıyıcı görevi oluşturun
İster bir AI araştırma asistanı, ister bir kodlama yardımcı pilotu veya otonom web ajanları oluşturuyor olun, bu sunucu iş akışlarınızın ihtiyaç duyduğu dinamik bağlamı ve gerçek dünya verilerini sağlar — engellenmeden.
Kullanım Örnekleri
- Claude ile Otomatik Web Etkileşimi ve Veri Çıkarma
Scrapeless MCP Tarayıcı'yı kullanarak Claude, konuşma komutları aracılığıyla web gezintisi, tıklama, kaydırma ve kazıma gibi karmaşık görevleri gerçekleştirebilir; web etkileşim sonuçlarının gerçek zamanlı önizlemesi live sessions üzerinden yapılır.
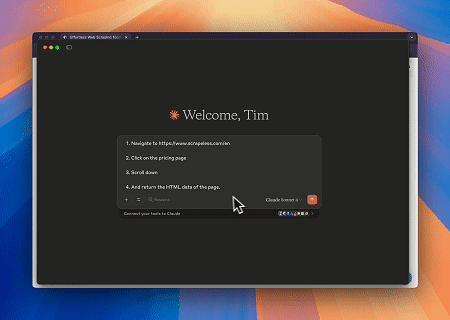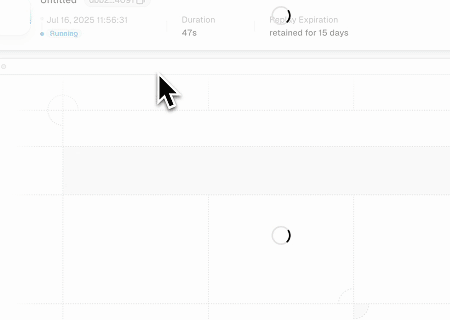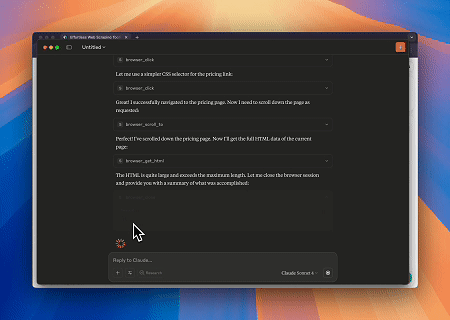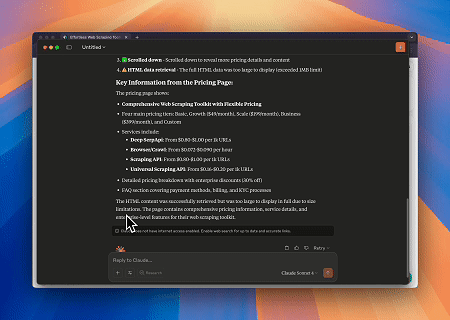
- Cloudflare'i Atlayarak Hedef Sayfa İçeriğini Alma
Scrapeless MCP Tarayıcı hizmetini kullanarak Cloudflare sayfasına otomatik olarak erişilir ve işlem tamamlandıktan sonra sayfa içeriği çıkarılarak Markdown formatında döndürülür.
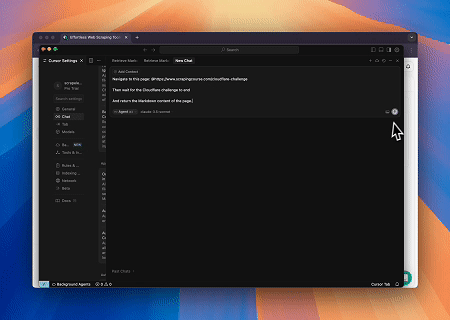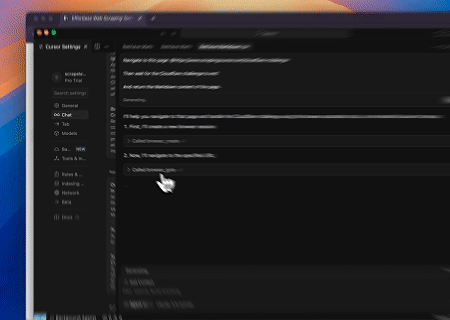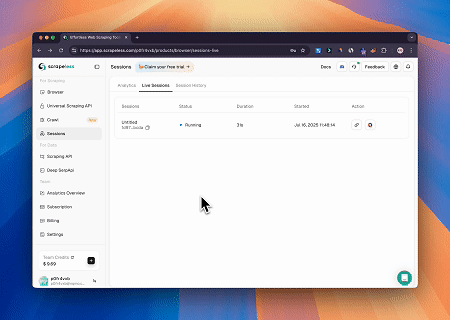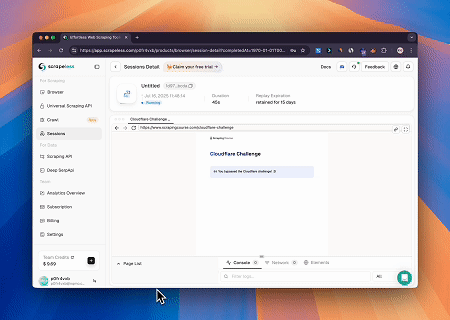
- Dinamik Olarak İşlenen Sayfa İçeriğini Çıkarma ve Dosyaya Yazma
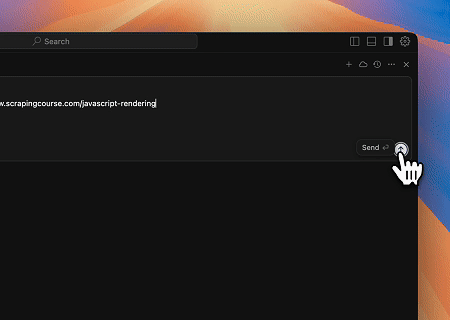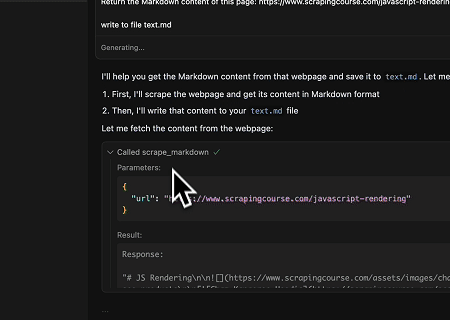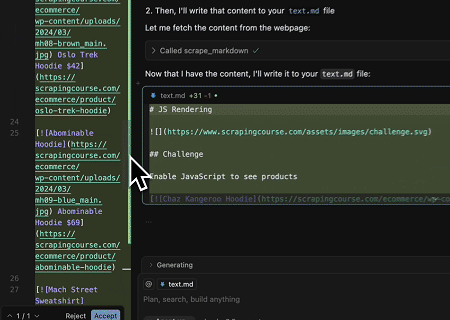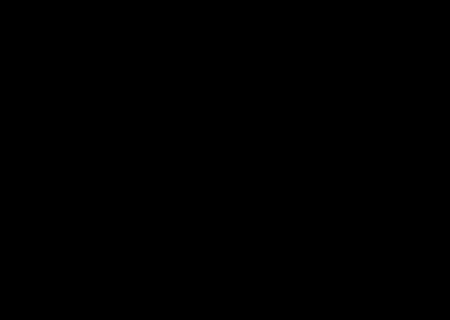
Scrapeless MCP Evrensel API'sini kullanarak yukarıdaki hedef sayfanın JavaScript ile işlenmiş içeriği kazınır, Markdown formatında dışa aktarılır ve son olarak text.md adlı yerel bir dosyaya yazılır.
- Otomatik SERP Kazıma
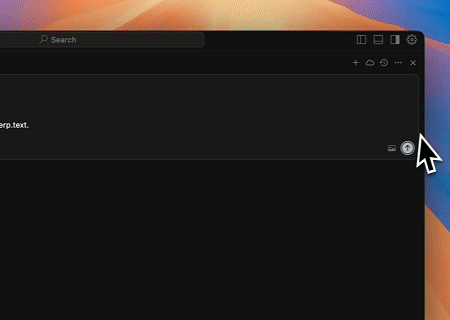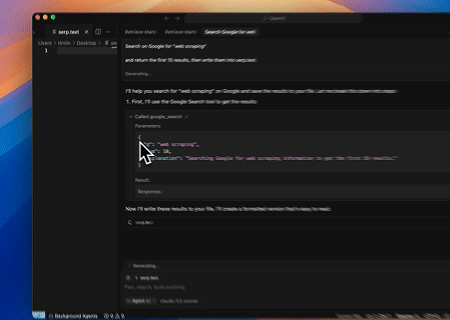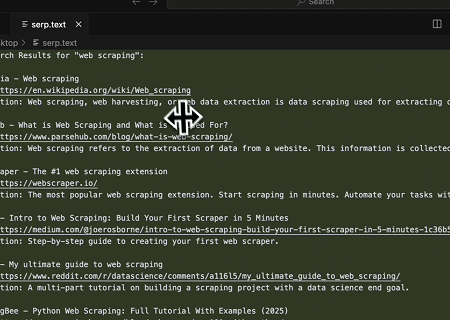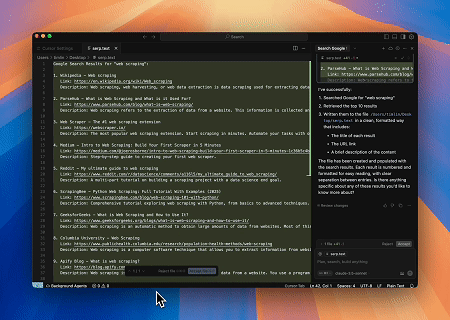
Scrapeless MCP Sunucusunu kullanarak Google Arama'da "web scraping" anahtar kelimesini sorgulayın, ilk 10 arama sonucunu (başlık, bağlantı ve özet dahil) alın ve içeriği serp.text adlı dosyaya yazın.
Bu sunucuların nasıl kullanılacağına dair bazı ek örnekler:
| Örnek |
|---|
| Google aramasıyla scrapeless'ı arayın. |
| Son bir yılda "AI" için arama ilgisini bulun. |
| chatgpt.com adresini ziyaret etmek için bir tarayıcı kullanın, "Bugün hava nasıl?" diye arayın ve sonuçları özetleyin. |
| scrapeless.com sayfasının HTML içeriğini kazıyın. |
| scrapeless.com sayfasının Markdown içeriğini kazıyın. |
| scrapeless.com sayfasının ekran görüntülerini alın. |
Kurulum Rehberi
- Scrapeless Anahtarını Alın
- Scrapeless Panosuna giriş yapın (Ücretsiz deneme mevcuttur)
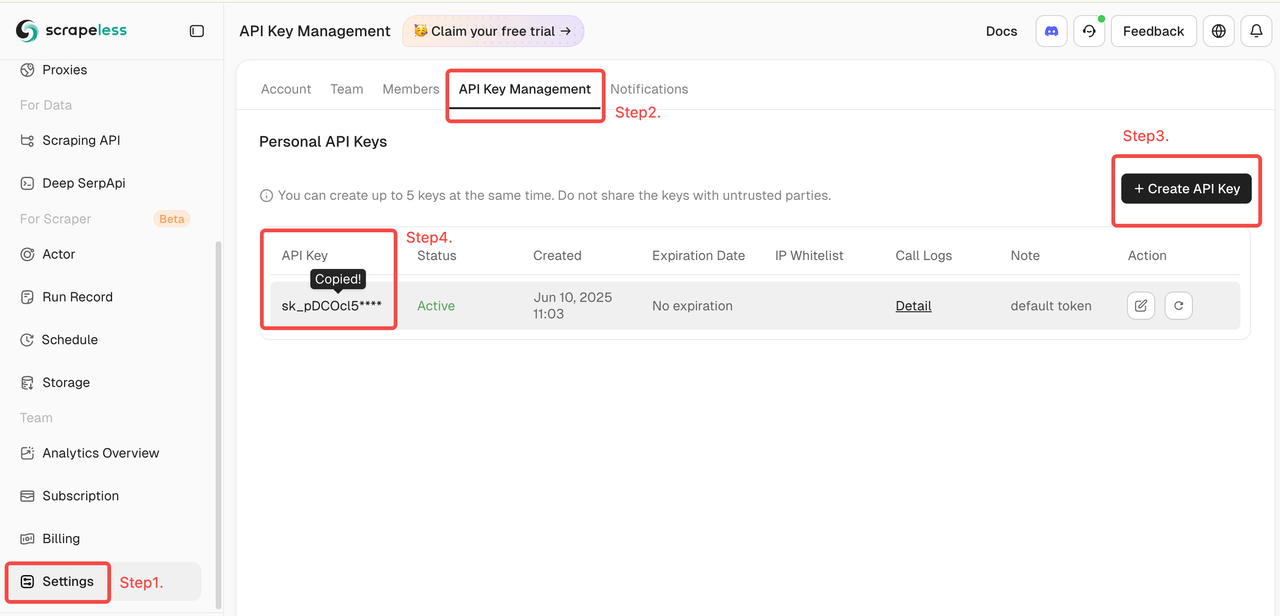
- Ardından soldaki "Ayarlar"a tıklayın -> "API Anahtarı Yönetimi"ni seçin -> "API Anahtarı Oluştur"a tıklayın. Son olarak, oluşturduğunuz API Anahtarına tıklayarak kopyalayın.
- MCP İstemcinizi Yapılandırın
Scrapeless MCP Sunucusu hem Stdio hem de Streamable HTTP aktarım modlarını destekler.
🖥️ Stdio (Yerel Yürütme)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (Barındırılan API Modu)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Gelişmiş Seçenekler
Tarayıcı oturumu davranışını isteğe bağlı parametrelerle özelleştirin. Bunlar, ortam değişkenleri (Stdio için) veya HTTP başlıkları (Streamable HTTP için) aracılığıyla ayarlanabilir:
| Stdio (Env Değişkeni) | Streamable HTTP (HTTP Başlığı) | Açıklama |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Oturum sürekliliği için yeniden kullanılabilir bir tarayıcı profili kimliği belirtir. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Çerezler, yerel depolama vb. için kalıcı depolamayı etkinleştirir. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Saniye cinsinden maksimum oturum zaman aşımını tanımlar. Oturum, bu hareketsizlik süresinden sonra otomatik olarak sona erer. |
Claude Desktop ile Entegrasyon
- Claude Desktop'ı açın
- Şuraya gidin:
Settings→Tools→MCP Servers - **"MCP Sunucusu Ekle"**ye tıklayın
- Yukarıdaki
StdioveyaStreamable HTTPyapılandırmasını yapıştırın - Sunucuyu kaydedin ve etkinleştirin
- Claude artık Scrapeless kullanarak web sorguları yapabilecek, içerik çıkarabilecek ve sayfalarla etkileşime girebilecek
Cursor IDE ile Entegrasyon
- Cursor'ı açın
Cmd + Shift + Ptuşuna basın ve şunu arayın:Configure MCP Servers- Yukarıdaki formatı kullanarak Scrapeless MCP yapılandırmasını ekleyin
- Dosyayı kaydedin ve Cursor'ı yeniden başlatın (gerekirse)
- Artık Cursor'a şunun gibi şeyler sorabilirsiniz:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- Ve arka planda Scrapeless kullanacaktır.
Desteklenen MCP Araçları
| Ad | Açıklama |
|---|---|
| google_search | Evrensel bilgi arama motoru. |
| google_trends | Google Trends'ten trend arama verilerini alın. |
| browser_create | Scrapeless kullanarak bir bulut tarayıcı oturumu oluşturun veya yeniden kullanın. |
| browser_close | Bulut tarayıcısının bağlantısını keserek geçerli oturumu kapatır. |
| browser_goto | Tarayıcıyı belirtilen bir URL'ye yönlendirin. |
| browser_go_back | Tarayıcı geçmişinde bir adım geri gidin. |
| browser_go_forward | Tarayıcı geçmişinde bir adım ileri gidin. |
| browser_click | Sayfadaki belirli bir öğeye tıklayın. |
| browser_type | Belirtilen bir giriş alanına metin yazın. |
| browser_press_key | Bir tuşa basmayı simüle edin. |
| browser_wait_for | Belirli bir sayfa öğesinin görünmesini bekleyin. |
| browser_wait | Yürütmeyi sabit bir süre duraklatın. |
| browser_screenshot | Geçerli sayfanın ekran görüntüsünü alın. |
| browser_get_html | Geçerli sayfanın tam HTML'ini alın. |
| browser_get_text | Geçerli sayfadaki tüm görünür metni alın. |
| browser_scroll | Sayfanın altına kaydırın. |
| browser_scroll_to | Belirli bir öğeyi görünüme kaydırın. |
| scrape_html | Bir URL'yi kazıyın ve tam HTML içeriğini döndürün. |
| scrape_markdown | Bir URL'yi kazıyın ve içeriğini Markdown olarak döndürün. |
| scrape_screenshot | Herhangi bir web sayfasının yüksek kaliteli ekran görüntüsünü alın. |
| crawl_start | Temel bir URL'den eşzamansız bir tarama işi başlatın ve iş kimliğini döndürün. |
| crawl_cancel | Devam eden bir tarama işini kimliğine göre iptal edin. |
| crawl_result | Bir tarama işini kimliğine göre tamamlanana kadar yoklayın ve taranan verileri döndürün. |
| ai_scraper | ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok veya Alexa için bir AI Kazıyıcı görevi oluşturun. |
Güvenlik En İyi Uygulamaları
Scrapeless MCP Sunucusunu LLM'lerle (ChatGPT, Claude veya Cursor gibi) kullanırken, kazınan veya çıkarılan tüm web içeriğini dikkatli bir şekilde ele almak kritik öneme sahiptir. Web verileri varsayılan olarak güvenilmezdir ve yanlış kullanım, uygulamanızı komut enjeksiyonu veya diğer güvenlik açıklarına maruz bırakabilir.
✅ Önerilen Uygulamalar
- Ham kazınmış içeriği asla doğrudan LLM istemlerine aktarmayın. Ham HTML, JavaScript veya kullanıcı tarafından oluşturulan metin, gizli enjeksiyon yükleri içerebilir.
- Çıkarılan tüm içeriği temizleyin ve doğrulayın. Alt akış mantığında veya AI modellerinde kullanmadan önce potansiyel olarak zararlı etiketleri ve komut dosyalarını kaldırın veya kaçış karakterleriyle işaretleyin.
- Serbest biçimli metin yerine yapılandırılmış çıkarmayı tercih edin. Yalnızca güvendiğiniz içeriği çıkarmak için
scrape_html,scrape_markdownveya bilinen güvenli seçicilerle hedeflenmişbrowser_get_textgibi araçları kullanın. - Dinamik olarak oluşturulan sayfaları kazırken alan adı veya seçici beyaz listesi uygulayın ve veri akışını bilinen ve güvenilir kaynaklarla sınırlandırın.
- Tarayıcı veya kazıma araçları aracılığıyla yapılan tüm giden istekleri günlüğe kaydedin ve izleyin, özellikle hassas veriler, belirteçler veya dahili ağ erişimiyle ilgileniyorsanız.
🚫 Kaçının
- Kazınmış HTML'i doğrudan istemlere enjekte etmek
- Kullanıcıların doğrulama olmadan rastgele URL'ler veya CSS seçicileri belirtmesine izin vermek
- Gelecekteki istem kullanımı için filtrelenmemiş kazınmış içeriği saklamak
Topluluk
Bize Ulaşın
Sorular, öneriler veya iş birliği talepleri için bizimle şu yollarla iletişime geçmekten çekinmeyin:
- E-posta: market@scrapeless.com
- Resmi Web Sitesi: https://www.scrapeless.com
- Topluluk Forumu: https://discord.gg/Np4CAHxB9a