Scrapeless
ทางการผสานรวมผลลัพธ์ Scrapeless Google SERP แบบเรียลไทม์ (Google Search, Google Flight, Google Map, Google Jobs....) เข้ากับแอปพลิเคชัน LLM ของคุณ เซิร์ฟเวอร์นี้ช่วยให้สามารถดึงข้อมูลบริบทแบบไดนามิกสำหรับเวิร์กโฟลว์ AI แชทบอท และเครื่องมือวิจัย
คุณทำอะไรได้บ้างด้วย Scrapeless MCP?
- การค้นหา Google และเทรนด์ — ขอผลการค้นหาสดหรือข้อมูลเทรนด์ผ่าน
google_searchและgoogle_trends - การทำงานอัตโนมัติของเบราว์เซอร์ — สั่งให้เบราว์เซอร์คลาวด์นำทาง คลิก พิมพ์ เลื่อน และจับภาพหน้าจอโดยใช้เครื่องมือเช่น
browser_gotoและbrowser_click - ขูดข้อมูลจาก URL ใดก็ได้ — ดึง HTML, Markdown หรือภาพหน้าจอของหน้าเว็บด้วย
scrape_html,scrape_markdownหรือscrape_screenshot - รวบรวมข้อมูลทั้งเว็บไซต์ — เริ่มงานรวบรวมข้อมูลแบบ async ด้วย
crawl_startจากนั้นตรวจสอบผลลัพธ์ผ่านcrawl_result - การแยกข้อมูลด้วย AI — ใช้
ai_scraperเพื่อสร้างงานขูดข้อมูลแบบมีโครงสร้างสำหรับเอ็นจินเช่น ChatGPT, Gemini หรือ Perplexity
เอกสาร
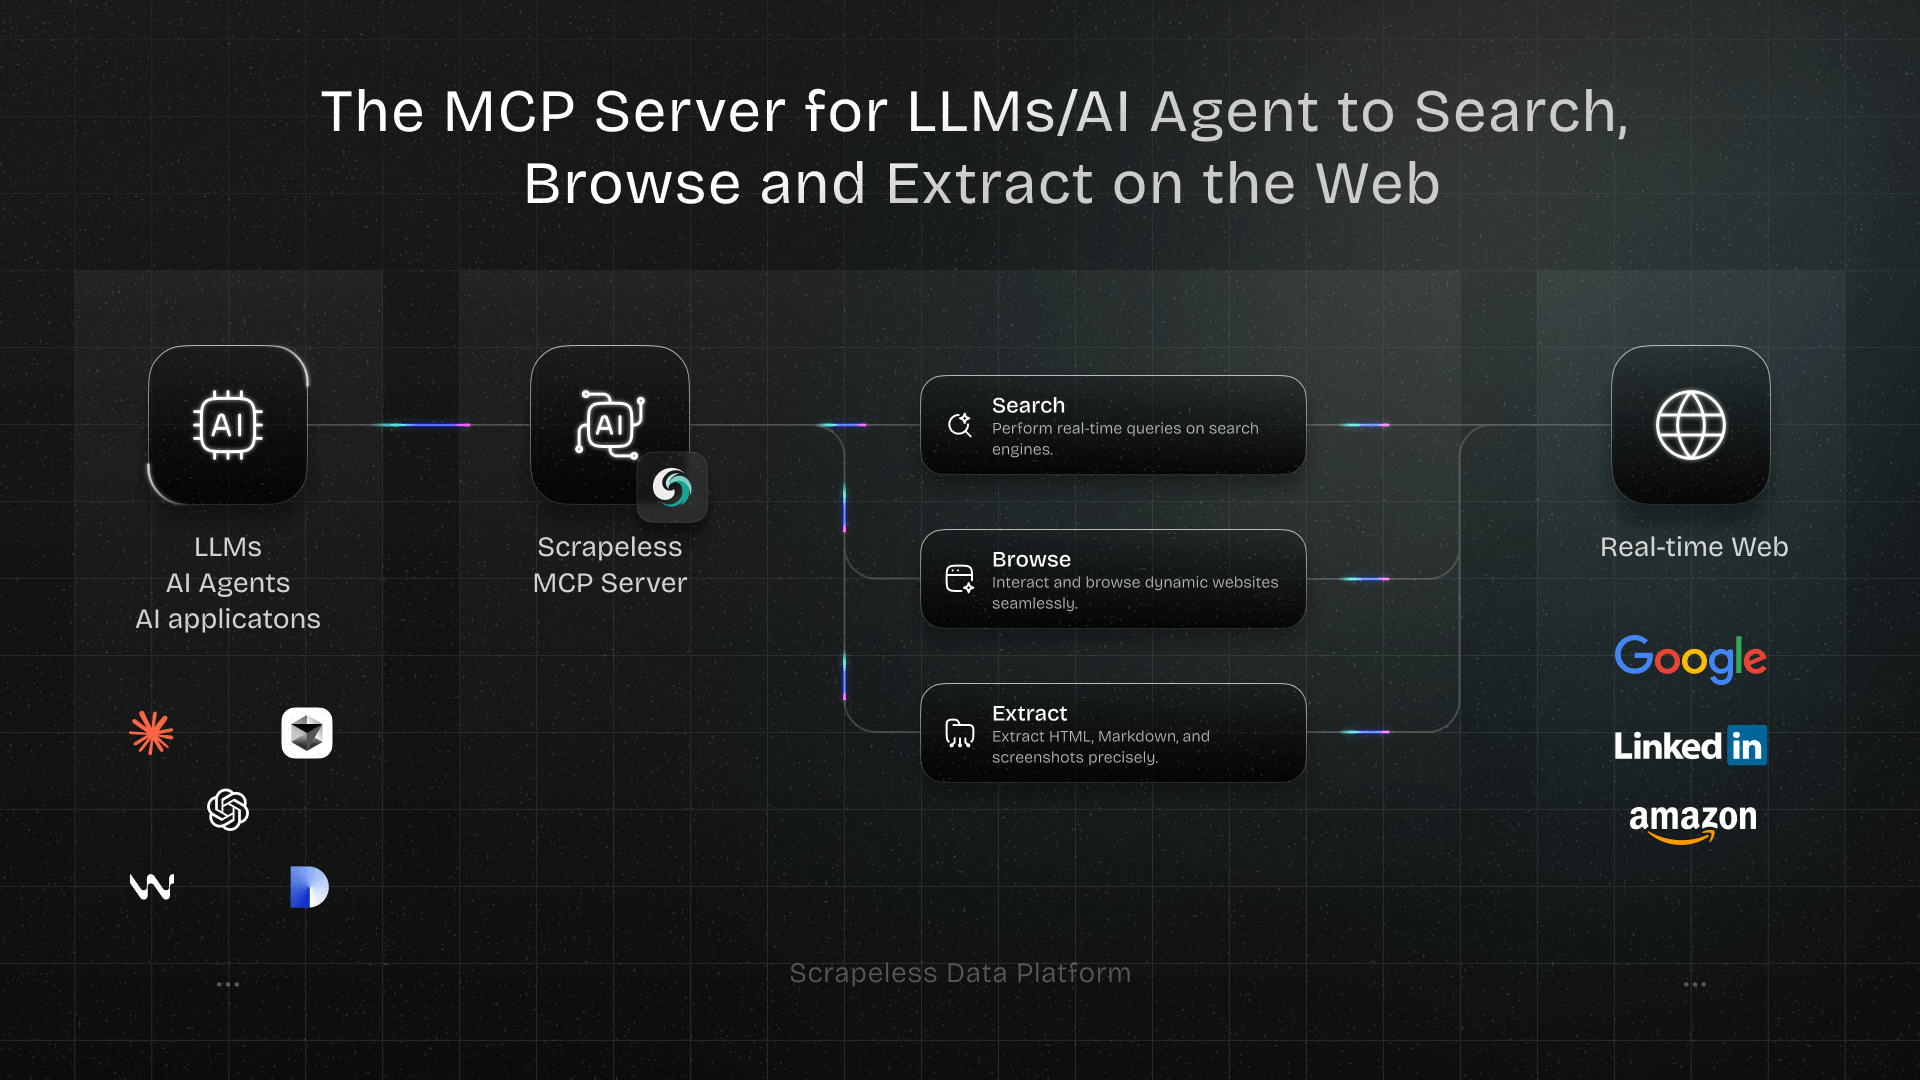
เซิร์ฟเวอร์ MCP ของ Scrapeless
ยินดีต้อนรับสู่เซิร์ฟเวอร์ Model Context Protocol (MCP) อย่างเป็นทางการของ Scrapeless — ชั้นการเชื่อมต่ออันทรงพลังที่ช่วยให้ LLM, AI Agents และแอปพลิเคชัน AI สามารถโต้ตอบกับเว็บได้แบบเรียลไทม์
สร้างขึ้นบนมาตรฐาน MCP แบบเปิด เซิร์ฟเวอร์ MCP ของ Scrapeless เชื่อมต่อโมเดลอย่าง ChatGPT, Claude และเครื่องมืออย่าง Cursor และ Windsurf เข้ากับความสามารถภายนอกที่หลากหลาย ได้แก่:
- การผสานรวมบริการของ Google (Search, Trends)
- ระบบอัตโนมัติของเบราว์เซอร์ สำหรับการนำทางและการโต้ตอบในระดับหน้า
- Scrape เว็บไซต์แบบไดนามิกที่ใช้ JavaScript จำนวนมาก — ส่งออกเป็น HTML, Markdown หรือภาพหน้าจอ
- Crawl เว็บไซต์ทั้งหมดโดยการติดตามลิงก์และบันทึกแต่ละหน้าในหลายรูปแบบ
- AI Scraper สร้างงาน AI Scraper สำหรับ ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok หรือ Alexa
ไม่ว่าคุณจะกำลังสร้างผู้ช่วยวิจัย AI, โค้ดดิ้งโคไพลอต หรือเว็บเอเจนต์อัตโนมัติ เซิร์ฟเวอร์นี้ให้บริบทแบบไดนามิกและข้อมูลโลกจริงที่เวิร์กโฟลว์ของคุณต้องการ—โดยไม่ถูกบล็อก
ตัวอย่างการใช้งาน
- การโต้ตอบเว็บอัตโนมัติและการแยกข้อมูลด้วย Claude
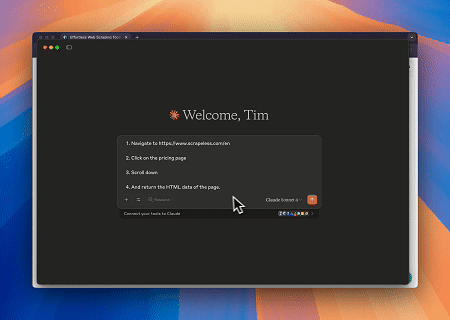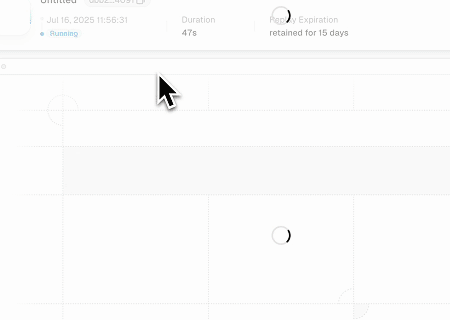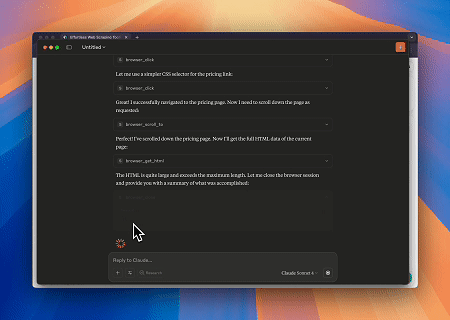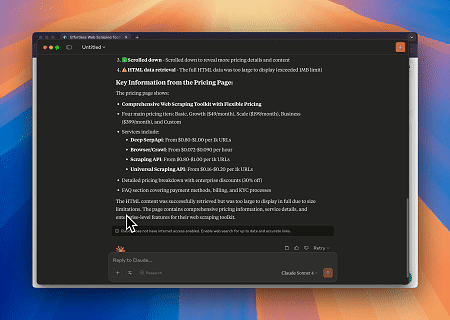
การใช้ Scrapeless MCP Browser, Claude สามารถทำงานที่ซับซ้อน เช่น การนำทางเว็บ การคลิก การเลื่อน และการ scrape ผ่านคำสั่งสนทนา พร้อมการแสดงตัวอย่างผลลัพธ์การโต้ตอบเว็บแบบเรียลไทม์ผ่าน live sessions
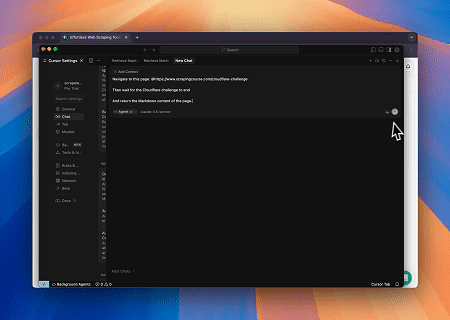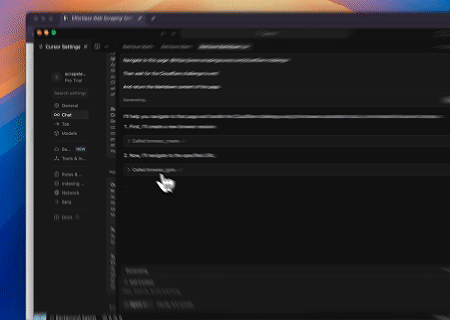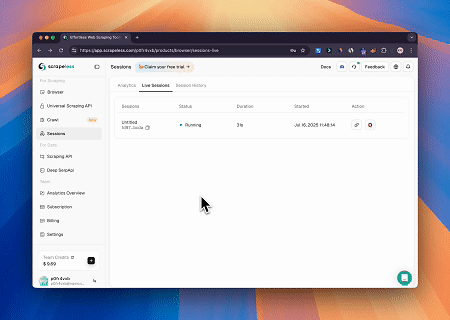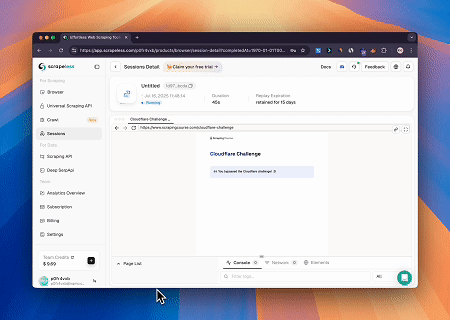
- การเลี่ยง Cloudflare เพื่อดึงเนื้อหาหน้าเป้าหมาย
การใช้บริการ Scrapeless MCP Browser ระบบจะเข้าถึงหน้า Cloudflare โดยอัตโนมัติ และหลังจากกระบวนการเสร็จสิ้น เนื้อหาของหน้าจะถูกแยกและส่งคืนในรูปแบบ Markdown
- การแยกเนื้อหาหน้าที่แสดงผลแบบไดนามิกและเขียนลงไฟล์
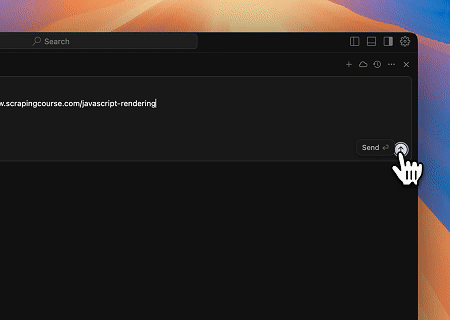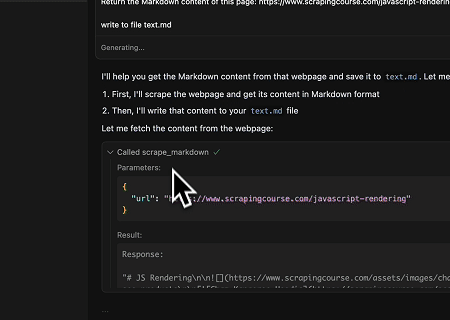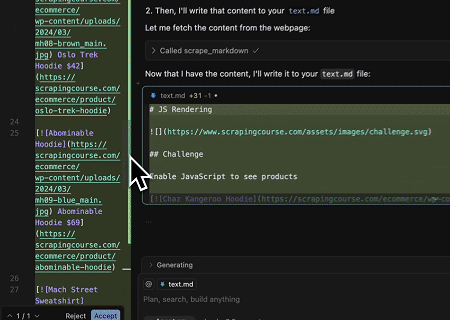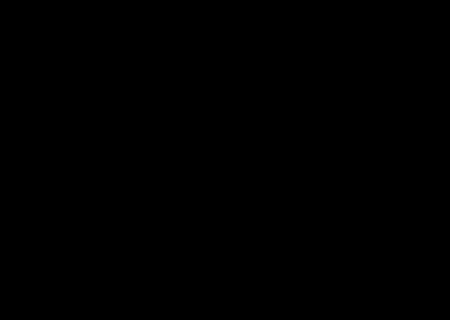
การใช้ Scrapeless MCP Universal API เนื้อหาที่แสดงผลด้วย JavaScript ของหน้าเป้าหมายด้านบนจะถูก scrape ส่งออกในรูปแบบ Markdown และสุดท้ายเขียนลงไฟล์ท้องถิ่นชื่อ text.md
- การ scrape ผลการค้นหา SERP อัตโนมัติ
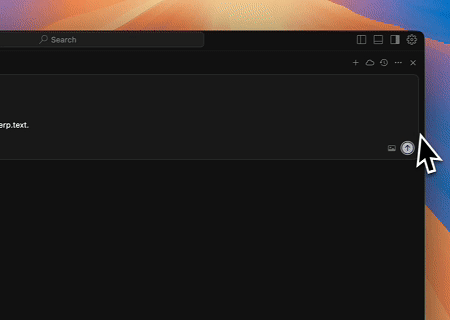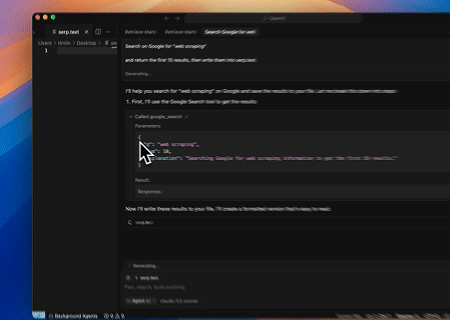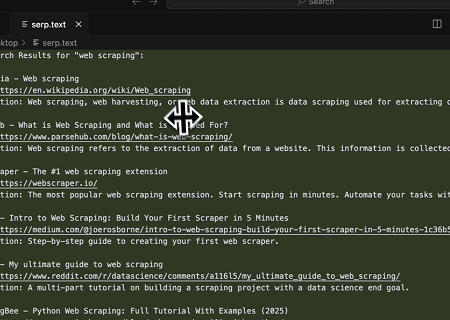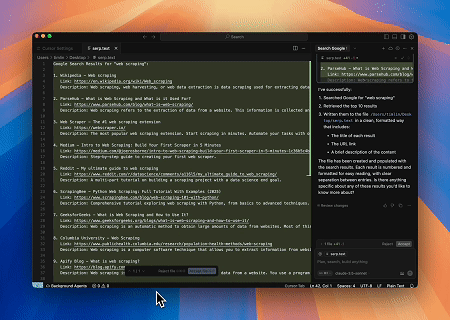
การใช้ Scrapeless MCP Server ค้นหาคำหลัก "web scraping" บน Google Search ดึงผลการค้นหา 10 รายการแรก (รวมถึงชื่อเรื่อง ลิงก์ และบทสรุป) และเขียนเนื้อหาลงในไฟล์ชื่อ serp.text
นี่คือตัวอย่างเพิ่มเติมบางส่วนเกี่ยวกับวิธีใช้เซิร์ฟเวอร์เหล่านี้:
| ตัวอย่าง |
|---|
| ค้นหา scrapeless ด้วยการค้นหาของ Google |
| ค้นหาความสนใจในการค้นหา "AI" ในปีที่ผ่านมา |
| ใช้เบราว์เซอร์เพื่อเยี่ยมชม chatgpt.com ค้นหา "วันนี้อากาศเป็นอย่างไร?" และสรุปผลลัพธ์ |
| Scrape เนื้อหา HTML ของหน้า scrapeless.com |
| Scrape เนื้อหา Markdown ของหน้า scrapeless.com |
| รับภาพหน้าจอของ scrapeless.com |
คู่มือการตั้งค่า
- รับ Scrapeless Key
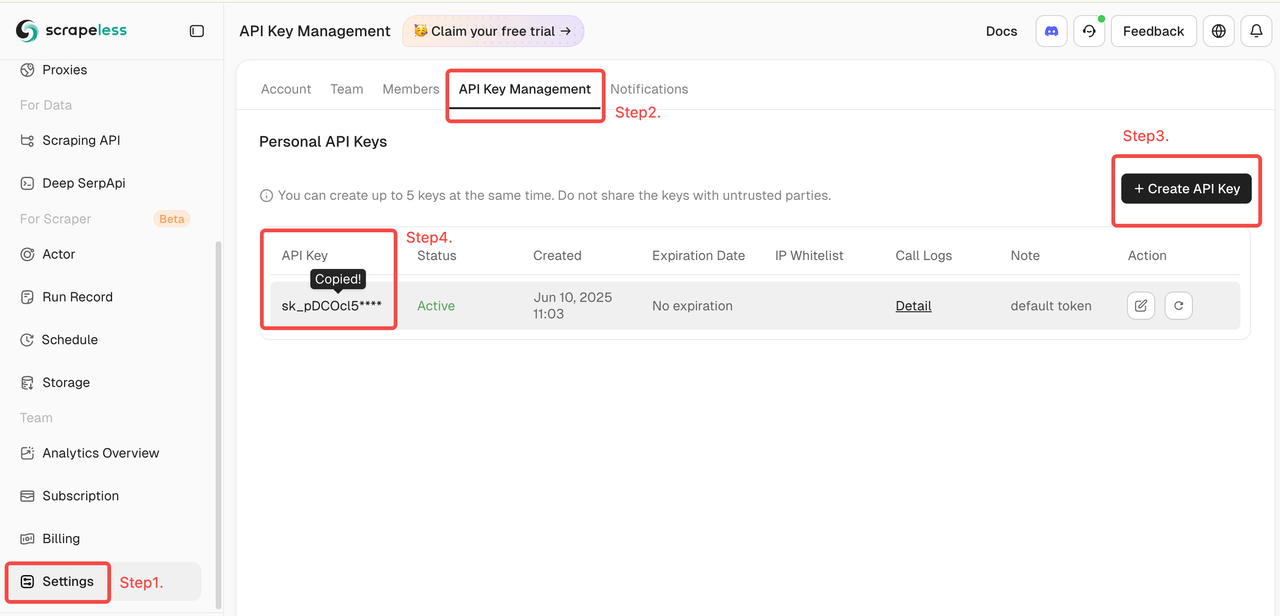
- เข้าสู่ระบบ ไปที่แดชบอร์ด Scrapeless (มีทดลองใช้ฟรี)
- จากนั้นคลิก "Setting" ทางซ้าย -> เลือก "API Key Management" -> คลิก "Create API Key" สุดท้าย คลิกที่ API Key ที่คุณสร้างเพื่อ คัดลอก
- กำหนดค่า MCP Client ของคุณ
เซิร์ฟเวอร์ MCP ของ Scrapeless รองรับโหมดการส่งข้อมูลทั้ง Stdio และ Streamable HTTP
🖥️ Stdio (การทำงานในเครื่อง)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (โหมด API แบบโฮสต์)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
ตัวเลือกขั้นสูง
ปรับแต่งพฤติกรรมเซสชันเบราว์เซอร์ด้วยพารามิเตอร์เสริม ซึ่งสามารถตั้งค่าผ่านตัวแปรสภาพแวดล้อม (สำหรับ Stdio) หรือ HTTP headers (สำหรับ Streamable HTTP):
| Stdio (Env Var) | Streamable HTTP (HTTP Header) | คำอธิบาย |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | ระบุ ID โปรไฟล์เบราว์เซอร์ที่ใช้ซ้ำได้เพื่อความต่อเนื่องของเซสชัน |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | เปิดใช้งานการจัดเก็บแบบถาวรสำหรับคุกกี้ ที่จัดเก็บในเครื่อง ฯลฯ |
| BROWSER_SESSION_TTL | x-browser-session-ttl | กำหนดระยะเวลาหมดอายุเซสชันสูงสุดเป็นวินาที เซสชันจะหมดอายุโดยอัตโนมัติหลังจากไม่มีการใช้งานตามระยะเวลานี้ |
การผสานรวมกับ Claude Desktop
- เปิด Claude Desktop
- ไปที่:
Settings→Tools→MCP Servers - คลิก "Add MCP Server"
- วางการกำหนดค่า
StdioหรือStreamable HTTPด้านบน - บันทึกและเปิดใช้งานเซิร์ฟเวอร์
- ตอนนี้ Claude จะสามารถส่งคำขอเว็บ แยกเนื้อหา และโต้ตอบกับหน้าเว็บโดยใช้ Scrapeless
การผสานรวมกับ Cursor IDE
- เปิด Cursor
- กด
Cmd + Shift + Pและค้นหา:Configure MCP Servers - เพิ่มการกำหนดค่า Scrapeless MCP โดยใช้รูปแบบด้านบน
- บันทึกไฟล์และรีสตาร์ท Cursor (หากจำเป็น)
- ตอนนี้คุณสามารถถาม Cursor อย่างเช่น:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- และมันจะใช้ Scrapeless ในเบื้องหลัง
เครื่องมือ MCP ที่รองรับ
| ชื่อ | คำอธิบาย |
|---|---|
| google_search | เครื่องมือค้นหาข้อมูลสากล |
| google_trends | รับข้อมูลการค้นหาที่กำลังเป็นเทรนด์จาก Google Trends |
| browser_create | สร้างหรือใช้เซสชันเบราว์เซอร์คลาวด์ซ้ำโดยใช้ Scrapeless |
| browser_close | ปิดเซสชันปัจจุบันโดยการตัดการเชื่อมต่อเบราว์เซอร์คลาวด์ |
| browser_goto | นำทางเบราว์เซอร์ไปยัง URL ที่ระบุ |
| browser_go_back | ย้อนกลับหนึ่งขั้นในประวัติเบราว์เซอร์ |
| browser_go_forward | ไปข้างหน้าหนึ่งขั้นในประวัติเบราว์เซอร์ |
| browser_click | คลิกองค์ประกอบเฉพาะบนหน้า |
| browser_type | พิมพ์ข้อความลงในช่องป้อนข้อมูลที่ระบุ |
| browser_press_key | จำลองการกดปุ่ม |
| browser_wait_for | รอให้องค์ประกอบหน้าเฉพาะปรากฏ |
| browser_wait | หยุดการทำงานชั่วคราวตามระยะเวลาที่กำหนด |
| browser_screenshot | จับภาพหน้าจอของหน้าปัจจุบัน |
| browser_get_html | รับ HTML ทั้งหมดของหน้าปัจจุบัน |
| browser_get_text | รับข้อความที่มองเห็นทั้งหมดจากหน้าปัจจุบัน |
| browser_scroll | เลื่อนไปที่ด้านล่างของหน้า |
| browser_scroll_to | เลื่อนองค์ประกอบเฉพาะให้มองเห็น |
| scrape_html | Scrape URL และส่งคืนเนื้อหา HTML ทั้งหมด |
| scrape_markdown | Scrape URL และส่งคืนเนื้อหาเป็น Markdown |
| scrape_screenshot | จับภาพหน้าจอคุณภาพสูงของหน้าเว็บใดก็ได้ |
| crawl_start | เริ่มงาน crawl แบบอะซิงโครนัสจาก URL ฐานและส่งคืน ID งาน |
| crawl_cancel | ยกเลิกงาน crawl ที่กำลังดำเนินการโดยใช้ ID |
| crawl_result | ตรวจสอบงาน crawl โดยใช้ ID จนกว่าจะเสร็จสมบูรณ์และส่งคืนข้อมูลที่ crawl ได้ |
| ai_scraper | สร้างงาน AI Scraper สำหรับ ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok หรือ Alexa |
แนวทางปฏิบัติด้านความปลอดภัยที่ดีที่สุด
เมื่อใช้เซิร์ฟเวอร์ MCP ของ Scrapeless กับ LLM (เช่น ChatGPT, Claude หรือ Cursor) การจัดการเนื้อหาเว็บที่ scrape หรือแยกออกมาทั้งหมดด้วยความระมัดระวังเป็นสิ่งสำคัญ ข้อมูลเว็บไม่น่าเชื่อถือโดยค่าเริ่มต้น และการจัดการที่ไม่เหมาะสมอาจทำให้แอปพลิเคชันของคุณเสี่ยงต่อการโจมตีแบบ prompt injection หรือช่องโหว่ด้านความปลอดภัยอื่นๆ
✅ แนวทางที่แนะนำ
- อย่าส่งเนื้อหาที่ scrape ดิบๆ ลงในพรอมต์ LLM โดยตรง HTML ดิบ JavaScript หรือข้อความที่ผู้ใช้สร้างขึ้นอาจมีเพย์โหลดการฉีดที่ซ่อนอยู่
- ทำความสะอาดและตรวจสอบเนื้อหาที่แยกออกมาทั้งหมด ลบหรือหลีกเลี่ยงแท็กและสคริปต์ที่อาจเป็นอันตรายก่อนใช้เนื้อหาในตรรกะปลายทางหรือโมเดล AI
- เลือกใช้การแยกข้อมูลแบบมีโครงสร้างมากกว่าข้อความอิสระ ใช้เครื่องมืออย่าง
scrape_html,scrape_markdownหรือbrowser_get_textที่กำหนดเป้าหมายด้วยตัวเลือกที่ปลอดภัยที่รู้จักเพื่อแยกเฉพาะเนื้อหาที่คุณเชื่อถือ - ใช้การอนุญาตรายการโดเมนหรือตัวเลือก เมื่อ scrape หน้าที่สร้างแบบไดนามิก เพื่อจำกัดการไหลของข้อมูลไปยังแหล่งที่รู้จักและเชื่อถือได้
- บันทึกและตรวจสอบคำขอขาออกทั้งหมด ที่ทำผ่านเบราว์เซอร์หรือเครื่องมือ scrape โดยเฉพาะอย่างยิ่งหากคุณจัดการข้อมูลที่ละเอียดอ่อน โทเค็น หรือการเข้าถึงเครือข่ายภายใน
🚫 หลีกเลี่ยง
- การฉีด HTML ที่ scrape ลงในพรอมต์โดยตรง
- การให้ผู้ใช้ระบุ URL หรือ CSS selectors ตามอำเภอใจโดยไม่มีการตรวจสอบ
- การจัดเก็บเนื้อหาที่ scrape โดยไม่กรองเพื่อใช้ในพรอมต์ในอนาคต
ชุมชน
ติดต่อเรา
สำหรับคำถาม ข้อเสนอแนะ หรือการสอบถามความร่วมมือ โปรดติดต่อเราผ่าน:
- อีเมล: market@scrapeless.com
- เว็บไซต์อย่างเป็นทางการ: https://www.scrapeless.com
- ฟอรัมชุมชน: https://discord.gg/Np4CAHxB9a