Scrapeless
официальныйИнтегрируйте результаты Google SERP в реальном времени (Google Search, Google Flight, Google Map, Google Jobs и другие) в ваши LLM-приложения. Этот сервер обеспечивает динамическое получение контекста для AI-рабочих процессов, чат-ботов и исследовательских инструментов.
Что можно делать с Scrapeless MCP?
- Поиск Google и тренды — Запрашивайте актуальные результаты поиска или данные о трендах через
google_searchиgoogle_trends. - Автоматизация браузера — Управляйте облачным браузером для навигации, кликов, ввода текста, прокрутки и создания скриншотов с помощью таких инструментов, как
browser_gotoиbrowser_click. - Скрейпинг любого URL — Получайте HTML, Markdown или скриншот страницы с помощью
scrape_html,scrape_markdownилиscrape_screenshot. - Обход целых сайтов — Запускайте асинхронную задачу обхода с помощью
crawl_start, затем опрашивайте результаты черезcrawl_result. - Извлечение на основе ИИ — Используйте
ai_scraperдля создания структурированных задач скрейпинга для таких движков, как ChatGPT, Gemini или Perplexity.
Документация
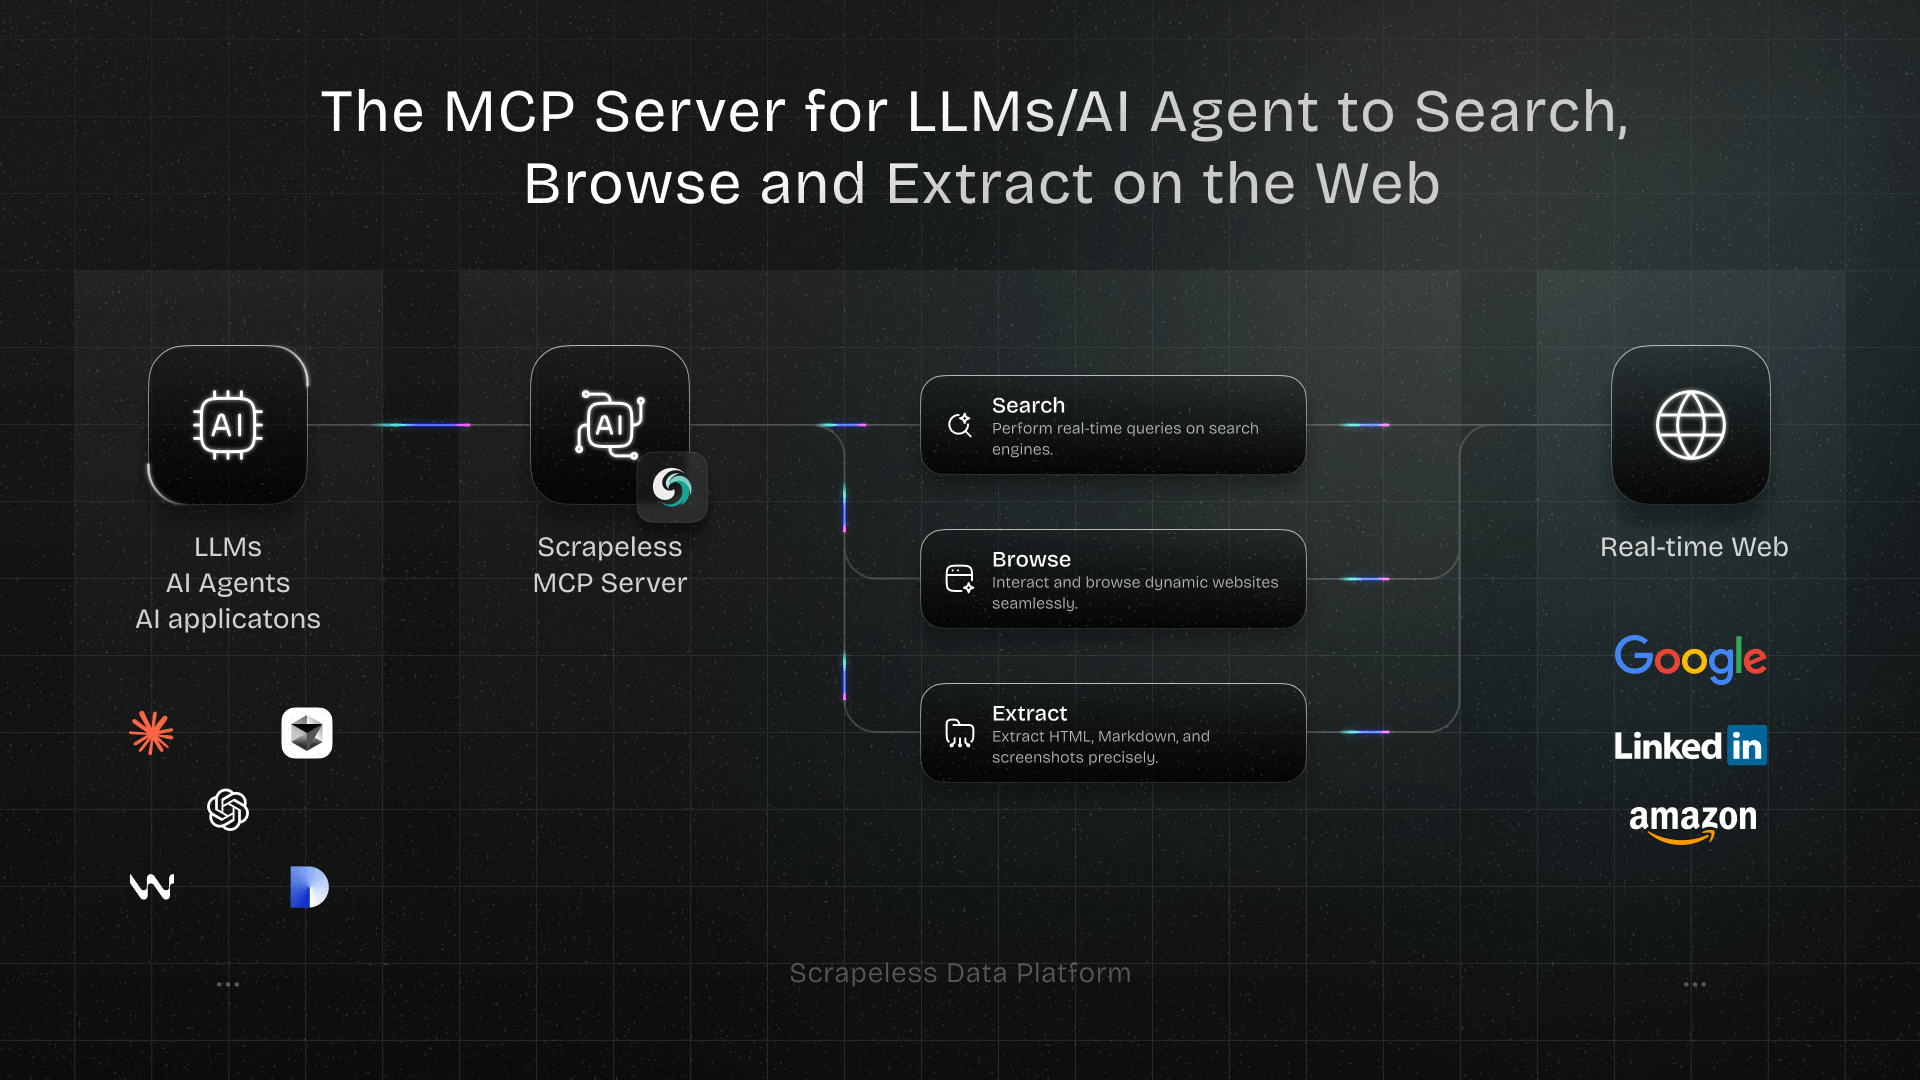
Scrapeless MCP Server
Добро пожаловать в официальный Scrapeless Model Context Protocol (MCP) Server — мощный интеграционный слой, который позволяет LLM, AI-агентам и AI-приложениям взаимодействовать с вебом в реальном времени.
Построенный на открытом стандарте MCP, Scrapeless MCP Server бесшовно подключает такие модели, как ChatGPT, Claude, и инструменты, такие как Cursor и Windsurf, к широкому спектру внешних возможностей, включая:
- Интеграция с сервисами Google (Поиск, Тренды)
- Автоматизация браузера для навигации и взаимодействия на уровне страниц
- Scrape динамических, насыщенных JavaScript сайтов — экспорт в HTML, Markdown или скриншоты
- Crawl целых веб-сайтов с переходом по ссылкам и захватом каждой страницы в нескольких форматах
- AI Scraper Создание задачи AI Scraper для ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok или Alexa
Создаете ли вы AI-исследовательского ассистента, кодинг-копайлота или автономных веб-агентов — этот сервер предоставляет динамический контекст и реальные данные, необходимые вашим рабочим процессам, без блокировок.
Примеры использования
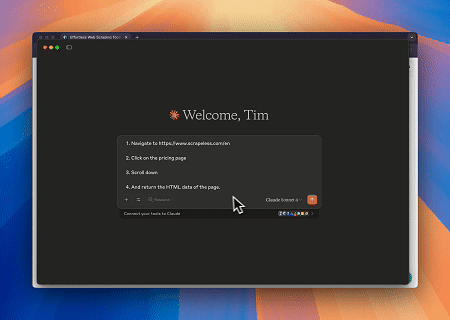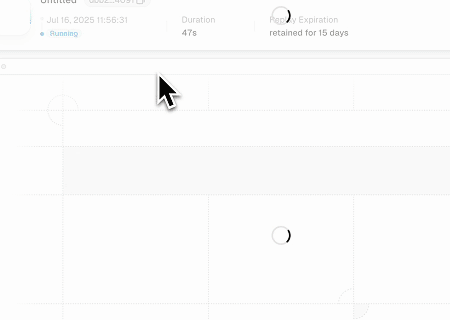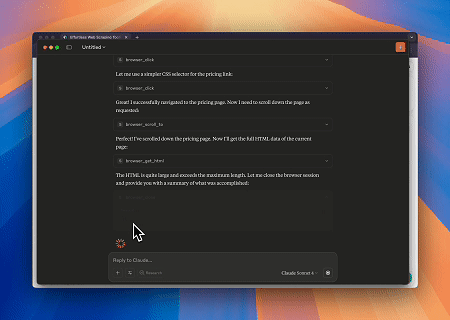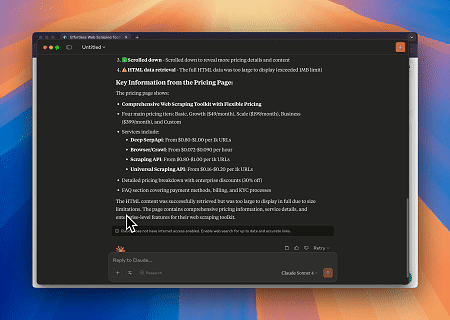
- Автоматизированное веб-взаимодействие и извлечение данных с помощью Claude
Используя Scrapeless MCP Browser, Claude может выполнять сложные задачи, такие как навигация по вебу, клики, прокрутка и скрапинг с помощью разговорных команд, с предварительным просмотром результатов веб-взаимодействия в реальном времени через live sessions.
- Обход Cloudflare для получения содержимого целевой страницы
Используя сервис Scrapeless MCP Browser, страница Cloudflare автоматически открывается, и после завершения процесса содержимое страницы извлекается и возвращается в формате Markdown.
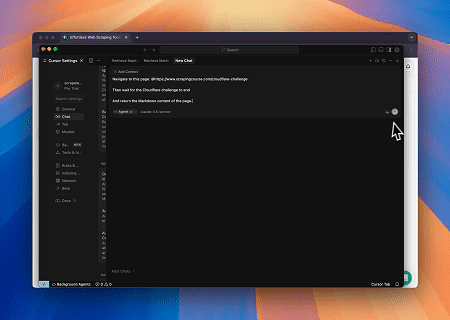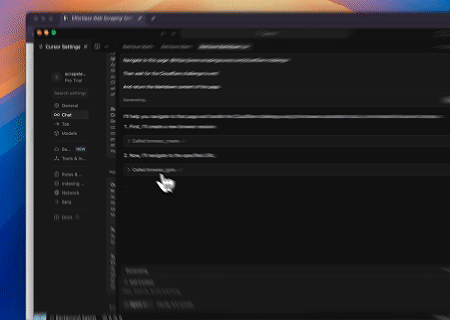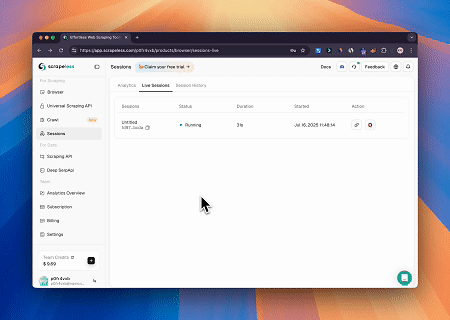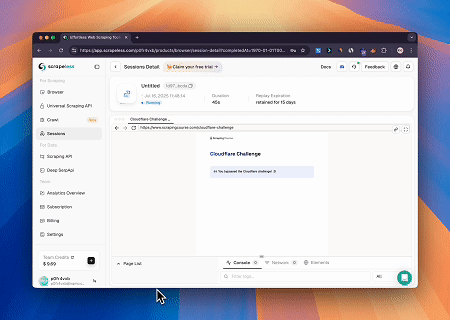
- Извлечение динамически отображаемого содержимого страницы и запись в файл
Используя Scrapeless MCP Universal API, извлекается содержимое целевой страницы выше, отображаемое с помощью JavaScript, экспортируется в формате Markdown и, наконец, записывается в локальный файл с именем text.md.
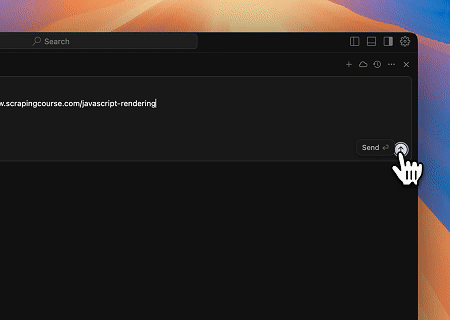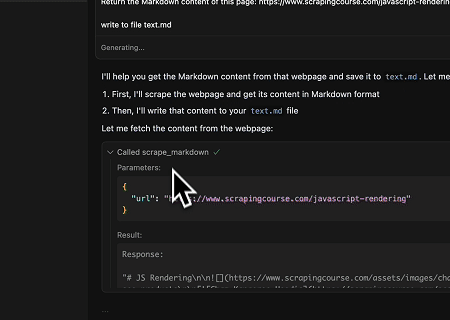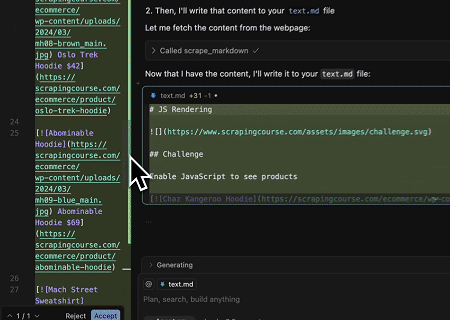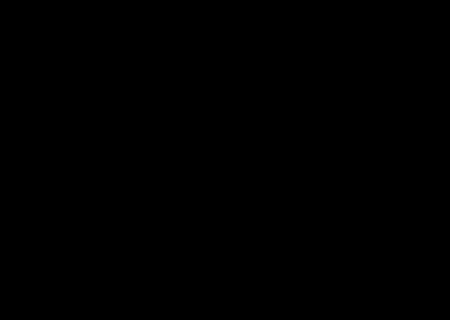
- Автоматизированный скрапинг SERP
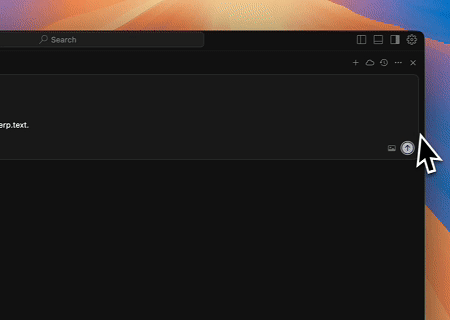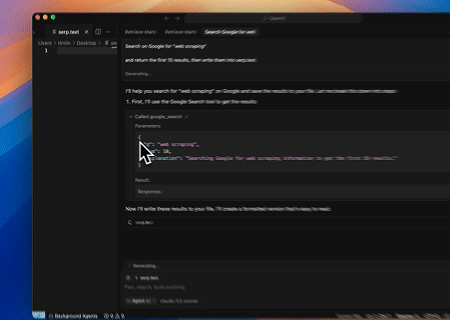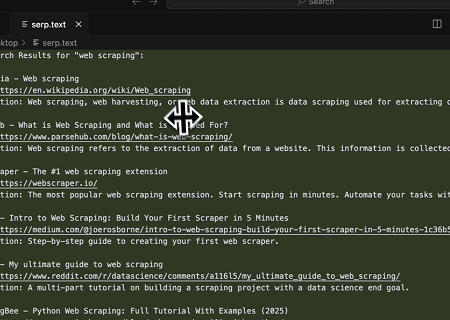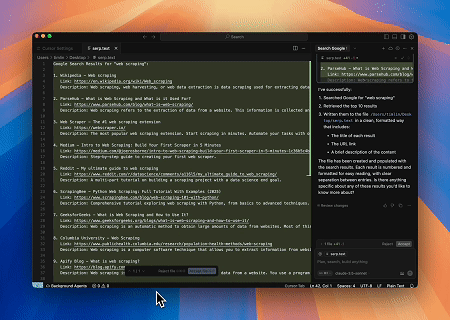
Используя Scrapeless MCP Server, выполните запрос по ключевому слову «web scraping» в Google Search, получите первые 10 результатов поиска (включая заголовок, ссылку и сводку) и запишите содержимое в файл с именем serp.text.
Вот несколько дополнительных примеров использования этих серверов:
| Пример |
|---|
| Поиск scrapeless через Google search. |
| Найдите интерес к поиску «AI» за последний год. |
| Используйте браузер для посещения chatgpt.com, выполните поиск «Какая сегодня погода?» и обобщите результаты. |
| Скрапьте HTML-содержимое страницы scrapeless.com. |
| Скрапьте Markdown-содержимое страницы scrapeless.com. |
| Получите скриншоты scrapeless.com. |
Руководство по настройке
- Получите ключ Scrapeless
- Войдите в панель управления Scrapeless (доступна бесплатная пробная версия)
- Затем нажмите «Setting» слева -> выберите «API Key Management» -> нажмите «Create API Key». Наконец, нажмите на созданный API-ключ, чтобы скопировать его.
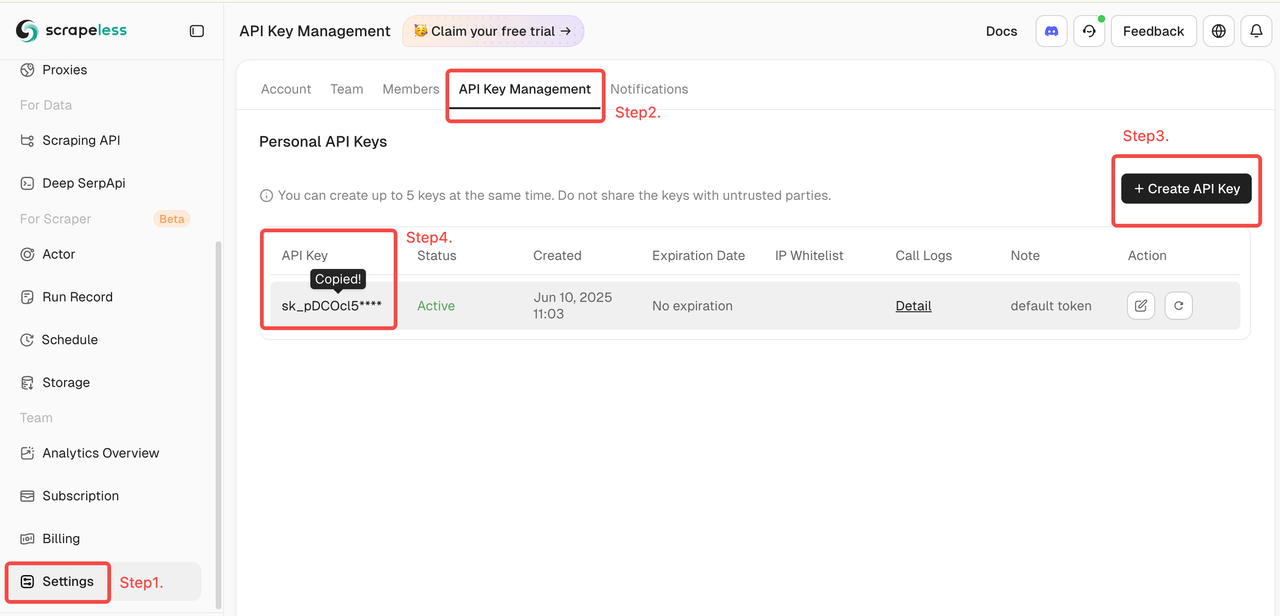
- Настройте ваш MCP-клиент
Scrapeless MCP Server поддерживает оба режима передачи: Stdio и Streamable HTTP.
🖥️ Stdio (локальное выполнение)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "command": "npx",
      "args": ["-y", "scrapeless-mcp-server"],
      "env": {
        "SCRAPELESS_API_KEY": "YOUR_SCRAPELESS_KEY"
      }
    }
  }
}
🌐 Streamable HTTP (режим хостинга API)
{
  "mcpServers": {
    "Scrapeless MCP Server": {
      "type": "streamable-http",
      "url": "https://api.scrapeless.com/mcp",
      "headers": {
        "x-api-token": "YOUR_SCRAPELESS_KEY"
      },
      "disabled": false,
      "alwaysAllow": []
    }
  }
}
Дополнительные параметры
Настройте поведение сессии браузера с помощью необязательных параметров. Их можно задать через переменные окружения (для Stdio) или HTTP-заголовки (для Streamable HTTP):
| Stdio (Env Var) | Streamable HTTP (HTTP Header) | Описание |
|---|---|---|
| BROWSER_PROFILE_ID | x-browser-profile-id | Указывает идентификатор переиспользуемого профиля браузера для непрерывности сессии. |
| BROWSER_PROFILE_PERSIST | x-browser-profile-persist | Включает постоянное хранение cookie, локального хранилища и т. д. |
| BROWSER_SESSION_TTL | x-browser-session-ttl | Определяет максимальный таймаут сессии в секундах. Сессия автоматически истечет после этого периода бездействия. |
Интеграция с Claude Desktop
- Откройте Claude Desktop
- Перейдите:
Settings→Tools→MCP Servers - Нажмите «Add MCP Server»
- Вставьте конфигурацию
StdioилиStreamable HTTPвыше - Сохраните и включите сервер
- Теперь Claude сможет выполнять веб-запросы, извлекать контент и взаимодействовать со страницами с помощью Scrapeless
Интеграция с Cursor IDE
- Откройте Cursor
- Нажмите
Cmd + Shift + Pи выполните поиск:Configure MCP Servers - Добавьте конфигурацию Scrapeless MCP, используя формат выше
- Сохраните файл и перезапустите Cursor (при необходимости)
- Теперь вы можете задавать Cursor такие вопросы, как:
"Search StackOverflow for a solution to this error""Scrape the HTML from this page"
- И он будет использовать Scrapeless в фоновом режиме.
Поддерживаемые MCP-инструменты
| Имя | Описание |
|---|---|
| google_search | Универсальная поисковая система информации. |
| google_trends | Получение данных о трендовых поисковых запросах из Google Trends. |
| browser_create | Создание или повторное использование облачной сессии браузера с помощью Scrapeless. |
| browser_close | Закрывает текущую сессию, отключая облачный браузер. |
| browser_goto | Переход браузера на указанный URL. |
| browser_go_back | Переход на один шаг назад в истории браузера. |
| browser_go_forward | Переход на один шаг вперед в истории браузера. |
| browser_click | Клик по конкретному элементу на странице. |
| browser_type | Ввод текста в указанное поле ввода. |
| browser_press_key | Имитация нажатия клавиши. |
| browser_wait_for | Ожидание появления конкретного элемента страницы. |
| browser_wait | Пауза выполнения на фиксированное время. |
| browser_screenshot | Создание скриншота текущей страницы. |
| browser_get_html | Получение полного HTML текущей страницы. |
| browser_get_text | Получение всего видимого текста с текущей страницы. |
| browser_scroll | Прокрутка вниз страницы. |
| browser_scroll_to | Прокрутка конкретного элемента в зону видимости. |
| scrape_html | Скрапинг URL и возврат его полного HTML-содержимого. |
| scrape_markdown | Скрапинг URL и возврат его содержимого в формате Markdown. |
| scrape_screenshot | Создание качественного скриншота любой веб-страницы. |
| crawl_start | Запуск асинхронной задачи crawl с базового URL и возврат её идентификатора. |
| crawl_cancel | Отмена выполняющейся задачи crawl по её идентификатору. |
| crawl_result | Опрос задачи crawl по её идентификатору до завершения и возврат собранных данных. |
| ai_scraper | Создание задачи AI Scraper для ChatGPT, Gemini, Perplexity, Copilot, Google AI Mode, Google AI Overview, Grok или Alexa. |
Рекомендации по безопасности
При использовании Scrapeless MCP Server с LLM (такими как ChatGPT, Claude или Cursor) крайне важно осторожно обращаться со всем скрапленным или извлеченным веб-контентом. Веб-данные по умолчанию не являются доверенными, и неправильная обработка может подвергнуть ваше приложение риску инъекций в промпты или другим уязвимостям безопасности.
✅ Рекомендуемые практики
- Никогда не передавайте сырой скрапленный контент напрямую в промпты LLM. Сырой HTML, JavaScript или пользовательский текст могут содержать скрытые инъекционные нагрузки.
- Очищайте и проверяйте весь извлеченный контент. Удаляйте или экранируйте потенциально опасные теги и скрипты перед использованием контента в дальнейшей логике или AI-моделях.
- Предпочитайте структурированное извлечение свободному тексту. Используйте такие инструменты, как
scrape_html,scrape_markdownили целевыеbrowser_get_textс известными безопасными селекторами, чтобы извлекать только тот контент, которому вы доверяете. - Применяйте белые списки доменов или селекторов при скрапинге динамически генерируемых страниц, чтобы ограничить поток данных известными и доверенными источниками.
- Ведите журнал и мониторьте все исходящие запросы, выполняемые через браузер или инструменты скрапинга, особенно если вы работаете с чувствительными данными, токенами или внутренним сетевым доступом.
🚫 Избегайте
- Внедрения скрапленного HTML напрямую в промпты
- Предоставления пользователям возможности указывать произвольные URL или CSS-селекторы без проверки
- Хранения нефильтрованного скрапленного контента для будущего использования в промптах
Сообщество
Свяжитесь с нами
По вопросам, предложениям или запросам о сотрудничестве, пожалуйста, свяжитесь с нами:
- Электронная почта: market@scrapeless.com
- Официальный сайт: https://www.scrapeless.com
- Форум сообщества: https://discord.gg/Np4CAHxB9a