tokensave
официальныйУвеличьте мощность вашего агента с помощью семантического анализа кода и сэкономьте 💰 в процессе!
Что можно делать с Tokensave MCP?
- Семантический поиск кода — Попросите ассистента найти код по смыслу, например, найти логику аутентификации в
login,validateTokenиAuthServiceодним запросом. - Анализ влияния перед изменениями — Проследите вызывающие и вызываемые функции, а также полный радиус влияния любого символа, чтобы точно знать, что сломается перед изменением.
- Сравнение кода между ветками — Сравните графы кода между двумя ветками, чтобы увидеть добавленные, удалённые или изменённые символы без переключения рабочей копии.
- Постоянная память сессии — Сохраняйте проектные решения и области кода с помощью
tokensave_record_decisionиtokensave_record_code_area, затем вызывайте их черезtokensave_session_recallв будущих сессиях. - Атомарные правки кода — Применяйте замены строк с уникальными якорями или вставляйте код в точные места без рисков, связанных с регулярными выражениями или экранированием в оболочке, с автоматическим переиндексированием после записи.
Документация
Семантический интеллект кода для ИИ-агентов программирования
Меньше токенов • Меньше вызовов инструментов • 100% локально




Зачем нужен tokensave?
ИИ-агенты программирования тратят токены впустую, исследуя кодовые базы. Каждый вызов grep, glob и чтение файла стоят денег. При выполнении сложных задач агенты порождают несколько субагентов Explore, которые сканируют сотни файлов только для того, чтобы построить контекст.
tokensave предоставляет агентам предварительно индексированный семантический граф знаний. Вместо сканирования файлов агент запрашивает граф и получает мгновенные структурированные ответы — нужные символы, их связи и исходный код за один вызов.
Как это работает
┌──────────────────────────────────────────────────────────────┐
│  AI Coding Agent (Claude Code, Codex, Gemini, Cursor, ...)   │
│                                                              │
│  "Implement user authentication"                             │
│        │                                                     │
│        ▼                                                     │
│  ┌─────────────────┐       ┌─────────────────┐               │
│  │  Sub-agent      │ ───── │  Sub-agent      │               │
│  └────────┬────────┘       └─────────┬───────┘               │
└───────────┼──────────────────────────┼───────────────────────┘
            │                          │
            ▼                          ▼
┌──────────────────────────────────────────────────────────────┐
│  tokensave MCP Server                                        │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐           │
│  │   Search    │  │   Callers   │  │   Context   │           │
│  │   "auth"    │  │  "login()"  │  │   for task  │           │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘           │
│         └────────────────┼────────────────┘                  │
│                          ▼                                   │
│              ┌───────────────────────┐                       │
│              │   libSQL Graph DB     │                       │
│              │   • Instant lookups   │                       │
│              │   • FTS5 search       │                       │
│              └───────────────────────┘                       │
└──────────────────────────────────────────────────────────────┘
Без tokensave: Агенты используют grep, glob и Read для сканирования файлов — множество вызовов API, высокий расход токенов.
С tokensave: Агенты запрашивают граф через MCP-инструменты — мгновенные результаты, локальная обработка, меньше токенов.
Ключевые возможности
| Умное построение контекста | Семантический поиск | Анализ влияния |
| Один вызов инструмента возвращает всё, что нужно агенту — точки входа, связанные символы и фрагменты кода. | Находите код по смыслу, а не только по тексту. Ищите «аутентификация» и находите login, validateToken, AuthService. | Точно знайте, что сломается до того, как вы это измените. Прослеживайте вызывающие, вызываемые функции и полный радиус влияния любого символа. |
| 80+ MCP-инструментов | 50+ языков | 12+ интеграций с агентами |
| От обхода графа вызовов до обнаружения мёртвого кода, примитивов атомарного редактирования, метрик здоровья кода, сопоставления тестов и анализа сложности. | Rust, Go, Java, Python, TypeScript, C, C++, Swift, Svelte, Astro и ещё 43, включая шейдеры WGSL/HLSL/Metal, CUDA/HIP и Markdown. Три уровня (lite/medium/full) управляют размером бинарного файла. | Claude Code, Codex CLI, Gemini CLI, Qwen Code, Kiro, Cursor, OpenCode, Copilot, Cline, Roo Code, Zed, Antigravity, Kilo CLI, Kimi CLI, Mistral Vibe, Grok Build, Factory Droid, OMP, Pi, Plank. |
| Многоветочная индексация (по желанию) | 100% локально | Всегда актуально |
| Опциональные базы данных для каждой ветки. Сравнение и поиск между ветками без переключения рабочей копии. | Никакие данные не покидают вашу машину. Никаких ключей API. Никаких внешних сервисов. Всё работает на локальной базе данных libSQL. | Проверка устаревания по требованию при каждом MCP-вызове (задержка 30 с) плюс синхронизация догоняющего типа при подключении сервера. Многоагентная работа предполагает использование git worktrees — каждый агент получает свою рабочую копию, а расхождения индексов объединяются через git, а не через файловый наблюдатель. |
| Изоляция извлечения в подпроцессах | Аналитика здоровья кода | Примитивы атомарного редактирования |
| Нативный сбой в любой грамматике tree-sitter (abort, segfault и т.п.) убивает только рабочий процесс; пул перезапускает его, и синхронизация продолжается. Синхронизация никогда не умирает из-за повреждённого файла. | Композитный показатель здоровья (0–10000), коэффициент Джини, глубина файлового DAG, матрица структуры дизайна, взвешенные по риску пробелы в тестах и дельты сессий. | Редактируйте файлы без рисков regex или экранирования в shell: уникальный якорь str_replace, атомарная множественная замена, переписывание AST, вставка с якорем. Автоматическая переиндексация после записи. |
Быстрый старт
1. Установка
Homebrew (macOS):
brew install aovestdipaperino/tap/tokensave
Scoop (Windows):
scoop bucket add tokensave https://github.com/aovestdipaperino/scoop-bucket
scoop install tokensave
Cargo / cargo-binstall (любая платформа):
# Fast install prebuilt binary without compiling:
cargo binstall tokensave

# Or compile from source:
cargo install tokensave                          # full (50+ languages, default)
cargo install tokensave --features medium        # medium tier
cargo install tokensave --no-default-features    # lite (smallest binary)
Готовые бинарные файлы (Linux, Windows, macOS):
Скачайте с последнего релиза и поместите бинарный файл в ваш PATH.
| Платформа | Архив |
|---|---|
| macOS (Apple Silicon) | tokensave-vX.Y.Z-aarch64-macos.tar.gz |
| Linux (x86_64) | tokensave-vX.Y.Z-x86_64-linux.tar.gz |
| Linux (ARM64) | tokensave-vX.Y.Z-aarch64-linux.tar.gz |
| Windows (x86_64) | tokensave-vX.Y.Z-x86_64-windows.zip |
2. Настройте своего агента
tokensave install                         # auto-detects installed agents
tokensave install --agent antigravity     # Google Antigravity (formerly Windsurf)
tokensave install --agent auggie          # AugmentCode
tokensave install --agent claude          # Claude Code
tokensave install --agent cline           # Cline
tokensave install --agent codex           # OpenAI Codex CLI
tokensave install --agent copilot         # GitHub Copilot
tokensave install --agent cursor          # Cursor
tokensave install --agent droid           # Factory Droid
tokensave install --agent gemini          # Gemini CLI
tokensave install --agent kilo            # Kilo CLI
tokensave install --agent kiro            # AWS Kiro
tokensave install --agent kimi            # Moonshot Kimi CLI
tokensave install --agent omp             # Oh My Pi (OMP)
tokensave install --agent opencode        # OpenCode
tokensave install --agent pi              # Pi (pi.dev)
tokensave install --agent plank           # Plank (macOS only)
tokensave install --agent qwen            # Qwen Code
tokensave install --agent roo-code        # Roo Code
tokensave install --agent vibe            # Mistral Vibe
tokensave install --agent zed             # Zed
tokensave install --agent grok            # Grok Build (xAI)
tokensave install --git-hook yes           # auto-install the global post-commit and post-checkout hooks (no prompt)
tokensave install --git-hook no            # skip the post-commit and post-checkout hooks (no prompt)
tokensave githooks                         # show which global git hooks tokensave owns
tokensave githooks off                     # remove them, leaving any hook content you wrote
Каждый агент получает свой MCP-сервер, зарегистрированный в нативном формате конфигурации. Claude Code дополнительно получает хук PreToolUse (блокирует расточительные Explore-агенты), хук UserPromptSubmit, хук Stop, правила подсказок в CLAUDE.md и автоматически разрешённые разрешения инструментов. Kiro получает глобальную MCP-конфигурацию, управление tokensave.md загружается как ресурс, а также управляемый tokensave агент по умолчанию с разрешительным встроенным/токенсейв-одобрением инструментов, хуками защиты делегирования и пост-записной синхронизацией; управляемые пользователем агенты Kiro сохраняются.
Глобальные установки OMP нацелены на профиль, сообщаемый голым omp config path, записывая <resolved-agent-dir>/mcp.json и <resolved-agent-dir>/rules/tokensave.md. Экспортируйте OMP_PROFILE или совместимый PI_PROFILE от OMP при установке в именованный профиль; резолвер OMP также учитывает PI_CONFIG_DIR и PI_CODING_AGENT_DIR. Tokensave доверяет нативному резолверу, а не дублирует логику профилей OMP. Tokensave устанавливает MCP и рекомендательные правила для OMP; он не устанавливает принудительное применение хуков OMP.
Все изменения идемпотентны — безопасно запускать снова после обновления. После настройки агента вам будет предложено установить глобальные git-хуки post-commit и post-checkout. tokensave uninstall удаляет эти хуки вместе с интеграциями агентов; передайте --keep-git-hooks, чтобы оставить их, или управляйте ими отдельно с помощью tokensave githooks.
Установка для нескольких агентов одновременно
Повторите --agent, чтобы установить несколько агентов за один запуск. Предоставление разрешений, предложение git-хуков и запись глобальной конфигурации выполняются по одному разу, независимо от того, сколько агентов вы перечислите:
tokensave install --agent claude --agent cursor --agent droid
Локальная установка для проекта
По умолчанию tokensave install регистрирует MCP-сервер в вашей глобальной конфигурации агента (например, ~/.claude.json). Чтобы зарегистрировать tokensave только для текущего проекта, добавьте --local:
tokensave install --local --agent claude
tokensave install --local --agent omp
Это записывает конфигурацию в рамках проекта, которую можно закоммитить и поделиться с командой. Для Claude это ./.mcp.json, ./.claude/settings.json и ./CLAUDE.md; OMP использует ./.omp/mcp.json и ./.omp/rules/tokensave.md без вызова CLI OMP. Поддерживаемые агенты: claude, cursor, droid, gemini, zed, opencode, roo-code, kiro, auggie, omp, plank (каждый записывает свой файл проекта, например .cursor/mcp.json, .factory/mcp.json, .gemini/settings.json, .zed/settings.json, opencode.json, .roo/mcp.json, .kiro/settings/mcp.json, .augment/settings.json, .omp/mcp.json, .mcp.json для plank). У других агентов нет конфигурации в рамках проекта, и они сообщают об ошибке с --local.
Удалите локальную установку проекта с помощью tokensave uninstall --local.
3. Индексируйте свой проект
cd /path/to/your/project
tokensave init
Это создаёт каталог .tokensave/ с базой данных графа знаний. Инициализация и синхронизация — отдельные команды: init — разовое согласие для каждого проекта, а sync обновляет только те проекты, которые уже были инициализированы. Это предотвращает создание глобальными git-хуками баз данных в репозиториях, которые вы не собирались индексировать. После init используйте tokensave sync для инкрементального обновления — переиндексируются только изменённые файлы.
Что установка записывает для Claude Code
MCP-сервер
{
  "mcpServers": {
    "tokensave": {
      "command": "/path/to/tokensave",
      "args": ["serve"]
    }
  }
}
Хук PreToolUse
Хук запускает tokensave hook-pre-tool-use — нативную Rust-команду (без bash или jq). Он перехватывает вызовы инструментов Agent, Grep, Glob и Bash: Explore-агенты блокируются напрямую, вызовы grep/rg/ag в форме символов (простые идентификаторы, альтернации, имена в \b) перенаправляются на соответствующий MCP-инструмент tokensave, а поиск в форме путей (Glob, find -name, fd --extension) по расширениям кода перенаправляется на tokensave_files. Regex-паттерны, git grep, конвейерные команды, не-кодовые расширения, корни поиска вне индекса и предикаты find, которые меняют поведение команды (-exec, -delete, -mtime), проходят без изменений; установите TOKENSAVE_DISABLE_GREP_HOOK=1, чтобы отказаться для конкретной оболочки.
Фильтры читаются от наиболее специфичного к наименее: явный type является авторитетным, затем явный файловый glob, затем путь поиска. Поиск документации, такой как path: "." с glob: "**/*.md", поэтому проходит насквозь, а не обрабатывается как поиск кода по широкому пути, тогда как glob только для кода (**/*.rs) всё равно перенаправляется даже под не-кодовым путём. Смешанные glob (**/*.{rs,md}) проходят насквозь, так как могут возвращать документацию.
Безголовый / субагентный диспетчер (claude -p). Дочерние процессы, запускаемые оркестрирующей сессией, наследуют её ~/.claude/settings.json, включая этот хук. Чтобы позволить дочернему процессу выполнять необработанные поиски, установите TOKENSAVE_DISABLE_GREP_HOOK=1 в окружении дочернего процесса — нативный бинарный файл учитывает его и пропускает все пути (Grep, Glob, Bash, Agent), так что нет необходимости в грубом --settings '{"hooks": {}}', который снимает все хуки. Защита не имеет состояния: она никогда не обращается к истории цитирования, поэтому перенаправляет только поиски в форме символов, описанные выше, и направляет нетипизированный исследовательский фан-аут; обычные команды не затрагиваются, независимо от того, интерактивна сессия или безголовая.
Правила CLAUDE.md
Добавляет инструкции в ~/.claude/CLAUDE.md, которые говорят Claude использовать инструменты tokensave перед обращением к Explore-агентам или необработанным чтениям файлов.
Устойчивая к сбоям синхронизация
Грамматики tree-sitter — это скомпилированный код на C/C++. Они иногда натыкаются на внутренние утверждения или иным образом завершают процесс путями, которые обработка паник Rust не может перехватить. Начиная с v4.3.0, каждый файл анализируется внутри короткоживущего рабочего подпроцесса: если грамматика вызывает segfault, вызывает abort() или сталкивается с переполнением стека, умирает только рабочий процесс. Пул перезапускает его, проблемный файл логируется и пропускается, а sync продолжает работу.
Рабочий процесс — это скрытая подкоманда extract-worker, аутентифицированная против родителя через 256-битный токен на каждый запуск, требуемый как переменная окружения TOKENSAVE_WORKER_TOKEN, так и как первые 32 байта, полученные на stdin. Прямой вызов пользователями не удаётся. По умолчанию используется available_parallelism() рабочих процессов; откажитесь с помощью TOKENSAVE_DISABLE_SUBPROCESS=1.
Примитивы редактирования (tokensave_str_replace, tokensave_insert_at и т.д.) по-прежнему работают в процессе: они нацелены на один файл за раз, где накладные расходы подпроцесса были бы доминирующими, а сбой экстрактора там немедленно виден агенту.
Многоветочная индексация (опционально)
tokensave может опционально поддерживать отдельный граф кода для каждой git-ветки. При включении переключение веток никогда не даёт устаревших результатов и не переиндексирует файлы, которые вы уже анализировали на другой ветке. Многоветочное отслеживание — по желанию: без него tokensave использует одну базу данных для всех веток.
Как это работает
Когда вы отслеживаете ветку, tokensave копирует ближайшую родительскую БД и синхронизирует только файлы, которые отличаются. Это означает, что отслеживание фиче-ветки от main почти мгновенно — анализируются только изменённые вами файлы.
CLI-команды
tokensave branch add              # track the current branch
tokensave branch list             # see tracked branches and DB sizes
tokensave branch remove <name>    # stop tracking a branch
tokensave branch removeall        # remove all tracked branches except default
tokensave branch gc               # clean up branches deleted from git
Межветочные MCP-инструменты
Три MCP-инструмента обеспечивают межветочные запросы без переключения рабочей копии:
tokensave_branch_search— поиск символов в графе другой веткиtokensave_branch_diff— сравнение графов кода между двумя ветками: добавленные, удалённые и изменённые символы (отличается сигнатура). Поддерживает фильтры по файлам и типам.tokensave_branch_list— список отслеживаемых веток с размерами БД, родительской веткой и временем синхронизации
Откат ветки
Когда MCP-сервер не может найти базу данных для текущей ветки, он обслуживает из БД ближайшей родительской ветки и включает предупреждение в каждый ответ инструмента, предлагая запустить tokensave branch add.
Автоматическое отслеживание веток (v7.3.0)
Once multi-branch mode is bootstrapped (a first manual tokensave branch add created the branch metadata), new branches can be tracked automatically instead of falling back to the ancestor DB. Two independent mechanisms cover this; projects in single-DB mode are never affected, and neither mechanism ever touches the default branch's database.
Git hook (on branch checkout). The post-checkout hook that tokensave install sets up recognizes a branch checkout (as opposed to a file checkout) and runs tokensave branch add in the background. That command is a no-op when the branch is already tracked or is the default branch, so ordinary switching between known branches costs nothing. The initial checkout of a fresh git clone and of a new git worktree add is a branch checkout too, and it can land on a branch that is not the default one (git clone -b feature, git worktree add -b feature); there the hook runs tokensave init first and tokensave branch add after it, in that order. A hook written by an earlier version keeps the body it was installed with — the installer never rewrites an existing one — so on those installs a fresh worktree still needs auto_track below, or a manual tokensave branch add.
Open-time auto-track (opt-in). When TokenSave::open runs — CLI command or MCP server start — and the active branch is untracked, tokensave can track it on the spot by copying the nearest tracked ancestor's DB and recording it in the branch metadata. This is gated by the auto_track config field (default false) or the TOKENSAVE_AUTO_TRACK environment variable, which overrides the config per-run (any value enables it except 0, false, no, off, or empty). The copy is the same near-instant ancestor-DB copy a manual branch add performs; no sync runs at that moment — the post-commit hook keeps the new branch DB fresh as you commit, or run tokensave sync to refresh immediately. Auto-tracking is strictly best-effort: any failure is reported as a warning and open() proceeds with the usual ancestor fallback, so it can never break a tool call.
In short: with the hook installed, checking out a new feature branch — including the branch a fresh clone or worktree starts on — transparently gives it its own per-branch graph; with auto_track enabled, even a branch created outside a checkout is picked up the first time tokensave opens the project on it.
See docs/BRANCHING-USER-GUIDE.md for the full guide.
Cross-Session Memory
Three MCP tools persist decisions and code-area context across sessions, stored in the per-project .tokensave/tokensave.db.
| Tool | Purpose |
|---|---|
tokensave_record_decision | Save a design/architecture decision with optional reason, files, and tags |
tokensave_record_code_area | Mark a path the agent has worked in (touch counter + last_touched_at) |
tokensave_session_recall | FTS5 query over saved decisions; pair with the two write tools |
Use these so the agent doesn't have to re-explain architecture choices session-to-session.
Savings Ledger
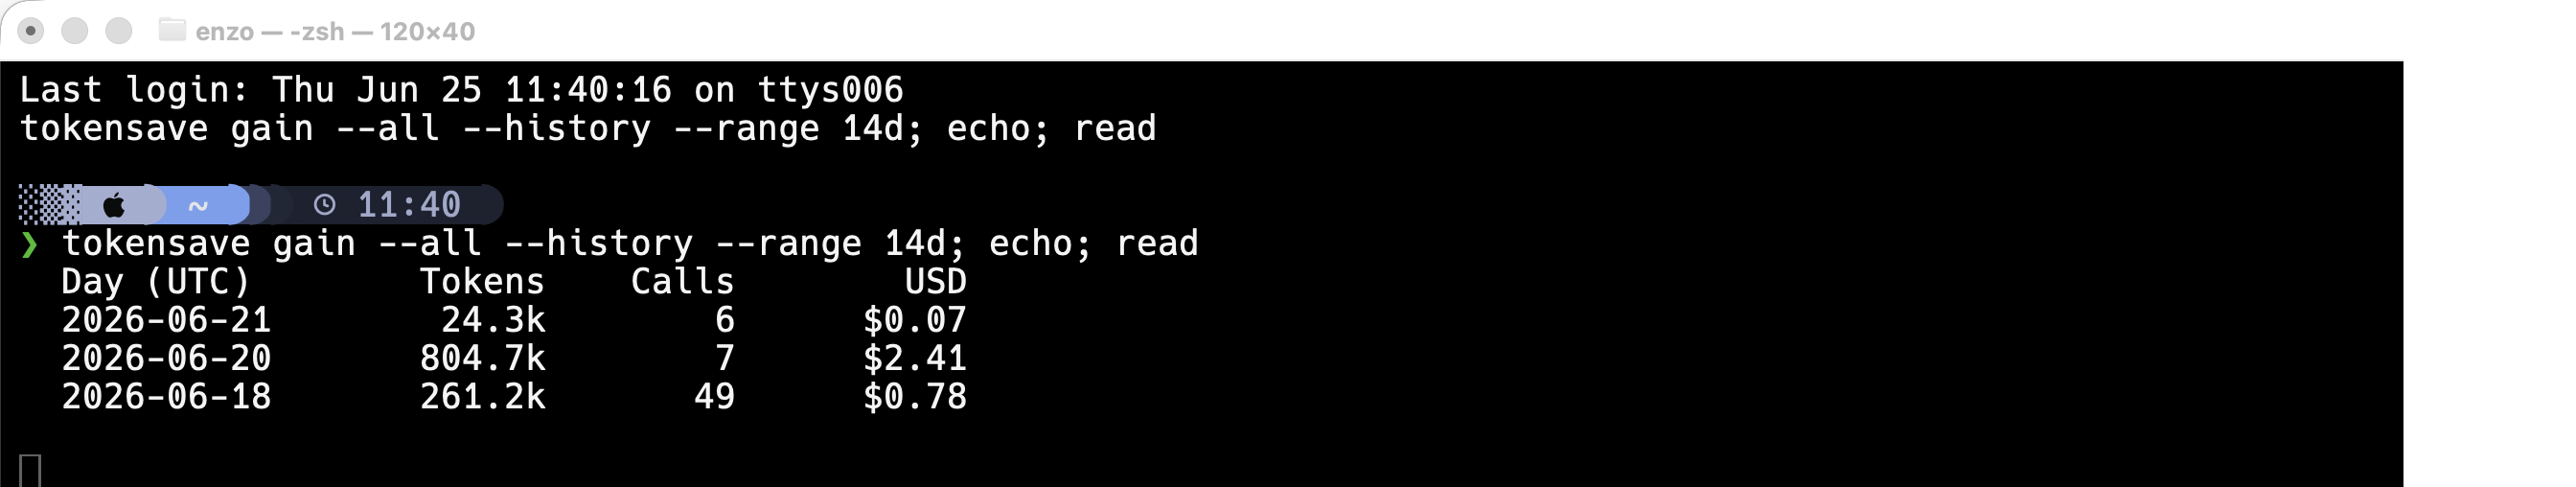
Every MCP call writes an append-only row to ~/.tokensave/global.db (savings_ledger table). Inspect with tokensave gain:
tokensave gain                    # current project, last 30 days
tokensave gain --all              # all projects
tokensave gain --history --range 7d
tokensave gain --json
Dollar estimates use the existing pricing module (Sonnet input pricing, refreshed daily via LiteLLM).
Reproducible Benchmark
tokensave bench runs a fixed query set through tokensave_context and reports retrieval savings vs a full-file baseline (mirrors the CCE methodology):
tokensave bench                                    # ships with 10 default queries
tokensave bench --queries my-queries.toml --json
tokensave bench --max-nodes 5
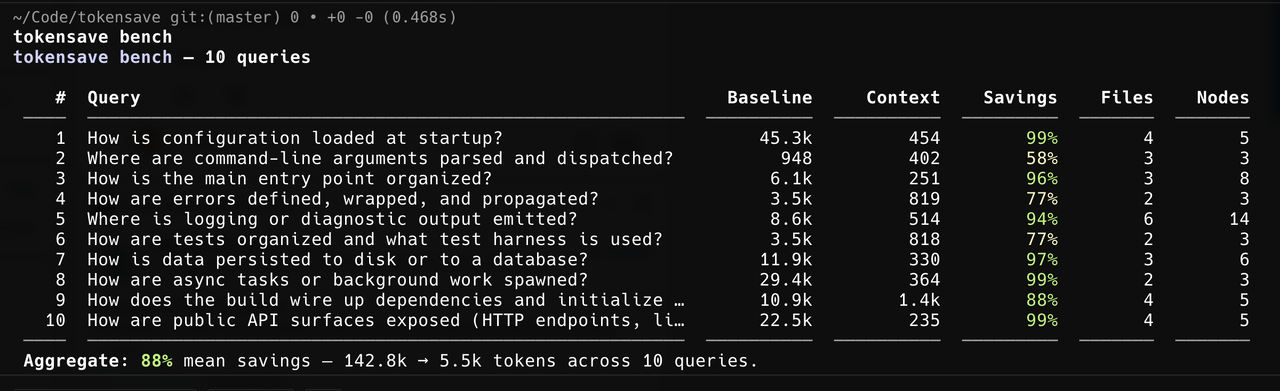
Measured against this repo (tokensave itself) using the shipped generic query set:
| # | Query | Baseline | Context | Savings | Files | Nodes |
|---|---|---|---|---|---|---|
| 1 | How is configuration loaded at startup? | 45.3k | 454 | 99% | 4 | 5 |
| 2 | Where are command-line arguments parsed and dispatched? | 948 | 402 | 58% | 3 | 3 |
| 3 | How is the main entry point organized? | 6.1k | 251 | 96% | 3 | 8 |
| 4 | How are errors defined, wrapped, and propagated? | 3.5k | 819 | 77% | 2 | 3 |
| 5 | Where is logging or diagnostic output emitted? | 8.6k | 514 | 94% | 6 | 14 |
| 6 | How are tests organized and what test harness is used? | 3.5k | 818 | 77% | 2 | 3 |
| 7 | How is data persisted to disk or to a database? | 11.9k | 330 | 97% | 3 | 6 |
| 8 | How are async tasks or background work spawned? | 29.4k | 364 | 99% | 2 | 3 |
| 9 | How does the build wire up dependencies and initialize state? | 10.9k | 1.4k | 88% | 4 | 5 |
| 10 | How are public API surfaces exposed (HTTP endpoints, library exports, or CLI commands)? | 22.5k | 235 | 99% | 4 | 5 |
Aggregate: 88% mean retrieval savings (142.8k → 5.5k tokens across 10 queries).
The default query set targets patterns present in most application codebases (CLIs, daemons, services). Run it on your own project with tokensave bench to see your numbers, or write a tailored query file (--queries my.toml) for tighter recall.
Criterion bench against large real-world repos
benches/large_repos.rs is a criterion micro-benchmark that exercises the MCP tools end-to-end against four large open-source codebases pinned at constant refs. Each tool is driven by at least 5 queries with arguments (node ids, qualified names, file globs, …) sampled from the indexed graph once per repo, so timings are reproducible across runs.
Repos and pinned refs (defined in benches/repos.rs):
| Repo | URL | Ref |
|---|---|---|
| polkadot-sdk | https://github.com/paritytech/polkadot-sdk | polkadot-stable2412 |
| emacs | https://github.com/emacs-mirror/emacs | emacs-30.1 |
| scipy | https://github.com/scipy/scipy | v1.14.1 |
| node | https://github.com/nodejs/node | v22.11.0 |
Each repo is shallow-cloned (git init + git fetch --progress --depth 1 origin <ref> + checkout FETCH_HEAD) on first use and cached locally; subsequent runs reuse the checkout. Git output is streamed to the terminal so the multi-GB fetch shows real-time progress.
Tools covered (5 queries each). Read tools — search, context, callers, callees, node, by_qualified_name, signature, impact, body, files, complexity, doc_coverage, largest, hotspots, god_class, module_api, derives, dead_code, rank, coupling, circular. Write tools — str_replace, multi_str_replace, insert_at, and (if ast-grep is on PATH) ast_grep_rewrite.
Force-sync on every run. Before any benchmark fires, the harness runs the equivalent of tokensave sync --force on each repo (index_all() regardless of .tokensave/ freshness) so timings always reflect the pinned source.
Write benches and cleanup. Write tools mutate files. To keep the "match must be unique" precondition holding, the harness uses criterion's iter_batched — a small scratch file under <repo>/.tokensave-bench-scratch/ is rewritten with known content before every timed iteration, then the edit tool runs against it. After all benchmarks finish, the harness runs git stash --include-untracked && git stash drop inside every prepared repo so the working tree returns to the pinned ref.
Criterion configuration. The bench overrides criterion's defaults to sample_size = 10 and measurement_time = 30s (vs the stock 100 / 5s), which gives each per-query timing ~30 seconds of measurement — enough that slow tools like tokensave_context on polkadot-sdk produce stable numbers.
Run it:
# Required: a writable cache directory for the cloned repos + their indexes.

<p align="center">
  <a href="https://ai.enzolombardi.net/"><img src="https://img.shields.io/badge/built%20with-AI-D97757?style=flat-square&labelColor=101010&logo=anthropic&logoColor=white" alt="Built with AI — part of Enzo Lombardi's AI portfolio"></a>
</p>

# Expect several GB of disk and a long first run (shallow clone + full index of each repo).
export TOKENSAVE_BENCH_REPOS_DIR=~/tokensave-bench-cache

cargo bench --bench large_repos
If TOKENSAVE_BENCH_REPOS_DIR is unset the bench prints a notice and registers zero benchmarks (so cargo bench --all stays cheap on contributors' machines).
Configuration (all optional, via environment):
| Variable | Effect |
|---|---|
TOKENSAVE_BENCH_REPOS_DIR | Required. Root directory where each repo is cloned to $DIR/<repo-name>/. |
TOKENSAVE_BENCH_REPOS | Comma-separated subset of repo names to bench, e.g. TOKENSAVE_BENCH_REPOS=emacs,scipy. Defaults to all four. |
TOKENSAVE_BENCH_SKIP_CLONE | If set, the bench fails fast for any repo not already at its pinned ref instead of fetching. Useful in CI / offline runs. |
Filtering benchmarks uses the standard criterion CLI — for example, only the search tool on scipy:
cargo bench --bench large_repos -- 'scipy/tokensave_search'
Reports (HTML + raw samples) land under target/criterion/.
To change the pinned refs (e.g. to a newer release or a specific SHA), edit REPOS in benches/repos.rs and delete the corresponding $TOKENSAVE_BENCH_REPOS_DIR/<repo>/.bench-ref marker so the next run re-fetches. If you skip the post-run cleanup (e.g. you Ctrl-C mid-bench), running git stash --include-untracked && git stash drop inside each repo dir restores it manually.
MCP test-matrix probe (scripts/mcp_probe)
scripts/mcp_probe/ is a Python harness that drives tokensave serve over stdio against a configurable set of real repos and exercises every read-only MCP tool with 5 query variants per language, producing a per-tool / per-repo status table. Same harness serves two purposes:
- Regression sweep. New language support, new tool, or a refactor — re-run the matrix and any cell that newly errors, times out, or returns empty results stands out as a 🚩.
- Perf probe. Per-call timings are logged in TSV; the same fixed corpus of repos doubles as a coarse cross-version comparison. The current
tokensave_inheritance_depthcycle bug was found by this harness when a single tool on polkadot-sdk timed out at >60 s.
Layout — probe.py is the driver (id-matched JSON-RPC so a slow tool can't poison subsequent calls), isolated.py re-runs a single tool with a fresh server per call (escapes server queueing), build_matrix.py reads the TSV and emits markdown, tools/<lang>.py modules contribute per-language query sets (Rust shipped; add Python/Go/… by dropping a new module), repos.toml lists target repos (override via $TOKENSAVE_PROBE_REPOS).
Quick run:
cargo build --release --bin tokensave
python3 scripts/mcp_probe/probe.py
python3 scripts/mcp_probe/build_matrix.py > matrix.md
Output cells are ✓ 5/5 (clean), 🐛 e/N (errors), ⏱ N/N (timeouts), ∅ E/N (empty), 🐢 ok/slow (>10 s calls). Any cell carrying an error or timeout earns a 🚩 in the rightmost column. Per-call detail with the first 100 chars of each error landS in the TSV log for follow-up.
Different from the criterion bench above: criterion measures per-iteration latency for a focused tool set on pinned refs and produces statistical reports under target/criterion/; mcp_probe exercises every tool with a broader query set on whatever repos you point it at, optimising for breadth of coverage rather than measurement precision.
80+ MCP Tools
The server exposes more than 80 tools (one fewer when the optional ast-grep binary is not on PATH). Since 7.14.0 only the 11 core tools plus tokensave_more are listed by default; the rest are listed on demand through tokensave_more, stay callable by name, and are all listed with "tools": "full". The tables below group the most commonly used ones by category. Most are read-only, safe to call in parallel, and annotated with readOnlyHint. The edit primitives are scoped to single files and re-index in place; session baseline and memory-recording tools also mutate local .tokensave state and are annotated as non-read-only. The three core tools (tokensave_context, tokensave_search, tokensave_status) are marked anthropic/alwaysLoad so they bypass the client's tool-search round-trip.
Query another initialized project
Semantic read tools can query an explicitly selected local graph without restarting the MCP server:
{
  "query": "screenGate",
  "graph_root": "/absolute/path/to/typewhisper"
}
Selected results include canonical root/branch provenance. Node IDs are namespaced to that graph, and the matching selectors must be repeated on follow-up calls. For example, a follow-up to a branch-selected query includes both values:
{
  "node_id": "graph:<fingerprint>:function:<raw-id>",
  "graph_root": "/absolute/path/to/typewhisper",
  "graph_branch": "feature/auth"
}
graph_root должен быть точным абсолютным корнем уже инициализированного проекта.
graph_branch необязателен и, если указан, должен называть отслеживаемую ветку.
Выбранные открытия доступны только для чтения: они никогда не инициализируют, не синхронизируют, не мигрируют, не отслеживают автоматически
и не записывают данные графа или исходников. Они также не учитываются в экономии.
Вызовы без селекторов ведут себя точно так же, как раньше.
graph_root полезен только в том случае, если вы знаете, что другой проект существует, поэтому сервер
сообщает вам: инициализированные проекты, расположенные непосредственно рядом с обслуживаемым корнем,
называются в MCP instructions, в tokensave_status и в пустых
результатах tokensave_search / tokensave_context — в тот момент, когда сессия
в противном случае заключила бы, что символ не существует, а не посмотрела бы по соседству
(#375). Предлагаются только непосредственные соседи, не более пяти, и ничего не открывается
и не индексируется от их имени; запрос к одному из них по-прежнему требует явного graph_root.
Селекторы намеренно недоступны для инструментов, которые пишут, выполняют внешние команды или
зависят от текущего чекаута: примитивы редактирования, инструменты VCS и веток,
диагностика и выполнение тестов, интроспекция зависимостей и рантайма, рабочие процессы
и инструменты памяти сессий, инструмент постоянного кэша (tokensave_redundancy),
и администрирование сервера. Эти инструменты отклоняют селектор вместо того, чтобы молча
игнорировать его.
Обнаружение
| Инструмент | Назначение |
|---|---|
tokensave_context | Получить релевантный контекст кода для задачи — точки входа, связанные символы, фрагменты кода |
tokensave_search | Найти символы по имени (функции, классы, типы) |
tokensave_node | Получить детали + исходный код для конкретного символа |
tokensave_files | Список индексированных файлов проекта (исходники и отслеживаемые артефакты) с фильтрацией |
tokensave_module_api | Публичная поверхность API файла или каталога |
tokensave_similar | Найти символы с похожими именами |
tokensave_annotations | Интроспекция атрибутов/аннотаций/декораторов — гистограмма всех аннотаций или поситовые списки с фильтрами целей |
tokensave_doc | Сопутствующая документация Markdown для исходного файла — содержимое документа, файлы, которые он покрывает, и сигнал устаревания |
tokensave_dependencies | Интроспекция манифестов пакетов в 17 экосистемах — сводка по рабочему пространству, поиск по пакетам, поверхность лицензий, расхождение версий |
tokensave_status | Статус индекса, статистика, сохраненные токены |
Не-кодовые артефакты
tokensave_files охватывает больше, чем исходники. Файлы, расширение которых указано в
artifact_extensions (.feature, .json, .yaml, .yml, .sql, .toml,
.proto, .graphql, .md, .bnd, .bndrun по умолчанию) отслеживаются по пути,
так что вопросы вроде «где находятся файлы .feature для потока входа?» имеют
ответ в графе, а не заблокированный find (#323). Они никогда не парсятся и не вносят символов;
kind: "artifact" и kind: "code" фильтруют между двумя, а анализы, которые
означают «код», исключают их. Расширение, уже обрабатываемое языковым экстрактором,
игнорируется в этом списке, поэтому его нельзя использовать для остановки парсинга языка.
Список также определяет, внутрь чего может заглядывать буквальный поиск (#442). Буквальный
поиск (literal: true) по tokensave_search читает байты, а не
символы, поэтому ему не нужен парсер — но он перебирает индексированные файлы, поэтому он
может достичь только файла, для которого в индексе есть строка. Отслеживаемый документ .rst или
шаблон .tmpl не имеет ни экстрактора, ни записи артефакта по умолчанию, поэтому его
совпадения отсутствуют; добавьте расширение здесь и запустите tokensave sync -f, и его
строки будут искаться как любые другие, с отчетом через enclosing: null, поскольку
нет контекста символа. Буквальный ответ, который не смог достичь каждого отслеживаемого
файла, сообщает об этом в блоке unscanned, указывая количество и расширения, так что
частичный ответ никогда не выдается за полный.
Граф вызовов и влияние
| Инструмент | Назначение |
|---|---|
tokensave_callers | Найти, что вызывает функцию |
tokensave_callees | Найти, что вызывает функция |
tokensave_impact | Посмотреть, на что повлияет изменение символа |
tokensave_affected | Найти тестовые файлы, затронутые изменениями исходников |
tokensave_rename | Переименование на основе графа: каждый сайт с классом уверенности (exact, heuristic, ambiguous, text_only), предпросмотр diff и применение «все или ничего». Не учитывает привязки |
tokensave_hotspots | Наиболее связанные символы (наибольшее количество вызовов) |
Качество кода
| Инструмент | Назначение |
|---|---|
tokensave_complexity | Ранжировать функции по цикломатической и когнитивной сложности, глубине вложенности, метрикам Холстеда, индексу поддерживаемости, CRAP и метрикам безопасности |
tokensave_dead_code | Найти недостижимые символы (нет входящих ребер; символы, названные как кандидаты на неоднозначность, исключаются) |
tokensave_ambiguous_calls | Сайты вызовов, которые резолвер не смог привязать к одной цели, со всеми связанными кандидатами |
tokensave_god_class | Найти классы со слишком большим количеством членов |
tokensave_coupling | Ранжировать файлы по fan-in/fan-out |
tokensave_inheritance_depth | Найти самые глубокие иерархии наследования |
tokensave_circular | Обнаружить циклические зависимости файлов |
tokensave_imports | Зависимости импорта на уровне модулей, циклы и симуляция разреза |
tokensave_recursion | Обнаружить рекурсивные/взаимно-рекурсивные циклы вызовов |
tokensave_unused_imports | Операторы импорта, на которые никогда не ссылаются |
tokensave_doc_coverage | Публичные символы без документации |
tokensave_simplify_scan | Анализ качества измененных файлов (дублирования, мертвый код, сложность) |
Аналитика здоровья кода
Пять инструментов выявляют сигналы структурного качества из существующего графа. Составной балл использует геометрическое среднее по независимым измерениям, так что ни одно из них нельзя «накрутить».
| Инструмент | Назначение |
|---|---|
tokensave_health | Составной сигнал качества (0-10000) из ацикличности, глубины, равенства, избыточности и модульности |
tokensave_gini | Коэффициент неравенства Джини для любой метрики (сложность, строки, fan-in/out, члены) — находит god-файлы и неравномерное распределение |
tokensave_dependency_depth | Самые длинные цепочки зависимостей на уровне файлов (левелизация Лакоша) с полной реконструкцией цепочек после разрыва циклов Тарьяна (SCC) |
tokensave_dsm | Матрица структуры дизайна в форме stats, clusters или matrix — выявляет нарушения слоев и скрытую связанность |
tokensave_test_risk | Анализ рискового тестового разрыва, объединяющий сложность, fan-in, покрытие и 90-дневный git churn в единый балл |
Сессии
Снимайте метрики здоровья в начале сессии AI-кодинга, затем сравнивайте в конце, чтобы увидеть, что улучшилось или ухудшилось.
| Инструмент | Назначение |
|---|---|
tokensave_session_start | Сохранить текущие метрики здоровья как JSON-базовую линию для последующего сравнения |
tokensave_session_end | Пересчитать и сравнить с базовой линией — дельты по измерениям, пройдено/не пройдено, автоматическая очистка |
Примитивы редактирования
Четыре инструмента записи, позволяющие агентам изменять файлы без опасностей regex или кавычек оболочки. Каждый работает с одним файлом, привязан к якорю и запускает повторную индексацию на месте после записи, чтобы граф никогда не устаревал.
| Инструмент | Назначение |
|---|---|
tokensave_str_replace | Заменить уникальный old_str на new_str; ошибка, если 0 или >1 совпадений (защита от ошибок множественного редактирования) |
tokensave_multi_str_replace | Применить N замен (old, new) атомарно — транзакция «все или ничего» |
tokensave_insert_at | Вставить содержимое до или после уникальной якорной строки или номера строки |
tokensave_ast_grep_rewrite | Структурное переписывание кода через CLI ast-grep в режиме --rewrite |
Git и рабочий процесс
| Инструмент | Назначение |
|---|---|
tokensave_diff_context | Семантический контекст для измененных файлов — измененные символы, зависимости, затронутые тесты |
tokensave_commit_context | Семантическая сводка незакоммиченных изменений для составления сообщения коммита |
tokensave_pr_context | Семантический diff между git-ссылками для описаний pull request |
tokensave_changelog | Семантический diff между двумя git-ссылками |
tokensave_test_map | Сопоставление исходников и тестов на уровне символов с обнаружением непокрытых символов |
tokensave_test_coverage | Сводка покрытия по файлам/символам/тестовым функциям с транзитивным расширением ребер вызовов |
Система типов
| Инструмент | Назначение |
|---|---|
tokensave_type_hierarchy | Рекурсивное дерево иерархии типов для трейтов, интерфейсов и классов |
tokensave_rank | Ранжировать узлы по количеству связей (самый реализованный интерфейс, самый расширенный класс) |
tokensave_distribution | Разбивка по типам узлов для файла или каталога |
tokensave_largest | Ранжировать узлы по размеру — самые большие классы, самые длинные методы |
Перенос
| Инструмент | Назначение |
|---|---|
tokensave_port_status | Сравнить символы между исходным/целевым каталогами для отслеживания прогресса переноса |
tokensave_port_order | Топологическая сортировка символов для переноса — сначала листья, затем зависимые |
Мульти-ветка
| Инструмент | Назначение |
|---|---|
tokensave_branch_search | Искать символы в графе другой ветки |
tokensave_branch_diff | Сравнить символы между ветками (добавлено/удалено/изменено) |
tokensave_branch_list | Список отслеживаемых веток с размерами БД и временем синхронизации |
Ресурсы MCP
Четыре ресурса доступны через resources/list и resources/read:
tokensave://status— статистика графа в формате JSONtokensave://files— дерево индексированных файлов, сгруппированное по каталогамtokensave://overview— сводка проекта с распределением языков и типами символовtokensave://branches— отслеживаемые ветки с размерами БД и информацией о родителях
Отслеживание токенов
tokensave измеряет токены, которые он экономит при каждом вызове инструмента MCP. Каждый ответ инструмента включает строку tokensave_metrics: before=N after=M, показывающую, сколько токенов исходных файлов было избегнуто этим конкретным вызовом.
Отключение отчетности. Строка метрик вместе с предложением в MCP instructions просит агента сообщать вам об экономии — что означает, что модель тратит выходные токены на повествование об экономии, которую tokensave сделал на входных токенах. Выходные токены — более дорогой вид, поэтому если ваш агент упоминает tokensave почти на каждом ходу, это повествование может свести на нет выигрыш (#356). Установите report_savings в false в .tokensave/config.json, или переменную окружения TOKENSAVE_REPORT_SAVINGS, чтобы переопределить это для каждого запуска (любое значение включает это, кроме 0, false, no, off или пустого). И строка метрик, и инструкция исчезают; tokensave install также перестает записывать правило отчетности в файлы подсказок агента. Измерение не затрагивается в любом случае — каждый вызов все равно попадает в реестр экономии, так что tokensave gain, tokensave list, status и monitor продолжают сообщать точно так же, как раньше. По умолчанию остается true.
По умолчанию перечислены только основные инструменты. MCP-клиент отправляет схему каждого перечисленного инструмента на каждом ходу, до вызова любого инструмента. Полная поверхность tokensave составляет около 89 КБ схемы, что на модели с малым контекстом может быть более половины окна (#576). Поэтому tools/list отправляет только основные инструменты: context, search, status, read, body, files, callers, callees, impact, str_replace и multi_str_replace (около 17 КБ с tokensave_more). Инструкции initialize называют эти инструменты и области, которые tokensave_more может перечислять, так что клиент, который откладывает схемы инструментов, все равно знает, что остальные существуют. Настройка выбирает, что сервер перечисляет, а не что он может запускать: инструмент, который не перечислен, все равно отвечает на вызов по имени, так что списки разрешений агента и хуки продолжают работать. Чтобы перечислить все инструменты, установите "tools": "full" в .tokensave/config.json, или TOKENSAVE_TOOLS=full в окружении MCP-сервера; переменная окружения имеет приоритет над файлом. "tools": "full", записанный версией 7.13.0, которая записывала его в каждый сохраненный конфиг, читается как старое значение по умолчанию; установите его снова после обновления, чтобы сохранить полный список.
С основным набором инструментов сервер также перечисляет tokensave_more. Вызов с area (analysis, edit, git, memory, navigate или all) перечисляет инструменты этой области на остаток сессии, и сервер отправляет notifications/tools/list_changed, чтобы клиент снова получил список. Сессия платит только за те области, которые использует: область git добавляет около 6 КБ. Клиент, игнорирующий list_changed, сохраняет основной список. tokensave install предоставляет tokensave_more вместе со всеми остальными инструментами, поэтому не запрашивает подтверждение; установка до этого релиза запрашивает один раз, пока tokensave reinstall или повторная синхронизация при обновлении не обновит список разрешений.
Наблюдаемость затрат
tokensave cost                     # 7-day cost summary (default)
tokensave cost today               # today only
tokensave cost --by-model          # breakdown by Claude model
tokensave cost --by-task           # breakdown by task category (coding, debugging, exploration, ...)
tokensave cost --export json       # JSON export to stdout
tokensave cost --export csv        # CSV export to stdout
Анализирует журналы сессий Claude Code (~/.claude/projects/**/*.jsonl), классифицирует каждый вызов API в одну из 13 категорий задач, вычисляет стоимость в долларах по ценам моделей и сохраняет результаты в ~/.tokensave/global.db для быстрых агрегированных запросов. Цены обновляются из LiteLLM каждые 24 часа, а при отсутствии сети используется встроенная таблица.
Заголовок tokensave status включает строку затрат, показывающую расходы за сегодня, за 7 дней и коэффициент эффективности (сохранённые токены / всего токенов). TUI tokensave monitor показывает живую панель затрат рядом с лентой экономии. В конце каждой сессии Claude Code обработчик hook_stop выводит в терминал однострочную квитанцию.
Категории классификации задач: Кодирование, Отладка, Разработка функций, Рефакторинг, Тестирование, Исследование, Планирование, Делегирование, Git-операции, Сборка/Развёртывание, Мозговой штурм, Разговор, Общее. Классификация детерминирована (сопоставление шаблонов по именам инструментов и командам Bash), не требует вызовов LLM и адаптирована из AgentSeal/codeburn.
Живой монитор
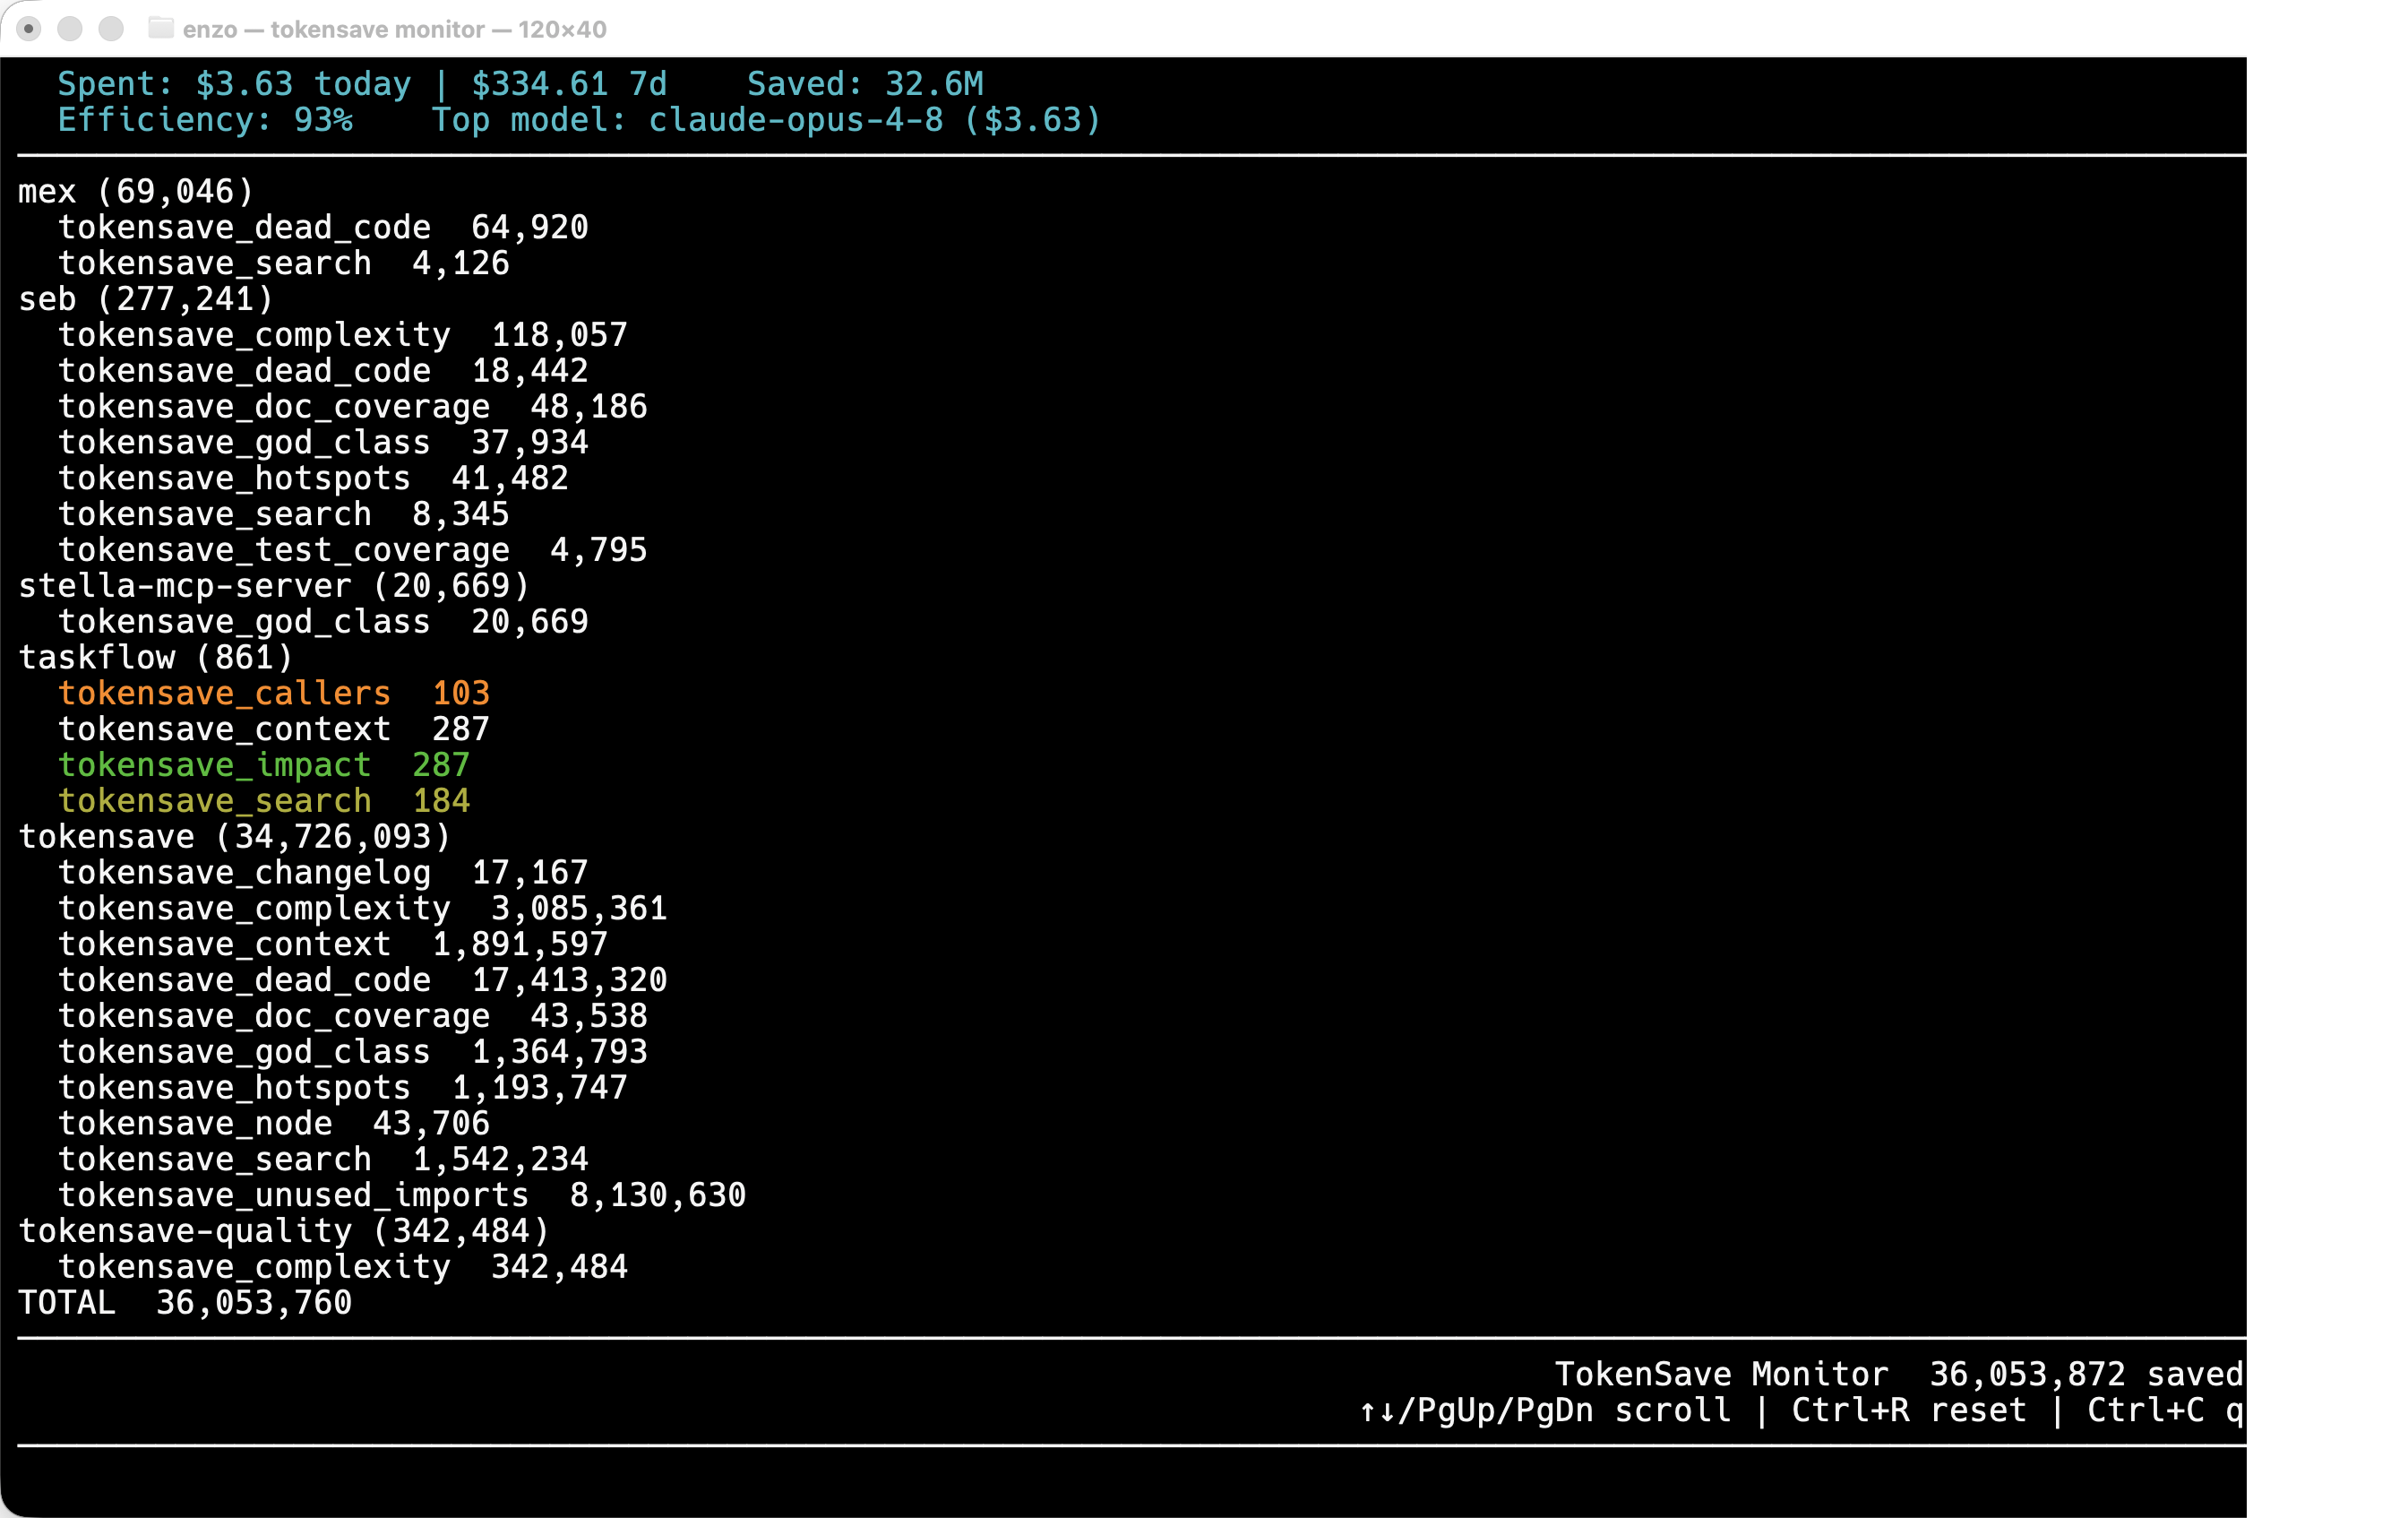
tokensave monitor
Глобальный TUI, показывающий вызовы MCP-инструментов из всех проектов в реальном времени через общее кольцевое буферное хранилище с отображением в память по адресу ~/.tokensave/monitor.mmap. Каждая запись показывает имя проекта, имя инструмента и дельту токенов. Панель затрат вверху показывает расходы за сегодня, экономию, эффективность и лучшую модель (обновляется каждые 30 секунд).
Диагностика памяти
tokensave memory [--clean]
Общесистемный отчёт о памяти для каждого процесса tokensave (MCP-серверы, синхронизации, запуски индексации) через общую таблицу с отображением в память по адресу ~/.tokensave/memory.mmap. Каждый экземпляр самостоятельно измеряет свой RSS по мере возможности при запуске, при каждом вызове MCP-инструмента и вокруг фаз синхронизации/разрешения, поэтому отчёт показывает текущий и пиковый RSS с фазой, которая вызвала пик — данные, необходимые для атрибуции высокого использования памяти (см. #253). Строки помечаются как alive, dead (процесс, убитый OOM, оставляет свой пик/фазу как судебную запись) или orphan (всё ещё работает, но переподчинён init). --clean очищает мёртвые слоты.
PEAK PHASE указывает на самый высокий сэмпл, поэтому его точность ограничена частотой выборки. Инкрементальная синхронизация записывает по порядку: sync:extract, sync:resolve:load_nodes, sync:resolve:build_caches, sync:resolve:refs, sync:variants, sync:done. Полная индексация записывает index:extract, index:resolve:build_caches, index:resolve:refs, index:resolve:done, index:insert, index:done.
Каждый сэмпл записывается после работы, которую он называет. Раньше они записывались до неё, поэтому каждый сэмпл сообщал RSS предыдущего шага под меткой следующего — что приписывало 73 МиБ загрузке узлов, хотя на самом деле это была загрузка неразрешённых ссылок, шаг без единого сэмпла, и направляло расследование памяти не в ту подсистему в течение месяцев (#409). Если вы добавляете фазу, делайте сэмпл после работы, а не до неё, и добавляйте сэмпл для любого шага, достаточно большого, чтобы удержать пик.
Счётчики сессий и времени жизни
tokensave current-counter          # show per-project session counter
tokensave reset-counter            # reset the session counter
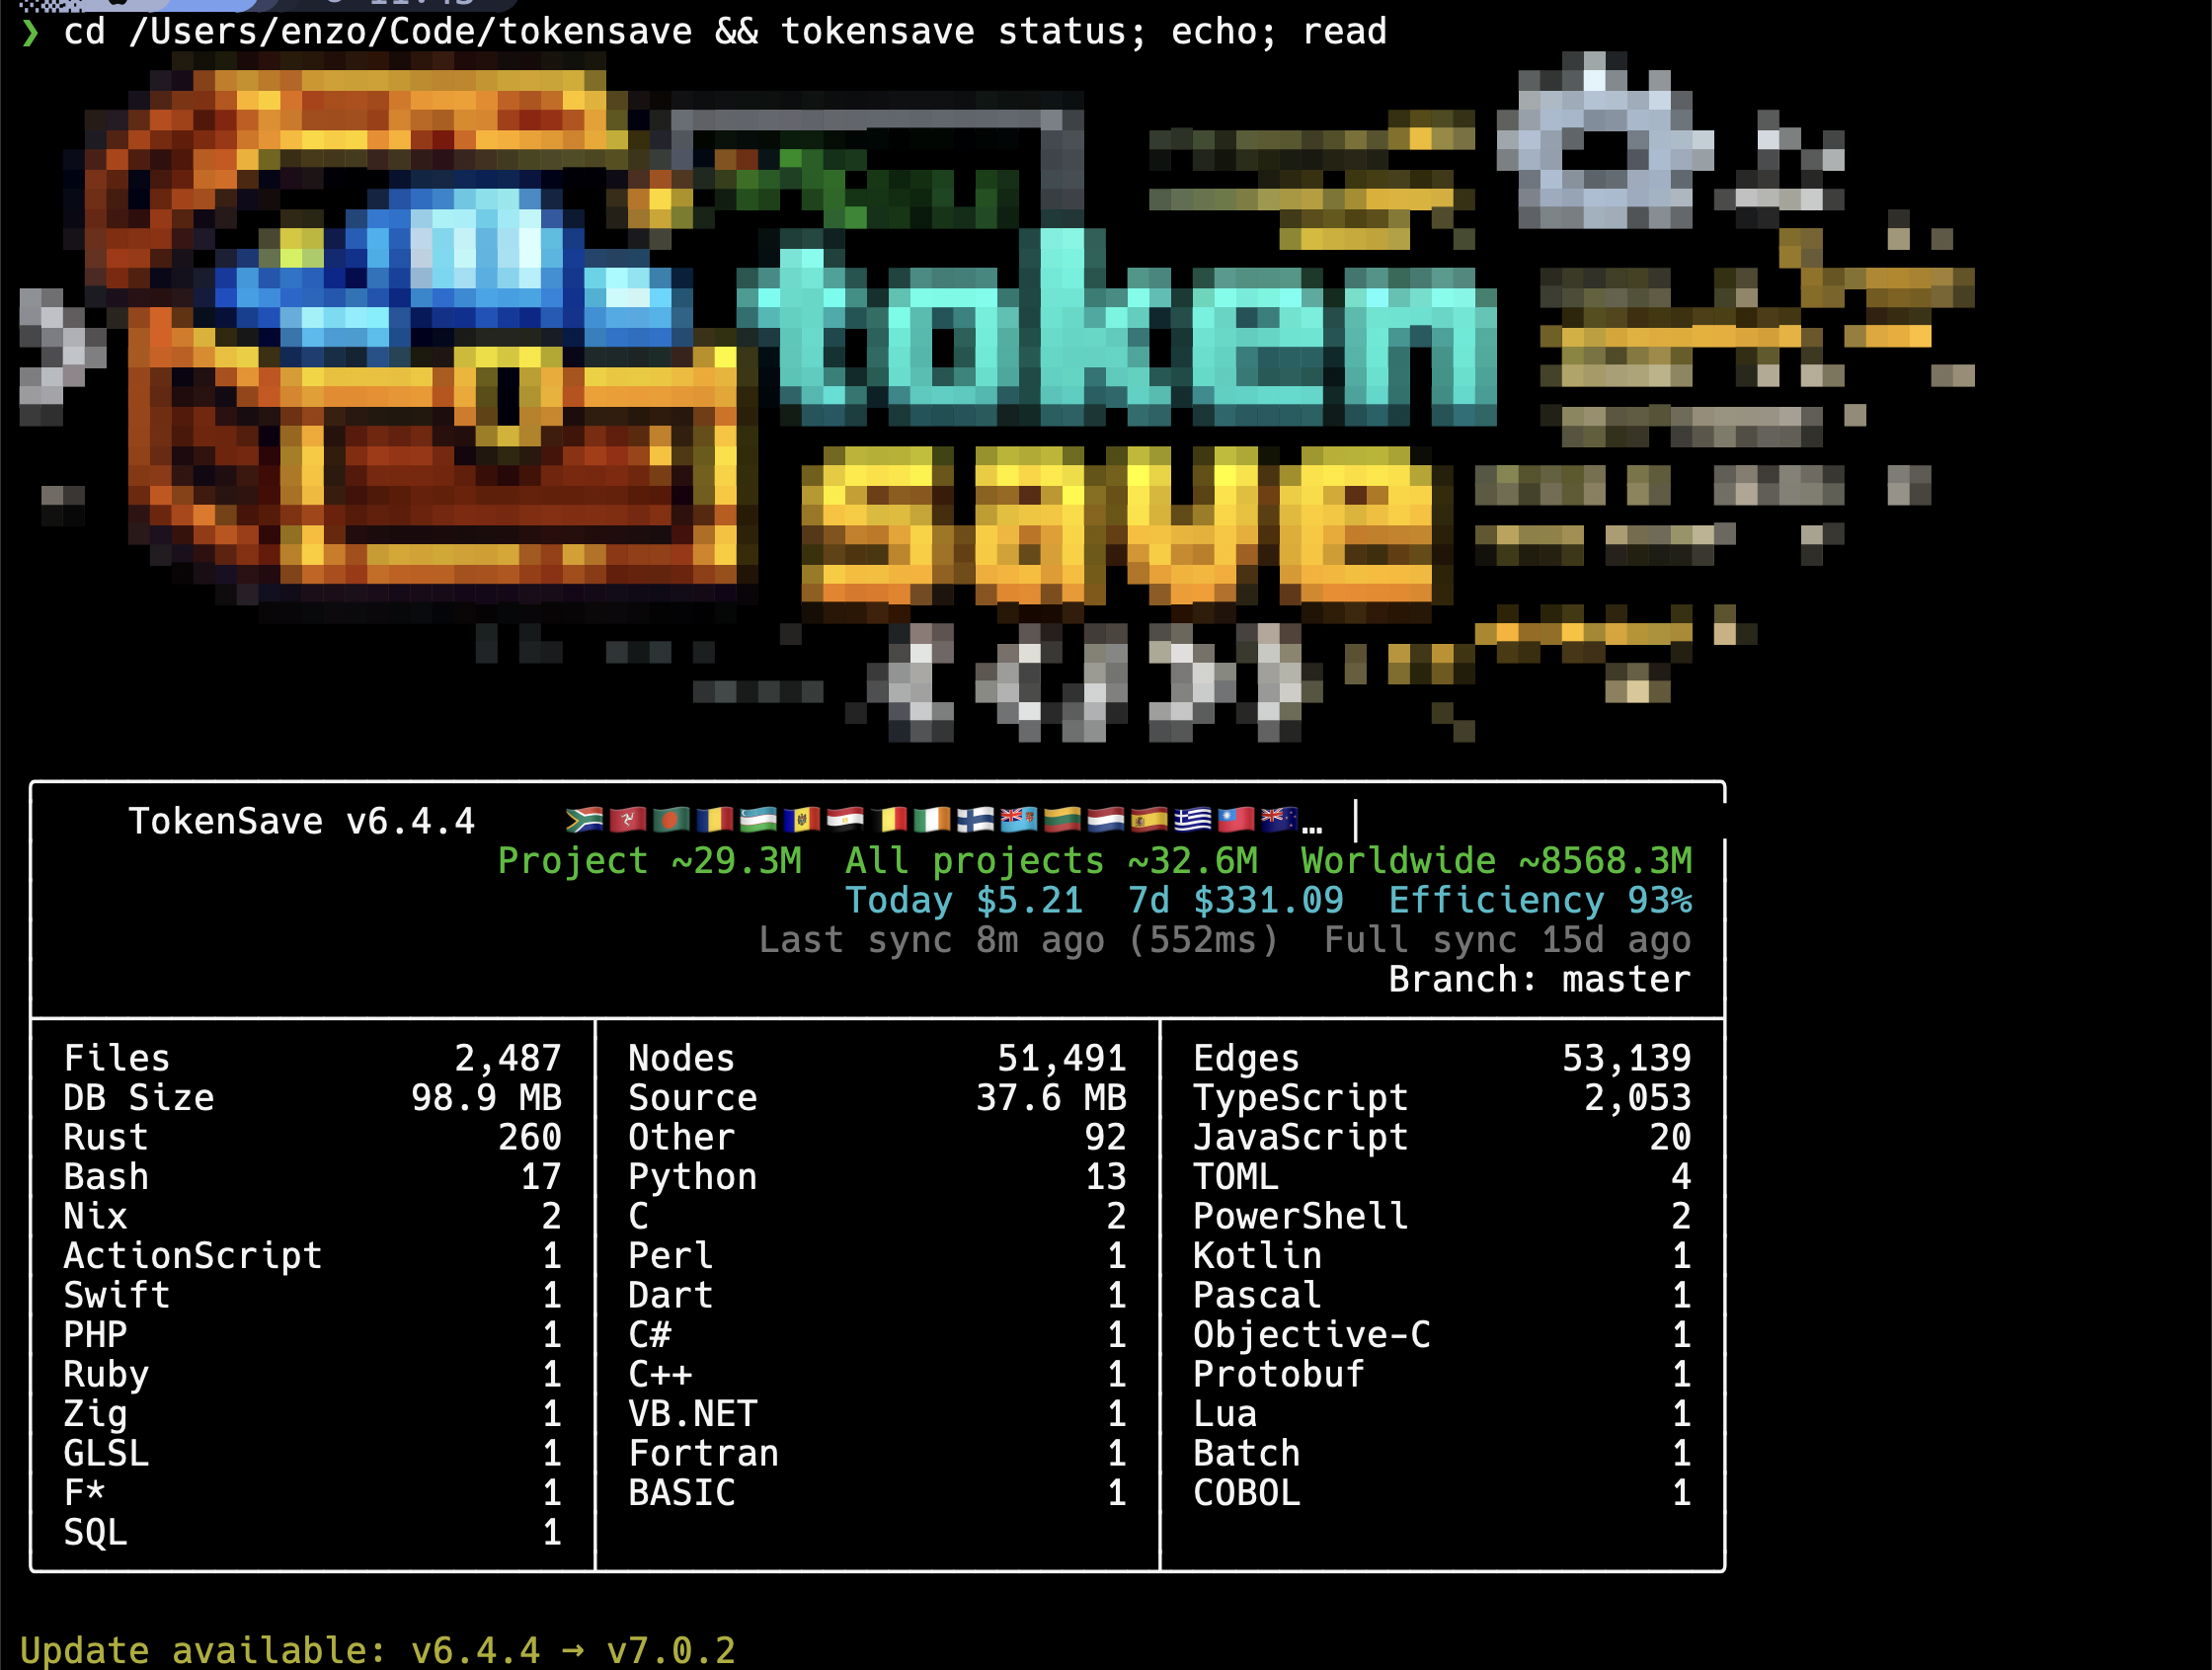
tokensave status                   # shows project + global lifetime totals + cost
tokensave status отображает статистику индекса проекта, разбивку по языкам, строку затрат (сегодня / 7 дней / эффективность) и итоги времени жизни проекта и по всему миру:
Общемировой счётчик
Все пользователи tokensave вносят вклад в анонимный агрегированный счётчик. tokensave status показывает как итог вашего проекта, так и общемировой итог. Загрузка отправляет только одно число (например, 4823) без идентифицирующей информации. Отказ через tokensave disable-upload-counter.
Свежесть индекса
tokensave поддерживает граф в актуальном состоянии без фонового демона или системного наблюдателя за файлами.
Проверка устаревания по требованию. Каждый вызов MCP-инструмента проверяет, были ли изменены какие-либо индексированные файлы с момента последней синхронизации. Если найдены устаревшие файлы, они повторно извлекаются до возврата ответа инструмента. 30-секундная задержка предотвращает повторный обход дерева при каждом нажатии клавиши при последовательных вызовах.
Догоняющая синхронизация при подключении. При запуске MCP-сервера немедленно выполняется неблокирующая догоняющая синхронизация, которая подхватывает любые изменения, сделанные, пока не был подключён агент — git pull, правка в IDE, шаг сборки — так что самый первый вызов инструмента в сессии видит свежий индекс.
Мультиагентная работа и git-рабочие деревья. Когда несколько агентов работают над одним проектом одновременно, основное предположение — каждый агент работает в своём git-рабочем дереве. Рабочие деревья — это независимые файловые копии одного репозитория: у агента A и агента B есть своя копия каждого файла, поэтому они никогда не перезаписывают правки друг друга. tokensave автоматически определяет, когда запрос приходит из рабочего дерева, вложенного в основную копию, и возвращает результаты из правильного графа веток. Изменения накапливаются независимо и в конечном итоге объединяются через git merge или rebase — тот же процесс, что и для любой другой параллельной разработки. Такая конструкция избегает сложности и режимов отказа межпроцессных блокировок над общей изменяемой директорией.
Рабочие процессы только через CLI. Если вы запускаете команды tokensave без подключённого агента (без MCP-сервера), проверка устаревания не выполняется между командами. Установите git-хуки, чтобы индекс автоматически обновлялся после каждого коммита или клонирования:
cp scripts/post-commit scripts/post-checkout .git/hooks/
chmod +x .git/hooks/post-commit .git/hooks/post-checkout
Обновление с 5.x
Отдельная команда tokensave daemon и её автозапуск через launchd/systemd/Windows Service были удалены в 6.0.0. Встроенный системный наблюдатель за файлами, заменивший демон, также был удалён в 6.1.1 (он вызывал неконтролируемое потребление CPU и памяти на больших монорепозиториях с глубокими деревьями node_modules или target). Модель проверки устаревания по требованию, описанная выше, — текущая конструкция.
Если у вас всё ещё есть автозапуск демона с 5.x, удалите его:
- macOS:
launchctl unload ~/Library/LaunchAgents/com.tokensave.daemon.plist && rm ~/Library/LaunchAgents/com.tokensave.daemon.plist - Linux:
systemctl --user disable --now tokensave-daemon && rm ~/.config/systemd/user/tokensave-daemon.service - Windows:
sc.exe delete tokensave-daemon(из терминала с правами администратора)
Если вы не помните точное имя: launchctl list | grep tokensave / systemctl --user list-units | grep tokensave / sc.exe query state= all | findstr -i tokensave.
Самообновление
tokensave upgrade                  # upgrade to latest in current channel
tokensave channel                  # show current channel (stable/beta)
tokensave channel beta             # switch to beta channel
tokensave channel stable           # switch back to stable
tokensave upgrade загружает правильный бинарный файл платформы из релизов GitHub и заменяет работающий бинарный файл на месте. Поддерживает стабильный и бета-каналы независимо.
Версионирование и обновления
Номера версий tokensave выглядят как SemVer, но не следуют ей: изменяемый компонент кодирует обслуживание, которое требуется обновлению, и tokensave выполняет его автоматически при следующем запуске — вам никогда не нужно вручную переустанавливать или переиндексировать.
| Изменение | Пример | Требуется обновление | Автоматическое действие |
|---|---|---|---|
Патч (x.y.Z) | 7.2.0 → 7.2.1 | Ничего | Нет — без переустановки, без переиндексации |
Минорное (x.Y.0) | 7.2.0 → 7.3.0 | Переустановка (новые обвязки, новые инструменты, новая конфигурация) | Глобальная переустановка каждой установленной интеграции агента (обновляет разрешения, хуки и MCP-конфигурацию) |
Мажорное (X.0.0) | 7.2.0 → 8.0.0 | Переустановка + полная повторная синхронизация | Глобальная переустановка и принудительная переиндексация каждого проекта (эквивалент sync -f) |
Глобальная переустановка. При первом запуске новой минорной или мажорной сборки tokensave молча повторно выполняет install для каждого зарегистрированного агента, чтобы конфигурация агента всегда указывала на текущий бинарный файл и предоставляла текущий набор инструментов. Патч-обновления пропускают это — просто продвигается маркер текущей версии.
Переустановка действительно молчалива: вывод настройки для каждого агента, который вы видите при явном tokensave install, здесь подавляется, поэтому он никогда не появляется перед обычным tokensave init или tokensave sync. Если конфигурацию агента нельзя обновить — приложение не установлено или его конфигурация находится в месте только для чтения — вы получаете одну строку с именами агентов, которые не удалось обновить:
warning: could not refresh tokensave config for: copilot.
  Run tokensave install to see the error.
Запустите tokensave install, чтобы увидеть основную ошибку. Маркеры версий продвигаются в любом случае, поэтому путь конфигурации, который никогда не может быть записан, сообщается один раз за обновление, а не повторяется при каждой последующей команде.
Принудительная переиндексация проекта (только мажорное). Мажорное изменение означает, что индексы проектов должны быть перестроены. tokensave делает это лениво и для каждого проекта: при первом вызове MCP-инструмента в проекте после мажорного обновления запускается фоновая полная переиндексация (эквивалент tokensave sync --force), которая никогда не блокирует ответ инструмента.
Резерв Brew / cargo. Внешние обновления, заменяющие бинарный файл вне tokensave upgrade — brew upgrade tokensave или cargo install tokensave — обнаруживаются так же: если работающая версия новее последней версии, выполнившей установку, переустановка запускается при следующем запуске, как и после самообновления.
См. TOKENSAVE-VERSIONING.md о том, почему tokensave расходится с SemVer (кодирование обслуживания в версии — это то, что делает возможными обновления без вмешательства), о механике маркеров, независимой версии схемы базы данных и правилах для мейнтейнеров при выпуске релизов.
Справочник CLI
tokensave init [path]              # Initialize a new project (full index)
tokensave sync [path]              # Incremental sync (must be initialized first)
tokensave sync --force [path]      # Force a full re-index
tokensave sync --doctor [path]     # Sync and list added/modified/removed files
tokensave status [path]            # Show statistics + cost summary
tokensave status [path] --json     # Show statistics (JSON output)
tokensave status --details         # Include node-kind breakdown
tokensave cost [range]             # Token cost summary (default: 7d)
tokensave cost --by-model          # Cost grouped by model
tokensave cost --by-task           # Cost grouped by task category
tokensave cost --export json|csv   # Export cost data
tokensave query <search> [path]    # Search symbols
tokensave files [--filter dir] [--pattern glob] [--json]   # List indexed files
tokensave affected <files...> [--stdin] [--depth N]        # Find affected test files
tokensave install [--agent NAME]   # Configure agent integration
tokensave reinstall                # Refresh settings for all installed agents
tokensave uninstall [--agent NAME] # Remove agent integration
tokensave serve [--idle-timeout-secs N]   # Start MCP server (N: exit after N idle seconds)
tokensave servers [--json]         # List running servers and the index each one holds
tokensave monitor                  # Live TUI showing MCP calls across all projects
tokensave memory [--clean]         # Per-instance RSS report for all tokensave processes
tokensave upgrade                  # Self-update to latest version
tokensave channel [stable|beta]    # Show or switch update channel
tokensave doctor [--agent NAME]    # Check installation health
tokensave githooks [on|off] [--local]  # Manage git hooks (--local: this repo only, no core.hooksPath)
tokensave branch add|list|remove|removeall|gc   # Multi-branch management
tokensave current-counter          # Show per-project token counter
tokensave reset-counter            # Reset per-project token counter
tokensave disable-upload-counter   # Opt out of worldwide counter uploads
tokensave enable-upload-counter    # Re-enable worldwide counter uploads
tokensave doctor
Запустите комплексную проверку работоспособности вашей установки tokensave:
tokensave doctor
Проверки: расположение бинарного файла, индекс проекта, глобальная БД, пользовательская конфигурация, интеграция агента (MCP-сервер, хуки, разрешения, правила промптов) и сетевое подключение. Если после обновления отсутствуют какие-либо разрешения инструментов, он сообщает вам запустить tokensave install. Используйте --agent для проверки только конкретного агента.
Doctor также проверяет, что каждый установленный хук использует правильную подкоманду tokensave, и автоматически исправляет сломанные хуки.
Как это работает с Claude Code
После настройки Claude Code автоматически использует tokensave вместо чтения сырых файлов, когда ему нужно понять вашу кодовую базу. Три уровня усиливают друг друга:
| Уровень | Что делает | Почему это важно |
|---|---|---|
| MCP-сервер | Предоставляет 80+ инструментов tokensave_* для Claude | Claude может напрямую запрашивать граф |
| Правила CLAUDE.md | Говорят Claude предпочитать tokensave агентам/чтению файлов | Предотвращает откат модели к дорогим паттернам |
| Хук PreToolUse | Нативный Rust-хук блокирует Explore-агентов | Ловит случаи, когда модель игнорирует правила CLAUDE.md |
| Хук UserPromptSubmit | Выполняется при отправке промпта | Отслеживание жизненного цикла для учёта токенов |
| Хук Stop | Выполняется при завершении сессии | Сбрасывает счётчики токенов |
Результат: Claude получает то же понимание кода с гораздо меньшим количеством токенов. Типичный Explore-агент читает 20–50 файлов; tokensave возвращает релевантные символы, связи и фрагменты кода из своего предварительно построенного индекса.
Сетевые вызовы и конфиденциальность
Основная функциональность tokensave (индексация, поиск, графовые запросы, MCP-сервер) на 100% локальна — ваш код никогда не покидает вашу машину.
| Вызов | Отправляемые данные | Когда | Отказ |
|---|---|---|---|
| Загрузка общемирового счётчика | Количество токенов (число) + страна (из IP) | синхронизация, статус, MCP-сессии | tokensave disable-upload-counter |
| Чтение общемирового счётчика | Ничего (GET-запрос) | статус | Н/Д (только чтение, таймаут 1 с) |
| Проверка версии | Ничего (GET-запрос) | статус (кэш 5 мин), синхронизация (параллельно) | Н/Д (таймаут 1 с, бездействие при сбое) |
| Обновление цен моделей | Ничего (GET-запрос) | tokensave cost (кэш 24 ч) | Н/Д (таймаут 5 с, возврат к встроенным ценам) |
Всемирный счётчик загрузок отправляет один HTTP POST с JSON-телом, как {"amount": 4823}. Никаких cookie, отслеживания или идентификатора пользователя. Cloudflare Worker логирует страну вашего IP-адреса (полученную из заголовков запроса) для агрегированной географической статистики — сам ваш IP-адрес не сохраняется. |
Обновление цен на модели получает публичный JSON-файл с GitHub (raw.githubusercontent.com/BerriAI/litellm/main/model_prices_and_context_window.json), чтобы поддерживать актуальные цены на модели Claude для tokensave cost. Никакие данные не отправляются — это обычный HTTPS GET. Ответ кэшируется в ~/.tokensave/pricing.json на 24 часа. Если запрос не удался, tokensave использует встроенную таблицу цен.
50+ языков
tokensave поддерживает более 50 языков программирования, организованных в три уровня, управляемых флагами функций Cargo. Каждый уровень включает все языки из уровня ниже. Заголовки Markdown извлекаются как узлы Module с иерархическими рёбрами Contains, чтобы структура документа участвовала в графовых запросах вместе с исходным кодом.
Lite — --no-default-features
Всегда компилируется. Самый маленький бинарник для самых популярных языков, плюс Svelte и Astro (извлечение блоков скриптов через экстрактор TypeScript, без дополнительной зависимости грамматики).
| Язык | Расширения |
|---|---|
| Rust | .rs |
| Go | .go |
| Java | .java |
| Scala | .scala, .sc |
| TypeScript | .ts, .tsx |
| JavaScript | .js, .jsx |
| Python | .py |
| C | .c, .h |
| C++ | .cpp, .hpp, .cc, .cxx, .hh |
| Kotlin | .kt, .kts |
| C# | .cs |
| Swift | .swift |
| Svelte | .svelte |
| Astro | .astro |
Medium (Lite + ещё 9) — --features medium
| Язык | Расширения | Флаг функции |
|---|---|---|
| Dart | .dart | lang-dart |
| Pascal | .pas, .pp, .dpr | lang-pascal |
| PHP | .php | lang-php |
| Ruby (включая шаблоны ERB и Slim) | .rb, .rake, .erb, .slim | lang-ruby |
| Bash | .sh, .bash | lang-bash |
| Protobuf | .proto | lang-protobuf |
| PowerShell | .ps1, .psm1 | lang-powershell |
| Nix | .nix | lang-nix |
| VB.NET | .vb | lang-vbnet |
Шаблоны ERB и Slim используют грамматику Ruby без необходимости в Ruby или гемах шаблонов во время индексации. Вызовы шаблонов принадлежат узлу файла и сохраняют исходную строку и байтовую колонку. ERB поддерживает теги кода/вывода, trim-маркеры, комментарии и экранированные теги. Slim поддерживает строки управления/вывода, блоки на основе отступов, атрибуты (включая многострочные списки атрибутов), текстовую интерполяцию и блоки ruby:.
Пользовательские сокращения Slim и компиляция встроенных языков не поддерживаются. Локальные переменные, предоставляемые Rails во время рендеринга, невозможно отличить от простых вызовов хелперов; имена, присвоенные или связанные в шаблоне, консервативно исключаются. Связи контроллер-представление и частичный рендеринг требуют отдельной семантической настройки Rails.
Full (Medium + всё остальное) — по умолчанию
| Язык | Расширения | Флаг функции |
|---|---|---|
| ActionScript | .as | lang-actionscript |
| Lua | .lua | lang-lua |
| Zig | .zig | lang-zig |
| Objective-C | .m, .mm | lang-objc |
| Perl | .pl, .pm | lang-perl |
| Batch/CMD | .bat, .cmd | lang-batch |
| Fortran | .f90, .f95, .f03, .f08, .f18, .f, .for | lang-fortran |
| COBOL | .cob, .cbl, .cpy | lang-cobol |
| MS BASIC 2.0 | .bas | lang-msbasic2 |
| GW-BASIC | .gw | lang-gwbasic |
| QBasic | .qb | lang-qbasic |
| QuickBASIC 4.5 | .bi, .bm | lang-qbasic |
| Dockerfile | Dockerfile, .dockerfile | lang-dockerfile |
| GLSL | .glsl, .vert, .frag, .comp | lang-glsl |
| Godot Shader | .gdshader, .gdshaderinc | lang-glsl |
| Minecraft Function | .mcfunction | lang-mcfunction |
| WGSL | .wgsl | lang-wgsl |
| HLSL | .hlsl, .fx | lang-hlsl |
| Verilog / SystemVerilog | .v, .vh, .sv, .svh | lang-systemverilog |
| VHDL | .vhd, .vhdl | lang-vhdl |
| Metal | .metal | lang-metal |
| CUDA / HIP | .cu, .cuh | lang-cuda |
| Markdown | .md, .markdown | lang-markdown |
| R | .r, .R | lang-r |
| SQL | .sql | lang-sql |
| Julia | .jl | lang-julia |
| Haskell | .hs, .lhs | lang-haskell |
| OCaml | .ml, .mli | lang-ocaml |
| Clojure | .clj, .cljs, .cljc | lang-clojure |
| Erlang | .erl, .hrl | lang-erlang |
| Elixir | .ex, .exs | lang-elixir |
| F# | .fs, .fsi, .fsx | lang-fsharp |
| F* | .fst, .fsti | lang-fstar |
| Quint | .qnt | lang-quint |
| Terraform | .tf, .tfvars | lang-terraform |
| TOML | .toml | lang-toml |
| Lean | .lean | lang-lean |
| HTML | .html, .htm | lang-html |
| CSS | .css | lang-css |
Отдельные языки также можно выбирать точечно без полного уровня:
cargo install tokensave --no-default-features --features lang-nix,lang-bash
Все экстракторы имеют одинаковую глубину: функции, классы, методы, поля, импорты, графы вызовов, цепочки наследования, docstring'и, метрики сложности, извлечение декораторов/аннотаций и отслеживание зависимостей между файлами.
HTML и CSS — исключение, потому что ни один из этих языков не имеет вызываемых символов. HTML записывает элементы с атрибутом id, пользовательские элементы, а также таблицы стилей и скрипты, которые подключает страница; CSS записывает селекторы классов и идентификаторов, пользовательские свойства, имена @keyframes и @import. Ни один из них не сопоставляет атрибут class="..." с правилом таблицы стилей: имена классов — обычные слова, и сопоставление их по голому имени во всём проекте создаёт рёбра, а не находит их.
tokensave против CodeGraph
tokensave — это полностью новая реализация CodeGraph (Node.js/TypeScript) на Rust. Оба строят семантические графы кода для ИИ-агентов программирования, но значительно расходятся в охвате и возможностях.
| tokensave | CodeGraph | |
|---|---|---|
| Среда выполнения | Нативный бинарник (Rust) | Node.js 18+ |
| Установка | brew install, cargo install, scoop install | npx @colbymchenry/codegraph |
| Языки | 50+ (3 уровня: lite/medium/full) | 19+ |
| MCP-инструменты | 80+ | 9 |
| Интеграции с агентами | 12+ (Claude, Codex, Gemini, Qwen, OpenCode, Cursor, Cline, Copilot, Roo Code, Zed, Antigravity, Kilo, Kiro, Kimi, Vibe, Grok, OMP, Pi, Plank, Factory Droid) | 1 (Claude Code) |
| Свежесть индекса | Проверка устаревания по требованию при каждом MCP-вызове; синхронизация догоняющих изменений при подключении; для многозадачных агентов предполагается использование git worktrees | Нативный файловый наблюдатель уровня ОС (FSEvents/inotify/ReadDirectoryChangesW, задержка 2 с); синхронизация догоняющих изменений при подключении |
| Многоветочная индексация | Да, по желанию (БД на ветку, межветочный diff/поиск) | Нет |
| Метрики сложности | Извлечённые из AST (ветви, циклы, глубина вложенности, цикломатическая и когнитивная сложность, Halstead, индекс поддерживаемости, CRAP) | Нет |
| Инструменты портирования | Да (port_status, port_order) | Нет |
| Визуализатор графа | Удалён (v4.0.1) | Да |
| Семантический поиск | Расширение ключевых слов, управляемое агентом (нулевая стоимость) | Локальные эмбеддинги (nomic-embed-text-v1.5 через ONNX) |
| MCP-ресурсы | 4 (status, files, overview, branches) | Нет |
| MCP-аннотации | Да (readOnlyHint, alwaysLoad) | Нет |
| Обнаружение мёртвого кода | Да | Нет |
| Обнаружение циклических зависимостей | Да | Нет |
| Иерархия типов | Да | Нет |
| Анализ god class / связанности | Да | Нет |
| Контекст коммитов / PR | Да | Нет |
| Сопоставление тестов | Да | Нет |
| Предпросмотр переименования | Да | Нет |
| Отслеживание токенов | Метрики на вызов, живой TUI-монитор, счётчики сессии и за всё время | Нет |
| Аналитика здоровья кода | Композитный балл, Gini, глубина зависимостей, DSM, взвешенные по риску пробелы в тестах, дельты сессий | Нет |
| Примитивы редактирования | 4 атомарных писателя (str_replace, multi_str_replace, insert_at, ast_grep_rewrite) с автоматической переиндексацией | Нет |
| Устойчивость к сбоям | Изоляция извлечения в подпроцессах; сбои нативных грамматик пропускают файл, синхронизация продолжается | Нет |
| Самообновление | tokensave upgrade с каналами stable/beta | npm update |
| Движок БД | libsql (форк SQLite, WAL, async) | better-sqlite3 / wa-sqlite (WASM) |
| Скорость индексации | ~1,2 с для 1 782 файлов | ~4 с для 1 782 файлов |
| Размер бинарника | ~25 МБ сжатая загрузка (все грамматики включены) | ~80 МБ (node_modules + WASM) |
CodeGraph был пионером подхода и остаётся надёжным выбором, если вы предпочитаете инструменты npm и вам нужна только интеграция с Claude Code. tokensave расширяет концепцию более глубоким анализом, большим числом агентов, поддержкой многоветочности и нативным бинарником без зависимостей среды выполнения.
Для подробных сравнений с CodeGraph, Dual-Graph (GrapeRoot), code-review-graph и OpenWolf см. docs/COMPARABLE-TOOLS.md.
Страницы попарных сравнений (на каждой указано, где другой инструмент лучше): Serena · code-review-graph · Graphify · CodeGraph · token-savior · GrapeRoot · LeanCTX · OpenWolf — индекс на tokensave.dev/vs.
Почему tokensave вместо альтернатив
Несколько инструментов снижают расход токенов для ИИ-агентов программирования. Вот почему tokensave выделяется.
Один нативный бинарник, ноль зависимостей
Большинство альтернатив требуют среду выполнения: Python, Node.js или оба. tokensave поставляется как один бинарник Rust со всеми 50+ грамматиками tree-sitter (~25 МБ сжатая загрузка). Больше ничего устанавливать не нужно — и, в отличие от инструментов на базе LSP, таких как Serena, не нужно устанавливать, запускать или прогревать языковой сервер для каждого языка. Два инструмента теперь сравнимы с tokensave по упаковке: CodeGraph включает собственную среду выполнения, а LeanCTX также является одним бинарником Rust.
Самая глубокая интеллектуальная обработка кода
tokensave работает на уровне символов: функции, структуры, поля, рёбра вызовов, иерархии типов, метрики сложности. Альтернативы, такие как Dual-Graph (GrapeRoot), работают на уровне файлов — они знают, какие файлы существуют, но не могут ответить «кто вызывает эту функцию?» или «что сломается, если я изменю эту структуру?». 80+ специализированных MCP-инструментов tokensave охватывают обход графа вызовов, анализ влияния, обнаружение мёртвого кода, сопоставление тестов, предпросмотр переименования, иерархии типов, обнаружение циклических зависимостей, ранжирование сложности, аналитику здоровья кода (Gini, DSM, глубина зависимостей, взвешенные по риску пробелы в тестах), атомарные примитивы редактирования и многое другое. Ближайший сопоставимый графовый инструмент, code-review-graph, предоставляет 30; несколько других предоставляют меньше 10 по осознанному решению.
Самая широкая поддержка агентов
Более дюжины интеграций с AI-агентами для написания кода с нативными форматами конфигурации для каждого агента. Ни один другой инструмент не охватывает столько агентов с такой глубокой интеграцией. Claude Code получает хуки, правила промптов и автоматически разрешённые разрешения инструментов. Kiro получает глобальную MCP-конфигурацию, tokensave.md управление, загружаемое как ресурс, управляемого агента с разрешающим встроенным/токенсейв-одобрением инструментов, а также хуки для защиты делегирования и пост-записной синхронизации. Другие агенты получают регистрацию MCP-сервера в их нативном формате конфигурации.
Мультиветочное индексирование
Единственный инструмент в этой области с опциональными графовыми базами данных на ветку и кросс-веточным diff и поиском. При включении переключение веток мгновенно — повторное индексирование не требуется.
По-вызовный учёт токенов
Единственный инструмент, который сообщает, сколько именно токенов сэкономил каждый отдельный вызов MCP-инструмента, плюс живой TUI-монитор по всем проектам и счётчики за всё время.
Полностью открытый исходный код
Rust под лицензией MIT, аудируемый от начала до конца. Основной движок Dual-Graph (graperoot на PyPI) проприетарный — вы не можете увидеть, что он делает с вашим графом кода. OpenWolf использует AGPL-3.0, что требует открытия производных работ.
Производительность
Бенчмарк полного индексирования на смешанной кодовой базе Rust/Java/Scala из 1 782 файлов (57K узлов, 103K рёбер):
| Инструмент | Время | Ускорение |
|---|---|---|
| CodeGraph (TypeScript) | 31,2 с | 1x |
| tokensave (Rust) | 1,2 с | 26x |
Устранение неполадок
«tokensave не инициализирован»
Каталог .tokensave/ не существует в вашем проекте.
tokensave init
MCP-сервер не подключается
AI-агент не видит инструменты tokensave.
- Убедитесь, что конфигурация агента включает MCP-сервер tokensave (запустите
tokensave doctor) - Полностью перезапустите агента
- Проверьте, что
tokensaveнаходится в вашем PATH:which tokensave
Отсутствующие символы в поиске
- Запустите
tokensave sync, чтобы обновить индекс - Проверьте, поддерживается ли язык (см. таблицу выше)
- Убедитесь, что файл не исключён через
.gitignore
Индексирование медленное
Большие проекты требуют больше времени при первом полном индексировании.
- Последующие запуски используют инкрементальную синхронизацию и работают намного быстрее
- Используйте
tokensave sync(не--force) для ежедневных обновлений - Устаревание проверяется автоматически при каждом вызове MCP-инструмента, пока агент подключён
Отключение tokensave для конкретных проектов
Если проект слишком большой и tokensave использует слишком много оперативной памяти, вы можете отключить MCP-сервер для конкретного проекта, установив TOKENSAVE_DISABLE_SERVER=true в его окружении. Сервер завершает работу корректно без инициализации.
Claude Code — добавьте в .claude/settings.json вашего проекта:
{
  "mcpServers": {
    "tokensave": {
      "command": "tokensave",
      "args": ["serve"],
      "env": {
        "TOKENSAVE_DISABLE_SERVER": "true"
      }
    }
  }
}
Другие агенты — установите переменную окружения в конфигурации, которую ваш агент использует для запуска MCP-серверов.
Вы также можете установить её глобально через оболочку (TOKENSAVE_DISABLE_SERVER=true claude), но это отключит MCP-сервер tokensave для всех проектов в сессии.
DISABLE_TOKENSAVE=true остаётся поддерживаемым как устаревший совместимый псевдоним для конфигураций, созданных до того, как эта переменная была помещена в пространство имён.
Происхождение
Этот проект — порт оригинальной реализации CodeGraph на TypeScript от @colbymchenry на Rust. Порт сохраняет ту же архитектуру и интерфейс MCP-инструментов, используя Rust для производительности и нативных привязок tree-sitter.
Сборка
cargo build --locked --release                          # full (50+ languages, default)
cargo build --locked --release --features medium        # medium tier
cargo build --locked --release --no-default-features    # lite (smallest binary)

cargo test --workspace --locked                         # run all tests (requires full)
cargo check --locked --no-default-features              # verify lite compiles
cargo clippy --workspace --all-targets --locked
Команды разработки используют отладочные сборки; установка использует только оптимизированные релизные выходные данные
(cargo install --path . --locked). target/debug никогда не является входным файлом для установки.
История звёзд

Спонсоры
| Бесплатная подпись кода на Windows предоставлена SignPath.io, сертификат от SignPath Foundation |
Лицензия
Лицензия MIT — см. LICENSE для подробностей.