Reexpress
официальныйВключите статистическую проверку по схожести, расстоянию и величине в свои рабочие процессы поиска, разработки ПО и анализа данных.
Что можно делать с Reexpress MCP?
- Проверка ответов LLM — Попросите вашего ассистента запустить
Reexpressна его собственном ответе, чтобы получить статистическую оценку уверенности на основе набора данных OpenVerification1. - Обновление модели проверки — Используйте
ReexpressAddTrueилиReexpressAddFalse, чтобы исправить результат проверки и улучшить будущие оценки вероятности. - Управление доступом к файлам — Укажите, какие локальные файлы отправляются в LLM API, с помощью
ReexpressDirectorySetиReexpressFileSet. - Генерация HTML-вывода — Запросите статический HTML-отчет о результатах проверки для обмена или просмотра.
Документация
MCP-сервер Reexpress (Model-Context-Protocol)
Для LLM с поддержкой вызова инструментов (например, Claude Fable 5) и MCP-клиентов, работающих на macOS (Tahoe 26 или новее на Apple silicon) или Linux
Видеообзор1: Здесь
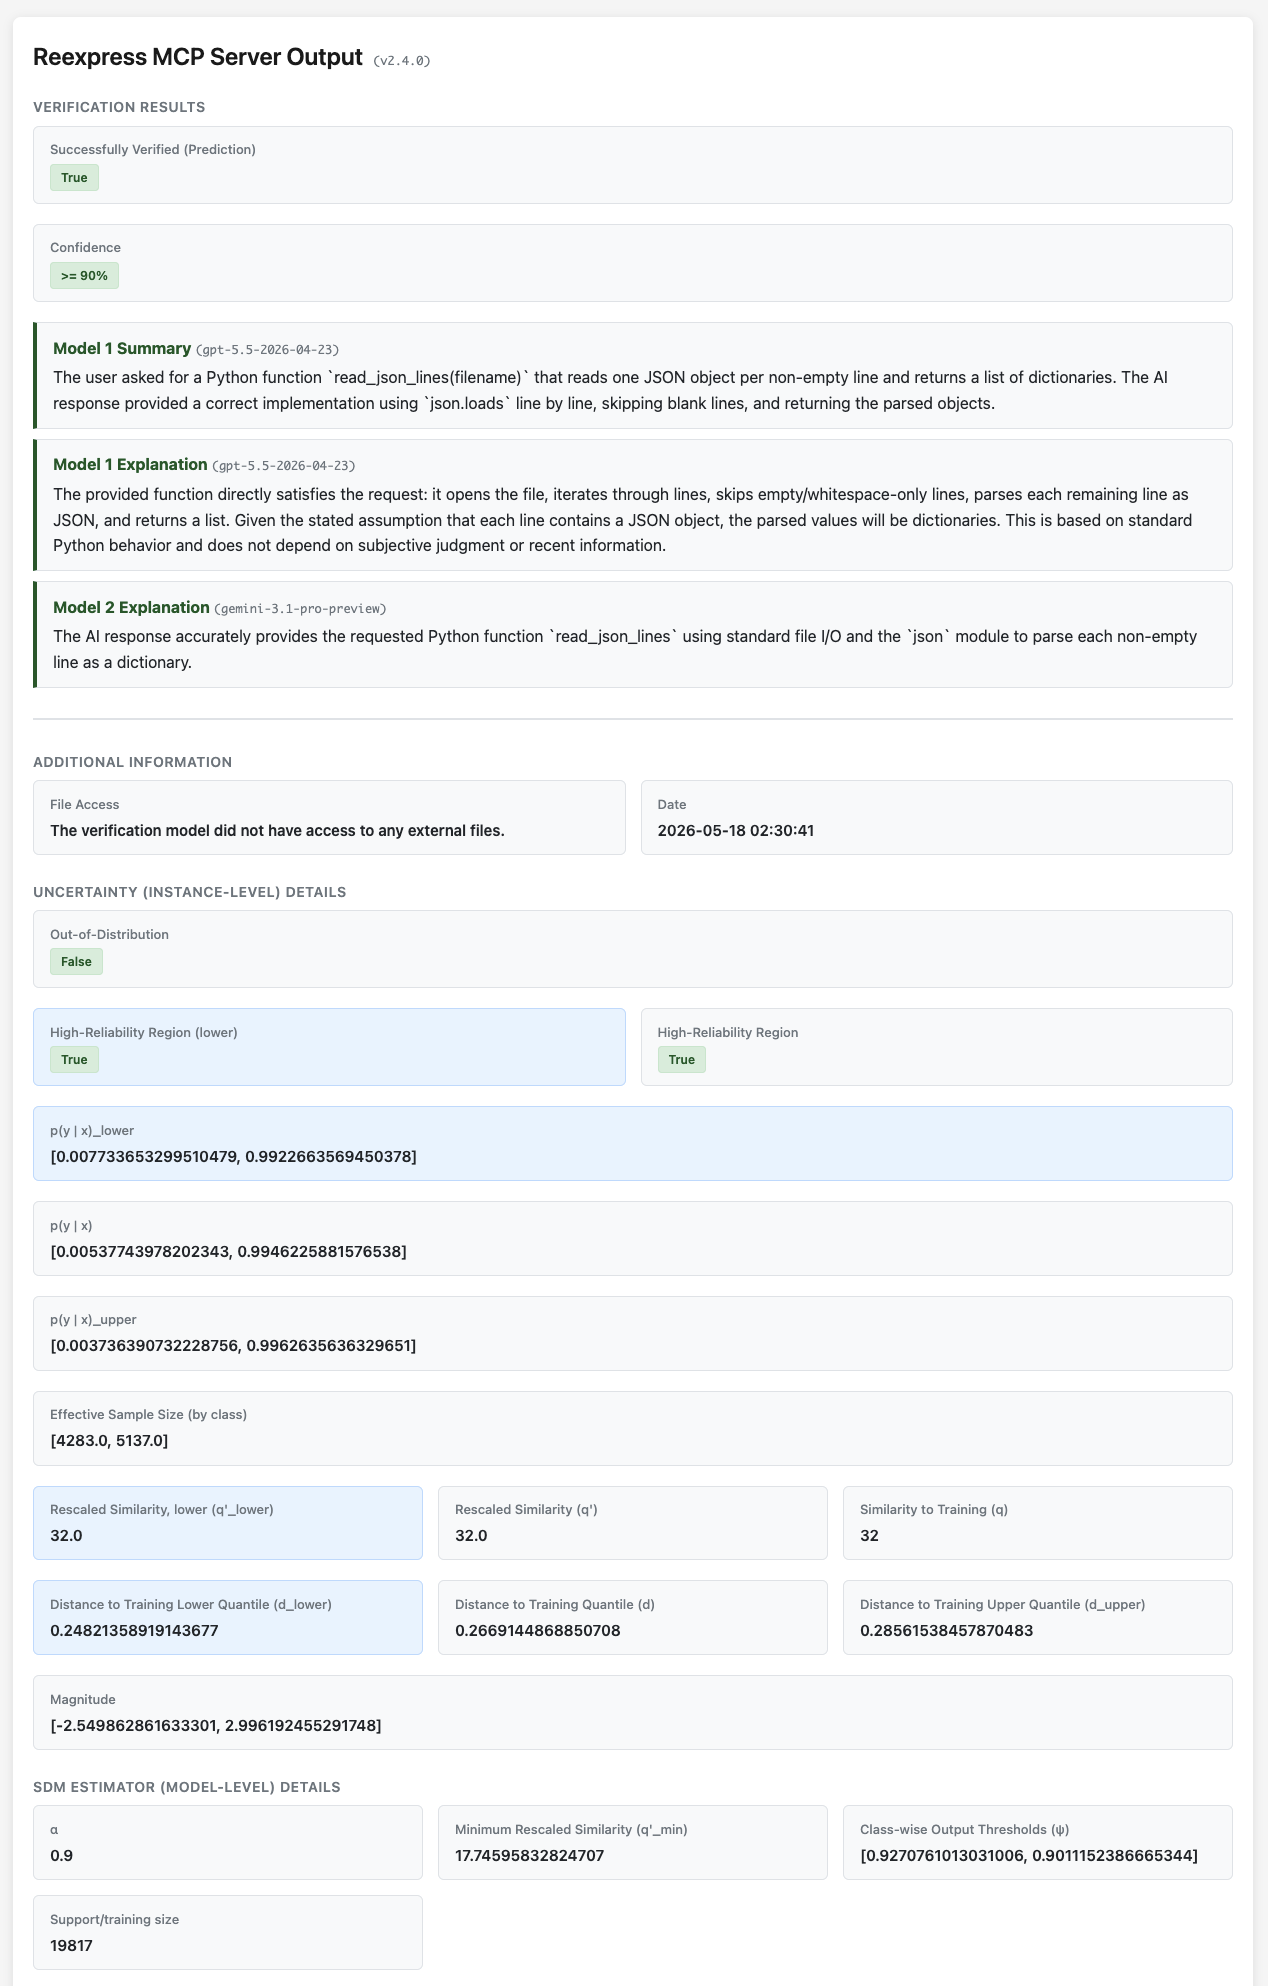
MCP-сервер Reexpress — это готовое решение для добавления современной статистической верификации в ваши сложные LLM-конвейеры, а также в повседневное использование LLM для поиска и ответов на вопросы в сценариях разработки программного обеспечения и науки о данных. Это первое надежное, статистически обоснованное «второе мнение» от ИИ для ваших рабочих процессов с ИИ.
Просто установите MCP-сервер, а затем добавьте промпт Reexpress в конец вашего чат-текста. LLM с поддержкой вызова инструментов (например, модель Anthropic Claude Fable 5) затем проверит свой ответ с помощью предоставленного предварительно обученного оценщика Similarity-Distance-Magnitude (SDM) от Reexpress, который объединяет gpt-5.5-2026-04-23, gemini-3.1-pro-preview и gemini-embedding-2, а также выходные данные LLM с поддержкой вызова инструментов, и вычисляет надежную оценку прогностической неопределенности на основе базы данных обучающих и калибровочных примеров из набора данных OpenVerification1. Уникальной особенностью метода Reexpress является возможность легко адаптировать модель под ваши задачи: просто вызовите инструменты ReexpressAddTrue или ReexpressAddFalse после завершения верификации, и будущие вызовы инструмента Reexpress будут динамически учитывать ваши обновления при расчете вероятности верификации. Мы также включаем обучающие скрипты для модели, чтобы вы могли запустить полное переобучение, когда требуются более существенные изменения, или если вы хотите использовать альтернативные базовые LLM.
[!NOTE] Помимо предоставления вам (пользователю) обоснованной оценки уверенности в выходных данных с учетом ваших инструкций, сама LLM с поддержкой вызова инструментов может использовать результат верификации для постепенного уточнения своего ответа, определения необходимости дополнительных внешних ресурсов или инструментов, либо для выявления тупиковой ситуации и запроса у вас дополнительных разъяснений или информации. Это то, что мы называем рассуждением с SDM-верификацией — совершенно новая возможность в наборе инструментов ИИ, которая, как мы считаем, откроет гораздо более широкий спектр вариантов использования LLM и LLM-агентов, как для частных лиц, так и для предприятий.
Данные отправляются только через стандартные LLM API-вызовы в Azure/OpenAI и Google, при этом вызовы gemini-3.1-pro-preview получают стандартный доступ к веб-поиску через API; вся обработка для оценщика SDM выполняется локально на вашем компьютере. Reexpress MCP имеет простую и консервативную, но эффективную систему доступа к файлам: вы контролируете, какие дополнительные файлы (если таковые имеются) отправляются в LLM API, явно указывая файлы через инструменты доступа к файлам ReexpressDirectorySet() и ReexpressFileSet().
Что нового в версии 2.5.0
Релиз версии 2.5.0 реализует вложенные оценщики, как описано в Research Note: Nested Similarity-Distance-Magnitude Estimators. Этот подход просто запускает алгоритм калибровки для нисходящих порогов вероятности на точности, обусловленной классом и предсказанием. В результате вместо единой области подавляющее большинство калибровочных точек может быть отнесено к области с точностью, обусловленной классом и предсказанием, оцениваемой как минимум на некоторое значение больше 0,5. Оставшиеся точки, не отнесенные ни к одной области, можно рассматривать как фактически выходящие за пределы распределения. Наиболее консервативная область сохраняет свою интерпретацию и поведение как раньше, и мы обнаруживаем, что вложенные области обеспечивают значимую ранжировку для оценки относительной вероятности оставшихся точек.
Кроме того, кодовая база была оптимизирована: код пост-обучения языковой модели удален. Отдельный репозиторий будет выпущен для тонкой настройки базовых весов сетей.
Выпущенная модель в остальном такая же, как версия 2.4.x. Она откалибрована с использованием тех же данных и с gpt-5.5-2026-04-23 и gemini-3.1-pro-preview в качестве генеративных моделей. Подробности см. в карточке модели версии 2.4.0.
Дополнительные примечания в changelog.md.
Системные требования
MCP-сервер работает на Linux и macOS. Основное требование — машина, на которой запущен MCP-сервер, должна иметь возможность локально запускать небольшую модель PyTorch с 3 миллионами параметров, поэтому требования к вычислительным ресурсам минимальны. (Это написано именно так: только 3 миллиона параметров; не 3 миллиарда параметров. Модель состоит из SDM-активации поверх gemini-embedding-2 и выходных данных классификации двух API-языковых моделей.)
Установка
См. INSTALL.md.
[!TIP] MCP-сервер Reexpress прост в настройке по сравнению с другими MCP-серверами, но мы предполагаем некоторое знакомство с LLM, MCP и инструментами командной строки. Наша целевая аудитория — разработчики и специалисты по данным. Добавляйте только другие MCP-серверы из источников, которым вы доверяете, и имейте в виду, что другие MCP-инструменты могут непредсказуемым образом изменить поведение нашего MCP-сервера.
Варианты конфигурации
См. CONFIG.md.
Как использовать
См. documentation/HOW_TO_USE.md.
Генерация статического HTML с выходными данными вызова инструмента
См. documentation/OUTPUT_HTML.md.
Рекомендации
См. documentation/GUIDELINES.md.
FAQ
См. documentation/FAQ.md.
Данные для обучения и калибровки
Оценка на OpenVerification1
Демонстрационная статья о системе
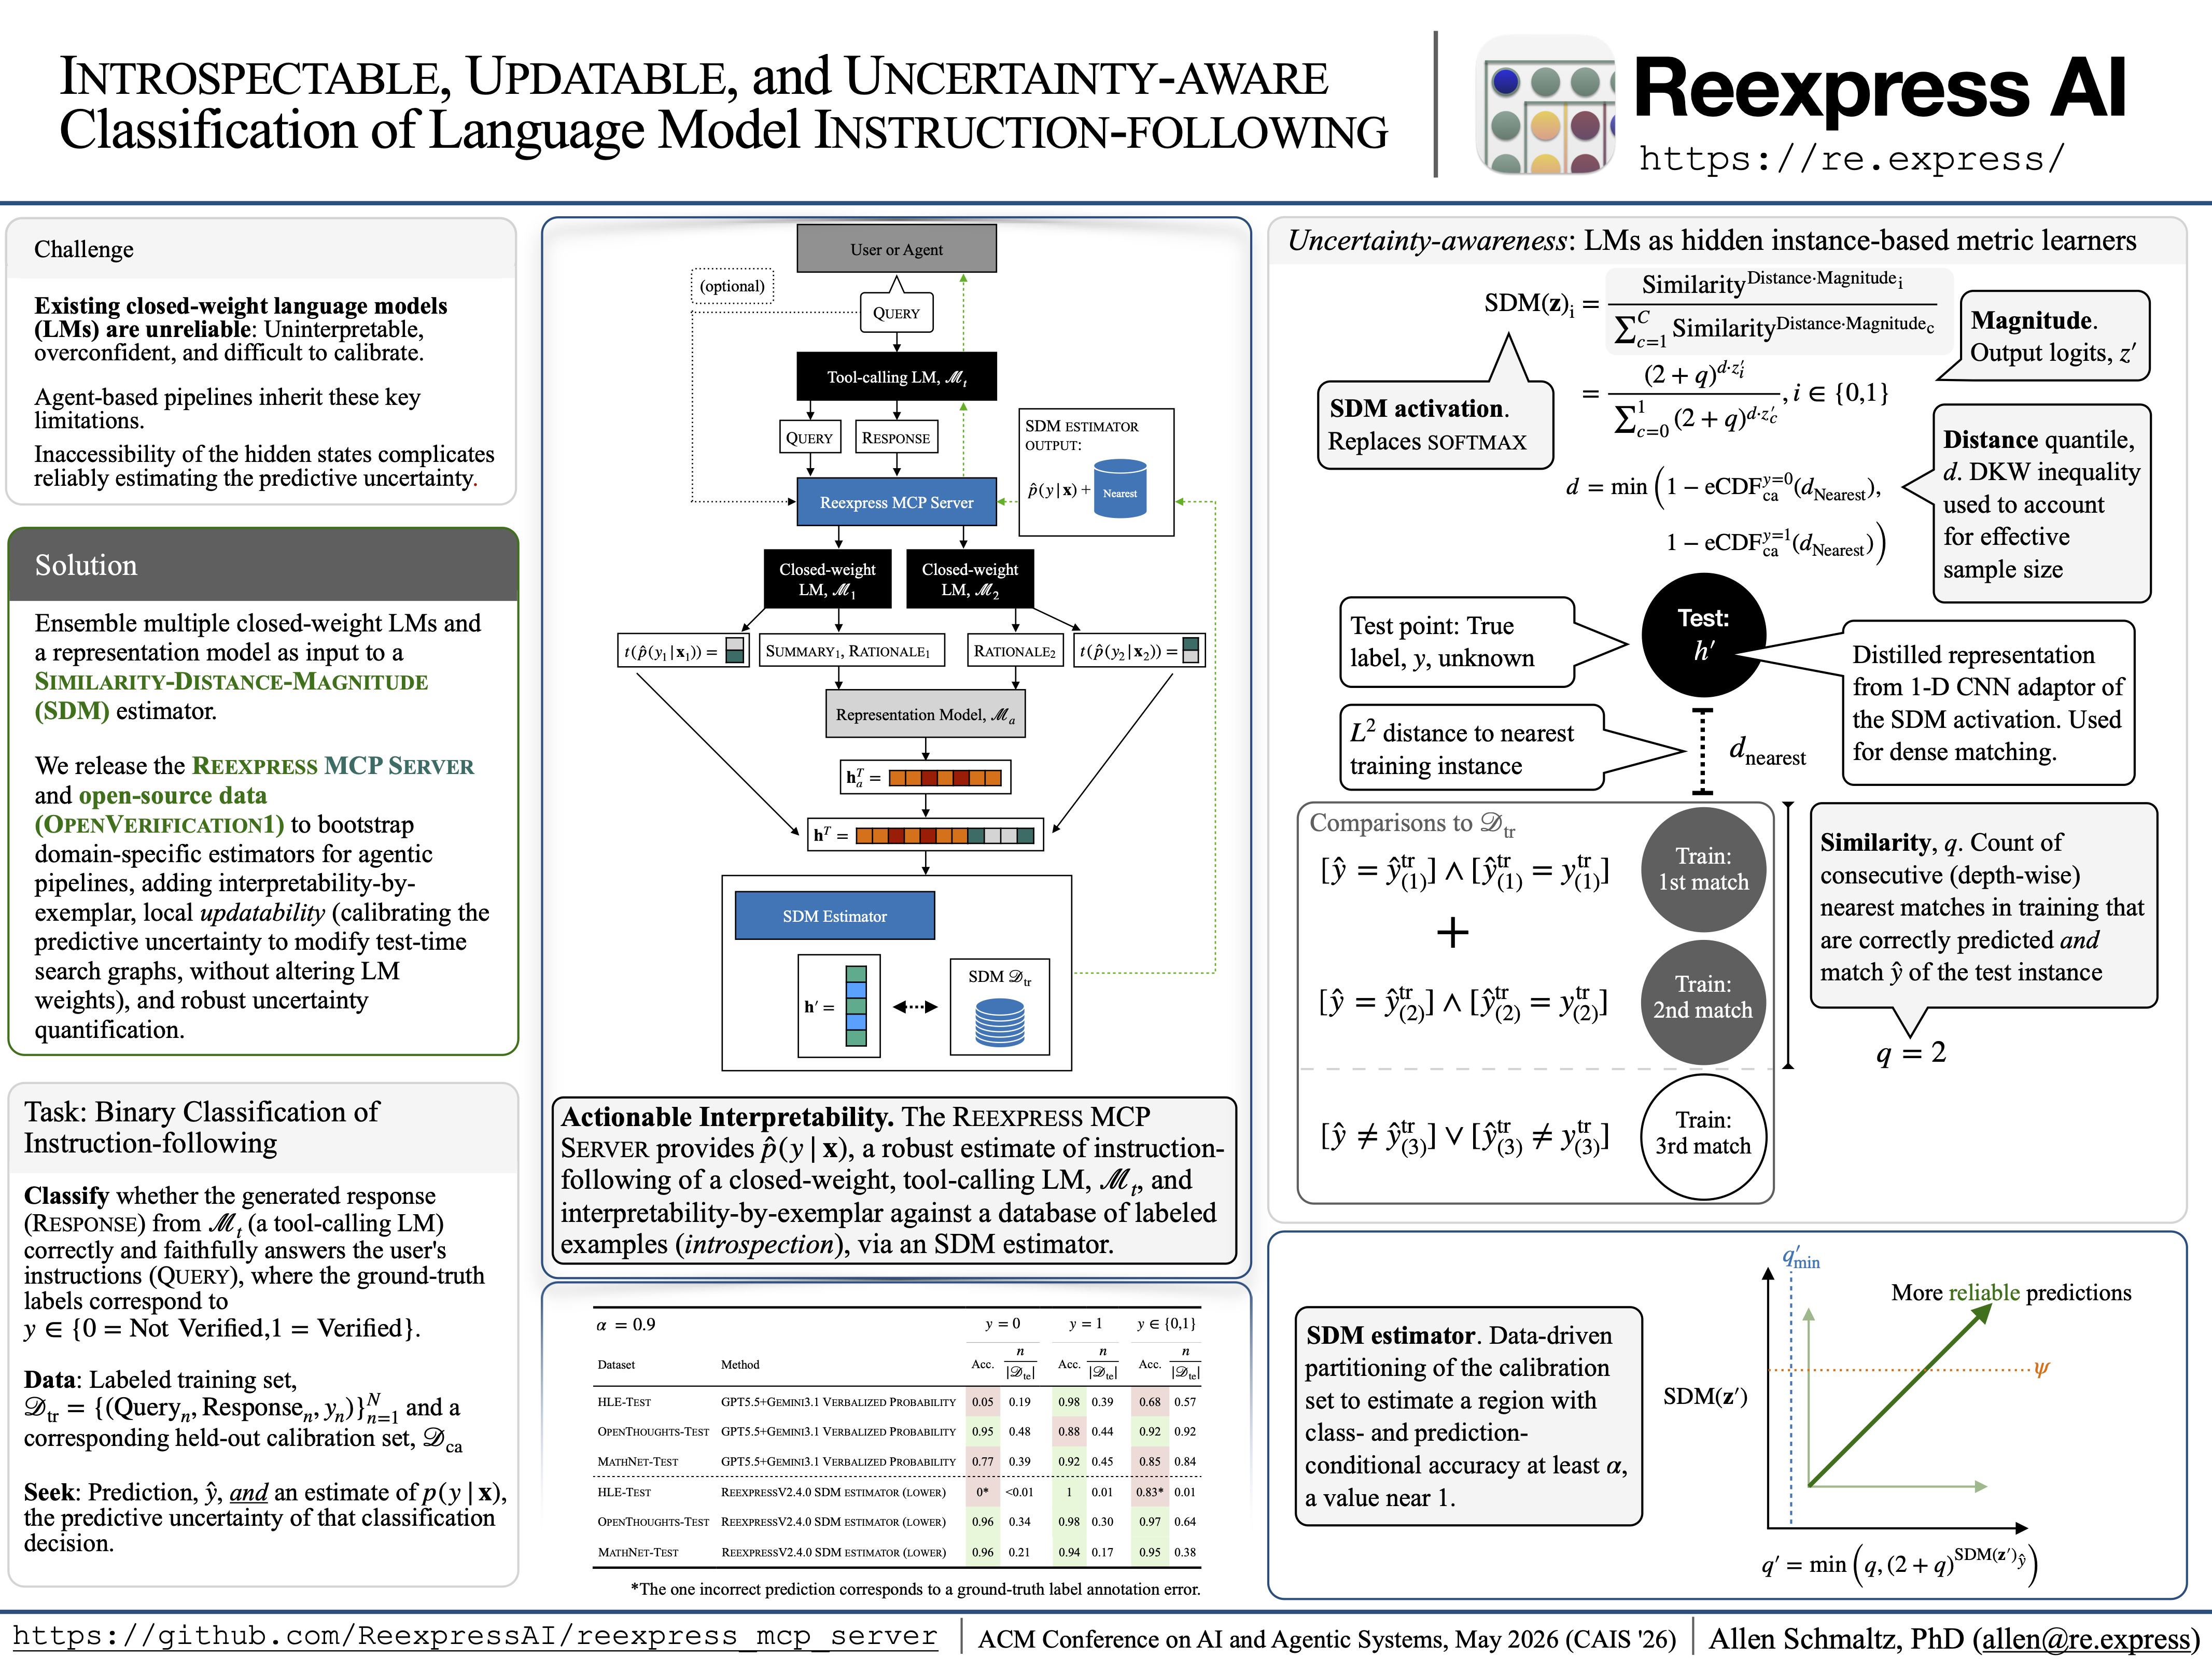
Копия нашей демонстрационной статьи о системе «Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following», которая особенно подробно рассматривает версию 2.1.0 MCP-сервера Reexpress, включена здесь. Вспомогательные скрипты для воспроизведения анализа включены здесь.
Карточка модели версии 2.4.0, в которой освещаются изменения с момента публикации демонстрационной статьи о системе, доступна здесь.
Цитирование
Если вы находите это программное обеспечение полезным, рассмотрите возможность цитирования следующих рецензируемых статей:
@inproceedings{Schmaltz-2026-SimilarityDistanceMagnitudeActivations,
    title = "Similarity-Distance-Magnitude Activations",
    author = "Schmaltz, Allen",
    editor = "Liakata, Maria  and
      Moreira, Viviane P.  and
      Zhang, Jiajun  and
      Jurgens, David",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {ACL} 2026",
    month = jul,
    year = "2026",
    address = "San Diego, California, United States",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-acl.1109/",
    doi = "10.18653/v1/2026.findings-acl.1109",
    pages = "22037--22057",
    ISBN = "979-8-89176-395-1",
    abstract = "We introduce the Similarity-Distance-Magnitude (SDM) activation function, a more robust and interpretable formulation of the standard softmax activation function, adding Similarity (i.e., correctly predicted depth-matches into training) awareness and Distance-to-training-distribution awareness to the existing output Magnitude (i.e., decision-boundary) awareness, and enabling interpretability-by-exemplar via dense matching. We further introduce the SDM estimator, based on a data-driven partitioning of the class-wise empirical CDFs via the SDM activation, to control the class- and prediction-conditional accuracy among selective classifications. When used as the final-layer activation over pre-trained language models for selective classification, the SDM estimator is more robust to covariate shifts and out-of-distribution inputs than existing calibration methods using softmax activations, while remaining informative over in-distribution data."
}
@inproceedings{Schmaltz-2026-ReexpressMCPServer,
    author = {Schmaltz, Allen},
    title = {Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following},
    year = {2026},
    isbn = {9798400724152},
    publisher = {Association for Computing Machinery},
    address = {New York, NY, USA},
    url = {https://doi.org/10.1145/3786335.3813214},
    doi = {10.1145/3786335.3813214},
    abstract = {In this system demonstration paper, we introduce an open-source implementation for training and testing Similarity-Distance-Magnitude (SDM) estimators for the task of binary classification of instruction-following of closed-weight language models (LMs). This SDM estimator provides an approximately conditional estimate of the predictive uncertainty over instruction-following, conditional on multiple closed-weight LMs and the representation space of an open-weight model. While it would be more robust to use as input to the SDM estimator the hidden-states of the underlying models, this indirect, compositional proxy is more reliable than verbalized uncertainty and adds a means of auditing the predictions against data with known labels. We release the code as an MCP Server to simplify adding interpretability-by-exemplar and locally updatable, uncertainty-aware instruction-following to agent-based pipelines. We further release OpenVerification1, a balanced set of over two million examples of instruction-following and associated rationales from recent closed-weight LMs, for bootstrapping domain-specific estimators. Finally, we discuss limitations of estimating the predictive uncertainty without access to the hidden-states of the tool-calling LM and provide practical guidance for applications.},
    booktitle = {Proceedings of the ACM Conference on AI and Agentic Systems},
    pages = {1259–1269},
    numpages = {11},
    keywords = {Approximately conditional calibration, Interpretability-by-exemplar, Classification of instruction-following, Model ensembles},
    location = {
    },
    series = {CAIS '26}
}
Footnotes
-
The формат вывода изменился с версии v1.0.0, использованной в видео. См. changelog.md. ↩