Longhand
Memória local persistente para Claude Code, zero chamadas de API, zero resumos, zero IA decidindo o que importa.
Documentação
Longhand
Também usa Codex? Compartilhe um arquivo de memória entre Claude Code e Codex.



Memória local persistente para Claude Code. Cada chamada de ferramenta, cada edição de arquivo, cada bloco de raciocínio de cada sessão do Claude Code — armazenado verbatim na sua máquina. Pesquisável, reproduzível e recuperável por perguntas difusas em linguagem natural. Zero chamadas de API. Zero resumos. Zero decisões tomadas por uma IA sobre o que vale a pena lembrar.
O Claude Code rotaciona silenciosamente seus arquivos de sessão após algumas semanas. O Longhand os captura em SQLite antes que desapareçam. Uma vez ingeridos, seu histórico permanece para sempre — mesmo depois que os arquivos JSONL de origem forem excluídos. Instale cedo; o passado que você não capturar é irrecuperável.
Se você tem 20+ sessões do Claude Code em
~/.claude/projects/, o Longhand pode pesquisar em cada correção, decisão e conversa que você teve em ~29ms — sem uma única chamada de API.
Ele usa muitos tokens? Não — as ferramentas que você usará mais são limitadas por design. Uma
recallcompleta em 100+ sessões retorna ~4K tokens. Ler um JSONL de sessão bruto custa 10–50× mais. Veja Orçamento de tokens para saber quais ferramentas limitam a saída e quais não.
pip install longhand
longhand setup        # ingest history + install hooks + configure MCP
longhand recall "that stripe webhook bug from last week"
Quer testar primeiro? Execute longhand demo para um passo a passo de 60 segundos em um corpus de exemplo com 3 sessões falsas — seus ~/.claude e ~/.longhand reais não são tocados. A demonstração semeia um armazenamento isolado com um bug de webhook do Stripe + migração de autenticação do Supabase + correção de 401 downstream, e então executa recall entre sessões e status do projeto para que você veja como é a saída antes de se comprometer.
pip install longhand
longhand demo         # sandboxed; cleans up afterwards (pass --keep to explore)
Atualizando para 1.0.0? Esta é a versão que fecha a janela de depreciação aberta pela 0.13. Tudo o que foi removido aqui já estava com aviso desde a 0.13.0:
- Quatro aliases de CLI desapareceram:
patterns→recall "<topic>",recap→status --days N,continue→status --session <prefix>,reanalyze→analyze --all. - A ferramenta MCP
reconcileagora usa execução simulada (dry run) por padrão. Se você tem um loop de agente que dependia da correção implícita, passefix=trueexplicitamente. As execuções simuladas informam isso no payload. - Seis ferramentas MCP aposentadas saíram da listagem (19 → 13), mas ainda respondem para sempre com uma nota de migração — nomes aposentados vivem nos próprios arquivos
CLAUDE.mddos usuários e nunca devem falhar. - Novo: COMPATIBILITY.md declara o que a 1.x garante e o que não garante.
Seu banco de dados não precisa de nada. As migrações são automáticas e um armazenamento 0.11+ abre em qualquer 1.x posterior — essa é a Promessa 2, e há um fixture real de esquema 0.11 no conjunto de testes provando isso.
Atualizando para 1.2.x? Sem remoções, apenas correções que vale a pena conhecer:
- 1.2.3: O
taildoget_session_timelinedo MCP agora retorna os verdadeiros últimos N eventos em sessões com mais de 5.000 eventos — antes retornava o meio. A dica de fechamento dosetupparou de sugerirrecap(removido na 1.0) e agora sugerestatus --days 7. Os rodapés do Recall e a descrição da própria ferramentaget_session_timelinepararam de nomearsearch_in_context(aposentado da listagem de ferramentas na 1.0, embora ainda responda) e agora apontam parasearch— os rodapés detalham a chamada,search(session_id=…, query=…, context_events=5). - 1.2.2: O
recallinforma quando sua melhor correspondência é muito mais antiga que as alternativas, em vez de deixar uma correção desatualizada parecer atual (veja Exemplo de Recall). Um registro de compactação de contexto do Codex (compacted) não dispara mais o aviso de desvio de formato de transcrição dodoctor. - 1.2.1: O
get_session_timelinedo MCP tinha um bug de sentinela que fazia cada chamada retornar exatamente um evento, ignorandolimit/offset, a menos quetailfosse passado explicitamente — corrigido. O escopo automático de projeto dosearchnão substitui mais umsession_idexplícito.
Atualizando para 0.13.0? Nada quebra — essa versão abriu a janela de depreciação da v1.0, então todo nome antigo continuou funcionando enquanto apontava para seu substituto:
statusagora é o único comando de retomada:statuspuro = resumo recente (erarecap),status <project>inalterado,status --session <prefix>= final da sessão (eracontinue). Os comandos antigos ainda rodam e imprimem um ponteiro; eles são removidos na v1.0.- Seis ferramentas MCP foram incorporadas em seis sobreviventes com parâmetros idênticos (
search_in_context→search+context_events,get_episode→find_episodes+episode_id, etc. — tabela completa no CHANGELOG). Os nomes aposentados ainda respondem, prefixados com uma nota de migração. - Hooks não podem mais sair com código diferente de zero — falhas viram breadcrumbs em
~/.longhand/logs/e duas novas linhasdoctor(Hook errors,Transcript format) as mantêm visíveis. - As janelas de recall "Hoje"/"ontem" agora seguem seu dia calendário local em vez do UTC; as classificações podem mudar uma vez se você não estiver no UTC.
- Usuários de Windows: esta versão corrige um bug sério em que a verificação de atividade do bloqueio de ingestão poderia encerrar outros processos do longhand.
- Novo:
LONGHAND_DATA_DIRrealoca o armazenamento para a CLI, hooks e servidor MCP em um único movimento — excetolonghand config --set, que sempre grava~/.longhand/config.jsonindependentemente do armazenamento realocado (#96;--editatualmente é um no-op, mesmo problema).status --json/doctor --jsonpara scripts.
Atualizando para 0.9.0? A ingestão ao vivo captura sessões em andamento, o histórico de planos é preservado como dado de primeira classe, e um trabalho opcional de reconciliação mantém o índice honesto em segundo plano:
- O novo comando
longhand ingest-liveroda a partir do hookStopdo Claude Code para acompanhar a transcrição ativa entre turnos do assistente. A sessão em andamento se torna consultável imediatamente vialist_sessions,get_session_timeline/timeline,get_file_historyereplay_file— ele grava apenas eventos, sem embeddings, entãorecalle osearchsemântico ainda precisam da passagem SessionEnd (ou de uma passagemreconcile --fix, que re-ingere com análise) para vê-la. - O novo comando
longhand plans liste a ferramenta MCPlist_plansexpõem cada Write/Edit em~/.claude/plans/*.mdem todo o seu histórico. Planos agora são extraídos como entidade própria, junto aos episódios. - O novo
longhand schedule install-reconcilerinstala um trabalho opcional do launchd que executareconcile --fixperiodicamente — captura qualquer coisa que os hooks ao vivo e pós-sessão perderam, sem que você precise pensar nisso. - O hook Stop coexiste com o hook SessionEnd existente: o ao vivo acompanha a transcrição enquanto ela cresce; o SessionEnd faz a passagem completa de análise quando a sessão fecha.
Atualizando para 0.8.1? Sinais de desatualização agora se propagam para todos os lugares certos, e reconcile é uma ferramenta MCP — o Claude pode autocorrigir o índice de dentro de uma sessão:
searchelist_sessionsagora envolvem a resposta comstale: true+stale_reasonquando o projeto ao qual estão escopados tem transcrições em disco ainda não ingeridas. Antes da v0.8.1, eles retornavam resultados vazios de aparência limpa (a mesma forma de falha silenciosa querecall_project_statusfoi criado para capturar — apenas uma camada acima).- A nova ferramenta MCP
reconcileenvolvelonghand reconcile --fix. Após um banner de desatualização disparar, o Claude chamareconcilediretamente em vez de pedir ao usuário para executar um comando CLI. - O
limitpadrão dolist_sessionssubiu de 20 para 50 — dias ativos rotineiramente cruzam 5+ projetos em 5+ sessões; o padrão antigo truncava revisões silenciosamente.
Atualizando da 0.7.x ou anterior? Narrativas de recall mais limpas, além de uma camada real de testes de detecção de bugs por baixo (desde a 0.8.0):
- O
_compose_fix_summaryanterior à v0.8 prefixava um rótulo literal"Intent:"em metade de todos os episódios extraídos (49% do corpus de referência). O rótulo vazava em toda narrativa de recall desses episódios. A migração v4 o remove das linhas existentes na primeira abertura do armazenamento — nenhum comando necessário. - O conteúdo de diff em
fix_summaryagora é truncado nos limites de espaços em branco com um…visível, em vez de cortar no meio de um token (phoneNum',family?:',strin'). Somente para frente. - As linhas de rodapé "Outras correspondências" da narrativa agora incluem o ID da sessão para que você possa aprofundar.
- Novo harness canário (
tests/fixtures/corpus/) ancora testes de regressão a bugs reais enviados. Novo validador de recall (scripts/recall_diff.py) captura e compara resultados de classificação com seu corpus ao vivo — detecta regressões que o pytest não vê.
pip install --upgrade longhand
longhand recall "..."   # migration runs transparently on first open
Se você também está vindo da 0.5.x, execute longhand reconcile --fix uma vez para reatribuir sessões multiprojeto conforme as melhorias de inferência da v0.6 (sessões cd-em-projeto agora são atribuídas ao projeto onde a maior parte do trabalho aconteceu, não ao cwd do primeiro evento). Se você está na 0.5.8 ou anterior, encadeie-os: longhand reconcile --fix && longhand analyze --all. Ambos são idempotentes.
Histórico grande? (>1 GB de ~/.claude/projects) Espere que o preenchimento inicial leve de 10 a 30 minutos em um Mac da série M — a maior parte desse tempo é o modelo de embeddings rodando em todos os seus núcleos (é por isso que você verá uso de CPU de três dígitos; isso é o ONNX fazendo seu trabalho, não um travamento). --skip-analysis adia a outra passagem — extração de episódios/segmentos e vetores de nível de projeto/sessão — não o embedding de eventos, que sempre roda, então reduz um pouco o tempo, mas não o custo dominante:
longhand setup --skip-analysis   # events stored + embedded; episodes/segments deferred
longhand analyze --all           # fill in episodes + segments + project/session vectors whenever, safe to background
search, linhas do tempo, histórico de arquivos e consulta de commits funcionam imediatamente após --skip-analysis — todo evento é incorporado independentemente dessa flag. A narrativa de episódios/segmentos do recall e o recall_project_status precisam da passagem analyze --all para ter dados para usar. A taxa de transferência típica em um Mac da série M é de ~1–2 sessões/segundo para análise completa.
Status: v1.2.3 — estável, testado em uso diário, auditado em segurança (zero achados críticos), no PyPI, disponível como plugin do Claude Code. Validado contra 792 sessões reais (786 Claude Code, 6 Codex) em 45 projetos inferidos (medido em 2026-09-27). 617 testes unitários passando.
Documentação completa: Wiki do Longhand — primeiros passos, referência da CLI, referência das ferramentas MCP, arquitetura e solução de problemas.
A Inversão
Todos estão resolvendo a memória de IA aumentando a janela de contexto. 1M de tokens. 2M de tokens. Contexto infinito. A indústria inteira está correndo na mesma direção: fazer o modelo carregar mais estado.
O Longhand vai na direção oposta. O modelo não precisa carregar a memória. O disco carrega.
| Janelas de contexto maiores | Longhand | |
|---|---|---|
| Onde vive | Alugado de um provedor de modelo | Um arquivo SQLite + ChromaDB no seu laptop |
| Custo por consulta | Tokens × dólares | Zero |
| Privacidade | Passa pelos servidores de terceiros | Nunca sai da sua máquina |
| Velocidade | Segundos a minutos para contextos grandes | ~29ms de busca · ~128ms de recall completo (quente; veja Estatísticas) |
| Perda | A atenção degrada no meio de contextos longos | Nada é resumido — mensagens, edições e blocos de raciocínio armazenados verbatim† |
| Persistência | Morre quando a janela fecha | Vive até você excluir o arquivo |
| Entre versões de modelo | Não transfere | Mesmos dados, qualquer modelo |
| Offline | Não | Sim |
| Escala com | Preço do provedor | Seu disco rígido |
† Nove tipos de entrada do Claude Code (KNOWN_SKIP_ENTRY_TYPES) e, no lado do Codex, três tipos de registro de nível superior (CODEX_SKIP_RECORD_TYPES) mais dez tipos de event_msg (CODEX_SKIP_EVENT_MSG_TYPES: os espelhos de UI das mensagens canônicas e a contabilidade de turnos) — em sua maioria mera contabilidade do harness (marcadores de fila, pings de progresso, snapshots de uso e estado) — são reconhecidos e ignorados em vez de armazenados. Isso não é exatamente "zero conteúdo descartado", no entanto: um desses tipos, attachment, pode carregar um prompt de acompanhamento enfileirado em seu próprio campo attachment.prompt, e os registros de raciocínio criptografado e compactação de contexto (compacted) do Codex são descartados por completo. Todo o resto com conteúdo real — cada mensagem comum, chamada de ferramenta, edição de arquivo e bloco de pensamento — é mantido verbatim. |
A "crise de memória" na IA foi uma restrição artificial. Armazenamento está resolvido. SQLite é de 2000. ChromaDB é um armazenamento vetorial de código aberto maduro. Ambos rodam em um laptop. O Longhand contorna a crise ignorando-a — suas sessões passadas já estão no disco, escritas pelo próprio Claude Code, em arquivos JSONL que contêm cada evento individual verbatim. O Longhand lê esses arquivos, indexa-os localmente e oferece recordação semântica de todo o seu histórico sem nunca enviar um token pela API de outra pessoa.
Local. Completo. Seu.
Espaço de armazenamento: ~7,5GB para um usuário pesado (792+ sessões, 269k+ eventos, meses de uso diário do Claude Code em 45 projetos inferidos — medido em 2026-09-27, veja Stats). Usuários típicos: 200–400MB. Quando o Claude Code rotaciona os arquivos de origem do disco, o Longhand não é uma duplicata — é a única cópia.
Suporte de plataforma
Python 3.10 – 3.14 são todos totalmente suportados e controlados no CI — a proteção de branch exige que a suíte completa passe em todas as cinco versões antes de um PR ser mesclado (administradores podem contornar isso — veja CONTRIBUTING.md).
O Longhand fixa chromadb<1.0 para cada versão do Python, não apenas a 3.14. A fixação originou-se com as bindings Rust mais novas do chromadb causando segfault na 3.14 (#4, agora fechado), e permanece até que um chromadb 1.x seja verificado em toda a matriz.
Windows não é suportado. Use WSL2. Uma etapa windows-latest × py3.12 roda em cada PR, mas é uma etapa continue-on-error não bloqueante — e ela falha. 12 testes principais falham em cada execução (idempotência de instalação/desinstalação de hooks, caminhos de arquivos de configuração, redação, contagem de linhas de ingestão ao vivo, limpeza de demo e mais — rastreados em #112), não casos extremos instáveis. O job mostra verde na UI do GitHub apenas porque continue-on-error engole a etapa falha; é coleta de evidências, não uma afirmação de que o Longhand funciona lá. Linux (3.10–3.14) é a única plataforma que o CI realmente controla; não há etapa macOS. macOS é o sistema operacional diário do autor e onde é validado manualmente (veja Stats), mas não é verificado independentemente no CI.
Duas coisas são específicas do macOS independentemente da matriz de CI: schedule install-reconciler instala um job launchd e é um no-op em outros lugares (use cron/systemd-user no Linux; no Windows, use WSL2). mcp install também só escreve o caminho de configuração do Claude Desktop no macOS (#105) — não há versão do Claude Desktop para Linux, e Windows não é suportado (#112); conectar um Claude Desktop do Windows a uma instalação WSL2 significaria editar manualmente sua configuração para iniciar o Longhand via wsl.exe, o que não é testado.
Threads do Codex Desktop e Codex CLI são capturados no mesmo arquivo desde a 1.1.0 — veja Works with Codex.
Compatibilidade
O Longhand 1.0 faz cinco promessas, cada uma respaldada por um artefato de aplicação no repositório. O texto completo está em COMPATIBILITY.md; a versão resumida:
- Superfície estável — CLI e MCP congelados durante a 1.x. Remoções apenas em uma versão principal, e somente após aviso por uma versão menor completa.
- Compatibilidade de dados futura — um banco de dados escrito pela 0.11+ abre em qualquer 1.x posterior. Migrações são automáticas, únicas, nunca renumeradas. Código mais antigo recusa um banco de dados mais novo de forma ruidosa em vez de operar às cegas.
- Garantias de hooks — hooks nunca lançam exceções, nunca tocam a rede, nunca bloqueiam seu prompt.
- Deriva upstream nunca é silenciosa — entradas de transcrição desconhecidas são preservadas, expostas em
doctore controladas por regressão. - Métricas honestas — contagens refletem sinais reais, e
doctornunca recomenda um remédio que não pode funcionar.
Política de depreciação: qualquer coisa destinada à remoção avisa por pelo menos uma versão menor completa primeiro, e o aviso nomeia seu substituto. Nomes de ferramentas MCP aposentados são a única coisa que nunca desaparece — eles saem da listagem de ferramentas, mas continuam respondendo para sempre com uma nota de migração, porque esses nomes vivem nos próprios arquivos CLAUDE.md dos usuários.
Longhand vs claude-mem
thedotmack/claude-mem é a ferramenta de memória do Claude Code mais popular no GitHub (55k+ estrelas). É uma boa ferramenta. Também está resolvendo o problema de memória na direção oposta ao Longhand, e a diferença vale a pena entender antes de escolher uma.
| claude-mem | Longhand | |
|---|---|---|
| O que é armazenado | Resumos gerados por IA / "observações" | Eventos verbatim do JSONL bruto |
| Quem decide o que é mantido | Um LLM, no momento da escrita | Ninguém — nenhum resumidor filtra |
| Compressão | Semântica (com perdas, por design) | Nenhuma (sem perdas) |
| Chamadas de API por sessão | Uma ou mais (chama o Claude para resumir) | Zero |
| Blocos de pensamento | Tipicamente incorporados nos resumos | Primeira classe, armazenados verbatim |
| Reprodução determinística | Não — resumos não podem reconstruir o estado do arquivo | Sim — cada diff é mantido e reproduzível |
| Portabilidade de modelo | Atado à saída do resumidor | Os mesmos dados funcionam em qualquer modelo, para sempre |
| Runtime | TypeScript, Bun, worker HTTP em :37777 | Python, sem servidor |
| Licença | AGPL-3.0 | MIT |
A divisão filosófica: o claude-mem pergunta a uma IA o que era importante e mantém isso. O Longhand mantém os bytes reais e deixa você decidir depois. Se você confia no julgamento de um modelo sobre seu próprio passado, a abordagem do claude-mem é mais barata no momento da consulta (pré-resumida) e mais leve no armazenamento. Se você já foi prejudicado por um resumo que descartou a coisa que acabou importando, o Longhand é a ferramenta que nunca joga nada fora.
Ambos podem coexistir na mesma máquina — eles operam nos mesmos arquivos JSONL sem interferir.
Os Princípios
O Longhand é construído sobre um punhado de princípios. Se você discorda deles, provavelmente quer uma ferramenta diferente.
1. A informação não desaparece — ela se move.
Quando os dados "somem", quase nunca estão realmente perdidos. Eles foram comprimidos, resumidos, arquivados em outro lugar ou renomeados. Encontre a fonte bruta e a verdade ainda está lá esperando. O Claude Code já escreve cada sessão no disco como JSONL. Esse arquivo é a fonte bruta. O Longhand apenas o lê.
2. Resumir é uma decisão com perdas disfarçada de conveniência.
A maioria dos sistemas de memória de IA lê uma conversa e pede à IA para anotar "o que importava". A IA agora é a guardiã de sua própria memória, e a IA tem incentivos — brevidade, confiança, coerência — que não são os mesmos da verdade. Você acaba com uma história sobre o que aconteceu em vez do que aconteceu.
O Longhand nunca resume. Ele armazena o registro completo e permite que você o consulte.
3. O registro bruto é barato. Agir como se não fosse o desperdiça.
Um arquivo JSONL completo do Claude Code tem kilobytes a poucos megabytes. Um ano de sessões diárias são centenas de megabytes. Isso não é nada no hardware moderno. Não há razão de engenharia para jogar os dados fora. Memória baseada em resumo não está economizando espaço — está doando informações que eram gratuitas.
4. O pensamento é a parte mais valiosa.
Quando o Claude produz um bloco thinking, esse é o raciocínio por trás da decisão — geralmente invisível para o usuário, quase sempre mais útil que a resposta final. Memória baseada em resumo joga fora os blocos de pensamento porque são "internos". O Longhand os trata como eventos de primeira classe. "O que eu estava pensando quando escolhi usar uma atualização condicional?" puxa o bloco de pensamento verbatim que contém a resposta.
5. Uma correção que você não pode reproduzir é uma correção que você não manteve.
Se você corrigiu um bug em março, o estado daquele arquivo quando o bug foi corrigido é um fato. O Longhand o reconstrói deterministicamente aplicando cada edição em sequência a partir do JSONL da sessão. Sem adivinhação, sem inferência de IA, apenas aplicação literal dos diffs. Você pode ver o estado exato de qualquer arquivo em qualquer ponto de qualquer sessão passada.
6. A memória deve ser proativa, não apenas pesquisável.
Um arquivo pesquisável é útil, mas passivo. Memória real responde a perguntas vagas. "Há alguns meses eu estava construindo um jogo que quebrava o tempo todo, então você o corrigiu — traga essa correção adiante." O Longhand analisa a frase de tempo, combina o projeto, encontra o episódio problema→correção e retorna o diff. Você não precisa saber o ID da sessão. Você só precisa lembrar que aconteceu.
7. Determinístico vence engenhoso.
Tudo na análise do Longhand é baseado em regras. Detecção de erros por regex. IDs de projeto baseados em hash. Extração de episódios por varredura direta. Sem LLMs no pipeline central. Isso significa rápido (~128ms de recall quente mediano — medido em 2026-09-27, veja Stats), reproduzível (mesma entrada → mesma saída) e totalmente local (sem chaves de API, sem nuvem). Uma camada de LLM poderia ser adicionada depois, mas a fundação roda em leis, não na opinião de um modelo.
8. Local ou nada.
Seu histórico do Claude Code é seu. Ele vai para um arquivo SQLite e um diretório ChromaDB em ~/.longhand/. Sem telemetria. Sem sincronização. Sem conta. Se seu laptop estiver offline, o Longhand funciona. Se a Anthropic cair, o Longhand funciona. Se você excluir o diretório, ele se foi.
Uma exceção chata, divulgada por completo: o CLI interativo verifica pypi.org por uma versão mais nova do Longhand. A maioria dos comandos respeita um cache de 24 horas e imprime qualquer dica apenas após sua própria saída, então nada que você está esperando é atrasado. doctor (e setup, que o executa) é a exceção — ele força uma busca síncrona e fresca toda vez, com timeout de 2 segundos, antes de imprimir sua tabela. A requisição carrega apenas a si mesma — sem telemetria, sem identificadores, nada sobre seu corpus. Está excluída dos hooks do Claude Code e do ponto de entrada mcp-server que mcp install realmente configura para o Claude Desktop, mas ainda não de longhand shared-mcp, mcp serve ou demo — esses atualmente executam a mesma verificação na saída como qualquer outro comando (#101). LONGHAND_NO_UPDATE_CHECK=1 desliga tudo isso. "Zero chamadas de API" significa o que sempre significou: nenhum LLM ou serviço de nuvem jamais toca seus dados.
O Que Ele Realmente Faz
Quando você usa o Claude Code, cada sessão escreve um arquivo JSONL em ~/.claude/projects/<project>/<session-id>.jsonl. Esse arquivo contém cada mensagem, cada chamada de ferramenta, cada bloco de pensamento, cada edição de arquivo com conteúdo completo antes/depois e um timestamp preciso ao milissegundo para cada evento.
O Longhand lê esses arquivos. Então ele oferece:
- Busca semântica em todos os eventos que você já gerou
- Busca filtrável — por ferramenta, arquivo, sessão, projeto e tipo de evento — todos os filtros combináveis (MCP
search; o comandosearchda CLI tem filtros de ferramenta/arquivo/sessão/tipo, mas não tem filtro de projeto, e nenhum dos dois tem filtro de intervalo de tempo) - Arqueologia de chamadas de ferramenta — "mostre-me comandos Bash que mexeram no Supabase" — ranqueados por relevância, não literalmente todas as correspondências; escopo para uma sessão ou projeto para reduzir o ruído
- Histórico de arquivos entre sessões — cada edição em um arquivo específico, cronologicamente, em todas as suas sessões
- Replay de sessão — reconstrua o estado de qualquer arquivo em qualquer ponto de qualquer sessão passada
- Recuperação de raciocínio — consulte os blocos de pensamento verbatim do Claude
- Visão de linha do tempo — reprodução cronológica com paginação (offset, tail, modo de varredura somente-resumo)
- Recordação difusa — perguntas em linguagem natural sobre trabalhos passados ("aquele fix de condição de corrida da semana passada")
- Inferência de projeto — detecção automática de em quais projetos você trabalhou, com categorias e aliases
- Extração de episódios — detecção automática de sequências problema→correção nas suas sessões
- Segmentos de conversa — agrupamento por tópico (histórias, discussões de design, depuração, planejamento) para que a recordação encontre o porquê, não apenas o o quê
- Recordação de projeto com ciência de git — pergunte "onde paramos em X" e receba commits recentes, problemas não resolvidos e o resultado da última sessão em uma única chamada
- Extração de commits git — extração estruturada de todo commit, push, merge e checkout de git das sessões, vinculada a episódios
- Servidor MCP — 13 ferramentas que permitem ao Claude consultar o Longhand diretamente durante conversas ao vivo
- Hook de ingestão automática — entra no hook
SessionEnddo Claude Code para que novas sessões sejam indexadas automaticamente - Ingestão ao vivo — o hook
Stop(instalado junto comSessionEndpelohook install; não é opcional separadamente) acompanha a transcrição ativa entre turnos para que uma sessão em andamento seja consultável imediatamente vialist_sessions, linha do tempo, histórico de arquivos e replay. Ele armazena apenas eventos, sem embeddings — a busca semânticarecall/searchainda espera a passagemSessionEnd, ou uma passagemreconcile --fixpara capturá-la (o tail ao vivo nunca defineproject_id, então o reconcile a trata como precisando de re-ingestão completa) - Histórico de planos — cada Write/Edit em
~/.claude/plans/*.mdé capturado como uma entidade de primeira classe, consultável vialonghand plans liste a ferramenta MCPlist_plans - Redação de segredos (opt-in) —
longhand config --set redact.enabled=truemascara strings com formato de segredo (chaves de API, tokens, JWTs, senhas de banco de dados) na ingestão antes de chegarem ao índice;longhand redact --applymascara retroativamente dados ingeridos anteriormente (veja SECURITY.md para a lacuna atual na cobertura de mensagens de commit git, #110) - Reconciliador em segundo plano — job opcional do launchd (
longhand schedule install-reconciler) mantém o índice íntegro sem execuções manuais dereconcile --fix - Injeção de contexto — o hook
UserPromptSubmitinjeta automaticamente contexto passado relevante antes de o Claude ver sua mensagem (limiar e limite de tamanho configuráveis); imprime a mesma linha de lacuna de idadeNote: …que orecallquando o contexto injetado é antigo e parece desatualizado em relação a trabalhos mais recentes - Configurável —
longhand configpara ajustar relevância de injeção, orçamento de tokens e comportamento sem editar código
Instalação
pip install longhand
longhand setup
É isso. longhand setup preenche o histórico existente do seu Claude Code, instala os hooks que o mantêm atualizado automaticamente, registra o Longhand como servidor MCP para o Claude Desktop, imprime o comando de uma linha para adicioná-lo ao Claude Code (claude mcp add longhand -s user -- longhand mcp-server) e verifica se tudo funciona. Cerca de dois minutos na primeira vez, zero manutenção depois disso.
Para atualizar depois: pip install -U longhand.
Instalação para desenvolvedores (a partir do código-fonte)
git clone https://github.com/Wynelson94/longhand.git
cd longhand
pip install -e .
longhand setup
Ou execute os comandos individuais você mesmo
longhand ingest                       # ingest all your existing Claude Code history
longhand analyze --all                # run analysis (projects, outcomes, episodes, segments)
longhand hook install                 # wires both SessionEnd and Stop hooks (installed together)
longhand prompt-hook install          # (optional) auto-inject past context into new prompts
longhand mcp install                  # register Longhand as an MCP server for Claude Desktop
claude mcp add longhand -s user -- longhand mcp-server  # ...and for Claude Code
longhand schedule install-reconciler  # (optional, macOS-only) launchd job to run reconcile --fix periodically
longhand config                       # view/tune hook behavior (relevance threshold, injection size)
longhand doctor                       # verify everything is wired up
longhand ingest-live não está nesta lista de propósito — é principalmente o ponto de entrada oculto que o hook Stop chama (lendo transcript_path do JSON do stdin), embora também aceite --transcript <path> diretamente se você quiser executá-lo manualmente.
Início Rápido
# What's in the archive?
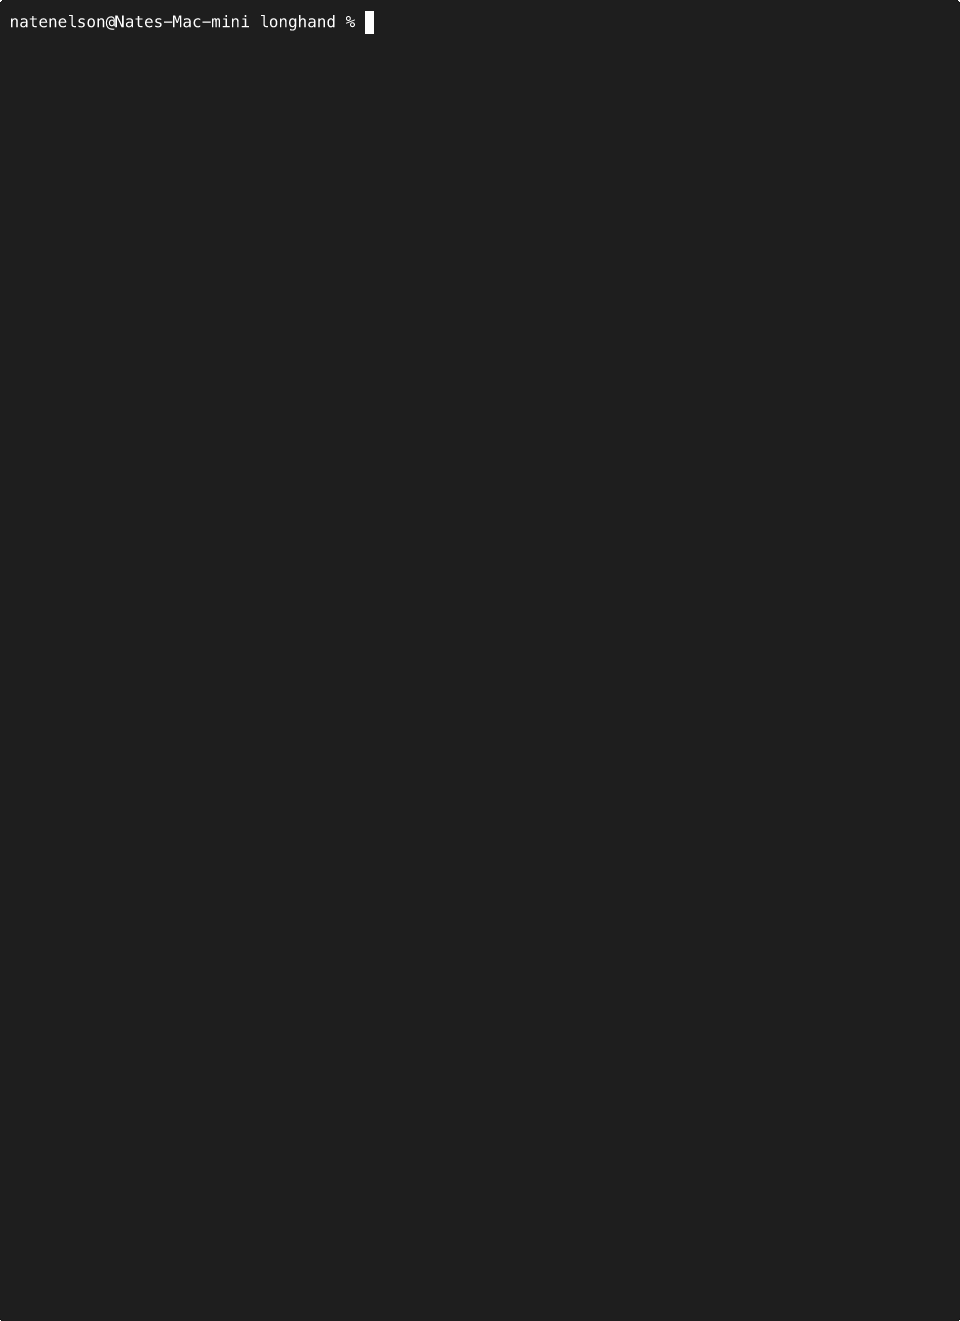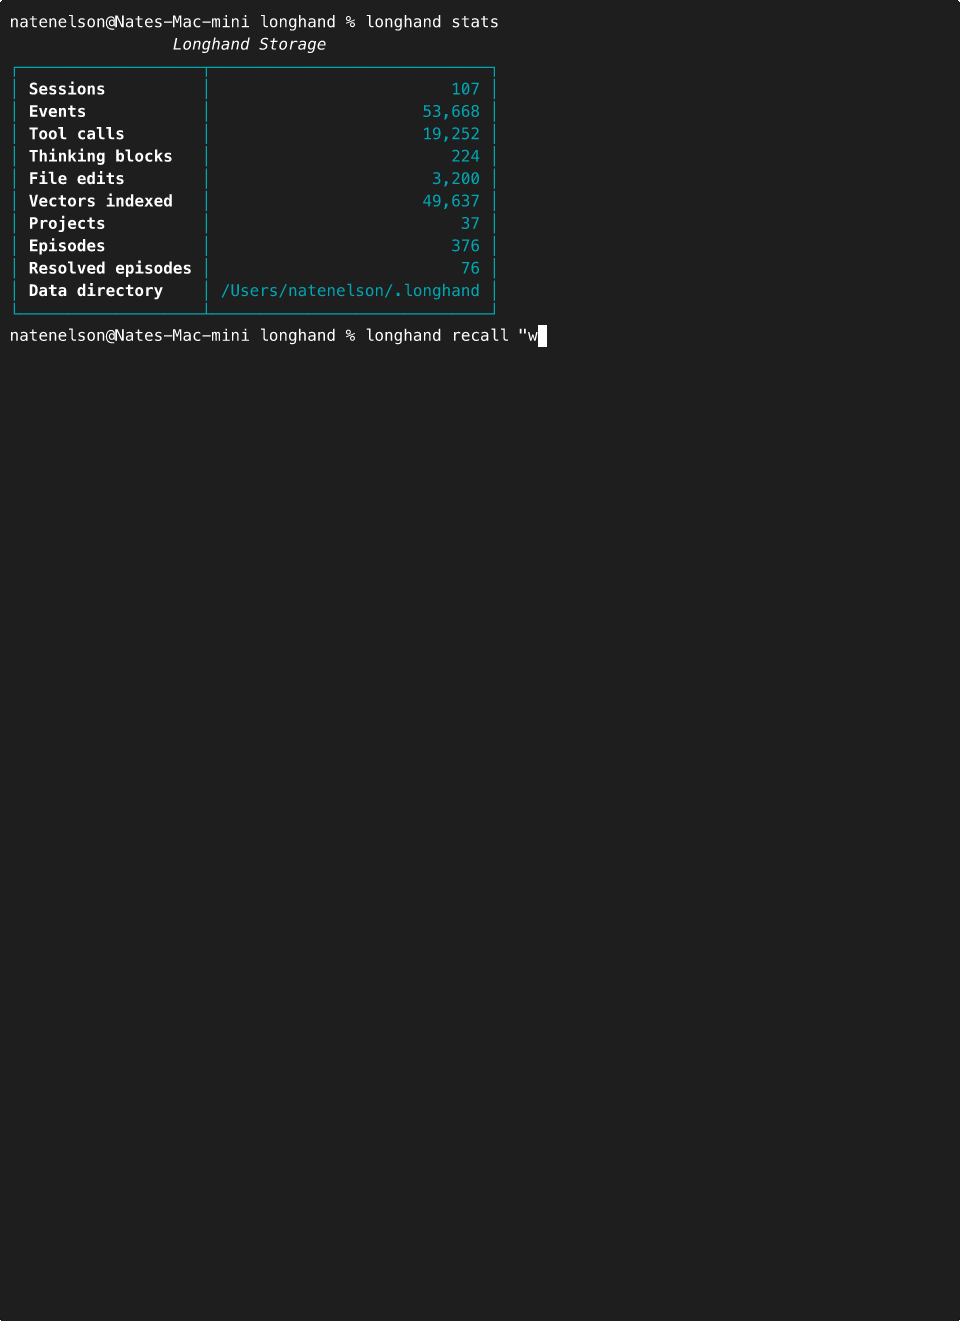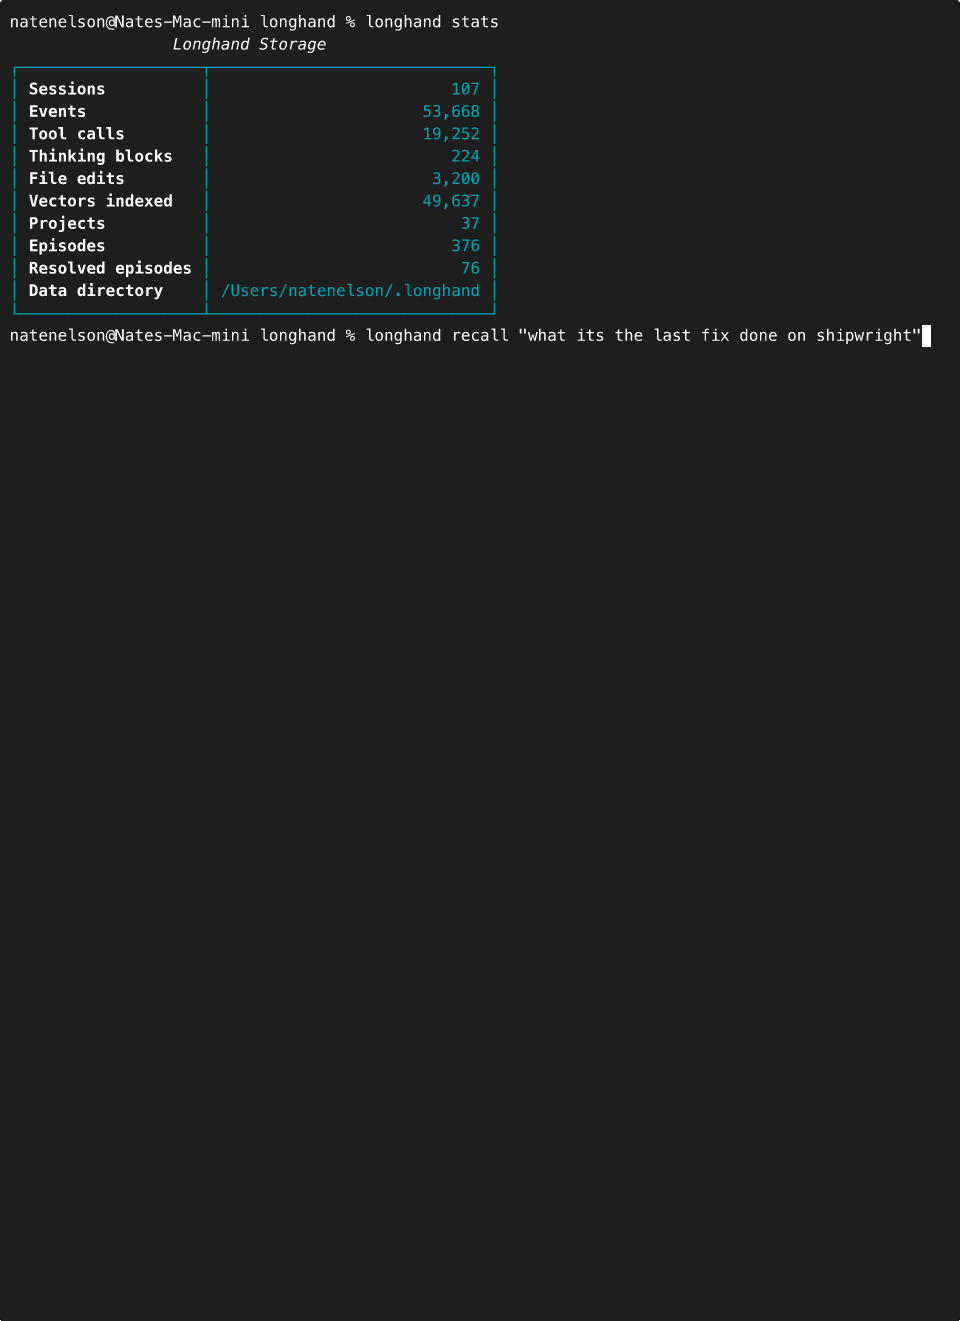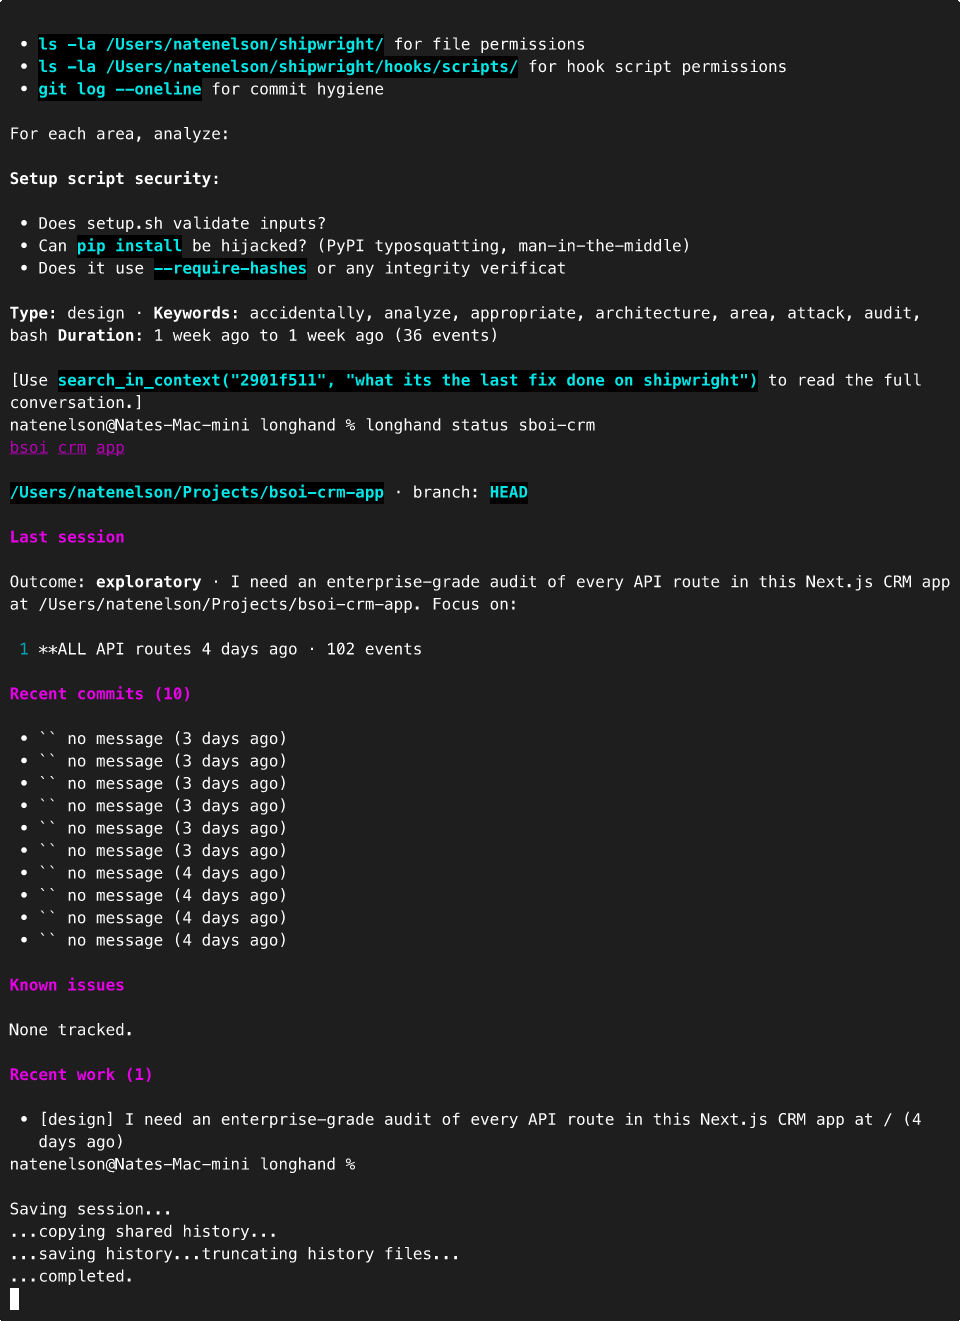
longhand stats
longhand sessions
longhand projects

# Daily-use commands — status is the single resume command (git-status shape)
longhand status                             # what have I been up to (recent digest)
longhand status --days 30 -p bsoi           # filtered digest
longhand status <project-name>              # where did we leave off on a project (git-aware)
longhand status --session <session-id>      # pick up where a session left off
longhand history src/app/route.ts           # every edit ever to a file
# (recap / continue / patterns / reanalyze were deprecated aliases through
#  0.13 and were removed at 1.0 — use status, recall, and analyze --all)

# Semantic search
longhand search "race condition"
longhand search "stripe webhook" --tool Edit
longhand search "why did we" --type assistant_thinking

# Proactive recall (the fun one)
longhand recall "that clerk type error I fixed a couple weeks ago"
longhand recall "the python missing module bug last month"

# Session inspection
longhand timeline <session-id-prefix>
longhand replay <session-id> /path/to/file.ts
longhand diff <event-id>

# Git history
longhand git-log                            # recent git operations across all sessions
longhand git-log <session-id>               # git ops in a specific session
longhand git-log --type commit              # only commits
longhand git-log --query "fix parser"       # search commit messages

# Export
longhand export latest-fix                  # most recent resolved episode
longhand export ep_<id> --out fix.md        # specific episode to file
longhand export <session-id-prefix>         # full session timeline

# Configuration
longhand config                             # show current hook settings
longhand config --set hook.min_relevance=3.0  # tune injection threshold
longhand config --set hook.max_inject_chars=1000  # cap token usage

# Plans + background maintenance
longhand plans list                         # every plan-mode plan you've written
longhand plans list --limit 100             # raise the row cap (default 50)
longhand schedule install-reconciler        # background launchd job (macOS); runs reconcile --fix
longhand reattribute                        # dry-run: find sessions attributed to the wrong project
longhand reattribute --fix                  # apply the moves (idempotent)
longhand db vacuum --prune-aux              # reclaim disk space; --prune-aux deletes ALL event_type='unknown' rows —
                                             #   not just harness noise, but doctor's drift records and the deliberately
                                             #   preserved summary/pr-link/worktree-state/frame-link rows too
IDs de sessão aceitam correspondência por prefixo — longhand timeline cf86 é suficiente se apenas uma sessão começar com isso.
Exemplo de Recordação
$ longhand recall "that stripe webhook I was fixing"

╭─ Project matches ───────────────────────────────────────╮
│ new-product (nextjs web app) · alias: 'stripe' · 1.52   │
╰─────────────────────────────────────────────────────────╯

You asked: that stripe webhook I was fixing

Found it: new-product · 2 weeks ago · session a4ba29d1

### What went wrong
Type error: Property 'current_period_end' does not exist on type 'Subscription'.

### How it was diagnosed
Nas definições de tipo do Stripe, current_period_end saiu da interface Subscription. Ainda está no payload real da API, mas os tipos não o expõem. Precisamos fazer cast via Record<string, unknown> para acessá-lo.
### The fix
Edit on route.ts: 'const periodEnd = sub.current_period_end' → 'const periodEnd
= (sub as Stripe.Subscription & Record<string, any>).current_period_end as number'

Diff:
- const periodEnd = sub.current_period_end
+ const periodEnd = (sub as Stripe.Subscription & Record<string, any>).current_period_end as number

✓ Verified — a test or command succeeded after the fix.

Other candidates (4)
• 2 weeks ago: Type error: Module '"@/lib/utils"' has no exported member 'getInitials'.
• 2 weeks ago: Type error: Property 'role' does not exist on type 'User'.
Isso é um comando local. Nenhuma chamada de API. A correção veio de um arquivo de sessão que o Claude Code escreveu no seu disco há semanas, e o Longhand estava esperando com a resposta o tempo todo.
Duas coisas não mostradas acima. Primeiro, o aviso de lacuna de idade dispara apenas quando a melhor correspondência tem pelo menos 30 dias e é pelo menos 30 dias mais antiga que o segundo colocado mais recente, sem frase de tempo na consulta — não apenas "semanas mais antiga". Quando dispara, uma linha aparece logo após "Found it:" — Older than the other matches — the best match is from 6 months ago, but newer related work exists from 2 months ago. If you meant current work, add a time phrase like "this week" or "this month". O ranqueamento não muda; é um aviso, não uma reordenação. Segundo, quando um candidato vem de segmentos de conversa em vez de um episódio limpo, o rodapé nomeia a chamada de acompanhamento exata com o ID de sessão real preenchido: search(session_id="a4ba29d1", query="...", context_events=5). O rodapé mais fraco "Also possibly relevant" (o que a recordação de episódios mostra quando há segmentos em outras sessões) atualmente imprime a mesma forma de chamada com um placeholder literal session_id="<session>" — copie o ID real do marcador acima.
Integração MCP
As 13 ferramentas do Longhand são as mesmas independentemente do cliente; como você registra o servidor é que difere.
Claude Code:
claude mcp add longhand -s user -- longhand mcp-server
Ou instale o plugin do Claude Code (envia o .claude-plugin/plugin.json deste repositório e um .mcp.json empacotado que registra o servidor para você) — veja a documentação do marketplace/plugin para o fluxo de instalação atual. longhand setup o passo 4 imprime o comando claude mcp add acima; ele não o executa por você.
Claude Desktop: execute longhand mcp install para conectar o Longhand à configuração do Claude Desktop (longhand setup faz isso também, a menos que --skip-mcp). Isso escreve apenas o arquivo de configuração do Claude Desktop — não tem efeito no Claude Code.
Após reiniciar o cliente, ele tem treze ferramentas:
Núcleo (arquivo pesquisável):
search— busca semântica com filtros de sessão, projeto, ferramenta, arquivo e tipo de evento (todos combináveis); passecontext_eventscom umsession_idpara obter cada correspondência envolvida na conversa ao redor. Quando o texto da consulta nomeia um projeto e nenhumproject_id/project_name/session_idexplícito é fornecido, os resultados são automaticamente limitados àquele projeto (o payload vira{auto_scoped_to, auto_scope_hint, hits}) — passe umsession_idexplícito para suprimir isso, ou um filtro de projeto para tornar o escopo deliberado; atualmente não há outra forma de sobrescrever (#102)list_sessions— sessões recentes com filtros de projeto/tempo; passeproject_id(maissince/untilopcionais) para uma linha do tempo de sessão de um projeto enriquecida com resultadosget_session_timeline— visão cronológica com paginação offset/tail e modo de varredura somente-resumo (tail: Ncobre "os eventos mais recentes / como terminou")replay_file— reconstrói o estado de um arquivo em um ponto no tempoget_file_history— cada edição em um arquivo em todas as sessõesget_stats— estatísticas de armazenamento (sua descrição atualmente promete um campodata_dirque não retorna — #106)
Memória proativa:
recall— recordação difusa em linguagem natural (use esta primeiro): uma narrativa construída a partir de segmentos de conversa e linhas do tempo de sessão, com episódios problema→correção de alta precisão quando o trabalho deixou evidências claras. Desde 1.2.2, uma consulta sem tempo cuja melhor correspondência tem 30+ dias e é 30+ dias mais antiga que o segundo colocado mais recente recebe uma nota inicial dizendo isso (o ranqueamento não muda) — adicione uma frase de tempo para pular a verificaçãorecall_project_status— "onde paramos em X?" — resumo de projeto com ciência de git com commits, problemas e último resultadofind_episodes— busca estruturada por pares problema→correção; passeepisode_idpara detalhes completos de um episódio (eventos referenciados, diff, estado do arquivo pós-correção)list_projects— navegue pelos projetos inferidos; passematchpara candidatos difusos com razões pontuadaslist_plans— cada Write/Edit em~/.claude/plans/*.mdem todo o seu histórico
Histórico git:
find_commits— busca em todas as sessões por mensagem de commit, prefixo de hash ou nome de branch; ou passe umsession_idsem consulta para a história git cronológica de uma sessão
Autocorreção:
reconcile— envolvelonghand reconcilepara que o Claude possa reatribuir e reingerir de dentro de uma sessão após um banner de desatualização; o padrão é um dry run (passefix=truepara aplicar — esse padrão mudou na v1.0)
Saiu da listagem de ferramentas na v1.0, ainda responde para sempre com um preâmbulo de migração: search_in_context → search(context_events) · get_latest_events → get_session_timeline(tail) · get_project_timeline → list_sessions(project_id) · get_session_commits → find_commits(session_id) · get_episode → find_episodes(episode_id) · match_project → list_projects(match)
O limite de saída é desigual, não universal: search, get_session_timeline, recall, recall_project_status e find_commits aceitam max_chars (passe 0 ou negativo para desativá-lo, embora raramente seja o que você quer); list_sessions e list_projects truncam em 16.000 caracteres fixos apenas em seus modos padrão — list_sessions(project_id=…) e list_projects(match=…) estão no caminho sem limite abaixo; get_file_history, replay_file, get_stats, find_episodes (seu modo de lista retorna até limit — padrão 20, máximo 1000 — não um episódio; apenas o modo de detalhe episode_id é limitado a um), list_plans e reconcile retornam o que a consulta produzir, sem limite (#103). Veja Token budget para o detalhamento completo.
Uma vez instalado, você pode perguntar ao Claude coisas como "o que decidimos sobre o middleware de autenticação na sessão da semana passada?" e ele realmente pesquisará o próprio trabalho passado.
Ingestão Automática
longhand hook install adiciona dois hooks ao ~/.claude/settings.json — Stop para acompanhamento ao vivo entre turnos, SessionEnd para a passagem de análise completa no fechamento da sessão. Ambos são instalados juntos; não há flag para adicionar um sem o outro. O instalador resolve longhand para seu caminho absoluto e envolve cada comando no esquema de hooks do Claude Code:
{
  "hooks": {
    "Stop": [
      {"matcher": "", "hooks": [{"type": "command", "command": "/abs/path/to/longhand ingest-live"}]}
    ],
    "SessionEnd": [
      {"matcher": "", "hooks": [{"type": "command", "command": "/abs/path/to/longhand ingest-session"}]}
    ]
  }
}
Ambos os comandos leem transcript_path do JSON do stdin do hook, então nenhuma flag é necessária na entrada do hook em si.
- Stop hook (
ingest-live) é executado após cada turno do assistente. Ele lê o arquivo de transcrição e armazena novos eventos (além do pareamento de chamadas de ferramentas e estatísticas de sessão) de forma incremental, para que uma sessão em andamento possa ser consultada vialist_sessions, linha do tempo, histórico de arquivos e replay enquanto você ainda está trabalhando nela. Ele nunca incorpora, entãorecall/searchsemânticos ainda precisam da passagemSessionEnd— ou de uma passagemreconcile --fix, que re-ingere com análise completa, já que uma sessão rastreada ao vivo nunca recebeu umproject_ide cai no bucketnull_projectdo reconcile. Uma falha aqui é silenciosa por design — sem stdout, sem breadcrumb — pois nunca deve arriscar interromper seu turno;SessionEndereconcilesão o plano de contingência. - SessionEnd hook (
ingest-session) é executado uma vez quando uma sessão é encerrada. Ele faz a passagem de análise completa: inferência de projeto, resultados, episódios, segmentos, embeddings. Uma falha aqui imprime uma linha no stderr e deixa um breadcrumb emlogs/hook-errors-YYYY-MM-DD.log(exibido pordoctor), e então sai com código 0.
Ambos são não bloqueantes e executam em um a dois segundos. Você não precisa pensar em nenhum deles novamente.
Reconciliador de fundo opcional: longhand schedule install-reconciler adiciona um plist do launchd que executa reconcile --fix em um agendamento. Ele captura sessões que os hooks perderam se a transcrição ainda estiver no disco — reconcile enumera a partir de ~/.claude/projects/, então uma transcrição que o Claude Code já rotacionou é invisível para ele, assim como para qualquer outra ferramenta aqui.
Funciona com Codex
Também usa o Codex Desktop ou o Codex CLI? O Longhand captura esses fluxos no mesmo arquivo, então uma pergunta feita no Claude Code pode ser respondida a partir do trabalho feito no Codex, e vice-versa.
pip install -U longhand
longhand codex-sync                                                  # capture Codex threads on this machine (up to 50/run)
claude mcp add --scope user longhand-shared -- longhand shared-mcp   # keyword search across both clients, from Claude
codex mcp add longhand -- longhand shared-mcp                        # the same server from Codex (Desktop: config.toml, see the docs)
A partir daí, reconcile --fix também captura novos fluxos do Codex, então um reconciliador agendado mantém ambos os clientes atualizados. Um fluxo é armazenado apenas como registro exato enquanto está sendo escrito — verbatim e pesquisável, sem modelo carregado — e recebe o pipeline completo 30 minutos depois de ficar inativo, então recall o vê sem você reexecutar nada, desde que algo esteja fazendo polling em um agendamento (o reconciliador launchd, um loop codex-sync --watch, ou o template launchd codex-sync abaixo) — codex-sync --semantic executa o pipeline completo imediatamente se nada estiver. Fluxos que o Codex gera para si mesmo são ignorados por padrão, espelhos de UI nunca são armazenados duas vezes, e formatos de registro desconhecidos aparecem em doctor como qualquer outra deriva. Configuração, limites e o template launchd do macOS: docs/codex.md.
Arquitetura
longhand/
├── parser.py           — JSONL → typed Events (a short list of known harness-bookkeeping entry types is skipped, not stored)
├── codex.py            — Codex rollout capture + 30-minute-quiet finalizer, shared archive
├── replay.py           — deterministic file state reconstruction
├── redaction.py        — opt-in secret-shaped-string masking
├── update_check.py     — best-effort pypi.org freshness check (most commands; the hooks and the hidden `mcp-server` are excluded)
├── types.py            — Pydantic models
├── storage/
│   ├── migrations.py      — version-aware schema evolution
│   ├── sqlite_store.py    — structured data + full raw JSON preserved
│   ├── vector_store.py    — ChromaDB: events, sessions, projects, segments, episodes (5 collections)
│   └── store.py           — unified ingest pipeline
├── extractors/         — per-event (errors, file refs, topics, git ops)
├── analysis/           — per-session (project, outcomes, episodes, embeddings)
├── recall/             — per-query (time parsing, project match, narrative)
├── demo/               — sandboxed sample corpus for `longhand demo`
├── cli/                — Typer CLI with Rich output (`_commands.py`, `helpers.py`)
├── mcp_server.py       — Model Context Protocol server (13 tools)
├── lightweight_mcp.py  — `longhand-shared`: 4-tool keyword-only server, no model loaded
└── setup_commands.py   — hook install, mcp install, config, doctor
Fonte da verdade: SQLite. Cada JSON bruto de evento é preservado como um blob. O ChromaDB é o índice de busca — ele só guarda o necessário para recuperação semântica.
Camada de análise: Executa no momento da ingestão, não no momento da consulta. Pré-computa projetos, resultados de sessão e episódios para que consultas de recall sejam rápidas. Totalmente determinística, sem LLM.
Pipeline de recall: query → time parse → project match → episode search → rank → load artifacts → narrative. Uma chamada completa de recall executa várias buscas vetoriais (eventos, projetos, episódios, segmentos, além de tentativas de relaxamento), depois carrega artefatos e compõe a narrativa. Medido em 2026-09-27 no corpus ao vivo do autor, quente e em processo (veja Stats): uma busca vetorial única é ~29ms de mediana; uma chamada completa de recall é ~128ms de mediana.
Comparação
| Longhand | Baseado em resumo (Mem0, MemPalace, LangMem) | |
|---|---|---|
| Fonte | JSONL bruto do Claude Code | Resumos gerados por IA |
| Chamadas de ferramentas capturadas | Cada uma, verbatim | O que o resumidor manteve |
| Edições de arquivo | Diffs completos antes/depois | Geralmente não capturadas |
| Blocos de pensamento | Eventos de primeira classe | Geralmente descartados |
| Replay de estado de arquivo | Determinístico | Não possível |
| Extração problema→correção | Baseado em regras, na ingestão | Depende do resumidor |
| Recall difuso | Sim, com artefatos | Busca de texto sobre resumos |
| O que é "decidido" | Nada — armazena tudo | A IA decide o que importa |
| Local-first | Sim | A maioria |
| Completude | Cada mensagem, edição e bloco de pensamento, verbatim† | O que o resumidor manteve |
| Chamadas de LLM para função | Zero | Varia |
Memória baseada em resumo e Longhand resolvem problemas diferentes. Memória baseada em resumo é boa para assistentes pessoais de longo prazo que precisam de contexto comprimido em muitas conversas. Longhand é bom para desenvolvedores que precisam de acesso forense ao seu trabalho passado no Claude Code — o tipo de acesso onde você precisa do diff exato, não de uma paráfrase.
Estatísticas
Corpus, medido em 2026-09-27 contra o armazenamento ao vivo do autor (Apple M4, macOS, código em main):
- 792 sessões (6 delas do Codex)
- 269.067 eventos
- 45 projetos inferidos automaticamente
- 1.809 episódios problema→correção extraídos
- 6.632 segmentos de conversa (design, história, depuração, discussão, planejamento)
- 3.723 operações git extraídas
- Pegada de armazenamento: 5,9 GB SQLite + 1,6 GB ChromaDB
Latência, benchmarkada no mesmo corpus e data — quente, em processo, as 8 consultas scripts/recall_diff:
recall(pipeline completo): ~128ms de mediana (16 execuções)- Busca vetorial: ~29ms de mediana (24 execuções)
- Leitura de linha do tempo SQL: ~1,6ms de mediana (24 execuções)
- Primeira chamada
recallem um processo novo (carregamento de modelo + índice, início frio): ~0,6s
Orçamento de tokens
A pergunta mais comum: o Longhand consome muitos tokens quando o Claude o usa?
Na maioria das vezes não — mas o limite não é universal, então leia esta tabela. Cinco das 13 ferramentas truncam sua saída e anexam uma dica de paginação antes que o Claude a veja; duas outras limitam a um tamanho fixo, mas apenas no modo padrão; seis retornam o que a consulta produz, sem limite (#103). Na prática, get_file_history/replay_file são naturalmente limitados a um arquivo (embora um histórico de edição longo ou um arquivo grande ainda possa retornar grande); find_episodes é o que merece atenção — seu modo padrão de lista não tem escopo natural e pode retornar até limit (máx. 1000) linhas completas de episódios sem limite, enquanto apenas seu modo episode_id de detalhe é limitado a um único episódio.
| Ferramenta | Limite de saída padrão | Ajustável? |
|---|---|---|
search | 12.000 caracteres | max_chars |
search no modo contexto (context_events) | 20.000 caracteres | max_chars |
get_session_timeline | 16.000 caracteres | max_chars |
recall, recall_project_status | 16.000 caracteres | max_chars |
find_commits | 12.000 caracteres | max_chars |
list_sessions, list_projects (modo padrão) | 16.000 caracteres | não — fixo |
list_sessions(project_id=…), list_projects(match=…) | nenhum | não — sem limite |
get_file_history, replay_file, get_stats, find_episodes, list_plans, reconcile | nenhum | não — sem limite |
Teto no parâmetro max_chars (MAX_OUTPUT_CHARS) | 200.000 caracteres | passe 0 ou negativo para desabilitar a truncagem completamente |
Por que isso importa — a comparação:
- Ler um JSONL de sessão bruta diretamente: 50K–200K tokens por sessão (sessões do Claude Code têm tipicamente 1–5MB cada).
- Abordagens de janela de contexto maior: cada prompt paga o histórico completo, toda vez.
- Ferramentas de memória baseadas em resumo: baratas por consulta, mas já descartaram os blocos de pensamento.
O Longhand tem custo fixo: o limite é por chamada, não por corpus. Recuperar em 10 sessões e recuperar em 1.000 sessões retorna no mesmo envelope de tokens. E o Longhand em si não faz nenhuma chamada de API — os únicos tokens consumidos são o payload MCP que o Claude lê de volta. Nenhum LLM fica entre você e seus dados.
Ajuste: as cinco ferramentas listadas acima aceitam um parâmetro max_chars que pode ser reduzido por chamada. summary_only: true em get_session_timeline remove o campo content e reduz os payloads em ~10×.
617 testes unitários passando, cobrindo a listagem e despacho de todas as 13 ferramentas MCP (apenas o handler de list_plans não é testado separadamente por chamada). Auditoria de segurança completa: zero achados críticos, zero achados altos. ~/.longhand/ é criado com permissões 0700 no caminho principal de abertura do armazenamento (vários caminhos de escrita antecipada ainda não aplicam esse modo — #99); todo SQL é parametrizado; todas as entradas são limitadas. Dependências: chromadb, posthog, typer, rich, pydantic, mcp.
Autor
Nate Nelson. Idaho Falls. Sem diploma em ciência da computação. Quatorze indústrias construindo software descrevendo o que vejo e deixando a tradução acontecer.
GitHub: Wynelson94
Licença
MIT. Faça o que quiser com ele.