Flama
O framework de produção para IA Preditiva e Generativa. Sirva qualquer modelo como uma API em uma linha, com endpoints compatíveis com OpenAI/Anthropic/Ollama, uma interface de chat integrada e MCP nativo.
Documentação
Ilumine seus modelos 🔥


Flama
O framework de produção para IA Preditiva e Generativa.
Transforme qualquer modelo em uma API de produção com uma única linha de código. Sirva modelos preditivos e generativos em um núcleo baseado em Rust e exponha suas ferramentas a agentes de IA por meio do Model Context Protocol (MCP).
Flama é o framework para Aplicações Leves, Modelos de inteligência artificial
e Automação. Ele empacota um modelo de qualquer um dos principais frameworks
em um formato portátil único (o arquivo .flm), para que cada modelo pareça igual à sua API,
independentemente de sua origem, e o serve por HTTP em segundos.
- 📦 Qualquer framework, um formato. Empacote scikit-learn, TensorFlow, PyTorch ou um LLM em um único artefato portátil
.flm. - ⬇️ Modelos sob demanda. Baixe e empacote qualquer modelo do HuggingFace Hub com um comando.
- 🤖 Serviço de IA generativa. Sirva LLMs com endpoints compatíveis com OpenAI, Anthropic e Ollama, lado a lado.
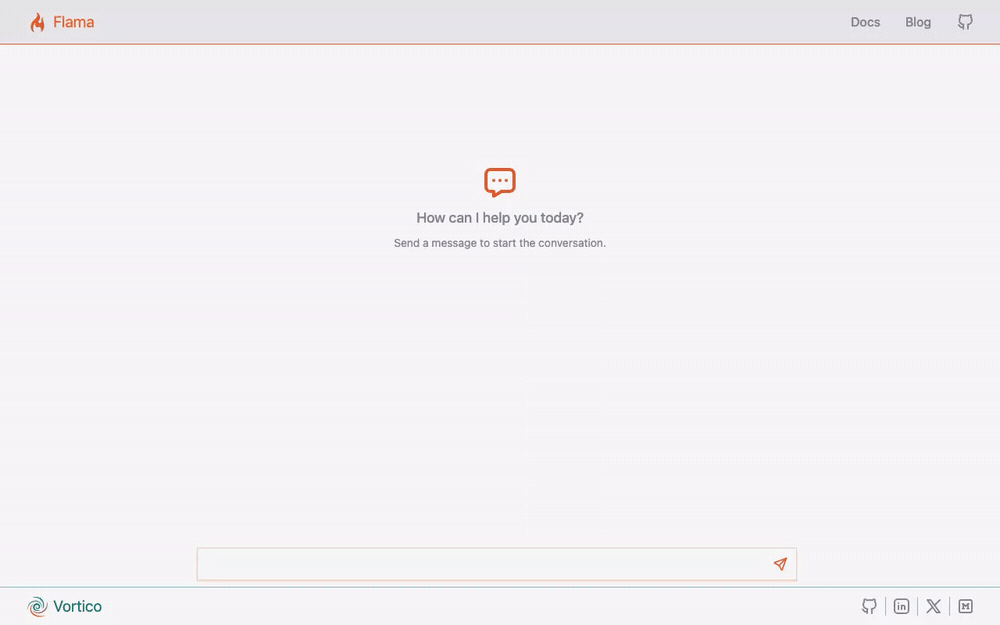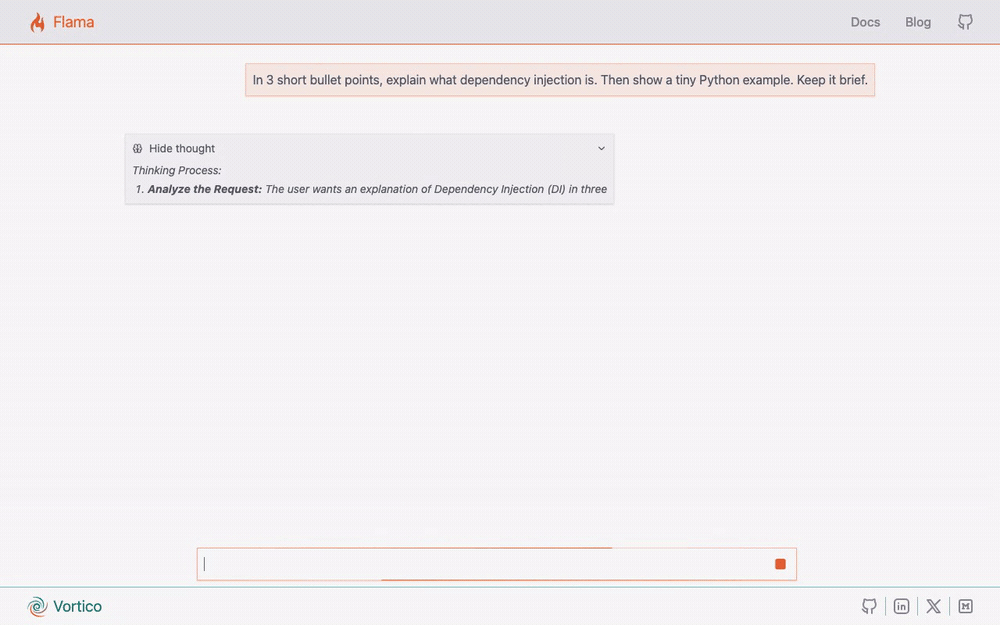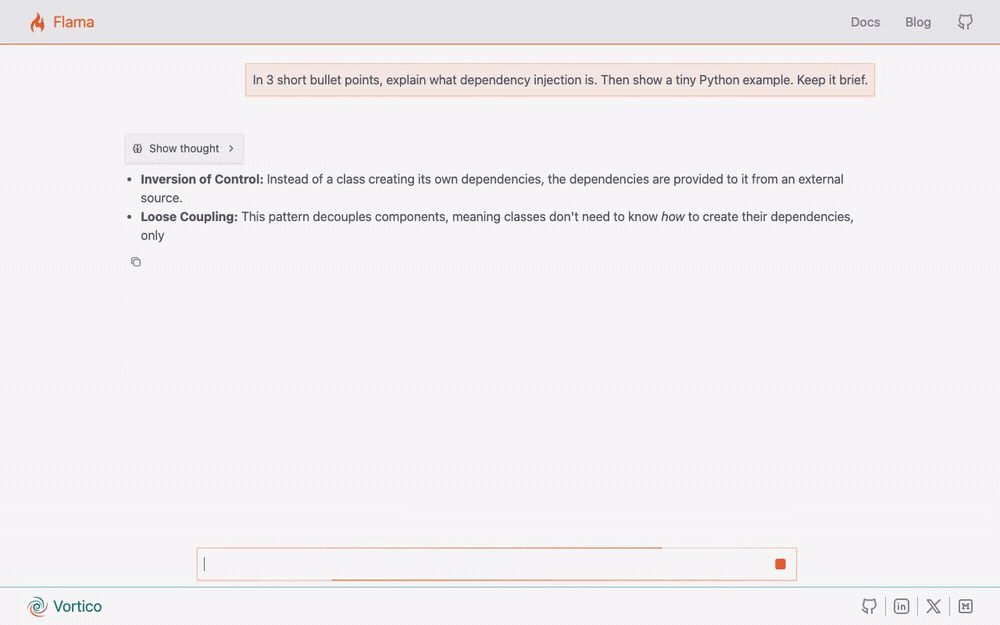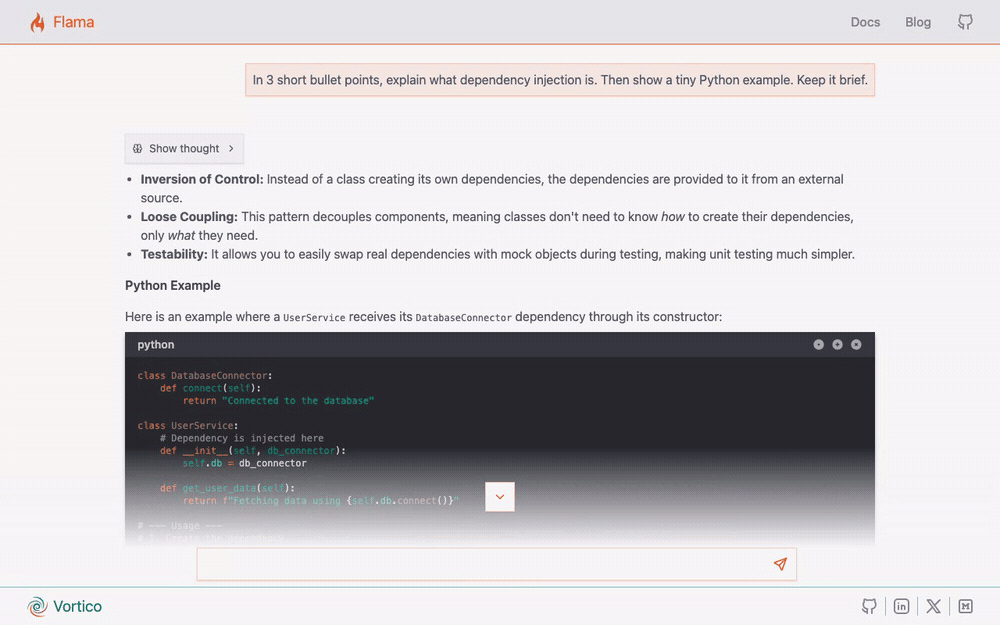
- 💬 Chatbot pronto para uso. Todo modelo servido inclui uma interface de chat em streaming polida em
/chat/, com suporte a Markdown, LaTeX e Mermaid. - 🔌 MCP nativo. Exponha ferramentas, recursos e prompts a agentes de IA com um único decorador, com esquemas derivados das suas anotações de tipo.
- ⚡ Núcleo baseado em Rust. Roteamento, codificação JSON, análise de requisições e compressão compilados em código nativo, distribuídos como wheels simples.
- 🚀 Pronto para produção desde o início. Vá de um modelo empacotado a um serviço em execução via CLI, em Python, com um arquivo de especificação ou dentro de um contêiner.
Instalação
Flama é publicado no PyPI e distribui wheels nativos para todas as versões suportadas do Python (3.10 a 3.14) em Linux, macOS e Windows. Nenhuma toolchain Rust é necessária.
pip install flama
Suporte a schema, banco de dados e LLM são extras opcionais, então você instala apenas o que precisa:
pip install "flama[pydantic]"      # schema validation (also: typesystem, marshmallow)
pip install "flama[database]"      # SQLAlchemy-backed resources
pip install "flama[llm]"           # generative AI serving (vLLM on Linux, MLX on Apple Silicon)
pip install "flama[full]"          # everything
Consulte a documentação de instalação para detalhes.
Início rápido
Os mesmos dois comandos servem ambas as famílias de modelos: empacote-o em um .flm e, em seguida, aponte
o flama serve para o arquivo. Nenhum código de aplicação em nenhum dos casos.
Sirva um modelo preditivo
Empacote um modelo treinado em qualquer framework principal:
import flama
from sklearn.neural_network import MLPClassifier

model = MLPClassifier(activation="tanh", hidden_layer_sizes=(10,))
# ... training ...
flama.dump(model, family="ml", path="model.flm", metrics={"accuracy": 0.947})
Ou busque um diretamente do Hub e, em seguida, sirva-o:
flama get --family ml --source huggingface scikit-learn/Fish-Weight
flama serve --model file=scikit-learn_Fish-Weight.flm,url=/model,name=fish
Você obtém dois endpoints, um schema OpenAPI em /schema/ e a interface Swagger em /docs/.
GET /model/ retorna os metadados do artefato; POST /model/predict/ executa a inferência:
curl -X POST http://127.0.0.1:8000/model/predict/ \
  -H "Content-Type: application/json" \
  -d '{"input": [[23.2, 25.4, 30.0, 11.52, 4.02]]}'
{"output": [242.0]}
Saiba mais na documentação de IA preditiva.
Sirva um modelo generativo
Do zero a uma API de produção com uma interface de chat integrada em três comandos:
pip install "flama[llm,pydantic]"

# 1. Download and package a model from HuggingFace into a portable .flm
flama get --family llm --source huggingface mlx-community/gemma-4-E2B-it-qat-4bit

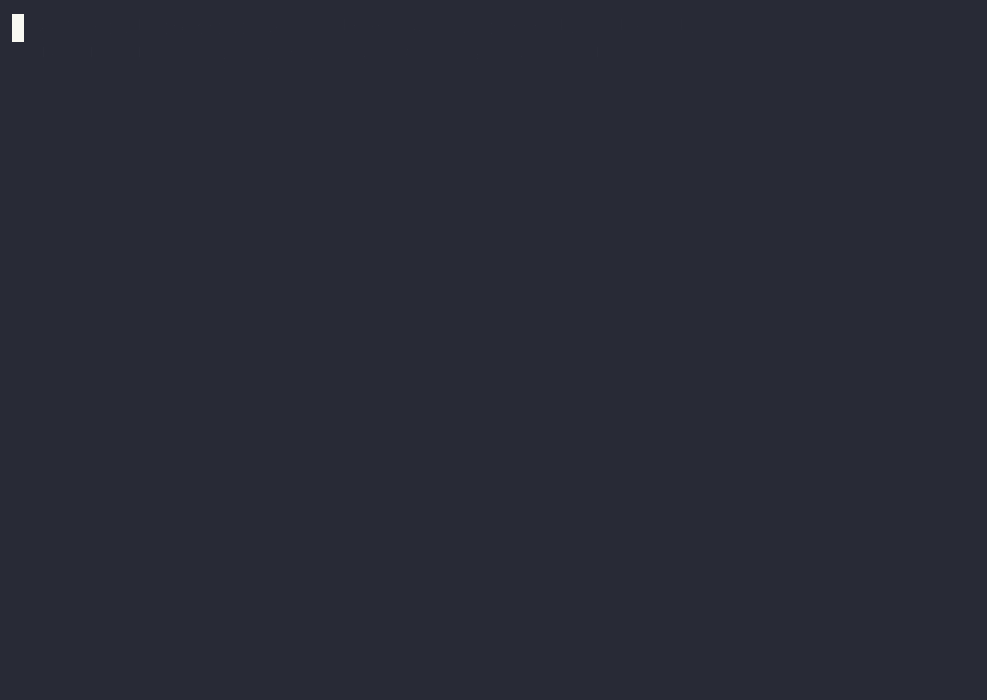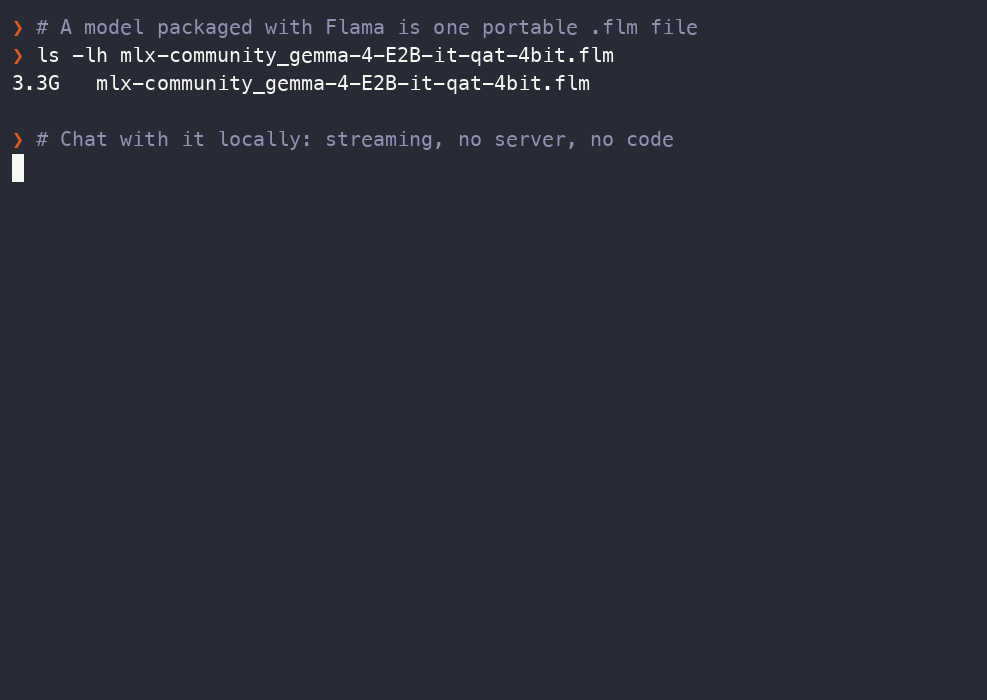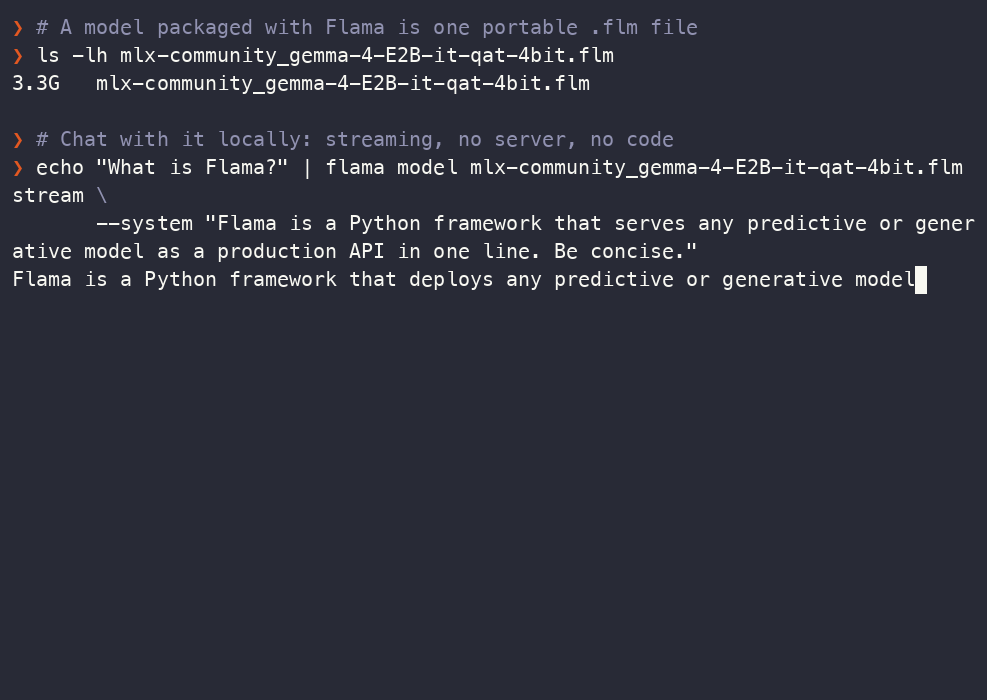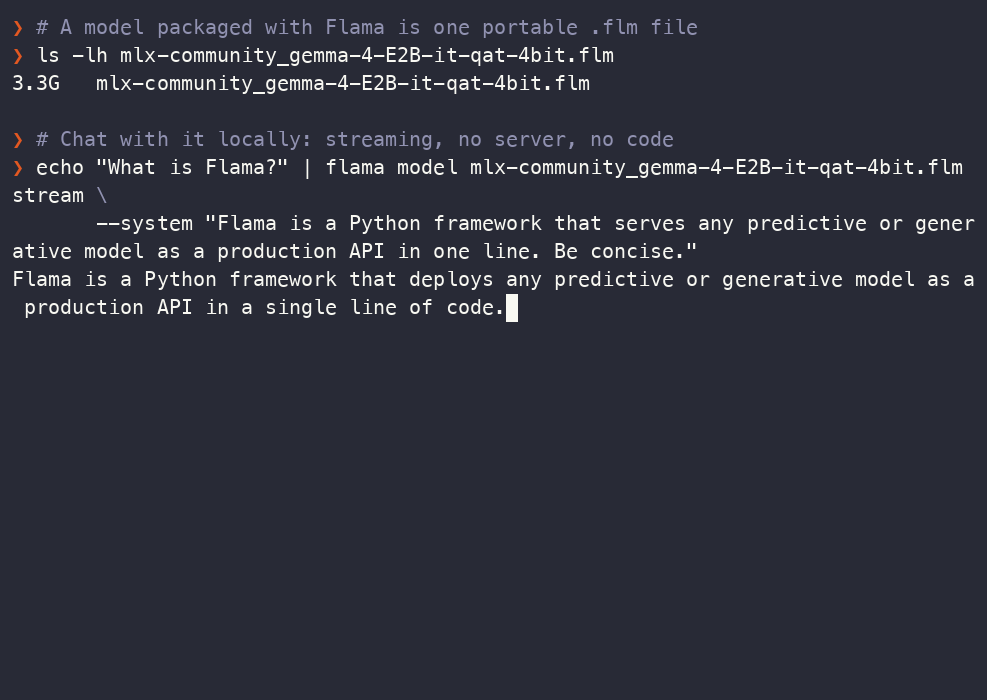
# 2. Try it straight from your terminal, no server needed
echo "What is Flama?" | flama model mlx-community_gemma-4-E2B-it-qat-4bit.flm stream --system "Be concise."

# 3. Serve it over HTTP
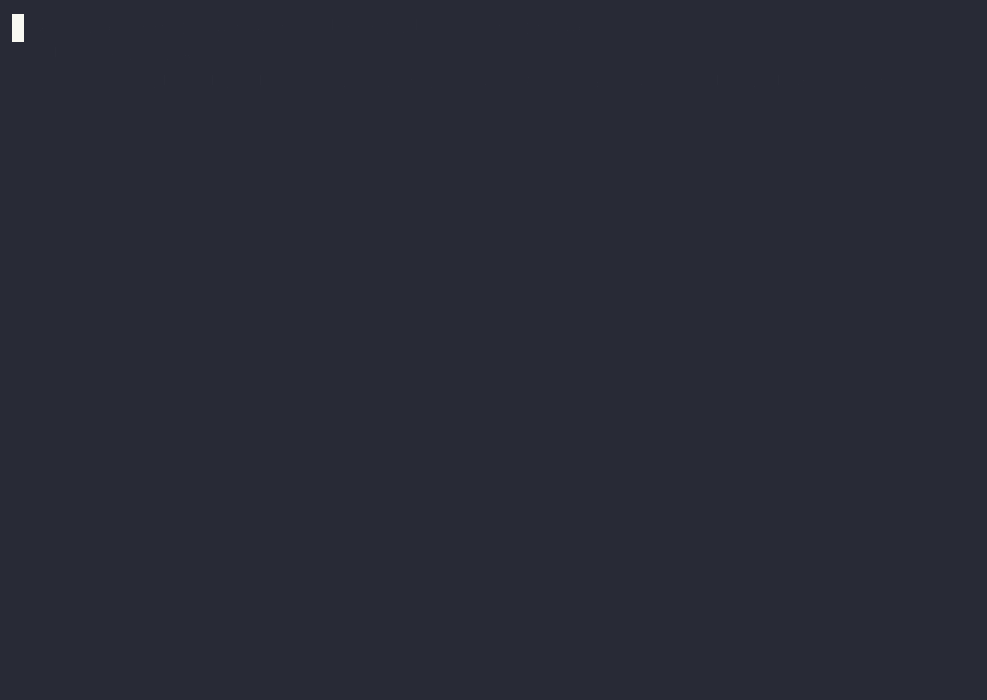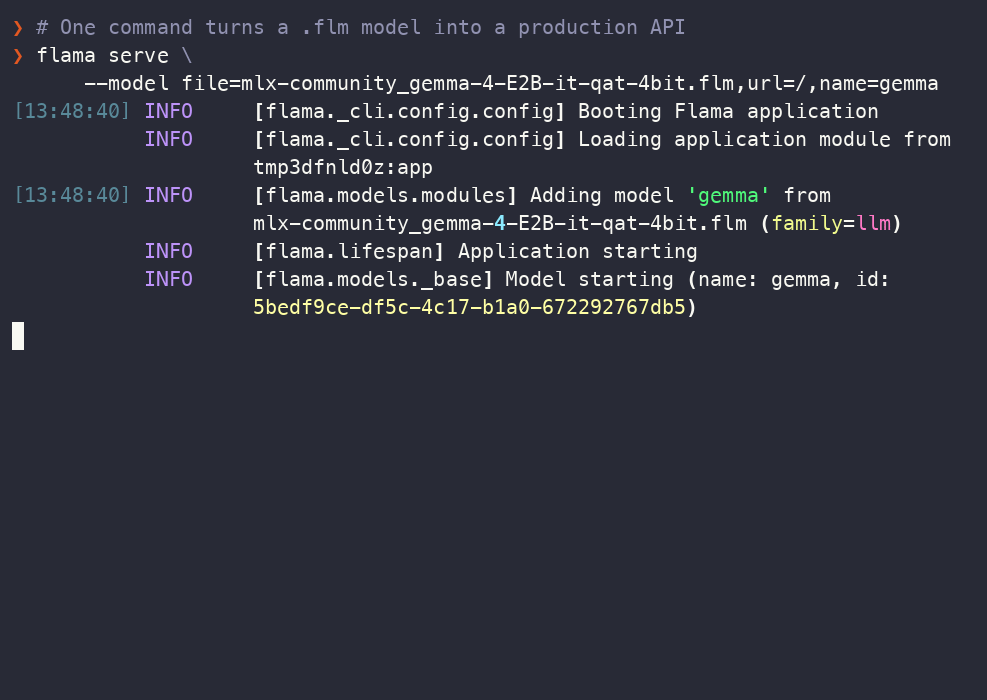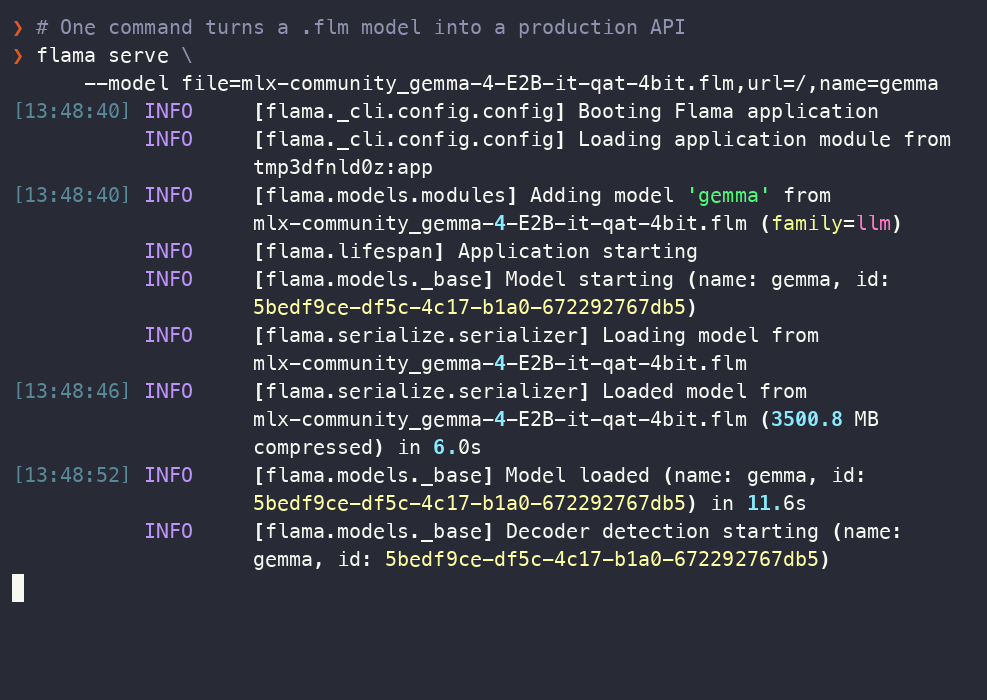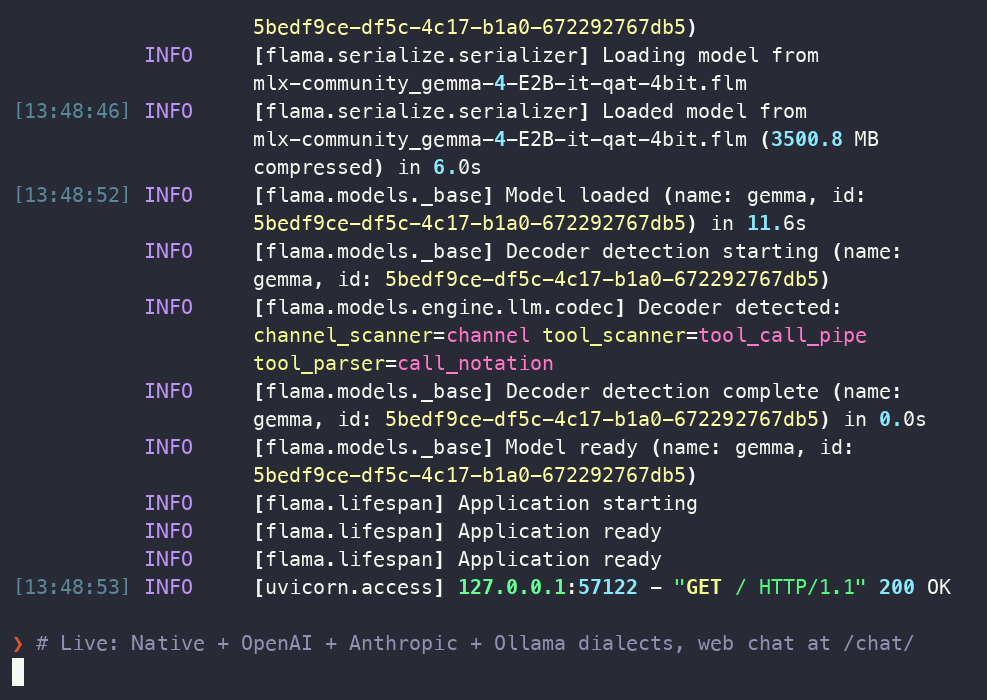
flama serve --model file=mlx-community_gemma-4-E2B-it-qat-4bit.flm,url=/,name=gemma
É isso: uma API HTTP completa, uma interface de chat em streaming em
http://127.0.0.1:8000/chat/ e endpoints multi-dialeto.
O mesmo arquivo .flm roda em vLLM (Linux com CUDA) ou MLX (Apple Silicon), com
Flama selecionando o backend no momento do carregamento.
O passo 2 acima não precisa de servidor algum. Envie um prompt para o flama model ... stream e a
resposta flui diretamente para o seu shell:
Saiba mais na documentação de IA generativa.
Fale os protocolos que seus clientes já usam
Um único modelo pode servir vários protocolos de rede simultaneamente, para que clientes OpenAI, Anthropic e Ollama existentes funcionem sem alterações de código — basta apontá-los para o seu servidor.
| Dialeto | Prefixo | Rotas representativas |
|---|---|---|
| Nativo | (nenhum) | /query/, /stream/, /chat/ |
| OpenAI | /openai | /v1/chat/completions, /v1/completions, /v1/responses, /v1/models |
| Anthropic | /anthropic | /v1/messages, /v1/models |
| Ollama | /ollama | /api/chat, /api/generate, /api/tags |
Inspecione, teste e implante
Todo arquivo .flm é autodescritivo. Além dos pesos, ele carrega o framework e a
versão, a classe do modelo, seus hiperparâmetros, as métricas de treinamento e quaisquer arquivos
auxiliares necessários no momento da inferência. Os metadados ficam antes dos pesos, então lê-los é uma
análise de cabeçalho, não uma descompressão completa, mesmo em um artefato de vários gigabytes.
flama model model.flm inspect --pretty
{
  "meta": {
    "id": "42342016-bade-48d4-a185-0a3352fb7561",
    "timestamp": "2026-09-15T10:30:00",
    "framework": {"family": "ml", "lib": "sklearn", "version": "1.9.1", "config": null},
    "model": {
      "obj": "RandomForestClassifier",
      "params": {"n_estimators": 100, "max_depth": 8},
      "metrics": {"accuracy": 0.947, "f1": 0.932}
    },
    "extra": {"dataset": "prod-2024-q3", "author": "team-ml"},
    "capabilities": {"kind": "ml"}
  },
  "manifest": []
}
Como as métricas viajam dentro do arquivo, um job de CI pode condicionar a promoção a elas sem levantar um servidor. O mesmo grupo de comandos executa inferência offline, para que um conjunto de referência seja pontuado exatamente no caminho de código que o servidor usaria:
flama model model.flm run -i reference.json -o predictions.json
Implante vários modelos a partir de um único arquivo
flama start lê um flama.json descrevendo a aplicação e os modelos que ela serve,
o que torna uma implantação revisável em um pull request:
{
  "app": {
    "title": "ML Platform",
    "models": [
      {"url": "/sentiment", "path": "models/sentiment.flm", "name": "sentiment"},
      {"url": "/assistant", "path": "models/assistant.flm", "name": "assistant",
       "serving": ["native", "openai"]}
    ]
  },
  "server": {"host": "0.0.0.0", "port": 8000, "workers": 4}
}
flama start --create-config full   # write a template to start from
flama start                        # run it
Toda opção também se vincula a uma variável de ambiente FLAMA_*, para que uma única imagem
sirva todos os ambientes. Imagens oficiais são distribuídas por versão do Python e biblioteca de schema,
o que deixa o Dockerfile como um FROM e dois COPYs:
FROM vortico/flama:latest-python3.12-pydantic
COPY models/ models/
COPY flama.json .
CMD ["start"]
Saiba mais na documentação da CLI.
Exponha ferramentas a agentes de IA com MCP
Flama oferece suporte nativo e de primeira classe ao Model Context Protocol. Declare uma capacidade com um único decorador, monte o servidor, e o Flama deriva o JSON Schema das suas anotações de tipo e o serve por um protocolo sem estado:
from flama import Flama

app = Flama()
app.mcp.add_server("/mcp/tools/", "tools")


@app.mcp.tool("add", description="Add two integers", mcp="tools")
def add(a: int, b: int) -> int:
    return a + b
Qualquer cliente compatível com MCP (Claude, Cursor, VS Code Copilot ou um agente personalizado) pode descobri-lo e invocá-lo. Tasks, Elicitation e MCP Apps estão incluídos. Saiba mais na documentação do MCP.
E um framework de API completo
Flama também é um kit de ferramentas completo para construir APIs de produção:
- Recursos com métodos CRUD padrão sobre tabelas SQLAlchemy.
- Injeção de dependências via
Components, a base do ecossistema de plugins. - Schemas adaptáveis com Pydantic, Typesystem ou Marshmallow, todos extras opcionais.
- OpenAPI gerado automaticamente, além de Swagger UI e ReDoc.
- Paginação, tarefas em segundo plano, eventos de ciclo de vida e autenticação JWT.
- HTTP com streaming em primeiro lugar, com Server-Sent Events e respostas NDJSON.
- Padrões de Domain-Driven Design: repositórios, workers e modelos de domínio.
- Codemods
flama upgradeque reescrevem imports e símbolos renomeados entre versões principais.
Exemplos
Um conjunto selecionado de exemplos executáveis, alinhado à documentação, vive em vortico/flama-examples, cobrindo fundamentos, a CLI, tópicos avançados, IA preditiva, IA generativa e domain-driven design.
Documentação
Visite https://flama.dev/docs/ para a documentação completa, incluindo o início rápido e o guia da CLI.
Use Flama com seu assistente de IA
Adicione skill.md ao seu assistente de codificação de IA e deixe-o
criar aplicativos Flama com conhecimento completo do framework.
Autores
- José Antonio Perdiguero López (@perdy)
- Miguel Durán-Olivencia (@migduroli)
Contribuindo
Este projeto é totalmente aberto a contribuições; se você tiver uma boa ideia, leia nossa documentação de contribuição antes de enviar um pull request. Perguntas e ideias são bem-vindas nas Discussões do GitHub.
Suporte
Se você acha o Flama útil para construir APIs robustas de Machine Learning e IA Generativa, a melhor maneira de apoiar nosso trabalho é nos dar uma ⭐ no GitHub — é o melhor combustível para nossos esforços de desenvolvimento. Você também pode seguir a Vortico para atualizações.
Histórico de Estrelas
Licença
Flama é distribuído sob a licença Apache 2.0.