Hindsight
Hindsight: Memória de Agente que Funciona Como a Memória Humana
Documentação


O que é Hindsight?
Hindsight™ é um sistema de memória para agentes, criado para desenvolver agentes mais inteligentes que aprendem com o tempo. A maioria dos sistemas de memória para agentes foca em recuperar o histórico de conversas. Hindsight é focado em fazer agentes que aprendem, não apenas que lembram.
Ele elimina as limitações de técnicas alternativas como RAG e grafo de conhecimento e oferece desempenho de última geração em tarefas de memória de longo prazo.
Conteúdo
- Desempenho e Precisão da Memória
- Início Rápido — servidor · clientes · plataformas · embutido
- Adicionando Hindsight ao Seu Agente — LLM Wrapper · integrações · agentes de codificação · MCP
- Conceitos Principais — tipos de memória · reter / recuperar / refletir · observações · modelos mentais e páginas de conhecimento · bancos
- Casos de Uso
- Executando em Produção
- Recursos
Desempenho e Precisão da Memória
Hindsight é o sistema de memória para agentes mais preciso já testado, de acordo com o desempenho em benchmarks. Ele alcançou desempenho de última geração no benchmark LongMemEval, amplamente utilizado para avaliar o desempenho de sistemas de memória em diversos cenários de IA conversacional. O desempenho atual relatado de Hindsight e de outras soluções de memória para agentes em janeiro de 2026 é mostrado aqui:
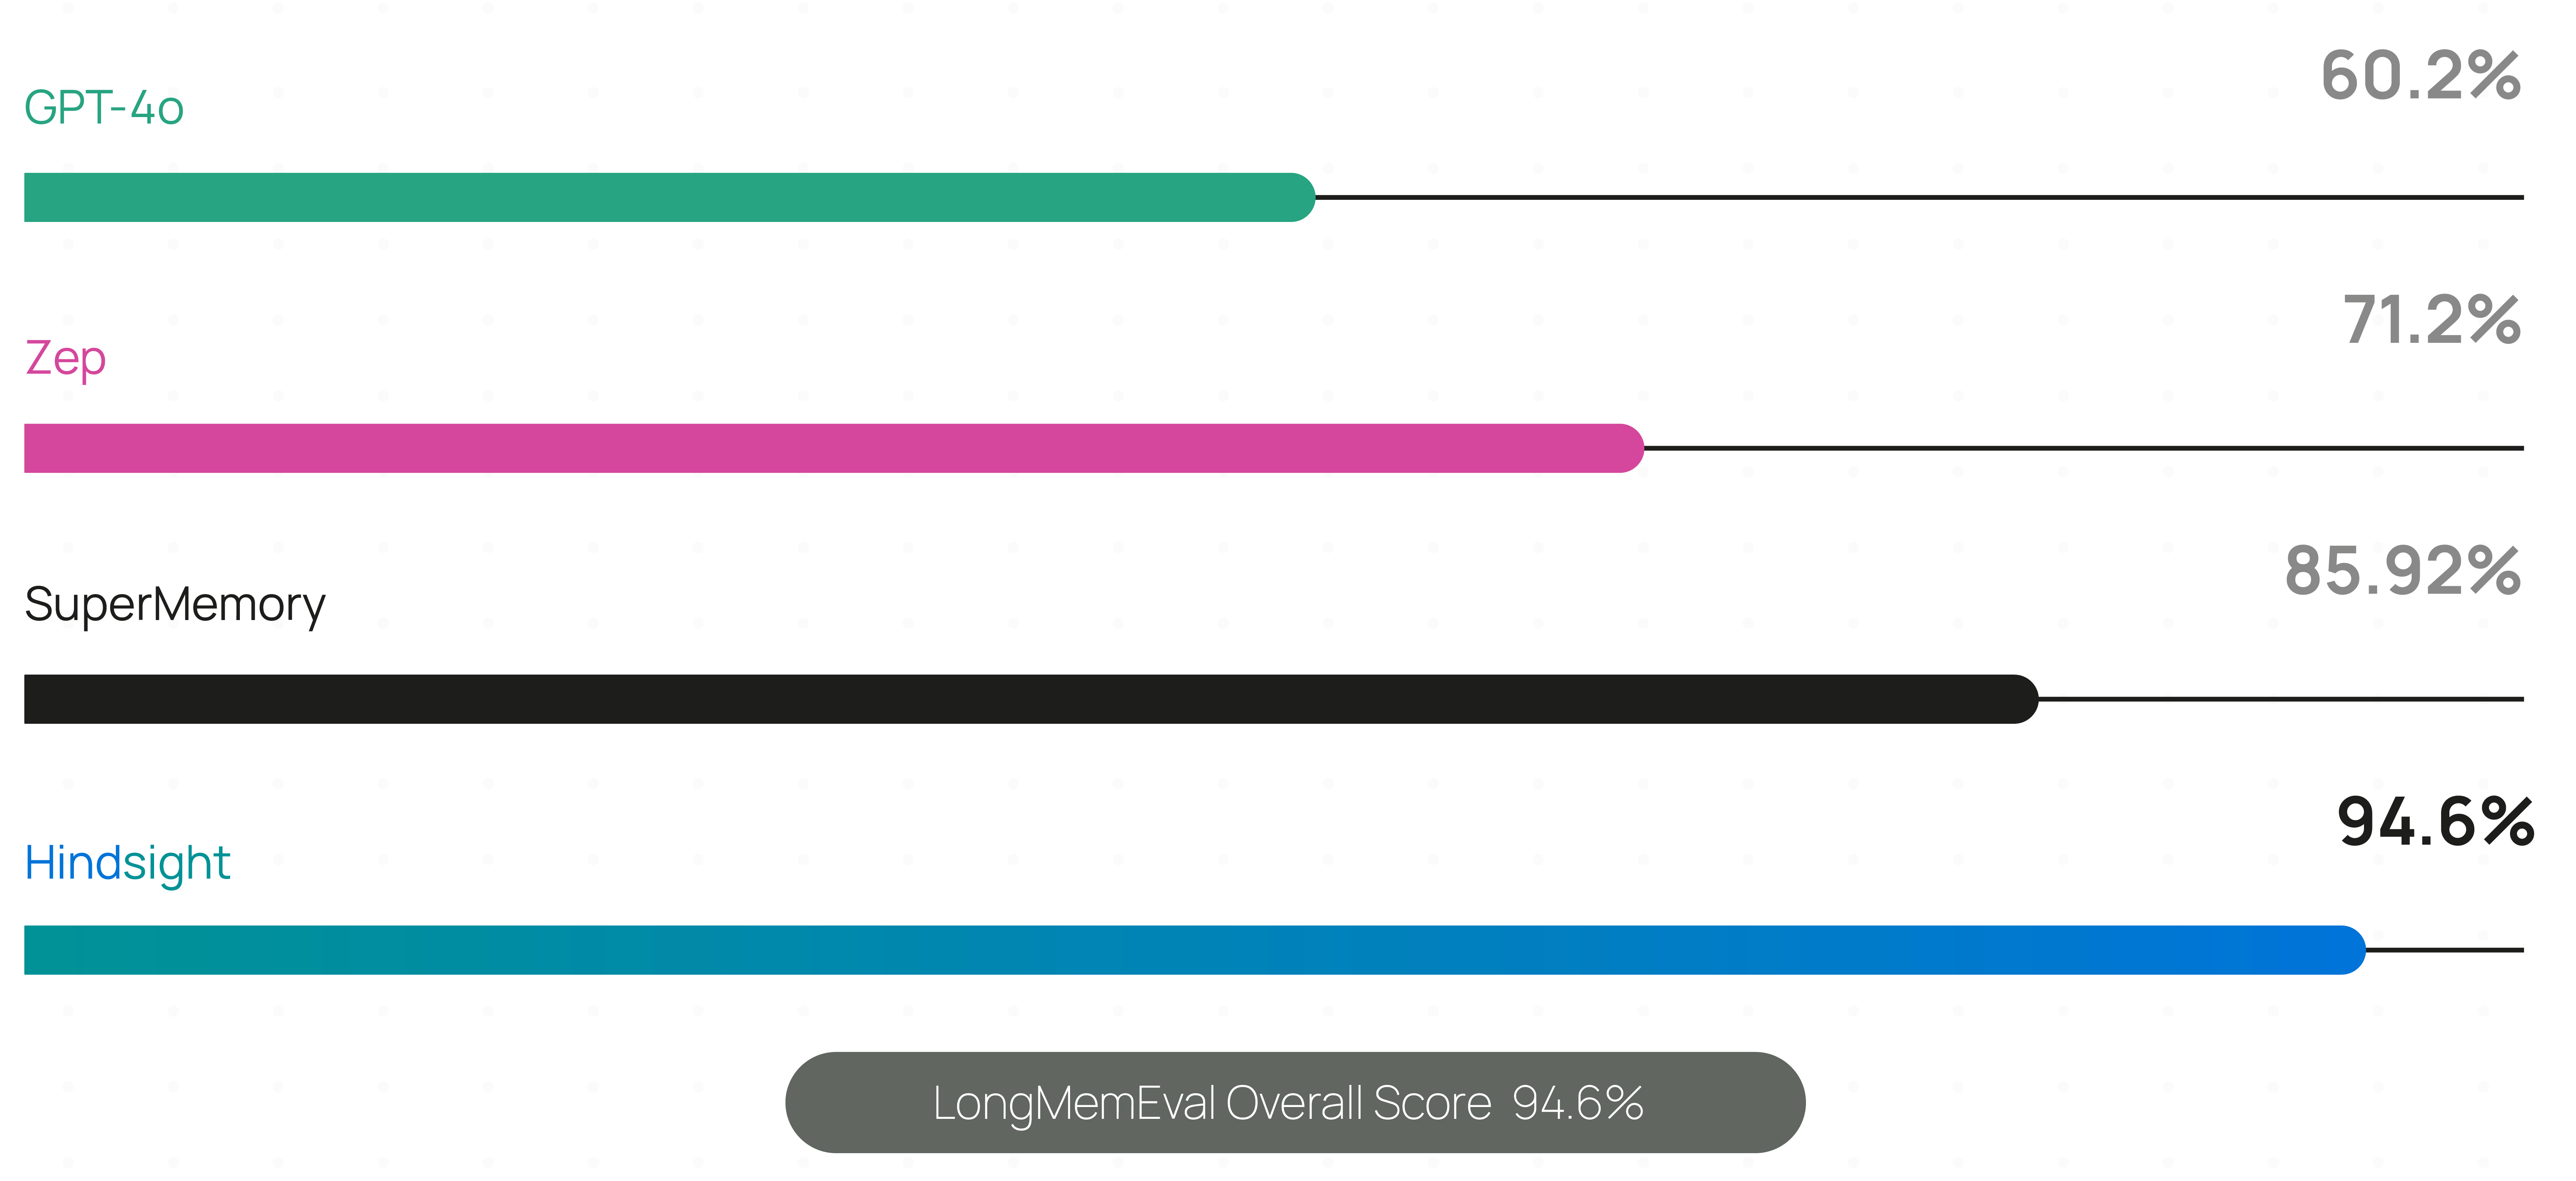
Resultados ao vivo e atualizados continuamente — incluindo precisão por modelo, latência e custo — são publicados em benchmarks.hindsight.vectorize.io.
Os dados de desempenho do benchmark para Hindsight foram reproduzidos de forma independente por colaboradores de pesquisa do Sanghani Center for Artificial Intelligence and Data Analytics da Virginia Tech e do The Washington Post. Outras pontuações são auto-relatadas pelos fornecedores de software.
Hindsight está sendo usado em produção em empresas da Fortune 500 e por um número crescente de startups de IA.
🤖 Usando um agente de codificação? Instale a skill de documentação do Hindsight para acesso instantâneo à documentação enquanto você codifica:
npx skills add https://github.com/vectorize-io/hindsight --skill hindsight-docsFunciona com Claude Code, Cursor e outros assistentes de codificação de IA.
Início Rápido
1. Inicie um servidor
Docker (recomendado)
export OPENAI_API_KEY=sk-xxx

docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
Hindsight funciona com mais de 25 provedores de LLM via HINDSIGHT_API_LLM_PROVIDER — hospedados (openai, anthropic, gemini, groq, bedrock, vertexai, minimax, deepseek, atlas, meta, …), totalmente locais (ollama, lmstudio, llamacpp), qualquer endpoint compatível com OpenAI e gateways (litellm, litellmrouter) que alcançam o restante. Assinaturas existentes também funcionam: openai-codex (ChatGPT Plus/Pro), claude-code (Claude Pro/Max) e github-copilot (GitHub Copilot) não precisam de chave de API. Consulte modelos suportados.
Docker (PostgreSQL externo)
export OPENAI_API_KEY=sk-xxx
export HINDSIGHT_DB_PASSWORD=choose-a-password
cd docker/docker-compose
docker compose up
O Oracle AI Database também é suportado para implantações empresariais com paridade total de recursos. Consulte a documentação de armazenamento para detalhes.
Bare metal (pip)
pip install hindsight-api
export HINDSIGHT_API_LLM_API_KEY=sk-xxx

hindsight-api
Kubernetes (Helm)
helm install hindsight oci://ghcr.io/vectorize-io/charts/hindsight \
  --set api.llm.provider=openai \
  --set api.llm.apiKey=sk-xxx \
  --set postgresql.enabled=true
Gerenciado (sem servidor)
Hindsight Cloud é a opção hospedada: infraestrutura gerenciada que escala automaticamente, além de um painel, backups, colaboração em equipe e um SLA de disponibilidade de 99,9%. O faturamento é baseado no uso, com créditos gratuitos para começar — sem taxa mensal fixa ou por assento. Aponte qualquer cliente para https://api.hindsight.vectorize.io com sua chave de API e pule a implantação completamente.
Compare self-hosted, Cloud e Enterprise → · Cadastre-se →
Todas as opções, incluindo Windows e configurações air-gapped, são abordadas no guia de instalação.
2. Conecte um cliente
pip install hindsight-client -U                                  # Python
npm install @vectorize-io/hindsight-client                        # Node.js / TypeScript
go get github.com/vectorize-io/hindsight/hindsight-clients/go     # Go
curl -fsSL https://hindsight.vectorize.io/get-cli | bash          # CLI
Python
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")

# Retain: Store information
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")

# Recall: Search memories
client.recall(bank_id="my-bank", query="What does Alice do?")

# Reflect: Generate disposition-aware response
client.reflect(bank_id="my-bank", query="Tell me about Alice")
Node.js / TypeScript
const { HindsightClient } = require('@vectorize-io/hindsight-client');

const main = async () => {
  const client = new HindsightClient({ baseUrl: 'http://localhost:8888' });

  await client.retain('my-bank', 'Alice loves hiking in Yosemite');

  const results = await client.recall('my-bank', 'What does Alice like?');
  console.log(results);
}

main();
Referência completa: Python · Node.js · Go · CLI · REST API
Plataformas Suportadas
| Plataforma | Docker | Bare Metal (pip) | Banco Embutido (pg0) |
|---|---|---|---|
| Linux (x86_64, ARM64) | ✅ | ✅ | ✅ |
| macOS (Apple Silicon / arm64) | ✅ | ✅ | ✅ |
| macOS (Intel / x86_64) | ✅ | ⚠️ | ✅ |
| Windows (x86_64) | ✅ | ✅ | ✅ |
⚠️ Macs Intel: use hindsight-all-slim — consulte o guia de instalação para detalhes.
Python Embutido (sem servidor necessário)
pip install hindsight-all -U
Em Macs Intel (x86_64), instale hindsight-all-slim — consulte Plataformas Suportadas.
import os
from hindsight import HindsightServer, HindsightClient

with HindsightServer(
    llm_provider="openai",
    llm_model="gpt-5-mini",
    llm_api_key=os.environ["OPENAI_API_KEY"]
) as server:
    client = HindsightClient(base_url=server.url)
    client.retain(bank_id="my-bank", content="Alice works at Google")
    results = client.recall(bank_id="my-bank", query="Where does Alice work?")
Um equivalente para Node.js e um CLI daemon também estão disponíveis.
Adicionando Hindsight ao Seu Agente
LLM Wrapper (2 linhas de código)
A maneira mais fácil de adicionar memória a um agente existente é o LLM Wrapper. Troque seu cliente de LLM por um wrapper — as memórias são então armazenadas e recuperadas automaticamente em cada chamada, sem outras alterações no seu código.
pip install hindsight-litellm
from openai import OpenAI
from hindsight_litellm import wrap_openai

# Wrap your existing LLM client and you're done.
# Defaults to Hindsight Cloud; pass hindsight_api_url for a self-hosted server.
client = wrap_openai(
    OpenAI(),
    bank_id="user-123",
    hindsight_api_url="http://localhost:8888",
)

# Hindsight recalls relevant memories before the call
# and retains the conversation after it.
response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "What do you know about me?"}],
)
wrap_anthropic() faz o mesmo para o SDK da Anthropic, e cada configuração — banco, orçamento de recuperação, tipos de fato, refletir em vez de recuperar — pode ser substituída por chamada com kwargs hindsight_*. O LiteLLM fica por baixo, então a mesma integração cobre mais de 100 modelos. Consulte a integração LiteLLM.
Se você precisar de controle explícito sobre quando as memórias são armazenadas e recuperadas, use os SDKs ou a REST API diretamente.
Integrações
Mais de 60 integrações — a maioria não precisa de alterações no código.
| Agentes de codificação | Claude Code · Codex · Cursor · GitHub Copilot · opencode · Cline · Aider · Zed · Continue · Roo Code · OpenHands |
| Frameworks de agentes | LangGraph / LangChain · LlamaIndex · CrewAI · Pydantic AI · OpenAI Agents SDK · Google ADK · Agno · Strands · AutoGen · Microsoft Agent Framework · Vercel AI SDK · Haystack |
| No-code / low-code | n8n · Zapier · Dify · Flowise |
| Apps e ferramentas | ChatGPT · Perplexity · Obsidian · Pipecat · Vapi |
👉 Explore todas as integrações
Agentes de Codificação
Um único pacote dá aos agentes de codificação CLI memória de longo prazo para projetos: um banco por repositório construído automaticamente a partir do histórico do git e sessões passadas, injetado no agente quando ele começa a trabalhar, além de páginas de conhecimento selecionadas cobrindo arquitetura, convenções e trabalho em andamento.
npx @vectorize-io/hindsight-coding-agents install all          # every detected agent, wired natively
npx @vectorize-io/hindsight-coding-agents install claude-code  # or just one
Suporta Claude Code, Codex CLI, Cursor CLI, GitHub Copilot CLI, opencode, Kilo CLI, Cline CLI, Antigravity CLI, Devin CLI, pi, Prime Agent, Grok Build e DeepSeek Harness. A ingestão é automática — não há comando de configuração. Consulte a integração de agentes de codificação.
Servidor MCP
Todo servidor inclui um endpoint Model Context Protocol integrado, um por banco, habilitado por padrão:
http://localhost:8888/mcp/{bank_id}/
Aponte qualquer cliente MCP para ele para expor reter, recuperar e refletir como ferramentas. Consulte a documentação do servidor MCP.
Conceitos Principais
Tipos de Memória
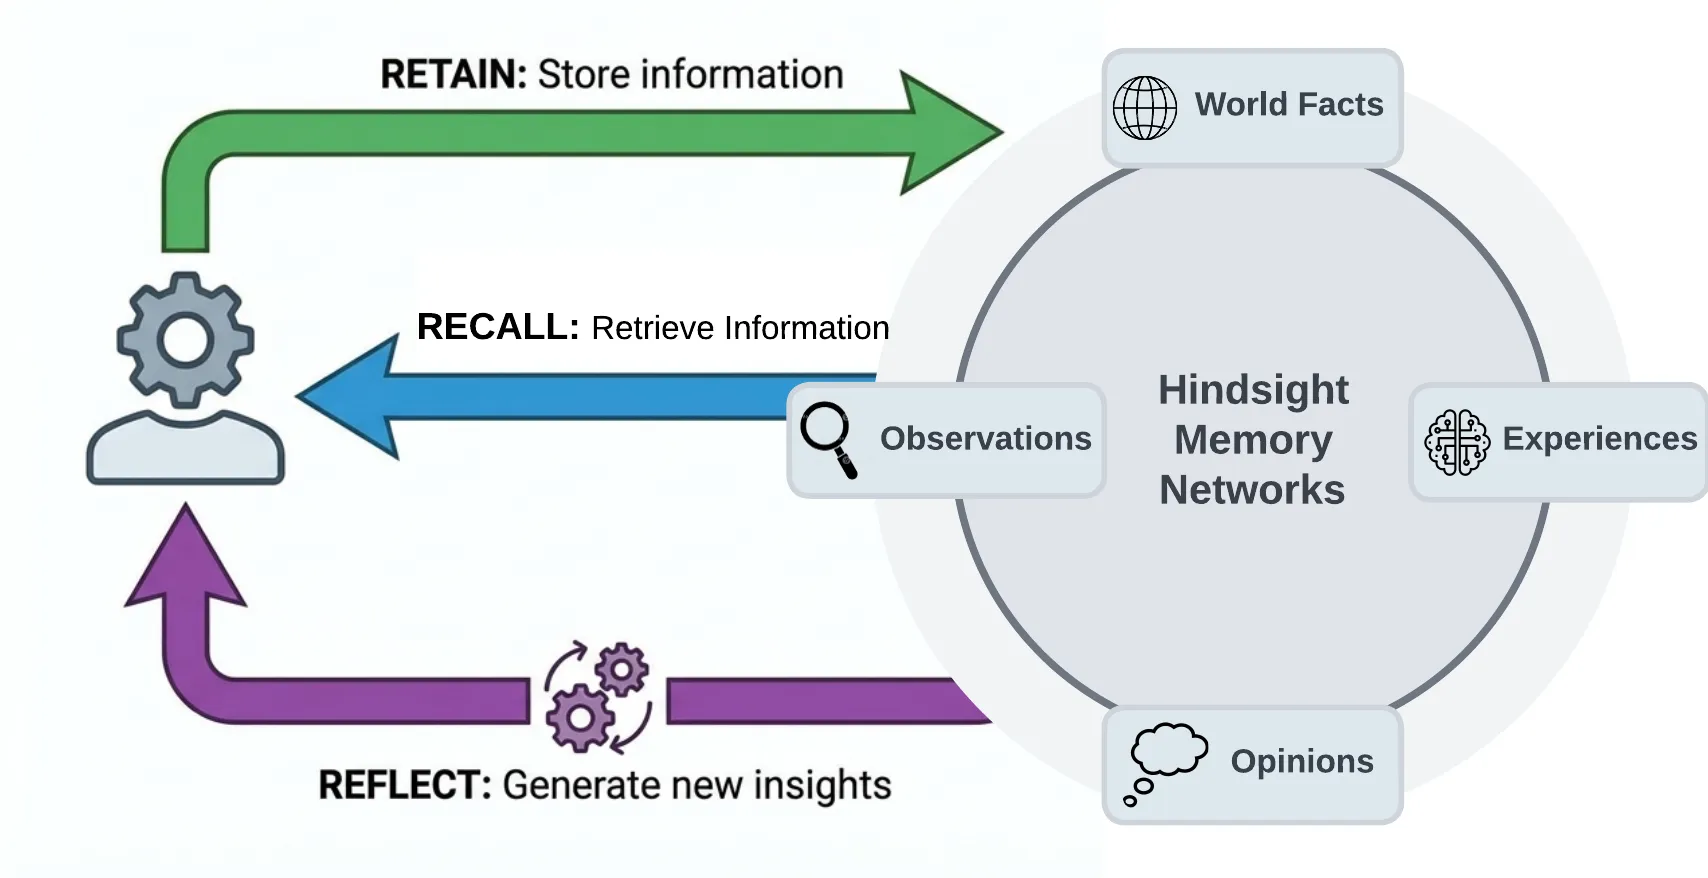
A maioria das implementações de memória para agentes depende de busca vetorial básica ou às vezes usa um grafo de conhecimento. Hindsight usa estruturas de dados biomiméticas para organizar as memórias do agente de uma maneira mais parecida com o funcionamento da memória humana:
- Fatos do mundo: fatos sobre o mundo ("O fogão esquenta")
- Experiências: as próprias experiências do agente ("Toquei no fogão e doeu muito")
- Observações: crenças consolidadas e baseadas em evidências, formadas a partir de muitas memórias
- Modelos mentais: compreensão aprendida do mundo do agente, sintetizada a partir de observações e fatos
As memórias vivem em bancos. Quando as memórias são adicionadas, elas são direcionadas para o caminho de fatos do mundo ou de experiências e, em seguida, representadas como uma combinação de entidades, relacionamentos e séries temporais com representações vetoriais esparsas/densas para auxiliar na recuperação posterior.
As Três Operações
Reter
A operação retain é usada para enviar novas memórias para o Hindsight. Ela diz ao Hindsight para reter a informação que você passa como entrada.
client.retain(
    bank_id="my-bank",
    content="Alice got promoted to senior engineer",
    context="career update",
    timestamp="2025-06-15T10:00:00Z",
)
Nos bastidores, reter usa um LLM para extrair fatos-chave, dados temporais, entidades e relacionamentos. Eles passam por um processo de normalização para transformar os dados extraídos em entidades canônicas, séries temporais e índices de busca, juntamente com metadados. Essas representações criam os caminhos para a recuperação precisa de memórias nas operações de recuperar e refletir.

Recuperar
A operação de recuperar é usada para obter memórias. Essas memórias podem vir de qualquer um dos tipos de memória (mundo, experiências, etc.)
client.recall(bank_id="my-bank", query="What does Alice do?")
client.recall(bank_id="my-bank", query="What happened in June?")   # temporal
Recuperar executa 4 estratégias de busca em paralelo:
- Semântica: similaridade vetorial
- Palavras-chave: correspondência exata BM25
- Grafo: links de entidade/temporal/causa
- Temporal: filtragem por intervalo de tempo

Os resultados individuais são mesclados, ordenados por relevância usando fusão de classificação recíproca e um modelo de reclassificação cross-encoder, e então ajustados conforme necessário para caber no limite de tokens.
Refletir
A operação de refletir realiza uma análise mais aprofundada das memórias existentes. Isso permite que o agente forme novas conexões entre memórias e construa uma compreensão mais completa do seu mundo — ou responda a uma pergunta que exige pensamento profundo em vez de busca.
client.reflect(bank_id="my-bank", query="What should I know about Alice?")
Por exemplo, refletir suporta casos de uso como:
- Um Gerente de Projeto de IA refletindo sobre quais riscos precisam ser mitigados em um projeto.
- Um Agente de Vendas refletindo sobre por que certas mensagens de divulgação tiveram respostas e outras não.
- Um Agente de Suporte refletindo sobre oportunidades em que os clientes têm perguntas não respondidas pela documentação atual do produto.

Observações
Os fatos retidos não ficam em uma pilha plana. Em segundo plano, o Hindsight consolida fatos relacionados em observações — crenças deduplicadas que o banco construiu ao longo do tempo. Cada observação mantém suas evidências de apoio com citações exatas e uma contagem de provas, e é refinada em vez de sobrescrita quando novas evidências chegam, então novas informações fortalecem, enfraquecem ou estendem uma crença existente em vez de substituí-la silenciosamente.
Modelos Mentais e Páginas de Conhecimento
Um modelo mental é uma resposta permanente a uma pergunta sobre um banco ("Quais são as preferências deste usuário?"). Você define a pergunta uma vez; o Hindsight escreve a resposta, armazena-a e a reescreve em segundo plano conforme o banco aprende mais. Ler um modelo mental é uma leitura de banco de dados — sem recuperação, sem chamada de LLM — então um agente pode iniciar com uma página de conhecimento consolidado em vez de redescobri-lo a cada sessão.
Páginas de conhecimento são modelos mentais com a mecânica oculta: documentos vivos que um banco escreve sobre si mesmo, organizados em pastas como uma wiki, pesquisáveis e projetáveis em disco como markdown comum. Forneça um nome e uma pergunta; todas as outras decisões são padrões que você pode substituir.
Modelos mentais → · Páginas de conhecimento →
Bancos de Memória
Um banco é um armazenamento de memória isolado — um "cérebro" para um usuário, agente ou projeto. O isolamento é estrito: sem vazamento entre bancos. Os bancos carregam contexto de fundo e traços de disposição (ceticismo, literalismo, empatia) que moldam como o reflect raciocina sobre suas memórias, e podem ser criados a partir de modelos de banco declarativos.
Mais duas coisas que vale a pena saber:
- Multilíngue por padrão. O idioma de entrada é detectado e preservado de ponta a ponta — os fatos permanecem no idioma original e as entidades mantêm sua escrita nativa (张伟 permanece 张伟, não "Zhang Wei"). Docs →
- Defesa de Memória. Uma política opcional por banco que verifica cada retenção em busca de segredos e PII contra 45 padrões e ou redige a correspondência (
[REDACTED:github_token]) ou bloqueia o item antes que ele chegue ao armazenamento. Docs →
Casos de Uso
O Hindsight é construído para suportar agentes de IA conversacionais, bem como agentes destinados a executar tarefas de forma autônoma. O caso de uso ideal para o Hindsight são agentes que exigem uma combinação desses recursos, como funcionários de IA que precisam lidar com tarefas abertas, mudar o comportamento com base no feedback do usuário e aprender a executar tarefas complexas para automatizar o trabalho em um nível que se aproxima do trabalho humano. O Hindsight pode ser usado com fluxos de trabalho de IA simples, como aqueles construídos com n8n e outras ferramentas semelhantes, mas pode ser excessivo para tais aplicações.
Memórias por Usuário e Histórico de Chat
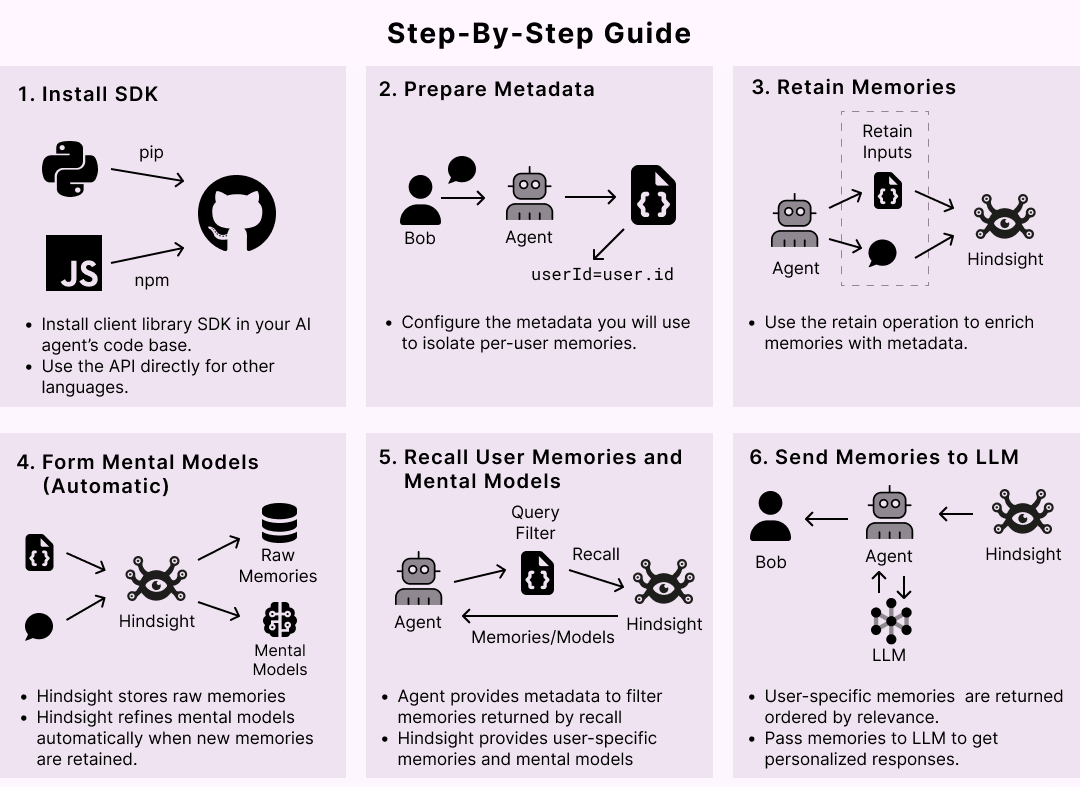
Um dos casos de uso mais simples para o Hindsight é personalizar chatbots de IA e outros agentes conversacionais, armazenando e recuperando memórias associadas a usuários individuais.
Os requisitos para este caso de uso geralmente se parecem com isto:
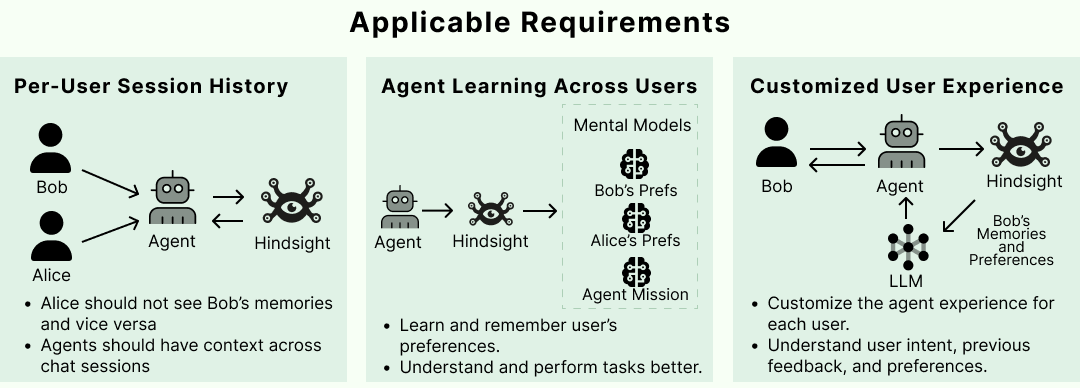
Atender a esses requisitos no Hindsight é simples. Quando novas entradas do usuário e chamadas de ferramentas são ingeridas no Hindsight usando a operação de retenção, metadados personalizados podem ser usados para enriquecer as novas memórias. Os metadados fornecem uma maneira conveniente de isolar memórias que precisam ser restritas a um determinado usuário. Uma vez alimentadas na operação de retenção, quaisquer memórias brutas e modelos mentais criados podem ser filtrados ao recuperar memórias relevantes.
Mais padrões no Cookbook e Best Practices.
Executando em Produção
| Armazenamento | PostgreSQL + pgvector, ou Oracle AI Database 23ai com paridade total de recursos — armazenamento |
| Configuração | Hierárquica: variáveis de ambiente globais → por locatário → por banco — configuração |
| Monitoramento | Métricas e painéis Prometheus para chamadas de LLM, tokens e latência — monitoramento |
| Operações | CLI administrativo para migrações, reparo de bancos e operações travadas — CLI administrativo |
| Eventos | Webhooks para eventos de ciclo de vida de retenção, consolidação e atualização — webhooks |
| Extensibilidade | Pontos de extensão para locatário, autenticação e armazenamento — extensões |
| Gerenciado | Pule tudo isso com o Hindsight Cloud — gerenciado, baseado em uso, SLA de 99,9% de disponibilidade |
Recursos
Documentação:
- Docs · FAQ · Best Practices · Cookbook · Blog
- Paper · Benchmarks · RAG vs Memória
Clientes:
Comunidade:
Histórico de Estrelas
Contribuindo
Consulte CONTRIBUTING.md.
Licença
MIT — consulte LICENSE
Construído por Vectorize.io