ContextBridge
Recuperação de código local-first para agentes de IA — reduz o contexto do código base de milhares de tokens para algumas centenas, com zero caminhos de arquivo alucinados.
Documentação
ContextBridge
Por que ContextBridge?
Sem a CB, um agente de codificação de IA ou adivinha quais arquivos são relevantes, ou você cola arquivos de código-fonte inteiros no chat — queimando milhares de tokens de entrada em código que não é necessário.
Com a CB, a IA chama uma única ferramenta MCP e recebe um resultado compacto e ranqueado: o arquivo dono, arquivos relacionados, símbolos-chave e um resumo de dependências — tipicamente algumas centenas de tokens em vez de dezenas de milhares de linhas de código-fonte bruto.
Isso não se limita a investigações de bugs — a mesma ferramenta responde perguntas gerais sobre como um recurso ou fluxo de trabalho existente é implementado.
| Sem CB | Com CB |
|---|---|
| Colar 10–50 arquivos brutos no contexto | A CB retorna os 3–5 arquivos que realmente importam |
| A IA adivinha qual código é relevante | O resultado é fundamentado na estrutura real do seu código |
| Alto custo de tokens, contexto ruidoso | Baixo custo de tokens, contexto focado |
| Caminhos de arquivo e nomes de métodos alucinados | Caminhos de arquivo, símbolos e dicas de linha exatos |
O estágio opcional de análise de IA local comprime ainda mais o resultado antes de chegar à sua IA na nuvem — então você paga ainda menos.
Nota de escopo: ContextBridge é uma ferramenta de roteamento e recuperação de código, não um mecanismo de raciocínio — ela encontra os arquivos, símbolos e conexões certos, mas não prova causalidade nem escolhe a correção para você. Veja Escopo pretendido para o limite completo.
💡 Novo aqui? Não quer ler tudo? Peça ao seu assistente de IA (Claude, ChatGPT, Gemini, etc.) para ler a pasta
docs/e guiá-lo na configuração para o seu sistema operacional e projeto.
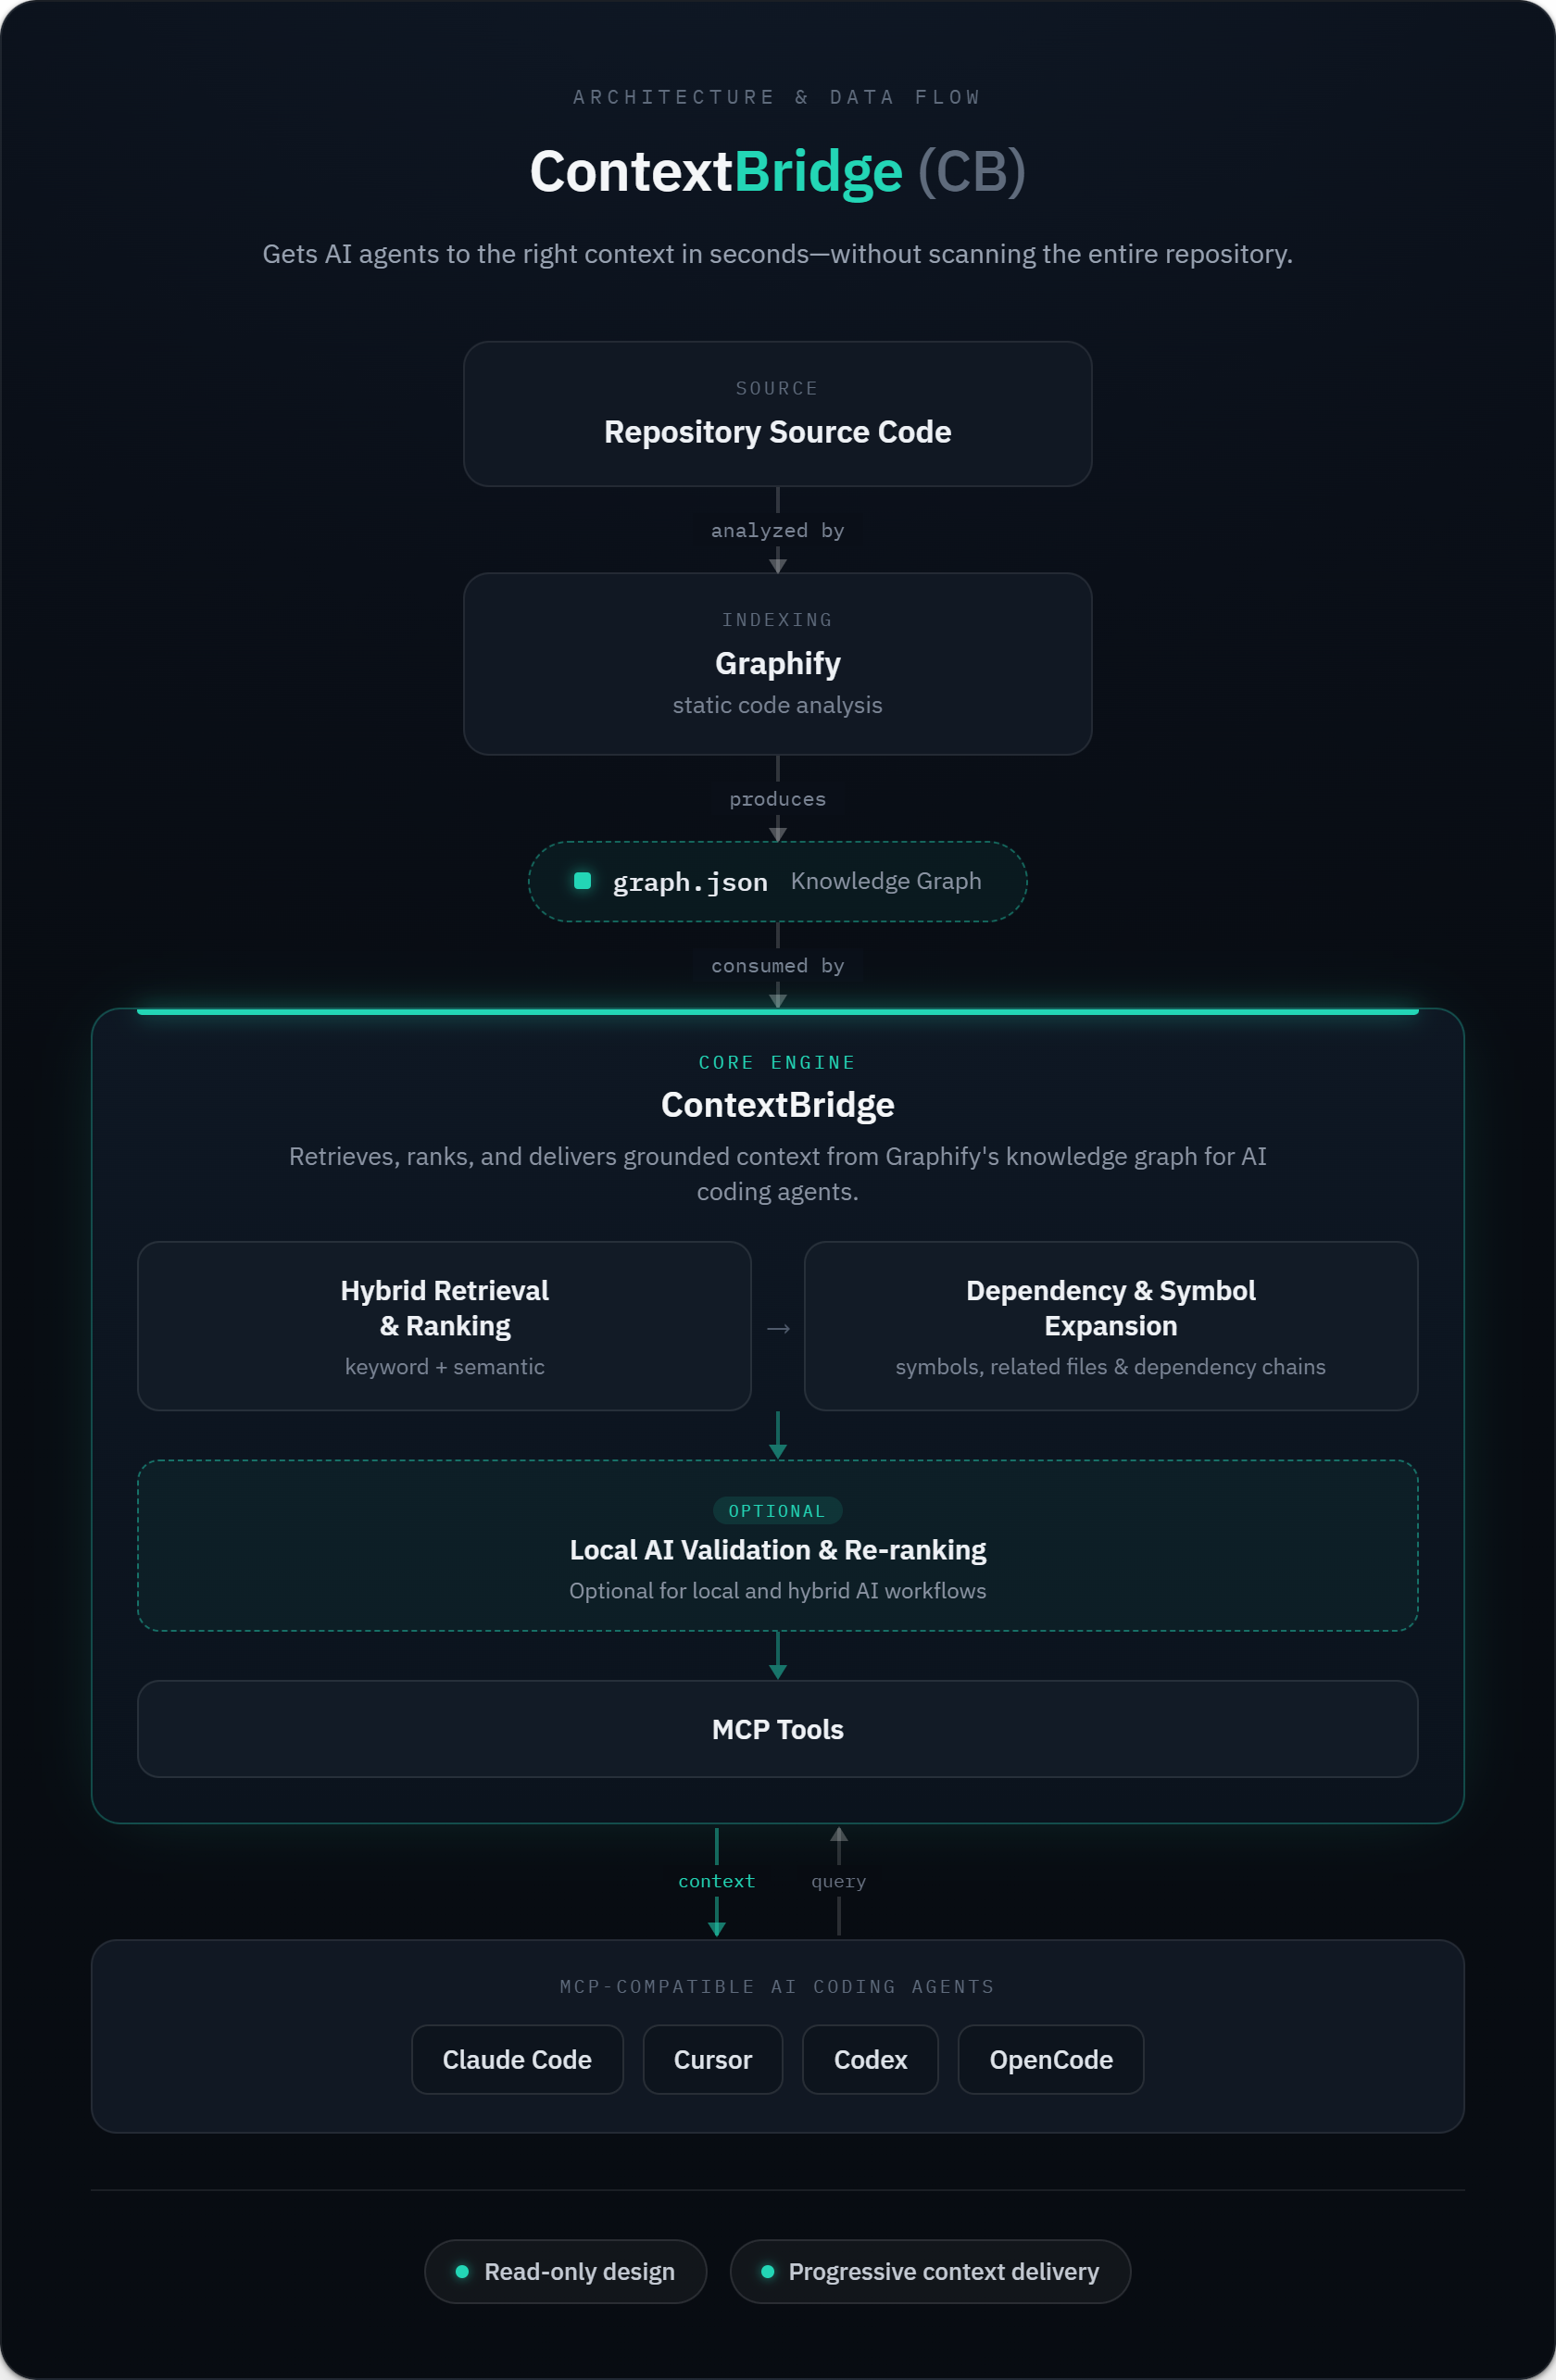
Uma camada de recuperação de código local-first para agentes de codificação de IA. A ContextBridge indexa seu código (via saída do Graphify) e expõe ferramentas MCP que qualquer cliente de IA (Claude Code, Codex, Cursor, Antigravity, …) pode chamar para obter arquivos, símbolos e cadeias de dependência ranqueados — opcionalmente validados e re-ranqueados por um LLM local antes de a resposta chegar à sua IA na nuvem.
Your prompt ─► ContextBridge (keyword + vector retrieval)
            ─► Local AI (optional: validates, re-ranks, fills gaps)
            ─► Your AI agent (implements, grounded in real files)
O mecanismo é genérico. Todo o ranqueamento específico do projeto vive em um plugin de perfil substituível, então a mesma ferramenta funciona para qualquer base de código.
Arquitetura
Como seu código flui pela ContextBridge até seu agente de IA:
Painel
A ContextBridge inclui um painel local para monitorar a qualidade da recuperação, a saúde do índice e a configuração — sem dependência de nuvem.
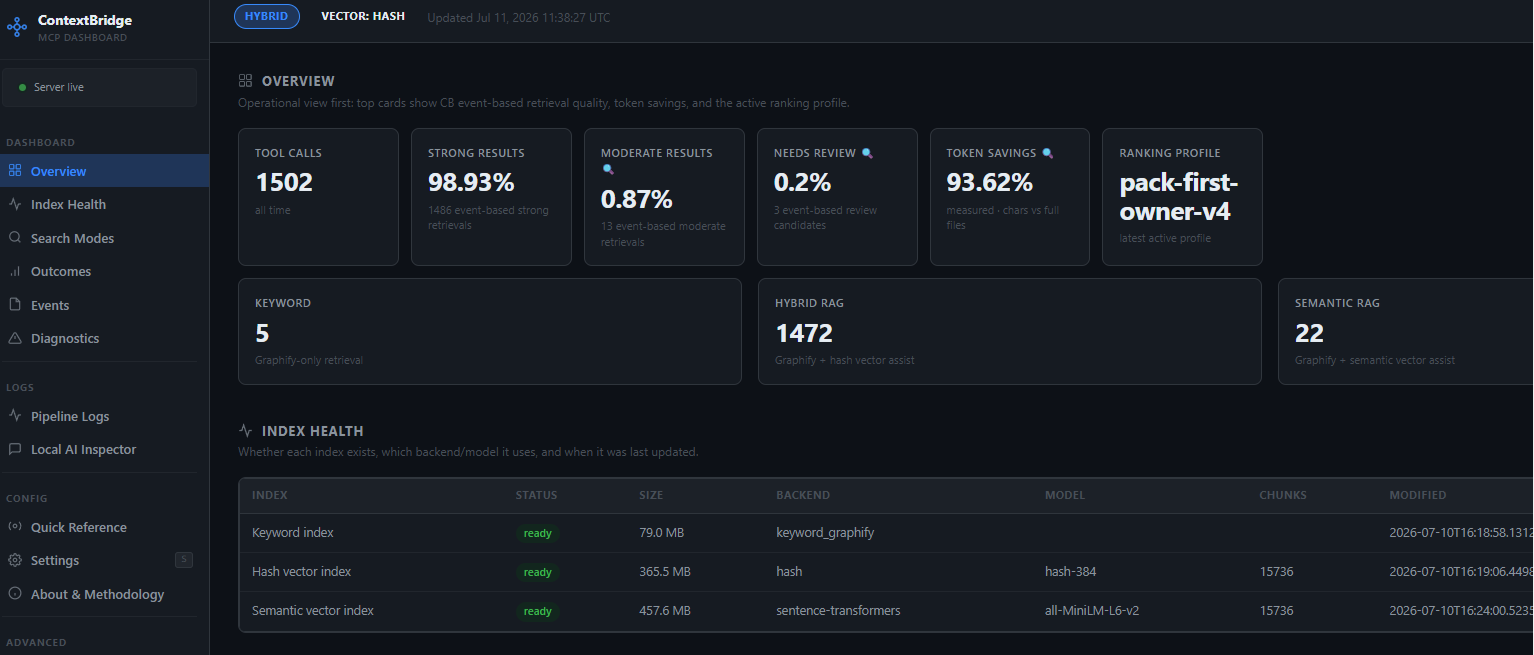
Visão geral — qualidade da recuperação, economia de tokens e detalhamento do modo de busca
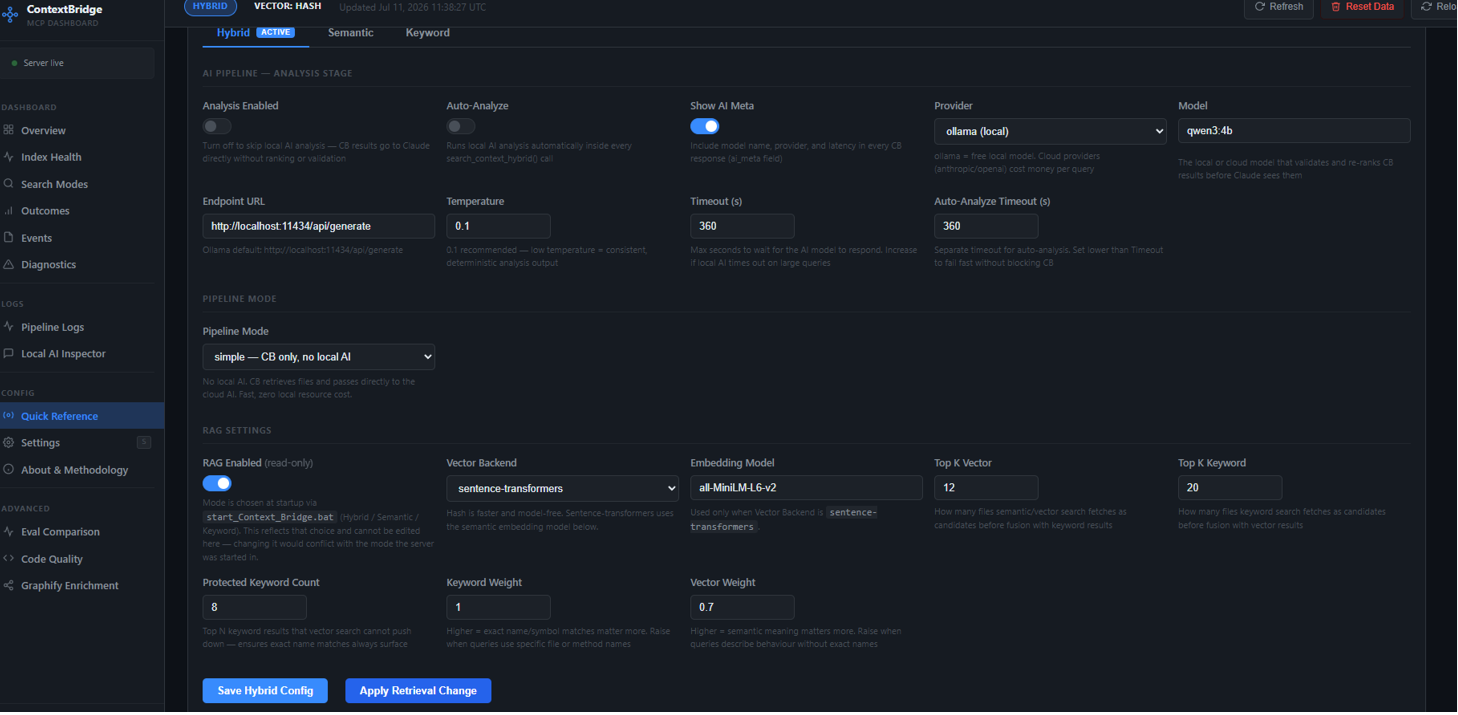
Configurações — ajuste o modo do pipeline, pesos RAG e configuração do modelo ao vivo
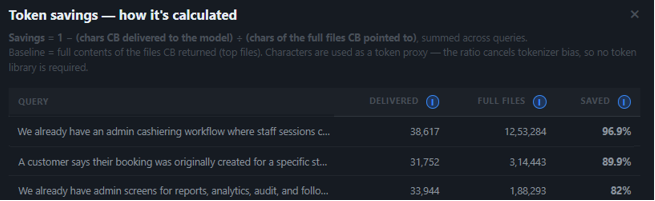
Economia de tokens — detalhamento por consulta do que a CB entregou vs. custo do arquivo completo
📖 Antes de começar — leia a documentação. A pasta
docs/contém tudo o que você precisa para configuração completa, pipeline e criação de perfis. Comece comdocs/0. README.mdpara um índice guiado de toda a documentação.
Início rápido
:: 1. Install deps + build the index + scaffold config files
context_bridge\setup\windows\setup_context_bridge.bat

:: 2. Point the config at YOUR source folders
::    edit config.hybrid.json  ->  settings.discovery.*  (replace your_backend / your_frontend)

:: 3. Re-run setup to index your code
context_bridge\setup\windows\setup_context_bridge.bat

:: 4. Start the server + dashboard (pick Hybrid / Semantic / Keyword)
context_bridge\setup\windows\1.  start_Context_Bridge.bat
Mac/Linux: use context_bridge/setup/mac/ ou equivalentes context_bridge/setup/linux/.
A configuração é re-executável e segura: ela cria arquivos de configuração/início a partir dos modelos *.example somente se estiverem ausentes (nunca sobrescreve suas edições) e reconstrói o índice a cada execução. Execute setup_context_bridge.bat --force para redefinir as configurações para os modelos.
O servidor MCP roda com SSE por padrão em http://127.0.0.1:8755/sse — aponte seu cliente de IA para lá. O transporte Stdio também é suportado (defina CONTEXT_BRIDGE_TRANSPORT=stdio antes de iniciar) para clientes que não suportam SSE; SSE é recomendado, pois permite que vários clientes de IA compartilhem um único servidor em execução em vez de cada um gerar seu próprio processo. Painel: http://127.0.0.1:8795. As estatísticas ao vivo podem ficar até ~15 segundos atrasadas em relação à atividade mais recente, e as listas de histórico (eventos recentes, arquivos perdidos, consultas com falha) mostram as 1000 entradas mais recentes em vez do log completo de toda a vida — ambos são tradeoffs intencionais de desempenho, não perda de dados.
Modos de recuperação
Escolhidos na inicialização (o script de início seleciona o arquivo de configuração correspondente):
| Modo | Configuração | O que faz |
|---|---|---|
| Híbrido | config.hybrid.json | Primeiro por palavras-chave + assistência vetorial protegida (recomendado) |
| Semântico | config.semantic.json | Somente vetores (requer sentence-transformers) |
| Palavras-chave | config.json | Somente palavras-chave, sem vetores |
Ferramentas MCP
| Ferramenta | Uso |
|---|---|
search_context_hybrid() | Principal — descoberta ampla de arquivos + contexto (executa análise automaticamente) |
find_code_locations() | Arquivo dono / símbolo / linha exatos para um método ou classe |
get_module_summary() | Visão geral de um módulo/serviço |
get_graphify_pack() | Todos os arquivos em um pacote de recursos |
record_outcome() | Registrar se um resultado ajudou |
health_check(), get_usage_summary(), search_context(), find_related_files() | Utilitário |
Quais ferramentas aparecem é controlado pela configuração — se uma ferramenta está registrada, é seguro chamá-la.
Escrevendo seu próprio perfil
O mecanismo genérico pede a um perfil o ranqueamento específico do projeto a cada etapa. Sem perfil (project_profile: "default") você obtém pontuação genérica pura.
- Copie
rules/projects/example_profile.py→rules/projects/<yourapp>_profile.py - Implemente os hooks que você precisa (todo hook é opcional — hooks ignorados caem para no-op)
- Ative-o: defina
CONTEXT_BRIDGE_PROFILE=<yourapp>no seu script de início, ouproject_profile: "<yourapp>"na sua configuração
Hooks de perfil (todos opcionais)
| Hook | Propósito |
|---|---|
expand_query_tokens(query, tokens) | Adicionar tokens de busca extras |
module_intent_tokens() | Mapear nome do módulo → vocabulário |
pinned_owner_files(query_tokens) | Forçar arquivos específicos para o topo |
adjust_document_score(...) | Aumentar/penalizar um documento candidato |
adjust_owner_score(...) | Aumentar/penalizar um arquivo dono pelo nome |
adjust_primary_owner_score(...) | Ajustar o único dono primário |
adjust_scoped_score(...) | Preferir arquivos sob o módulo/pacote dominante |
extra_owner_file_patterns() | Padrões de nome de arquivo extras de alta prioridade |
infer_module_from_path(path) | Caminho → nome do módulo (escopo de fusão) |
low_signal_terms() | Palavras de módulo/domínio a tratar como baixo sinal |
noise_files() | Nomes de arquivo a despriorizar (ui/suporte/raiz) |
gap_queries() | Palavras de gatilho → consulta de re-busca limpa |
analysis_prompt_override() | Prompt de sistema completo para a IA local |
pack_files_for_intents(...) | Mapear intenções → arquivos de pacote do Graphify (avançado) |
Veja docs/ para guias estendidos sobre configuração, pipeline, criação de perfis e comandos de depuração.
Indexação
A ContextBridge indexa a saída do Graphify (graph.json, GRAPH_REPORT.md, source-files.txt, scope-summary.md, manifest.json) além dos documentos /behavior/ — não o código-fonte bruto. Gere o Graphify para o seu projeto, aponte settings.discovery.* para essas pastas e execute a configuração. Re-execute a configuração após cada atualização do Graphify para atualizar o índice.
IA local (opcional)
Configure um modelo local em pipeline.analysis_stage (provedor ollama por padrão, ou anthropic/openai/openrouter). Quando habilitado, ele valida e re-ranqueia os resultados da CB, decompõe prompts de múltiplos tópicos e dispara re-buscas de lacunas — depois passa um resultado compacto e fundamentado para sua IA na nuvem. Troque os modelos alterando apenas model; os prompts são independentes de modelo.
Licença
Copyright 2026 Tiju Thomas
Licenciado sob a Apache License, Versão 2.0.