LLMSlim Memory
Memória de longo prazo para clientes MCP sem chamada de LLM. Armazena mensagens palavra por palavra em SQLite local e recupera as que respondem a uma pergunta dentro de um orçamento de tokens.
Documentação



A camada de contexto para agentes de IA em produção. Este repositório é o LLMSlim Core (v0.11.1, MIT): planejamento e compressão de contexto local-first que encaixa prompts, histórico de conversas, RAG, memória e schemas de ferramentas em orçamentos reais de tokens, preservando instruções e limites de execução.
Playground do Studio ao vivo • Documentação • Integração com Sarvam • Benchmarks • Changelog
Experimente em 60 segundos
1. Instale o LLMSlim Core a partir do PyPI (Python 3.9+). Executá-lo não exige chave de API, modelo nem chamada de rede:
pip install llmslim
2. Execute este trecho:
from llmslim import compress

ticket = """
Hi team, I hope you are all doing well and had a good weekend.
I am writing about invoice INV-2291, which charged us $480 instead of $240.
We upgraded to the Pro plan on 3 September, but the old Basic plan was billed as well.
Our finance lead was asking about this during the weekly sync, which ran long as usual.
Please refund the duplicate $240 charge to the card ending 4417.
Thanks so much, and let me know if you need anything else from me.
"""

result = compress(ticket, target_ratio=0.6)  # target: keep about 60% of the tokens
print(result.compressed_text)
print(f"{result.original_tokens} -> {result.compressed_tokens} tokens ({result.reduction_percent:.1f}% fewer)")
3. O que você deve ver (llmslim 0.11.1, instalação base):
Hi team, I hope you are all doing well and had a good weekend. I am writing about invoice INV-2291, which charged us $480 instead of $240. We upgraded to the Pro plan on 3 September, but the old Basic plan was billed as well. Please refund the duplicate $240 charge to the card ending 4417.
112 -> 72 tokens (35.7% fewer)
Duas das seis frases são descartadas; o número da fatura, os valores, a mudança de plano
e a solicitação de reembolso são mantidos. O modo extrativo padrão apenas seleciona frases
da sua entrada, então a mesma entrada sempre gera a mesma saída. A instalação base
estima tokens em cerca de 4 caracteres por token e imprime um aviso de uma linha
informando isso. Com pip install "llmslim[fast-tokens]", os tokens são contados com
tiktoken: nesta entrada, as mesmas quatro frases são mantidas, e a contagem
aparece como 107 -> 72 tokens (32.7% fewer).
Próximo: Docs • Beta da plataforma • Issues
Se o LLMSlim for útil, considere dar uma estrela ao repositório ou abrir uma issue com feedback.
LLMSlim Core e LLMSlim Platform
| LLMSlim Core | LLMSlim Platform | |
|---|---|---|
| Versão | 0.11.1 | 0.9.1 beta |
| Licença | MIT, este repositório | Proprietária, beta privado |
| Instalação | pip install llmslim | Por convite; não publicada no PyPI |
| O que faz | Comprime, planeja e rastreia o contexto visível ao modelo dentro do seu processo Python | Baseia-se no Core: uma linha do tempo verificável do estado do agente, decisões de contexto explicáveis e reproduzíveis, e políticas de contexto orientadas a resultados que começam em modo shadow |
O Core é e permanece totalmente open source. O Platform é um produto separado que depende do Core; nenhum de seus códigos vive neste repositório. Saiba mais e solicite acesso ao beta em llmslim.app/platform.
Novidades no Core: o runtime de contexto para agentes (v0.7.0) e o runtime de contexto com reconhecimento de cache (v0.7.1). Ambos estão no pacote PyPI a partir da 0.7.1; a 0.7.0 foi marcada com tag, mas não publicada no PyPI.
Adaptive Context Planner (v0.6.0)
O LLMSlim não é mais apenas um compressor de prompt de taxa fixa. O Adaptive
Context Planner escolhe representações seguras para cada item de contexto e, em seguida, usa
um alocador restrito determinístico para encaixar o contexto de maior valor em um
orçamento finito de modelo. A API original compress() continua totalmente suportada.
A versão v0.6.0 adiciona decisões explicáveis por item, relatórios explícitos de inviabilidade, validação pós-planejamento, telemetria de tokens e custos, presets de política e integrações opcionais com Sarvam AI, Zoho e MongoDB, mantendo a instalação base local-first e neutra em relação a provedores.
from llmslim import plan_context

plan = plan_context(
    messages=[
        {"role": "system", "content": "Answer only from verified context."},
        {"role": "user", "content": "When does Acme renew?"},
    ],
    documents=[{"content": "CRM: Acme renews on 2026-11-30."}],
    query="Acme renewal date",
    model="sarvam-105b",
    max_input_tokens=8_000,
    reserve_output_tokens=512,
)
assert plan.feasible
print(plan.final_context)
print(plan.metrics.planned_tokens, plan.metrics.estimated_input_cost_after)
O planejamento funciona offline com a instalação base. As integrações opcionais ficam isoladas em extras:
pip install "llmslim[sarvam]"   # Sarvam provider (official sarvamai SDK)
pip install "llmslim[zoho]"     # CRM and WorkDrive context sources
pip install "llmslim[mongodb]"  # explicit memory and Atlas retrieval
Veja a arquitetura, o algoritmo, o modelo de segurança, a CLI e o benchmark offline medido.
Programas de startups
O LLMSlim faz parte de 15 programas de startups. Eles oferecem créditos, ferramentas e orientação; nenhum deles é investidor, e a participação não implica endosso.
| Programa | Empresa |
|---|---|
| Sarvam Startup Program | Sarvam AI |
| Zoho for Startups | Zoho |
| MongoDB for Startups | MongoDB |
| Claude for Startups | Anthropic |
| OpenAI for Startups | OpenAI |
| Auth0 for Startups | Okta (Auth0) |
| Zendesk for Startups | Zendesk |
| Mixpanel for Startups | Mixpanel |
| Sentry for Startups | Sentry |
| Descope Hello World Startup Program | Descope |
| Pulumi for Startups | Pulumi |
| Honeycomb for Builders | Honeycomb |
| Exa Startup Grants | Exa |
| Neo4j Startup Program | Neo4j |
| Cartesia Startups Grant Program | Cartesia |
Os logotipos são marcas registradas de seus proprietários e identificam cada programa.
Sarvam Startup Program e integração com Sarvam
✦ Aceito no Sarvam Startup Program
O LLMSlim foi aceito no Sarvam Startup Program. Trata-se apenas de participação no programa: não é uma parceria e não implica endosso da Sarvam AI.
Separadamente, o LLMSlim Core inclui uma integração opcional com Sarvam (llmslim[sarvam])
construída sobre o SDK oficial sarvamai para Python. Você planeja e comprime o contexto localmente
e envia apenas o contexto planejado para um modelo Sarvam, como o sarvam-105b.
- Planejamento local: os documentos recuperados são planejados e comprimidos no seu processo Python antes de qualquer requisição ser enviada.
- Local-first: o contexto recuperado sensível permanece local; apenas o contexto planejado é enviado ao modelo.
- Sua aplicação continua no controle: o LLMSlim é um pré-processador. Sua aplicação é dona das chaves de API, dos prompts e da inferência, e nada é enviado à Sarvam a menos que seu código chame o provedor.
Início rápido: Planejamento Adaptativo + Sarvam
pip install "llmslim[sarvam]"
export SARVAM_API_KEY="..."   # your own Sarvam API key
from llmslim import plan_context
from llmslim.integrations.sarvam import SarvamProvider

documents = [
    {"content": "Q3 filing: new data-localisation rules take effect in April 2027."},
    {"content": "Q3 filing: two pending licence renewals carry a regulatory risk of delay."},
]

plan = plan_context(
    messages=[{"role": "system", "content": "Answer from verified context."}],
    documents=documents,
    query="Summarize the key regulatory risks.",
    model="sarvam-105b",
    max_input_tokens=8_000,
    reserve_output_tokens=256,
)
provider = SarvamProvider.from_env(model="sarvam-105b", max_tokens=256)
answer = provider.chat([{"role": "user", "content": plan.final_context}])
print(answer, provider.last_usage)
👉 Leia o guia de integração com Sarvam (também em docs/integrations/SARVAM.md)
🔮 O que é o LLMSlim?
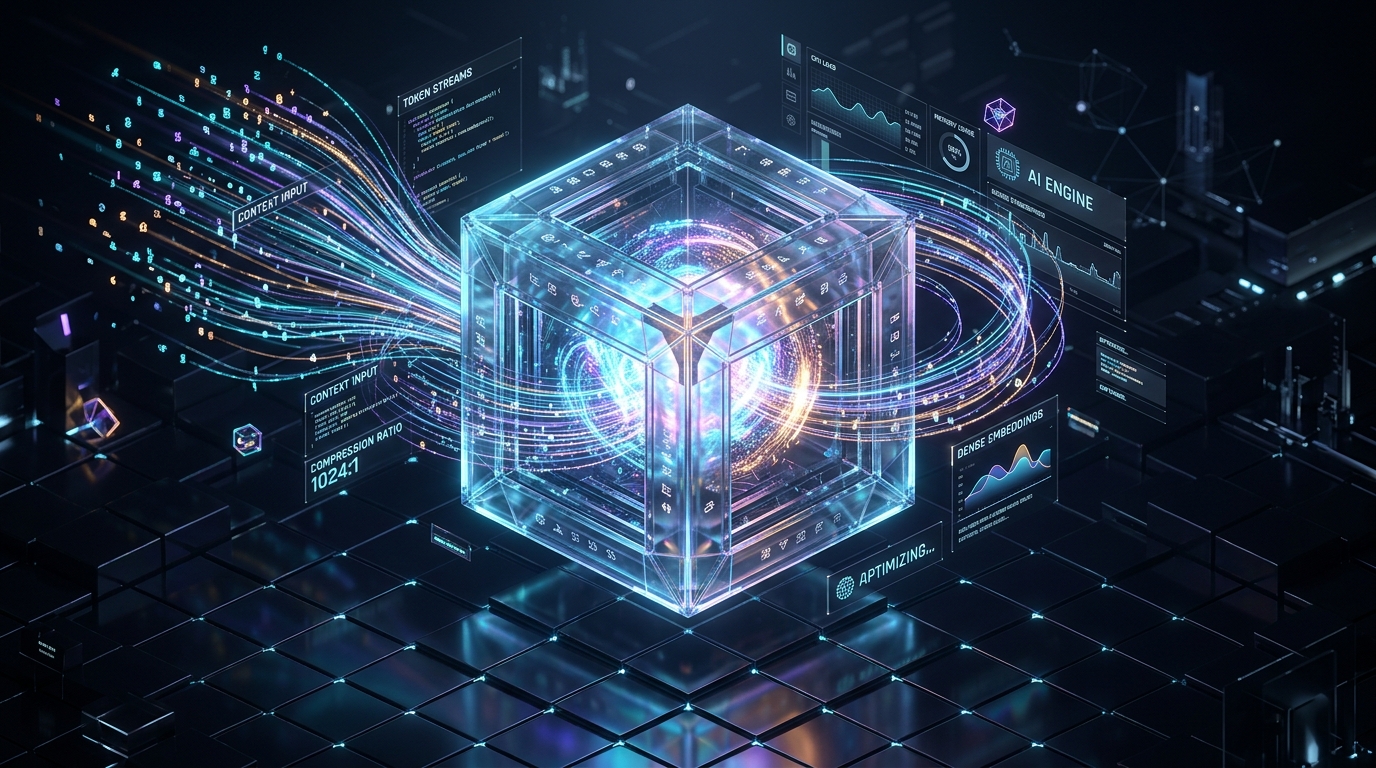
LLMSlim Holographic Engine: compressão de tokens em múltiplos estágios, condensando fluxos de contexto esparsos em núcleos de informação densos com zero mutação de contrato.
Sistemas LLM modernos sofrem com o Dilema da Janela de Contexto:
- Custo financeiro: Reenviar grandes prompts a cada turno significa pagar pelos mesmos tokens de entrada repetidamente.
- Gargalo de latência: Prompts grandes inflam o Time-To-First-Token (TTFT) e os tempos de fila.
- Síndrome do perdido no meio: Modelos podem perder ou usar incorretamente informações enterradas no meio de contextos longos.
- Riscos de segurança: Conteúdo RAG não confiável pode contrabandear injeções indiretas de prompt para dentro das instruções do sistema.
O LLMSlim resolve isso na origem. Ele oferece compressão determinística e que preserva contratos, executada nativamente na camada da sua aplicação antes de chamar qualquer modelo.
💎 Pilares arquiteturais centrais
| Pilar | Como o LLMSlim resolve |
|---|---|
| 🏎️ Sobrecarga ultrabaixa | Python puro + NumPy/Scikit-learn. Mediana de 0,026 ms por amostra (p95 1,889 ms) na avaliação da Fase 2 com 24 amostras, majoritariamente textos curtos, sem chamadas de modelo no caminho padrão. Entradas mais longas levam mais tempo. |
| 🔒 Determinístico por padrão | O modo extrativo padrão apenas seleciona frases da sua entrada, então a saída é reproduzível e não contém texto gerado. Ainda assim, ele pode descartar um fato de que você precisa, então verifique os resultados para o seu caso de uso. Os modos de reescrita e híbrido chamam o seu próprio LLM. |
| 🛡️ Segurança de proveniência | A hierarquia ContextRole isola texto não confiável de RAG/ferramentas para que injeções de prompt não possam escalar para a prioridade system. |
| 🧩 Schemas de ferramentas seguros para contratos | Normalização canônica de JSON, impressões digitais de contrato SHA-256 e zero reescritas de execução para ferramentas de agentes. |
| 🔌 Neutro em relação a provedores | Construtores de requisição sem execução para Sarvam, OpenAI, Anthropic, Gemini e vLLM, além de uma ponte para o OpenAI Agents SDK. Funciona com qualquer framework que consiga passar listas simples de mensagens ou documentos. |
🖥️ Playground do Studio ao vivo (www.llmslim.app)
Cole um chat longo, uma pilha de resultados de busca ou um log de CI, faça uma pergunta e veja o LLMSlim manter o que a responde. O Studio mostra os tokens e o custo economizados, se a resposta sobreviveu e o que a truncagem simples para o mesmo tamanho teria mantido em vez disso.
- Cenários prontos: um chat de suporte de seis meses, resultados de busca de central de ajuda e um log de CI com uma falha, cada um com uma pergunta cuja resposta é conhecida.
- Seu próprio texto: cole até cerca de 16.000 tokens e escolha quanto manter.
- No lugar: as linhas mantidas são destacadas dentro do original, ao lado do texto exato que o modelo receberia.
- Sem chamada de modelo: o Studio executa o Core no servidor e não chama nenhum provedor. Nada do que você cola é armazenado.
Veja a implantação do Studio e a política de segurança.
🌐 Site moderno para desenvolvedores e documentação
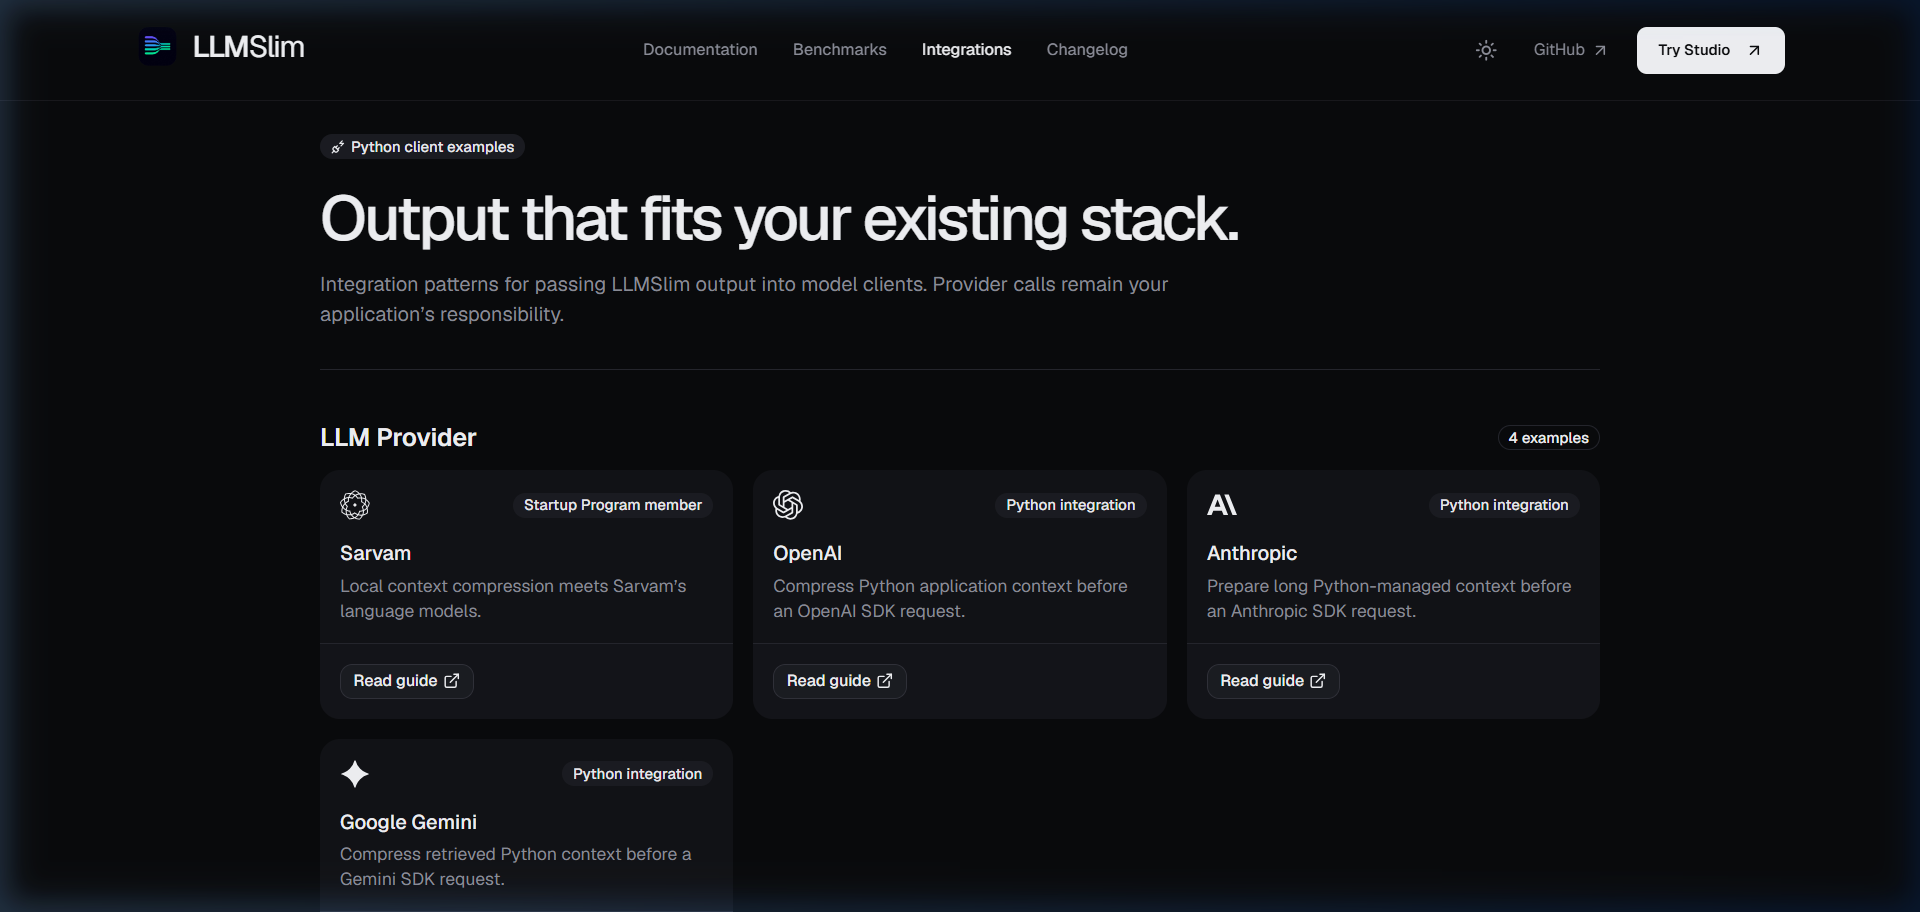
Explore nosso site de documentação redesenhado em modo escuro/claro, cobrindo padrões de integração de ponta a ponta:
📦 Instalação
# Core package (Deterministic extractive engine, 0 external LLM dependencies)
pip install llmslim

# With optional Model Context Protocol (MCP) catalog ingestion (Python 3.10+)
pip install "llmslim[mcp]"

# With optional OpenAI Agents SDK host bridge (Python 3.10+)
pip install "llmslim[agents]"

# With optional local multilingual semantic retrieval
pip install "llmslim[semantic]"

# Sarvam: chat providers, language tools and document source (official sarvamai SDK)
pip install "llmslim[sarvam]"

# Exa web search as an untrusted RAG context source (spend capped in USD)
pip install "llmslim[exa]"

# Neo4j temporal agent memory with auditable supersession
pip install "llmslim[neo4j]"

# Read-only Zoho CRM and WorkDrive context sources
pip install "llmslim[zoho]"

# Explicit MongoDB context memory and Atlas retrieval
pip install "llmslim[mongodb]"

# LangChain, LlamaIndex (Python 3.10+) and Haystack adapters
pip install "llmslim[langchain]"
pip install "llmslim[llamaindex]"
pip install "llmslim[haystack]"

# Agent history: gptme (0.34+) and Pydantic AI adapters (Python 3.10+).
# Hermes Agent needs no extra: install llmslim into Hermes's environment.
pip install "llmslim[gptme]"
pip install "llmslim[pydantic-ai]"

# All optional extensions
pip install "llmslim[all]"
Requisitos: Python 3.9 ou superior. Nenhum SDK de provedor, PyTorch, sentence-transformers ou serviço de nuvem é necessário para a instalação padrão.
⚡ Início rápido e padrões de uso
1. Compressão extrativa básica (padrão)
from llmslim import ContextRole, compress

text = """
The Apollo program was conceived in 1960 during the Eisenhower administration.
NASA announced the program as a follow-up to Project Mercury.
The spacecraft was designed to carry three astronauts.
Apollo succeeded in landing the first humans on the Moon in 1969.
Funding for the program peaked in 1966 with over $4.5 billion appropriated.
"""

result = compress(
    text,
    target_ratio=0.5,                    # Target: keep about 50% of the tokens
    strategy="extractive",               # Deterministic sentence selection
    context_role=ContextRole.GENERAL,
)

print("Compressed Output:")
print(result.compressed_text)
print(f"Original: {result.original_tokens} tokens | Compressed: {result.compressed_tokens} tokens")
print(f"Saved: {result.tokens_saved} tokens ({result.reduction_percent:.1f}%)")
print(f"Sentences kept: {result.sentences_kept} of {result.sentences_total}")
A seleção extrativa mantém frases inteiras, não o significado: sempre verifique se as
frases de que você precisa sobreviveram. Neste texto, a instalação base 0.7.1 mantém três das
cinco frases e descarta a frase sobre o pouso na Lua em 1969; com
llmslim[fast-tokens] (contagem via tiktoken), ela mantém essa frase e descarta outra.
2. Compressão de RAG com múltiplos documentos
Comprima cada trecho recuperado antes de montar o prompt. compress_documents
aceita strings simples e retorna um resultado por documento, em ordem:
from llmslim import compress_documents

documents = [
    "Q3 revenue grew 23% year-over-year to $1.2B. "
    "Growth came mainly from enterprise subscriptions in India and Southeast Asia. "
    "The board met twice during the quarter. "
    "The office cafeteria menu was updated in August. "
    "A new logo was unveiled at the annual offsite. "
    "Net revenue retention reached 118%, up from 109% a year earlier.",
    "Operating expenses rose 11% because of AI research infrastructure. "
    "Most of the increase was GPU capacity for model evaluation. "
    "Travel costs were flat. "
    "The parking garage was repainted in September. "
    "Employees voted on a new name for the meeting rooms. "
    "Headcount in engineering grew by 40 people.",
]

results = compress_documents(
    documents,
    query="What drove Q3 revenue and cost changes?",
    target_ratio=0.5,
)

context = "\n\n".join(r.compressed_text for r in results)
print(context)
print(f"Saved {sum(r.tokens_saved for r in results)} tokens across {len(results)} documents")
Com uma consulta, os documentos compartilham um único orçamento e ele vai para onde a consulta aponta. A relevância é lexical por padrão (BM25 com feedback: sem modelo, determinístico, dezenas de milissegundos em um contexto de 3 mil tokens). Para RAG e memória de chat longo, onde a resposta costuma compartilhar poucas palavras com a pergunta, adicione o reranker opcional:
# pip install "llmslim[semantic]"   (sentence-transformers; uses a GPU when there is one)
results = compress_documents(documents, query=question, target_ratio=0.25, relevance="semantic")
relevance também aceita qualquer scorer(query, texts) -> scores chamável, como uma API de reranking hospedada.
Recuperando com LangChain, LlamaIndex ou Haystack? Use os
adaptadores de framework em vez de chamar
compress_documents diretamente.
[!NOTE]
compress_documentstrata documentos como não confiáveis (ContextRole.RAG) por padrão, então formulações imperativas dentro de um documento recuperado nunca são mantidas à força como instrução protegida. Isso não remove texto injetado: uma frase injetada ainda pode sobreviver à compressão. Para marcar conteúdo recuperado como não confiável no prompt final, useplan_contextouContextRuntime, que envolvem cada documento em uma tag de proveniênciatrusted="false"e ignoram qualquer papel que um documento reivindique para si.
3. Compressão de conversas de chat com múltiplos turnos
Comprima turnos anteriores longos enquanto repassa instruções system e perguntas do usuário sem alterações:
from llmslim import compress_chat_messages

review = (
    "Here are my suggestions for your schema. First, add a composite index on "
    "(customer_id, created_at) because most of your queries filter by customer and sort by "
    "date. Second, the orders table stores the shipping address inline, which duplicates "
    "data across rows; move it to an addresses table. Third, the status column is a "
    "free-text string, so use an enum or a lookup table instead. Fourth, the price column "
    "uses FLOAT, which loses precision for money; use DECIMAL(12, 2). Finally, add ON "
    "DELETE RESTRICT to the foreign key from orders to customers so that deleting a "
    "customer cannot silently orphan their orders."
)

messages = [
    {"role": "system", "content": "You are a specialized code review engineer."},
    {"role": "user", "content": "Can you review my database schema design?"},
    {"role": "assistant", "content": review},
    {"role": "user", "content": "What about the foreign key constraint on line 42?"},
]

compressed_messages = compress_chat_messages(
    messages,
    target_ratio=0.5,
    compressible_roles=("assistant",),  # Only compress assistant turns; system and user pass through
    min_tokens=60,                      # Turns shorter than this are never compressed
)

for message in compressed_messages:
    print(f"{message['role']}: {message['content']}")
4. Otimização híbrida de prompt (extrativa + reescrita)
Combine a pré-filtragem extrativa ultrarrápida com o seu próprio provedor de LLM para paráfrase semântica profunda:
from llmslim import CallableProvider, compress
import openai

client = openai.OpenAI()  # reads OPENAI_API_KEY; requires `pip install openai`

long_raw_text = """
The Apollo program was conceived in 1960 during the Eisenhower administration.
NASA announced the program as a follow-up to Project Mercury.
The spacecraft was designed to carry three astronauts.
Apollo succeeded in landing the first humans on the Moon in 1969.
Funding for the program peaked in 1966 with over $4.5 billion appropriated.
"""

# Define your own provider callback (LLMSlim does not bundle vendor SDKs).
# The callback receives a RewriteRequest with ready-made prompts and returns text.
provider = CallableProvider(
    lambda req: client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": req.system_prompt},
            {"role": "user", "content": req.user_prompt},
        ],
    ).choices[0].message.content
)

result = compress(
    long_raw_text,
    target_ratio=0.3,
    strategy="hybrid",                   # 1. Extractive filter -> 2. LLM semantic rewrite
    provider=provider,
)

meta = result.rewrite_metadata
print(result.compressed_text)
print(f"Strategy: {meta.strategy} | Rewrite accepted: {meta.accepted} | Fell back to extractive: {meta.fallback_used}")
print("Validation failures:", meta.failure_reasons)
Toda reescrita é validada quanto a estrutura, retenção de instruções, retenção de entidades
e similaridade. Se uma reescrita híbrida falhar na validação, o LLMSlim retorna o resultado
extrativo e informa o motivo em rewrite_metadata.failure_reasons.
Agentes de código: llmslim wrap claude
O Claude Code reenvia a conversa inteira a cada turno. Assim, logs de teste longos, saída de build, resultados de busca e páginas web são pagos repetidamente, e ainda aumentam o contexto que o Claude Code eventualmente compacta.
llmslim wrap claude executa o Claude Code por meio de um proxy local:
- Ele reduz essa saída na primeira vez que o modelo a vê. Linhas que parecem erros, falhas ou avisos vêm primeiro, depois as linhas relacionadas ao comando.
- Ele envia exatamente os mesmos bytes em cada requisição posterior, então o cache de prompt continua acertando e o raciocínio do Claude permanece válido.
- A saída das próprias ferramentas do Claude Code
Read,EditeWritenunca é alterada. Um arquivo impresso pelo shell (cat,head) conta como saída de shell.
pip install "llmslim[proxy]"
llmslim wrap claude
llmslim proxy stats
O que isso faz com a conta, medido no Claude Code 2.1.296 real com Claude Haiku 5.5, em oito pequenas tarefas sintéticas. Contamos dólares a preço de tabela a partir do uso da API, com leituras de cache precificadas separadamente, e publicamos todas as 572 execuções em benchmarks/claude_code_cost. O resultado principal tem ambos os braços no modo de permissão padrão do Claude Code; uma segunda execução tem ambos em modo automático.
- Logs longos: uma execução de CI com falha simulada (cerca de 12 KB de log, a causa no meio) custou 26-32% menos, e uma execução de lint com três erros entre 240 avisos, 17-21% menos.
- Execuções de teste: cerca de 4% menos no modo padrão, dentro do ruído para cada tarefa; 2-15% menos no modo automático. Os agentes já
reduzem a saída de teste com
tail. - Nas 8 tarefas: +5,3% no modo padrão (intervalo de 95% de +1,5% a +9,4%), principalmente por causa de uma tarefa em que o JSON encurtado custou cerca do dobro; -5,1% no modo automático. O JSON é deixado intacto por padrão desde a 0.11.1.
- Sessões reais: em uma reprodução offline das próprias transcrições do mantenedor (32 sessões e as 412 execuções de subagentes
que elas iniciaram, quase todas Claude Opus 5.5, a preços de tabela), a saída de ferramentas era uma pequena parte da conta: com os mesmos
turnos, toda a saída de shell, busca e web custando zero teria reduzido a conta em 13,4%. A releitura de contexto longo era a
parte grande. A configuração
/autocompactdo Claude Code decide quando ele compacta; o que isso faz com o custo não é medido aqui.
Sem a reprodução byte a byte, um histórico editado invalida o raciocínio do Claude: em nossa verificação de API no Claude Haiku 5.5 a requisição foi rejeitada com HTTP 400, o padrão para contas criadas em ou após 31 de agosto de 2026. Com a reprodução, as leituras de cache cresceram em cada requisição de um teste de API de 7 requisições. Veja docs/PROXY.md para saber o que é comprimido, os limites e a segurança.
Como plugin do Claude Code. O plugin adiciona o servidor de memória do LLMSlim (abaixo) e dois comandos:
/llmslim:wrap-claudeorienta você a iniciar o Claude Code pelo proxy;/llmslim:savingsmostra quantos tokens de saída de ferramentas o proxy manteve fora das suas requisições: uma estimativa contada antes dos descontos de cache de prompt, não dólares economizados.
/plugin marketplace add Thanatos9404/llmslim
/plugin install llmslim@llmslim
No Claude Code 2.1.275 ou posterior, /plugin install llmslim --marketplace Thanatos9404/llmslim faz as duas coisas em uma etapa.
O servidor de memória roda com uvx, então precisa de uv.
Memória para agentes, sem LLM no loop
llmslim.memory armazena cada turno literalmente e seleciona, no momento da leitura, os turnos que respondem a uma pergunta dentro de um
orçamento de tokens. Não há modelo de extração na entrada e nenhuma chamada de modelo na saída.
from llmslim.memory import Memory

memory = Memory("memory.db")  # SQLite, built into Python
memory.add([{"role": "user", "content": "I'm allergic to peanuts."}], user_id="asha")
context = memory.search("Am I allergic to anything?", user_id="asha", budget=1500)
print(context.text)  # put it in the prompt as untrusted data
Ele executa o pipeline por trás dos benchmarks da rodada 3. Nas próprias perguntas do LongMemEval da Mem0, esse pipeline (com seu
reranker) respondeu 78,3% por US$ 1,04 por 1.000 perguntas, contra 76,7% por US$ 220,88 da Mem0. Vindo da Mem0?
from llmslim.memory.compat import Mem0Memory as Memory mantém os nomes de métodos da Mem0. Veja
docs/MEMORY.md para escopos, armazenamentos, evidências e limites, e o roteiro 1.0.
No Claude, Cursor ou qualquer cliente MCP
llmslim mcp serve essa memória via MCP, com uma ferramenta fit_context para texto longo. Ele precisa de pip install "llmslim[mcp]"
no Python 3.10+.
claude mcp add llmslim -- llmslim mcp
- Ferramentas:
remember,recall,list_memories,forgetefit_context. - Escopo: o servidor o fixa com
--user-id, então o modelo não pode ler a memória de outro usuário. - Armazenamento: um arquivo SQLite local; o servidor não faz chamadas de rede.
- Mais: configurações e opções de cliente estão em docs/MCP.md.

Via HTTP, de qualquer linguagem
llmslim serve coloca a mesma memória e um endpoint de ajuste de contexto por trás de uma pequena API JSON. Ele roda como um processo com
um arquivo SQLite e sem chamadas de modelo. Instale-o com pip install "llmslim[server]", ou compile o Dockerfile.
curl -s localhost:8080/v1/memories/search -H 'content-type: application/json' -d '{"user_id": "asha", "query": "Where did I move to?", "budget": 1500}'
Ele precisa de uma chave de API bearer para escutar além do localhost. As rotas, limites e configuração do Docker estão em docs/SERVER.md.
O cliente TypeScript, npm install llmslim (clients/typescript), envolve essa API sem
dependências. Ele também fornece ao Vercel AI SDK as ferramentas recall_memory e remember e um middleware que salva turnos. Nenhum deles altera seu
prompt, então os caches de prompt continuam acertando e o raciocínio preservado do Claude permanece válido.
Uso com LangChain / LlamaIndex / Haystack
Cada adaptador executa compress_documents nos documentos recuperados, com o mesmo
orçamento compartilhado quando há uma consulta. Os documentos mantidos preservam seus metadados, e
os documentos que se comprimem a nada são descartados. Eles rodam localmente sem modelo.
| Framework | Instalação | Classe | Use onde você usaria |
|---|---|---|---|
| LangChain | llmslim[langchain] | llmslim.integrations.langchain.LLMSlimCompressor | LLMLinguaCompressor, por exemplo em ContextualCompressionRetriever |
| LlamaIndex | llmslim[llamaindex] (Python 3.10+) | llmslim.integrations.llama_index.LLMSlimPostprocessor | LongLLMLinguaPostprocessor, em node_postprocessors |
| Haystack | llmslim[haystack] | llmslim.integrations.haystack.LLMSlimDocumentCompressor | um componente entre o retriever e o construtor de prompt |
from langchain_classic.retrievers.contextual_compression import ContextualCompressionRetriever
from llmslim.integrations.langchain import LLMSlimCompressor

retriever = ContextualCompressionRetriever(
    base_compressor=LLMSlimCompressor(target_ratio=0.25),
    base_retriever=your_retriever,
)
Exemplos executáveis com sua saída: LangChain, LlamaIndex, Haystack.
Uso com gptme / Hermes Agent / Pydantic AI
Esses adaptadores ajustam o histórico de mensagens de um agente a um orçamento de tokens. Eles mantêm o prompt de sistema, as chamadas de ferramentas e os turnos mais recentes como estão, comprimem localmente a saída de ferramentas e os turnos mais antigos (falhas e tracebacks na saída de ferramentas são mantidos), e mantêm cada chamada de ferramenta emparelhada com seu resultado. Não há chamada de modelo.
| Agente | Instalação | Classe ou função | Como se conecta |
|---|---|---|---|
| gptme | llmslim[gptme] (gptme 0.34+) | llmslim.integrations.gptme.LLMSlimContextProvider | provedor de contexto do gptme llmslim; [plugin.llmslim] compaction = true faz dele o que a compactação do gptme usa |
| Hermes Agent | llmslim no ambiente do Hermes | llmslim.integrations.hermes.LLMSlimContextEngine | plugin do Hermes ContextEngine llmslim; selecione-o com context.engine: llmslim |
| Pydantic AI | llmslim[pydantic-ai] (1.0+) | llmslim.integrations.pydantic_ai.llmslim_history_processor | processador de histórico, em ProcessHistory(...) ou history_processors=[...] |
from pydantic_ai import Agent
from pydantic_ai.capabilities import ProcessHistory
from llmslim.integrations.pydantic_ai import llmslim_history_processor

agent = Agent(
    "openai:gpt-5",
    capabilities=[ProcessHistory(llmslim_history_processor(max_tokens=8_000))],
)
Configuração e exemplos executáveis com sua saída: gptme, Hermes Agent, Pydantic AI.
🛡️ Arquitetura de Segurança: Isolamento de Proveniência
Algoritmos de compressão que pontuam frases de forma ingênua com base em palavras-chave imperativas ("Must", "Always", "Action Required") introduzem uma vulnerabilidade grave: amplificação de injeção indireta de prompt. Um atacante que injeta instruções maliciosas em um documento RAG recuperado pode enganar o compressor para preservar o payload do ataque enquanto descarta contexto legítimo.
Encontramos esse problema internamente no LLMSlim e o corrigimos na v0.3.1. Nenhum CVE ou aviso de segurança foi publicado, e o problema não tem pontuação CVSS oficial.
O LLMSlim resolve isso por meio de uma Fronteira de Confiança de Papel de Contexto explícita:
 ┌────────────────────────────────────────────────────────┐
 │           HIGHEST TRUST (Priority Tier 4)              │
 │  System & Developer Prompts (Strictly Protected)       │
 ├────────────────────────────────────────────────────────┤
 │           INTERMEDIATE TRUST (Priority Tier 2-3)       │
 │  Direct User Input                                     │
 ├────────────────────────────────────────────────────────┤
 │           PROVENANCE-LOCKED (Priority Tier 0-1)        │
 │  RAG Documents • Assistant History • Tool Outputs     │
 │  *Cannot reach Tier 4 through imperative patterns*     │
 └────────────────────────────────────────────────────────┘
- Bloqueio de Prioridade Reforçado: Conteúdo marcado como
ContextRole.RAG,ContextRole.TOOLouContextRole.ASSISTANTnão pode alcançar prioridade de Nível 4, independentemente da sintaxe imperativa. - Delimitadores de Reescrita Protegidos por Nonce: Quando a entrada contém um token semelhante a cerca, como
---END TEXT---, as cercas do template de reescrita recebem um nonce aleatório por chamada, então o token embutido não pode fechar a região de texto. A entrada em si nunca é modificada. - Não confiável por padrão, não filtrado: essas proteções impedem que o texto injetado ganhe prioridade. Elas não o excluem.
plan_contexteContextRuntimeo rotulam comotrusted="false"no contexto final para que seu modelo e aplicação possam tratá-lo adequadamente.
🧩 Esquemas de Ferramentas Seguros para Contratos e Ingestão MCP
Catálogos grandes de agentes (dezenas ou centenas de definições de ferramentas) desperdiçam milhares de tokens antes mesmo de o agente começar a pensar. O LLMSlim introduz a Infraestrutura de Ferramentas Segura para Contratos (v0.4.0 e v0.5.0):
from llmslim.tools import (
    canonical_json,
    contract_equivalent,
    fingerprint_tool_schema,
    from_mcp_tool,
    optimize_tool_schema,
)

# 1. Ingest authoritative raw tool definition
raw_tool = {
    "name": "enterprise.search_ledger",
    "description": "Searches financial transaction records by date range.",
    "inputSchema": {
        "type": "object",
        "properties": {"account_id": {"type": "string"}, "limit": {"type": "integer"}},
        "required": ["account_id"],
    },
}

# 2. Parse and safely optimize schema formatting
tool = from_mcp_tool(raw_tool, namespace="finance")
result = optimize_tool_schema(tool)

# 3. Mathematically verify exact contract equivalence
assert result.equivalence.status.value == "EXACT"
assert fingerprint_tool_schema(tool) == fingerprint_tool_schema(result.optimized)

print("Canonical Fingerprint:", fingerprint_tool_schema(result.optimized))
print(canonical_json(result.optimized.raw))
Fonte de Catálogo MCP Assíncrona (v0.5.0)
Requer pip install "llmslim[mcp]" (Python 3.10+) e um servidor MCP que você executa:
import asyncio

from llmslim.mcp import MCPToolCatalogSource, PlanMode, plan_catalog_context


async def main() -> None:
    # Streamable HTTP MCP source with bounded pagination and stale-cache detection
    source = MCPToolCatalogSource.from_streamable_http(
        "http://127.0.0.1:8000/mcp",
        headers={"Authorization": "Bearer local-token"},
    )

    snapshot = await source.list_tools()
    plan = plan_catalog_context(snapshot, mode=PlanMode.FULL)

    print(f"Catalog contains {len(snapshot.tools)} tools ({plan.metrics.catalog_tokens} tokens)")


asyncio.run(main())
📊 Benchmarks e Transparência Radical
Muitas bibliotecas fazem afirmações sem fundamento sobre 90% de compressão de prompt. Na LLMSlim, praticamos a Transparência Radical de Benchmarks:
Rodada 3: Core 0.9.0 contra sistemas de memória e compressores, custo em primeiro lugar
Medido em 13-15 de outubro de 2026 em perguntas de teste reservadas. Todo sistema é lido pelo Claude Haiku 5.5 com o mesmo prompt de resposta e juízes. Mem0 e Zep rodaram por meio de seus próprios harnesses de benchmark, e LLMLingua-2 e LongLLMLingua (LLaMA-2-7B em float16) com suas configurações publicadas. O contexto de cada compressor foi construído em notebooks públicos do Kaggle fixados a um commit. Cada célula é a acurácia e quanto custam 1.000 perguntas de ponta a ponta a preços de tabela: a chamada de resposta, as chamadas de construção de memória da Mem0 e da Zep, e a computação de cada sistema. Tabelas completas, intervalos de confiança, pontos fracos e todas as respostas: benchmarks/live/round3.
| Benchmark | LLMSlim 0.9 + reranker | LLMSlim 0.9 (sem modelo) | Mem0 | Zep | LongLLMLingua | LLMLingua-2 | Linha de base de recuperação* | Contexto completo |
|---|---|---|---|---|---|---|---|---|
| LoCoMo, 1.307 q, ~2.500 tokens | 93,0% · US$ 0,95 | 91,7% · US$ 0,89 | 91,0% · US$ 2,66 | 74,4% · US$ 6,24 | 73,3% · US$ 7,01 (300 q) | 34,1% · US$ 0,43 | 85,2% · US$ 0,90 | 95,1% · US$ 0,83 em cache |
| LongMemEval-S, 180 q, ~10.000 tokens | 74,4% · US$ 2,21 | 77,8% · US$ 2,13 | não executado | 15,6% · US$ 8,43 | 80,6% · US$ 4,45 | 77,8% · US$ 90,21 | ||
| LongMemEval-S, 60 q da Mem0, ~2.500 tokens | 78,3% · US$ 1,04 | 71,7% · US$ 0,96 | 76,7% · US$ 220,88 | 80,0% · US$ 3,36 | 78,3% · US$ 90,20 | |||
| LongMemEval-S, 24 q da Zep, ~2.500 tokens | 87,5% · US$ 1,01 | 87,5% · US$ 0,94 | 87,5% · US$ 219,48 | 58,3% · US$ 697,56 | 83,3% · US$ 3,28 | 91,7% · US$ 90,22 | ||
| NaturalQuestions, 2.255 q, 25% dos tokens | 73,5% · US$ 0,33 | 60,6% · US$ 0,30 | 70,5% · US$ 1,32 (1.000 q) | 52,5% · US$ 0,87 | 73,9% · US$ 0,30 | 78,4% · US$ 0,65 | ||
| HotpotQA, 2.000 q, 40% dos tokens (correspondência exata) | 52,2% · US$ 0,15 | 52,4% · US$ 0,13 | 50,4% · US$ 0,77 (1.000 q) | 46,7% · US$ 0,47 | 50,5% · US$ 0,13 | 58,0% · US$ 0,24 |
* Recuperação densa sobre turnos (Qwen3-Embedding-0.6B) no LoCoMo e LongMemEval; um reranker simples no NaturalQuestions e HotpotQA. Mem0 são suas 50 principais memórias, exceto as 200 principais na própria amostra da Mem0. LongLLMLingua rodou em amostras pré-registradas; nas mesmas perguntas o LLMSlim com seu reranker pontua 93,3% no LoCoMo (+20,0, IC 95% +15,0 a +25,0) e 72,7% no NaturalQuestions, e o LLMSlim padrão 53,3% no HotpotQA. Um histórico completo em cache custa US$ 4,48 por 1.000 perguntas do LoCoMo quando o cache erra. Onde o LLMSlim perde:
- NaturalQuestions sem o reranker. O modo lexical padrão pontua 60,6% contra 73,9% de um reranker simples: perguntas parafraseadas exigem correspondência semântica, então use o reranker para recuperação de domínio aberto.
- Recuperação densa no LongMemEval. 80,6% contra 77,8% do LLMSlim em 10.000 tokens e 76,1% contra 74,4% em 2.500, a cerca do dobro do custo. Nenhuma das diferenças é significativa em 180 perguntas, mas ambas apontam na mesma direção. Uma correção que reduziu a diferença em perguntas de desenvolvimento não se sustentou no teste, então não está na 0.9.0.
- Perguntas multi-hop e temporais em 1.000 tokens. As 20 principais memórias do Mem0 superam o LLMSlim padrão nas perguntas multi-hop (88,7% vs 80,3%) e temporais (93,4% vs 85,7%) do LoCoMo. Com seu reranker, o LLMSlim fica à frente no geral (90,5% vs 88,7%).
- Um histórico completo em cache. Quando as perguntas de uma conversa vêm em sequência, o histórico em cache (95,1% por $0,83) supera todos os contextos comprimidos no LoCoMo.
Documentos longos e agentes: rodada 2, Core 0.8.0
Mesmo modelo e prompt para cada configuração; a truncagem recebe exatamente a contagem de tokens do LLMSlim, e cada suíte foi reexecutada uma vez em uma amostra nova após o congelamento do código (benchmarks/live). A 0.9.0 altera apenas como transcrições de chat em texto puro são selecionadas.
| Benchmark | Contexto completo | LLMSlim 0.8 + reranker | LLMSlim 0.8 (sem modelo) | Truncar, mesmo orçamento | Tokens (completo → LLMSlim) |
|---|---|---|---|---|---|
| LongBench v1, 210 amostras (macro) | 54,9 | 54,2 | 54,9 | 45,2 | 15.532 → 5.232 |
| … 210 amostras novas | 55,1 | 55,4 | 55,0 | 46,8 | |
| LongBench v2, 180 q (acurácia) | 60,0 | 55,6 | 53,9 | 48,3 | 30.493 → 8.469 |
| SWE-bench Verified Mini, 50 issues (resolvidos) | 36-38 | não executado | 38 | não executado | 48-58k → 51k por tarefa |
O reranker é opcional (relevance="semantic", um cross-encoder de 22M de parâmetros do extra semantic); sem
ele, o LLMSlim não executa modelo algum.
[!NOTE] A Medição do Schema-Tax: No nosso benchmark v0.4.0 com 375 esquemas de ferramentas sintéticos em 18 catálogos escritos para este repositório (veja o cartão do conjunto de dados), a compressão de esquema sem perdas economizou 0 tokens (0,00%) quando a linha de base já era JSON canônico compacto. Publicamos este resultado com transparência: nunca alegamos economias imaginárias onde nenhuma existe.
v0.6 Adaptive Planner (Suíte Offline Congelada)
| Método | Sucesso no orçamento | Redução de contexto | Fatos necessários | Restrições rígidas | Latência média* |
|---|---|---|---|---|---|
| Contexto completo bruto | 71,4% | 0,0% | 100% | 100% | apenas medição |
| Prefixo ingênuo | 100% | 9,2% | 100% | 100% | 2,21 ms |
| Compressor de proporção fixa | 78,6% | 9,6% | 94,0% | 96,4% | 26,55 ms |
| Planejador adaptativo | 96,4% | 11,4% | 100% | 100% | 208,02 ms |
O corpus de 28 casos cobre chat, RAG, ferramentas, misto, fonte externa e 12 idiomas em casos multilíngues. A única inviabilidade adaptativa é um caso de catálogo completo intencionalmente impossível; ele é reportado explicitamente. Essas verificações fundamentadas em tarefas não são uma alegação de juiz-LLM ou de qualidade universal. A latência é específica da execução e do hardware registrados. Veja os resultados do gate de release, resultados brutos e o conjunto de dados congelado. O harness Sarvam ao vivo não foi executado sem opt-in explícito e credenciais.
🖥️ Interface de Linha de Comando (CLI)
Comprima arquivos, streams ou prompts diretamente do seu terminal:
# Compress a document to 50% ratio
llmslim document.txt -o compressed.txt --ratio 0.5

# Pipeline integration with jq / curl
cat input.txt | llmslim --ratio 0.4 --mode rag > rag_context.txt

# Inspect token count differences
llmslim document.txt --stats
📋 Changelog
As notas de versão de cada versão, incluindo a 0.11.1, estão em CHANGELOG.md e nas GitHub Releases.
🤝 Integrações do Ecossistema
O LLMSlim opera como um pré-processador de contexto sem opiniões. Essas integrações vêm no Core; nenhuma delas envia uma requisição por você. Toda integração que gasta um crédito de fornecedor é verificada por um UsageGuard antes de a requisição sair do processo (taxa por minuto, limite vitalício de requisições e um limite de unidades em INR, USD ou consultas, configurável com variáveis LLMSLIM_<VENDOR>_*; veja .env.example):
| Fornecedor / Framework | O que vem no Core | Padrão |
|---|---|---|
| Sarvam AI | llmslim[sarvam]: SarvamProvider/AsyncSarvamProvider, SarvamLanguageTools, SarvamDocumentSource, annotate_languages()/normalize_scripts(), sarvam_messages() | Planejamento local + SDK Python oficial sarvamai, protegido com preços em INR datados |
| Exa | llmslim[exa]: ExaSearchSource, WebSearchSource neutro em relação ao fornecedor | Itens de contexto RAG não confiáveis com proveniência de URL, data e classificação; gasto limitado em USD |
| Neo4j | llmslim[neo4j]: Neo4jContextStore | Memória temporal explícita com escopo de tenant: supersede(), recall(as_of=...), history(), conflicts() |
| OpenAI | openai_compatible_request(), openai_responses_request() | Construtores de requisição sem execução; seu código envia a requisição |
| Anthropic Claude | anthropic_messages_request() | Construtor de requisição sem execução com marcadores opcionais de cache de prompt |
| Google Gemini | gemini_generate_request(), gemini_cached_content_request() | Construtores de requisição sem execução |
| vLLM / auto-hospedado | vllm_chat_request() | Construtor de requisição sem execução |
| OpenAI Agents SDK | llmslim[agents]: make_openai_agents_input_filter(), to_openai_agents_tools() | Filtro de entrada de modelo apenas texto; o SDK mantém a execução e a propriedade das ferramentas |
| LangChain | llmslim[langchain]: LLMSlimCompressor | BaseDocumentCompressor para ContextualCompressionRetriever |
| LlamaIndex | llmslim[llamaindex]: LLMSlimPostprocessor | BaseNodePostprocessor para motores de consulta |
| Haystack | llmslim[haystack]: LLMSlimDocumentCompressor | Componente de pipeline entre o retriever e o construtor de prompt |
| gptme | llmslim[gptme]: LLMSlimContextProvider | Provedor de contexto para a compactação do gptme (ponto de entrada llmslim) |
| Hermes Agent | LLMSlimContextEngine (sem extra) | Plugin ContextEngine; sem chamada de LLM, prefixo estável em cache |
| Pydantic AI | llmslim[pydantic-ai]: llmslim_history_processor() | Processador de histórico que mantém chamadas de ferramentas e retornos emparelhados |
Para outros frameworks não há adaptador dedicado. O LLMSlim funciona com qualquer framework
que possa passar listas de mensagens simples (dicts {"role": ..., "content": ...}) ou strings de
documentos; você escreve as poucas linhas de cola que passam a saída do LLMSlim para o seu cliente.
📜 Licença e Citação
O LLMSlim é um software de código aberto licenciado sob a Licença MIT. Veja LICENSE para detalhes completos.
Se você usar o LLMSlim em sua pesquisa ou sistemas de produção, por favor cite:
@software{llmslim2026,
  author = {Yashvardhan Thanvi},
  title = {LLMSlim: Deterministic Context Compression and Contract-Safe Tool Schemas for LLMs},
  year = {2026},
  publisher = {GitHub},
  url = {https://github.com/Thanatos9404/llmslim}
}
Agent Context Runtime (v0.7.0)
A versão 0.7.0 adicionou um caminho de contexto por turno para aplicações de agentes (a 0.7.0 não foi publicada no PyPI; instale a 0.7.1 ou posterior). O host fornece mensagens, documentos recuperados, memórias, resultados de ferramentas e esquemas de ferramentas autorizados; o LLMSlim retorna uma entrada de modelo verificada quanto à qualidade e um traço local explicável. Chamadas de modelo e execução de ferramentas permanecem com o host.
from llmslim import ContextRuntime, generic_request

runtime = ContextRuntime(model="sarvam-105b", max_input_tokens=8_000)
prepared = runtime.prepare_sync(
    user_input="When does Acme renew?",
    messages=[{"role": "system", "content": "Use verified dates."}],
    documents=[{"id": "contract", "content": "Acme renews on 9 November 2026."}],
)
if prepared.feasible:
    request = generic_request(prepared)  # the host sends this to its model
    print(request["messages"])
    print(prepared.trace.explain())
O runtime inclui ContextEnvelope, ContextGraph, ContextPolicy,
planejamento progressivo, gates de qualidade, sessões em memória limitadas e
adaptadores sem execução para aplicações genéricas, Sarvam, compatíveis com OpenAI e OpenAI Agents
apenas texto. ContextTrace omite corpos de prompt por padrão.
As APIs existentes compress() e plan_context() continuam funcionando.
Veja a arquitetura, modelo de segurança, integrações, guia de migração, benchmark e relatório de engenharia.
Cache-Aware Context Runtime (v0.7.1)
O planejamento de cache é uma camada opcional para turnos repetidos de agentes. O LLMSlim identifica
prefixos estáveis visíveis ao fornecedor, mantém contexto de conversa somente de acréscimo quando
seguro, cria impressões digitais de configurações sensíveis ao cache e relata estimativas locais de cache
separadamente do uso reportado pelo fornecedor. Um CacheManager com escopo de tenant armazena
metadados e referências de fornecedor, nunca corpos de prompt ou tensores KV.
from llmslim import CacheManager, CachePolicy, ContextRuntime

runtime = ContextRuntime(
    model="generic-128k",
    cache_policy=CachePolicy(mode="auto", provider="openai", tenant_id="my-workspace"),
    cache_manager=CacheManager(),
)
prepared = runtime.prepare_sync(
    session_id="conversation-1",
    messages=[{"role": "system", "content": "Use verified sources."}],
    user_input="What changed?",
)
print(prepared.trace.to_dict()["cache"])
Construtores de requisição sem execução cobrem OpenAI Responses, Anthropic Messages, recursos em cache do Gemini e vLLM auto-hospedado. Um adaptador Transformers avançado em processo valida o estado de continuação de KV. A continuação com estado do fornecedor OpenAI e a criação de recursos em cache do Gemini exigem opt-in explícito do host. O cache de prompt do Sarvam permanece não verificado e está desabilitado por padrão. O Context Inspector mostra a segmentação de prefixo e diagnósticos de cache sem chamar um fornecedor. Veja orientações de cache, benchmark multi-turno e relatório de engenharia.
Ferramentas de segurança de código aberto
O Snyk fornece ferramentas de segurança para desenvolvedores em projetos de código aberto. Saiba mais sobre o Secure Developer Program dele.