MCP Alchemy
Explore, consulte e analise bancos de dados compatíveis com SQLAlchemy diretamente do seu desktop.
Documentação
MCP Alchemy
Status: Mantido ativamente e em uso diário. Versões testadas são publicadas no PyPI com tags git, e issues e pull requests são triados regularmente.
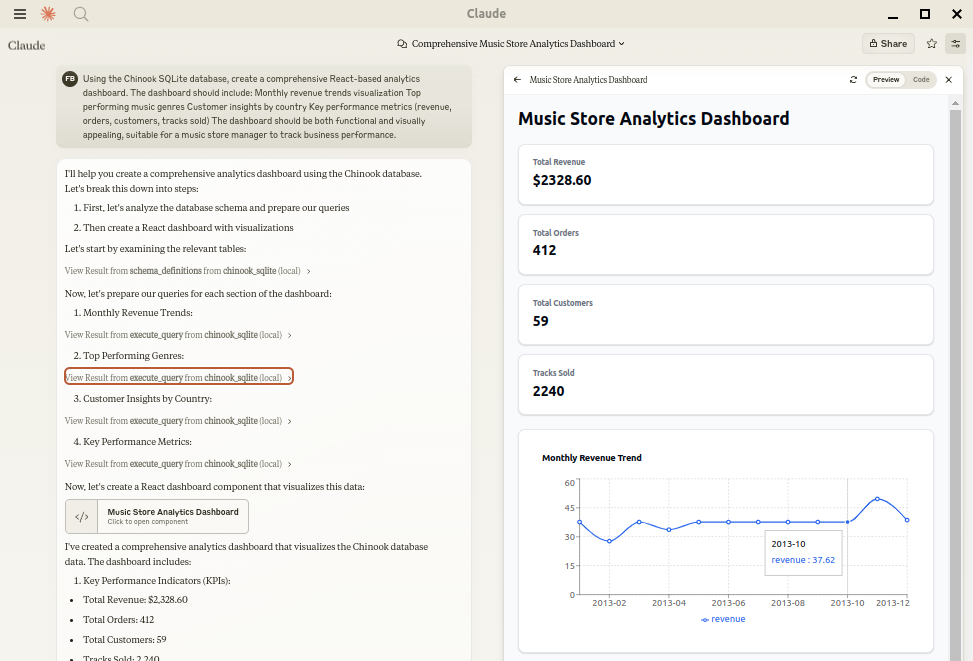
Deixe o Claude ser seu especialista em banco de dados! O MCP Alchemy conecta o Claude Desktop diretamente aos seus bancos de dados, permitindo que ele:
- Ajude você a explorar e entender a estrutura do seu banco de dados
- Auxilie na escrita e validação de consultas SQL
- Exiba relações entre tabelas
- Analise grandes conjuntos de dados e crie relatórios
- O Claude Desktop pode analisar e criar artefatos para conjuntos de dados muito grandes usando claude-local-files.
Funciona com PostgreSQL, MySQL, MariaDB, SQLite, Oracle, MS SQL Server, CrateDB, Vertica, e uma variedade de outros bancos de dados compatíveis com SQLAlchemy.
Instalação
Certifique-se de ter o uv instalado:
# Install uv if you haven't already
curl -LsSf https://astral.sh/uv/install.sh | sh
Uso com o Claude Desktop
Adicione ao seu claude_desktop_config.json. Você precisa adicionar o driver de banco de dados apropriado no parâmetro --with.
Nota: Após o lançamento de uma nova versão, pode haver um período de até 600 segundos enquanto o cache local é limpo, fazendo com que o uv apresente um erro de versionamento. Reiniciar o cliente MCP novamente resolve o erro.
SQLite (integrado ao Python)
{
  "mcpServers": {
    "my_sqlite_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "sqlite:////absolute/path/to/database.db"
      }
    }
  }
}
PostgreSQL
{
  "mcpServers": {
    "my_postgres_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "psycopg2-binary",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "postgresql://user:password@localhost/dbname"
      }
    }
  }
}
MySQL/MariaDB
{
  "mcpServers": {
    "my_mysql_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "pymysql",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "mysql+pymysql://user:password@localhost/dbname"
      }
    }
  }
}
Microsoft SQL Server
{
  "mcpServers": {
    "my_mssql_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "pymssql",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "mssql+pymssql://user:password@localhost/dbname"
      }
    }
  }
}
Oracle
{
  "mcpServers": {
    "my_oracle_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "oracledb",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "oracle+oracledb://user:password@localhost/dbname"
      }
    }
  }
}
CrateDB
{
  "mcpServers": {
    "my_cratedb": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "sqlalchemy-cratedb>=0.42.0.dev1",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "crate://user:password@localhost:4200/?schema=testdrive"
      }
    }
  }
}
Para conectar ao CrateDB Cloud, use uma URL como
crate://user:password@example.aks1.westeurope.azure.cratedb.net:4200?ssl=true.
Vertica
{
  "mcpServers": {
    "my_vertica_db": {
      "command": "uvx",
      "args": ["--from", "mcp-alchemy==2026.9.5.185701", "--with", "vertica-python",
               "--refresh-package", "mcp-alchemy", "mcp-alchemy"],
      "env": {
        "DB_URL": "vertica+vertica_python://user:password@localhost:5433/dbname",
        "DB_ENGINE_OPTIONS": "{\"connect_args\": {\"ssl\": false}}"
      }
    }
  }
}
Docker
Uma imagem de contêiner é publicada no GitHub Container Registry com drivers de banco de dados comuns (PostgreSQL, MySQL/MariaDB, MS SQL Server, Oracle) pré-instalados:
{
  "mcpServers": {
    "my_db": {
      "command": "docker",
      "args": ["run", "-i", "--rm", "-e", "DB_URL",
               "ghcr.io/runekaagaard/mcp-alchemy:latest"],
      "env": {
        "DB_URL": "postgresql://user:password@host.docker.internal/dbname"
      }
    }
  }
}
Ou construa você mesmo com docker build -t ghcr.io/runekaagaard/mcp-alchemy .
Transportes
Por padrão, o servidor fala stdio. Ele também pode servir via HTTP para clientes que se conectam dessa forma:
# Recommended HTTP transport (serves on http://HOST:PORT/mcp)
mcp-alchemy --transport streamable-http --host 127.0.0.1 --port 7000

# Legacy SSE transport, for older clients (serves on http://HOST:PORT/sse)
mcp-alchemy --transport sse --host 127.0.0.1 --port 7000
Variáveis de Ambiente
DB_URL: URL do banco de dados do SQLAlchemy (obrigatório)CLAUDE_LOCAL_FILES_PATH: Diretório para conjuntos de resultados completos (opcional)EXECUTE_QUERY_MAX_CHARS: Comprimento máximo de saída (opcional, padrão 4000)DB_ENGINE_OPTIONS: String JSON contendo opções adicionais do mecanismo SQLAlchemy (opcional)
Pool de Conexões
O MCP Alchemy usa pool de conexões otimizado para servidores MCP de longa duração. As configurações padrão são:
pool_pre_ping=True: Testa conexões antes do uso para lidar com timeouts de banco de dados e problemas de redepool_size=1: Mantém 1 conexão persistente (servidores MCP normalmente lidam com uma solicitação por vez)max_overflow=2: Permite até 2 conexões adicionais para capacidade de picopool_recycle=3600: Atualiza conexões com mais de 1 hora (evita problemas de timeout)isolation_level='AUTOCOMMIT': Garante que cada consulta seja confirmada automaticamente
Esses padrões funcionam bem para a maioria dos bancos de dados, mas você pode substituí-los via DB_ENGINE_OPTIONS:
{
  "DB_ENGINE_OPTIONS": "{\"pool_size\": 5, \"max_overflow\": 10, \"pool_recycle\": 1800}"
}
Para bancos de dados com configurações agressivas de timeout (como o padrão de 8 horas do MySQL), a combinação de pool_pre_ping e pool_recycle garante conexões confiáveis.
API
Ferramentas
-
all_table_names
- Retorna todos os nomes de tabelas no banco de dados
- Nenhuma entrada necessária
- Retorna lista separada por vírgulas de tabelas
users, orders, products, categories -
filter_table_names
- Encontra tabelas que correspondem a uma substring
- Entrada:
q(string) - Retorna nomes de tabelas correspondentes
Input: "user" Returns: "users, user_roles, user_permissions" -
schema_definitions
- Obtém esquema detalhado para tabelas especificadas
- Entrada:
table_names(string[]) - Retorna definições de tabelas incluindo:
- Nomes e tipos de colunas
- Chaves primárias
- Relações de chave estrangeira
- Flags de nulabilidade
users: id: INTEGER, primary key, autoincrement email: VARCHAR(255), nullable created_at: DATETIME Relationships: id -> orders.user_id -
execute_query
- Executa consulta SQL com formato de saída vertical
- Entradas:
query(string): consulta SQLparams(objeto, opcional): parâmetros da consulta
- Retorna resultados em formato vertical limpo:
1. row id: 123 name: John Doe created_at: 2024-03-15T14:30:00 email: NULL Result: 1 rows- Recursos:
- Truncamento inteligente de resultados grandes
- Acesso ao conjunto completo de resultados via integração claude-local-files
- Exibição limpa de valores NULL
- Datas formatadas em ISO
- Separação clara de linhas
Claude Local Files
Quando claude-local-files está configurado:
- Acesse conjuntos de resultados completos além da janela de contexto do Claude
- Gere relatórios detalhados e visualizações
- Realize análises profundas em grandes conjuntos de dados
- Exporte resultados para processamento adicional
A integração é ativada automaticamente quando CLAUDE_LOCAL_FILES_PATH está definido.
Desenvolvimento
Primeiro, clone o repositório do github, instale as dependências e o(s) driver(s) de banco de dados de sua escolha:
git clone git@github.com:runekaagaard/mcp-alchemy.git
cd mcp-alchemy
uv sync
uv pip install psycopg2-binary
Em seguida, defina isso no claude_desktop_config.json:
...
"command": "uv",
"args": ["run", "--directory", "/path/to/mcp-alchemy", "-m", "mcp_alchemy.server", "main"],
...
Meus Outros Projetos LLM
- MCP Redmine - Deixe o Claude Desktop gerenciar seus projetos e issues do Redmine.
- MCP Notmuch Sendmail - Assistente de e-mail para Claude Desktop usando notmuch.
- Diffpilot - Visualizador de diff git multicoluna com agrupamento e marcação de arquivos.
- Claude Local Files - Acesse arquivos locais em artefatos do Claude Desktop.
Listagens no Diretório MCP
O MCP Alchemy está listado nos seguintes sites e repositórios de diretório MCP:
Contribuindo
Contribuições são calorosamente bem-vindas! Seja relatórios de bugs, solicitações de recursos, melhorias na documentação ou contribuições de código - toda contribuição é valiosa. Sinta-se à vontade para:
- Abrir uma issue para relatar bugs ou sugerir recursos
- Enviar pull requests com melhorias
- Melhorar a documentação ou compartilhar seus exemplos de uso
- Fazer perguntas e compartilhar suas experiências
O objetivo é tornar a interação com bancos de dados via Claude ainda melhor, e seus insights e contribuições ajudam a alcançar isso.
Licença
Mozilla Public License Version 2.0