slop-eval
Servidor MCP que encapsula a CLI do slop-eval para pontuação de genericidade de saída de UI gerada por IA.
Documentação
slop-eval


Quickstart • CLI reference • Library API • MCP Server • Comparison • FAQ
Avalie interfaces geradas por IA quanto à genericidade com um juiz LLM, para que uma verificação de CI capture o mesmo problema de "isso parece igual a qualquer outro app feito com IA" que um revisor humano apontaria à primeira vista.
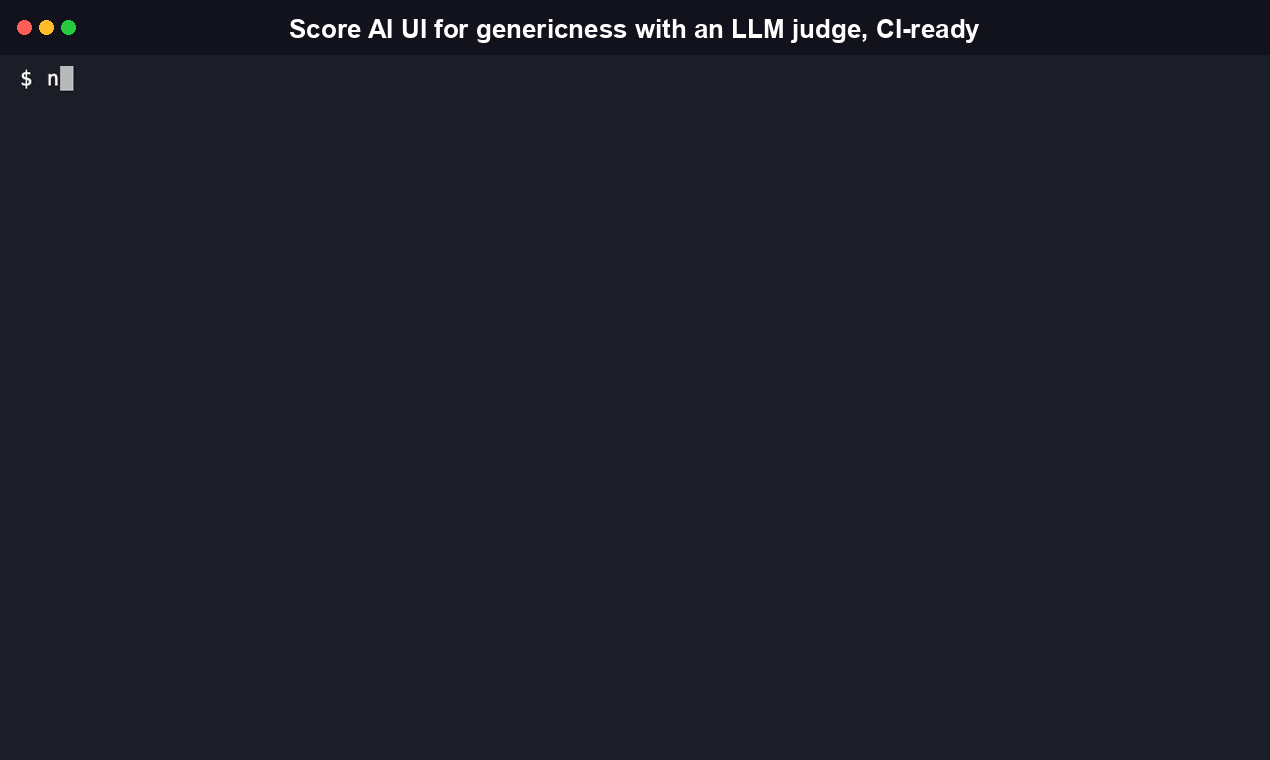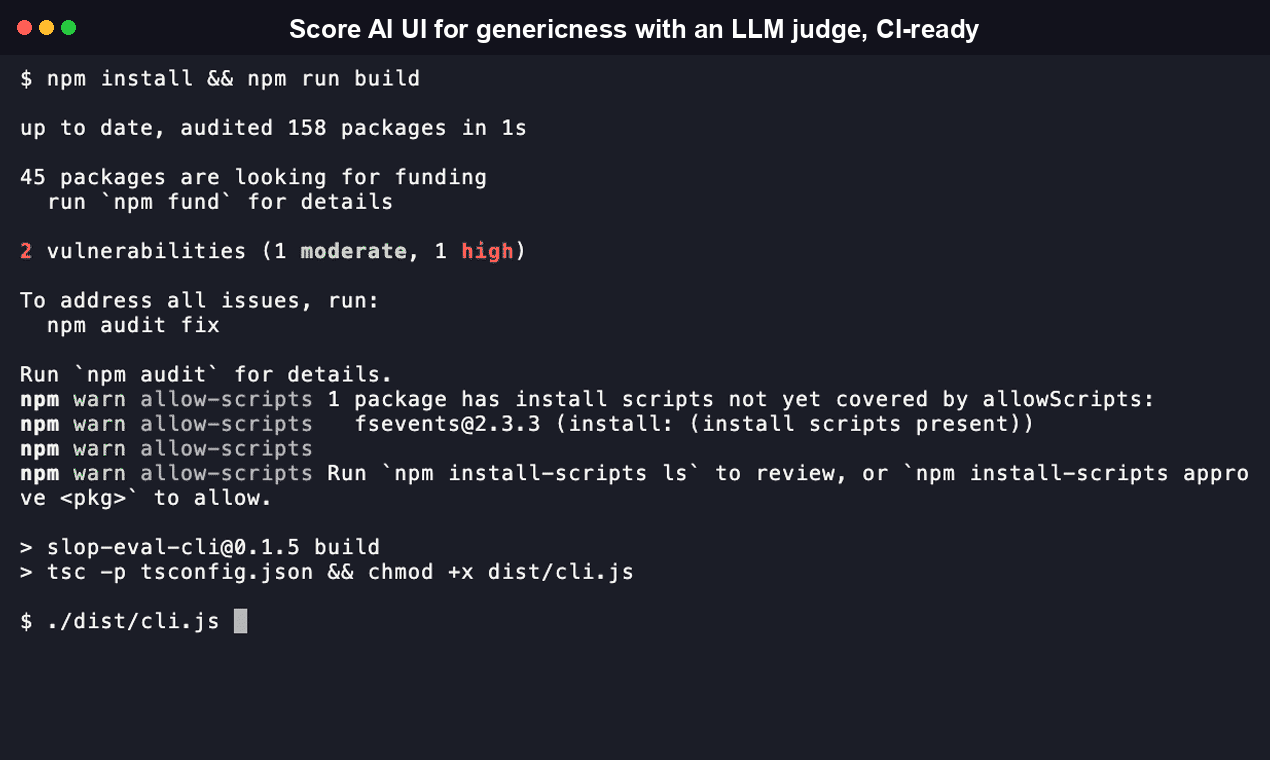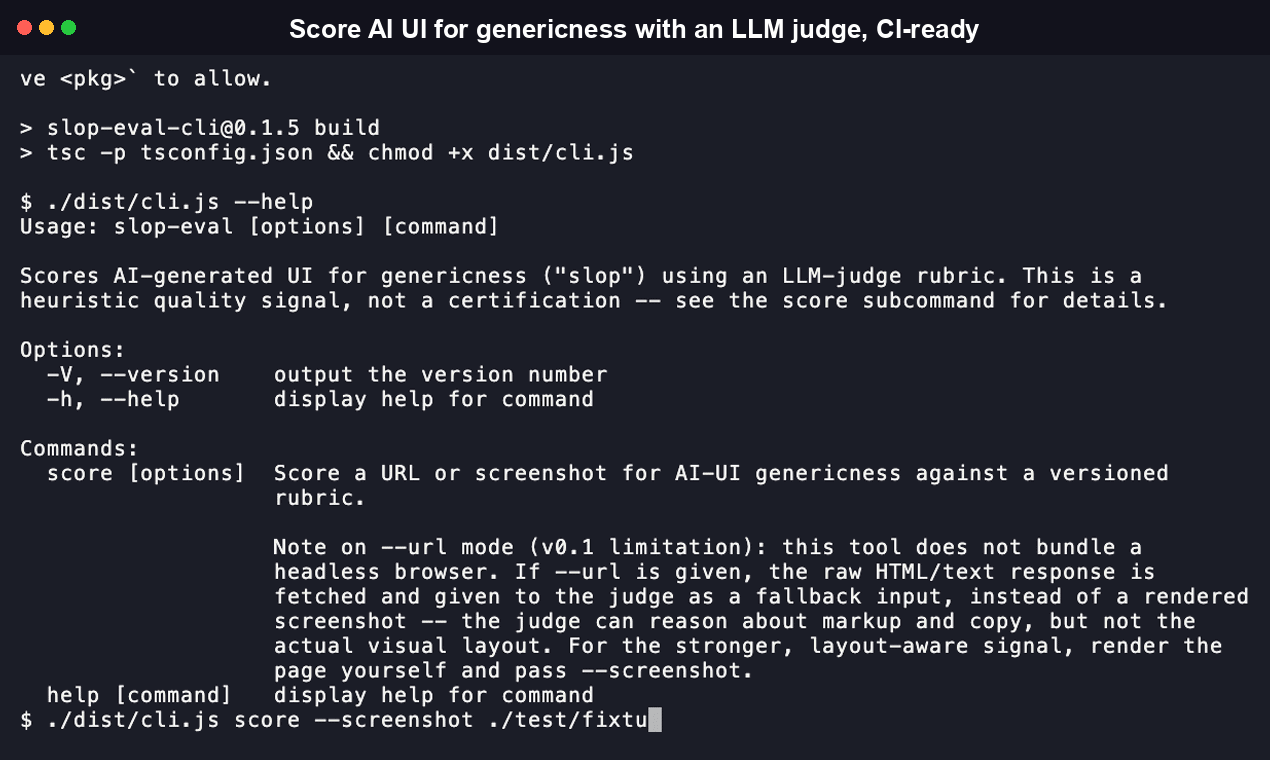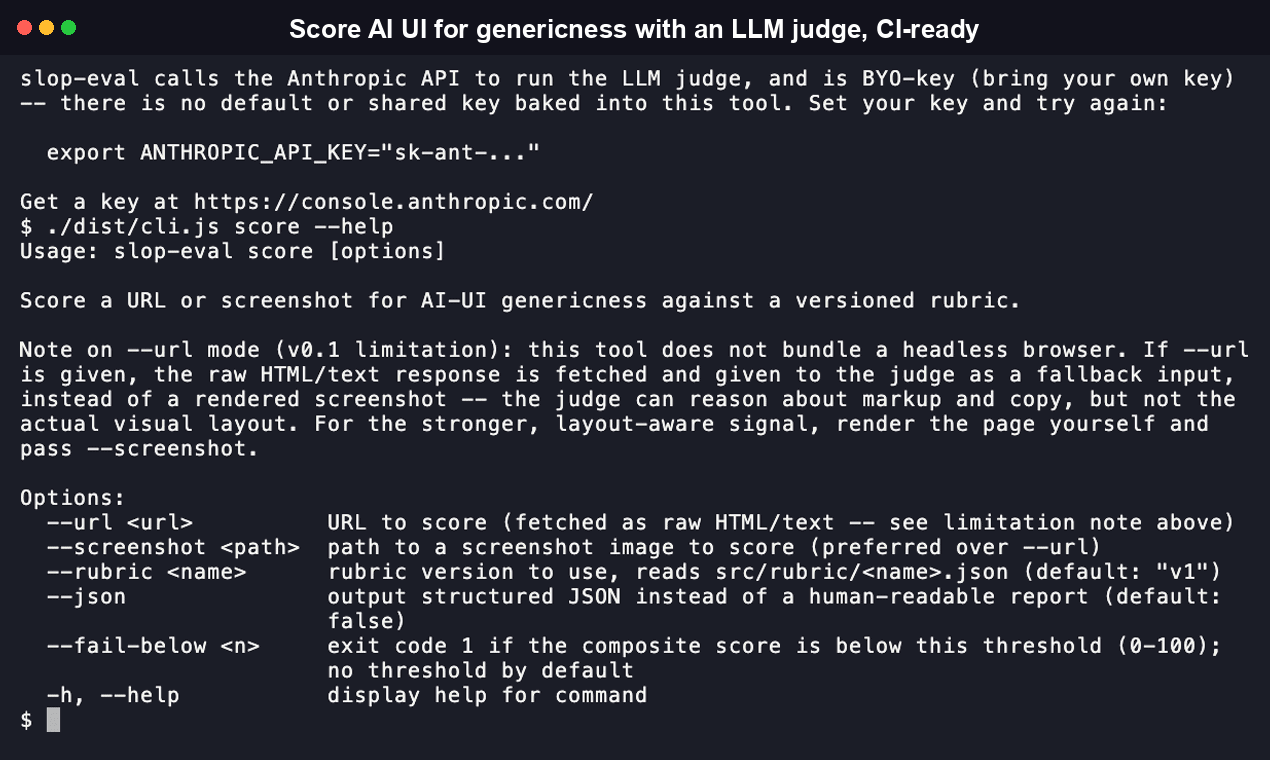
npx slop-eval-cli score --screenshot ./preview.png --json
Sem etapa de instalação: npx baixa e executa o pacote npm publicado diretamente. Prefere Python? pip install slop-eval-cli oferece a mesma CLI como um port genuíno e independente da lógica de pontuação.
Duas distribuições: npm e Python, ambas ativas
slop-eval-cli está ativo tanto no npm quanto no PyPI (pacote slop_eval). O port Python é uma implementação genuína e independente, construída e testada (60/60 testes, verificados nesta passagem) contra a mesma rubrica e o mesmo prompt de juiz Anthropic do original em TypeScript. Veja python/README.md para uso específico em Python.
Por que isso existe, e o que não é
O Hallmark do Nutlope, uma skill de design de IA popular com mais de 21.000 estrelas, tem uma issue aberta em que um usuário diz diretamente: "tudo isso parece slop." O mantenedor a fechou NOT_PLANNED. Separadamente, um contribuidor abriu um PR contra o Hallmark intitulado "Add eval-driven quality harness for Hallmark outputs" que está aberto e sem merge há cerca de dois meses até o momento em que escrevo. Ambos são reais e datados até o momento em que escrevo. Nenhum prova que a demanda é grande, apenas que a lacuna é real e atualmente não abordada.
slop-eval não é a primeira ferramenta nesse espaço, e não tenta ser. Duas ferramentas reais e gratuitas já estão próximas:
- Impeccable (pbakaus/impeccable, mais de 54.000 estrelas, Apache 2.0) traz uma CLI que sinaliza 59 indícios visuais específicos de UI gerada por IA (paletas de gradiente, glassmorphism, bordas com faixa lateral, violações de contraste WCAG), todos habilitados por padrão sem chamada de modelo; um comando separado
impeccable critiqueadiciona julgamentos opcionais baseados em LLM por cima. A detecção principal continua rápida porque não precisa de um modelo para nenhuma das verificações padrão. Cresceu muito além de um detector de slop, tornando-se uma skill completa de linguagem de design para Claude Code, Cursor e Codex, com 23 comandos no total. - aislop (MIT, mais de 500 estrelas) faz o equivalente determinístico e baseado em regras para código gerado por IA (não UI): mais de 50 regras de regex/AST em 8 linguagens, sem LLM no caminho de execução, posicionado exatamente como um portão de qualidade de CI.
Nenhum dos dois faz pontuação holística de UI baseada em julgamento: "esse layout parece novo", "essa escolha de componente parece considerada", o tipo de leitura que uma regra fixa não consegue codificar facilmente. Essa é a lacuna que o slop-eval preenche, construído para compor com ferramentas como as do Impeccable, e não para substituí-las.
Recursos
Verificados diretamente contra o código deste repositório:
- Três categorias de rubrica, cada uma com evidência citada obrigatória.
src/rubric/v1.jsonpontua novidade de layout, distinção de identidade visual e novidade de padrão de componentes, de 0 a 10 cada. Uma constatação sem citação específica é tratada como bug, não como pontuação válida (vejasrc/sources/RuleSource.ts). - Juiz LLM via chamada de ferramenta forçada, retornando JSON estruturado.
LLMJudgeSourcechama a API da Anthropic comtool_choicetravado em um esquemasubmit_slop_scores: a resposta volta como JSON estruturado de forma confiável, em vez de uma resposta de chat que precisa ser separada com regex. - Modo
--jsonpara CI e agentes. Cada execução pode emitir um objeto{ target, rubric, compositeScore, findings[], summary, disclaimer }analisável no stdout, tanto nos caminhos de sucesso quanto de erro, para que um script ou agente nunca precise ramificar por formato para encontrar uma string de erro. - Contrato real de código de saída.
0sucesso (sem limite, ou pontuação igual/acima de--fail-below),1sucesso, mas abaixo do limite,2erro de uso ou falha irrecuperável. Verificado diretamente contra a CLI compilada e os pacotes reais npm/PyPI nesta sessão; veja CLI reference. - Cache por hash de conteúdo.
src/cache/judge-cache.tsaplica hash nos bytes de entrada e pula a chamada de API completamente em uma execução repetida com entrada inalterada. Isso é uma garantia de correção tanto quanto uma economia de custo: um PR inalterado não pode fazer um portão de CI oscilar por variação de execução do LLM. - Interface de plugin
RuleSourcecomponível.src/sources/RuleSource.tsé o limite que toda fonte de pontuação implementa. Hoje há uma fonte real (LLMJudgeSource) e um stub documentado (ScreenshotDiffSource, honestamente relatado comonot_scoredaté existir um corpus rotulado real), para que um catálogo futuro de regras ou um segundo provedor de LLM se encaixe sem tocar no avaliador composto. - Entrada por captura de tela (leitura visual real) ou fallback
--url.--screenshotenvia a imagem renderizada real ao juiz.--urlé uma limitação documentada da v0.1: sem navegador headless embutido, então busca HTML/texto bruto e o juiz raciocina sobre marcação e texto em vez do layout. - GitHub Action que lidera com o sinal específico, depois a pontuação.
action/action.ymlpublica um comentário no PR encabeçado pela constatação sinalizada mais específica, seguida da pontuação composta, dando ao revisor o raciocínio por trás do número. - Rubrica pública e versionada. Cada pontuação nomeia a versão da rubrica (
v1hoje) que a produziu. Mudanças na rubrica saem como um novo arquivo, nunca uma edição silenciosa em um existente. - Uma API de biblioteca real e nativa para agentes, além da CLI. Ambas as distribuições exportam um ponto de entrada programático (
score_compositee amigos em Python,runScore/scoreCompositeem TypeScript) para que um framework de agentes possa chamar o slop-eval em processo em vez de invocar um subprocesso. Veja Library API.
Quickstart
Requer Node.js 18+ (npm) ou Python 3.9+ (PyPI), e uma ANTHROPIC_API_KEY (traga sua própria chave; obtenha uma em console.anthropic.com).
O caminho mais rápido, sem necessidade de clone local ou build, é o one-liner no topo deste README:
npx slop-eval-cli score --screenshot ./preview.png --json
Verificado nesta sessão contra o pacote npm real publicado, com um PNG real em ./preview.png e sem ANTHROPIC_API_KEY definido:
$ npx --yes slop-eval-cli@latest score --screenshot ./preview.png --json
{
  "error": "ANTHROPIC_API_KEY environment variable is not set.\nslop-eval calls the Anthropic API to run the LLM judge, and is BYO-key (bring your own key) -- there is no default or shared key baked into this tool. Set your key and try again:\n\n  export ANTHROPIC_API_KEY=\"sk-ant-...\"\n\nGet a key at https://console.anthropic.com/"
}
# exit code 2
Para compilar a partir do código-fonte:
git clone https://github.com/RudrenduPaul/slop-eval.git
cd slop-eval
npm install
npm run build

export ANTHROPIC_API_KEY="sk-ant-..."
./dist/cli.js score --screenshot ./test/fixtures/sample.png
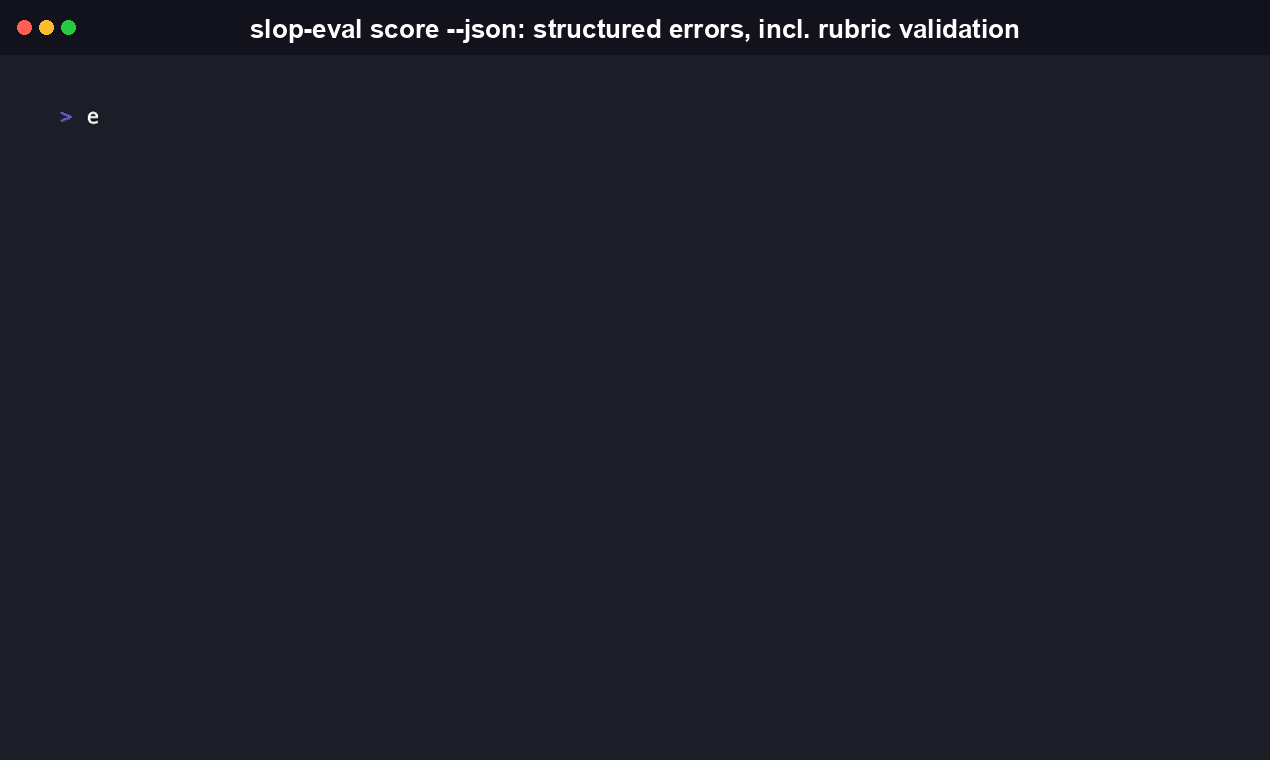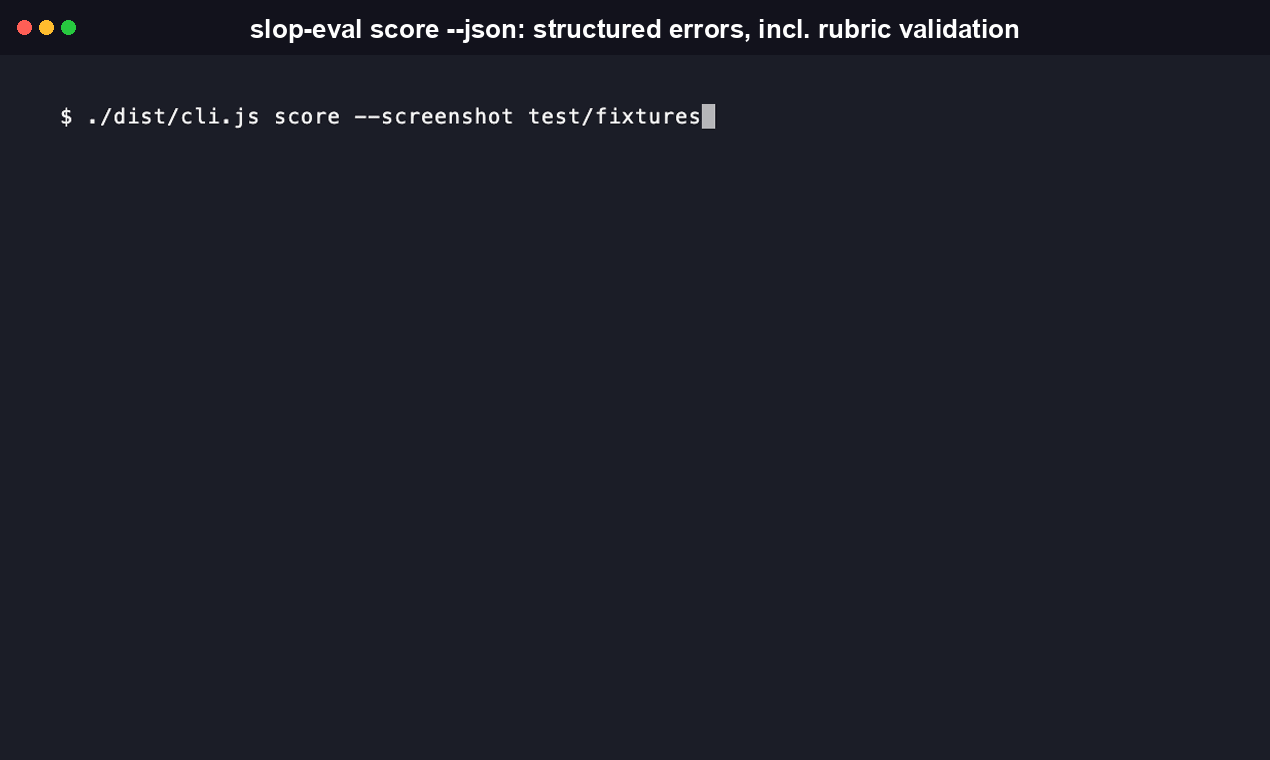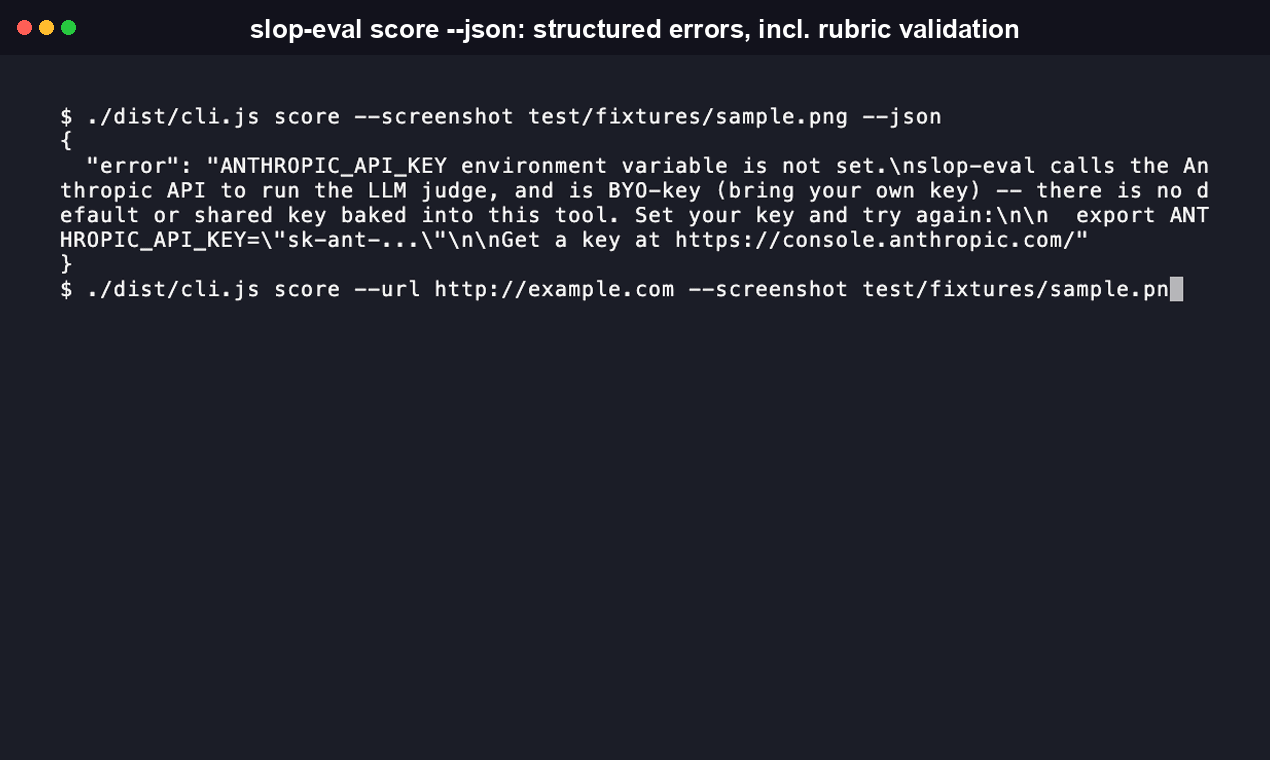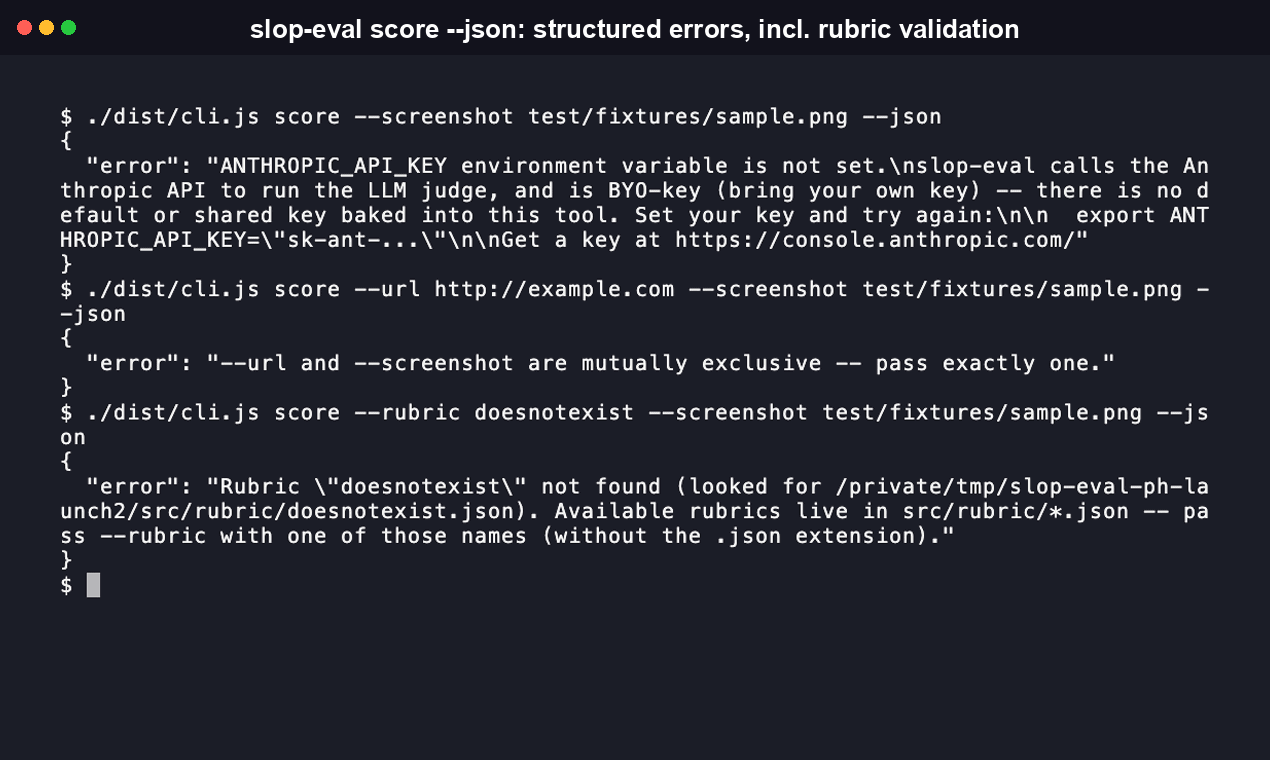
Para consumo em CI ou por agentes, adicione --json. --json sempre emite um objeto JSON válido no stdout, tanto nos caminhos de sucesso quanto de erro, e a verificação de exclusividade mútua --url/--screenshot é um bom exemplo de um caminho real de erro de uso no qual você pode confiar que será analisável:
./dist/cli.js score --screenshot ./test/fixtures/sample.png --json
{
  "target": "./test/fixtures/sample.png",
  "rubric": "v1",
  "compositeScore": 62,
  "findings": [
    {
      "ruleId": "llm-judge.layout-novelty",
      "category": "Layout novelty",
      "score": 4,
      "evidence": "Matches a common hero + 3-card grid + footer CTA pattern.",
      "status": "flag"
    }
  ],
  "summary": { "pass": 1, "flagged": 1, "notScored": 1 },
  "disclaimer": "This score is a heuristic quality signal from an LLM judge, not a certification..."
}
CLI reference
Capturado diretamente de ./dist/cli.js score --help na CLI compilada nesta sessão, palavra por palavra:
Usage: slop-eval score [options]

Score a URL or screenshot for AI-UI genericness against a versioned rubric.

Note on --url mode (v0.1 limitation): this tool does not bundle a headless
browser. If --url is given, the raw HTML/text response is fetched and given to
the judge as a fallback input, instead of a rendered screenshot -- the judge
can reason about markup and copy, but not the actual visual layout. For the
stronger, layout-aware signal, render the page yourself and pass --screenshot.

Options:
  --url <url>          URL to score (fetched as raw HTML/text -- see
                        limitation note above)
  --screenshot <path>  path to a screenshot image to score (preferred over
                        --url)
  --rubric <name>       rubric version to use, reads src/rubric/<name>.json
                        (default: "v1")
  --json                output structured JSON instead of a human-readable
                        report (default: false)
  --fail-below <n>      exit code 1 if the composite score is below this
                        threshold (0-100); no threshold by default
  -h, --help             display help for command
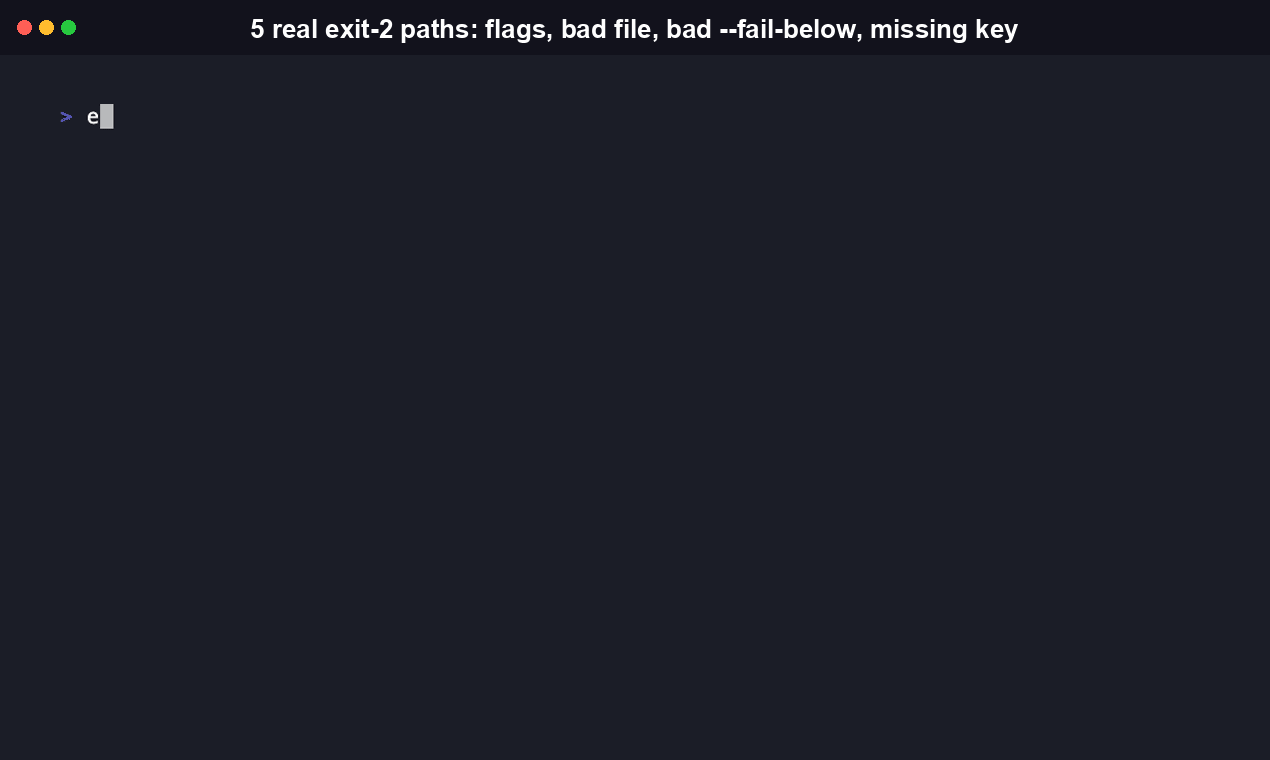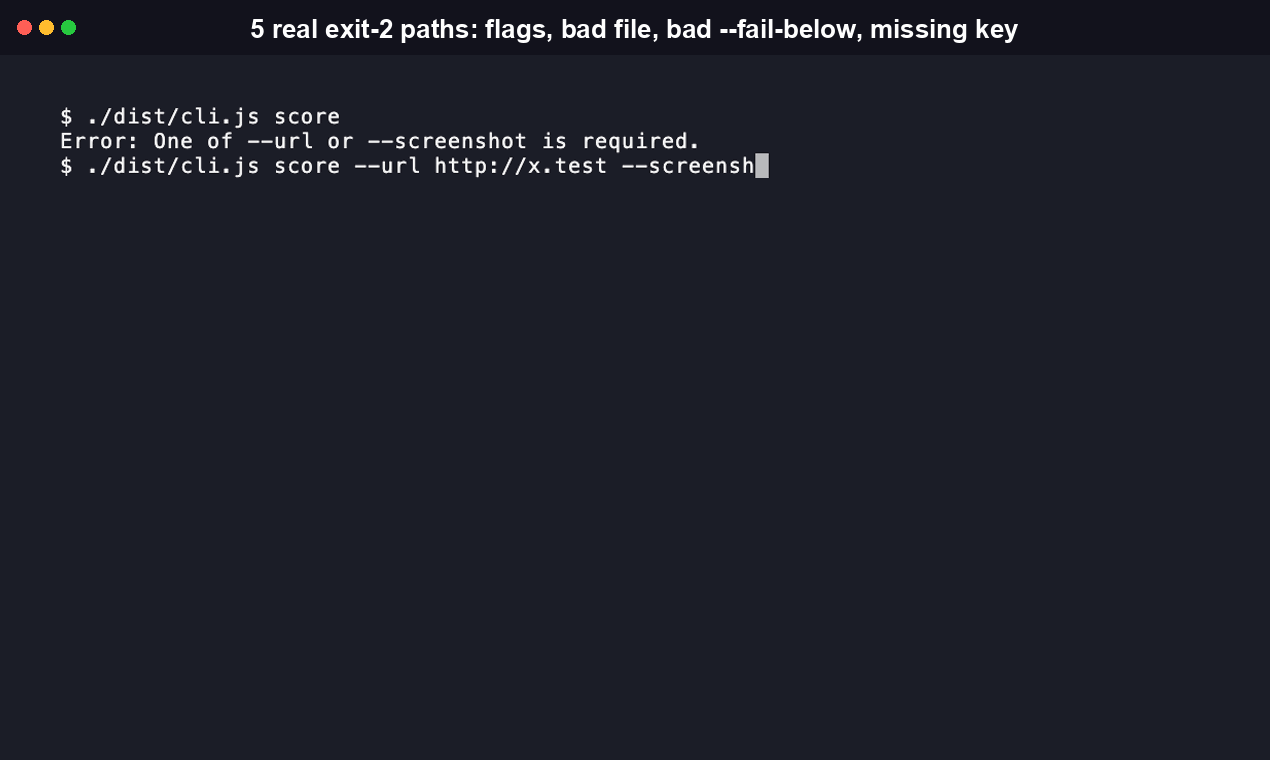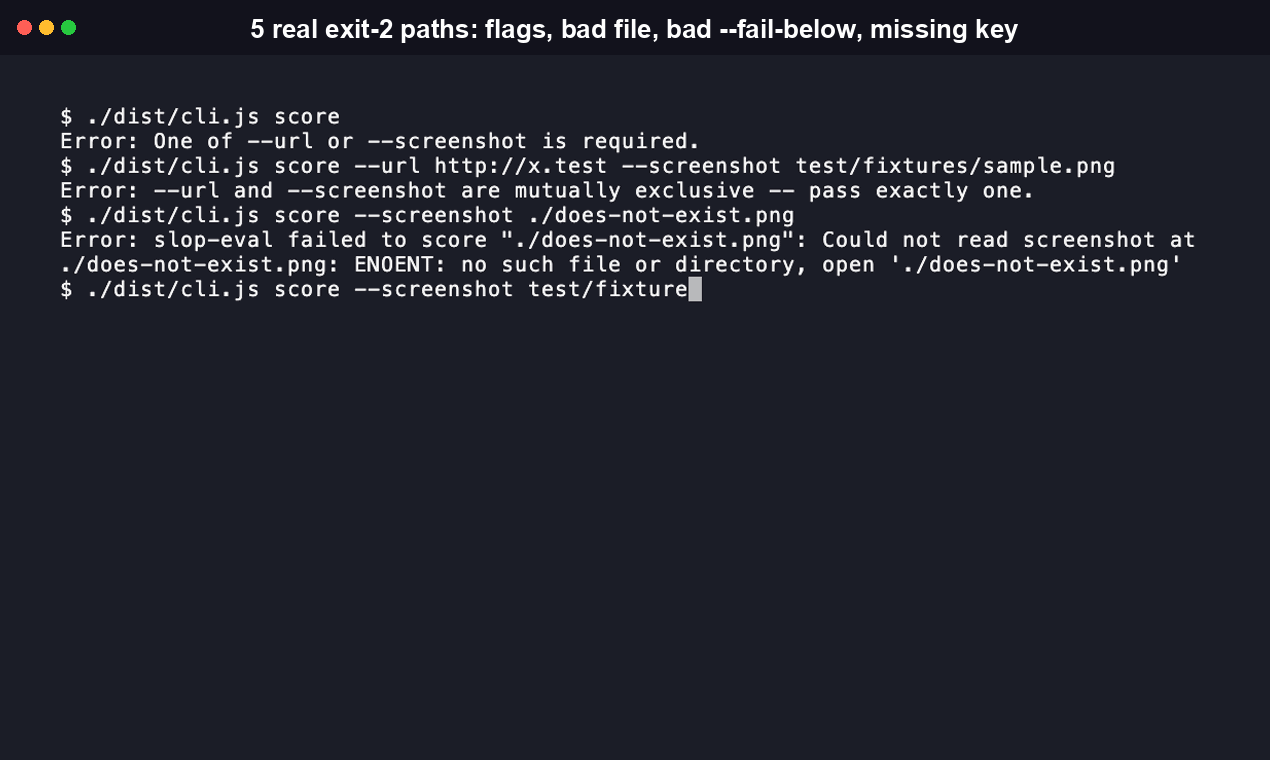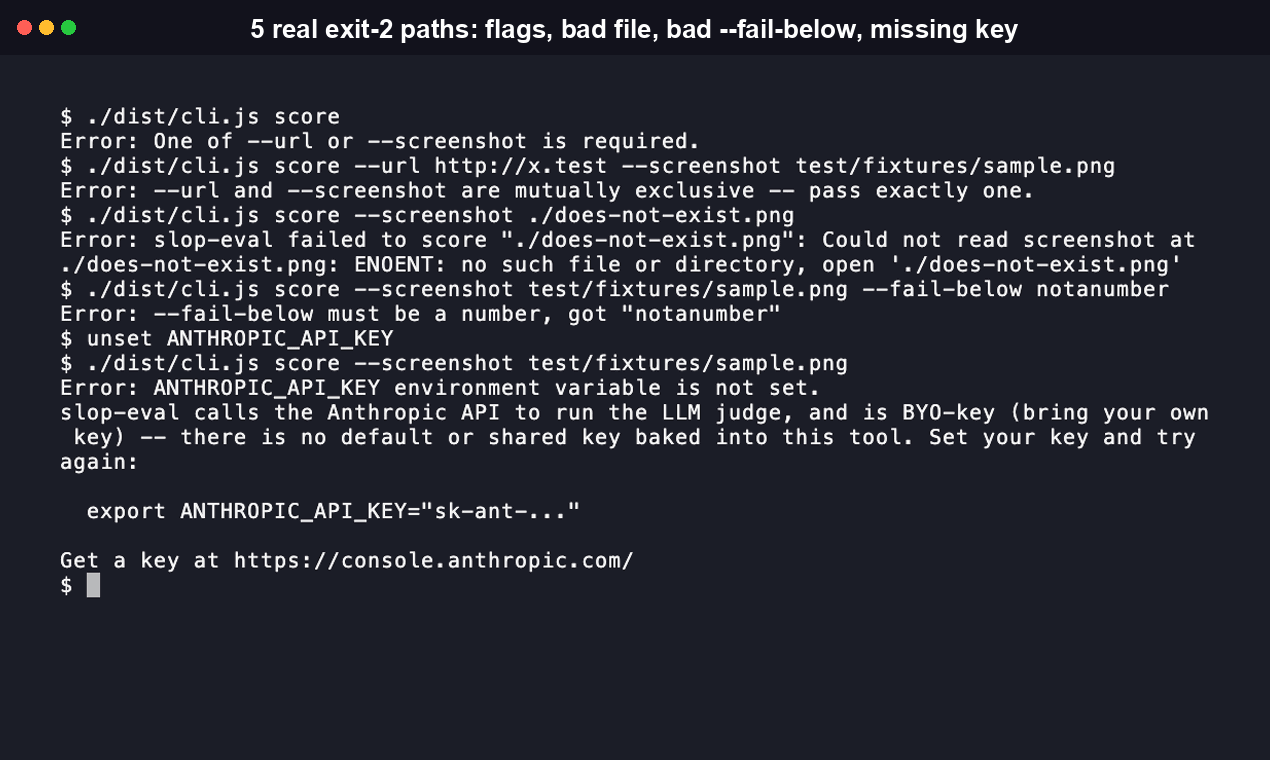
Códigos de saída: 0 sucesso (sem limite, ou pontuação igual/acima de --fail-below), 1 sucesso, mas abaixo do limite, 2 erro de uso ou falha irrecuperável (chave de API ausente, arquivo ilegível, rubrica malformada, --url/--screenshot mutuamente exclusivos).
--url e --screenshot são mutuamente exclusivos; passar ambos ou nenhum é um erro de uso (saída 2) em qualquer modo de saída. Ambos verificados diretamente contra a CLI compilada nesta sessão.
[!NOTE]
--urlé uma limitação da v0.1, por design: sem navegador headless embutido. Ele busca HTML/texto bruto e o entrega ao juiz como fallback de texto, raciocinando sobre marcação e texto em vez do layout renderizado.--screenshoté o sinal mais forte; renderize a página você mesmo (Playwright, Puppeteer ou a etapa existente de captura de tela de preview do seu CI) e passe a imagem.
A CLI Python (script de console slop-eval, instalado via pip install slop-eval-cli) expõe o mesmo conjunto de flags e o mesmo contrato de código de saída, confirmado contra sua própria saída --help nesta sessão.
Library API
Ambas as distribuições exportam um ponto de entrada programático real e documentado, além da CLI. Esta é a interface que um framework de agentes ou script de CI chama em processo em vez de invocar um subprocesso.
Python (slop_eval/__init__.py):
from slop_eval import score_composite, ScoreInput, LLMJudgeSource, ScreenshotDiffSource

sources = [LLMJudgeSource("v1"), ScreenshotDiffSource()]
result = score_composite(sources, ScoreInput(screenshot_path="./preview.png"))
print(result.composite_score, result.findings)
score_composite(sources: List[RuleSource], score_input: ScoreInput) -> CompositeResult executa cada RuleSource na ordem da lista, achata as constatações e retorna um CompositeResult com composite_score: float (0-100) e findings: List[RuleFinding]. Também exportados: RuleFinding, RuleFindingStatus, RuleSource, Rubric, RubricCategory, load_rubric, build_json_report, render_human_report, print_report, print_error, MissingApiKeyError, RubricLoadError.
TypeScript (src/cli.ts, exportado da entrada main/types do pacote): runScore(options: ScoreOptions, buildSources?) => Promise<number> e buildProgram(): Command são os dois pontos de entrada exportados, junto com a interface ScoreOptions. scoreComposite (de src/scorer/composite.ts) é a mesma função de pontuação composta que a CLI chama internamente. Eles existem principalmente para que a suíte de testes possa dirigir a CLI em processo; o __init__.py do pacote Python é a superfície de biblioteca "nativa para agentes" mais deliberadamente documentada das duas.
MCP Server
O slop-eval inclui um servidor Model Context Protocol, para que um agente compatível com MCP (Claude Desktop, Claude Code, Cursor, um orquestrador) possa chamar o slop-eval diretamente como ferramenta em vez de invocar a CLI e analisar o stdout.
pip install "slop-eval-cli[mcp]"
Configuração do Claude Desktop:
{
  "mcpServers": {
    "slop-eval": {
      "command": "slop-eval-mcp",
      "env": { "ANTHROPIC_API_KEY": "sk-ant-..." }
    }
  }
}
O servidor expõe uma ferramenta, run(args: list[str]) -> dict, um wrapper genérico em torno da CLI: passe os mesmos argv que você passaria na linha de comando (menos o slop-eval inicial), e ele retorna a saída JSON analisada da CLI, ou um dict {"error": ...} estruturado em uma saída não zero, um timeout ou uma falha de subprocesso — a chamada de ferramenta em si nunca levanta exceção. Exemplo:
run(["score", "--screenshot", "./preview.png", "--json"])
# -> {"result": {"target": "./preview.png", "rubric": "v1", "compositeScore": 62.0, "findings": [...], ...}}
Inicie diretamente com slop-eval-mcp (transporte stdio). Requer Python 3.9+ para o pacote base; o extra mcp em si precisa de mcp>=2.0.0.
GitHub Action
- uses: RudrenduPaul/slop-eval/action@main
  with:
    url: ${{ steps.deploy.outputs.preview_url }}
    fail-below: 50
  env:
    ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
Publica um comentário no PR encabeçado pela constatação sinalizada mais específica, seguida da pontuação composta. Requer permissions: pull-requests: write no workflow chamador. Referência completa de entrada/saída em action/README.md.
Comparação honesta
| slop-eval | Impeccable | aislop | |
|---|---|---|---|
| Alvo | UI gerada por IA | UI gerada por IA | código gerado por IA |
| Método de detecção | Juiz LLM (holístico) | Regras determinísticas, 59 verificações por padrão; comando separado critique adiciona julgamentos LLM opcionais | Regras determinísticas (mais de 50 verificações) |
| Requer chave de API | Sim (chave Anthropic própria) | Não, para as 59 verificações determinísticas padrão | Não |
| Velocidade | Mais lento por design, uma chamada real de modelo está no caminho crítico | Quase instantâneo para as verificações determinísticas | Sub-segundo, sem chamada de rede |
| Fontes de regras componíveis | Sim, interface de plugin RuleSource | Não (conjunto fixo de regras) | Não (conjunto fixo de regras) |
| Estrelas no GitHub | Novo (este repositório) | 54.000+ | 500+ |
| Licença | Apache 2.0 | Apache 2.0 | MIT |
| Modelo de portão de CI | GitHub Action, limite --fail-below | Não posicionado principalmente como produto de CI | Sim, portão de qualidade de CI |
Quer verificações rápidas, determinísticas e de custo zero para indícios conhecidos de IA em UI? A ferramenta do Impeccable é a melhor opção hoje, e por contagem de estrelas e escopo é o projeto mais estabelecido de longe. Para um julgamento holístico sobre novidade de layout e componentes que um conjunto fixo de regras não consegue codificar facilmente, é isso que o slop-eval adiciona. Nada impede você de rodar ambos no mesmo job de CI.
Sobre velocidade: o slop-eval é genuinamente mais lento que as verificações principais do Impeccable e o aislop, porque uma chamada de LLM está no caminho crítico. Números reais e medidos de overhead de CLI de um clone e build novos, obtidos nesta sessão (caminhos --help e de erro, sem chamada de pontuação):
| Comando | Tempo real medido |
|---|---|
slop-eval score --help | ~0.05s |
slop-eval score --screenshot <x> (sem chave de API, falha rapidamente, apenas leitura de arquivo local) | ~0.05s |
slop-eval score --url <x> (sem chave de API, falha rapidamente) | 0.18s-0.91s, varia com a latência de rede, pois este caminho busca a URL antes da verificação da chave |
A latência real da execução pontuada (uma chamada real de LLM-judge, nova vs. em cache) exige uma ANTHROPIC_API_KEY ativa que este ambiente não possui, então esses dois números são metas pendentes de uma execução medida de verdade: menos de 10 segundos para execução nova, menos de 1 segundo em cache hit para entrada idêntica. O número de cache hit é garantido pela lógica de cache por hash de conteúdo em src/cache/judge-cache.ts; o número de execução nova é uma estimativa. Preferimos rotular uma meta como meta do que afirmar um número que não conseguimos reproduzir.
O que uma pontuação significa (e o que não significa)
Uma pontuação do slop-eval é um sinal heurístico de qualidade a partir da leitura de um LLM da sua UI contra uma rubrica declarada. Não é uma certificação de que algo é ou não gerado por IA, e uma pontuação limpa não significa que a UI é boa em todos os aspectos, apenas que esta rubrica, nesta versão, não a sinalizou.
A rubrica é pública e versionada
Cada pontuação é avaliada contra src/rubric/v1.json, um arquivo real e versionado que você pode abrir e ler diretamente. Leia-o, proponha mudanças ou fixe uma versão específica com --rubric. Uma versão de rubrica nunca é editada no lugar; uma mudança é publicada como um novo arquivo, para que uma pontuação histórica sempre registre qual rubrica a produziu.
Roteiro
- v0.1 (esta versão): pontuação por LLM-judge, CLI, GitHub Action, cache por hash de conteúdo, modo
--json, API de biblioteca em ambas as distribuições. - v0.2:
ScreenshotDiffSourcese torna real quando um corpus rotulado genuíno existir. Um adaptador de catálogo Impeccable, pendente de verificação de licença. Comando explícitorescore --rubric v2para que uma atualização de rubrica nunca seja silenciosa.
Segurança
ANTHROPIC_API_KEY é lido apenas do ambiente, nunca é registrado em logs e nunca é gravado no cache por hash de conteúdo -- veja SECURITY.md para a política completa e o processo de divulgação privada.
FAQ
O que é o slop-eval e como ele é diferente de um linter? É um CLI, GitHub Action e biblioteca que pontua UI gerada por IA quanto à genericidade ("slop") usando um LLM judge da Anthropic contra uma rubrica versionada (src/rubric/v1.json), em vez de um conjunto fixo de verificações determinísticas de padrões. Foi criado para capturar a leitura "isto parece qualquer outro app construído por IA" que um revisor humano faz à primeira vista, e para rodar junto com um linter determinístico no mesmo job de CI ou loop de agente.
Preciso de uma chave de API? Sim. O slop-eval é bring-your-own-key contra a API da Anthropic; não há chave compartilhada ou hospedada. Nada é enviado a lugar algum exceto à API da Anthropic.
Como instalo e quais plataformas são suportadas? Duas distribuições independentes, ambas verificadas como instaláveis e executáveis nesta sessão. npm: npx slop-eval-cli score ... (sem instalação) ou npm install -g slop-eval-cli, exigindo Node.js 18+ (veja engines em package.json). PyPI: pip install slop-eval-cli, exigindo Python 3.9-3.13 (veja os classificadores em python/pyproject.toml). Nenhum dos pacotes tem binário nativo ou etapa de build específica de plataforma, então ambos instalam da mesma forma em macOS, Linux e Windows.
Como o slop-eval se compara especificamente ao Impeccable? Veja a tabela Comparação honesta acima para o detalhamento completo. Em resumo: o núcleo do Impeccable tem 59 verificações determinísticas, todas habilitadas por padrão, que não precisam de chave de API e rodam quase instantaneamente, e o projeto em si cresceu para uma habilidade de design-language muito maior (54,000+ estrelas, 23 comandos) além da detecção de slop; um comando separado critique adiciona mais julgamentos de LLM sobre o conjunto determinístico. O slop-eval é uma única chamada de LLM-judge que precisa de uma chave BYO da Anthropic e é mais lento por design, porque uma chamada real de modelo está no caminho crítico, em troca de um julgamento holístico de layout/componentes que uma regra fixa não consegue codificar facilmente. Eles foram feitos para rodar juntos no mesmo job de CI.
Posso usar um provedor de modelo diferente (OpenAI, Gemini)? Não na v0.1. LLMJudgeSource chama a API da Anthropic diretamente; ANTHROPIC_MODEL só permite escolher um modelo diferente da Anthropic. Um provedor plugável é um encaixe natural para a interface RuleSource no futuro, mas ainda não foi construído, então não interprete "fontes de regras compostáveis" como "multi-provedor" hoje.
O --url renderiza a página como um navegador faria, e o que acontece se minha execução de pontuação falhar? Não, não na v0.1. --url busca a resposta bruta de HTML/texto e a entrega ao judge como fallback; renderize a página você mesmo e passe --screenshot para uma leitura visual real. Sobre falhas em geral: todo caminho de erro, incluindo uma ANTHROPIC_API_KEY ausente, sai com o código 2 e imprime uma mensagem clara (um objeto JSON {"error": ...} no modo --json), então uma execução com falha deve sempre dizer exatamente o que corrigir.
Reexecutar o slop-eval no mesmo PR vai fazer a verificação de CI oscilar? Não. Entrada idêntica (mesmos bytes de screenshot, ou mesma URL mais conteúdo buscado) atinge o cache por hash de conteúdo em src/cache/judge-cache.ts e nunca re-chama a API, então a mesma entrada sempre retorna o mesmo resultado em cache.
O screenshot-diff-vs-corpus é uma verificação real hoje? Não. É uma implementação real de RuleSource no código, mas a v0.1 a entrega como um stub honesto de not_scored porque ainda não existe um corpus de comparação rotulado. Semear manualmente um corpus não validado seria um sinal menos honesto do que reportar "não pontuado". A comparação baseada em corpus está planejada para a v0.2.
Posso usar o slop-eval comercialmente, inclusive em um produto de código fechado? Sim. Ambas as distribuições são Apache 2.0 (LICENSE, python/LICENSE), uma licença permissiva que permite uso comercial, modificação e redistribuição em código fechado, e inclui uma concessão expressa de patentes. Chamar o CLI, a Action ou a biblioteca a partir de um projeto de código fechado não obriga você a abrir nada; a licença e o aviso de copyright só precisam acompanhar cópias redistribuídas do próprio código do slop-eval.
Contribuindo
Issues e PRs são bem-vindos, veja CONTRIBUTING.md (cobre tanto os pacotes npm quanto Python, incluindo requisitos de cobertura por pacote). Novas implementações de RuleSource são a contribuição de maior impacto: a interface de plugin existe especificamente para que um novo método de detecção não exija mexer no scorer composto.
Licença
Apache 2.0. Veja LICENSE.