ownvoice
Servidor MCP que encapsula a CLI do ownvoice para verificações de voz e identidade.
Documentação
OwnVoice
Treine um adaptador de voz LoRA para o pocket-tts e mantenha o resultado: um arquivo no seu próprio disco, não uma assinatura de API.


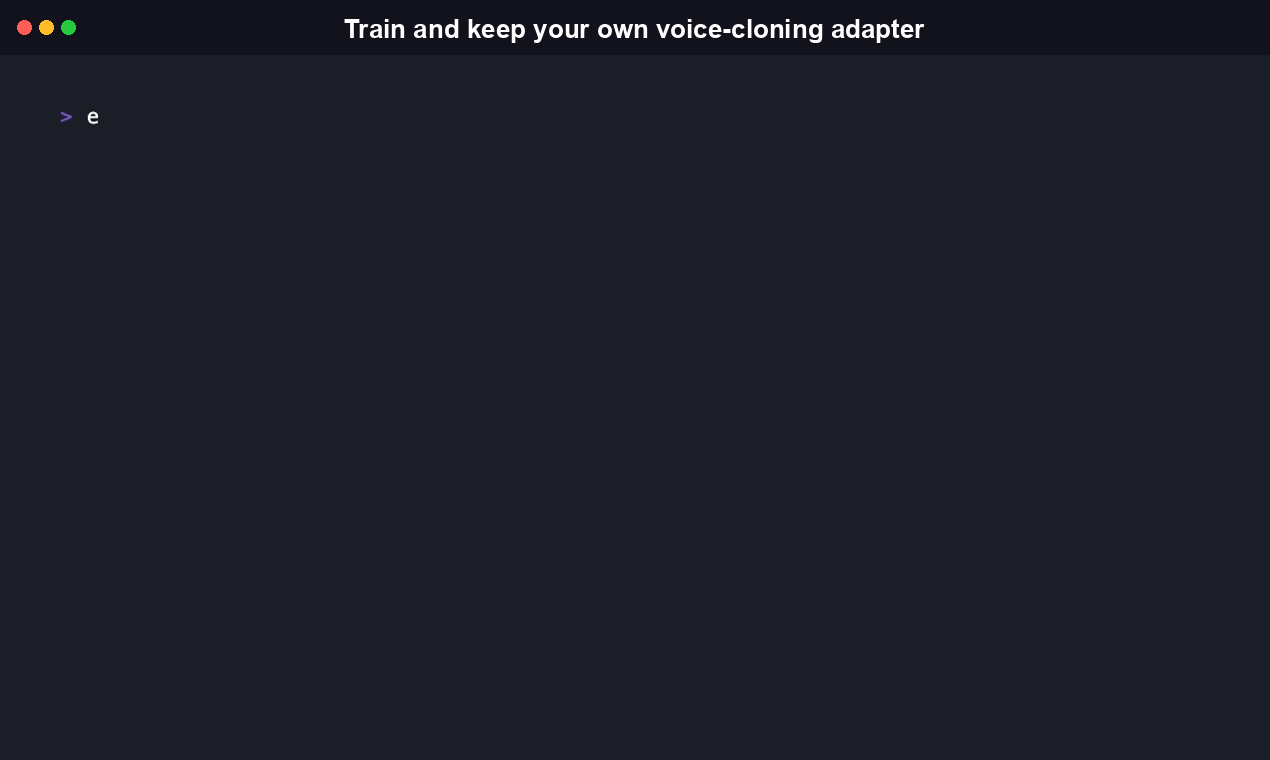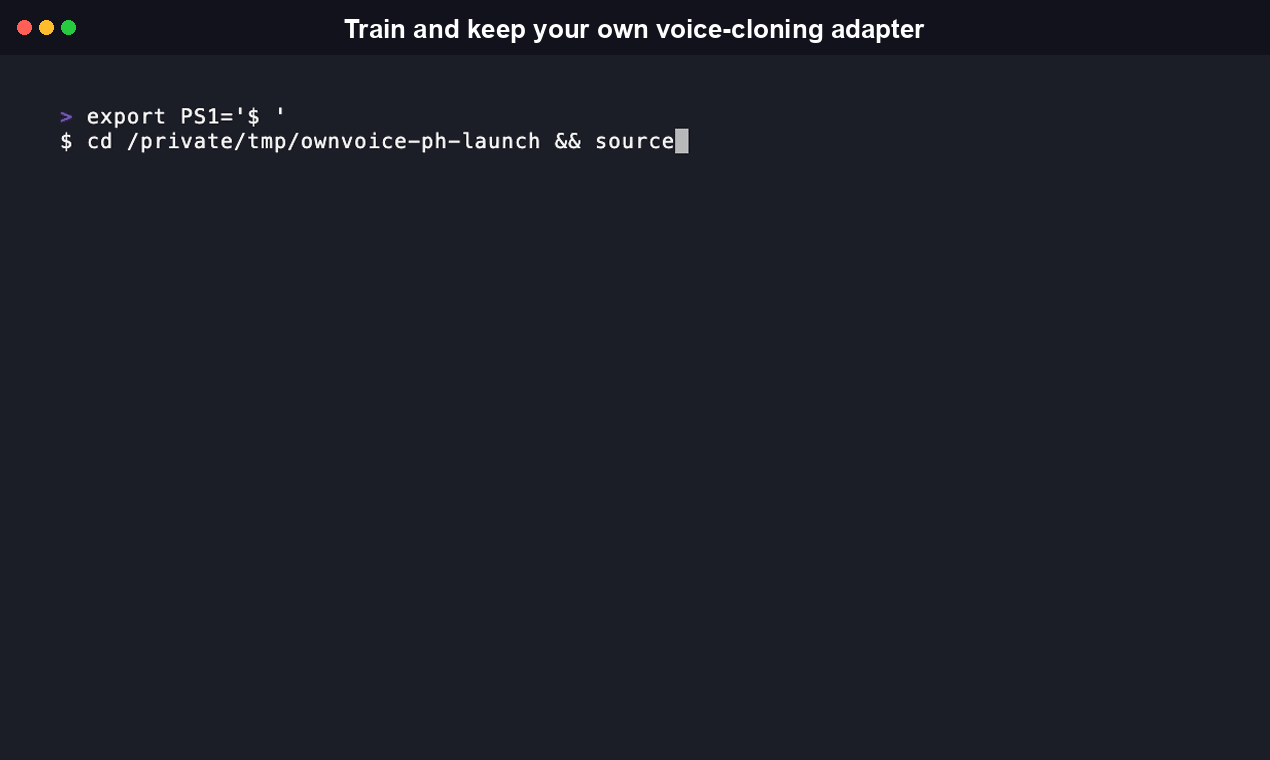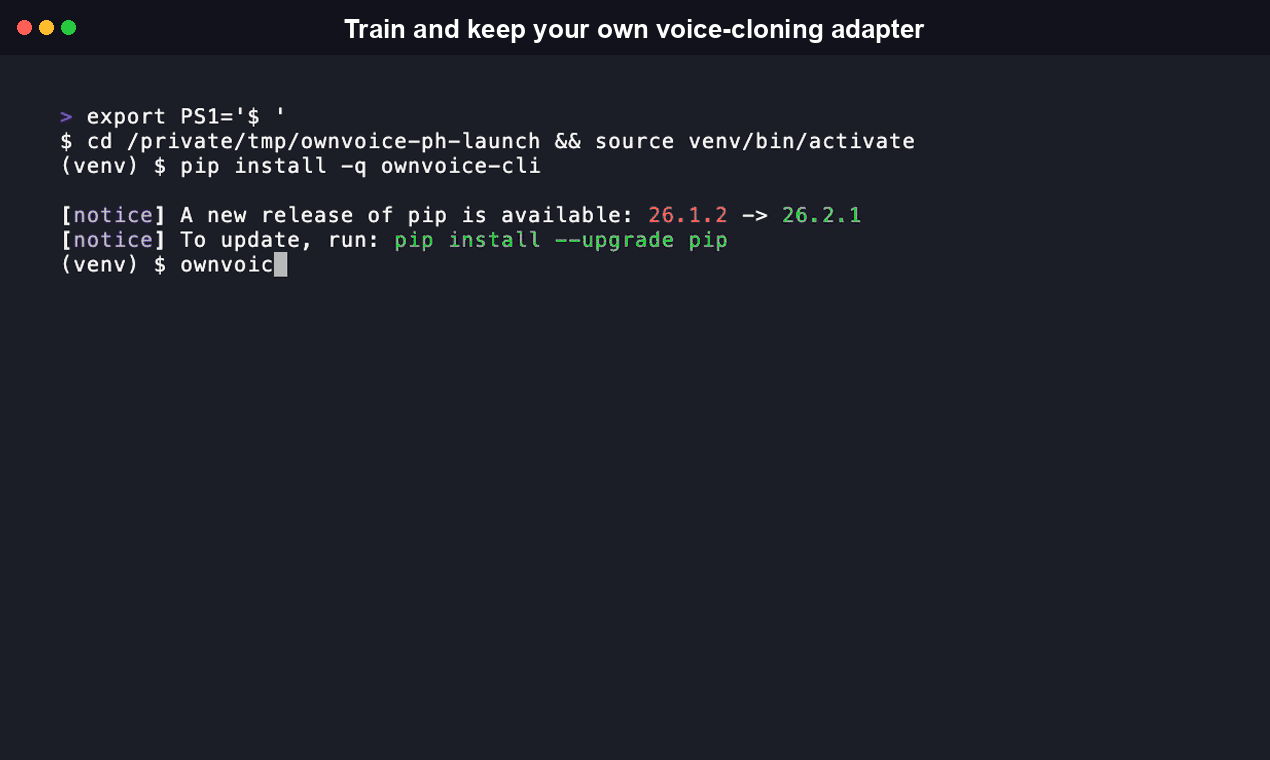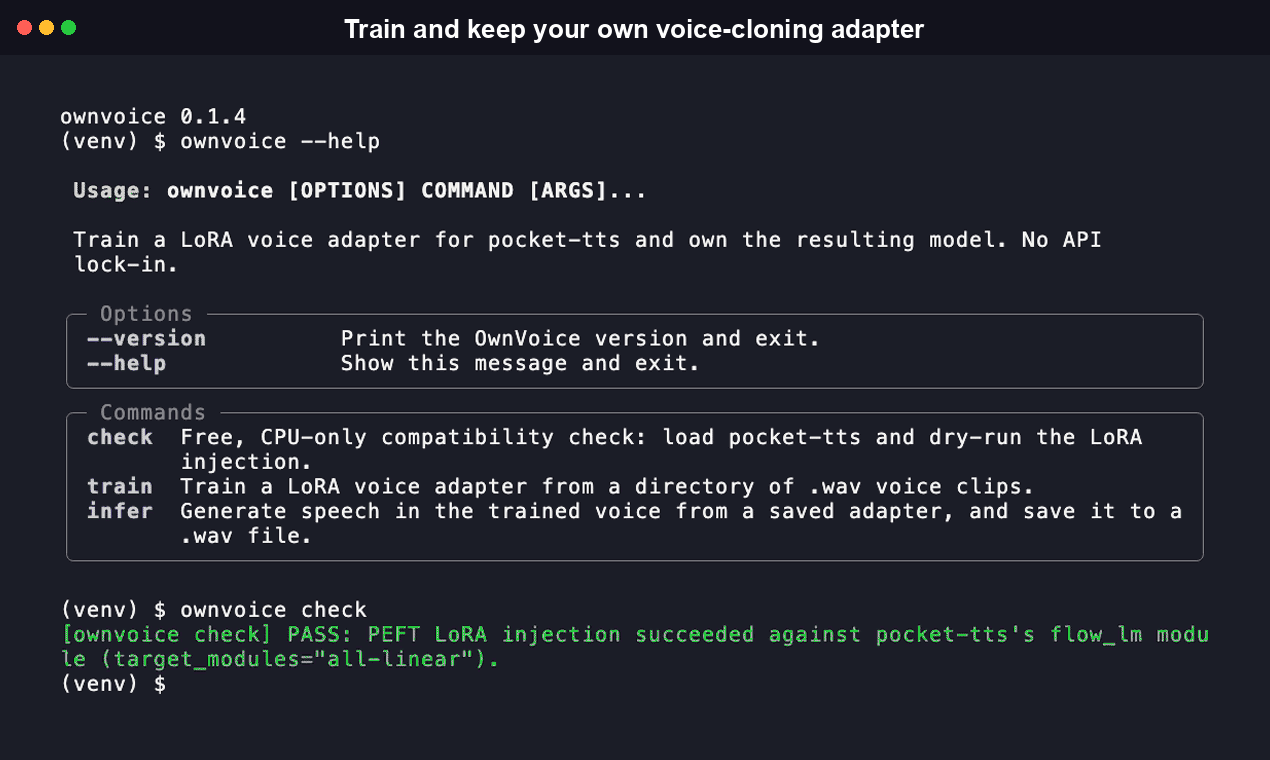
pip install ownvoice-cli
Requer Python 3.11 ou mais recente. Veja Instalação abaixo para o caminho via npx / agent-sandbox.
Sumário
- Instalação
- Início Rápido
- Referência da CLI
- Recursos
- Como Funciona
- Benchmark de Tempo de Configuração vs Ferramentas Comparáveis
- Por Que o OwnVoice Existe
- O Que o OwnVoice Não É
- Consentimento e Uso Indevido
- Status da Implementação
- Perguntas Frequentes
- Contribuindo
- Licença
Instalação
pip install ownvoice-cli
Ambientes npx / agent-native: O OwnVoice é uma CLI em Python/PyTorch, então o pacote npm é um wrapper fino, não uma reimplementação em Node. Ele inicializa a CLI real via uv ou pipx, o que já estiver em PATH, útil para sandboxes de agentes de codificação e runners de CI que usam Node por padrão. O pacote npm foi renomeado para ownvoice-cli (antes era o antigo ownvoice, agora descontinuado) para corresponder à sua contraparte no PyPI.
npx ownvoice-cli check
Tanto o wrapper npm quanto o pacote PyPI (ownvoice-cli) estão ativos, então o comando acima funciona hoje.
Torch e CUDA: ownvoice check não precisa de GPU e roda na CPU, combinando com o design do próprio pocket-tts que também funciona na CPU. Treinar um adaptador real é muito mais rápido em uma GPU NVIDIA. Se você tiver uma, instale a versão CUDA do PyTorch primeiro seguindo pytorch.org/get-started/locally, depois instale o OwnVoice por cima, para que pip não baixe silenciosamente a versão apenas-CPU. Em Apple Silicon ou em uma máquina apenas-CPU, o pip install padrão do torch é suficiente: ownvoice check e ownvoice infer rodam normalmente, ownvoice train apenas leva mais tempo por época.
Início Rápido
1. ownvoice check, a validação gratuita do Dia 0
Antes de gravar qualquer coisa ou alugar uma GPU, confirme que a injeção LoRA do PEFT realmente funciona contra a estrutura real do modelo do pocket-tts. Isso é totalmente gratuito: apenas CPU, sem treinamento, sem GPU.
$ ownvoice check
[ownvoice check] PASS: PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules="all-linear").
Se falhar, o OwnVoice imprime a árvore real de módulos do modelo em vez de um stack trace cru, para que você veja exatamente o que não correspondeu e possa reportar com precisão:
$ ownvoice check
[ownvoice check] FAIL: PEFT LoRA injection failed against pocket-tts's flow_lm module structure: <error detail>. Please post an honest blocker (this error plus the module tree above) as a comment on https://github.com/kyutai-labs/pocket-tts/issues/30 rather than working around it silently, that issue is exactly where this gap needs to be visible.

Module tree (for debugging / for the issue #30 blocker post):
<root>: FlowLMModel
input_linear: Linear
transformer: StreamingTransformer
transformer.layers.0.self_attn.in_proj: Linear
transformer.layers.0.self_attn.out_proj: Linear
...
2. ownvoice train
Grave de 5 a 10 minutos de áudio limpo da voz que você quer treinar (sua própria voz, com seu próprio consentimento, veja Consentimento e uso indevido), divida em alguns clipes de .wav em um diretório, e aponte o OwnVoice para ele:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] USABLE ADAPTER
Usable adapter (similarity 0.812 >= 0.75). Try it now:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
Apenas --voice-clips é obrigatório. Todos os outros parâmetros têm um padrão sensato (veja a Referência da CLI completa abaixo).
Uma execução que termina mas não ultrapassa a barra de similaridade ainda sai com código 0. É um resultado rotulado com um próximo passo concreto, não uma falha:
$ ownvoice train --voice-clips ./my-voice-clips
[ownvoice train] BELOW THRESHOLD
Below threshold (similarity 0.612 < 0.75). The adapter was still saved, try more/cleaner voice clips, more epochs, or a higher --lora-rank, then re-run. You can still listen to it:
  ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "This is my own voice, trained with OwnVoice."
Apenas um problema de carregamento de dados (nenhum clipe utilizável) ou uma falha capturada de injeção PEFT sai com código diferente de zero. Uma execução concluída sempre grava adapter.safetensors e metadata.json (configuração de treinamento, pontuação de similaridade, um timestamp) no diretório de saída: dois arquivos que você mantém, sem necessidade de ida ao servidor para usá-los novamente.
3. ownvoice infer
$ ownvoice infer --adapter ownvoice-adapter/adapter.safetensors --text "Hello, this is my own voice."
[ownvoice infer] Wrote ownvoice-output.wav
Todo subcomando também suporta --json para um modo de saída estruturada e legível por máquina, útil se um script ou um agente estiver chamando ownvoice programaticamente em vez de uma pessoa lendo o terminal:
$ ownvoice check --json
{"success": true, "message": "PEFT LoRA injection succeeded against pocket-tts's flow_lm module (target_modules=\"all-linear\").", "module_tree": null}
Referência da CLI
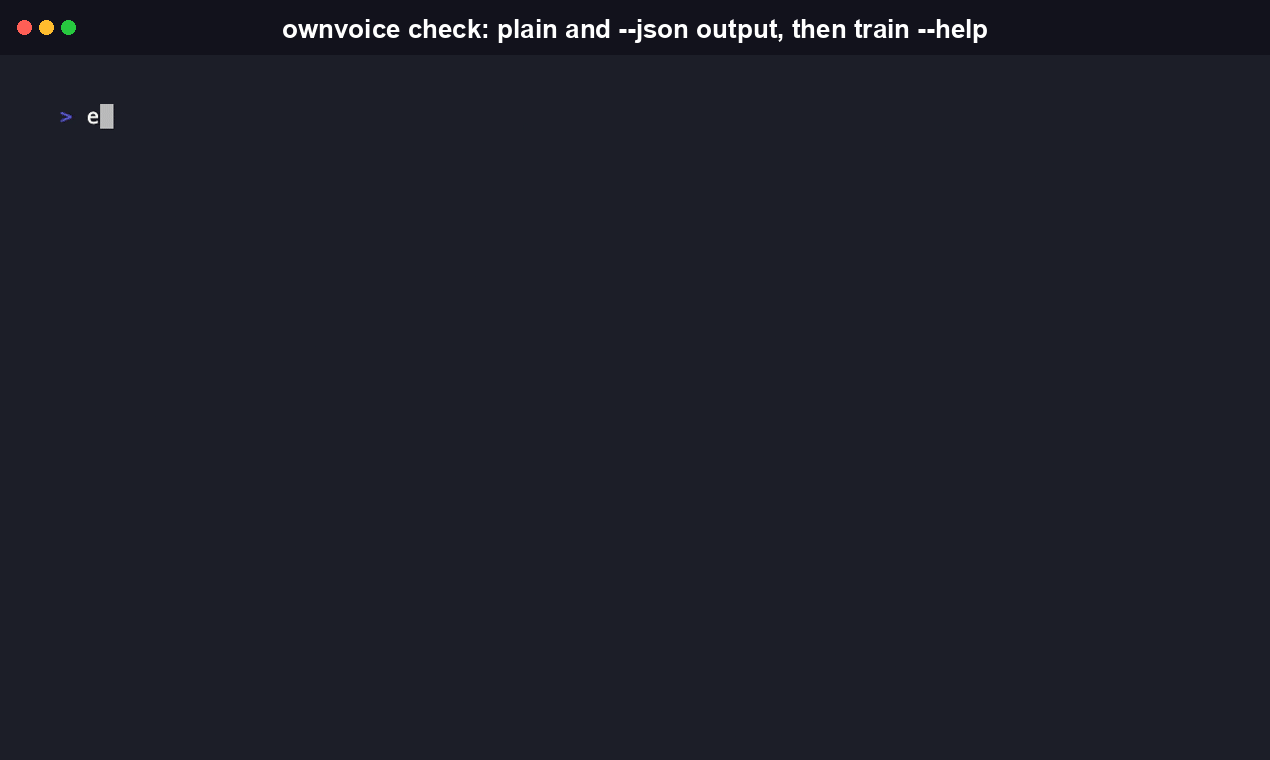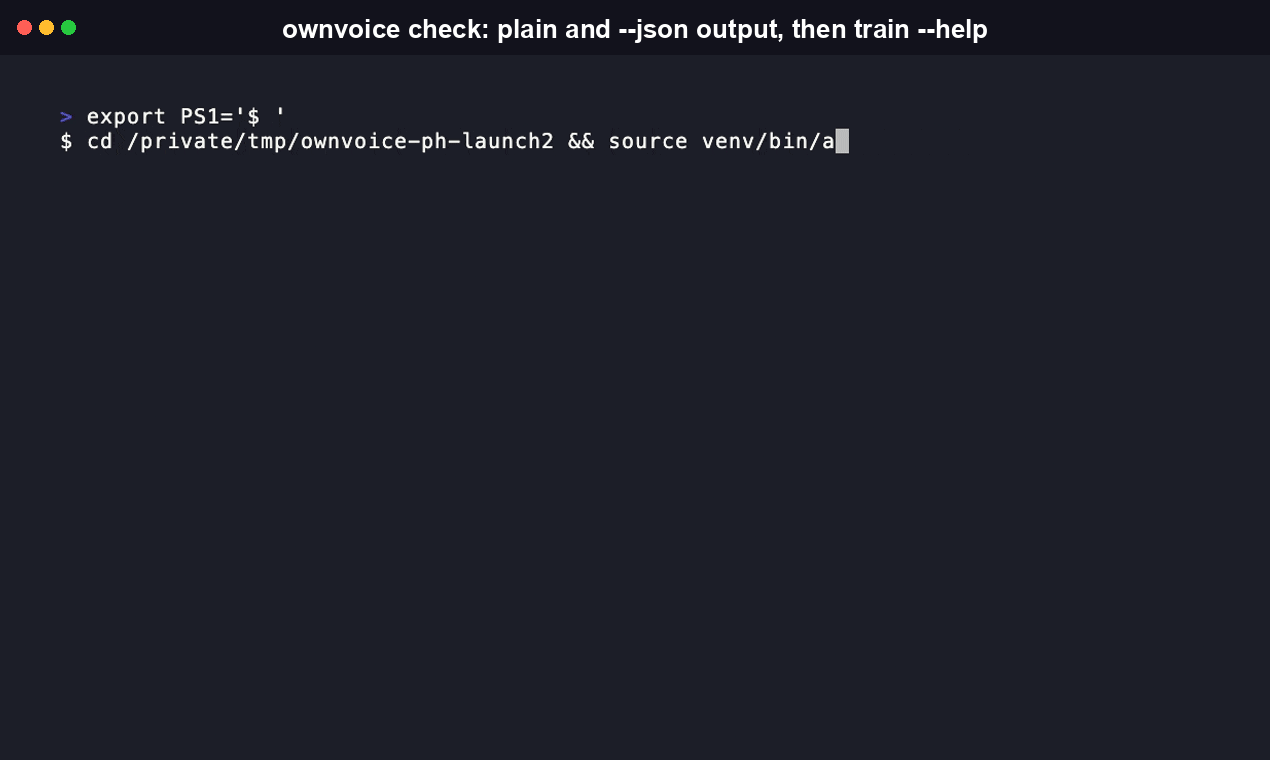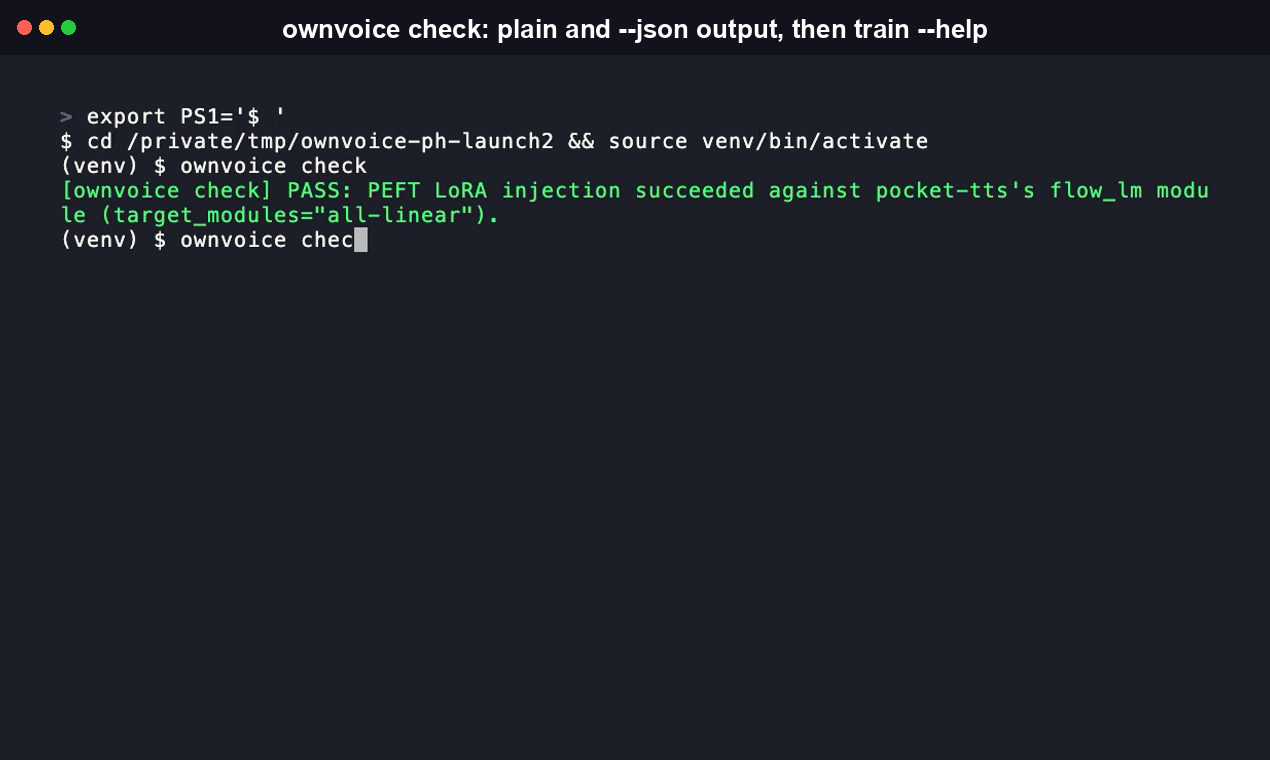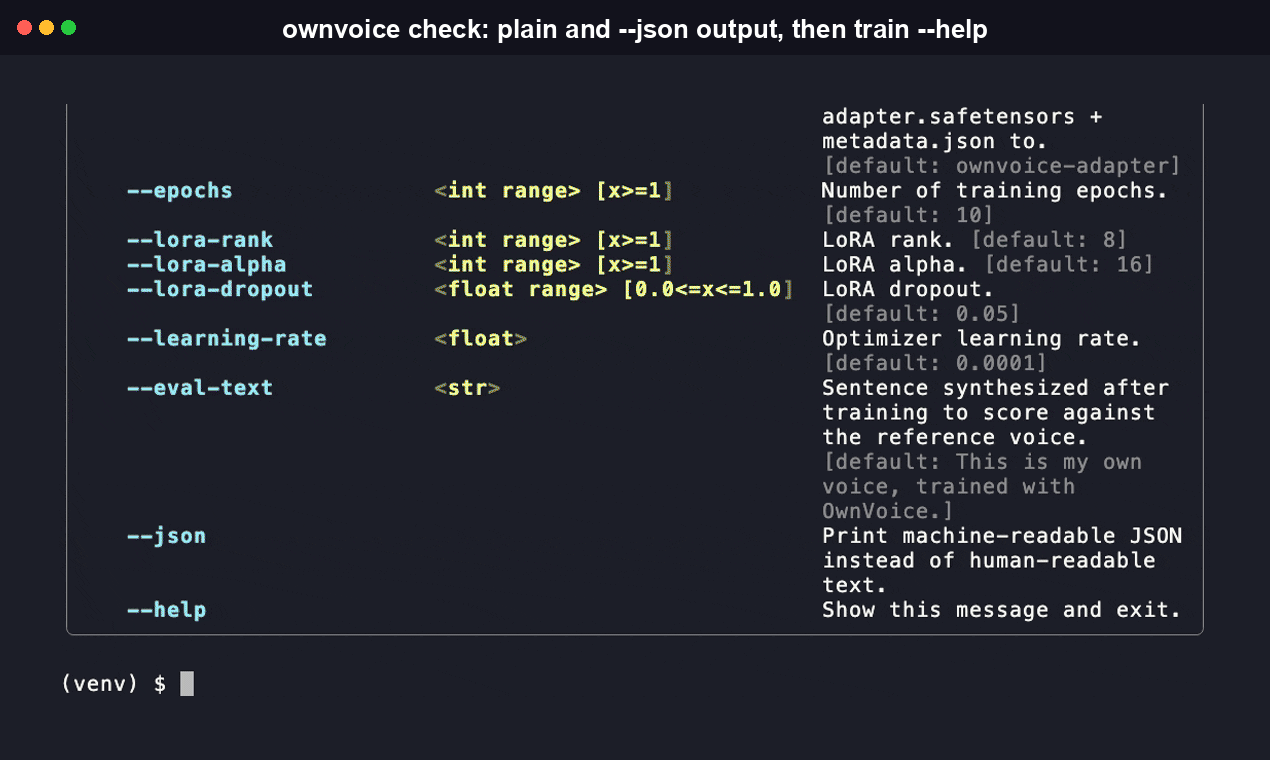
A referência abaixo é retirada diretamente da saída real de --help de cada subcomando (ownvoice-cli 0.1.2 no PyPI).
Global
ownvoice [OPTIONS] COMMAND [ARGS]...
| Parâmetro | Descrição |
|---|---|
--version | Imprime a versão do OwnVoice e sai. |
--help | Mostra a mensagem de ajuda e sai. |
ownvoice check
Verificação de compatibilidade gratuita, apenas CPU: carrega o pocket-tts e faz um teste seco da injeção LoRA. Sem GPU e sem treinamento.
| Parâmetro | Descrição |
|---|---|
--json | Imprime JSON legível por máquina em vez de texto legível por humanos. |
--help | Mostra a mensagem de ajuda e sai. |
ownvoice train
Treina um adaptador de voz LoRA a partir de um diretório de clipes de voz .wav. Apenas --voice-clips é obrigatório.
| Parâmetro | Tipo | Padrão | Descrição |
|---|---|---|---|
--voice-clips | diretório, obrigatório | – | Diretório de gravações de clipes de voz .wav para treinar. |
--out | caminho | ownvoice-adapter | Diretório para gravar adapter.safetensors + metadata.json. |
--epochs | int, >=1 | 10 | Número de épocas de treinamento. |
--lora-rank | int, >=1 | 8 | Rank do LoRA. |
--lora-alpha | int, >=1 | 16 | Alpha do LoRA. |
--lora-dropout | float, 0.0–1.0 | 0.05 | Dropout do LoRA. |
--learning-rate | float | 0.0001 | Taxa de aprendizado do otimizador. |
--eval-text | string | "This is my own voice, trained with OwnVoice." | Frase sintetizada após o treinamento para pontuar contra a voz de referência. |
--json | flag | desligado | Imprime JSON legível por máquina em vez de texto legível por humanos. |
--help | flag | – | Mostra a mensagem de ajuda e sai. |
ownvoice infer
Gera fala na voz treinada a partir de um adaptador salvo e salva em um arquivo .wav.
| Parâmetro | Tipo | Padrão | Descrição |
|---|---|---|---|
--adapter | caminho, obrigatório | – | Caminho para um arquivo adapter.safetensors treinado. |
--text | string, obrigatório | – | Texto para sintetizar na voz treinada. |
--out | caminho | ownvoice-output.wav | Caminho do arquivo .wav de saída. |
--reference-audio | caminho | referência gravada | Substitui o clipe de referência que o OwnVoice gravou em metadata.json no momento do treinamento. |
--json | flag | desligado | Imprime JSON legível por máquina em vez de texto legível por humanos. |
--help | flag | – | Mostra a mensagem de ajuda e sai. |
Recursos
- Uma verificação de compatibilidade gratuita antes de gastar qualquer coisa com GPU.
ownvoice checkcarrega o pocket-tts e faz um teste seco da injeção LoRA do PEFT contra sua árvore real de módulosflow_lm, apenas CPU, sem treinamento. Em caso de falha, imprime a árvore real de módulos em vez de um stack trace, para que um bloqueio real seja reportável em vez de silencioso. - Um sinal objetivo de utilizável/não utilizável, não um palpite. Cada execução de treinamento reamostra o enunciado de teste gerado para 16kHz mono e o pontua contra seus clipes de referência com similaridade de cosseno do Resemblyzer.
0.75ou mais é rotulado comoUSABLE ADAPTER; qualquer coisa menor éBELOW THRESHOLD, um resultado rotulado e não uma falha, código de saída0de qualquer forma. - Saída estruturada em todo subcomando.
check,traineinfertodos aceitam--json, retornando um objeto legível por máquina em vez de texto colorido de terminal: confirmado diretamente,ownvoice check --jsonretorna{"success": true, "message": "...", "module_tree": null}. - Dois arquivos que você mantém, sem ida ao servidor. Uma execução de treinamento concluída grava
adapter.safetensors(os pesos treinados, alguns megabytes no--lora-rank 8padrão) emetadata.json(a configuração completa de treinamento, pontuação de similaridade, perda por época e um timestamp) no disco. Carregue-os novamente a qualquer momento comownvoice infer, sem necessidade de chamada de rede. - Um modelo base, de propósito. O OwnVoice envolve apenas o pocket-tts. Não há camada de abstração para um segundo modelo base, combinando com a nota de arquitetura de alvo único por design do próprio código: o caminho de injeção LoRA (
target_modules="all-linear"contra as camadas reaisflow_lmdo pocket-tts) permanece exato em vez de genérico.
Como Funciona
voice clips (wav)
      |
      v
  data.py   --validate format/duration-->  clean clip set
      |
      v
  train.py  --PEFT LoRA (target_modules="all-linear")--> adapter.safetensors + metadata.json
      |
      v
  infer.py  --generate test utterance--> synthesized audio
      |
      v
  score.py  --resample to 16kHz mono--> Resemblyzer cosine similarity
      |
      v
  CLI report (>= 0.75 = usable adapter, below triggers a labeled next-step message)
ownvoice/data.py carrega e valida o diretório de clipes de voz. ownvoice/train.py carrega o modelo base congelado do pocket-tts, injeta um adaptador LoRA em seu transformer flow_lm com PEFT (target_modules="all-linear"), executa o loop de treinamento e salva o adaptador mais um manifesto. ownvoice/infer.py carrega um adaptador salvo de volta no modelo base e gera fala. ownvoice/score.py reamostra o áudio para 16kHz mono com torchaudio.transforms.Resample e pontua a similaridade do locutor com o Resemblyzer.
O OwnVoice é intencionalmente de modelo único: envolve apenas o pocket-tts, sem camada de abstração para um segundo modelo base, já que nenhum está no escopo.
Benchmark de Tempo de Configuração vs Ferramentas Comparáveis
| Ferramenta | Tempo até a primeira configuração funcional | Escolha de design notável | Fonte |
|---|---|---|---|
| kokoro-tts | menos de 2 minutos | pip install git+..., síntese CLI instantânea, sem fine-tuning | README do kokoro-tts |
| Unsloth | menos de 1 minuto para iniciar uma execução | início de treinamento com um comando (uv pip install) | Documentação do Unsloth |
| pocket-tts | segundos | --voice <wav> clonagem zero-shot, sem treinamento disponível | README do pocket-tts |
| OwnVoice | menos de 2 minutos para um ambiente de treinamento confirmado e funcional | ownvoice check: validação de compatibilidade PEFT gratuita, instantânea e apenas-CPU antes de gastar qualquer coisa com GPU | este repositório |
O próprio treinamento do OwnVoice é tempo real de GPU, honestamente rotulado e não escondido atrás de uma barra de progresso falsa, a mesma norma de categoria que o Unsloth usa. O que o OwnVoice comprime para menos de dois minutos é tudo antes disso: confirmar que seu ambiente realmente funciona.
Por Que o OwnVoice Existe
O pocket-tts é um modelo de texto-para-fala local genuinamente bom, licenciado sob MIT e capaz de rodar na CPU, da Kyutai. Seus próprios mantenedores foram claros que o código de fine-tuning não virá tão cedo: na issue #30, o mantenedor @vvolhejn escreveu "Não planejamos lançar código de fine-tuning para nossos modelos TTS e STT no futuro próximo", e 18 pessoas reagiram a esse tópico pedindo exatamente isso. O OwnVoice é uma CLI pequena e independente que preenche essa lacuna específica: aponte-a para algumas gravações da sua própria voz, e ela treina um adaptador LoRA que você mantém e executa você mesmo.
Não é um serviço hospedado, não tem cobrança e não rastreia uso. É um script de treinamento, um script de inferência e um script de pontuação, conectados por trás de três comandos de CLI.
O Que o OwnVoice Não É
O pocket-tts já oferece clonagem de voz zero-shot pronta para uso: passe um arquivo .wav para --voice (ou chame get_state_for_audio_prompt() do Python) e ele clona essa voz sem nenhuma etapa de treinamento. Se isso é tudo que você precisa, use o pocket-tts diretamente, é mais simples e rápido.
O OwnVoice existe para um caso mais restrito: fixar uma voz permanentemente em pesos treinados, para que a geração não dependa mais de distribuir ou reprocessar um clipe de áudio de referência em tempo de execução, com (com base no objetivo de treinamento, ainda não avaliado de forma independente em escala) saída mais consistente em muitas gerações do que um embedding zero-shot de clipe único tende a produzir. Essa é a lacuna específica que os 18 reatores da issue #30 estavam descrevendo, e é a única coisa que o OwnVoice adiciona sobre o que o pocket-tts já faz bem.
Consentimento e Uso Indevido
Esta ferramenta clona uma voz a partir de áudio que você tem o direito de usar. Não clone a voz de outra pessoa, ou a voz de uma figura pública, sem o consentimento explícito dela. O OwnVoice não inclui nenhum recurso de geração em massa ou auto-escala nesta versão, mantendo o raio de impacto de qualquer caso isolado de uso indevido pequeno.
Status da Implementação
Esta é uma versão jovem, em estágio inicial. ownvoice check, a análise de argumentos de CLI, a validação de clipes de voz, a matemática de pontuação de similaridade e o caminho de salvamento/carregamento de adaptadores/manifestos estão implementados e cobertos pela suíte de testes (pytest). A injeção de LoRA foi verificada estruturalmente contra o código-fonte real do pocket-tts e depois confirmada na prática: ownvoice check foi executado contra os pesos reais baixados do pocket-tts, em CPU, e a injeção target_modules="all-linear" do PEFT realmente funcionou. O caminho completo de treinamento e geração foi verificado de ponta a ponta na prática também: uma execução real de treinamento LoRA de 2 épocas contra os pesos carregados do pocket-tts produziu uma perda de flow-matching finita e não-NaN, e o adaptador resultante produziu um arquivo .wav real e não-silencioso via ownvoice infer. Essa validação revelou duas lacunas reais na abordagem ingênua e as corrigiu: (1) o pacote PyPI publicado do pocket-tts, apenas para inferência, não expõe uma maneira de calcular a perda de treinamento através de FlowLMModel.forward() apesar de seu próprio docstring afirmar o contrário, então o OwnVoice calcula a perda de flow-matching diretamente dos submódulos reais de flow_lm; (2) trocar base_model.flow_lm pelo modelo embrulhado com PEFT antes de chamar generate_audio() quebra a busca interna de estado do cache KV do pocket-tts — nenhuma troca é necessária, já que a injeção LoRA do PEFT já muta base_model.flow_lm no lugar. Uma limitação externa real a conhecer: os pesos publicamente baixáveis do pocket-tts (kyutai/pocket-tts-without-voice-cloning) recusam diretamente um caminho/URL de clipe de referência bruto; o OwnVoice contorna isso pré-carregando e reamostrando o próprio clipe, mas a fidelidade de clonagem de voz desse checkpoint é uma limitação conhecida do modelo base, não um bug do OwnVoice — para os pesos de clonagem de melhor qualidade da kyutai, solicite acesso restrito em huggingface.co/kyutai/pocket-tts. Execute ownvoice check você mesmo e leia o código-fonte antes de confiar mais do que isso; esse é o nível certo de ceticismo para um projeto tão inicial.
FAQ
O que é o OwnVoice e por que não usar apenas o pocket-tts sozinho?
O OwnVoice treina um adaptador LoRA para o pocket-tts e o salva no seu próprio disco como adapter.safetensors mais metadata.json. Ele existe porque os próprios mantenedores do pocket-tts disseram que o código de fine-tuning não está no roteiro de curto prazo deles (veja a issue #30). Depois que você tiver um adaptador treinado, nunca mais precisará do OwnVoice para usá-lo: ownvoice infer apenas carrega o adaptador de volta no modelo base.
Como isso é diferente da clonagem zero-shot embutida --voice <wav> do próprio pocket-tts?
O pocket-tts já clona uma voz a partir de um único clipe de referência sem etapa de treinamento, --voice <wav> na CLI ou get_state_for_audio_prompt() em Python. O OwnVoice troca essa velocidade por um adaptador permanentemente treinado, então a geração não depende mais de carregar um clipe de referência em tempo de execução, com (com base no objetivo de treinamento, ainda não avaliado de forma independente em escala) saídas mais consistentes entre gerações repetidas do que um embedding zero-shot de clipe único tende a dar. Se zero-shot for suficiente para o seu caso de uso, use o pocket-tts diretamente; é mais simples e rápido.
O que preciso instalar e ele roda em Apple Silicon ou em uma máquina só com CPU?
Python 3.11 ou mais novo, depois pip install ownvoice-cli. ownvoice check e ownvoice infer não precisam de GPU e funcionam bem em Apple Silicon ou em uma máquina só com CPU, acompanhando o design do próprio pocket-tts que também é capaz de rodar em CPU. ownvoice train também roda em CPU, só demora mais por época; instale a versão CUDA do PyTorch primeiro se você tiver uma GPU NVIDIA e quiser que o treinamento seja mais rápido.
Como o OwnVoice se compara ao kokoro-tts e ao Unsloth?
O kokoro-tts permite sintetizar fala em menos de 2 minutos, mas não tem nenhuma etapa de fine-tuning. O Unsloth inicia uma execução de treinamento em menos de um minuto, mas é um framework geral de fine-tuning de LLM, não específico para TTS. O OwnVoice é mais restrito que ambos: um modelo base (apenas pocket-tts), um trabalho (um adaptador de voz), além de uma etapa gratuita ownvoice check que confirma se a injeção LoRA do PEFT realmente funciona no seu ambiente antes de você gastar qualquer coisa com GPU, uma verificação que nenhuma dessas ferramentas tem equivalente.
Minha execução de treinamento terminou, mas imprimiu "BELOW THRESHOLD"; isso é um bug?
Não. É um resultado rotulado, não uma falha; ownvoice train sai com 0 de qualquer forma. Abaixo da barra de similaridade de cosseno de 0,75, o adaptador ainda é salvo no disco e o OwnVoice diz claramente para tentar mais clipes de voz ou clipes mais limpos, mais épocas ou um --lora-rank maior, e então executar novamente. Apenas duas coisas realmente fazem o comando falhar com uma saída não-zero: nenhum clipe utilizável para carregar ou uma falha de injeção PEFT capturada.
Posso usar o OwnVoice e os adaptadores que ele produz comercialmente?
O código do próprio OwnVoice é MIT (veja LICENSE). O pacote de código do pocket-tts também é MIT, mas os pesos do modelo que o OwnVoice realmente baixa e treina, kyutai/pocket-tts-without-voice-cloning e o kyutai/pocket-tts com acesso restrito, são licenciados sob CC-BY-4.0, não MIT. CC-BY-4.0 permite uso comercial, mas exige atribuição à Kyutai. Como qualquer adaptador que você treinar é derivado desses pesos, verifique esse requisito de atribuição antes de lançar um produto comercial baseado nele.
De quem posso realmente clonar a voz com isso? Apenas a sua própria, ou a de outra pessoa com consentimento explícito e verificado, nunca a de uma figura pública sem isso. Veja Consentimento e Uso Indevido acima. O OwnVoice não inclui nenhum recurso de geração em massa ou auto-escala nesta versão, o que mantém o raio de impacto de qualquer caso isolado de uso indevido pequeno.
Servidor MCP
O OwnVoice inclui um servidor Model Context Protocol, para que um agente compatível com MCP possa acionar ownvoice check / train / infer diretamente via stdio em vez de chamar comandos externos e analisar texto por conta própria.
pip install "ownvoice-cli[mcp]"
Adicione-o à configuração de um cliente MCP (por exemplo, o claude_desktop_config.json do Claude Desktop):
{
  "mcpServers": {
    "ownvoice": {
      "command": "ownvoice-mcp"
    }
  }
}
O servidor expõe uma única ferramenta, run(args: list[str]) -> dict, que chama a CLI real ownvoice com os argv fornecidos e retorna o resultado como JSON estruturado, então o chamador obtém exatamente o mesmo comportamento da CLI voltada para humanos, incluindo o modo --json. Exemplo de chamada: run(args=["check", "--json"]) retorna {"result": {"success": true, "message": "...", "module_tree": null}}. Uma saída não-zero, uma falha de inicialização ou um timeout do subprocesso é sempre retornado como {"error": "..."} em vez de ser lançado como exceção.
Contribuindo
Issues e PRs são bem-vindos, tudo licenciado sob MIT. Se você quiser ajudar a fechar a lacuna real que este projeto visa, a contribuição mais útil é upstream: um script leve de treinamento de adaptador LoRA contribuído de volta ao kyutai-labs/pocket-tts, discutido na issue #30.
Licença
MIT. Veja LICENSE.