reprompt
Servidor MCP de análise de prompts: avalie prompts, pesquise histórico, detecte credenciais vazadas e escaneie sessões de codificação com IA.
Documentação
ctxray
Veja como você realmente usa IA.
Faça um raio-X das suas sessões de codificação com IA em Claude Code, Cursor, ChatGPT e mais 6 ferramentas. Descubra seus padrões, encontre tokens desperdiçados, capture segredos vazados — tudo localmente, nada sai da sua máquina.



Início rápido
pip install ctxray

ctxray scan                    # discover prompts from your AI tools
ctxray wrapped                 # your AI coding persona + shareable card
ctxray insights                # your patterns vs research-optimal
ctxray privacy                 # what sensitive data you've exposed
Funciona no seu pipeline
Coloque o ctxray no seu CI como um portão de qualidade de prompts. Sem LLM, sem chave de API, sem rede — <50ms por prompt.
# .github/workflows/prompt-quality.yml
- uses: ctxray/ctxray@main
  with:
    score-threshold: 43    # experimentally validated quality threshold
    model: claude          # model-specific rules (claude/gpt/gemini)
    comment-on-pr: true
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/ctxray/ctxray
    rev: v3.0.0
    hooks:
      - id: ctxray-lint-score   # fail below quality threshold
      # or: id: ctxray-lint-claude  # Claude-specific rules + threshold
- Determinístico — mesmo prompt, mesma pontuação, em todas as execuções. Sem verificações instáveis baseadas em LLM.
- Isolado — roda em redes offline e privadas. Toda a análise permanece na sua infraestrutura.
- Configurável —
.ctxray.tomlou[tool.ctxray.lint]no pyproject.toml. Regras por projeto.
Configuração completa: GitHub Action · pre-commit · .ctxray.toml
O que você vai descobrir
Sua persona de codificação com IA
ctxray wrapped gera um relatório estilo Spotify Wrapped das suas interações com IA — sua persona (Depurador? Arquiteto? Explorador?), principais padrões e um card compartilhável.
Seus padrões de prompt
ctxray insights compara seus hábitos reais de prompting com benchmarks baseados em pesquisa. Seus prompts são específicos o suficiente? Você coloca instruções no início? Quanto contexto você fornece?
Sua exposição de privacidade
ctxray privacy --deep escaneia cada prompt que você enviou em busca de chaves de API, tokens, senhas e PII. Veja exatamente o que você compartilhou com cada ferramenta de IA.
Diagnóstico completo de prompt
ctxray check "your prompt" pontua, faz lint e reescreve em um único comando — sem LLM, <50ms.
Validado experimentalmente em mais de 3000 chamadas de LLM em 8 modelos (1.5B → 27B): prompts com pontuação igual ou acima de 43 atingem ~93% de taxa de aprovação em testes de código executável. Abaixo de 43, a média é de 72% ou menos. O ctxray mostra em qual lado você está e o que corrigir — veja experiments/RESULTS.md para os dados completos entre modelos.
ctxray check "fix the auth bug in login.ts"        # threshold pass/fail + diagnostics
ctxray check "fix bug" --model claude               # model-specific scoring for Claude
ctxray check "refactor middleware" --threshold 50    # custom threshold for stricter teams

Mais capturas de tela
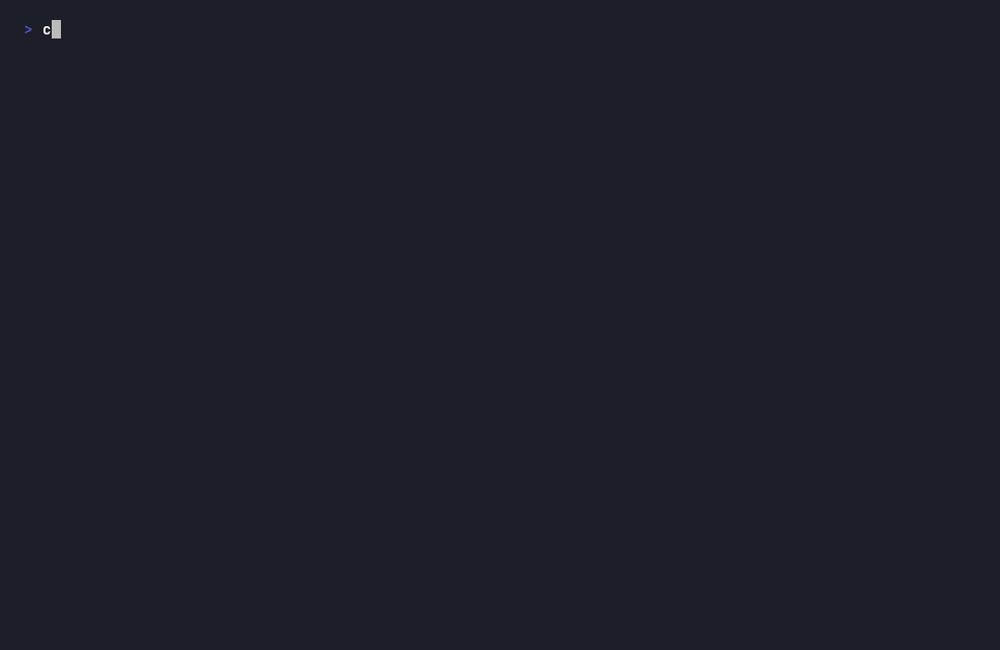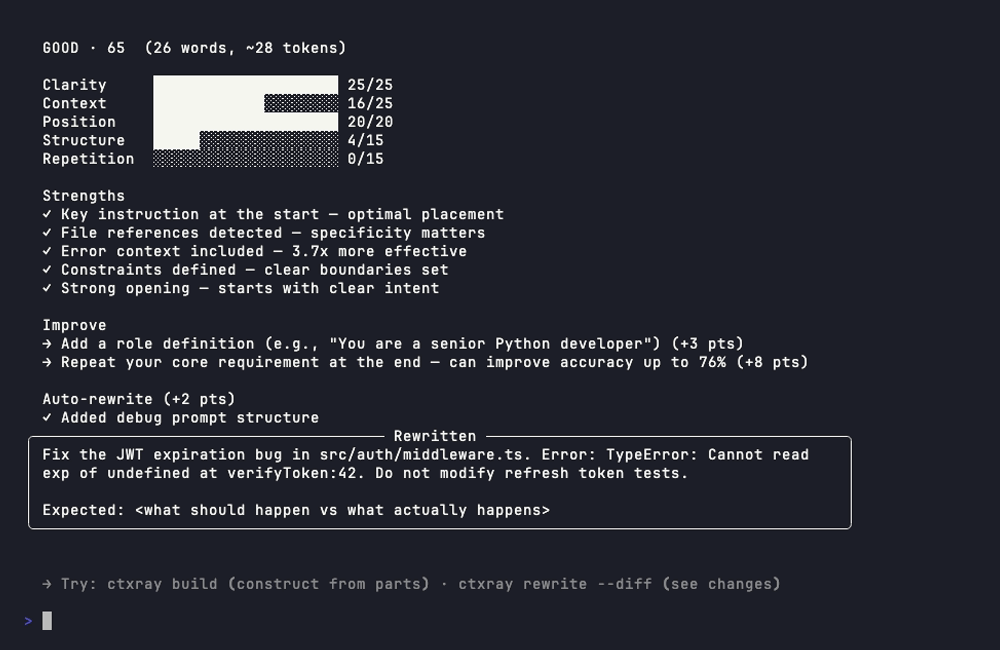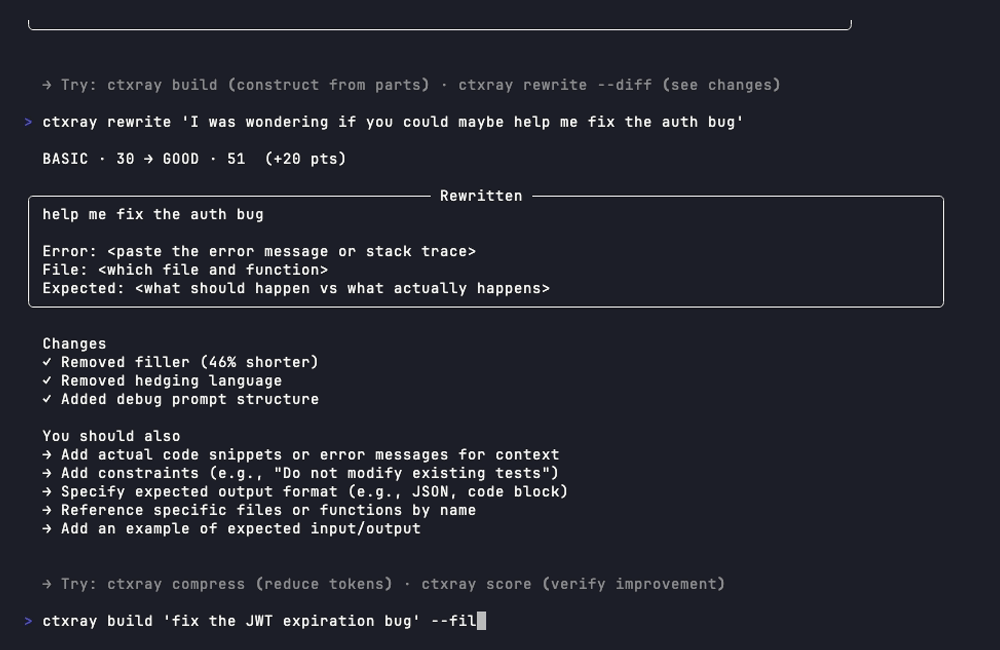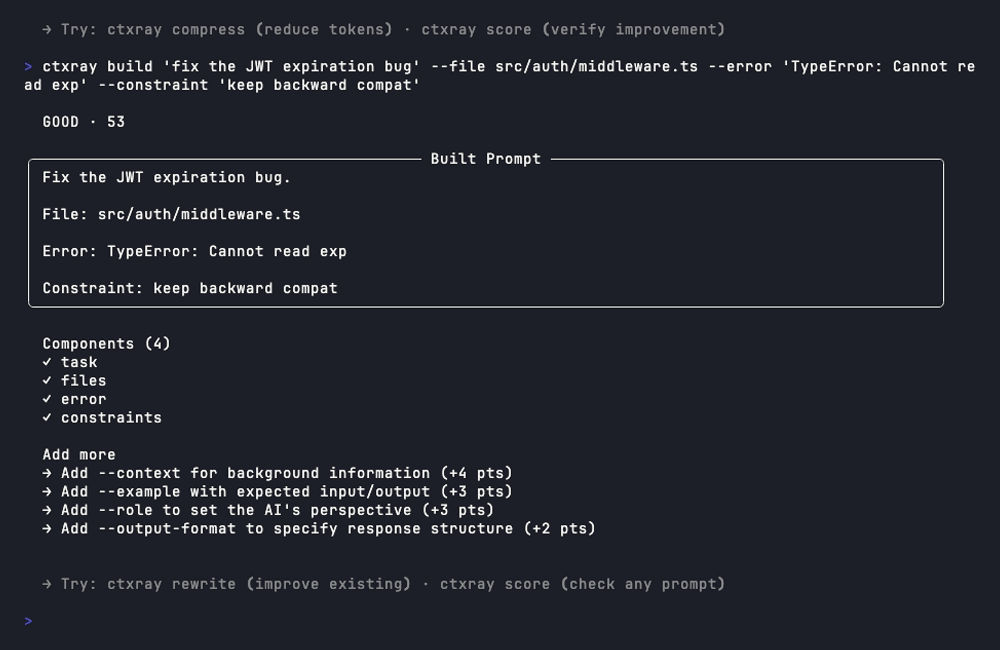
ctxray rewrite — melhoria de prompt baseada em regras

ctxray build — monte prompts a partir de componentes

Como é um prompt ruim

Todos os comandos
Descubra seus padrões
| Comando | Descrição |
|---|---|
ctxray wrapped | Persona de codificação com IA + card compartilhável |
ctxray insights | Padrões pessoais vs. benchmarks ideais de pesquisa |
ctxray tools | Comparação entre ferramentas — como seus hábitos no Claude Code / Cursor / ChatGPT diferem |
ctxray sessions | Pontuações de qualidade de sessão com detecção de sinal de frustração |
ctxray agent | Análise de fluxo de trabalho do agente — loops de erro, padrões de ferramentas, eficiência |
ctxray repetition | Detecção de repetição entre sessões — identifique prompts recorrentes |
ctxray patterns | Fraquezas pessoais em prompts — lacunas recorrentes por tipo de tarefa |
ctxray distill | Extração de turnos importantes de conversas com pontuação de 6 sinais |
ctxray projects | Detalhamento de qualidade por projeto |
ctxray style | Impressão digital de prompting com --trends para rastreamento de evolução |
ctxray privacy | Veja quais dados você enviou para onde — caminhos de arquivo, erros, exposição de PII |
Otimize seus prompts
| Comando | Descrição |
|---|---|
ctxray check "prompt" | Diagnóstico completo — pontuação + lint + reescrita + aprovação/reprovação por limite |
ctxray score "prompt" | Pontuação de 0 a 100 baseada em pesquisa com mais de 30 recursos |
ctxray score "prompt" --model claude | Pontuação específica por modelo — ajustes para Claude, GPT ou Gemini |
ctxray rewrite "prompt" | Melhoria baseada em regras — remoção de excessos, reestruturação, limpeza de hedging |
ctxray build "task" | Construa prompts a partir de componentes — tarefa, contexto, arquivos, erros, restrições |
ctxray compress "prompt" | Compressão de prompt em 4 camadas (economia típica de 40-60% em tokens) |
ctxray compare "a" "b" | Análise de prompt lado a lado (ou --best-worst para seleção automática) |
ctxray lint | Linter configurável com suporte a CI/GitHub Action |
Gerenciar
| Comando | Descrição |
|---|---|
ctxray | Painel instantâneo — prompts, sessões, pontuação média, principais categorias |
ctxray scan | Descoberta automática de prompts em 9 ferramentas de IA |
ctxray report | Análise completa: frases quentes, clusters, padrões (--html para painel) |
ctxray digest | Resumo semanal comparando o período atual com o anterior |
ctxray template save|list|use | Salve e reutilize seus melhores prompts |
ctxray distill --export | Recupere contexto quando uma sessão esgotar — cole em uma nova sessão |
ctxray init | Gere configuração de .ctxray.toml para seu projeto |
Ferramentas de IA suportadas
| Ferramenta | Formato | Descoberta automática por scan |
|---|---|---|
| Claude Code | JSONL | Sim |
| Codex CLI | JSONL | Sim |
| Cursor | .vscdb | Sim |
| Aider | Markdown | Sim |
| Gemini CLI | JSON | Sim |
| Cline (VS Code) | JSON | Sim |
| OpenClaw / OpenCode | JSON | Sim |
| ChatGPT | JSON | Via ctxray import |
| Claude.ai | JSON/ZIP | Via ctxray import |
Instalação
pip install ctxray              # core (all features, zero config)
pip install ctxray[chinese]     # + Chinese prompt analysis (jieba)
pip install ctxray[mcp]         # + MCP server for Claude Code / Continue.dev / Zed
Verificação automática após cada sessão
ctxray install-hook # adds post-session hook to Claude Code
Extensão do navegador
Capture prompts do ChatGPT, Claude.ai e Gemini diretamente no seu navegador. O selo de qualidade ao vivo mostra o nível do prompt enquanto você digita — clique em "Reescrever e aplicar" para melhorar e substituir o texto diretamente na caixa de entrada.
- Instale a extensão da Chrome Web Store ou dos Complementos do Firefox
- Conecte ao CLI:
ctxray install-extension - Verifique:
ctxray extension-status
Os prompts capturados são sincronizados localmente via Native Messaging — nada sai da sua máquina.
Integração de CI
GitHub Action
# .github/workflows/prompt-lint.yml
name: Prompt Quality
on: pull_request

jobs:
  lint:
    runs-on: ubuntu-latest
    permissions:
      pull-requests: write
    steps:
      - uses: actions/checkout@v4
      - uses: ctxray/ctxray@main
        with:
          score-threshold: 43     # experimentally validated (below = 83% failure rate)
          model: claude           # optional: model-specific rules
          strict: true
          comment-on-pr: true
pre-commit
# .pre-commit-config.yaml
repos:
  - repo: https://github.com/ctxray/ctxray
    rev: v3.0.0
    hooks:
      - id: ctxray-lint-score     # quality threshold gate (score >= 43)
      # - id: ctxray-lint-claude  # Claude-specific rules + threshold
      # - id: ctxray-lint-gpt    # GPT-specific rules + threshold
CLI direto
ctxray lint --score-threshold 43  # exit 1 below experimentally validated threshold
ctxray lint --score-threshold 50  # or set your own bar
ctxray lint --model claude        # model-specific lint rules
ctxray lint --strict              # exit 1 on warnings
ctxray lint --json                # machine-readable output
Configuração do projeto
ctxray init # generates .ctxray.toml with all rules documented
# .ctxray.toml (or [tool.ctxray.lint] in pyproject.toml)
[lint]
score-threshold = 43   # experimentally validated quality threshold
model = "claude"       # model-specific rules (claude/gpt/gemini)

[lint.rules]
min-length = 20
short-prompt = 40
vague-prompt = true
debug-needs-reference = true
Prompt Science — base de pesquisa
Prompt Science
A pontuação é calibrada com base em 10 artigos revisados por pares cobrindo mais de 30 recursos em 5 dimensões:
| Dimensão | O que mede | Artigos-chave |
|---|---|---|
| Estrutura | Markdown, blocos de código, restrições explícitas | Prompt Report (2406.06608) |
| Contexto | Caminhos de arquivo, mensagens de erro, especificações de I/O, casos extremos | Zi+ (2508.03678), Google (2512.14982) |
| Posição | Posicionamento das instruções em relação ao contexto | Stanford (2307.03172), Veseli+ (2508.07479), Chowdhury (2603.10123) |
| Repetição | Redundância que degrada a atenção do modelo | Google (2512.14982) |
| Clareza | Legibilidade, comprimento das frases, ambiguidade | SPELL (EMNLP 2023), PEEM (2603.10477) |
Descobertas com validação cruzada que orientam nosso motor:
- O viés de posição é arquitetural — presente na inicialização, não aprendido. Colocar instruções no início é eficaz para prompts abaixo de 50% da janela de contexto (3 artigos concordam)
- Compressão moderada melhora a saída — a remoção de excessos baseada em regras não só economiza tokens, mas também melhora o desempenho do LLM (2505.00019)
- A qualidade do prompt é mensurável de forma independente — a pontuação apenas do prompt prevê a qualidade da saída sem ver a resposta (ACL 2025, 2503.10084)
- Limite de qualidade na pontuação ~43 — nosso próprio experimento (30 prompts, 5 níveis, 2 modelos) encontrou uma função de degrau: abaixo de 43, 83% de taxa de falha; acima de 43, 94% de sucesso (Pearson r=0,56, Spearman ρ=0,64)
- As preferências de formato dependem do modelo — XML beneficia Claude, Markdown beneficia GPT, mas ter qualquer estrutura importa mais do que o formato específico (PromptBridge 2512.01420)
A pontuação específica por modelo (--model claude/gpt/gemini) aplica ajustes baseados em pesquisa para as preferências e sensibilidades conhecidas de cada modelo.
Toda a análise é executada localmente em <1ms por prompt. Sem chamadas de LLM, sem solicitações de rede.
Como funciona — arquitetura
Como funciona
 Data sources:
 ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐
 │Claude Code│ │  Cursor  │ │  Aider   │ │ ChatGPT  │ │ 5 more.. │
 └─────┬────┘ └─────┬────┘ └─────┬────┘ └─────┬────┘ └─────┬────┘
       └─────────────┴───────────┴─────────────┴─────────────┘
                                 │
                    scan -> dedup -> store -> analyze
                                 │
              ┌──────────────────┼──────────────────┐
              v                  v                  v
        ┌──────────┐     ┌──────────────┐    ┌──────────┐
        │ insights │     │  patterns    │    │ sessions │
        │ wrapped  │     │  repetition  │    │ projects │
        │ style    │     │  privacy     │    │ agent    │
        └──────────┘     └──────────────┘    └──────────┘
Principais decisões de design:
- Apenas regras, sem LLM — a pontuação e a reescrita usam regex + TF-IDF + heurísticas de pesquisa. Determinístico, privado, <1ms por prompt.
- Padrão de adaptador — cada ferramenta de IA recebe um parser que normaliza para um modelo comum
Prompt. Adicionar uma nova ferramenta = um arquivo. - Dedup em duas camadas — SHA-256 para correspondências exatas, similaridade de cosseno TF-IDF para quase duplicados.
- Calibrado por pesquisa — 10 artigos revisados por pares informam os pesos de pontuação.
Destilação de conversas
Destilação de conversas
ctxray distill pontua cada turno de uma conversa usando 6 sinais:
- Posição — os primeiros/últimos turnos carregam enquadramento e conclusões
- Comprimento — turnos substanciais contêm mais informações
- Acionador de ferramenta — turnos que causam chamadas de ferramenta impulsionam ações
- Recuperação de erro — turnos após erros mostram resolução de problemas
- Mudança semântica — mudanças de tópico marcam limites de conversa
- Exclusividade — formulação nova vs. acompanhamentos repetitivos
O tipo de sessão (depuração, desenvolvimento de recursos, exploração, refatoração) é detectado automaticamente e os pesos dos sinais se adaptam de acordo.
Por que o ctxray?
Depois que o Promptfoo entrou para a OpenAI e o Humanloop entrou para a Anthropic, o ctxray é a alternativa independente e de código aberto para entender suas interações com IA.
- 100% local — seus prompts nunca saem da sua máquina
- Sem necessidade de LLM — análise puramente baseada em regras, <50ms por prompt
- 9 ferramentas de IA — a única ferramenta que funciona com Claude Code, Cursor, ChatGPT e mais
- Baseado em pesquisa — calibrado com 10 artigos revisados por pares, não em impressões
Publicado anteriormente como
reprompt-cli. Mesma ferramenta, novo nome, namespace limpo.
Privacidade
- Toda a análise é executada localmente. Nenhum prompt sai da sua máquina.
ctxray privacymostra exatamente o que você enviou para cada ferramenta de IA.- Telemetria opcional envia apenas vetores de recursos anônimos — nunca texto de prompt.
- Código aberto: audite exatamente o que é coletado.
Links
- PyPI: ctxray
- Extensão Chrome: Chrome Web Store
- Complemento Firefox: Complementos do Firefox
- Changelog: CHANGELOG.md
Contribuição
Veja CONTRIBUTING.md para configuração de desenvolvimento e diretrizes.
Licença
MIT