GENOME
Memória totalmente local para agentes de IA: zero chamadas de LLM no caminho de escrita, opera isolado da rede, paridade de precisão com Mem0 em benchmarks publicados.
Documentação
GENOME
Memória aberta para agentes de IA. Mesma precisão de respostas que o Mem0 - mas ~1.000× mais barato para armazenar, roda totalmente offline e mantém um registro auditável.



Artigos: Agentes Precisam de um LLM para Lembrar? (a avaliação central, 2026) e O Que Cada Recurso de Memória Entrega? (uma auditoria medida de todos os cinco recursos opcionais, com acertos e falhas, 2026). PDFs em papers/; tabelas de resultados em benchmarks/AUDIT-RESULTS.md.
A maioria das ferramentas de memória para agentes (como o Mem0) chama um LLM em cada mensagem para decidir o que lembrar. Essa é a parte lenta e cara - e a aposta do GENOME é que você não precisa disso. O GENOME apenas incorpora cada mensagem localmente: sem LLM, sem API, sem rede no caminho de escrita.
Avaliado honestamente em conjuntos de dados públicos (LoCoMo, LongMemEval), o GENOME responde com a mesma precisão que o Mem0 - enquanto armazena memórias por uma fração minúscula do custo e roda completamente offline.
Transparência desde o início: em precisão de respostas, o GENOME empata com o Mem0 - nós não afirmamos superá-lo nesse quesito (seis configurações independentes de benchmark confirmam paridade, nenhuma significativa em qualquer direção). A vantagem está no custo, na velocidade, na operação offline e em um registro temporal/auditável que o Mem0 não consegue produzir.
Veja funcionando
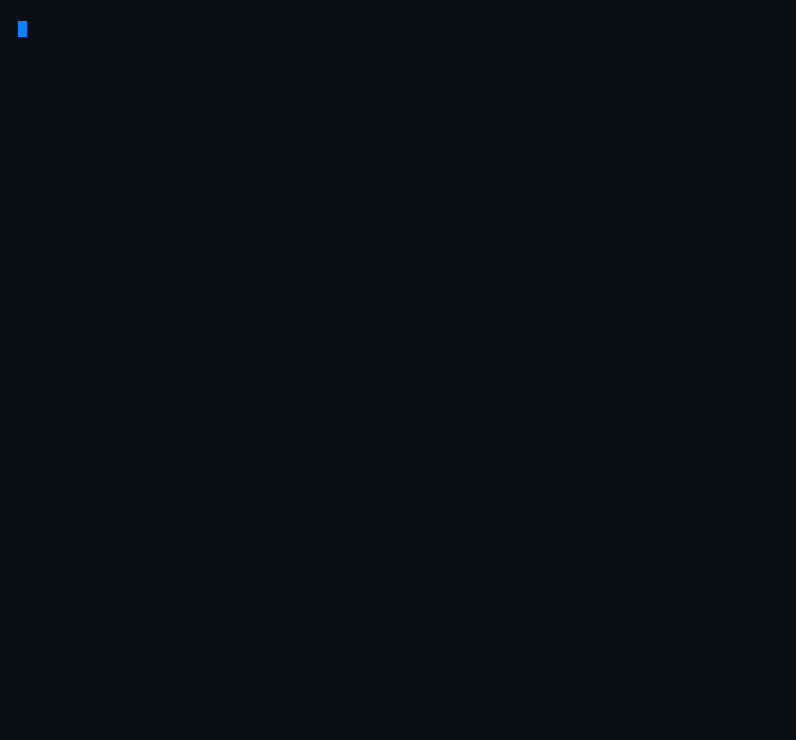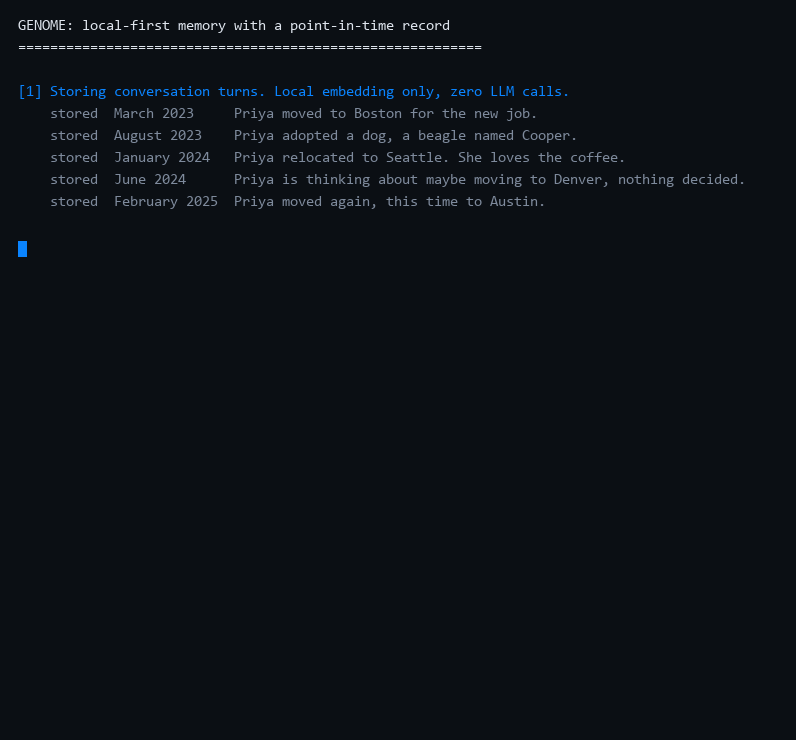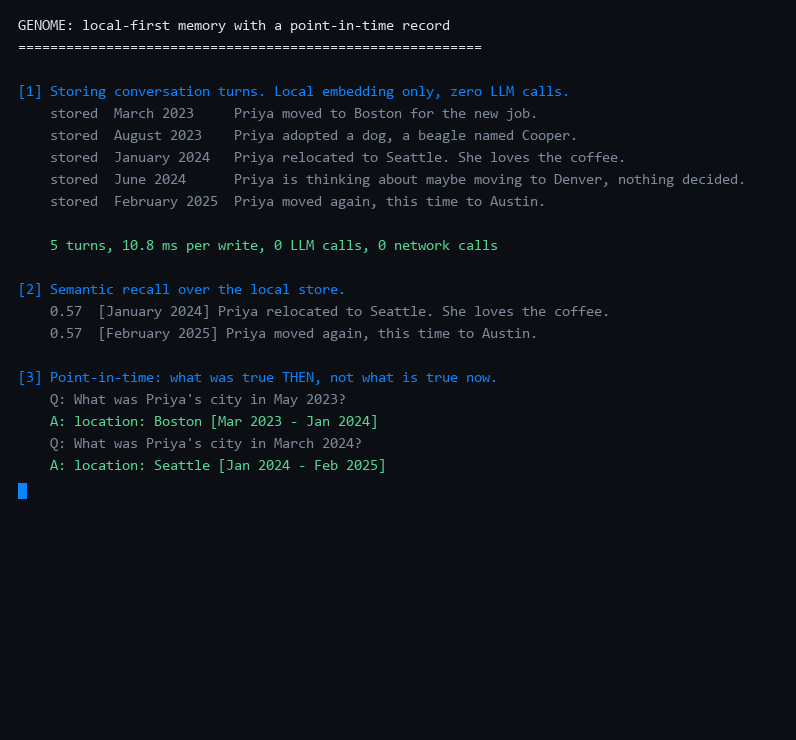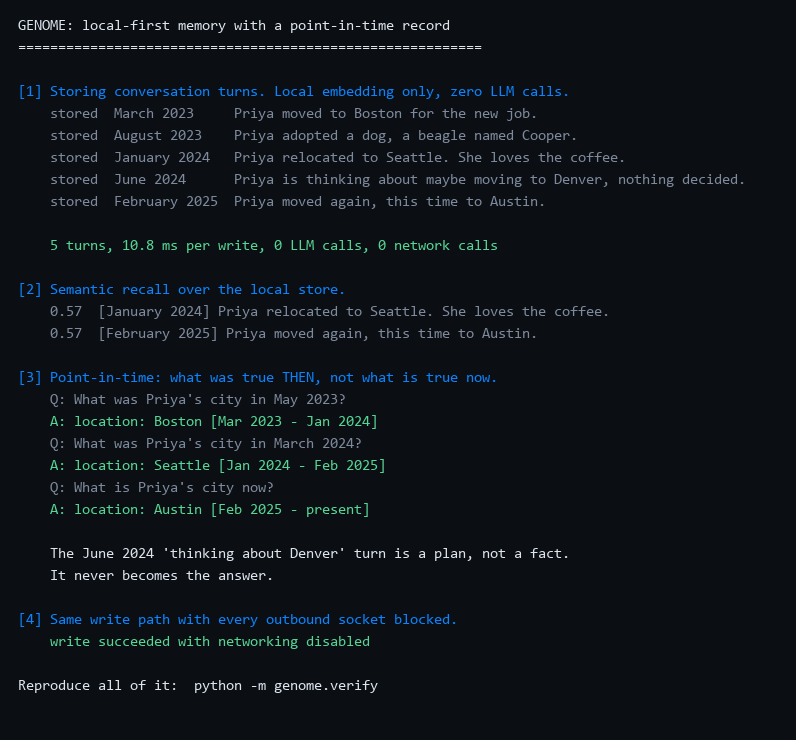
Cada quadro é saída real de examples/demo_timeline.py,
capturada por tools/render_demo_gif.py. Execute você mesmo,
sem necessidade de chave de API:
python examples/demo_timeline.py
A parte interessante é o passo 3. A mesma pergunta recebe três respostas corretas diferentes dependendo de quando você pergunta, porque o armazenamento mantém quando cada fato se tornou verdadeiro em vez de sobrescrevê-lo:
| Pergunta | Resposta |
|---|---|
| Qual era a cidade de Priya em maio de 2023? | Boston [mar 2023 - jan 2024] |
| Qual era a cidade de Priya em março de 2024? | Seattle [jan 2024 - fev 2025] |
| Qual é a cidade de Priya agora? | Austin [fev 2025 - presente] |
A virada "pensando em talvez mudar para Denver, nada decidido" é armazenada, mas nunca se torna uma resposta: é um plano, não um fato durável.
Como funciona
O caminho de escrita é deliberadamente simples e barato. Toda a inteligência acontece no momento da leitura, quando há uma consulta para focá-la.
flowchart LR
    M["incoming message"] --> E["local embedder<br/>all-MiniLM-L6-v2"]
    E --> S[("local store<br/>SQLite or Postgres")]
    M -. "optional, opt-in" .-> B["belief extraction<br/>(the only LLM call)"]
    B --> K[("bi-temporal<br/>fact log")]

    Q["query"] --> R["exact cosine search<br/>over this tenant's rows"]
    S --> R
    R --> RR["optional cross-encoder<br/>rerank"]
    RR --> A["context for the agent"]
    Q --> PIT["as-of resolution<br/>facts_valid_at(entity, T)"]
    K --> PIT
    PIT --> A

    style E fill:#0A84FF,color:#fff
    style S fill:#1c2530,color:#fff
    style K fill:#1c2530,color:#fff
    style B fill:#3a3a3a,color:#fff
Escrita: incorpora localmente, armazena. Cerca de 10 ms, zero chamadas de LLM, zero chamadas de rede. A incorporação é determinística -- o mesmo texto sempre produz o mesmo vetor, sem etapa de extração amostrada decidindo o que importa -- então o que é armazenado é uma função da entrada, e reproduzir um diário reproduz esse armazenamento exatamente. (Ids e carimbos de tempo são registrados por escrita, então duas ingestões independentes da mesma conversa concordam em conteúdo e vetores, não em ids de registro.)
Leitura: busca exata por cosseno dentro do escopo do locatário (sem índice ANN para construir ou atualizar), com um reordenador local opcional de codificador cruzado.
Camada bi-temporal (opt-in): registra cada fato em seu tempo de domínio, o momento em que se tornou verdadeiro no mundo, não o momento em que foi ingerido. É isso que torna perguntas pontuais respondíveis mesmo quando os fatos chegam fora de ordem.
Por que o registro pode ser rederivado
flowchart TB
    subgraph LLM["LLM-extraction memory"]
        A1["message"] --> A2["LLM decides what matters<br/>(sampled, non-deterministic)"]
        A2 --> A3[("store")]
        A3 --> A4["replaying the same input<br/>can produce a different store"]
    end
    subgraph GEN["GENOME"]
        B1["message"] --> B2["local embedding<br/>(deterministic)"]
        B2 --> B3[("store")]
        B3 --> B4["replaying the same input<br/>reproduces the same store"]
    end
    style A4 fill:#5c1f1f,color:#fff
    style B4 fill:#1f4d33,color:#fff
Um registro que não pode ser rederivado é difícil de auditar. Essa propriedade, não a precisão, é o argumento real para este design.
Não acredita? Prove você mesmo
As afirmações de custo, velocidade e offline não precisam de chave de API - meça-as na sua máquina em 60 segundos:
git clone https://github.com/NORTHTEKDevs/genome && cd genome
pip install -e . && python -m genome.verify
A primeira execução baixa o modelo de incorporação local (~90 MB, uma única vez) antes de imprimir qualquer coisa, então espere 30-120 segundos de silêncio aparente em uma máquina fria. Toda execução depois disso é instantânea.
Ele escreve memórias com sua rede de saída fisicamente bloqueada e imprime um recibo de aprovação/reprovação ao vivo - 0 chamadas de rede, 0 chamadas de LLM, escritas em dígitos únicos de ms, recuperação que funciona:
  [PASS] Air-gapped write path: wrote 200 memories with every outbound socket blocked -> 0 network attempts, 0 LLM calls
  [PASS] Write latency: 7.1 ms/message  (Mem0's measured write path: ~2,055 ms + 1 LLM call/message)
  [PASS] Retrieval works: top hit score 0.598
Esse recibo cobre apenas a história de custo/velocidade/offline. A afirmação de paridade de precisão com o Mem0
é uma verificação separada e maior que precisa de uma chave de LLM - reproduza-a frente a frente nas mesmas
perguntas com sua própria chave via python benchmarks/head_to_head.py (uma chave OpenRouter funciona;
veja benchmarks/RESULTS.md para as execuções n=90 / n=205, os testes
de significância pareados e os nulos publicados). A suíte de testes completa roda em CI público (selo
acima). A proposta não é "confie em mim" - é "execute".
Adicione memória persistente ao seu agente em uma linha (MCP)
O GENOME inclui um servidor MCP totalmente local - memória entre sessões para Claude Desktop, Claude Code ou Cursor sem chave de API e sem dados saindo da sua máquina:
pip install "genome-memory[mcp]"
{ "mcpServers": { "genome": { "command": "genome-mcp" } } }
Ou instalação zero via uv: { "command": "uvx", "args": ["--from", "genome-memory[mcp]", "genome-mcp"] }
Ferramentas que o agente recebe: remember, recall, forget, reset_memories.
As memórias persistem localmente em ~/.genome/memories.db. Detalhes completos do MCP ↓
GENOME vs Mem0 de relance
| GENOME | Mem0 | |
|---|---|---|
| Precisão de respostas (LoCoMo, LongMemEval) | empate | empate |
| Chamadas de LLM para armazenar uma mensagem | 0 | 1+ |
| Velocidade de escrita | ~10 ms | ~2.000 ms |
| Roda offline / isolado | sim | não (precisa de uma API de LLM) |
| Custo de ingestão (implantação de 10 mil usuários) | ~$190 / ano | $159 mil-$1,6 mi / ano |
| "O que era verdade em março?" (ponto no tempo) | sim | não |
| Memória determinística e auditável | sim | não |
Cada número é medido dentro de uma única estrutura - mesmo respondedor, juiz, incorporador e top-k;
apenas a camada de memória muda - com testes de significância pareados. Detalhes completos e proveniência
por número: benchmarks/RESULTS.md. Relatório formatado:
benchmarks/GENOME-LoCoMo-Report.pdf.
Por que é ~1.000× mais barato: nunca chama um LLM para lembrar
Armazenar uma mensagem custa uma chamada de LLM no Mem0, zero no GENOME (apenas uma incorporação local). Isso não é um benchmark que você pode contestar - é aritmética, e vale não importa qual LLM você use para precificar. Com 10.000 usuários × 50 mensagens/dia (15 milhões de mensagens/mês):
| Modelo que o Mem0 usa para extrair | Conta anual de ingestão do Mem0 | GENOME |
|---|---|---|
| Claude Haiku | $1.601.757 | $190 |
| gpt-4o-mini | $238.596 | $190 |
| modelo hospedado mais barato | $159.064 | $190 |
A diferença sobrevive ao modelo mais barato e cresce em produção (o Mem0 reenvia memórias armazenadas
ao LLM conforme o armazenamento enche). Reproduza: python benchmarks/tco_project.py (sem chave de API).
Roda isolado
O incorporador padrão do GENOME é local. Provamos que o caminho de escrita é genuinamente offline ao bloquear toda a rede durante as escritas - elas ainda funcionam:
- ~10 ms/mensagem, 0 chamadas de rede, 0 chamadas de LLM (
python benchmarks/local_writepath.py) - O Mem0 não consegue fazer isso - precisa de uma chamada de API de LLM para ingerir.
Isso torna o GENOME utilizável on-premise, em ambientes regulados ou totalmente offline. É uma capacidade sim/não, não um ponto de preço.
Como funciona
- Escrita: incorpora a mensagem localmente e armazena. Sem LLM, sem rede. (~10 ms)
- Leitura: busca vetorial sobre suas memórias, com um reordenador local opcional de codificador cruzado para consultas mais difíceis.
- Camada bi-temporal opcional: acompanha como os fatos mudam ao longo do tempo e responde "o que era verdade no tempo T" - veja abaixo.
O que o determinismo compra para você
Como nada no caminho de escrita interpreta seu conteúdo, o GENOME pode fazer coisas que um sistema de memória com ingestão por LLM não pode fazer em princípio:
-
Firewall de memória (
genome.firewall): etiqueta cada escrita com sua origem (user,agent,tool,web), coloca em quarentena origens de baixa confiança da recuperação e impõe autoridade vinculada à origem - conteúdo da web nunca pode ATUALIZAR ou EXCLUIR o que seu usuário disse, mesmo quando um resolvedor de conflitos com injeção de prompt solicita. Também não há etapa de extração para conteúdo injetado atacar: o caminho de escrita não tem LLM.from genome import Memory from genome.firewall import TrustPolicy m = Memory(trust_policy=TrustPolicy(recall_min_trust=1)) m.add("I live in Anchorage", user_id="u1", provenance="user") m.add(scraped_page_text, user_id="u1", provenance="web") # quarantined -
Recuperação explicável (
genome.explain):explain_search()relata a cada candidato a pontuação densa, classificação BM25, pontuação fundida e - quando não foi retornado - o motivo exato (filtrado por pai, em quarentena, além do limite). Duas execuções concordam, então um bug de recuperação pode ser registrado como um teste de regressão em vez de um "tanto faz". -
Diário + reprodução (
genome.journal): registra cada mutação e reproduz comprovadamente o armazenamento -verify_journal()reproduz o histórico e compara hashes canônicos. Reproduza um prefixo para reverter; reproduza em um armazenamento diferente para ramificar uma memória para uma execução de "e se". O diário fica após a extração, então a reprodução é determinística mesmo se você configurou um extrator de LLM. Cada linha encadeia com sua antecessora, então uma linha removida ou editada é detectada mesmo quando a mudança se cancela no estado final.# Tamper-EVIDENT by default. Pass a key (kept outside the journal's directory) # to make it tamper-PROOF: an unkeyed chain can be recomputed by anyone with # write access, an HMAC chain cannot. m = Memory(journal="mem.journal", journal_key=os.environb[b"GENOME_JOURNAL_KEY"]) -
Atribuição de crença multiagente (
record_fact(..., believed_by="agent-a")): agentes que compartilham um armazenamento mantêm suas próprias linhas do tempo de crença - o agente B discordando não sobrescreve o fato do agente A - ebelief_conflicts()traz divergências à tona para resolução deliberada em vez de escolher silenciosamente um vencedor. -
Uma estrutura de benchmark neutra (
benchmarks/neutral/): execute GENOME, Mem0 e uma linha de base de contexto completo através do mesmo respondedor, juiz e incorporador, com uma matriz McNemar pareada e um bloco de divulgação completa. O GENOME é uma linha na tabela, não a casa.
Instalação
pip install genome-memory
O incorporador padrão é local (sentence-transformers/all-MiniLM-L6-v2) - sem chave de API,
funciona offline; a primeira execução baixa o modelo de ~90 MB uma única vez. Incorporações OpenAI são
opcionais para recuperação de maior dimensionalidade.
Pegada de dependências, honestamente: a instalação principal é numpy, sentence-transformers,
scikit-learn e rank-bm25. Incorporações locais rodam em PyTorch (puxado pelo
sentence-transformers), então não é uma instalação pequena - esse é o tradeoff deliberado para
incorporação offline e de custo zero. Dependências de plotagem/gráficos de benchmark ficam em um extra opcional [viz],
não no núcleo. Migrando do Mem0? Veja
docs/migrating_from_mem0.md.
Início rápido (totalmente local, sem chave de API)
from genome import Memory

mem = Memory(storage="genome.db")   # local embedder by default; ":memory:" for ephemeral

# Store a message -- embedded locally, no LLM call, no network
mem.add("Ada met Lin at the robotics summit in Berlin.", user_id="u1")
mem.add("They are collaborating on an open-source planning library.", user_id="u1")

# Retrieve the most relevant memories
for hit in mem.search("Where did Ada meet Lin?", user_id="u1", limit=5):
    print(f"{hit.score:.3f}  {hit.content}")
Memory espelha a API do Mem0 (add / search / get / delete / reset) - uma troca quase
direta. Para usar incorporações OpenAI em vez disso (defina OPENAI_API_KEY):
from genome import Memory, EmbeddingProvider
mem = Memory(storage="genome.db",
             embedding_provider=EmbeddingProvider(model_name="openai:text-embedding-3-small"))
Use como servidor MCP (memória totalmente local para qualquer agente)
O GENOME inclui um servidor MCP, então qualquer cliente MCP (Claude Desktop, Claude Code, Cursor, ...) recebe memória persistente entre sessões que roda inteiramente na máquina local - sem chamadas de LLM, sem chaves de API, sem dados saindo da máquina. A maioria dos MCPs de memória não pode dizer isso.
Instale com o extra mcp, depois adicione à configuração do seu cliente:
pip install "genome-memory[mcp]"
{
  "mcpServers": {
    "genome": { "command": "genome-mcp" }
  }
}
Ferramentas que o agente recebe: remember (armazena um fato/preferência, local + 0 LLM), recall
(busca semântica), forget (exclui a memória que corresponde a uma consulta), reset_memories
(limpa as memórias de um usuário). As memórias persistem em ~/.genome/memories.db (substitua com a
variável de ambiente GENOME_MCP_DB). Execute de forma autônoma com genome-mcp ou python -m genome.mcp.server.
Execute como API HTTP
Prefere HTTP? O GENOME inclui um servidor FastAPI que espelha a biblioteca 1:1 (add / search /
get / update / delete / reset / synthesize), com uma especificação OpenAPI gerada automaticamente em
/docs.
pip install "genome-memory[fastapi]"
Experimente localmente (sem chave, apenas loopback - uma única flag torna explícita a intenção de "sem autenticação"):
GENOME_ALLOW_NO_AUTH=1 python -m genome.server # serves on 127.0.0.1:8080
curl -X POST localhost:8080/v1/memories \
  -H 'Content-Type: application/json' \
  -d '{"text": "Ada met Lin at the robotics summit in Berlin.", "user_id": "u1"}'

curl -X POST localhost:8080/v1/search \
  -H 'Content-Type: application/json' \
  -d '{"query": "Where did Ada meet Lin?", "user_id": "u1", "limit": 5}'
Seguro por padrão. O servidor se recusa a servir sem autenticação a menos que você opte por participar
como acima, e não vincula uma interface não-loopback sem uma chave. Para expô-lo, defina uma
chave de API (enviada como X-API-Key) - necessária para vincular além do localhost:
GENOME_API_KEY=$(openssl rand -hex 32) GENOME_HOST=0.0.0.0 python -m genome.server
# then add:  -H "X-API-Key: $GENOME_API_KEY"  to every request
Para implantações multi-tenant, defina GENOME_REQUIRE_SCOPE=1 para exigir user_id/agent_id em
cada chamada e desative o reset global. Docker: docker-compose up (requer GENOME_API_KEY
e POSTGRES_PASSWORD; o Postgres é publicado apenas em loopback). Guia completo, incluindo o
backend Postgres e todas as variáveis de ambiente: docs/tutorial_quickstart.md.
Cliente TypeScript / JavaScript
@northtek/genome-memory espelha a
estrutura da API Python Memory neste servidor (ESM, Node 20+ ou navegador):
npm install @northtek/genome-memory
import { Memory } from "@northtek/genome-memory";

const mem = new Memory({ baseUrl: "http://localhost:8080" });
await mem.add({ text: "Ada met Lin in Berlin.", userId: "u1" });
const hits = await mem.search({ query: "Where did Ada meet Lin?", userId: "u1" });
Documentação completa do cliente: sdks/typescript/README.md.
Os resultados honestos
Mesmo respondedor + avaliador + embedder para cada sistema; apenas a camada de memória muda.
| O que medimos | Resultado | Veredito |
|---|---|---|
| Precisão das respostas, dentro da janela (LoCoMo) | GENOME 0.851 vs Mem0 0.855 (p > 0.23) | Empate |
| Precisão das respostas, benchmark mais difícil (LongMemEval, n=90 e n=205) | direcionalmente à frente, não significativo (p = 0.14-0.19) | Empate |
| Precisão quando o histórico excede a janela de contexto | +0.409 com 80× menos contexto (p = 8e-10) | Vitória |
| Custo para armazenar uma mensagem | 0 chamadas de LLM vs 1+; 837-8.433× mais barato | Vitória |
| Caminho de escrita | ~10 ms, sem conexão externa, 0 chamadas de rede | Vitória |
| Ponto no tempo ("o que era verdade em T") | estado de crença 0.870 vs Mem0 0.676 (dados sintéticos) | Vitória, com ressalva |
| Taxa de recuperação com reranking | melhora hit@10 (até 0.943); local e gratuito | Vitória |
O que testamos que não ajudou (para você não precisar)
Publicamos nossos nulos — é assim que você sabe que as vitórias são reais:
- Síntese / consolidação: neutro em precisão com orçamento de tokens igual (p = 0.86).
- Híbrido (BM25 + denso) e recuperação por grafo: o híbrido teve desempenho inferior ao denso puro no LoCoMo; o grafo não foi validado aqui.
- O ganho de precisão do reranking depende do embedder: ele melhora de forma confiável a taxa de recuperação, mas seu efeito na precisão final das respostas depende do embedder — trate-o como uma ferramenta de qualidade de recuperação, não como uma vitória garantida de precisão.
Memória bi-temporal: "o que era verdade no tempo T"
O GENOME pode rastrear como os fatos mudam ao longo do tempo e responder perguntas de ponto no tempo — algo que a memória baseada em sobrescrita estruturalmente não consegue (ela só mantém o valor mais recente):
from genome.memory.belief import ingest_belief_turn, answer_belief_context

mem = Memory(storage="genome.db", llm_call=my_llm_fn)

# facts land at their DOMAIN time (parsed from the text), not wall-clock ingest time
ingest_belief_turn(mem, "In March 2024, Jordan moved to Seattle.", session_time=t0, user_id="u")
ingest_belief_turn(mem, "Jordan just moved to Austin.", session_time=t2, user_id="u")

answer_belief_context(mem, "Where does Jordan live now?", user_id="u")            # -> Austin
answer_belief_context(mem, "Where did Jordan live in early 2024?", user_id="u")   # -> Seattle
answer_belief_context(mem, "List every city Jordan has lived in.", user_id="u")   # -> Seattle; Austin
No benchmark TempBelief, ele responde consultas "na data" com 0.870 vs 0.676 do Mem0, com o grafo de conhecimento auditado em 0.97 de precisão / 0.96 de recall. Ressalva: o TempBelief é texto sintético com datas explícitas; a vantagem diminui na fala natural. Capacidade real, comprovação limitada.
Recursos opcionais
Opt-in; o caminho padrão permanece sem LLM e local na ingestão.
mem = Memory(
    storage="genome.db",
    llm_call=my_llm_fn,             # LLM-based fact extraction on add()
    resolve_conflicts=True,         # ADD/UPDATE/DELETE vs existing memories
    auto_extract_entities=True,     # entity graph for graph retrieval
    auto_consolidate_threshold=200, # summarize-or-prune when a scope grows past N
)
mem.search("...", user_id="u1", mode="hybrid")   # modes: "dense" (default), "hybrid", "graph"
Reranking (local, gratuito, sem API):
from genome.memory.rerank import CrossEncoderReranker
mem = Memory(storage="genome.db", reranker=CrossEncoderReranker())   # lazy-loaded
mem.search("Where did the user go on vacation?", user_id="u1", limit=5)  # reranked
Reproduza os benchmarks
Os conjuntos de dados LoCoMo e LongMemEval não estão incluídos (eles têm suas próprias
licenças — LoCoMo é CC BY-NC 4.0). Veja benchmarks/data/README.md para
baixá-los. As duas primeiras linhas não precisam de conjunto de dados nem de chaves de API:
python benchmarks/local_writepath.py        # local write path: ~10ms/msg, 0 network
python benchmarks/tco_project.py            # deployment cost projection
python benchmarks/verdict.py                # in-window accuracy + McNemar
python benchmarks/haystack_report.py        # overflow / context-window crossover
python benchmarks/ingest_cost.py --n 80     # measured ingestion cost vs Mem0
python benchmarks/lme_qa.py --n 90          # LongMemEval head-to-head vs Mem0
python benchmarks/tempbelief_run.py --convs 6   # bi-temporal point-in-time vs baselines
Suporte e nível comercial
Bugs e perguntas: issues e discussions. O suporte da comunidade é de melhor esforço — veja SUPPORT.md.
GENOME Enterprise é um produto comercial separado para compradores regulados e on-premise que precisam prestar contas a um auditor sobre o que um sistema de IA sabia e quando: registro de auditoria com hash encadeado e à prova de adulteração, reconstrução de ponto no tempo, relatórios de conformidade, retenção com provas de apagamento, RBAC e SSO. Auto-hospedado e licenciado por implantação — não há versão hospedada, deliberadamente, porque o valor está em seus dados nunca saírem. Esse nível é o que financia este. Avaliando-o ou quer suporte comercial no núcleo aberto? info@northtek.io
Licença
Apache License 2.0 — veja LICENSE e NOTICE.
O GENOME é gratuito e de código aberto: leia, modifique, auto-hospede e incorpore-o em seus próprios aplicativos — incluindo uso comercial — sob os termos do Apache 2.0. Não há "isca e troca de open core" planejada: o núcleo permanece Apache-2.0.
A concessão Apache-2.0 cobre o código, não o nome — veja TRADEMARKS.md, que começa com o que você pode fazer sem pedir. Perguntas: info@northtek.io.
Copyright 2026 Northtek (FrostByte Digital LLC). mcp-name: io.github.NORTHTEKDevs/genome