StudyDiff
Explica por que dois artigos científicos discordam: extrai o desenho de cada estudo, mostra onde eles diferem e fundamenta cada afirmação em uma citação verbatim da fonte. Exemplos práticos integrados funcionam sem chave de API.
Documentação
StudyDiff
Entenda por que dois estudos científicos chegam a conclusões diferentes —
com cada afirmação verificada na fonte.






Demonstração ao vivo · Início rápido · Como funciona · Exemplos · Servidor MCP · Roteiro · Contribuição
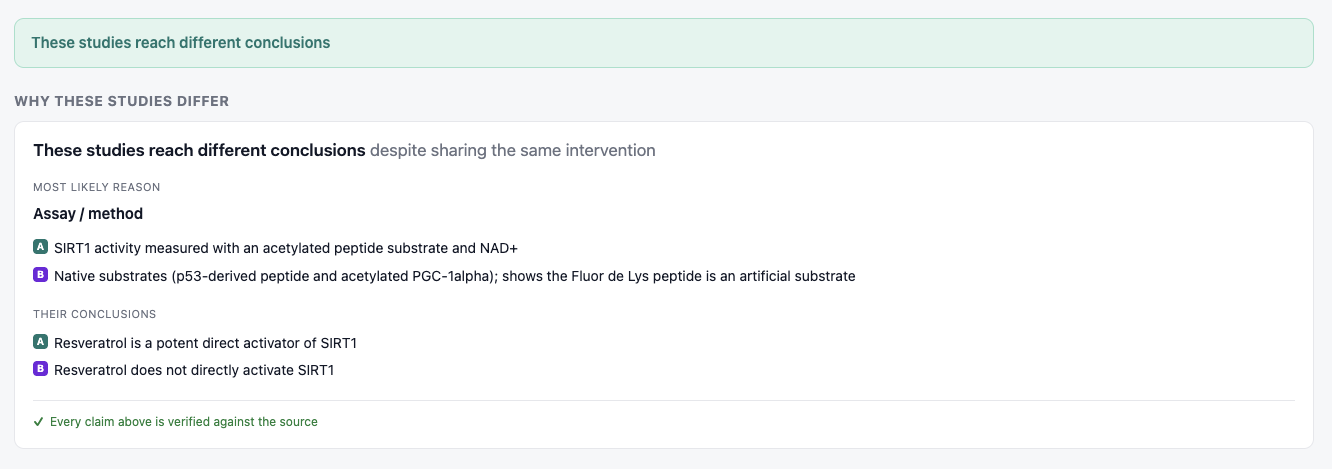
Dois artigos bem conduzidos frequentemente chegam a conclusões opostas. Normalmente, o motivo não é que um esteja errado — é uma diferença metodológica (um tipo de célula, uma dose, uma janela de acompanhamento, uma escolha de análise) que o leitor precisa extrair manualmente das seções de métodos. O StudyDiff faz essa extração. Dê a ele dois estudos e ele extrai o desenho de cada um, destaca as diferenças que poderiam explicar a discordância e — crucialmente — fundamenta cada afirmação no texto-fonte, para que nunca invente um resultado.
Ele foi criado para um cientista de bancada que precisa decidir qual de dois artigos conflitantes é confiável antes de planejar um experimento.
Por que é diferente
A maioria das ferramentas de "literatura com IA" gera uma resposta fluente e pede que você confie nela. O StudyDiff inverte isso:
- Ele mostra as evidências e depois sai do caminho. As diferenças de desenho no topo; cada valor com a frase literal que o sustenta abaixo.
- Ele se recusa a adivinhar. Qualquer campo que a fonte não declare é mostrado como não relatado, nunca inferido.
- Ele se verifica. Uma verificação determinística de fundamentação (sem um segundo LLM como juiz) confirma que cada valor extraído e cada explicação é respaldado por uma citação literal e números rastreáveis. Qualquer coisa que falhe é rebaixada antes de poder ser usada como motivo.
- Ele sabe o que não pode fazer, porque isso foi medido — veja abaixo.
Funciona? Uma resposta medida
O StudyDiff costumava classificar as dimensões de desenho divergentes e apresentar a principal como provável causa da discordância. Construímos um benchmark para testar isso, e não funciona.
15 contradições documentadas em que a literatura já estabeleceu por que os artigos discordavam — cada rótulo com sua própria citação, o conjunto construído às cegas antes de qualquer número de precisão existir. Pontuado contra o principal fator classificado pelo StudyDiff:
Top-1 accuracy (strict)      13.3%  (95% CI 3.7-37.9%)   [2/15]
Baseline "always say assay"  13.3%  (95% CI 3.7-37.9%)   [2/15]
                             → discordant on 0 of 15 cases
Oracle ceiling (reachable)   66.7%  (95% CI 41.7-84.8%)  [10/15]
Non-assay-labelled cases      0.0%  (95% CI 0.0-22.8%)   [0/13]
A classificação era um prior fixo (DRIVER_RANK em src/compare.mjs) no qual assay
supera tudo. Dois artigos quase sempre usam métodos um pouco diferentes, então assay
quase sempre diverge, por isso foi escolhido 13 vezes em 15 — e os dois acertos são exatamente
os dois casos rotulados como ensaio. Não é apenas tão bom quanto adivinhar uma constante; é
comportamentalmente idêntico a isso em todos os casos do conjunto.
Corrigir a fundamentação primeiro (Fase 2) removeu essa desculpa. Recuperar 20 de 26 rejeições falso-positivas dobrou o teto do oráculo de 33% para 67% — a causa estabelecida agora é um candidato disponível em 10 de 15 casos, em vez de 5 — e a precisão top-1 não mudou nada. O classificador recebeu a resposta certa cinco vezes a mais e não aproveitou nenhuma.
O que mudou como resultado: o aplicativo não indica mais um fator principal. Ele apresenta as dimensões divergentes como uma lista não classificada, porque essa lista é informativa (contém a causa estabelecida 10 vezes em 15), enquanto a ordenação não é. Escolher entre elas exige conhecimento de domínio que a ferramenta não tem.
O que ainda se mantém: quais dimensões diferem, quais são idênticas (descartadas) e a frase literal por trás de cada valor. Nada disso depende da classificação.
Confirmado às cegas, em um segundo conjunto
Esses 15 casos já haviam sido lidos em duas fases — falhas analisadas, trechos reauditados — então todos os números pós-correção deles são precisão de conjunto de desenvolvimento, não uma medição às cegas. Então construímos um segundo conjunto e o medimos uma única vez.
eval/cases-heldout.json são mais 15 contradições documentadas, curadas de acordo com um protocolo escrito
e confirmado antes de qualquer caso ser selecionado (eval/HELDOUT-PROTOCOL.md),
por um curador que permaneceu cego às falhas caso a caso do conjunto de desenvolvimento, em campos
deliberadamente diferentes: microbioma, ecologia marinha, toxicologia, psicologia, cuidados
intensivos, oncologia, doenças infecciosas. Nenhum artigo e nenhuma contradição é compartilhada com
o conjunto de desenvolvimento — selftest aplica isso mecanicamente.
Top-1 accuracy (strict)      13.3%  (95% CI 3.7-37.9%)   [2/15]
Baseline "always say assay"  20.0%  (95% CI 7.0-45.2%)   [3/15]
                             → discordant on 1 of 15 cases
Oracle ceiling (reachable)   73.3%  (95% CI 48.0-89.1%)  [11/15]
Non-assay-labelled cases      0.0%  (95% CI 0.0-24.3%)   [0/12]
Em dados não vistos, o prior pontua abaixo do palpite constante — por exatamente um caso. Os
intervalos se sobrepõem quase inteiramente e as duas estratégias discordam em 1 de 15, então a
afirmação honesta é que ele permanece indistinguível de adivinhar assay toda vez, não que
seja pior.
A linha que não se move é a última. Em ambos os conjuntos, 25 casos em que a causa estabelecida
era algo diferente de assay, o prior não identificou nenhum deles. E o teto aqui é
maior que no conjunto de desenvolvimento — 73,3% contra 66,7% — então a extração colocou a
resposta certa diante do classificador com mais frequência, e ela foi aproveitada com a mesma
frequência. Essa é a conclusão das Fases 1–2 reproduzida em dados que o loop de desenvolvimento
nunca viu, que é a única maneira de fortalecê-la.
O número é relatado como está e nunca é combinado com o número do conjunto de desenvolvimento:
somar ambos em uma figura "n=30" relavaria dados lidos como dados cegos. Nada em src/ foi
alterado com base nisso. O conjunto foi buscado uma única vez em um braço pré-registrado, mas a
pontuação não foi uma passagem limpa — a primeira execução relatou n=14 depois que um artigo falhou
na busca, e o conjunto completo foi pontuado após recuperá-lo. Ambas as figuras, os dezesseis
defeitos que uma passagem de verificação adversária encontrou e corrigiu antes de qualquer
pontuação, e o raciocínio por trás de cada rótulo estão registrados no bloco de proveniência do
próprio arquivo, em vez de resumidos.
npm run eval:heldout            # the blind number, offline and free
npm run eval:selftest:heldout   # set integrity, incl. zero overlap with the dev set
Método completo, decisões pré-registradas e cada previsão que se revelou errada:
eval/README.md e eval/PHASE2.md. Os conjuntos de
benchmark são eval/cases.json (desenvolvimento) e
eval/cases-heldout.json (retido).
npm run eval            # offline, free, no API key — regenerates the numbers above
npm run eval:selftest   # validates the harness maths and set integrity
eval/cache/ e eval/cache-heldout/ são confirmados de propósito. Eles não são saída de build,
são evidências: os números publicados são reproduzíveis a partir de artefatos no repositório, em
vez de aceitos por fé.
Início rápido
Em menos de 60 segundos, sem chave de API, sem rede:
git clone https://github.com/nickjlamb/studydiff && cd studydiff
npm install
npm run demo                        # explains a real, famous contradiction
npm run demo -- resveratrol-sirt1   # a second worked example
npm run demo -- treg-stability      # a third: Treg lineage stability
Execute o aplicativo web:
cp .env.example .env    # add ANTHROPIC_API_KEY for live comparisons
npm run serve           # http://localhost:4173
Os exemplos integrados rodam em dados em cache e não precisam de chave. Para comparar ao vivo, adicione sua chave e use as entradas PMID / DOI, Enviar PDF ou Colar.
Como funciona
flowchart LR
  IN["Two papers<br/>PMID · DOI · PDF · text"] --> R["Retrieve<br/>PubMed / PMC / PDF"]
  R --> E["Extract<br/>Claude → structured study cards"]
  E --> V["Verify<br/>deterministic grounding"]
  V -- "ungrounded → not reported" --> E
  V --> C["Compare<br/>divergent vs. shared design"]
  C --> X["Present<br/>divergent dimensions + ruled out"]
- Recuperar — um cliente PubMed/PMC com fallback de texto completo para resumo que marca o
quão fundo leu (
fulltext/abstract/pasted); PDFs enviados são extraídos como texto no servidor. - Extrair — Claude transforma cada artigo em um cartão de estudo fixo (espécie, modelo, ensaio, dose, tempo, desfecho, tamanho amostral, estatística, resultado, limitações). Cada campo carrega uma citação literal de apoio; campos ausentes assumem não relatado por padrão.
- Verificar — a fundamentação roda primeiro: qualquer valor cuja citação não esteja na fonte, ou cujos números não rastreiem, é rebaixado para não relatado. O StudyDiff não pode citar um fato que não verificou.
- Comparar — determinístico: quais dimensões de desenho são relatadas por ambos os artigos, quais delas divergem e quais são idênticas. Divergência é um teste de sobreposição de tokens nas dimensões de desenho e desigualdade estrita na própria conclusão, porque a polaridade de uma conclusão importa onde o conteúdo de uma lista de métodos não importa.
- Apresentar — as dimensões divergentes sem classificação, cada uma com os valores de ambos os artigos e a frase literal por trás deles, e as idênticas explicitamente descartadas. O StudyDiff não indica uma como causa: foi medido e não funciona.
Duas coisas sustentam a garantia: a chave de API nunca sai do servidor, e a verificação é determinística — fundamentação e comparação não envolvem julgamento de modelo algum, então a mesma evidência verificada sempre produz as mesmas dimensões divergentes.
Por que Claude?
A confiabilidade do StudyDiff vem de como ele usa Claude, não apenas do fato de usar:
- Extração estruturada via uso de ferramentas. Cada artigo vira um cartão de estudo por meio de um esquema de ferramenta forçado do Claude (Sonnet), então cada campo retorna validado e carrega uma citação literal de apoio — sem parsing de texto livre, sem falhas de "quase-JSON".
- Raciocínio que mapeia afirmações para evidências. Claude lê a prosa de métodos/resumo e identifica tanto o valor de desenho quanto a frase exata que o sustenta — a parte difícil de transformar artigos não estruturados em cartões comparáveis e auditáveis.
- Claude propõe, a fundamentação dispõe. O StudyDiff nunca usa um LLM como juiz. Uma verificação determinística confere a saída de Claude contra a fonte e rebaixa qualquer coisa não suportada antes de ser mostrada. Combinar a extração por ferramentas de Claude com verificação não-LLM é o que permite à ferramenta confiar na própria saída e contorna as armadilhas usuais de LLM-como-avaliador.
- Construído com Claude Code. Todo o aplicativo — pipeline, UI, endurecimento, deploy — foi construído iterativamente com Claude Code em um único loop agêntico.
Exemplos
| Pergunta | Artigos | O que o StudyDiff encontra |
|---|---|---|
| Modelos de camundongo imitam inflamação humana? | Seok 2013 vs Takao & Miyakawa 2015 | Mesmos conjuntos de dados, conclusões opostas — impulsionado pela estratégia de seleção de genes. |
| O resveratrol ativa SIRT1? | Howitz 2003 vs Beher 2009 | Um artefato de ensaio — o substrato peptídico Fluor de Lys vs. substratos nativos. |
| A linhagem Treg é estável in vivo? | Zhou 2009 vs Rubtsov 2010 | Uma controvérsia marcante de células T — estável vs. instável, impulsionada pelo método de mapeamento de destino. |
Todos os três vêm como demonstrações offline (npm run demo / npm run demo -- resveratrol-sirt1 / npm run demo -- treg-stability).
Como usar
- Aplicativo web (
npm run serve) — exemplos, busca PMID/DOI, envio de PDF ou colar; transmite cada etapa do pipeline ao vivo e exporta um relatório Markdown reproduzível com a frase literal de apoio de cada valor. - Servidor MCP (
npm run mcp) — permite que Claude, ou qualquer agente, chame o mecanismo de contradição diretamente. Veja Servidor MCP. - CLI —
node src/cli.mjs --q "Does resveratrol activate SIRT1?" 12939617 19843076 - Deploy — veja DEPLOY.md (Railway + domínio personalizado).
Servidor MCP
O mecanismo do StudyDiff também é um servidor Model Context Protocol, então um agente pode perguntar por que dois artigos discordam como uma chamada de ferramenta — o mesmo pipeline fundamentado, sem navegador.
Publicado no Registro oficial de MCP como io.github.nickjlamb/studydiff, e no npm como
studydiff-mcp.
| Ferramenta | O que faz |
|---|---|
compare_studies(paperA, paperB, question?) | O pipeline completo em dois artigos. Cada artigo é {id} (PMID ou DOI) ou {citation, text}. Precisa de ANTHROPIC_API_KEY. |
compare_example(example) | Executa um exemplo trabalhado em cache — sem chave de API, sem rede. A maneira mais rápida de ver a saída fundamentada. |
list_examples() | Lista os exemplos trabalhados integrados. |
| Ele retorna o mesmo relatório auditável que o aplicativo web exporta: o veredito, as dimensões de design divergentes (sem classificação) e as idênticas (descartadas), cada valor com a frase literal que o sustenta, as contagens de verificação e quais evidências resolveriam a discordância. Campos sem fundamentação retornam como não relatados — nunca adivinhados — e a ferramenta nunca escolhe um vencedor, nunca indica um fator principal e nunca relata uma confiança que não calculou. |
Adicione-o ao Claude Code:
claude mcp add studydiff -- npx -y studydiff-mcp
…ou ao Claude Desktop (claude_desktop_config.json):
{
  "mcpServers": {
    "studydiff": {
      "command": "npx",
      "args": ["-y", "studydiff-mcp"],
      "env": { "ANTHROPIC_API_KEY": "sk-ant-..." }
    }
  }
}
ANTHROPIC_API_KEY só é necessário para compare_studies. Deixe-o de fora e list_examples / compare_example ainda funcionam — os exemplos em cache rodam sem chave e sem rede. (Para executar a partir de um clone local, troque o comando por node /absolute/path/to/studydiff/src/mcp.mjs.)
Depois, basta perguntar:
Use studydiff para comparar PMID 19633673 e 20929851 — por que eles discordam?
Sem chave à mão? list_examples, então compare_example("treg-stability") roda totalmente offline.
Estrutura do projeto
src/ncbi.mjs        PubMed / PMC retrieval (+ DOI resolution, source-depth tagging)
src/pdf.mjs         PDF text extraction (pure JS)
src/extract.mjs     Claude tool-use → structured study cards
src/grounding.mjs   deterministic verification (OpenGATE)
src/compare.mjs     divergence detection (divergent vs. shared design dimensions)
eval/               driver-ranking benchmark: 15 cited contradictions + scorer
src/gaps.mjs        bounded "observed across these papers"
src/pipeline.mjs    orchestration: retrieve → extract → verify → compare
src/report.mjs      shared Markdown report (answer, drivers, quotes, verification)
src/server.mjs      web server + streaming API (+ rate limiting, caching)
src/mcp.mjs         MCP server: compare_studies / compare_example / list_examples
public/index.html   single-file dashboard UI
fixtures/           cached real papers for the offline demos
Roadmap
Busca por palavras-chave com um seletor de resultados, um visualizador de fontes que destaca cada citação fundamentada no texto original, comparação em lote e um relatório exportável. Lista completa em ROADMAP.md.
Contribuição
Contribuições são bem-vindas — veja CONTRIBUTING.md para a configuração e os invariantes que mantêm a garantia de confiança intacta.
Proveniência
O StudyDiff foi criado para o hackathon Built with Claude: Life Sciences da Anthropic (trilha Builder). Todo o código de aplicação neste repositório foi escrito do zero durante o evento. A fundamentação usa OpenGATE e a extração de PDF usa unpdf, ambos como dependências publicadas. A recuperação usa os E-utilities públicos do NCBI; a extração usa a API do Claude.
Licença
MIT © Nick Lamb