cogvault
Memória local para agentes de IA sobre arquivos Markdown simples: recall híbrido vetorial + BM25 (RRF), uma memória isolada por diretório de agente, totalmente offline sem LLM no fluxo.
Documentação




Começar · Por quê · Comparação · Como funciona · Benchmark · Instalação · Início rápido · MCP · Frotas
Comece em 30 segundos
Plugin Claude Code — servidor MCP mais uma skill que informa ao agente quando lembrar e quando gravar:
/plugin install cogvault --marketplace NBibikov/cogvault
Claude Code anterior a 2.1.275: /plugin marketplace add NBibikov/cogvault, depois
/plugin install cogvault@cogvault.
A memória fica em ~/.cogvault/memory (defina COGVAULT_TENANT para alterar). O plugin
adiciona /cogvault:remember.
Qualquer cliente MCP, uma linha (requer uv):
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Claude Desktop, Cursor, Windsurf, Cline — configuração JSON
Adicione a claude_desktop_config.json, ~/.cursor/mcp.json ou à configuração MCP do seu cliente:
{
  "mcpServers": {
    "cogvault": {
      "command": "uvx",
      "args": ["cogvault", "mcp", "--tenant", "~/agent/memory"]
    }
  }
}
Já tem memória em Markdown? Aponte o tenant para ela — nada para importar. A
memória automática do Claude Code funciona como está (frontmatter type, [[links]] e tudo):
M=~/.claude/projects/<project>/memory
uvx cogvault index  --tenant $M --ignore MEMORY.md   # first pass embeds, later passes are incremental
uvx cogvault search --tenant $M "how do we deploy"
O servidor MCP indexa sozinho na inicialização; a CLI search lê o índice existente.
--ignore MEMORY.md impede que o arquivo de índice dispute com os cards que ele referencia.
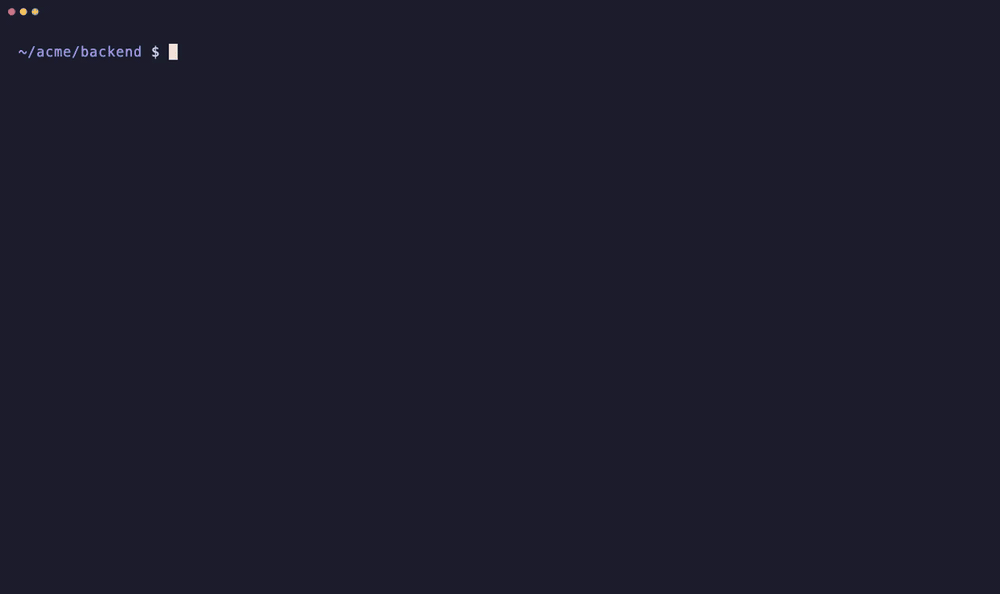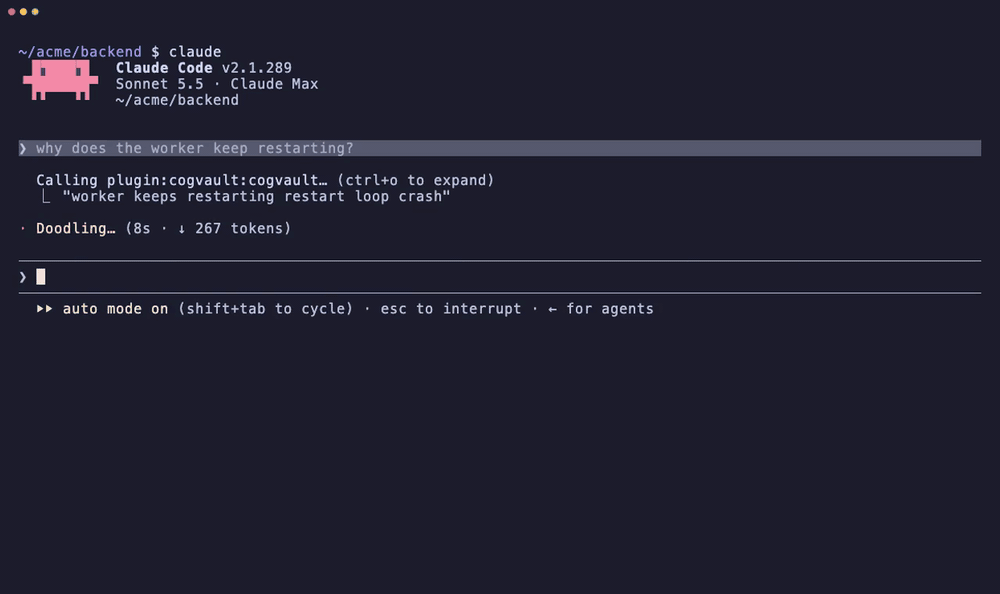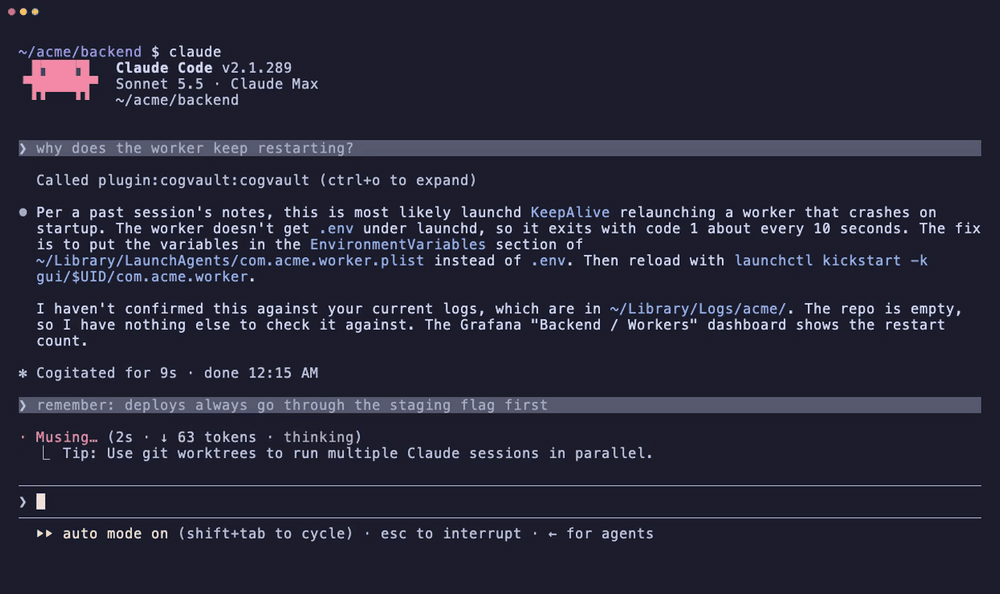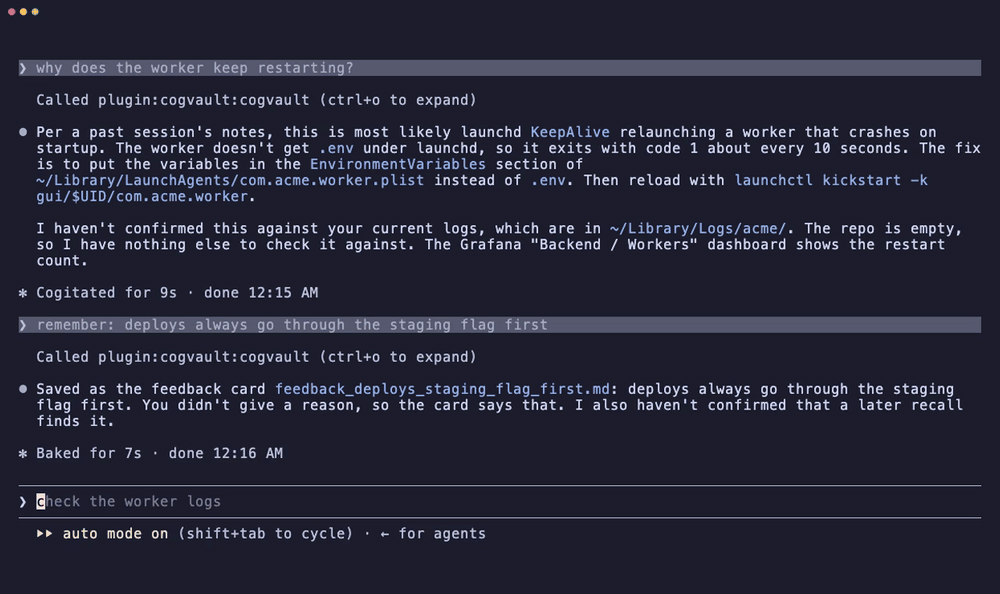
Respostas não editadas de uma sessão real (Sonnet, plugin instalado, uma memória demo de seis cards); apenas o tempo de espera foi cortado.
Por quê
A maioria das ferramentas de "memória para agentes de IA" quer ser um daemon LLM autônomo que resume seu trabalho em um banco de dados opaco ou um grafo que você não consegue ler. Para uma frota de agentes de codificação que só precisam lembrar de forma confiável uma decisão, uma correção de bug ou um detalhe de infraestrutura, essa é a troca errada.
cogvault aposta no oposto:
- Seus arquivos Markdown são a fonte da verdade. Abra-os, edite-os,
git diffeles. O índice SQLite é um cache derivado — delete-o e ele se reconstrói a partir dos arquivos. - Uma biblioteca, muitos tenants. Cada agente recebe um namespace de memória isolado via seu próprio diretório. Um processo carrega cada modelo de embedding uma vez e o compartilha entre todos os tenants que toca; com o servidor MCP stdio, isso significa um pequeno processo por sessão de agente, não um daemon central.
- Sem LLM no caminho. Ingestão e recuperação são determinísticas. Seu agente é o LLM — ele não precisa de um segundo para lembrar.
- Local, privado, offline. FastEmbed roda no dispositivo. Nada sai da sua máquina.
Comparado a
Verificado contra o README e a documentação de cada projeto em 2026-10-05.
| cogvault | basic-memory | mem0 | Graphiti | Letta Code | |
|---|---|---|---|---|---|
| Fonte da verdade | Arquivos Markdown | Arquivos Markdown | Banco vetorial (Qdrant / pgvector) | Banco de grafo (Neo4j, FalkorDB, …) | Markdown em um repositório git por agente |
| LLM necessário para armazenar ou lembrar | Não | Não (reranker opcional) | Sim por padrão (add() extrai fatos) | Sim para ingestão | Sim — o agente edita sua própria memória |
| Recuperação | Vetorial + BM25, RRF, decaimento, MMR | Texto completo + vetorial, rerank opcional | Semântica + BM25 + entidades | Semântica + BM25 + grafo | Busca em arquivos; híbrida opcional |
| Infraestrutura | Um processo, arquivo SQLite | Um processo, SQLite (Postgres opcional) | Biblioteca, ou Docker + servidor Postgres | Um banco de grafo | Backend Letta |
Escolha outra coisa quando: você quiser que um LLM destile e mescle fatos para você (mem0), relações entre entidades forem o ponto (Graphiti), você quiser que o agente gerencie sua própria memória (Letta), ou quiser um app de notas mais rico em torno da mesma ideia de Markdown, com sincronização Obsidian e uma opção hospedada (basic-memory — o mais próximo do cogvault).
Escolha cogvault quando: você roda vários agentes e quer que a memória de cada um fique isolada em seu
próprio diretório atrás de um único processo; você quer que a recuperação seja determinística e offline; e você
quer medir isso — cogvault eval pontua a recuperação nas consultas reais dos seus agentes e
cogvault analyze lista o que eles tentaram lembrar e não conseguiram.
Como funciona

Anatomia de uma recuperação

A recuperação híbrida funde a classificação semântica (vetorial) e por palavras-chave (BM25/FTS5) com Fusão de Classificação Recíproca, e então aplica decaimento temporal opcional (memória recente supera a obsoleta) e MMR (resultados diversos no topo, não cinco quase duplicados). Cada card contribui apenas com seu melhor chunk, então um arquivo longo não pode preencher toda a lista de resultados.
Benchmark

Medido em tráfego de recuperação real, não em perguntas sintéticas: 66 consultas amostradas dos
logs de consulta de 6 tenants de agentes ao vivo (58% em ucraniano, o restante em inglês), cada uma julgada
contra os cards reais — incluindo respostas que nenhuma configuração retornou. Uma consulta não tem
resposta na memória e conta como lacuna, então 65 são pontuadas. Cada configuração foi reindexada
do zero em cópias dos mesmos tenants com cogvault 0.11.0.
| Configuração | hit@1 | hit@5 | MRR@10 |
|---|---|---|---|
multilingual-e5-small, chunk_chars = 700, chunk de resumo | 0.57 | 0.91 | 0.70 |
multilingual-e5-small, chunk_chars = 700, sem chunk de resumo | 0.55 | 0.86 | 0.69 |
paraphrase-multilingual-MiniLM-L12-v2 (padrão embutido) | 0.54 | 0.80 | 0.66 |
bge-small-en-v1.5 (somente inglês) | 0.57 | 0.77 | 0.65 |
O que os números dizem e não dizem:
- hit@1 é um empate. Todos os quatro ficam entre 0,54–0,57, e os intervalos de bootstrap de 95% se sobrepõem quase completamente. Consultas reais de agentes parecem títulos de cards, então o card certo geralmente vence só pelo nome.
- A lacuna está no top 5. e5-small com o chunk de resumo coloca a resposta no top 5 para 91% das consultas vs. 80% para o MiniLM padrão e 77% para bge somente inglês nesta memória de idioma misto. É isso que um agente lendo 5 resultados realmente sente.
- 65 consultas ainda é uma amostra pequena. Trate diferenças abaixo de ~0,1 como ruído. Os
números agregados estão em
assets/benchmark.json; as consultas são privadas e permanecem em cada tenant.
Reranking
Um cross-encoder lê a consulta e cada card candidato juntos, então ele pode dizer qual
card responde à pergunta, não apenas qual é sobre o mesmo tópico. Com
rerank = "BAAI/bge-reranker-v2-m3-int8", o cogvault pontua o top 10 híbrido pelos primeiros
800 caracteres de cada arquivo de card e os reordena. Nas mesmas 65 consultas
(cogvault 0.12.0, e5-small + chunk de resumo):
| hit@1 | hit@5 | MRR@10 | |
|---|---|---|---|
| somente híbrido | 0.60 | 0.88 | 0.70 |
| híbrido + reranker | 0.80 | 0.91 | 0.85 |
O reranker melhorou 17 consultas e piorou 3. O intervalo de bootstrap de 95% do ganho de hit@1
é de +0,09 a +0,34. O custo é ~2 GB de RAM e 1–2 s por recuperação em uma CPU Apple M-series,
então ele roda apenas no daemon compartilhado e em cogvault eval
(--no-rerank pontua sem ele).
Rode a mesma verificação na sua própria memória: coloque consultas julgadas em
<tenant>/.cogvault-golden.jsonl ({"query": "...", "relevant": ["file.md"]}, vazio
relevant = uma lacuna conhecida) e execute cogvault eval --tenant DIR.
Escolhendo um modelo de embedding
A memória de agentes geralmente não é somente em inglês. O padrão é multilíngue para que nada
seja quebrado de fábrica — mas escolha o modelo que combina com a mistura de idiomas da sua frota
(defina COGVAULT_MODEL, ou Config(model=...)). Trocar de modelo reconstrói o índice automaticamente.
Modelo (COGVAULT_MODEL) | Dim | Tamanho | hit@5 em consultas reais* | Cirílico / multilíngue | Quando |
|---|---|---|---|---|---|
paraphrase-multilingual-MiniLM-L12-v2 (padrão) | 384 | 0,22 GB | 0,80 | ✅ funciona | Frotas de idioma misto; padrão seguro |
BAAI/bge-small-en-v1.5 | 384 | 0,13 GB | 0,77 | ❌ vetores cirílicos quebram | Memória somente em inglês |
intfloat/multilingual-e5-small | 384 | 0,47 GB | 0,91 | ✅ melhor por GB (janela de 512 tokens) | Frotas de idioma misto; use chunk_chars = 700 |
intfloat/multilingual-e5-large | 1024 | 2,24 GB | não medido | ✅ melhor | Qualidade máxima, RAM de sobra |
*Do benchmark acima: 65 consultas reais sobre memória mista EN/UK,
cogvault 0.11.0. Em memória somente em inglês, bge-small-en é uma boa escolha; em conteúdo
ucraniano ele retorna uma margem de relevância negativa (um distrator supera a resposta),
então é inseguro para memória não inglesa. Rode cogvault eval no seu próprio vault para decidir.
COGVAULT_MODEL=BAAI/bge-small-en-v1.5 cogvault index --tenant ~/agent/memory
Fixe o modelo por tenant para que ele viaje com os dados em vez de depender de cada
comando exportar COGVAULT_MODEL (esqueça uma vez e uma incompatibilidade de modelo re-embute
silenciosamente todo o índice). Coloque um .cogvault.toml na raiz do tenant:
# ~/agent/memory/.cogvault.toml
model = "BAAI/bge-small-en-v1.5"
# optional: recursive = true, strip_frontmatter = true, ignore_globs = ["Templates/*"]
Agora cogvault search --tenant ~/agent/memory "…" usa o modelo certo sem variável de ambiente.
Precedência: --model / $COGVAULT_MODEL explícitos > .cogvault.toml > padrão embutido.
Instalação
uv tool install cogvault        # CLI on PATH
# or
pip install cogvault
Ou pule a instalação e rode sob demanda com uvx cogvault …. A primeira execução baixa
o modelo de embedding (~0,2–0,5 GB, uma vez por máquina).
Adicione ao Claude Code como servidor MCP em uma linha:
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Também listado no Registro MCP oficial
como io.github.NBibikov/cogvault. Wheels estão anexados a cada
release do GitHub.
Início rápido
# index a tenant's markdown memory
cogvault index --tenant ~/agent/memory

# search (hybrid semantic + keyword)
cogvault search --tenant ~/agent/memory "how do I restart the worker service"

# enable temporal decay (recent wins) and tune diversity
cogvault search --tenant ~/agent/memory "deployment steps" --half-life 30 --mmr 0.5

# only cards of one frontmatter type (user / feedback / project / reference / …)
cogvault search --tenant ~/agent/memory "hard rules for deploys" --type feedback
Cards de memória
O cogvault entende duas convenções leves de Markdown (ambas opcionais — arquivos simples indexam bem):
- Frontmatter
type— plano (type: reference) ou aninhado (metadata:→type: reference). Analisado na indexação e filtrável na busca (--type, parâmetro MCPtype,search(card_type=...)). Cada resultado carrega um campotype; cards sem frontmatter recebemnull. [[wiki-links]]— os alvos dos links são indexados, e o principal resultado de busca inclui uma listarelatedde cards vinculados que existem no índice (links fantasmas são descartados; a correspondência é pelo nome exato do arquivo sem extensão).
Como servidor MCP (Claude Code, Cursor, qualquer cliente MCP)
claude mcp add cogvault -- uvx cogvault mcp --tenant ~/agent/memory
Expõe duas ferramentas:
cogvault_recall— busca híbrida em linguagem natural sobre a memória deste agente. O parâmetro opcionaltypefiltra para um tipo de card de frontmatter; o principal resultado inclui uma linhaRelated:construída a partir do seu[[wiki-links]].cogvault_record— salva um fato; ele é gravado como um card Markdown e indexado
Indexando uma árvore de pastas (vaults Obsidian, bases de conhecimento)
Por padrão, um tenant é um único diretório plano de arquivos .md. Para um vault
aninhado (ex.: Obsidian, com 01-Projects/…, frontmatter e pastas para pular), opte por:
cogvault index --tenant ~/vault \
  --recursive \
  --strip-frontmatter \
  --ignore ".obsidian/*" --ignore ".trash/*" --ignore "Templates/*"
--recursivepercorre subdiretórios; os arquivos mantêm seu caminho relativo ao tenant, então duas notas chamadasTasks.mdem pastas diferentes nunca colidem.--strip-frontmatterremove um bloco YAML--- … ---inicial para que suas chaves não poluam o embedding.--ignore GLOB(repetível) pula caminhos relativos à raiz do tenant.
As mesmas flags existem em search e mcp, e como Config(recursive=True, strip_frontmatter=True, ignore_globs=(...)) para a biblioteca. A indexação é
incremental: a primeira passada incorpora tudo, passadas posteriores só re-incorporam arquivos
alterados. (Referência: um vault de ~3.500 notas → ~9.500 chunks, primeira indexação ≈ 3–4 min,
depois recuperação quente em milissegundos de um dígito.)
Como biblioteca
from cogvault import Vault, Config

vault = Vault("~/agent/memory", Config(half_life_days=30))
vault.reindex()
for hit in vault.search("where are credentials stored"):
    print(hit["score"], hit["file"], hit["snippet"])
Mantendo um tenant saudável
cogvault doctor --tenant DIR relata o que degrada silenciosamente a recuperação: cartões sem
frontmatter ou tipo, nomes de arquivo com timestamp legado, frontmatter aninhado dentro
de frontmatter, slugs duplicados de name: e [[links]] que não resolvem para nada.
Links são resolvidos pelo name: do frontmatter, pelo nome do arquivo, por ambos os estilos de separador e
com ou sem o prefixo do tipo de cartão; links dentro de código e caminhos para arquivos fora
do tenant não são contados.
cogvault repair --tenant DIR corrige a parte mecânica (dry run por padrão,
--apply para gravar): desaninha frontmatter aninhado, infere um tipo ausente, renomeia
card-<timestamp>-….md para <type>_<slug>.md e reescreve toda referência a ele
(incluindo MEMORY.md), e adiciona frontmatter mínimo a cartões <type>_*.md que
não o possuem. Cartões saudáveis são deixados intactos, e cartões reparados mantêm seu mtime para que
a decadência temporal não seja reiniciada.
Registro de eficácia
Cada recuperação é registrada (uma linha JSONL) para que você possa medir se a memória está
realmente ajudando. cogvault analyze transforma o log em um relatório:
cogvault analyze            # recalls, latency, per-tenant hit distance, weakest hits, card writes
cogvault analyze --json     # machine-readable
cogvault analyze --since 7  # only the last 7 days (or --since 2026-10-05)
A seção que importa é hits mais fracos: o pior decil de cada tenant por distância
vetorial — consultas onde a recuperação retornou algo (a busca híbrida quase sempre retorna)
mas provavelmente não a resposta. Essa lista é o que seus agentes tentaram recuperar e não conseguiram,
ou seja, as lacunas de memória a preencher. Defina COGVAULT_LOG=off para desativar, ou
COGVAULT_LOG=/path.jsonl para realocar.
Frotas multi-tenant
Aponte um processo para muitos tenants — cada diretório é um namespace isolado, comprovado pela
suíte de testes (test_multi_tenant_isolation). O Agente B nunca pode recuperar a memória do
Agente A, a menos que você aponte B para o diretório de A.

Daemon compartilhado
Cada cliente MCP inicia seu próprio cogvault mcp. Sem um daemon, cada um desses processos
carrega o modelo de embedding (~1 GB), e nenhum pode arcar com o reranker. cogvault daemon
carrega cada modelo uma vez para todos os tenants e os serve por um socket Unix
(~/.cache/cogvault/daemon.sock, modo 600). cogvault mcp e cogvault search o encontram
automaticamente e encaminham para ele; o processo MCP então permanece em ~40 MB. Quando o daemon está
fora do ar, eles buscam em processo como antes, sem o reranker, e registram um
evento daemon-fallback no log de consultas.
cogvault daemon            # run in the foreground
cogvault daemon --status   # ping it: version, loaded models, tenants served
O daemon descarrega um modelo após 10 minutos sem busca ou reindexação, e o carrega
novamente na próxima recuperação (~1,5 s extras nessa chamada). Defina --idle-unload SECONDS ou
$COGVAULT_IDLE_UNLOAD (0 mantém os modelos carregados). Medido com e5-small e o
reranker: ~1,8 GB carregados, ~0,4 GB descarregados. ONNX Runtime usa 4 threads
($COGVAULT_THREADS, 0 = todos os núcleos) e sem arena de memória de CPU, então uma reindexação completa
atinge o pico de ~1 GB em vez de manter vários GB depois. Um shim que iniciou enquanto o daemon estava
fora do ar espera até 60 s por ele antes de carregar um modelo por conta própria, e descarta um modelo que carregou
assim que o daemon responde novamente.
O reranker tem sua própria contagem de threads ($COGVAULT_RERANK_THREADS, padrão = os
núcleos de desempenho no Apple silicon, senão 4). Ele roda apenas no momento da recuperação e é a maior parte da
latência de recuperação: em 10 P-cores, a recuperação p50 passou de 2,3 s (4 threads) para 1,65 s, e para 1,05 s
com onnxruntime 1.31 (essa versão também reduziu a recuperação de 4 threads para 1,5 s).
No macOS, execute-o sob launchd com RunAtLoad e KeepAlive (argumentos de programa
cogvault daemon). Após atualizar o cogvault, reinicie o daemon:
launchctl kickstart -k gui/$(id -u)/<label>.
Notas de design
| Decisão | Porquê |
|---|---|
| Markdown = fonte da verdade | Legível por humanos, versionável com git, editável, nunca bloqueado em um banco de dados |
SQLite + sqlite-vec + FTS5 | Busca híbrida sem infraestrutura; um arquivo .db portátil; reconstruível |
| FastEmbed (MiniLM multilíngue padrão, 384-d) | ONNX em processo, sem servidor, sem chave de API, ~220 MB |
| Cache de hash de conteúdo | Reindexação só incorpora chunks alterados |
| RRF + decadência + MMR | Precisão, recência e diversidade sem um banco de grafos |
| Um processo, muitos tenants | Infraestrutura de frota, não um sidecar de desktop para um único usuário |
| WAL + reindexação incremental | Agentes concorrentes leem enquanto um escreve; apenas arquivos alterados são reincorporados |
| Daemon compartilhado opcional | Uma cópia de cada modelo para a frota; clientes recorrem ao processo quando ele está fora do ar |
Roadmap
- Importadores (migrar memória existente de outros armazenamentos)
- Embedders plugáveis (Ollama, endpoint compatível com OpenAI)
-
valid_untilvalidade temporal por cartão - Transporte FastMCP opcional
Licença
MIT — sua memória, seus arquivos, sua infraestrutura. Para sempre.
Figuras são SVG construídas à mão a partir de assets/make_graphics.py — python assets/make_graphics.py --png as regenera.