MCP Lucene Server
O servidor MCP Lucene Server é um servidor do Model Context Protocol (MCP) que expõe as capacidades de busca em texto completo do Apache Lucene por meio de uma interface conversacional. Ele permite que assistentes de IA (como o Claude) ajudem usuários a pesquisar, indexar e gerenciar coleções de documentos sem exigir conhecimento técnico sobre Lucene ou mecanismos de busca.
Documentação
MCP Lucene Server

Um servidor Model Context Protocol (MCP) que expõe recursos de busca fulltext do Apache Lucene com rastreamento e indexação automática de documentos. Este servidor suporta transporte STDIO (para integração com Claude Desktop) e transporte HTTP (para clientes baseados na web e acesso remoto).
Recursos
Rastreamento Automático de Documentos
- Indexa automaticamente PDFs, documentos Microsoft Office e OpenOffice
- Rastreamento multithread para indexação rápida
- Monitoramento de diretório em tempo real para atualizações automáticas
- Indexação incremental com reconciliação completa (ignora arquivos inalterados, remove órfãos)
Busca Poderosa
- Busca por palavras-chave simples (sem necessidade de sintaxe Lucene) e busca com sintaxe completa de consulta Lucene
- Filtragem por campo específico (por autor, idioma, tipo de arquivo, etc.)
- Passagens estruturadas com metadados de qualidade para consumo por LLM
- Resultados paginados com sugestões de filtro
Busca Semântica
- Busca semântica opcional baseada puramente em embeddings KNN usando embeddings multilingual-e5 com Late Chunking
- Encontra documentos semanticamente relacionados mesmo sem correspondência exata de palavras-chave
- Requer
VECTOR_MODELconfigurado. Consulte SEMANTICSEARCH.md para detalhes.
Perfilamento e Depuração de Consultas
- Análise e perfilamento profundo de consultas (ferramenta
profileQuery) - Entenda por que consultas retornam determinados resultados e como a pontuação funciona
- Análise de impacto de filtros mostrando redução de documentos por filtro
- Explicações de pontuação de documentos com detalhamento BM25
- Estatísticas de termos (IDF, raridade, frequência de documentos)
- Recomendações acionáveis de otimização
- Saída estruturada otimizada para LLM para fácil interpretação
Extração Rica de Metadados
- Detecção automática de idioma
- Extração de autor, título e data de criação
- Informações de tipo e tamanho de arquivo
- Hash de conteúdo SHA-256 para detecção de alterações
Enriquecimento de Metadados JDBC
- Carrega metadados adicionais de PostgreSQL, MySQL ou qualquer banco compatível com JDBC no momento da indexação
- Metadados baseados em JSON com tipos de campo explícitos (keyword, text, int, long, date)
- Suporte a campos multivalorados, registro automático de facetas
- Job de sincronização em segundo plano para atualizações incrementais de metadados (intervalo configurável)
- Todos os campos originados do banco prefixados com
dbmeta_para evitar colisões de esquema
Normalização de Texto
- Remoção automática de caracteres quebrados/inválidos (caracteres de substituição, caracteres de controle, caracteres de largura zero)
- Normalização de espaços em branco (espaços múltiplos colapsados em espaço único)
- Garante resultados de busca e passagens limpos e legíveis
Otimização de Desempenho
- Processamento em lote para indexação eficiente
- Busca NRT (Near Real-Time) com otimização dinâmica
- Pools de threads configuráveis para processamento paralelo
- Notificações de progresso durante operações em massa
Integração Fácil
- Suporte a transporte duplo: STDIO (padrão) e HTTP
- Transporte STDIO para integração perfeita com Claude Desktop
- Transporte HTTP para clientes baseados na web e acesso remoto
- Ferramentas MCP abrangentes para controle de busca e rastreador
- Configuração flexível via YAML e propriedades de sistema
- Notificações multiplataforma (Central de Notificações do macOS, Toast do Windows, notify-send do Linux)
Sumário
- Documentação
- Início Rápido
- Ferramentas MCP
- Configuração de Exposição de Ferramentas
- Esquema de Campos do Índice
- Exemplos de Uso
- Recursos do Rastreador de Documentos
- Solução de Problemas
- Considerações de Segurança
- Opções de Configuração
- Enriquecimento de Metadados JDBC
- Desenvolvimento
Documentação
Documentação técnica adicional:
- PIPELINE.md — Cadeias de analisadores, pipeline de consulta e detalhes de tokenização
- SEMANTICSEARCH.md — Arquitetura de busca semântica: Late Chunking, indexação Block Join, pontuação KNN e configuração
- ONNX.md — Guia de exportação de modelo ONNX, otimização e quantização INT8 para e5-base e e5-large
Início Rápido
Comece a usar o MCP Lucene Server em três etapas.
Pré-requisitos
- Java 25 ou posterior - Necessário para executar o servidor
- Maven 3.9+ (apenas se compilar a partir do código-fonte)
Etapa 1: Obter o Servidor
Opção A: Baixar JAR Pré-compilado (Recomendado)
- Vá para a aba Actions
- Clique na execução de workflow bem-sucedida mais recente
- Role até "Artifacts" e baixe
luceneserver-X.X.X-SNAPSHOT - Extraia o arquivo ZIP para obter o JAR
Para releases com tags, você também pode baixar da página Releases.
Opção B: Compilar a partir do Código-Fonte
./mvnw clean package -DskipTests
Isso cria um JAR executável em target/luceneserver-0.0.1-SNAPSHOT.jar.
Opção C: Usar Docker (Apenas Transporte HTTP Disponível)
docker run -v ./lucene-data-dir:/userdata -p 9000:9000 -it mirkosertic42/mcpluceneserver:main
Isso inicia um contêiner Docker com o servidor escutando na porta 9000. Todos os dados de configuração, incluindo os
arquivos de índice, são armazenados no diretório ./lucene-data-dir na máquina host. Observe que o indexador
Lucene só pode acessar arquivos visíveis ao contêiner Docker, portanto, todos os arquivos devem ser colocados no
diretório ./lucene-data-dir ou em um subdiretório dele. As configurações da JVM podem ser ajustadas pela variável
de ambiente JAVA_OPTS, que pode ser modificada usando a CLI do Docker ou um arquivo Docker Compose. O tamanho
máximo padrão do heap da JVM (-Xmx) é 2GB.
Para habilitar a busca semântica, defina a variável de ambiente VECTOR_MODEL:
docker run -v ./lucene-data-dir:/userdata -p 9000:9000 \
  -e VECTOR_MODEL=e5-base \
  -e JAVA_OPTS="-Xmx4g" \
  -it mirkosertic42/mcpluceneserver:main
| Variável de Ambiente | Padrão | Descrição |
|---|---|---|
VECTOR_MODEL | (nenhum) | Modelo de embedding ONNX: e5-base (768 dimensões, mais rápido) ou e5-large (1024 dimensões, maior qualidade). Defina para habilitar a busca semântica. |
JAVA_OPTS | -Xmx2g | Opções da JVM. Aumente para -Xmx4g ou mais ao usar busca semântica. |
Etapa 2: Configurar o Claude Desktop
Localize seu arquivo de configuração do Claude Desktop:
- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json - Linux:
~/.config/Claude/claude_desktop_config.json
Adicione o servidor MCP Lucene à seção mcpServers:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": [
        "--enable-native-access=ALL-UNNAMED",
        "-Xmx2g",
        "-Dspring.profiles.active=deployed",
        "-jar",
        "/absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar"
      ]
    }
  }
}
Importante: Substitua /absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar pelo caminho absoluto real para seu arquivo JAR.
A flag -Dspring.profiles.active=deployed é necessária para comunicação STDIO limpa (desativa o log de console e o banner de inicialização).
Etapa 3: Começar a Usar
- Reinicie o Claude Desktop para carregar a nova configuração
- Verifique se o servidor está em execução nas configurações de desenvolvedor do Claude Desktop
- Diga ao Claude para adicionar seus documentos:
"Add /Users/yourname/Documents as a crawlable directory and start crawling"
Pronto! A configuração é salva em ~/.mcplucene/config.yaml e persiste entre reinicializações. Agora você pode pesquisar seus documentos através do Claude.
Exemplos de busca:
- "Pesquisar artigos sobre aprendizado de máquina"
- "Encontrar todos os PDFs de João Silva"
- "Quais documentos mencionam relatórios trimestrais?"
Ferramentas MCP
As ferramentas são organizadas em grupos. Use LUCENE_TOOLS_INCLUDE e LUCENE_TOOLS_EXCLUDE para controlar
quais ferramentas são expostas (consulte Configuração de Exposição de Ferramentas).
Ferramentas de Busca (grupo: search)
simpleSearch
Pesquise o índice fulltext do Lucene usando busca por palavras-chave em texto simples. Caracteres especiais são tratados como literais — nenhum conhecimento de sintaxe Lucene é necessário. Usa BM25 com stemming em alemão e inglês.
Parâmetros:
query(opcional): Consulta de busca em texto simples. Pode sernullou"*"para corresponder a todos os documentos (útil com filtros).filters(opcional): Matriz de filtros estruturados para filtragem precisa por campo (consulte Filtros Estruturados abaixo)page(opcional): Número da página, baseado em 0 (padrão: 0)pageSize(opcional): Resultados por página (padrão: 10, máximo: 100)sortBy(opcional): Campo de ordenação -_score(padrão),modified_date,created_date,file_size, ou qualquer campo de metadadosdbmeta_*(INT/LONG/DATE/KEYWORD) registrado a partir do enriquecimento JDBCsortOrder(opcional): Ordem de ordenação -ascoudesc(padrão:desc)
extendedSearch
Pesquise o índice fulltext do Lucene usando sintaxe completa de consulta Lucene. Suporta operadores booleanos, curingas, consultas de proximidade e consultas por campo específico. Usa BM25 com stemming em alemão e inglês.
Parâmetros:
query(opcional): A consulta de busca usando sintaxe de consulta Lucene. Pode sernullou"*"para corresponder a todos os documentos (útil com filtros).filters(opcional): Matriz de filtros estruturados para filtragem precisa por campo (consulte Filtros Estruturados abaixo)page(opcional): Número da página, baseado em 0 (padrão: 0)pageSize(opcional): Resultados por página (padrão: 10, máximo: 100)sortBy(opcional): Campo de ordenação -_score(padrão),modified_date,created_date,file_size, ou qualquer campo de metadadosdbmeta_*(INT/LONG/DATE/KEYWORD) registrado a partir do enriquecimento JDBCsortOrder(opcional): Ordem de ordenação -ascoudesc(padrão:desc)
Ordenação de Resultados:
Por padrão, os resultados são ordenados por pontuação de relevância (mais relevante primeiro). Você pode ordenar por campos de metadados:
| Campo de Ordenação | Descrição | Ordem Padrão |
|---|---|---|
_score | Pontuação de relevância (padrão) | Decrescente (melhor correspondência primeiro) |
modified_date | Data da última modificação | Decrescente (mais recente primeiro) |
created_date | Data de criação | Decrescente (mais recente primeiro) |
file_size | Tamanho do arquivo em bytes | Decrescente (maior primeiro) |
dbmeta_* | Qualquer campo de metadados JDBC de valor único com tipo INT, LONG, DATE ou KEYWORD | Crescente ou decrescente |
Exemplos de Ordenação:
// Most recently modified documents
{ "query": "contract", "sortBy": "modified_date", "sortOrder": "desc" }

// Oldest documents first
{ "query": "contract", "sortBy": "created_date", "sortOrder": "asc" }

// Smallest files (for quick review)
{ "query": "summary", "sortBy": "file_size", "sortOrder": "asc" }

// Combine sorting with filters
{
  "query": "*",
  "sortBy": "modified_date",
  "sortOrder": "desc",
  "filters": [
    { "field": "file_extension", "value": "pdf" },
    { "field": "modified_date", "operator": "range", "from": "2024-01-01" }
  ]
}
Nota: Ao ordenar por campos de metadados, as pontuações de relevância ainda são calculadas e usadas como critério de ordenação secundário para desempate.
Filtros Estruturados:
A matriz filters aceita objetos com estes campos:
| Campo | Obrigatório | Descrição |
|---|---|---|
field | sim | Nome do campo para filtrar |
operator | não | eq (padrão), in, not, not_in, range |
value | para eq/not | Valor único para correspondência exata ou exclusão |
values | para in/not_in | Matriz de valores (semântica OR dentro do campo) |
from | para range | Início do intervalo (inclusivo) |
to | para range | Fim do intervalo (inclusivo) |
addedAt | não | Carimbo de data/hora do cliente — retornado na resposta activeFilters |
Referência de operadores:
| Operador | Descrição | Exemplo |
|---|---|---|
eq | Correspondência exata (padrão) | {field: "language", value: "en"} |
in | Corresponder a qualquer um dos valores | {field: "file_extension", operator: "in", values: ["pdf", "docx"]} |
not | Excluir valor | {field: "language", operator: "not", value: "unknown"} |
not_in | Excluir múltiplos valores | {field: "language", operator: "not_in", values: ["unknown", ""]} |
range | Intervalo numérico/de data | {field: "modified_date", operator: "range", from: "2024-01-01", to: "2025-12-31"} |
Campos filtráveis:
- Facetados (DrillSideways):
language,file_extension,file_type,author - String (correspondência exata):
file_path,content_hash - Numérico/data (intervalo):
file_size,created_date,modified_date,indexed_date
Formato de data: ISO-8601 — "2024-01-15", "2024-01-15T10:30:00" ou "2024-01-15T10:30:00Z"
Regras de combinação de filtros:
- Filtros em campos diferentes usam lógica AND
- Múltiplos filtros
eqou valoresinno mesmo campo facetado usam lógica OR (DrillSideways) - Filtros
not/not_insão aplicados como cláusulas MUST_NOT
Expansão de sinônimos com IA:
Este servidor foi projetado para trabalhar com assistentes de IA como o Claude. Em vez de usar arquivos de sinônimos tradicionais do Lucene, a IA gera sinônimos apropriados ao contexto automaticamente, construindo consultas OR.
Por que isso é melhor que sinônimos tradicionais:
- Consciente do contexto: A IA entende sua intenção e seleciona sinônimos relevantes (ex.: "contrato" em contexto jurídico vs. "contrato" em construção)
- Sem manutenção: Não é necessário manter arquivos de configuração de sinônimos estáticos
- Adaptável ao domínio: Funciona automaticamente em linguagem jurídica, técnica, médica ou casual
- Multilíngue: Gera sinônimos em qualquer idioma sem configuração
Quando você pede ao Claude para "encontrar documentos sobre carros", ele automaticamente busca por (car OR automobile OR vehicle) — dando melhores resultados do que uma lista estática de sinônimos.
Detalhes técnicos (correspondência lexical):
O servidor usa um pipeline de indexação multi-analisador e um pipeline de consulta ponderada de múltiplos campos para busca abrangente:
- Normalização Unicode — normalização NFKC, dobra de diacríticos, expansão de ligaduras via ICUFoldingFilter
- Otimização de curinga inicial — o campo
content_reversedarmazena tokens invertidos para consultas eficientes do tipo*vertrag - Curingas sem distinção de maiúsculas/minúsculas — termos curinga/prefixo são automaticamente convertidos para minúsculas
- Lematização OpenNLP — lematização baseada em dicionário para alemão e inglês, incluindo formas irregulares (ran→run, ging→gehen, paid→pay, analyses→analysis)
- Indexação bilíngue — campos de lema em alemão e inglês indexados para todos os documentos, permitindo correspondência em idiomas mistos
- Transliteração de umlaut alemão — o campo sombra
content_translit_demapeia dígrafos (Mueller→Müller) - Expansão automática de frases — frases exatas são automaticamente expandidas para incluir correspondências de proximidade (veja abaixo)
- Pontuação adaptativa de prefixo — pontuação BM25 para prefixos específicos (>= 4 caracteres)
Consulte PIPELINE.md para documentação completa da cadeia de analisadores, exemplos concretos e detalhes do pipeline de consulta.
O assistente de IA compensa as limitações restantes (sem expansão de sinônimos, sem correspondência fonética) expandindo consultas de forma inteligente.
Melhores práticas para melhores resultados:
-
Gere sinônimos você mesmo: Use OR para combinar termos relacionados:
- Em vez de:
contract - Use:
(contract OR agreement OR deal)
- Em vez de:
-
Use curingas para variações: Lide com diferentes formas de palavras:
- Em vez de:
contract - Use:
contract*(corresponde a contracts, contracting, contracted)
- Em vez de:
-
Aproveite os facetas: Use os valores de faceta retornados para descobrir termos exatos no índice:
- Verifique
facets.authorpara encontrar nomes exatos de autores - Verifique
facets.languagepara ver idiomas disponíveis - Use esses valores exatos para filtrar
- Verifique
-
Combine técnicas:
(contract* OR agreement*) AND (sign* OR execut*) AND author:"John Doe"
Sintaxe de consulta suportada (extendedSearch):
- Termos simples:
hello world(AND implícito entre termos) - Consultas de frase:
"exact phrase"(preserva a ordem das palavras) - Operadores booleanos:
term1 AND term2,term1 OR term2,NOT term - Curinga final:
contract*corresponde a contracts, contracting, contracted - Curinga inicial:
*vertragencontra eficientemente Arbeitsvertrag, Kaufvertrag (otimizado via campo de token reverso) - Curinga infixo:
*vertrag*encontra tanto Vertragsbedingungen quanto Arbeitsvertrag - Curinga de caractere único:
te?tcorresponde a test, text - Busca difusa:
term~2encontra termos dentro da distância de edição Levenshtein 2 (padrão: 2) - Busca por proximidade:
"term1 term2"~5encontra termos a até 5 palavras um do outro - Busca específica de campo:
title:hello content:world - Agrupamento:
(contract OR agreement) AND signed - Consultas de intervalo:
modified_date:[1609459200000 TO 1640995200000](carimbos de data/hora em milissegundos)
Expansão automática de proximidade de frases:
Consultas de frases com múltiplas palavras são automaticamente expandidas: "Domain Design" torna-se ("Domain Design")^2.0 OR ("Domain Design"~3). Correspondências exatas têm a maior pontuação (boost de 2,0x), enquanto correspondências aproximadas (a até 3 palavras) também aparecem com pontuações menores. Frases de uma única palavra e slop especificado pelo usuário não são expandidos.
Consulte PIPELINE.md para exemplos detalhados e configuração.
Pontuação adaptativa de consultas de prefixo:
Consultas de prefixo com >= 4 caracteres (vertrag*, design*) usam pontuação BM25 real, classificando termos mais curtos/frequentes acima de compostos longos. Prefixos mais curtos (ver*) usam pontuação constante por desempenho. Isso equilibra qualidade de classificação e velocidade automaticamente.
Consulte PIPELINE.md para exemplos de pontuação e detalhes técnicos.
Busca de palavras compostas em alemão:
Use curingas para compostos alemães: *vertrag encontra Arbeitsvertrag, vertrag* encontra Vertragsbedingungen. Curingas iniciais são otimizados via campo content_reversed.
Lematização automática:
A lematização OpenNLP lida com variações morfológicas automaticamente. Alemão: "Haus" encontra "Häuser", "gehen" encontra "ging". Inglês: "run" encontra "ran", "pay" encontra "paid". Correspondências exatas sempre têm a maior pontuação.
Suporte bilíngue:
Todos os documentos são indexados com campos de lema em alemão e inglês, permitindo correspondência em idiomas mistos. Documentos em alemão com termos técnicos em inglês ("Recommendation Engines") correspondem a consultas no singular ("Recommendation Engine") via o lematizador de inglês, e vice-versa.
Transliteração de umlaut alemão:
O campo content_translit_de mapeia dígrafos ASCII para umlauts: "Mueller" corresponde a "Müller", "Kaese" corresponde a "Käse".
Consulte PIPELINE.md para cadeias de analisadores completas, exemplos concretos de tokens e detalhes do pipeline de consulta.
Retornos:
- Resultados de documentos paginados, cada um contendo uma matriz
passagescom texto destacado e metadados de qualidade - Pontuações de relevância em nível de documento
facets: Valores de faceta e contagens do conjunto de resultados (usa DrillSideways quando filtros de faceta estão ativos, mostrando valores alternativos)activeFilters: Espelha ofiltersde entrada com ummatchCountpara cada filtro (contagem dos facetas, ou -1 para filtros de intervalo/não facetados)- Tempo de execução da busca em milissegundos (
searchTimeMs)
Exemplos de filtros:
// Browse all English PDFs
{ "query": null, "filters": [
    { "field": "language", "value": "en" },
    { "field": "file_extension", "value": "pdf" }
]}

// Date range filter
{ "query": "contract*", "filters": [
    { "field": "modified_date", "operator": "range", "from": "2024-01-01", "to": "2025-12-31" }
]}

// Multiple values with exclusion
{ "query": "report", "filters": [
    { "field": "file_extension", "operator": "in", "values": ["pdf", "docx"] },
    { "field": "language", "operator": "not", "value": "unknown" }
]}
Ferramentas de busca semântica (grupo: semantic)
As ferramentas de busca semântica exigem que VECTOR_MODEL esteja configurado (ex.: VECTOR_MODEL=e5-base).
semanticSearch
Busca semântica pura baseada em embeddings KNN. Encontra documentos semanticamente relacionados mesmo sem correspondências exatas de palavras-chave. Os resultados são ordenados por similaridade de cosseno. Requer VECTOR_MODEL configurado.
Parâmetros:
query(obrigatório): Consulta em linguagem natural — o servidor calcula um embedding e encontra os trechos de documento mais próximos.filters(opcional): Matriz de filtros estruturados (mesmo formato desimpleSearch/extendedSearch)page(opcional): Número da página, baseado em 0 (padrão: 0)pageSize(opcional): Resultados por página (padrão: 10, máximo: 100)similarityThreshold(opcional): Pontuação mínima de similaridade de cosseno para incluir um resultado (0,0–1,0, padrão: 0,70). Menor = mais resultados (correspondência mais ampla); maior = menos resultados (correspondência mais próxima).
Use profileSemanticSearch para ajustar similarityThreshold para seu corpus.
profileSemanticSearch
Ferramenta de depuração para busca semântica. Mostra tempo de embedding, pontuações de cosseno, trechos correspondentes e quantos candidatos passaram no limite de similaridade. Use esta ferramenta para ajustar similarityThreshold para seus dados.
Parâmetros:
query(obrigatório): Consulta em linguagem natural para perfilfilters(opcional): Matriz de filtros estruturadossimilarityThreshold(opcional): Limite a testar (0,0–1,0, padrão: 0,70)
Ferramentas de depuração (grupo: debug)
profileQuery
Analise e depure consultas simpleSearch / extendedSearch. Fornece insights detalhados sobre como o Lucene processa sua consulta, quais termos contribuem para a pontuação, como os filtros afetam os resultados e onde existem oportunidades de otimização.
Parâmetros:
query(opcional): A consulta de busca (mesma desimpleSearch/extendedSearch)filters(opcional): Matriz de filtros estruturados (mesma das ferramentas de busca)page(opcional): Número da página, baseado em 0 (padrão: 0)pageSize(opcional): Resultados por página (padrão: 10, máximo: 100)sortBy(opcional): Campo de ordenação (mesmo das ferramentas de busca)sortOrder(opcional): Ordem de ordenação (mesma das ferramentas de busca)queryMode(opcional):SIMPLE(padrão) ouEXTENDED— seleciona o modo do analisador de consulta para corresponder à ferramenta de busca que você está analisandoanalyzeFilterImpact(opcional): Setrue, analisa como cada filtro reduz a contagem de resultados. AVISO: Operação cara que requer múltiplas consultas. Padrão:falseanalyzeDocumentScoring(opcional): Setrue, fornece explicações detalhadas de pontuação para os principais documentos usando a API Explanation do Lucene. AVISO: Operação cara. Padrão:falseanalyzeFacetCost(opcional): Setrue, mede a sobrecarga de cálculo de facetas. AVISO: Operação cara. Padrão:falsemaxDocExplanations(opcional): Número máximo de documentos a explicar quandoanalyzeDocumentScoring=true(padrão: 5, máximo: 10)
Níveis de análise:
Nível 1: Análise rápida (sempre incluída)
- Estrutura da consulta e detalhamento de componentes
- Identificação do tipo de consulta (BooleanQuery, TermQuery, WildcardQuery, etc.)
- Custo estimado por componente da consulta
- Estatísticas de termos (frequência de documentos, IDF, classificação de raridade)
- Métricas de busca (total de resultados, porcentagem de redução por filtro) Nível 2: Análise de Impacto de Filtros (Opcional, Custoso)
- Mostra como cada filtro afeta a contagem de resultados
- Calcula a seletividade (baixa/média/alta/muito alta)
- Mede o tempo de execução por filtro
- Ajuda a identificar filtros redundantes ou ineficazes
Nível 3: Explicações de Pontuação de Documentos (Opcional, Custoso)
- Detalhamento de pontuação para os documentos mais bem classificados
- Mostra quais termos contribuem mais para a pontuação de cada documento
- Fornece resumos de pontuação legíveis para humanos
- Usa a API Explanation do Lucene, mas formatada para ser amigável a LLMs
Nível 4: Análise de Custo de Facetas (Opcional, Custoso)
- Mede a sobrecarga de computação de facetas
- Mostra o custo por dimensão de faceta
- Ajuda a decidir se a faceta deve ser desabilitada por questões de desempenho
Retorna:
Um objeto de análise estruturado contendo:
{
  success: boolean,
  queryAnalysis: {
    originalQuery: string,
    parsedQueryType: string,
    components: [{
      type: string,              // "TermQuery", "WildcardQuery", etc.
      field: string,
      value: string,
      occur: string,             // "MUST", "SHOULD", "FILTER", "MUST_NOT"
      estimatedCost: number,
      costDescription: string    // "~450 documents (moderate)"
    }],
    rewrites: [{                 // Query optimizations performed by Lucene
      original: string,
      rewritten: string,
      reason: string
    }],
    warnings: string[]
  },
  searchMetrics: {
    totalIndexedDocuments: number,
    documentsMatchingQuery: number,
    documentsAfterFilters: number,
    filterReductionPercent: number,
    termStatistics: {
      [term: string]: {
        term: string,
        documentFrequency: number,
        totalTermFrequency: number,
        idf: number,
        rarity: string           // "very common", "common", "uncommon", "rare"
      }
    }
  },
  filterImpact?: {               // Only if analyzeFilterImpact=true
    baselineHits: number,
    finalHits: number,
    filterImpacts: [{
      filter: {...},
      hitsBeforeFilter: number,
      hitsAfterFilter: number,
      documentsRemoved: number,
      reductionPercent: number,
      selectivity: string,       // "low", "medium", "high", "very high"
      executionTimeMs: number
    }],
    totalExecutionTimeMs: number
  },
  documentExplanations?: [{      // Only if analyzeDocumentScoring=true
    filePath: string,
    rank: number,
    score: number,
    scoringBreakdown: {
      totalScore: number,
      components: [{
        term: string,
        field: string,
        contribution: number,
        contributionPercent: number,
        details: {
          idf: number,
          tf: number,
          termFrequency: number,
          documentLength: number,
          averageDocumentLength: number,
          explanation: string
        }
      }],
      summary: string            // "Score dominated by term 'contract' (60.8%)"
    },
    matchedTerms: string[]
  }],
  facetCost?: {                  // Only if analyzeFacetCost=true
    facetingOverheadMs: number,
    facetingOverheadPercent: number,
    dimensions: {
      [dimension: string]: {
        dimension: string,
        uniqueValues: number,
        totalCount: number,
        computationTimeMs: number
      }
    }
  },
  recommendations: string[]      // Actionable optimization suggestions
}
Exemplo: Análise Básica de Consulta
Ask Claude: "Profile my search for 'contract AND signed' to understand its performance"
Isso executa uma análise rápida mostrando:
- Estrutura da consulta (consulta booleana AND com dois termos)
- Estatísticas dos termos (quão comuns são "contrato" e "assinado")
- Estimativas de custo (quantos documentos serão examinados)
- Recomendações de otimização
Exemplo: Análise Profunda com Pontuação
{
  "query": "(contract OR agreement) AND signed",
  "filters": [
    { "field": "language", "value": "en" },
    { "field": "modified_date", "operator": "range", "from": "2024-01-01" }
  ],
  "analyzeDocumentScoring": true,
  "maxDocExplanations": 3
}
Isso fornece explicações detalhadas de pontuação para os 3 principais documentos, mostrando:
- Quais termos corresponderam em cada documento
- Quanto cada termo contribuiu para a pontuação final
- Por que o documento A ficou classificado acima do documento B
Exemplo: Otimização de Filtros
{
  "query": "*",
  "filters": [
    { "field": "file_extension", "value": "pdf" },
    { "field": "language", "value": "en" },
    { "field": "file_type", "value": "application/pdf" }
  ],
  "analyzeFilterImpact": true
}
Isso analisa a eficácia dos filtros, potencialmente revelando:
file_extension=pdfreduz os resultados em 75% (alta seletividade)file_type=application/pdfreduz os resultados em 0% (redundante com file_extension)- Recomendação: Remover o filtro redundante
file_type
Exemplo: Entendendo a Expansão Automática de Frases
Quando você pesquisa por uma frase exata como "Domain Design", a consulta é automaticamente expandida para melhorar a recuperação, mantendo a precisão:
{
  "query": "\"Domain Design\"",
  "analyzeDocumentScoring": true,
  "maxDocExplanations": 3
}
O profiler revela como a consulta foi expandida:
Análise da Consulta:
- Consulta Original:
"Domain Design" - Tipo Analisado:
BooleanQuery - Reescrita: Expansão automática de proximidade de frases (correspondência exata com boost + variantes de proximidade)
- Componentes da Consulta:
PhraseQuery (boost=4.0)-"domain design"(correspondência exata, maior boost)PhraseQuery (boost=2.0)-"domain design"~3(correspondência de proximidade, slop=3)- Variantes adicionais com stemming e boosts menores
Pontuação de Documentos:
- Correspondência exata ("Domain Design"): Pontuação 0.81 - corresponde a ambas as cláusulas, a cláusula exata domina
- Correspondência de proximidade ("Domain-driven Design"): Pontuação 0.15 - corresponde apenas à cláusula de proximidade
- Correspondência de proximidade ("Domain Effective Design"): Pontuação 0.15 - corresponde apenas à cláusula de proximidade
Isso mostra:
- Correspondências exatas ficam no topo devido ao boost acumulado de 4.0x (2.0 do stemming x 2.0 da expansão de frase)
- Correspondências de proximidade ainda são encontradas com slop=3 (permitindo até 3 palavras entre os termos)
- Separação clara de pontuação entre correspondências exatas e de proximidade garante precisão
Notas de Desempenho:
- Análise básica (padrão): Muito rápida, sobrecarga insignificante (~5-10ms)
- Análise de impacto de filtros: Requer consultas N+1, onde N é o número de filtros. Pode levar segundos para conjuntos de filtros complexos.
- Análise de pontuação de documentos: Requer que o Lucene compute objetos Explanation completos. O custo cresce com
maxDocExplanations. - Análise de custo de facetas: Requer computação de facetas. O custo depende do número de valores de faceta únicos.
Melhores Práticas:
- Comece com análise básica (sem flags opcionais) para obter insights rápidos
- Habilite análises custosas apenas ao depurar problemas específicos de desempenho
- Use
analyzeDocumentScoringpara entender por que certos documentos ficam bem classificados - Use
analyzeFilterImpactpara otimizar a ordem dos filtros e remover filtros redundantes - Preste atenção ao array
recommendationspara dicas de otimização acionáveis
Ferramentas de Crawler (grupo: crawler)
startCrawl
Inicia o rastreamento dos diretórios configurados para indexar documentos.
Parâmetros:
fullReindex(opcional): Se verdadeiro, limpa o índice antes de rastrear (padrão: falso). Quando falso ereconciliation-enabledé verdadeiro, um rastreamento incremental é realizado.
Recursos:
- Extrai automaticamente conteúdo de PDFs, documentos do Office e arquivos do OpenOffice
- Detecta o idioma do documento
- Extrai metadados (autor, título, data de criação, etc.)
- Processamento multithread para indexação rápida
- Notificações de progresso durante o rastreamento
- Modo incremental (padrão): Apenas arquivos novos ou modificados são indexados; arquivos excluídos são removidos do índice automaticamente. Recorre a um rastreamento completo se a reconciliação encontrar um erro.
getCrawlerStats
Obtém estatísticas em tempo real sobre o progresso do crawler.
Retorna:
filesFound: Total de arquivos descobertosfilesProcessed: Arquivos processados até agorafilesIndexed: Arquivos indexados com sucessofilesFailed: Arquivos que falharam ao processarbytesProcessed: Total de bytes processadosfilesPerSecond: Taxa de transferência de processamentomegabytesPerSecond: Taxa de transferência de dadoselapsedTimeMs: Tempo decorrido desde o início do rastreamentoperDirectoryStats: Estatísticas detalhadas por diretórioorphansDeleted: Número de entradas de índice removidas porque o arquivo não existe mais no disco (modo incremental)filesSkippedUnchanged: Número de arquivos ignorados porque não foram modificados desde o último rastreamento (modo incremental)reconciliationTimeMs: Tempo gasto comparando o índice com o sistema de arquivos (modo incremental)crawlMode: Ou"full"ou"incremental"currentlyProcessing: Array de arquivos atualmente sendo processados (extraídos/indexados). Cada entrada contém:filePath: Caminho completo para o arquivo sendo processadoprocessingDurationMs: Há quanto tempo o arquivo está sendo processado (em milissegundos)
lastCrawlCompletionTimeMs: Timestamp Unix (ms) da última conclusão bem-sucedida do rastreamento (nulo se não houver rastreamento anterior)lastCrawlDocumentCount: Número de documentos no índice após o último rastreamento bem-sucedido (nulo se não houver rastreamento anterior)lastCrawlMode: Modo do último rastreamento -"full"ou"incremental"(nulo se não houver rastreamento anterior)
getCrawlerStatus
Obtém o estado atual do crawler.
Retorna:
state: Um deIDLE,CRAWLING,PAUSEDouWATCHING
pauseCrawler
Pausa uma operação de rastreamento em andamento. O crawler pode ser retomado posteriormente com resumeCrawler.
resumeCrawler
Retoma uma operação de rastreamento pausada.
listCrawlableDirectories
Lista todos os diretórios rastreáveis configurados.
Retorna:
success: Booleano indicando sucesso da operaçãodirectories: Lista de caminhos absolutos de diretórios atualmente configuradostotalDirectories: Contagem de diretórios configuradosconfigPath: Caminho para o arquivo de configuração (~/.mcplucene/config.yaml)environmentOverride: Booleano indicando se a variável de ambienteLUCENE_CRAWLER_DIRECTORIESestá definida
Exemplo de resposta:
{
  "success": true,
  "directories": [
    "/Users/yourname/Documents",
    "/Users/yourname/Downloads"
  ],
  "totalDirectories": 2,
  "configPath": "/Users/yourname/.mcplucene/config.yaml",
  "environmentOverride": false
}
addCrawlableDirectory
Adiciona um diretório à configuração do crawler.
Parâmetros:
path(obrigatório): Caminho absoluto para o diretório a ser rastreadocrawlNow(opcional): Se verdadeiro, inicia imediatamente o rastreamento do novo diretório (padrão: falso)
Retorna:
success: Booleano indicando sucesso da operaçãomessage: Mensagem de confirmaçãototalDirectories: Contagem atualizada de diretórios configuradosdirectories: Lista atualizada de todos os diretórioscrawlStarted(opcional): Presente secrawlNow=true, indica que o rastreamento foi acionado
Validação:
- O diretório deve existir e ser acessível
- O caminho deve ser um diretório (não um arquivo)
- Diretórios duplicados são impedidos
- Falha se a variável de ambiente
LUCENE_CRAWLER_DIRECTORIESestiver definida
Exemplo:
Ask Claude: "Add /Users/yourname/Documents as a crawlable directory"
Ask Claude: "Add /path/to/research and crawl it now"
Persistência da Configuração:
O diretório é imediatamente salvo em ~/.mcplucene/config.yaml e será rastreado automaticamente em futuras reinicializações do servidor.
removeCrawlableDirectory
Remove um diretório da configuração do crawler.
Parâmetros:
path(obrigatório): Caminho absoluto para o diretório a ser removido
Retorna:
success: Booleano indicando sucesso da operaçãomessage: Mensagem de confirmaçãototalDirectories: Contagem atualizada de diretórios configuradosdirectories: Lista atualizada dos diretórios restantes
Notas Importantes:
- Isso NÃO remove documentos já indexados do diretório removido
- Para remover documentos indexados, use
startCrawl(fullReindex=true)após remover os diretórios - Falha se a variável de ambiente
LUCENE_CRAWLER_DIRECTORIESestiver definida - O diretório deve existir na configuração atual
Exemplo:
Ask Claude: "Stop crawling /Users/yourname/Downloads"
Ask Claude: "Remove /path/to/old/archive from the crawler"
Ferramentas de Informações do Índice (grupo: info)
getIndexStats
Obtém estatísticas sobre o índice Lucene, incluindo métricas de desempenho do cache do lematizador, percentis de tempo de execução de consultas (p50-p99) e tempo de computação de facetas por campo.
Retorna:
documentCount: Número total de documentos no índiceindexPath: Caminho para o diretório do índiceschemaVersion: Versão atual do esquema do índicesoftwareVersion: Versão do software do servidorbuildTimestamp: Timestamp de build do servidordateFieldHints: Intervalos de data mín/máx para campos de data (created_date,modified_date,indexed_date) no formato ISO-8601 — útil para construir filtros de intervalo de datassortableFields: Mapa de camposdbmeta_*ordenáveis registrados dinamicamente a partir do enriquecimento de metadados JDBC para seu tipo de ordenação ("numeric"ou"keyword"). Nulo quando nenhum enriquecimento JDBC registrou campos ordenáveis. Use isso para descobrir quais camposdbmeta_*podem ser passados comosortBy. Campos nativos (file_size,created_date,modified_date) são sempre ordenáveis e não estão listados aqui.lemmatizerCacheMetrics: Métricas de desempenho para os caches do lematizador OpenNLP (um por idioma: alemão e inglês)language: Código do idioma (de ou en)hitRate: Taxa de acerto do cache como porcentagem (ex.: "85,3%")totalHits: Número de vezes que um token foi encontrado no cachetotalMisses: Número de vezes que um token exigiu lematizaçãocacheSize: Número atual de entradas no cacheevictions: Número de entradas de cache removidas devido a limites de tamanho
queryRuntimeMetrics: Estatísticas agregadas de desempenho de consultas de busca (nulo antes de qualquer busca ser executada)totalQueries: Número total de consultas de busca executadas desde o início do servidoraverageDurationMs: Duração média de consulta em milissegundos (ex.: "12,5")minDurationMs: Duração de consulta mais rápida em milissegundosmaxDurationMs: Duração de consulta mais lenta em milissegundosaverageHitCount: Número médio de documentos correspondentes por consulta (ex.: "42,3")p50Ms/p75Ms/p90Ms/p95Ms/p99Ms: Percentis de duração de consulta em milissegundos (calculados a partir das últimas 1000 consultas)averageFacetDurationMs: Tempo médio de computação de facetas por consulta em milissegundos (ex.: "0,125")perFieldAverageFacetDurationMs: Tempo médio de computação de facetas por campo em milissegundos (ex.:{"language": "0.031", "file_extension": "0.028", ...})
Desempenho do Cache do Lematizador:
O servidor usa cache de token único para lematização OpenNLP para reduzir o uso de CPU durante indexação e consultas. Cada analisador de idioma (alemão e inglês) mantém um cache LRU compartilhado com até 1.500.000 entradas, compartilhado entre todas as threads de indexação do Lucene. O cache usa chaves insensíveis a maiúsculas/minúsculas para palavras comuns (ex.: "Vertrag" e "vertrag" compartilham a mesma entrada de cache), mantendo nomes próprios sensíveis a maiúsculas/minúsculas (ex.: "Berlin" vs "berlin").
Métricas Principais:
- Taxa de Acerto: Quanto maior, melhor. 85-95% é típico após indexar alguns milhares de documentos. Taxas de acerto mais altas significam menos uso de CPU.
- Tamanho do Cache: Número atual de mapeamentos (token, POS tag) para lema em cache. Cresce até 1.500.000 entradas por idioma.
- Remoções: Quantas entradas foram removidas para abrir espaço para novas. Algumas remoções são normais com grandes conjuntos de documentos. Impacto no desempenho: Sem cache, a lematização pode consumir 70-80% da CPU durante a indexação. Com cache, o uso de CPU normalmente cai para 20-30%, resultando em uma taxa de indexação 2-3x mais rápida para conjuntos de documentos com vocabulário repetitivo.
listIndexedFields
Lista todos os nomes de campos presentes no índice Lucene.
Retorna:
fields: Matriz de nomes de campos disponíveis para busca e filtragem
Exemplo de resposta:
{
  "success": true,
  "fields": [
    "file_name",
    "file_path",
    "title",
    "author",
    "content",
    "language",
    "file_extension",
    "file_type",
    "created_date",
    "modified_date"
  ]
}
getDocumentDetails
Recupera todos os campos armazenados e o conteúdo completo de um documento do índice Lucene pelo seu caminho de arquivo. Esta ferramenta recupera detalhes do documento diretamente do índice sem exigir acesso ao sistema de arquivos — útil para examinar conteúdo indexado mesmo se o arquivo original foi movido ou excluído.
Parâmetros:
filePath(obrigatório): Caminho absoluto para o arquivo (deve corresponder exatamente aofile_patharmazenado no índice)
Retorna:
success: Booleano indicando sucesso da operaçãodocument: Objeto contendo todos os campos armazenados:file_path: Caminho completo para o arquivofile_name: Nome do arquivofile_extension: Extensão do arquivo (ex.:pdf,docx)file_type: Tipo MIMEfile_size: Tamanho do arquivo em bytestitle: Título do documentoauthor: Nome do autorcreator: Aplicativo criadorsubject: Assunto do documentokeywords: Palavras-chave/etiquetas do documentolanguage: Código de idioma detectadocreated_date: Carimbo de data/hora de criaçãomodified_date: Carimbo de data/hora de modificaçãoindexed_date: Carimbo de data/hora de indexaçãocontent_hash: Hash SHA-256 do conteúdocontent: Conteúdo de texto extraído completo (limitado a 500KB)contentTruncated: Booleano indicando se o conteúdo foi truncadooriginalContentLength: Tamanho original do conteúdo (presente apenas se truncado)
Limite de tamanho do conteúdo:
O campo content é limitado a 500.000 caracteres (500KB) para garantir que a resposta permaneça com segurança abaixo do limite de resposta MCP de 1MB. Verifique o campo contentTruncated para determinar se o conteúdo completo foi retornado.
Exemplo:
Ask Claude: "Show me the indexed details of /Users/yourname/Documents/report.pdf"
Ask Claude: "What content was extracted from /path/to/contract.docx?"
Exemplo de resposta:
{
  "success": true,
  "document": {
    "file_path": "/Users/yourname/Documents/report.pdf",
    "file_name": "report.pdf",
    "file_extension": "pdf",
    "file_type": "application/pdf",
    "file_size": "125432",
    "title": "Annual Report 2024",
    "author": "John Doe",
    "language": "en",
    "indexed_date": "1706540400000",
    "content_hash": "a1b2c3d4...",
    "content": "This is the full extracted text content of the document...",
    "contentTruncated": false
  }
}
Ferramentas de Observabilidade (grupo: observability)
suggestTerms
Sugere termos do índice que correspondem a um prefixo. Útil para descobrir vocabulário, encontrar palavras compostas em alemão, explorar nomes de autores ou preencher automaticamente valores de campos.
Parâmetros:
field(obrigatório): Nome do campo para sugerir termos (ex.:content,author,file_extension)prefix(obrigatório): Prefixo para corresponder aos termos (ex.:verpara encontrarvertrag,version)limit(opcional): Número máximo de termos a retornar (padrão: 20, máximo: 100)
Observações:
- Para campos analisados (
content,title, etc.), o prefixo é automaticamente convertido para minúsculas para corresponder aos tokens indexados - Para StringFields (
file_extension,language), o prefixo é usado como está (correspondência exata) - Campos numéricos/de data (
file_size,modified_date, etc.) não são suportados — usegetIndexStatspara intervalos de data - Retorna termos ordenados por frequência no documento (mais comuns primeiro)
- Retorna resultados vazios para campos inexistentes (não é um erro)
Exemplo — descobrir palavras compostas em alemão:
{
  "field": "content",
  "prefix": "vertrag",
  "limit": 10
}
Exemplo de resposta:
{
  "success": true,
  "field": "content",
  "prefix": "vertrag",
  "terms": [
    {"term": "vertrag", "docFreq": 45},
    {"term": "vertrags", "docFreq": 23},
    {"term": "vertragsklausel", "docFreq": 8},
    {"term": "vertragsbedingungen", "docFreq": 5}
  ],
  "totalTermsMatched": 4
}
getTopTerms
Obtém os termos mais frequentes em um campo. Útil para entender o vocabulário do índice, descobrir valores comuns (idiomas, tipos de arquivo, autores) e identificar termos dominantes.
Parâmetros:
field(obrigatório): Nome do campo para obter os principais termos (ex.:content,author,file_extension)limit(opcional): Número máximo de termos a retornar (padrão: 20, máximo: 100)
Observações:
- Retorna termos ordenados por frequência no documento (mais comuns primeiro)
- Para campos de conteúdo grandes (>100K termos únicos), um aviso é incluído sugerindo
suggestTermsem vez disso - Campos numéricos/de data não são suportados — use
getIndexStatspara intervalos de data - Retorna resultados vazios para campos inexistentes (não é um erro)
Exemplo — explorar tipos de arquivo no índice:
{
  "field": "file_extension",
  "limit": 10
}
Exemplo de resposta:
{
  "success": true,
  "field": "file_extension",
  "terms": [
    {"term": "pdf", "docFreq": 234},
    {"term": "docx", "docFreq": 156},
    {"term": "txt", "docFreq": 89},
    {"term": "md", "docFreq": 45}
  ],
  "uniqueTermCount": 12
}
Exemplo — explorar vocabulário de conteúdo:
{
  "field": "content",
  "limit": 20
}
Ferramentas de Administração (grupo: admin)
indexAdmin
Um aplicativo MCP que fornece uma interface visual de usuário para tarefas de manutenção do índice diretamente dentro do seu cliente MCP (ex.: Claude Desktop). Quando invocado, o aplicativo é renderizado inline na conversa e oferece acesso com um clique a operações administrativas sem exigir chamadas manuais de ferramentas.
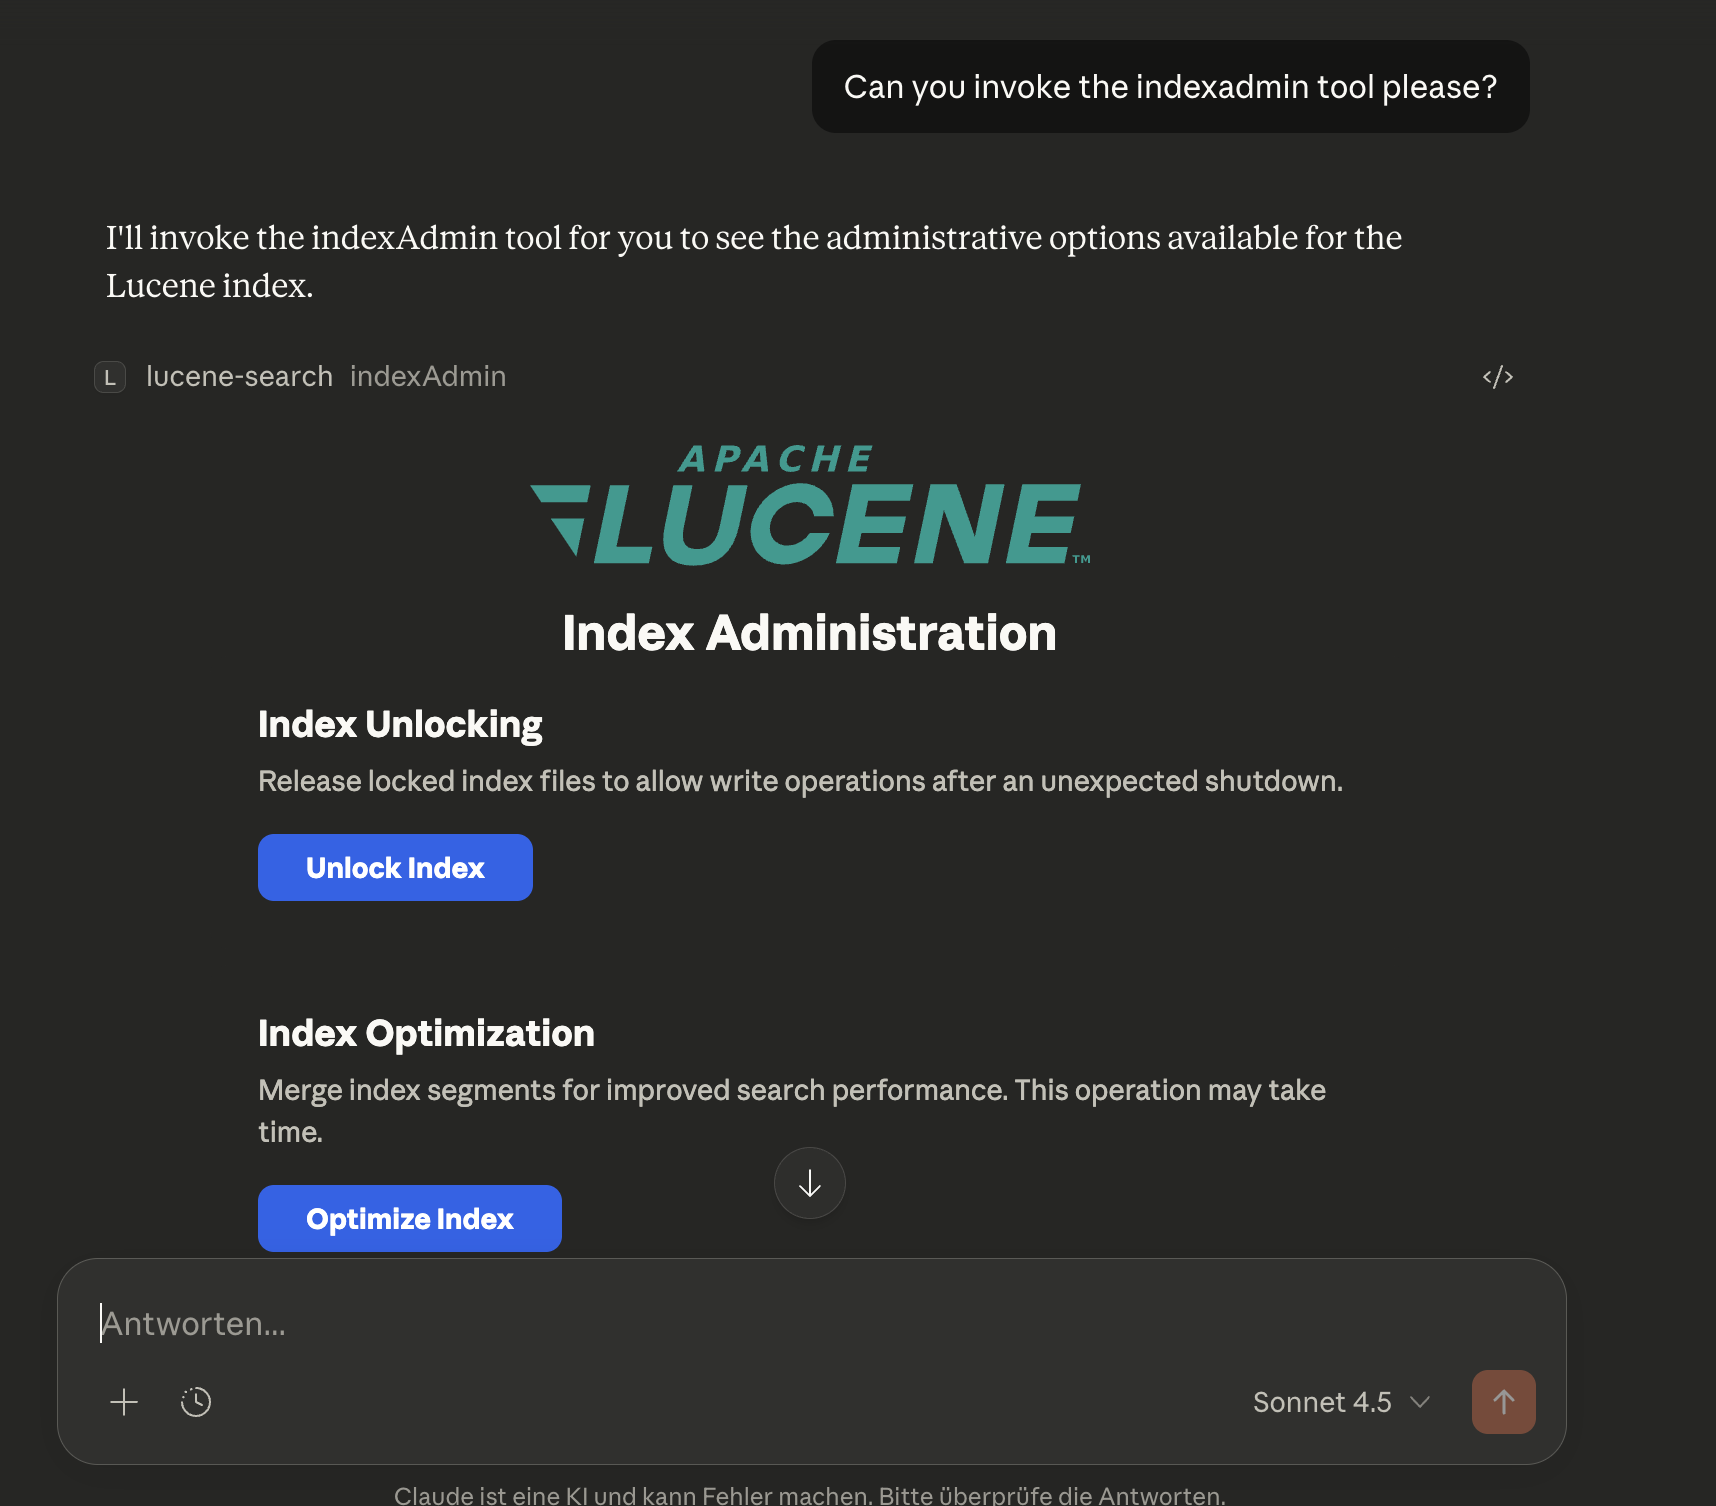
Ações disponíveis:
- Desbloquear Índice — Remove um arquivo
write.lockobsoleto após um desligamento inadequado (equivalente a chamarunlockIndexcomconfirm=true) - Otimizar Índice — Mescla segmentos do índice para melhorar o desempenho de busca (equivalente a chamar
optimizeIndex) - Purgar Índice — Exclui todos os documentos do índice (equivalente a chamar
purgeIndexcomconfirm=true)
Cada ação mostra feedback de status inline (sucesso, erro ou detalhes de progresso) diretamente na interface do aplicativo.
Exemplo:
Ask Claude: "Can you invoke the indexAdmin tool please?"
optimizeIndex
Otimiza o índice Lucene mesclando segmentos. Esta é uma operação de longa duração que é executada em segundo plano.
Parâmetros:
maxSegments(opcional): Número alvo de segmentos após a otimização (padrão: 1 para otimização máxima)
Retorna:
success: Booleano indicando que a operação foi iniciadaoperationId: UUID para rastrear a operaçãotargetSegments: A contagem alvo de segmentoscurrentSegments: A contagem atual de segmentos antes da otimizaçãomessage: Mensagem de status
Comportamento:
- Retorna imediatamente após iniciar a operação em segundo plano
- Use
getIndexAdminStatuspara consultar o progresso - Não pode ser executado enquanto o rastreador está ativamente rastreando
- Apenas uma operação administrativa pode ser executada por vez
Exemplo:
Ask Claude: "Optimize the search index"
Ask Claude: "What's the status of the optimization?"
Observações de desempenho:
- A otimização melhora o desempenho de busca reduzindo o número de segmentos
- Aumenta temporariamente o uso de disco durante a mesclagem
- Para índices grandes, isso pode levar de vários minutos a horas
purgeIndex
Exclui todos os documentos do índice Lucene. Esta é uma operação destrutiva e de longa duração que é executada em segundo plano.
Parâmetros:
confirm(obrigatório): Deve ser definido comotruepara prosseguir. Esta é uma medida de segurança.fullPurge(opcional): Setrue, também exclui arquivos de índice e reinicializa (padrão:false)
Retorna:
success: Booleano indicando que a operação foi iniciadaoperationId: UUID para rastrear a operaçãodocumentsDeleted: Número de documentos que serão excluídosfullPurge: Se uma purga completa foi solicitadamessage: Mensagem de status
Comportamento:
- Retorna imediatamente após iniciar a operação em segundo plano
- Use
getIndexAdminStatuspara consultar o progresso - Apenas uma operação administrativa pode ser executada por vez
Modos de purga:
- Purga padrão (
fullPurge=false): Exclui todos os documentos, mas mantém os arquivos de índice. O espaço em disco é recuperado gradualmente durante mesclagens futuras. - Purga completa (
fullPurge=true): Exclui todos os documentos E arquivos de índice, depois reinicializa um índice vazio. O espaço em disco é recuperado imediatamente.
Exemplo:
Ask Claude: "Delete all documents from the index - I confirm this"
Ask Claude: "Purge the index completely and reclaim disk space - I confirm this"
Aviso: Esta operação não pode ser desfeita. Todos os documentos indexados serão excluídos permanentemente. Você precisará rastrear novamente os diretórios para repovoar o índice.
unlockIndex
Remove o arquivo write.lock do diretório do índice Lucene. Esta é uma operação de recuperação perigosa — use apenas se tiver certeza de que nenhum outro processo está usando o índice.
Parâmetros:
confirm(obrigatório): Deve ser definido comotruepara prosseguir. Esta é uma medida de segurança.
Retorna:
success: Booleano indicando sucesso da operaçãomessage: Mensagem de confirmaçãolockFileExisted: Booleano indicando se um arquivo de bloqueio estava presentelockFilePath: Caminho para o arquivo de bloqueio
Quando usar:
Use esta ferramenta quando o servidor falhar ao iniciar com um LockObtainFailedException após um desligamento inadequado. Consulte Solução de problemas para detalhes.
Exemplo:
Ask Claude: "Unlock the Lucene index - I confirm this is safe"
Aviso: Desbloquear um índice que está sendo ativamente gravado por outro processo pode causar corrupção de dados. Use apenas quando tiver certeza de que o bloqueio está obsoleto.
getIndexAdminStatus
Obtém o status de operações administrativas de longa duração do índice (otimizar, purgar).
Parâmetros: Nenhum
Retorna:
success: Booleano indicando que o status foi recuperadostate: Estado atual:IDLE,OPTIMIZING,PURGING,COMPLETEDouFAILEDoperationId: UUID da operação atual/últimaprogressPercent: Porcentagem de progresso (0-100)progressMessage: Mensagem de progresso legível por humanoselapsedTimeMs: Tempo decorrido desde o início da operação (em milissegundos)lastOperationResult: Mensagem de resultado da última operação concluída
Exemplo de resposta (durante otimização):
{
  "success": true,
  "state": "OPTIMIZING",
  "operationId": "a1b2c3d4-...",
  "progressPercent": 45,
  "progressMessage": "Merging segments...",
  "elapsedTimeMs": 12500,
  "lastOperationResult": null
}
Exemplo de resposta (ocioso após conclusão):
{
  "success": true,
  "state": "IDLE",
  "operationId": null,
  "progressPercent": null,
  "progressMessage": "No admin operation running",
  "elapsedTimeMs": null,
  "lastOperationResult": "Optimization completed successfully. Merged to 1 segment(s)."
}
Exemplo:
Ask Claude: "What's the status of the index optimization?"
Ask Claude: "Is the purge operation complete?"
Configuração de Exposição de Ferramentas
Controle quais ferramentas MCP são expostas usando duas variáveis de ambiente:
| Variável | Padrão | Descrição |
|---|---|---|
LUCENE_TOOLS_INCLUDE | * (todas as ferramentas) | Nomes de ferramentas separados por vírgula ou abreviações de grupo para expor |
LUCENE_TOOLS_EXCLUDE | (vazio) | Nomes de ferramentas separados por vírgula ou abreviações de grupo para ocultar; sempre vence sobre incluir |
Grupos de Ferramentas
| Grupo | Ferramentas |
|---|---|
search | simpleSearch, extendedSearch |
semantic | semanticSearch, profileSemanticSearch |
debug | profileQuery |
info | getIndexStats, listIndexedFields, getDocumentDetails |
observability | suggestTerms, getTopTerms |
crawler | startCrawl, getCrawlerStats, getCrawlerStatus, pauseCrawler, resumeCrawler, listCrawlableDirectories, addCrawlableDirectory, removeCrawlableDirectory |
admin | optimizeIndex, purgeIndex, unlockIndex, getIndexAdminStatus, indexAdmin |
Nomes individuais de ferramentas podem ser usados além das abreviações de grupo.
Exemplos
# Default — all tools (semantic tools require VECTOR_MODEL)
java -jar mcpluceneserver.jar

# Small LLM — search tools only
LUCENE_TOOLS_INCLUDE=search java -jar mcpluceneserver.jar

# Search + semantic search
LUCENE_TOOLS_INCLUDE=search,semantic VECTOR_MODEL=e5-base java -jar mcpluceneserver.jar

# All tools except destructive admin
LUCENE_TOOLS_EXCLUDE=purgeIndex,unlockIndex java -jar mcpluceneserver.jar

# All tools except entire admin group
LUCENE_TOOLS_EXCLUDE=admin java -jar mcpluceneserver.jar
Esquema de Campos do Índice
Quando os documentos são indexados pelo rastreador, os seguintes campos são automaticamente extraídos e armazenados:
Campos de Conteúdo
content: Texto completo do documento (analisado, pesquisável)content_reversed: Tokens invertidos do conteúdo (analisados comReverseUnicodeNormalizingAnalyzer, não armazenados). Usados internamente para consultas eficientes de curinga à esquerda -- não diretamente pesquisáveis pelos usuários.content_lemma_de: Tokens lematizados usando o lematizador OpenNLP alemão (analisados comOpenNLPLemmatizingAnalyzer, não armazenados). SEMPRE presente para TODOS os documentos, independentemente do idioma detectado, para permitir correspondência em idiomas mistos. Usado internamente para busca baseada em lematização -- não diretamente pesquisável pelos usuários.content_lemma_en: Tokens lematizados usando o lematizador OpenNLP inglês (analisados comOpenNLPLemmatizingAnalyzer, não armazenados). SEMPRE presente para TODOS os documentos, independentemente do idioma detectado, para permitir correspondência em idiomas mistos. Usado internamente para busca baseada em lematização -- não diretamente pesquisável pelos usuários.content_translit_de: Campo de sombra de transliteração alemã que mapeia dígrafos de trema (ae→ä, oe→ö, ue→ü) antes da normalização Unicode padrão (analisado comGermanTransliteratingAnalyzer, não armazenado). SEMPRE presente para TODOS os documentos. Permite consultas de dígrafos ASCII como "Mueller" corresponderem a documentos com trema como "Müller". Usado internamente -- não diretamente pesquisável pelos usuários.passages: Matriz de passagens destacadas retornadas nos resultados de busca (veja Formato de Resposta de Busca abaixo)
Informações do Arquivo
file_path: Caminho completo para o arquivo (ID único)file_name: Nome do arquivofile_extension: Extensão do arquivo (ex.:pdf,docx)file_type: Tipo MIME (ex.:application/pdf)file_size: Tamanho do arquivo em bytes
Metadados do Documento
title: Título do documento (extraído dos metadados)author: Nome do autorcreator: Criador/aplicativo que criou o documentosubject: Assunto do documentokeywords: Palavras-chave/etiquetas do documento
Idioma e Datas
language: Código de idioma detectado automaticamente (ex.:en,de,fr)created_date: Carimbo de data/hora de criação do arquivomodified_date: Carimbo de data/hora de modificação do arquivoindexed_date: Quando o documento foi indexado
Técnico
content_hash: Hash SHA-256 para detecção de alterações
Formato de Resposta de Busca
Os resultados de busca são otimizados para respostas MCP (< 1 MB) e incluem:
{
  "success": true,
  "documents": [
    {
      "score": 0.85,
      "file_name": "example.pdf",
      "file_path": "/path/to/example.pdf",
      "title": "Example Document",
      "author": "John Doe",
      "language": "en",
      "passages": [
        {
          "text": "...relevant <em>search term</em> highlighted in context...",
          "score": 1.0,
          "matchedTerms": ["search term"],
          "termCoverage": 1.0,
          "position": 0.12,
          "source": "keyword"
        },
        {
          "text": "...another occurrence of <em>search</em> in a later section...",
          "score": 0.75,
          "matchedTerms": ["search"],
          "termCoverage": 0.5,
          "position": 0.67,
          "source": "keyword"
        }
      ]
    }
  ],
  "totalHits": 42,
  "page": 0,
  "pageSize": 10,
  "totalPages": 5,
  "hasNextPage": true,
  "hasPreviousPage": false,
  "searchTimeMs": 12,
  "facets": {
    "language": [
      { "value": "en", "count": 25 },
      { "value": "de", "count": 12 },
      { "value": "fr", "count": 5 }
    ],
    "file_extension": [
      { "value": "pdf", "count": 30 },
      { "value": "docx", "count": 8 },
      { "value": "xlsx", "count": 4 }
    ],
    "file_type": [
      { "value": "application/pdf", "count": 30 },
      { "value": "application/vnd.openxmlformats-officedocument.wordprocessingml.document", "count": 8 }
    ],
    "author": [
      { "value": "John Doe", "count": 15 },
      { "value": "Jane Smith", "count": 10 }
    ]
  },
  "_search": {
    "query": "contract",
    "filters": [],
    "page": 0,
    "pageSize": 10
  },
  "_actions": [
    {
      "type": "nextPage",
      "tool": "simpleSearch",
      "parameters": { "query": "contract", "filters": [], "page": 1, "pageSize": 10 }
    },
    {
      "type": "drillDown",
      "tool": "simpleSearch",
      "parameters": { "query": "contract", "filters": [{ "field": "language", "operator": "eq", "value": "en" }], "page": 0, "pageSize": 10 },
      "hits": 25
    }
  ]
}
Cada documento em documents[] também carrega seu próprio bloco _actions:
{
  "score": 0.85,
  "file_path": "/path/to/example.pdf",
  "_actions": [
    {
      "type": "fetchContent",
      "tool": "getDocumentDetails",
      "parameters": { "filePath": "/path/to/example.pdf" }
    }
  ]
}
_actions Estilo HATEOAS (Encadeamento de LLM):
Cada resposta de busca inclui dois blocos de ação pré-calculados que permitem que um LLM encadeie chamadas de ferramenta sem raciocinar sobre o mapeamento de parâmetros:
-
_search-- Captura o estado exato da busca (consulta, filtros, página, pageSize) usado para produzir esta resposta. Útil para introspecção e para construir consultas de acompanhamento. -
_actionsem nível de resposta -- Contém chamadas de ferramenta prontas para uso para navegar pelo conjunto de resultados:Tipo de ação Quando presente Descrição prevPagepage > 0 Ir para a página anterior de resultados. Passe parametersdiretamente para otoolnomeado.nextPagehasNextPage = true Ir para a próxima página de resultados. Passe parametersdiretamente para otoolnomeado.drillDownfacetas disponíveis Restringir resultados adicionando um valor de faceta como filtro. O campo hitsmostra a contagem esperada de resultados. Limitado aos 2 principais valores por dimensão de faceta; apenas valores que ainda não estão ativos como filtros são incluídos. -
_actionsem nível de documento -- Cada documento emdocuments[]inclui:Tipo de ação Descrição fetchContentBuscar o texto completo do documento e metadados usando getDocumentDetails. OfilePathé pré-preenchido.
Para usar uma ação, chame o tool nomeado na ação com o mapa parameters passado como está — nenhuma transformação necessária.
Principais Recursos:
-
Métricas de Desempenho de Busca: Cada resposta de busca inclui
searchTimeMsmostrando o tempo exato de execução em milissegundos, permitindo monitoramento de desempenho e otimização. -
Passagens com Destaque: O campo completo
contentNÃO é incluído nos resultados de busca para manter os tamanhos de resposta gerenciáveis. Em vez disso, cada documento contém uma matrizpassagescom atémax-passages(padrão: 3) trechos destacados individualmente. Cada passagem é um trecho separado em nível de frase (não uma única string concatenada), ordenado por relevância (melhor primeiro). Passagens longas são truncadas paramax-passage-char-length(padrão: 200) centralizadas em torno dos termos destacados, removendo texto irrelevante no início/fim. Cada passagem inclui:text-- O trecho destacado com termos correspondentes envolvidos em tags<em>.score-- Pontuação de relevância normalizada (0.0-1.0), derivada da pontuação de passagem BM25 do Lucene. A melhor passagem pontua 1.0; outras passagens são pontuadas em relação à melhor.matchedTerms-- Os termos de consulta distintos que aparecem nesta passagem (extraídos das tags<em>). Úteis para entender quais partes de uma consulta de múltiplos termos uma passagem satisfaz.termCoverage-- A fração de todos os termos da consulta presentes nesta passagem (0.0-1.0). Um valor de 1.0 significa que todos os termos da consulta corresponderam. LLMs podem usar isso para preferir passagens que atendam à consulta completa.position-- Localização dentro do documento de origem (0.0 = início, 1.0 = fim), derivada do deslocamento de caracteres da passagem. Útil para citações ou para entender a estrutura do documento.source-- Indica como esta passagem foi produzida:"keyword"significa que o realçador BM25 encontrou correspondências de termos no texto do documento indexado;"semantic"significa que o melhor trecho vetorial correspondente foi usado como o trecho (relevante porque o documento foi recuperado por similaridade vetorial, mesmo que as palavras exatas da consulta não apareçam no texto).
-
Facetamento Lucene: O objeto
facetsusa SortedSetDocValues do Lucene para busca facetada eficiente. Mostra valores reais de facetas e contagens de documentos dos resultados de busca, não apenas campos disponíveis. Apenas dimensões de facetas que possuem valores no conjunto de resultados são retornadas. -
Dimensões de Facetas: Os seguintes campos são indexados como facetas:
language- Idioma do documento detectado (código ISO 639-1)file_extension- Extensão do arquivo (pdf, docx, etc.)file_type- Tipo MIMEauthor- Autor do documento (multivalorado)
Exemplos de Busca Facetada
Use facetas para criar consultas de drill-down e refinar os resultados da busca:
# Filter by file type using facet values
filters: [{ field: "file_extension", value: "pdf" }]

# Filter by language using facet values
filters: [{ field: "language", value: "de" }]

# Filter by author using facet values
filters: [{ field: "author", value: "John Doe" }]

# Combine search query with facet filter
query: "contract agreement"
filters: [{ field: "file_extension", value: "pdf" }]
Fluxo de Trabalho Orientado por Facetas:
- Realize a busca inicial com uma consulta ampla
- Revise
facetsna resposta para ver as opções de refinamento disponíveis - Aplique filtros usando valores de facetas para restringir os resultados
- Itere para aprofundar em subconjuntos específicos
Exemplos de Uso
Exemplo 1: Indexe sua Pasta de Documentos
- Edite
application.yaml:
lucene:
  crawler:
    directories:
      - "/Users/yourname/Documents"
    crawl-on-startup: true
- Inicie o servidor:
java -jar target/luceneserver-0.0.1-SNAPSHOT.jar
- O rastreador inicia automaticamente e indexa todos os documentos suportados na sua pasta de Documentos.
Exemplo 2: Busca com Filtragem
Pergunte ao Claude:
Search for "machine learning" in PDF documents only
Claude usará:
query: "machine learning"
filters: [{ field: "file_extension", value: "pdf" }]
Exemplo 3: Encontrar Documentos por Autor
Pergunte ao Claude:
Find all documents written by John Doe
Claude usará:
query: "*"
filters: [{ field: "author", value: "John Doe" }]
Exemplo 4: Monitorar o Progresso do Rastreador
Pergunte ao Claude:
Show me the crawler statistics
Claude chama getCrawlerStats() e mostra:
- Arquivos processados: 1,234 / 5,000
- Taxa de transferência: 85 arquivos/seg
- Indexados: 1,200 (98%)
- Falhas: 34 (2%)
Exemplo 5: Rastreamento Manual com Reindexação Completa
Pergunte ao Claude:
Reindex all documents from scratch
Claude chama startCrawl(fullReindex: true), que:
- Limpa o índice existente
- Re-rastreia todos os diretórios configurados
- Indexa todos os documentos do zero
Exemplo 6: Busca Específica por Idioma
Pergunte ao Claude:
Find German documents about "Technologie"
Claude usa:
query: "Technologie"
filters: [{ field: "language", value: "de" }]
Exemplo 7: Busca com Passagens
Os resultados da busca incluem uma matriz passages com trechos destacados e metadados de qualidade:
{
  "file_name": "report.pdf",
  "passages": [
    {
      "text": "...discusses the impact of <em>machine learning</em> on modern software development. The study shows...",
      "score": 1.0,
      "matchedTerms": ["machine learning"],
      "termCoverage": 1.0,
      "position": 0.08,
      "source": "keyword"
    },
    {
      "text": "...<em>machine learning</em> algorithms were applied to the dataset in Section 4...",
      "score": 0.75,
      "matchedTerms": ["machine learning"],
      "termCoverage": 1.0,
      "position": 0.45,
      "source": "keyword"
    }
  ]
}
Isso permite que você veja trechos relevantes sem baixar o documento completo. Os campos de metadados ajudam LLMs a identificar rapidamente a melhor passagem: prefira passagens com alto termCoverage (cobre mais da consulta), use position para contexto de estrutura do documento e verifique source para entender se a passagem foi encontrada por correspondência de palavras-chave ("keyword") ou por similaridade vetorial ("semantic").
Exemplo 8: Gerenciando Diretórios Rastreáveis em Tempo de Execução
Pergunte ao Claude para gerenciar diretórios sem editar arquivos de configuração:
"What directories are currently being crawled?"
# Claude calls listCrawlableDirectories()
# Response: Shows all configured directories and config file location

"Add /Users/yourname/Research as a crawlable directory"
# Claude calls addCrawlableDirectory(path="/Users/yourname/Research")
# Directory is added to ~/.mcplucene/config.yaml

"Add /Users/yourname/Projects and start crawling it now"
# Claude calls addCrawlableDirectory(path="/Users/yourname/Projects", crawlNow=true)
# Directory is added and crawl starts immediately

"Stop crawling /Users/yourname/Downloads"
# Claude calls removeCrawlableDirectory(path="/Users/yourname/Downloads")
# Directory is removed from config (indexed documents remain)
Persistência de Configuração:
Os diretórios que você adiciona por meio das ferramentas MCP são salvos em ~/.mcplucene/config.yaml:
lucene:
  crawler:
    directories:
      - /Users/yourname/Documents
      - /Users/yourname/Research
      - /Users/yourname/Projects
Essa configuração persiste entre reinicializações do servidor - não é necessário reconfigurar a cada vez.
Substituição por Variável de Ambiente:
Se você definir a variável de ambiente LUCENE_CRAWLER_DIRECTORIES, ela terá precedência:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": ["-Dspring.profiles.active=deployed", "-jar", "/path/to/jar"],
      "env": {
        "LUCENE_CRAWLER_DIRECTORIES": "/path1,/path2"
      }
    }
  }
}
Quando isso é definido, addCrawlableDirectory e removeCrawlableDirectory retornarão uma mensagem de erro indicando que a substituição por ambiente está ativa.
Exemplo 9: Trabalhando com Busca Lexical (Sinônimos e Variações)
Nota: Ao usar este servidor por meio do Claude ou de outro assistente de IA, a expansão de sinônimos acontece automaticamente - a IA constrói consultas OR para você com base na sua solicitação em linguagem natural. Os exemplos abaixo mostram a sintaxe de consulta subjacente para referência ou uso direto da API.
Como o mecanismo de busca realiza correspondência lexical exata sem expansão automática de sinônimos, você precisa incluir explicitamente sinônimos e variações de palavras na sua consulta:
Busca básica (pode perder resultados relevantes):
query: "car"
Isso corresponderá SOMENTE a documentos que contenham a palavra exata "car", perdendo documentos com "automobile", "vehicle", etc.
Melhor: Inclua sinônimos com OR:
query: "(car OR automobile OR vehicle)"
Melhor ainda: Combine sinônimos com curingas para variações:
query: "(car* OR automobile* OR vehicle*)"
Isso corresponde a: car, cars, automobile, automobiles, vehicle, vehicles, etc.
Exemplo do mundo real - Encontrando contratos:
query: "(contract* OR agreement* OR deal*) AND (sign* OR execut* OR finali*)"
filters: [{ field: "file_extension", value: "pdf" }]
Isso encontrará documentos contendo variações como:
- "contract signed", "agreement executed", "deal finalized"
- "contracts signing", "agreements execute", "deals finalizing"
Dica: Use o facets na resposta da busca para descobrir os termos exatos usados nos seus documentos e refine sua consulta de acordo.
Recursos do Rastreador de Documentos
Rastreamento Automático
O rastreador inicia automaticamente na inicialização do servidor (se crawl-on-startup: true) e:
- Descobre arquivos que correspondem aos padrões de inclusão nos diretórios configurados
- Extrai conteúdo usando Apache Tika (suporta mais de 100 formatos de arquivo)
- Detecta idioma automaticamente para cada documento
- Extrai metadados (autor, título, datas, etc.)
- Indexa documentos em lotes para desempenho ideal
- Monitora diretórios para alterações (criar, modificar, excluir)
Indexação Incremental (Reconciliação)
Por padrão (reconciliation-enabled: true), todo rastreamento que não seja uma reindexação completa realiza uma passagem incremental primeiro. Isso torna rastreamentos repetidos significativamente mais rápidos porque arquivos inalterados nunca são reprocessados.
Como funciona:
- Index snapshot — Todos os pares
(file_path, modified_date)são lidos do índice Lucene. - Filesystem snapshot — Os diretórios configurados são percorridos e os pares
(file_path, mtime)atuais são coletados (sem extração de conteúdo nesta etapa). - Diff de quatro vias é calculado:
- DELETE — caminhos no índice que não existem mais no disco (órfãos).
- ADD — caminhos no disco que ainda não estão no índice.
- UPDATE — caminhos onde o mtime no disco é mais recente que o
modified_datearmazenado. - SKIP — caminhos idênticos; estes nunca são tocados.
- Exclusões de órfãos são aplicadas primeiro (exclusão em massa via uma única consulta Lucene).
- Apenas arquivos ADD e UPDATE são rastreados, extraídos e indexados.
- Após a conclusão bem-sucedida, o estado do rastreamento (timestamp, contagem de documentos, modo) é persistido em
~/.mcplucene/crawl-state.yaml.
Comportamento de fallback: Se a reconciliação falhar por qualquer motivo (erro de I/O ao ler o índice, falha na varredura do filesystem, etc.), o sistema automaticamente cai para um rastreamento completo. Nenhum dado é perdido e nenhuma intervenção manual é necessária.
Desabilitando indexação incremental:
Defina reconciliation-enabled: false em application.yaml para sempre executar um rastreamento completo. Alternativamente, passe fullReindex: true para startCrawl para forçar um único rastreamento completo sem alterar o padrão.
Arquivo de estado persistido:
~/.mcplucene/crawl-state.yaml
Este arquivo registra o horário de conclusão, a contagem de documentos e o modo do último rastreamento bem-sucedido. Ele é gravado somente após um rastreamento concluir com sucesso.
Gerenciamento de Versão de Esquema
O servidor rastreia a versão do esquema do índice para detectar quando o esquema muda entre atualizações de software. Isso elimina a necessidade de reindexação manual após atualizações.
Como funciona:
- Cada versão incorpora uma constante
SCHEMA_VERSIONque reflete o esquema atual de campos do índice. - A versão do esquema é persistida nos metadados de commit do Lucene junto com a versão do software.
- Na inicialização, o servidor compara a versão do esquema armazenada com a atual.
- Se forem diferentes (ou se um índice legado não tiver versão), uma reindexação completa é acionada automaticamente.
O que aciona um aumento de versão de esquema:
- Adicionar ou remover campos indexados
- Alterar analisadores de campos
- Modificar opções de indexação de campos (armazenados, vetores de termos, etc.)
Verificando informações de versão:
Use getIndexStats para ver a versão atual do esquema, a versão do software e o timestamp de build.
Monitoramento em Tempo Real
Com o monitoramento de diretórios habilitado (watch-enabled: true):
- Novos arquivos são automaticamente indexados quando adicionados
- Arquivos modificados são reindexados com conteúdo atualizado
- Arquivos excluídos são removidos do índice
Otimização de Desempenho
Multithreading:
- Rastreia múltiplos diretórios em paralelo (pool de threads configurável)
- Cada diretório é processado por uma thread separada
Processamento em Lote:
- Documentos são indexados em lotes (padrão: 100 documentos)
- Reduz a sobrecarga de I/O e melhora a velocidade de indexação
Otimização NRT (Near Real-Time):
- Operação normal: intervalo de atualização de 100ms para atualizações rápidas de busca
- Indexação em massa (>1000 arquivos): Reduz automaticamente para 5s para reduzir sobrecarga
- Restaura para 100ms após a conclusão da operação em massa
Notificações de Progresso:
- Baseadas em timer: atualizações a cada 30 segundos (configurável via
progress-notification-interval-ms) - Mostra throughput (arquivos/seg, MB/seg), progresso e nomes de arquivos em processamento
- Não bloqueante: Aparecem na área de notificação do sistema sem interromper o fluxo de trabalho
- macOS: Notificações aparecem na Central de Notificações (canto superior direito)
- Windows: Notificações toast na área de notificação do sistema
- Linux: Usa notify-send para notificações de desktop
Tratamento de Erros
- Arquivos com falha são registrados, mas não interrompem o rastreamento
- Estatísticas rastreiam arquivos bem-sucedidos vs. com falha
- Documentos grandes são totalmente indexados (sem truncamento por padrão)
- Arquivos corrompidos ou inacessíveis são ignorados graciosamente
Solução de Problemas
Onde encontrar os logs?
Ao executar com o perfil deployed, o log de console é desabilitado para garantir comunicação STDIO limpa com clientes MCP. Em vez disso, os logs são gravados em arquivos em:
~/.mcplucene/log/mcplucene.log
O diretório de logs é ${user.home}/.mcplucene/log por padrão (configurado em logback.xml). Os arquivos de log são rotacionados automaticamente:
- Máximo de 10MB por arquivo
- Até 5 arquivos de log retidos
- Tamanho total limitado a 50MB
Para visualizar logs recentes:
# View the current log file
cat ~/.mcplucene/log/mcplucene.log

# Follow logs in real-time
tail -f ~/.mcplucene/log/mcplucene.log

# View last 100 lines
tail -n 100 ~/.mcplucene/log/mcplucene.log
Durante o desenvolvimento (sem o perfil deployed), os logs são gravados no console em vez de arquivos.
Mudanças de versão de esquema e reindexação automática
O servidor agora inclui gerenciamento automático de versão de esquema. Quando você atualiza para uma nova versão que altera o esquema do índice (por exemplo, adiciona novos campos, altera analisadores ou modifica opções de indexação de campos), o servidor detecta a incompatibilidade de versão na inicialização e aciona automaticamente uma reindexação completa.
O que acontece:
- Na inicialização, o servidor compara a versão do esquema armazenada com a versão atual
- Se forem diferentes, uma reindexação completa é acionada automaticamente
- Você verá uma mensagem de log:
Schema version changed — triggering full reindex - A reindexação é executada em segundo plano; você pode verificar o progresso com
getCrawlerStats
Reindexação manual: Se você precisar forçar uma reindexação manual por qualquer motivo, ainda pode acioná-la:
Ask Claude: "Reindex all documents from scratch"
Isso chama startCrawl(fullReindex: true), que limpa o índice existente e re-rastreia todos os diretórios configurados.
Informações de versão:
Use getIndexStats para ver a versão atual do esquema, a versão do software e o timestamp de build.
Arquivo de bloqueio do índice impede a inicialização (write.lock)
Sintoma: O servidor falha ao iniciar com um erro como Lock held by another program ou LockObtainFailedException.
Causa: Quando o servidor MCP não é encerrado corretamente (por exemplo, o processo foi morto à força, o sistema travou ou o Claude Desktop foi encerrado abruptamente), o Lucene pode deixar um arquivo write.lock no diretório do índice. Este arquivo de bloqueio é usado para impedir que múltiplos processos gravem no mesmo índice simultaneamente. Quando é deixado para trás após um encerramento não limpo, ele bloqueia a inicialização do servidor porque o Lucene pensa que outro processo ainda está usando o índice.
Solução: Exclua o arquivo de bloqueio manualmente:
# Remove the write.lock file from the index directory
rm ~/.mcplucene/luceneindex/write.lock
Após remover o arquivo de bloqueio, o servidor deve iniciar normalmente.
Prevenção: Tente encerrar o Claude Desktop graciosamente quando possível. Se você precisar forçar o encerramento, esteja ciente de que pode ser necessário remover o arquivo de bloqueio antes da próxima inicialização.
Nota: O caminho padrão do índice é ~/.mcplucene/luceneindex. Se você configurou um caminho de índice personalizado via LUCENE_INDEX_PATH ou application.yaml, procure o arquivo write.lock nesse diretório.
Servidor mostra "em execução" mas as ferramentas não funcionam
Isso geralmente indica problemas de comunicação STDIO:
- Certifique-se de que o argumento
-Dspring.profiles.active=deployedestá presente na configuração - Verifique se nenhuma outra saída está sendo gravada no stdout
- Confirme que o caminho do JAR é absoluto, não relativo
- Se você modificou a configuração, certifique-se de que as configurações do perfil "deployed" estão corretas
Claude Desktop não mostra o servidor
- Verifique se o caminho do arquivo JAR na configuração está correto e é absoluto
- Confirme que o Java 25+ está instalado:
java -version - Valide a sintaxe JSON no arquivo de configuração
- Verifique os logs do Claude Desktop para mensagens de erro
- Tente executar o JAR manualmente para verificar erros de inicialização:
java -jar /path/to/luceneserver-0.0.1-SNAPSHOT.jar
Servidor falha ao iniciar
- Certifique-se de que o caminho do diretório do índice Lucene é válido
- Verifique se nenhum outro processo está bloqueando o diretório do índice
- Confirme espaço em disco suficiente para o índice
Resultados de busca vazios
O índice pode estar vazio por vários motivos:
- Nenhum diretório configurado: Adicione diretórios a
application.yamlsoblucene.crawler.directories - Crawler não iniciado: Use a ferramenta MCP
startCrawlou habilitecrawl-on-startup: true - Nenhum arquivo correspondente: Verifique se seus diretórios contêm arquivos que correspondem aos padrões de inclusão
- Arquivos com falha na indexação: Verifique os logs para erros, use
getCrawlerStatspara ver a contagem de arquivos com falha
Crawler não está indexando arquivos
- Verifique os caminhos dos diretórios: Certifique-se de que os caminhos em
application.yamlsão absolutos e existem - Verifique as permissões de arquivo: O servidor precisa de acesso de leitura a todos os arquivos
- Verifique os padrões de inclusão: Os arquivos devem corresponder a pelo menos um padrão de inclusão
- Verifique os padrões de exclusão: Os arquivos não devem corresponder a nenhum padrão de exclusão
- Monitore o status do crawler: Use as ferramentas MCP
getCrawlerStatusegetCrawlerStats - Verifique os logs: Procure por erros de parsing ou exceções de I/O
Erros de falta de memória durante a indexação
Se você encontrar erros OOM com documentos muito grandes:
- Defina o limite de conteúdo: Altere
max-content-lengthemapplication.yaml(por exemplo,5242880para 5MB) - Aumente o heap do JVM: Adicione
-Xmx2gaos argumentos JVM na configuração do Claude Desktop - Reduza o pool de threads: Diminua
thread-pool-sizepara reduzir o processamento concorrente - Reduza o tamanho do lote: Diminua
batch-sizepara fazer commits mais frequentes
Desempenho de indexação lento
- Aumente o pool de threads: Aumente
thread-pool-size(padrão: 4) - Aumente o tamanho do lote: Aumente
batch-sizepara menos commits (padrão: 100) - Desabilite a detecção de idioma: Defina
detect-language: falsese não for necessário - Desabilite a extração de metadados: Defina
extract-metadata: falsese não for necessário - Verifique o I/O do disco: Disco lento pode ser um gargalo para a indexação
Considerações de Segurança
Conteúdo de Documentos Não Confiável
O MCP Lucene Server indexa documentos de diretórios rastreados e retorna seu conteúdo (passagens, metadados, texto completo) nas respostas das ferramentas MCP. Este conteúdo é inerentemente não confiável — qualquer documento colocado em um diretório rastreado pode influenciar o que o cliente MCP (LLM) vê nas respostas das ferramentas.
Risco de Injeção Indireta de Prompt
Isso cria um potencial para injeção indireta de prompt: um documento maliciosamente elaborado pode conter texto projetado para manipular um LLM que processa os resultados da busca. Por exemplo, um documento pode incluir instruções que parecem texto natural, mas são destinadas a influenciar o comportamento ou as respostas do LLM.
Recomendações
- Clientes MCP devem tratar todo conteúdo derivado de documentos nas respostas das ferramentas como dados não confiáveis
- O servidor adiciona um campo
contentNoteàs respostas contendo conteúdo de documentos como um lembrete - Considere o nível de confiança dos diretórios rastreados ao configurar o servidor
- Esteja ciente de que o conteúdo indexado pode influenciar o comportamento do LLM através dos resultados da busca
Esta é uma característica inerente de sistemas que recuperam e apresentam conteúdo externo a modelos de linguagem.
Opções de Configuração
Nota: O Quick Start acima usa configuração zero. Esta seção cobre opções avançadas de personalização.
O servidor pode ser configurado via variáveis de ambiente e application.yaml:
Perfis de Logging
O servidor suporta dois perfis de logging (para compatibilidade retroativa, usa a mesma propriedade de sistema do Spring Boot):
| Perfil | Uso | Saída de Logging |
|---|---|---|
| default | Desenvolvimento em IDE | Logging de console habilitado |
| deployed | Produção/Claude Desktop | Apenas logging em arquivo |
Perfil padrão (nenhum perfil especificado):
- Logging completo habilitado no console
- Adequado para depuração e desenvolvimento
Perfil deployed (-Dspring.profiles.active=deployed):
- Logging de console desabilitado (necessário para transporte STDIO)
- Logging em arquivo habilitado (
~/.mcplucene/log/mcplucene.log) - Usado ao executar sob Claude Desktop ou outros clientes MCP
Configuração de Transporte
O servidor suporta dois tipos de transporte: STDIO (padrão) e HTTP. O transporte é selecionado via a propriedade de sistema mcp.transport.
Transporte STDIO (Padrão)
O transporte STDIO é o modo padrão e recomendado para integração com Claude Desktop. Nenhuma configuração adicional é necessária.
Configuração do Claude Desktop:
{
  "mcpServers": {
    "lucene-search": {
      "command": "java",
      "args": [
        "--enable-native-access=ALL-UNNAMED",
        "-Xmx2g",
        "-Dspring.profiles.active=deployed",
        "-jar",
        "/absolute/path/to/luceneserver-0.0.1-SNAPSHOT.jar"
      ]
    }
  }
}
Transporte HTTP
O transporte HTTP permite acesso remoto e integração com clientes MCP baseados na web usando o protocolo MCP Streamable HTTP (Spec 2025-03-26). Para habilitar o transporte HTTP, defina a propriedade de sistema mcp.transport como http.
Iniciando com o transporte HTTP:
# Minimal HTTP configuration (uses defaults: 0.0.0.0:8080/mcp/message)
java --enable-native-access=ALL-UNNAMED \
  -Xmx2g \
  -Dmcp.transport=http \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
Configuração HTTP personalizada:
java --enable-native-access=ALL-UNNAMED \
  -Xmx2g \
  -Dmcp.transport=http \
  -Dmcp.http.port=9000 \
  -Dmcp.http.host=localhost \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
Propriedades de configuração HTTP:
| Propriedade do Sistema | Padrão | Descrição |
|---|---|---|
mcp.transport | stdio | Tipo de transporte: stdio ou http |
mcp.http.host | 0.0.0.0 | Endereço de bind do servidor HTTP (somente modo HTTP) |
mcp.http.port | 8080 | Porta do servidor HTTP (somente modo HTTP) |
mcp.http.endpoint | /mcp/message | Caminho do endpoint de mensagens MCP (somente modo HTTP)* |
*O /mcp/message padrão é o endpoint MCP padrão e normalmente não precisa ser alterado.
Notas importantes:
- O transporte HTTP usa o protocolo MCP Streamable HTTP com modo assíncrono sem estado
- O transporte STDIO usa modo síncrono com estado (adequado para conexões persistentes)
- O modo HTTP não suporta HTTPS/TLS - use um proxy reverso (nginx, Caddy) para criptografia
- Para uso em produção com HTTP, sempre coloque o servidor atrás de um proxy reverso com autenticação adequada
- O perfil
deployedé opcional com HTTP (o log do console não interferirá)
Exemplo: Executando em uma porta diferente
java -Dmcp.transport=http -Dmcp.http.port=9090 -jar luceneserver-0.0.1-SNAPSHOT.jar
Exemplo: Somente localhost (mais seguro)
java -Dmcp.transport=http -Dmcp.http.host=127.0.0.1 -jar luceneserver-0.0.1-SNAPSHOT.jar
Configuração de busca semântica
A busca vetorial semântica é um recurso opcional ativado ao definir a variável de ambiente VECTOR_MODEL.
Habilitando a busca semântica:
java --enable-native-access=ALL-UNNAMED \
  -Xmx4g \
  -Dspring.profiles.active=deployed \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
# With VECTOR_MODEL set in environment:
VECTOR_MODEL=e5-base java --enable-native-access=ALL-UNNAMED \
  -Xmx4g \
  -Dspring.profiles.active=deployed \
  -jar luceneserver-0.0.1-SNAPSHOT.jar
| Variável de Ambiente | Padrão | Descrição |
|---|---|---|
VECTOR_MODEL | (nenhum) | Modelo de embedding: e5-base (768 dims, mais rápido) ou e5-large (1024 dims, maior qualidade). Defina para habilitar as ferramentas de busca semântica. |
Consulte SEMANTICSEARCH.md para detalhes completos da arquitetura, orientações de ajuste e configuração de pontuação KNN.
Nota sobre busca semântica e a lacuna semântica
A busca vetorial foi projetada para fechar a lacuna semântica: encontrar documentos sobre "automóvel" quando o usuário pesquisa por "carro", porque o modelo de embedding mapeia ambos os conceitos para pontos próximos no espaço vetorial.
No entanto, ao usar este servidor com um LLM (Claude, GPT, etc.), a situação muda fundamentalmente.
Um LLM já preenche a lacuna semântica como parte do seu processo de raciocínio. Antes de chamar a ferramenta de busca, um LLM bem instruído pode reescrever "encontrar documentos sobre carros" em uma consulta OR explícita: (car OR automobile OR vehicle OR sedan). Isso significa que o LLM lida com a expansão de sinônimos e a reformulação de consultas — exatamente o problema que a busca vetorial foi projetada para resolver.
Quando a busca semântica agrega valor genuíno:
- Interfaces de busca diretas voltadas ao usuário, sem LLM no fluxo
- Pipelines em lote ou automatizados sem reformulação de consultas por LLM
- Consultas envolvendo jargão específico de domínio onde os sinônimos não são óbvios
- Consultas conceituais onde a redação exata dos documentos relevantes é desconhecida
Quando a busca semântica agrega valor marginal (casos de uso baseados em LLM):
- O cliente LLM expande consultas com sinônimos antes de chamar a ferramenta
- O LLM reformula consultas vagas em expressões Lucene precisas
- O corpus de busca usa terminologia consistente que o BM25 trata bem
Compensações a considerar:
- O cálculo de embeddings adiciona latência (~31ms/doc durante a indexação, ~5ms/consulta para e5-base)
- Os modelos ONNX exigem ~100-200MB de espaço em disco e RAM adicional
- A complexidade do índice aumenta (documentos pai + documentos filhos (chunks) via Block Join)
Variáveis de Ambiente
| Variável de Ambiente | Padrão | Descrição |
|---|---|---|
LUCENE_INDEX_PATH | ${user.home}/.mcplucene/luceneindex | Caminho para o diretório do índice Lucene |
LUCENE_CRAWLER_DIRECTORIES | (nenhum) | Lista separada por vírgulas de diretórios a rastrear (substitui o arquivo de configuração) |
VECTOR_MODEL | (nenhum) | Modelo de embedding (e5-base ou e5-large). Defina para habilitar a busca semântica. |
LUCENE_TOOLS_INCLUDE | * (todos) | Nomes de ferramentas ou abreviações de grupos separados por vírgulas a expor |
LUCENE_TOOLS_EXCLUDE | (vazio) | Nomes de ferramentas ou abreviações de grupos separados por vírgulas a ocultar |
Nota sobre LUCENE_CRAWLER_DIRECTORIES:
Quando esta variável de ambiente é definida, ela tem precedência sobre ~/.mcplucene/config.yaml e application.yaml. As ferramentas de configuração MCP (addCrawlableDirectory, removeCrawlableDirectory) se recusarão a modificar a configuração enquanto esta substituição estiver ativa. Para usar a configuração em tempo de execução, remova esta variável de ambiente.
Configuração do rastreador de documentos
Os diretórios do rastreador podem ser configurados de três maneiras, com a seguinte prioridade (da maior para a menor):
- Variável de Ambiente:
LUCENE_CRAWLER_DIRECTORIES(caminhos separados por vírgulas) - Configuração em tempo de execução:
~/.mcplucene/config.yaml(gerenciada via ferramentas MCP) - Padrão da aplicação:
src/main/resources/application.yaml
Configuração em tempo de execução via ferramentas MCP (recomendado)
O servidor fornece ferramentas MCP para gerenciar diretórios rastreáveis em tempo de execução sem editar arquivos de configuração:
listCrawlableDirectories - Lista todos os diretórios configurados
Ask Claude: "What directories are being crawled?"
addCrawlableDirectory - Adiciona um novo diretório para rastreamento
Ask Claude: "Add /Users/yourname/Documents as a crawlable directory"
Ask Claude: "Add /path/to/folder and start crawling it immediately"
removeCrawlableDirectory - Remove um diretório do rastreamento
Ask Claude: "Stop crawling /Users/yourname/Downloads"
Benefícios da configuração em tempo de execução:
- Não é necessário recompilar o JAR ou reiniciar o servidor
- A configuração persiste entre reinicializações em
~/.mcplucene/config.yaml - Fácil distribuição de JARs pré-compilados
- Interface conversacional via Claude
Localização do arquivo de configuração:
~/.mcplucene/config.yaml
Exemplo de config.yaml:
lucene:
  crawler:
    directories:
      - /Users/yourname/Documents
      - /Users/yourname/Downloads
Configuração estática via application.yaml
Configure o rastreador de documentos em src/main/resources/application.yaml:
lucene:
  index:
    path: ${LUCENE_INDEX_PATH:./lucene-index}
  crawler:
    # Directories to crawl and index
    directories:
      - "/path/to/your/documents"
      - "/another/path/to/index"

    # File patterns to include
    include-patterns:
      - "*.pdf"
      - "*.doc"
      - "*.docx"
      - "*.odt"
      - "*.ppt"
      - "*.pptx"
      - "*.xls"
      - "*.xlsx"
      - "*.ods"
      - "*.txt"
      - "*.eml"
      - "*.msg"
      - "*.md"
      - "*.rst"
      - "*.html"
      - "*.htm"
      - "*.rtf"
      - "*.epub"

    # File patterns to exclude
    exclude-patterns:
      - "**/node_modules/**"
      - "**/.git/**"
      - "**/target/**"
      - "**/build/**"

    # Performance settings
    thread-pool-size: 4                    # Parallel crawling threads
    batch-size: 100                        # Documents per batch
    batch-timeout-ms: 5000                 # Batch processing timeout

    # Directory watching
    watch-enabled: true                    # Monitor directories for changes
    watch-poll-interval-ms: 2000          # Watch polling interval

    # NRT optimization
    bulk-index-threshold: 1000            # Files before NRT slowdown
    slow-nrt-refresh-interval-ms: 5000    # NRT interval during bulk indexing

    # Content extraction
    max-content-length: -1                 # -1 = unlimited, or max characters
    extract-metadata: true                 # Extract author, title, etc.
    detect-language: true                  # Auto-detect document language

    # Auto-crawl
    crawl-on-startup: true                 # Start crawling on server startup

    # Progress notifications
    progress-notification-files: 100       # Notify every N files
    progress-notification-interval-ms: 30000  # Or every N milliseconds

    # Incremental indexing
    reconciliation-enabled: true           # Skip unchanged files, remove orphans (default: true)

    # Search passages
    max-passages: 3                        # Max highlighted passages per search result (default: 3)
    max-passage-char-length: 200           # Max character length per passage; longer ones are truncated (default: 200, 0 = no limit)
Formatos de arquivo suportados:
- Documentos PDF (
.pdf) - Microsoft Office: Word (
.doc,.docx), Excel (.xls,.xlsx), PowerPoint (.ppt,.pptx) - OpenOffice/LibreOffice: Writer (
.odt), Calc (.ods), Impress (.odp) - Arquivos de texto simples (
.txt) - E-mail: Outlook (
.msg), EML (.eml) - Marcação: Markdown (
.md), reStructuredText (.rst), HTML (.html,.htm) - Rich Text Format (
.rtf) - E-books: EPUB (
.epub)
Exemplo completo de configuração:
lucene:
  index:
    path: /Users/yourname/lucene-index
  crawler:
    # Add your document directories here
    directories:
      - "/Users/yourname/Documents"
      - "/Users/yourname/Downloads"
      - "/Volumes/ExternalDrive/Archive"

    # Include only these file types
    include-patterns:
      - "*.pdf"
      - "*.docx"
      - "*.xlsx"

    # Exclude these directories
    exclude-patterns:
      - "**/node_modules/**"
      - "**/.git/**"

    # Performance tuning
    thread-pool-size: 8              # Use more threads for faster indexing
    batch-size: 200                  # Larger batches for better throughput

    # Auto-start crawler
    crawl-on-startup: true

    # Real-time monitoring
    watch-enabled: true

    # No content limit (index full documents)
    max-content-length: -1
Enriquecimento de metadados JDBC
O servidor pode enriquecer documentos indexados com metadados adicionais carregados de um banco de dados relacional no momento da indexação. Isso é útil quando os metadados de negócio (por exemplo, IDs de clientes, códigos de projeto, tags) são armazenados em um banco de dados em vez de nos próprios arquivos.
Como funciona
- Para cada documento durante o rastreamento, o enriquecedor executa uma consulta SQL configurável.
- O resultado da consulta é uma única linha com uma coluna JSON contendo o payload de metadados.
- O payload JSON é analisado e campos tipados são adicionados ao documento Lucene.
- Um trabalho de sincronização em segundo plano reindexa os arquivos quando seus metadados de banco de dados mudam.
Nomenclatura de campos
Todos os campos originados de JDBC são prefixados com dbmeta_ para evitar colisões com o esquema base do documento.
| Nome do campo JSON | Nome do campo Lucene |
|---|---|
customer_id | dbmeta_customer_id |
tags | dbmeta_tags |
department | dbmeta_department |
Formato de metadados JSON
A consulta ao banco de dados deve retornar uma coluna (configurável via json.columnName) contendo JSON neste formato:
{
  "fields": [
    {
      "name": "customer_id",
      "type": "keyword",
      "value": "C-42",
      "faceted": true
    },
    {
      "name": "tags",
      "type": "keyword",
      "values": ["invoice", "2024", "urgent"],
      "faceted": true
    },
    {
      "name": "description",
      "type": "text",
      "value": "Some free-text description"
    },
    {
      "name": "amount",
      "type": "long",
      "value": 9999,
      "faceted": true
    },
    {
      "name": "doc_date",
      "type": "date",
      "value": "2024-01-15T00:00:00Z"
    }
  ]
}
Tipos de campo:
| Tipo | Armazenamento Lucene | Facetable | Notas |
|---|---|---|---|
keyword | StringField | Sim | Correspondência exata; use para IDs, códigos, categorias |
text | TextField | Não | Texto completo analisado; adequado para descrições longas |
int | IntPoint + StoredField | Sim | Inteiro de 32 bits; consultas de intervalo suportadas |
long | LongPoint + StoredField | Sim | Inteiro de 64 bits; consultas de intervalo suportadas |
date | LongPoint + StoredField | Não | String ISO-8601 → epoch millis |
Flags opcionais por campo:
| Flag | Padrão | Descrição |
|---|---|---|
faceted | false | Expor como faceta de busca (somente keyword/long) |
stored | true | Armazenar o valor para que possa ser recuperado nos resultados de busca |
searchable | true | Indexar o campo para consulta |
Configuração
Adicione a seguinte seção a ~/.mcplucene/config.yaml:
lucene:
  crawler:
    directories:
      - /path/to/your/documents
  metadata:
    jdbc:
      enabled: true
      url: "jdbc:postgresql://localhost:5432/mydb"
      username: "myuser"
      password: "${DB_PASSWORD}"   # env-var substitution supported
      poolSize: 5
      connectionTimeout: 30000    # ms
      queryTimeout: 5000          # ms
      query: >
        SELECT metadata_json
        FROM document_metadata
        WHERE file_path = :file_path
      parameters:
        - name: file_path
          sourceField: file_path   # Lucene field to use as query parameter
      json:
        columnName: metadata_json  # Column in the result set containing the JSON

      # Optional: background sync when DB metadata changes
      sync:
        enabled: true
        intervalMinutes: 5
        query: >
          SELECT dbmeta_customer_id
          FROM document_metadata
          WHERE updated_at > :last_sync_timestamp
Exemplo avançado: Construindo metadados dinamicamente a partir de uma tabela (MySQL)
Os metadados geralmente não são armazenados como JSON pré-construído, mas distribuídos em tabelas normalizadas. As funções JSON_OBJECT() / JSON_ARRAY() / JSON_ARRAYAGG() do MySQL permitem montar o payload de metadados diretamente na consulta SQL — sem necessidade de view materializada separada ou job de ETL.
Cenário
Os documentos são PDFs de perfis de freelancers. Os nomes de arquivo seguem o padrão .../ABC-1234_Profile.pdf, onde ABC-1234 é um código único de freelancer. As tabelas relevantes:
-- Master data
CREATE TABLE freelancer (
    id               BIGINT PRIMARY KEY,
    code             VARCHAR(20) UNIQUE,   -- e.g. "ABC-1234"
    salary_per_day   DECIMAL(10, 2)
);

-- n:m tags
CREATE TABLE freelancer_tags (
    freelancer_id    BIGINT,
    tag_id           BIGINT
);
Configuração
lucene:
  metadata:
    jdbc:
      enabled: true
      url: "jdbc:mysql://localhost:3306/mydb"
      username: "myuser"
      password: "${DB_PASSWORD}"
      poolSize: 5
      connectionTimeout: 30000
      queryTimeout: 5000
      query: |
        SELECT JSON_OBJECT(
                      'fields', JSON_ARRAY(
                            JSON_OBJECT('name', 'daily_rate', 'type', 'long', 'value', f.salary_per_day_long, 'faceted', CAST(FALSE AS JSON)),
                            JSON_OBJECT('name', 'tags',       'type', 'long', 'values', (
                                SELECT JSON_ARRAYAGG(ft.tag_id)
                                FROM freelancer_tags ft
                                WHERE ft.freelancer_id = f.id
                            ), 'faceted', CAST(FALSE AS JSON))
                      )
              ) as metadata_json
        FROM
            freelancer f
        WHERE
            f.code = REGEXP_SUBSTR(:file_path, '[A-Z]+-[0-9]+')
      parameters:
        - name: file_path
          sourceField: file_path   # Lucene field to use as query parameter
      json:
        columnName: metadata_json  # Column in the result set containing the JSON
Como funciona passo a passo
1. Vinculação de parâmetros — o caminho do arquivo como chave de consulta
Durante o rastreamento, o indexador armazena o caminho absoluto do arquivo no campo Lucene file_path (por exemplo, /docs/profiles/ABC-1234_Profile.pdf). Via parameters.sourceField: file_path, esse valor é passado como o parâmetro nomeado :file_path para a consulta SQL.
2. Extraindo o código do freelancer com uma regex
Como o caminho completo do arquivo é passado ao banco de dados, o código deve ser extraído lá. REGEXP_SUBSTR(:file_path, '[A-Z]+-[0-9]+') extrai ABC-1234 de /docs/profiles/ABC-1234_Profile.pdf e o compara com freelancer.code. O banco de dados não precisa conhecer as estruturas de diretórios — a regex é executada inteiramente dentro do mecanismo do banco de dados.
3. Montando o payload JSON em SQL
JSON_OBJECT(...) produz um objeto JSON. Dentro dele, um JSON_ARRAY(...) contém um elemento por campo de metadados:
daily_rate(tipolong): um único valor escalar def.salary_per_day_longtags(tipolong, multivalorado): um array produzido por uma subconsulta correlacionada —JSON_ARRAYAGG(ft.tag_id)agrega todos os IDs de tags do freelancer em um array JSON
A consulta retorna uma única linha com uma única coluna metadata_json:
{
  "fields": [
    { "name": "daily_rate", "type": "long", "value": 850,              "faceted": false },
    { "name": "tags",       "type": "long", "values": [12, 47, 103],   "faceted": false }
  ]
}
4. Processamento pelo indexador
JdbcMetadataEnricher lê esta resposta JSON e adiciona campos ao documento Lucene:
dbmeta_daily_rate→LongPoint(850)+StoredField(850)+SortedNumericDocValuesField(850)(pesquisável, recuperável e ordenável)dbmeta_tags→ três entradasLongPointpara valores12,47,103(multivalorado — DocValues ignorados, portanto não ordenável)
Porque faceted: false, nenhuma entrada SortedSetDocValuesFacetField é criada. Os campos estão disponíveis para consultas direcionadas e filtros de intervalo sem adicionar sobrecarga ao cálculo de facetas em cada solicitação de pesquisa.
Ordenação por campos de metadados JDBC: Campos INT, LONG e DATE de valor único recebem automaticamente um SortedNumericDocValuesField, e campos KEYWORD de valor único recebem um SortedDocValuesField. Isso os torna utilizáveis como valores sortBy em solicitações de pesquisa. Campos com múltiplos valores ignoram DocValues (a ordenação em campos com múltiplos valores é indefinida). Use getIndexStats para ver quais campos dbmeta_* estão atualmente registrados como ordenáveis por meio do mapa sortableFields.
5. Consulta em tempo de execução
Após a varredura, esses campos podem ser usados como filtros em extendedSearch:
{
  "query": "Java developer",
  "filters": [
    { "field": "dbmeta_daily_rate", "operator": "range", "from": "500", "to": "1000" },
    { "field": "dbmeta_tags",       "operator": "in",    "values": ["47", "103"] }
  ]
}
Nota sobre CAST(FALSE AS JSON)
MySQL não possui literal booleano JSON nativo. CAST(FALSE AS JSON) produz o valor JSON false, que JsonMetadataParser interpreta corretamente como faceted: false. Use CAST(TRUE AS JSON) para faceted: true.
Exemplo Avançado: Sincronização em Segundo Plano via Consulta de Índice (PostgreSQL)
Cenário
Mesma configuração de PDF do freelancer do exemplo de enriquecimento. Quando a tarifa diária ou as tags de um freelancer mudam no banco de dados, o servidor deve reindexar automaticamente o PDF afetado — sem que o banco de dados precise saber os caminhos dos arquivos.
Pré-requisito: A consulta de enriquecimento armazena customer_id como dbmeta_customer_id (tipo keyword) no índice Lucene, e a tabela document_metadata também possui uma coluna customer_id além de um timestamp updated_at.
Configuração
sync:
  enabled: true
  intervalMinutes: 5
  query: >
    SELECT customer_id AS dbmeta_customer_id
    FROM document_metadata
    WHERE updated_at > :last_sync_timestamp
Como Funciona Passo a Passo
1. Filtro de timestamp
O parâmetro :last_sync_timestamp está vinculado ao horário da última sincronização bem-sucedida (persistido em ~/.mcplucene/metadata-sync-state.yaml). Na primeira execução, o padrão é 1970-01-01T00:00:00Z, então a tabela inteira é varrida.
2. Nome da coluna como campo Lucene
O conjunto de resultados tem exatamente uma coluna. Seu nome — dbmeta_customer_id (definido via alias AS) — é lido do ResultSetMetaData JDBC. Isso se torna o campo Lucene que o servidor usará para pesquisar.
3. Consulta TermQuery
Para cada linha (por exemplo, valor C-42), o servidor executa um TermQuery Lucene em dbmeta_customer_id = "C-42" restrito a documentos pai. Isso encontra todos os arquivos indexados que foram enriquecidos com esse ID de cliente.
4. Resolução do caminho do arquivo
file_path é extraído de cada documento Lucene correspondente. O índice — não o banco de dados — é a fonte da verdade para a localização física do arquivo.
5. Reindexar ou excluir
Se o arquivo ainda existir no disco, ele é re-varrido, o que aciona novamente a consulta de enriquecimento para que o documento Lucene capture os metadados mais recentes do banco de dados. Se o arquivo foi removido, sua entrada de índice é excluída.
6. Avanço do timestamp
Após uma execução bem-sucedida, o horário atual é salvo como o novo lastSyncTimestamp. A próxima sincronização retorna apenas linhas modificadas após esse ponto.
Usando uma Chave de Junção Numérica
Se a chave de junção for um ID numérico do banco de dados em vez de um código de string, use o tipo inteiro SQL apropriado para que o servidor construa a consulta de ponto Lucene correta:
sync:
  enabled: true
  intervalMinutes: 5
  query: >
    SELECT freelancer_id AS dbmeta_freelancer_id
    FROM document_metadata
    WHERE updated_at > :last_sync_timestamp
Aqui freelancer_id é uma coluna BIGINT, então o servidor usa LongPoint.newExactQuery("dbmeta_freelancer_id", …). O enriquecimento deve ter armazenado freelancer_id como um campo do tipo long para que a consulta corresponda.
| Tipo de coluna SQL | Consulta Lucene | Deve corresponder ao tipo de enriquecimento |
|---|---|---|
VARCHAR / CHAR | TermQuery | keyword |
INTEGER / SMALLINT | IntPoint.newExactQuery() | int |
BIGINT / NUMERIC | LongPoint.newExactQuery() | long |
Bancos de Dados Suportados
| Banco de Dados | Dependência do driver | Observações |
|---|---|---|
| PostgreSQL | incluído (runtime opcional) | jdbc:postgresql://... |
| MySQL | incluído (runtime opcional) | jdbc:mysql://... |
| H2 | apenas escopo de teste | jdbc:h2:... (para testes) |
| Qualquer JDBC | Adicione ao classpath | Defina driverClassName explicitamente |
Integração de Facetas
Campos declarados com "faceted": true são automaticamente registrados como dimensões de facetas dinâmicas. Eles aparecem ao lado das facetas integradas (language, file_extension, file_type, author) nos resultados de pesquisa e podem ser usados como valores de filtro.
Campos com múltiplos valores (usando "values": [...]) são automaticamente configurados como dimensões de facetas multivaloradas.
Sincronização em Segundo Plano
Quando sync.enabled: true, o servidor executa um trabalho em segundo plano a cada intervalMinutes minutos que:
- Consulta o banco de dados em busca de registros modificados desde a última sincronização (usando
:last_sync_timestamp). - Lê o conjunto de resultados — exatamente uma coluna, N linhas. O nome da coluna é o campo Lucene a ser pesquisado; o valor da coluna é o termo a ser correspondido.
- Executa uma consulta Lucene por linha para encontrar documentos de índice correspondentes e extrai seus
file_path. - Reindexa arquivos que ainda existem no disco com os metadados mais recentes.
- Remove entradas de índice para arquivos que não existem mais.
O timestamp da última sincronização é persistido em ~/.mcplucene/metadata-sync-state.yaml.
Tipos de coluna suportados:
| Tipo de coluna SQL | Consulta Lucene | Tipo de campo dbmeta_ compatível |
|---|---|---|
VARCHAR, CHAR, … | TermQuery | keyword |
INTEGER, SMALLINT, TINYINT | IntPoint.newExactQuery() | int |
BIGINT, NUMERIC, DECIMAL | LongPoint.newExactQuery() | long |
O tipo de consulta é inferido automaticamente a partir do tipo de coluna JDBC — nenhuma configuração extra é necessária. O tipo de coluna SQL deve corresponder ao tipo de campo Lucene usado durante o enriquecimento (IntPoint e LongPoint são tipos de campo separados). Campos text analisados não são adequados como chaves de sincronização.
Tratamento de Erros
O enriquecedor segue um padrão de resiliência "pular e avisar":
- Falhas de conexão com o banco de dados: o documento é indexado sem enriquecimento, um aviso é registrado.
- Erros de consulta: mesmo comportamento de pular e avisar.
- Payloads JSON inválidos: erros de análise são registrados, o campo é ignorado.
- Valores NULL: ignorados silenciosamente por campo.
- Colisões de nomes de campos com o esquema base: erro registrado, campo ignorado.
Desenvolvimento
Executando para Desenvolvimento
Ao desenvolver e depurar em sua IDE, execute o servidor sem o perfil "deployed" para obter registro completo:
Na sua IDE (IntelliJ, Eclipse, VS Code):
# Just run the main class directly - no profile needed
# You'll see full console logging and debug output
java -jar target/luceneserver-0.0.1-SNAPSHOT.jar
Isso fornece a você:
- Saída de registro completa para depuração
- Configuração carregada do classpath e da configuração do usuário
- Todas as informações de depuração visíveis no console
Para implantação em produção/Claude Desktop:
# Use the deployed profile for clean STDIO
java --enable-native-access=ALL-UNNAMED -Xmx2g -Dspring.profiles.active=deployed -jar target/luceneserver-0.0.1-SNAPSHOT.jar
Depuração com o MCP Inspector
O MCP Inspector fornece uma interface visual de depuração para testar servidores MCP. Use-o para inspecionar solicitações, respostas e depurar o comportamento das ferramentas sem precisar de um cliente MCP completo como o Claude Desktop.
Execute o servidor com o inspetor para conexão STDIO:
npx @modelcontextprotocol/inspector java -jar --enable-native-access=ALL-UNNAMED -Xmx2g -Dspring.profiles.active=deployed -jar ./target/luceneserver-0.0.1-SNAPSHOT.jar
ou no caso de Streaming HTTP:
npx @modelcontextprotocol/inspector http://localhost:9000/mcp/message --transport http
Isso abre uma interface baseada na web onde você pode:
- Testar todas as ferramentas MCP interativamente
- Inspecionar payloads JSON de solicitação/resposta
- Depurar problemas de comunicação STDIO
- Verificar parâmetros e valores de retorno das ferramentas
Nota: O inspetor requer os mesmos argumentos JVM da implantação em produção (--enable-native-access=ALL-UNNAMED, -Dspring.profiles.active=deployed) para garantir um comportamento consistente.
Adicionando Documentos ao Índice
Abordagem recomendada: Use o rastreador de documentos configurando diretórios em application.yaml. O rastreador lida automaticamente com extração de conteúdo, metadados e detecção de idioma.
Abordagem programática: Para tipos de documentos personalizados ou indexação direta:
// Get the LuceneIndexService instance from your application
LuceneIndexService indexService = // ... from your application

public void addDocument(String title, String content) throws IOException {
    Document doc = new Document();
    doc.add(new TextField("title", title, Field.Store.YES));
    doc.add(new TextField("content", content, Field.Store.YES));
    doc.add(new StringField("file_path", "/custom/path", Field.Store.YES));
    indexService.getIndexWriter().addDocument(doc);
    indexService.getIndexWriter().commit();
}
Para o esquema completo de campos, consulte a seção Esquema de Campos do Índice.