cowork-semantic-search
Pesquisa semântica local sobre documentos (txt, md, pdf, docx, pptx, csv). Totalmente offline, multilíngue, busca híbrida vetorial + por palavras-chave via LanceDB. Sem chaves de API, sem nuvem.
Documentação
cowork-semantic-search


Se você acha isso útil, considere dar uma ⭐ — isso ajuda outras pessoas a descobrirem o projeto.
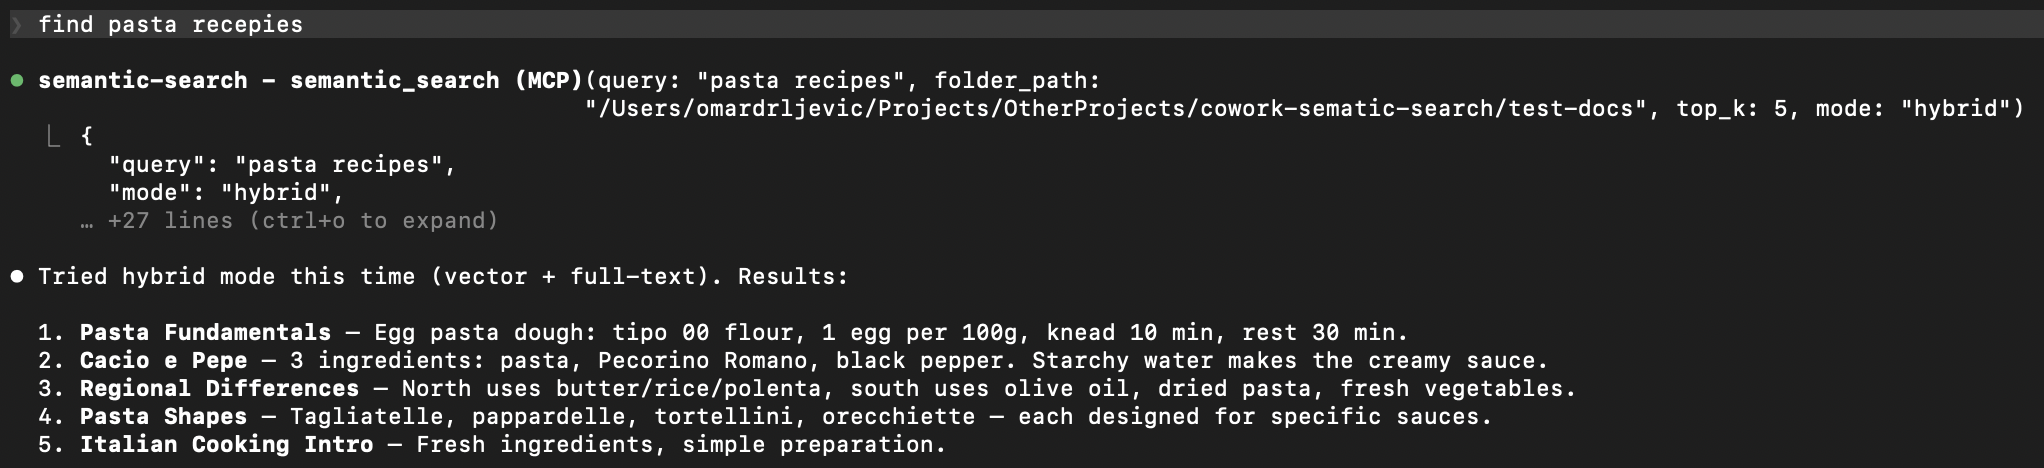
Busca semântica local para seus documentos. Sem chaves de API. Sem nuvem. Funciona com qualquer cliente MCP.
Por quê
Ferramentas de codificação com IA são poderosas, mas têm pontos cegos quando se trata dos seus arquivos locais:
- Conhecimento congelado — os dados de treinamento têm um limite. Seus relatórios, anotações e contratos mais recentes não existem no mundo do modelo.
- Limites de janela de contexto — você não pode colar 500 documentos em um prompt.
- Sem busca entre arquivos — sua ferramenta de IA pode ler um arquivo por vez, mas não pode buscar em toda a sua biblioteca de documentos pelas partes relevantes.
Este plugin preenche essa lacuna. Ele indexa seus documentos locais em um banco de dados vetorial pequeno e rápido. Quando você faz uma pergunta, ele recupera apenas as partes relevantes — para que sua ferramenta de IA possa responder com seus dados reais.
Your documents --> chunked --> embedded --> local vector DB
                                                 |
         Your question --> embedded --> similarity search --> relevant chunks --> AI answers
Recursos
- Totalmente offline — download único do modelo (~120MB), depois nenhuma chamada de rede. Nenhum dado sai da sua máquina.
- Indexação incremental — hash de conteúdo SHA-256. Apenas arquivos alterados são reprocessados. Reindexar 1000 arquivos onde 3 foram alterados leva segundos.
- Multilíngue — suporta mais de 50 idiomas nativamente. Busque em um idioma, encontre resultados em outro.
- Busca híbrida — combina similaridade semântica com busca por palavras-chave de texto completo via Fusão de Classificação Recíproca. Captura o que a busca vetorial pura não captura.
- Múltiplos formatos — txt, md, pdf, docx, pptx, csv prontos para uso.
- Qualquer cliente MCP — funciona com Claude Code, Cursor, Windsurf, Cline e qualquer outra ferramenta compatível com MCP.
- Zero infraestrutura — LanceDB armazena tudo como arquivos locais. Sem servidor, sem Docker, sem banco de dados para gerenciar.
Formatos Suportados
| Formato | Extensão | Detalhes |
|---|---|---|
| Texto simples | .txt | UTF-8 com fallback |
| Markdown | .md | Texto bruto preservado |
.pdf | Extração por página com metadados | |
| Word | .docx | Extração completa de parágrafos |
| PowerPoint | .pptx | Extração por slide com metadados |
| CSV | .csv | Extração de texto por linha |
Início Rápido
1. Instalação
git clone https://github.com/ZhuBit/cowork-semantic-search.git
cd cowork-semantic-search
python3 -m venv .venv && source .venv/bin/activate
pip install -e ".[all]"
2. Configure seu cliente MCP
Adicione o servidor à configuração do seu cliente MCP. Substitua os caminhos pelos seus próprios.
Claude Code — .mcp.json na raiz do seu projeto
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "cwd": "/absolute/path/to/cowork-semantic-search",
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Cursor — .cursor/mcp.json na raiz do seu projeto ou ~/.cursor/mcp.json globalmente
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Windsurf — ~/.codeium/windsurf/mcp_config.json
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
Cline — Configurações de Servidores MCP na extensão Cline do VS Code
Abra Cline > Ícone de Servidores MCP > Configurar > Configurações MCP Avançadas e adicione:
{
  "mcpServers": {
    "semantic-search": {
      "command": "/absolute/path/to/.venv/bin/python",
      "args": ["-m", "server.main"],
      "env": {
        "PYTHONPATH": "/absolute/path/to/cowork-semantic-search"
      }
    }
  }
}
3. Reinicie seu cliente MCP e pronto
"Indexe todos os documentos em ~/Documents/projects"
"Busque por 'relatório de receita trimestral'"
Na primeira execução, o modelo de embeddings é baixado (~120MB), depois tudo roda offline.
Exemplo: Busque em seu Cofre Obsidian
Se você mantém anotações no Obsidian (ou em qualquer pasta de arquivos markdown), este plugin transforma sua ferramenta de IA em um mecanismo de busca para sua base de conhecimento.
You: "Index my vault at ~/Documents/ObsidianVault"
AI:  Indexed 847 files -> 3,291 chunks in 42s

You: "What did I write about API rate limiting?"
AI:  Found 6 relevant chunks across 3 files:
       - notes/backend/rate-limiting-strategies.md
       - projects/acme-api/design-decisions.md
       - daily/2025-11-03.md
       ...

You: "Find anything about the client meeting last November, use hybrid search"
AI:  Found 4 results using hybrid search (vector + keyword):
       - meetings/2025-11-12-acme-kickoff.md
       - daily/2025-11-12.md
       ...
Funciona da mesma forma com PDFs, documentos Word, PowerPoints e CSVs — basta apontar para uma pasta.
Ferramentas
| Ferramenta | Descrição |
|---|---|
index_folder | Indexa ou reindexa todos os documentos em uma pasta. Incremental — ignora arquivos inalterados. |
semantic_search | Busca em documentos indexados usando linguagem natural. Suporta modos vector e hybrid. |
get_index_status | Mostra total de chunks, contagem de arquivos e lista de arquivos indexados. |
reindex_file | Força a reindexação de um único arquivo, ignorando o cache de hash. |
Como Funciona
- Analisar — extrai texto de cada documento, preservando a estrutura (páginas, slides)
- Dividir — divide em pedaços sobrepostos de ~400 caracteres para recuperação precisa
- Incorporar — converte cada pedaço em um vetor de 384 dimensões usando
paraphrase-multilingual-MiniLM-L12-v2 - Armazenar — salva pedaços + vetores em um banco de dados LanceDB (um arquivo local, sem necessidade de servidor)
- Buscar — incorpora sua consulta, encontra os pedaços mais próximos por similaridade de cosseno, opcionalmente combinando com busca por palavras-chave de texto completo via RRF
Uso Avançado
Usar como biblioteca Python
from server.indexer import index_folder
from server.search import semantic_search

# Index a folder
result = index_folder("/path/to/docs")
print(f"{result['files_indexed']} files -> {result['total_chunks']} chunks")

# Search
results = semantic_search("project deadline", mode="hybrid")
for r in results["results"]:
    print(f"  {r['file_name']}: {r['text'][:100]}...")
Arquitetura
server/
  main.py       # MCP server + tool definitions
  parsers.py    # Per-format text extraction
  chunker.py    # Text splitting with metadata
  indexer.py    # Discovery, hashing, embedding pipeline
  store.py      # LanceDB vector store + FTS + hybrid search
  search.py     # Query embedding + search orchestration
| Componente | Escolha | Por quê |
|---|---|---|
| Framework MCP | FastMCP | Definições de ferramentas limpas, suporte a async |
| Embeddings | sentence-transformers | Offline, multilíngue, rápido |
| Banco vetorial | LanceDB | Serverless, embutido, FTS integrado |
| Divisão | langchain-text-splitters | Divisão recursiva testada em batalha |
| PyMuPDF | Extração rápida e precisa | |
| DOCX | python-docx | Leve, sem dependências de sistema |
| PPTX | python-pptx | Extração por slide |
Desenvolvimento
source .venv/bin/activate
pytest tests/ -v
56 testes cobrindo analisadores, divisão, indexação, busca e integração de ferramentas MCP.
Contribuições são bem-vindas — abra uma issue ou envie um PR.
Roadmap
- Runtime ONNX para embeddings mais rápidos (remover dependência do PyTorch)
- Tamanho de chunk e sobreposição configuráveis via parâmetros de ferramenta
- Índices nomeados para múltiplas pastas
- Filtragem por metadados (intervalos de datas, tags, campos personalizados)
- Modo de observação (reindexação automática em alterações de arquivos)
Suporte
Se isso for útil para você, considere dar uma ⭐ — isso ajuda outras pessoas a encontrarem o projeto.
Licença
AGPL-3.0 — livre para usar, modificar e hospedar. Se você oferecer isso como um serviço de rede, deve compartilhar seu código-fonte. Veja LICENSE para detalhes.