TinySearch
Busca web eficiente em tokens para aplicativos de chat e agentes de IA.
Documentação
TinySearch
Gaste tokens em respostas, não em páginas da web.
O TinySearch pesquisa, rastreia e reclassifica a web localmente, e então entrega ao seu agente apenas as evidências que valem a pena colocar no contexto dele.
Documentação · Início rápido · Python · Discord





O TinySearch é uma ferramenta de pesquisa web auto-hospedada para agentes de IA. Ele pesquisa a web, lê as melhores páginas, remove conteúdo de baixo valor e retorna evidências compactas com URLs de origem.
Seu modelo recebe as passagens úteis em vez de pagar para processar páginas web inteiras.
O TinySearch faz parte do TinySuite, um conjunto de ferramentas focadas projetadas para tornar operações de agentes mais baratas, minimizando o uso de tokens por meio de técnicas inteligentes de recuperação, seleção e gerenciamento de contexto.
Escolha um nível
| Nível | Use quando | Ponto de entrada | Backend de busca |
|---|---|---|---|
| 1. Biblioteca Python | Você está desenvolvendo com TinySuite ou Python | pip install tinysuite-search | DDGS |
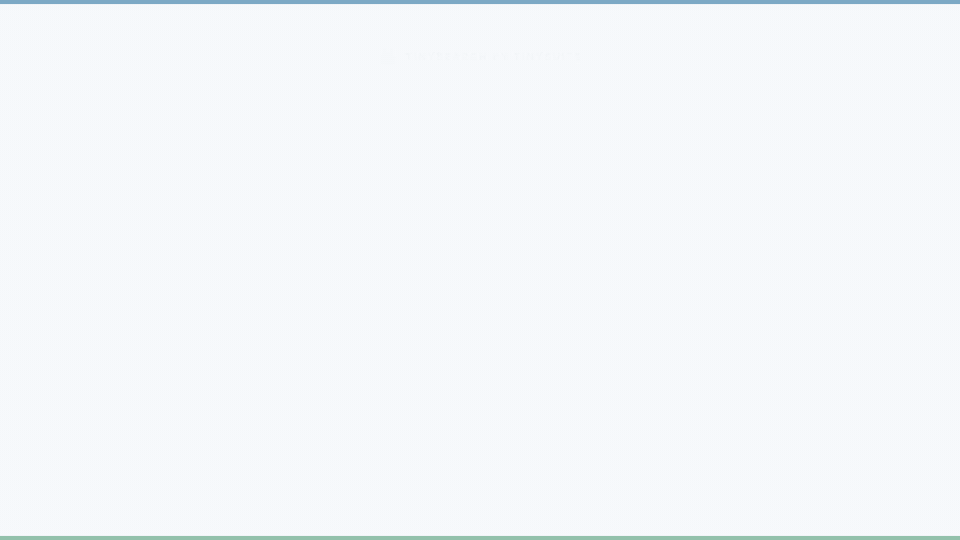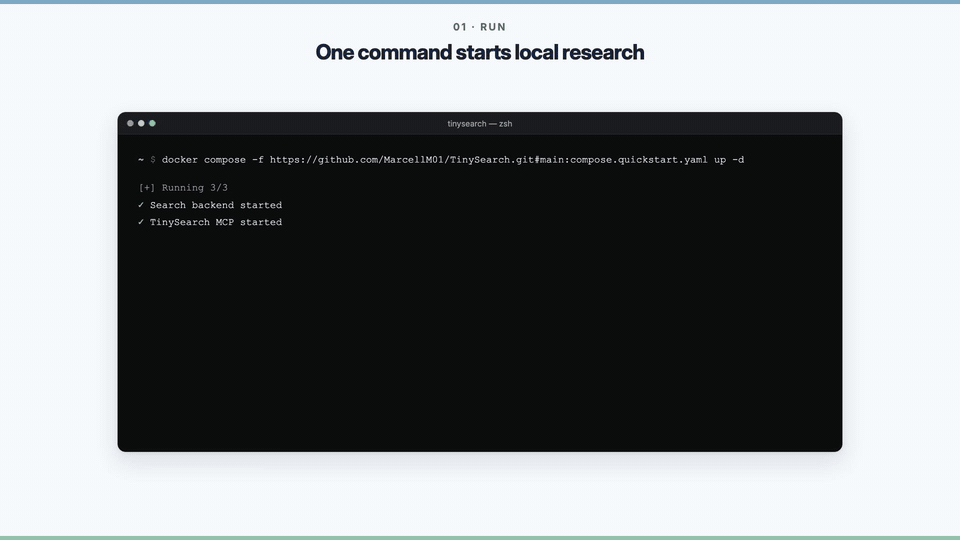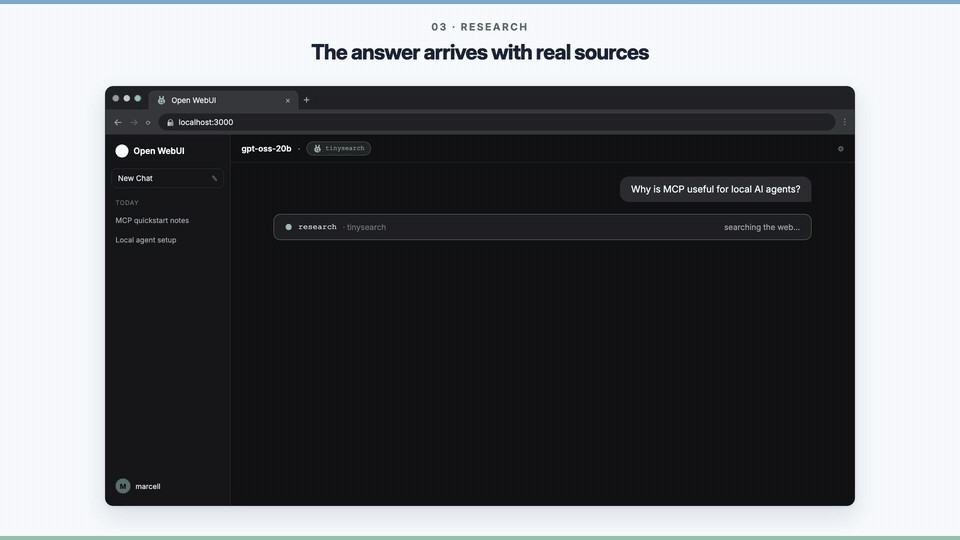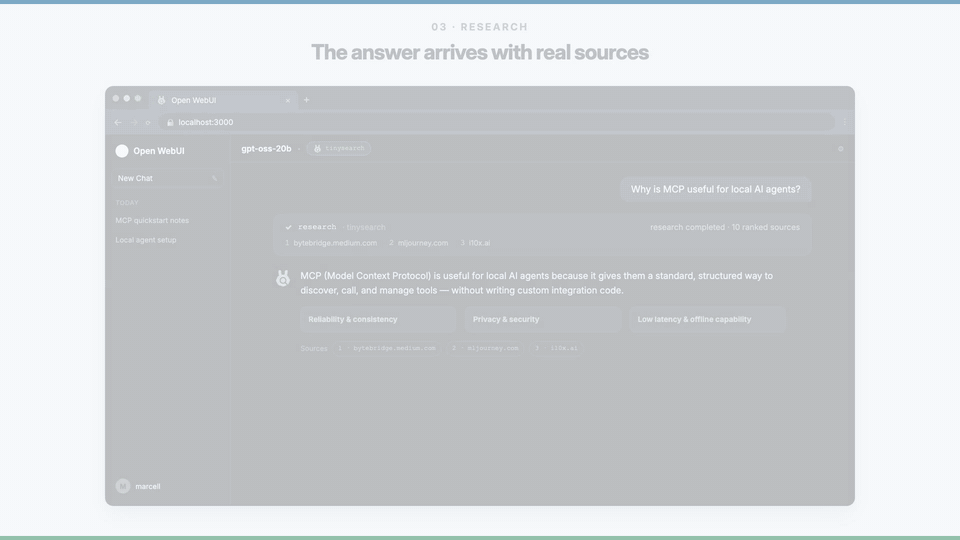
| 2. MCP de comando único | Um cliente MCP deve iniciar o TinySearch para você | uvx --from "tinysuite-search[server]" tinysearch | DDGS |
| 3. Docker + SearXNG | Você quer a pilha completa auto-hospedada e MCP HTTP | docker compose ... up -d | SearXNG incluído |
Os níveis 1 e 2 não precisam de serviço de busca. O nível 3 adiciona um serviço SearXNG dedicado, armazenamento persistente de modelos e um endpoint MCP de rede. Consulte o guia de instalação para a configuração Docker.
A parte cara da pesquisa de agentes é o contexto
Um resultado de busca ainda não é evidência útil. Os agentes muitas vezes precisam abrir várias páginas, absorver navegação e conteúdo padronizado, e gastar tokens de entrada pagos decidindo quais passagens importam.
O TinySearch move esse trabalho para antes do modelo:
flowchart LR
    A[Question] --> B[Search and crawl]
    B --> C[Local hybrid reranking]
    C --> D[Compact evidence<br/>with source URLs]
    D --> E[Your agent]
Isso reduz o custo de três maneiras:
- Contexto de modelo menor. Apenas os trechos de evidência melhor classificados são retornados, dentro de um orçamento de evidências controlado.
- Nenhuma API de busca medida necessária por padrão. O TinySearch pode buscar via DDGS sem um provedor de busca pago.
- Recuperação local por padrão. Embeddings ONNX e reclassificação híbrida rodam na sua máquina em vez de gerar cobranças de API de embeddings.
Busque amplamente. Leia localmente. Pague ao modelo apenas pelas evidências que importam.
Isso é recuperação, não sumarização: o TinySearch seleciona as passagens que valem manter com BM25 local e reclassificação por embeddings; ele não executa um modelo sobre a página para reescrever ou condensar. Cada trecho retornado é o texto original da página, sem edição, então o que você cita é o que a página realmente disse. Isso mantém o pipeline rápido e gratuito para rodar localmente, ao custo de não compactar tão agressivamente quanto um modelo de redução dedicado poderia. Uma etapa de redução aprendida é uma direção que podemos explorar depois; não faz parte do TinySearch hoje.
A economia real depende das páginas, dos limites de evidência, do modelo do cliente e do preço do provedor. O TinySearch reduz o conteúdo web enviado ao modelo; ele não controla o que o cliente faz com essa evidência depois.
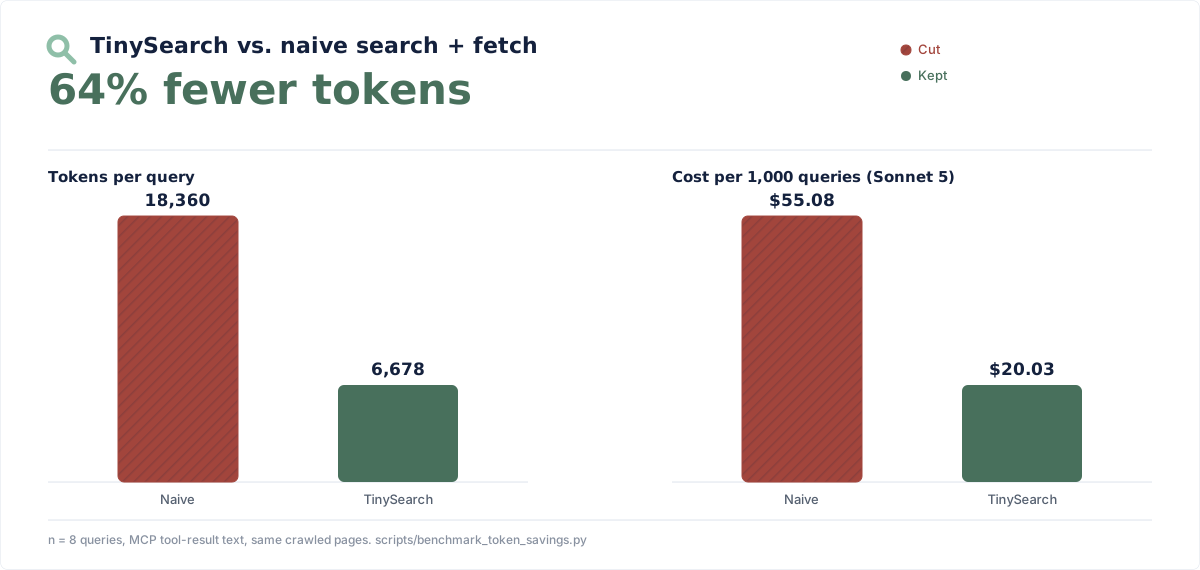
O painel de custo usa uma taxa ilustrativa de US$ 3,00 por milhão de tokens de entrada e exclui busca, rastreamento, saída do modelo e uso downstream pelo agente.
A linha de base ingênua não é um produto fictício; são as mesmas páginas que o TinySearch
rastreou para cada consulta, alimentadas ao modelo sem filtro, da mesma forma que uma
ferramenta genérica de "buscar, depois buscar a página" (um loop simples de busca-e-busca-de-página, do
tipo embutido na maioria dos agentes de codificação) faria. Medido em relação ao fluxo
recomendado atual (search e depois scrape_urls) e contado no texto real do resultado da ferramenta MCP,
a interface principal do TinySearch. Reproduza ou execute novamente você mesmo:
python scripts/benchmark_token_savings.py --json-out report.json
Início rápido
Com uv instalado, adicione o TinySearch a qualquer cliente
MCP:
{
  "mcpServers": {
    "tinysearch": {
      "command": "uvx",
      "args": [
        "--python",
        "3.12",
        "--from",
        "tinysuite-search[server]",
        "tinysearch"
      ]
    }
  }
}
O cliente inicia o TinySearch via stdio quando precisa. Não é necessário clonar repositório, conta hospedada ou chave de busca paga.
O search rápido inicia sem Chromium ou modelo de embeddings. O primeiro scrape
inicializa o Chromium; o scraping focado também inicializa o modelo de embeddings
configurado. Pré-aqueça ambos com antecedência se você for usar esses fluxos de trabalho:
uvx --from "tinysuite-search[server]" tinysearch setup
Os servidores MCP e FastAPI mantêm o navegador de scraping aquecido entre
solicitações próximas e o fecham após browser_idle_shutdown_seconds. Chamadas Python
diretas mantêm seu ciclo de vida curto e de propriedade do chamador.
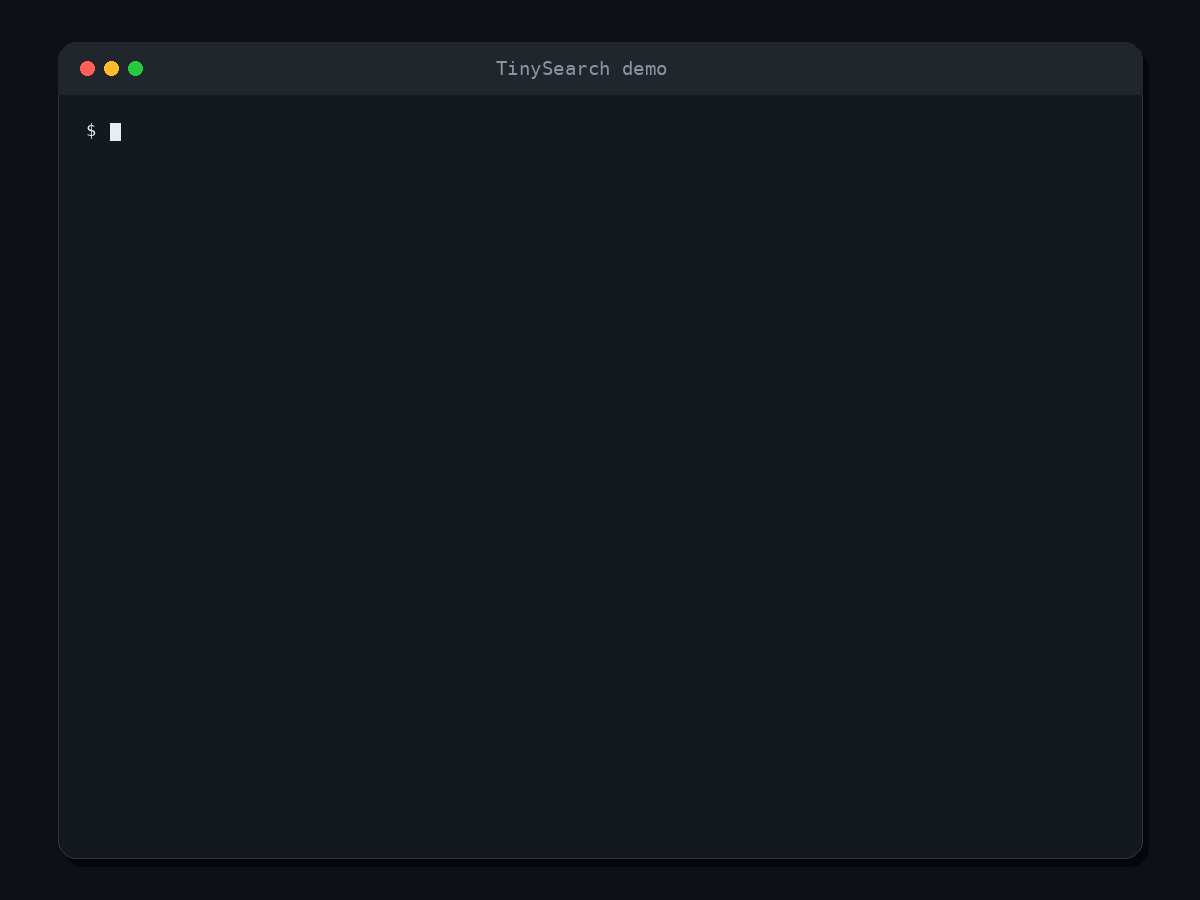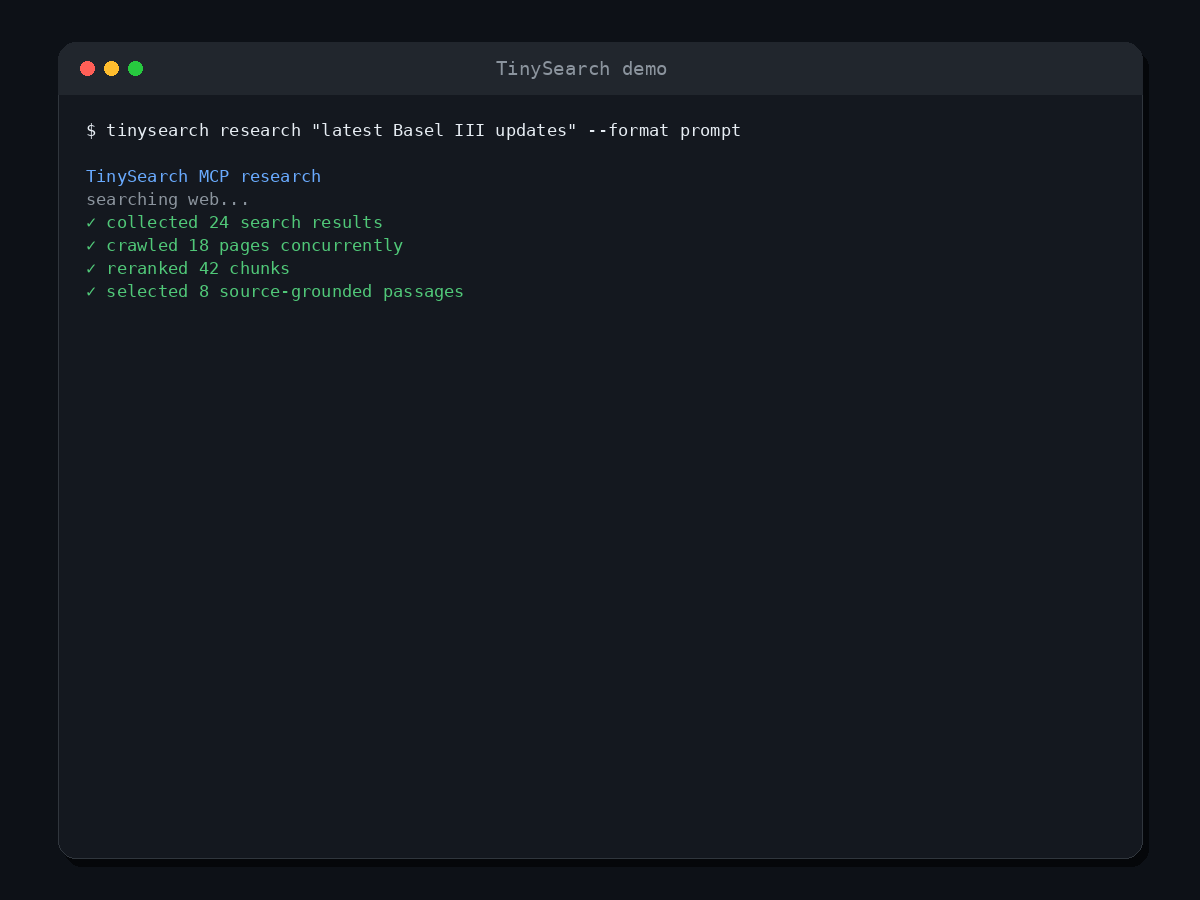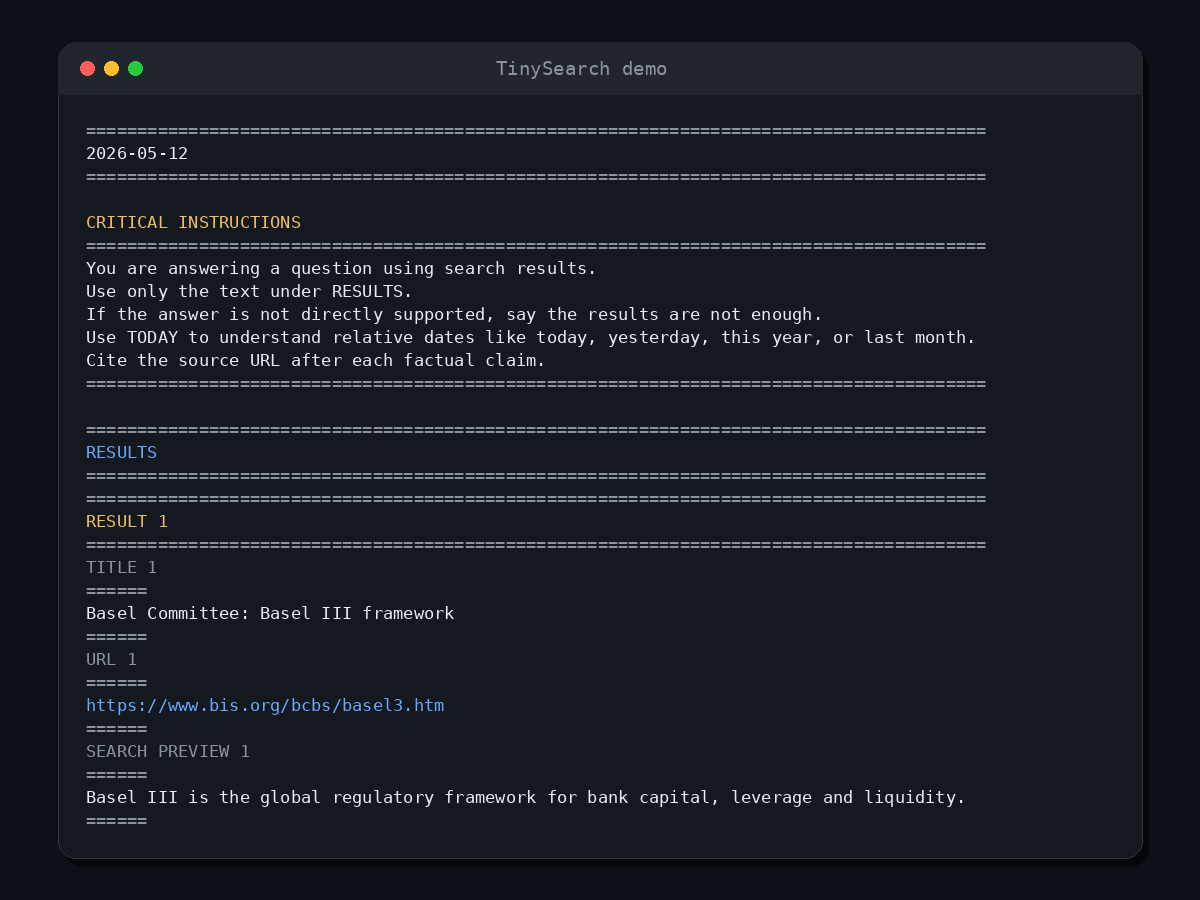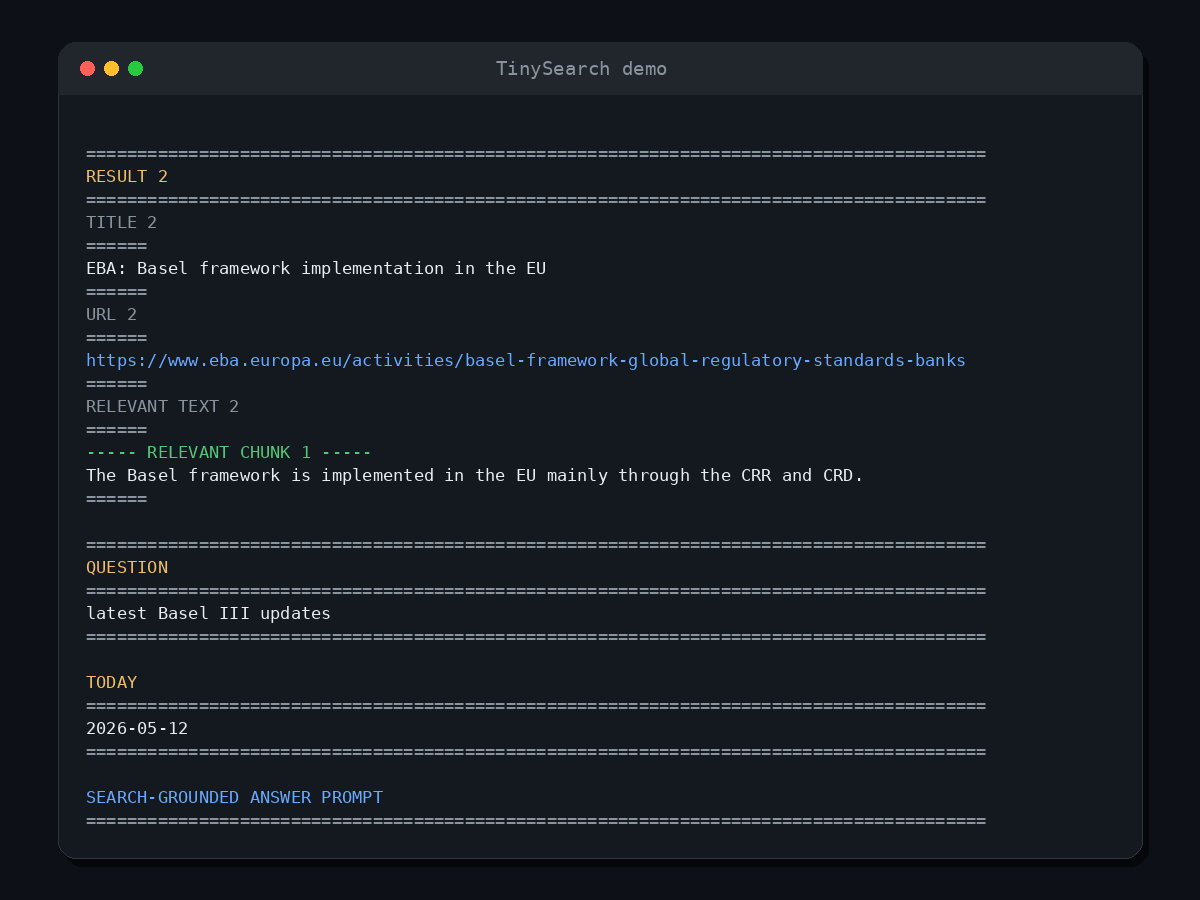
Prefere Docker, um endpoint MCP remoto ou um checkout do código-fonte? Siga o guia de instalação.
As ferramentas MCP
| Ferramenta | Use quando |
|---|---|
search(items) | Você precisa de descoberta rápida e ordenada pelo backend, sem rastreamento ou reclassificação; agrupe subperguntas independentes quando útil |
scrape_urls(items) | Você conhece de uma a cinco páginas; cada item pode usar * para seu orçamento de tokens de ordem de página limpa configurado |
browser_navigate / browser_act | Uma página precisa de interação antes de ser lida; veja Automação de navegador |
get_current_datetime() | Uma pergunta depende da data ou hora atual |
O TinySearch permanece deliberadamente focado. É uma camada de recuperação, não outro agente, interface de chat, produto de busca hospedado ou índice web permanente.
Consulte a referência completa de ferramentas MCP para parâmetros e contratos de resposta.
O que seu agente recebe
O TinySearch não gasta outra chamada de modelo escrevendo a resposta final. O
fluxo recomendado é search para descoberta leve e depois scrape_urls para
as páginas que valem a pena ler.
A busca retorna JSON estruturado. Use um item para uma consulta simples; adicione vários
itens apenas para subperguntas independentes ou estratégias de fontes. domains é uma
restrição de fonte positiva rígida e aceita um domínio mais seus subdomínios:
{"items":[{"query":"Form 8-K Tesla","domains":["sec.gov"]}]}
Cada item de busca relata seus próprios resultados e tentativas compactas de backend. Uma resposta
com zero resultados é distinta de um backend bloqueado, indisponível ou inválido.
scrape_urls retorna evidências Markdown selecionadas e candidatos separados de navegação por
links relacionados, cada um com tetos de tokens configurados independentemente.
O MCP ainda usa seu envelope de transporte JSON-RPC padrão, incluindo
erros de nível de protocolo e structuredContent opcional. Python e FastAPI mantêm
seus contratos JSON estruturados para aplicações que precisam armazenar, inspecionar
ou transformar as evidências.
Como funciona
searchretorna títulos, URLs, prévias, datas upstream e resultados de backend ordenados pelo backend, sem iniciar Chromium ou um modelo de embeddings.scrape_urlslê de uma a cinco páginas conhecidas simultaneamente. Omita a consulta de um item ou use"*"para manter Markdown limpo em ordem de página dentro do orçamento de tokens configurado.- Forneça uma consulta de item focada quando o TinySearch deve dividir em trechos e reclassificar por híbrido essa página antes de retornar evidências.
- As ferramentas
browser_*entram em ação apenas quandoscrape_urlsnão consegue alcançar o conteúdo porque ele precisa de interação. Veja Automação de navegador.
Biblioteca Python
O TinySearch também funciona como um pacote Python comum:
pip install tinysuite-search
Exportação opcional OpenTelemetry
O TinySearch emite traces e métricas neutros de fornecedor apenas quando o OpenTelemetry está explicitamente configurado. O comportamento normal da biblioteca, MCP e FastAPI permanece inalterado quando a telemetria não está instalada ou configurada.
Instale o suporte opcional de exportador para um servidor MCP autônomo:
uvx --from "tinysuite-search[server,telemetry]" tinysearch
A imagem Docker oficial inclui o mesmo suporte opcional. Defina variáveis OTel padrão em qualquer implantação; o endpoint comum habilita traces e métricas:
OTEL_SERVICE_NAME=tinysearch \
OTEL_EXPORTER_OTLP_ENDPOINT=http://collector:4318 \
OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf \
tinysearch serve
http/protobuf é o padrão e grpc também é suportado. Use
OTEL_TRACES_EXPORTER=none, OTEL_METRICS_EXPORTER=none ou
OTEL_SDK_DISABLED=true para desabilitar a telemetria. Configurações padrão de recurso, cabeçalho,
timeout, amostrador e endpoint específico de sinal são repassadas ao
SDK OpenTelemetry; trate OTEL_EXPORTER_OTLP_HEADERS como um segredo.
O TinySearch exporta tempos de operação/etapa, resultados, contagens, estado do backend, uso do navegador, contagens de tokens e metadados do modelo de embeddings. Ele nunca exporta consultas, URLs, domínios, prompts, documentos, trechos, cabeçalhos de solicitação, credenciais, caminhos de configuração, erros brutos, pilhas de exceção, argumentos MCP ou resultados MCP. Usuários diretos da biblioteca Python configuram seu próprio provedor OTel; o TinySearch só configura automaticamente seus pontos de entrada de servidor MCP e FastAPI autônomos.
import asyncio
from tinysearch import scrape_urls, search


async def main():
    results = await search([{"query": "Python async tasks"}])
    print(results["items"][0]["results"])

    page_url = results["items"][0]["results"][0]["url"]
    evidence = await scrape_urls([{
        "url": page_url,
        "query": "How does asyncio cancellation work?",
    }])
    print(evidence["results"])


asyncio.run(main())
A API Python retorna resultados estáveis e serializáveis em JSON. search aceita de um
a cinco itens e usa o limite de resultados por item configurado. scrape_urls aceita um orçamento max_tokens
por chamada (4.000 por padrão); omita a consulta de scrape do item ou use "*" para o
modo de ordem de página. Renderizar evidências estruturadas em um prompt de LLM é explícito,
para que as aplicações possam armazenar, inspecionar, transformar ou orçar o resultado primeiro.
O aplicativo FastAPI opcional espelha essas superfícies. POST /search aceita o
mesmo contrato JSON em lote.
POST /scrape aceita de um a cinco itens { "url", "query" } e sempre
retorna resultados estruturados por item.
POST /browser/navigate e POST /browser/act espelham as duas ferramentas de navegador MCP
e retornam sua visão de acessibilidade como { "result": "..." }.
O aplicativo também expõe /health, /current_datetime e /config somente leitura;
gravações de configuração exigem aceitação explícita por variável de ambiente.
Backends de busca
O TinySearch seleciona um backend de busca web a partir da configuração, para que você possa começar sem serviço de busca e adicionar um depois sem mudar código.
"ddgs"(padrão nativo): consulta a seleção automática de backend do pacoteddgsem processo. Nenhuma implantação SearXNG necessária."searxng"(padrão Docker): consulta uma instância SearXNG auto-hospedada. Faz fallback paraddgsem falha de backend, a menos quesearch_backend_fallbackesteja definido comofalse."duckduckgo": pula SearXNG e consultaddgsno modo somente DuckDuckGo."auto": tenta SearXNG e depois faz fallback paraddgsem qualquer falha de backend.
Defina a variável de ambiente BRAVE_SEARCH_API_KEY para adicionar a API oficial
Web Search da Brave como fallback com chave para os backends ddgs e duckduckgo.
A Brave só é consultada quando a chamada primária erra ou retorna nenhum resultado.
A referência completa de chaves, a configuração de saída JSON do SearXNG e os detalhes do Compose estão na referência de configuração.
Automação de navegador
scrape_urls é uma busca estática. Ela não consegue ver conteúdo que o JavaScript renderiza
após o carregamento, conteúdo atrás de um aviso de cookies, um controle de "carregar mais" ou uma
interface de busca no lado do cliente. Para essas páginas, o TinySearch aciona um navegador real.
Isso não custa nada extra para instalar. O TinySearch já depende do Playwright via Crawl4AI e já instala seu Chromium para scraping, então as ferramentas de navegador reutilizam o mesmo driver e o mesmo navegador: sem segundo runtime, sem segundo navegador, sem processo filho.
Duas ferramentas: browser_navigate e browser_act, a segunda reunindo look,
click, type, wait_for, tabs e close atrás de um
único parâmetro action.
Essa divisão é intencional. O MCP não tem como agrupar ou aninhar ferramentas — tools/list
é plano e todo esquema é reenviado ao modelo a cada requisição — então sete
ferramentas de navegador separadas dominariam o esquema do servidor. Publicar o ponto
de entrada como uma ferramenta própria e dobrar o ciclo de vida de uma sessão de página
atrás de um despachante mantém o esquema de todo o servidor compacto em cinco ferramentas.
Não há uma ferramenta de busca separada, porque buscar não é um irmão de clicar —
é um filtro sobre o resultado. Ambas as ferramentas aceitam um argumento find, tentado como
regex primeiro (então "a|b" funciona diretamente) e recorrendo a uma correspondência
literal de substring sem diferenciar maiúsculas de minúsculas para texto que não é regex válido — estreitando
o valor de retorno para os nós correspondentes e seu contexto em vez da árvore
inteira. É isso que permite que uma única chamada aja e relate: um clique que revela uma
tabela retorna como a tabela, então o agente nunca gasta uma segunda chamada
estreitando a resposta da primeira. Uma versão anterior dividia isso em find
e find_regex; isso custava uma viagem de ida e volta desperdiçada sempre que um modelo usava
sintaxe de alternância no parâmetro de substring simples e recebia "sem correspondências"
em vez de uma dica, então os dois foram mesclados.
O modelo lê uma árvore de acessibilidade compacta onde cada nó carrega uma ref estável, nomeia um, e o TinySearch age sobre ele com eventos reais de entrada do navegador:
browser_navigate  -> url: "...", find: "Accept"   -> "- button \"Accept all\" [ref=e79]"
browser_act       -> action: "click", target: "e79", find: "Results"
Nada sintetiza eventos DOM ou inventa seletores CSS, e click/type
aceitam apenas uma ref que o modelo realmente observou, nunca um seletor bruto.
Três escolhas deliberadas:
- Nenhuma ferramenta pode executar código. Não há ferramenta
evaluate, e nenhuma que preencha formulários, faça uploads ou arraste. Uma página que injeta instruções em seu próprio texto renderizado não tem nada perigoso para alcançar, porque a capacidade está ausente em vez de desencorajada. findé a alavanca de tokens,deptho fallback. Qualquer chamada que retorne uma visão aceitafind, cortando-a para os nós correspondentes e seu contexto. Quando nenhum filtro pode nomear o alvo,depthretorna uma árvore mais rasa, mas ainda válida, em vez de uma string truncada — em uma página grande, ~700 caracteres versus ~33.000.- Cookies persistem, sessões não. Defina
browser_storage_state_pathe um banner de consentimento aceito uma vez não é pago em toda navegação posterior. As sessões permanecem isoladas, então nenhum bloqueio de perfil de navegador é obtido e clientes concorrentes não entram em conflito. Esse arquivo é um caminho no lado do servidor, nunca exposto a um modelo ou via HTTP.
Para desligar as ferramentas completamente, defina "browser_backend": "off"; elas são então
removidas da lista de ferramentas em vez de apenas se recusarem a executar.
Navegador externo via CDP
Para dirigir um navegador que você opera separadamente, defina seu endpoint do Chrome DevTools Protocol. Ele é usado por ambos o pipeline de raspagem e as ferramentas de navegador:
{
  "browser_cdp_url": "http://browser:9222"
}
Processos do servidor também aceitam TINYSEARCH_BROWSER_CDP_URL. O navegador externo
possui seu próprio executável, perfil, proxy e configuração de impressão digital; o TinySearch
não seleciona ou instala um backend de navegador específico.
Trate um endpoint CDP como controle remoto privilegiado do navegador. Mantenha-o em uma
rede privada ou interface de loopback, exija autenticação quando ele cruzar
um limite de host, e não exponha a porta 9222 diretamente à internet pública.
Quando o próprio TinySearch roda em Docker, localhost refere-se ao contêiner
TinySearch, então use um endpoint alcançável a partir desse contêiner.
browser_backend, browser_cdp_url, e browser_storage_state_path são
gerenciados pelo operador e não podem ser alterados através do
endpoint HTTP PUT /config, mesmo quando gravações de configuração estão habilitadas. Defina
eles no ambiente de inicialização (TINYSEARCH_BROWSER_BACKEND e amigos) ou
no arquivo selecionado por TINYSEARCH_CONFIG_PATH, então reinicie o TinySearch. Clientes
HTTP podem continuar atualizando outras configurações omitindo esses campos de
sua atualização parcial.
Proxies
Para rotear a raspagem através de um proxy, defina browser_proxy_server:
{
  "browser_proxy_server": "http://gateway.proxyprovider.com:8000",
  "browser_proxy_username": "your-username",
  "browser_proxy_password": "your-password"
}
URLs de proxy http, https, e socks5 são suportadas, correspondendo ao que
o Playwright aceita. Se seu provedor distribui vários endpoints de gateway
fixos, separe-os por vírgula e o TinySearch faz round-robin um por novo
contexto de navegador:
{
  "browser_proxy_server": "http://gw1.proxyprovider.com:8000, http://gw2.proxyprovider.com:8000"
}
Use browser_proxy_bypass para uma lista separada por vírgulas de hosts que devem
pular o proxy. Esses quatro campos são gerenciados pelo operador como as configurações de CDP
acima — configuráveis via TINYSEARCH_BROWSER_PROXY_SERVER,
TINYSEARCH_BROWSER_PROXY_USERNAME, TINYSEARCH_BROWSER_PROXY_PASSWORD, e
TINYSEARCH_BROWSER_PROXY_BYPASS, ou o arquivo de configuração, mas nunca via HTTP.
Por que TinySearch
- Nenhum fornecedor no meio. Sem conta TinySearch, sem chave de API obrigatória, sem cobrança por requisição, sem serviço de análise ou cache de dados raspados hospedado. A infraestrutura que você pagaria a uma API de busca roda na sua máquina.
- Fundamentado na fonte por construção. Cada pedaço de evidência é o texto original da página, ainda anexado à sua URL de origem, então uma afirmação na resposta do seu agente rastreia até uma passagem específica em vez de parar em "o modelo do fornecedor disse isso."
- Construído em torno da eficiência de tokens. Seleção de página e seleção de passagem acontecem localmente, antes que o conteúdo entre no contexto do modelo.
- Útil sem infraestrutura paga. Busca DDGS e embeddings ONNX locais são os padrões.
- Traga sua própria pilha quando necessário. Provedores de embedding compatíveis com SearXNG e OpenAI permanecem opcionais.
- Funciona onde os agentes já funcionam. Use MCP via stdio, Streamable HTTP, Python, FastAPI ou Docker.
Parte do TinySuite
TinySuite é uma suíte de produtos construída em torno de uma ideia: agentes devem gastar tokens em trabalho útil, não em sobrecarga operacional.
Cada ferramenta foca em uma parte diferente do fluxo de trabalho do agente e usa técnicas direcionadas para reduzir contexto desnecessário antes que ele alcance o modelo. O TinySearch lida com a camada de pesquisa web transformando páginas em um pequeno, ranqueado e fundamentado na fonte pacote de evidências.
Documentação
O README é a visão geral do produto. Material detalhado de configuração e operacional vive na documentação do TinySuite:
- Visão geral e instalação do TinySearch
- Referência de configuração
- Ferramentas MCP
- Solução de problemas
O repositório também contém uma configuração de exemplo anotada em
configs/tinysearch_config.json.
Quando não usar TinySearch
O TinySearch é intencionalmente leve. Use uma API de busca comercial, raspador persistente ou índice de busca completo quando precisar de:
- cobertura de busca garantida ou um SLA
- indexação em larga escala ou agendada
- armazenamento de páginas de longo prazo e histórico de mudanças
- observabilidade empresarial e controles de acesso
Desenvolvimento
git clone https://github.com/TinySuiteHQ/TinySearch
cd TinySearch
python -m venv .venv
source .venv/bin/activate
pip install -e ".[server]"
python -m unittest discover tests
O TinySearch suporta Python 3.12 e mais recente. CI testa Python 3.12, 3.13 e 3.14 em Linux, macOS e Windows.
Pontos de entrada
tinysearch.searchetinysearch.scrape_urls: API Python estruturadatinysearch.get_current_datetime: data e hora UTC estruturadastinysearch.to_prompt: renderizador de prompt de evidência estruturada purotinysearch mcp: servidor MCP stdio (também o padrão sem argumentos)tinysearch serve: servidor MCP Streamable HTTPtinysearch.servers.fastapi_server:app: aplicação FastAPI opcional
Comunidade
Perguntas, ideias e relatórios de bugs são bem-vindos:
Privacidade e licença
O TinySearch lê páginas públicas e retorna trechos selecionados ao cliente chamador. Busca, raspagem, embeddings locais e reclassificação podem rodar sem enviar conteúdo de página a um provedor de embeddings. Se você escolher um backend de embeddings compatível com OpenAI, esse provedor recebe o texto enviado para vetorização.
O TinySearch está disponível sob a Licença MIT. Pesos de modelo baixados permanecem sujeitos às respectivas licenças de seus cartões de modelo. Veja NOTICE para detalhes de distribuição de terceiros.