Toon Memory
toon-memory é um servidor MCP de memória persistente 100% local, projetado para assistentes de código com IA (Cursor, Claude Code, Windsurf, etc.). Utiliza o formato ultraeficiente TOON para reduzir o consumo de tokens em até 30%, permitindo que os agentes salvem, busquem e consolidem o contexto e as decisões do projeto entre sessões de forma privada e criptografada (AES-256).
Documentação
English | Español | 中文 | 日本語 | 한국어 | Português (BR) | Deutsch | Français
toon-memory
A Camada de Continuidade para Agentes de IA — agentes de IA não deveriam ter que reaprender seu projeto a cada sessão.


Sumário
- Visão Geral
- Post do Blog
- Recursos
- Instalação
- Agentes Suportados
- Ferramentas MCP
- Coordenação multi-sessão
- Grafo de Memória (recall baseado em grafo)
- Dicas e Melhores Práticas
- Comandos CLI
- Configuração
- Como Funciona
- Por que TOON?
- Solução de Problemas
- FAQ
- Desenvolvimento
- Contribuição
- Segurança e Privacidade
- Licença
Visão Geral
Já teve aquela sensação de que seu agente de IA esquece tudo da sessão de ontem? Você explica a mesma decisão de arquitetura pela terceira vez, e ele ainda sugere a abordagem que você já rejeitou?
toon-memory resolve isso. É a Camada de Continuidade para Agentes de IA — um sistema leve que preserva o conhecimento, as decisões e as convenções do seu projeto entre sessões, para que cada sessão comece de onde a última terminou. Totalmente local e privado, via MCP — sem nuvem, sem servidor.
Casos de uso reais
| Cenário | O que o toon-memory faz |
|---|---|
| Debates de design | "Escolhemos Redis em vez de Memcached por causa do suporte a pub/sub" |
| Escolhas de framework | "Este projeto usa Zod para validação, não Joi" |
| Correções de bugs | "Esgotamento do pool Redis — a correção foi max_connections=20" |
| Notas de arquitetura | "O serviço Broker usa o protocolo RESP, não HTTP" |
| Onboarding | "O script de deploy fica em scripts/deploy.sh" |
| Contexto da equipe | "O PR #142 reverteu a mudança de cache — não a re-adicione" |
Post do Blog
Leia Como o toon-memory torna seu agente de IA mais inteligente para ver uma demonstração real de memória persistente em ação.
Recursos
- Um kit de memória completo — Gerenciamento completo de memória via Model Context Protocol, incluindo
memory_smart_recall(recall unificado com viés de sessão),memory_sessionspara coordenação multi-sessão,context_*ferramentas para geração de contexto em uma chamada (briefing, diff, foco, auditoria de saúde, exportação),memory_compress(compressão com LLM),memory_consolidate(deduplicação/merge/limpeza determinística),memory_primer(contexto injetado automaticamente),memory_merge_sessions(merge entre sessões),memory_pin/memory_unpin(fixar entradas importantes com prioridade 1-5),memory_checkpoint(snapshot de sessão com TTL de 7d),memory_search(busca unificada com filtros de tag + viés de sessão),memory_tag(operações de tag em lote),memory_export_gist/memory_import_gist(sincronização com GitHub Gist),memory_secret(cofre de segredos criptografado),memory_export_global/memory_import_global(convenções entre projetos),memory_forget(exclusão suave/definitiva, restauração, substituição),memory_reflect(reflexão de obsolescência/qualidade) ememory_promote(promoção automática de rascunhos de baixa confiança) - Recursos MCP — Leia memória como contexto sem invocações de ferramenta, incluindo um Primer de Sistema (mapa de conhecimento gerado automaticamente)
- 22 agentes suportados — OpenCode, VS Code, Claude Code, Cursor, Windsurf, Cline, Continue, Codex CLI, Gemini CLI, Zed, Antigravity, Aider, KiloCode, OpenClaw, Kiro, Qwen, Kimi, Goose, Junie, Amp, Grok, Trae
- Instalador interativo — Selecione quais agentes configurar a partir de um menu
- Hooks de SessionStart — Lembretes automáticos para Claude Code, Codex CLI, Gemini CLI, Antigravity
- Formato TOON — 22% menos tokens que JSON (medido), melhor compreensão por LLMs
- Memória por projeto — Cada projeto tem seu próprio arquivo de memória
- Zero configuração — Basta instalar e usar
- Auto gitignore — Adiciona automaticamente
.toon-memory/memory/ao.gitignore - Filtro por data — Busque memória por intervalo de datas
- Arquivamento automático — Entradas antigas (>30 dias), entradas com TTL expirado ou 100+ entradas são movidas para o arquivo automaticamente
- Criptografia — Criptografia AES-256-GCM para dados sensíveis
- Modo de observação — Backup automático a cada N minutos
- TTL de memória — Expiração configurável por entrada (7d, 30d ou datas exatas)
- Inferência de tags — Detecta tags automaticamente a partir do conteúdo quando as tags estão vazias (vocabulário embutido + dependências do projeto)
- Diff de memória — Veja o que mudou desde sua última sessão
- Entradas relacionadas — Sugere memórias relacionadas automaticamente ao salvar
- Grafo de memória — Conecte entradas com referências
links/[[key]];memory_recallpode expandir um subgrafo ciente de relacionamentos para recall mais preciso e com menos tokens (sem embeddings, sem LLM) - Recall eficiente em tokens —
memory_recall({ compact: true })retorna entradas indexadas numericamente, removeid/date/file, renderiza arestas do grafo como->2e trunca vizinhos do grafo em trechos - Ranking BM25 + centralidade — O recall reordena por relevância BM25 e centralidade no grafo (hubs aparecem mesmo sem a palavra da consulta); decaimento por salto mantém nós distantes baixos
- Auto-tag a partir de dependências —
toon-memory initescaneiapackage.json/Cargo.toml/requirements.txt/go.mode escreve um vocabulário do projeto para que entradas que mencionem uma dependência sejam automaticamente marcadas com ela - Recall inteligente —
memory_smart_recallcombina BM25 + grafo + decaimento + qualidade em uma única chamada; o LLM chama isso no início de cada tarefa - Pontuação de qualidade — Cada entrada recebe uma pontuação de qualidade de 0–1 baseada na estrutura (tags, links, especificidade do conteúdo, recência, contagem de acessos); entradas de alta qualidade aparecem primeiro
- Merge-dedup — Salvar com o mesmo
keymescla atributos (união de tags, confiança máxima, data mais recente, links combinados) em vez de sobrescrever - Detecção de quase-duplicados — A consolidação detecta quase-duplicados via similaridade de Jaccard (limiar 0.7) e os mescla
- Pontuação de confiança — Cada entrada rastreia confiabilidade: afirmada pelo usuário = 1.0, inferida = 0.65–0.75
- Compressão com LLM —
memory_compressusa IA para resumir entradas longas;memory_consolidate(mode: "low-quality")faz limpeza em lote de forma determinística - Merge entre sessões —
memory_merge_sessionsmescla observações entre sessões paralelas para um arquivo - Sincronização com GitHub Gist —
memory_export_gistememory_import_gistsincronizam entradas de memória via GitHub Gist (zero dependências) - Modo verbatim —
config.verbatimpreserva entradas originais em vez de sobrescrever ao salvar - Ferramentas de geração de contexto —
context_generate(briefing completo),context_diff(incremental),context_focus(direcionado),context_health(auditoria),context_export(markdown) — cada uma substitui 5-6 chamadas manuais de ferramenta. Zero LLM, agregação puramente determinística - Primer de Sistema — Injetado automaticamente no início da sessão via
systemPrimer(), mostrando as 5 principais memórias para contexto instantâneo - Escopo de caminho — Entradas podem ser limitadas a caminhos de arquivo via padrões glob (
path_scope); o recall filtra por escopo automaticamente - Controle de orçamento — Três níveis de saída:
budget: "tiny"(chave+1 linha, ~50 tokens),"normal"(compacto com tags/arestas),"deep"(todos os campos com origem/escopo/status). Compatível com versões anteriores viacompact: true - Rastreamento de origem — Cada entrada rastreia sua origem (
human,agent,inferred); afirmações humanas recebem um bônus de qualidade - Exclusão suave —
memory_forgetexclui suavemente por padrão (definestatus=obsolete). Restaure commemory_forget(key, action: "restore"), oculte comaction: "soft", remoção permanente viaaction: "hard" - Auditoria de saúde aprimorada —
context_healthagora detecta evidência ausente (path_scope sem arquivo) e alegações obsoletas (conteúdo sobreposto na mesma categoria) - Arestas de grafo tipadas — Arestas carregam tipos (
superseded_by,supersedes,relates), escritas comotype:keyno grafo.linksexplícitas tornam-serelates:key, para que você saiba como as entradas estão relacionadas, não apenas que estão - Ranking RRF — O recall funde BM25 (×3) e ranks de centralidade no grafo com Fusão de Rank Recíproco e um
k = clamp(3..60, round(sqrt(n)))adaptativo. Benchmark (8 consultas douradas): nDCG 0.776, MRR 0.917 — paridade exata com a pontuação linear anterior. Passerrf: falsepara reverter - Reflexão de memória —
memory_reflectclassifica entradas por obsolescência, qualidade e sobre-conexão para destacar o que precisa de atenção ou limpeza. Determinístico, zero LLM - Substituição de memória —
memory_forget(key, action: "supersede", new_key)marca uma entrada como substituída por uma mais nova (linksuperseded_by+ datasupersededOn).memory_recall({ as_of })re-inclui entradas antigas para consultas pontuais antes de sua substituição - Promoção automática —
memory_promotepromove rascunhos de baixa confiança para entradas ativas de forma determinística (limiar 0.65, dedup Jaccard), comdryRunpor padrão - Explique o PORQUÊ —
memory_recall/memory_smart_recallaceitamexplain: truee anexam uma linha de razão determinística a cada entrada retornada (↳ 100% relevance · used 14× · used today · importance HIGH) — por que foi recuperada, sem LLM - Orçamentos de tokens —
budget_tokenslimita a saída do recall por contagem estimada de tokens; entradas acumulam-se de forma gulosa e a cauda que excederia o orçamento é descartada (0= sem limite) - Substituição de versão —
memory_consolidate(mode: "versions")detecta entradas que descrevem o mesmo assunto em versões diferentes de bibliotecas (ex.: "Use React 18" vs "Use React 19") e aposenta as mais antigas em favor das mais novas - Memórias negativas — uma categoria
warningpara fatos de "NÃO faça isso"; entradaswarningrecebem um bônus de recall para que o agente veja as minas terrestres antes de repeti-las - Ranking por idioma + pasta — o recall impulsiona entradas escritas na mesma família de script (latim/CJK/cirílico/…) e entradas cujo
path_scopecorresponde ao arquivo atual - Importância explícita —
memory_remember({ importance })definecritical,high,mediumoulow. Decisões críticas aparecem primeiro (+0.3), notas baixas ficam fora do caminho (−0.1); vazio = automático (recência + frequência). Re-salvar mantém o nível mais alto - Camada de evidência — cada salvamento
memory_rememberé anotado com um nível de evidência:verifiedquando o arquivo referenciado existe no disco,unverifiedquando não existe,conflictquando sobrepõe um aviso ou decisão crítica/alta. Conflitos recebem um bônus de recall de +0.15 (verificado +0.03, não verificado −0.02) e um aviso ⚠️ CONTRADIÇÃO ao salvar — mas nunca bloqueiam a escrita - Cofre de segredos —
memory_secretarmazena credenciais em um sidecar criptografado (secrets.toon, AES-256-GCM) para quedata.toonpermaneça um formato aberto legível enquanto valores sensíveis nunca aparecem em texto puro - Importação/exportação de memória global —
memory_export_globalescreve memória do projeto em~/.toon-memory/memory/global.toon;memory_import_globalpuxa convenções entre projetos de volta com um merge determinístico, offline e de uma única vez (nunca uma fonte dupla ativa) - Instalação de ~1 MB — três pacotes de prompt minúsculos (
@inquirer/checkbox/select/confirm); o MCP SDK, zod e o parser TOON são empacotados no binário enviado — um úniconpm i -gbaixa ~1 MB (era ~14 MB) e ocupa ~4.4 MB no disco (era ~33 MB)
Instalação
1. Instale
# macOS / Linux
curl -fsSL https://raw.githubusercontent.com/LuiggiVal08/toon-memory/main/install.sh | sh

# Windows (PowerShell)
irm https://raw.githubusercontent.com/LuiggiVal08/toon-memory/main/install.ps1 | iex

# Or with npm (any platform)
npm i -g toon-memory
Dica: A instalação via npm é o método mais confiável. Os scripts curl/irm são wrappers de conveniência.
Tamanho: Um
npm i -g toon-memorysimples baixa ~1 MB e instala ~4.4 MB — três pacotes de prompt minúsculos; todo o resto (MCP SDK, zod, parser TOON) é enviado empacotado.
2. Configure seu(s) agente(s)
# Interactive installer — detects agents and configures MCP
npx toon-memory
O instalador irá:
- Detectar quais agentes de IA você tem instalados
- Perguntar quais deseja configurar
- Adicionar a configuração do servidor MCP automaticamente
3. Use
É isso! Na sua próxima sessão com o agente, tente:
memory_stats      # See what's in memory
memory_recall     # Search memory before reading files
memory_remember   # Save important decisions
Dica: Sempre execute
memory_recallno início de uma sessão. Seu agente terá contexto de sessões anteriores instantaneamente.
Configuração Rápida do Cliente MCP
Cursor
Adicione em .cursor/mcp.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Claude Desktop
Adicione em claude_desktop_config.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Windsurf
Adicione em ~/.codeium/windsurf/mcp_config.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Agentes Suportados
| Agente | Local da Configuração | Formato | Hooks | Configuração Automática |
|---|---|---|---|---|
| OpenCode | .opencode/opencode.json + .opencode/plugins/toon-memory.ts | Plugin | SessionStart (plugin, sem hooks de nível superior) | ✅ |
| VS Code / Copilot | .vscode/mcp.json | JSON | — | ✅ |
| Claude Code | .mcp.json (MCP) + .claude/settings.json (hooks) | JSON | SessionStart + PostToolUse + Stop | ✅ |
| Cursor | .cursor/mcp.json | JSON | — | ✅ |
| Windsurf | ~/.codeium/windsurf/mcp_config.json | JSON | — | ✅ |
| Cline | .cline/mcp.json | JSON | — | ✅ |
| Continue | .continue/config.json | JSON | — | ✅ |
| Codex CLI | .codex/config.toml | TOML | SessionStart + PostToolUse + Stop ([[hooks]] event=) | ✅ |
| Gemini CLI | .gemini/settings.json | JSON | SessionStart + PostToolUse + Stop (hooks.*) | ✅ |
| Zed | ~/.config/zed/settings.json | JSONC | — | ✅ |
| Antigravity | .agents/mcp_config.json + .agents/hooks.json | hooks.json | PreInvocation + PostToolUse + Stop (sem evento SessionStart) | ✅ |
| Aider | — | — | — | 📝 Instruções |
| KiloCode | ~/.kilocode/mcp_settings.json | JSON | — | ✅ |
| OpenClaw | .openclaw.json | JSON | — | ✅ |
| Kiro | .kiro/settings/mcp.json | JSON | — | ✅ |
Dica: Você pode configurar o toon-memory para vários agentes ao mesmo tempo. Cada agente recebe o mesmo arquivo de memória compartilhada em
.toon-memory/memory/.
Ferramentas MCP
| Ferramenta | Descrição |
|---|---|
memory_remember | Salva uma decisão, padrão, bug, conhecimento ou aviso (memória negativa "NÃO faça isso", recuperada com prioridade) — TTL opcional, inferência automática de tags, links para construir o grafo de memória, mesclagem-deduplicação na mesma chave, pontuação de qualidade e confiança automáticas. Inteligência no caminho de escrita: cada salvamento é anotado com um nível de evidência — verified quando o arquivo referenciado existe no disco, unverified quando não existe, conflict quando sobrepõe um aviso ou decisão crítica/alta (recuperado com prioridade e exibido com um aviso ⚠️ CONTRADIÇÃO, mas nunca bloqueia a escrita) |
memory_recall | Busca na memória (use ANTES de ler arquivos, filtra TTL expirado). mode: "graph" expande um subgrafo sensível a relacionamentos para maior precisão. `budget: "tiny" |
memory_smart_recall | Recuperação unificada: BM25 + grafo + decaimento + qualidade em uma única chamada. sessionBias prioriza entradas do branch git atual. explain: true anexa motivos por entrada, budget_tokens limita a saída por tokens estimados. Use no INÍCIO de cada tarefa. Retorna saída compacta e eficiente em tokens |
memory_forget | Operações de ciclo de vida por chave ou id: action: "soft" (padrão) marca como obsoleto, "hard" remove permanentemente, "restore" traz de volta ao ativo, "supersede" aposenta com um link superseded_by para new_key |
memory_stats | Visualiza o estado da memória (incluindo estatísticas de TTL, distribuição de qualidade, detalhamento de origem/status, memórias frias abaixo dos limites de qualidade/acesso e métricas de taxa de acerto / duplicatas / obsoletas) |
memory_summary | Salva/recupera resumos de arquivos |
memory_archive | Arquiva entradas antigas (>30 dias) e entradas com TTL expirado |
memory_diff | Mostra alterações desde uma data (24h, 7d ou data exata) |
memory_suggest | Encontra entradas relacionadas para um determinado contexto |
memory_encrypt | Ativa criptografia AES-256-GCM |
memory_decrypt | Desativa criptografia |
memory_backup | Cria backup com timestamp do arquivo de memória (podando automaticamente para os 10 mais recentes) |
memory_captured | Lista atividades capturadas automaticamente por hooks (opt-in) ou limpa o log |
memory_checkpoint | Ponto de verificação de sessão: cria um snapshot do estado atual da memória com TTL de 7 dias. Útil para referência de reversão durante sessões longas |
memory_consolidate | Operações de limpeza, determinísticas (sem LLM): mode: "identical" (padrão) deduplica entradas de conteúdo idêntico, "similar" mescla quase-duplicatas (Jaccard >50%), "low-quality" remove em lote entradas de baixa qualidade (minQuality, dryRun), "versions" aposenta versões antigas de biblioteca em favor da mais recente |
memory_sessions | Mostra sessões de agente ativas (branch, arquivos, última visualização) e conflitos suaves para trabalho paralelo |
memory_compress | Compressão em duas etapas com LLM: resumir + sobrescrever. Usa CLI anthropic/openai se disponível, caso contrário retorna prompt para compressão manual |
memory_primer | Primer de contexto em uma chamada: principais memórias + categorias + alterações de arquivos da sessão. Injetado automaticamente no início da sessão |
memory_merge_sessions | Mescla observações entre sessões paralelas para um arquivo. Deduplica e opcionalmente promove automaticamente para memória |
memory_export_gist | Exporta entradas de memória para um GitHub Gist (público ou privado). Usa CLI GITHUB_TOKEN ou gh |
memory_import_gist | Importa entradas de um GitHub Gist. Mescla com entradas existentes (união de tags, confiança máxima) |
memory_secret | Cofre de segredos criptografado (secrets.toon, AES-256-GCM): store/get/list/forget. Mantém data.toon legível enquanto valores sensíveis permanecem criptografados em repouso. Requer TOON_MEMORY_KEY |
memory_export_global | Escreve a memória do projeto atual no arquivo global (~/.toon-memory/memory/global.toon). Compartilhamento único de convenções entre projetos |
memory_import_global | Mescla convenções entre projetos do arquivo global neste projeto (único, determinístico, offline). merge: false substitui em vez disso |
memory_graph_path | Caminho mais curto BFS entre duas entradas no grafo de conhecimento. Mostra como conceitos estão conectados |
context_brief | Briefing de contexto em uma chamada: memória + sessões + saúde em markdown compacto. Use em vez de 5-6 chamadas separadas memory_*. Zero LLM, agregação determinística pura |
context_generate | Briefing completo do projeto: combina estrutura do projeto, estado git, entradas de memória e sessões ativas em uma chamada. Substitui 5-6 chamadas manuais de ferramentas |
context_diff | Briefing incremental: commits git + arquivos modificados + memória nova/atualizada + sessões ativas desde a última sessão |
context_focus | Briefing hiperfocado: apenas memória relevante + arquivos de código-fonte relacionados + chamadores + arquivos de teste para uma consulta |
context_health | Auditoria de saúde da memória: links órfãos, duplicatas, referências de arquivos quebradas, TTL expirado, sessões obsoletas, pontuação 0–100 |
context_export | Exporta memória como markdown: contexto injetável para prompts de sistema (completo ou compacto) |
memory_pin | Fixar uma entrada com prioridade 1-5: entradas fixadas sempre aparecem primeiro nos resultados de recuperação ordenados por prioridade, mesmo sem correspondência de palavra-chave |
memory_unpin | Desafixar uma entrada: remove o sinalizador de prioridade |
memory_search | Busca unificada com filtros: igual a memory_recall mais filtros category, tags, from_date, to_date. O filtro de tags usa lógica AND — todas as tags especificadas devem corresponder. budget controla a verbosidade da saída. path_scope filtra por padrão glob. sessionBias prioriza entradas do branch git atual |
memory_tag | Operações de tags em lote: add, remove ou set tags em uma ou mais entradas por chave ou id |
Recursos MCP
A memória também é exposta como recursos MCP para leitura direta de contexto:
| Recurso | URI | Descrição |
|---|---|---|
| Entradas de Memória | toon://memory/entries | Despejo completo da memória |
| Memória Atual | toon://memory/current | Estado atual da memória com entradas recentes |
| Estatísticas de Memória | toon://memory/stats | Contagens de categorias e informações de TTL |
| Primer do Sistema | toon://memory/summaries | Mapa de conhecimento gerado automaticamente (principais entradas, categorias, padrões) |
Prompts MCP
| Prompt | Descrição |
|---|---|
summarize_project_context | Analisa a memória TOON atual e gera um resumo compacto do projeto. Parâmetro opcional intent para focar em uma área específica |
Exemplos
Lembrar uma decisão
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation — simpler than Joi, better TS support",
  file: "src/types.ts",
  tags: "validation;types"
})
// 🧠 Guardado: decision/use-zod (a1b2c3d4)
// Quality score: 0.65 (2 tags, detailed content)
// 🔗 Entradas relacionadas:
//   [pattern] zod-schemas — Shared Zod schemas for API validation
Dica: Use chaves descritivas como
use-zodem vez de vagas comovalidation. Seu agente busca por chave e conteúdo, então especificidade ajuda. Salvar com a mesma chave mescla automaticamente (união de tags, confiança máxima).
Lembrar com TTL
memory_remember({
  category: "knowledge",
  key: "sprint-deadline",
  content: "Sprint ends July 18, feature freeze is July 16",
  ttl: "7d"
})
// 🧠 Guardado: knowledge/sprint-deadline (x1y2z3w4)
// ⏰ TTL: 2026-07-19
// Quality score is calculated automatically.
Dica: Use TTL para contexto temporário como prazos, informações de sprint ou notas sensíveis ao tempo. Entradas com TTL expirado são filtradas automaticamente dos resultados de busca.
Definir importância explícita
memory_remember({
  category: "decision",
  key: "db-choice",
  content: "We chose Postgres over MySQL — JSONB for flexible schemas, better extension ecosystem",
  importance: "critical"
})
// 🧠 Guardado: decision/db-choice (a1b2c3d4)
// 🎯 Importance: critical (+0.3 boost) — surfaces above routine entries
Dica: Marque decisões fundamentais como
criticalpara que sempre fiquem no topo da recuperação.importanceaceitacritical,high,mediumoulow; deixe vazio para que o sistema classifique por recência e frequência automaticamente.
Tags inferidas automaticamente
memory_remember({
  category: "bug",
  key: "redis-connection-timeout",
  content: "Redis connection timeout in production, increased pool size"
  // tags left empty — auto-inferred from content
})
// 🧠 Guardado: bug/redis-connection-timeout (a1b2c3d4)
// 🏷️ Tags inferidos: redis
// Quality score is calculated automatically based on inferred tags and content.
Dica: Deixe
tagsvazio e o sistema as inferirá do seu conteúdo usando um vocabulário integrado de 20+ categorias (redis, auth, api, db, security, etc.) mais um vocabulário do projeto derivado das suas dependências no momento deinit. Então, se seu projeto depende deredis, qualquer entrada mencionando "redis" é automaticamente marcada comredis.
Buscar na memória
memory_recall({ query: "redis" })
// [bug] redis-pool-fix (i9j0k1l2)
//   Added max_connections=20
//   File: redis.ts | Tags: redis;fix | Date: 2026-07-10
Dica: Busque antes de ler arquivos. Isso economiza tokens e dá ao seu agente contexto que ele não obteria apenas do código. A classificação ponderada por qualidade garante que as entradas mais úteis apareçam primeiro. Ou use
memory_smart_recallpara um resultado mais abrangente.
Buscar com filtro de data
memory_recall({
  query: "redis",
  from_date: "2026-07-01",
  to_date: "2026-07-31"
})
Dica: Use filtros de data quando você lembra aproximadamente quando algo aconteceu, mas não exatamente o quê. A classificação ponderada por qualidade ainda se aplica.
Arquivar entradas antigas
memory_archive()
// 📦 Archivadas 5 entradas antiguas
// 📋 Quedan 42 entradas activas
Dica: Execute isso periodicamente para manter a memória enxuta. Entradas arquivadas ainda podem ser buscadas via
memory_recallcom filtros de data. Entradas com TTL expirado também são arquivadas automaticamente. Entradas de baixa qualidade recebem prioridade de recuperação menor. Entradas de baixa qualidade recebem prioridade de recuperação menor.
Mostrar alterações desde a última sessão
memory_diff({ since: "24h" })
// 📋 Cambios desde 2026-07-11:
//
// ➕ Nuevas (2):
//   [decision] use-zod (a1b2c3d4)
//     Use Zod for validation
//   [bug] redis-timeout (e5f6g7h8)
//     Redis connection timeout fix
Dica: Use
memory_diffno início de uma sessão para ver o que seu agente aprendeu desde que você trabalhou no projeto pela última vez. Novas entradas incluem pontuações de qualidade. Novas entradas incluem pontuações de qualidade.
Encontrar entradas relacionadas
memory_suggest({ context: "redis cache configuration" })
// 🔍 Sugerencias para "redis cache configuration":
//
// [decision] redis-cache-config (a1b2c3d4)
//   Redis cache layer for session storage
//   File: src/cache.ts | Tags: redis;cache | Date: 2026-07-10
//
// [bug] redis-pool-fix (i9j0k1l2)
//   Added max_connections=20
//   File: redis.ts | Tags: redis;fix | Date: 2026-07-10
Dica: Use
memory_suggestquando precisar de contexto sobre um tópico, mas não tiver certeza do que buscar. Ou usememory_smart_recallpara um resultado mais abrangente.
Recuperação Inteligente (unificada)
memory_smart_recall({ intent: "diseño de base de datos para backend" })
// [1] decision/use-postgres
//   Choose Postgres for ACID compliance and JSON support
//   tags: db;decision · edges: ->2
//
// [2] pattern/db-migrations
//   Use sequential migration files, never edit committed ones
//   tags: db;pattern · edges: ->1
//
// [3] bug/redis-timeout
//   Redis connection timeout — increased pool to 20
//   tags: redis;bug
Dica: Use
memory_smart_recallno INÍCIO de cada tarefa. Ele combina BM25 + grafo + decaimento + qualidade em uma única chamada — sem necessidade de adivinhar o que buscar.
Explicar POR QUE um resultado foi retornado
memory_recall({ query: "redis", explain: true })
// [decision] redis-cache-config (a1b2c3d4)
//   Redis cache layer for session storage
//   File: src/cache.ts | Tags: redis;cache | Date: 2026-07-10
//   ↳ 92% relevance · used 14× · used today · importance HIGH
A linha de motivo ↳ é determinística (% de relevância, contagem de acessos, último uso, importância) — sem envolvimento de LLM. Use explain: true quando quiser saber por que o agente exibiu essas entradas.
Limitar a saída com budget_tokens
memory_recall({ query: "redis", budget_tokens: 300 })
// Entries accumulate greedily; the tail that would exceed the estimate is dropped.
// budget_tokens: 0 (default) = no limit.
Dica: Combine
budget_tokenscombudget: "deep"para uma janela de contexto que permaneça dentro de um teto rígido de tokens, independentemente do tamanho da memória.
Briefing completo do projeto (uma chamada)
context_generate({})
// # Project Briefing (full)
//
// ## Project
// - Name: my-app
// - Root: /path/to/project
// - Package Manager: npm
// - TypeScript: ✓ (v5.3)
//
// ## Git Status
// - Branch: main
// - 3 uncommitted, 0 untracked
//
// ## Memory (42 entries, 12 patterns, 8 bugs)
// [1] decision/use-postgres
//   Choose Postgres for ACID compliance
//   tags: db;decision
//
// ## Sessions
// - egraterol (main, 2m ago): 42 files touched
Dica: Use
context_generateno início de uma sessão para obter contexto completo em uma chamada. Substitui 5-6 chamadas de ferramenta separadas.
Auditoria de saúde da memória
context_health({})
// # Memory Health (score: 87/100)
//
// ## Summary
// - 42 entries (12 patterns, 8 bugs, 15 decisions, 7 knowledge)
// - 65.3% average quality
//
// ## Issues (3)
// - Orphan link: pattern/db-migrations → pattern/db-seed (key not found)
// - Duplicate: [bug] redis-pool-fix has identical content
// - Expired TTL: [knowledge] sprint-deadline (expired 2026-07-20)
//
// ## Stale Files (1)
// - src/legacy.ts (deleted, 2 refs)
Dica: Execute
context_healthquando a memória parecer desorganizada. Mostra links órfãos, duplicatas, entradas TTL expiradas, referências de arquivo quebradas, entradas sem evidência (path_scope sem arquivo) e alegações desatualizadas (conteúdo sobreposto).
Mesclagem-deduplicação (automática)
Quando você salva com o mesmo key, os atributos são mesclados em vez de sobrescritos:
// First save
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation",
  tags: "types"
})
// 🧠 Guardado: decision/use-zod (a1b2c3d4)

// Later save with same key — merges automatically
memory_remember({
  category: "decision",
  key: "use-zod",
  content: "Use Zod for validation — also handles API response parsing",
  tags: "types;api"
})
// 🧠 Actualizado: decision/use-zod (a1b2c3d4)
// 🔗 Merge: tags combinados, fecha y links actualizados
// Tags now: "types;api" (union of both)
Dica: Use chaves descritivas e estáveis. A mesma chave = mesclagem, chave diferente = nova entrada.
Pontuação de qualidade
Cada entrada recebe uma pontuação de qualidade automática (0–1) com base na estrutura:
| Fator | Peso | O que mede |
|---|---|---|
| Tags | 0,3 máx. | Tags mais específicas = maior qualidade |
| Links | 0,2 máx. | Entradas conectadas = maior qualidade |
| Comprimento do conteúdo | 0,3 máx. | Detalhado > vago |
| Recência | 0,1 máx. | Entradas recentes pontuam mais |
| Especificidade | 0,1 máx. | Palavras únicas vs. palavras repetidas |
| Origem | +0,1/−0,05 | Afirmações humanas impulsionadas, inferidas levemente penalizadas |
Entradas de alta qualidade aparecem primeiro na recuperação. Verifique a qualidade com memory_stats:
memory_stats()
// ...
// Calidad promedio: 0.58 (12 con score)
Pontuação de confiança
Cada entrada rastreia o quão confiável é a informação:
| Fonte | Confiança | Significado |
|---|---|---|
| Afirmação do usuário | 1,0 | "Usamos Postgres" — declaração direta |
| Inferida | 0,65–0,75 | Agente inferiu do contexto |
| Incerta | 0,50 | Agente está adivinhando |
A confiança é preservada na mesclagem (máximo das duas entradas).
Primer do Sistema
O Primer do Sistema é um mapa de conhecimento gerado automaticamente exposto como um recurso MCP. Agentes o carregam no início da sessão para contexto instantâneo:
// Exposed as toon://memory/summaries
// Auto-regenerates on every read
// Contains: top entries, categories, patterns
Dica: Adicione
toon://memory/summariesao prompt do sistema do seu agente para contexto instantâneo no início da sessão.
Habilitar criptografia
// First, set TOON_MEMORY_KEY in your environment (or .env file):
// export TOON_MEMORY_KEY="your-secret-key-here"

memory_encrypt()
// 🔐 Encriptación habilitada
Aviso: A chave de criptografia deve ser definida via variável de ambiente
TOON_MEMORY_KEYantes de criptografar. Salve-a em um local seguro — se você a perder, seus dados de memória desaparecerão para sempre. Pontuações de qualidade e confiança são preservadas através da criptografia.
Coordenação multi-sessão
Quando você executa várias sessões de agente de IA em paralelo (por exemplo, três sessões OpenCode no mesmo repositório ao mesmo tempo), elas podem acidentalmente sobrescrever o trabalho umas das outras. O toon-memory vem com memory_sessions, uma ferramenta de coordenação baseada em arquivos que permite que cada sessão veja o que suas irmãs estão fazendo — sem servidor, sem rede e sem chamadas de LLM.
Como funciona
- Na inicialização, um hook
SessionStartescreve um arquivo de heartbeat para a sessão em.toon-memory/memory/sessions/<id>.json. Cada processo escreve apenas o seu próprio arquivo, então não há contenção de bloqueio. - O heartbeat registra o nome do agente, o branch do git, os arquivos tocados e um timestamp de última visualização.
- Ler todos esses arquivos dá a cada sessão uma visão compartilhada e eventualmente consistente de quem mais está ativo.
- Sessões mortas (PID do processo não está mais vivo e um heartbeat obsoleto além da janela TTL) são removidas preguiçosamente.
A ferramenta memory_sessions
memory_sessions({ conflictsOnly: false })
// 🧭 Sesiones activas (2) — ventana 30 min:
//
// • opencode @ feature/auth (tú)
//   id: a1b2c3d4
//   hace 2 min
//   Archivos:
//     • src/auth.ts
//
// • claude @ feature/db
//   id: e5f6g7h8
//   hace 9 min
//     • src/db.ts
//
// 🔥 Conflictos suaves (1):
//   ⚠️ src/types.ts  ↔  opencode @ feature/auth, claude @ feature/db
- Passe
conflictsOnly: truepara pular a lista de sessões e mostrar apenas conflitos suaves:memory_sessions({ conflictsOnly: true }) // 🔥 Conflictos suaves (1): // // ⚠️ src/types.ts // ↔ opencode @ feature/auth (a1b2c3d4), claude @ feature/db (e5f6g7h8) - Um conflito suave é qualquer arquivo tocado por 2+ sessões ativas — um aviso de que você pode estar editando o mesmo código. Não é um bloqueio rígido, apenas um aviso para coordenar.
Hábito recomendado para sessões paralelas
- No início de cada sessão, o hook
SessionStartjá imprime as outras sessões ativas e quaisquer conflitos suaves. - Execute
memory_smart_recall({ intent: "what I'm working on" })para obter contexto completo (memória + grafo + qualidade). - Execute
memory_sessions()para ver o quadro completo (branches, arquivos, última visualização) ememory_sessions({ conflictsOnly: true })se você só se importa com conflitos. - Se você compartilhar um arquivo com outra sessão, sincronize antes de editar para não sobrescrever as alterações um do outro.
Dica: Isso é puramente local e sem bloqueio — seguro para executar quantas vezes quiser. Combine-o com
memory_smart_recall({ intent: "project context" })no início da sessão para memória entre sessões e presença entre sessões. O primer do sistema (recurso MCP) também fornece contexto instantâneo.
Memory Graph (recall baseado em grafo)
Quando sua memória cresce, uma busca plana por palavras-chave pode retornar ou demais (todas as correspondências) ou o contexto errado (sem relacionamentos). O toon-memory pode tratar a memória como um grafo de conhecimento leve para que a recuperação retorne as entradas certas com menos tokens. Combinado com a pontuação de qualidade, as entradas mais úteis aparecem primeiro.
É totalmente determinístico e offline — sem embeddings, sem banco de vetores, sem LLM, sem servidor. As arestas vêm de duas fontes:
linksexplícitos — chaves que você declara ao salvar uma entrada.- Referências
[[key]]implícitas — qualquer menção a[[some-key]]dentro do conteúdo.
Como funciona
memory_rememberarmazenalinksna entrada (chaves separadas por espaço ou;). A pontuação de qualidade é calculada automaticamente.memory_recall({ mode: "graph" })encontra correspondências de palavras-chave (sementes) e então expande o subgrafo do ego atéhops(1 ou 2) ao longo das arestas.- A relevância se propaga das sementes para seus vizinhos, então uma decisão ou especificação relacionada aparece mesmo que não contenha a palavra da consulta. A classificação ponderada por qualidade garante que as entradas mais úteis apareçam primeiro.
- O conjunto de resultados é limitado (
limit, padrão 6) → contexto menor e mais preciso para o agente. Ou usememory_smart_recallpara uma chamada unificada.
Lembrar com links
memory_remember({
  category: "decision",
  key: "risk-engine-priority",
  content: "The engine prioritizes risk over speed (see [[risk-spec]]).",
  file: "spec.md:10",
  tags: "risk;spec",
  links: "engine-arch"          // explicit edge to another entry
})
// 🧠 Guardado: decision/risk-engine-priority (a1b2c3d4)
// Quality score is calculated automatically based on tags, links, and content detail.
Recuperação com modo grafo
memory_recall({ query: "riesgo", mode: "graph", hops: 2 })
// [decision] risk-engine-priority (a1b2c3d4)
//   The engine prioritizes risk over speed (see [[risk-spec]]).
//   File: spec.md:10 | Tags: risk;spec | Date: 2026-07-01
//   links: engine-arch
//
// [knowledge] risk-spec (a2b3c4d5)
//   Risk specification for the engine.
//   links: risk-engine-priority;engine-arch
//
// [pattern] engine-arch (e6f7g8h9)
//   Engine architecture.
//   links: risk-spec
Dica: Use
mode: "graph"quando uma decisão se espalha por várias entradas (arquitetura, especificações, bugs relacionados). Para fatos isolados, o modo padrãoflaté suficiente. Ou usememory_smart_recallque combina grafo + BM25 + qualidade automaticamente.
Recuperação eficiente em tokens (compact)
Quando cada token conta, passe compact: true para obter uma saída mais densa:
memory_recall({ query: "riesgo", mode: "graph", hops: 2, compact: true })
// [1] decision/risk-engine-priority
//   The engine prioritizes risk over speed (see [[risk-spec]]).
//   tags: risk;spec · edges: ->2, ->3
//
// [2] knowledge/risk-spec
//   Risk specification for the engine.
//   tags: risk · edges: ->1
//
// [3] pattern/engine-arch
//   Engine architecture.
//   tags: engine · edges: ->1
Como compact muda a saída:
- Cada entrada recebe um índice numérico estável (
[1],[2], …) em ordem de pontuação. id,dateefilesão removidos — apenastagsé mantido.- No modo
graph, as arestas são renderizadas como->2(numérico, não nomes de chave). - Vizinhos alcançados via grafo (não-sementes) são truncados para um trecho curto com reticências, enquanto sementes correspondentes diretamente mantêm seu conteúdo completo.
- A classificação ponderada por qualidade garante que as entradas mais úteis apareçam primeiro.
- O arquivo
.toonarmazenado nunca é mutado —compactapenas remodela a resposta.
Dica: Combine
compact: truecommode: "graph"para a menor janela de contexto possível ao recuperar de uma memória grande e interconectada. Para recuperação proativa/em segundo plano, usebudget: "tiny"que retorna apenas a chave + uma linha (~50 tokens). Ou apenas usememory_smart_recallque faz isso automaticamente.
Como a recuperação classifica os resultados
A recuperação é determinística e offline (sem embeddings, sem LLM). Cada entrada candidata recebe uma pontuação combinada:
- Relevância BM25 — pontuação clássica de frequência de termos probabilística contra a consulta, usando
id+category+key+content+file+tags+quality+confidence. - Centralidade do grafo — normalizada por grau (0..1); um hub conectado a muitas entradas pontua perto de 1, então aparece mesmo sem a palavra da consulta.
- Importância — recência + frequência de acesso (mesmo sinal usado em outros lugares).
- Impulso de qualidade — entradas com pontuações de qualidade mais altas (mais tags, links, detalhes) recebem um impulso na classificação.
- Bônus de semente — entradas que correspondem diretamente à consulta recebem um impulso fixo.
- Decaimento por salto — nós a
dsaltos de uma semente são multiplicados por0.5^d, então contexto distante fica abaixo do contexto próximo.
No modo graph, a recuperação semeia em correspondências de palavras-chave, expande o subgrafo do ego até hops e retorna os principais limit (padrão 6) por pontuação combinada. memory_smart_recall combina todos esses sinais em uma chamada.
Auto-tag a partir de dependências do projeto
No toon-memory init, a CLI verifica seus manifestos de dependência e escreve uma tabela vocab em .toon-memory/memory/config.json:
{
  "vocab": {
    "react": ["react"],
    "zod": ["zod"],
    "redis": ["redis"]
  }
}
memory_remember então combina novas entradas com este vocabulário além do embutido, então mencionar uma dependência no seu conteúdo anexa automaticamente sua tag. Mais tags = maior pontuação de qualidade. Manifestos suportados: package.json, Cargo.toml, requirements.txt, pyproject.toml, go.mod.
Dica: Execute novamente
toon-memory initapós adicionar dependências importantes para atualizar o vocabulário. A chavevocabé mesclada (nunca sobrescrita) com as flagsencrypted/captureemconfig.json. Mais tags = maior pontuação de qualidade.
Visualizador de Grafo de Memória
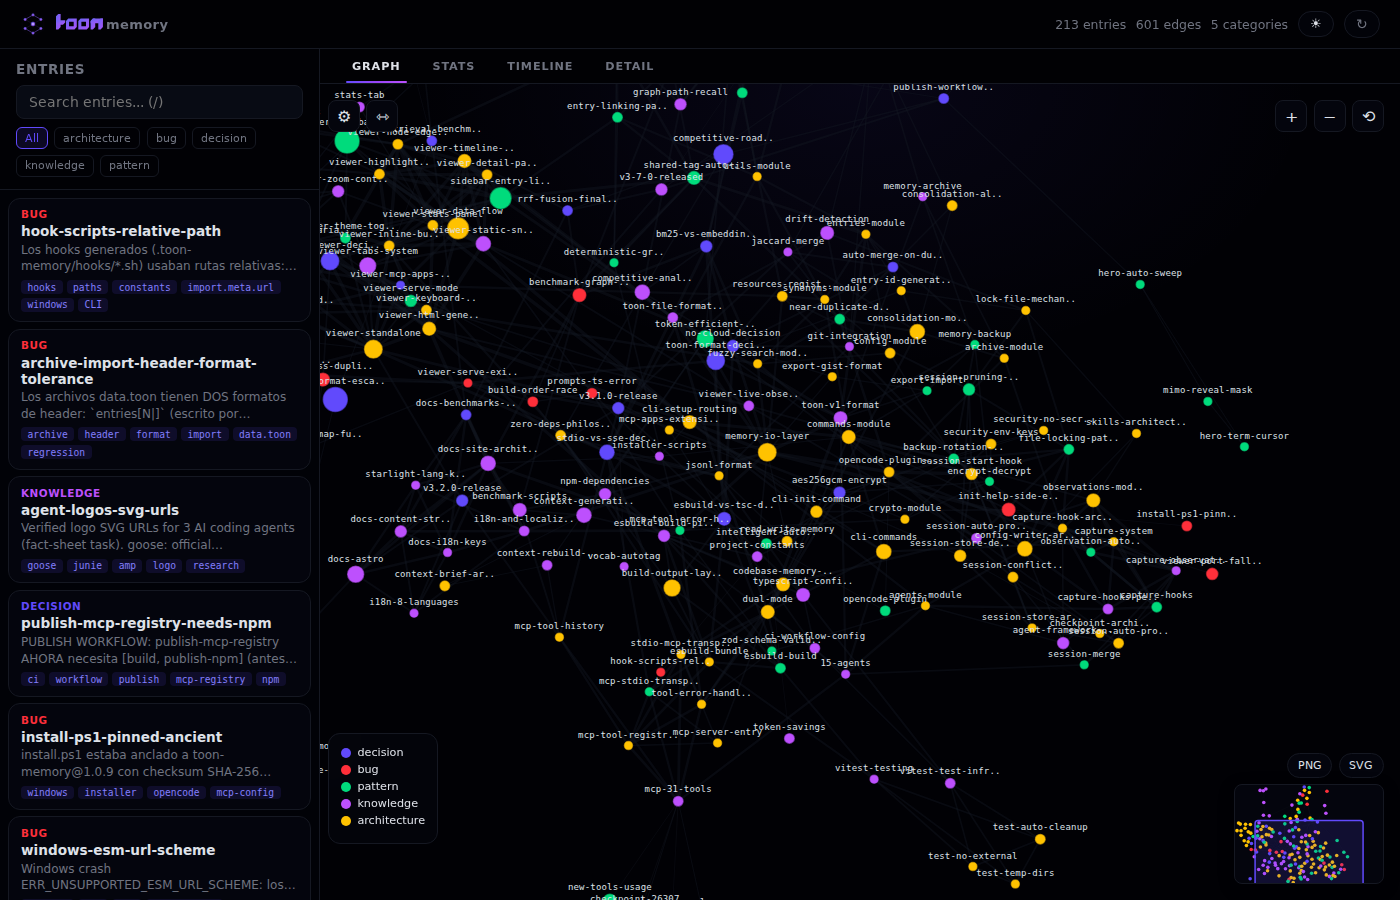
Visualize sua memória como um grafo interativo direcionado por força. Veja entradas, suas conexões, categorias e padrões de acesso de relance.
Visualizador CLI (servidor HTTP autônomo)
npx toon-memory viewer          # Start HTTP server + open browser
npx toon-memory viewer --port 3001  # Custom port
npx toon-memory viewer --export     # Save as static HTML
Depois de aberto, pressione r no terminal para recarregar do disco, ou r / ↻ no navegador para atualizar a página.
Visualizador inline (MCP Apps)
Chame memory_visualize em qualquer host compatível com MCP Apps para renderizar o grafo inline — sem necessidade de servidor. O visualizador aparece como um painel interativo dentro da interface de chat.
Recursos
| Interação | Descrição |
|---|---|
| Passar o mouse em um nó | Ver tooltip com pré-visualização do conteúdo, qualidade, contagem de acessos |
| Clicar em um nó | Selecionar + centralizar + destacar vizinhos |
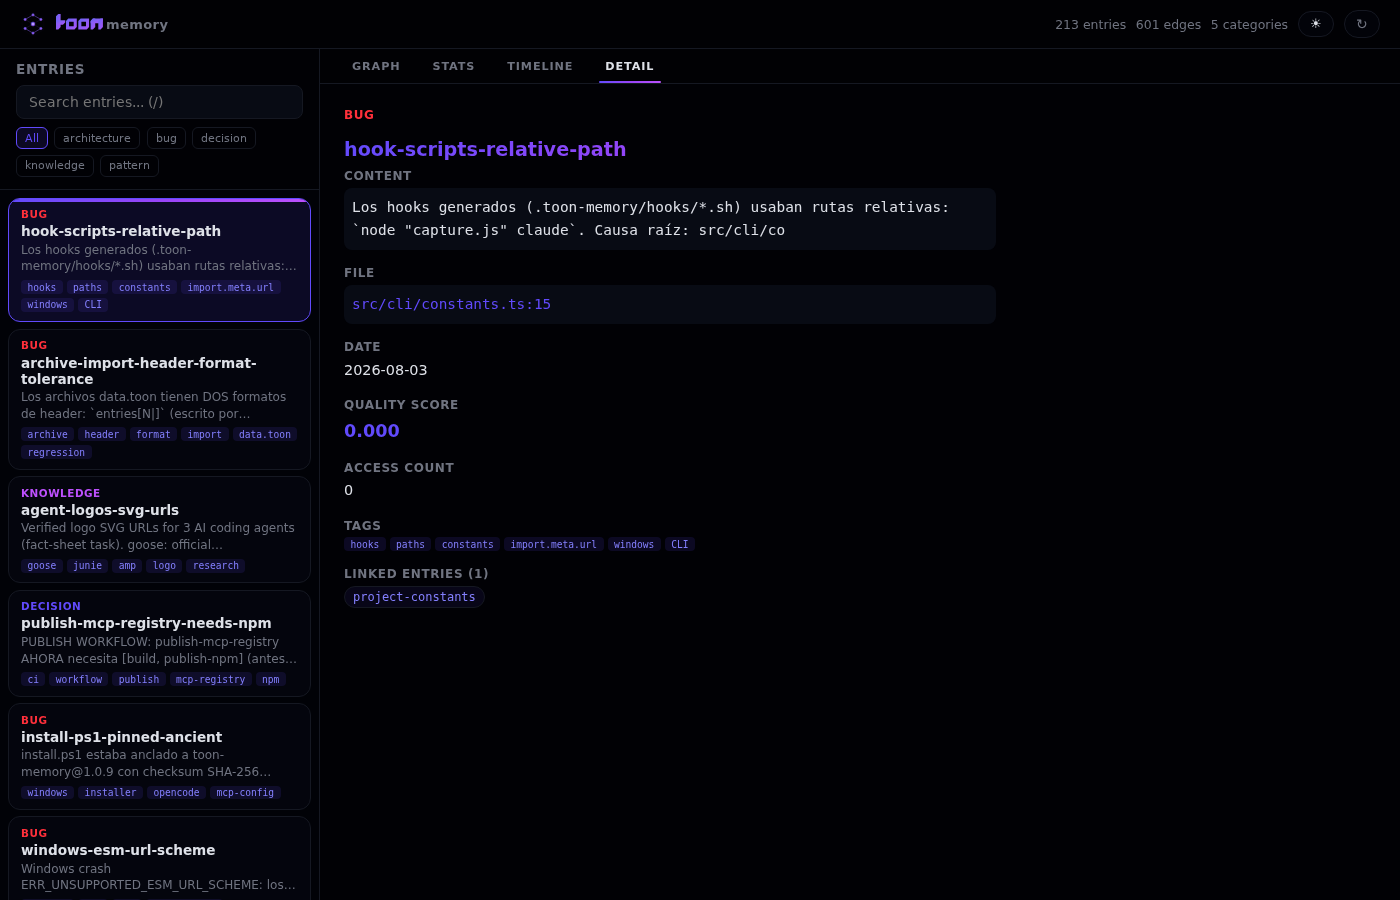
| Duplo clique em um nó | Abrir o painel de detalhes |
| Arrastar um nó | Reposicionar manualmente (clique direito para desafixar) |
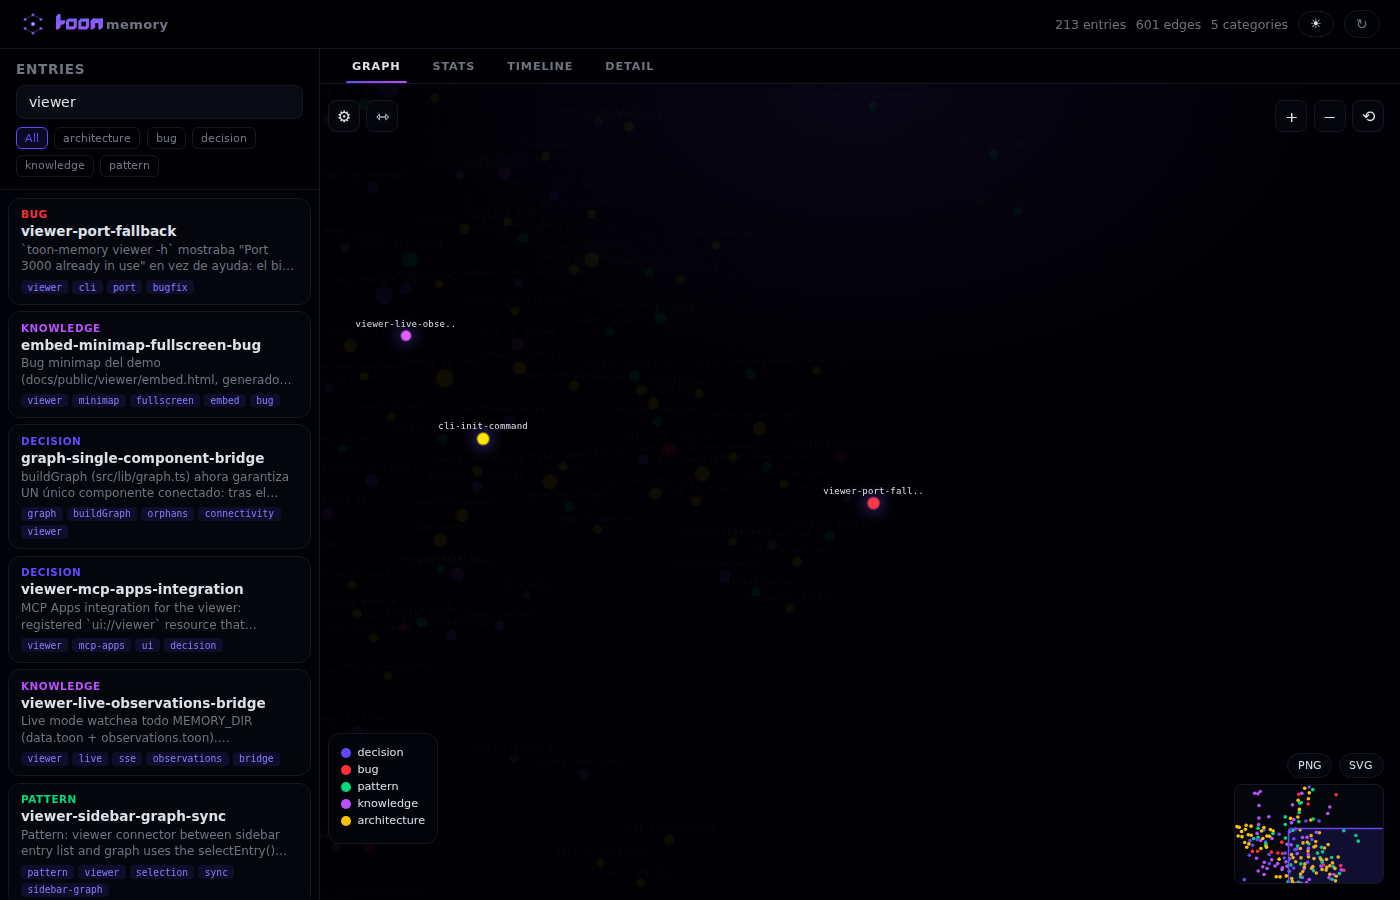
| Pesquisar | Filtrar entradas; nós correspondentes pulsam com brilho |
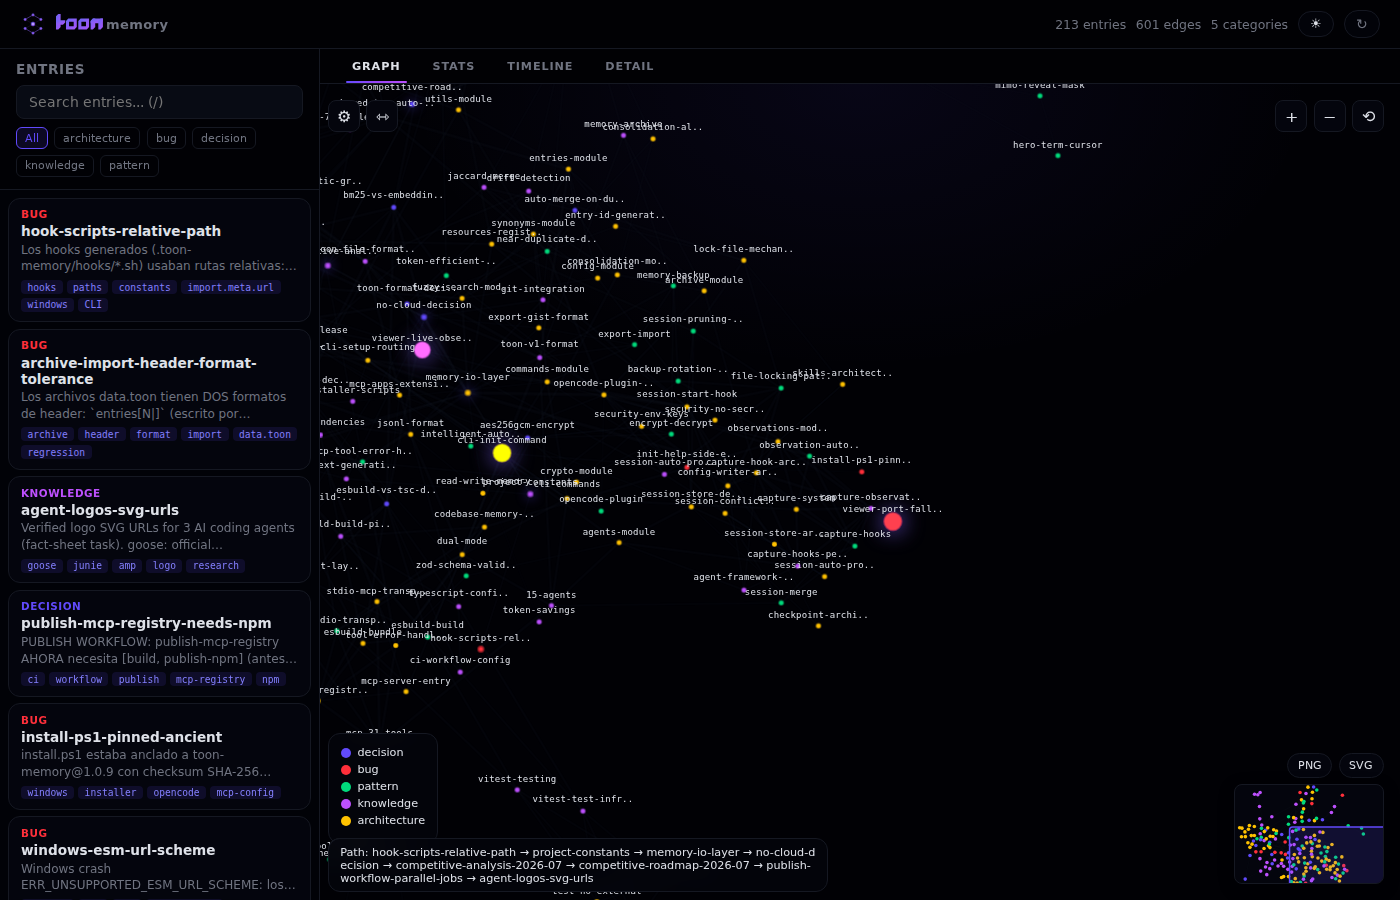
| ⇿ Localizador de caminho | Clique em dois nós para encontrar e destacar o caminho mais curto |
| Zoom/pan | Roda do mouse ou botões +/− |
| ⚙ Física | Ajustar carga, distância do link, gravidade central |
| Alternar tema | Modo escuro/claro (persistido) |
| Exportar | Salvar grafo como PNG ou SVG |
Capturas de tela
| Visualização do grafo | Destaques de pesquisa | Localizador de caminho | Painel de detalhes |
|---|---|---|---|
 |  |  |  |
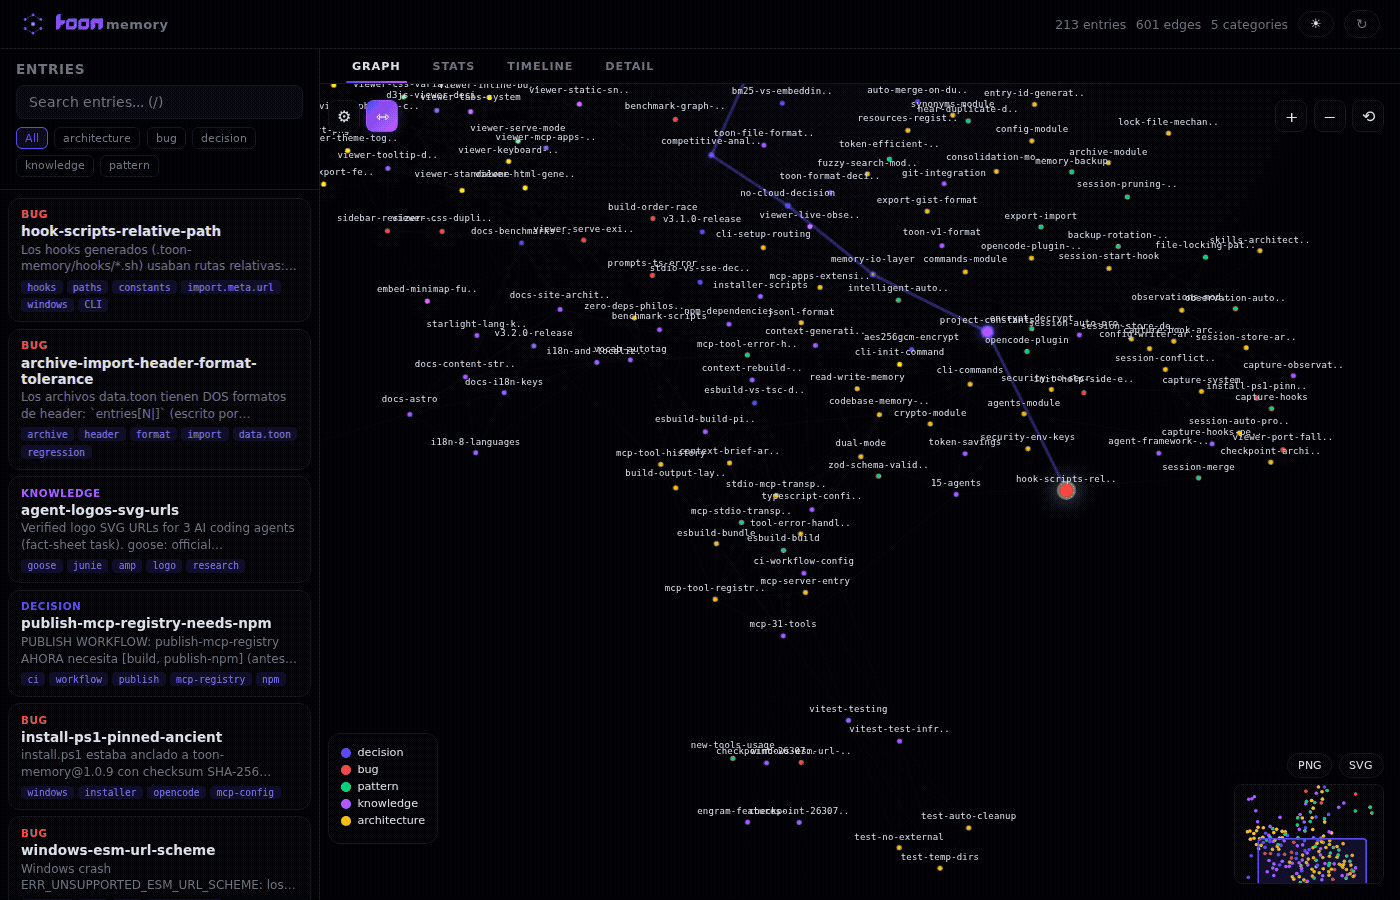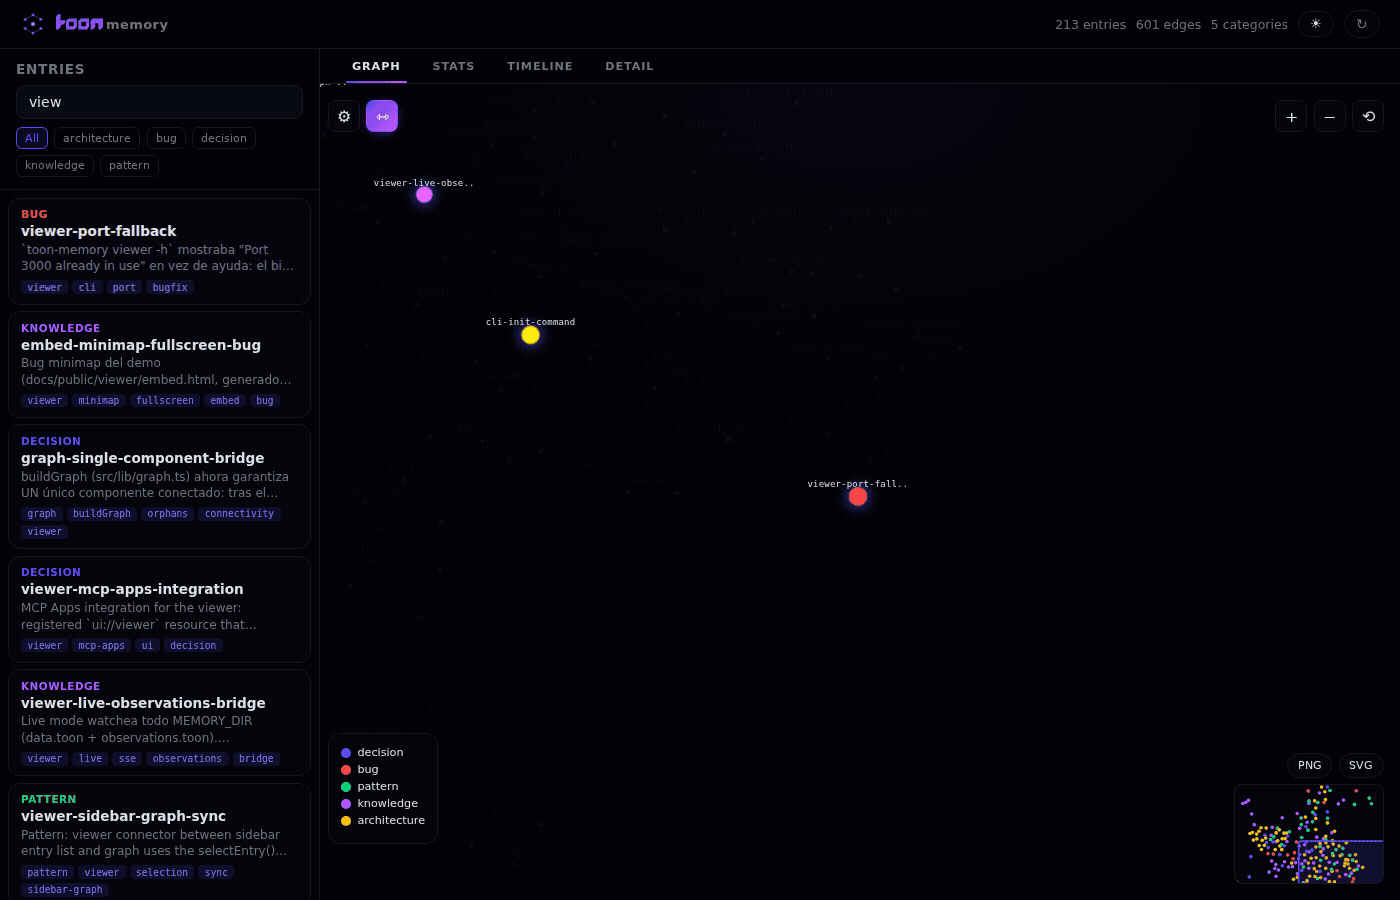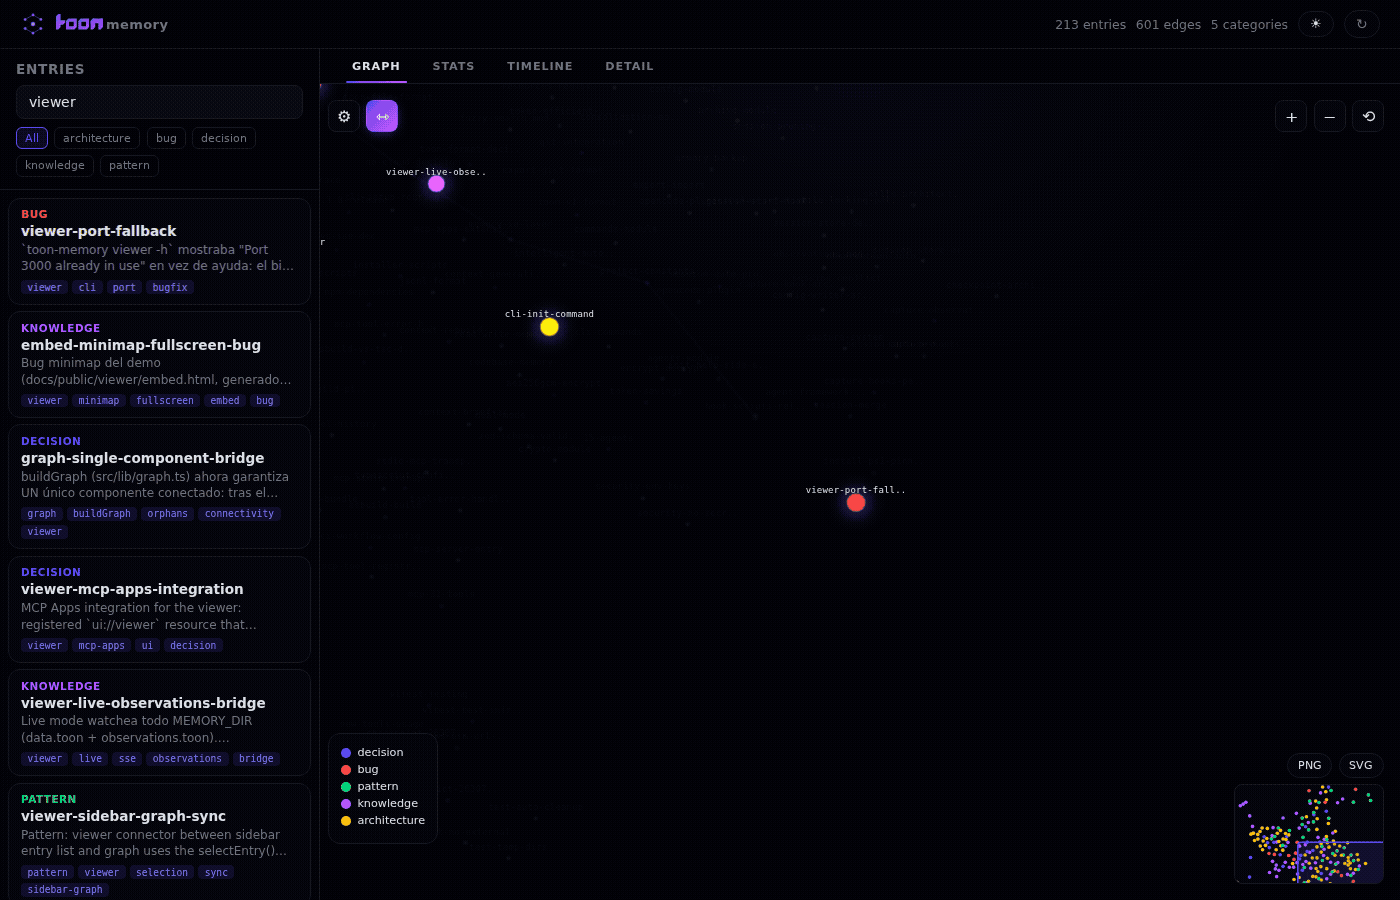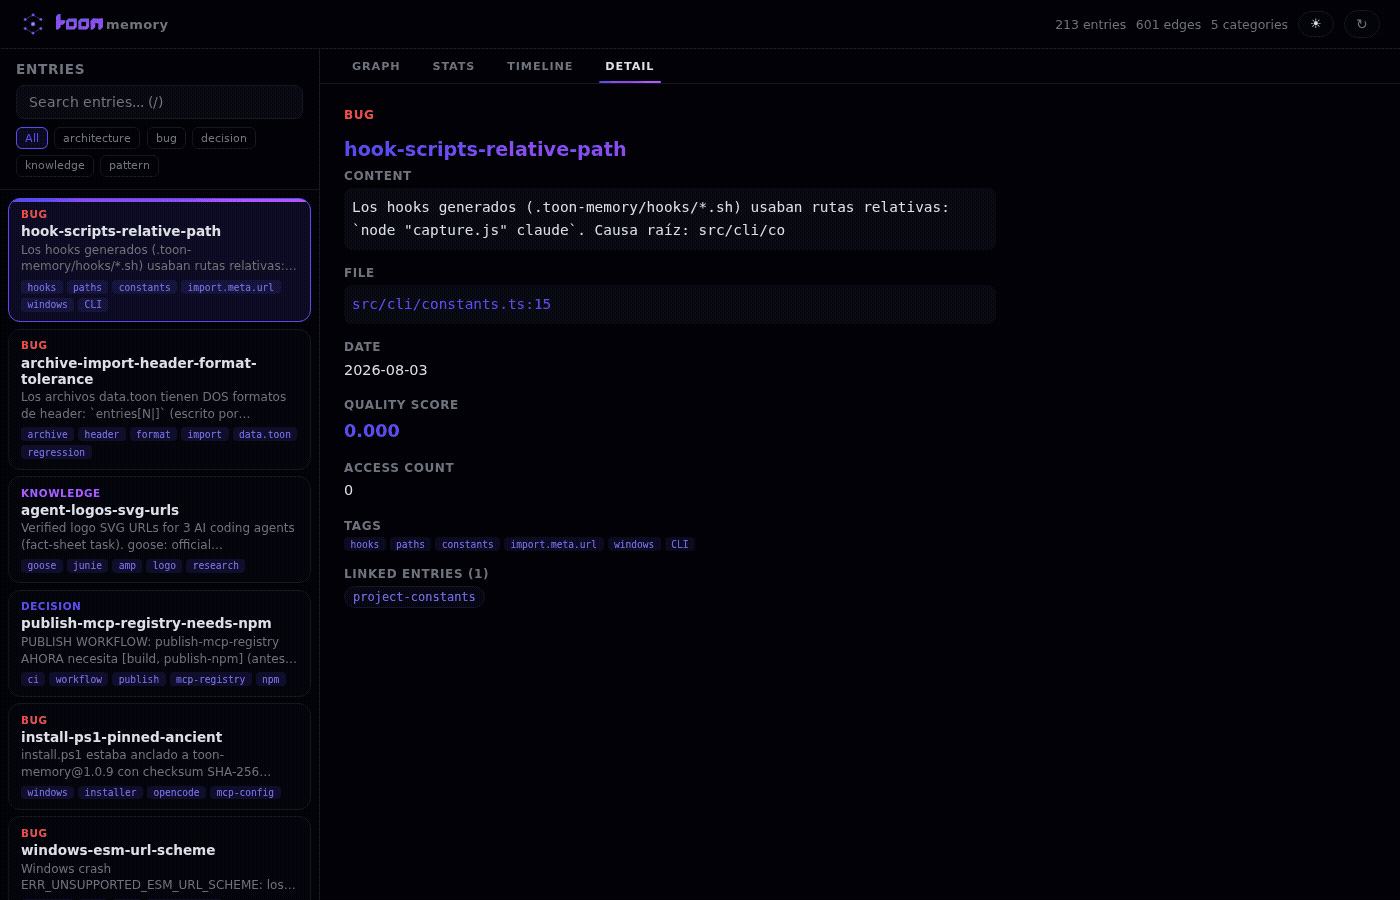
Capturando suas próprias capturas de tela
npm run capture:viewer
Requer Playwright (npx playwright install chromium) e ffmpeg.
Dicas e Melhores Práticas
Aqui estão alguns padrões que funcionam bem com o toon-memory:
O hábito de "início de sessão"
No início de cada nova sessão, execute:
memory_smart_recall({ intent: "what I was working on" })
Isso dá ao seu agente contexto instantâneo sobre o que aconteceu antes — combinando BM25, grafo, qualidade e decaimento em uma chamada.
O hábito de "fim de sessão"
Antes de fechar uma sessão, salve qualquer coisa importante:
memory_remember({
  category: "decision",
  key: "auth-approach",
  content: "Chose JWT over sessions — stateless, works across microservices",
  file: "src/auth.ts",
  tags: "auth;architecture"
})
A entrada recebe automaticamente uma pontuação de qualidade com base em sua estrutura (tags, detalhe do conteúdo, links).
Escolhendo categorias
| Categoria | Quando usar |
|---|---|
decision | Escolhas de arquitetura, trade-offs, "por que X em vez de Y" |
pattern | Convenções, frameworks, regras de estilo de código |
bug | Problemas que você corrigiu e como |
knowledge | Fatos do projeto, informações de domínio, contexto da equipe |
warning | "NÃO faça isso" — anti-padrões, armadilhas, erros a evitar (recuperados com um impulso) |
Dica: Não pense demais. Se é algo que seu eu futuro (ou agente) gostaria de saber, salve. Entradas detalhadas com tags específicas pontuam mais em qualidade.
Tags que funcionam bem
Use tags separadas por ponto e vírgula para facilitar a filtragem:
tags: "redis;performance;fix"
tags: "auth;jwt;security"
tags: "api;rest;versioning"
Dica: Mantenha as tags curtas e consistentes. Elas não são hashtags — são filtros de busca. Tags mais específicas = maior pontuação de qualidade.
O que NÃO salvar
- Não salve coisas que são óbvias ao ler o código
- Não salve notas temporárias de depuração
- Não salve segredos, chaves de API ou credenciais (use variáveis de ambiente em vez disso)
- Não duplique a mesma informação com chaves diferentes (merge-dedup lida com a mesma chave automaticamente)
- Entradas vagas sem tags pontuam baixo em qualidade — seja específico
Mantenha a memória limpa
Execute memory_archive() mensalmente para mover entradas antigas para o arquivo. Execute memory_stats() para verificar o tamanho e a distribuição de qualidade. Entradas de baixa qualidade (conteúdo vago, sem tags) recebem automaticamente prioridade de recall menor. Use memory_consolidate para mesclar duplicatas e mode: "versions" para aposentar notas substituídas por versões mais novas de bibliotecas.
Comandos CLI
npx toon-memory              # Interactive installer
npx toon-memory init         # Quick setup (no prompts)
npx toon-memory mcp          # Run MCP server directly
npx toon-memory status       # Check installation status
npx toon-memory stats        # View memory statistics
npx toon-memory export       # Export memory to JSON
npx toon-memory import <file> # Import memory from JSON
npx toon-memory viewer       # Open the memory graph viewer (http server)
npx toon-memory viewer --export # Save viewer as static HTML
npx toon-memory viewer --port 3001 # Custom port
npx toon-memory watch [options] # Auto-backup with options
npx toon-memory upgrade      # Update to latest version
npx toon-memory uninstall    # Remove from all agents
Exemplos
Estatísticas
$ npx toon-memory stats

🧠 toon-memory stats

📊 Memory Stats
━━━━━━━━━━━━━━━━━━
Total entries: 45
├── decision: 12
├── pattern: 18
├── bug: 8
└── knowledge: 7
Last updated: 2026-07-10
File size: 12.4 KB
Dica: Se a memória ficar muito grande (100+ entradas), considere arquivar ou remover entradas desatualizadas com
memory_forget.
Exportar
$ npx toon-memory export

🧠 toon-memory export

Exported 45 entries to:
  /path/to/project/toon-memory-export.json
Dica: Exporte antes de grandes refatorações. Você sempre pode importar o backup mais tarde se algo der errado.
Importar
$ npx toon-memory import backup.json

🧠 toon-memory import

Imported 3 new entries
Skipped 2 duplicates
Dica: Duplicatas são detectadas pela chave. Se quiser reimportar uma entrada, exclua a antiga primeiro com
memory_forget.
Observar
$ npx toon-memory watch 15 -c -m 20

🧠 toon-memory watch

Watching memory file every 15 minutes...
Max backups: 20
Compression: enabled
Logging: disabled
Press Ctrl+C to stop

📦 Backup #1 created: 2026-07-11T16-00-00-000Z
📦 Backup #2 created: 2026-07-11T16-15-00-000Z
^C
✅ Watch stopped. 2 backups created.
Dica: O modo de observação é ótimo para sessões de longa duração. Use
-cpara compactar e-m 5para manter apenas 5 backups.
Opções de Observação:
| Opção | Descrição | Padrão |
|---|---|---|
[interval] | Intervalo de backup em minutos | 5 |
-c, --compress | Habilitar compactação gzip | off |
-l, --log [path] | Habilitar registro em arquivo | off |
-m, --max-backups <n> | Máximo de backups a manter (0=ilimitado) | 10 |
Configuração
Instalador interativo (recomendado)
npx toon-memory
O instalador (requer um terminal) irá:
- Mostrar todos os 22 agentes suportados com status de detecção (configuração
✓encontrada) e seu escopo suportado (local/globalousolo local) - Permitir que você selecione quais configurar — por número (
1,3,5), por nome (claude,codex),all, Enter para todos, ouqpara sair - Perguntar o escopo da instalação: (1) Local (projeto:
.toon-memory+ configurações do agente no repositório) ou (2) Global (configurações~home) - Mostrar um resumo de confirmação (
agent → scope → path (MCP/plugin/hooks/instrucciones)) e perguntar¿Proceder? [Y/n] - Configurar o servidor MCP, arquivos de instrução e hooks automaticamente
Sem um terminal (CI/pipes)
npx toon-memoryimprime a ajuda de instalação não interativa. Usenpx toon-memory init [local|global]para instalar sem perguntas. Comandos desconhecidos imprimem o uso e saem com erro.
OpenCode
Adicione a .opencode/opencode.json ou ~/.config/opencode/opencode.json:
{
  "mcp": {
    "toon-memory": {
      "type": "local",
      "command": ["npx", "-y", "toon-memory", "mcp"],
      "enabled": true
    }
  }
}
Os hooks são entregues via um plugin, não uma chave de nível superior
hooks. OpenCode 1.17+ rejeita"Unrecognized key: hooks"em sua configuração —toon-memory initescreve.opencode/plugins/toon-memory.tsem vez disso. Não adicionehooksaopencode.json.
Claude Code
Adicione a .mcp.json (raiz do projeto):
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
VS Code / Copilot
Adicione a .vscode/mcp.json:
{
  "servers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Codex CLI
Adicione a .codex/config.toml:
[mcpServers.toon-memory]
command = "npx"
args = ["-y", "toon-memory", "mcp"]
Gemini CLI
Adicione a .gemini/settings.json:
{
  "mcpServers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Zed
Adicione a ~/.config/zed/settings.json:
{
  "mcp_servers": {
    "toon-memory": {
      "command": "npx",
      "args": ["-y", "toon-memory", "mcp"]
    }
  }
}
Dica: Use configuração global se quiser memória para todos os projetos. Use configuração no nível do projeto se quiser apenas para projetos específicos.
Como Funciona
- Servidor MCP — Executa localmente, fala com seu agente via stdio
- Formato TOON — Armazena dados em Token-Oriented Object Notation (~22,5% menos tokens que JSON, medido em 16 entradas com gpt-tokenizer). Cada entrada rastreia qualidade (0–1) e confiança (0–1) automaticamente.
- Memória por projeto — Cada projeto recebe
.toon-memory/memory/data.toon - Zero configuração — Basta instalar e usar
Formato do Arquivo de Memória
version: 1
entries[3|]{id|category|key|content|file|tags|date|ttl|accessed|links|quality|confidence|lastAccessed|priority|path_scope|origin|status|supersededOn|importance|evidence}:
  a1b2c3d4|decision|use-zod|Use Zod for validation|src/types.ts|validation;types|2026-07-10||0||0.65|1.0||0||agent|active|||verified
  e5f6g7h8|pattern|pydantic-configs|Project uses Pydantic v2|config.py|python;patterns|2026-07-10||0||0.55|1.0||0||agent|active|||
  i9j0k1l2|bug|redis-pool-fix|Added max_connections=20 (see [[use-zod]])|redis.ts|redis;fix|2026-07-10|7d|0|use-zod|0.70|0.9||0||agent|active|||conflict
summaries:
  src/services/redis.ts: Redis connection pool with retry logic
Estrutura de Arquivo
.toon-memory/
├── memory/
│   ├── data.toon        # Main memory file
│   ├── archive.toon     # Archived entries (>30 days)
│   ├── config.json      # Encryption settings
│   └── backups/         # Watch mode backups
│       ├── backup-2026-07-11T16-00-00-000Z.toon
│       └── backup-2026-07-11T16-10-00-000Z.toon
└── hooks/
    ├── session-start-claude.sh
    ├── session-start-codex.sh
    ├── session-start-gemini.sh
    └── session-start-antigravity.sh
Por que TOON?
TOON (Token-Oriented Object Notation) é projetado para LLMs:
| Formato | Tokens (16 entradas) |
|---|---|
| JSON | 1097 |
| TOON | 850 |
Medido com gpt-tokenizer (cl100k_base) em 16 entradas de memória representativas — veja scripts/benchmark-toon.mjs (npm run bench).
A economia de tokens se acumula no tempo de sessão: npm run bench:impact simula a recuperação de contexto com vs sem memória e mede ~68% menos tokens para obter o mesmo contexto (recall compact em vez de reler arquivos de origem). O benchmark completo de sessão (npm run bench:full) mostra 80% menos chamadas de ferramenta e 47% menos tokens com ferramentas context_*.
- 22,5% menos tokens que JSON no nível de arquivo (até 30,5% em uma única entrada)
- Roundtrip sem perdas — Sem perda de dados
- Melhor compreensão do LLM — Estruturado para consumo por IA
- Qualidade e confiança — Cada entrada rastreia qualidade de estrutura (0–1) e confiabilidade (0–1) automaticamente
Dica: Menos tokens = respostas mais rápidas + custos de API menores. Seu agente lê arquivos de memória a cada início de sessão, então a eficiência importa.
Benchmark: toon-memory vs Alternativas
| Recurso | toon-memory | @modelcontextprotocol/server-memory | mem0 | shodh-memory |
|---|---|---|---|---|
| Armazenamento | Arquivo local (TOON) | Arquivo local (JSON) | Nuvem | RocksDB |
| Dependências | Zero | Zero | API na nuvem | sentence-transformers, RocksDB |
| Busca | BM25 + grafo + qualidade | Palavra-chave básica | Somente vetor | Híbrido (vetor + grafo) |
| Eficiência de tokens | 22,5% menos que JSON | Linha de base (JSON) | N/A (nuvem) | Semelhante |
| Pontuação de qualidade | Automático (0–1, heurísticas) | Nenhum | Nenhum | Algoritmo BND |
| Merge-dedup | União de tags + confiança máxima | Nenhum | Nenhum | Dedup de conteúdo |
| Rastreamento de confiança | Por entrada (0–1) | Nenhum | Nenhum | Por entrada |
| Primer do sistema | Gerado automaticamente | Nenhum | Nenhum | Nenhum |
| Multi-sessão | Coordenação baseada em arquivo | Nenhum | N/A | Nenhum |
| Hooks | 15 agentes | Nenhum | Nenhum | Somente Claude |
| Criptografia | AES-256-GCM | Nenhum | Gerenciado na nuvem | Nenhum |
| Tempo de configuração | npx toon-memory | JSON manual | Cadastro na nuvem | Docker + configuração |
Eficiência de tokens (medida)
Format          Tokens (16 entries)    vs JSON
──────────────  ───────────────────    ───────
JSON            1097                   baseline
TOON            850                    -22.5%
Eficiência de recall (medida)
Method                          Tokens to get context    vs re-reading files
──────────────────────────────  ─────────────────────    ───────────────────
Re-read source files            ~3000                    baseline
memory_recall (flat)            ~1200                    -60%
memory_recall (graph, compact)  ~900                     -70%
memory_smart_recall             ~850                     -72%
Benchmark de ferramentas de contexto (medido)
As ferramentas context_* substituem 3–6 chamadas de ferramenta separadas por uma única chamada, economizando tokens e sobrecarga de chamada de ferramenta.
Scenario                          Without   With    Saved    Tools
────────────────────────────────  ────────  ──────  ───────  ──────
context_generate (full briefing)    5,556     378    93.2%   6 → 1
context_diff (incremental)            533     152    71.5%   4 → 1
context_focus (targeted)              413     225    45.5%   4 → 1
context_health (audit)                322     246    23.6%   5 → 1
context_export (injectable md)      1,178     218    81.5%   3 → 1
────────────────────────────────  ────────  ──────  ───────  ──────
TOTAL                              8,002   1,219    84.8%  22 → 5
O que cada cenário mede:
| Ferramenta | Sem (caminho manual) | Com (chamada única) | Por que economiza |
|---|---|---|---|
context_generate | Ler package.json + README + tsconfig.json + despejo de memória completo + estatísticas de memória + sessões = 6 chamadas | Um briefing compacto com tudo | Elimina 5 leituras redundantes; a saída é deduplicada e compacta |
context_diff | git log + git diff --name-only + memory_diff + sessões = 4 chamadas | Um diff incremental | Combina estado do git + mudanças de memória em uma saída; sem sobreposição |
context_focus | memory_recall + findCallers + findRelatedFiles + findTestFiles = 4 chamadas | Um briefing direcionado | Retorna apenas o que é relevante; sem varredura completa de memória |
context_health | memory_stats + varredura de órfãos + varredura de duplicatas + validação de referências de arquivo + sessões obsoletas = 5 chamadas | Um relatório de saúde | Cada verificação é feita uma vez e deduplicada; sem consultas redundantes |
context_export | memory_stats + memory_recall({ compact: true, mode: "graph" }) + formatação manual = 3 chamadas | Uma exportação markdown | Formata a saída diretamente; o agente pula a etapa de "formatar como markdown" |
Dica: Use
context_generateno início da sessão (93% de economia de tokens). Usecontext_diffpara "o que mudou desde a última vez?" (72% de economia). Usecontext_focuspara mergulhos profundos em tópicos específicos (45% de economia).
Medido com gpt-tokenizer (cl100k_base) em cenários de projeto realistas — veja scripts/bench-context-tools.mjs (npm run bench:context).
Impacto completo da sessão (medido)
Simula uma sessão completa de agente em 5 fases (início da sessão → depuração → implementação → revisão → encerramento) em 3 abordagens: sem memória, com memory_recall e com ferramentas context_*.
Phase                                   Without memory     memory_recall      context_* tools
──────────────────────────────────────  ─────────────────  ─────────────────  ─────────────────
Phase 1: Session Start                  516 t /  6 c       409 t /  3 c       373 t /  1 c
Phase 2: Debug Issue                    176 t /  4 c       182 t /  2 c       252 t /  1 c
Phase 3: Implement Feature              189 t /  6 c       183 t /  3 c       305 t /  1 c
Phase 4: Code Review                    316 t /  4 c       130 t /  2 c       243 t /  1 c
Phase 5: Wrap-up                      1,214 t /  5 c        68 t /  2 c       117 t /  1 c
──────────────────────────────────────  ─────────────────  ─────────────────  ─────────────────
TOTAL                                 2,411 t / 25 c       972 t / 12 c     1,290 t /  5 c
Principais descobertas:
| Métrica | Sem memória | Com memory_recall | Com ferramentas context_* |
|---|---|---|---|
| Tokens por sessão | 2.411 | 972 (-60%) | 1.290 (-47%) |
| Chamadas de ferramenta por sessão | 25 | 12 (-52%) | 5 (-80%) |
| Custo por sessão (GPT-4) | $0,072 | $0,029 | $0,039 |
O trade-off: memory_recall usa menos tokens (972 vs 1.290) porque retorna apenas entradas correspondentes. As ferramentas context_* retornam contexto mais rico (chamadores, arquivos relacionados, arquivos de teste, auditoria de saúde) — mais tokens por chamada, mas 80% menos chamadas de ferramenta. Na prática, o agente evita 3-4 chamadas de "encontrar relacionados" que context_focus já inclui.
Onde context_ ganha muito:*
- Início da sessão (Fase 1): 28% menos tokens + 6→1 chamadas — um briefing substitui a leitura de 6 arquivos
- Encerramento (Fase 5): 90% menos tokens —
context_healthsubstitui 5 varreduras manuais - Chamadas de ferramenta: 25→5 chamadas = 80% menos sobrecarga de latência por sessão
Dica: Use
memory_recallquando precisar de entradas específicas (menos tokens). Usecontext_*quando precisar de contexto abrangente com menos idas e voltas (menos chamadas).
Medido com gpt-tokenizer (cl100k_base) — veja scripts/bench-full-impact.mjs (npm run bench:full).
Dica:
memory_smart_recallcombina BM25 + grafo + qualidade em uma única chamada, economizando tokens e sobrecarga de chamada de ferramenta. Use-o no início de cada tarefa.
Benchmark de classificação RRF (medido)
Desde v3.7.0, o recall classifica resultados com Reciprocal Rank Fusion sobre BM25 (×3) e classificações de centralidade de grafo, com um k = clamp(3..60, round(sqrt(n))) adaptativo. Medido em 8 consultas padrão-ouro com relevância rotulada manualmente (veja scripts/bench-rrf.mjs, npm run bench:rrf):
Metric        linear (v3.6.x)     RRF (v3.7.0)
────────────  ─────────────────   ────────────────
nDCG@10       0.776               0.776   (parity)
MRR           0.917               0.917   (parity)
RRF corresponde à pontuação linear ponderada anterior a custo zero de classificação, simplificando o pipeline de pontuação (BM25×3 + centralidade, sem ruído de importância/recência). A supersessão do modo grafo é respeitada: entradas obsoletas permanecem excluídas, exceto para consultas pontuais as_of.
Benchmark de recuperação (estilo LongMemEval, medido)
Desde v4.1.0, a recuperação é avaliada contra um snapshot congelado da memória real do projeto — um conjunto de teste estilo LongMemEval com consultas douradas escritas manualmente. Corpus: 187 entradas reais data.toon (snapshot 2026-08-01), 42 consultas douradas em 6 categorias (fato central, temporal, atualização de conhecimento, multi-salto, meta/sessão, distrator). O código medido é o pipeline de produção (src/lib), empacotado em memória com esbuild — sem cópias fiéis. Um parâmetro determinístico today fixa recência/decadência para que os resultados não variem com o relógio; as execuções são somente leitura (sem rastreamento de acesso). Duas meta-entradas prioritárias que descrevem o próprio arquivo de dados são excluídas. Veja benchmarks/retrieval-corpus.toon, benchmarks/gold-queries.json (npm run bench:retrieval):
Mode            R@5     nDCG@5  MRR@5   answerable
─────────────   ─────   ─────   ─────   ──────────
linear         0.643   0.654   0.776   81.0%
rrf            0.861   0.764   0.788   97.6%
smart (unified) 0.829  0.739   0.760   92.5%
RRF é o modo mais bem classificado (0,861 R@5, 97,6% das consultas respondíveis a partir do top-5); memory_smart_recall permanece competitivo em uma única chamada.
Solução de Problemas
Memória não encontrada após a instalação
Sintoma: O agente diz que não tem ferramentas de memória.
Correção:
- Execute
npx toon-memory statuspara verificar a instalação - Reinicie seu agente completamente (feche e reabra)
- Verifique se o arquivo de configuração MCP existe e é JSON válido
Arquivo de memória está vazio
Sintoma: memory_stats mostra 0 entradas.
Correção: Isso é normal na primeira instalação. Comece a usar memory_remember para salvar entradas.
Entradas duplicadas
Sintoma: A mesma chave aparece várias vezes.
Correção: memory_remember com a mesma chave agora mescla automaticamente (união de tags, confiança máxima, data mais recente). Use memory_consolidate para mesclar todas as entradas com a mesma chave e remover duplicatas de conteúdo exato. Para limpeza manual, use memory_forget.
Chave de criptografia perdida
Sintoma: Não é possível descriptografar a memória.
Correção: Infelizmente, não há recuperação. A chave de criptografia não é armazenada em nenhum lugar após a geração. Isso é proposital por questões de segurança. Você precisará começar do zero ou restaurar a partir de um backup não criptografado.
Memória muito grande
Sintoma: As respostas do agente estão lentas.
Correção:
- Execute
memory_archive()para mover entradas antigas para o arquivo - Use
memory_forgetpara remover entradas irrelevantes - Mantenha as entradas concisas — salve a decisão, não a conversa inteira
- Entradas de baixa qualidade (vagas, sem tags) recebem automaticamente menor prioridade de recuperação
FAQ
Isso funciona com qualquer agente de IA?
Sim, desde que ele suporte MCP (Model Context Protocol). Temos configuração automática para 22 agentes, com configuração manual disponível para outros.
Meus dados são enviados para algum lugar?
Não. Tudo permanece na sua máquina. O servidor MCP roda localmente via stdio — sem chamadas de rede, sem telemetria, sem nuvem.
Posso usar isso em várias máquinas?
Sim, se você sincronizar o diretório .toon-memory/memory/ (por exemplo, via Git ou uma pasta compartilhada). Cada máquina precisa ter o toon-memory instalado, mas o arquivo de memória é portátil.
O que acontece se eu tiver vários projetos?
Cada projeto recebe seu próprio arquivo de memória. A memória não vaza entre projetos.
Posso criptografar apenas entradas específicas?
Não, a criptografia se aplica a todo o arquivo de memória. Se você precisar de criptografia seletiva, mantenha dados sensíveis em uma ferramenta separada.
Como isso é diferente de apenas usar um arquivo markdown?
Arquivos markdown não são estruturados, não são pesquisáveis pelo seu agente da mesma forma, não se integram via MCP e não possuem recursos como arquivamento, filtragem por data, pontuação de qualidade, mesclagem-deduplicação, rastreamento de confiança ou criptografia. O toon-memory é construído especificamente para agentes de IA.
Desenvolvimento
git clone https://github.com/LuiggiVal08/toon-memory.git
cd toon-memory
npm install
npm run build
npm test
Estrutura do Projeto
toon-memory/
├── src/
│   ├── bin/
│   │   └── toon-memory.ts      # Entry point
│   ├── cli/
│   │   ├── setup.ts             # CLI commands
│   │   └── toon-memory.ts       # CLI runner
│   ├── mcp/
│   │   ├── server.ts            # MCP server (38 tools + 4 resources + 1 prompt)
│   │   ├── tools.ts             # Tool registration (38 tools)
│   │   ├── resources.ts         # Resource registration (4 resources)
│   │   ├── prompts.ts           # Prompt registration (1 prompt)
│   │   ├── session-store.ts     # Session layer (auto-promote, cleanup)
│   │   ├── memory-io.ts         # Memory file read/write
│   │   ├── entries.ts           # Entry parsing & utilities
│   │   ├── scoring.ts           # Entry scoring & access tracking
│   │   ├── archive.ts           # Archive management
│   │   ├── consolidation.ts     # Duplicate consolidation
│   │   ├── config.ts            # Config loading & saving
│   │   └── crypto.ts            # AES-256-GCM encryption
│   ├── lib/
│   │   ├── lock.ts              # Advisory file lock + atomic write
│   │   ├── sessions.ts          # Multi-session coordination
│   │   ├── graph.ts             # Memory graph (parse, build, BM25, centrality, compact render)
│   │   ├── quality.ts           # Quality scoring, merge-dedup, smart recall, system primer
│   │   ├── context.ts           # Context briefing generator (one-call context)
│   │   └── vocab.ts             # Project-vocabulary discovery from dependencies
├── tests/
│   ├── cli.test.ts              # CLI tests
│   ├── memory.test.ts           # Memory tests
│   ├── sessions.test.ts         # Multi-session tests
│   ├── graph.test.ts            # Memory graph tests
│   └── quality.test.ts          # Quality scoring, merge-dedup, smart recall, system primer tests
├── .github/workflows/
│   ├── ci.yml                   # CI (Node.js 20/22)
│   └── publish.yml              # Auto-publish on release
├── package.json
├── tsconfig.json
└── vitest.config.ts
Contribuindo
Contribuições são bem-vindas! Por favor, leia nosso Código de Conduta e Guia de Contribuição primeiro.
- Faça um fork do repositório
- Crie sua branch de funcionalidade (
git checkout -b feature/amazing-feature) - Faça commit das suas alterações (
git commit -m 'feat: add amazing feature') - Envie para a branch (
git push origin feature/amazing-feature) - Abra um Pull Request
Segurança e Privacidade
O toon-memory é projetado com segurança e privacidade como princípio central.
- Armazenamento 100% local — Toda a memória é armazenada localmente na sua máquina em
.toon-memory/memory/. Nenhum dado é enviado para servidores externos, serviços em nuvem ou terceiros. - Sem telemetria — O projeto tem zero telemetria, análise ou rastreamento de qualquer tipo. Nenhum dado de uso é coletado.
- Sem execução remota de código — O toon-memory roda como um servidor MCP padrão via stdio. Ele não baixa, executa ou avalia código remoto.
- Criptografia em repouso — Criptografia opcional AES-256-GCM para todo o arquivo de memória. Ative com
memory_encrypt(requer a variável de ambienteTOON_MEMORY_KEY). - A chave de criptografia nunca é armazenada — A chave de criptografia deve ser fornecida via variável de ambiente e nunca é persistida pelo toon-memory. Se perdida, os dados não podem ser recuperados.
- Isolamento por projeto — Cada projeto tem seu próprio arquivo de memória isolado. A memória não vaza entre projetos.
.gitignoreautomático — O instalador adiciona.toon-memory/memory/ao.gitignorepara evitar commits acidentais de dados de memória.
Licença
MIT
Créditos
Construído com @toon-format/toon e @modelcontextprotocol/server.