llmprobe
Teste endpoints de API LLM e reporte métricas de saúde, incluindo tempo até o primeiro token, latência e throughput. Verifique modelos individuais ou execute verificações completas de saúde baseadas em configuração.
Documentação

llmprobe
Monitoramento sintético e testes de fumaça de CI para endpoints de inferência de LLM. Meça TTFT, latência, throughput e erros. Binário único, zero SDKs.


O llmprobe é uma ferramenta CLI para confiabilidade de servidores de LLM. Ele sonda APIs hospedadas ou servidores de inferência compatíveis com OpenAI e relata as métricas que importam para a experiência do usuário em produção: tempo até o primeiro token (TTFT), latência total, throughput de geração (tokens/seg) e taxas de erro.
Use-o como uma verificação de saúde pontual, um monitor contínuo ou um gate de CI que bloqueia deploys quando seu provedor de LLM está degradado.
Benchmark público
O llm-bench usa o llmprobe para executar um benchmark público contínuo das principais APIs de LLM. Ele publica um painel ao vivo em bench.jonathanwrede.de e dados JSONL brutos em Jwrede/llm-bench-data.
Este é o caso de uso pretendido: sondagens sintéticas repetidas que tornam visíveis a latência de LLM, regressões de TTFT, quedas de throughput e degradação do provedor antes que os usuários as relatem.
Instalação
Baixe um binário pré-compilado da última versão (Linux, macOS, Windows; amd64 e arm64).
Ou instale a partir do código-fonte:
go install github.com/Jwrede/llmprobe@latest
llmprobe version
Plugin do Claude Code
Instale como um plugin do Claude Code para a skill /llmprobe e ferramentas MCP:
claude plugin install Jwrede/llmprobe
Ou registre o servidor MCP diretamente:
claude mcp add --transport stdio llmprobe -- llmprobe mcp
O llmprobe é executado localmente e só contata os endpoints de LLM que você configurar. Consulte PRIVACY.md para detalhes.
Início rápido
O llmprobe funciona com OpenAI, Anthropic, Google, Azure OpenAI, AWS Bedrock e endpoints compatíveis com OpenAI, como vLLM, Ollama, OpenRouter, Groq, Together AI, Fireworks, DeepSeek e Mistral.
Crie um probes.yml (ou copie o exemplo incluído):
providers:
  - name: openai
    api_key: ${OPENAI_API_KEY}
    models:
      - name: gpt-4o
        thresholds:
          max_ttft: 2s
      - name: gpt-4o-mini
        thresholds:
          max_ttft: 500ms

  - name: anthropic
    api_key: ${ANTHROPIC_API_KEY}
    models:
      - name: claude-sonnet-4-20250514
        thresholds:
          max_ttft: 1s
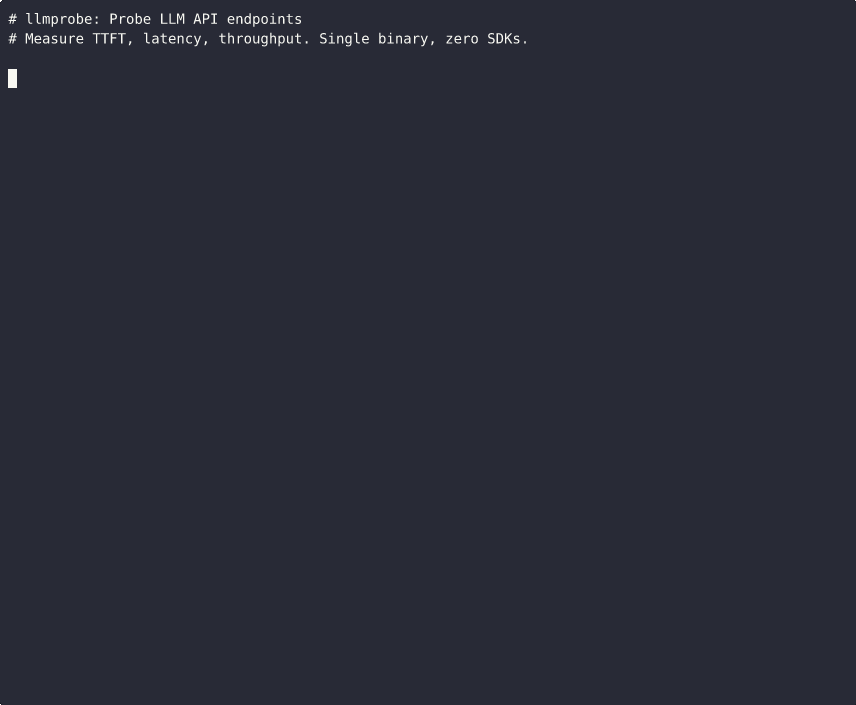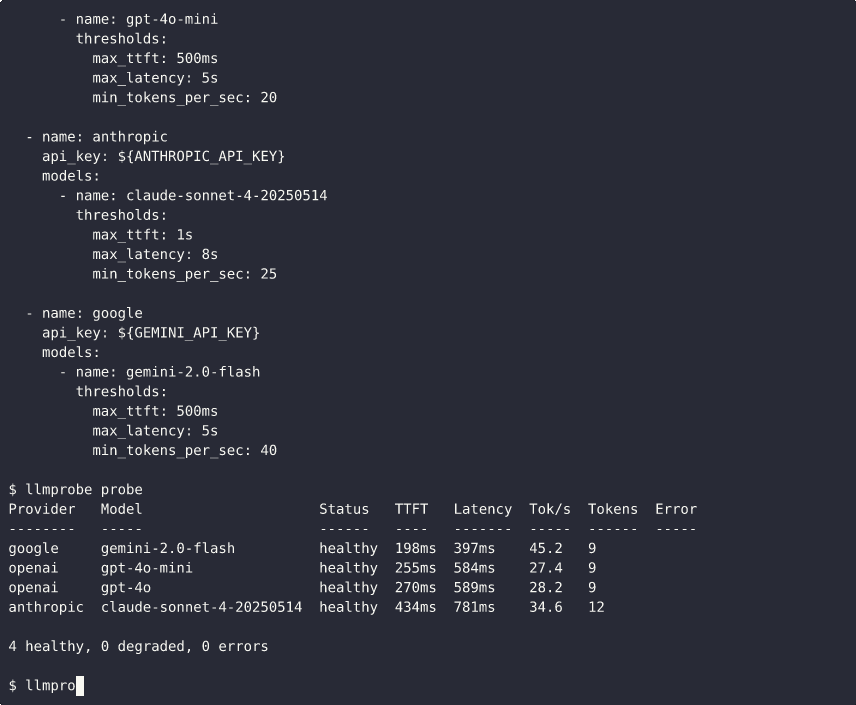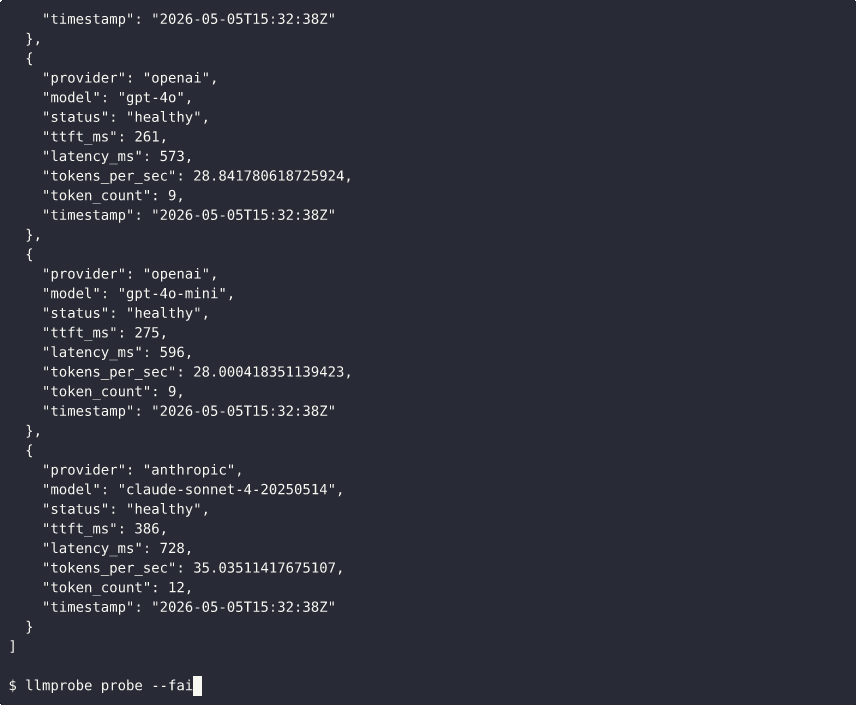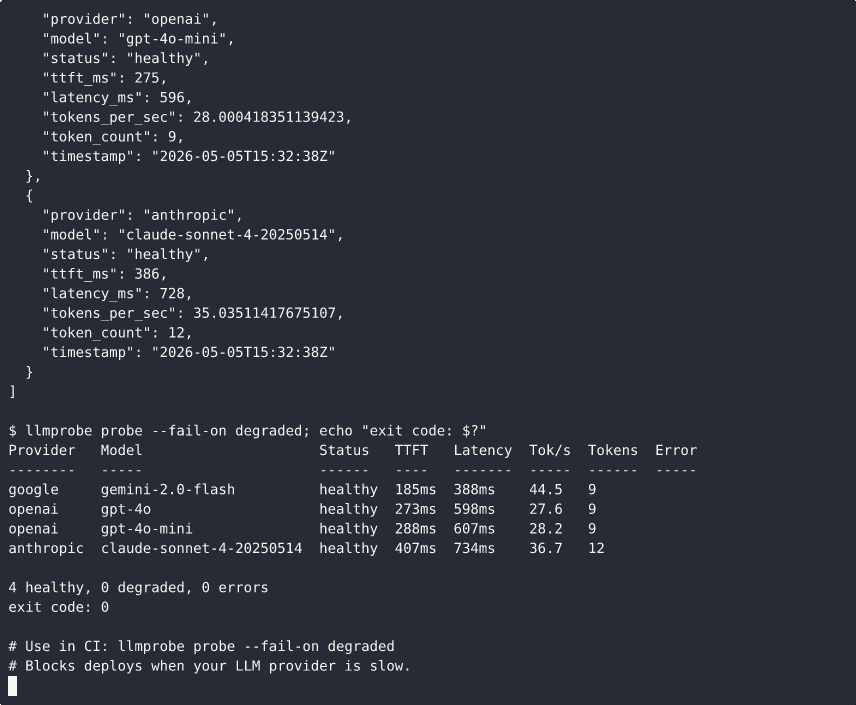
Execute uma sondagem:
$ llmprobe probe

Provider   Model                    Status    TTFT    Latency  Tok/s  Tokens  Error
--------   -----                    ------    ----    -------  -----  ------  -----
openai     gpt-4o                   healthy   312ms   2100ms   68.4   42
openai     gpt-4o-mini              healthy   98ms    814ms    112.3  56
anthropic  claude-sonnet-4-20250514 healthy   420ms   2831ms   52.1   38
azure      gpt-4o                   healthy   289ms   1950ms   71.2   44
bedrock    anthropic.claude-3-5...  degraded  1820ms  4510ms   28.1   38

4 healthy, 1 degraded, 0 errors
O que ele mede
| Métrica | O que significa |
|---|---|
| TTFT | Tempo do envio da requisição até o primeiro token de conteúdo. É o que os usuários sentem como "atraso" antes da resposta começar a transmitir. |
| Latência | Tempo total da requisição até o fechamento do stream. |
| Tok/s | Throughput de geração: tokens produzidos por segundo após o primeiro token. Calculado como token_count / (latency - ttft). |
| Tokens | Total de tokens de saída. Prefere metadados de uso do provedor quando disponíveis; caso contrário, usa a contagem de eventos SSE. |
| Status | healthy se todos os limites forem atendidos, degraded se algum limite for excedido, error se a requisição falhar. |
Comandos
llmprobe probe
Verificação de saúde pontual. Sonda todos os endpoints configurados e imprime os resultados.
llmprobe probe                        # table output
llmprobe probe -f json                # JSON output
llmprobe probe --fail-on degraded     # exit 1 if any endpoint is degraded
llmprobe probe -c custom-config.yml   # custom config path
Códigos de saída para CI:
--fail-on | Saída 0 | Saída 1 |
|---|---|---|
error (padrão) | saudável ou degradado | qualquer erro |
degraded | apenas saudável | degradado ou erro |
none | sempre | nunca |
llmprobe watch
Monitoramento contínuo. Sonda todos os endpoints em um intervalo e imprime uma linha de resumo por iteração.
llmprobe watch                          # default 60s interval
llmprobe watch --interval 30s           # custom interval
llmprobe watch --tui                    # live terminal dashboard with TTFT chart
llmprobe watch --tui --load data.jsonl  # load historical data into the dashboard
llmprobe watch -f json                  # JSONL output (one line per result)
llmprobe watch --prometheus :9090       # expose Prometheus metrics
llmprobe watch --otel localhost:4317     # export OpenTelemetry metrics via OTLP/gRPC
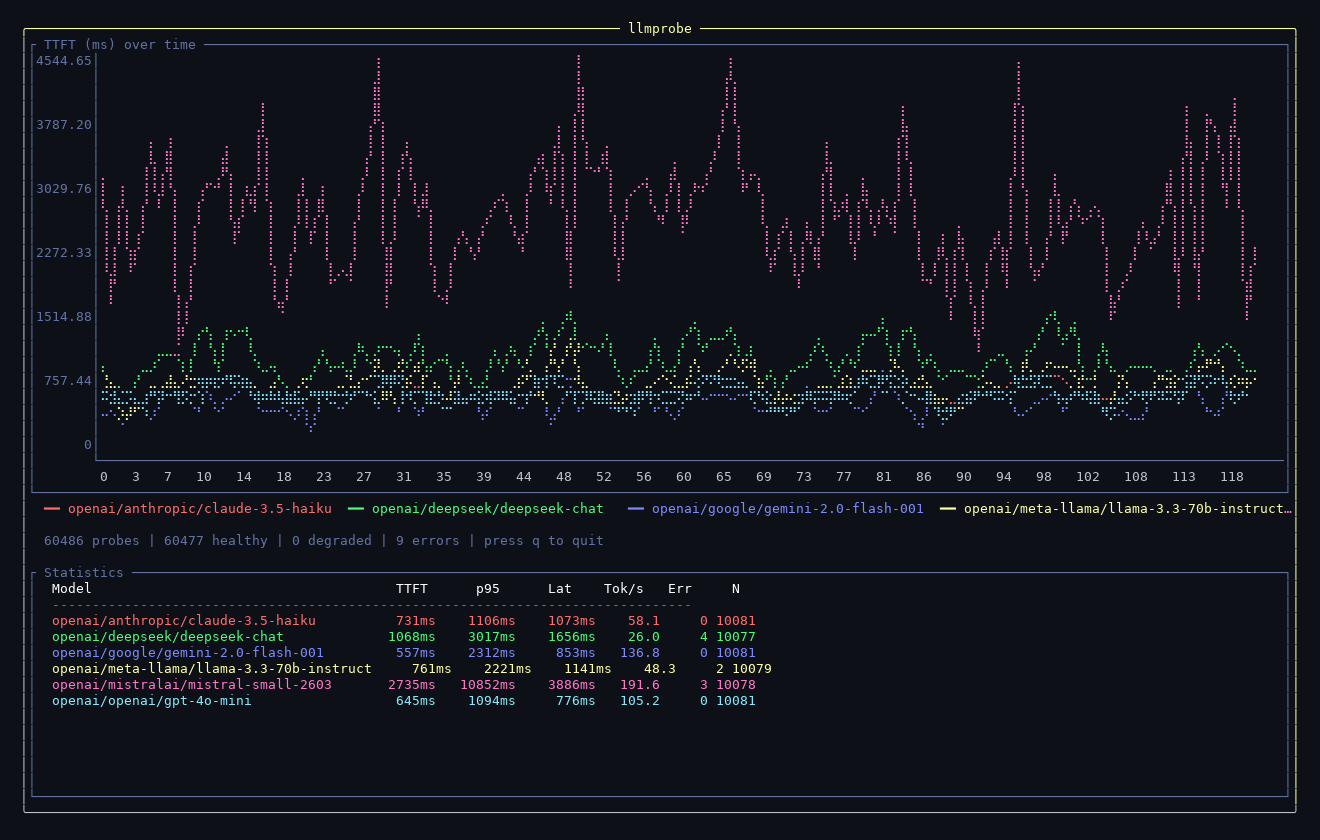
A flag --tui inicia um painel de terminal ao vivo com gráfico de TTFT, legenda de cores e tabela de estatísticas. Use --load para importar dados JSONL históricos (de llmprobe watch -f json > data.jsonl).
$ llmprobe watch --interval 30s

Watching 4 endpoints every 30s (Ctrl+C to stop)

[14:01:02] All 4 endpoints healthy.
[14:01:32] All 4 endpoints healthy.
[14:02:02] 3 healthy, 1 degraded, 0 errors. DEGRADED: openai/gpt-4o (TTFT 1820ms)
[14:02:32] All 4 endpoints healthy.
llmprobe report
Gere um resumo em Markdown a partir de dados de sondagem JSONL com percentis p50/p95/p99 para TTFT, latência e throughput por endpoint.
llmprobe report data.jsonl
Saída:
| Provider | Model | Probes | Errors | TTFT p50 | TTFT p95 | ... | Tok/s p50 | ...
|----------|-------|--------|--------|----------|----------|-----|-----------|----
| openai   | gpt-4o | 100  | 2      | 115ms    | 188ms    | ... | 46.9      | ...
llmprobe baseline
Crie um arquivo de linha de base a partir de dados JSONL históricos para detecção de regressões.
llmprobe baseline data.jsonl -o baseline.json
Referencie a linha de base na sua configuração para usar limites baseados em multiplicadores:
baseline: baseline.json

providers:
  - name: openai
    api_key: ${OPENAI_API_KEY}
    models:
      - name: gpt-4o
        thresholds:
          max_ttft_multiplier: 2.0       # fail if TTFT > 2x baseline p50
          max_latency_multiplier: 2.5    # fail if latency > 2.5x baseline p50
Isso permite detectar regressões em relação aos seus próprios dados históricos, em vez de definir limites absolutos.
llmprobe version
Imprima a versão do binário instalado.
llmprobe version
Integração com CI
Use llmprobe probe como um gate de pré-deploy:
# .github/workflows/deploy.yml
- name: Check LLM providers
  env:
    OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
    ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
  run: |
    go install github.com/Jwrede/llmprobe@latest
    llmprobe probe --fail-on degraded
Isso bloqueia o deploy se algum provedor de LLM estiver com desempenho degradado no momento.
Quando uma sondagem falha, a saída mostra apenas os endpoints com falha:
Failed endpoints (1/4):
  openai/gpt-4o  DEGRADED  TTFT=280ms  Latency=950ms  Tok/s=32.1
Servidor MCP

O llmprobe inclui um servidor Model Context Protocol integrado, permitindo que o Claude Code e outros hosts MCP verifiquem a saúde da API de LLM diretamente de um fluxo de trabalho de agente.
Executando o servidor
llmprobe mcp
Isso inicia o servidor MCP via stdio.
Registrando no Claude Code
claude mcp add --transport stdio llmprobe -- llmprobe mcp
Uma vez registrado, o Claude Code pode chamar as ferramentas do llmprobe durante qualquer conversa.
Ferramentas disponíveis
| Ferramenta | Descrição |
|---|---|
probe_all | Sonda todos os endpoints configurados de probes.yml. Retorna TTFT, latência, throughput e status de saúde para cada modelo. Aceita um parâmetro opcional config para um caminho de configuração personalizado. |
probe_model | Sonda um único modelo sem arquivo de configuração. Requer provider, model e api_key_env. Suporta base_url opcional para endpoints compatíveis com OpenAI e label opcional para exibição. |
list_providers | Lista todos os provedores e modelos no arquivo de configuração com seus limites. Use isso para descobrir modelos disponíveis antes de sondar. |
get_config | Retorna a configuração completa analisada, incluindo padrões, provedores, modelos e limites. |
Exemplo de uso: Um agente chama list_providers para ver quais modelos estão configurados e depois probe_all para verificar se estão saudáveis antes de implantar alterações.
Configuração
defaults:
  prompt: "Hello"                                # probe prompt
  max_tokens: 20                                 # max output tokens
  timeout: 30s                                   # per-probe timeout
  concurrency: 5                                 # max parallel probes

providers:
  - name: openai                    # openai, anthropic, google, azure, bedrock
    label: openai-prod              # optional display name; useful for multiple OpenAI-compatible endpoints
    api_key: ${OPENAI_API_KEY}      # env var expansion
    base_url: https://custom.api    # optional, override endpoint
    models:
      - name: gpt-4o
        prompt: "Say hello."        # override default prompt
        max_tokens: 10              # override default max_tokens
        response_format: json       # optional; OpenAI-compatible JSON mode
        validate_json: true         # optional; mark degraded if returned content is not valid JSON
        thresholds:
          max_ttft: 2s              # alert if TTFT exceeds this
          max_latency: 10s          # alert if total latency exceeds this
          min_tokens_per_sec: 20    # alert if throughput drops below this
          max_ttft_multiplier: 2.0  # optional; compare against baseline p50
          max_latency_multiplier: 2.5

  - name: azure
    api_key: ${AZURE_OPENAI_API_KEY}
    base_url: https://your-resource.openai.azure.com
    api_version: "2024-10-21"       # optional, defaults to 2024-10-21
    models:
      - name: gpt-4o               # deployment name

  - name: bedrock
    access_key: ${AWS_ACCESS_KEY_ID}
    secret_key: ${AWS_SECRET_ACCESS_KEY}
    region: us-east-1
    models:
      - name: anthropic.claude-3-5-sonnet-20241022-v2:0
Chaves de API e credenciais AWS suportam sintaxe ${ENV_VAR}. Apenas campos de credenciais são expandidos, então referências a variáveis de ambiente em prompts ou nomes de modelos são mantidas como estão.
Provedores compatíveis com OpenAI
Muitos provedores (Groq, Together AI, Fireworks, DeepSeek, Mistral, OpenRouter, Ollama, vLLM) expõem uma API compatível com OpenAI. Eles funcionam imediatamente definindo base_url. Use o campo label para distinguir vários blocos compatíveis com OpenAI:
providers:
  # Groq
  - name: openai
    label: groq
    api_key: ${GROQ_API_KEY}
    base_url: https://api.groq.com/openai
    models:
      - name: llama-3.3-70b-versatile

  # DeepSeek
  - name: openai
    label: deepseek
    api_key: ${DEEPSEEK_API_KEY}
    base_url: https://api.deepseek.com
    models:
      - name: deepseek-chat

  # Together AI
  - name: openai
    label: together
    api_key: ${TOGETHER_API_KEY}
    base_url: https://api.together.xyz
    models:
      - name: meta-llama/Meta-Llama-3.1-70B-Instruct-Turbo

  # Local Ollama
  - name: openai
    label: ollama
    api_key: unused
    base_url: http://localhost:11434
    models:
      - name: llama3.2
Consulte examples/ para configurações prontas para vLLM, SGLang e Ollama.
Validação de resposta JSON
Para endpoints compatíveis com OpenAI, defina response_format: json para solicitar o modo JSON e validate_json: true para marcar a sondagem como degraded se o conteúdo transmitido não for JSON válido.
providers:
  - name: openai
    label: vllm-json
    api_key: unused
    base_url: http://localhost:8000
    models:
      - name: meta-llama/Llama-3.1-8B-Instruct
        prompt: 'Return {"ok": true} as JSON.'
        response_format: json
        validate_json: true
Métricas Prometheus
Execute com --prometheus para expor métricas para coleta:
llmprobe watch --interval 30s --prometheus :9090
Métricas disponíveis em /metrics:
| Métrica | Tipo | Rótulos |
|---|---|---|
llmprobe_ttft_seconds | gauge | provider, model |
llmprobe_latency_seconds | gauge | provider, model |
llmprobe_tokens_per_second | gauge | provider, model |
llmprobe_token_count | gauge | provider, model |
llmprobe_status | gauge | provider, model |
llmprobe_probes_total | counter | provider, model |
llmprobe_errors_total | counter | provider, model |
llmprobe_ttft_seconds_hist | histogram | provider, model |
llmprobe_latency_seconds_hist | histogram | provider, model |
llmprobe_tokens_per_second_hist | histogram | provider, model |
O gauge llmprobe_status codifica a saúde como: 1 = saudável, 0.5 = degradado, 0 = erro. Use isso para alertas no Grafana ou Alertmanager.
Métricas OpenTelemetry
Execute com --otel para exportar métricas de sondagem para um coletor OTLP/gRPC.
llmprobe watch --interval 30s --otel localhost:4317
Nomes das métricas exportadas:
| Métrica | Descrição |
|---|---|
llmprobe.ttft.seconds | Tempo até o primeiro token em segundos |
llmprobe.latency.seconds | Latência total da requisição em segundos |
llmprobe.tokens_per_second | Throughput de geração |
llmprobe.token_count | Contagem de tokens de saída da última sondagem |
llmprobe.status | 1 = saudável, 0.5 = degradado, 0 = erro |
llmprobe.probes.total | Total de sondagens executadas |
llmprobe.errors.total | Total de erros de sondagem |
Todas as métricas incluem atributos provider e model.
Arquitetura
probes.yml
  -> Config loader (YAML + env var expansion)
    -> Probe engine (concurrent goroutines per provider/model)
      -> Provider clients (raw HTTP + SSE parsing, no SDKs)
        -> Results (TTFT, latency, tokens/sec, status)
          -> Output (table, JSON, JSONL)
Cada cliente de provedor é um wrapper HTTP leve que envia uma requisição de streaming e analisa a resposta. Nenhum SDK de LLM é importado. O parser SSE lida tanto com eventos somente de dados (OpenAI, Google) quanto com eventos nomeados (Anthropic). O cliente Bedrock implementa assinatura SigV4 e análise de stream de eventos binários da AWS do zero.
O TTFT é medido desde o momento em que a requisição HTTP é enviada até o primeiro evento que contém texto de conteúdo real (não atribuições de papel ou metadados).
Provedores
| Provedor | Endpoint | Autenticação | Formato de streaming |
|---|---|---|---|
| OpenAI | /v1/chat/completions | Authorization: Bearer | SSE, sentinela [DONE] |
| Anthropic | /v1/messages | cabeçalho x-api-key | SSE com eventos nomeados |
/v1beta/models/{model}:streamGenerateContent?alt=sse | parâmetro de consulta key | SSE | |
| Azure OpenAI | /openai/deployments/{model}/chat/completions | cabeçalho api-key | SSE, sentinela [DONE] |
| AWS Bedrock | /model/{model}/converse-stream | SigV4 | Stream de eventos binários AWS |
| OpenAI-compat | /v1/chat/completions (base_url personalizado) | Authorization: Bearer | SSE |
Compatível com OpenAI abrange: Groq, Together AI, Fireworks, DeepSeek, Mistral, OpenRouter, Ollama, vLLM e qualquer endpoint que fale a API de chat completions da OpenAI.
Roadmap
- Mais exemplos específicos de provedores para endpoints compatíveis com OpenAI auto-hospedados
- Mais formatos de relatório para janelas de monitoramento de longa duração
- Modelos opcionais de runbook para falhas comuns de endpoints de LLM
Licença
MIT