Druid MCP server
Servidor MCP para acessar e administrar o banco de dados Apache Druid
Documentação
Druid MCP Server
Um servidor abrangente de Model Context Protocol (MCP) para Apache Druid que fornece ferramentas, recursos e prompts extensivos para gerenciar e analisar clusters Druid.
Desenvolvido por iunera - Soluções Avançadas de IA e Análise de Dados
Visão Geral
Este servidor MCP implementa uma arquitetura baseada em intenções, onde perfis descrevem sua intenção de uso e a área correspondente de uso do Druid. O servidor fornece três tipos principais de componentes MCP:
- Ferramentas - Funções executáveis para realizar operações
- Recursos - Provedores de dados para acessar informações
- Prompts - Modelos de orientação assistidos por IA
Vídeo de Demonstração
Aprenda como integrar agentes de IA com Apache Druid usando o servidor MCP. Este tutorial demonstra exploração de séries temporais, análise estatística e ingestão de dados usando linguagem natural com assistentes de IA como Claude, ChatGPT e Gemini.

Clique na miniatura acima para assistir ao vídeo no YouTube
🌊 Y̊pipe: Interface de IA para Druid
Experimente seus dados como nunca antes com Y̊pipe (anteriormente Data-Philter), um aplicativo desktop local que torna a IA offline prática, projetado pela iunera. Ele aproveita este Druid MCP Server para fornecer uma interface conversacional e integrada para seu cluster Druid.
- Consultas em Linguagem Natural: Faça perguntas em inglês simples e obtenha resultados instantaneamente.
- Local e Seguro: Executa completamente localmente com suporte para modelos offline (CPU/GPU).
- Plug & Play: Funciona imediatamente com a Instalação de Desenvolvimento do Druid.

A maneira mais fácil de testar iunera/druid-mcp-server é ypipe.com / https://github.com/iunera/ypipe
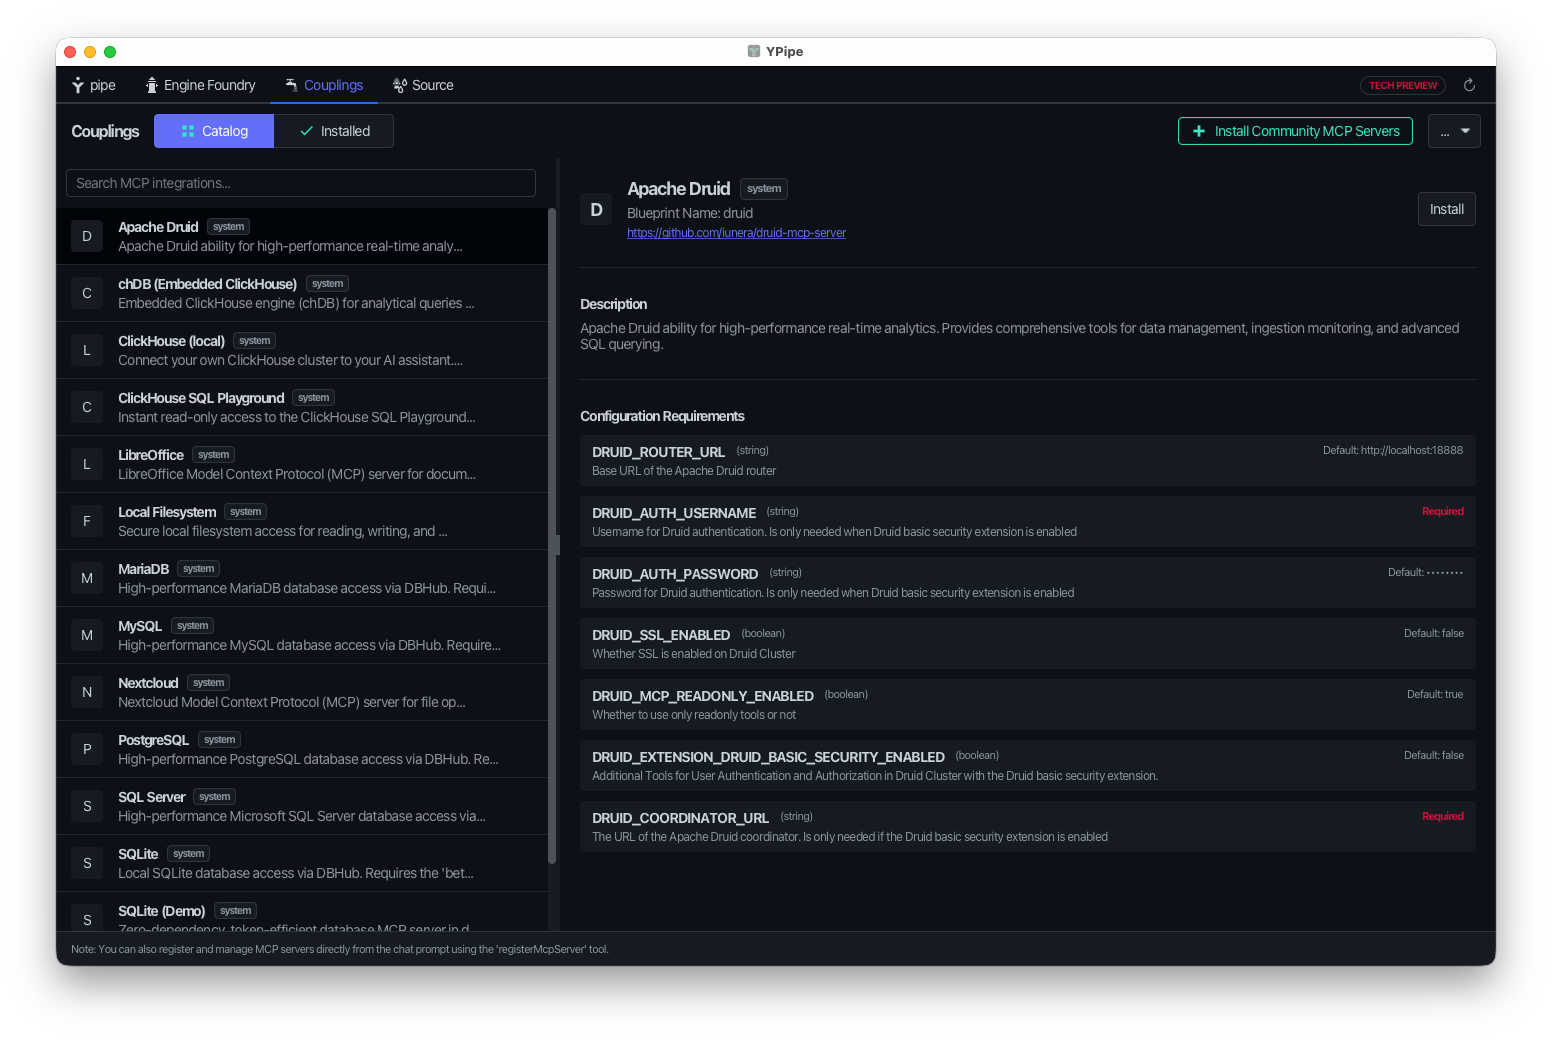
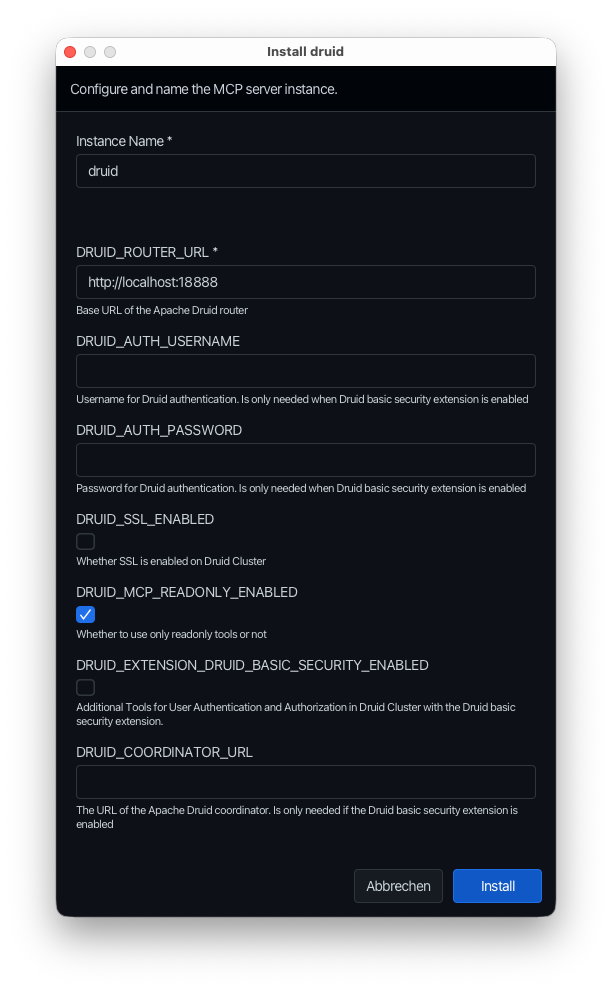
📋 Blueprint de Integração Ypipe
Para integração perfeita, fornecemos um arquivo de blueprint de integração Ypipe predefinido:
- Arquivo Blueprint: druid.ypipe
- Guia de Configuração: Documentação de Exemplo do Ypipe
Este blueprint permite que você conecte e configure facilmente o servidor MCP Druid no Ypipe através de um espaço de trabalho visual.
| Fluxo do Espaço de Trabalho Ypipe | Configuração do Nó Druid |
|---|---|
 |  |
Recursos
- Java Puro
- Integração com Spring AI MCP Server
- Arquitetura baseada em ferramentas para conformidade com o protocolo MCP
- Arquitetura Baseada em Ferramentas: Conformidade completa com o protocolo MCP com geração automática de esquema JSON
- Múltiplos Modos de Transporte: Suporte a STDIO, SSE e HTTP Streamable incluindo OAuth
- Comunicação em Tempo Real: Server-Sent Events com capacidades de streaming
- Tratamento abrangente de erros
- Modelos de Prompt Personalizáveis: Orientação assistida por IA com personalização de modelos
- Tratamento Abrangente de Erros: Tratamento gracioso de erros com respostas significativas
- Pronto para Empresas: Configuração de produção e recursos de segurança
Interface do Inspetor MCP
Quando conectado a um cliente MCP, você pode inspecionar as ferramentas, recursos e prompts disponíveis através da interface do inspetor MCP:
Ferramentas Disponíveis
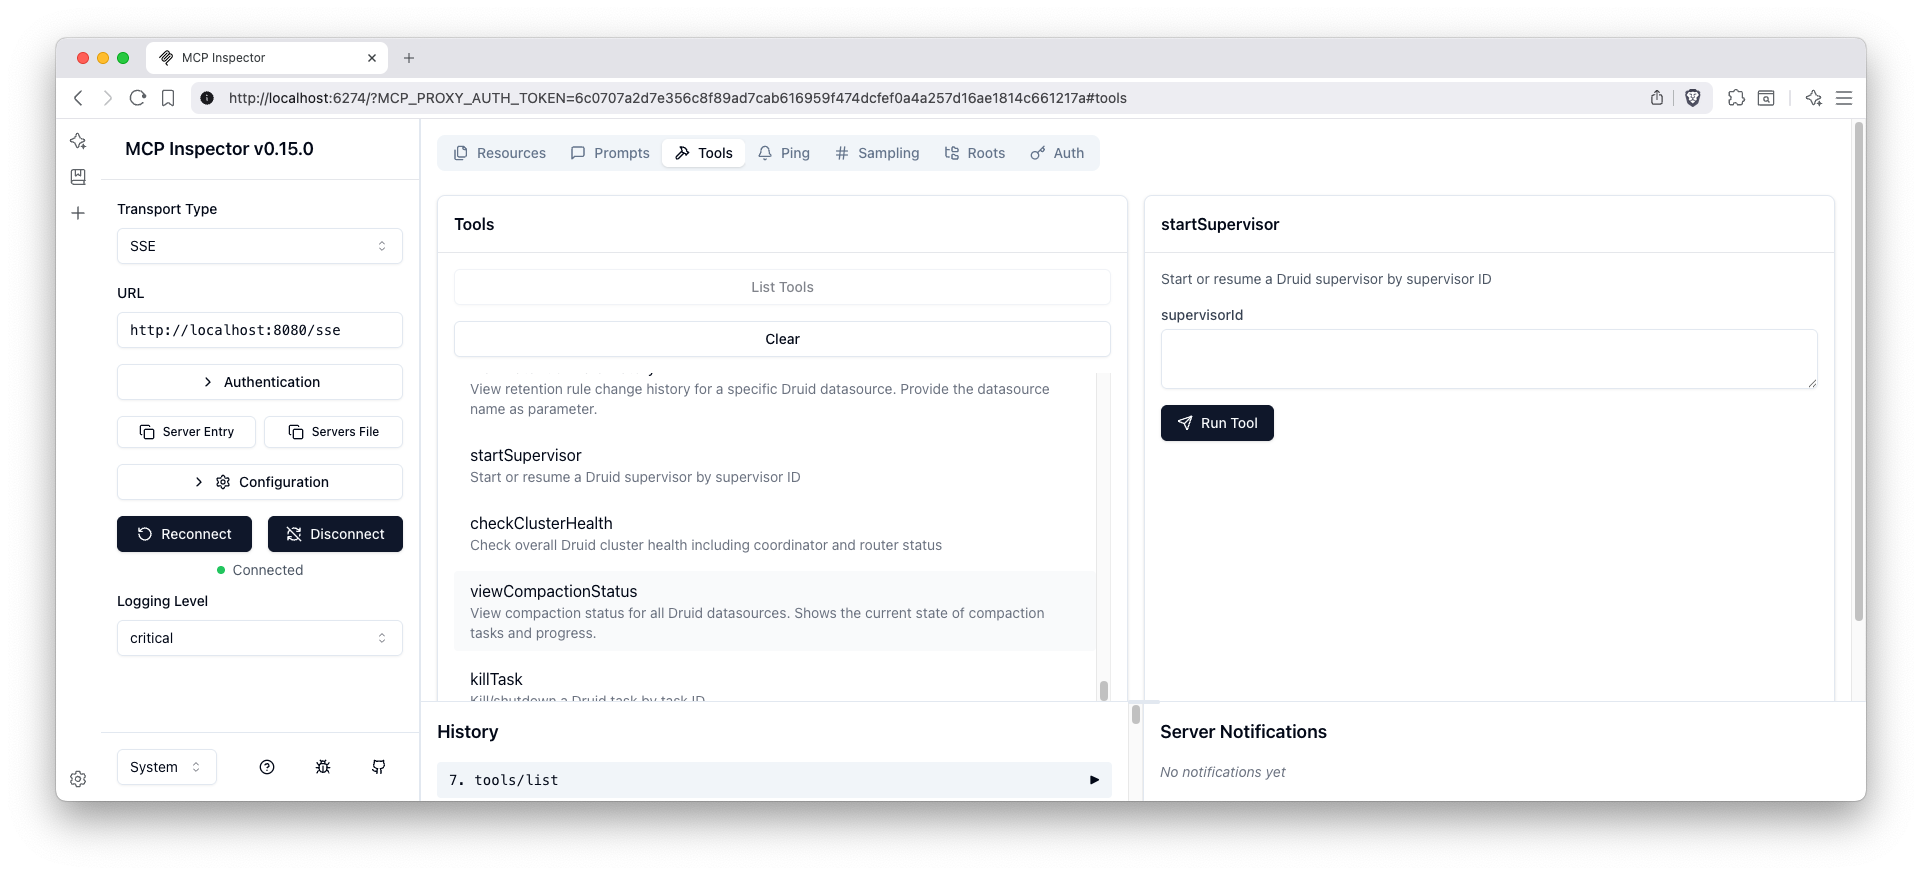
A interface de ferramentas mostra todas as funções de gerenciamento do Druid disponíveis, organizadas por áreas de recursos, incluindo gerenciamento de dados, gerenciamento de ingestão e monitoramento e saúde.
Recursos Disponíveis
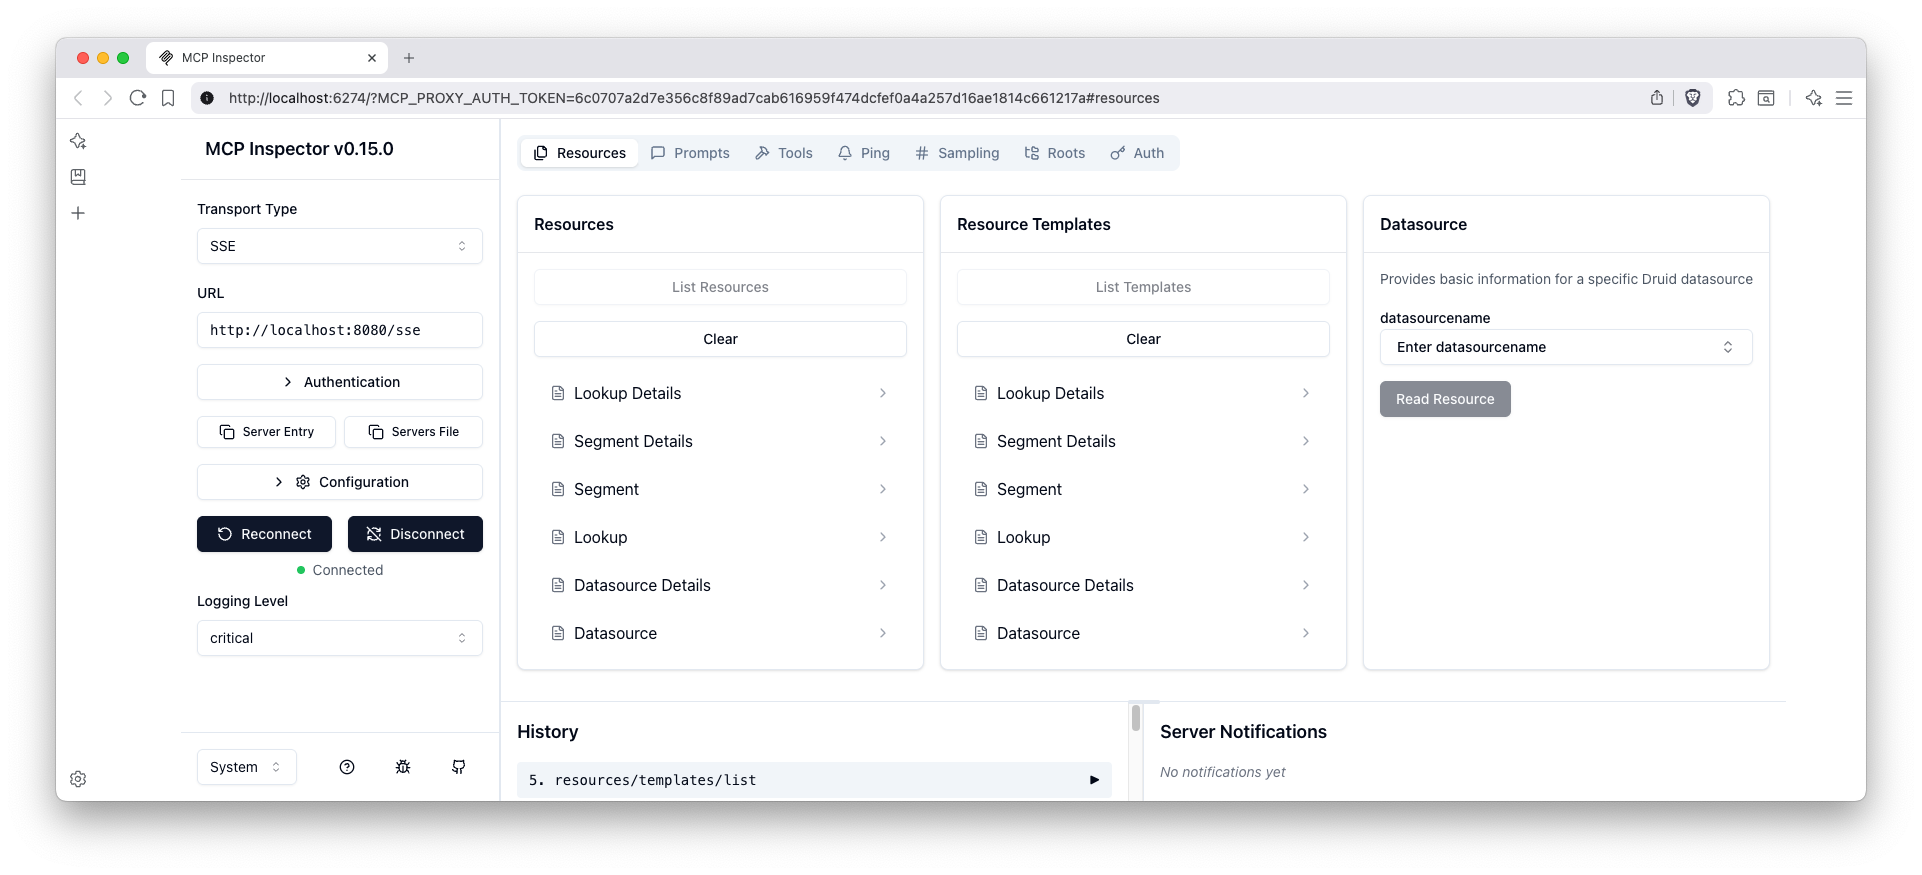
A interface de recursos exibe todas as fontes de dados e metadados do Druid acessíveis que podem ser recuperados através do protocolo MCP.
Prompts Disponíveis
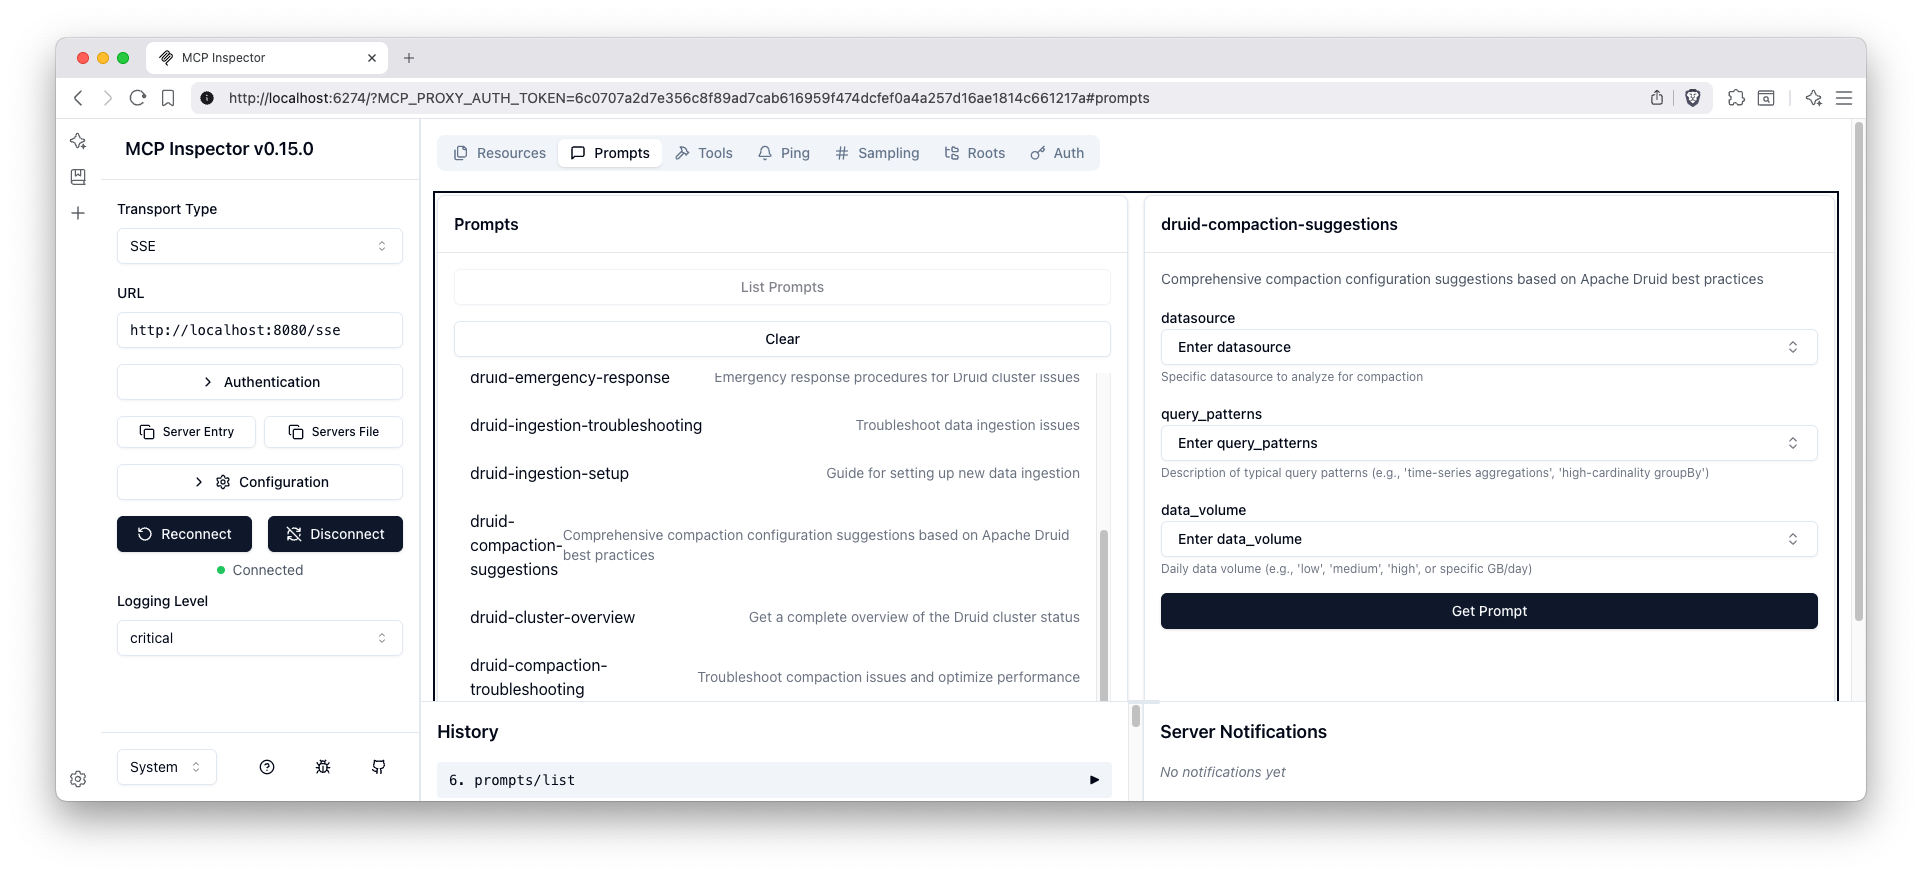
A interface de prompts mostra todos os modelos de orientação assistidos por IA disponíveis para várias tarefas de gerenciamento do Druid e fluxos de trabalho de análise de dados.
Início Rápido
Configuração MCP para LLMs
Um arquivo de configuração MCP pronto para uso é fornecido em mcp-servers-config.json que pode ser usado com clientes LLM para conectar a este servidor MCP Druid.
Exemplos
A configuração inclui múltiplas opções de integração e transporte:
- STDIO (padrão): veja examples/stdio/README.md - o servidor é iniciado pelo cliente MCP via STDIO.
- HTTP Streamable (perfil: http): veja examples/streamable-http/README.md - endpoint único /mcp conforme MCP 2025-06-18.
- Blueprint Ypipe: veja examples/ypipe/README.md - configure e execute o Druid MCP Server dentro do cliente desktop Ypipe usando o blueprint druid.ypipe.
Exemplos Docker usando variáveis de ambiente:
# STDIO mode (default)
docker run --rm -i \
  -e DRUID_ROUTER_URL=http://your-druid-router:8888 \
  -e DRUID_COORDINATOR_URL=http://your-druid-coordinator:8081 \
  iunera/druid-mcp-server:latest

# HTTP mode (enable profile 'http' and expose /mcp)
docker run -p 8080:8080 \
  -e SPRING_PROFILES_ACTIVE=http,query \
  -e DRUID_ROUTER_URL=http://your-druid-router:8888 \
  -e DRUID_COORDINATOR_URL=http://your-druid-coordinator:8081 \
  iunera/druid-mcp-server:latest
Nota sobre perfis Spring:
- Perfil padrão: stdio,query
- Perfil HTTP: defina SPRING_PROFILES_ACTIVE=http,query para habilitar HTTP Streamable em /mcp
Pré-requisitos
- Java 25
- Maven 3.6+
- Cluster Apache Druid em execução com roteador na porta 8888
Compilar e Executar
# Build the application
mvn clean package -DskipTests

# Run the application
java -jar target/druid-mcp-server-2.0.1.jar
O servidor iniciará na porta 8080 por padrão.
Para instruções detalhadas de compilação, testes, configuração Docker e diretrizes de desenvolvimento, veja development.md.
Segurança e Autenticação
- Os transportes HTTP Streamable e SSE são protegidos com OAuth 2.0 por padrão.
- Os clientes devem enviar um token Bearer válido no cabeçalho Authorization ao conectar.
- Exemplo: Authorization: Bearer YOUR_JWT_TOKEN
Variáveis de Ambiente
DRUID_MCP_SECURITY_OAUTH2_ENABLED:- Descrição: Habilita ou desabilita a segurança OAuth2 para autenticação de clientes.
- Tipo: Booleano
- Padrão:
true(OAuth2 está habilitado por padrão conforme o texto acima) - Uso: Defina como
falsepara desabilitar a autenticação OAuth2. Quando desabilitado, os clientes podem acessar o servidor sem fornecer tokens OAuth2.
- Para integração SSO empresarial (OpenID Connect, Azure AD, Keycloak, etc.), envie uma consulta para consulting@iunera.com e veja Contato e Suporte.
Instalação a partir do Maven Central
Se você preferir usar o JAR pré-compilado sem compilar a partir do código-fonte, você pode baixá-lo e executá-lo diretamente do Maven Central.
Pré-requisitos
- Apenas JRE Java 25
Baixar e Executar
Baixe o JAR do Maven Central https://repo.maven.apache.org/maven2/com/iunera/druid-mcp-server/
# STDIO mode (default)
java -jar target/druid-mcp-server-2.0.1.jar

# HTTP mode (profile: http) - exposes /mcp on port 8080
java -Dspring.profiles.active=http \
     -jar target/druid-mcp-server-2.0.1.jar
Para Desenvolvedores
Para informações detalhadas de desenvolvimento, incluindo instruções de compilação, diretrizes de teste, detalhes de arquitetura e diretrizes de contribuição, veja development.md.
Ferramentas Disponíveis por Recurso
O servidor MCP ativa ferramentas dinamicamente com base nos perfis Spring ativos (SPRING_PROFILES_ACTIVE). A configuração padrão executa o servidor no modo STDIO com o perfil query habilitado.
Perfil: query (Perfil Ativo Padrão)
Fornece capacidades seguras e somente leitura de consulta e navegação de dados.
| Ferramenta | Descrição | Parâmetros | Endpoint / Funcionalidade da API Druid |
|---|---|---|---|
getDatasources | Lista todas as fontes de dados Apache Druid disponíveis ou obtém esquema detalhado para uma fonte de dados específica. | datasourceName (String, opcional), detailed (Booleano, opcional) | /druid/v2/sql (consulta catálogos do sistema como INFORMATION_SCHEMA.TABLES e COLUMNS) |
getLookups | Obtém configuração ou status de lookups para todos ou um nível específico. | tier (String, opcional), lookupName (String, opcional), includeStatus (Booleano, opcional) | Endpoints /druid/coordinator/v1/lookups/config e /status |
getSegments | Busca metadados de segmentos ou detalhes para um segmento específico. | datasource (String, opcional), segmentId (String, opcional), detailed (Booleano, opcional), metadataOnly (Booleano, opcional) | /druid/coordinator/v1/datasources/{ds}/segments e tabelas do sistema (sys.segments via /druid/v2/sql) |
getSegmentLoadQueue | Obtém o status da fila de carregamento mostrando segmentos atualmente sendo carregados. | serverName (String, opcional) | /druid/coordinator/v1/loadqueue |
queryDruidSql | Executa uma consulta SQL contra fontes de dados Druid. | sqlQuery (String, obrigatório) | /druid/v2/sql (Endpoint SQL do Roteador / Broker) |
Perfil: ops
Fornece controle administrativo sobre especificações de ingestão, tarefas, supervisores de streaming, regras de retenção e compactação.
| Ferramenta | Descrição | Parâmetros | Endpoint/Funcionalidade da API Druid |
|---|---|---|---|
getCompactionConfig | Visualizar configuração de compactação ou histórico de alterações de configuração para datasources. | datasource (String, opcional), includeHistory (Boolean, opcional) | Endpoints /druid/coordinator/v1/config/compaction |
getCompactionStatus | Recuperar o status atual das execuções de compactação e seu progresso. | datasource (String, opcional) | /druid/coordinator/v1/compaction/status |
manageCompaction | Adicionar, atualizar ou remover uma configuração de compactação. | action (Enum: UPSERT, DELETE, obrigatório), datasource (String, obrigatório), configJson (String, opcional) | /druid/coordinator/v1/config/compaction (POST/DELETE) |
manageDatasourceOrSegment | Modificar estados de segmentos ou descartar permanentemente um datasource. | action (Enum: ENABLE_SEGMENT, DISABLE_SEGMENT, KILL_DATASOURCE, obrigatório), datasource (String, obrigatório), segmentId (String, opcional), interval (String, opcional) | /druid/coordinator/v1/datasources e POST/DELETE de segmentos |
manageLookup | Criar, atualizar ou excluir uma configuração de lookup. | action (Enum: UPSERT, DELETE, obrigatório), tier (String, obrigatório), lookupName (String, obrigatório), configJson (String, opcional) | /druid/coordinator/v1/lookups/config (POST/DELETE) |
queryDruidMultiStage | Executar uma consulta SQL multi-estágio (MSQ) contra datasources Druid como uma tarefa. | sqlQuery (String, obrigatório) | /druid/v2/sql/task (endpoint de execução MSQ) |
queryDruidMultiStageWithContext | Executar uma consulta SQL multi-estágio com parâmetros de contexto personalizados. | sqlQuery (String, obrigatório), contextJson (String, opcional) | /druid/v2/sql/task com configurações de contexto |
getMultiStageQueryTaskStatus | Obter o status de uma tarefa de consulta multi-estágio. | taskId (String, obrigatório) | /druid/indexer/v1/task/{taskId}/status |
cancelMultiStageQueryTask | Cancelar uma tarefa de consulta multi-estágio em execução. | taskId (String, obrigatório) | /druid/indexer/v1/task/{taskId}/shutdown (POST) |
getRetentionRules | Recuperar regras de retenção ou histórico de auditoria para um datasource específico ou todos os datasources. | datasource (String, opcional), includeHistory (Boolean, opcional) | /druid/coordinator/v1/rules |
manageRetentionRules | Atualizar a configuração de regras de retenção para um datasource específico. | datasource (String, obrigatório), rulesJson (String, obrigatório) | /druid/coordinator/v1/rules |
submitIngestion | Enviar uma especificação de ingestão Druid ou gerar um modelo de lote simples. | action (Enum: SUBMIT_SPEC, GENERATE_TEMPLATE, obrigatório), payloadJson (String, opcional), datasourceName (String, opcional), inputSourceType (String, opcional), inputSourcePath (String, opcional) | /druid/indexer/v1/task (POST) |
getSupervisors | Listar todos os supervisores ou consultar detalhes de um supervisor específico. | supervisorId (String, opcional) | /druid/indexer/v1/supervisor |
manageSupervisor | Suspender, retomar ou encerrar a execução de um supervisor. | supervisorId (String, obrigatório), action (Enum: SUSPEND, RESUME, TERMINATE, obrigatório) | /druid/indexer/v1/supervisor/{id}/(suspend/resume/terminate) |
getTasks | Listar tarefas de ingestão que correspondem a estados específicos. | state (Enum: RUNNING, PENDING, WAITING, COMPLETED, opcional) | /druid/indexer/v1/runningTasks, pendingTasks, waitingTasks, completeTasks |
getTaskDetails | Buscar informações detalhadas, especificações, relatórios de execução ou logs de execução de uma tarefa. | taskId (String, obrigatório), aspect (Enum: STATUS, RAW_DETAILS, SPEC, REPORTS, LOG, obrigatório), logOffset (Long, opcional) | Endpoints de spec, status, relatórios e log de /druid/indexer/v1/task/{id} |
shutdownTask | Encerrar/desligar uma tarefa Druid. | taskId (String, obrigatório) | /druid/indexer/v1/task/{id}/shutdown (POST) |
getClusterStatus | Verificar a saúde geral ou buscar metadados/propriedades específicos de coordenadores ou roteadores. | aspect (Enum: OVERALL, COORDINATOR, ROUTER, LEADER, METADATA, PROPERTIES, SELF_DISCOVERY_COORDINATOR, SELF_DISCOVERY_ROUTER, opcional) | /status/health, /status/selfDiscovered, /druid/coordinator/v1/leader, /druid/coordinator/v1/config |
getNodesStatus | Listar servidores registrados, seu status detalhado ou status de um único nó. | serverName (String, opcional), detailed (Boolean, opcional) | /druid/coordinator/v1/servers e /status |
diagnoseCluster | Realizar verificações de saúde diagnósticas automatizadas, auditorias de configuração ou análise de desempenho de consultas. | mode (Enum: COMPREHENSIVE, QUICK, PERFORMANCE, CONFIGURATION, obrigatório) | Orquestra varreduras diagnósticas sobre tarefas ativas, status de servidores, contagens de segmentos e APIs |
checkFunctionalityHealth | Validar operações de sistemas de ingestão, transições de estado de supervisores e latência histórica de consultas. | component (Enum: ALL, SUPERVISORS, HISTORICALS, INGESTION, opcional), quick (Boolean, opcional) | Orquestra verificações sobre logs de execução de tarefas e status de supervisores |
Perfil: permissions
Fornece administração básica de autenticação e autorização de segurança.
[!IMPORTANT] As ferramentas de segurança básica só são ativadas se ambas as condições a seguir forem atendidas:
- O perfil
permissionsestá ativado (spring.profiles.active=permissions).- A URL do Coordenador (
druid.coordinator.url) está definida e não vazia.
| Ferramenta | Descrição | Parâmetros | Endpoint/Funcionalidade da API Druid |
|---|---|---|---|
manageAuthentication | Administrar usuários e credenciais de segurança básica. | authenticator (String, obrigatório), action (Enum: LIST, GET, CREATE, DELETE, SET_PASSWORD, obrigatório), username (String, opcional), password (String, opcional) | /druid-ext/basic-security/authentication/db/... |
manageAuthorization | Gerenciar propriedades de autorização de segurança, funções e políticas de acesso a recursos. | authorizer (String, obrigatório), action (Enum: LIST_USERS, GET_USER, CREATE_USER, DELETE_USER, LIST_ROLES, GET_ROLE, CREATE_ROLE, DELETE_ROLE, SET_PERMISSIONS, obrigatório), name (String, opcional), permissionsJson (String, opcional) | /druid-ext/basic-security/authorization/db/... |
manageSecurityAssignments | Configurar regras de mapeamento que atribuem funções a usuários, ou recuperar as cadeias de autenticador configuradas. | authorizer (String, obrigatório), action (Enum: ASSIGN_ROLE, UNASSIGN_ROLE, GET_CHAIN, obrigatório), username (String, opcional), roleName (String, opcional) | /druid-ext/basic-security/authorization/db/... e /status/properties |
Perfil: health
Fornece verificação ativa de saúde, status do cluster, diagnósticos e varreduras de recomendação do doctor.
| Ferramenta | Descrição | Parâmetros | Endpoint/Funcionalidade da API Druid |
|---|---|---|---|
getClusterStatus | Verificar a saúde geral ou buscar metadados/propriedades específicos de coordenadores ou roteadores. | aspect (Enum: OVERALL, COORDINATOR, ROUTER, LEADER, METADATA, PROPERTIES, SELF_DISCOVERY_COORDINATOR, SELF_DISCOVERY_ROUTER, opcional) | /status/health, /status/selfDiscovered, /druid/coordinator/v1/leader, /druid/coordinator/v1/config |
getNodesStatus | Listar servidores registrados, seu status detalhado ou status de um único nó. | serverName (String, opcional), detailed (Boolean, opcional) | /druid/coordinator/v1/servers e /status |
diagnoseCluster | Realizar verificações de saúde diagnósticas automatizadas, auditorias de configuração ou análise de desempenho de consultas. | mode (Enum: COMPREHENSIVE, QUICK, PERFORMANCE, CONFIGURATION, obrigatório) | Orquestra varreduras diagnósticas sobre tarefas ativas, status de servidores, contagens de segmentos e APIs |
checkFunctionalityHealth | Validar operações de sistemas de ingestão, transições de estado de supervisores e latência histórica de consultas. | component (Enum: ALL, SUPERVISORS, HISTORICALS, INGESTION, opcional), quick (Boolean, opcional) | Orquestra verificações sobre logs de execução de tarefas e status de supervisores |
Recursos Disponíveis por Funcionalidade
| Funcionalidade | Padrão de URI do Recurso | Descrição | Parâmetros |
|---|---|---|---|
| Datasource | druid://datasource/{datasourceName} | Acessar informações e metadados do datasource | datasourceName (String) |
| Datasource | druid://datasource/{datasourceName}/details | Acessar informações detalhadas do datasource, incluindo esquema | datasourceName (String) |
| Lookup | druid://lookup/{tier}/{lookupName} | Acessar configuração e dados de lookup | tier (String), lookupName (String) |
| Segmentos | druid://segment/{segmentId} | Acessar metadados e informações de segmentos | segmentId (String) |
Prompts Disponíveis por Funcionalidade
| Funcionalidade | Nome do Prompt | Descrição | Parâmetros |
|---|---|---|---|
| Análise de Dados | data-exploration | Guia para explorar dados em datasources Druid | datasource (String, opcional) |
| Análise de Dados | query-optimization | Ajuda a otimizar consultas SQL Druid para melhor desempenho | query (String) |
| Gerenciamento de Cluster | health-check | Orientação abrangente para avaliação de saúde do cluster | Nenhum |
| Gerenciamento de Cluster | cluster-overview | Visão geral e análise do status do cluster | Nenhum |
| Gerenciamento de Ingestão | ingestion-troubleshooting | Solucionar problemas de ingestão | issue (String, opcional) |
| Gerenciamento de Ingestão | ingestion-setup | Guia para configurar novos pipelines de ingestão | dataSource (String, opcional) |
| Gerenciamento de Retenção | retention-management | Gerenciar políticas de retenção de dados | datasource (String, opcional) |
| Compactação | compaction-suggestions | Otimizar configuração de compactação de segmentos | datasource (String, opcional), currentConfig (String, opcional), performanceMetrics (String, opcional) |
| Compactação | compaction-troubleshooting | Solucionar problemas de compactação | issue (String), datasource (String, opcional) |
| Operações | emergency-response | Procedimentos e orientação para resposta a emergências | Nenhum |
| Operações | maintenance-mode | Procedimentos de manutenção do cluster | Nenhum |
Configuração de Variáveis de Ambiente
O aplicativo pode ser configurado usando variáveis de ambiente, que é a abordagem recomendada para ambientes de produção. Abaixo está uma lista abrangente de variáveis de ambiente suportadas, derivadas do arquivo de configuração application.yaml.
Conexão Druid
DRUID_ROUTER_URL: A URL do roteador Druid.DRUID_AUTH_USERNAME: O nome de usuário para autenticação Druid.DRUID_AUTH_PASSWORD: A senha para autenticação Druid.DRUID_SSL_ENABLED: Ativa ou desativa SSL para conexões Druid (true/false).DRUID_SSL_SKIP_VERIFICATION: Ignora a verificação de certificado SSL (true/false).DRUID_MCP_SQL_SYNTAX_CORRECTION_ENABLED: Ativa ou desativa a correção automática de sintaxe SQL (padrão:true). Quando ativado, formata automaticamente consultas, corrige maiúsculas/minúsculas e coloca identificadores entre aspas para Druid.DRUID_MCP_SQL_SYNTAX_CORRECTION_CACHE_TTL_MS: O Time-To-Live (TTL) em milissegundos para os metadados de tabelas e colunas em cache carregados do Druid (padrão:300000/ 5 minutos).
Configuração do Servidor MCP
DRUID_MCP_SECURITY_OAUTH2_ENABLED: Ativa ou desativa a segurança OAuth2 para autenticação de cliente HTTP (true/false).SPRING_PROFILES_ACTIVE: Lista de perfis separados por vírgula para ativar (ex.:query,ops,permissions,healthpara capacidades de ferramentas, ouhttppara habilitar transporte de servidor HTTP em vez do STDIO padrão).SPRING_AI_MCP_SERVER_NAME: O nome do servidor MCP.SPRING_AI_MCP_SERVER_PROTOCOL: O protocolo usado pelo servidor MCP (ex.:streamable).
Configuração Geral do Servidor
SERVER_PORT: A porta em que o servidor escuta.SERVER_SERVLET_SESSION_COOKIE_NAME: O nome do cookie de sessão.SPRING_APPLICATION_NAME: O nome do aplicativo.SPRING_CONFIG_IMPORT: Importa arquivos de configuração adicionais.SPRING_MAIN_BANNER_MODE: O modo para o banner de inicialização (ex.:off).
Registro de Logs
LOGGING_FILE_NAME: O nome do arquivo de log.LOGGING_LEVEL_ORG_SPRINGFRAMEWORK_SECURITY: O nível de log para Spring Security (ex.:DEBUG).
Cluster Druid Criptografado com SSL e Autenticação
Esta seção fornece orientação abrangente sobre como conectar-se a clusters Druid criptografados com SSL, utilizando autenticação por nome de usuário e senha.
Pré-requisitos
- Cluster Druid habilitado para SSL com endpoints HTTPS
- Credenciais válidas de nome de usuário e senha para autenticação no Druid
- Certificados SSL configurados corretamente (ou capacidade de ignorar a verificação para testes)
Métodos de Configuração
Método 1: Variáveis de Ambiente (Recomendado para Produção)
Defina as seguintes variáveis de ambiente antes de iniciar o servidor MCP:
# Druid cluster URL with HTTPS
export DRUID_ROUTER_URL="https://your-druid-cluster.example.com:8888"

# Authentication credentials
export DRUID_AUTH_USERNAME="your-username"
export DRUID_AUTH_PASSWORD="your-password"

# SSL configuration
export DRUID_SSL_ENABLED="true"
export DRUID_SSL_SKIP_VERIFICATION="false"  # Use "true" only for testing

# Start the MCP server
java -jar target/druid-mcp-server-2.0.1.jar
Método 2: Propriedades de Sistema em Tempo de Execução
Passe a configuração como propriedades de sistema JVM:
java -Ddruid.router.url="http://localhost:8888" \
     -Ddruid.auth.username="admin" \
     -Ddruid.auth.password="password" \
     -jar target/druid-mcp-server-2.0.1.jar
Opções de Configuração SSL
Configuração SSL para Produção
Para ambientes de produção com certificados SSL válidos:
export DRUID_ROUTER_URL="https://druid-prod.company.com:8888"
export DRUID_SSL_ENABLED="true"
export DRUID_SSL_SKIP_VERIFICATION="false"
O servidor utilizará o truststore padrão do sistema para validar certificados SSL.
Métodos de Autenticação
O servidor MCP suporta Autenticação Básica HTTP com nome de usuário e senha:
- Nome de usuário: Definido via
DRUID_AUTH_USERNAMEoudruid.auth.username - Senha: Definida via
DRUID_AUTH_PASSWORDoudruid.auth.password
As credenciais são automaticamente codificadas em Base64 e enviadas em cada requisição usando o cabeçalho Authorization: Basic.
Configuração do Cliente MCP com SSL
Atualize seu mcp-servers-config.json para incluir variáveis de ambiente:
{
  "mcpServers": {
    "druid-mcp-server": {
      "command": "docker",
      "args": [
        "run",
        "--rm",
        "-i",
        "-e",
        "DRUID_ROUTER_URL",
        "-e",
        "DRUID_COORDINATOR_URL",
        "-e",
        "DRUID_AUTH_USERNAME",
        "-e",
        "DRUID_AUTH_PASSWORD",
        "-e",
        "DRUID_SSL_ENABLED",
        "-e",
        "DRUID_SSL_SKIP_VERIFICATION",
        "iunera/druid-mcp-server:2.0.1"
      ],
      "env": {
        "DRUID_ROUTER_URL": "http://host.docker.internal:8888",
        "DRUID_COORDINATOR_URL": "http://host.docker.internal:8081",
        "DRUID_AUTH_USERNAME": "",
        "DRUID_AUTH_PASSWORD": "",
        "DRUID_SSL_ENABLED": "false",
        "DRUID_SSL_SKIP_VERIFICATION": "true"
      }
    }
  }
}
Personalização de Prompts MCP
O servidor oferece amplas capacidades de personalização de prompts através do arquivo prompts.properties localizado em src/main/resources/.
Estrutura de Configuração de Prompts
O arquivo prompts.properties contém:
- Configurações Globais: Habilita/desabilita prompts e define marcas d'água
- Alternâncias de Recursos: Controla quais prompts estão disponíveis
- Variáveis Personalizadas: Informações específicas da organização
- Definições de Modelos: Modelos completos de prompts para cada recurso
Substituindo Prompts
Você pode substituir qualquer modelo de prompt usando propriedades de sistema Java com a flag -D:
Método 1: Propriedades de Sistema (Substituição em Tempo de Execução)
java -Dprompts.druid-data-exploration.template="Your custom template here" \
     -jar target/druid-mcp-server-2.0.1.jar
Método 2: Arquivo de Propriedades Personalizado
- Crie um arquivo de propriedades personalizado (ex.:
custom-prompts.properties):
# Custom prompt template
prompts.druid-data-exploration.template=My custom data exploration prompt:\n\
1. Custom step one\n\
2. Custom step two\n\
{datasource_section}\n\
Environment: {environment}
- Carregue-o em tempo de execução:
java -Dspring.config.additional-location=classpath:custom-prompts.properties \
     -jar target/druid-mcp-server-2.0.1.jar
Variáveis de Prompt Disponíveis
Todos os modelos de prompt suportam estas variáveis:
| Variável | Descrição | Exemplo |
|---|---|---|
{environment} | Nome do ambiente atual | production, staging, dev |
{organizationName} | Nome da organização | Your Organization |
{contactInfo} | Informações de contato | your-team@company.com |
{watermark} | Marca d'água gerada | Generated by Druid MCP Server v1.0.0 |
{datasource} | Nome da fonte de dados (específico do contexto) | sales_data |
{query} | Consulta SQL (específica do contexto) | SELECT * FROM sales_data |
Exemplos de Modelos de Prompt
Modelo Personalizado de Exploração de Dados
prompts.druid-data-exploration.template=Welcome to {organizationName} Druid Analysis!\n\n\
Please help me explore our data:\n\
{datasource_section}\n\
Environment: {environment}\n\
Contact: {contactInfo}\n\n\
{watermark}
Modelo Personalizado de Otimização de Consultas
prompts.druid-query-optimization.template=Query Performance Analysis for {organizationName}\n\n\
Query to optimize: {query}\n\n\
Please provide:\n\
1. Performance bottleneck analysis\n\
2. Optimization recommendations\n\
3. Best practices for our {environment} environment\n\n\
{watermark}
Desabilitando Prompts Específicos
Você pode desabilitar prompts individuais definindo sua flag de habilitação como false:
mcp.prompts.data-exploration.enabled=false
mcp.prompts.query-optimization.enabled=false
Ou desabilitar todos os prompts globalmente:
mcp.prompts.enabled=false
Integração MCP
Este servidor utiliza o framework Spring AI MCP Server e suporta transportes STDIO e SSE. As ferramentas, recursos e prompts são automaticamente registrados e expostos através do protocolo MCP.
Modos de Transporte
O Druid MCP Server suporta múltiplos modos de transporte em conformidade com a especificação MCP 2025-06-18:
Transporte HTTP Streamable (Recomendado)
O novo transporte Streamable HTTP proporciona desempenho e escalabilidade aprimorados com suporte a múltiplos clientes concorrentes:
# Default configuration with Streamable HTTP

java -Dspring.profiles.active=http \
     -jar target/druid-mcp-server-2.0.1.jar
# Server available at http://localhost:8080/mcp (configurable endpoint)
Recursos:
- Endpoint Único: Um endpoint HTTP lida com requisições POST e GET
- Múltiplos Clientes: Suporte a conexões concorrentes de clientes
- Streaming SSE Opcional: Server-Sent Events para atualizações em tempo real
- Segurança Aprimorada: Validação de cabeçalho de origem e autenticação
- Compatibilidade Retroativa: Fallback automático para clientes MCP mais antigos
- Keep-alive: Monitoramento configurável da saúde da conexão
Segurança
- Os modos Streamable HTTP e SSE são protegidos com OAuth por padrão. Seu cliente MCP deve obter e enviar um token bearer válido ao conectar.
- Para integração SSO empresarial (OpenID Connect, Azure AD, Keycloak, etc.), envie uma consulta para consulting@iunera.com e veja Contato & Suporte.
Transporte STDIO (Integração via Linha de Comando)
Perfeito para clientes LLM e aplicações desktop:
java -jar target/druid-mcp-server-2.0.1.jar
Transporte SSE Legado (Obsoleto)
Ainda suportado para compatibilidade retroativa. Não é mais o padrão e pode ser removido em uma versão futura.
Nota: O endpoint SSE é protegido com OAuth por padrão. Os clientes devem incluir um token bearer válido ao conectar. Para suporte à integração SSO, veja Contato & Suporte.
Coleta de Métricas
Para aprimorar o produto e entender os padrões de uso, este servidor coleta métricas de uso anônimas. Esses dados ajudam a priorizar novos recursos e melhorias. Você pode optar por não participar da coleta de métricas anônimas definindo druid.mcp.metrics.enabled como false.
🐳 Instalação de Desenvolvimento do Druid
Para desenvolvimento local, testes e aprendizado, uma configuração completa de Docker Compose para executar um cluster Apache Druid completo está disponível em iunera/druid-local-cluster-installer.
Esta configuração é a maneira recomendada de obter um cluster Druid em execução para uso com este servidor MCP.
Recursos Principais:
- Cluster Druid Completo: Inclui todos os serviços principais do Druid (Coordinator, Broker, Historical, MiddleManager, Router).
- Instalação com Um Comando: Scripts automatizados para macOS, Linux e Windows.
- Multiplataforma: Funciona em qualquer lugar onde o Docker esteja disponível.
- Pré-configurado: Padrões sensatos para desenvolvimento local.
- Segurança Básica Habilitada: Usuário administrador pré-configurado (
admin/password). - Pronto para Ypipe: Projetado para funcionar imediatamente com
iunera/ypipe.
Projetos Relacionados
Este Druid MCP Server faz parte de um ecossistema abrangente de ferramentas e extensões Apache Druid desenvolvidas pela iunera. Esses projetos complementares aprimoram diferentes aspectos do gerenciamento de clusters Druid e da ingestão de dados:
🔧 Configuração de Cluster Druid
Gerenciamento avançado de configuração e ferramentas de implantação para clusters Apache Druid. Este projeto fornece:
- Configuração Automatizada de Cluster: Modelos de configuração simplificados para diferentes cenários de implantação
- Gerenciamento de Configuração: Melhores práticas e modelos para clusters Druid de produção
- Automação de Implantação: Ferramentas e scripts para implantações consistentes de clusters
- Configurações Específicas por Ambiente: Configurações otimizadas para ambientes de desenvolvimento, homologação e produção
Integração com o Druid MCP Server: As configurações de cluster fornecidas por este projeto funcionam perfeitamente com as capacidades de monitoramento e gerenciamento do Druid MCP Server, permitindo um gerenciamento abrangente do ciclo de vida do cluster.
📊 Extensão de Ingestão de Código Druid
Uma extensão Apache Druid especializada para ingerir e analisar dados e métricas relacionados a código. Esta extensão permite:
- Ingestão de Métricas de Código: Parsers especializados para dados de análise de código e métricas de software
- Analítica para Desenvolvedores: Ferramentas para analisar qualidade de código, complexidade e padrões de desenvolvimento
- Integração CI/CD: Integração perfeita com pipelines de integração contínua e implantação
- Formatos de Dados Personalizados: Suporte para várias ferramentas e formatos de análise de código
Integração com o Druid MCP Server: Esta extensão expande as capacidades de ingestão que podem ser gerenciadas através das ferramentas de gerenciamento de ingestão do servidor MCP, fornecendo suporte especializado para casos de uso de análise de código.
Por que Usar Estes Juntos?
- Ecossistema Completo: Da configuração do cluster à ingestão e gerenciamento especializado de dados
- Arquitetura Consistente: Todos os projetos seguem princípios de design e padrões de integração semelhantes
- Capacidades Aprimoradas: Cada projeto estende diferentes aspectos do ecossistema Druid
- Pronto para Produção: Configurações e extensões testadas em batalha para implantações empresariais
Roadmap
- Auto Compactação Druid: Configuração inteligente de compactação automática
- Auto Completar MCP: Funcionalidade aprimorada de autocompletar com amostragem usando McpComplete
- Notificações MCP: Notificações em tempo real para operações MCP
- Observabilidade Adequada: Métricas e rastreamento abrangentes
- Monitoramento Aprimorado: Capacidades avançadas de monitoramento e alerta de cluster
- Analítica Avançada: Insights e recomendações com aprendizado de máquina
- Suporte Kubernetes: Implantação adequada no Kubernetes
Sobre a iunera
Este Druid MCP Server é desenvolvido e mantido pela iunera, uma provedora líder de soluções avançadas de IA e análise de dados.
A iunera é especializada em:
- Analítica com IA: Soluções de inteligência artificial de ponta para análise de dados
- Plataformas de Dados Empresariais: Infraestrutura de dados escalável e plataformas de análise (Druid, Flink, Kubernetes, Kafka, Spring)
- Soluções Model Context Protocol (MCP): Implementações avançadas de servidores MCP para vários sistemas de dados
- Desenvolvimento de IA Personalizado: Soluções de IA sob medida para necessidades empresariais
Como veteranos em Apache Druid, a iunera implantou e manteve um grande número de soluções baseadas em Apache Druid em cenários produtivos de nível empresarial.
Precisa de Consultoria Especializada em Apache Druid?
Maximize seu retorno sobre dados com serviços profissionais de implementação e otimização Druid. Da arquitetura ao ajuste de desempenho e integração de IA, nossos especialistas ajudam você a navegar pela complexidade do Druid e desbloquear todo o seu potencial.
Obtenha Consultoria Especializada em Druid →
Precisa de Consultoria em Desenvolvimento de Servidores MCP Empresariais?
INTEGRAÇÃO DE IA EMPRESARIAL E DESENVOLVIMENTO PERSONALIZADO DE SERVIDORES MCP (MODEL CONTEXT PROTOCOL)
A Iunera é especializada no desenvolvimento de agentes de IA de nível de produção e soluções LLM de nível empresarial, ajudando empresas a ir além dos chatbots genéricos de IA. Eles constroem infraestrutura de IA segura, escalável e pronta para o futuro, sustentada pelo Model Context Protocol (MCP), para conectar dados proprietários, sistemas legados e APIs externas a modelos avançados de IA.
Obtenha Consultoria em Desenvolvimento de Servidores MCP Empresariais →
Para mais informações sobre nossos serviços e soluções, visite www.iunera.com.
Contato & Suporte
Precisa de ajuda? Entre em contato:
- Website: https://www.iunera.com
- Serviços Profissionais: Entre em contato conosco por e-mail para consultoria empresarial, suporte e desenvolvimento personalizado Apache Druid
- Código Aberto: Este projeto é open source e contribuições da comunidade são bem-vindas
© 2026 iunera. Licenciado sob a Apache License 2.0.