SEO Audit Console
Auditorias técnicas de SEO no Claude: histórico do Search Console, um crawl próprio e DataForSEO mesclados em uma auditoria priorizada com correções prontas para colar.
Documentação
SEO Audit Console - o servidor MCP de auditoria técnica de SEO para Claude
Uma auditoria técnica de SEO com a qual você pode conversar - construída a partir dos seus próprios dados do Search Console e de um rastreamento ao vivo do seu site, executada dentro do Claude.



Quase toda auditoria técnica de SEO que recebi em vinte anos é a opinião de um rastreador, e um rastreador só vê metade do quadro. Ele diz o que seu site diz. Não tem nada a dizer sobre o que o Google fez a respeito: para quais consultas você rankeia, quais páginas ganham as impressões, onde os cliques chegam.
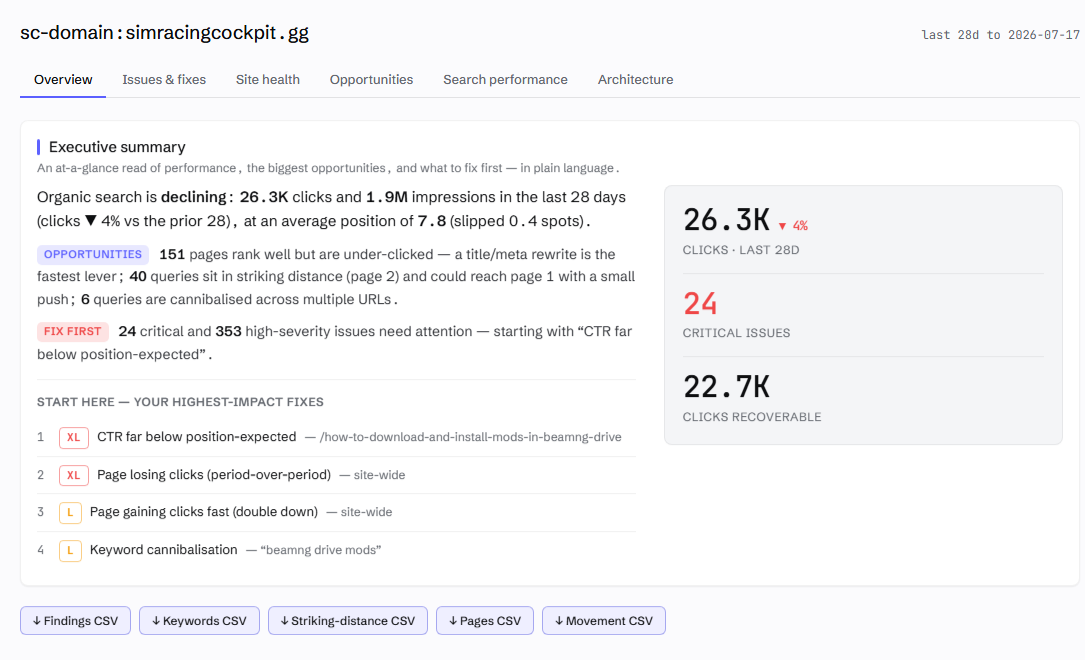
Este traz a outra metade. O SEO Audit Console roda dentro do Claude, puxa seu histórico do Google Search Console, rastreia seu site corretamente e une os dois para que cada descoberta carregue o tráfego em jogo. Noventa e nove verificações, classificadas pelos cliques que a correção poderia recuperar, em vez de quão alarmante a verificação parece, e ele escreve a correção para você: a regra de 301, o JSON-LD, os links internos. A auditoria principal não precisa de nada além do seu próprio Search Console; DataForSEO e Majestic entram depois, quando suas perguntas crescem para concorrentes e construção de links. Seus dados permanecem na sua máquina.
Construído por Houtini. Construímos automação para o trabalho braçal do marketing digital - a coleta de dados, o rastreamento, a mesclagem, a verificação - para que o tempo da sua equipe vá para o pensamento, a estratégia e o trabalho com clientes que precisa de um humano. Este plugin é essa ideia aplicada à auditoria técnica de SEO.
Novo em MCPs, ou não sabe por onde começar? O Guia de introdução leva você de uma máquina completamente nova (sem Node, sem Git, nunca ouviu falar de conta de serviço) até sua primeira auditoria - cada etapa com captura de tela, incluindo a que todo mundo esquece. Dez minutos, honestamente.
you  › run an SEO audit on mysite.com

     ⣾ search console  1.8M rows synced (19s - incremental)
     ⣾ crawl           868 pages · HTTP/2 · robots-polite · 8 parallel
     ⣾ link graph      internal PageRank · click depth · in-degree
     ✓ 99 checks · 220 findings · ranked by expected clicks per dev-hour

     #1  CTR far below position-expected     /pricing                   XL
     #2  Page losing clicks (trend)          site-wide                  XL
     #3  Keyword cannibalisation             "project management app"   L
     #4  Robots-blocked page earning traffic /category/guides           L

you  › generate the fix for #1 ▍
O manual
Este README é a história e o início rápido. Os detalhes vivem no manual:
| Página | O que contém |
|---|---|
| Introdução | Instalação, configuração da conta de serviço do GSC (e a etapa que todo mundo esquece), configuração do Claude Desktop e do Claude Code, sua primeira auditoria, solução de problemas |
| Referência de ferramentas | Cada ferramenta: o que faz, entradas, junções, um exemplo de prompt |
| O registro de verificações | Todas as 99 verificações com o que cada uma captura, seu rótulo D/N e a correção |
| Composição | As chaves de junção, os grãos e treze receitas práticas para fazer suas próprias perguntas nos dados |
| Análise competitiva | Os fluxos de trabalho substitutos do Semrush, configuração do DataForSEO, interseção de links com o nível Trust Flow do Majestic e os custos reais |
| SEO Recon | Por que uma página está perdendo: o veredito de citações da SERP ao vivo + AI Overviews, o diff do concorrente e o registro de tarefas rastreável |
| Funções do DataForSEO | Cada ferramenta baseada em DataForSEO agrupada por módulo de API - Keywords, SERP, Labs, Backlinks, OnPage - cada uma com seu endpoint e custo |
| Funções do Majestic | O nível opcional Trust Flow - o que ele adiciona e como o link_intersect o usa |
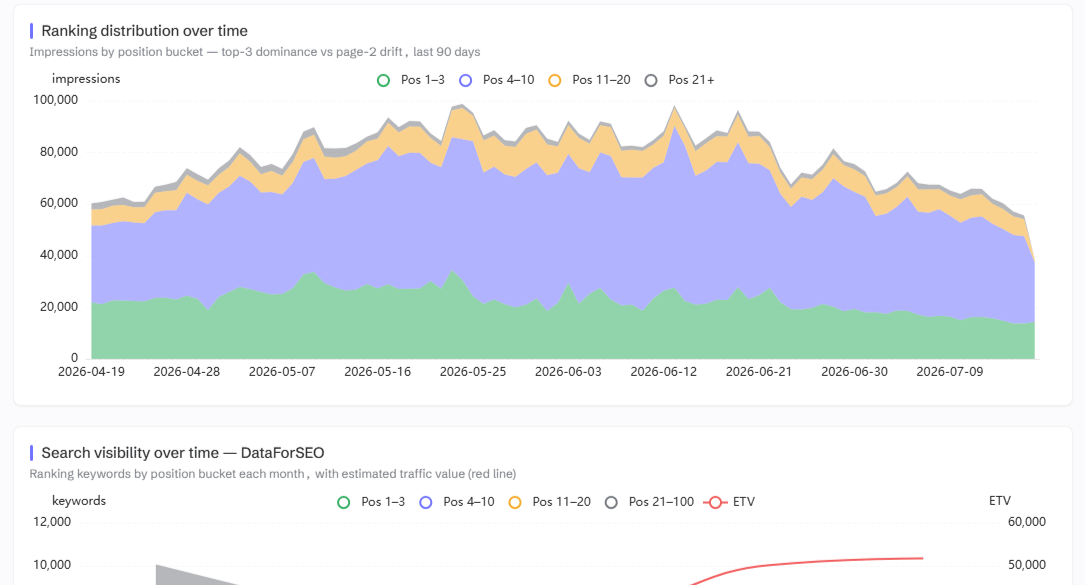
| Painel e relatórios | As oito abas, o hub de relatórios, o que cada gráfico mostra e a exportação compartilhável |
Surpreendentemente, pouco mudou em vinte anos
A auditoria técnica que eu escrevia para clientes em 2006 é, estruturalmente, a auditoria que a maioria das agências ainda vende hoje. Um rastreador roda, um modelo é preenchido, um PDF de 60 páginas chega. Tudo o que um rastreador poderia encontrar, em ordem de gravidade, sem ideia de quais descobertas valem dinheiro e quais são cosméticas.
O que mudou é o que é possível. O Google dá a cada proprietário de site um registro completo de sua realidade de busca - quais consultas, quais páginas, quantas impressões, onde você rankeou. Seu rastreamento diz o que seu site diz. O Search Console diz o que o Google fez a respeito. E, na minha experiência, a lacuna entre esses dois conjuntos de dados é onde quase todo o tráfego recuperável se esconde.
Então foi isso que construí. O SEO Audit Console é um servidor Model Context Protocol que mescla seu histórico do Search Console com um rastreamento de primeira parte do seu site (e, quando você quiser, DataForSEO) em uma coisa só: uma auditoria priorizada e baseada em evidências que você pode interrogar dentro do Claude Desktop. Ele entrega correções prontas para colar. Cada descoberta remonta a um ponto de dados real.
Uma ideia por baixo de tudo:
Seu rastreamento é intenção. O Search Console é realidade. O dinheiro está onde eles divergem.
Um rastreador simples diz que uma página retorna 404. Útil, mas só isso. Este diz que o 404 está drenando 15% do PageRank interno da sua página inicial, que a página costumava ganhar 10.000 cliques por mês, e escreve a regra de 301 para corrigir. Ele encontra a página na posição #3 com 150.000 impressões e uma taxa de cliques de 0,2% - uma reescrita de título provavelmente vale milhares de cliques - e a classifica acima das descobertas cosméticas. Gravidade é o que os rastreadores vendem. Rendimento é o que move os números.
Para quem é isso?
Para o consultor de SEO que quer a coleta e a verificação automatizadas para que o tempo de pensamento sobreviva. Para o profissional de marketing interno que recebeu um orçamento de quatro dígitos por uma auditoria genérica. E para qualquer pessoa mais nova nisso que queira aprender o que uma boa auditoria examina - porque cada descoberta mostra sua evidência, a ferramenta também serve como professora.
Uma nota sobre onde executar. O Claude Desktop é o início fácil, mas na minha visão o Claude Code é o melhor lar para esta ferramenta - porque fecha o ciclo. Em um cliente de chat, a auditoria entrega uma regra de 301 para você colar em algum lugar. No Claude Code, a mesma sessão tem o repositório do seu site, um terminal e o git: a auditoria encontra o problema, escreve a correção, aplica ao código, faz o commit e re-rastreia para verificar. Da descoberta à correção implantada, em uma conversa.
Você não precisa aprender uma interface. Você digita "execute uma auditoria de SEO em meusite.com" no Claude e isso acontece. Esqueceu o que é possível? Pergunte "execute seo_audit_help" e você recebe o menu completo com prompts de exemplo.
A abordagem funciona?
Sim. A mesclagem de rastreamento mais GSC não é uma novidade; é o método. Em uma propriedade, semear o rastreamento a partir das URLs do Search Console levou a cobertura de páginas conhecidas pelo GSC de 29% para 70% - cada uma dessas páginas extras é uma página que um rastreamento convencional silenciosamente perdeu, e várias estavam ganhando tráfego sem nenhum link interno apontando para elas. Na mesma propriedade, a sincronização incremental transformou uma atualização de dados de 33 minutos em 19 segundos, o que é a diferença entre "auditar trimestralmente" e "auditar sempre que tiver curiosidade".
O que a auditoria verifica
O run_audit executa 99 verificações sobre os dados unidos e retorna uma lista classificada - não uma parede de tudo, mas uma ordem de prioridade com o tráfego em jogo anexado a cada descoberta. As famílias, resumidamente:
| Família | O que captura |
|---|---|
| Rastreabilidade e indexação | Links quebrados, cadeias de redirecionamento, órfãos, inchaço de índice, armadilhas de spider, páginas bloqueadas por robots ainda ganhando tráfego e o motivo pelo qual cada URL não é indexável |
| On-page e dados estruturados | Títulos, metas, H1s, texto alternativo - além de um validador local cobrindo ~30 tipos de rich results, apenas campos obrigatórios, para nunca reclamar de propriedades que o Google ignora |
| Tendências (GSC ao longo do tempo) | Páginas perdendo cliques, rankings caindo, consultas desaparecidas, páginas em ascensão que valem a pena dobrar a aposta, conteúdo obsoleto decaindo ano após ano |
| As perguntas mescladas | Canibalização, distância de destaque, páginas fantasmas, tráfego para URLs mortas, autoridade interna desperdiçada em páginas sem cliques, títulos sem a consulta pela qual você já rankeia |
| Prontidão para busca com IA | Frases pelas quais você rankeia mas nunca diz, consultas que seu conteúdo nunca responde em uma única passagem, conteúdo que não se divide limpo para recuperação |
Cada verificação é rotulada como D (determinística - aqui estão os bytes) ou N (julgamento - desativada por padrão, peça "as descobertas de julgamento" para vê-las). Na minha visão, uma descoberta errada é pior do que nenhuma descoberta, então as verificações heurísticas precisam pedir permissão. O registro completo, verificação por verificação, está em o manual.
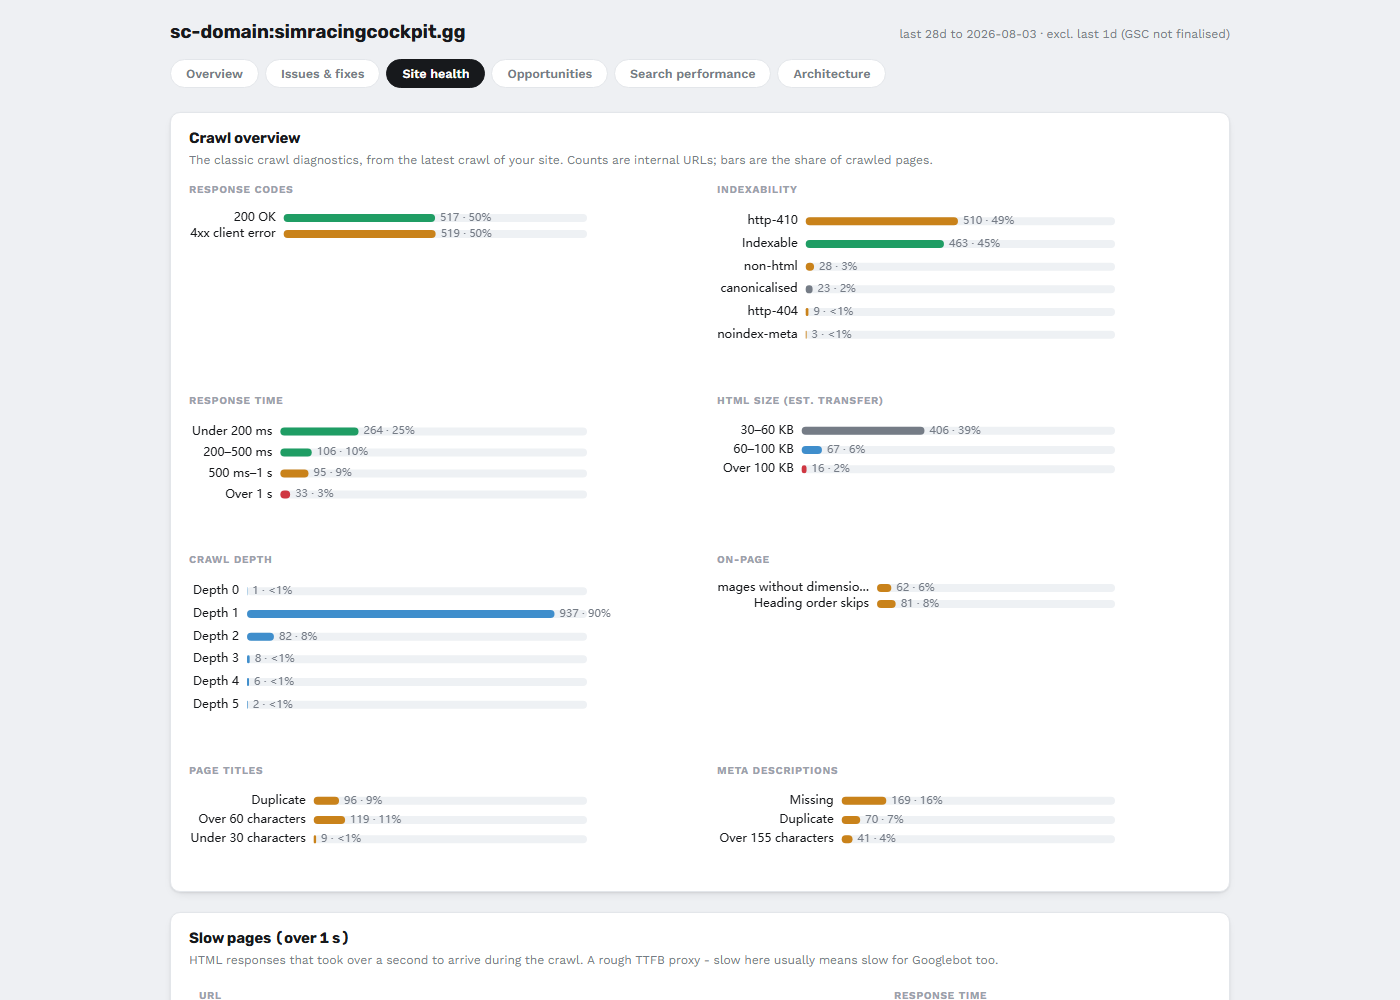
E se você cresceu com Screaming Frog ou Sitebulb, a aba Site health do painel vai parecer familiar - códigos de resposta, motivos de indexabilidade, profundidade de rastreamento, as imagens mais pesadas, erros de servidor e páginas lentas, tudo como barras de estatísticas limpas. Mesmos diagnósticos, exceto que cada um está ao lado dos números do Search Console para a mesma URL. O tour aba por aba está em dashboard.md.
O rastreamento, explicado corretamente
O rastreamento é onde as auditorias geralmente dão errado, então vale a pena entender o que este faz de diferente. Passei boa parte da minha carreira limpando a bagunça de rastreadores que se enganavam. Este é um rastreador de SEO de verdade - só que tem seu histórico do Search Console ao lado.
Ele descobre páginas de três maneiras. Seguindo links, lendo seus sitemaps XML e - a importante - começando de cada URL para a qual o Google já está enviando tráfego, direto dos seus dados do GSC. A cobertura deixa de depender do seu sitemap ser honesto. É também exatamente assim que páginas fantasmas são pegas: se o Google rankeia uma URL que a estrutura do seu próprio site não alcança, essa URL ainda é rastreada, e a incompatibilidade vira uma descoberta.
Ele registra o porquê, não apenas o o quê. Para cada URL que não é indexável, ele armazena o motivo - 404, noindex, cabeçalho X-Robots, canonicalizada em outro lugar, bloqueada por robots, não-HTML. "Esta página não vai rankear" é um fato; "esta página não vai rankear porque um plugin definiu um cabeçalho X-Robots que ninguém lembra" é uma correção.
Ele se recusa a ser enganado. Um redirecionamento que sai do seu site (fluxos OAuth do Shopify, estou olhando para vocês) é registrado como redirecionamento de saída, nunca armazenado como página. Ele sempre usa GET em vez de HEAD, porque uma solicitação HEAD pode retornar um status diferente da solicitação real - mas abandona o corpo para imagens, PDFs e ativos, então registra status e tamanho sem baixar os bytes.
É rápido sem ser rude. HTTP/2 onde sua origem suporta, gzip e brotli negociados, conexões keep-alive reutilizadas. A velocidade vem da eficiência, não de martelar seu servidor. Ele respeita robots.txt corretamente (um grupo específico de bot substitui o *, conforme a especificação, o que muitos rastreadores comerciais erram), recua quando seu host limita a taxa e pula o lixo: busca interna, combinações de filtros facetados, fluxos de login. Este é um rastreador para sites que você possui. Ser um bom visitante é o ponto.
Após o rastreamento, ele calcula um grafo de links real: PageRank interno com links de navegação e rodapé com peso reduzido, profundidade de clique a partir da página inicial contando apenas links de corpo, grau de entrada por página. Esse grafo alimenta as verificações de órfãos, vazamento de autoridade e páginas com poucos links - e os rankings de doadores quando a ferramenta sugere links internos.
Os fluxos de trabalho, resumidamente
Cada um destes é um procedimento real que uso, e cada um é um único prompt. As versões expandidas, com o que acontece por baixo, vivem nas páginas do manual vinculadas.
- Sua primeira auditoria. "Atualize sc-domain:mysite.com", depois "Execute uma auditoria de SEO em mysite.com". Vinte minutos em um site de médio porte, e as cinco principais descobertas geralmente valem mais do que as outras oitenta e cinco combinadas. Em seguida, "gere a correção para o item #1". → getting-started.md
- Otimização de palavras-chave em todo o site. A pergunta não é "quais palavras-chave devo segmentar?" - é "onde meu conteúdo falha em dizer o que eu já rankeio?" "Pontue os trechos em mysite.com" executa um pequeno modelo local de relevância em cada página ranqueada; "rascunhe o conteúdo ausente para /page" escreve a correção na voz do seu próprio site, fundamentada para não inventar nada. → tools.md
- Canibalização. "Mostre-me as descobertas de canibalização com evidências" - limites ajustados para que sobreposição incidental de cauda longa não conte, então a decisão de consolidar ou diferenciar é tomada com base em números. → checks.md
- O plano de conteúdo. "Sugira novas páginas para mysite.com" explora a demanda que o Google já mostra; "quais tópicos mysite.com deve cobrir?" mapeia a demanda que ele não mostra. Juntos: um plano trimestral. → competitive.md
- A jogada dos templates. "Liste os templates de página" - sites grandes não são 50.000 páginas, são uma dúzia de templates repetidos, e uma correção de template corrige o cluster inteiro. → tools.md
- Monitoramento e migrações. "Detecte mudanças em mysite.com" compara seus dois rastreamentos mais recentes por gravidade. Durante uma migração, isso é a diferença entre pegar um noindex perdido na terça-feira e explicar um gráfico de tráfego em uma reunião de diretoria três semanas depois. Já estive no lado errado dessa história. → tools.md
- Prontidão para busca com IA. "Verifique a prontidão para agentes em mysite.com" - a web está silenciosamente ganhando um segundo público, e quase nenhuma ferramenta de SEO verifica isso. → tools.md
- Suas próprias perguntas. Os quatro conjuntos de dados compartilham três chaves de junção, e as análises mais valiosas são aquelas que você mesmo compõe - "quais páginas perderam cliques após serem citadas em AI Overviews?" é um prompt aqui e um recurso em nenhum outro lugar. → composition.md
- Relatórios. "Mostre-me o dashboard" no chat, "sirva o dashboard" para a versão ao vivo no seu navegador, ou "exporte o relatório" como um único arquivo HTML autônomo que você pode enviar a um cliente. → dashboard.md
- O relatório de oportunidades de conteúdo. Se você escreve para viver, esta é sua página um: "Oportunidades de conteúdo para mysite.com" retorna o que ESCREVER em seguida (demanda que você já ganha impressões sem página vencedora), o que ATUALIZAR (páginas perdendo cliques), quais SNIPPETS reescrever (ranqueando bem, com poucos cliques), e quais clusters FORTALECER (posição 4-20, a um passo do dinheiro). Cada linha remonta aos seus próprios dados do Search Console - sem ideias de palavras-chave inventadas - e "rascunhe o briefing para a linha 1" transforma qualquer uma delas em um esboço fundamentado. → competitive.md
- Dimensionamento de mercado e priorização. "Dimensione o mercado: mysite.com vs rival1.com e rival2.com" - o universo de palavras-chave, a demanda mensal total e a participação de voz por cluster de tópico, a partir de uma chamada em cache por domínio. A leitura de abertura de engajamento que antes exigia uma assinatura do Semrush. → competitive.md
- Reconhecimento de conteúdo - por que esta página está perdendo? "Execute reconhecimento de conteúdo em mysite.com" pega suas piores páginas em declínio, puxa o SERP ao vivo do Google para cada uma e lê se o AI Overview cita você. O veredito é a parte honesta: ranqueada mas não citada é um problema de precisão de dados ou frescor, não uma reescrita. Ele transcreve os vídeos ranqueados (Supadata), lê os concorrentes acessíveis (Firecrawl, além de uma busca gratuita por perfil de navegador que até pega o Reddit), e escreve as lacunas em um quadro de tarefas rastreável que você pode anotar e medir novamente. → recon.md
- Prospecção de links, ordenada por autoridade real. "Interseção de links para mysite.com vs rival1.com, rival2.com" retorna os domínios que linkam para seus rivais e não para você - a lista de divulgação, com seguidos primeiro e filtrada por spam. Adicione uma chave Majestic e ela reordena por Trust Flow e mostra o Topical Trust Flow de cada prospecto, então os diretórios caem fora e o que resta é autoridade no seu tópico. → Majestic, abaixo
O que o DataForSEO adiciona (e o que custa)
Tudo acima funciona apenas com seus dados do Search Console. Mas o GSC só pode descrever buscas onde você já aparece. No momento em que sua pergunta é "qual é o tamanho deste mercado?" ou "o que os concorrentes rankeiam que eu não rankeio?", você precisa de dados de terceiros - e é aí que entra o DataForSEO: uma API pré-paga para volumes, rankings ao vivo, dados de concorrentes e execuções de Lighthouse. Sem assinatura; chamadas custam frações de centavo a alguns centavos, em cache por 7 dias, e só são executadas quando você pede. Meu próprio uso chega a alguns dólares por mês.
Isso desbloqueia a camada substituta do Semrush: a visão geral de visibilidade orgânica para qualquer domínio, as principais páginas e palavras-chave ranqueadas de qualquer site (incluindo quais palavras-chave citam um site em AI Overviews), a lacuna de conteúdo, lacunas de tópicos, intenção de busca, Core Web Vitals de laboratório e backlinks. Também alimenta o reconhecimento de conteúdo - recon_targets puxa o SERP ao vivo do Google para uma página perdedora, lê se o AI Overview cita você e diz por que você está atrás. Os fluxos de trabalho completos e a configuração: competitive.md.
Mais duas chaves opcionais, apenas para reconhecimento de conteúdo. Quando você pede ao reconhecimento para buscar os concorrentes que ele encontra, ele roteia cada um por fonte: vídeos para Supadata (SUPADATA_API_KEY) para transcrições, e páginas de concorrentes para Firecrawl (FIRECRAWL_API_KEY) para markdown limpo, com uma busca gratuita por perfil de navegador por trás. Ambos são pré-pagos e totalmente opcionais - o reconhecimento ainda classifica a página e lista os concorrentes sem eles. Pegue uma chave do Firecrawl aqui: https://firecrawl.link/2d1PLD8.
Mais uma coisa que o DataForSEO desbloqueia ganha uma seção própria, porque o trabalho de links tem um segundo serviço opcional por trás.
Interseção de links e o nível Majestic Trust Flow
Link building é a única disciplina onde a lista de prospectos é a estratégia, então link_intersect a constrói a partir de evidências, não de um palpite. Uma chamada domain_intersection do DataForSEO sobre seu conjunto de concorrentes - excluindo o seu - retorna todos os domínios que linkam para eles e não para você, agregados por prospecto: para quantos de seus rivais ele linka, se o link é seguido, sua pior pontuação de spam, a mistura de âncoras. Aponte para uma única empresa em vez de um conjunto e ele responde o outro clássico: quais links a empresa X tem que nós não temos?
Isso te dá uma lista. Não te dá uma ordem de prioridade, e é aqui que a prospecção de links sempre deu errado. O DataForSEO ordena por rank de domínio, que é uma métrica de volume de links, então diretórios, agregadores e domínios de imprensa sindicalizada flutuam direto para o topo - tecnicamente autoritativos, inúteis para abordar. Todo link builder que conheço já perdeu uma semana com essa lista.
Defina MAJESTIC_API_KEY e a ordem muda para uma que você pode defender. O Majestic rastreia e pontua o grafo de links da web desde antes de a maioria das ferramentas de SEO de hoje existir, e suas duas métricas principais são exatamente as que corrigem isso:
- Trust Flow (0-100) - autoridade editorial, propagada de um conjunto inicial de sites confiáveis. Mede quem atesta um domínio, em vez de quantos links ele conseguiu acumular. Esse é o matador de diretórios: em testes, um domínio que o DataForSEO classificou como 227 voltou com Trust Flow 0. Uma métrica de volume simplesmente não consegue ver isso.
- Topical Trust Flow - sobre o que essa autoridade é, como tópicos ranqueados. Um Trust Flow 45 é um link brilhante quando seu tópico principal é
Recreation/Autose você vende peças de carro, e um pitch desperdiçado quando éHealth/Nutrition. É a diferença entre um link forte e um relevante, e é a coluna que faz uma lista de divulgação sobreviver ao contato com um cliente.
Com a chave definida, cada prospecto qualificado é enriquecido, a tabela ganha uma coluna de Trust Flow e o tópico principal de cada domínio, e a lista inteira é reordenada por Trust Flow:
you  › link intersect for mysite.com vs rival1.com, rival2.com

     Prospect domain     Links to  Trust Flow  Link    Spam  Backlinks  Top topic
     enthusiast-mag.com  2/2       54          follow  2     31         Recreation/Autos
     club-forum.org      2/2       41          follow  0     12         Recreation/Autos
     free-link-list.net  2/2       0           follow  28    904        –
(Formato da saída, nomes inventados.) Mesmos três prospectos, mesmos dados do DataForSEO por baixo - e note qual deles tem mais backlinks. Ordenado do jeito do DataForSEO, o diretório seria o primeiro que você teria enviado um e-mail.
link_intersect precisa da assinatura de Backlinks do DataForSEO, que é separada das APIs de SERP/Palavras-chave/Labs; se não estiver ativada, a ferramenta diz isso em inglês simples, em vez de jogar um código em você.
O nível é cuidadoso com seu saldo: o enriquecimento é agrupado em 100 domínios por chamada (cerca de uma unidade cada), limitado por enrichLimit (padrão 100 - e quando mais prospectos se qualificam do que são enriquecidos, a resposta diz isso e manda você aumentar, em vez de entregar uma lista meio pontuada), as solicitações são serializadas, e cada resposta é armazenada em cache por 30 dias via MAJESTIC_CACHE_DAYS. Pergunte a mesma coisa duas vezes em quinze dias e a segunda resposta não custa nada.
Opcional, e quero dizer opcional: sem chave, link_intersect ainda roda e ainda ordena seguidos primeiro por confiança de domínio. O Majestic é o que transforma "aqui estão 100 domínios" em "aqui estão os 20 que valem um e-mail, e aqui está o porquê". Pegue uma chave na página de planos e preços deles; o fluxo de trabalho completo está em competitive.md.
Trust Flow e Topical Trust Flow são marcas registradas do Majestic (Majestic-12 Ltd). Este nível chama a API do Majestic com sua própria chave, apenas quando você executa
link_intersect, e nada mais na ferramenta toca nela.
Instalação, em resumo
Três passos - o passo a passo completo com as pegadinhas está em getting-started.md:
- Obtenha: o caminho rápido é npx - aponte sua configuração MCP para
npx -y @houtini/seo-audit-consolee não há nada para compilar. Ou clone este repositório,npm install,npm run buildse quiser o código-fonte. De qualquer forma, Node ≥ 20. - Conecte o Search Console: crie uma conta de serviço do Google Cloud, baixe a chave JSON dela e - o passo que todo mundo esquece - adicione o e-mail da conta de serviço como usuário na sua propriedade no Search Console. Prefere um passo a passo com imagens? Configurando do zero cobre todo o fluxo.
- Aponte seu cliente MCP para
dist/index.jscomGOOGLE_APPLICATION_CREDENTIALSdefinido. Funciona no Claude Desktop e no Claude Code; apenas essa variável de ambiente é obrigatória.
Toda variável de ambiente que o servidor lê, em um bloco - a primeira é obrigatória e tudo abaixo dela é opcional, então apague as linhas dos serviços que você não usa:
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "node",
      "args": ["C:/path/to/seo-audit-console/dist/index.js"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "SAC_DATA_DIR": "C:/path/to/where/audits/are/stored",
        "DATAFORSEO_USERNAME": "you@example.com",
        "DATAFORSEO_PASSWORD": "your-dataforseo-password",
        "DATAFORSEO_CACHE_DAYS": "7",
        "MAJESTIC_API_KEY": "your-majestic-api-key",
        "MAJESTIC_CACHE_DAYS": "30",
        "FIRECRAWL_API_KEY": "your-firecrawl-key",
        "SUPADATA_API_KEY": "your-supadata-key"
      }
    }
  }
}
GOOGLE_APPLICATION_CREDENTIALS te dá toda a auditoria principal. O DataForSEO adiciona a camada de mercado, MAJESTIC_API_KEY adiciona a reordenação por Trust Flow ao link_intersect, e Firecrawl e Supadata são os buscadores do reconhecimento de conteúdo. Linha por linha, incluindo as duas avançadas que você provavelmente nunca vai precisar: getting-started.md.
Depois: "liste propriedades" para verificar se está conectado, "atualize", "execute uma auditoria de SEO".
As ferramentas, de relance
A versão de uma linha - descrições completas, entradas e exemplos de prompts para cada ferramenta estão em a referência de ferramentas.
| Ferramenta | O que faz |
|---|---|
refresh_property | Sincroniza GSC + rastreamento + inspeção + histórico de rankings, em um único job |
sync_gsc · start_crawl · inspect_urls · track_ranks | Executa uma parte isolada por vez |
check_sync_status · check_crawl_status | Acompanha o progresso de um job longo |
run_audit · query_audit · list_checks | A auditoria pontuada · uma verificação com evidências · o catálogo |
query_data | Consultas somente leitura sobre as tabelas brutas — agregações no banco, respostas, não linhas |
fix_finding | Correções prontas para colar (JSON-LD / 301 / links internos) |
detect_changes | O que mudou entre os dois rastreamentos mais recentes |
check_agent_readiness | Pontuação de prontidão para agentes de IA de 0 a 100, com correções de copiar e colar |
list_templates · suggest_pages | Clusters de templates · ideias de novas páginas a partir de demanda real |
score_passages · draft_content | Pontuação de relevância local · briefings de escrita fundamentados |
resolve_entities | Entidades do Wikidata e as lacunas de links entre elas |
keyword_volume · related_terms · search_intent | Dados de palavras-chave do DataForSEO |
youtube_discovery · news_discovery · topic_trend | Pesquisa de conteúdo: os vídeos ranqueando para um tópico (combine com uma ferramenta de transcrição) · cobertura recente de notícias / atualidade · interesse do Google Trends ao longo do tempo (em alta / em queda / sazonal) |
competitors_domain · page_intersection · topic_gaps | Concorrentes · lacuna de conteúdo · lacunas de tópicos |
domain_visibility · top_pages · ranked_keywords | As visões estilo Semrush, para qualquer domínio (+ aioOnly para citações do AI Overview) |
page_lighthouse · pull_backlinks | CWV de laboratório · perfil de backlinks com status ao vivo |
link_intersect | Os links que seus concorrentes têm e você não — uma lista de divulgação priorizada (primeiro os seguidos, ordenados por confiança de domínio; a reordenação opcional por Trust Flow do Majestic elimina o ruído de diretórios) |
market_sizing · serp_features | Participação de voz vs. concorrentes nomeados · exposição em AI-Overview / snippet / vídeo por volume |
keyword_list · content_opportunities | Agrupa uma lista de palavras-chave (próprias / fracas / ausentes) · o relatório do profissional de marketing de conteúdo |
recon_targets · save_recon_todo · recon_todos | Reconhecimento de conteúdo: por que uma página está perdendo (SERP ao vivo + AI Overview) → um quadro de tarefas rastreável e anotável |
get_dashboard · serve_dashboard · export_report | Painel no chat · o mesmo em uma aba do navegador local · HTML compartilhável |
composition_cookbook | O mapa da superfície de dados e receitas para análises personalizadas |
data_storage | Uso de disco por propriedade e contagens de linhas, com poda confirmada |
normalize_url · data_location · list_properties · seo_audit_help | Utilitários e o menu de ajuda |
Como funciona por baixo dos panos
- A chave de junção (
url_key). Opagedo GSC e ourldo rastreamento ambos normalizam para a mesma chave — forçam HTTPS, unificam www e apex, removem parâmetros de rastreamento, e assim por diante. Tudo se junta nessa chave. É todo o truque, na verdade. - Um banco de dados SQLite por propriedade (WAL, declarações preparadas). Seus dados permanecem na sua máquina.
- Pontuado uma vez, ordenado por rendimento.
(expected clicks × yield × certainty) / effort. Com índices de cobertura, a auditoria continua rápida mesmo quando a tabela do GSC chega a milhões de linhas. - Cuidado com seu histórico. Rastreamentos e sincronizações nunca destroem o snapshot anterior até que novos dados comecem a chegar — uma queda do site no meio do rastreamento não custa seus dados.
- Somente sites próprios, correções em modo simulação. Ele rastreia sites que você controla, e os geradores retornam artefatos. Eles nunca escrevem no seu site. Essa é uma linha que não vou cruzar.
Privacidade e dados
Seus dados do Search Console e o rastreamento vivem em arquivos SQLite locais em SAC_DATA_DIR. O modelo de pontuação de passagens também roda localmente. Nada sai da sua máquina, exceto as chamadas de API que você aciona — Google (seu próprio GSC) e, se você os configurou, DataForSEO, Majestic (link_intersect envia nomes de domínios prospectados, nada mais), e Firecrawl/Supadata (o reconhecimento de conteúdo envia as URLs de concorrentes que encontrou). Cada uma delas é chaveada por você, chamada sob demanda e armazenada em cache localmente para não ser chamada duas vezes. Sem telemetria. Nenhuma.
O que está por vir
Algumas coisas que estou construindo em seguida, em ordem aproximada:
- Oportunidades de dados estruturados, por template. Não "você não tem schema" (a maioria das lojas modernas tem bastante), mas "este template poderia ganhar estrelas de avaliação ou um rich result de FAQ e não ganha."
- Um scorecard de conteúdo por página. Uma tabela dedicada de todas as frases de ranking que seu conteúdo perde, não apenas a consulta principal.
- Mais prontidão para agentes. Um advisory WebMCP (quais ações de ferramentas seu site poderia expor a agentes) e os protocolos de comércio para agentes.
- Um relatório imprimível. Um documento A4 adequado que você pode entregar a um cliente, não um deck de slides.
- Verificações de parser no nível da fonte. A especificação da auditoria está escrita — ~94 verificações cobrindo a camada que a maioria das ferramentas nunca toca: elementos que quebram silenciosamente o parsing de
<head>, diretivas içadas para o corpo e ignoradas, divergência entre bruto e renderizado.
Tem um caso extremo estranho que você gostaria que uma ferramenta pegasse? Me conte — foi exatamente assim que as verificações mescladas GSC×rastreamento foram construídas.
Sobre a Houtini
A Houtini existe por um único motivo: as horas que sua equipe perde com trabalho braçal. Baixar exportações do Search Console, rodar rastreamentos, cruzar planilhas, verificar novamente o que mudou desde o mês passado — nada disso precisa de uma pessoa, e tudo isso consome o tempo que sua equipe deveria gastar em estratégia, em clientes, no trabalho que move números. Então automatizamos exatamente essa camada. O SEO Audit Console é uma de uma família de ferramentas construídas sobre o mesmo princípio — se uma máquina pode coletar, mesclar e verificar, uma máquina deve.
Perguntas, licenciamento ou algo que você gostaria de automatizar: hello@houtini.com
Créditos
O SEO Audit Console se apoia em alguns serviços de terceiros — todos opcionais, exceto seu próprio acesso ao Search Console, e cada um chamado apenas com uma chave que você fornece:
- Google Search Console — seu próprio histórico de desempenho de pesquisa (a única credencial obrigatória).
- DataForSEO — dados de SERP, palavras-chave, Labs e backlinks: volumes de palavras-chave, pegadas de concorrentes, histórico de rankings e a interseção de domínios
link_intersect. Pague conforme o uso, opcional. - Majestic — Trust Flow e Topical Trust Flow para o nível de enriquecimento
link_intersect, que reordena prospects de links por autoridade editorial real. Trust Flow e Topical Trust Flow são marcas registradas da Majestic (Majestic-12 Ltd). Opcional; obtenha uma chave na página de planos. - Firecrawl e Supadata — busca de páginas de concorrentes e vídeos ranqueados para reconhecimento de conteúdo. Opcionais.
Construído com better-sqlite3, cheerio, Apache ECharts e um cross-encoder ms-marco local (via Transformers.js) para pontuação de passagens no dispositivo — nenhum dado sai da sua máquina para isso.
Contribuindo
Issues e PRs são bem-vindos. O registro de verificações (src/audit/checks.ts) é feito para ser estendido — cada verificação é uma leitura pura sobre os dados unidos que retorna descobertas com evidências, então adicionar uma é bastante autocontido. Há um teste de fumaça de ponta a ponta (npm run smoke) e sondas por recurso (npm run probe:*) para manter você honesto. Ao enviar um PR, você concorda que sua contribuição é licenciada sob a LICENÇA do projeto (Apache-2.0).
Licença
Apache License 2.0. Livre para usar, modificar e redistribuir, inclusive comercialmente — termos completos em LICENSE.