token-save-mcp
Mantém arquivos grandes fora do contexto do seu agente de codificação. Delega leituras grandes para um modelo de trabalho barato de sua escolha e retorna apenas a resposta — além de um hook que bloqueia leituras excessivamente grandes, para que a economia não dependa da memória do agente. Medido entre 72-99% de economia, com base nos números de uso do próprio provedor.
Documentação
token-save-mcp
Seu agente de codificação gasta o contexto lendo arquivos. Isso interrompe esse ciclo — e mostra o comprovante.


Ler um arquivo de 4.000 linhas coloca cerca de 35.000 tokens no contexto do seu agente pelo resto da sessão. Leia mais alguns e ele compacta, esquece suas instruções, e cada etapa posterior custa mais — porque cada uma paga novamente por todo o contexto acumulado.
Este servidor MCP envia esses arquivos para um modelo de trabalho barato e retorna apenas a resposta. Os bytes são pagos uma vez, no contexto do trabalhador, não permanentemente no seu.
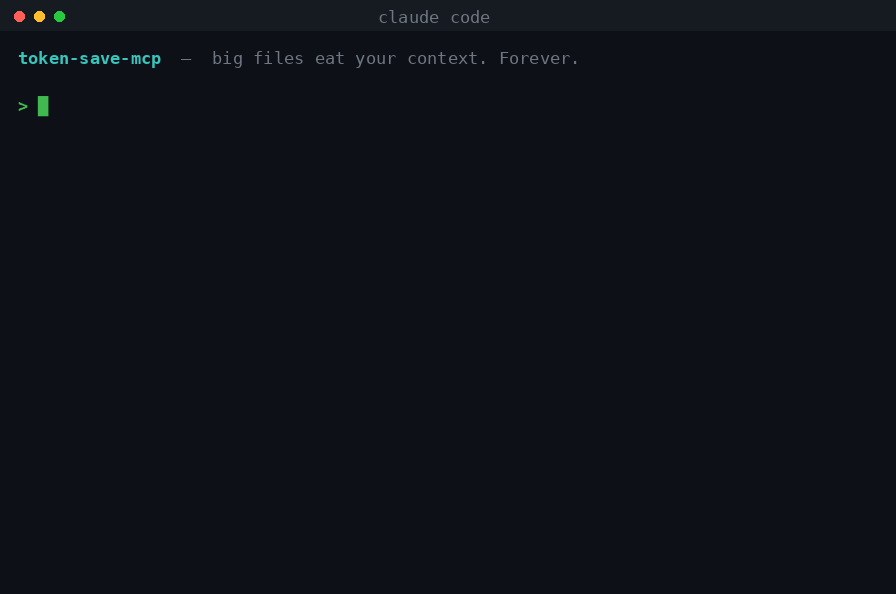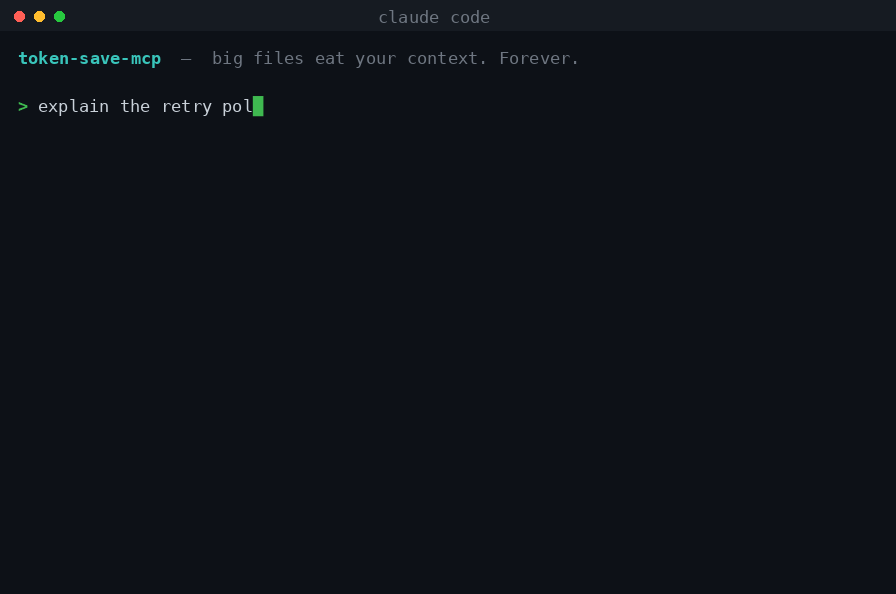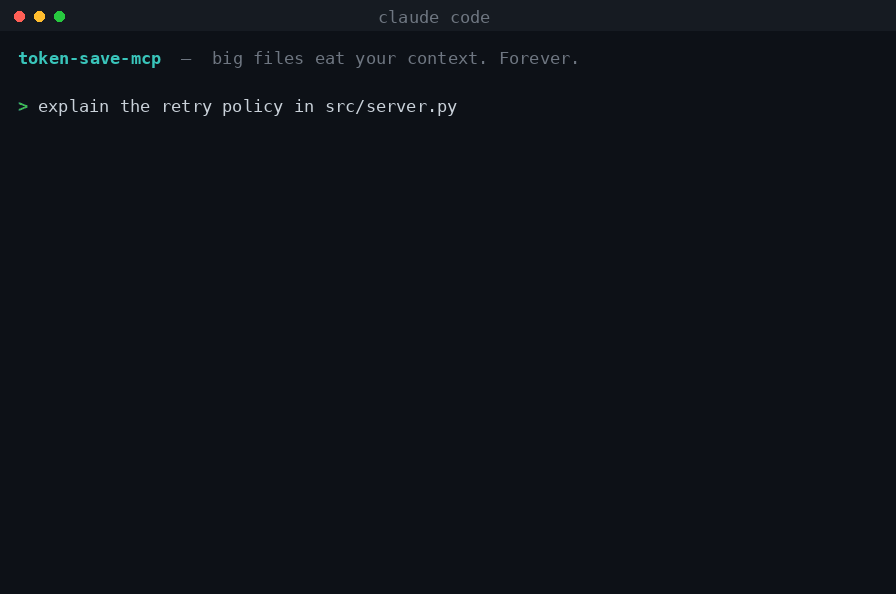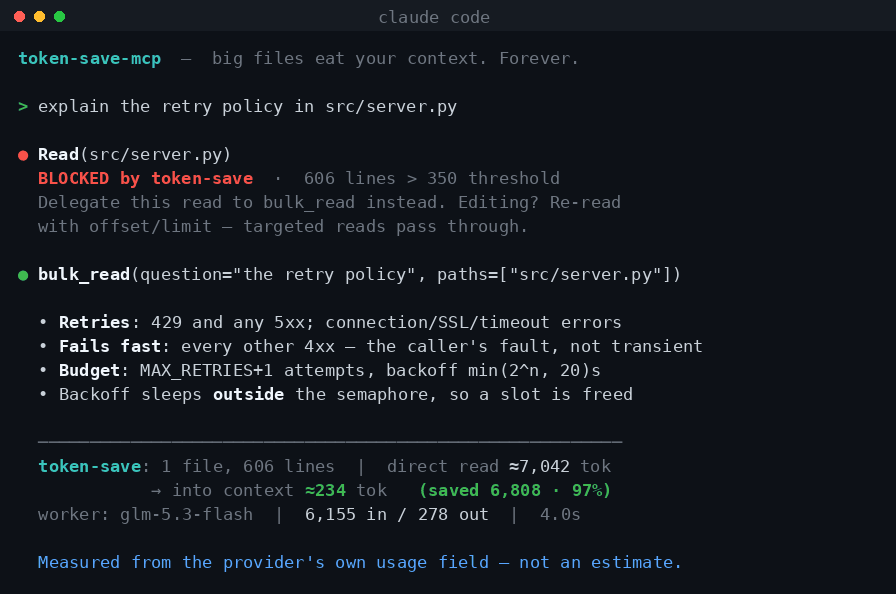
O hook bloqueia a leitura cara e a redireciona. A resposta volta com o uso real de tokens do trabalhador a partir da resposta da API — não uma estimativa, um comprovante:
─────────────────────────────────────────────────────────────
token-save: 1 file, 606 lines | direct read ≈7,042 tok →
into context ≈234 tok (saved 6,808 · 97%)
worker: glm-5.3-flash | 6,155 in / 278 out | 4.0s
(glm-5.3-flash é apenas o trabalhador configurado naquela execução — você escolhe o seu.)
Instalação
Dois comandos, mais uma chave de API sua.
pip install token-save-mcp
token-save-mcp init --hook
init encontra uma chave de provedor que você já tem, registra o servidor MCP no seu
agente e instala o hook. Se você ainda não tem chave, ele imprime as
opções e onde obter uma.
Um pacote, um comando. Não há um segundo servidor MCP para adicionar e nenhuma ferramenta de linha de comando externa para instalar — o hook é Python puro e vem no wheel.
Você precisa de uma coisa sua: uma chave de API de um provedor de sua escolha (ou um modelo local, que precisa do Ollama instalado). O trabalhador é seu — sua chave, seu provedor, sua conta.
E se eu não tiver chave de API?
init mostrará isto:
  This tool sends files to a worker model of YOUR choosing.
  Nothing is connected automatically and no key ships with it.

  openrouter  one key, hundreds of models     export OPENROUTER_API_KEY=...
  deepseek    cheap and strong on code        export DEEPSEEK_API_KEY=...
  groq        fastest responses               export GROQ_API_KEY=...
  ollama      Ollama Cloud subscription       export OLLAMA_API_KEY=...
  local       your own machine — no key       nothing to set
Escolha um, exporte a chave, execute init novamente. A chave é lida do seu
ambiente e armazenada na configuração MCP do seu agente — você nunca a cola em um
arquivo manualmente.
Sem chave alguma? --provider local executa contra um modelo na sua própria máquina
(Ollama em localhost:11434). Nada sai do computador.
Login por navegador em vez de chave? Não suportado. Ferramentas como Kimi Code e GitHub Copilot autenticam pelo navegador e não expõem endpoint compatível com OpenAI, então não podem ser usadas como trabalhador. Cada provedor listado acima usa uma chave de API simples.
Usando um provedor que não está na lista, ou quer um modelo específico? Veja Escolhendo o modelo de trabalho abaixo — não há lista fixa.
Verifique a qualquer momento com token-save-mcp doctor — ele verifica a configuração e
faz uma chamada ao vivo para provar que o trabalhador responde:
✓ provider: openrouter -> https://openrouter.ai/api/v1
✓ worker model: deepseek/deepseek-chat
✓ hook script present (no external tools required)
✓ MCP server registered and connected
✓ worker replied in 1.8s (21 in / 13 out)
Requisitos
- Python 3.10+
- Um agente que fale MCP — Claude Code para a experiência completa, já que o hook de aplicação é um mecanismo do Claude Code. Cursor, Cline, Windsurf e Codex recebem as ferramentas, e você as chama manualmente.
- Uma chave de API de qualquer provedor compatível com OpenAI — ou um modelo local, que não precisa de nenhuma
Todo o resto vem com o pacote.
Escolhendo o modelo de trabalho
Não há lista fixa. Qualquer ID de modelo que seu provedor sirva funciona — nada é codificado, porque uma lista embutida fica desatualizada no dia em que um provedor lança algo novo.
# switch provider (and get its default model)
token-save-mcp init --provider deepseek

# pick a specific model
token-save-mcp init --provider openrouter --model anthropic/claude-3.5-haiku

# per call, when one question deserves a stronger model
bulk_read(question="...", paths=[...], model="openai/gpt-4o")
Qualquer endpoint compatível com OpenAI — incluindo os sem predefinição:
export TOKENSAVE_BASE_URL=https://api.openai.com/v1
export TOKENSAVE_API_KEY=sk-...
export TOKENSAVE_MODEL=gpt-4o-mini
token-save-mcp init --provider openrouter   # provider ignored once BASE_URL is set
--model e TOKENSAVE_MODEL fazem a mesma coisa e funcionam com qualquer provedor ou
endpoint; a flag vence se ambas estiverem definidas. --provider apenas escolhe a URL e a variável
de chave de uma predefinição, então uma vez que TOKENSAVE_BASE_URL está definido, não importa mais
qual você nomeia.
Qual modelo escolher
O trabalhador lê código e responde perguntas sobre ele. Isso é um trabalho mecânico, então o nível barato geralmente é o certo — um modelo de fronteira aqui custa mais e compra pouco.
| Se você quer | Use |
|---|---|
| O mais barato que funciona | Um modelo pequeno/flash de qualquer provedor |
| Velocidade acima de tudo | Groq, cujo ponto central é latência |
| Grandes corpora em uma chamada | Um modelo com janela de contexto grande |
| Nada sai da máquina | --provider local |
token-save-mcp doctor prova que o que você escolheu realmente responde antes de você
depender dele.
Para onde seu código vai
Isso importa mais do que a matemática de tokens, então vem antes dela.
bulk_read envia o conteúdo dos arquivos que você nomeia para o provedor que você
configurou. É assim que funciona — o trabalhador precisa ver o código para responder
sobre ele. Nada é enviado para qualquer outro lugar: sem telemetria, sem analytics, sem
contato com a base. O registro de economia é um arquivo local.
O que isso significa na prática:
| Sua situação | O que fazer |
|---|---|
| Código open-source ou pessoal | Qualquer provedor é adequado |
| Código do empregador, sem política contra isso | Verifique os termos de retenção de dados do provedor primeiro |
| Código proprietário ou regulado | Use --provider local — o trabalhador roda na sua máquina e nada sai dela |
Para a opção local, instale Ollama e baixe um pequeno
modelo de codificação; então token-save-mcp init --provider local não precisa de chave alguma.
É mais lento que um modelo hospedado, e em um laptop visivelmente, mas o código
nunca cruza a rede.
Se não tiver certeza, comece local. Você pode trocar de provedor com um comando depois.
Quanto custa
O trabalhador é muito mais barato que seu agente principal — esse é o ponto central — mas não é grátis, e os números dependem do seu provedor.
Uma forma aproximada, para um arquivo de 600 linhas:
- O trabalhador lê ~6.000 tokens e escreve ~300. Nas tarifas típicas de modelos baratos (menos de $1 por milhão de tokens de entrada), isso é uma fração de centavo por chamada.
- A mesma leitura no contexto de um agente de fronteira custa talvez 10-50× mais, e continua custando, porque cada etapa posterior paga por ela novamente.
O segundo ponto é o que importa. Uma leitura de arquivo na etapa 20 de uma sessão de 200 etapas não é paga uma vez — ela fica no contexto que cada etapa restante relê. Esse acúmulo é o que isto remove.
token-save-mcp stats mostra o que você realmente economizou, a partir de números de uso
reais em vez de estimativas.
A parte que ninguém mais faz: aplicação
Toda ferramenta de economia de tokens tem o mesmo modo de falha — o agente esquece de usá-la. Uma ferramenta que o modelo pode ignorar é ignorada, e suas economias são o que o modelo decidiu naquele dia.
Apenas Claude Code. O hook usa o mecanismo
PreToolUsedo Claude Code. No Cursor, Cline, Windsurf ou Codex, as ferramentasbulk_readecode_writefuncionam normalmente — você apenas as chama manualmente em vez de ser redirecionado.install-hookavisa se não encontrar o Claude Code.
init --hook o instala durante a configuração; token-save-mcp install-hook o adiciona
depois. De qualquer forma, registra um hook PreToolUse que bloqueia
Read em arquivos acima do limite e redireciona o agente para bulk_read:
Read("src/server.py")
→ BLOCKED: This file is 606 lines (threshold: 350).
  Use bulk_read to delegate this read instead.
  Need exact content to EDIT? Re-read with offset/limit — that passes through.
O que ainda passa, por design:
- Leituras direcionadas (
offset/limit) — editar precisa do texto exato - Arquivos pequenos — abaixo do limite, delegar custa mais do que economiza
- Binários e arquivos ausentes — nada para resumir
Não pronto para ouvir "não"? Instale no modo de aviso — a leitura passa, mas você vê o que custou:
token-save-mcp install-hook --hook-mode warn
A aplicação é opt-in e reversível: token-save-mcp uninstall-hook.
Ferramentas
bulk_read(question, paths, model?, effort?)
Leia arquivos sem puxá-los para o contexto.
bulk_read(
  question="Which methods touch the database, and where is auth enforced?",
  paths=["src/service.py", "src/handlers.py"]
)
Use para: explorar código desconhecido, "o que isto faz", rastrear um fluxo entre arquivos, encontrar onde algo é tratado.
Não use para: editar (você precisa do texto exato — use uma leitura direcionada), depuração que exige seu próprio raciocínio sobre o código bruto, ou arquivos com menos de ~350 linhas onde a sobrecarga de delegação excede a economia. A ferramenta avisa quando você cruza essa linha em vez de queimar uma chamada silenciosamente.
code_write(spec, reference, target?, model?, effort?)
Gere código boilerplate que corresponde ao estilo de um arquivo existente. Com target, o código
é escrito direto no disco e apenas uma confirmação retorna — o código gerado
nunca entra no seu contexto.
code_write(
  spec="pytest suite for clamp(value, lo, hi), covering both bounds and lo>hi",
  reference=["tests/test_total.py"],
  target="tests/test_clamp.py"
)
→ Wrote tests/test_clamp.py (32 lines). Not read into your context.
Nunca sobrescreve: o destino é criado com O_EXCL, que também se recusa a
seguir um symlink quebrado.
Como você revisa código que nunca viu? Você o executa. Isto é para trabalho gerado
com uma verificação barata — uma suíte de testes que você executa, uma configuração que valida, um
stub que compila. Se a correção da saída depende de lê-la
cuidadosamente, pule target e faça com que ela retorne para você.
run_command(command, question?, cwd?, timeout?, model?, effort?)
Execute um comando e receba o veredito, não a saída.
run_command(command="pytest -q")
→ The run failed (exit 1): 3 tests failed, 197 passed in 42.11s.

  FAILED tests/test_payment.py::test_refund_partial
  E   AssertionError: assert Decimal('12.50') == Decimal('12.55')
  tests/test_payment.py:142

  Full output (168 lines): ~/.token-save/logs/run-1789759198.log
  ─────────────────────────────────────────────────────────────
  token-save: 168 lines | direct ≈2,922 tok → into context ≈202 tok (93%)
Uma suíte com falha imprime centenas de linhas de ruído de configuração em torno das quatro que importam. Essas centenas vão para o trabalhador; o veredito volta. A saída completa é escrita em um arquivo, então se o resumo perdeu algo, você pode ler a parte que precisa — nada é descartado.
Use para: suítes de teste, builds, linters, verificadores de tipo, migrações.
Não use para: saída que você precisa verbatim (git diff antes de uma edição),
comandos interativos, ou qualquer coisa curta — abaixo de ~400 tokens é retornado
integralmente em vez de enviado a um trabalhador.
O comando roda em um shell com suas permissões. É seu comando: nada é filtrado ou isolado.
status()
A versão de ferramenta MCP de doctor: seu agente pode chamá-la no meio da sessão para ver
a configuração e confirmar que o trabalhador responde. Use doctor do
terminal ao configurar; use status() quando uma chamada falhar e o agente
deve descobrir o porquê.
token-save-mcp stats
Cada chamada adiciona uma linha a um registro local, para que você veja o que a ferramenta realmente economizou. Exemplo de saída após algumas semanas de uso:
$ token-save-mcp stats --badge
token-save-mcp — all time
148 calls · 71,204 lines of code read by a worker
context saved: 812,455 tokens (94%)
worker time: 612s total
Markdown badge:
Também sinaliza arquivos que você continua delegando e distingue os dois casos:
  Files delegated repeatedly

    4×  src/server.py
       26.8K worker tokens spent  3 with an identical question
    3×  src/cli.py
       13.5K worker tokens spent  all different questions

  The same question asked twice returns the same answer. Keep the
  first answer in your notes, or ask the follow-up in the same call.
A mesma pergunta duas vezes é desperdício — a resposta já foi paga. Perguntas diferentes sobre um arquivo são legítimas, mas se você continua voltando, perguntar tudo em uma chamada custa menos do que cinco.
O registro é um arquivo JSONL simples em ~/.token-save/ e nunca sai da sua
máquina. Ele registra caminhos de arquivo e um hash de cada pergunta — suficiente para detectar
uma repetição, sem colocar seus prompts no disco. --since 7 limita a janela;
TOKENSAVE_NO_LEDGER=1 desliga a gravação completamente.
Economias medidas
Execuções reais, não projeções. Cada número é o rodapé de uma chamada real:
| O quê | Tamanho | Leitura direta | Via token-save | Economia |
|---|---|---|---|---|
| server.py deste projeto | 606 linhas | ≈7.042 tok | ≈234 tok | 97% |
| Um handler TypeScript grande | 602 linhas | ≈13.340 tok | ≈689 tok | 95% |
| Serviço Python de produção | 443 linhas | ≈5.788 tok | ≈684 tok | 88% |
| 4 arquivos em uma base de código | 1.910 linhas | ≈28.379 tok | ≈304 tok | 99% |
| Geração de código para disco | 58 linhas escritas | — | 0 tok | 100% |
Método: "leitura direta" é o tamanho do arquivo a ~3,6 caracteres/token (código-fonte
é mais denso que prosa); "via token-save" é a resposta retornada medida da mesma
forma. Os números de entrada/saída do trabalhador vêm do campo usage do provedor.
Reproduza qualquer linha executando a mesma chamada — o rodapé é impresso em cada uma.
Onde é mais fraco, honestamente: em um diff de 281 linhas, a economia foi de 67%, porque uma entrada curta com uma resposta longa é o pior caso. A ferramenta diz isso em sua própria saída. As economias são melhores onde o arquivo é grande e a pergunta é estreita.
Como se compara
Ferramentas diferentes resolvem "tokens demais" de maneiras genuinamente diferentes:
| Abordagem | Aplicada? | Figura de economia | |
|---|---|---|---|
| token-save-mcp | Trabalhador LLM lê, retorna uma resposta | Sim — hook bloqueia Read | Medida por chamada |
| Ferramentas AST estáticas | Analisam a árvore, retornam símbolos exatos | Não | Determinística |
| Outros MCPs de delegação | Trabalhador LLM, provedor único | Não | Geralmente estimada |
Ferramentas AST estáticas são melhores que esta em "dê-me o corpo exato de
handleRequest" — são gratuitas, instantâneas e não podem alucinar. Use-as
para busca de símbolos.
Esta ferramenta é para perguntas semânticas sobre arquivos grandes — "o que este
serviço faz", "onde a autenticação acontece", "quais desses arquivos lidam com
retentativas" — onde você quer uma resposta, não um trecho extraído. Isso custa
uma chamada de worker e alguns segundos, e um worker pode errar. Use ambos.
Configuração
| Variável | Padrão | Finalidade |
|---|---|---|
TOKENSAVE_PROVIDER | ollama* | Predefinição: ollama, openrouter, deepseek, groq, local |
TOKENSAVE_API_KEY | — | Substitui a variável de chave da predefinição |
TOKENSAVE_BASE_URL | predefinição | Qualquer endpoint compatível com OpenAI |
TOKENSAVE_MODEL | predefinição | ID do modelo do worker |
TOKENSAVE_MIN_LINES | 350 | Limite do hook e o aviso de "muito pequeno" |
TOKENSAVE_HOOK_MODE | block | warn permite a leitura, mas sinaliza o custo |
TOKENSAVE_HOOK_MAX_BYTES | 100000 | Também bloqueia por tamanho — captura arquivos minificados |
TOKENSAVE_MAX_CORPUS_BYTES | 2000000 | Teto para uma única solicitação |
TOKENSAVE_TIMEOUT | 600 | Segundos por chamada |
TOKENSAVE_MAX_RETRIES | 4 | Repetições em falhas transitórias |
TOKENSAVE_MAX_CONCURRENCY | 3 | Corresponda ao limite do seu provedor |
TOKENSAVE_LEDGER | ~/.token-save/ledger.jsonl | De onde stats lê |
TOKENSAVE_NO_LEDGER | não definido | Defina para desativar o registro local |
* O padrão só importa se você definir as variáveis manualmente. init grava
o provedor que você escolheu na configuração do MCP, então ele nunca se aplica a
uma configuração normal. Exclua o registro a qualquer momento com rm ~/.token-save/ledger.jsonl.
Quando não usar isto
Ser claro sobre isso é o objetivo, não um aviso legal:
- Você precisa do texto exato para editar. Use uma leitura direcionada. O hook permite que elas passem.
- Você releria o arquivo de qualquer forma. Se você não puder agir com base na resposta sem verificá-la contra a fonte, você pagou por ambas. A economia é real apenas quando a resposta é suficiente — o que é o caso da maioria das perguntas de levantamento e de quase nenhuma depuração.
- Você está depurando comportamento sutil. Resumos perdem o detalhe que importa.
- O arquivo é pequeno. Abaixo de ~350 linhas, ler diretamente é mais barato e mais rápido.
- O worker pode errar. É um LLM. Para qualquer coisa em que você agirá às cegas, verifique contra a fonte. Ferramentas estáticas não têm esse modo de falha.
Desenvolvimento
git clone https://github.com/Habartru/token_save_mcp
cd token_save_mcp
pip install -e ".[dev]"

python tests/test_server.py    # 118 server tests — no API calls
python tests/test_cli.py       # 34 CLI tests
bash tests/test_hook.sh        # 21 hook routing tests
A suíte de testes simula o transporte, então não custa nada para executar e é segura em CI. Ela cobre o loop de repetição, a montagem do corpus, a remoção de cercas, as proteções de gravação em disco e cada decisão de roteamento do hook.
Créditos
O padrão de delegação mais hook é adaptado do plugin shunt em
spotify/portal-ai-plugins
(Apache-2.0), que roteia o mesmo tipo de trabalho através do Portal CLI interno do Spotify.
Este projeto mantém a ideia e troca o transporte por qualquer
provedor compatível com OpenAI, então nenhuma instância corporativa do Portal é necessária. Os arquivos
também viajam em processo em vez de através de argv, o que remove o limite de 128 KiB
por argumento no Linux.
Licenciado sob MIT.