agent-eval
Teste de regressão estatística para agentes de LLM: valor-p, tamanho de efeito e IC sobre mudança de comportamento.
Documentação

Avaliação de Agentes


Testes de regressão estatística para agentes de LLM: execute a versão A e a versão B 50 vezes cada e obtenha um valor-p, um tamanho de efeito e um intervalo de confiança de 95% sobre se o comportamento realmente mudou.
pip install agent-regress-cli
(uv add e o wrapper npm/npx são abordados em Instalação abaixo.)
O teste que todo framework de avaliação ignora
Você mudou um prompt. Suas avaliações ainda passam. Mas a precisão das ferramentas do seu agente caiu de 84% para 70%.
Isso é uma regressão real? Ou é apenas ruído de execução para execução do LLM?
Testes de limite não conseguem responder a essa pergunta. agent-eval consegue.
Execute seu agente 50 vezes na versão A, 50 vezes na versão B. Obtenha um valor-p, um tamanho de efeito e um intervalo de confiança de 95% sobre se o comportamento realmente mudou.
p=0.003, Cohen's d=-0.61 -> REGRESSED (deploy blocked)
p=0.410, Cohen's d=0.021 -> STABLE (safe to ship)
[!NOTE] Promptfoo, um dos frameworks de avaliação de LLM open source mais amplamente utilizados, foi adquirido pela OpenAI em março de 2026, permanecendo open source, mas incorporando sua equipe à plataforma Frontier da OpenAI. agent-eval é licenciado sob Apache 2.0, auto-hospedável e sem dependência comercial. O núcleo estatístico (Mann-Whitney U, bootstrap CI, d de Cohen) nunca será colocado atrás de paywall.
Instalação
pip install agent-regress-cli
# or
uv add agent-regress-cli
# or, from Node/npx (thin wrapper around the same Python CLI)
npx agent-regress-cli
Início rápido
Em 30 segundos (CLI)
Já tem pontuações por execução do seu próprio harness? Aponte a CLI para dois arrays JSON de pontuações, um por versão:
pip install agent-regress-cli

agent-regress compare \
  --version-a-results v1_scores.json \
  --version-b-results v2_scores.json \
  --metric tool_accuracy

# ============================================================
# agent-regress Report -- tool_accuracy
# ============================================================
# Verdict:    REGRESSED
# p-value:    0.0000
# Cohen's d:  -2.193
# 95% CI:     [-0.213, -0.148]
#
# Version A:  0.8470 +/- 0.0525  (n=50)
# Version B:  0.6685 +/- 0.1025  (n=50)
# Delta:      -0.1786
# ============================================================
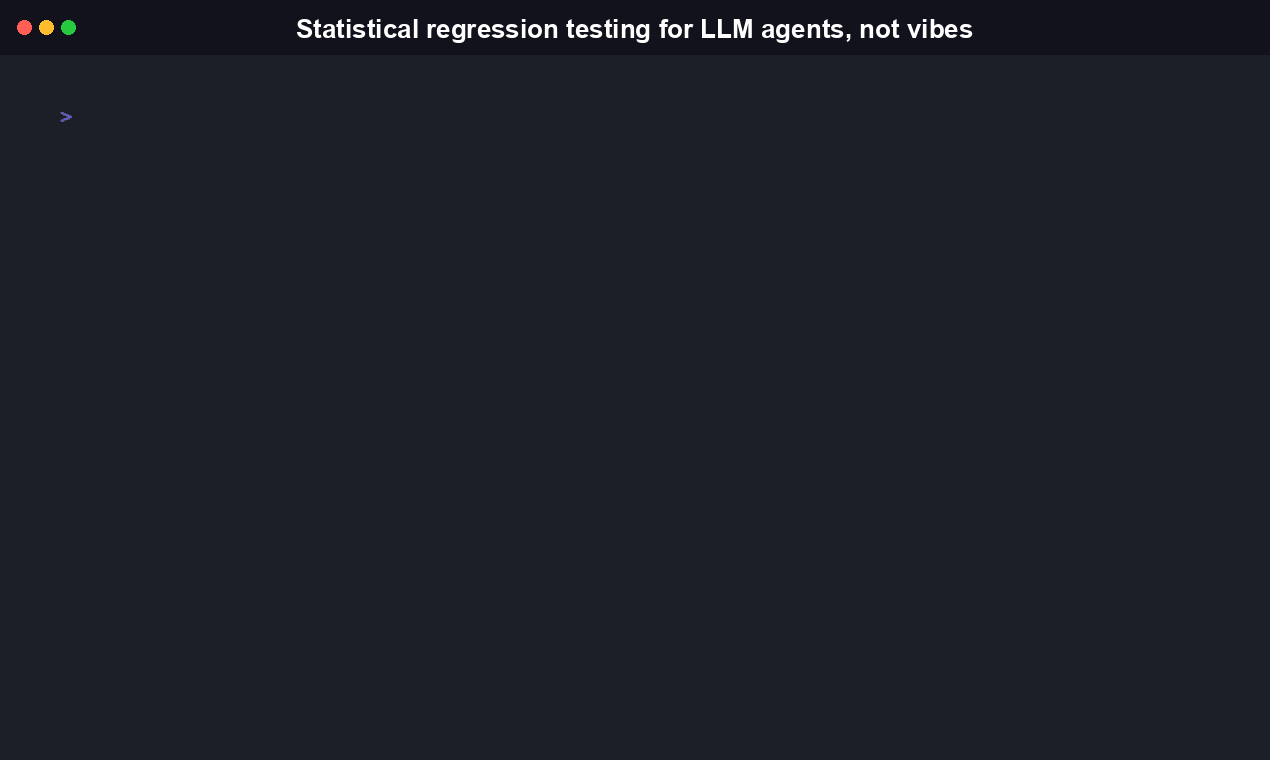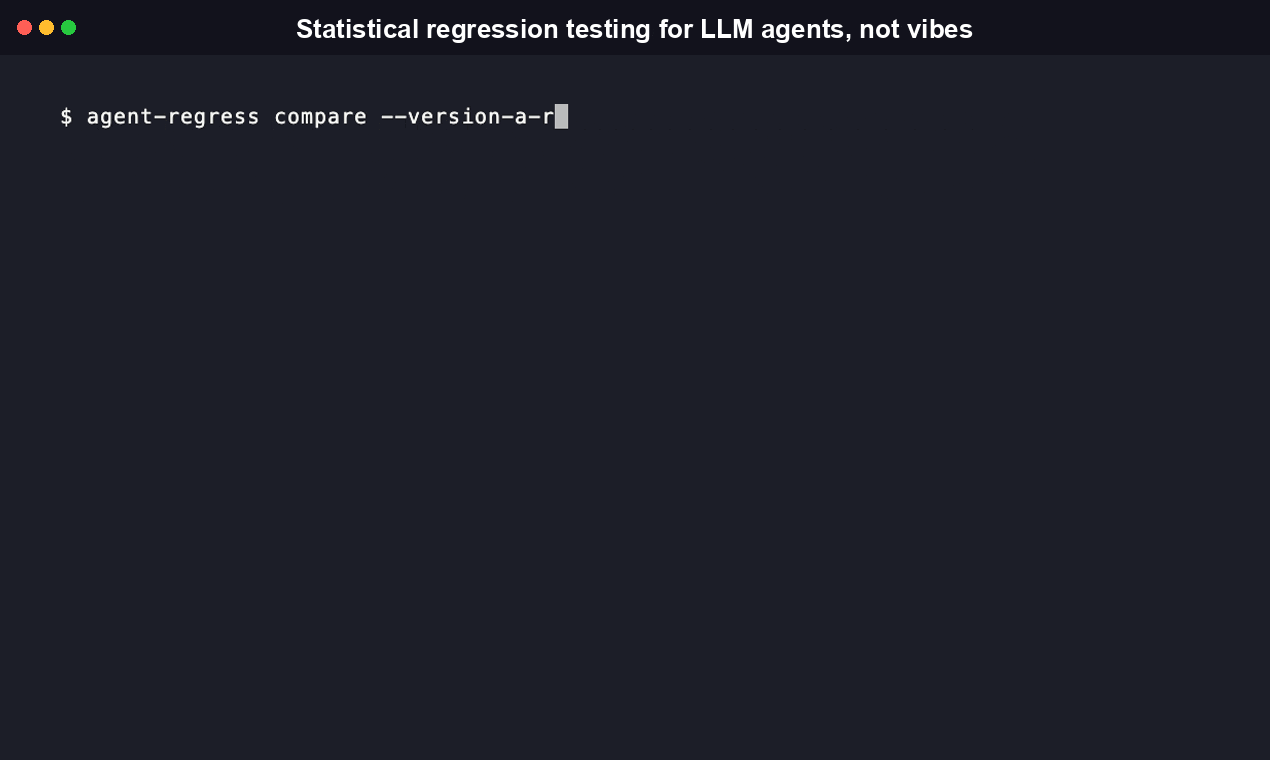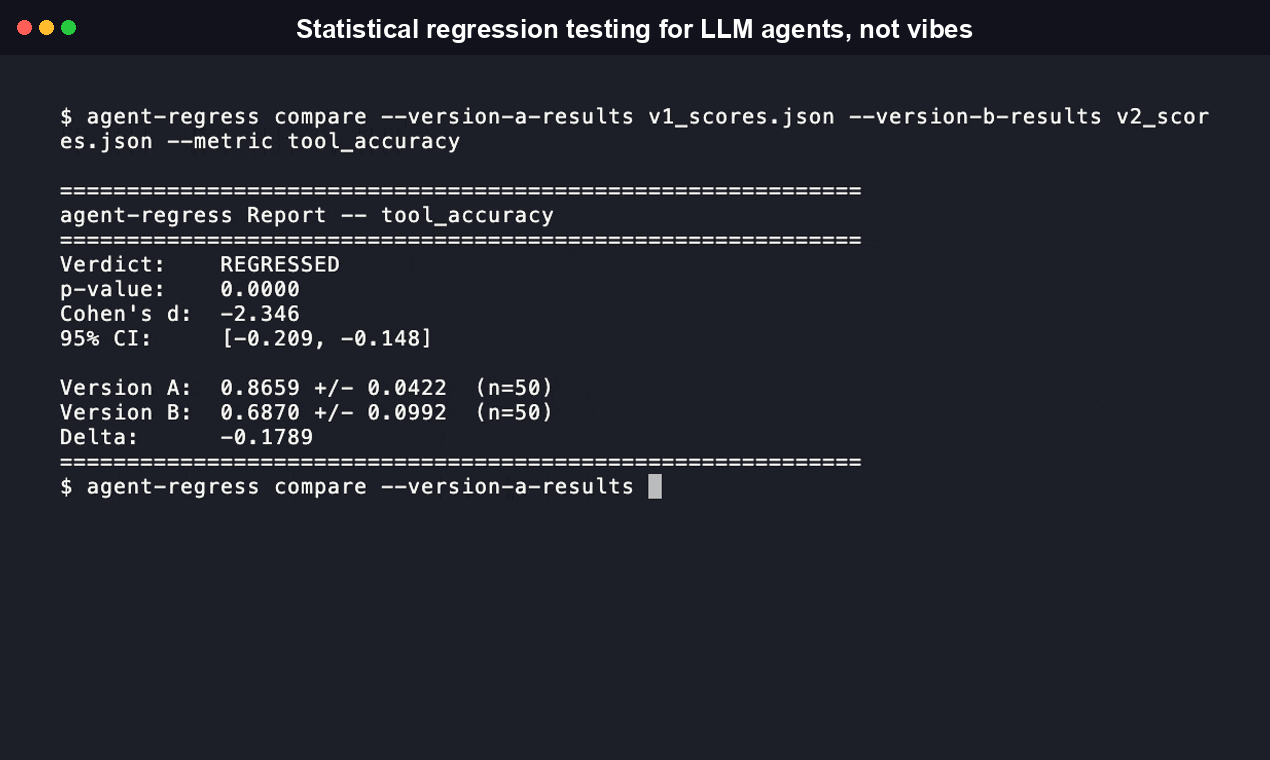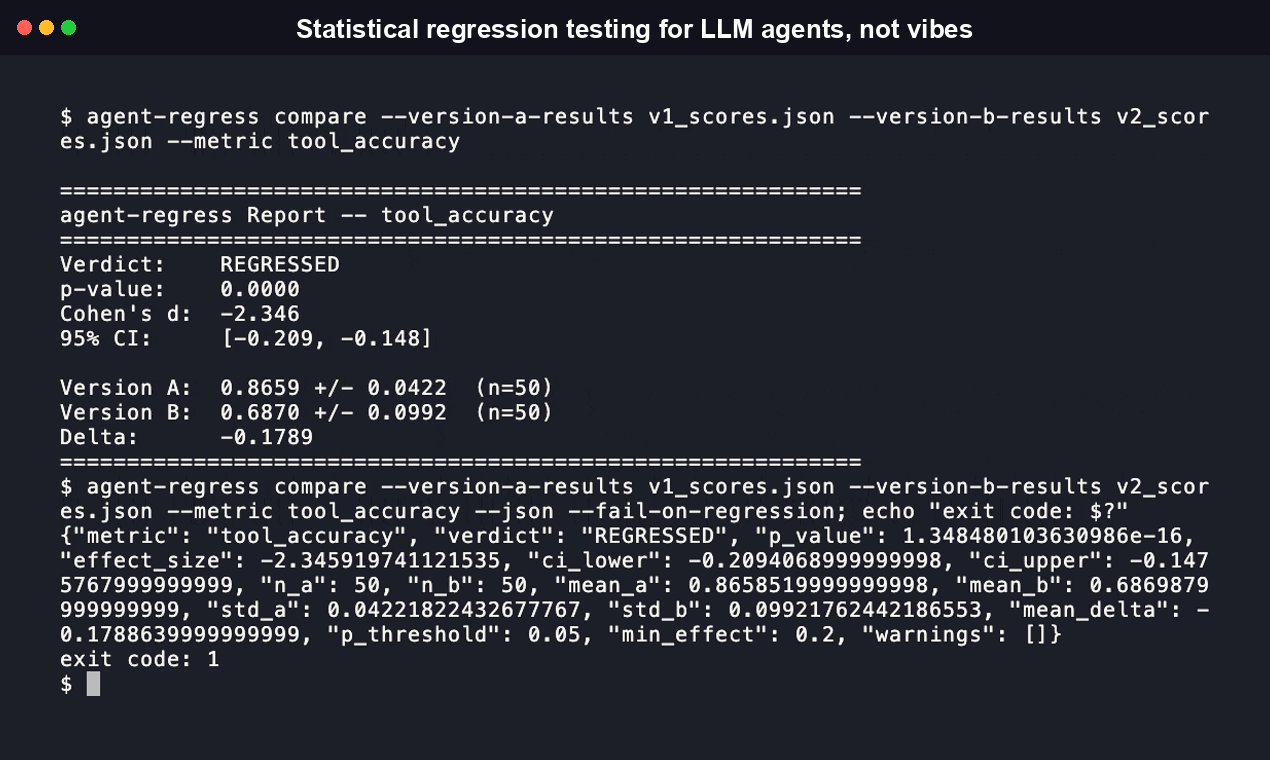
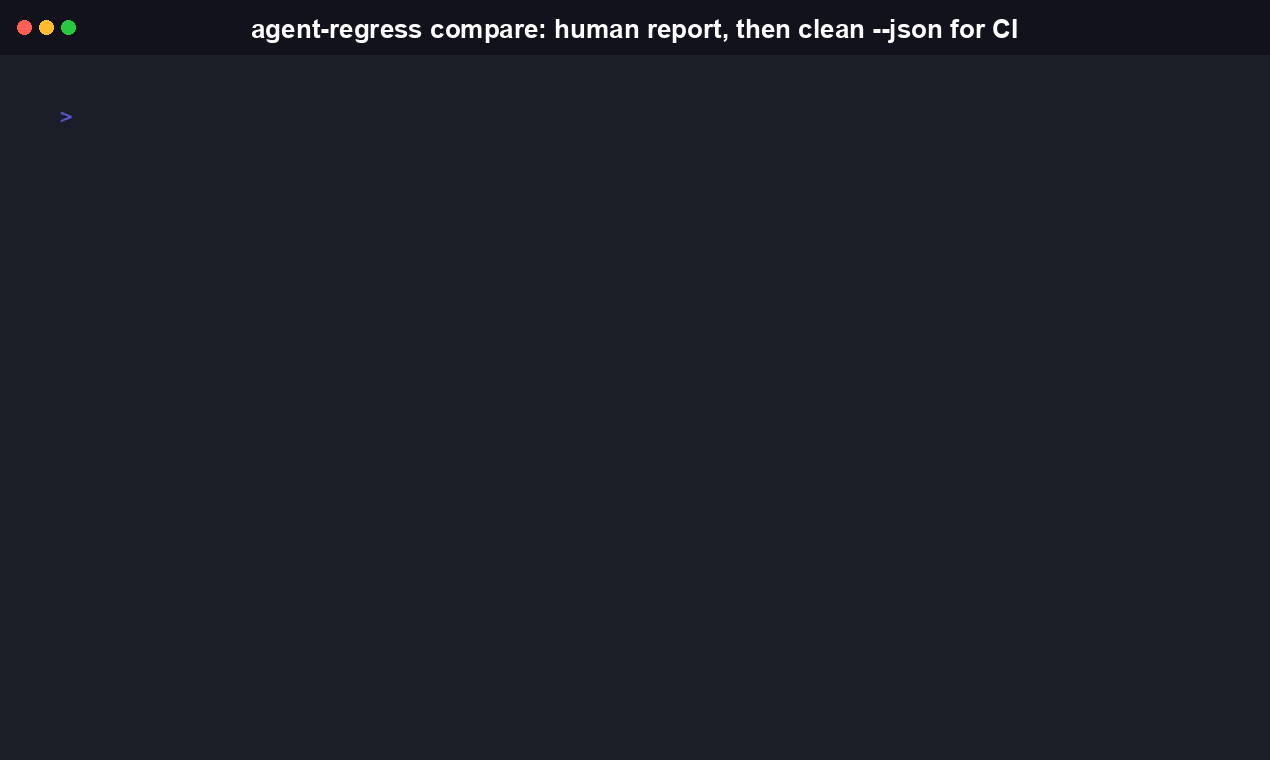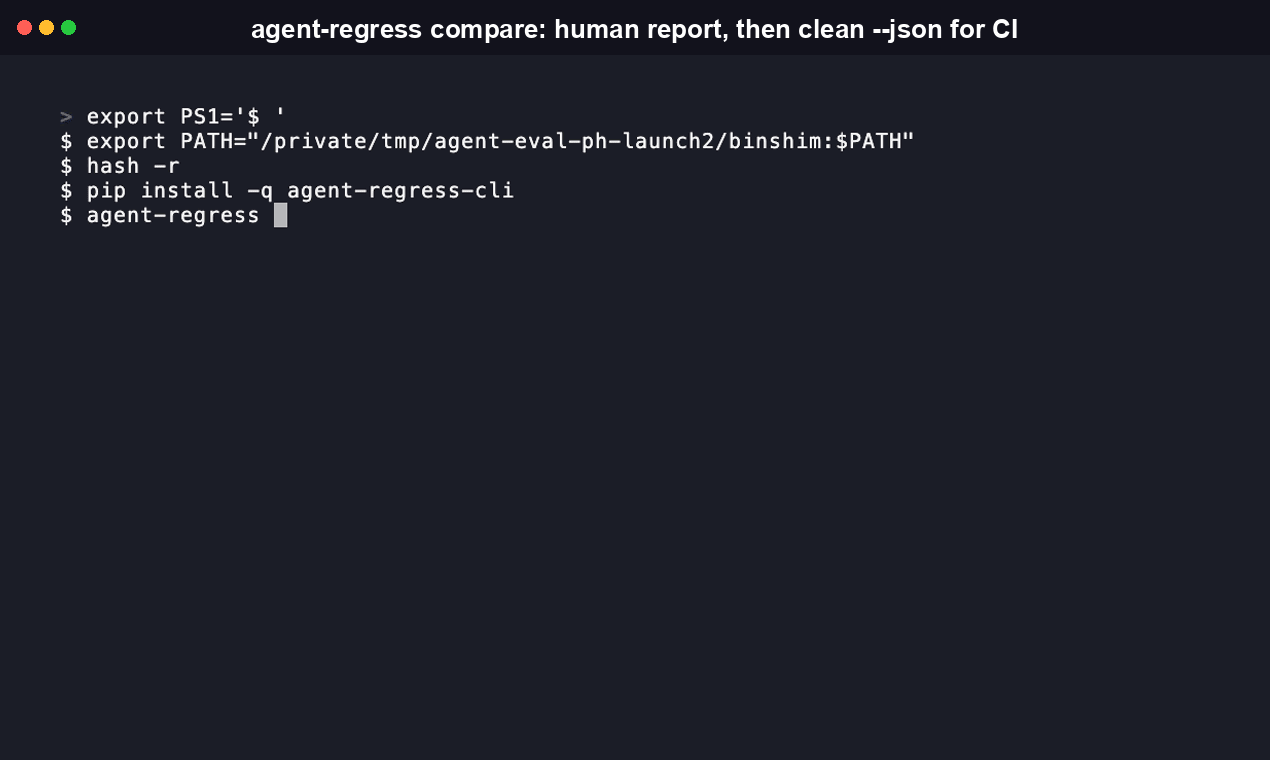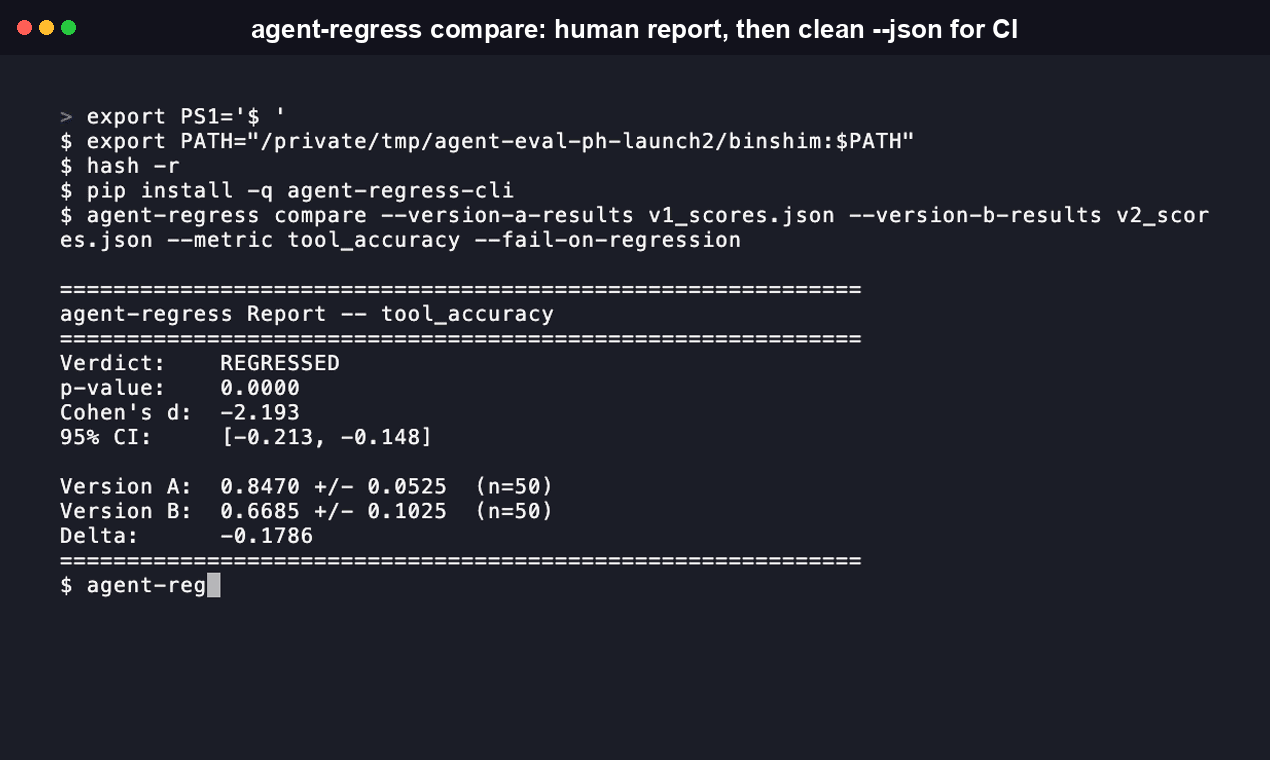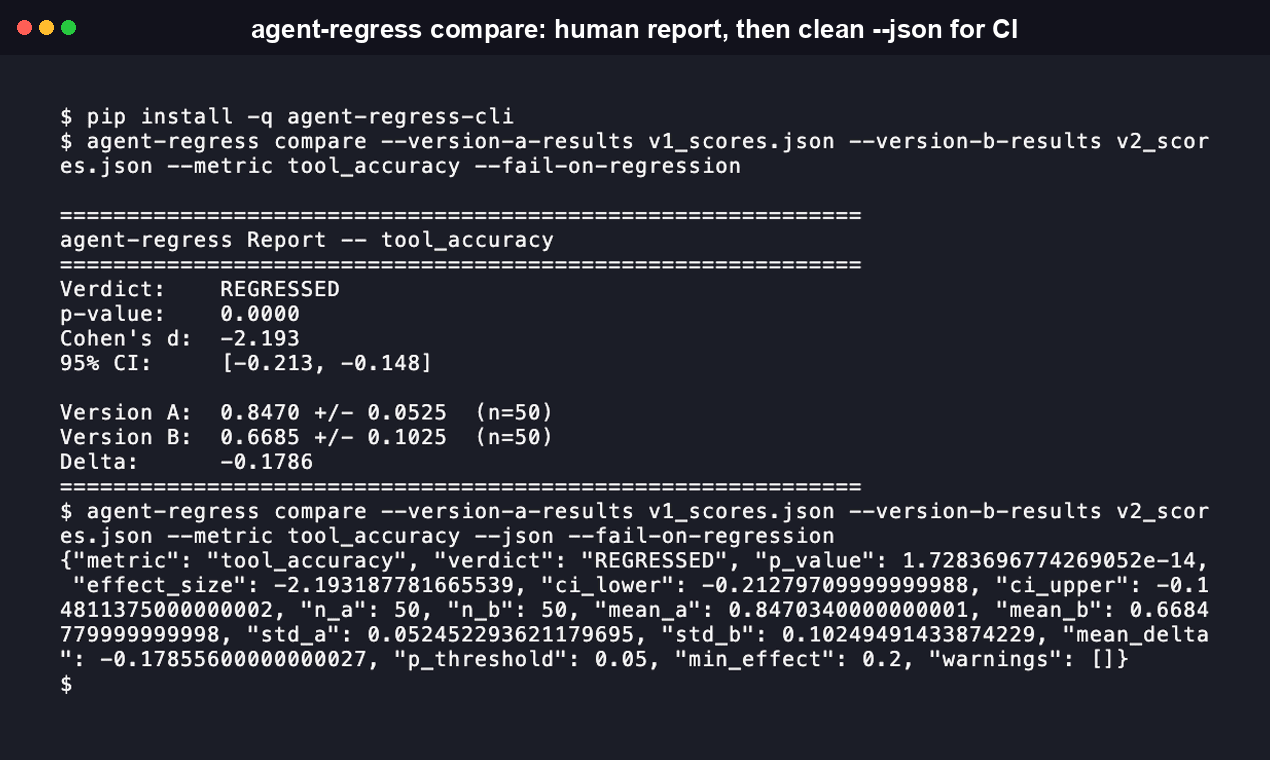
Adicione --json --fail-on-regression para obter saída limpa e analisável e um código de saída diferente de zero em REGRESSED, para integração direta com CI.
Todas as flags de agent-regress compare:
| Flag | Padrão | Descrição |
|---|---|---|
--version-a-results PATH | (obrigatório) | Caminho para um array JSON de pontuações por execução da versão A (linha de base). |
--version-b-results PATH | (obrigatório) | Caminho para um array JSON de pontuações por execução da versão B (candidata). |
--metric NAME | accuracy | Nome da métrica sendo comparada, exibido no relatório. |
--p-threshold P | 0.05 | Limiar de significância para o valor-p do Mann-Whitney U. |
--min-effect D | 0.2 | Mínimo |d de Cohen| para classificar uma diferença estatisticamente significativa como REGRESSED/IMPROVED em vez de STABLE. |
--n-resamples N | 1000 | Número de reamostragens bootstrap usadas para o intervalo de confiança (mínimo: 100). |
--json | off | Imprime o relatório como um único objeto JSON em stdout em vez do formato legível por humanos. Avisos continuam indo para stderr, então stdout permanece limpo e analisável como JSON. |
--fail-on-regression | off | Sai com status 1 se o veredito for REGRESSED (útil para CI). Sem esta flag, o comando sai com 0 independentemente do veredito. |
A flag de nível superior agent-regress --version imprime a versão instalada e sai.
Códigos de saída:
| Código | Significado |
|---|---|
0 | Executado com sucesso. O veredito pode ser REGRESSED, STABLE, IMPROVED ou INSUFFICIENT_DATA — sem --fail-on-regression, o código de saída não reflete o veredito. |
1 | --fail-on-regression foi passado e o veredito é REGRESSED. |
2 | Erro de uso ou dados: argumentos inválidos/ausentes, nenhum subcomando fornecido, um arquivo --version-*-results que não existe ou não é JSON válido, um array de pontuações vazio/não numérico, ou um valor fora do intervalo para --p-threshold (deve estar em (0, 1)), --min-effect (deve ser >= 0) ou --n-resamples (deve ser >= 100). |
No seu código (API Python)
Dirigindo o agente você mesmo em vez de pré-computar pontuações? Use a API Python:
from agent_regress import compare

# Any callable that takes a test case dict and returns a score 0.0-1.0
def agent_v1(test_case: dict) -> float:
    ...  # your existing agent

def agent_v2(test_case: dict) -> float:
    ...  # your updated agent

test_suite = [
    {"query": "find SKU for order 8823", "expected": "SKU-4492"},
    # ... more test cases
]

report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    metric="tool_accuracy",  # use any name except "accuracy" when agents return floats
)

print(report)           # structured output with p-value, CI, effect size
report.assert_stable()  # raises AssertionError if behavior regressed
O agente retorna texto? Passe um scorer ou use os integrados:
from agent_regress import compare, exact_match_scorer, f1_scorer

# exact_match_scorer: 1.0 if str(output).strip() == str(expected).strip()
# f1_scorer: token-level F1 (multiset — handles repeated tokens correctly)
report = compare(
    version_a=agent_v1,
    version_b=agent_v2,
    test_suite=test_suite,
    n_runs=50,
    scorer=exact_match_scorer,  # test_case must have an "expected" key
)
Ou escreva o seu próprio:
def my_scorer(output: str, test_case: dict) -> float:
    return 1.0 if output.strip() == test_case["expected"] else 0.0

report = compare(..., scorer=my_scorer)
Servidor MCP
agent-eval inclui um servidor Model Context Protocol para que um agente de IA (Claude, Cursor ou qualquer cliente compatível com MCP) possa executar testes de regressão estatística diretamente, sem que um humano invoque a CLI manualmente.
Instale o extra:
pip install "agent-regress-cli[mcp]"
Adicione-o à configuração do seu cliente MCP (para Claude Desktop, claude_desktop_config.json):
{
  "mcpServers": {
    "agent-eval": {
      "command": "uvx",
      "args": ["--from", "agent-regress-cli", "agent-regress-mcp"]
    }
  }
}
O servidor expõe uma ferramenta, run, que chama a CLI agent-regress com o
subcomando e argumentos fornecidos, além de --json, e retorna o resultado JSON analisado:
run(["compare", "--version-a-results", "a.json", "--version-b-results", "b.json", "--metric", "accuracy"])
O transporte é stdio, então não há nada para hospedar: o cliente MCP inicia o servidor como um
subprocesso local. Fonte: src/agent_regress/mcp_server.py.
Por que não DeepEval, Promptfoo ou Braintrust?
| Capacidade | Agent Evaluation | DeepEval | Braintrust | Promptfoo |
|---|---|---|---|---|
| Comparação estatística de versões (valores-p) | Sim | Não | Não | Não |
| Relatório de tamanho de efeito (d de Cohen) | Sim | Não | Não | Não |
| Intervalos de confiança bootstrap de 95% | Sim | Não | Não | Não |
| Detecção de mudança distribucional | Sim | Não | Não | Não |
| Harness Tau-bench pass^k (k=1,4,8) | Sim | Não | Não | Não |
| Harness de divisão GAIA Nível 1-3 | Sim | Não | Não | Não |
| Harness de pontuação de scaffold SWE-bench | Sim | Não | Não | Não |
| Auto-hospedável, zero SaaS necessário | Sim | Parcial | Não | Sim |
| Avisos de tamanho de amostra | Sim | Não | Não | Não |
| Licença principal | Apache 2.0 | MIT | Proprietária | MIT† |
| Requer conta em nuvem | Não | Opcional | Sim | Não |
| Tipo de teste | Distribucional | Limite | Limite | Limite |
†Promptfoo adquirido pela OpenAI, março de 2026; permanece open source sob sua licença atual.
DeepEval testa se uma resposta individual de agente ultrapassa um padrão de qualidade. Agent Evaluation testa se o comportamento mudou significativamente entre duas versões de agente, uma questão estatística diferente que testes de limite não conseguem responder. A chamada scipy Mann-Whitney U no núcleo é uma linha, então qualquer plataforma SaaS de avaliação pode adicioná-la. O que se acumula ao longo do tempo através do uso em produção é o histórico de regressão específico de versão e um leaderboard de benchmarks mantido pela comunidade com verificação independente de resultados.
Regressões reais que testes estatísticos detectam e que testes de limite perdem
LangGraph
- #5243: uma nova API tipada
context=substituiu aconfig['configurable']não tipada. Uma única execução em qualquer estilo de invocação ainda ultrapassa uma verificação de limite; apenas uma comparação versão-A-vs-B mostra se a mudança alterou o comportamento medido. - #4486: cache de resultados em nível de nó/tarefa pode mascarar silenciosamente a variância de amostragem repetida. Verificações de limite não se importam se um resultado veio do cache; uma comparação estatística depende de amostras genuinamente independentes, então
agent-evaladicionou cache-busting para proteger essa suposição.
OpenAI Agents SDK
- #2463: chamadas de agente-como-ferramenta estavam silenciosamente descartando o
RunConfigda execução pai. A chamada aninhada ainda retorna uma resposta de aparência normal, então uma verificação de resposta única passa; apenas inspecionar a propagação de configuração entre execuções revela a regressão. - #2214: saídas de ferramentas de imagem/áudio/arquivo foram silenciosamente rebaixadas para somente texto. Um scorer de limite somente texto não tem como notar um anexo descartado.
CrewAI
- #6134: uma correção de segurança para ferramentas de arquivo que vazavam caminhos absolutos do sistema de arquivos nas respostas. Um scorer de qualidade verifica se a resposta está correta, não se ela também vaza um caminho, então o vazamento ultrapassa o padrão.
- #6236: ferramentas ganharam um
output_schemaPydantic opcional, movendo-se de saídastr()não estruturada para JSON estruturado. Tanto o formato antigo quanto o novo podem parecer "razoáveis" para um scorer de limite, mesmo que o schema tenha mudado por baixo.
Essas são as regressões que motivaram este projeto. Detalhes completos sobre todos os 14 PRs individualmente documentados (extraídos de uma campanha de validação de 29 PRs e 239 linhas em LangGraph, CrewAI e OpenAI Agents SDK) estão em docs/pr-analysis.md.
O problema que isso resolve
Você mudou um prompt. Ou mudou de GPT-4o para GPT-4o-mini para cortar custos. Ou uma dependência foi atualizada silenciosamente. Suas avaliações ainda passam, porque testam respostas individuais contra limites fixos. Elas não detectam se o comportamento mudou em toda a distribuição.
Uma queda de 3 pontos na precisão pode ser ruído da variância do LLM. Ou pode ser uma regressão real. Sem testes estatísticos, você não consegue distinguir. Equipes ou ignoram pequenas quedas e perdem problemas reais, ou escalam tudo e se afogam em falsos alarmes.
Agent Evaluation responde à questão distribucional com um valor-p e tamanho de efeito:
============================================================
agent-regress Report -- tool_accuracy
============================================================
Verdict:    REGRESSED
p-value:    0.0031
Cohen's d:  -0.610
95% CI:     [-0.221, -0.067]

Version A:  0.8400 +/- 0.0601  (n=50)
Version B:  0.7000 +/- 0.0903  (n=50)
Delta:      -0.1400
============================================================
Quando o CI falha, o erro de asserção dá a mensagem que bloqueia o deploy:
AssertionError: REGRESSED: tool_accuracy dropped 16.7%
(p=0.003, Cohen's d=-0.61, 95% CI [-0.22, -0.07])
Version A: 0.840 +/- 0.060  (n=50)
Version B: 0.700 +/- 0.090  (n=50)
Quando nada mudou:
Verdict:    STABLE
p-value:    0.4100
Cohen's d:  0.021
DeepEval, Promptfoo e Braintrust testam se respostas individuais atendem a limites. Nenhum deles responde se a distribuição de comportamento de uma versão mudou significativamente desde a última. Agent Evaluation aborda essa questão estatística específica, que testes de limite não conseguem responder.
Adicionar ao CI: falhar o build em regressão
Dois padrões. Escolha um.
report.assert_stable() — inline, depois de já ter chamado compare():
# test_regression.py -- add to your existing test suite
from agent_regress import compare

def test_no_regression():
    report = compare(
        version_a=production_agent,
        version_b=staging_agent,
        test_suite=load_test_suite(),
        n_runs=50,
    )
    report.assert_stable(
        p_threshold=0.05,  # act on changes at p < 0.05
        min_effect=0.2,    # Cohen's d threshold -- ignore noise below 0.2
    )
RegressionGate — objeto de gate reutilizável, útil quando você executa múltiplas comparações com os mesmos limites:
from agent_regress import compare, RegressionGate

gate = RegressionGate(p_threshold=0.05, min_effect=0.2)

def test_tool_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=suite, n_runs=50)
    gate.check(report)  # raises AssertionError on regression; warns if n < 30

def test_routing_accuracy():
    report = compare(version_a=prod, version_b=staging, test_suite=routing_suite, n_runs=50)
    gate.check(report)

Ambos os padrões: avisam (não falham) quando n < 30 por versão, e tratam n < 10 como dados insuficientes e pulam o gate. Este limite de gate de CI (30) é intencionalmente menor que o aviso geral de baixa potência do próprio compare() (n < 50, veja FAQ) — ele existe para impedir que uma amostra genuinamente pequena bloqueie silenciosamente um build, não para garantir 80% de potência estatística como a recomendação de 50 execuções faz.
uv run pytest test_regression.py
Métodos estatísticos
Agent Evaluation usa três testes estatísticos, aplicados em combinação:
Mann-Whitney U compara duas distribuições de pontuação sem assumir normalidade. Pontuações de LLM não são gaussianas. O teste U é livre de distribuição e robusto às caudas longas e distribuições bimodais que aparecem em saídas reais de agentes.
Intervalos de confiança bootstrap (1.000 reamostragens, seed=42) dão um IC de 95% sobre o delta médio de pontuação. O IC informa o tamanho da mudança: um IC de [-0,22, -0,07] significa que você pode ter 95% de confiança de que a queda real de precisão por execução está entre 7 e 22 pontos percentuais.
d de Cohen (desvio padrão agrupado) separa significância estatística de significância operacional. Uma mudança com p=0,001 e d=0,04 é real, mas sem sentido. Uma mudança com p=0,06 e d=0,5 é operacionalmente grande, mas requer mais dados para confirmar. O gate de CI padrão age apenas quando ambos p < 0.05 and d >= 0,2.
Veja docs/statistical-methods.md para a metodologia completa.
Benchmarks
A sobrecarga do teste estatístico é o tempo para executar a comparação em si, não as chamadas do agente. As chamadas do agente são o gargalo; as estatísticas não são.
Medido em Apple M3 Pro, Python 3.14, scipy 1.15, numpy 2.2:
| Operação | n=50 por versão | n=1.000 por versão |
|---|---|---|
| Mann-Whitney U | 0,34ms | 0,47ms |
| Bootstrap CI (1.000 reamostragens) | 26ms | 31ms |
| Sobrecarga estatística completa de compare() | ~27ms | ~32ms |
Veja docs/benchmarks.md para reproduzir.
Matriz de integração
| Framework | Status | Instalação |
|---|---|---|
| LangGraph | Enviado (v0.1) | pip install agent-regress-cli[langgraph] |
| OpenAI Agents SDK | Enviado (v0.1) | pip install agent-regress-cli[openai-agents] |
| CrewAI | Enviado (v0.1) | pip install agent-regress-cli[crewai] |
| LangChain LCEL | Enviado (v0.1) | pip install agent-regress-cli[langchain] |
| AutoGen | Planejado (v0.3) | |
| Vercel AI SDK (TypeScript) | Planejado (v0.4) |
Comparando duas versões instaladas do mesmo framework (em vez de duas
configurações em processo)? Veja
docs/cross-version-comparison.md para o
padrão subprocess_runner().
[!WARNING] O extra
[crewai]: o backend de memória/conhecimento/RAG do CrewAI pode puxar o ChromaDB, que atualmente possui uma CVE crítica sem correção (GHSA-f4j7-r4q5-qw2c) afetando qualquer servidor ChromaDB executado comtrust_remote_code=Truee exposto à rede. Oagent-evalnunca inicia, configura ou expõe um servidor ChromaDB por conta própria, então isso só importa se o seu próprioCrewfizer isso — não execute uma instância ChromaDB exposta à rede comtrust_remote_code=Trueaté que uma correção seja lançada.
Benchmarks padrão
O Agent Evaluation inclui harnesses para os três benchmarks padrão de agentes:
Tau-bench pass^k mede a confiabilidade em k tentativas independentes. Benchmarks de execução única não capturam degradação: um agente que tem sucesso 60% das vezes em k=1 alcança 99,93% em k=8. A curva de k=1 vs k=8 é o sinal.
from agent_regress.benchmarks.tau_bench import TauBenchHarness

harness = TauBenchHarness(agent=my_agent, dataset=tau_bench_dataset)
results = harness.evaluate(k_values=[1, 4, 8])
Divisão GAIA Nível 1-3 estratifica por dificuldade da tarefa. A precisão geral esconde regressões por dificuldade: uma mudança de prompt que ajuda o Nível 1 frequentemente prejudica o Nível 3.
from agent_regress.benchmarks.gaia import GAIAHarness

harness = GAIAHarness(agent=my_agent, dataset=gaia_dataset)
results = harness.evaluate()  # returns list[GAIALevelResult], one per level
for r in results:
    print(f"Level {r.level}: {r.accuracy:.3f}  ({r.n_correct}/{r.n_questions})")
Pontuação de scaffold SWE-bench isola a contribuição do framework da contribuição do modelo.
from agent_regress.benchmarks.swebench import SWEBenchHarness

harness = SWEBenchHarness(agent=my_agent, dataset=swe_dataset)
result = harness.evaluate()
print(f"scaffold pass rate: {result.scaffold_pass_rate:.3f}  ({result.n_resolved}/{result.n_instances})")
Veja leaderboard/README.md para enviar resultados.
Experimente no Docker
git clone https://github.com/RudrenduPaul/agent-eval
cd agent-eval
docker compose up
Inicia dois serviços:
- web (
http://localhost:8080) — interface do leaderboard servida porweb/serve.py, lendoleaderboard/results/*.json - example — executa
examples/01-basic-comparison/example.pye imprime o relatório de comparação no stdout
Útil para verificar se a instalação funciona e visualizar a interface do leaderboard antes de conectar o agent-regress ao seu próprio agente.
Segurança
- Cadeia de suprimentos: Releases são construídos e publicados a partir de um workflow do GitHub Actions, assinados com Sigstore, e acompanham um SBOM CycloneDX anexado a cada GitHub Release. (Nenhuma atestação de proveniência SLSA é gerada ainda — isso exigiria adotar
slsa-framework/slsa-github-generator.) - Varredura de vulnerabilidades: Trivy escaneia em cada execução de CI (apenas HIGH/CRITICAL, saída em caso de não corrigido). Análise estática CodeQL em cada push.
- Fixação de dependências: Dependabot mantém todas as GitHub Actions e dependências Python atualizadas.
- Divulgação: SECURITY.md — relate vulnerabilidades de forma privada via GitHub Security Advisories.
Leaderboard
O diretório leaderboard/ versiona resultados de Tau-bench pass^k, GAIA e SWE-bench entre modelos e frameworks. Envie abrindo um PR com um arquivo JSON correspondente a leaderboard/schema.json. Os resultados são reproduzidos de forma independente antes da mesclagem.
Veja leaderboard/README.md.
FAQ
O que é agent-eval, e o que o torna diferente de um framework de avaliação de LLM normal?
O Agent Evaluation é uma biblioteca de estatísticas para detectar se o comportamento de um agente realmente mudou entre duas versões. Execute o mesmo conjunto de testes 50 vezes na versão A e 50 vezes na versão B, e ele relata um valor-p (Mann-Whitney U), um tamanho de efeito (d de Cohen) e um intervalo de confiança bootstrap de 95% no delta da pontuação. A maioria dos frameworks de avaliação verifica se uma única resposta ultrapassa um limite fixo de qualidade. O Agent Evaluation responde a uma questão distribucional: a distribuição de pontuações mudou significativamente, ou uma mudança é apenas ruído de execução para execução do LLM?
Como instalo e quais plataformas são suportadas?
pip install agent-regress-cli ou uv add agent-regress-cli. Requer Python 3.10 a 3.13 (conforme os classificadores em pyproject.toml) e não possui código específico de SO, então roda em qualquer lugar onde essas versões de Python rodam. Um wrapper Node/npx (npx agent-regress-cli, também publicado como agent-regress-cli no npm) também está disponível — ele chama este mesmo pacote Python, então um toolchain Python (ou uv/pipx, que podem executá-lo de forma efêmera sem uma etapa manual de pip install) ainda precisa estar disponível; ele imprime um erro acionável se nenhum for encontrado.
Como ele se compara ao DeepEval, Promptfoo ou Braintrust?
A análise completa está na tabela de comparação acima. Em resumo: DeepEval, Promptfoo e Braintrust testam se uma resposta individual ultrapassa uma barra fixa de qualidade. Nenhum dos três relata um valor-p, um tamanho de efeito ou um intervalo de confiança bootstrap sobre se o comportamento mudou entre duas versões, que é a questão estatística específica que o agent-eval foi construído para responder.
Executei uma comparação e recebi um aviso sobre poder estatístico insuficiente, ou um veredito de INSUFFICIENT_DATA. O que isso significa?
A biblioteca avisa (mas não falha) quando qualquer versão tem menos de 50 execuções, já que esse é o tamanho de amostra necessário para detecção confiável de um efeito moderado (d de Cohen de 0,2) com 80% de poder. Abaixo de 10 execuções por versão, ela retorna INSUFFICIENT_DATA em vez de um veredito REGRESSED/STABLE/IMPROVED, pois a amostra é pequena demais para confiar em qualquer conclusão estatística. Execute novamente com n_runs=50 ou mais para um veredito acionável.
O agent-eval chama meu LLM ou gerencia chaves de API para mim?
Não. O compare() recebe dois callables que você fornece, version_a e version_b, e executa seu código de agente existente contra seu conjunto de testes. O Agent Evaluation nunca faz uma chamada de modelo por conta própria, e o módulo de estatísticas (src/agent_regress/stats/) é obrigado a permanecer Python puro e scipy sem chamadas de LLM, então o núcleo estatístico não tem dependência de rede e nada para configurar credenciais.
Com quais frameworks de agentes ele se integra hoje?
LangGraph, OpenAI Agents SDK, CrewAI e LangChain LCEL são enviados a partir da v0.1 (veja a matriz de integração acima), cada um instalável como um extra, por exemplo, pip install agent-regress-cli[langgraph]. AutoGen e uma integração Vercel AI SDK (TypeScript) estão planejadas, mas ainda não foram lançadas.
Posso usar agent-eval comercialmente e sob qual licença?
Sim. É licenciado sob Apache License 2.0, que permite uso comercial, modificação e distribuição, e inclui uma concessão explícita de patente. Você precisa preservar os avisos de copyright e licença e declarar quaisquer alterações que fizer; não há garantia. Veja LICENSE para o texto completo.
Contribuindo
- Leia CONTRIBUTING.md antes de abrir um PR
- Boas primeiras issues são rotuladas no GitHub
- O módulo de estatísticas (
src/agent_regress/stats/) deve permanecer Python puro + scipy — sem chamadas de LLM, nunca - Todos os PRs exigem 95% de cobertura em
stats/, 80% no geral
GitHub Discussions para questões de design.
Apache 2.0. Contribuições são bem-vindas.
Cite este trabalho
Se você usar o Agent Evaluation em pesquisa, por favor cite:
@software{paul2026agenteval,
  author = {Paul, Rudrendu and Nandy, Sourav},
  title = {Agent Evaluation: Statistical Regression Testing for LLM Agents},
  year = {2026},
  url = {https://github.com/RudrenduPaul/agent-eval},
  license = {Apache-2.0}
}
Construído por Rudrendu Paul e Sourav Nandy