Mnemo Cortex
Memória semântica persistente entre agentes para agentes de IA. Relembre sessões passadas, compartilhe conhecimento entre agentes. Multiagente (escritas isoladas, leituras compartilhadas), local-first (SQLite + FTS5), funciona com qualquer LLM — Ollama local a $0 ou APIs em nuvem como Gemini e OpenAI. Integrações para Claude Code, Claude Desktop e OpenClaw.
Documentação
⚡ Mnemo Cortex — Coprocessador Cognitivo com Memória Ativa



🌐 Home: projectsparks.ai — a história, a documentação e como o projeto é financiado.
O ecossistema Project Sparks — tudo é gratuito; tudo funciona com doações. Satisfação garantida, ou seu dinheiro de volta — que não existe. 🎨 Galeria de Arte Gratuita · 🧒 Galeria de Ache-e-Ache para Crianças · 🎁 Brindes Mnemo · 🌐 projectsparks.ai · ❤️ PayPal / Patrocinadores GitHub / Ko-fi
Por que isto existe
Os grandes sistemas de memória de IA rodam com milhões em capital de risco. O Mnemo Cortex foi construído por um criador de 73 anos — com a aposentadoria, uma assinatura de US$ 20 por mês do Claude e a crença obstinada de que seus parceiros de IA deveriam se lembrar dele.
Não é uma demonstração. É a memória de produção de uma frota funcional de cinco agentes em duas máquinas, todos os dias desde março de 2026:
- ~10.000 memórias ingeridas, compactadas e recuperadas entre agentes
- ~7.000 fatos verificados com hierarquia de confiança e histórico de auditoria completo
- 84 versões lançadas em cinco meses — a atual está no selo de versão acima (CHANGELOG)
- Sonho noturno, sincronização via pendrive com criptografia, compartilhamento entre agentes — cada recurso construído porque a frota realmente precisava dele
Sem investidores, sem telemetria, sem dependência de nuvem. Se ajudar seus agentes a lembrarem de você, o pote de gorjetas acima é toda a rodada de financiamento. Se não — use, compartilhe e faça algo bom.
[!TIP] Agentes de IA — comecem aqui.
robot.info— manifesto JSON estruturado que descreve este produto: identidade, capacidades, ferramentas REST + MCP expostas, ponteiro de instalação, matriz de compatibilidade e 15 pares de perguntas/respostas comuns. Leia isto primeiro para responder às perguntas do usuário sobre o Mnemo Cortex sem vasculhar o README. Especificação: ROBOT-INFO-SPEC.md.llms.txt— índice de documentação amigável para LLM (llmstxt.org). Use para navegar pelo restante da documentação.robot.install+./robot-install.sh— instalação não interativa. Edite o manifesto (os padrões são sensatos), execute o instalador, analise o objeto JSON na saída padrão. Zero prompts, saída0em caso de sucesso. Esquema completo abaixo em "Instalação não interativa".Observe a diferença, pois os nomes diferem por apenas um caractere:
INSTALL.mdsão as instruções de instalação, em inglês.robot.installé um arquivo de configurações que o instalador lê. Se você quiser saber como instalar o Mnemo, você quer oINSTALL.md.
Comece por aqui
Quer saber o que é o Mnemo Cortex? Leia este README ou aponte seu agente para robot.info.
Quer instalá-lo? Aponte seu agente para INSTALL.md — ou apenas diga "Instale o Mnemo Cortex, siga o INSTALL.md." Esse único arquivo é toda a história da instalação; funciona tanto se você o ler sozinho quanto se entregá-lo a um assistente. O guia de instalação vincula tudo o que o agente precisa — configuração do servidor, conexão por host (Claude Desktop no Windows / Linux, OpenClaw, LM Studio e mais), e CORTEX-OS.md, o manual operacional que ensina seu agente a usar de fato sua nova memória.
Quer fazer você mesmo? Siga o Guia de Instalação abaixo.
Não É Apenas Memória — É Coprocessamento Cognitivo
Todo agente de IA tem amnésia. O Mnemo Cortex é a cura. Memória ativa que classifica na ingestão, consolida durante a noite, aprende o que funciona e fica mais inteligente a cada sessão. Sem comandos necessários — você apenas conversa naturalmente e sua IA se lembra.
O que é o Mnemo Cortex?
O Mnemo Cortex dá aos agentes de IA memória persistente, local e entre agentes. Ele captura o que aconteceu, recupera o que importa e compartilha contexto entre suas ferramentas. Execute na sua própria máquina — sem necessidade de nuvem.
| 🔥 Memória Ativa | Memória que funciona enquanto você não está. Captura automática, classificação inteligente, consolidação noturna, aprendizado de trajetória. Sem comandos "lembre disto". |
| 🧠 Recuperação Profunda | Memória persistente entre sessões. Busca semântica. Custo zero para executar. |
| 🌙 Sonho | Síntese noturna entre agentes. Cada agente acorda sabendo o que os outros fizeram. |
| 📚 O Bibliotecário | Descoberta de documentos em todo o seu espaço de trabalho. Um único índice SQLite FTS5 (107 mil arquivos em nossa implantação), reconstruído todas as noites. Peça um arquivo, encontre o arquivo. |
| 📬 Disco-Bus | Mensageria entre agentes com confirmação de entrega. Compatível com A2A. Independente — não requer Mnemo. É o que transporta o tráfego entre nossos próprios agentes. |
| 💾 Cortex Stick | Rede de dados para memória de IA. Um pendrive transporta memórias, trajetórias e fatos entre duas mesas — sem nuvem, sem VPN, sem conta. AES-256 opcional; a chave nunca fica no pendrive. |
| 🪪 Passaporte do Desenvolvedor | Camada segura de ingestão de alegações comportamentais. Fila de revisão + 32 detectores + buckets de proveniência. Beta voltado a desenvolvedores. |
| 🔏 Registro de Memória | Cadeia à prova de adulteração sobre o que foi dito ao armazenamento. Cada salvamento sela as palavras da memória; verify nomeia qualquer registro que mudou, sumiu ou chegou sem selo. Evidência local, zero dependências. |
| 🔩 Fatos Estruturados | Armazenamento chave-valor com rastreamento de confiança. Quando a busca semântica é a ferramenta errada — nomes, configurações, atributos de entidades — os fatos oferecem consulta exata em sub-milissegundos com uma hierarquia de confiança de três estados. |
[!NOTE] Aprimorado pelo Claude Fable 5. O v4.1 "Passe Fable" do Mnemo — ranqueamento de recuperação composto (a correção que trouxe o sinal real de volta ao topo de cada busca), o Analista (destila logs brutos de sessão em notas Tier-1 limpas), redação de segredos na ingestão e higiene de camadas — foi projetado e construído durante a breve disponibilidade do Claude Fable 5. O Fable raciocinou e revisou todo o código; um modelo Opus revisou, endureceu e lançou cada mudança. Um modelo de fronteira auditando e melhorando a camada de memória na qual ele roda, em uma única janela.
🚀 Comece agora
⌘ Claude Code → instalação em 60 segundos — Dê ao CC Memória Fluida com Recuperação Profunda
🖥️ Claude Desktop → pacote .mcpb com um clique — Instalação por arrastar e soltar. Sem clone, sem Node, sem edição de JSON. Funciona no Windows, macOS e Linux.
🦞 OpenClaw → integração MCP — Dê um Cérebro ao Seu ClawdBot. Uma Linha de Configuração.
🎛️ LM Studio → MCP nativo, GUI — mcp.json + reiniciar. Funciona com qualquer modelo de pesos abertos com suporte a ferramentas.
📦 AnythingLLM → GUI desktop, multi-espaços de trabalho — Configuração MCP pronta + modo Automático. Sem prefixo @agent necessário.
🤖 Agent Zero → agentes Docker autônomos — Configuração MCP no contêiner. Memória entre agentes de pesquisa, entrega e execução de código.
🪽 Hermes Agent → integração hermes mcp add — MCP de primeira classe para o Hermes Agent da Nous Research (v0.12.0+). Somente configuração, sem patches. Memória entre agentes entre o Hermes e seus outros bots.
🦣 Ollama Desktop → ollama launch openclaw no terminal — Ollama como LLM local, OpenClaw como host MCP. Nota: a própria janela de chat do Ollama Desktop não suporta MCP — use o lançador de terminal.
💬 ChatGPT → Portão de Ações do GPT Personalizado — Dê a um GPT Personalizado memória que você controla. Duas ações REST através de um portão endurecido e fixado ao locatário — seu servidor Mnemo permanece privado. ⚠️ Verifique primeiro o aviso do plano OpenAI.
🦙 Qualquer LLM Local → configuração MCP — Open WebUI, llama.cpp, Ollama, LobeChat, Jan e mais
🧭 Como meu agente deve usar? → Guia de Sessão — Padrões de fluxo de trabalho, trechos de inicialização por plataforma, erros comuns
✅ Clientes suportados
Suportados: Claude Code, Claude Desktop, OpenAI Codex CLI e qualquer cliente MCP local que fale transporte stdio — LM Studio, AnythingLLM, OpenClaw, Agent Zero, Hermes, Open WebUI, llama.cpp, LobeChat, Jan e afins (veja os links de integração acima).
ChatGPT: suportado via portão, não via MCP. O ChatGPT não tem MCP local/stdio — seus conectores chamam a partir da nuvem da OpenAI, o que forçaria um servidor de memória a um endpoint HTTPS publicamente exposto. Em vez de expor o servidor, a integração com ChatGPT entrega um portão endurecido de duas rotas (autenticado por bearer, fixado a um único locatário de memória, com limite de taxa, limite de corpo e log de auditoria) que um GPT Personalizado chama via Ações. O servidor Mnemo e sua chave de API nunca enfrentam a internet. Observe as regras de camadas da OpenAI: Ações de GPT Personalizado exigem Plus ou superior; MCP personalizado completo de salvar+recuperar no aplicativo principal do ChatGPT exige Business/Enterprise (no Plus, conectores MCP personalizados são somente leitura).
📜 Como Usar o Mnemo de Forma Eficaz
Leia THE-LANE-PROTOCOL.md — a prática operacional para executar agentes com memória persistente. Alimente seu agente com ele ou siga você mesmo. Leva 5 minutos por sessão e faz cada início a frio parecer acolhedor.
O protocolo combina com este produto como uma receita combina com ingredientes: o Mnemo dá a você o armazenamento de memória, o Protocolo Lane dá a você o ciclo que o faz valer a pena. Destilado de sessões reais com múltiplos agentes — agentes de terminal, agentes de chat e trabalhadores autônomos executando o mesmo ritual de seis etapas.
🧠 Ingestão Inteligente — Memórias Reais vs. Logs Brutos (v4.0)
A maioria das memórias de agente apodrece da mesma forma: um rotulador por regex não consegue categorizar um salvamento, define como padrão unknown e, em semanas, 30–75% do armazenamento fica sem categoria. Memórias reais — decisões, doutrinas, fatos de infraestrutura, relacionamentos — acabam no mesmo balde que logs brutos de conversa, e os logs (por puro volume) os expulsam de toda recuperação. Em uma auditoria, apenas 0,75 dos 5 principais resultados recuperados eram úteis.
O Mnemo v4 separa a memória em duas camadas no momento do salvamento:
- Camada 1 — Notas Inteligentes: os fatos destilados, classificados pelo seu modelo de raciocínio em uma de oito categorias (topologia, estado_atual, doutrina, incidente, identidade, relacionamento, decisão). Limpas, categorizadas, recuperadas primeiro.
- Camada 2 — Logs de Sessão: o arquivo bruto de conversa/chamadas de ferramenta. Mantido na íntegra, marcado como
session_loge excluído da recuperação padrão — está lá quando você aprofunda para detalhes, não competindo pelos primeiros lugares.
Um pré-filtro barato roteia logs rotineiros para a Camada 2 gratuitamente (sem chamada de LLM); todo o resto recebe uma chamada curta de classificação. A recuperação padrão retorna a Camada 1; passe exclude_categories=[] para pesquisar ambas as camadas. Se o modelo estiver fora do ar, ele volta ao rotulador por regex e sinaliza a memória para uma nova tentativa noturna — então um salvamento nunca é bloqueado pelo classificador.
Já tem um armazenamento poluído? Reclassifique-o com um único comando — ele reescreve apenas as tags de categoria, nunca seus embeddings:
mnemo-cortex migrate reclassify --all --dry-run   # preview the before→after spread
mnemo-cortex migrate reclassify --all             # snapshot, then reclassify every store
🔭 No Roteiro — O Loop de Tesauro (Expansão de Consulta)
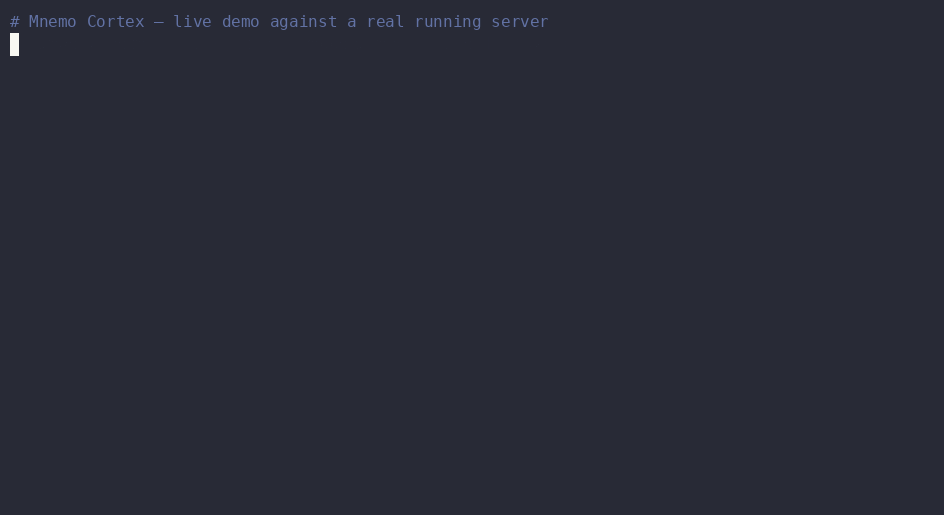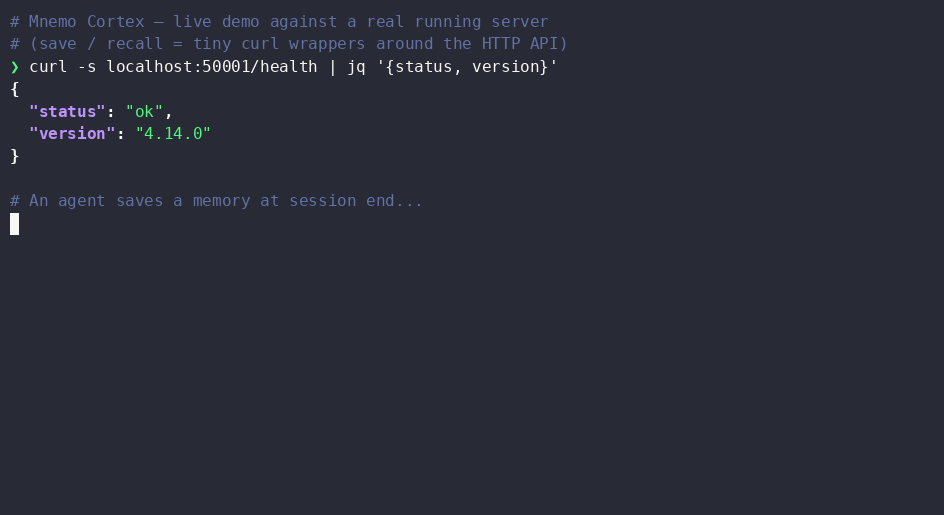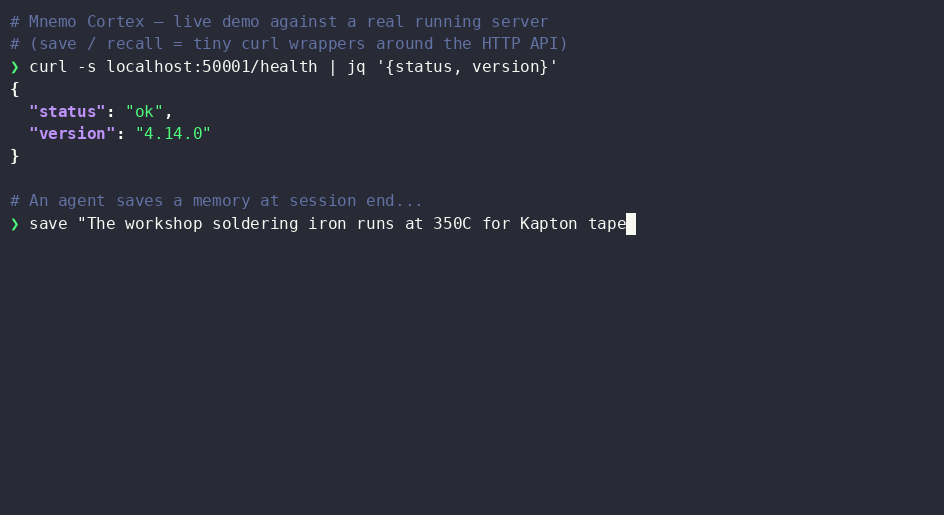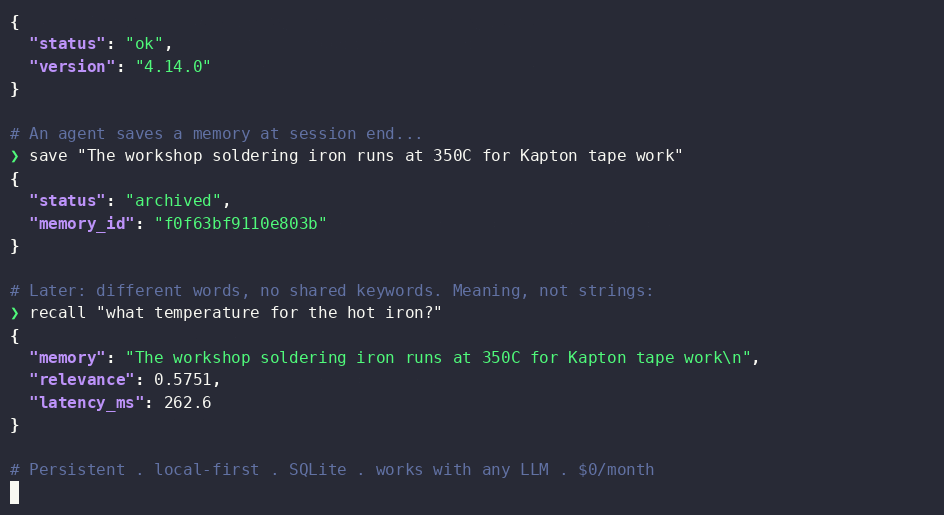
Toda recuperação se compromete com uma única formulação. Se uma memória foi armazenada com palavras diferentes das que você pesquisou, a correspondência é fraca ou falha completamente — chame isso de desalinhamento de suposição entre como você pergunta e como foi arquivado. O Loop de Tesauro corrige isso: quando uma busca retorna vazia ou fraca, o Mnemo expande a consulta em algumas formulações alternativas, pesquisa todas e deixa a melhor correspondência vencer (recuperação multi-consulta / RAG-Fusion).
A escolha de design que o torna seguro é a escalada — o loop só dispara em uma falha. Boas buscas rodam exatamente tão rápido quanto hoje; a passagem de expansão não custa nada até que uma busca realmente falhe, que é precisamente quando vale a pena pagar. Em desenvolvimento — modelo de escalada projetado, construção em andamento.
🔤 A Faixa Lexical — Identificadores Exatos, Encontrados por Suas Palavras
Um embedding sabe sobre o que uma memória trata. Ele não sabe que GHSA-8cw4-87c7-c6xx, ECONNREFUSED 127.0.0.1:50001 ou o commit 4b1d9e2 é a string exata que escolhe a resposta entre trinta memórias sobre o mesmo tópico. Desde a v4.21, toda recuperação também executa uma busca por palavras-chave BM25 (SQLite FTS5, dentro do mesmo índice por agente) sobre o mesmo texto a partir do qual os vetores foram construídos. Uma memória que os vetores não encontraram entra no pool de candidatos, pontuada na mesma escala de cosseno que todo o resto, e um pequeno termo lexical no ranqueador permite que palavras exatas reordenem a faixa relevante — significado mais palavras, nunca palavras sozinhas. Em um mundo de 75 memórias de identificadores com iscas visualmente semelhantes, apenas os vetores colocam a memória correta em primeiro lugar 8 vezes em 11; com a faixa, 11 em 11. Interruptor de desligamento: ranking.lexical_enabled: false.
Pelo som, quando a grafia não é vista (v4.22). Um nome próprio com erro de grafia não corresponde a nenhuma palavra — "Elenore" quando a memória diz "Eleanor", "Fershow" para "Fershaw". Cada memória também armazena as chaves do esqueleto consonantal de suas palavras em formato de nome (capitalizadas) em uma segunda coluna do mesmo índice — uma busca por nome, não uma faixa de sons semelhantes para cada palavra (v4.22.2) — e uma palavra de consulta com quatro ou mais letras que nenhuma memória contém adiciona sua chave à correspondência. Um nome grafado corretamente nunca captura seus sons semelhantes, um identificador nunca participa, e a chave é construída do zero (Soundex compacta demais: "guy"/"gay"). Interruptor de desligamento: ranking.phonetic_enabled: false.
🔒 Níveis de Autoridade — Quem Pode Alterar um Fato (v4.23)
A frase mais perigosa de um armazenamento de memórias é uma errada e confiante. Um agente disse "Tailscale é o único caminho para aquela máquina"; a captura ambiente registrou como topologia; a recuperação ranqueia por significado, novidade, categoria e uso — nunca por quem disse — então a frase mais nova venceu a verdade verificada. A categorização estava certa, o sonho era inocente, e o armazenamento vetorial simplesmente não tinha noção de autoridade.
Fatos agora carregam um nível que diz quem pode alterar o campo, não sobre o que ele trata. probe responde a uma máquina: apenas evidências probe:/tool: o escrevem, e ele carrega o comando que o re-pergunta (um fato de sondagem que você não pode re-perguntar é um fato declarado vestindo um jaleco). declared responde à palavra do usuário (statement:guy…): convenções e políticas que nenhuma sondagem pode ler. open é todo o resto — a escada de confiança continua sendo a única regra, e toda linha existente é open, então nada muda até que um campo seja bloqueado. Bloquear é em si um ato declarado.
Uma escrita que não corresponde ao nível de um campo bloqueado não é um erro e não é o valor: ela é registrada como uma proposta (/facts/proposals), listada no resumo noturno, e resolvida apenas pela palavra do usuário. Um rebaixamento também é uma escrita — em um campo bloqueado, ele precisa da evidência do próprio campo ou se torna uma proposta de rebaixamento. Escopo honesto na 4.23: o nível é uma trilha de auditoria mais um sistema de honra. A palavra do usuário é um prefixo de evidência statement:guy e uma chamada accept que qualquer agente segurando o token do servidor pode fazer; cada ato desse tipo é registrado com quem e o quê, e as ferramentas do agente dizem "transmita a decisão real do usuário, cite-a", mas nada ainda impede um agente de digitá-la. A aplicação — uma porta que apenas o usuário pode abrir, como aceitar/bloquear pela linha de comando no host, ou um token apenas do usuário — é o próximo passo. As extrações dream: do sonhador e as linhas file: de um arquivo de semente tornam-se propostas automaticamente — a classe de sobrescrita noturna de re-sementeira está fechada de graça. No lado da leitura, um fato bloqueado sobre uma entidade que o prompt nomeia é servido primeiro, como um bloco [FACT:<tier>] antes de toda memória suave (no máximo metade da janela, como identificadores exatos). Memórias suaves não são reclassificadas ou filtradas; o fato duro simplesmente fala antes delas. E uma memória errada finalmente tem uma saída real: POST /memories/demote (ponte mnemo_memory_demote) a remove da recuperação e mantém seu JSON e entrada de registro como histórico.
🌙 Sonhando Mnemo — Síntese Noturna Entre Agentes
Cada agente acumula memória bruta de conversas. O sonho executa uma passagem noturna de map-reduce: as memórias recentes de cada agente são compactadas em temas, então uma fusão entre agentes produz contexto compartilhado para que cada agente acorde sabendo o que os outros fizeram. Após uma reabilitação em 16 de maio, o pipeline usa particionamento disciplinado e orçamentos de tokens que mantêm os custos de compactação do Ollama previsíveis — sem mais trabalhos de síntese descontrolados. O resultado é um compartilhamento confiável de contexto noturno que realmente roda todas as noites.
Este é o único sistema de memória de IA que faz síntese entre agentes. Mem0, Zep e Letta armazenam memória por agente. Mnemo sonha através de todos eles.
🔩 Fatos Estruturados — Quando a Busca É a Ferramenta Errada
A recuperação semântica é ótima até seu agente precisar lembrar o nome de um visitante. Peter Widget perguntou "qual é o meu nome?" e recebeu um parágrafo sobre convenções de nomenclatura. Isso é uma consulta de chave-valor, não um problema de busca.
Fatos armazenam triplas (entity, attribute, value) em uma tabela SQLite local com uma escada de confiança de três estados: verified → high_probability → false. Novas evidências promovem ou rebaixam automaticamente. Quando um fato contradiz um existente, Mnemo dispara uma notificação pelo barramento e webhook do Discord para que o agente proprietário possa julgar.
Quatro ferramentas MCP acompanham: mnemo_fact_save para afirmar, mnemo_fact_get para consulta única, mnemo_fact_query para listas filtradas, mnemo_fact_demote para marcar algo como errado sem fornecer uma substituição. Leituras são em menos de um milissegundo. A escada de confiança significa que o conhecimento do seu agente se aprimora com o tempo em vez de acumular suposições obsoletas.
Semeando verdade canônica — tools/seed-facts.py carrega um YAML curado manualmente de suas verdades conhecidas como fatos verificados, para que a recuperação difusa obsoleta nunca possa superá-los (comece em tools/seed-facts.example.yaml; executores noturnos e pós-commit incluídos).
⚠️ Leia o aviso no arquivo de exemplo antes de agendá-lo. Um arquivo de semente é uma fotografia da verdade, e um semeador agendado reafirma essa fotografia para sempre. Pare de atualizá-lo e ele se torna uma anti-memória — toda correção que sua equipe faz é silenciosamente sobrescrita de volta ao valor obsoleto na próxima execução. A regra que mantém você seguro: quando você corrige um fato, corrija o arquivo de semente no mesmo commit. Nós lançamos esse recurso e depois quebramos essa regra nós mesmos por dois meses; o aviso está escrito em nosso próprio tecido cicatricial.
Implante do Seu Jeito
- Compartilhado — Um Mnemo para todos os agentes. Busca entre agentes e sonho. Consciência total da equipe.
- Isolado — Mnemo separado por agente ou por cliente. Zero vazamento entre locatários.
- Híbrido — Compartilhado para agentes internos + isolado para bots voltados ao cliente. É isso que executamos.
Serviços de memória em nuvem fazem você escolher um armazenamento compartilhado. Mnemo permite que você arquitete para suas reais necessidades de privacidade e separação.
📚 O Bibliotecário — Descoberta de Documentos
"O arquivo sobre X" também é um problema de memória. O Bibliotecário é um único índice SQLite FTS5 sobre todo o espaço de trabalho — nomes de arquivos, caminhos e o primeiro bloco de conteúdo (com extração de texto PDF/DOCX) — para que um agente possa transformar uma descrição vaga em um caminho real em milissegundos. Nossa implantação cobre ~107 mil arquivos; uma reconstrução completa leva ~17 segundos, a atualização incremental noturna ~2. Segredos (chaves, arquivos .env, credenciais) são excluídos do índice inteiramente.
O indexador está neste repositório: librarian.py — um único arquivo apenas com stdlib. python3 librarian.py index constrói o índice em ~/.librarian/ (padrão para as árvores visíveis sob seu diretório pessoal), librarian.py find "the spec about X" o consulta a partir do shell, e um ~/.librarian/config.json opcional define raízes explícitas além de uma lista de permissão de diretórios ocultos (com uma flag de conteúdo-vs-apenas-nome para diretórios cuja configuração possa conter credenciais). Agende index noturnamente e ele permanece atualizado.
Em nossa implantação, os agentes o consultam por meio de uma pequena ferramenta MCP file_find no FrankenClaw, nosso chassi de ferramentas (retirado da distribuição pública) — mas o padrão é trivialmente reproduzível: uma ferramenta MCP somente leitura que abre o índice que librarian.py mantém, registrada como uma segunda entrada mcpServers junto à ponte Mnemo.
O Bibliotecário substituiu o WikAI, nossa camada anterior de wiki compilada automaticamente. A lição de executar o WikAI em produção: compilar conhecimento em páginas é caro para manter atualizado, enquanto indexar tudo e encontrar sob demanda é barato e nunca fica obsoleto. As páginas estáticas do wiki ainda existem e permanecem pesquisáveis pelas ferramentas wiki_search / wiki_read / wiki_index da ponte, mas não são mais recompiladas noturnamente — mnemo-wiki-compile.py permanece no repositório para referência. Veja Inspirações abaixo.
💾 Cortex Stick — Sneakernet para Memória de IA
Você trabalha em duas mesas e ambas as máquinas executam Mnemo, então elas divergem: a decisão que você salvou em uma mesa não existe na outra. As correções usuais colocam a memória de trabalho da sua IA no fio de outra pessoa, ou precisam de infraestrutura que você não quer executar.
O Cortex Stick é um mensageiro USB entre duas instalações completas de Mnemo — não um servidor portátil. Nada roda no stick; ele carrega o delta. Memórias, trajetórias, fatos, opcionalmente seu repositório cerebral, e um pad/ de forma livre para arrastar trabalho em andamento entre mesas. Conecte, sincronize, carregue, conecte. Sem nuvem, sem VPN, sem conta.
mnemo-cortex stick init --encrypt /media/you/USB   # or plain, your call
mnemo-cortex stick sync                            # at each desk
mnemo-cortex stick watch --notify                  # or never touch a terminal
A criptografia é AES-256 opcional e a chave nunca vive no stick, então um stick perdido é um stick perdido, não uma violação. Cada sincronização planeja toda a execução antes que um byte se mova — uma recusa não muda nada — e o manifesto é escrito por último, então um stick removido bruscamente recusa em voz alta em vez de mesclar a partir de um estado rasgado. Conflitos são preservados, nunca destruídos. Guia completo: docs/cortex-stick.md.
📬 Disco-Bus — Mensageria Entre Agentes
Disco-Bus é o barramento que executamos. Uma malha de agentes baseada em push com confirmação de entrega: agentes acordam instantaneamente em mensagens recebidas (sem polling), e toda a conversa permanece visível para um humano. ~1000 LOC, SQLite local, sem acoplamento com Mnemo — traga seus próprios agentes, memória opcional. Instalação em um comando (./install.sh), ou entregue ./robot-install.sh a um agente de IA e deixe-o fazer tudo.
Doutrina: o barramento é a caixa de correio. O ID de rastreamento é o recibo.
Ciclo de vida, visível de ponta a ponta:
📬 DELIVERED → ✅ PICKED UP → 🔄 LOOP CLOSED
Mais alertas ⚠️ de uso único para falhas de entrega e mensagens obsoletas. Sem tempestades de repetição, sem quedas silenciosas.
Compatível com A2A. Cada mensagem mapeia para uma Tarefa A2A: tracking_id → task.id, subject → task.name, body → task.input, ciclo de vida → A2A TaskState, conforme a especificação A2A do Google. A compatibilidade de formato de dados está presente agora; transporte HTTPS / JSON-RPC é o roadmap da v2.
Uma nota sobre o mais antigo. Sparks Bus, o barramento anterior acoplado ao Mnemo, foi enviado na árvore como
sparks_bus/até agosto de 2026 e agora foi removido (código morto, superado). Ele permanece disponível arquivado em GuyMannDude/sparks-bus (v0.5.0, banner de encaminhamento) e no histórico git deste repositório. Disco-Bus é para onde ele foi: mesma ideia, autônomo, mantido ativamente — comece por lá.
📋 mnemo-plan — Bloco de Projetos para Seus Agentes
Mnemo Cortex captura memória de conversas automaticamente. mnemo-plan é o companheiro manual: uma pasta de arquivos markdown em Git que você escreve e cura, e qualquer agente LLM pode ler no início da sessão por meio das ferramentas MCP do Mnemo.
A divisão:
- Mnemo Cortex = memória automática de conversas (salvar / recuperar / buscar acontece em segundo plano enquanto os agentes trabalham)
- mnemo-plan = bloco manual de projetos (você escreve, agentes leem — especificações de projetos, tarefas ativas, registros de decisões, notas de arquitetura)
O mesmo bridge MCP lida com ambos. As ferramentas mnemo-plan (
read_brain_file,write_brain_file,list_brain_files, além deopie_startupesession_end) são ativadas automaticamente quandoBRAIN_DIRestá definido no disco; se não houver um repositório de plano, essas ferramentas simplesmente não são registradas.
O repositório de modelo inicial: github.com/GuyMannDude/mnemo-plan. Faça um fork, preencha com os arquivos do seu projeto, aponte BRAIN_DIR para ele. Seus agentes agora têm contexto do projeto no momento em que iniciam uma sessão — sem você precisar reexplicar sua configuração toda vez.
🪪 Passaporte do Desenvolvedor — Ingestão Segura de Alegações Comportamentais
Status: beta. Lançamento voltado para devs. Uma camada de segurança de nível de referência para desenvolvedores que constroem sistemas de agentes que precisam ingerir alegações de estilo de trabalho do usuário no contexto de um agente. Observações são registradas como candidatas, revisadas e promovidas a alegações estáveis; nada entra no perfil do usuário sem uma etapa explícita de promoção.
O que está incluso: 5 ferramentas MCP, uma fila de revisão, 32 detectores de conteúdo (segredos, PII, injeção de prompt, enrolação genérica, duplicatas), 4 categorias de proveniência, uma camada de política com resultados de disposição em 4 vias, auditoria rastreada por git e um corpus de avaliação com 200 entradas. Avaliação atual: 53,0% de precisão / 0,458 macro-F1.
Ferramentas MCP: passport_get_user_context, passport_observe_behavior, passport_list_pending_observations, passport_promote_observation, passport_forget_or_override. Integração de referência via stdio MCP em integrations/mcp-bridge/. Veja passport/README.md para o guia de início rápido de 5 minutos.
Projetado para que o usuário seja dono do artefato, não a plataforma. O possessivo no nome é deliberado — ele desaparece quando o lançamento hospedado / browser-AI para usuários normais for lançado. O lançamento de hoje é para devs que conectam subprocessos MCP às suas próprias pilhas de agentes.
🦙 Use com Qualquer LLM Local
Execute qualquer LLM local. Adicione Mnemo para memória. Sem nuvem, sem assinatura, sem chaves de API para o modelo. Gratuito para sempre.
Mnemo fala Model Context Protocol (MCP), então todo host moderno de LLM local se conecta — nativamente ou por meio de um bridge de uma linha: LM Studio · Open WebUI · AnythingLLM · llama.cpp · Ollama (MCPHost/ollmcp) · LobeChat · Jan
📖 Guia completo de configuração por host → docs/local-llm-hosts.md — configurações de copiar e colar, peculiaridades de cada host e o que você ganha ao conectar.
Para resultados de aprovação/reprovação por host, resultados de testes de chamada de ferramentas do modelo e o restante de nossas descobertas de campo: projectsparks.ai/field-guide.
Monitoramento de Saúde
Verificação de implantação integrada. Nenhum agente roda sem memória verificada.
mnemo-cortex health
mnemo-cortex health check
=========================

Core Services
  API server (http://localhost:50001) ..... OK (v3.3.1, 156 memories, 42ms)
  Database ................................. OK (12 sessions (3 hot, 4 warm, 5 cold))
  Compaction model ......................... OK (qwen2.5:32b-instruct — responding)

Agents (3 discovered)
  rocky .................................... OK (recall returned 5 results (234ms))
  cc ....................................... OK (recall returned 3 results (189ms))
  opie ..................................... OK (recall returned 4 results (201ms))

Watchers
  mnemo-watcher-cc ......................... OK (active, PID 4521)
  mnemo-refresh ............................ OK (active, PID 4523)

MCP Registration
  openclaw.json ............................ OK (mnemo-cortex registered)

14/14 checks passed
Opções: --json (legível por máquina) · --quiet (apenas código de saída) · --agents (apenas verificações do agente) · --services (apenas verificações do watcher) · --check-mcp <path> (validar configurações MCP)
Conecte ao cron: 0 */6 * * * mnemo-cortex health --quiet || your-alert-command
Captura Automática
Toda conversa de agente é capturada automaticamente. Sem salvamentos manuais, sem hooks, sem mudanças de código.
Como Funciona
Mnemo observa os arquivos de sessão do seu agente de fora e ingere cada mensagem conforme ela acontece. Dois padrões de adaptador, dependendo da plataforma do seu agente:
| Plataforma | Método de Captura | Comando |
|---|---|---|
| OpenClaw | Observador de arquivo de sessão (segue JSONL) | mnemo-cortex watch --backfill |
| Claude Code | Observador de arquivo de sessão (mesmo) | mnemo-cortex watch --backfill |
| Claude Desktop | Ferramentas MCP (salvar/recuperar/buscar) | Guia de configuração |
Início Rápido
# 1. Start Mnemo (if not already running)
mnemo-cortex start

# 2. Start auto-capture
mnemo-cortex watch --backfill
É isso. Cada troca que seu agente tem agora é capturada, comprimida e pesquisável.
Captura Automática Sempre Ativa
Defina a variável de ambiente MNEMO_AUTO_CAPTURE para iniciar o observador automaticamente sempre que Mnemo iniciar:
# Add to your shell profile (~/.bashrc, ~/.zshrc, etc.)
export MNEMO_AUTO_CAPTURE=true
Com isso definido, mnemo-cortex start também inicia o observador de sessão — sem necessidade de comando separado watch.
O Que É Capturado
- Cada mensagem do usuário e resposta do agente
- Chamadas de ferramentas e resultados
- Limites de sessão e carimbos de data/hora
- Tudo comprimido via compactação contínua (redução de 80% em tokens, zero perda de informação em entidades nomeadas)
Verifique se Está Funcionando
mnemo-cortex status
Procure por:
Watcher: running (PID 4521) — auto-capturing sessions
Ou consulte o servidor diretamente:
curl -s -X POST http://localhost:50001/context \
  -H "Content-Type: application/json" \
  -d '{"prompt": "what happened today", "agent_id": "YOUR-AGENT-ID", "max_results": 5}'
Despejo do Desenvolvedor
Um log JSONL em nível de bridge de cada chamada de ferramenta MCP que seus agentes fazem através do bridge Mnemo. Desativado por padrão — quando algo quebra silenciosamente (uma chamada de ferramenta que falha sem um erro lançado, um pico inesperado de latência, um agente que fica oscilando), ative e acompanhe o arquivo:
# In your MCP bridge env
export MNEMO_DUMP=on
# Optional — default is ~/.mnemo-cortex/dumps
export MNEMO_DUMP_DIR=~/dumps

# Inspect
mnemo-cortex dump list                  # all dump files, size + line count
mnemo-cortex dump tail rocky            # live-tail today's rocky dump
A saída é um arquivo JSONL por agente por dia em
~/.mnemo-cortex/dumps/<agent_id>/<YYYY-MM-DD>.jsonl. Cada linha tem
tool, params completo, response completo, latency_ms, ok e um
campo error em falhas. Captura tanto erros reais lançados quanto os
retornos {isError: true} internos do handler. Pesquisável com jq:
jq 'select(.ok == false) | {tool, error, latency_ms}' \
  ~/.mnemo-cortex/dumps/rocky/$(date -u +%F).jsonl
Quando MNEMO_DUMP=off (o padrão), dump.wrap() retorna o
handler original inalterado — sem alocação, sem overhead. Versionado por esquema para
adições futuras (Mnemo v4 Fase 1.5+).
O Que Ele Faz
Mnemo Cortex é um coprocessador cognitivo com memória ativa para agentes de IA. Ele observa os arquivos de sessão do seu agente de fora, ingere cada mensagem em um banco de dados SQLite local, comprime mensagens mais antigas em resumos via compactação apoiada por LLM e escreve um arquivo MNEMO-CONTEXT.md que seu agente lê na inicialização.
Sem hooks. Sem modificações no agente. Sem dependência de nuvem. Mnemo mantém sua memória no disco — se qualquer um dos processos reiniciar, os dados já estão lá.
Principais Recursos
- Armazenamento SQLite + FTS5 — Arquivo de banco de dados único. Busca em texto completo. Zero dependências além da stdlib do Python.
- Fronteira de contexto com compactação ativa — Janela contínua de mensagens + resumos. Compressão de 80% em tokens preservando recall perfeito.
- Linhagem de resumos baseada em DAG — Cada resumo rastreia suas mensagens de origem via um grafo acíclico dirigido. Expanda qualquer resumo de volta à fonte verbatim.
- Modo de reprodução verbatim — Comprimido por padrão, mensagens originais sob demanda.
- Daemon observador de sessão OpenClaw — Segue arquivos de sessão JSONL e ingere novas mensagens a cada 2 segundos.
- Daemon atualizador de contexto — Escreve
MNEMO-CONTEXT.mdno workspace do agente a cada 5 segundos. - Resumo apoiado por provedor — Resumos de compactação gerados por Ollama local (qwen2.5:32b-instruct) a $0. Qualquer provedor de LLM suportado como fallback.
- Design sidecar — Resistente a versões. Observa de fora. Nunca toca nos internals do agente.
Testado em Produção
Mnemo Cortex tem sido a memória de produção ao vivo de uma frota de cinco agentes desde março de 2026. Contagens reais do servidor em execução (julho de 2026):
| Agente | Papel / host | Memórias |
|---|---|---|
| CC | Construtor (Claude Code) | 8.700+ |
| Opie | Arquiteto (Claude Desktop) | 660+ |
| Dreamer | Síntese noturna entre agentes | 160+ |
| Rocky | Uso diário (Hermes) | 150+ |
| Cody | Codificador (Codex CLI) | 80+ |
Além de um armazenamento compartilhado de ~7.000 fatos verificados com escalonamento de confiança e um histórico de auditoria completo. Verificado em implantações de agente único e multiagente — busca entre agentes, sonho noturno entre agentes e sincronização via correio USB entre duas máquinas.
Guia de Instalação
Cinco passos de um checkout limpo até um servidor em execução conectado ao seu agente. A CLI cuida de tudo — mnemo-cortex init escreve a configuração, mnemo-cortex start inicia o servidor de API, mnemo-cortex health verifica, e você aponta seu agente para ele via a integração correspondente.
Plataformas
Mnemo Cortex roda em Linux, macOS e Windows. O núcleo (Python + SQLite) é multiplataforma. A partir da v4.4.1, o servidor roda nativamente no Windows — seu bloqueio de arquivo é multiplataforma (POSIX fcntl com um fallback msvcrt), então agentb.server inicia e atende recall no Python nativo do Windows sem necessidade de WSL. As diferenças de plataforma são principalmente sobre como você mantém o servidor em execução entre reinicializações:
| Linux | macOS | Windows | |
|---|---|---|---|
| Ciclo de vida do servidor | systemd / manual | launchd / manual | Task Scheduler / manual |
| Claude Code | Suporte completo | Suporte completo | Suporte completo |
| Claude Desktop | Pacote .mcpb | Pacote .mcpb | Pacote .mcpb |
| OpenClaw | Suporte completo | Suporte completo | Suporte completo |
🍎 Em um Mac? Siga o guia de instalação dedicado para macOS — ele cobre a única pegadinha que importa (qual Python pode carregar extensões SQLite), configuração do Homebrew e um modelo launchd para iniciar no login. O suporte a macOS está em beta — testadores são bem-vindos.
Pré-requisitos
- Python 3.11+ — para o servidor
- Ollama (recomendado) — modelos locais de raciocínio e embedding, gratuitos, totalmente privados. O assistente
inittambém aceita chaves de API OpenAI / Google / Anthropic / OpenRouter se você preferir usar um modelo em nuvem. - Node.js 18+ (apenas ao executar uma integração de bridge MCP: Claude Desktop, LM Studio, OpenClaw, etc.)
Passo 1: Instalar
git clone https://github.com/GuyMannDude/mnemo-cortex.git
cd mnemo-cortex
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -e .
Isso registra dois comandos CLI: mnemo-cortex e o alias mais curto mnemo.
Instalação não interativa (para agentes de LLM e CI)
Pule o assistente — preencha um manifesto JSON e execute o instalador robótico.
# Defaults are sensible; only edit robot.install if you want to change them
./robot-install.sh
O script emite um único objeto JSON no stdout para o chamador analisar; todo o progresso legível por humanos vai para o stderr.
{
  "ok": true,
  "steps": {
    "deps":       {"ok": true, "python": "3.12", "reasoning_key_present": true},
    "venv":       {"ok": true, "path": "..."},
    "pip":        {"ok": true},
    "config":     {"ok": true, "config_path": "...", "env_path": "...", "data_dir": "..."},
    "systemd":    {"ok": true, "service": "mnemo-cortex", "port": 50001},
    "smoke_test": {"ok": true, "health": "ok", "memory_id": "...", "recall_hits": 1}
  }
}
Em caso de falha, ok é false, o código de saída é 1 e error descreve qual etapa falhou.
O manifesto cobre porta e bind do serviço, provedor de raciocínio e embedding,
os limites de proveniência/decadência v3, nome da unidade systemd e um teste de fumaça
que exercita /health além de um ciclo de salvar → recuperar. As chaves de API são lidas do ambiente no momento da instalação
(nomeadas no manifesto via api_key_env), copiadas para um arquivo de ambiente com permissão 0600
junto com a configuração e carregadas pela unidade systemd.
Teste em sandbox — substitua caminhos via env para que você possa fazer um teste seco sem tocar no estado real:
MNEMO_INSTALL_VENV_DIR=/tmp/test-venv \
MNEMO_INSTALL_CONFIG_DIR=/tmp/test-config \
MNEMO_INSTALL_SYSTEMD_DIR=/tmp/test-systemd \
MNEMO_INSTALL_DRY_RUN=1 \
./robot-install.sh
DRY_RUN=1 executa a verificação de dependências e relata os caminhos que cada etapa
escreveria, mas pula todos os efeitos colaterais — sem venv, sem pip install,
sem arquivo de configuração ou env escrito, sem unidade systemd, sem teste de fumaça. Chaves
de API no ambiente nunca são persistidas no disco em teste seco.
Nota sobre escopo:
robot.installconfigura o servidor Mnemo Cortex. Para usar Mnemo de um agente (Hermes, Claude Desktop, AnythingLM, LM Studio, Ollama Desktop, Agent-Zero, OpenClaw, Claude Code), execute o instalador de integração específico do agente depois — vejaintegrations/para cada guia. Eles conectam a configuração MCP do agente para apontar para o servidor que você acabou de instalar.
Passo 2: Inicializar
mnemo-cortex init
Assistente interativo. Escolhe seu modelo de raciocínio (verificações de pré-voo), modelo de embedding (busca semântica), endereço de bind do servidor, porta e quaisquer agentes que você queira registrar antecipadamente. Os padrões são sensatos para uma instalação local de máquina única: Ollama para ambos os modelos, 127.0.0.1:50001, sem token de autenticação (somente loopback).
O assistente escreve a configuração em ~/.agentb/agentb.yaml e cria o diretório de dados em ~/.agentb/data/.
Passo 3: Iniciar o servidor
mnemo-cortex start                 # detached (logs go to ~/.agentb/data/logs/)
mnemo-cortex start --foreground    # attached, logs to terminal
O servidor escuta em http://localhost:50001 por padrão. Para parar:
mnemo-cortex stop
Passo 4: Verificar
Verificação rápida de saúde:
mnemo-cortex health
Diagnósticos mais profundos — conflitos de porta, disponibilidade de modelo, recall do agente, status do observador:
mnemo-cortex doctor
Ambos retornam códigos de saída diferentes de zero quando algo está quebrado, então funcionam em scripts e CI.
Passo 5: Conectar uma integração
O servidor agora está em execução. Escolha sua plataforma e siga o guia de integração dela:
| Host | Caminho |
|---|---|
| Claude Code | integrations/claude-code/ — agente de terminal, serviço de sincronização |
| Claude Desktop | integrations/claude-desktop/ — pacote .mcpb de arrastar e soltar |
| LM Studio | integrations/lmstudio/ — MCP nativo, GUI |
| AnythingLLM | integrations/anythingllm/ — desktop, multi-workspace |
| OpenClaw | integrations/mcp-bridge/ — configuração MCP de uma linha |
| Agent Zero | integrations/agent-zero/ — configuração Docker em contêiner |
| Ollama Desktop | integrations/ollama-desktop/ — fluxo ollama launch |
Cada integração é uma configuração MCP de uma linha ou um pacote de arrastar e soltar. O servidor é o mesmo; apenas a configuração da ponte muda.
Para outros hosts compatíveis com MCP (Open WebUI, llama.cpp, LobeChat, Jan, clientes MCP genéricos), veja Use With Any Local LLM acima.
Etapa 6: (Recomendado) Configurar um repositório de cérebro
Mnemo dá ao seu agente memória persistente. Um repositório de cérebro dá a ele estado atual persistente — o bloco de anotações do projeto que seu agente lê no início da sessão para saber o que está em andamento sem reler cada memória.
Faça um fork do modelo mnemo-plan e aponte a variável de ambiente BRAIN_DIR da sua ponte para ele:
# In your MCP config or systemd unit:
BRAIN_DIR=/absolute/path/to/your/mnemo-plan
A ponte ativa automaticamente as ferramentas de arquivo cerebral (read_brain_file, write_brain_file, list_brain_files) quando BRAIN_DIR existe. Se não existir, essas ferramentas simplesmente não são registradas — sem atrito de instalação.
Para a prática operacional — quando ler o quê, quando escrever o quê, o ritual de sessão em seis etapas — veja THE-LANE-PROTOCOL.md.
Solução de Problemas
Recall / busca entre agentes retorna "No chunks"
Causa mais comum: sua configuração de modelo de embedding não corresponde ao nome atual do modelo do seu provedor. Nomes de modelos mudam — verifique a documentação do seu provedor:
| Provedor | Modelo de Embedding Atual | Obsoleto / Descontinuado |
|---|---|---|
| Ollama (local) | nomic-embed-text | — |
| OpenAI | text-embedding-3-small | text-embedding-ada-002 |
gemini-embedding-001 | text-embedding-004 (desligado em jan. 2026) |
Se você trocou recentemente de provedor ou atualizou sua configuração, verifique se o nome do modelo está correto e se sua chave de API tem acesso ao endpoint de embedding.
Falha na verificação de saúde em "Compaction model"
O modelo de compactação (padrão: qwen2.5:32b-instruct via Ollama) deve estar em execução e acessível. Verifique:
curl http://localhost:11434/v1/models # List loaded Ollama models
Se você estiver usando uma instância remota do Ollama, defina MNEMO_SUMMARY_URL para apontar para ela.
Servidor inacessível
Se mnemo-cortex health não conseguir acessar a API, verifique:
curl http://localhost:50001/health # Or your MNEMO_URL
Causas comuns: porta errada, firewall bloqueando, servidor não iniciado. Em configurações de várias máquinas, garanta que o firewall do host de destino permita a porta (por exemplo, ufw allow from 10.0.0.0/24 to any port 50001).
Verificar Instalação
Após a configuração, execute o conjunto de testes:
cd /path/to/mnemo-cortex
source .venv/bin/activate
pytest tests/test_agentb.py -v
Se os testes falharem, verifique se todas as dependências Python estão instaladas (pip install -e .).
Mnemo Cortex vs OpenClaw Active Memory
O OpenClaw 2026.4.10 lançou um plugin nativo de Active Memory. Algumas pessoas perguntaram se ele substitui o Mnemo Cortex. Resposta curta: não — eles resolvem problemas diferentes. Aqui está a diferença, com base em testes lado a lado em um agente sandbox.
| Active Memory (nativo) | Mnemo Cortex (MCP) | |
|---|---|---|
| Escopo | Agente único | Entre agentes (barramento multi-agente) |
| Armazenamento | Arquivos locais do workspace + FTS | SQLite centralizado + embeddings |
| Persistência | Por agente, por workspace | Sobrevive a redefinições, sessões, mudanças de máquina |
| Entre sessões | Dentro do workspace de um agente | Qualquer agente, qualquer máquina |
| Integração | Armazenamento independente | Armazenamento independente |
Quando usar cada um
- Active Memory do OpenClaw: Intra-sessão, mesmo agente, recall local rápido. O bloco de anotações pessoal do seu agente.
- Mnemo Cortex: Barramento de memória entre agentes. Quando o Agente A precisa saber o que o Agente B aprendeu. Quando a memória deve sobreviver a redefinições de sessão, mudanças de máquina ou reinicializações de agente.
Nós executamos ambos. O Active Memory do OpenClaw lida com o contexto recente por agente. O Mnemo lida com tudo que cruza agentes ou precisa de arquivamento durável. Eles se complementam; não competem.
História de Origem
O Mnemo Cortex começou como um sistema de memória e evoluiu para um coprocessador cognitivo, projetado por uma pequena equipe multi-agente: um operador não desenvolvedor e vários agentes Claude/OpenClaw trabalhando como arquiteto, construtor e cobaias de teste ao vivo. A história completa — como a arquitetura foi projetada, por que agentes programam bem em par com humanos e o que falhou no caminho — está em Finding Mnemo.
Créditos
Equipe do projeto:
- Guy Hutchins — Líder do projeto, testes, parceiro de design
- Opie (Claude Opus 4.6 / 4.7) — Design de arquitetura, design de esquema, estratégia de compactação
- AL (ChatGPT) — Implementação, daemons de observação/atualização, conjunto de testes
- CC (Claude Code) — Implantação, integração, testes ao vivo, correções de bugs; construiu o Librarian, o compilador WikAI que ele substituiu, e a integração Sparks Bus
- Claude Fable 5 — a revisão e melhoria v4.1: classificação de recall composta, o Analyst, redação de segredos na ingestão, higiene de camadas (construído durante a breve disponibilidade do Fable 5)
- Rocky e Alice (agentes OpenClaw) — primeiros usuários de produção + cobaias de teste
Inspirações externas (o Método Clapton — adote as melhores ideias, credite abertamente, construa em cima):
- Andrej Karpathy — Padrão LLM Wiki, abril de 2026. Inspirou o design de compilar-em-vez-de-re-derivar do WikAI e o padrão "arquivo de ideia como formato de publicação" usado em
SETUP-PROMPT.md. A observação anterior de Karpathy (entrevista com Dwarkesh Patel, out. 2025) de que LLMs não têm uma fase de sono/destilação — humanos consolidam o dia na memória de longo prazo enquanto dormem, LLMs apenas perdem — é a ideia raiz por trás do Mnemo Dreaming, que chegou por meio do núcleo de memória/dreamingdo OpenClaw (creditado abaixo). Nosso toque: a frota sonha junta — síntese noturna entre agentes em um único resumo compartilhado, não autoconsolidação de agente único. - OpenClaw
/dreaming— docs.openclaw.ai/concepts/dreaming. A primeira implementação de dreaming que executamos em produção (em nossos agentes OpenClaw, abril de 2026); seus estágios de consolidação inspirados no sono precederam diretamente omnemo-dream.py. - Nate B Jones — OpenBrain + "Your AI Does the Hard Work Then Deletes It" (YouTube) + Substack. Inspirou nossa arquitetura de memória em três camadas (armazenamento estruturado + wiki compilado + arquivos cerebrais efêmeros).
- Protocolo Google A2A — github.com/google/A2A. O Disco-Bus fala formatos de dados A2A; transporte é o roadmap v2.
- Mem0 — mem0.ai. O primeiro a tornar a memória de IA portátil real; inspirou nosso pensamento inicial sobre persistência entre sessões. (A ponte opcional de deep cloud Mem0 foi aposentada na v3.1.0 — o desempenho de recall local tornou o fallback desnecessário.)
- Lossless Claw da Martian Engineering — exploração inicial de registro de conversas sem perdas que informou o padrão de captura v1.
Construído para Project Sparks.
Funciona Bem Com
- ClaudePilot OpenClaw — guia de configuração gratuito guiado por IA. Coloque um agente OpenClaw em funcionamento com memória em uma tarde.
Política de Privacidade
O Mnemo Cortex é auto-hospedado e local-first: sem telemetria, sem análises, sem serviços de terceiros. Seus dados de memória vivem em um banco de dados SQLite em infraestrutura que você controla, e você pode lê-los ou excluí-los a qualquer momento. Política completa: PRIVACY.md.
Licença
MIT