llmtrim
Servidor MCP que comprime suas requisições de API de LLM para você pagar menos, sem alterar as respostas. Remove tokens desperdiçados de prompts, histórico, saída de ferramentas e código antes de serem enviados: -31% de entrada / -74% de saída, medido ao vivo.
Documentação
llmtrim
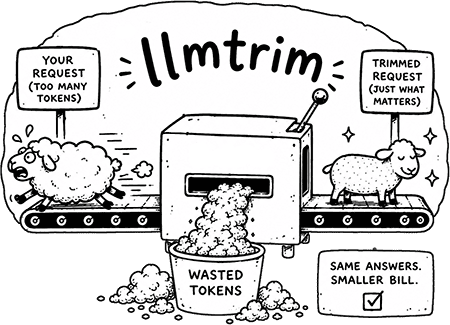
Proxy local que compacta o tráfego de API de LLMs para você pagar menos. Mesmas respostas, conta menor.
−31% entrada · −74% saída · −66% custo de ida e volta · 112 casos A/B ao vivo · ~5 ms/chamada · sem modelo para carregar
Usando Claude Code? Uma instalação também te dá /sub
para servir através do CLIProxyAPI.
Proxy · CLI · MCP · biblioteca (Python · Ruby · Swift · Kotlin · JS/WASM)



O que faz • Instalação • Dia a dia • Em ação • Funciona com • Claude Code • Números • Config • CLI & biblioteca
O que faz
Você usa Claude Code, Codex, Cursor ou seu próprio aplicativo. A cada turno, a ferramenta envia uma solicitação grande: prompt do sistema, ferramentas, histórico, saída bruta de comandos. Você paga por cada token disso, incluindo as partes que não ajudam o modelo.
Um log de build de 200 linhas com dois erros. Esquemas de ferramentas reenviados a cada chamada. JSON com centenas de linhas quase idênticas. Esse volume ainda é cobrado.
llmtrim fica na sua máquina como um proxy local, remove o desperdício e encaminha uma solicitação menor. A resposta não muda. Você mantém as mesmas ferramentas e respostas; gasta menos.
  before:  your tool ───── full request ─────▶  OpenAI / Anthropic / …
                    ◀──────── reply ──────────

  after:   your tool ──▶ llmtrim ──smaller──▶  OpenAI / Anthropic / …
                            (on your machine)
                    ◀──────── reply ──────────  (same answer)
A compactação não pode aumentar sua conta nem quebrar uma solicitação; o pior caso é zero de economia. Tudo roda localmente, nada é enviado para nós. Em ação →
Para Claude Code, a mesma instalação também conecta /sub para rotear sessões por outra assinatura. Detalhes →
Comece agora
npm install -g @llmtrim/cli@latest && llmtrim setup
# open a new terminal, then keep working
llmtrim status
É isso. setup inicia um proxy local e configura seu shell. Quando Claude Code está presente, também ativa /sub. Você não precisa de uma instalação separada para isso.
| Você quer | Execute |
|---|---|
| Primeira instalação | llmtrim setup |
| Nova versão | llmtrim update (depois llmtrim ensure após npm/brew/cargo) |
| Algo quebrado | llmtrim ensure · llmtrim doctor --fix · ou f em status |
Qualquer ferramenta que respeite
HTTPS_PROXYfunciona (Claude Code, Codex, Cursor, Aider, seu SDK). GitHub Copilot não funciona (fixação de certificado). Lista completa →
Outros instaladores (Homebrew, curl, Scoop, Cargo, Docker)
# Linux / macOS
curl -fsSL https://raw.githubusercontent.com/fkiene/llmtrim/main/install.sh | sh

# Windows (PowerShell)
irm https://raw.githubusercontent.com/fkiene/llmtrim/main/install.ps1 | iex

# Package managers
brew install fkiene/tap/llmtrim
cargo binstall llmtrim
scoop install llmtrim
docker run -d -p 43117:43117 -v llmtrim-state:/data ghcr.io/fkiene/llmtrim
Opções completas: INSTALL.md.
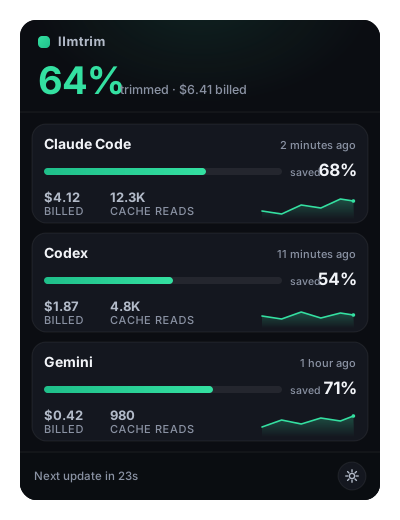
Bandeja da área de trabalho (menu bar / bandeja do sistema)
Popover na barra de menus / bandeja do sistema com os mesmos números de economia. Incluído no Homebrew, Scoop e npm; setup pode ativar abrir no login. Abra com llmtrim tray. Em desktops Linux, ensure interativo pode buscar o binário da bandeja na última versão (precisa de libwebkit2gtk-4.1 e libayatana-appindicator3).
Isso é seguro?
Mesma técnica do mitmproxy, limitada apenas a hosts de API de LLM. setup muda três coisas; llmtrim uninstall reverte todas as três:
- CA privada em
~/.llmtrim/(com restrição de nome; não pode interceptar seu banco ou e-mail) - Env do shell:
HTTPS_PROXY+ confiança na CA - Serviço de login: daemon no login
Nenhuma chave de API armazenada (a autenticação da sua ferramenta é encaminhada). Prompts nunca tocam o disco; apenas contagens anônimas de tokens. Resultados recuperáveis de ferramentas ficam em RAM limitada do daemon por cinco horas por padrão e desaparecem ao reiniciar. Modelo de ameaça completo: SECURITY.md.
llmtrim ca
openssl x509 -in ~/.llmtrim/ca.pem -noout -text | grep -A3 "Name Constraints"
Dia a dia
llmtrim status     # savings + health  (aliases: monitor, gain)
llmtrim update     # new release, restart daemon, refresh integrations
llmtrim ensure     # match the recommended install state on this machine
| Situação | Comando |
|---|---|
| Ver economia | llmtrim status |
Após upgrade de npm / brew / cargo | llmtrim ensure (ou f no status) |
| Diagnosticar | llmtrim doctor · repare com doctor --fix |
| Pausar / retomar proxy | llmtrim stop · llmtrim start |
| Forçar uma sessão pelo llmtrim | llmtrim wrap claude |
| Remover tudo | llmtrim uninstall |
Após setup, update ou ensure, o /sub do Claude Code permanece sincronizado com o binário.
Séries temporais: llmtrim status --daily · --weekly · --monthly · --json · --csv.
Em ação
Um agente executou um build. A ferramenta retornou 58 linhas; duas eram erros. Todas as 58 teriam sido cobradas.
4.662 caracteres → 978 (−79%). Erros permanecem verbatim. Linhas INFO repetidas se dobram em um template mais os valores (sem perda quando o intervalo é regular).
# before (noise + signal)
[2026-06-13T10:02:00Z] INFO  compiling module core::worker::task_0 (incremental)
… 28 more near-identical INFO lines …
[2026-06-13T10:02:31Z] ERROR src/worker/pool.rs:214: mismatched types: expected `usize`, found `i64`
… 25 more INFO lines …
[2026-06-13T10:03:01Z] ERROR src/net/conn.rs:88: cannot borrow `buf` as mutable more than once
[2026-06-13T10:03:02Z] INFO  build failed, 2 errors

# after (errors verbatim; INFO folded losslessly)
[{}] INFO compiling module core::worker::task_{} (incremental) [×30: (10:02:00Z..10:02:29Z step 1s; 0..29)]
[2026-06-13T10:02:31Z] ERROR src/worker/pool.rs:214: mismatched types: expected `usize`, found `i64`
[{}] INFO compiling module core::net::conn_{} (incremental) [×25: 10:02:32Z..10:02:56Z; 0..24]
[2026-06-13T10:03:01Z] ERROR src/net/conn.rs:88: cannot borrow `buf` as mutable more than once
[2026-06-13T10:03:02Z] INFO  build failed, 2 errors
Experimente com um corpo de solicitação seu:
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim compress --provider openai
A dobra de logs é um estágio. Outros entram em ação com diferentes desperdícios:
| Desperdício | O que acontece |
|---|---|
| Logs de build, diffs, dumps de grep | Mantém erros / mudanças / correspondências; dobra o resto |
| Contexto longo colado | Mantém trechos relevantes à pergunta |
| Código-fonte | Mantém corpos úteis; resto → assinaturas |
| Esquemas de ferramentas a cada turno | Apara + mantém o prefixo de cache estável |
| Arrays JSON enormes | Tabela compacta (TOON) ou amostra |
| Respostas verbosas do modelo | Pede saída mais concisa onde for seguro |
[!IMPORTANT] A compactação não pode aumentar sua conta nem quebrar uma solicitação. Cada estágio é re-medido com o tokenizador real do provedor e desfeito se não economizar tokens. Se o provedor rejeitar o corpo compactado, o original é reenviado. O pior caso é zero de economia.
Prefixos existentes de prompt-cache (cache_control) são deixados intactos. A modelagem recuperável de primeira chegada (llmtrim recall r_…) está desativada por padrão; a janela de saída de ferramentas na zona ativa ainda roda, e uma re-execução da mesma ferramenta é enviada por completo. Para pular a modelagem de um comando (stdout verbatim, incluindo um trailer de terminal), defina toolout_passthrough = ["*gpt.sh*"] ou prefixe o comando com LLMTRIM_TOOL_OUTPUT=passthrough. Linhas começando com LLMTRIM_KEEP: sobrevivem à janela mesmo quando o resto é cortado.
Todos os 10 compactadores
Os estágios rodam em ordem de economia. Nada sob um marcador cache_control é reescrito.
| Estágio | O que faz | Quando roda |
|---|---|---|
| saída-de-ferramenta | Dobra de template sem perda primeiro, depois janela de logs · diffs · grep · dumps até erros / mudanças / correspondências; recall opcional de primeira chegada pode restaurar resultados omitidos de limite de cache com llmtrim recall | resultados de ferramentas |
| disciplina de cache | Marca + estabiliza o prefixo invariante (ordena ferramentas/esquema · OpenAI prompt_cache_key) para permanecer em cache | ferramentas |
| recuperação lexical | Ranking BM25+ com feedback RM3 · cortes de tópico TextTiling · seleção orçada sem redundância; pergunta protegida | contexto longo |
| esqueletização | tree-sitter mantém corpos de funções relevantes, descarta o resto para assinaturas (14 linguagens) | código |
| serializar + higiene | Minifica JSON, codifica arrays de registros em TOON ou CSV, normaliza Unicode | sempre · sem perda |
| amostra json | Reduz amostragem de arrays grandes de registros: primeiro/último + outliers + amostra diversa enviesada pela consulta | JSON grande |
| dedup | Colapsa linhas duplicadas + quase duplicadas (apenas prosa) | sempre |
| controle de saída | Instrução concisa · Chain-of-Draft · orçamento de tokens · esquema JSON nativo · diretiva anti-pensamento excessivo (raciocínio quantizado) · diretiva de frugalidade em loop de agente | automático |
| camada de ferramentas | Seleção estática de ferramentas + corte de descrições | ferramentas |
| multimodal | Reduz imagens ao limite de resolução do provedor | imagens |
auto padrão ativa cada estágio apenas onde compensa. safe é apenas sem perda. Config →
Claude Code
Quando ~/.claude existe, setup, update e ensure conectam /sub (e subagentes roteados). Nenhum comando de instalação separado para isso.
| Recurso | O que você ganha |
|---|---|
/sub | Por janela: /sub on [optional:codex|kimi|grok] · /sub off · /sub status |
Redirecionamento de assinatura (`sub`) (opt-in; pode conflitar com os ToS do provedor)
Envie Claude Code pelo CLIProxyAPI em vez da Anthropic, ou como um salto de fallback quando o caminho atual falhar. O login é a TUI do CLIProxyAPI; decida por si mesmo se isso se encaixa nos ToS do provedor.
llmtrim sub on                  # install + start CLIProxyAPI, enable redirect
llmtrim sub on grok             # write opus/sonnet/haiku/fable → that CLI's models
llmtrim sub auth                # CLIProxyAPI TUI — sign in
llmtrim sub models              # official + live sidecar models
llmtrim sub map on opus grok-4.6
llmtrim sub chain anthropic,codex
llmtrim sub mode fallback       # try hops in order when the current one fails
llmtrim sub status
llmtrim sub off
Interativo: llmtrim status → aba 4 Sub — Off / Always / Fallback, depois e para editar o
mapa entrada→saída (digite para pesquisar o catálogo do CLIProxyAPI;
s salvar, a adicionar, d excluir). [ ] rotaciona o primeiro salto de fallback.
llmtrim update também atualiza o CLIProxyAPI quando você o usa. Aponte LLMTRIM_CLIPROXY_URL para uma
instância existente para pular o sidecar gerenciado.
Roteie apenas um subagente delegado do Claude Code enquanto mantém a janela pai inalterada:
llmtrim agents install # also installed/refreshed by setup, update, and ensure
Depois pergunte naturalmente: Implement it using a Grok subagent, use Terra ou review this with GPT Terra.
Agentes somente-provedor preservam o nível Claude da solicitação do filho através do mapeamento configurado; um
agente de modelo explícito fixa o modelo daquele provedor. Agentes locais à solicitação sobrescrevem o /sub da janela e
a política global apenas para suas próprias solicitações. llmtrim agents uninstall remove apenas arquivos de agente de propriedade do llmtrim
e registra um opt-out para que ensure os deixe removidos.
Somente esta janela (instalado com ensure; inclui subagentes; sobrevive a /clear):
/sub on [optional:cli-or-model]  # gemini, codex, claude, grok, kimi, vertex, qwen, copilot, or a model id
/sub off
/sub status
Sidecar: ~/.llmtrim/cliproxy/ (binário + config). Autenticação: ~/.cli-proxy-api quando presente, senão
~/.llmtrim/cliproxy/auth. Env: LLMTRIM_SUB, LLMTRIM_SUB_MODE, LLMTRIM_CLIPROXY_URL,
LLMTRIM_CLIPROXY_KEY.
Conectores Anthropic /login vs claude.ai: com sub global em modo always, por
padrão o llmtrim escreve um ANTHROPIC_AUTH_TOKEN dummy em ~/.claude/settings.json (mesma
ideia do claude-code-proxy's
ANTHROPIC_AUTH_TOKEN=unused) para que o Claude Code não precise de uma sessão OAuth Anthropic ativa.
O MITM remove esse token dummy e envia /v1/messages ao CLIProxyAPI; sondas Anthropic
não-messages são respondidas localmente para que nunca retornem 401 Invalid bearer token.
Claude Code trata qualquer autenticação por chave de API como sobrescrevendo o login do claude.ai, então conectores claude.ai
são desativados enquanto o token dummy estiver definido. Isso é esperado. Para manter os conectores (e aceitar
/login Anthropic quando a sessão expirar):
llmtrim sub anthropic-login keep   # connectors OK; Anthropic login required
llmtrim sub anthropic-login skip   # default: no Anthropic /login; connectors off
Reinicie o Claude Code após sub on / sub off / sub mode / sub anthropic-login para a
mudança de configuração ter efeito. Fallback cujo primeiro salto é "o que está em uso" ainda precisa de um login
Anthropic real.
Use como CLI, MCP ou biblioteca
Mesmo mecanismo, sem necessidade de proxy. Sem chamadas extras de modelo; a compressão roda no processo.
| Linguagem | Instalação |
|---|---|
| Rust | cargo add llmtrim-core |
| Python | pip install llmtrim |
| Ruby | gem install llmtrim |
| Kotlin | implementation("io.github.fkiene:llmtrim:0.13.7") |
| Swift | SwiftPM fkiene/llmtrim-swift ≥ 0.1.8 |
| JS / TS | @llmtrim/js (WASM) |
CLI pipe
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim compress --provider openai > out.json
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim send --provider openai
Rust · Python · JS
use llmtrim_core::{compress, ir::ProviderKind};
let out = compress(request_json, Some(ProviderKind::OpenAi))?;
import llmtrim
out = llmtrim.compress(request_json, llmtrim.Provider.OPEN_AI, "aggressive")
import { compress } from "@llmtrim/js";
const out = compress(requestJson, "openai", "aggressive");
Notas sobre bindings e WASM: crates/llmtrim-uniffi · crates/llmtrim-wasm.
MCP server
llmtrim mcp install          # Claude Code
llmtrim mcp install --print  # paste into any client
{
  "mcpServers": {
    "llmtrim": { "command": "llmtrim", "args": ["mcp"] }
  }
}
Ferramentas: llmtrim_compress, llmtrim_compress_text, llmtrim_stats (mesmo ledger do status).
Funciona com
Qualquer ferramenta que respeite HTTPS_PROXY e uma CA fornecida por env:
| Ferramenta | Funciona | Notas |
|---|---|---|
| Claude Code | ✅ | O desconto de prompt-cache permanece intacto |
| Codex CLI | ✅ | |
| Gemini CLI | ✅ | |
| Cursor (IDE), Cline, Roo, Kilo Code | ✅ | Extensões do VS Code; defina NODE_EXTRA_CA_CERTS para o processo host do Node |
| Goose, OpenCode, Crush, Mux, Forge, OpenClaw, Pi/OMP | ✅ | Agentes CLI em hosts padrão de provedores |
| Qwen Code, Grok CLI, Kimi Code, Mistral Vibe | ✅ | Hosts de provedores vêm no registro llm_providers, interceptados de fábrica |
Aider, qualquer outro CLI que respeite HTTPS_PROXY | ✅ | |
| Hermes, Droid (modo BYOK) | ✅ | Interceptável apenas quando uma chave direta de provedor está configurada; veja o guia para Hermes |
| Seu próprio app / SDK | ✅ | Ou chame o CLI / biblioteca diretamente |
| GitHub Copilot | ❌ | Fixação de certificado bloqueia a interceptação |
| Warp, Devin | ❌ | A chamada ao provedor é no servidor; um proxy local nunca a vê |
| Cursor Agent, Kiro | ❌ | Rota via gateway do fornecedor, não um host padrão de provedor |
Sem proxy: qualquer cliente MCP pode chamar llmtrim como ferramentas (llmtrim mcp install), ou usar o CLI / biblioteca.
Os provedores vêm do registro llm_providers (OpenAI, Anthropic, Google, DeepSeek, Mistral, xAI, Moonshot, Zhipu, Qwen, OpenRouter, …) e são atualizados junto com ele. Conexões que não são de LLM passam intocadas.
Configuração
O padrão é suficiente para a maior parte do tráfego. auto inspeciona cada requisição e escolhe compressores pela forma (ferramentas → agent, código → code, Q&A longo → rag, senão aggressive).
Substitua com LLMTRIM_PRESET=<name> ou preset = "<name>" em $XDG_CONFIG_HOME/llmtrim/config.toml:
| predefinição | Quando usar |
|---|---|
auto (padrão) | Deixe o llmtrim escolher por requisição |
safe | Apenas entrada sem perdas |
aggressive | Máxima compressão, com controle de qualidade |
Predefinições avançadas
auto compõe estas por forma de requisição, então a maioria dos usuários nunca as define diretamente. Escolha uma quando souber seu tráfego e quiser pular a detecção de forma:
| predefinição | para |
|---|---|
agent | loops de chamada de ferramenta: poda o bloco de ferramentas apenas na primeira vez para manter o prompt-cache aquecido |
code | turnos de codificação: esqueletiza e minifica código, comprime logs e diffs colados |
rag | contexto longo com uma pergunta: recuperação em nível de frase |
cache | um prefixo fixo reutilizado em muitas chamadas |
reasoning | cargas de trabalho de matemática e passo a passo |
frugal | isola apenas a diretiva de frugalidade do loop de agente, para benchmarking limpo |
Substituições por flag (usuários avançados)
Cada etapa é ajustável individualmente via flags de configuração; preset vence sobre flags individuais. A tabela completa é longa; veja a lista de campos em config.rs ou execute llmtrim compress --help. Os controles mais úteis:
| campo | padrão | significado |
|---|---|---|
toolout | ligado em agent/aggressive | compressão de saída de ferramenta (logs / diffs / grep / dumps) |
retrieve | false | recuperação lexical para contexto longo (com perdas) |
skeletonize | false | remove corpos de funções não relevantes para assinaturas |
serialize | true | codificação TOON / CSV de arrays de registros |
json_crush | ligado em agent/aggressive | amostra arrays de registros enormes |
output_control | false | instrução de saída concisa + limite |
output_anti_overthink | ligado em aggressive/rag/code/agent | diretiva de compromisso com a resposta para tráfego de raciocínio quantizado |
output_frugal_tools | ligado em agent | orienta loops de agente para menos turnos de chamada de ferramenta (em lote, não repita) |
cache | false | breakpoints cache_control (sem perdas) |
dedup | true | colapsa linhas duplicadas (sem perdas) |
quality_gate | true | reverte qualquer corte com perdas cuja cobertura relevante à consulta caia demais |
Env: LLMTRIM_PRESET (predefinição), LLMTRIM_CONFIG (caminho do arquivo de configuração).
Configurações de runtime (env ou arquivo de configuração)
Esses controles são ortogonais à compressão. Cada um resolve primeiro via env, depois do arquivo de configuração, então defina o que for mais adequado. A variável de env vence quando ambas estão presentes.
| variável de env | chave de configuração | significado |
|---|---|---|
LLMTRIM_EXTRA_HOSTS | extra_hosts | hosts extras exatos de API de LLM para interceptar (separados por vírgula no env / array no arquivo), ex.: um endpoint compatível com OpenAI auto-hospedado |
LLMTRIM_EXCLUDE_PROVIDERS | exclude_providers | formas de wire para pular a compressão: openai / anthropic / google (ex.: anthropic para deixar o Claude Code intocado); grosseiro, cobre todos os hosts daquela forma |
LLMTRIM_EXCLUDE_HOSTS | exclude_hosts | nomes de host exatos para pular a compressão (ex.: openrouter.ai); preciso, deixa outros hosts da mesma forma comprimidos |
LLMTRIM_UPSTREAM_PROXY | upstream_proxy | roteia a saída por outro proxy (veja abaixo) |
LLMTRIM_DB_PATH | db_path | localização do ledger |
LLMTRIM_CAPTURE_DIR | capture_dir | diretório de captura de QA antes/depois |
LLMTRIM_CAPTURE_MAX_MB | capture_max_mb | teto de tamanho do corpus de captura (0 desativa) |
LLMTRIM_FIRST_ARRIVAL_RECALL | first_arrival_recall | modelagem recuperável de saída de ferramenta na primeira chegada (padrão false; defina true para admitir resultados de limite de cache para llmtrim recall) |
LLMTRIM_TOOL_OUTPUT | toolout_passthrough | pula compressão de saída de ferramenta para comandos correspondentes: passthrough (todos) ou globs de comando (*gpt.sh*); também honrado como atribuição de comando ou linha de resultado. Linhas LLMTRIM_KEEP: são sempre retidas |
LLMTRIM_FIRST_ARRIVAL_RECALL_TTL_SECS | first_arrival_recall_ttl_secs | tempo de vida do resultado bruto em memória (padrão 18.000 segundos / cinco horas) |
LLMTRIM_BIND | bind | IP de escuta (padrão loopback; 0.0.0.0 para contêineres) |
LLMTRIM_BREAKDOWN_WINDOW | breakdown_window | substituição da janela de contexto para o detalhamento de custo |
LLMTRIM_RETENTION_DAYS | retention_days | retenção por idade do ledger em dias |
LLMTRIM_NO_UPDATE_CHECK | no_update_check | desativa a verificação passiva de atualização |
Entradas extra_hosts devem ser nomes de host exatos (llm.acme.com, nunca um acme.com puro): cada uma amplia a CA MITM restrita por nome, que se regenera automaticamente no próximo lançamento para cobri-las.
Opções do Claude Code (redirecionamento de assinatura) estão em Claude Code.
Proxy upstream (egress corporativo ou encadeamento de ferramentas locais)
export LLMTRIM_UPSTREAM_PROXY=http://host:port
# or with auth: http://user:pass@host:port  (redacted in logs)
Chamadas de saída usam CONNECT + TLS de verificação; o upstream vê apenas o fluxo criptografado.
Looping para o próprio endereço de escuta do llmtrim é rejeitado. Coloque a variável no ambiente de
lançamento do daemon (launchd / systemd), não apenas no seu shell interativo. Segredos de perfil
ficam em texto puro.
Ferramentas complementares em outra porta (ex.: headroom) são aceitáveis.
Os números
Cada caso é enviado duas vezes, uma original e uma comprimida, e então ambas as respostas são pontuadas e cobradas a taxas reais. Custo e qualidade são medidos juntos, não estimados, em 112 casos:

| original | comprimido | economizado | |
|---|---|---|---|
| tokens de entrada | 71.031 | 49.062 | −31% |
| tokens de saída | 25.843 | 6.628 | −74% |
| custo de ida e volta | $0,0365 | $0,0126 | −66% |
| qualidade da resposta | 78,9% | 82,2% | sem degradação medida |
Os cortes de tokens são independentes do modelo (−31% entrada, −74% saída). A economia em dólares acompanha a razão de preço saída-para-entrada do modelo: −66% aqui, projetando −57% nas taxas do GPT-4o e −59% nas taxas do Claude Sonnet. O proxy comprime apenas a superfície de conteúdo novo e nunca reescreve o prefixo controlado por cache, então seu desconto de prompt-cache sobrevive.
Precisão preservada em benchmarks padrão
O mesmo A/B nas suítes acadêmicas padrão, com uma predefinição conservadora correspondente à forma (qwen3-next-80b, IC de 95% pareado). Qualidade é a pontuação na requisição original vs. a comprimida. GSM8K vem da fronteira acima (n=12); os outros três são os benchmarks nomeados que os leitores comparam (n=20 cada):
| benchmark | tarefa | avaliador | entrada economizada | qualidade (orig → comp) | retenção |
|---|---|---|---|---|---|
| GSM8K | matemática de ensino fundamental | exato numérico | −47%¹ | 100% → 92% | −8pp |
| TruthfulQA (MC1) | veracidade factual | exato de escolha | 0% | 75% → 75% | +0,0±0,0pp |
| SQuAD v2 | QA extrativo | token-F1 / EM | 11% | 84% → 84% | −0,0±15,2pp |
| BFCL (live_multiple) | chamada de função | correspondência de chamada de ferramenta | 33% | 95% → 95% | +0,0±15,2pp |
Três linhas comprimem sem perda de qualidade; GSM8K é a única queda:
- BFCL remove os esquemas de ferramenta que a consulta não precisa (um menu de 2 a 37 candidatos por chamada).
- SQuAD v2 ainda responde corretamente suas perguntas sem resposta.
- TruthfulQA mantém a precisão factual exata: seus prompts de ~75 tokens são quase todo texto de resposta, então a predefinição segura não encontra nada para cortar.
- GSM8K troca −8pp de precisão por −71% de custo, então meça por carga de trabalho antes de habilitar sua predefinição de raciocínio. ¹Sua entrada fica negativa porque essa predefinição injeta uma instrução de Chain-of-Draft cujo retorno está no lado da saída (veja a tabela da fronteira).
Evidência e uma reprodução de uma linha (snapshot de benchmark nomeado):
make -C crates/llmtrim-cli/bench data
(cd crates/llmtrim-cli && cargo run -q --features live -- bench quality \
   --corpus bench/data/squad2.jsonl --preset rag \
   --model qwen/qwen3-next-80b-a3b-instruct --route "" --n 20)
Metodologia, fronteira por corpus e intervalos de confiança: crates/llmtrim-cli/bench/README.md. Reproduza:
make -C crates/llmtrim-cli/bench data   # pull real corpora (gsm8k, humaneval, dolly, hotpotqa, …)
(cd crates/llmtrim-cli && cargo run -q --features live -- bench suite)  # live A/B across all corpora (needs OPENROUTER_API_KEY)
(cd crates/llmtrim-cli/bench/scripts && PYTHONPATH=. python3 -m benchkit.tools.chart)  # regenerate the chart + table
Como se compara
Cada ferramenta comprime uma fatia da requisição. O llmtrim comprime entrada e saída, deixa o prefixo em cache intocado para manter o prompt-cache estável, e pontua se a resposta sobrevive ao corte, não pelos tokens removidos. Ambos os eixos abaixo usam o codificador o200k_base e reproduzem a partir deste repositório.
| llmtrim | Headroom | RTK | caveman | |
|---|---|---|---|---|
| Comprime | entrada · saída | entrada | saída de ferramenta/CLI | saída do modelo |
| Pula transformações sem efeito | ✅ | ❌ | ❌ | n/a |
| Um binário estático | ✅ | Python + modelos | ✅ | ✅ |
Entrada
Redução de entrada (determinística) ao lado da qualidade da resposta de um A/B ao vivo. Qualidade é a queda vs. llmtrim em cada configuração comparada da ferramenta (✅ mantida, empate estatístico; ❌ significativamente menor), então uma grande redução com ❌ significa que a ferramenta comprou tokens perdendo respostas:
| Ferramenta | Redução | Qualidade vs llmtrim | Overhead |
|---|---|---|---|
llmtrim auto | 25% | ✅ ref | ~5 ms |
llmtrim aggressive | 28% | ✅ ref | ~5 ms |
| Headroom (ML on) | 24% | ✅ empate | ~0,9 s |
| leanctx / LLMLingua-2 | 52-81% | ❌ 18% menor | ~6 s |
| entroly | 80-89% | ❌ 42% menor | <1 ms |
Overhead é o tempo mediano de compressão por chamada (wall-clock em Python, não CPU comparável): Headroom e leanctx executam ML na CPU aqui (mais rápido em GPU) e pagam um carregamento único de modelo por cima (~3 s e ~4 s); llmtrim é Rust e entroly é lexical, então nenhum dos dois paga.
autoé o padrão com gate de qualidade;aggressiveaceita cortes com perda onde o gate se mantém.- Headroom cai para 0% com seu ML desabilitado (seus roteadores não operam em prosa).
- leanctx e entroly são com perda e sem gate de qualidade; entroly não tem modo de baixa redução.
Headroom empata na redução correspondente (24-25%, n=30, não significativo), mas suas respostas mais longas atingem o limite de tokens de saída do modelo e são truncadas 12 vezes contra 2 do llmtrim, a inflação de saída por trás de seu custo maior. leanctx (medido em 26%) e entroly (em 69%, seu modo mais suave) pontuam significativamente abaixo do llmtrim (n=20), e caem ainda mais em suas reduções de destaque (vs-leanctx, vs-entroly).
Saída
Redução de saída ao pedir respostas mais concisas, em uma chamada paga ao vivo em 9 prompts de codificação:
| corte de saída | overhead / requisição | |
|---|---|---|
| caveman | 80% | 949 tokens |
llmtrim output_terse | 69% | 19 tokens |
O custo é o prompt de sistema de 949 tokens que caveman reenvia em toda requisição (coluna direita); o do llmtrim é 19 para quase o mesmo corte. Ambos ainda economizam líquido aqui, então o corte mais profundo do caveman só sai à frente quando a saída que ele remove vale mais do que os 949 tokens que ele adiciona de volta (artefato vs-caveman).
As ferramentas se empilham: RTK encolhe a saída da CLI, então llmtrim comprime os schemas das ferramentas por cima. Comparações completas: crates/llmtrim-cli/bench/README.md.
Limitações conhecidas
Estas são expostas pelo mesmo A/B que prova as economias:
- As contagens de tokens da Anthropic / Gemini são aproximadas. Não há tokenizador público exato, então um proxy BPE é usado e sinalizado em
status. OpenAI é exato. - As economias de saída não são medidas ao vivo. O proxy comprime entrada; uma economia de saída precisa do contrafactual A/B, que só o benchmark offline executa.
status"economizado" é do lado da entrada. - O padrão tem gate de qualidade, não é sem perda. Estágios com perda rodam apenas onde a avaliação mostra que a qualidade se mantém. Quer um round-trip byte a byte fiel? Use o preset
safe. - "Sem perda" é do lado da entrada, não restauração de resposta. Um estágio sem perda preserva a informação que o modelo lê (um log dobrado, um array codificado em TOON, uma legenda de abreviação que o modelo decodifica no prompt), e o gate de tokens reverte qualquer corte de entrada que não compensa. O motor não transforma a resposta do modelo de volta a uma forma original.
Agradecimentos
Cada compressor é uma implementação determinística de pesquisa publicada: as ideias são deles, a engenharia e o gate de tokens são nossos.
Artigos + crates por trás de cada estágio
Recuperação e contexto: BM25 (Robertson & Zaragoza 2009, bm25); BM25+ (Lv & Zhai, CIKM 2011); RM3 (Lavrenko & Croft, SIGIR 2001); TextTiling (Hearst, CL 1997); TextRank (Mihalcea & Tarau, EMNLP 2004); MMR (Carbonell & Goldstein, SIGIR 1998); Objetivo submodular (Lin & Bilmes, ACL 2011); maximizador de mochila greedy modificado (Tang et al., SIGMETRICS 2021, arXiv:2008.05391); amostragem diversa DPP (Chen et al., NeurIPS 2018); Lost in the Middle (arXiv:2307.03172); DSLR (arXiv:2407.03627).
Código: RepoCoder (arXiv:2303.12570); Hierarchical Context Pruning (arXiv:2406.18294); The Hidden Cost of Readability (arXiv:2508.13666); Contabilidade de tokens por minificação (arXiv:2606.01326).
Saída de ferramenta: Drain (He et al., ICWS 2017); Brain (Yu et al., IEEE TSC 2023); LogLSHD (arXiv:2504.02172).
Dedup e abreviação: SimHash (Charikar, STOC 2002, gaoya); CompactPrompt (arXiv:2510.18043); Repetições máximas (arXiv:1304.0528) + Re-Pair (Larsson & Moffat, DCC 1999).
Controle de saída: Chain-of-Draft (arXiv:2502.18600); TALE (arXiv:2412.18547).
Serialização: TOON (Token-Oriented Object Notation), Johann Schopplich.
Construído sobre tiktoken-rs, tree-sitter, image, whatlang, hudsucker, rusqlite, e mais.
Encontrou um problema?
llmtrim doctor          # diagnose
llmtrim doctor --fix     # diagnose + apply repairs
llmtrim ensure          # same repair path
Cada verificação que falha nomeia sua correção. Se uma requisição foi corrompida, defina LLMTRIM_CAPTURE_DIR e
abra uma issue com o par antes/depois.
Se llmtrim economizou seu dinheiro, uma ⭐ ajuda outros a encontrá-lo.
Histórico de estrelas
Licenciado sob MPL-2.0. Use llmtrim livremente em sua stack, inclusive comercialmente, sem obrigação de divulgação de fonte para seu próprio código; o copyleft em nível de arquivo se aplica apenas a modificações que você fizer nos próprios arquivos-fonte do llmtrim. Contribuições via assinatura DCO.