FleetQ
Controle de Missão para Agentes de IA — Mais de 200 ferramentas MCP para gerenciar agentes, experimentos, fluxos de trabalho, equipes, habilidades, aprovações, orçamentos e muito mais.
Documentação
FleetQ — Plataforma de Orquestração de Agentes de IA Open-Source
Centro de controle auto-hospedado para agentes de IA. Construa, execute e monitore sistemas autônomos multi-agente com um construtor visual de DAG, aprovações human-in-the-loop, integração com servidor MCP e trilha de auditoria completa. Funciona com Claude, GPT-4o, Gemini, Ollama, Codex, Claude Code e qualquer LLM compatível com OpenAI.


Palavras-chave: agentes de IA · orquestração de agentes · servidor MCP · Model Context Protocol · alternativa ao LangGraph · alternativa ao CrewAI · n8n para IA · agentes Claude · fluxo de trabalho LLM · agentes autônomos · framework de agentes · automação de IA · auto-hospedado
☁️ Prefere gerenciado? Experimente FleetQ Cloud — zero configuração, plano gratuito. ⭐ Gostou do projeto? Dê uma estrela no GitHub — isso ajuda outras pessoas a encontrar o FleetQ.
Sumário
- Por que FleetQ?
- Conceitos-chave
- Capturas de tela
- Recursos
- Casos de uso
- Como o FleetQ se compara
- Início rápido
- Autenticação
- Configuração
- Acesso a hosts SSH
- Arquitetura
- Servidor MCP (675+ ferramentas)
- Stack tecnológico
- Contribuindo
- Changelog
Por que FleetQ?
A maioria dos frameworks de agentes oferece um notebook Python. O FleetQ oferece uma plataforma de produção.
- 🧩 675+ ferramentas MCP em 45 domínios — cada recurso é exposto via Model Context Protocol, então qualquer LLM (Claude Desktop, Cursor, ChatGPT, agentes locais) pode acionar a plataforma programaticamente. Novo na versão 1.27: interfaces web para capacidades anteriormente headless (sessões de agentes, chaves de assinatura de release, monitores de drift e eval, transmissões, suítes de teste, importação CSV); oito canais de chat de saída como drivers de primeira classe; o Agentic AI Flywheel (conjunto de eval auto-expansível + monitores de drift/produção); autonomia governada por políticas (políticas versionadas por agente + replay); orquestração ciente de custos e métricas de Retorno sobre Gasto Cognitivo (ROCS).
- 🔁 Fluxos de trabalho visuais em DAG com 8 tipos de nós (agente, condicional, tarefa humana, switch, fork dinâmico, do-while, compensação, sub-fluxo) — sem código Python de cola.
- 👥 Equipes multi-agente com papéis de coordenador/trabalhador/revisor, pontuação de QA ponderada e validação cruzada.
- 🛡️ Governança de Ações no Mundo Real — chamadas de ferramentas do assistente, gravações de integrações e pushes de git passam por uma política de risco por nível (automático / perguntar / rejeitar para baixo / médio / alto). Aprovações são executadas automaticamente. Trilha de auditoria anexada.
- 💰 Controles de orçamento com um razão de crédito real, bloqueio pessimista e pausa automática em caso de gasto excessivo — não apenas contadores de tokens.
- 🧠 Evolução de agentes — o LLM analisa o histórico de execução e propõe mudanças de configuração que você aprova com um clique.
- ⚙️ BYOK + LLMs locais — Anthropic, OpenAI, Google, além de Ollama, LM Studio, vLLM, Codex, Claude Code. Zero dependência de fornecedor.
- 🔒 Nível de produção — isolamento de tenant, cofre de credenciais criptografado, webhooks HMAC, proteções SSRF, circuit breakers, trilha de auditoria.
- 📊 Observabilidade OpenTelemetry — códigos de erro estruturados (canônicos gRPC), propagação de prazos, rastreamento distribuído. Interface Jaeger a um comando de distância. Endpoints OTLP por equipe para observabilidade BYO.
- 📈 Grafo de equipe ao vivo — visualização force-directed com Cytoscape.js de agentes, humanos e equipes. Atualizações em tempo real via Laravel Reverb WebSockets.
- 🏠 Auto-hospedado ou nuvem — licença AGPLv3 amigável ao MIT, roda em Docker Compose, ou use FleetQ Cloud.
Conceitos-chave
| Conceito | O que é | Quando usar |
|---|---|---|
| Agente | Uma personalidade de IA configurada com papel, objetivo, histórico, habilidades e acesso a ferramentas | A unidade básica — um agente por tarefa especializada |
| Habilidade | Um prompt LLM reutilizável, regra, conector ou chamada de computação GPU | Quando vários agentes precisam da mesma capacidade |
| Experimento | Uma execução com estado através de um pipeline de 20 estágios (pontuação → planejamento → construção → execução → avaliação) | Qualquer tarefa de agente não trivial com ciclo de vida |
| Equipe | Um time de agentes trabalhando em um objetivo (sequencial, paralelo, hierárquico, adversarial, fanout, sala de chat) | Tarefas com múltiplas perspectivas ou quando você precisa de revisão/QA |
| Fluxo de trabalho | Um template visual em DAG (reutilizável entre experimentos) com ramificações, loops, tarefas humanas | Processos recorrentes — CI/CD, pipelines de conteúdo, fluxos de QA |
| Projeto | Um contêiner contínuo (agendado por cron) ou único para experimentos, com orçamento + marcos | Iniciativas de longo prazo, trabalho de agente agendado |
| Sinal | Um evento de entrada (webhook, RSS, email, relatório de bug, issue do GitHub) que pode acionar agentes | Automação orientada a eventos |
| Ferramenta MCP | Uma ação programática que qualquer LLM pode chamar para consultar ou modificar a plataforma | Expor o FleetQ a agentes externos (Claude, Cursor, etc.) |
Capturas de tela
|
Painel Visão geral de KPIs com experimentos ativos, taxa de sucesso, gasto de orçamento e aprovações pendentes. 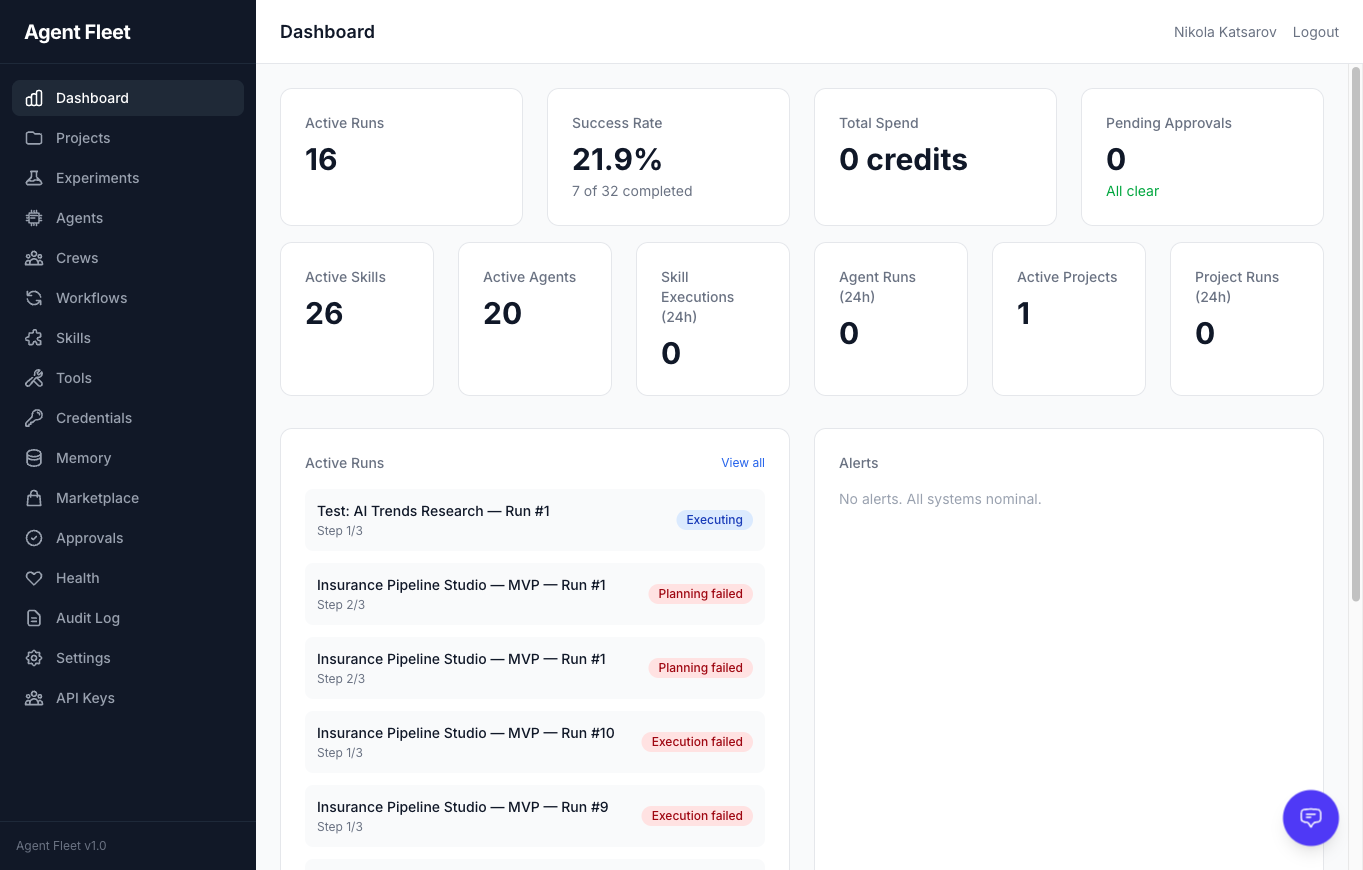
|
Galeria de Templates de Agentes Navegue por 14 templates de agentes pré-construídos em 5 categorias. Pesquise, filtre por categoria e implante com um clique. 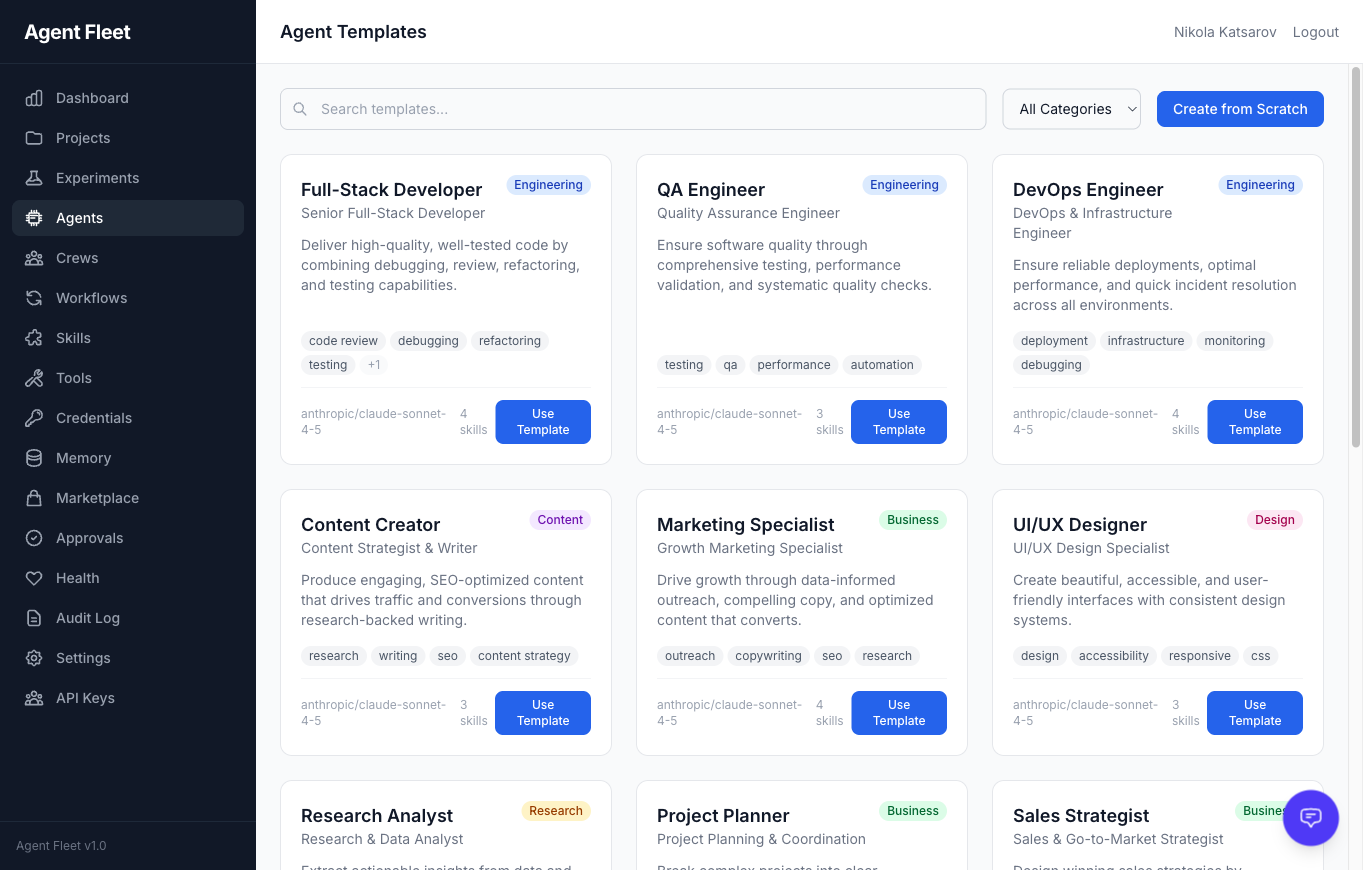
|
|
Configuração LLM do Agente Seleção de provedor e modelo por agente com cadeias de fallback. Suporta Anthropic, OpenAI, Google e agentes locais. 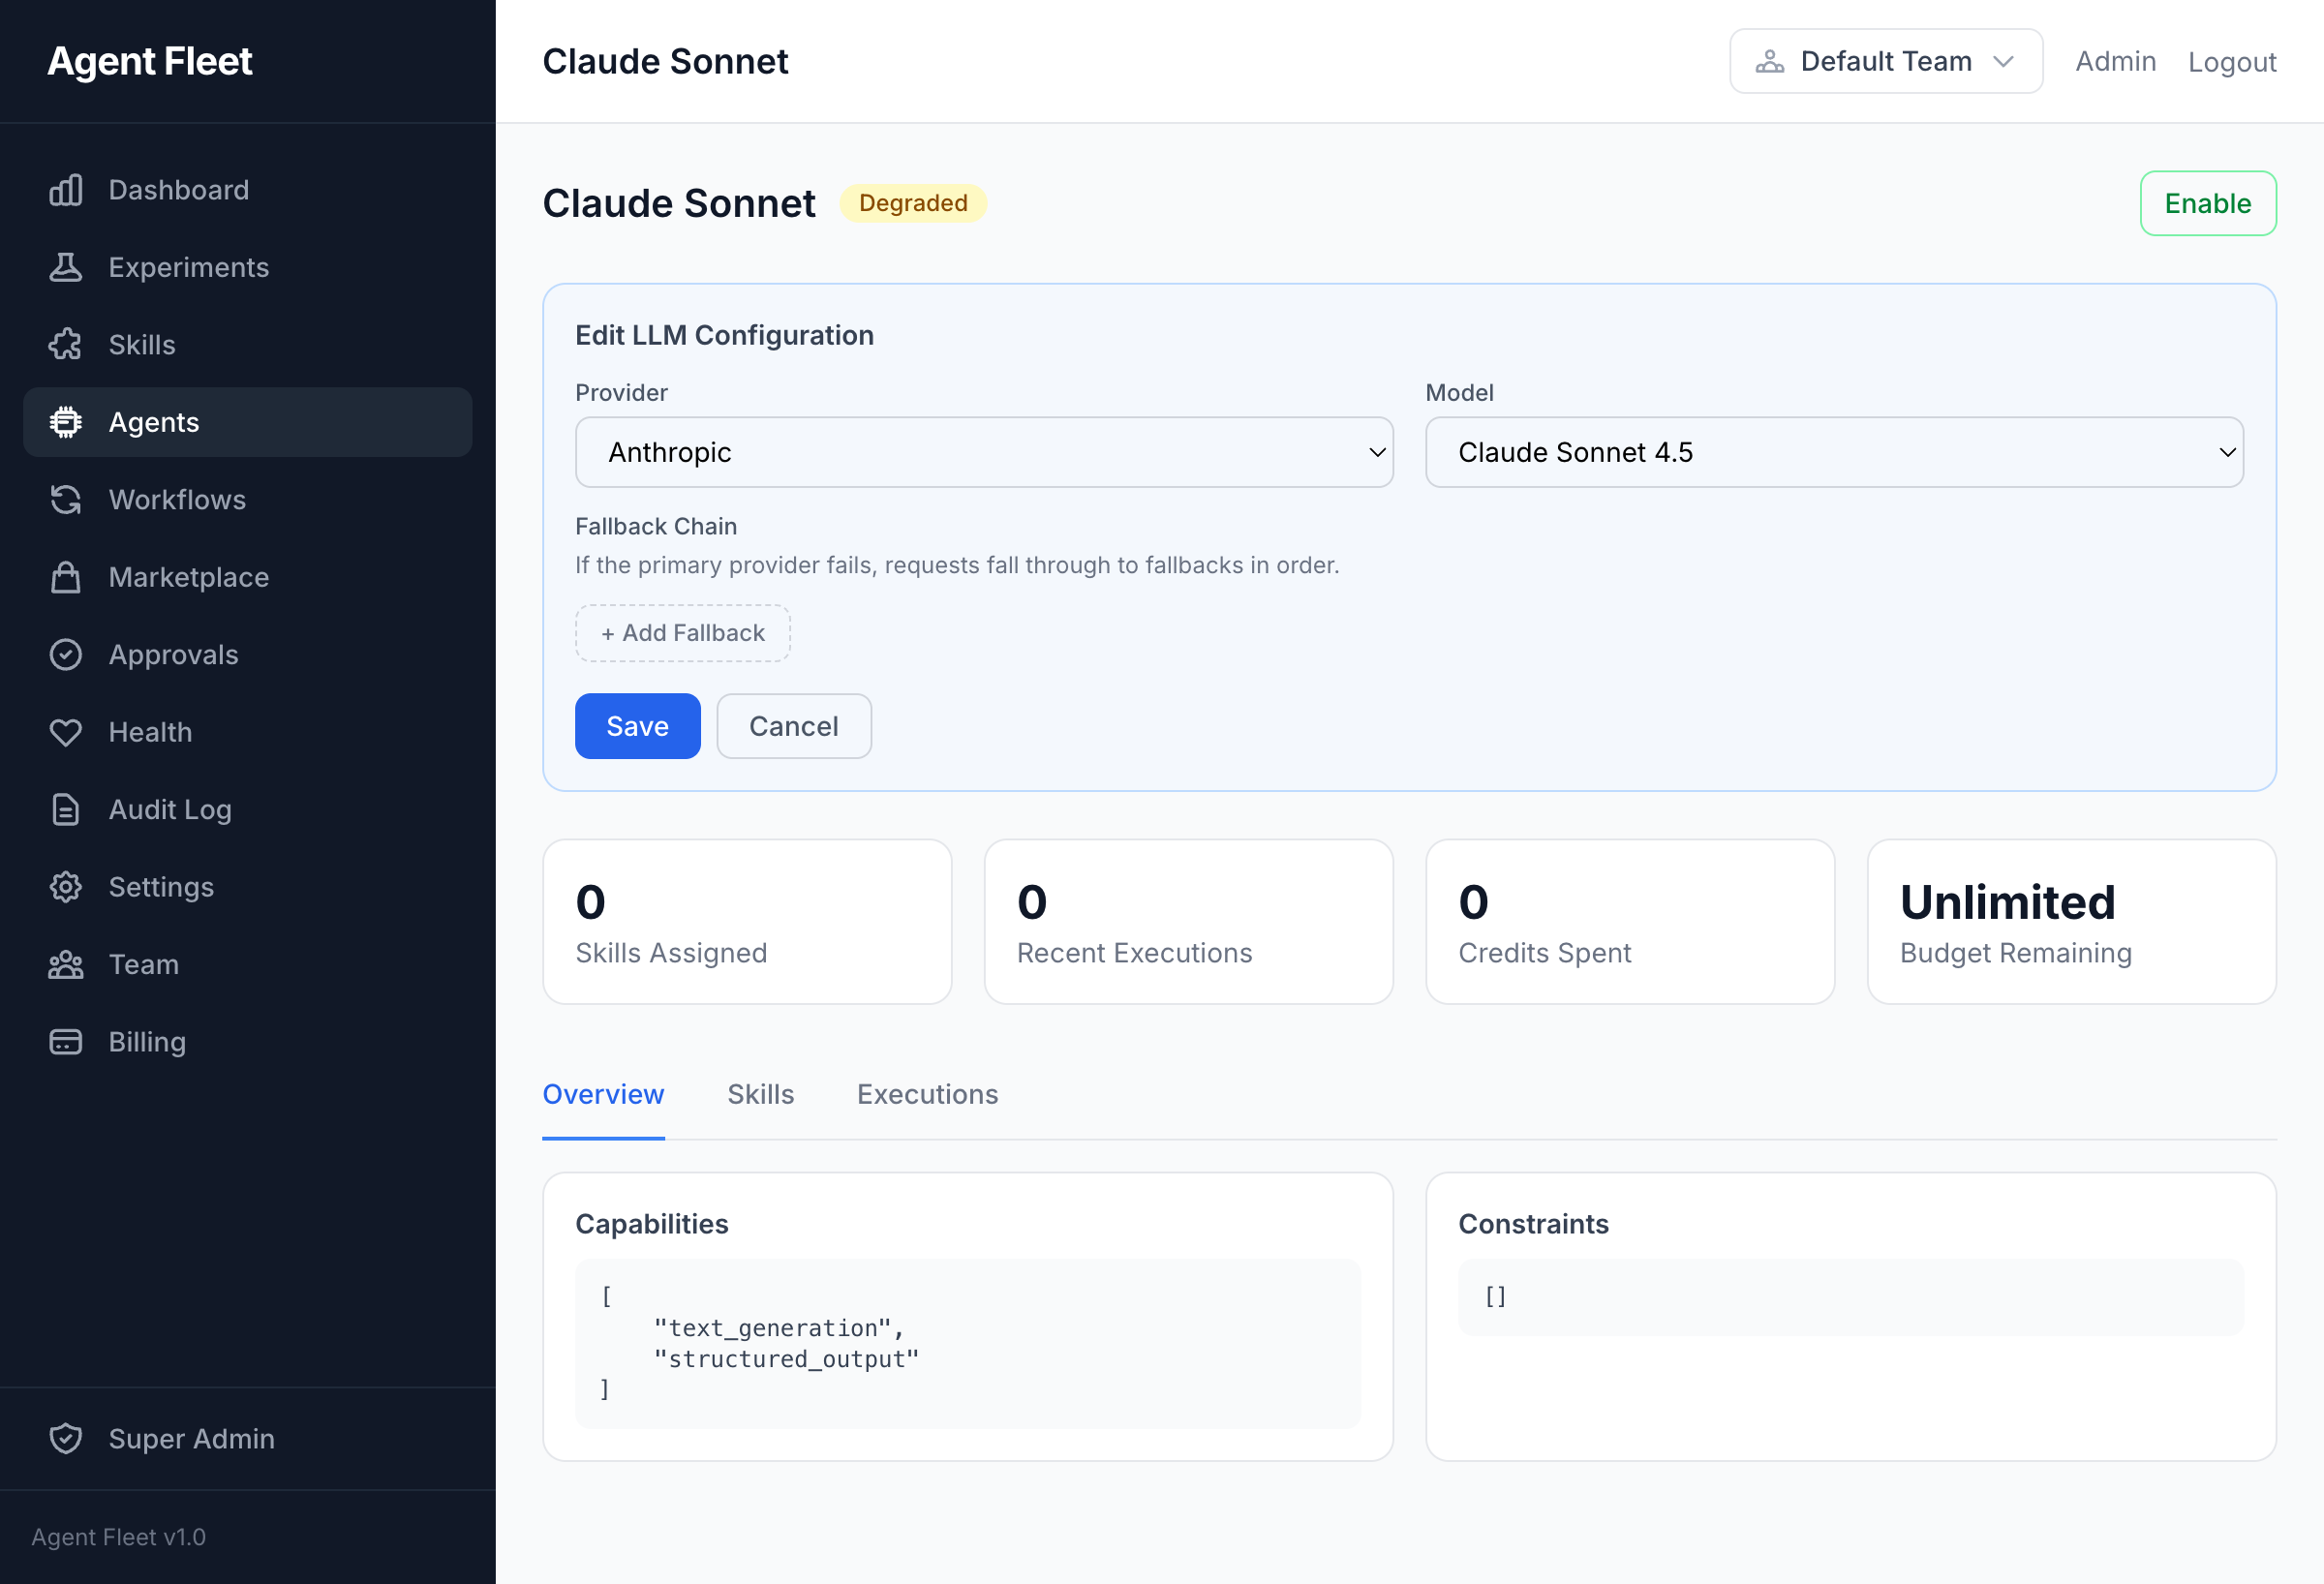
|
Evolução de Agentes Auto-melhoria de agentes orientada por IA. Analise o histórico de execução, proponha mudanças de personalidade e configuração e aplique com um clique. 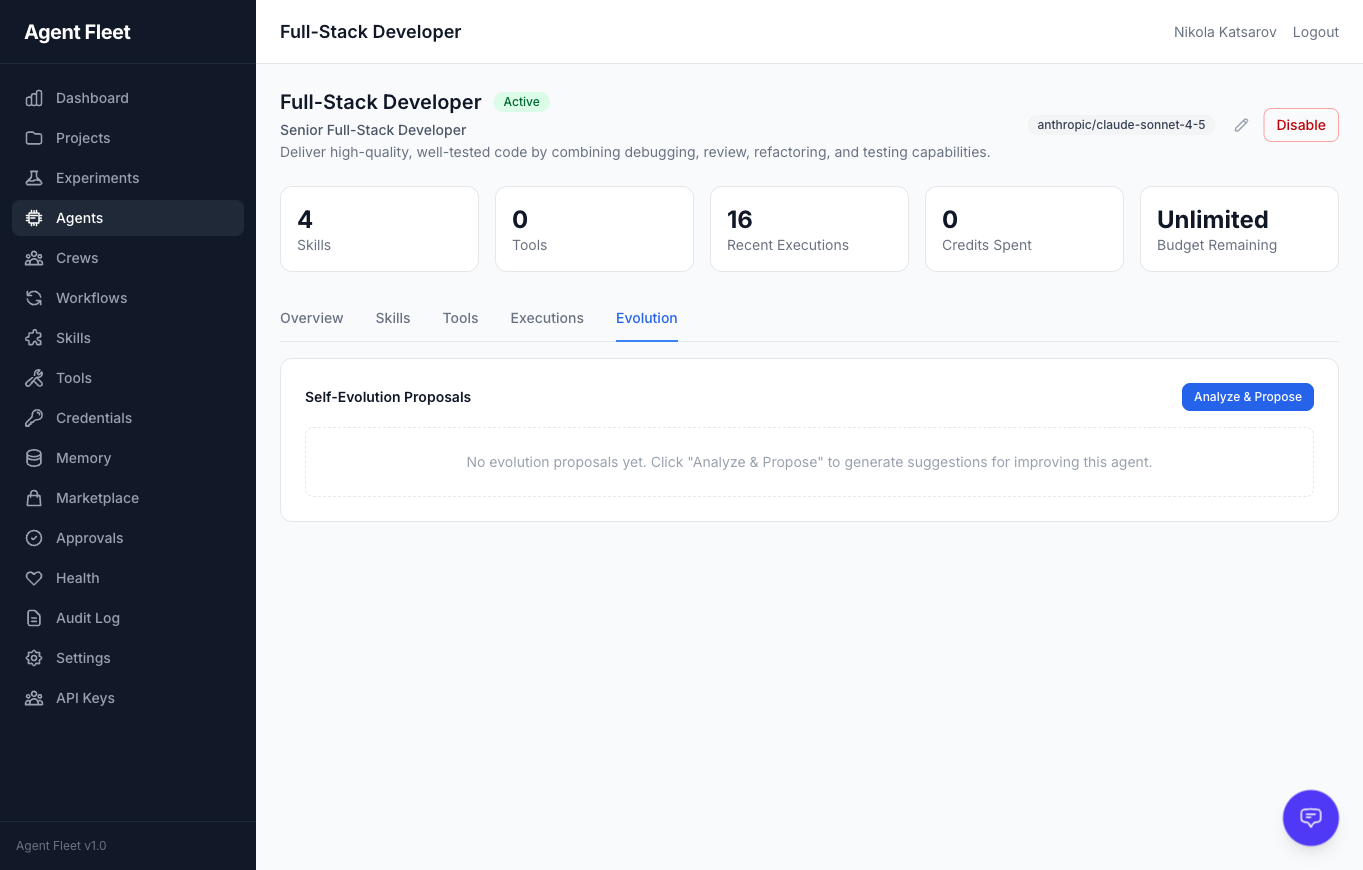
|
|
Execução de Equipe Acompanhamento de progresso ao vivo durante a execução de equipes multi-agente. Cada tarefa mostra sua habilidade atribuída, provedor e tempo decorrido. 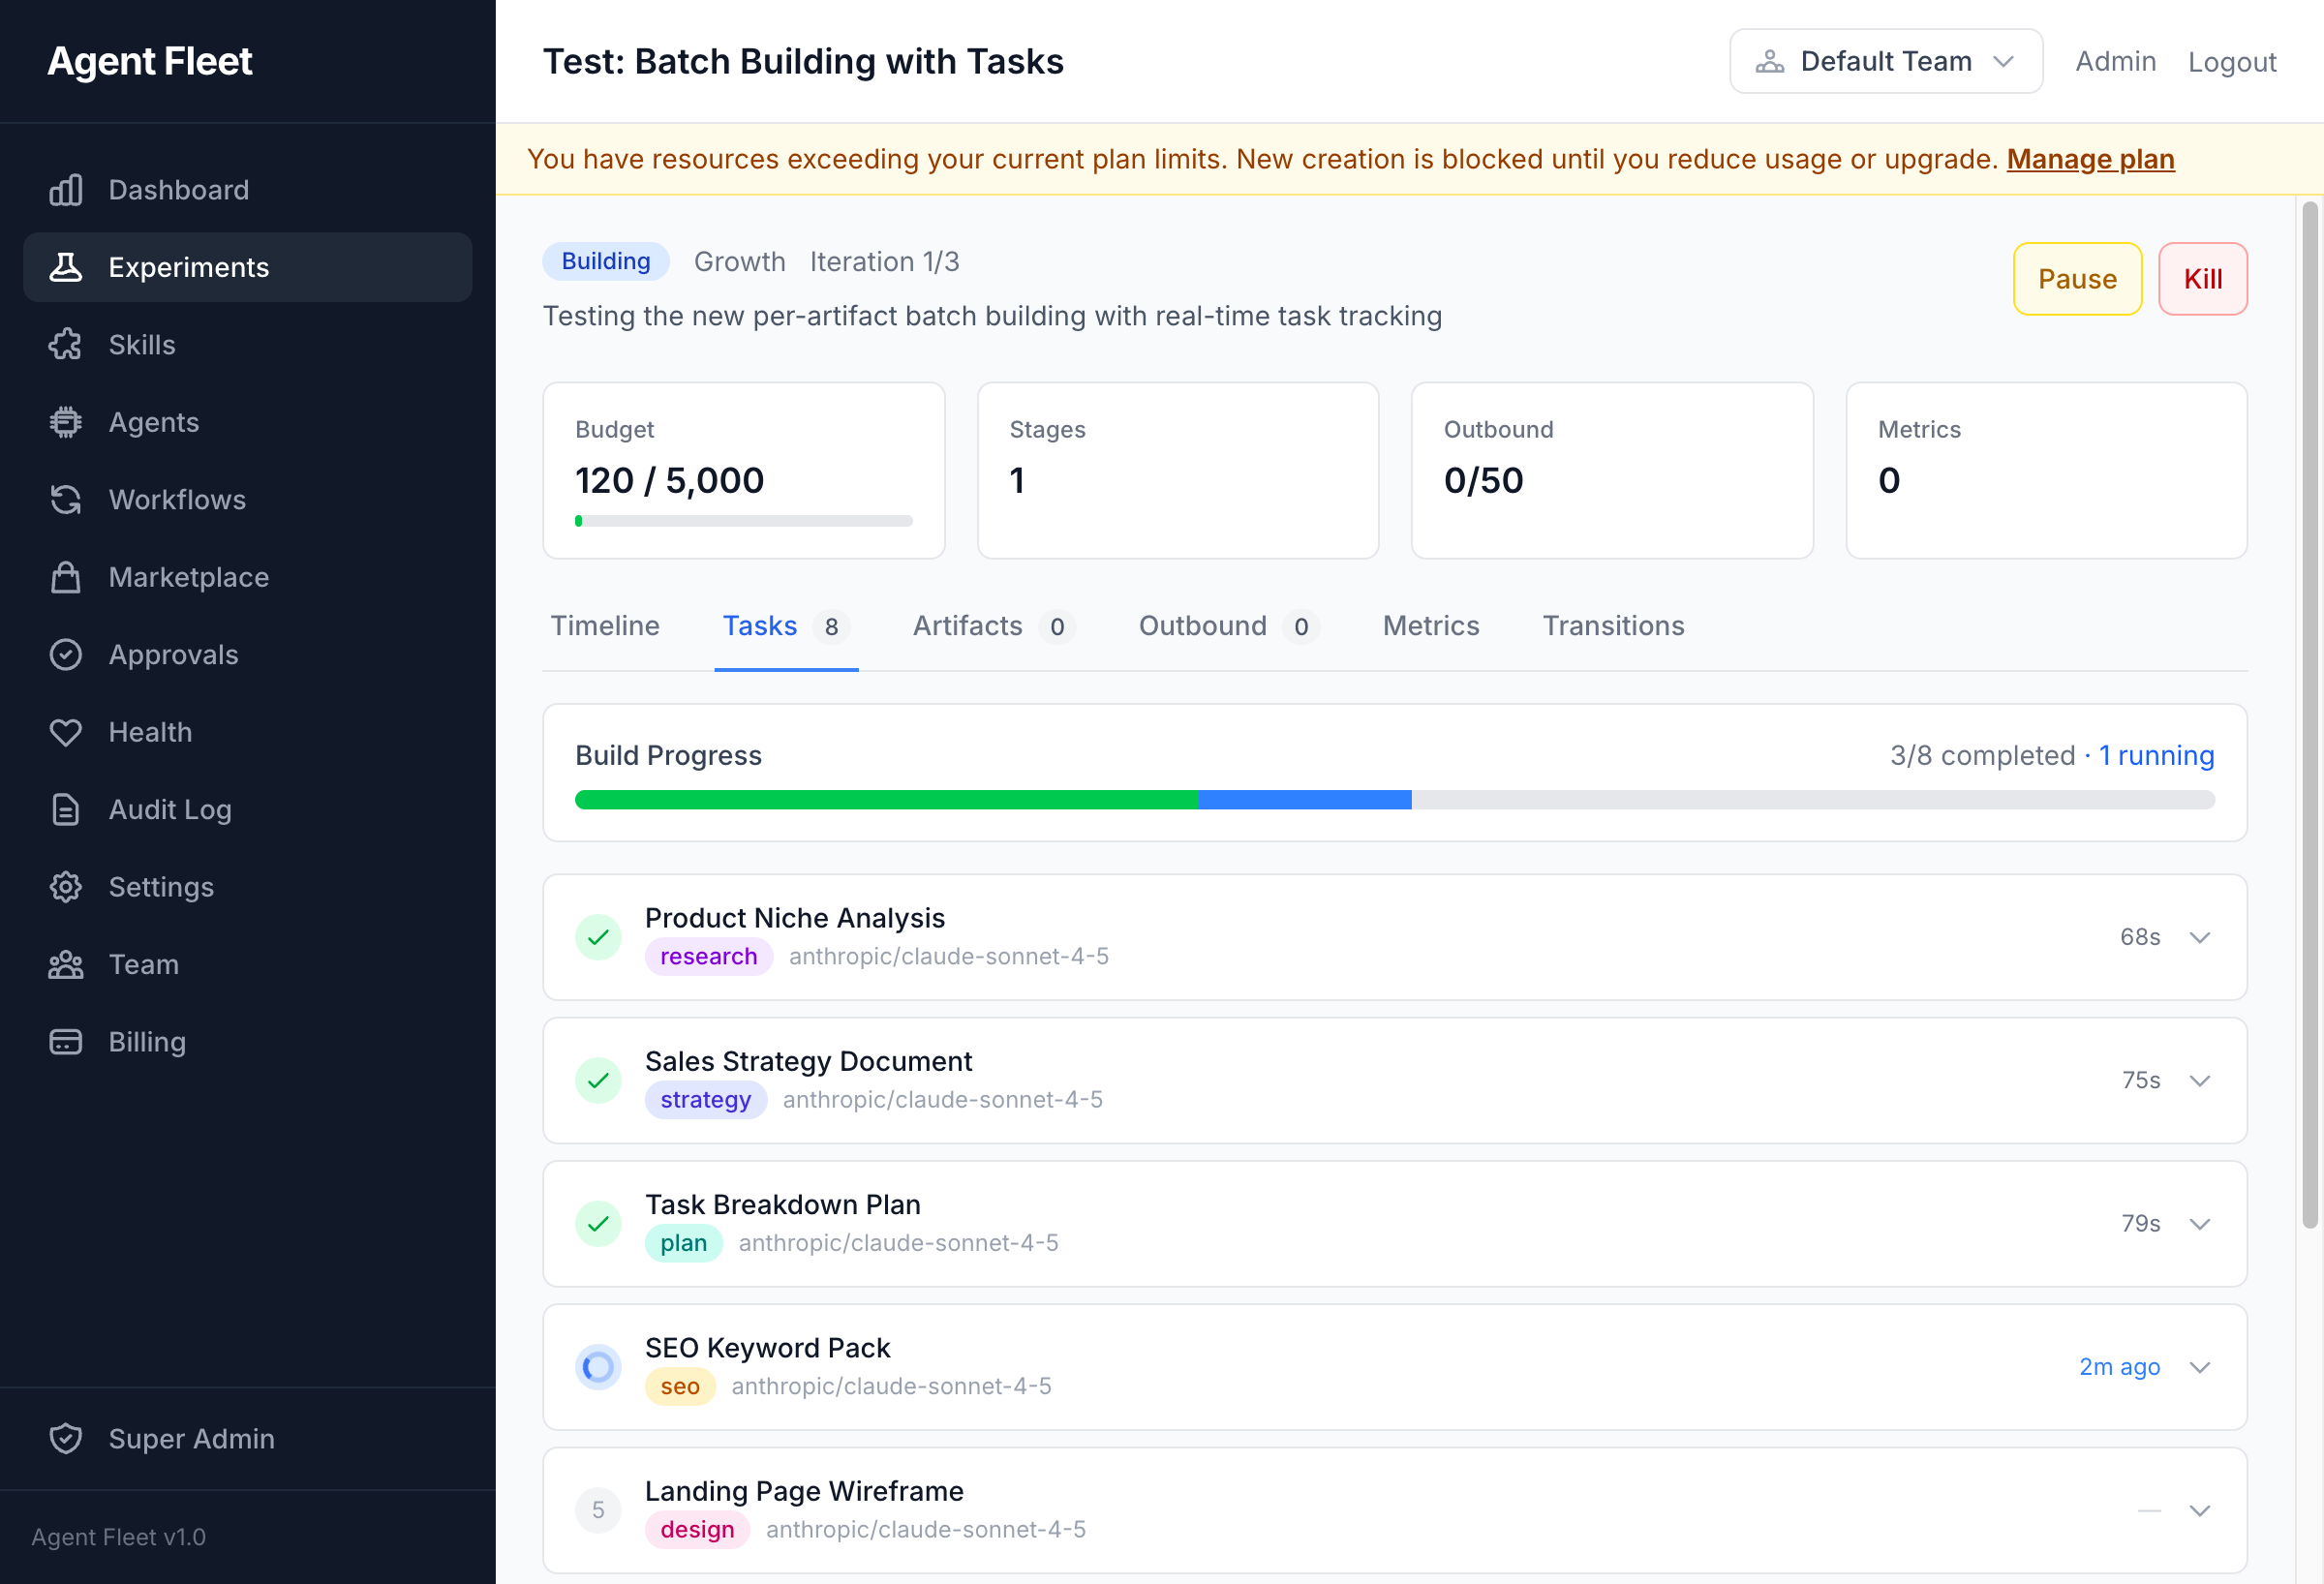
|
Saída de Tarefa Expanda qualquer tarefa concluída para inspecionar a saída gerada por IA, incluindo respostas JSON estruturadas. 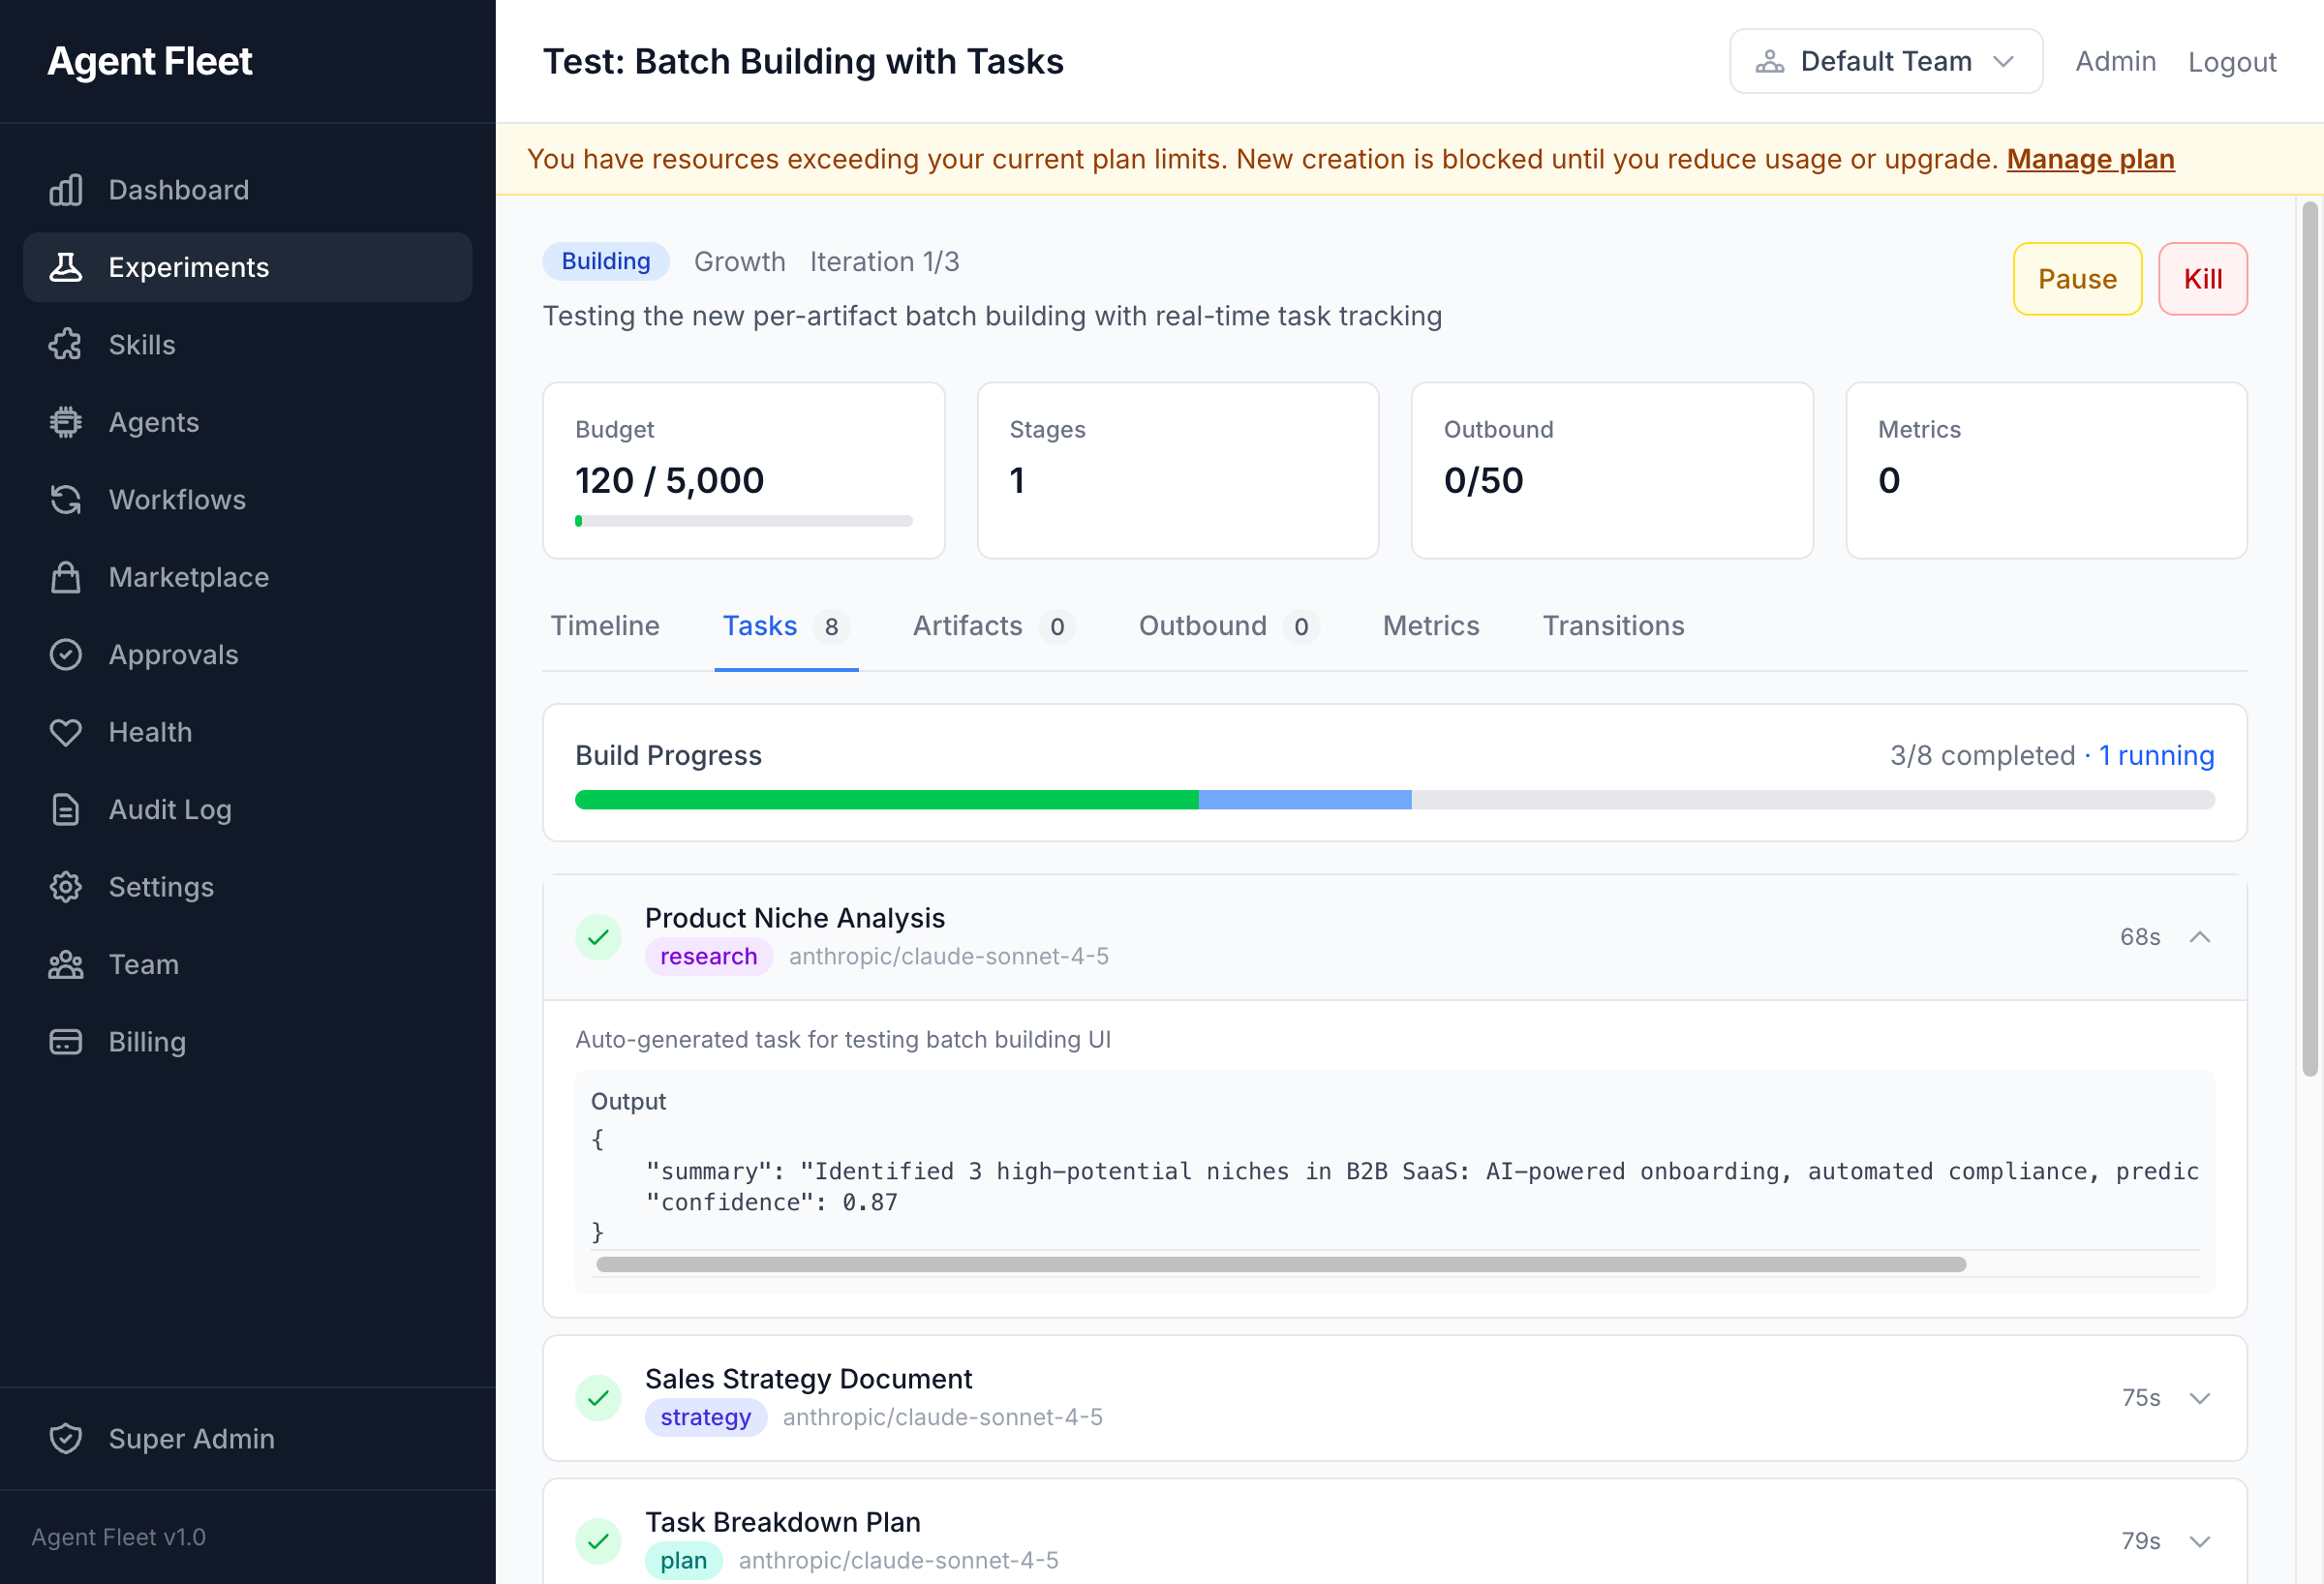
|
|
Construtor Visual de Fluxos de Trabalho Editor de fluxos de trabalho baseado em DAG com ramificações condicionais, tarefas humanas, nós switch e forks dinâmicos. 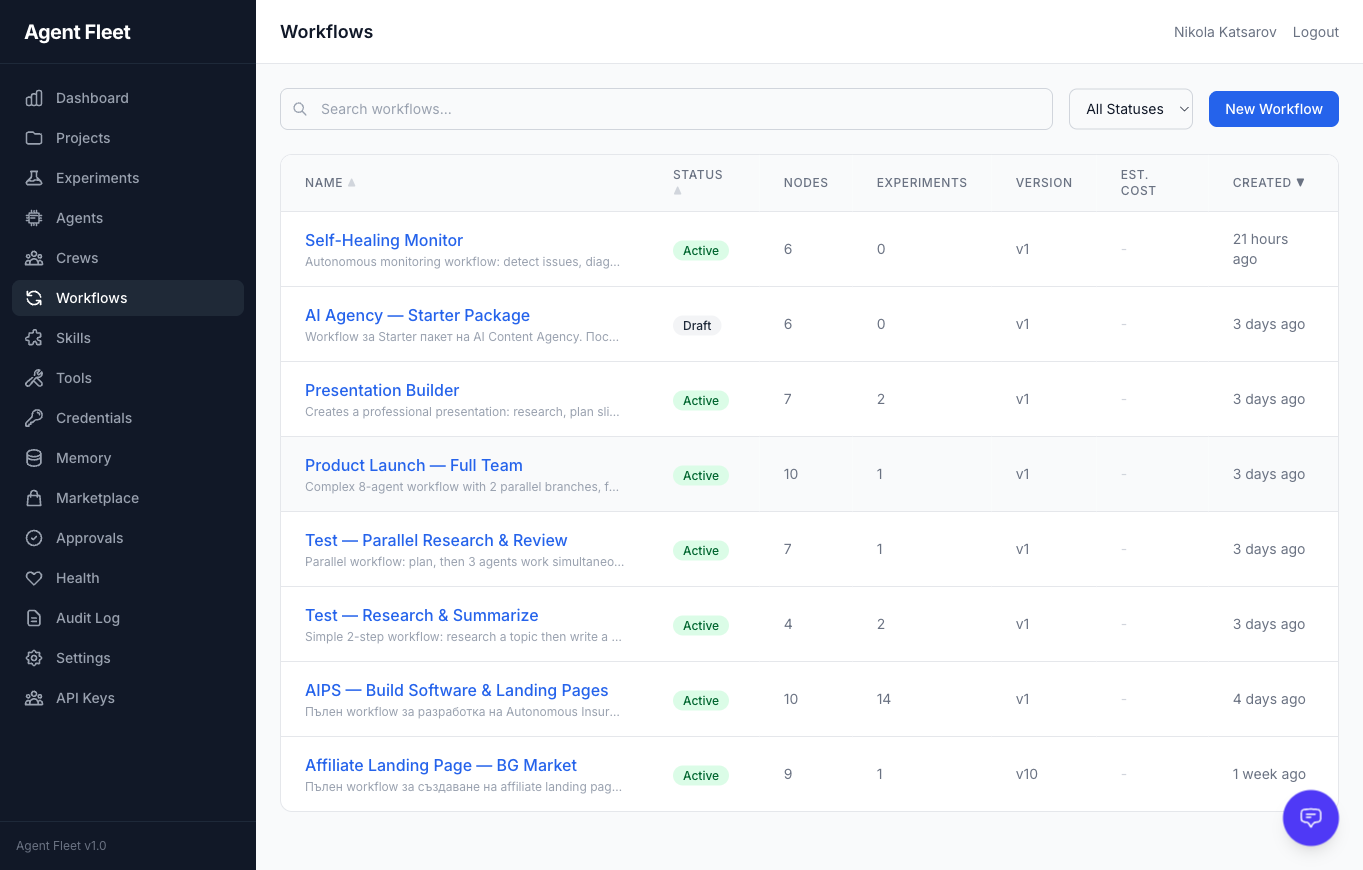
|
Gerenciamento de Ferramentas Gerencie servidores MCP, ferramentas integradas e integrações externas com classificação de risco e atribuição por agente. 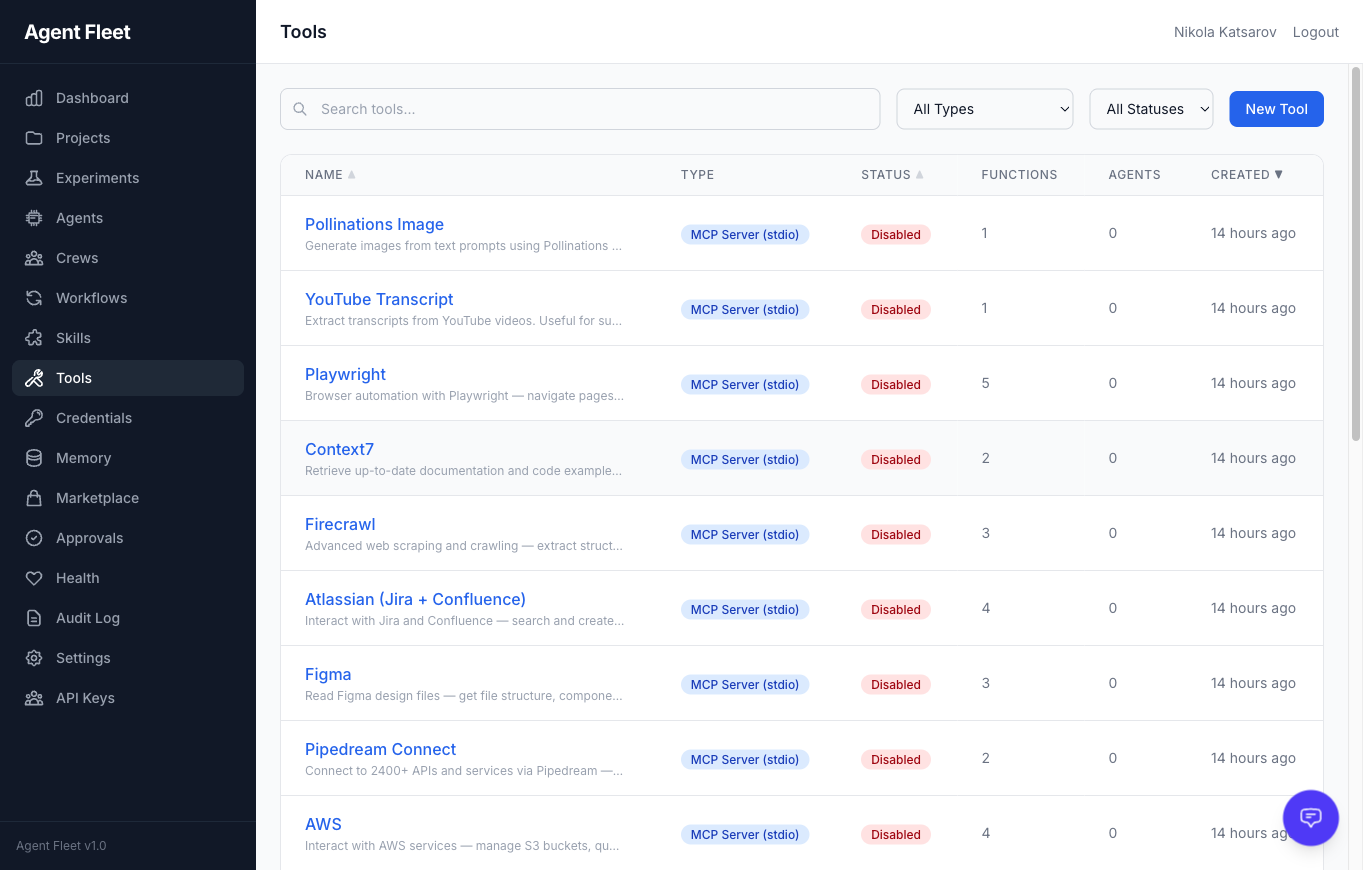
|
|
Barra Lateral do Assistente de IA Chat de IA sensível ao contexto embutido em cada página com 28 ferramentas integradas para consultar e gerenciar a plataforma. 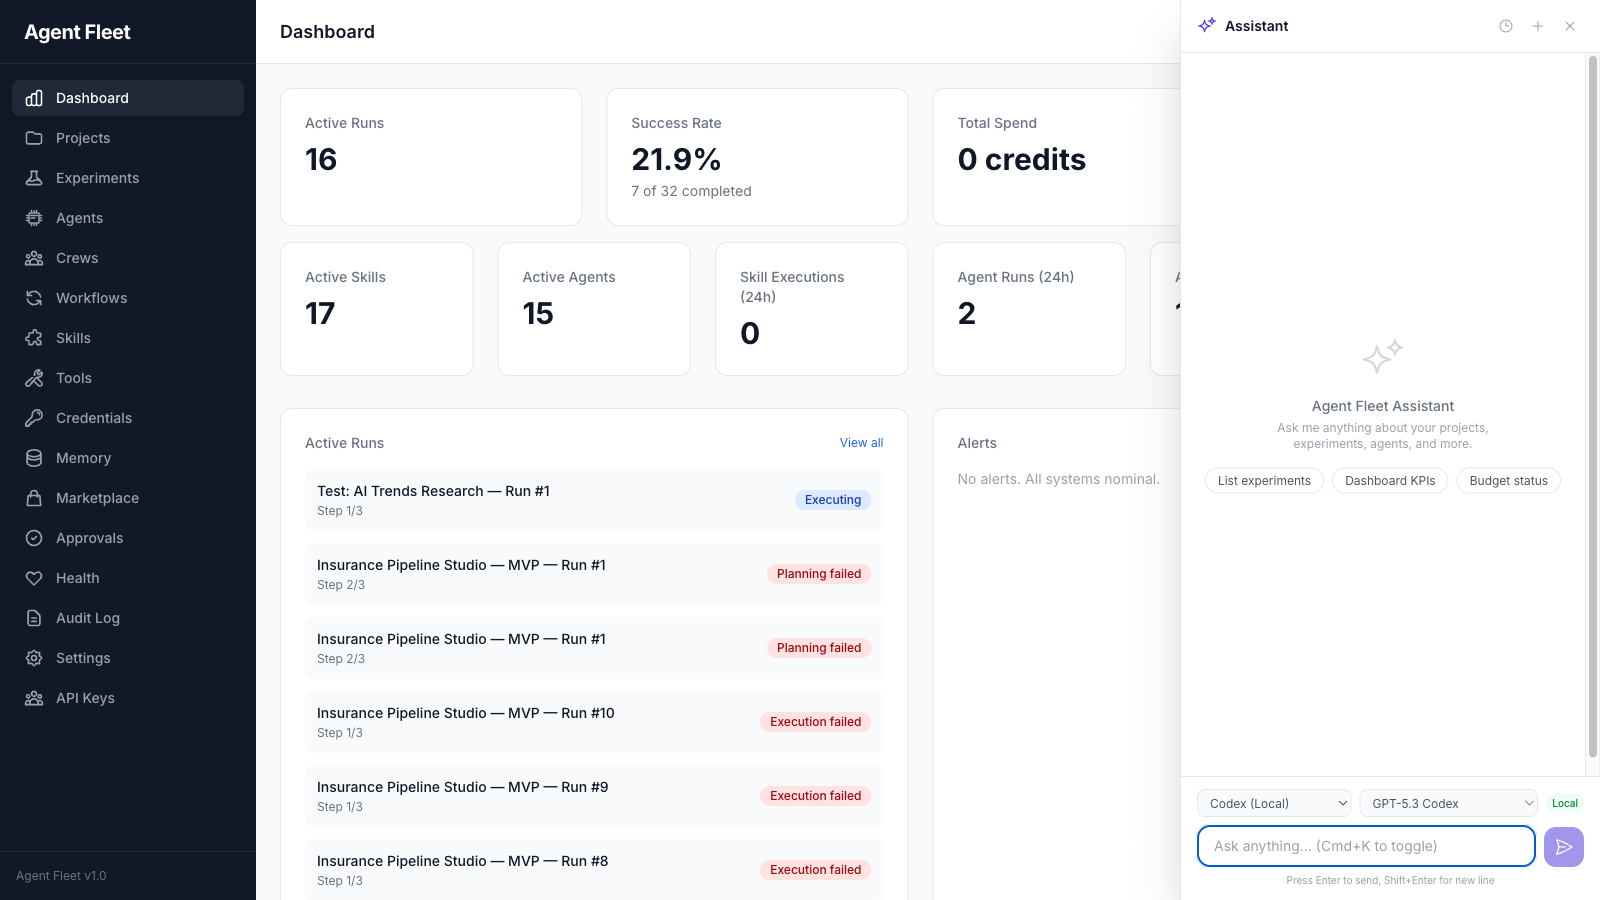
|
Detalhe do Experimento Visão completa do ciclo de vida do experimento com linha do tempo, tarefas, transições, artefatos, métricas e entrega de saída. 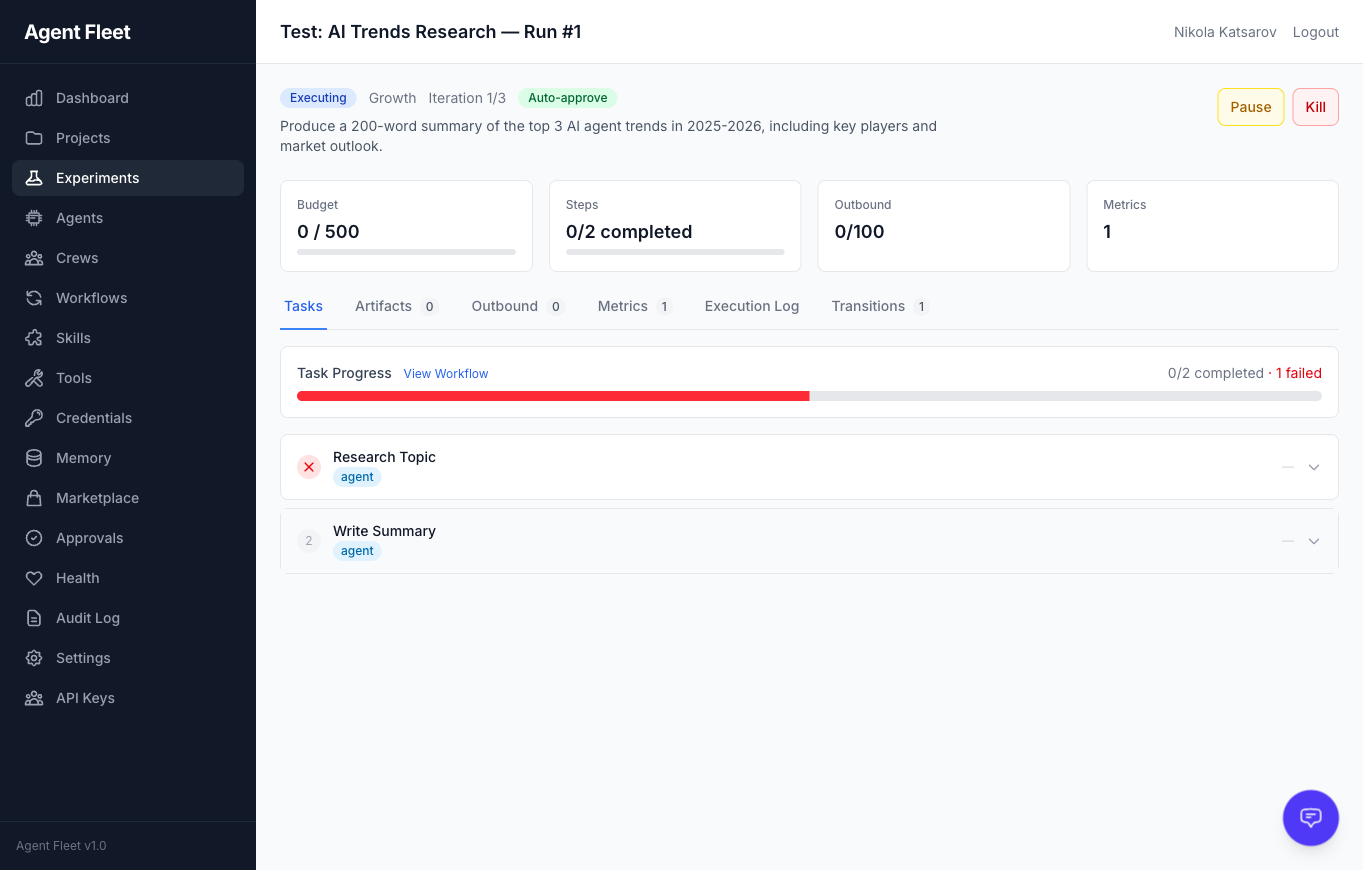
|
|
Configurações e Webhooks Configurações globais da plataforma, chaves de provedores de IA (BYOK), conectores de saída e configuração de webhooks. 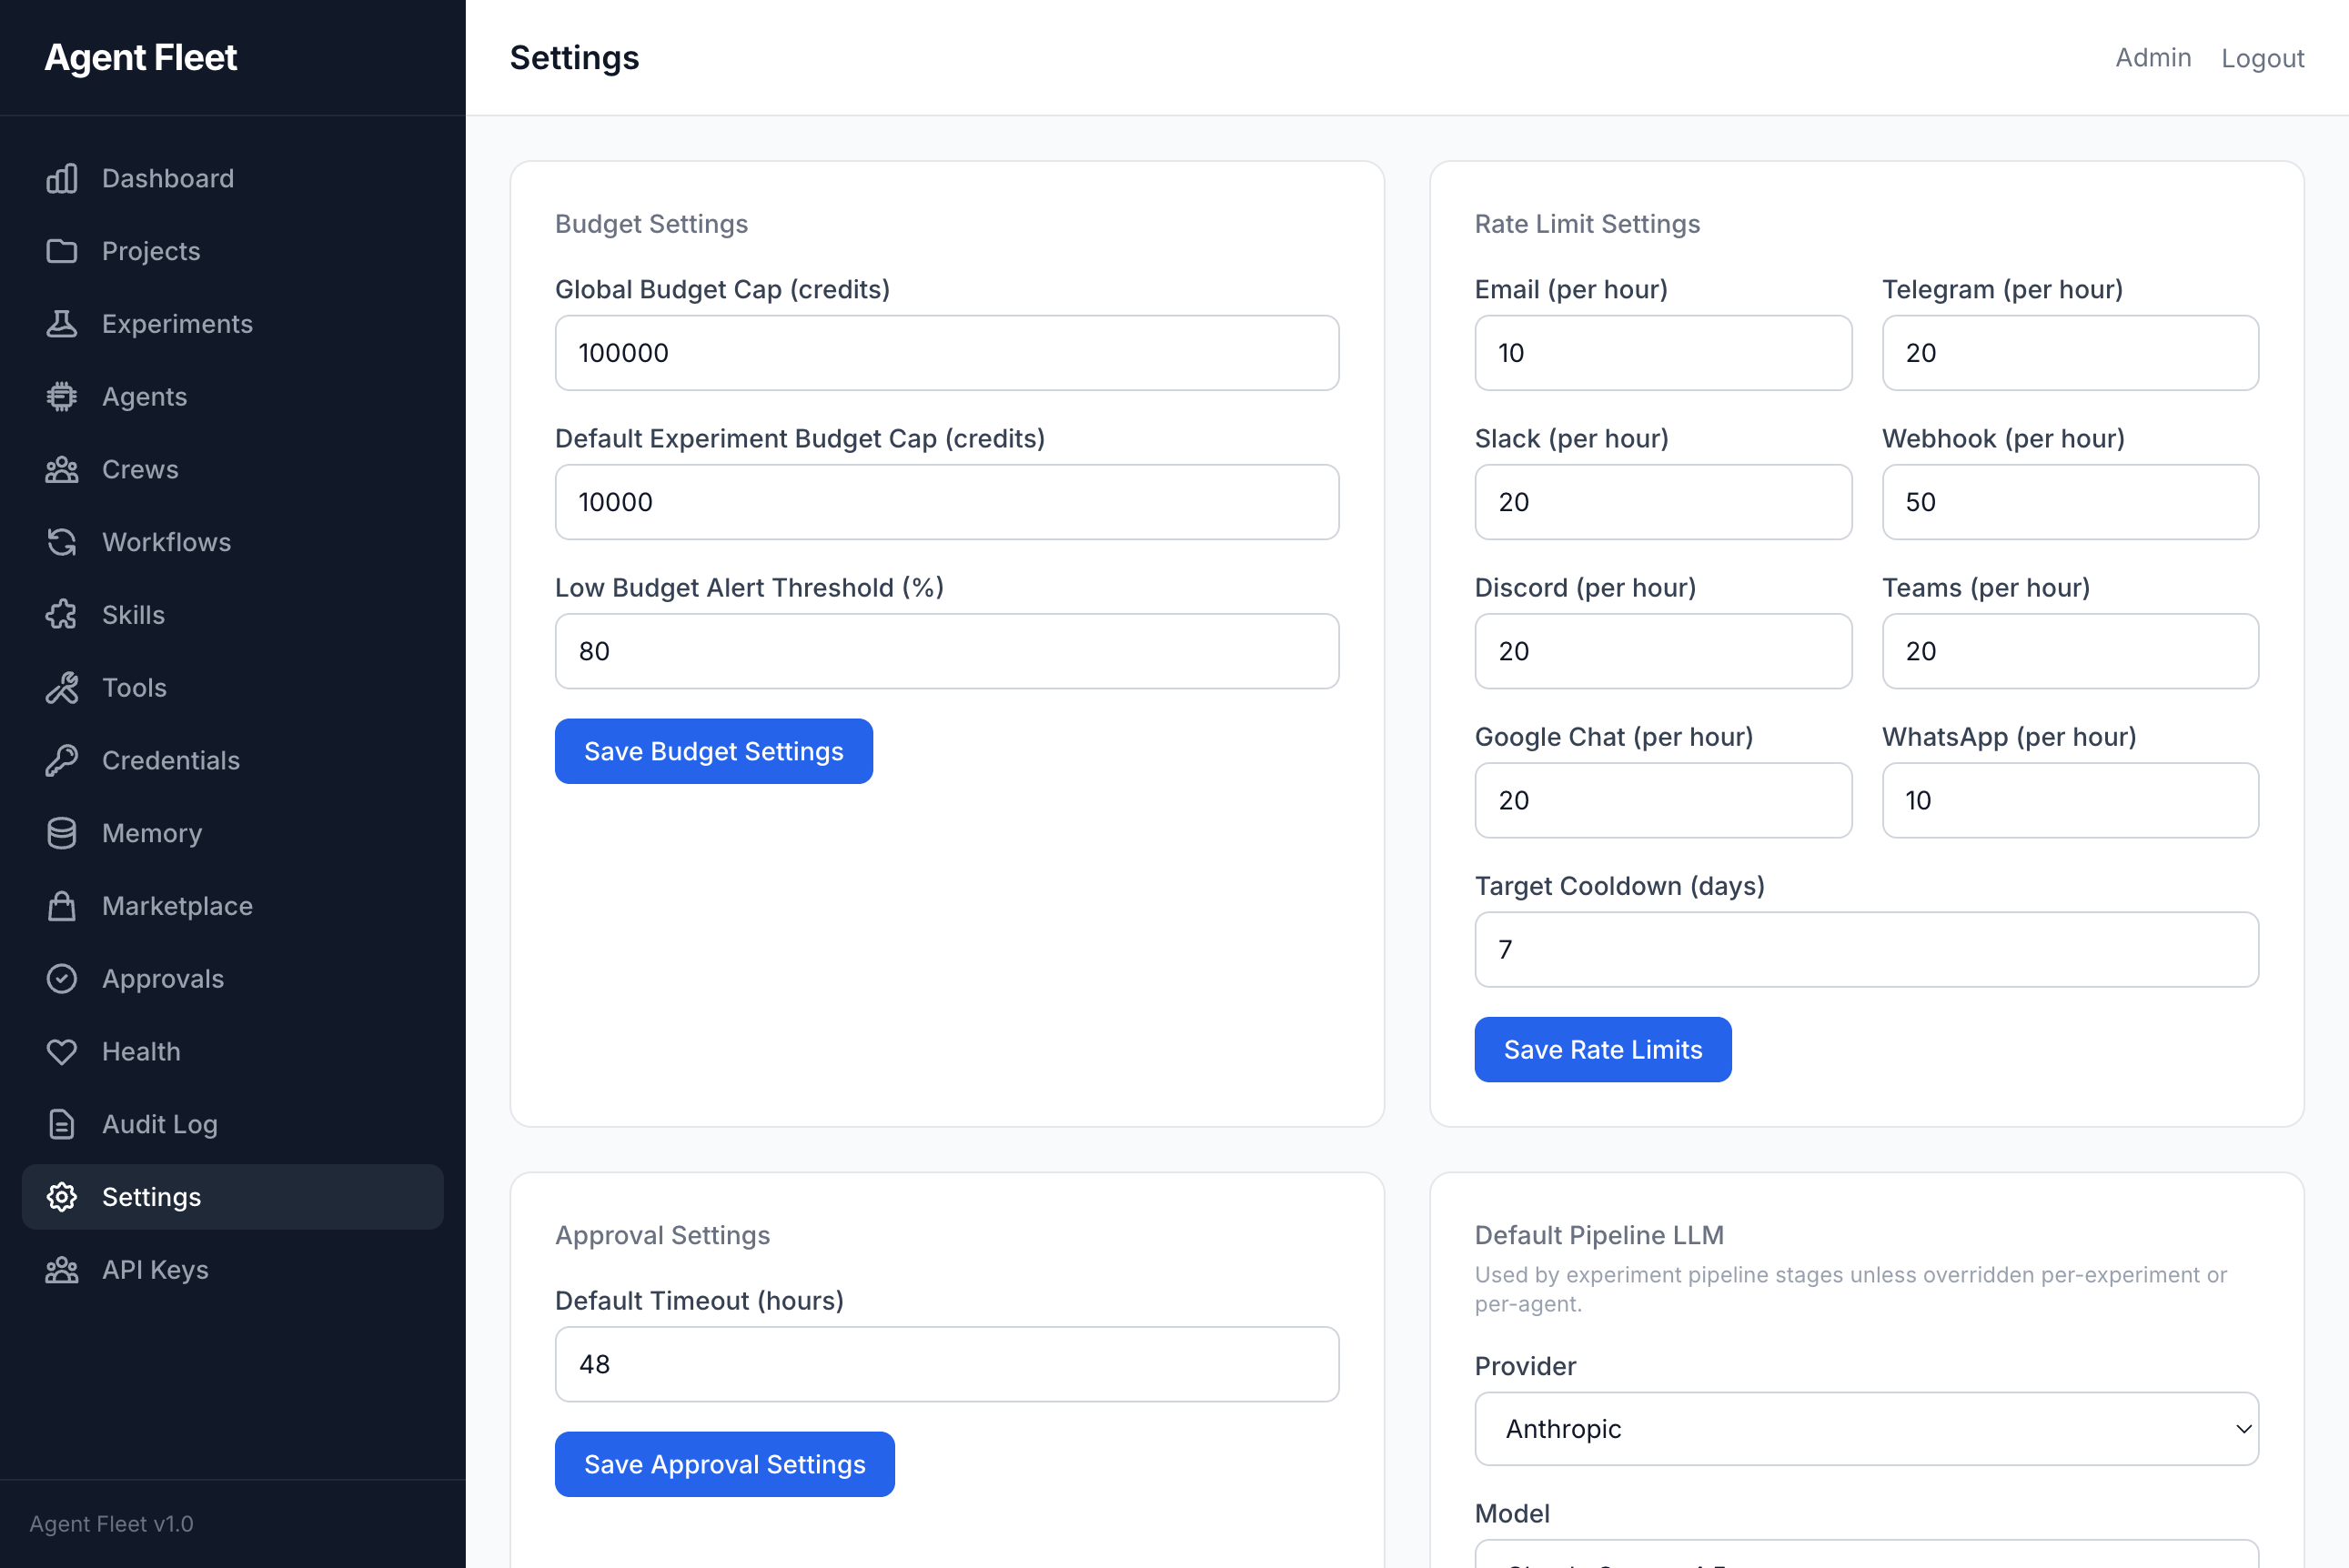
|
Tratamento de Erros Tarefas com falha exibem informações detalhadas de erro, incluindo provedor, tipo de erro e IDs de requisição para depuração. 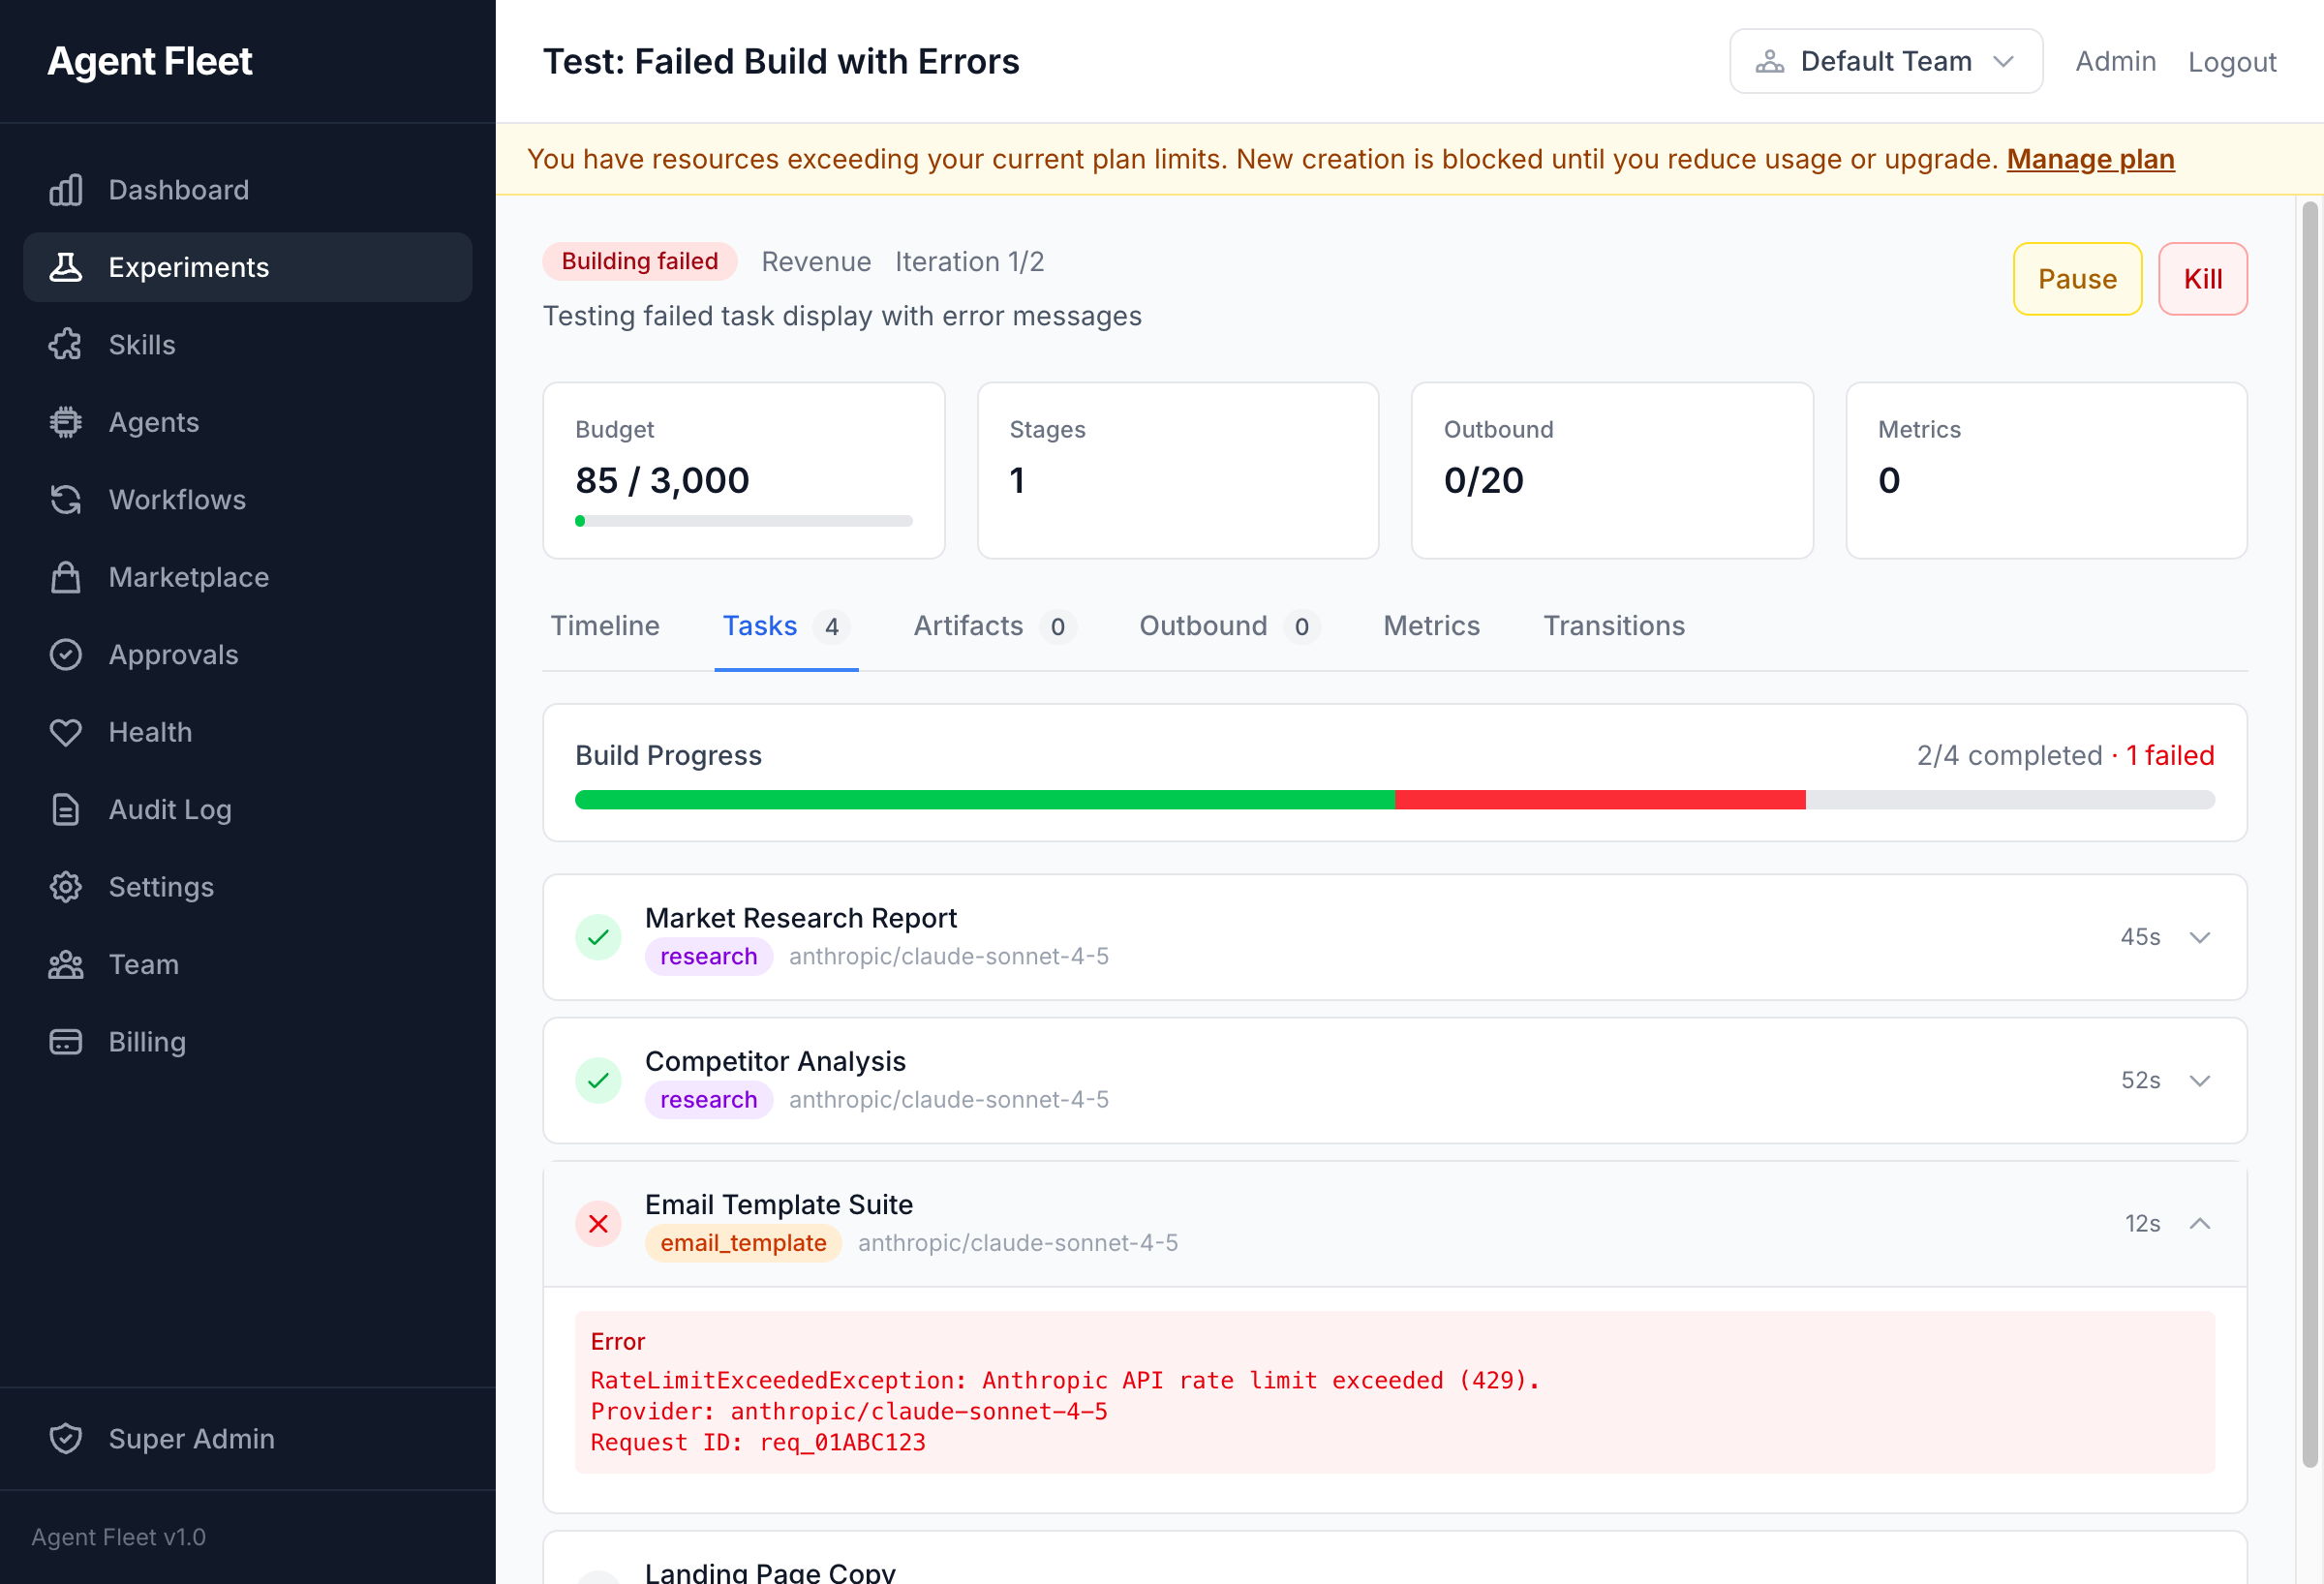
|
Recursos
Agentes, equipes e fluxos de trabalho
- Agentes de IA — papel, objetivo, histórico, traços de personalidade, atribuições de habilidades, cadeias de fallback de provedor/modelo por agente
- Templates de Agentes — 14 templates pré-construídos em 5 categorias (engenharia, conteúdo, negócios, design, pesquisa)
- Evolução de Agentes — o LLM analisa o histórico de execução, propõe mudanças de configuração, aprovação com um clique
- Equipes de Agentes — times multi-agente com papéis de coordenador/QA/trabalhador, 7 tipos de processo (sequencial, paralelo, hierárquico, auto-reivindicação, adversarial, fanout, sala de chat), pontuação de QA ponderada
- Fase de Reconhecimento Pré-Execução — chamada LLM barata antes da execução identifica qual conhecimento o agente precisa → busca semântica direcionada em vez de recuperação genérica
- Consciência de Orçamento de Passos — o prompt do sistema do agente visa 80% dos passos permitidos para o trabalho principal, reservando o restante para síntese
- Pipeline de Experimentos — máquina de estados de 20 estágios com progressão automática (pontuação → planejamento → construção → aprovação → execução → métricas → avaliação)
- DAG Visual de Fluxos de Trabalho — 8 tipos de nós (agente, condicional, tarefa humana, switch, fork dinâmico, do-while, compensação, sub-fluxo). Template pré-construído de Ciclo de Desenvolvimento Web. Gerador de fluxo de trabalho a partir de linguagem natural.
- Projetos — projetos únicos e contínuos com agendamento cron, limites de orçamento, marcos, políticas de sobreposição
LLMs e computação
- BYOK — traga suas próprias chaves para Anthropic (Claude), OpenAI (GPT-4o), Google (Gemini)
- LLMs locais — Ollama, LM Studio, vLLM, llama.cpp via endpoints compatíveis com OpenAI; 17 modelos Ollama predefinidos; proteção SSRF
- Agentes locais — Codex e Claude Code como backends de execução (auto-detectados, custo zero)
- Portkey Gateway — opcional, plug-and-play que desbloqueia 250+ provedores de LLM com cache semântico e fallbacks
- Integração RunPod GPU — invoque endpoints serverless do RunPod ou gerencie ciclos de vida completos de pods GPU como habilidades; chave API BYOK; preços spot
- Provedores de Computação Plugáveis —
gpu_computehabilidades suportadas por RunPod, Replicate, Fal.ai, Vast.ai - AI Gateway — agnóstico de provedor via PrismPHP com middleware de 6 camadas (rate-limit, orçamento, idempotência, cache semântico, validação de schema, rastreamento de uso), circuit breakers, cadeias de fallback
- Cache Semântico — similaridade de cosseno com pgvector (limiar 0.92) cache entre equipes — reduz gasto com LLM em prompts repetidos
Sinais, gatilhos, saída
- Conectores de sinais — 20+ drivers: webhook, RSS, IMAP, Slack, Discord, WhatsApp, GitHub, Linear, Jira, PagerDuty, Sentry, Datadog, ClearCue, Telegram, Matrix, Notion, Confluence, Screenpipe, Searxng, e mais
- Sinais de relatórios de bug — pipeline de QA leve com widget JS público, captura de screenshot + console + rede + log de ações, comentários em thread (relator + agente + suporte), delegação de agentes, escalonamento SLA
- Regras de gatilho — automação orientada a eventos com avaliador de condições, teste de simulação
- Saída Multi-Canal — Email (SMTP), Webhook, ntfy além de oito canais de chat como drivers de primeira classe (Telegram, Slack, Discord, Microsoft Teams, Google Chat, Matrix, Signal, Supabase Realtime), cada um com página de configuração, rate limiting e lista negra
- Webhooks — entrada (HMAC-SHA256) + saída (retry, filtragem de eventos)
Human-in-the-loop, orçamentos, segurança
- Aprovações — caixa de entrada com aplicação de SLA + escalonamento
- Tarefas Humanas — schemas de formulário embutidos em nós de fluxo de trabalho
- Razão de Crédito — por experimento e por projeto com bloqueio pessimista e pausa automática em caso de gasto excessivo
- Cofre de Credenciais — credenciais de serviços externos criptografadas com rotação, OAuth2, rastreamento de expiração, injeção por projeto
- Ferramentas SSH — verificação de impressão digital TOFU (Trust On First Use), whitelist de comandos permitidos por ferramenta, política de segurança de comandos em múltiplas camadas
- Trilha de Auditoria — log completo de atividades (spatie/activitylog), pesquisável e filtrável
- Isolamento de Tenant — disciplina de
TeamScope+BelongsToTeam+withoutGlobalScopes()em múltiplas camadas
Integrações e pipeline de desenvolvimento web
- Integrações — GitHub, Slack, Notion, Airtable, Linear, Stripe, Vercel, Netlify, webhook/polling genérico com OAuth 2.0
- Pipeline Autônomo de Desenvolvimento Web — agentes podem abrir PRs, mesclar, disparar workflows de CI, criar releases, acionar deploys na Vercel/Netlify/SSH por meio de ferramentas MCP
- Construtor de Sites — sites estáticos gerados por IA com 8 tipos de widgets, drivers de deploy Vercel + ZIP, envios de formulários, widgets de blog/navegação/contato
- Pacote Founder Mode — pacote do marketplace com 6 agentes de persona (Estrategista, Líder de Produto, Growth Hacker, Consultor Financeiro, Gerente de Operações, Oficial de Risco), 20 habilidades de frameworks (RICE, SPIN, BANT, MEDDIC, OKRs, Shape Up, Unit Economics, Kano, TAM-SAM-SOM, K-Factor, NPV-IRR, RACI, A/B Testing, OWASP), 5 workflows pré-construídos
- Marketplace — navegue, publique, instale habilidades, agentes, workflows e pacotes compartilhados com varredura de risco por IA
Superfície de API e MCP
- API REST — mais de 175 endpoints sob
/api/v1/com autenticação Sanctum, paginação por cursor, OpenAPI 3.1 gerado automaticamente em/docs/api - Servidor MCP — mais de 675 ferramentas Model Context Protocol em 45 domínios (62 grupos de ferramentas) (stdio + HTTP/SSE + OAuth2/PKCE)
- Governança de Ações no Mundo Real — o fluxo
ActionProposalcontrola chamadas de ferramentas do assistente, gravações de integrações e pushes de git por meio de uma política de risco por nível com execução automática após aprovação - Endpoint público de descoberta —
GET /.well-known/fleetqretorna um manifesto de capacidades controlado por configuração para que ferramentas de IA externas possam se autoconfigurar - Grafo de equipe ao vivo — página
/team-graphcom atualizações em tempo real via Laravel Reverb WebSockets - Erros MCP estruturados — códigos de erro canônicos no estilo gRPC (
UNAVAILABLE,PERMISSION_DENIED,RESOURCE_EXHAUSTED,DEADLINE_EXCEEDED,INVALID_ARGUMENT,FAILED_PRECONDITION,NOT_FOUND,INTERNAL) com dicas de nova tentativa — os agentes sabem quando tentar novamente versus falhar rapidamente - Prazos por ferramenta — parâmetro opcional
deadline_msem cada ferramenta MCP; os agentes podem limitar o tempo de relógio por chamada - Rastreamento OpenTelemetry — exportador HTTP OTLP, Jaeger all-in-one via
docker compose --profile observability up, spans para ferramenta MCP → gateway de IA → provedor de LLM - Gerenciamento de Ferramentas — servidores MCP (stdio/HTTP), ferramentas integradas (bash/filesystem/browser), classificação de risco, atribuição por agente
- Compatibilidade com clientes MCP — Claude Desktop, Claude.ai, ChatGPT Apps, Cursor, Codex, Claude Code, Gemini CLI, qualquer cliente OAuth2
Infraestrutura
- Gerenciamento de Filas — Laravel Horizon com 6 filas de prioridade e autoescalonamento
- Testes — suítes de testes de regressão para saídas de agentes com avaliação automatizada
- Diretório de Trabalho por Chamada — agentes locais/bridge podem operar em um diretório de trabalho configurado por agente, com contextos de projeto isolados
Casos de Uso
O FleetQ é construído para equipes que executam agentes de IA em produção, não para demonstrações de brinquedo.
- Pipelines de desenvolvimento autônomos — agente abre PR → CI executa → agente revisor aprova → mescla → deploy. Humanos aprovam apenas em sinais de risco.
- Triagem de suporte ao cliente — widget de relatório de bug → agente extrai etapas de reprodução do console/log de rede → experimento é executado → notifica o relator com correção ou solução alternativa gerada por agente.
- Pesquisa multiagente — equipe de Estrategista + Pesquisador + Redator com revisor de QA. Cada etapa ponderada por rubrica de domínio.
- Operações de conteúdo agendadas — projeto contínuo executa diariamente, cada execução executa um DAG: rascunho → revisão → verificação de SEO → publicação → agendamento social.
- Resposta a incidentes — sinal PagerDuty/Sentry → regra de gatilho → agente de diagnóstico → aprovação humana na ação do runbook → notificação no Slack.
- Cargas de trabalho GPU — agente chama a habilidade
gpu_computeno RunPod serverless (Whisper, FLUX, Bark) como parte de um workflow maior, com contabilidade de custos. - Desenvolvimento de agentes local-first — Ollama + Codex + Claude Code detectados automaticamente, custo zero de API para prototipagem; mude para provedores de nuvem em produção.
- Traga o FleetQ para o Claude — exponha seus dados e ferramentas internos como servidor MCP; Claude Desktop/ChatGPT/Cursor podem acionar a plataforma programaticamente.
Como o FleetQ se compara
| FleetQ | n8n | CrewAI | LangGraph | Make.com | |
|---|---|---|---|---|---|
| Código aberto | ✅ AGPLv3 | ✅ Uso Sustentável | ✅ MIT | ✅ MIT | ❌ Proprietário |
| Construtor visual de DAG | ✅ 8 tipos de nós | ✅ (não focado em IA) | ❌ | ❌ | ✅ |
| Equipes multiagente | ✅ 7 tipos de processo | ❌ | ✅ | ✅ (construa o seu) | ❌ |
| Servidor MCP (nativo) | ✅ 675+ ferramentas | ❌ | ❌ | ❌ | ❌ |
| Humano no circuito | ✅ nativo | ⚠️ solução alternativa | ⚠️ código | ⚠️ código | ⚠️ nó de aprovação |
| Ledger de orçamento + bloqueios | ✅ pessimista | ❌ | ❌ | ❌ | ❌ |
| Trilha de auditoria | ✅ cada ação | ✅ | ❌ | ❌ | ✅ |
| BYOK + LLMs locais | ✅ ambos | ⚠️ apenas BYOK | ⚠️ depende | ⚠️ BYOK | ❌ |
| Auto-hospedado | ✅ Docker Compose | ✅ | n/a (biblioteca) | n/a (biblioteca) | ❌ |
| Evolução de agentes (auto-melhoria) | ✅ | ❌ | ❌ | ❌ | ❌ |
| Rastreamento OpenTelemetry | ✅ nativo | ❌ | ❌ | ⚠️ parcial | ❌ |
| Medição de crédito/uso | ✅ por equipe/projeto | ❌ | ❌ | ❌ | por workspace |
TL;DR — se você está construindo sistemas de agentes de produção com LLMs e quer workflows visuais + MCP + supervisão humana, o FleetQ é a única plataforma que reúne tudo isso.
Início Rápido (Docker)
git clone https://github.com/escapeboy/agent-fleet-o.git
cd agent-fleet
make install
Isso irá:
- Copiar
.env.examplepara.env - Construir e iniciar todos os serviços Docker
- Executar o assistente de configuração interativo (banco de dados, conta de administrador, provedor de LLM)
Visite http://localhost:8080 quando concluído.
Início Rápido (Manual — Configuração Web)
Requisitos: PHP 8.4+, PostgreSQL 17+, Redis 7+, Node.js 20+, Composer
git clone https://github.com/escapeboy/agent-fleet-o.git
cd agent-fleet
composer install
npm install && npm run build
cp .env.example .env
# Edit .env — set DB_HOST, DB_DATABASE, DB_USERNAME, DB_PASSWORD, REDIS_HOST
php artisan key:generate
php artisan migrate
php artisan horizon &
php artisan serve
Em seguida, abra http://localhost:8000 no seu navegador. A página de configuração irá guiá-lo na criação da sua conta de administrador.
Alternativa: Execute
php artisan app:installpara um assistente de configuração CLI interativo que também popula agentes e habilidades padrão.
Autenticação
- Sem verificação de e-mail — a edição auto-hospedada pula a verificação de e-mail completamente. As contas ficam ativas imediatamente no registro.
- Usuário único — todos os usuários registrados entram no workspace padrão automaticamente.
Modo Sem Senha (instalações locais)
Se você está executando o FleetQ localmente na sua própria máquina e não quer digitar uma senha a cada visita, defina APP_AUTH_BYPASS=true em .env:
APP_AUTH_BYPASS=true   # Auto-login as first user
APP_ENV=local          # Required — bypass is disabled in production
Com o bypass habilitado, o aplicativo faz login automaticamente em cada requisição. Um link de logout ainda é exibido, mas você será logado novamente no próximo carregamento de página — isso é intencional.
Aviso: Nunca defina
APP_AUTH_BYPASS=trueem um servidor acessível pela internet.
Configuração
Toda a configuração está em .env. Variáveis-chave:
# Database (PostgreSQL required)
DB_CONNECTION=pgsql
DB_HOST=postgres
DB_DATABASE=agent_fleet

# Redis (queues, cache, sessions, locks)
REDIS_HOST=redis
REDIS_DB=0          # Queues
REDIS_CACHE_DB=1    # Cache
REDIS_LOCK_DB=2     # Locks

# LLM Providers -- at least one required for AI features
ANTHROPIC_API_KEY=
OPENAI_API_KEY=
GOOGLE_AI_API_KEY=

# Auth bypass -- local no-password mode (never use in production)
APP_AUTH_BYPASS=false
Chaves LLM adicionais podem ser configuradas em Configurações > Chaves de Provedores de IA após o login.
Para usar modelos locais (Ollama, LM Studio, vLLM):
LOCAL_LLM_ENABLED=true
LOCAL_LLM_SSRF_PROTECTION=false  # set false if Ollama is on a LAN IP (192.168.x.x)
LOCAL_LLM_TIMEOUT=180
Em seguida, configure os endpoints em Configurações > Endpoints LLM Locais.
Acesso SSH ao Host
Os agentes podem executar comandos na máquina host (ou em qualquer servidor remoto) via SSH usando o tipo de ferramenta SSH integrado. Isso é útil para executar scripts locais, interagir com o sistema de arquivos ou orquestrar processos de nível de host a partir de um agente.
Como funciona
- A plataforma armazena chaves privadas SSH criptografadas no cofre de Credenciais.
- Uma Ferramenta SSH é configurada com
host,port,username,credential_ide uma lista de permissõesallowed_commandsopcional. - Na primeira conexão a um host, a impressão digital da chave pública do servidor é armazenada via TOFU (Trust On First Use). Conexões subsequentes verificam a impressão digital — uma incompatibilidade gera um erro para prevenir ataques MITM.
- Gerencie impressões digitais confiáveis via Configurações > Impressões Digitais SSH ou a ferramenta MCP
tool_ssh_fingerprints.
Configuração (Docker — conectando contêiner ao host)
Os contêineres alcançam a máquina host via host.docker.internal, que é pré-configurado em docker-compose.yml via extra_hosts: host.docker.internal:host-gateway.
Passo 1 — Habilite SSH no host
| SO | Comando |
|---|---|
| macOS | Ajustes do Sistema → Geral → Compartilhamento → Login Remoto → Ativado |
| Ubuntu/Debian | sudo apt install openssh-server && sudo systemctl enable --now ssh |
| Fedora/RHEL | sudo dnf install openssh-server && sudo systemctl enable --now sshd |
| Windows | Configurações → Sistema → Recursos Opcionais → Servidor OpenSSH, depois Start-Service sshd |
Passo 2 — Gere um par de chaves SSH
ssh-keygen -t ed25519 -C "fleetq-agent@local" -f ~/.ssh/fleetq_agent_key -N ""
Passo 3 — Autorize a chave no host
cat ~/.ssh/fleetq_agent_key.pub >> ~/.ssh/authorized_keys
chmod 600 ~/.ssh/authorized_keys
Passo 4 — Crie uma Credencial no FleetQ
Navegue até Credenciais → Nova Credencial:
- Tipo:
SSH Key - Cole o conteúdo de
~/.ssh/fleetq_agent_key(chave privada)
Ou via API:
curl -X POST http://localhost:8080/api/v1/credentials \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Host SSH Key",
    "credential_type": "ssh_key",
    "secret_data": {"private_key": "<contents of fleetq_agent_key>"}
  }'
Passo 5 — Crie uma Ferramenta SSH
Navegue até Ferramentas → Nova Ferramenta → Integrada → SSH Remoto, ou via API:
curl -X POST http://localhost:8080/api/v1/tools \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Host SSH",
    "type": "built_in",
    "risk_level": "destructive",
    "transport_config": {
      "kind": "ssh",
      "host": "host.docker.internal",
      "port": 22,
      "username": "your-username",
      "credential_id": "<credential-id>",
      "allowed_commands": ["ls", "pwd", "whoami", "uname", "date", "df"]
    },
    "settings": {"timeout": 30}
  }'
Passo 6 — Atribua a ferramenta a um agente
Na página de detalhes do Agente, vá em Ferramentas e atribua a ferramenta SSH. O agente agora terá uma função ssh_execute disponível durante a execução.
Política de segurança de comandos
A plataforma aplica uma hierarquia de segurança em múltiplas camadas para comandos bash e SSH:
- Nível de plataforma — sempre bloqueados:
rm -rf /,mkfs,shutdown,reboot, padrões de pipe-para-shell - Nível de organização — configure em Configurações > Política de Segurança ou via ferramenta MCP
tool_bash_policy - Nível de ferramenta — lista de permissões
allowed_commandsna configuração de transporte da ferramenta - Nível de projeto — restrições adicionais nas configurações do projeto
- Nível de agente — sobreposições por agente no pivô da ferramenta
Camadas mais restritivas sempre vencem. Um comando bloqueado no nível de plataforma não pode ser desbloqueado por nenhuma outra camada.
Gerenciamento de impressões digitais SSH
Impressões digitais de hosts confiáveis são visualizáveis e removíveis via:
- API:
GET /api/v1/ssh-fingerprints/DELETE /api/v1/ssh-fingerprints/{id} - MCP:
tool_ssh_fingerprintscom açãolistoudelete
Remova uma impressão digital quando a chave SSH de um host for legitimamente rotacionada — a próxima conexão será reverificada via TOFU.
Arquitetura
flowchart LR
    subgraph Clients["Operators & external agents"]
        UI["Admin UI — Livewire 4 + Alpine"]
        MCPCLI["MCP clients (Claude Desktop, Cursor, Codex, Claude Code)"]
        APIC["REST clients — /api/v1/* (Sanctum)"]
        SIG["Inbound signals (webhook / RSS / IMAP / Slack / Telegram)"]
    end

    UI --> WEB
    APIC --> API
    MCPCLI -->|HTTP/SSE or stdio| MCP
    SIG --> INGEST

    subgraph App["FleetQ app (Laravel 13 / PHP 8.4)"]
        WEB["Web routes (auth:web)"] --> DOM
        API["/api/v1/* — Sanctum tokens"] --> DOM
        MCP["AgentFleetServer — 675+ MCP tools / 62 tool groups"] --> DOM
        INGEST["SignalWebhookController / IngestSignalAction"] --> TRIG["TriggerRule evaluator"]
        TRIG --> DOM

        DOM["Domain layer — Agent / Crew / Experiment / Workflow / Project / Approval / Budget / Tool / Credential / Skill / Outbound"]
        DOM --> SM["ExperimentStateMachine (20 states)"]
        SM --> EVT(("ExperimentTransitioned event"))
        EVT --> STAGE["BaseStageJob + PlaybookExecutor"]
        STAGE --> GATEWAY["AI Gateway (PrismPHP) — 6-layer middleware + circuit breakers"]
        GATEWAY --> LLM["Providers: Anthropic / OpenAI / Google / Ollama / vLLM / Codex / Claude Code"]
        STAGE --> TOOLS["ToolTranslator — MCP stdio/HTTP, bash, filesystem, browser, SSH (TOFU)"]
        STAGE --> APPR["ApprovalRequest / HumanTask (auth:web inbox)"]
        STAGE --> OUT["Outbound connectors — Email / Telegram / Slack / Webhook / ntfy"]
        STAGE --> ARTI[("Artifact + ArtifactVersion")]

        DOM --> DB[("Postgres 17 + pgvector — semantic cache, UUIDv7, JSONB+GIN")]
        STAGE --> QUEUE[("Redis 7 — 6 Horizon queues, cache, locks")]
        APPR --> DB
        ARTI --> DB
    end

    subgraph Optional["Optional Docker profiles"]
        REVERB["Reverb — WebSocket live team graph"]
        BROWSER["browserless (Chromium)"]
        SEARX["searxng"]
        VOICE["voice-worker (LiveKit / Deepgram)"]
        SANDBOX["bash_sidecar (sandboxed shell)"]
        RELAY["fleetq-bridge relay"]
        JAEGER["Jaeger — OTLP traces (--profile observability)"]
    end

    App -.OTLP spans.-> JAEGER
    UI <-->|WebSocket| REVERB
    TOOLS -.->|browser tools| BROWSER
    TOOLS -.->|web search skill| SEARX
    TOOLS -.->|bash skill| SANDBOX
    App <-->|relay| RELAY
    DOM <--> VOICE
A plataforma é um monólito único em Laravel 13 que expõe três superfícies de controle coiguais sobre a mesma camada de domínio: a UI administrativa Livewire, uma API REST autenticada por Sanctum em /api/v1/* (~175 endpoints) e AgentFleetServer — um servidor MCP com mais de 675 ferramentas em 62 grupos de ferramentas servidas tanto por HTTP/SSE quanto por stdio local. Sinais de entrada (webhook, RSS, IMAP, Slack, Telegram e o restante dos 20+ conectores) fluem através de IngestSignalAction e do avaliador TriggerRule para a camada de domínio, onde o ExperimentStateMachine percorre um pipeline de 20 estados emitindo eventos ExperimentTransitioned cujos listeners despacham o próximo BaseStageJob para filas Redis gerenciadas pelo Horizon. Jobs de estágio falam com LLMs através do AI Gateway baseado em PrismPHP (middleware de limite de taxa, orçamento, idempotência, cache semântico, validação de esquema, rastreamento de uso + circuit breakers + fallbacks de provedor), invocam instâncias Tool traduzidas para chamadas de ferramenta PrismPHP (MCP stdio/HTTP, bash/filesystem/browser integrados, SSH com impressões digitais TOFU), estacionam registros ApprovalRequest/HumanTask para a caixa de entrada humano-no-circuito e persistem versões Artifact além de entregar mensagens de saída via Email/Telegram/Slack/Webhook/ntfy. Estado e dados de tenant vivem no Postgres 17 com pgvector (cache semântico, chaves primárias UUIDv7, índices JSONB+GIN); o Redis 7 carrega as seis filas Horizon, cache de aplicação e bloqueios de orçamento pessimistas. Perfis opcionais do Docker Compose adicionam Reverb para o WebSocket de grafo de equipe ao vivo, browserless para ferramentas de navegador, searxng para busca web, um worker de voz (LiveKit/Deepgram), um sidecar bash em sandbox, o relay fleetq-bridge e Jaeger para rastreamento OpenTelemetry via --profile observability.
Construído com Laravel 13, Livewire 4 e Tailwind CSS. Design orientado a domínio com 45 contextos delimitados — a tabela abaixo mostra os 17 domínios primários:
| Domínio | Propósito |
|---|---|
| Agent | Configurações de agentes de IA, execução, personalidade, evolução |
| Crew | Equipes multiagentes com papéis de líder/membro |
| Experiment | Pipeline, máquina de estados, playbooks |
| Signal | Ingestão de dados de entrada |
| Outbound | Entrega multicanal |
| Approval | Revisões com intervenção humana e tarefas humanas |
| Budget | Contabilidade de créditos, aplicação de custos |
| Metrics | Medição, atribuição de receita |
| Audit | Registro de atividades |
| Skill | Definições reutilizáveis de habilidades de IA |
| Tool | Servidores MCP, ferramentas integradas, classificação de risco |
| Credential | Credenciais criptografadas de serviços externos |
| Workflow | Construtor visual de DAG, executor de grafos |
| Project | Projetos contínuos/únicos, agendamento |
| Assistant | Chat de IA sensível ao contexto com 28 ferramentas |
| Marketplace | Compartilhamento de habilidades/agentes/workflows |
| Integration | Conectores de serviços externos (GitHub, Slack, Notion, Airtable, Linear, Stripe, Generic) |
Serviços Docker
| Serviço | Propósito | Porta |
|---|---|---|
| app | PHP 8.4-fpm | -- |
| nginx | Servidor web | 8080 |
| postgres | PostgreSQL 17 | 5432 |
| redis | Cache/Fila/Sessões | 6379 |
| horizon | Trabalhadores de fila | -- |
| scheduler | Tarefas cron | -- |
| vite | Servidor de desenvolvimento frontend | 5173 |
Comandos Comuns
make start          # Start services
make stop           # Stop services
make logs           # Tail logs
make update         # Pull latest + migrate
make test           # Run tests
make shell          # Open app container shell
Ou com Docker Compose diretamente:
docker compose exec app php artisan tinker       # REPL
docker compose exec app php artisan test          # Run tests
docker compose exec app php artisan migrate       # Run migrations
Harness de Avaliação do Modelo de Decisão
jev:eval avalia um modelo de decisão — o Jev da TypeSafe, um segundo endpoint
System One, ou um LLM de chat comum — contra um dataset JSONL, e jev:report
transforma as respostas registradas em números de precisão, calibração, cobertura,
latência, custo e determinismo. Nada no caminho da requisição o chama: é uma
ferramenta de medição, não uma dependência de produção.
A chave da API nunca toca o repositório
TYPESAFE_API_KEY vive no 1Password e chega ao processo apenas através de
op run. .env.op (commitado) guarda a referência, nunca o valor:
TYPESAFE_API_KEY="op://AI Agent/Jev API Key/credential"
Os drivers de baseline seguem a mesma regra — .env.op também carrega referências
para ANTHROPIC_API_KEY, GEMINI_API_KEY / GOOGLE_AI_API_KEY e
OPENAI_API_KEY, e cada comando passa apenas os nomes que precisa através de
docker compose run -e.
Todo comando que chama a API é executado via op run, que resolve a
referência no processo filho e a mascara na saída. Não passe
--no-masking, não op read o item em uma variável, e não escreva o
valor em .env, em um arquivo compose ou em um fixture.
Executando uma avaliação de ponta a ponta
# 1. Build the datasets.
python3 base/scripts/jev-eval/export_next_tool_dataset.py    # -> next-tool.jsonl
python3 base/scripts/jev-eval/export_routing_v2_dataset.py   # -> routing-v2.jsonl + routing-v2-synth.jsonl
python3 base/scripts/jev-eval/export_domain_prefilter_dataset.py  # -> domain-prefilter.jsonl
#    both write into ~/jev-eval/datasets/fleetq/

# 2. Make them reachable from the container (storage/ is bind-mounted).
mkdir -p storage/app/jev-eval
cp ~/jev-eval/datasets/fleetq/*.jsonl storage/app/jev-eval/

# 3. Run the eval. The key is injected by op, by name, for this process only.
export OP_SERVICE_ACCOUNT_TOKEN=$(cat ~/.config/op/sa-token)

op run --env-file=.env.op -- docker compose run --rm -e TYPESAFE_API_KEY app \
  php artisan jev:eval storage/app/jev-eval/routing-v2.jsonl --driver=jev --split=test --concurrency=8

# 4. Report on the run id the eval printed.
docker compose exec app php artisan jev:report <run-id> \
  --dataset-path=storage/app/jev-eval/routing-v2.jsonl
Medindo determinismo — as mesmas requisições enviadas N vezes:
op run --env-file=.env.op -- docker compose run --rm -e TYPESAFE_API_KEY app \
  php artisan jev:eval storage/app/jev-eval/routing-v2.jsonl --driver=jev --split=dev --repeat=3
Comparando o Jev contra um modelo de chat no mesmo dataset — os drivers de LLM usam o gateway de IA da plataforma, então não precisam de chave TypeSafe:
op run --env-file=.env.op -- docker compose run --rm -e ANTHROPIC_API_KEY app \
  php artisan jev:eval storage/app/jev-eval/routing-v2.jsonl --driver=haiku --split=test --team=<team-id>
--team é obrigatório: o gateway registra cada chamada no
llm_request_logs com escopo de tenant, e uma avaliação não tem tenant próprio. O gateway
também limita a Anthropic a 60 requisições por minuto em todo o processo, então os drivers
de LLM publicam seu próprio requests_per_minute e a avaliação se limita a ele —
dois desses rodando a todo vapor em paralelo ainda vão passar fome um para o outro.
gemini-flash e gpt-mini existem por um motivo: em um dataset cujos rótulos
dourados foram produzidos por modelos Claude, um baseline Anthropic está avaliando seu
próprio dever de casa. Uma família de modelos que não teve participação nos rótulos é o
único baseline que significa algo ali.
Quando a chave Anthropic medida não está disponível, claude_cli_haiku e
claude_cli_sonnet executam os mesmos prompts através do CLI local do Claude Code com
suas credenciais de assinatura. Eles não precisam de chave, --team nem gateway:
docker compose run --rm -v "$HOME/.claude/.credentials.json:/root/.claude/.credentials.json:ro" \
  -e CLAUDE_CLI_CONCURRENCY=5 app \
  php artisan jev:eval storage/app/jev-eval/topics-bg.jsonl --driver=claude_cli_sonnet --split=test
Sem Docker, os mesmos comandos rodam diretamente:
op run --env-file=.env.op -- php artisan jev:eval ~/jev-eval/datasets/fleetq/routing-v2.jsonl --driver=jev --split=test
op run --env-file=.env.op -- php artisan jev:report
Opções
jev:eval:
| Opção | Padrão | Significado |
|---|---|---|
--driver | jev | Uma chave de config/decision.php: jev, jeff, haiku, sonnet, gemini-flash, gpt-mini, claude_cli_haiku, claude_cli_sonnet |
--split | test | dev, test ou all. 20/80, decidido por um hash do id do caso |
--repeat | 1 | Envia cada caso N vezes; alimenta as colunas de determinismo |
--concurrency | 8 | Casos em voo ao mesmo tempo, para drivers que suportam lote |
--limit | 0 | Para após N casos, tomados em ordem de arquivo para que dois drivers permaneçam comparáveis |
--team | — | Equipe sob a qual os drivers de LLM registram suas chamadas de gateway (obrigatório para haiku/sonnet) |
jev:report:
| Opção | Significado |
|---|---|
run_id... | Uma ou mais execuções; várias colocam diferentes drivers em um conjunto de tabelas |
--group-by=meta.source | Divide cada tabela por uma chave de meta do dataset |
--where=meta.source=assistant_turn | Mantém apenas casos que correspondem a uma chave de meta (valores separados por vírgula permitidos) |
--questions=domain | Relata apenas estes ids de pergunta |
--multi-label | Pontua cada caso como um CONJUNTO de rótulos (Noul por rótulo) em vez de por pergunta |
--dataset-path= | O arquivo do dataset; obrigatório para --group-by, --where e a análise de variantes |
A precisão é exibida com um intervalo de Wilson de 95%, que é o que torna uma tabela por fonte legível quando algumas fontes têm apenas um punhado de casos.
Cada tipo de pergunta também ganha seu próprio bloco sob a tabela principal:
| Tipo | Métricas extras |
|---|---|
| Choice | precisão top-2 (dourado dentro das duas opções de maior probabilidade), precisão / recall / F1 por classe, pares de confusão ordenados por contagem |
| Noul | precisão, recall e F1 da classe positiva em t=0.5, PR-AUC (precisão média), e a taxa positiva dourada exibida ao lado da precisão |
| Score | MAE no índice de nível, e precisão binária para nível 0 vs nível > 0 |
A execução permanece dentro dos tetos publicados do Jev (1.200 requisições/minuto e 250.000 tokens/segundo) por conta própria. Um caso cujo estado mais a pergunta mais longa é estimado acima de 32k tokens é rejeitado e registrado por id, nunca truncado — um estado encurtado é um caso diferente, e pontuá-lo moveria o número de precisão sem dizer isso.
Datasets
JSONL, um caso por linha:
{"id":"routing-006cbe1f682e","state":{...},"questions":{"domain":{"type":"choice","instructions":"...","criteria":{...}}},"gold":{"domain":"filesystem"},"meta":{"lang":"en","source":"phoenix:local_agent.tool","split":"test"}}
| Arquivo | O que mede | De onde vem o dourado |
|---|---|---|
next-tool.jsonl | previsão da próxima ferramenta dentro de um loop de codificação | a ferramenta que o agente de fato chamou em seguida |
routing-v2.jsonl | qual domínio MCP do FleetQ lida com uma requisição | configuração, ou a escolha registrada de um humano |
routing-v2-synth.jsonl | a mesma pergunta, em requisições com redação de registro | o domínio de registro da ferramenta de onde uma descrição veio |
domain-prefilter.jsonl | quais domínios podem ser descartados (multi-rótulo) | todo domínio MCP do qual o assistente extraiu uma ferramenta naquele turno |
next-tool.jsonl é um caso por chamada de ferramenta que um agente realmente fez dentro de uma
sessão pertencente a um experimento que alcançou completed. O estado carrega
o resumo da tarefa e os passos já dados; a resposta dourada é a ferramenta que foi
de fato escolhida em seguida. A narração do próprio assistente é deliberadamente excluída — ela
rotineiramente nomeia a próxima ferramenta, o que transformaria o roteamento em extração de string.
Isso é comportamento de agente, não roteamento do FleetQ.
routing-v2.jsonl nunca pontua contra o que um agente decidiu. Cada resposta dourada
é um fato de configuração ou uma escolha humana explícita já no banco de dados:
um usuário pediu algo ao assistente e ele chamou ferramentas de exatamente um
domínio MCP (turnos abrangendo dois domínios são descartados, porque o dourado seria
ambíguo); um sinal foi roteado para um experimento cujo template de workflow foi
configurado; um humano criou um experimento e atribuiu um agente específico a ele.
meta.source registra qual, para que um subconjunto possa ser pontuado por conta própria. Uma
única tarefa de origem contribui com no máximo 15 casos.
routing-v2-synth.jsonl é gerado a partir das próprias descrições do registro de ferramentas
para cobrir os domínios que os dados de produção nunca exercitam. Cada caso carrega
meta.source = "synthetic" e vive em seu próprio arquivo para nunca ser misturado
nos números principais — pontue-o separadamente ou não o pontue.
domain-prefilter.jsonl faz uma pergunta diferente do routing-v2: não "qual
domínio único lida com isso", mas "quais domínios podem ser descartados" — a forma que um
pré-filtro na frente de um servidor MCP com 700 ferramentas precisa. Um Noul por domínio, todos os 67
em uma única requisição, dourado verdadeiro para todo domínio do qual o turno extraiu uma ferramenta.
Turnos multi-domínio são mantidos aqui, porque um turno abrangendo dois domínios é uma
resposta multi-rótulo correta em vez de uma ambígua. Pontue-o com
jev:report --multi-label, que varre o limiar e relata o pré-filtro mais restrito
que ainda mantém essencialmente todo rótulo verdadeiro.
Sobre os números principais do routing-v2: apenas a fonte assistant_turn pertence a
um. As fontes signal_workflow e experiment_agent codificam um
fato de configuração que o texto da requisição não pode sustentar — um relatório de bug do Sentry
parece um signal qualquer que seja o tenant configurado para acioná-lo — e
model_tier tem um único valor em todos os casos onde os dados de produção podem derivá-lo.
Relate-os por fonte, nunca mesclados:
docker compose exec app php artisan jev:report <run-id> \
  --dataset-path=storage/app/jev-eval/routing-v2.jsonl \
  --where=meta.source=assistant_turn --questions=domain
A lista de opções de domínio e suas descrições de uma frase são lidas do
registro por base/scripts/jev-eval/mcp_domain_registry.py; adicione um grupo de ferramentas e
a opção aparece por conta própria.
Atualização
make update
Isso puxa o código mais recente, reconstrói contêineres, executa migrações e limpa caches.
Pilha Tecnológica
- Framework: Laravel 13 (PHP 8.4)
- Banco de dados: PostgreSQL 17
- Cache/Fila: Redis 7
- Frontend: Livewire 4 + Tailwind CSS 4 + Alpine.js
- Gateway de IA: PrismPHP
- Fila: Laravel Horizon
- Autenticação: Laravel Fortify (2FA) + Sanctum (tokens de API)
- Auditoria: spatie/laravel-activitylog
- Documentação da API: dedoc/scramble (OpenAPI 3.1)
- MCP: laravel/mcp (Model Context Protocol)
Contribuindo
Contribuições são bem-vindas. Por favor, abra uma issue primeiro para discutir as mudanças propostas.
- Faça um fork do repositório
- Crie um branch de funcionalidade (
git checkout -b feat/my-feature) - Faça suas mudanças e adicione testes
- Execute
php artisan testpara verificar - Envie um pull request
Veja CONTRIBUTING.md para convenções de código, estilo de commit e checklist de PR.
Comunidade e Suporte
- Issues — Relatórios de bug + solicitações de funcionalidades
- Discussões — Faça uma pergunta ou compartilhe o que você construiu
- Changelog — O que mudou em cada versão
- Versão em nuvem — fleetq.net (plano gratuito, sem cartão de crédito)
Histórico de Estrelas
Se o FleetQ economiza seu tempo, uma ⭐ ajuda outros a encontrá-lo. O GitHub classifica repositórios por velocidade de estrelas.
Licença
O FleetQ Community Edition é um software de código aberto licenciado sob a GNU Affero General Public License v3.0.
Resumo da AGPLv3: Você pode auto-hospedar, modificar e executar o FleetQ gratuitamente — incluindo uso comercial. Se você oferecer o FleetQ como um serviço hospedado para outros, você deve abrir o código-fonte de suas modificações. Dúvidas? Veja nosso FAQ da AGPLv3.