Context Lens
Base de conhecimento de busca semântica para assistentes de IA habilitados para MCP
Documentação
Context Lens
Dê à sua IA a capacidade de entender significado, não apenas corresponder palavras-chave.


O que é o Context Lens?
O Context Lens transforma qualquer conteúdo em uma base de conhecimento pesquisável para seu assistente de IA. Este servidor autossuficiente do Model Context Protocol (MCP) com armazenamento vetorial serverless integrado (LanceDB) traz busca semântica para suas conversas. Aponte-o para qualquer conteúdo — bases de código, documentações, contratos ou arquivos de texto — e sua IA poderá instantaneamente entender e responder perguntas sobre o conteúdo.
A busca tradicional por palavras-chave encontra arquivos que contêm palavras específicas. Perdeu o termo exato? Perdeu o conteúdo.
O Context Lens entende o significado. Pergunte sobre "autenticação" e encontre código sobre login, credenciais, tokens, OAuth e controle de acesso — mesmo que esses arquivos nunca usem a palavra "autenticação".
Veja em Ação
Quer entender como o Context-Lens funciona? Aqui está a parte divertida: você pode usar o Context-Lens para aprender sobre o Context-Lens.
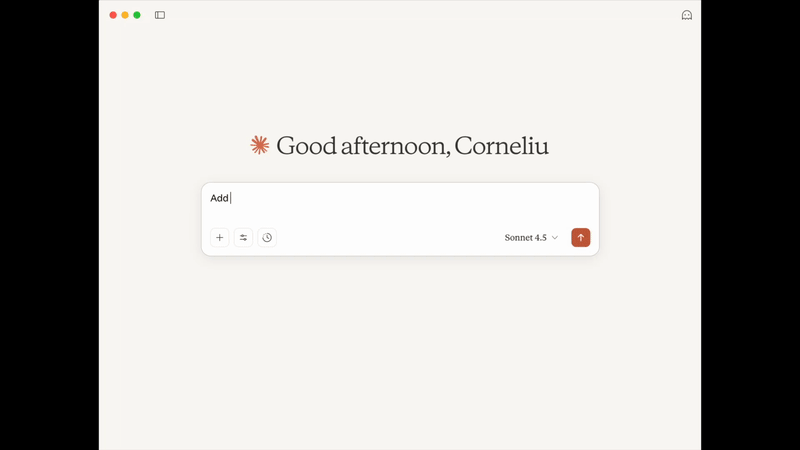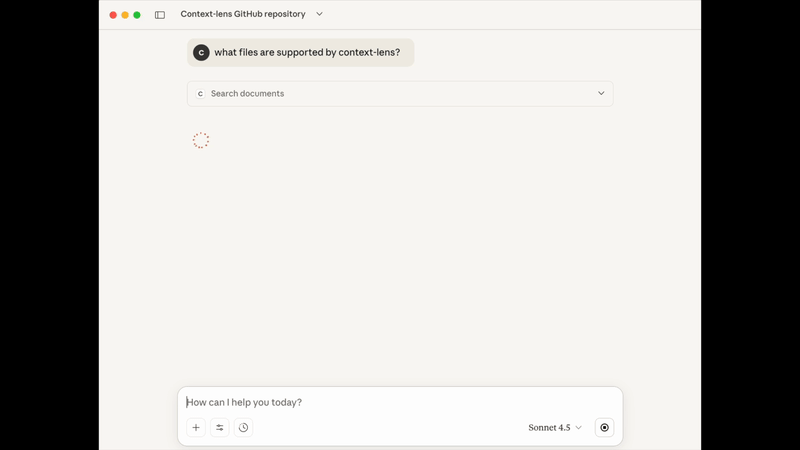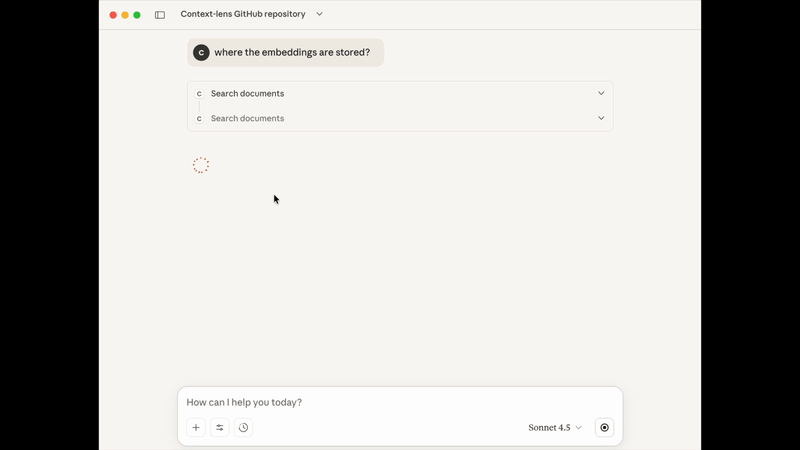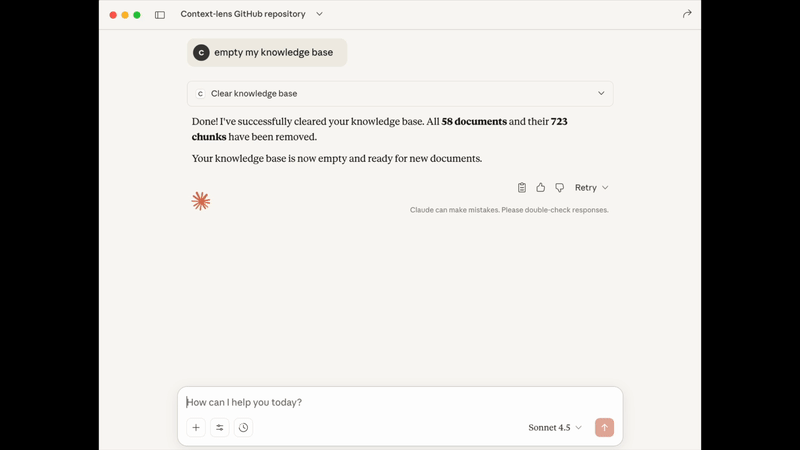
Demonstração: Usando o Claude Desktop com o Context-Lens para indexar e consultar este próprio repositório. Sem git clone, sem rolar pelo código — apenas perguntas e respostas.
Por que LanceDB?
O Context Lens usa LanceDB — um banco de dados vetorial moderno e serverless:
- 🆓 Completamente Gratuito e Local - Sem serviços em nuvem, chaves de API ou assinaturas
- ⚡ Zero Infraestrutura - Banco de dados embutido, apenas um arquivo no disco
- 🚀 Rápido e Eficiente - Construído sobre Apache Arrow, otimizado para busca vetorial
- 💾 Armazenamento Simples - Banco de dados de arquivo único, fácil de fazer backup ou mover
Pense nele como "SQLite para embeddings de IA" — todo o poder da busca vetorial sem a complexidade.
Recursos
- 🔍 Busca Semântica - Entende o significado, não apenas palavras-chave
- 🚀 Zero Configuração - Sem instalação, sem configuração, sem chaves de API
- 💾 Armazenamento Serverless - LanceDB integrado, sem banco de dados externo
- 🔒 100% Local e Privado - Todos os dados permanecem na sua máquina
- 📁 Local e GitHub - Indexa arquivos locais ou repositórios públicos do GitHub
- 🎯 Análise Inteligente - Divisão em blocos ciente da linguagem para melhores resultados
Arquitetura
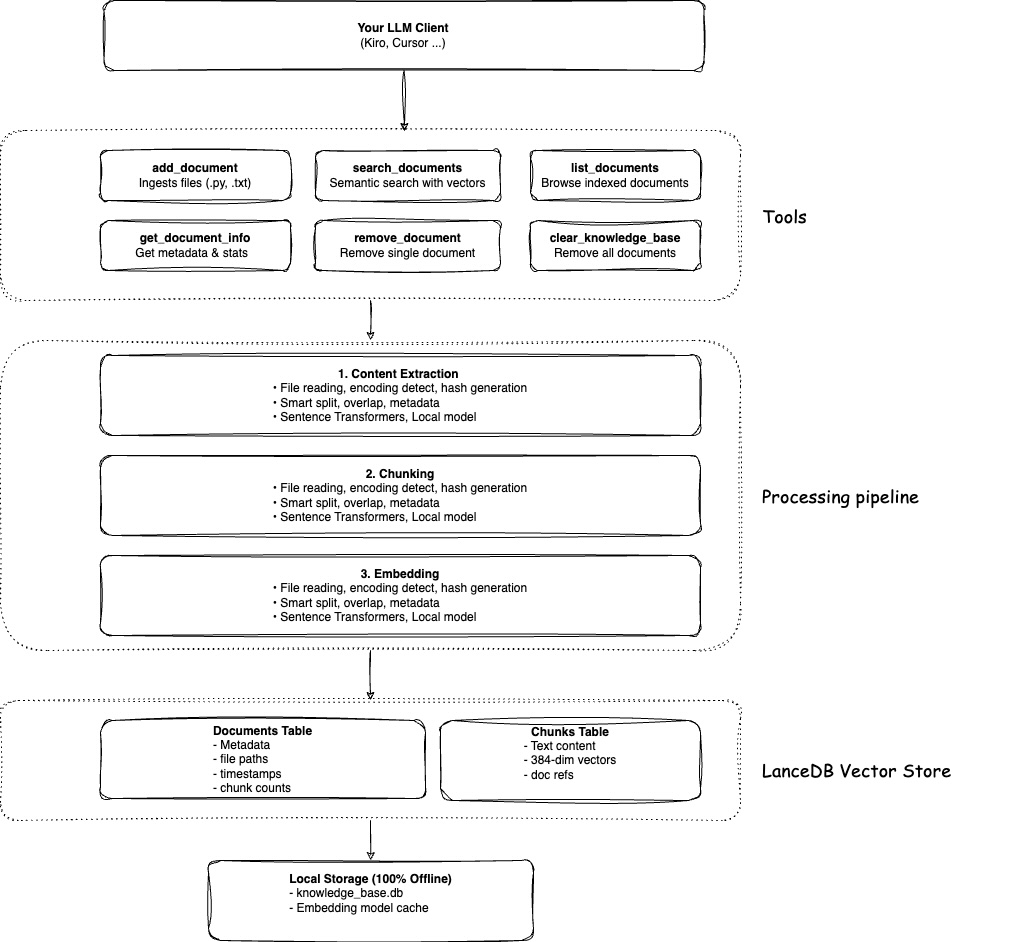
Como Funciona
Quando você adiciona conteúdo ao Context Lens, ele não apenas despeja texto em um banco de dados. Veja o que realmente acontece:
Leitura Inteligente: O Context Lens detecta o tipo do seu arquivo e usa analisadores especializados. Arquivos Python são analisados com parsing AST, JSON é analisado estruturalmente, Markdown é dividido por cabeçalhos. Isso preserva a estrutura natural do seu conteúdo.
Blocos Significativos: Em vez de limites arbitrários de caracteres, o conteúdo é dividido em blocos de forma inteligente — funções completas, parágrafos lógicos, seções inteiras. Seu código nunca é dividido no meio de uma função.
Vetores Semânticos: Cada bloco é convertido em um vetor de 384 dimensões usando um modelo de embedding local. Esses vetores capturam significado, não apenas palavras. "autenticação" e "sistema de login" tornam-se vetores semelhantes, mesmo sem compartilhar palavras.
Armazenamento Local: Tudo vai para o LanceDB — um banco de dados vetorial serverless que é apenas um arquivo no seu disco. Sem serviços em nuvem, sem chamadas de API, completamente privado.
Busca Conceitual: Quando você faz uma pergunta, ela também se torna um vetor. O Context Lens encontra blocos com vetores semelhantes (significado semelhante) e os classifica por relevância. Você obtém respostas baseadas em conceitos, não em correspondência de palavras-chave.
Especificações Técnicas
| Componente | Detalhes |
|---|---|
| Modelo de Embedding | sentence-transformers/all-MiniLM-L6-v2 |
| Dimensões do Vetor | 384 dimensões |
| Tamanho do Modelo | ~90MB (baixado no primeiro uso) |
| Tamanho do Bloco | 1000 caracteres (padrão, configurável) |
| Sobreposição de Blocos | 200 caracteres (padrão, configurável) |
| Banco de Dados Vetorial | LanceDB (serverless, baseado em arquivo) |
| Formato de Armazenamento | Formato colunar Apache Arrow |
| Método de Busca | Similaridade de cosseno |
| Processamento | 100% local, sem chamadas de API externas |
📖 Quer personalizar? Veja SETUP.md para opções de configuração e TECHNICAL.md para benchmarks de desempenho.
Configuração Rápida
Kiro IDE
Adicione a .kiro/settings/mcp.json:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "autoApprove": ["list_documents", "search_documents"]
    }
  }
}
Recarregue: Paleta de Comandos → "MCP: Reload Servers"
Cursor
Adicione a .cursor/mcp.json:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
Outros Clientes MCP
Para Claude Desktop, Continue.dev ou qualquer cliente compatível com MCP:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
📖 Precisa de instruções detalhadas de configuração? Veja SETUP.md para todos os clientes, uso programático e opções de configuração.
Registro MCP
O Context Lens está publicado no Model Context Protocol Registry oficial como io.github.cornelcroi/context-lens.
📖 Detalhes do registro e verificação: Veja REGISTRY.md para verificação de instalação e informações do registro.
Uso Programático
Use o Context Lens diretamente em suas aplicações Python:
#!/usr/bin/env python3
import os
from dotenv import load_dotenv
from mcp import StdioServerParameters, stdio_client
from strands import Agent
from strands.models.openai import OpenAIModel
from strands.tools.mcp import MCPClient

def main():
    # Load environment variables from .env file
    load_dotenv()

    # Create MCP client for context-lens server
    mcp_client = MCPClient(
        lambda: stdio_client(
            StdioServerParameters(command="uvx", args=["context-lens"])
        )
    )

    # Create an agent with OpenAI model and MCP tools
    model = OpenAIModel(model_id="gpt-4o-mini")
    agent = Agent(model=model, tools=[mcp_client])

    print("Chatbot started! Type 'quit' to exit.")

    while True:
        user_input = input("\nYou: ").strip()

        if user_input.lower() in ['quit', 'exit', 'bye']:
            print("Goodbye!")
            break

        if not user_input:
            continue

        try:
            response = agent(user_input)
            print(f"Bot: {response}")
        except Exception as e:
            print(f"Error: {e}")

if __name__ == "__main__":
    main()
Exemplo de conversa:
You: Add https://github.com/fastapi/fastapi to the knowledge base
Bot: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
Bot: FastAPI uses a sophisticated dependency injection system...
📖 Exemplos completos: Veja SETUP.md para código completo e mais frameworks.
Início Rápido
Adicione Seu Projeto
You: Add all Python files from ./src to the knowledge base
LLM: ✓ Added 23 Python files with 156 chunks

You: How does the authentication system work?
LLM: The authentication system uses JWT tokens. The login flow starts in
     auth/login.py where credentials are validated, then a token is generated
     with the user's ID and expiration time...

You: Show me all the database models
LLM: Based on the codebase, here are the main database models:
     1. User model (models/user.py) - handles user accounts and authentication
     2. Post model (models/post.py) - manages blog posts with relationships...
Aprenda com Código Aberto
You: Add https://github.com/fastapi/fastapi to the knowledge base
LLM: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
LLM: FastAPI uses a sophisticated dependency injection system. The Depends()
     function in fastapi/dependencies.py analyzes function signatures and
     automatically resolves dependencies. Here's how it works...

You: Compare FastAPI's routing to Flask
LLM: FastAPI uses decorator-based routing similar to Flask, but with key
     differences: 1) Type hints for automatic validation, 2) Async support
     built-in, 3) Automatic OpenAPI documentation generation...
Analise Documentos
You: Add all contracts from ./legal/contracts
LLM: ✓ Added 12 contract documents with 487 chunks

You: Find all termination clauses
LLM: I found termination clauses in 8 contracts. Here's a summary:
     - Service Agreement: 30-day notice required for either party
     - Vendor Contract: Immediate termination for breach of confidentiality...

You: What are the payment terms across all contracts?
LLM: Payment terms vary by contract type:
     - Service contracts: Net 30 days from invoice date
     - Vendor agreements: 50% upfront, 50% on delivery...
Busque Arquivos de URLs
You: Add https://raw.githubusercontent.com/fastapi/fastapi/master/README.md
LLM: ✓ Document 'README.md' added successfully with 42 chunks

You: What is FastAPI and what are its key features?
LLM: FastAPI is a modern, fast web framework for building APIs with Python 3.7+.
     Key features include:
     - Fast performance (on par with NodeJS and Go)
     - Automatic API documentation
     - Type hints for validation
     - Async support built-in...
📖 Mais exemplos e padrões de consulta: USAGE_GUIDE.md
Análise Inteligente e Divisão em Blocos
O Context Lens não apenas divide texto às cegas — ele entende a estrutura do código e cria blocos inteligentes que respeitam os limites da linguagem.
A diferença: A divisão genérica em blocos divide o código arbitrariamente por contagem de caracteres, muitas vezes quebrando funções no meio. A análise inteligente entende a estrutura do seu código e cria blocos completos e significativos.
Tipos de Arquivo Suportados
- 🐍 Python (
.py,.pyw) - Funções, classes, imports - ⚡ JavaScript/TypeScript (
.js,.jsx,.ts,.tsx,.mjs,.cjs) - Funções, classes, imports - 📦 JSON (
.json,.jsonc) - Chaves de nível superior, objetos aninhados - 📋 YAML (
.yaml,.yml) - Chaves de nível superior, listas, mapeamentos - 📝 Markdown (
.md,.markdown,.mdx) - Hierarquia de cabeçalhos, blocos de código - 🦀 Rust (
.rs) - Structs, traits, blocos impl, funções - 📄 Outros Arquivos (
.txt,.log,.cpp,.java, etc.) - Divisão inteligente em parágrafos/frases
Benefícios
✅ Unidades de Código Completas - Nunca divide funções ou classes no meio
✅ Contexto Preservado - Docstrings, comentários e estrutura permanecem intactos
✅ Melhor Busca - Encontre trechos de código completos e compreensíveis
✅ Automático - Sem necessidade de configuração, funciona com base na extensão do arquivo
📖 Quer ver como funciona? Confira PARSING_EXAMPLES.md para exemplos detalhados.
O Que Você Pode Adicionar
O Context Lens funciona com arquivos baseados em texto de múltiplas fontes:
- 📁 Arquivos e pastas locais - Seus projetos, documentações, qualquer arquivo de texto
- 🌐 Repositórios GitHub - Repositórios públicos, branches específicas, diretórios ou arquivos
- 🔗 URLs de arquivos diretos - Qualquer arquivo acessível via HTTP/HTTPS
- 📄 Documentos - Contratos, políticas, artigos de pesquisa, documentações técnicas
Tipos de arquivo suportados: .py, .js, .ts, .java, .cpp, .go, .rs, .rb, .php, .json, .yaml, .md, .txt, .sh, e mais (25+ extensões)
Tamanho máximo de arquivo: 10 MB (configurável via variável de ambiente MAX_FILE_SIZE_MB)
Exemplos:
./src/- Diretório local/path/to/file.py- Arquivo local únicohttps://github.com/fastapi/fastapi- Repositório inteirohttps://github.com/django/django/tree/main/django/contrib/auth- Diretório específicohttps://example.com/config.yaml- URL de arquivo direto/path/to/contracts/- Documentos legais
📖 Veja mais exemplos: USAGE_GUIDE.md
Ferramentas Disponíveis
- 📥 add_document - Adiciona arquivos, pastas ou URLs do GitHub
- 🔍 search_documents - Busca semântica em todo o conteúdo
- 📋 list_documents - Navegue pelos documentos indexados
- ℹ️ get_document_info - Obtenha metadados sobre um documento
- 🗑️ remove_document - Remove documentos específicos
- 🧹 clear_knowledge_base - Remove todos os documentos
📖 Veja exemplos detalhados: USAGE_GUIDE.md
FAQ
Como isso se compara ao servidor MCP do GitHub?
Eles servem a propósitos diferentes e se complementam:
O Context Lens é melhor para:
- 🧠 Compreensão semântica - "Encontre código de autenticação" retorna login, credenciais, tokens, OAuth - mesmo sem palavras-chave exatas
- 📚 Aprender bases de código - Pergunte "Como X funciona?" e obtenha resultados conceitualmente relevantes em todo o projeto
- 🔍 Descoberta de padrões - Encontre padrões de código semelhantes, abordagens de tratamento de erros ou decisões arquiteturais
- 💾 Desenvolvimento offline - Uma vez indexado, funciona sem conexão com a internet
- 🔒 Privacidade - Todo o processamento acontece localmente, nenhum dado é enviado a serviços externos
O servidor MCP do GitHub é melhor para:
- 🔧 Gerenciamento de repositórios - Crie issues, gerencie PRs, lide com operações de CI/CD
- 📊 Estado em tempo real - Sempre busca a versão mais recente do GitHub
- 🌐 Recursos específicos do GitHub - Integra-se ao ecossistema do GitHub (Actions, Projects, etc.)
Diferença chave: O Context Lens clona uma vez e indexa tudo para busca semântica rápida (offline). O GitHub MCP faz chamadas de API por consulta para acesso em tempo real (online). Use o Context Lens para entender código, o GitHub MCP para gerenciar repositórios.
Por que a primeira execução é lenta?
O modelo de embedding (~100MB) é baixado no primeiro uso. Isso acontece apenas uma vez.
Preciso de uma chave de API?
Não! O Context Lens roda completamente local. Sem chaves de API, sem serviços em nuvem.
Onde meus dados são armazenados?
O Context-Lens armazena dados em diretórios específicos da plataforma:
- macOS:
~/Library/Application Support/context-lens/ - Linux:
~/.local/share/context-lens/ - Windows:
%LOCALAPPDATA%\context-lens\
Você pode alterar o diretório base definindo a variável de ambiente CONTEXT_LENS_HOME:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "env": {
        "CONTEXT_LENS_HOME": "/path/to/your/data"
      }
    }
  }
}
Ou substitua caminhos individuais com LANCE_DB_PATH (banco de dados) e EMBEDDING_CACHE_DIR (modelos).
Posso usar isso com código privado?
Sim! Todo o processamento acontece localmente. Nada é enviado a serviços externos.
Quanto espaço em disco isso usa?
~100MB para o modelo + ~1KB por bloco de texto. Uma base de código de 10MB usa ~5-10MB de espaço no banco de dados.
📖 Mais perguntas: TROUBLESHOOTING.md
Documentação
- 📖 Guia de Configuração - Configuração detalhada para todos os clientes, opções de configuração
- 📚 Guia de Uso - Exemplos, consultas e melhores práticas
- 🎨 Exemplos de Análise - Como a análise inteligente funciona
- 🔧 Solução de Problemas - Problemas comuns e soluções
- ⚙️ Detalhes Técnicos - Arquitetura, stack e desempenho
- 📋 Informações do Registro - Verificação e instalação do Registro MCP
- 🤝 Contribuindo - Como contribuir, roadmap
- 📦 Guia de Publicação - Processo de publicação no Registro MCP (para mantenedores)
Contribuindo
Contribuições são bem-vindas! Por favor:
- Abra uma issue primeiro para discutir sua ideia
- Obtenha aprovação antes de começar o trabalho
- Envie um PR referenciando a issue
Veja CONTRIBUTING.md para detalhes.
Licença
Licença MIT - veja LICENSE para detalhes.
Dê uma estrela no repositório se você achou útil! ⭐