Flexreport Finance
Fornece pesquisa de ações em tempo real para Agentes de IA, dando a eles uma visão do mercado.
Servidor MCP hospedado
npx add-mcp 'https://mcp.flexreportfinapi.com/mcp'Instala no Claude Code, Codex, Cursor e outros
Documentação
flexreport-mcp
Um microsserviço MCP autônomo que expõe o backend de ações da FlexReport — eventos ao vivo, artefatos de relatórios de pesquisa e o banco de dados com mais de 750 milhões de pontos de dados — como ferramentas sob demanda para o Claude (e qualquer cliente MCP).
Ele potencializa agentes de IA com eventos de mercado em tempo real e dados curados de fonte dourada, abrangendo fundamentos, transcrições, arquivamentos, negociações de insiders (Formulários 3, 4 e 5), índices, dados macro, decks de RI extraídos diretamente do site de relações com investidores de cada empresa, e muito mais.
Instalação rápida
Adicione o conector ao Claude Code
claude mcp add --transport http flexreport https://mcp.flexreportfinapi.com/mcp
Ou adicione ao Codex
codex mcp add flexreport --url https://mcp.flexreportfinapi.com/mcp
Em seguida, inicie o Claude e basta perguntar (por exemplo, "puxe os maiores movimentos do flexreport").
Na primeira chamada de dados, seu cliente MCP executa um login OAuth no seu navegador —
faça login ou registre-se quando solicitado; você nunca cola um token. Adicione --scope user para
disponibilizá-lo em todos os diretórios. Consulte Auth para detalhes.
Demonstração
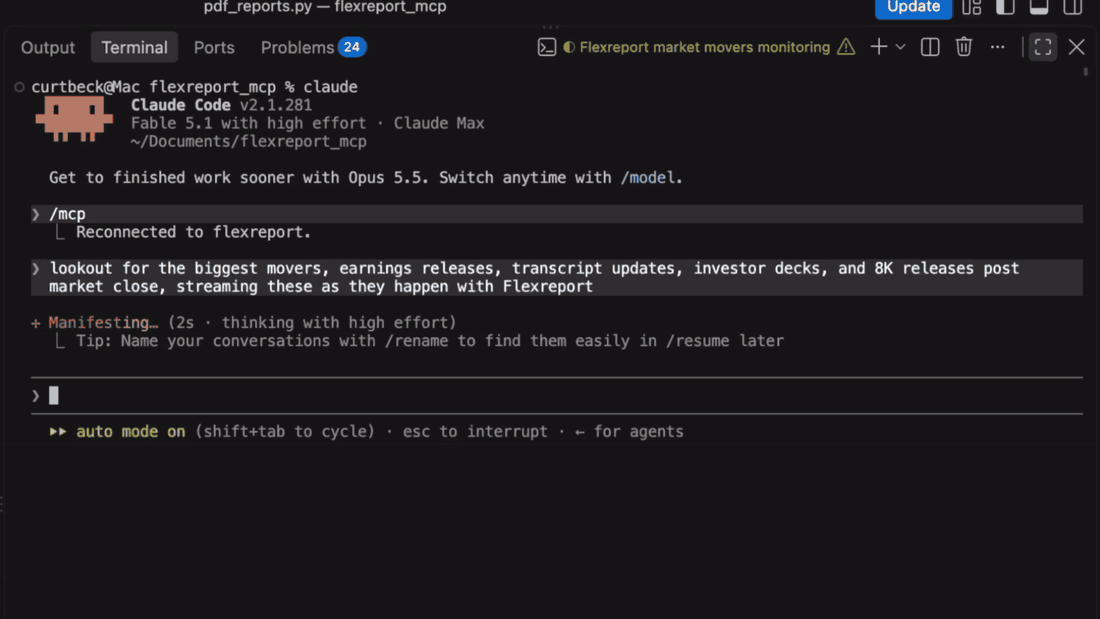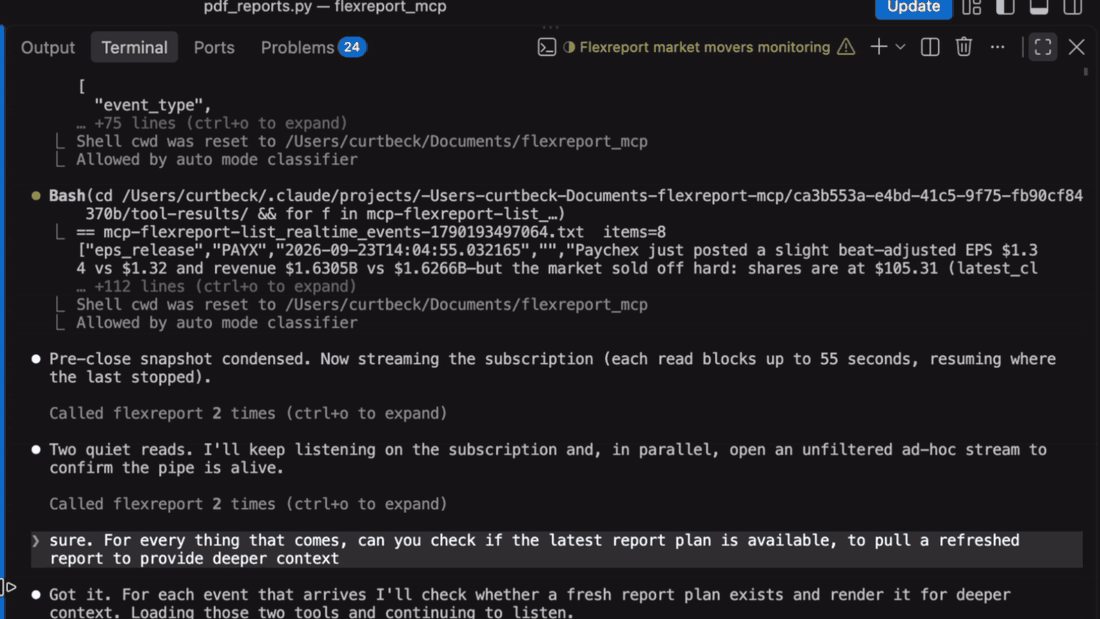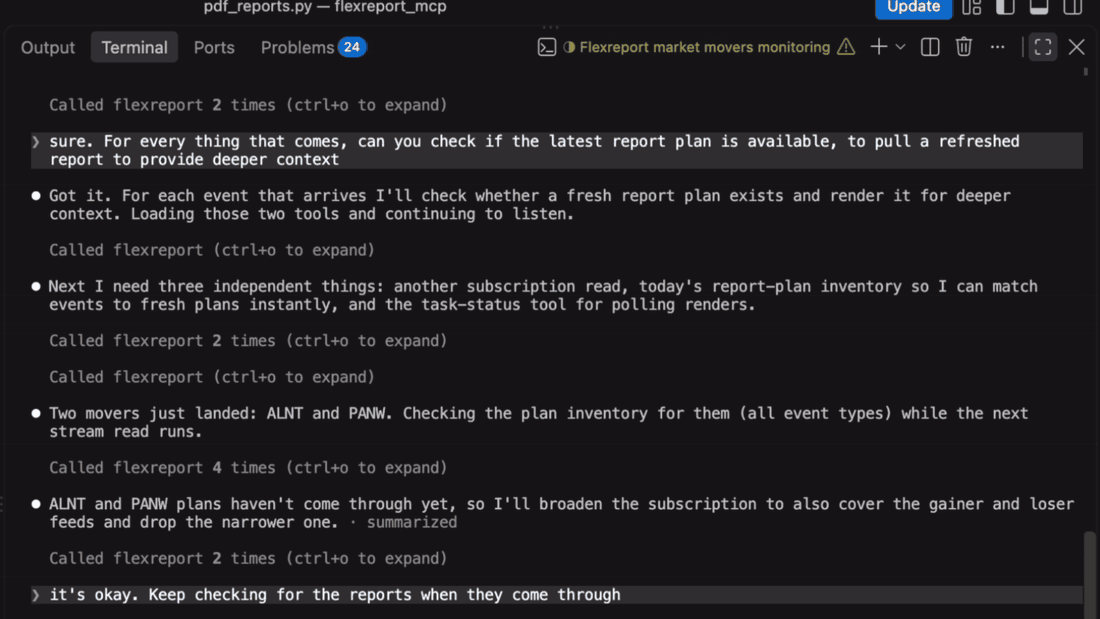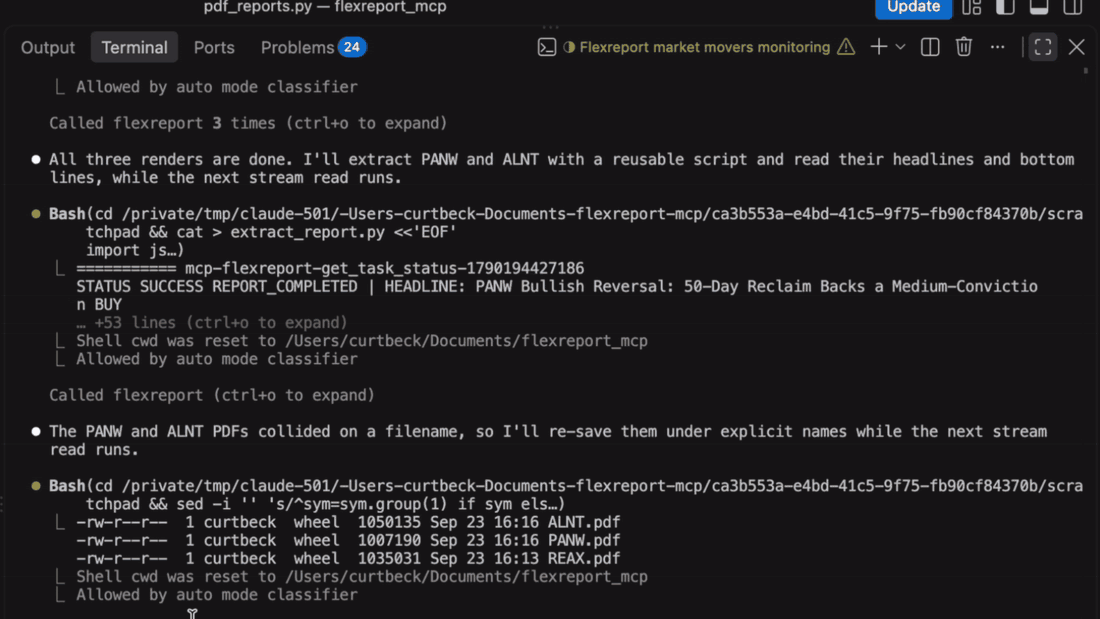
Transmita eventos em tempo real no terminal. Peça ao Claude para observar o mercado e os eventos chegam conforme ocorrem: movimentos, divulgações de resultados, 8-Ks, decks de RI e novos planos de relatório. Conforme cada plano de relatório é salvo, o Claude renderiza o relatório atualizado.
"Fique de olho nos maiores movimentos, divulgações de resultados, atualizações de transcrições, decks de investidores e divulgações de 8K após o fechamento do mercado, transmitindo-os em tempo real com o Flexreport"
"Para tudo o que chegar, você pode verificar se o plano de relatório mais recente está disponível, para puxar um relatório atualizado e fornecer contexto mais profundo"
Abra o relatório de pesquisa. Cada figura remete à consulta que a produziu, e cada manchete remete à sua fonte. Aqui está um relatório para a AAPL:
"Me traga o relatório flexreport mais recente para a AAPL"
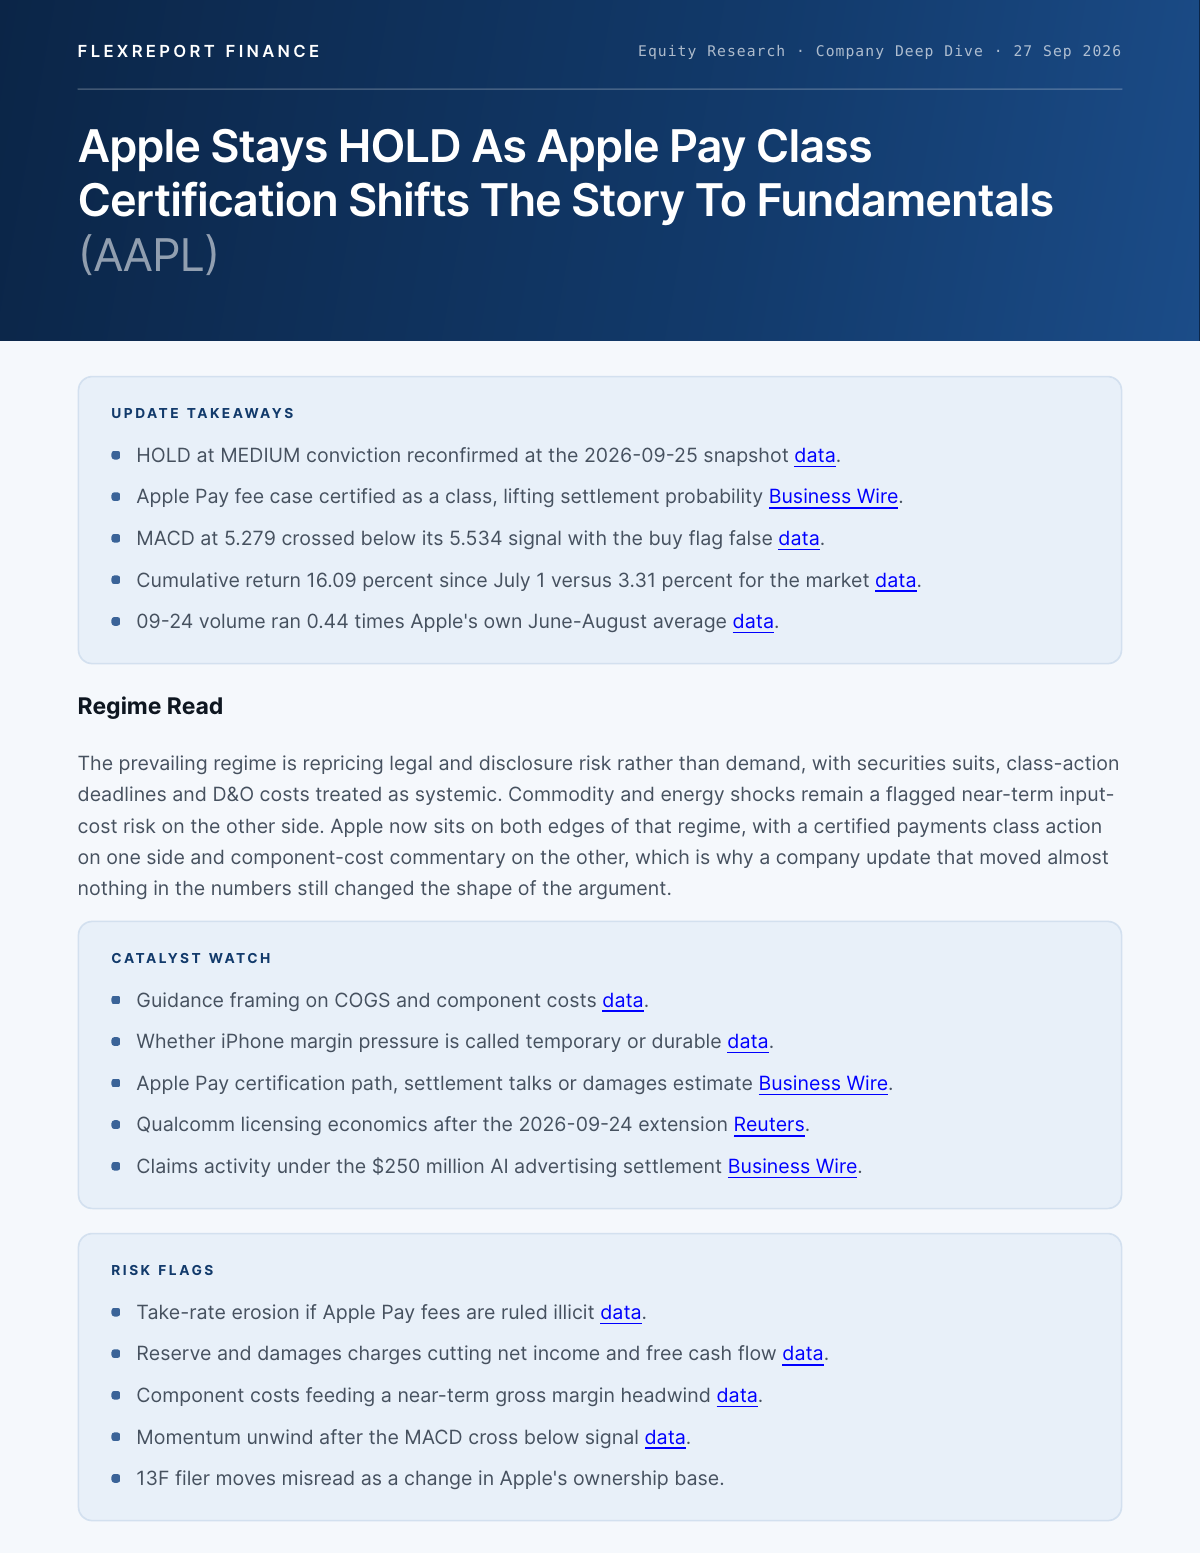
Abra o relatório completo da AAPL (PDF, 13 páginas)
Casos de uso
1. Tempo real
1a. Streaming (eventos e relatórios em tempo real). Assine eventos conforme são publicados, incluindo o tópico report_plan, que dispara sempre que um relatório fica pronto, e então puxe o relatório renderizado: "Me assine para divulgações de resultados, 8-Ks, publicações de RI e novos planos de relatório para NVDA, AVGO, AMD e MU. Conforme cada um chegar, me diga o que aconteceu, verifique o tape intradiário para movimentos anormais e puxe o relatório FlexReport assim que estiver pronto."
Ferramentas: register_event_subscription → stream_event_subscription, ou stream_events ad hoc, depois detect_intraday_outlier_jumps e get_latest_report.
Por padrão, uma solicitação de transmissão ao vivo gera um dashboard (no Claude, um Artifact) em vez de uma transcrição de chat. A página executa o loop stream_events por conta própria, carregando o cursor de leitura em leitura, então um único prompt mantém o stream aberto. Se a página não conseguir alcançar o servidor, o agente executa o loop e escreve cada evento no dashboard. Peça explicitamente a saída em chat se preferir a visualização de terminal mostrada na demonstração acima.
1b. Eventos das últimas doze horas. Analise arquivamentos SEC 8-K em tempo real, enquanto também puxa decks de relações com investidores e barras de 5 minutos para identificar rapidamente ações com movimentos significativos: "Quais são as divulgações de 8-K mais recentes? Destaque as mais significativas, puxe as divulgações de relações com investidores correspondentes via FlexReport, faça gráficos de barras de 5 minutos para qualquer nome com movimentos relevantes e me diga como elas se alinham com o estado atual de cada empresa. Gostaria disso em formato tabular: resumo do 8-K, tendência da empresa, link S3 da análise do 8-K do FlexReport, link do deck de RI."
Ferramentas: situate → list_realtime_events, depois get_aftermarket_data / detect_intraday_outlier_jumps e get_latest_report.
2. Relatórios
2a. O relatório mais recente para uma empresa específica: "Puxe o relatório FlexReport mais recente sobre a Snowflake e resuma o que mudou neste trimestre: guidance, margens e qualquer coisa que a gestão sinalizou na teleconferência."
Ferramentas: get_latest_report(["SNOW"]). Um plano novo renderiza em ~10-20 s; um símbolo stale ou missing pode ser reconstruído com generate_report_for_stock.
2b. Os relatórios mais recentes para um período: "Quais relatórios saíram no setor de Energia nos últimos três dias? Puxe os novos e classifique-os pela significância do evento subjacente."
Ferramentas: list_available_reports(report_date=<3 days ago>), filtrado para nomes de Energia (list_options("sectors"), get_company_snapshot), depois get_latest_report para os mais recentes (fresh).
2c. Um relatório personalizado com base nos seus critérios: "Monte um relatório sobre semicondutores dos EUA de grande capitalização com ROIC acima de 20% e dívida líquida/EBITDA abaixo de 1x, negociando acima da média móvel de 200 dias com RSI abaixo de 60. Mostre os fundamentos, os técnicos e as revisões de estimativas mais recentes para cada um, organizados no meu template salvo."
Ferramentas: screen_stocks, explore_data_catalogue (índices, fundamentos, estimativas), get_technical_indicator_data e get_user_template. O agente monta o PDF no seu template; configure um com draft_user_template → save_user_template.
3. Análise preditiva
Preveja a volatilidade futura de resultados, puxando médias móveis simples e exponenciais e Bandas de Bollinger, e criando um memorando de investimento personalizado: "Preveja a volatilidade dos resultados de amanhã, destacando as ações com os maiores movimentos esperados; faça gráficos das médias móveis simples e exponenciais e das Bandas de Bollinger; e destaque os maiores impulsionadores fundamentais agora, colocando tudo isso em um memorando de investimento para minha equipe."
Ferramentas: list_earnings_announcements → predict_earnings_move, get_technical_indicator_data, get_company_snapshot.
4. Pesquisa e exploração
Conduza pesquisa temática sobre uma narrativa de mercado: "O trade de IA esfriou recentemente, em grande parte devido a preocupações com CapEx e retorno sobre investimento. Acredito que isso já aconteceu antes, no outono de 2025. Você pode confirmar, e quais foram os fatores que aliviaram essas preocupações? Foi o comentário da gestão, a demanda contínua por serviços de IA, a lucratividade robusta e um guidance mais alto? Por favor, monte um relatório aprofundado com o FlexReport Finance."
Ferramentas: explore_data_catalogue (transcrições, fundamentos, estimativas), trace_data_sources / get_document_section para citações referenciadas, ou generate_research_report para o texto completo.
Ferramentas
50 ferramentas, agrupadas pelo módulo que as registra. Os clientes as veem na ordem de importação tools/__init__.py (situate primeiro).
Situate e eventos em tempo real (tools/realtime_events.py)
| Ferramenta | Endpoint do backend | O que faz |
|---|---|---|
situate(symbols, window_days, question) | GET /get-company-event-web + GET /get-event-ontology + GET /is-market-open | A primeira chamada. Compõe a teia de eventos (o que aconteceu com esta empresa), a ontologia (o que esse tipo de evento implica, o que vem depois, onde o payload vive após o cache de 12h, quando cada tabela é atualizada) e o status do mercado em o que está acontecendo agora, mais um plan ordenado de chamadas de ferramentas exatas, uma lista skip de chamadas que retornariam nada, e guidance com escopo de situação. O plano começa no tipo de evento em tempo real que a pergunta nomeia (EVENT_VOCABULARY em situate.py cobre todos os tipos em list_options("event_types")); uma pergunta que nomeia apenas uma família percorre seu episódio, uma que não nomeia nada varre todos os episódios — não há família padrão, e explore_data_catalogue nunca é planejado para uma pergunta de "hoje" de todo o mercado. A composição está em situate.py (funções puras; python tests/test_situate_routing.py); nenhuma rota nova no backend. Pública, síncrona |
list_realtime_events(event_type, tickers, sector, industry, market_cap) | POST /get-realtime-events | Puxe eventos ao vivo (atualizações de EPS, transcrições, ratings, …) do cache de 12h |
get_company_snapshot(symbol) | GET /get-company-snapshot | Snapshot estruturado: tese, fundamentos, técnicos, preços-alvo, participação acionária, notas |
get_company_event_web(symbol, window_days, max_nodes) | GET /get-company-event-web | O porquê por trás do snapshot — o grafo de eventos recentes da empresa: nós de evento/data_update em ordem cronológica com dicas fetch e arestas tipadas (same_chain_run / lineage / co_occurrence). Combine com get_company_snapshot e chame antes de encadear um list_realtime_events / explore_data_catalogue / pedido de relatório direcionado em um símbolo |
get_event_ontology(event_type, family, relation, format) | GET /get-event-ontology | A ontologia de nível de classe por trás da teia de eventos — o que um tipo de evento implica: as tabelas gravadas quando ele dispara (por camada), os eventos que geralmente seguem (taxa observada / atraso), onde o payload vive após o cache de tempo real de 12h (persisted_in), qual workflow atualiza cada relação e seu next_run_at (a verificação de frescor), e qual ferramenta a lê. Independente de símbolo, pública, cacheável — chame primeiro em qualquer solicitação orientada a eventos e junte-a ao type / relation / family de um nó da teia |
Streaming de eventos (tools/event_subscriptions.py)
A entrega padrão para uma solicitação de transmissão ao vivo é um dashboard (no Claude, um Artifact) cuja página faz loop de stream_events com seu cursor. As instruções do servidor e os docstrings das ferramentas de stream dizem isso.
| Ferramenta | Endpoint do backend | O que faz |
|---|---|---|
stream_events(topics, symbols, cursor, max_events, max_wait_seconds) | GET /events (SSE) | Entrega push, ad hoc. Uma leitura limitada do stream de eventos em tempo real: retorna após max_events eventos correspondentes ou max_wait_seconds (limite de 55 s) com {events, cursor, closed} — cada evento é o mesmo objeto que list_realtime_events retorna, no momento em que é publicado. Filtre inline por topics (tipos de evento ou famílias de list_options("event_types"), mais o tópico report_plan exclusivo do stream — um frame cada vez que um plano de relatório é salvo) e symbols. Sem estado no servidor: sempre passe o cursor retornado de volta ou a próxima chamada começa em "agora" (autenticado) |
register_event_subscription(topics, symbols) | POST /register-subscription | Salve um filtro no servidor → {subscription_id, filter, cursor, created_at}. Apenas eventos publicados após o registro são entregues; guarde o id (ainda não há endpoint de listagem). 30/hora (autenticado) |
stream_event_subscription(subscription_id, cursor, max_events, max_wait_seconds) | GET /event-subscription/{id} (SSE) | Entrega push, retomável. Mesma forma de leitura limitada que stream_events, mas a API salva o cursor quando a leitura fecha, então chamadas repetidas veem cada evento correspondente exatamente uma vez, sem contabilidade cursor; cursor só substitui a posição salva para uma conexão. closed: "subscription deleted" significa parar de reconectar; 404 cobre tanto um id ausente quanto o id de outro usuário (autenticado) |
delete_event_subscription(subscription_id) | DELETE /event-subscription/{id} | Remova uma assinatura salva; qualquer stream aberto nela termina com um frame closed dentro de um ciclo de leitura (autenticado) |
Relatórios e templates de PDF (tools/pdf_reports.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
get_latest_report(symbols) | POST /get-cached-reports | O caminho rápido para um ou mais tickers nomeados. Um símbolo com um plano salvo recente cai em rendering ({task_id, status, symbol}): o backend puxa o JSON do plano e o renderiza no template do usuário em ~10-20 s — consulte get_task_status para {"pdf": ...}. Qualquer outro símbolo retorna como PDF em cache (URL pré-assinada + base64 inline, com generated_at, age_hours, latest_event_at, stale) ou em missing. stale: true significa que o plano em si está desatualizado — apenas um rebuild generate_report_for_stock(ticker) (~10 min) o atualiza. 500/hora |
list_available_reports(event_types, report_date) | POST /list-available-reports | Inventário de planos de relatório salvos criados em ou após report_date (YYYY-MM-DD, padrão hoje; os planos permanecem renderizáveis por 7 dias, então passe uma data anterior para o inventário corrente — uma lista vazia significa que nada foi planejado no período, não que não há pesquisa) — todo símbolo cujo evento material (eps_update, eps_release, 8k_release, financials_release, ir_publication, transcript_update; company_update noturno) salvou um plano, do mais novo ao mais antigo, cada um com event_type, planned_at, queued_at, source e um flag fresh que aplica a mesma regra que /get-cached-reports usa: true → get_latest_report([ticker]) o renderiza em ~10-20 s, false → apenas um rebuild generate_report_for_stock (~10 min) o atualiza. Filtre por event_types; amplie com report_date (uma data malformada é um 422). A verificação entre list_realtime_events (o que acabou de publicar) e get_latest_report (puxe-o), ou a forma direta de ver qual pesquisa em tempo real está disponível agora |
generate_report_for_stock(ticker, user_override, financial_items, as_reported_financial_items, ratios, revenue_segment, technical_analysis_items, estimate_items, institutional_ownership, include_as_report_financials, as_reported_periods) | POST /create-full-report | Somente rebuild completo (~10 min) — use com moderação. Padrão (somente ticker): reconstrói e salva o plano de relatório do símbolo; a chamada a fazer apenas quando get_latest_report retornou o ticker stale ou missing e o usuário quer esperar — nunca para um símbolo em rendering. Personalizado (user_override=true + listas de modelagem): um build completo (~10 min, não salvo) em torno dos itens de linha, índices, conceitos conforme relatados, segmentos, indicadores, estimativas ou CIKs de gestores que o usuário nomeou; a ferramenta ativa o interruptor sempre que um campo de modelagem não está vazio. Pedidos sob medida normalmente são explore → ideate → overlay no template em vez disso. Assíncrono → {ticker: {task_id, status}} |
generate_research_report(query, delivery) | POST /generate-research-report | Mergulho profundo (~10-12 min, assíncrono) — relatório de nível analista, apenas quando o usuário pede explicitamente um relatório completo → {task_id, status} |
download_pdf_from_url(url, file_name) | POST /download-pdf-from-url | Busca uma URL de PDF S3 pré-assinada no lado do servidor (protegido contra SSRF) e a retorna inline como base64 — ex.: um get_latest_report url em clientes que não conseguem abrir o link (autenticado) |
draft_user_template(template, template_type, anchor) | POST /draft-user-template | Etapa 1 de 2 para o formato de PDF próprio do usuário: compila uma página HTML em um blueprint sob vários tratamentos e renderiza cada um como pré-visualizações PNG pré-assinadas do documento espécime da plataforma — um de cada tipo de conteúdo (título, lead, seções, bullets, cartões de KPI, tabelas, gráficos, figura, linha de fonte, nota de rodapé); um add_on na largura da coluna do relatório, um bespoke como páginas completas — além de um draft_id. O usuário aprova como o design trata cada tipo de conteúdo, não o texto de amostra. Nada é armazenado — o rascunho vive 24h (autenticado, 30/min) |
save_user_template(draft_id, variant_id, template, template_type, anchor) | POST /save-user-template | Etapa 2 de 2: passe draft_id + o variant_id escolhido e o tratamento revisado é salvo; ou passe template + template_type (+ anchor) diretamente para pular as pré-visualizações (HTML apenas — markdown é um 422). Um template por usuário — upsert, salvar substitui o anterior. Retorna {status: "SAVED", template_type, anchor, bytes, patterns, tones, warnings} — os tipos de conteúdo que o design estiliza e suas classes de tom (autenticado, 100/min) |
update_user_template(template, template_type, anchor, draft_id, variant_id) | PUT /update-user-template | Altera o template salvo — qualquer campo (campos omitidos mantêm seus valores armazenados), ou nenhum campo para recompilá-lo como armazenado com o compilador atual. Assíncrono: {task_id, status: "PENDING", changed, next_step} → consulte get_task_status para {status: "SAVED", patterns, tones, warnings}. 404 = nada salvo ainda (salve primeiro); 422 = erros de validação (autenticado) |
get_user_template() | GET /get-user-template | O template salvo do chamador (template_type, template_format, anchor, template sanitizado, timestamps). 404 = nenhum salvo; um 503 significa que a tabela do backend ainda não foi criada, não "nada salvo". Também o markup para compor um PDF elaborado por agente |
delete_user_template() | DELETE /delete-user-template | Exclui o template salvo — permanente, os PDFs revertem para os layouts padrão; a propriedade é aplicada na cláusula WHERE |
Exploração de dados, citações e consultas salvas (tools/data_exploration.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
explore_data_catalogue(query) | POST /data-catalogue-exploration | Rota padrão — EDA rápida e interativa contra a plataforma de dados → conjuntos de resultados para renderizar como gráficos/tabelas (somente dashboard, 20/hora) → {task_id, status} |
explore_data_coverage(query) | POST /data-coverage-exploration | Contagens de cobertura e detalhamentos — quantos símbolos carregam um conjunto de dados (decks de RI, transcrições, 13F, insider, estimativas…), por setor / indústria / país / capitalização de mercado / ano, e até onde vai o histórico. Público: sem necessidade de conta, então prospects podem perguntar o que a plataforma cobre |
get_signed_sql_drilldown(encrypted_query_token, prompt, values, max_rows) | GET /query-data | Siga o get_company_event_web de um nó signed_query_url (ou seu token t puro) até as linhas por trás dele — novo registro sinalizado is_new_record: true, além de linhas de contexto; tokens são cunhados apenas pelo servidor, nunca construídos. values opcional (preenchimento de slot tipado, sem LLM) e prompt (linguagem natural, preenche o que values deixou de fora) re-aimam um token que é um gêmeo de placeholder para outras entidades; max_rows limita o payload, e uma resposta fatiada carrega row_count + truncated: true (autenticado) |
trace_data_sources(relation, keys, column, encrypted_query_token, prompt, values, max_documents, resolve_passages) | GET /trace-sources | Citações — resolva números de linhas explore_data_catalogue / run_saved_query / get_signed_sql_drilldown de volta ao arquivo, seção ou citação verificada de onde foram lidos. Prefira relation + keys (toda coluna identificadora, incl. o período) em vez de um token |
get_document_section(symbol, year, quarter, n, name) | GET /query-section | Abre uma seção numerada de um documento de origem — a fala exata do participante da call de resultados para a qual uma citação trace_data_sources aponta. Leia os quatro valores da URL da citação; year / quarter são o período fiscal da call, não o trimestre calendário |
save_user_query(user_request, query_tokens) | POST /save-user-query | Salva os query_token opacos de um resultado de explore_data_catalogue sob a própria redação do usuário, para que a solicitação possa ser reproduzida sem replanejá-la. Retorna {msg, id, placeholder_status} — id é a chave de exclusão; PENDING significa que o backend está criando um gêmeo de placeholder de cada consulta mais o esquema de slots metadata da linha (~10 s a 5 min) para que a solicitação possa ser re-perguntada para outras entidades; NOT_DISPATCHED significa apenas reprodução exata (autenticado, escopo do proprietário; sem upsert — salvar duas vezes cria duas linhas, 100/min) |
list_saved_queries(limit) | GET /get-saved-queries | As solicitações salvas do chamador, do mais novo ao mais antigo — id (o que a exclusão usa), queries (os tokens para uma reprodução exata), query_placeholder (os tokens gêmeos, alinhados por índice com queries), user_request (o rótulo próprio do usuário) e metadata: o summary da linha (uma linha, slots entre chaves), esquema de slots parameters ({name, type, description, example} — as chaves de run_saved_query(values=…)), entities, datasets, topics, result_schema por consulta, stale, run_count, last_run_at. Corresponda uma pergunta em metadata, não no rótulo, e pule linhas stale; metadata e query_placeholder são null até a tarefa de placeholder ter sido executada. Um 503 significa que a tabela do backend ainda não foi criada, não "nada salvo" |
run_saved_query(query_tokens, prompt, values, max_rows) | GET /query-data | Reproduz uma solicitação salva: cada token roda contra dados ao vivo, sincronamente, na ordem dada (máx. 25) — apenas linhas, nunca SQL; segundos em vez de um job de planejamento de ~1-5 min, e sem consumir o orçamento de exploração de 20/hora. Com tokens query_placeholder, values (chaveado por metadata.parameters, preenchido deterministicamente sem LLM — slots de conjunto de entidades aceitam linhas [{id, name}] e um nome sem id resolve no lado do servidor) re-aima as consultas salvas; prompt ("os últimos 8 trimestres de vendas para KSS") preenche apenas o que values deixou de fora, e um slot que nenhum cobre mantém seu exemplo salvo. A resposta carrega parameters, defaulted_parameters e ignored_values; um 422 significa que a solicitação não pôde ser mapeada — caia para explore_data_catalogue. Sempre passe max_rows (ex.: 500): o companheiro _constituents de uma linha retorna 7.000–35.000 linhas sem limite |
delete_saved_query(query_id) | DELETE /delete-saved-query | Exclui uma solicitação salva por id — permanente, e os tokens vão junto; o 404 cobre deliberadamente tanto "id inexistente" quanto "não é seu" |
Dados de mercado (tools/market_data.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
get_technical_indicator_data(symbol, indicator, start_date, end_date) | GET /technical-indicator-endpoint | Histórico diário de um indicador técnico (de list_options("technical_indicators")) em um intervalo YYYY-MM-DD inclusivo (autenticado) |
detect_intraday_outlier_jumps(symbol, frequency, zscore_threshold) | GET /detect-intraday-outlier-jumps | Visão ao vivo do tape de 1 min de hoje; em frequency (de list_options("intraday_frequency")); sinaliza barras cujo movimento é um outlier de sigma diário (síncrono, autenticado) |
get_aftermarket_data(symbols, start_datetime, end_datetime) | POST /get-aftermarket-data | Consulta barras armazenadas de 15 minutos após o expediente (abertura/máxima/mínima/fechamento/volume, 16:00-20:00 ET) para símbolos em um intervalo de datetime ET; linhas ordenadas por símbolo, hora da barra DESC (padrão hoje, autenticado, 300/min) |
predict_earnings_move(symbols) | POST /predict-earnings-announcement-move | Tamanho esperado do movimento de cada ação em sua próxima reação a resultados (ex.: NFLX expected_move 0,10, cerca de 10%), ao lado de sua própria média histórica |
list_earnings_announcements(start_date, end_date, symbols, industry, sector, market_cap) | POST /list-upcoming-earnings-announcements | Anúncios de resultados agendados em uma janela de datas (ambos padrão hoje), apenas nomes cobertos; sector / industry / market_cap validados no lado do servidor (422 em valor inválido) |
is_market_open(exchange) | GET /is-market-open | Uma bolsa está aberta agora (código sensível a maiúsculas, padrão NYSE) — roteia entre detect_intraday_outlier_jumps (aberta) e get_aftermarket_data (fechada). Público |
Triagem, portfólios e estratégias (tools/strategies.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
screen_stocks(metrics, sectors, sub_sectors, market_cap, analyst_ratings, institutional_ownership, countries, price_performance) | POST /screen-stocks | Trie o universo por métricas de crescimento, setor / sub-indústria, capitalização de mercado, classificações de analistas, propriedade institucional, país e desempenho de preço. Assíncrono → {task_id} (10/hora) |
optimize_portfolio_default(symbols, risk_tolerance) | POST /optimize-symbols-non-llm | Otimizador padrão — pesos otimizados por risco para uma lista de tickers, síncrono, sem LLM; tickers não suportados em missing, os de histórico curto em dropped. Público |
optimize_portfolio(symbols, risk_tolerance, delivery) | POST /optimize-symbols | Variante mais lenta curada por LLM: pontuação multi-sinal + curadoria por LLM + otimização de risco. Assíncrono → {task_id} (10/hora) |
get_stock_picks(strategy_name) | GET /get-stock-picks | Últimas seleções de ações escolhidas por LLM para o rebalanceamento atual (opcionalmente uma estratégia) |
get_strategy_performance_summary(amount) | GET /get-strategy-performance-summary | Leaderboard de cada livro de estratégia vs o S&P 500 desde o início (retorno, excesso, Sharpe, drawdown, YTD, crescimento de amount) — o primeiro lugar para "como estão as escolhas?" |
get_strategy_track_record(strategy_name, book, amount) | GET /get-strategy-track-record | A série diária desde o início de um livro vs o S&P 500 mais estatísticas principais; book = llm (padrão) ou mechanical, strategy_name pode ser pooled |
get_strategy_swaps(strategy_name) | GET /get-strategy-swaps | Livro-razão por negociação de adições / remoções semanais, cada uma medida contra o S&P 500 (remoções como retorno perdido) |
Agendamento (tools/scheduling.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
schedule_task(name, steps, regular_cron, delivery, description) | POST /save-user-workflow | Salvar um fluxo de trabalho de 1 a 8 etapas (fetch endpoints na allowlist + transform etapas) e anexar uma entrega recorrente via cron; upsert por slug em minúsculas name |
list_scheduled_tasks() | GET /get-scheduled-tasks | Os jobs cron do chamador (name, schedule, enabled, last_run_at, total_run_count); jobs de fluxo de trabalho são nomeados wf:{email}:{workflow-name} |
delete_scheduled_task(task_name) | DELETE /delete-scheduled-task | Remover um job cron pelo name completo de list_scheduled_tasks; a definição do fluxo de trabalho salvo é mantida |
Utilitários e cobrança (tools/utility.py)
| Ferramenta | Endpoint de backend | O que faz |
|---|---|---|
get_task_status(task_id) | GET /task-status | Consultar um job assíncrono para SUCCESS e ler seu result |
list_options(kind, ticker, q, cik) | GET /list-realtime-event-options, /list-financial-items, /list-financial-ratios, /list-as-reported-items?ticker=, /list-revenue-segments?ticker=, /list-institutional-managers?q=&cik=, /get-sectors, /list-institutional-investor-types, /list-countries, /get-fiscal-quarter, /list-marketcap-options, /list-intraday-chart-options, /list-technical-indicators, /list-tickers, /list-symbols-with-names | Uma ferramenta de catálogo: enumerar valores válidos para um parâmetro (tipos de evento, itens de linha, índices, conceitos XBRL conforme reportados pelo próprio declarante e segmentos de receita (ticker), gestores institucionais por fragmento de nome / CIK (q / cik), setores, tipos de investidor, países, trimestre fiscal, faixas de capitalização de mercado, frequências intradiárias, indicadores técnicos e o universo de tickers com ou sem nomes de empresas) |
list_sub_industries(sectors) | GET /get-sub-industries | Indústrias distintas dentro do(s) setor(es) fornecido(s) |
onboard_symbol(symbol) | POST /onboard-symbol | Solicitar onboarding de um ticker não coberto (assíncrono, autenticado, 5/hora) |
upgrade_plan() | GET /payment/upgrade-link | Link de checkout para atualizar ou alterar o plano do usuário (ex.: após atingir uma cota); o pagamento é concluído no navegador |
manage_billing() | GET /payment/portal-link | Link do portal de cobrança do Stripe — faturas, cartão, cancelamento |
Para uma única empresa nomeada, get_company_snapshot e get_company_event_web são o par padrão — as duas metades da mesma pergunta, geralmente chamadas juntas. O snapshot é o o quê (onde a empresa está agora: tese, fundamentos, técnica, propriedade, notas); a teia de eventos é o porquê (o episódio por trás disso: divulgação de resultados → 8-K → atualização de transcrição → publicação de RI → reação de analistas, com arestas mostrando como cada um se relaciona). Um snapshot sozinho é um veredito sem evidências; a teia é a evidência. A teia também é a chamada de fundamentação barata que torna o resto do loop preciso — cada nó carrega a chamada de acompanhamento exata, então a próxima list_realtime_events, explore_data_catalogue ou solicitação de relatório carrega tipos de evento e datas reais em vez de suposições.
Loop típico de agente: padrão para explore_data_catalogue(query) para perguntas abertas/exploratórias (rápido, gráficos/tabelas interativos). Escale apenas com intenção cristalina — get_latest_report(symbols) para o relatório existente de um ticker nomeado, screen_stocks(...) para filtrar o universo, ou generate_research_report(query) para um mergulho profundo explícito (~10-12 min, assíncrono — consulte com get_task_status).
Perguntou a mesma coisa duas vezes — ou a mesma pergunta sobre uma empresa diferente? explore_data_catalogue replaneja seu SQL toda vez, então, quando uma exploração termina, o agente se oferece para salvá-la: save_user_query armazena seus query_tokens, e o backend cria um gêmeo de espaço reservado de cada consulta — elevando ticker, lista de CIKs, data, intervalo e contagem para slots tipados — junto com o metadata da linha, que nomeia esses slots e resume o que a linha pergunta. run_saved_query então reproduz o queries da linha exatamente (as mesmas consultas contra dados ao vivo, em segundos, sem etapa de planejamento, sem consulta), ou pega os tokens query_placeholder da linha mais os values tipados para reorientar a solicitação para outras entidades — "as últimas 8 trimestres de vendas da TGT" salvo ontem responde "as últimas 8 trimestres de vendas da KSS" hoje, deterministicamente e sem modelo de linguagem no preenchimento, com o parameters substituído (e qualquer defaulted_parameters / ignored_values) retornado junto às linhas; um prompt ainda cobre o que o agente não pode digitar. list_saved_queries é a coisa a verificar antes de qualquer exploração, comparando a pergunta com o metadata de cada linha — summary, parameters, datasets — em vez do rótulo user_request, e pulando linhas marcadas como stale; delete_saved_query limpa uma. Passe max_rows em toda reprodução e escolha as consultas a executar de metadata.result_schema para que o companheiro _constituents (7.000–35.000 linhas) fique fora da chamada. Os tokens são texto cifrado opaco que o backend cunhou: passe-os inalterados, nunca construa ou edite um, e nunca mostre um ao usuário.
Quer relatórios no seu próprio formato? Um usuário fornece uma página HTML — cabeçalho, cores, layout, marca — e ela é salva como um blueprint: a folha de estilos e o chrome da página do autor, mais um padrão de marcação por tipo de conteúdo, que o backend aplica automaticamente a cada PDF que renderiza para esse usuário (get_latest_report renderiza de planos novos, generate_report_for_stock reconstruções, padrão e personalizado, e relatórios agendados). Um template é estrutura e estilo aplicados ao conteúdo do próprio documento: ninguém preenche a marcação do template, e nenhuma outra chamada muda. É uma escolha visual, então é aprovada olhando: draft_user_template compila a página sob vários tratamentos e renderiza cada um como prévias PNG do documento de espécime da plataforma (um add_on reestiliza uma seção do layout padrão, nomeado por anchor; um bespoke dirige o documento inteiro), o usuário escolhe um, e save_user_template(draft_id, variant_id) armazena esse tratamento — um template por usuário, com upsert. update_user_template muda qualquer campo depois, ou recompila o design armazenado quando chamado sem argumentos; get_user_template mostra o que está em vigor; delete_user_template retorna o usuário aos layouts padrão.
Não há construtor de PDF dirigido por agente: as ferramentas build_pdf_full_width / build_pdf_sidebar (backend /create-pdf e /create-pdf-sidebar) e o catálogo pdf_options foram aposentados em favor de templates. Quando um usuário quer um documento composto de dados Flexreport que nenhum relatório de backend cobre — incluindo uma abordagem sob medida de um relatório de empresa ("o relatório SNOW, construído em torno de receita de produto e RPO") — o agente explora os itens que ele nomeou, idealiza com ele sobre os conjuntos de resultados e constrói o PDF com sua própria ferramenta de documento, sobrepondo os resultados acordados no template salvo do usuário (get_user_template) quando um existe — e se oferecendo para rascunhar um (rascunho → prévia → salvar, depois atualizar) quando nenhum existe.
Relatórios são sob demanda: nada é regenerado até que alguém peça. Os dois endpoints de relatório são estritamente separados:
get_latest_report→/get-cached-reportsé o caminho rápido. Um plano de relatório salvo é JSON — resumo, consultas, resultados, mapa de formato — construído no momento em que um evento material publica para um símbolo (ou por uma reconstrução) e atualizado todas as noites enquanto suas entradas mudam. Quando o plano de um símbolo está fresco (tem um mapa de formato, com menos de 7 dias, não mais antigo que as últimas entradas de relatório do símbolo, lê o lado certo da divisão EDGAR/FMP), o endpoint não retorna um PDF pré-construído: ele renderiza esse plano no template do usuário em ~10-20 s e lista o símbolo sobrenderingcom umtask_idpara consultar. Todo outro símbolo volta como seu PDF em cache marcadostale(true= o plano em si está desatualizado — uma impressão, um arquivamento, uma atualização 13F chegou depois) ou cai emmissing.generate_report_for_stock→/create-full-reporté uma reconstrução completa (~10 min), usada com moderação. O agente a chama com o ticker sozinho apenas quandoget_latest_reportretornou o símbolostaleoumissinge o usuário quer esperar; o plano reconstruído é salvo, então chamadasget_latest_reportposteriores o renderizam em segundos. Nunca para um símbolo emrendering, e nunca distribuído por uma lista.- Solicitações sob medida passam por exploração, não por reconstrução. O agente explora os itens que o usuário nomeou (
list_saved_queries, depoisexplore_data_catalogue), idealiza com ele sobre os conjuntos de resultados e sobrepõe os resultados acordados no template dele (get_user_template) com sua própria ferramenta de documento.
list_available_reports(event_types, report_date) é o inventário desses planos salvos, limitado a planos construídos em ou após report_date (padrão hoje) — quais símbolos têm pesquisa em tempo real pronta e se cada um é fresh (get_latest_report o renderiza em segundos) ou reconstruiria (minutos) — para que o agente possa ir de list_realtime_events (um evento publicado) a um relatório fresco sem adivinhar, ou pular a etapa de eventos e listar o que está disponível diretamente. Para "puxar os relatórios mais relevantes hoje", os eventos são o filtro e os planos são a verificação de disponibilidade, nessa ordem: puxe os tipos materiais (transcript_update, 8k_release, ir_publication, eps_release, financials_release) e a fita (biggest_mover, biggest_loser), leia o conteúdo, confirme a significância contra a ação de preço intradiária (detect_intraday_outlier_jumps), compare os sobreviventes com planos usando list_available_reports(event_types=[...]) e puxe apenas aqueles com get_latest_report. situate apresenta isso como uma sugestão em todo plano de mercado, carregando report_date quando a janela em tempo real de 12h abriu em uma data UTC anterior. Apenas um pedido explícito pelo relatório do pipeline reconstruído em torno de itens nomeados o torna um relatório personalizado — user_override=true mais as listas de modelagem (financial_items, ratios, as_reported_financial_items, revenue_segment, technical_analysis_items, estimate_items, institutional_ownership CIKs, include_as_report_financials / as_reported_periods) — que é uma construção completa (~10 min) que nunca é salva. O backend rejeita listas de modelagem sem o switch (422), então a ferramenta o define sempre que um campo de modelagem não está vazio. Vocabulários vêm de list_options: financial_items, financial_ratios, technical_indicators, e o as_reported_items / revenue_segments com escopo de ticker e o institutional_managers com escopo de q (retorna CIKs). O contexto de evento é de propriedade do servidor — a solicitação não carrega tese, resumo de mudança, include_* ou campos de data de preço.
Layout do código
server.py            entrypoint: imports the tools package, adds /health, runs the transport
core.py              the FastMCP instance, server instructions and `_send` (backend forwarding)
client.py            shared httpx client + inbound-bearer forwarding
auth_verifier.py     OAuth resource-server token validation (RS256 via the backend JWKS)
situate.py           pure composition logic behind the `situate` tool
instructions.json    server instructions (non-code copy)
tools/
  realtime_events.py     situate, list_realtime_events, company snapshot / event web, event ontology
  event_subscriptions.py stream_events, register / stream / delete_event_subscription (SSE bounded reads)
  pdf_reports.py         get_latest_report, list_available_reports, generate_*, download_pdf_from_url, PDF templates
  data_exploration.py    explore_data_*, signed drilldowns, trace_data_sources, document sections, saved queries
  utility.py             get_task_status, list_options, list_sub_industries, onboard_symbol, billing
  market_data.py         technical indicators, intraday outliers, after-hours bars, earnings calendar + move prediction, market status
  strategies.py          screen_stocks, portfolio optimization, stock picks, strategy track records
  scheduling.py          schedule / list / delete scheduled tasks
Cada módulo faz from core import mcp, _send e registra com @mcp.tool(...);
importar tools registra tudo. tools/__init__.py corrige a ordem de importação,
que é a ordem em que as ferramentas são anunciadas aos clientes (situate primeiro).
Executar localmente
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env          # set API_BASE_URL, MCP_HOST, MCP_PORT
set -a && source .env && set +a
python server.py              # serves streamable-http on http://MCP_HOST:MCP_PORT/mcp
Autenticação
O servidor é um Servidor de Recursos OAuth 2.0 e sem estado (amigável a balanceadores de carga), então a autenticação acompanha cada chamada. Ele não mantém nenhuma credencial e nenhum segredo de assinatura — ele valida o token de portador recebido e o encaminha ao backend, que aplica escopo, plano e cota.
Como funciona
O login é um fluxo padrão de código de autorização + PKCE no navegador, executado pelo seu cliente MCP (ex.: Claude) contra o backend FlexReport, que é o Servidor de Autorização. Registre-se ou entre com email + senha, ou use o Google Sign-In — você nunca cola ou digita um token:
- Em uma solicitação sem token válido, o servidor retorna
401com um desafioWWW-Authenticatee serve Metadados de Recurso Protegido em/.well-known/oauth-protected-resource, apontando o cliente para o AS do backend. - O cliente abre seu navegador; você entra / consente e recebe um token de acesso RS256 emitido pelo backend.
- O servidor valida esse token em toda chamada — assinatura via JWKS do
backend (chave pública RS256) mais
aud,isseexp— então o encaminha ao backend. Inválido ou expirado → um401limpo e o cliente reexecuta o fluxo. O servidor nunca vê sua senha e nunca mantém a chave de assinatura — ele permanece um proxy sem credenciais. Apenas tokens OAuth RS256 válidos são aceitos; não há fallback de senha ou JWT estático.
Config (env)
| Var | Padrão | Finalidade |
|---|---|---|
OAUTH_ISSUER | https://app.flexreportfinapi.com | Token esperado iss + servidor de autorização anunciado. Deve corresponder ao iss do backend — produção usa o domínio raiz https://flexreportfinapi.com. |
OAUTH_AUDIENCE | = OAUTH_ISSUER | Token esperado aud. Defina ambos os lados para a URL MCP canônica para vinculação real de audiência. |
OAUTH_JWKS_URL | {issuer}/.well-known/jwks.json | Onde as chaves públicas são buscadas (desacoplado do emissor para rede de contêineres). |
MCP_RESOURCE_URL | https://mcp.flexreportfinapi.com/mcp | Identificador de recurso canônico deste servidor (o PRM resource). |
Cabeçalho estático
Configure Authorization: Bearer <OAuth access token> no seu cliente MCP e o servidor valida e encaminha como qualquer outra chamada — útil para testes com um token cunhado em outro lugar. Nada é armazenado em repouso; os tokens são encaminhados por chamada.
Conectar a um cliente MCP
.mcp.json (Claude Code):
{
  "mcpServers": {
    "flexreport": {
      "type": "http",
      "url": "http://localhost:8000/mcp",
      "headers": { "Authorization": "Bearer <YOUR_OAUTH_ACCESS_TOKEN>" }
    }
  }
}
Verificar com o MCP Inspector
npx @modelcontextprotocol/inspector
# Connect to http://localhost:8000/mcp with header Authorization: Bearer <OAuth access token>
# Confirm the tools list loads (46 tools), then exercise:
#   list_realtime_events("eps_update")        -> events (or [])
#   get_company_event_web("NVDA")             -> event graph (or an empty/degraded web)
#   get_latest_report(["AAPL"])               -> rendering task_id, cached PDF url, or missing  [named-ticker report; max 100 symbols]
#   list_available_reports(["eps_release"])   -> plans built today with `fresh` flags (or []); report_date="YYYY-MM-DD" widens
#   explore_data_catalogue("MU EPS growth last 8 quarters")  -> task_id  [default exploratory route]
#   get_task_status(task_id)                  -> eventually SUCCESS
# Negative: connect with no/invalid token     -> 401 + WWW-Authenticate challenge
Implantar
Construa a imagem e execute-a como um contêiner próprio (por exemplo, um serviço ECS separado com sua própria definição de tarefa), independente da API e dos workers Celery. Defina API_BASE_URL para a URL do backend implantado.
docker build -t flexreport-mcp .
docker run -p 8000:8000 -e API_BASE_URL=https://flexreportfinapi.com flexreport-mcp
Privacidade
A política de privacidade da FlexReport — o que é coletado, janelas de retenção e os terceiros envolvidos — está publicada em app.flexreportfinapi.com/privacy (fonte: PRIVACY.md).