Lexicon
Um léxico pessoal para voz-para-agentes. Um arquivo YAML com as palavras que o reconhecimento de fala erra, aplicado em todos os lugares onde sua voz chega: MCP, Claude Code, o navegador, macOS.
Documentação
Lexicon
Um léxico pessoal para voz-para-agentes.
Um arquivo YAML com as palavras que o reconhecimento de fala erra, aplicado em todos os lugares onde sua voz chega: MCP, Claude Code, navegador, macOS.


Demonstração ao vivo · Início rápido · Documentação · lexicon.ashlr.ai
You said:        "tell Ashlr.AI to deploy the Kubernetes auth service"
STT heard:       "tell Ashler to deploy the Cooper Nettie's off service"
Agent received:  "tell Ashlr.AI to deploy the Kubernetes auth service"
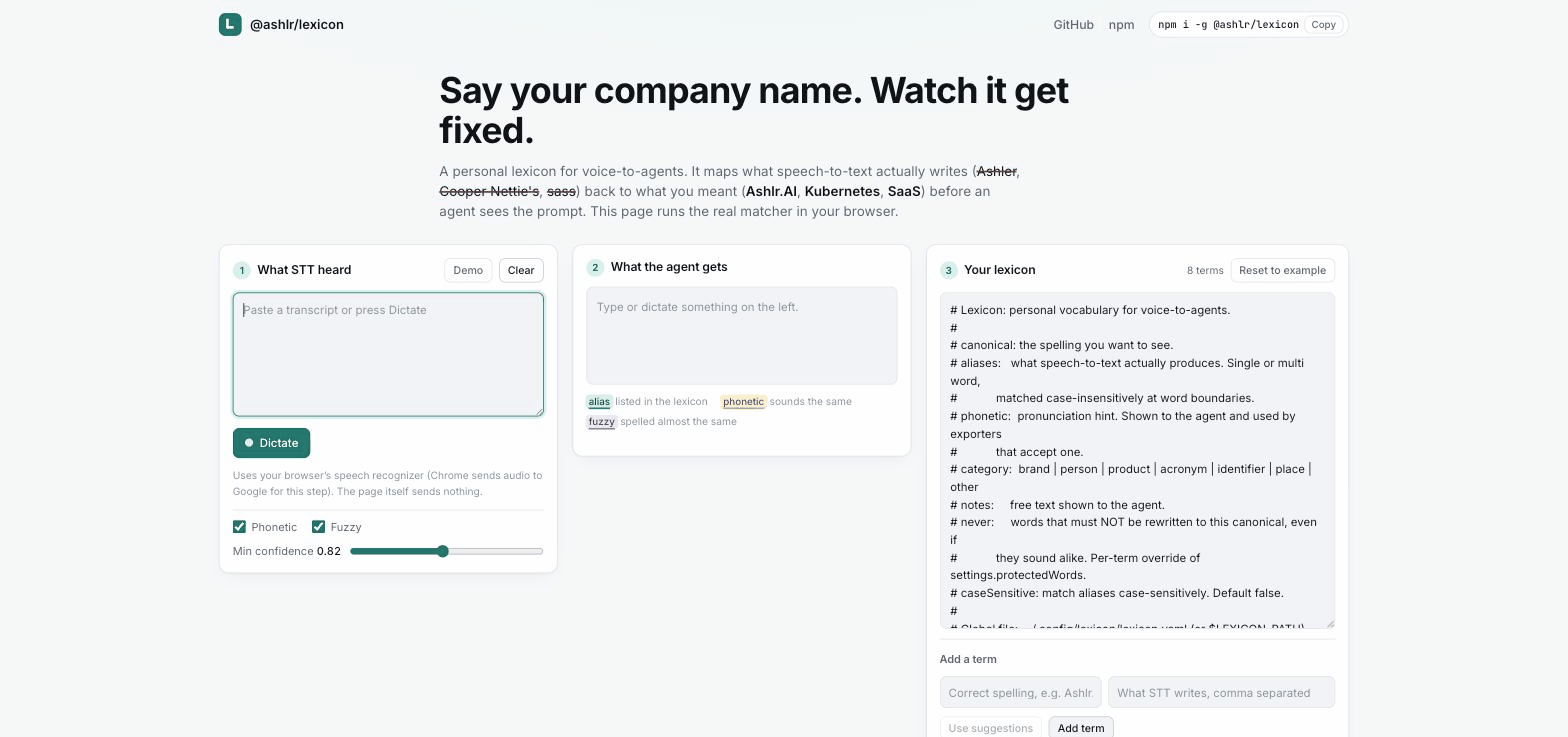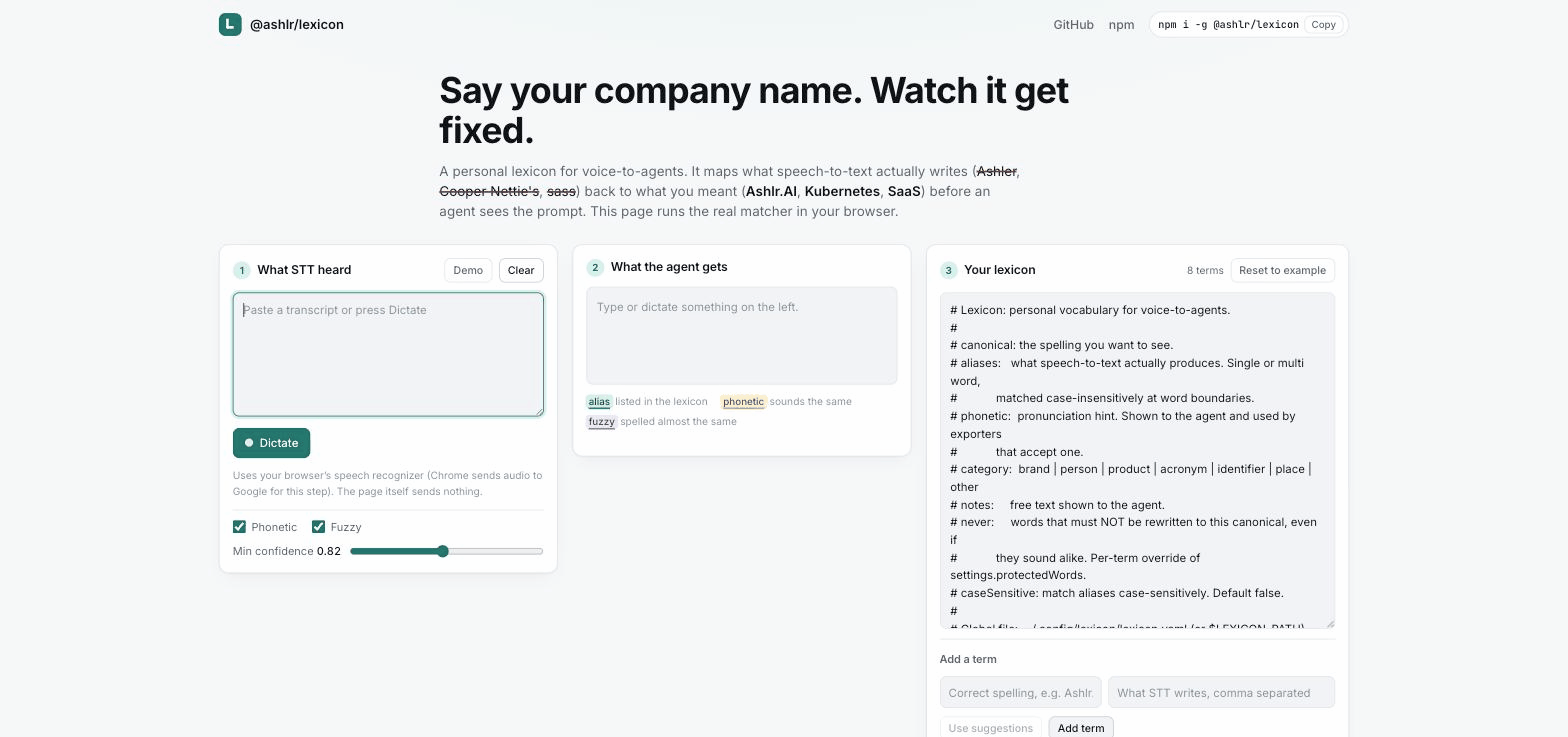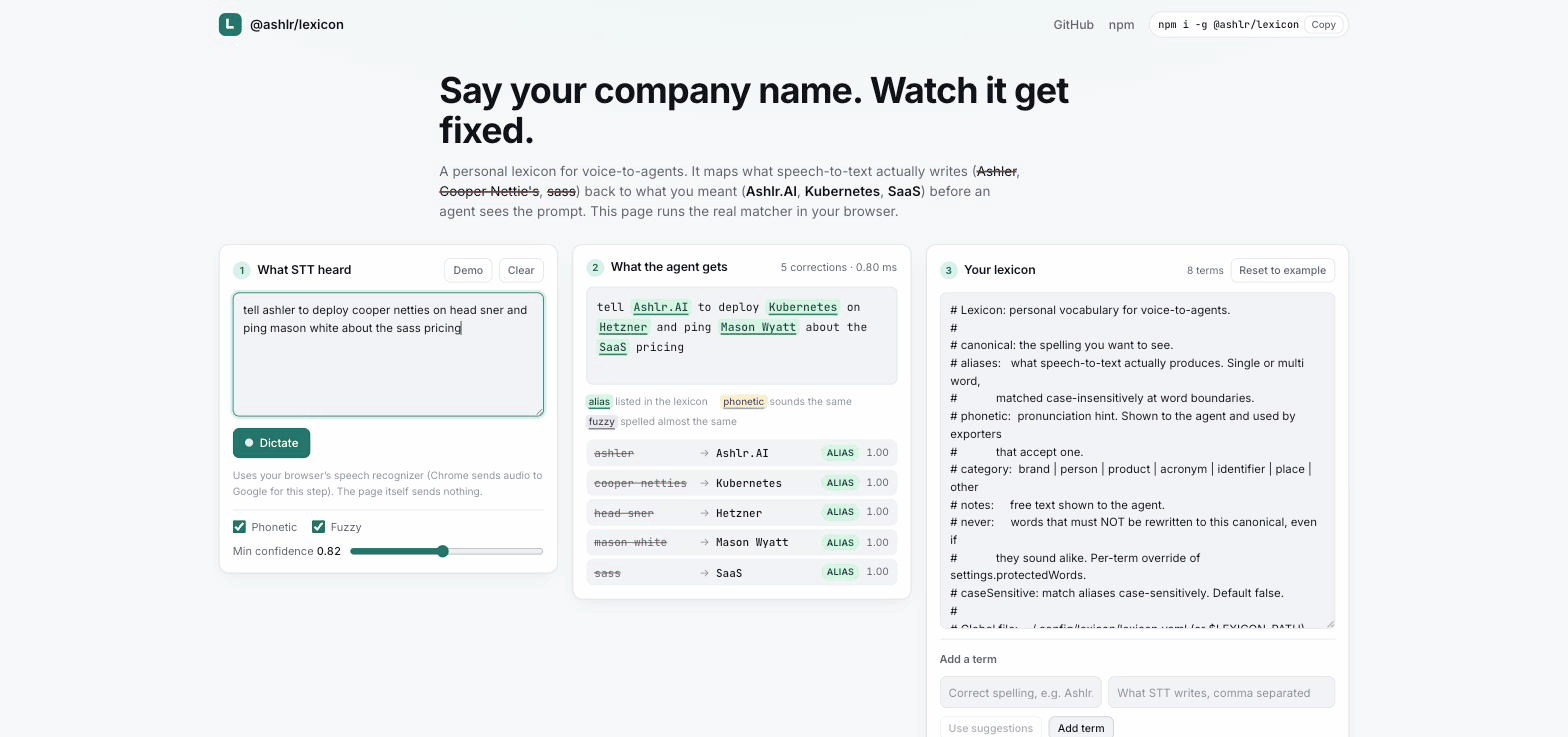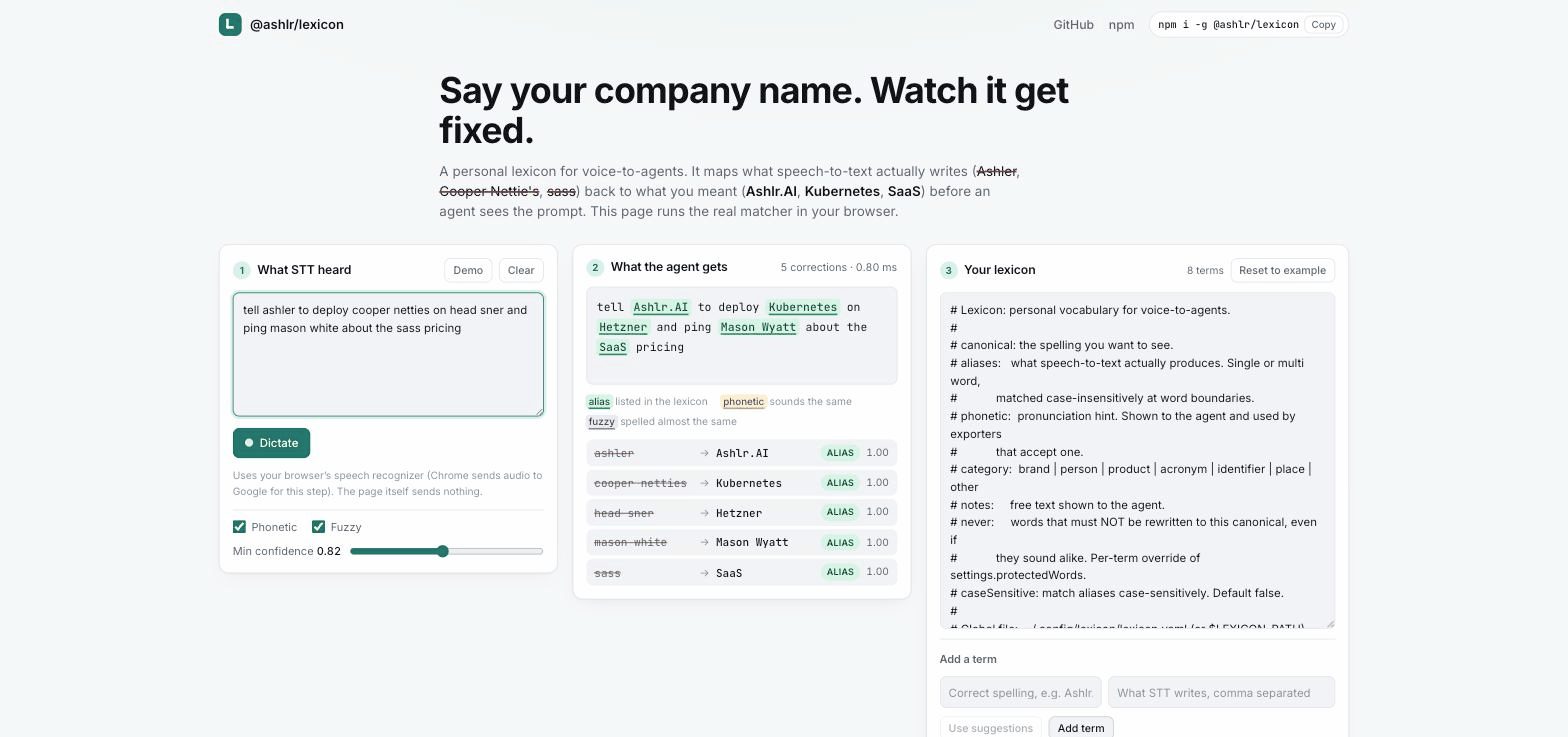
Essa é a demonstração ao vivo executando o matcher real deste repositório no seu texto, no seu navegador, sem nada instalado. (O botão Dictate usa o reconhecedor de fala do próprio navegador, que no Chrome envia áudio para o Google.)
Medido
Método, tabelas completas e todos os casos de falha estão em docs/BENCHMARK.md. Reproduza com npm run bench (sem configuração além de um clone), ou npm run bench:audio && npm run bench:compare (requer macOS e whisper.cpp).
Contra as alternativas. 330 clipes de áudio real através do whisper.cpp small.en, três vozes. Mesmo áudio, mesmo reconhecedor, mesmo léxico de 70 termos em cada linha; a única coisa que muda é como os nomes próprios são corrigidos.
| como as palavras são corrigidas | nomes próprios recuperados | prosa limpa alterada indevidamente |
|---|---|---|
| nada, whisper.cpp bruto | 45,9% | n/d, nada é executado |
| substituição exata de string, a abordagem de Substituição de Texto do macOS | 62,0% | 0 de 72 |
| o mesmo, mais uma regra de capitalização por termo | 71,3% | 0 de 72 |
a própria lista de dicas --prompt do whisper.cpp | 76,0% | n/d, nada é executado |
| Lexicon | 91,0% | 0 de 72 |
Cada linha usa o mesmo léxico curado de setenta termos (bench/lexicon.yaml). A coluna de prosa é uma propriedade dos termos no arquivo tanto quanto do matcher, então um léxico montado de outra forma é uma medição diferente.
A substituição exata recupera as grafias que alguém já anotou, e nada mais. Ela não consegue alcançar Versal, Superbase, CloudFloor ou pedantic, porque nenhuma tabela escrita à mão contém o erro que você ainda não ouviu. As camadas fonética e difusa existem para essa lacuna e recuperam 31 dos 279 espaços de termos por conta própria, o que equivale a 11 pontos. Os 9 pontos restantes sobre a linha com capitalização vêm da tolerância da camada de aliases para como o reconhecedor divide um nome em palavras, já que essa linha já corresponde à capitalização. --prompt é um complemento, não um rival: empilhado com o léxico, alcança 95,7%.
Duas notas honestas sobre essa tabela. O whisper.cpp bruto não pode alterar prosa indevidamente porque nada é executado, o que é a ausência do recurso, não uma vantagem. --prompt não é o mesmo caso: ele enviesa o próprio reconhecedor, então o que ele altera já está no transcript antes da pontuação começar, enquanto a métrica conta frases que uma pós-passagem alterou. Essa célula é não medida, não zero. Descobrir para que lado ela vai exigiria comparar transcripts com dicas contra os sem dicas, o que este harness não faz.
Antes e depois.
| corpus | nomes próprios recuperados, STT bruto | após o léxico | prosa limpa alterada indevidamente |
|---|---|---|---|
| áudio real, whisper.cpp base.en (330 clipes) | 41,9% | 82,8% | 0 de 72 |
| áudio real, whisper.cpp small.en com dicas de prompt | 76,0% | 95,7% | 0 de 72 |
| erros STT sintéticos (402 frases, 70 termos) | 5,1% | 96,5% | 0 de 95 |
A latência é de cerca de 0,3 ms por frase. As linhas de áudio real usam texto-para-fala do macOS lido no whisper.cpp, então são mais limpas do que um microfone de telefone.
Os 5,1% sintéticos não são uma afirmação de que o reconhecimento de fala acerta 5% dos nomes próprios em geral. Cada frase nesse corpus foi escrita para conter um erro de audição, então 5,1% é apenas o punhado que saiu certo de qualquer forma. O número "antes" honesto é o de áudio real, 41,9%.
A última coluna conta apenas prosa comum. Cada corpus também contém frases deliberadamente construídas para enganar o matcher (um "llama" solto ao lado de um termo Ollama, sons parecidos, trechos de código), marcadas como expected-hard; com elas incluídas, a taxa de falsos positivos é de 15,3% (19 de 124) sintético e 16,7% (15 de 90) em áudio. Ambos os números, e cada caso de falha, estão em docs/BENCHMARK.md.
Instalação
O pacote é @ashlr/lexicon; o comando é lexicon.
curl -fsSL https://ashlrai.github.io/lexicon/install.sh | sh   # CLI + the setup wizard
brew install ashlrai/tap/lexicon                               # or Homebrew (macOS, Linux)
npm i -g @ashlr/lexicon                                        # or npm (Node 20+)
Depois abra o Claude Code e diga uma frase com o nome da sua empresa. Pronto.
O script de instalação executa lexicon setup por você (LEXICON_NO_SETUP=1 pula isso); após uma instalação via Homebrew ou npm, execute você mesmo. Cada etapa é opcional e segura para repetir, e lexicon setup --dry-run não escreve nada enquanto descreve a execução que você teria com o mesmo comando sem ele: as etapas que seriam realizadas e aquelas em que ele pararia e perguntaria, com a resposta que pressionar Enter dá a cada uma.
Com Homebrew, use sempre o nome completo do tap ashlrai/tap/lexicon. O simples brew install lexicon instala dns-lexicon, uma ferramenta DNS não relacionada no homebrew-core.
O que lexicon setup faz, em sete etapas numeradas
- Semeia o léxico com seu nome e sua empresa, com os erros de grafia que o STT produzirá para cada um.
- Oferece os pacotes iniciais como uma lista de verificação.
- Coleta o repositório atual em busca de nomes já presentes no seu código.
- Registra o servidor MCP e os hooks em cada cliente de agente que detecta.
- Instala a API local como um serviço de login.
- Exporta para seu aplicativo de ditado.
- Dita uma frase construída a partir dos termos que acabou de semear e mostra a correção.
O passo a passo completo, com a saída real do terminal, está em docs/QUICKSTART.md.
Ou pule o assistente e adicione um termo manualmente. O primeiro argumento é a grafia canônica, o restante é o que o STT realmente produz:
lexicon add Ashlr.AI Ashler Ashlar "Ashler AI" --phonetic ASH-ler
lexicon normalize "tell Ashler to ship it"
# tell Ashlr.AI to ship it
Plugin do Claude Code, se você preferir não instalar uma CLI. Sem etapa de instalação do Node, sem build:
claude plugin marketplace add ashlrai/lexicon
claude plugin install lexicon@ashlrai
lexicon doctor verifica a instalação. Não há telemetria e todo o estado são arquivos locais: a CLI, hooks, servidor MCP, API local e extensão não fazem nenhuma requisição além de loopback. A única requisição de saída no código é lexicon voice baixando um modelo whisper no primeiro uso. O script de instalação, npm e Homebrew buscam o próprio pacote. Veja SECURITY.md.
Por quê
O reconhecimento de fala tem cerca de 95% de precisão em inglês comum e é muito pior em nomes inventados. No benchmark acima, o whisper.cpp base.en bruto transcreveu corretamente 117 de 279 nomes próprios ditados. "Ashlr.AI" vira "Ashler", "Kubernetes" vira "Cooper Nettie's", "SaaS" vira "sauce", "auth" vira "off". Essas são exatamente as palavras que um agente precisa acertar.
Aplicativos de ditado (Wispr Flow, Superwhisper, Aqua) cada um mantém seu próprio dicionário e nenhum deles o compartilha. Agentes (Claude Code /voice, voz do ChatGPT, Codex, Whisper local) executam seu próprio reconhecedor sem vocabulário de usuário algum. Esta é a camada portátil no meio: correções acontecem após o STT e antes do modelo, onde quer que o texto passe.
Isso não é um aplicativo de ditado. Ele fica entre o ditado que você já usa e o agente com quem você fala. A pesquisa por trás dessa decisão, incluindo os critérios de eliminação, está em docs/RESEARCH.md.
O que você obtém
- Dezenove ferramentas MCP, dois recursos e dois prompts, para Claude Code, Codex, Cursor, Windsurf, Gemini CLI, VS Code e Claude Desktop. Seu agente pode executar sua própria configuração:
setup_lexicon,lexicon_doctor,install_client,trust_project,import_dictionaryesuggest_termssignificam que "configure meu léxico" funciona sem terminal. As ferramentas que alteram sua máquina mostram uma prévia primeiro:setup_lexiconeinstall_clientretornam um plano e não escrevem nada até o agente passarapply: true,trust_projectmostra os termos do arquivo antes de fixá-lo, eimport_dictionaryaceitadryRun. - Um plugin do Claude Code: servidor MCP, hooks
SessionStarteUserPromptSubmit, uma habilidadelexicone um comando/lexicon. Instala a partir do marketplace deste repositório sem etapa de build. - Uma CLI com 25 comandos, de
lexicon addalexicon voice. - 155 termos iniciais em quatro pacotes (desenvolvedor, IA, negócios, ferramentas de voz), um comando para cada.
- Quinze formatos de exportação (Wispr Flow, Superwhisper, Substituição de Texto do macOS, espanso, prompts Whisper e OpenAI, Deepgram, AssemblyAI, Azure, Google, CLAUDE.md, markdown, texto, CSV, JSON) e sete importadores para o dicionário que você já treinou.
- Coleta de repositório, aprendizado de correção ("é Ashlr.AI, não Ashler"), estatísticas de uso, sugestões extraídas do seu histórico de voz e um portão de confiança para léxicos de projeto.
- Uma biblioteca simples.
normalize()é uma função pura: texto mais léxico na entrada, texto corrigido e uma lista de substituições na saída.
Onde se aplica
| Superfície | Como | Documentação |
|---|---|---|
| Claude Code | Plugin, ou servidor MCP mais dois hooks que corrigem o prompt antes de o modelo lê-lo | CLIENTS.md |
| Codex, Cursor, Windsurf, Gemini CLI, VS Code, Claude Desktop | lexicon install <client> --apply registra o servidor MCP | CLIENTS.md |
| Qualquer cliente MCP | servidor stdio, dezenove ferramentas | MCP.md |
| ChatGPT, Claude.ai, Grok, Gemini, Perplexity, Poe, Copilot | Extensão de navegador: reescreve o compositor quando você pressiona enviar | EXTENSION.md |
| Qualquer aplicativo macOS, qualquer ferramenta de ditado | Aplicativo de barra de menus LexiconBar: reescreve texto ditado no campo focado via Accessibility, com um balão de desfazer | MACOS-APP.md |
| Shortcuts, Raycast, scripts, seu próprio aplicativo | lexicon serve: API HTTP de loopback em 127.0.0.1:41733 atrás de um token bearer | LOCAL-API.md |
| Ditado sem aplicativo de ditado | lexicon voice: ffmpeg grava, whisper.cpp transcreve com seus canônicos como dicas de prompt, o léxico corrige | VOICE.md |
| Qualquer campo de texto, qualquer SO | lexicon daemon --once --paste em uma tecla de atalho | DAEMON.md |
| Wispr Flow, Superwhisper, Substituição de Texto do macOS, espanso, Deepgram, Azure, Google | Exporte para seus próprios dicionários e parâmetros de enviesamento | EXPORTS.md |
| Seu próprio pipeline de STT | npm i @ashlr/lexicon, chame normalize() entre a transcrição e o modelo | LIBRARY.md |
| Qualquer um dos acima, no Windows ou Linux | Quais superfícies são testadas em CI em cada SO, quais funcionam mas nunca foram executadas em hardware real, e quais não existem | PLATFORMS.md |
Como funciona
Três camadas sobre janelas de tokens: alias exato primeiro, depois fonético double-metaphone, depois difuso Damerau-Levenshtein acima de um piso de confiança. Correspondências exatas vencem o trecho; correspondências nunca se sobrepõem. Uma lista de bloqueio de cerca de 3400 palavras comuns em inglês, listas never por termo e (com o skipCode padrão) trechos de código, URLs, e-mails, caminhos e identificadores colados são todos proibidos. É por isso que zero frases limpas foram alteradas no benchmark. Cada substituição relata seu reason e confidence.
lexicon normalize --diff "deploy to head sner with cuban eatties"
# stderr:  "head sner" -> "Hetzner" (alias, 1.00)
#          "cuban eatties" -> "Kubernetes" (phonetic, 0.86)
# stdout:  deploy to Hetzner with Kubernetes
As regras completas, incluindo cada proteção, estão em docs/MATCHING.md.
Documentação
O índice completo está em docs/, agrupado por tarefa: comece, use com seu cliente, entenda como funciona, contribua, detalhes internos. As três páginas que a maioria das pessoas precisa:
| Página | O que cobre |
|---|---|
| QUICKSTART.md | Cinco minutos do zero até correções no Claude Code, com o que cada etapa de configuração escreve |
| CLIENTS.md | Instalação no Claude Code (plugin, hooks, headless) e em todos os outros clientes de agente |
| FAQ.md | As perguntas que as pessoas fazem antes de instalar |
| Escrevendo um agente que instala isso para alguém? docs/AGENTS.md é escrito | |
| para você. Alterando o código? Comece em CONTRIBUTING.md e | |
| docs/ARCHITECTURE.md. |
Também na raiz: SECURITY.md, CODE_OF_CONDUCT.md, CHANGELOG.md.
Downloads
Cada lançamento do GitHub anexa a extensão do navegador para Chrome/Edge/Brave e para Firefox, LexiconBar.app.zip para macOS, o tarball npm para instalações offline e SHA256SUMS. A fórmula Homebrew vive em ashlrai/homebrew-tap; npm i -g github:ashlrai/lexicon#v0.5.4 instala uma tag diretamente do GitHub e compila na instalação.
Roadmap e não-objetivos
Não-objetivos: isto não é um aplicativo de ditado, e não há contas hospedadas nem serviço de sincronização. É um arquivo.
- Listagens na Chrome Web Store e no Firefox AMO para a extensão. Hoje ela instala a partir do zip de lançamento.
- Aplicativo macOS notarizado. O LexiconBar é assinado ad-hoc, então o primeiro lançamento precisa de clique com o botão direito e Abrir.
- Aplicativo de bandeja para Linux com as mesmas ações de push-to-talk e corrigir área de transferência. O para Windows está construído: veja docs/WINDOWS-APP.md.
- Fonética não-inglesa. O double metaphone é ajustado para inglês; nomes em outros idiomas recorrem à correspondência difusa.
- Benchmark com microfone real. O corpus de áudio é texto-para-fala do macOS lido no whisper.cpp, não fala gravada.
Contribuindo
Boas primeiras issues são rotuladas e escopadas: um novo pacote inicial, um exportador, um importador, uma fonte de coleta. CONTRIBUTING.md tem a configuração, o layout de testes e uma receita para cada uma.
Encontrou um nome que ele erra? Abra uma issue de termo ouvido errado.
Licença
MIT. Copyright 2026 AshlrAI, Inc.